Omni-Woodpecker:基于证据-先验再平衡的全模态大模型幻觉校正 Omni-Woodpecker: Hallucination Correction via Evidence-Prior Rebalancing for Omni LLMs
免训练框架在融合表征内诊断跨模态冲突、正交分离证据与先验并自适应再平衡,修正全模态幻觉
前置知识
对比解码(Contrastive Decoding)
一种推理时的幻觉缓解技术:把原始输入与被扰动(遮挡、加噪)的输入分别送入模型得到两组 logits,用两组分布之差修正最终输出,惩罚那些在感知输入退化后依然高概率出现的 token。VCD(视觉对比解码)、AVCD(音视频对比解码)、DoLa(层间对比)都属于这一类,全部只作用于最后的解码分布。
OWP 的主要对比基线 AVCD、MAD 都是输出级方法。理解对比解码的'只改输出、不动内部',才能体会 OWP 把干预点前移到融合隐藏状态这一转变的意义。
早期融合全模态大模型(Early-fusion OLLM)
把音频、视频编码器的输出 token 与文本拼进同一个 LLM 上下文、在一次前向中联合推理的架构(如 Qwen2.5-Omni、VideoLLaMA2-AV)。各模态信息在解码开始之前的隐藏状态里就已经混合,这个混合态称为融合表征(fused representation),幻觉正是在这里形成的。
OWP 的核心论点是:证据与先验在融合表征中早已纠缠,因此必须在融合后的隐藏状态上动手,而不是像传统方法那样只在输出端补救。
残差流与表征编辑(Residual Stream / Representation Editing)
Transformer 各层输出会叠加进残差流(hidden state)。表征编辑不改动权重,而是在推理时沿某个方向对隐藏状态做加减:ITI 沿'真实性方向'平移激活,RepE 用对比提示集提取行为方向,HulluEdit 在视觉证据子空间做单次编辑。编辑向量通常取两个对比状态下探针 token 的状态差并归一化。
OWP 的残差分支编辑(抑制先验方向、补偿证据亏缺)正是这类技术在全模态模型上的扩展,是理解其干预机制的直接前置知识。
注意力头与值向量贡献(Attention Heads & Value Contributions)
多头注意力中每个头把 token 的值向量(value)加权聚合进输出。若把某个头的输出按注意力来源分解,可以度量该头分别从音频、视频、语言 span'搬运'了多少信息,从而定位负责传递竞争性先验或目标证据的头,并对这些头的值输出做定向加减。
OWP 的路径级编辑先要诊断出竞争头集合 $H^-_\ell$ 与证据头集合 $H^+_\ell$,再在聚合前改写这些头送出的值向量;不懂逐头归因就看不懂这一步。
正交投影(Orthogonal Projection)
把向量 $e$ 沿单位方向 $u$ 分解后,剩余分量 $e-(u^\top e)u$ 与 $u$ 正交(内积为零)。抑制这个正交分量在数学上保证不会破坏沿 $u$ 方向保存的信息,这是子空间编辑中'删 A 不伤 B'的标准手段。
OWP 用正交性实现'抑先验不伤证据':先固定证据方向 $u_\ell$,再把先验方向 $p_\ell$ 定义为融合偏移去掉证据分量后的正交残余,满足 $p_\ell^\top u_\ell=0$。
CMM 与 AVHBench 基准
CMM 包含 1,200 条跨模态冲突样本,把失败分为语言主导、视觉主导、音频主导,并用感知准确率 PA 与幻觉抵抗率 HR 两个指标衡量;AVHBench 包含 5,302 条样本,测试音频驱动的视觉幻觉(audio→video)、视觉驱动的听觉幻觉(video→audio)以及音视频匹配(AV Matching)。
本文所有主结果都在这两个基准上报告,PA-HR 差距(89.5% vs 57.0%)正是论文'感知没问题、融合出问题'论点的关键证据。
研究动机
全模态大模型(OLLM)将音频、视频与文本放进同一个 LLM 联合推理,但当下游查询所需的模态证据与另一条模态流或语言先验冲突时,模型会跟随更显著的线索而压制真实证据。论文给出的典型例子是:问“Is the dog barking?”,即使音频里完全是静音(模型确实编码了“无声”这一证据),强烈的视觉先验(看到一只狗)也会在融合阶段覆盖音频证据,最终答出“狗在叫”。基准数据同样触目:在 CMM 上,Qwen2.5-Omni-7B 的感知准确率 PA 高达 89.5%,但幻觉抵抗率 HR 只有 57.0%,二者相差 32.5 个百分点——模型“看得见、听得着”,却在融合时把证据压没了。现有缓解手段(VCD/AVCD 对比解码、MAD 模态自适应解码、OmniDPO/MoD-DPO 偏好优化)无论用于训练还是推理,都作用于最终解码分布或模型权重;而早期融合 OLLM 中证据与先验早在解码前就已纠缠,这些方法无法修复真正导致幻觉的内部隐藏状态,冲突依旧悬而未决。
本文的目标是本文的目标是把全模态幻觉的矫正从“输出端补救”前移到“表征端修复”,提出完全免训练的框架 Omni-Woodpecker(OWP):不改任何模型参数、不改语言头和解码规则,只在推理时对冻结 OLLM 做三件事。(1) 用同一冻结模型的四个输入视图(完整输入、仅音频、仅视频、纯文本)诊断出该查询真正需要的证据流(target)与与之竞争的先验流(competing);(2) 在隐藏状态中通过正交分解把“应保护的证据方向”与“应抑制的竞争方向”分开,并量化融合状态丢失了多少目标证据(evidence deficit $g_\ell$);(3) 按诊断出的冲突强度,把一份修正预算自适应地分配到注意力路径编辑与残差状态编辑两个位点,在解码前恢复被压制的证据、衰减误导性先验。量化目标很明确:把 CMM 上 32.5 分的 PA-HR 差距重新拉近(最终缩到 1.2 分),同时在音视频双向冲突上都取得修正,并保持乃至提升通用推理能力。
与已有工作不同的是,切入角度的独特性在于“按查询逐样本诊断冲突,再在表征内部按冲突定制修正”。此前的表征级编辑方法(ITI、RepE、HulluEdit)都假设一个固定的对立面——通常是感知证据 vs 语言先验——并对每个输入施加同一条编辑方向,一次写完;MAD 这类查询条件方法也只用模态相关性去加权输出分支,既不控制引发错误的相互作用,也不识别哪条流在与查询竞争。OWP 则明确回答两个问题:目标流是什么、竞争流是什么,编辑方向直接由这两个流的视图状态差在线构造;并且不把修正预算一次性花完,而是依据融合视图对答案的偏好 $\Delta_F(x)$ 把预算在注意力路径与残差状态之间动态分配。此外 OWP 强调“证据保留”:非目标流并非整体有害,只有其中支持竞争答案的成分才被分离进正交先验方向,因此抑制先验时不会误伤有用上下文,这正是与 HulluEdit 单向子空间编辑的本质差别。
核心方法
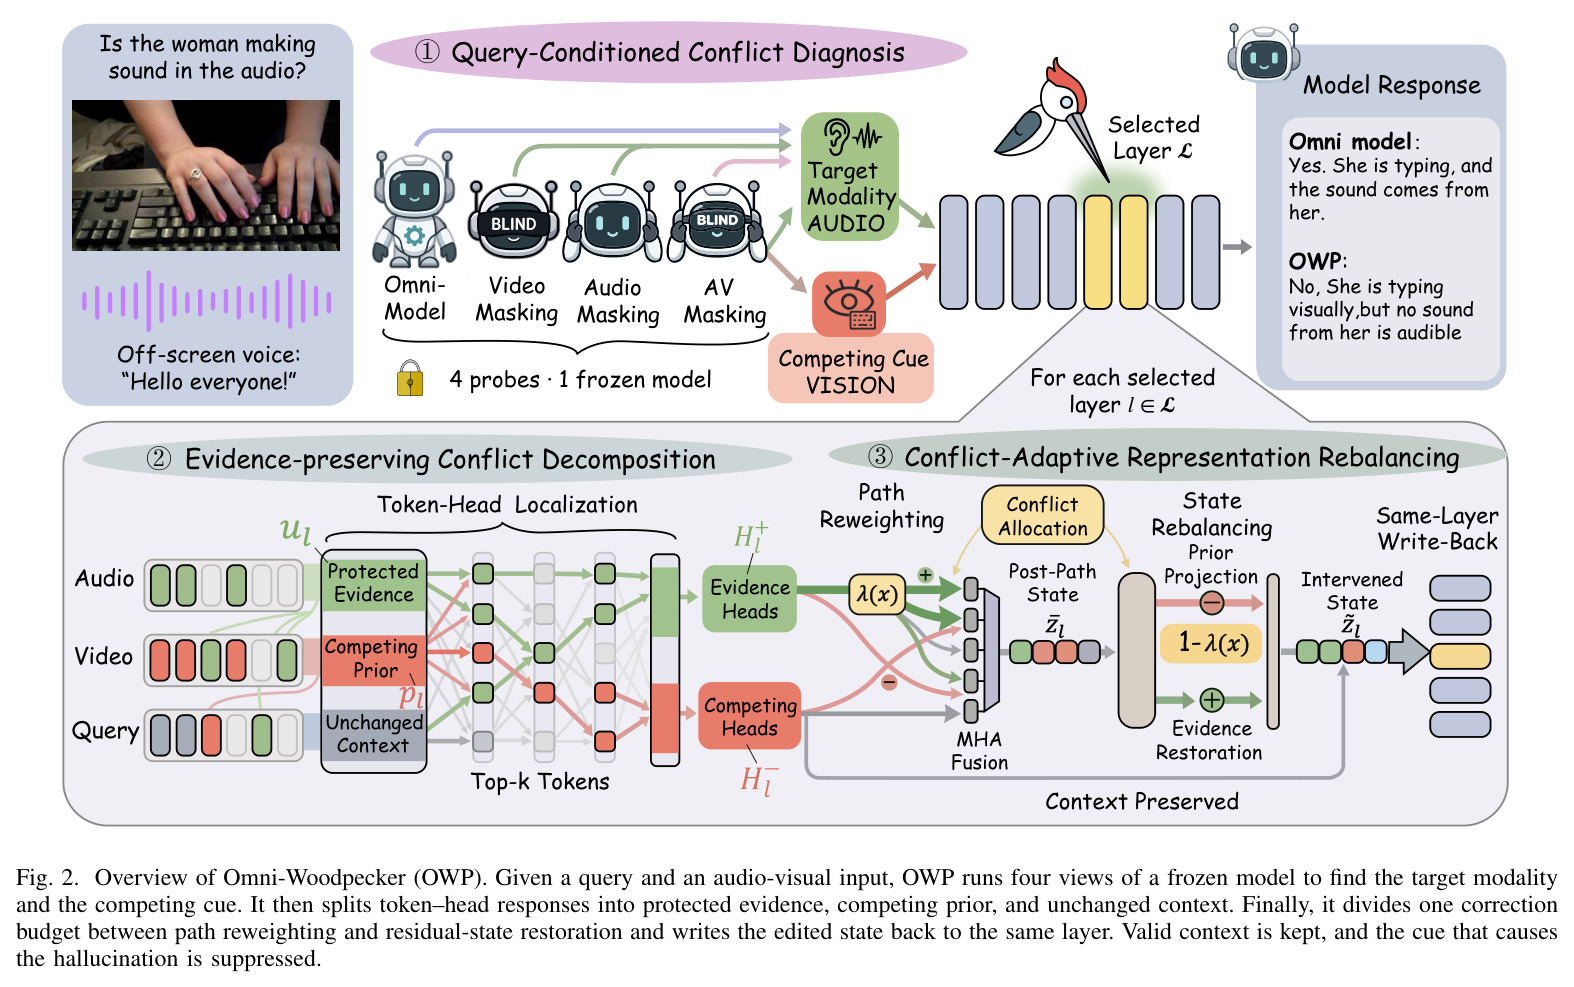
OWP 的直觉是:幻觉发生时正确答案其实已被模型感知到,只是被竞争线索压在融合表征之下,因此无需改模型,只需在解码前把表征内部失衡的天平摆正。技术路线分三阶段(Fig. 2)。第一步“查询条件冲突诊断”:对同一冻结模型跑四个视图 $x_F=(q,v,a)$、$x_A=(q,a)$、$x_V=(q,v)$、$x_T=q$,先用附加的诊断问题(问需要音频/视频/还是两者)做 target typing 选出目标视图,再用“与完整视图答案一致 + 源归一化注意力质量更大”两个条件验证竞争源;若目标视图与完整视图答案一致则判定无冲突,直接返回骨干输出。第二步“证据保留的冲突分解”:从视图状态差构造锚定在目标证据上的单位方向 $u_\ell$,定义正交先验方向 $p_\ell$ 与证据亏缺 $g_\ell$,并把 token-头响应划分为保护证据、竞争先验、不变上下文三组以定位要编辑的头。第三步“冲突自适应再平衡”:以 $\lambda(x)$ 把一份修正预算分给注意力路径编辑(聚合前改写竞争头/证据头的值输出)与残差状态编辑(抑制 $p_\ell$、恢复 $g_\ell u_\ell$),写回同层后照常解码。全程无标注,常数全局固定。
核心创新是把全模态幻觉重新表述为“融合表征内部证据与先验的失衡”,主张“幻觉应在其起源处被修正,而不是在其出现处”。与已有方法的本质区别有三点。其一,干预位点不同:对比解码(VCD/AVCD)与偏好优化(OmniDPO/MoD-DPO)只动最终 logits 或模型权重,OWP 直接编辑融合后的隐藏状态与注意力路径,修复被破坏的内部表征。其二,编辑是逐查询定制的:不像 HulluEdit 用一条固定方向套所有输入,OWP 对每个输入都从“目标流 vs 竞争流”的视图差在线构造方向、头集合与分配权重,全程不用任何标注。其三,“一份预算、两个位点”:路径编辑控制各来源在注意力聚合前送出什么,残差编辑处理已合并进隐藏态的竞争,分配比例 $\lambda(x)=\sigma((\tau-\Delta_F(x))/T)$ 随冲突进展自适应——融合视图越强烈偏向竞争答案,预算越移向残差位点。再加上正交分解从数学上保证抑制先验不触碰证据分量,以及冲突触发调度让 74.2% 的无冲突输入零开销透传,构成了“精准、便宜、可移植”的完整方案。
方法步骤详情
流程如下(常数全局固定)。(1) 冲突诊断:对冻结模型跑完整/仅音频/仅视频/纯文本四视图;target typing 附加诊断问题,对 $(\pi_A,\pi_V,\pi_{AV})$ 取 softmax,按 $\rho_A=\pi_A+\pi_{AV}/2$、$\rho_V=\pi_V+\pi_{AV}/2$ 选目标模态,分差需超 0.12;诊断问题有 4 种同义措辞(Table VI)。(2) 竞争源验证:将最后 query token 对各模态 span 的头平均注意力按 span 长度归一并跨层平均,仅当该源的单流分支答案与完整视图一致而目标分支不一致、且注意力质量以 0.05/0.03 余量胜出时才接受为竞争源,分数接近则跳过编辑。(3) 校准证据方向:$\Delta_b=S_b(y_{tar})-S_b(y_F)$ 定标定置信,$\kappa=\tanh(|\bar\Delta|/\tau_s)$,信任项 $t_{tar}=[\sigma(\Delta_{tar}/\tau_s)\sigma(\Delta_F/\tau_s)]^{1/2}$,权重 $w_{non}=\gamma\kappa\pi_{tar}t_{tar}$、$w_{fus}=\gamma\kappa\pi_F t_F$($\gamma=0.75$、$\tau_s=1.0$),方向 $u_\ell=\mathcal{N}(\mathcal{N}(e^{tar}_\ell)+w_{non}\mathcal{N}(e^{non}_\ell)+w_{fus}\mathcal{N}(e^{fus}_\ell))$,各 $e$ 为视图状态减纯文本状态。(4) 先验方向 $p_\ell=\mathcal{N}(e^{fus}_\ell-(u_\ell^\top e^{fus}_\ell)u_\ell)$,证据亏缺 $g_\ell=\max(u_\ell^\top(z^{tar}_\ell-z^F_\ell),0)$。(5) 头定位:每来源组保留注意力最高的 16 个 token、每层至多 4 头,按答案对齐值贡献排出竞争头集 $H^-_\ell$ 与证据头集 $H^+_\ell$。(6) 自适应分配:$\lambda(x)=\sigma((\tau-\Delta_F(x))/T)$,$\tau=-9/16$、$T=0.10$。(7) 双位点编辑:路径分支 $e^{o}_\ell=o_\ell+\eta_P\lambda(x)[-\beta_P\sum_{j\in H^-_\ell}v^{src}_j+\alpha_P\sum_{j\in H^+_\ell}v^{evi}_j]$,残差分支 $e^{z}_\ell=\bar z_\ell+[1-\lambda(x)][-\beta_R(\bar z_\ell^\top p_\ell)p_\ell+\alpha_R g_\ell u_\ell]$,$\eta_P=0.25$、$\alpha_{P,R}=0.10$、$\beta_{P,R}=0.95$。(8) 层调度:证据层 12/16/20(权重 0.25/0.35/0.40)、先验层 24/26/27(0.23/0.61/0.16),写回同层,语言头不变;换骨干只适配证据层与两个残差增益。
技术新颖性
技术新颖性体现在四个层面。第一,问题重构:首次把全模态幻觉显式建模为融合表征内的证据-先验失衡而非感知失败,并给出行为学证据——冻结模型单独看目标流就能答对,融合后却被竞争流带偏(Table V 显示仅喂竞争流使准确率暴跌 25.21 分,而仅喂目标流反而 +2.23 分)。第二,逐输入的冲突条件化编辑:方向、头集合、位点分配全部在线推导,与 HulluEdit 的单次固定子空间编辑、ITI/RepE 的全局静态方向形成鲜明对照,也与 MAD 只在输出端加权分支不同。第三,证据保留的正交分解:先验方向被定义为去掉证据分量后的正交残余($p_\ell^\top u_\ell=0$),抑制它数学上保证不触碰证据;亏缺项 $g_\ell$ 只在证据确实丢失时非零,避免无谓干预。第四,把机制发现直接编码进设计:消融显示残差状态是主要修正位点(与路径-only 的 HR 差距达 14.66 分),证据宜在中层恢复、先验宜在深层抑制(两层交换使准确率掉 6.79 分),OWP 据此安排层调度并用 $\lambda(x)$ 做位点分配,理论结构与实证规律互相咬合。
实验结果
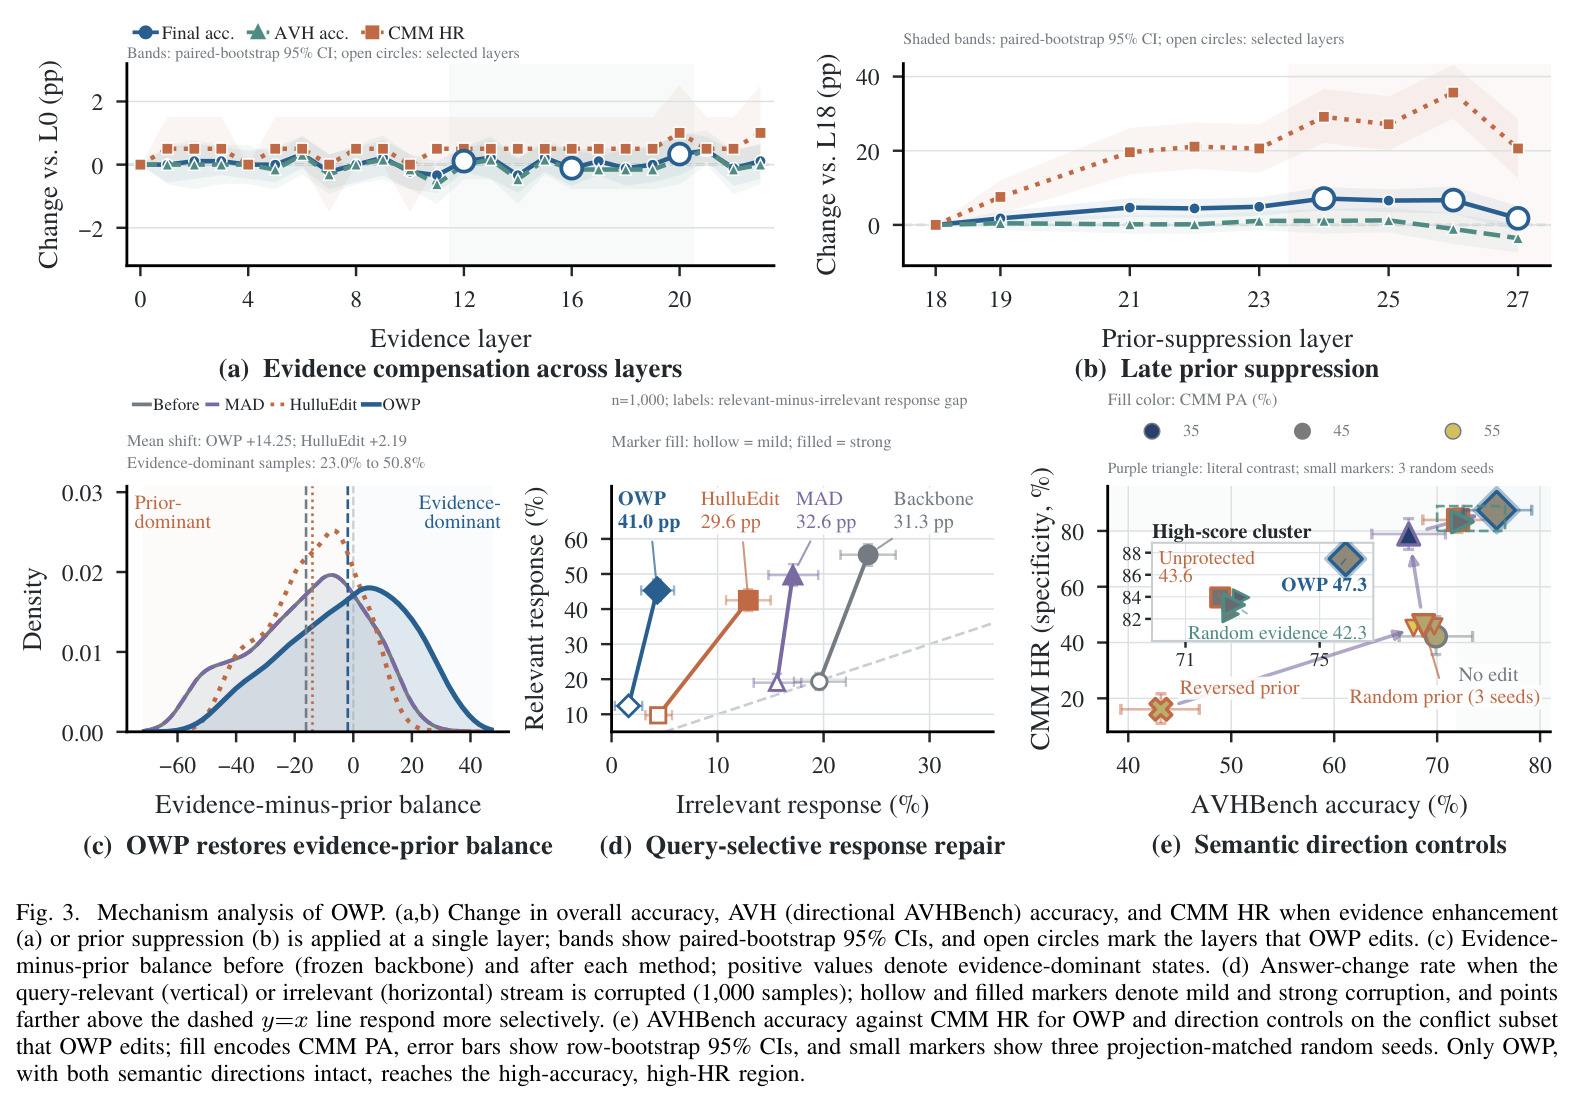
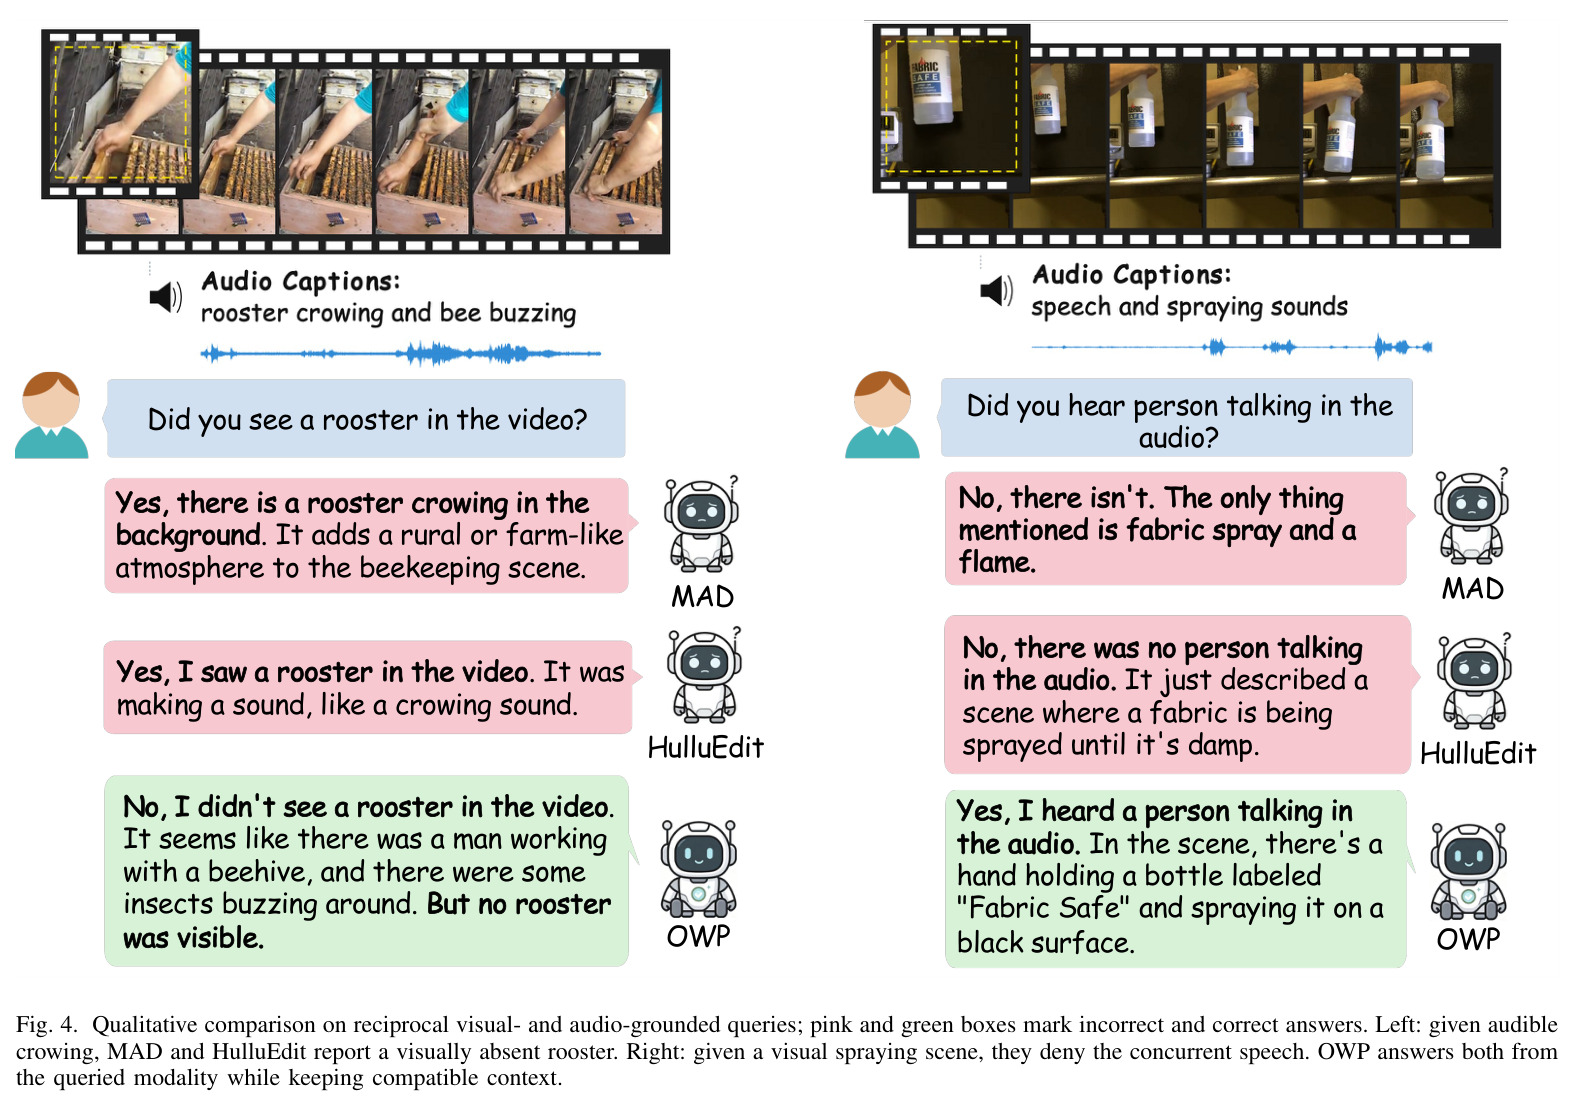
实验回答四个问题。(1) 冲突修正:Qwen2.5-Omni-7B 上 CMM 达 86.1%(骨干 73.2%,+12.9 分;最强基线 MAD 81.2%,+4.9 分),AVHBench 全集 83.7%(+8.6 分,超 MAD 7.7 分),配对差异 $p<10^{-16}$;视觉/音频/语言主导分别 86.0%/90.2%/82.0%,双向 84.9%/85.3%。HR 从 57.0% 升至 85.5%(PA 86.7%),PA-HR 差距从 32.5 分缩到 1.2 分(MAD 仍差 16.9 分)。(2) 双流证据保留:AV Matching 81.1%,超骨干 6.6、MAD 13.1、AVCD 17.9 分;AVCD 方向 81.2% 但 Matching 仅 63.2% 暴露偏科,OWP 兼得 84.9%/85.3%/81.1%。迁移到 VideoLLaMA2-AV:CMM 76.2→80.8、AVHBench 70.2→74.1、HR 65.3→77.7;OWP+Qwen2.5-Omni-7B 反超更新的 Qwen3-Omni 4.3/6.2 分。(3) 能力保持:OmniBench +1.93、WorldSense +2.25、MUSIC-AVQA +1.00、AVQA +0.67 分。冲突识别只编辑 25.8% 输入、改动 16.9% 答案,target typing 一致率 99.48%。(4) 开销:延迟 1.71×/1.77×(MAD 2.81×/2.36×、HulluEdit 3.68×),≤5 次前向,显存 24.9 GiB。机制:证据-先验平衡位移 +14.25(HulluEdit 仅 +2.19),证据主导状态 23.0%→50.8%;流腐坏选择性差距 41.0 分(骨干 31.3),强腐坏下相关流 45.3% vs 无关流 4.3%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| CMM 跨模态冲突(Qwen2.5-Omni-7B) | 总体准确率 | 86.1% | 骨干 73.2%;最强基线 MAD 81.2% | 对骨干 +12.9 分,对 MAD +4.9 分(p<1e-16) |
| CMM 幻觉抵抗率(HR) | HR(PA 为参照) | 85.5%(PA 86.7%) | 骨干 57.0%(PA 89.5%);MAD 72.8%(PA 89.7%) | +28.5 分;PA-HR 差距从 32.5 分缩至 1.2 分(MAD 仍差 16.9 分) |
| AVHBench 全集(Qwen2.5-Omni-7B) | 官方准确率 / F1 | 83.7% / 83.3 | 骨干 76.3% / 76.3;MAD 76.0% | 对骨干 +8.6 分,对 MAD +7.7 分 |
| AVHBench AV Matching(音视频匹配) | 准确率 | 81.1% | 骨干 75.1%;MAD 68.0%;AVCD 63.2% | +6.6 / +13.1 / +17.9 分 |
| CMM 与 AVHBench(VideoLLaMA2-AV 跨骨干迁移) | 总体准确率 | 80.8% / 74.1% | 骨干 76.2% / 70.2% | +4.6 / +3.9 分(组内最佳,HR 65.3%→77.7%) |
| 通用全模态推理(OmniBench / WorldSense / MUSIC-AVQA / AVQA) | 准确率 | 47.29% / 47.46% / 86.08% / 92.50% | 骨干 45.36% / 45.21% / 85.08% / 91.83% | +1.93 / +2.25 / +1.00 / +0.67 分 |
| 推理开销(Qwen2.5-Omni-7B) | 相对骨干延迟 / 前向次数 | 1.71×(6.05s)/ ≤5 次 | MAD 2.81×(9.96s,9 次);HulluEdit 3.68×(13.02s,5 次) | 比 MAD 快约 39%,比 HulluEdit 快 2.15× |
局限与改进
作者承认四点局限:只针对跨模态幻觉,未覆盖时间性(顺序/时长/同步)与副语言(说话人、情绪、韵律)幻觉;只能恢复骨干已编码但未使用的证据,目标模态单流视图本身就感知错时无证据可恢复;需访问注意力与残差状态等内部,只适用开源权重模型,API 模型无法使用;与所有多视图对比方法一样需额外前向计算(已压到 1.71–1.77×)。我的补充:全部评测依赖闭集答案(CMM、AVHBench 与四推理基准均为选择/二元题型),开放式生成幻觉未验证;超参数量不少(margin 0.12/0.05/0.03、$\tau_s=1.0$、$\gamma=0.75$、$\eta_P=0.25$ 等),换骨干仍需适配证据层与残差增益,“零调参”打折扣;Fig 3e 等机制分析在 OWP 实际编辑的冲突子集上计算(如 75.8%/87.4%),与全集口径不同,横向比较需留意;诊断查询隐含假设模型指令遵循良好,弱模型上未测。
独立分析的弱点
独立分析五点弱点。第一,诊断依赖模型自身的指令遵循:target typing 靠附加“需要哪种模态”的诊断问题,99.48% 的一致率是在强骨干上测得的;若模型指令遵循差或查询表述含混,诊断会失准。改进方向是多种措辞加权投票或训练一个轻量冲突分类头替代生成式诊断。第二,二元化判定过于刚性:0.12/0.05/0.03 的余量把冲突当成离散事件,边界模糊的渐进式冲突可能漏检或误跳过;可改成连续冲突分数连续调制编辑强度,而非“编辑/不编辑”的硬开关。第三,证据方向锚定在目标单流视图的状态差上,隐含“单流视图状态即干净证据”的假设,但单流视图同样可能被语言先验污染(Table V 显示纯文本输入只有 52.88%,接近 50% 随机水平);可用多采样一致性或对照输入净化证据方向。第四,实时性:多视图前向使延迟增至 1.71×,对流式语音助手等实时交互 OLLM 仍偏贵;可缓存视图结果、增量诊断,或把冲突探测蒸馏为单次前向的探针。第五,只在 7B 级两个骨干上验证,更大规模模型(如 30B+)的中层/深层分工是否迁移、层调度是否需重定位,均未检验。
未来方向
作者提出的延伸方向:时间性幻觉——诊断各流在什么时刻提供证据并比较事件时序,可校正顺序、时长与音画同步错误;声学与副语言幻觉——在音频流内部把说话内容与声学属性(身份、情绪、韵律)分离后再诊断;与训练式方法直接组合——OWP 不改权重,可与 OmniDPO 类偏好训练叠加获得叠加收益;更广义地,把“修正融合内部的证据流”作为通往可靠全模态推理的一般路线。基于本文成果还可延伸:把“证据-先验正交分解”推广到更多模态组合(3D、触觉、生理信号)与检索增强场景——把检索文档视为另一种可竞争的先验流;将逐输入诊断出的编辑方向做聚类,提炼可复用的“冲突方向字典”以降低在线开销;把机制发现(中层恢复证据、深层抑制先验、残差为主位点)转化为训练时的结构正则,从头训练融合更鲁棒的 OLLM;以及在流式/多轮对话 setting 中研究编辑的误差累积与状态一致性。
复现评估
复现条件较好:代码开源(https://github.com/ZiiJianLiu/Omni-Woodpecker),骨干 Qwen2.5-Omni-7B 与 VideoLLaMA2-AV 均有公开权重,CMM、AVHBench 与四个推理基准全部公开,基线 AVCD/MAD/HulluEdit 用官方实现。所有常数逐一列出:margin 0.12/0.05/0.03、$\tau_s=1.0$、$\gamma=0.75$、每源 16 token、每层 ≤4 头、证据层 12/16/20(0.25/0.35/0.40)、先验层 24/26/27(0.23/0.61/0.16)、$\alpha=0.10$、$\beta=0.95$、$\eta_P=0.25$、$\tau=-9/16$、$T=0.10$;迁移他骨干只改证据层与两个残差增益(VideoLLaMA2-AV 用层 16/20/24,$\alpha_R=0.20$、$\beta_R=1.20$)。算力门槛低:免训练,单卡 RTX A6000(峰值 24.9 GiB)即可,骨干单条 3.54s、OWP 6.05s。难点在于要在注意力路径与残差流挂钩子做逐头值分解、正交投影与同层写回,需熟悉目标模型内部结构;统计协议(配对 McNemar、5000 次 bootstrap、Holm 校正)完整给出。总体:中等难度,熟悉 hook 机制者约 1–2 周可复现主表。
论文图表
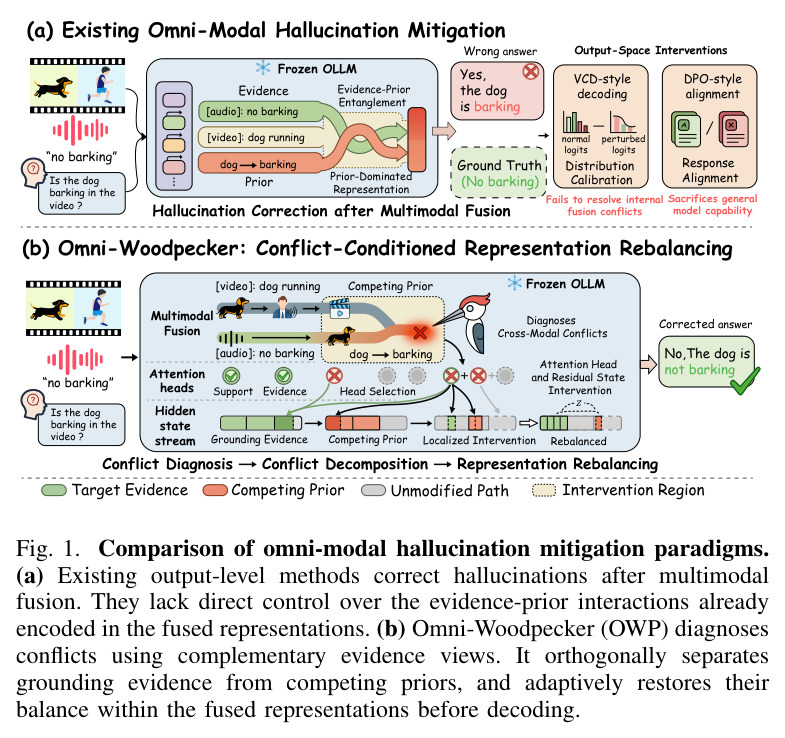
左右对照两种范式。(a) 现有方法:VCD 式解码干预与 DPO 式对齐都在多模态融合之后、只校准最终 logits/响应分布,证据与先验在融合表征中的纠缠未被触及,错误答案(“狗在叫”)依旧出现。(b) OWP:用互补的模态特定视图诊断跨模态冲突,正交分离真实证据(音频静音)与竞争先验(视觉上的狗),在解码前对融合表征做再平衡,输出被纠正的答案(“狗没有在叫”)。
一张图讲清论文的核心立场——干预位点从输出端移到融合表征内部,即“在幻觉起源处修正而非在出现处修补”,是理解全文动机与方法定位的入口。
主结果表:两个受控骨干(Qwen2.5-Omni-7B、VideoLLaMA2-AV)各配三个基线(AVCD/MAD/HulluEdit),另列 VITA-1.5、OmniVinci、Qwen3-Omni 三个外部模型作参照;列覆盖 CMM 三类主导准确率与 PA/HR,AVHBench 双向准确率、AV Matching 与官方 F1。OWP 在 Qwen 上 CMM 86.1%、AVHBench 83.7%(F1 83.3)全面第一,Matching 81.1% 远超 AVCD 的 63.2%;在 VideoLLaMA2-AV 上同样组内最佳(80.8%/74.1%);OWP+Qwen2.5-Omni-7B 甚至超过更新的 Qwen3-Omni 4.3/6.2 分。
支撑“修正跨模态冲突”与“保留双流证据”两大主张的核心数据,也是与其他方法比较的唯一权威口径。
同一冻结配置下四个通用推理基准的结果:OmniBench 45.36→47.29(+1.93)、WorldSense 45.21→47.46(+2.25)、MUSIC-AVQA 85.08→86.08(+1.00)、AVQA 91.83→92.50(+0.67)。增益在多流组合问答的 OmniBench 与 WorldSense 上最大,说明修跨模态幻觉顺带强化了通用全模态推理。
回应“只修幻觉会不会牺牲通用能力”的质疑,证明 OWP 的编辑是安全的、甚至有外溢收益。
RTX A6000 上三次运行平均的单条延迟:Qwen2.5-Omni-7B 骨干 3.54s(1.00×,1 次前向),OWP 6.05s(1.71×,≤5 次),MAD 9.96s(2.81×,9 次),HulluEdit 13.02s(3.68×,5 次);VideoLLaMA2-AV 上骨干 1.40s、OWP 2.48s(1.77×)、MAD 3.29s(2.36×)、HulluEdit 1.94s(1.38×)。峰值显存 24.9/17.3 GiB。
免训练推理方法的实用性取决于开销。此表证明冲突触发调度(74.2% 输入零编辑透传)把多视图方法中最贵的一类做到了比 MAD 更便宜。
逐组件消融(原生协议):仅证据增强 AVH +5.41/HR +13.00;仅先验抑制 +6.72/+27.33;两者组合最优(AVH 85.17%、HR 85.50%),且相互抵消对方约 3–4 分的 PA 代价。位点消融:残差-only 83.23%/84.33%,路径-only 81.68%/69.67%(HR 差 14.66 分);双位点固定分配提升 AVH 至 83.93% 但 HR 降至 82.33%。自适应分配三项全面最优(85.17/86.70/85.50,较固定分配 +1.24/+2.03/+3.17)。层交换使准确率掉 6.79 分(Holm 校正 p<0.001)。
验证每个设计决策的必要性:两组件互补、残差是主位点、分配必须随冲突自适应、层调度不可互换,是理解方法为何如此设计的必读表。
输入视图消融:单流输入全面掉点(Qwen 上音频 -12.35、视频 -10.64、纯文本 -29.18,接近 50% 随机水平);oracle 按基准标注选目标流 +2.23,只喂竞争流 -25.21,说明退化源于“竞争流误导”而非“信息丢失”。OWP 的在线目标推断(84.91%)甚至超过 oracle 路由(84.28%)。匹配 OWP“否”率的常数偏置只 +0.60/+0.67,远低于 OWP 的 +2.85/+2.14(p<1e-6/1e-3),且偏置会压低正例准确率(86.73→85.39)而 OWP 反而提升(→86.90)。共享单一配置在两骨干上分别 +2.85/+2.14。
一张表同时回答两个最关键的质疑:增益不是把答案推向“否”的先验偏置,冲突的根源是竞争流而非信息缺失;方法主张的因果链在此闭合。
列出 target typing 用的 4 种同义诊断问句(如“Identify which modality is required to answer the question (audio, video, or both).”等),均追加在原始查询之后且保持相同的三个候选回答 token(audio/video/both),用于降低诊断问题措辞对模态判定的扰动。
诊断问题是冲突识别的第一环,其措辞鲁棒性直接影响整个流程;此表给出确切文本,是复现 target typing 的必要细节。