协同头信息分布漂移引发多模态大模型幻觉:HEAL头级信息解耦与动态校准框架 MLLMs Hallucinate when Information Distribution Drifts in Synergy Heads
HEAL解耦注意力头信息分布,发现协同头漂移致幻并动态校准缓解。
前置知识
多模态大语言模型(MLLM)与视觉幻觉
以LLM为骨干、经投影层接入视觉编码器(如CLIP ViT)的模型,代表有LLaVA-1.5、LLaVA-NeXT、Qwen2.5-VL、InternVL。视觉token与文本token拼接后一起做自回归生成。视觉幻觉指模型生成听着合理但与图像事实不符的内容,如编造不存在的物体、错误属性或空间关系,是阻碍其在医学影像等高精度领域落地的主要瓶颈。
本文的研究对象就是MLLM幻觉,所有实验都在LLaVA/Qwen/InternVL三大系列共7个模型上开展,需要先了解这类模型的结构与典型失效模式,才能理解实验设计与结论的适用范围。
多头注意力与KV缓存
Transformer每层含 $H$ 个注意力头,各头独立计算 $o=\mathrm{Softmax}(qK^\top/\sqrt{d})V$,其中K、V在推理时被缓存(KV-cache)避免重复计算,各头输出拼接后经输出投影矩阵 $W_O$ 回到残差流。实践中不同头会自发分工:有的主要响应视觉token,有的承载语言先验,有的两者协同。
HEAL的全部干预都落在单个注意力头的输出和value向量上:噪声干预替换头输出,校准时对 $\beta V_{vis}$、$\gamma V_{lang}$ 缩放。不理解头的计算与KV缓存机制,就无法明白干预注入的具体位置和式(1)(17)的含义。
部分信息分解(Partial Information Decomposition, PID)
信息论框架,研究多个输入源共同决定输出时,把总信息分解为各源的独有信息、冗余信息和协同信息。本文借用该视角,把一个多模态注意力头的内部信息视为纯视觉信息、纯语言信息、先验信息与多模态协同的组合,并给出可计算的近似量 $I_{vis}$、$I_{lang}$、$I_{syn}$。
协同头(synergy head)这一核心概念直接来自PID中的协同信息,公式(8)-(11)的四态差分就是PID思想的可操作化。不懂PID就无法理解为什么头能被分成冗余/视觉/语言/协同四类,以及 $I_{syn}$ 为什么可为正也可为负。
反事实干预与双重差分(DiD)
因果推断技术:不直接观察相关性,而是构造反事实输入做对比。本文分别构造全输入 $H_{11}$、掩掉视觉 $H_{01}$、掩掉语言 $H_{10}$、全掩掉 $H_{00}$ 四种状态,比较头输出相似度的差分,剥离出单一模态的净贡献。掩码采用保持一、二阶统计量的高斯噪声,避免引入分布漂移。
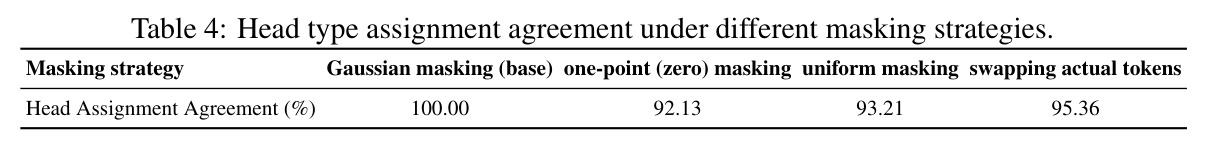
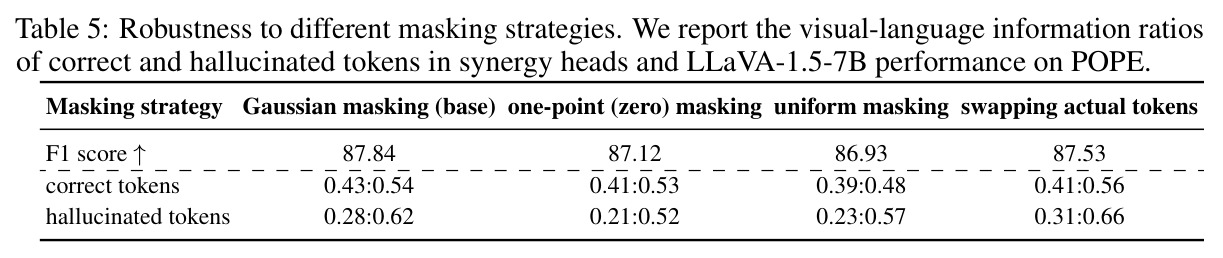
HEAL的头分类完全建立在 $H_{11},H_{01},H_{10},H_{00}$ 四态反事实差分之上,理解DiD是读懂 $I_{total}$、$I_{vis}$、$I_{lang}$ 计算方式的前提,也是理解鲁棒性实验(Table 4/5)中不同掩码策略对比的钥匙。
POPE、CHAIR等幻觉评测基准
POPE通过询问图中物体是否存在来测量物体级幻觉,报告F1、准确率、召回率;CHAIR考察详细图像描述中的幻觉率,CHAIRs(句子级)与CHAIRi(实例级)越低越好,同时要看召回率和描述长度防止模型靠少说来作弊;MME、LLaVA-Bench、BLINK-Twice测综合感知与推理能力,用于确认方法不伤通用能力。
论文全部结论用这些指标表述,例如HEAL在LLaVA-1.5上POPE F1 87.7、CHAIRs 36.7、MME总分669.76。不了解各指标含义与升降方向,就无法判断方法是否真的有效、是否以牺牲描述质量为代价。
中位数绝对偏差(MAD)
稳健统计量 $\mathrm{MAD}(x)=\mathrm{median}|x-\mathrm{median}(x)|$,对离群值不敏感,适合处理偏态分布。本文先对模态比 $\alpha_{vis}$ 做Logit变换去偏,再用 $\mathrm{median}+\lambda\cdot\mathrm{MAD}$ 设定视觉/语言头与协同头的分界;$\lambda=1.4826\approx1/\Phi^{-1}(0.75)$ 时近似正态下的1σ。
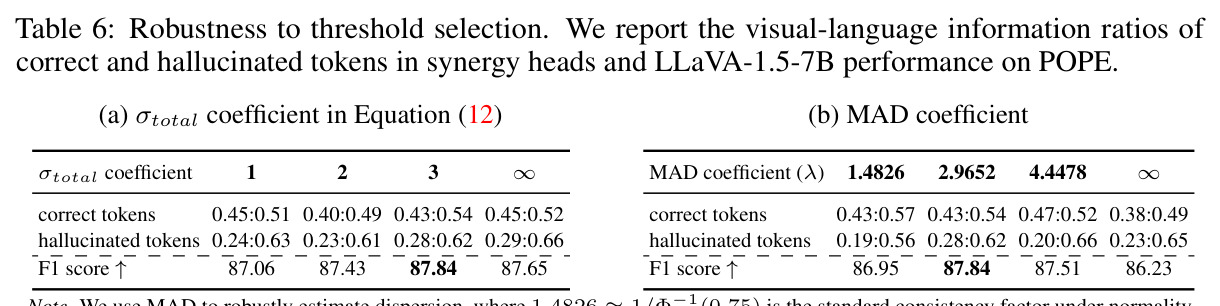
四类头的划分边界由Logit-MAD阈值决定,理解MAD才能看懂头分类规则,以及Table 6中 $\lambda$ 取1.4826/2.9652/4.4478/∞时性能稳定的阈值鲁棒性实验。
研究动机
多模态大语言模型(MLLM)经常生成与图像事实不符却听起来合理的回答,即视觉幻觉,这阻碍了其在医学影像等高精度场景的可靠应用。现有缓解手段分两层:宏观层面(重训练/微调、架构扩展、强化学习)把模型当黑箱从外部纠正,成本高且不解释内部机制;微观层面中,解码优化方法(VCD、OPERA、DoLa、DOPRA等)只在输出分布上做对比或引导,可解释性有限;而主流注意力增强方法(PAI、EAH、VHR、VAR、TAME等)依赖注意力权重或FFN激活这类间接信号,无法反映幻觉生成时真实的因果信息分布与多头的协同混淆效应——一个激活很大但投影权重很小的头、或多个头协作产生的效果都会被误判。此外,单向增强视觉注意力存在跷跷板困境:加强视觉注意力会使回答被截断、创造力下降,过度依赖语言又加剧幻觉。作者在LLaVA-NeXT-7B与Qwen3-VL-8B上的初步统计(Figure 1a、1b)还显示,幻觉token与正确token在各类头的数量与强度上差异不大,说明注意力权重并非幻觉的可靠指示器,需要更根本的测量手段。
本文的目标是本文设定三重目标。第一,建立细粒度、可解释的头级分析框架:直接测量每个注意力头内部携带的纯视觉信息、纯语言信息与协同信息,而非依赖注意力权重这类间接代理,从信息层面回答"幻觉到底发生在哪里"。第二,通过因果干预而非相关性观察,找到真正可操纵的幻觉成因——作者假设并最终验证:幻觉源于协同头(synergy heads)内视觉-语言信息分布偏离健康均衡点,而非视觉头或语言头的数量与强度不足;同时刻画注意力头在自回归生成中的"任务驱动相变"动态行为。第三,在不重训练、不改动架构的前提下,设计推理时即插即用的动态信息校准机制:引入均衡因子 $\alpha$ 把协同头的信息分布主动拉回均衡,使输出重新偏向视觉证据,并在POPE、CHAIR、MME、LLaVA-Bench等幻觉与综合基准上同时降低幻觉、保持甚至提升通用多模态能力。
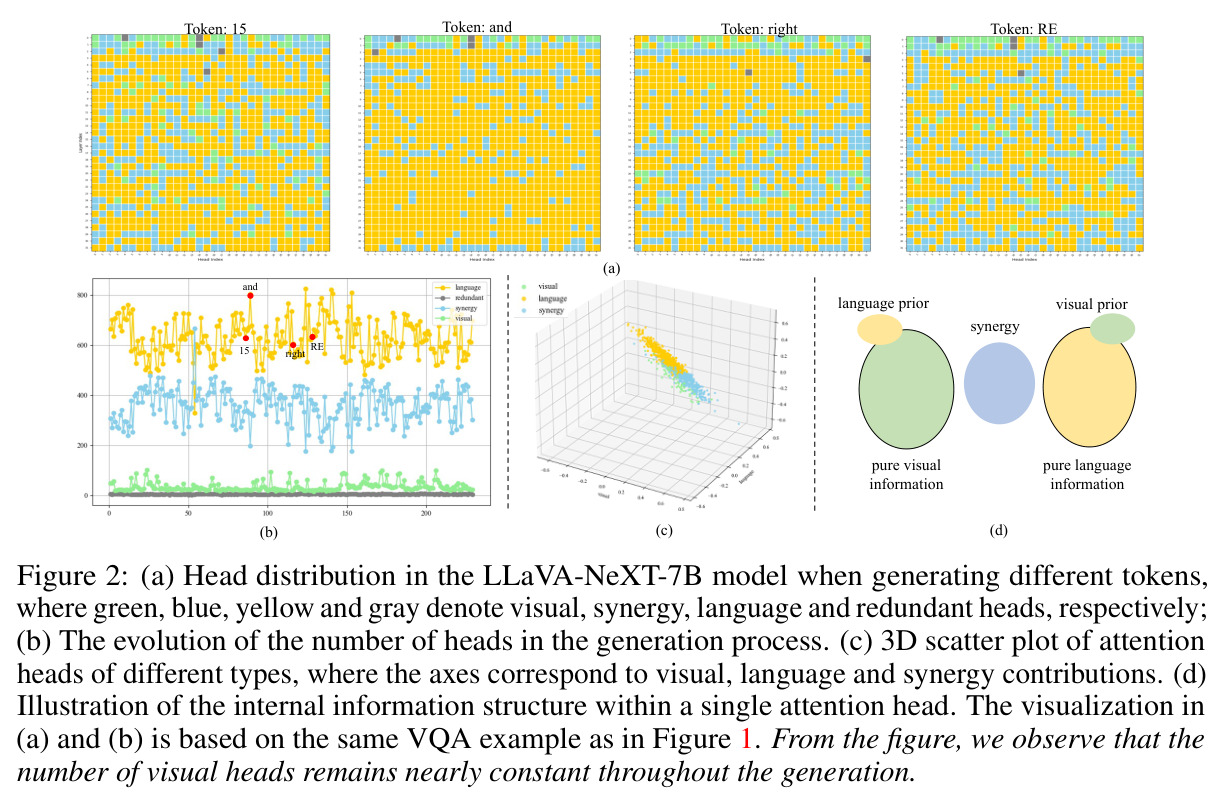
与已有工作不同的是,本文的独特切入角度有三。其一,测量对象从"注意力权重"换成"信息分布":对多头输出做分布匹配的高斯噪声干预(因果噪声干预),用干预前后层表示的相似度变化定义每个头的真实信息贡献 $I^{(t,l,i)}=1-\mathrm{Sim}(y^{(t,l)},\tilde{y}^{(t,l)(-i)})$,能捕捉权重无法反映的多头协作效应。其二,借鉴部分信息分解理论,用反事实双重差分把每个头的信息解耦为纯视觉、纯语言与协同成分,首次将头划分为冗余、视觉、语言、协同四类,并借此发现"任务驱动相变":生成语言token时协同头向语言头回退,生成视觉接地带token时部分语言头转向协同头、少数协同头进一步转向视觉头。其三,因果归因落在协同头内部的信息失衡上——正确token在协同头中视觉:语言比例约为0.43:0.54,幻觉token漂移至约0.28:0.62——并通过双向干预实验证明这是因果关系而非相关关系。这既不同于解码层的对比采样,也不同于简单放大视觉注意力的头级方法,是一条"先诊断、后对症"的新路径。
核心方法
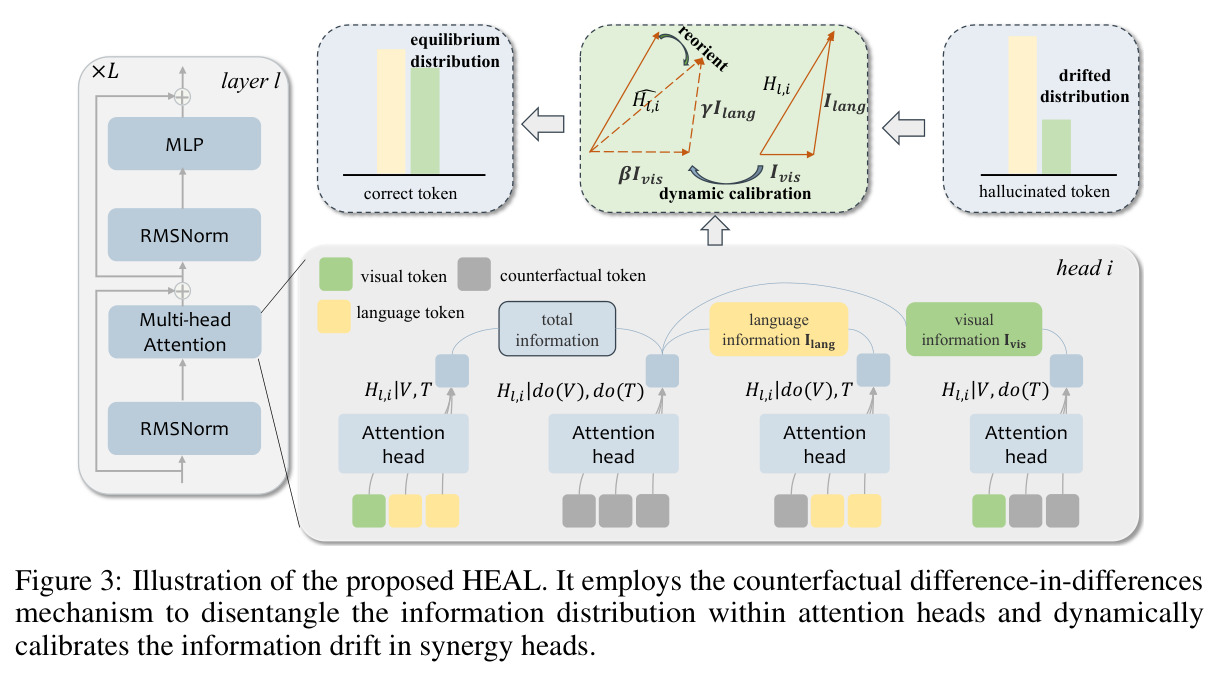
HEAL的直觉是:与其用注意力权重猜哪个头负责视觉,不如直接干预测量信息。整体分四步。第一步因果噪声干预筛头:把第 $i$ 个头的输出替换为分布匹配高斯噪声,用 $I=1-\mathrm{Sim}(y,\tilde{y}^{(-i)})$ 度量信息贡献,低于 $\mu-3\sigma$ 判为冗余头。第二步反事实双重差分:用统计量匹配的高斯掩码构造 $H_{11},H_{01},H_{10},H_{00}$ 四种输入,计算总信息 $I_{total}$、视觉信息 $I_{vis}$、语言信息 $I_{lang}$ 与协同项 $I_{syn}$。第三步把非冗余头分为视觉、语言、协同三类。第四步动态校准:引入均衡因子 $\alpha\in(0,1)$ 刻画健康均衡,解出校准因子 $\beta=\alpha/\alpha_{vis}$、$\gamma=(1-\alpha)/\alpha_{lang}$,对协同头中两模态token的value向量分别乘 $\beta,\gamma$ 后再做注意力。全流程免训练,头类型每 $S=10$ 步周期更新,干预与差分均做了并行化与批处理以控制开销。
核心创新是与已有方法的两个本质区别。第一,信息级而非权重级的头诊断:以往EAH、VHR、VAR、TAME等头级方法用注意力权重或激活强度挑头再单向增强,HEAL用噪声干预测真实因果贡献,再用PID式四态反事实差分把头内信息拆为纯视觉、纯语言、先验与协同成分($I_{syn}$ 即折扣先验重叠后的协同效应),相当于给MLLM装上头级显微镜。第二,均衡恢复而非单边增强:Figure 1a、1b显示幻觉与视觉/语言头的数量、强度都不强相关,真正可干预的变量是协同头内部视觉:语言信息比例的漂移(正确token约0.43:0.54,幻觉token约0.28:0.62)。于是校准目标设为让视觉与语言信息的加权比例等于 $\alpha$,双向调节两个模态,从机制上避开单向增强的跷跷板效应。理论上有两条定理保证自洽:定理1证明在value空间用 $\beta,\gamma$ 缩放等价于校准头内信息分布;定理2证明RMSNorm后输出 $z(\alpha)$ 与视觉信息的几何对齐随 $\alpha$ 单调变化,即拧动 $\alpha$ 可预测地把表示几何推向均衡方向。
方法步骤详情
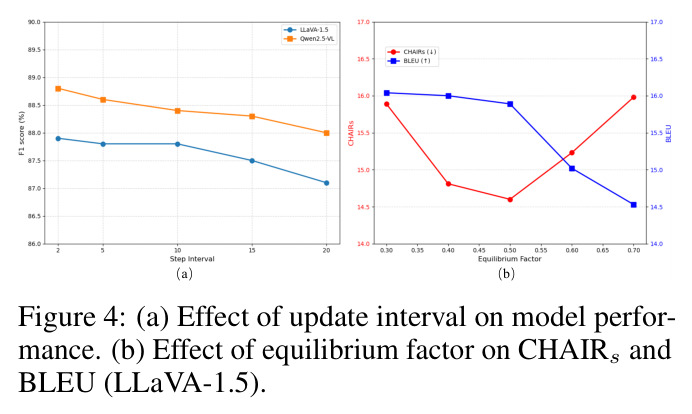
(1)冗余头筛除:对每个头的输出 $o^{(t,l,i)}$ 用分布匹配的高斯噪声替换,以余弦相似度 $\mathrm{Sim}$ 计算信息贡献 $I^{(t,l,i)}$,低于 $\mu-3\sigma$ 者判为因果冗余并排除;该步经式(18)的并行张量一次算完 $H$ 个头。(2)四态反事实与DiD:对视觉token集 $V$ 与语言token集 $T$ 分别做统计量匹配的高斯掩码,得 $H_{11},H_{01},H_{10},H_{00}$ 四态,按式(8)-(11)计算 $I_{total},I_{vis},I_{lang},I_{syn}$,批量张量一次前向完成。(3)头分类:$I_{total}$ 过低为冗余头;仅 $I_{vis}>0$ 为视觉头、仅 $I_{lang}>0$ 为语言头;两者皆正者算模态比 $\alpha_{vis}$,经Logit变换后用 $\mathrm{median}+\lambda\cdot\mathrm{MAD}$ 定阈值分出偏视觉/偏语言头,其余即协同头。(4)动态校准:每步重估协同头信息分布,取 $\beta=\alpha/\alpha_{vis}$、$\gamma=(1-\alpha)/\alpha_{lang}$,在KV缓存更新后、注意力核前对两模态value向量乘 $\beta,\gamma$(式17),不破坏FlashAttention/PagedAttention实现。(5)效率与超参:头类型每 $S=10$ 步更新、$\beta,\gamma$ 每步更新;LLaVA/InternVL系 $\alpha$ 取0.5(POPE/CHAIR)或0.6,Qwen系取0.4或0.5。
技术新颖性
技术新颖性有四点。(1)测量学创新:以分布匹配噪声干预取代注意力权重代理,$I=1-\mathrm{Sim}(y,\tilde{y}^{(-i)})$ 直接反映"去掉这个头后层表示变多少",能捕捉多头协作效应,这是与EAH/VAR/TAME等权重类方法的根本区别。(2)分解理论创新:首次把部分信息分解理论落到注意力头的反事实差分上,用 $3\sigma$ 与Logit-MAD双阈值实现四类头划分;Table 4显示换用零掩码、均匀掩码、真实token交换时头分配一致率仍达92.13%-100%,说明分类刻画的是模型自身属性而非掩码伪影。(3)机制发现创新:"任务驱动相变"(生成不同token类型时头角色动态迁移)与"协同头信息漂移致幻"均为新观察,且双向干预实验证明其因果性而非仅相关性。(4)工程与理论配套:定理1、2给出value缩放与信息校准的等价性及单调方向性;周期类型更新、并行噪声干预、批量DiD把开销压到可用水平,使其成为免训练即插即用方案,并在LLaVA、Qwen、InternVL三大系列共7个模型(7B-8B级)上验证泛化性,这在细粒度头级方法中相当少见。
实验结果
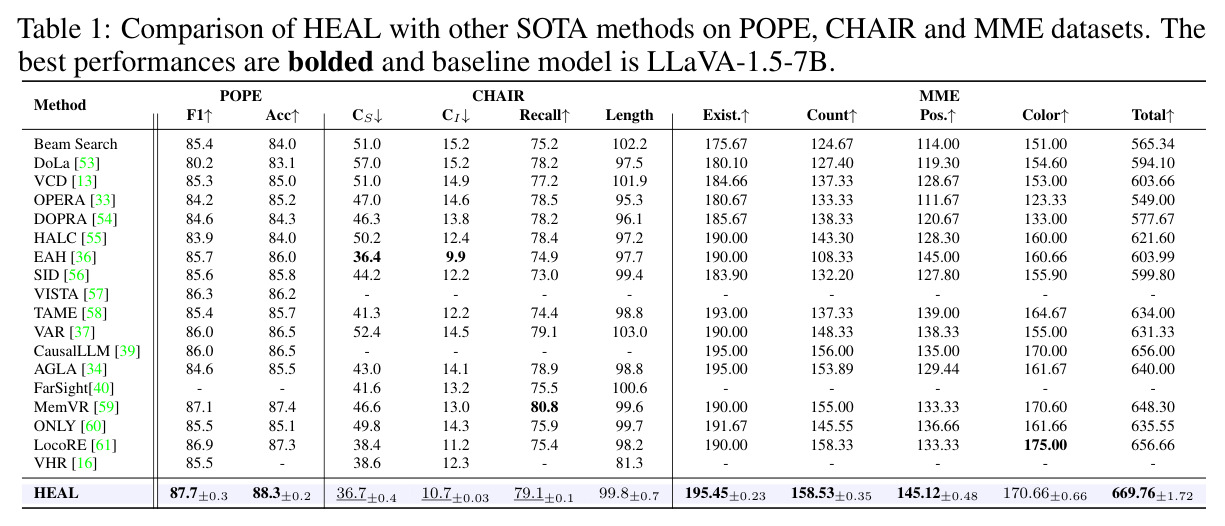
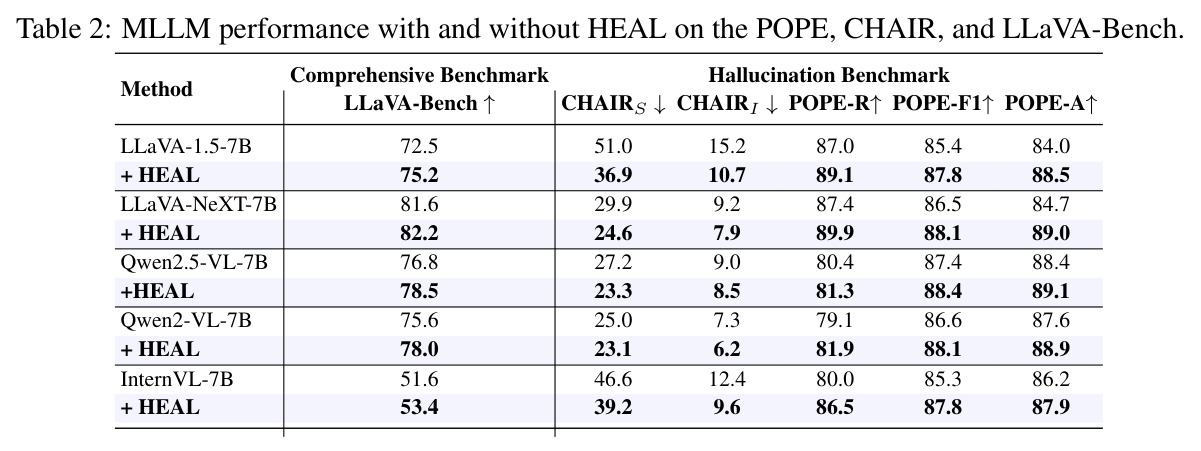
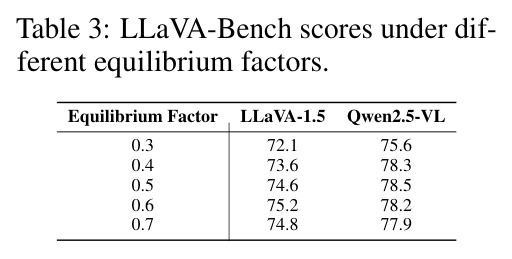
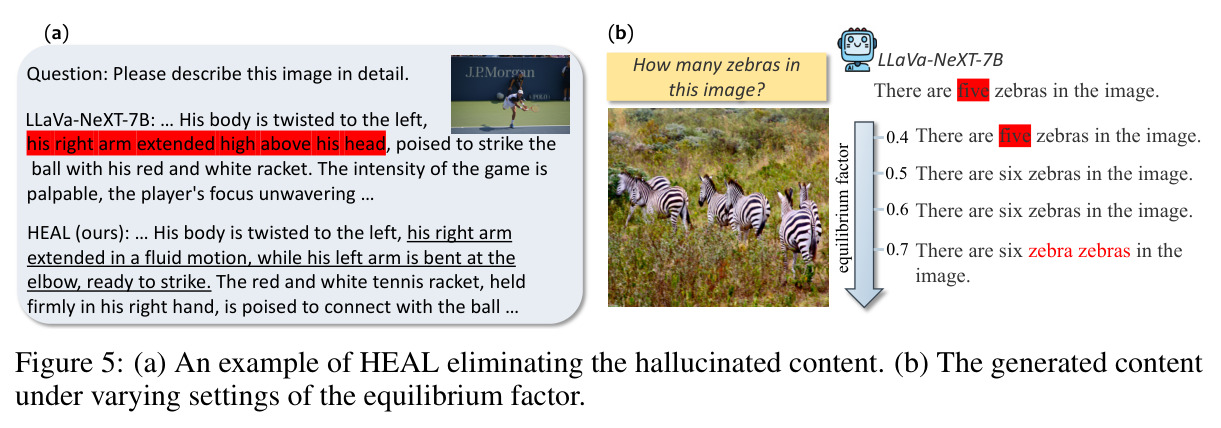
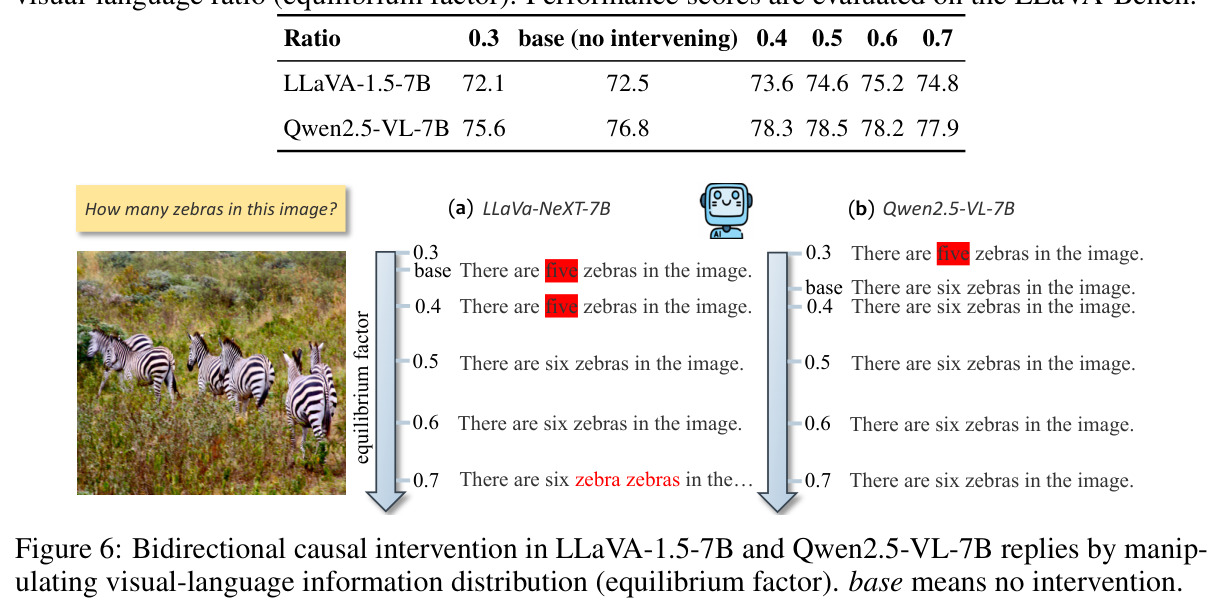
主结果分三层。(1)与SOTA对比(Table 1,基座LLaVA-1.5-7B):HEAL在POPE上F1 87.7±0.3、Acc 88.3±0.2,超过全部16个基线中最强的MemVR(87.1)、LocoRE(86.9)与EAH(85.7);CHAIR上CS 36.7、CI 10.7,与最优EAH(36.4/9.9)相当,但召回率79.1、长度99.8更健康(EAH召回仅74.9);MME总分669.76±1.72,高于CausalLLM与LocoRE的656.66。(2)跨模型泛化(Table 2):LLaVA-1.5-7B加HEAL后LLaVA-Bench 72.5→75.2、CHAIRs 51.0→36.9、POPE F1 85.4→87.8;LLaVA-NeXT-7B CHAIRs 29.9→24.6;Qwen2-VL-7B CHAIRi 7.3→6.2;InternVL-7B POPE-R 80.0→86.5提升最显著,五个模型全部指标一致改善。(3)消融与机制:头类型更新间隔取10-15步性能几乎无损且开销更低;$\alpha$ 呈U形,LLaVA-1.5在LLaVA-Bench上 $\alpha=0.6$ 最优(75.2分),过小或过大都退化;斑马计数案例中 $\alpha=0.4$ 答错、0.5-0.6答对、0.7语法崩坏;双向干预证明降视觉比例可诱发幻觉、升可缓解;四种掩码策略头分配一致率92.13%-100%,幻觉token协同头视觉:语言比例约0.2:0.6、正确token约0.4:0.5。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| POPE 物体存在判断(LLaVA-1.5-7B) | F1 / Acc | 87.7±0.3 / 88.3±0.2 | Beam Search 85.4/84.0;最强免训练基线 MemVR 87.1/87.4;LocoRE 86.9/87.3 | 比Beam Search高+2.3 F1,比最强基线MemVR高+0.6 F1、+0.9 Acc,为表中17个方法最高 |
| CHAIR 详细图像描述(LLaVA-1.5-7B) | CHAIRs↓ / CHAIRi↓ / Recall↑ | 36.7±0.4 / 10.7 / 79.1±0.1 | EAH 36.4/9.9/74.9;VCD 51.0/14.9/77.2;MemVR 46.6/13.0/80.8 | 幻觉率与最优EAH持平,但召回率高4.2点,说明不是靠少说来降幻觉 |
| MME 综合感知评测(LLaVA-1.5-7B) | Total | 669.76±1.72 | CausalLLM 656.00;LocoRE 656.66;AGLA 640.00;Beam Search 565.34 | 比最强基线高约13.1-13.8分,且存在性、计数、位置、颜色四子项全面领先 |
| POPE-R 召回率(InternVL-7B) | Recall | 86.5(加HEAL后) | InternVL-7B原始80.0 | +6.5,为Table 2中所有模型单项最大提升,同时F1 85.3→87.8、Acc 86.2→87.9 |
| LLaVA-Bench 综合问答(LLaVA-1.5-7B) | score | 75.2($\alpha=0.6$) | 原始模型72.5 | +2.7,且Table 3显示 $\alpha$ 从0.3扫到0.7呈倒U形,验证均衡点的存在 |
局限与改进
作者承认的局限:其一,校准因子 $\alpha$ 与更新间隔 $S$ 靠经验确定且随模型与任务变化(LLaVA/InternVL系POPE/CHAIR取0.5、其他取0.6;Qwen系取0.4/0.5),Table 3显示不同模型最优点不同;其二,若相关视觉信息在视觉编码或早期融合阶段已丢失,头校准无力回天——Figure 5b中即使调大 $\alpha$,斑马计数等错误仍存在,且 $\alpha$ 过大(0.7)反而产生语法崩坏的输出。我的补充观察:其一,冗余头筛选与DiD分解每 $S$ 步都要做 $H$ 头噪声干预与4倍批前向,对长上下文、大batch在线服务的实际延迟影响仍需评估;其二,校准只作用于协同头,若漂移发生在模态专属头或更深层融合机制,该方法会失效;其三,主基准(POPE/CHAIR)偏物体级幻觉,BLINK-Twice、MMHal-Bench等细粒度空间推理结果在正文中着墨较少;其四,$I_{syn}$ 可为负,先验与证据重叠的折扣方式是近似,PID框架的严格性有待推敲;最后,正文未见代码开源声明,复现需自行实现。
独立分析的弱点
独立分析出的弱点及改进方向:(1)超参敏感且需逐模型调参——$\alpha$ 的U形曲线意味着每个新模型、新任务都要网格扫描,改进方向是把 $\alpha$ 与token级不确定性或熵联动做成自适应控制器,甚至用小回归头从当前信息分布预测最优 $\alpha$;(2)只在协同头内部做重分配,回避了"信息本身缺失"的场景——视觉编码损失导致的幻觉无法靠头间再平衡解决,可与视觉端的token增强、检索增强或重编码机制联动,按幻觉根因分流处理;(3)高斯掩码虽经鲁棒性验证,但均匀掩码下F1降到86.93、换token策略下幻觉比例漂移到0.31:0.66,说明长上下文中统计量匹配并不完美,可探索学习式掩码或最优传输式掩码;(4)更新间隔 $S$ 固定为10,但头角色迁移速度随生成阶段变化,可按相变检测信号动态调整 $S$;(5)因果噪声干预成本随头数 $H$ 线性增长,在70B级模型或多媒体长序列上代价更高,可用低秩代理或头重要性蒸馏预筛;(6)验证集中在7-8B模型与图像模态,向更大规模、视频/音频模态的推广尚缺证据。
未来方向
作者明确提出两个方向:更自适应的校准策略(自动确定 $\beta,\gamma$ 与更新间隔),以及与模型训练更紧的整合(例如把协同头均衡作为训练目标或偏好学习信号)。基于本文成果还可延伸:(1)把协同头的视觉:语言信息漂移量做成免训练的幻觉检测器或置信度估计,为高风险场景提供拒答依据,这是比干预更轻量的应用;(2)用四类头分类做模型诊断与压缩——$3\sigma$ 之下的冗余头是否可安全剪除、协同头占比是否与模型多模态能力相关,值得系统研究;(3)把均衡因子思想推广到视频、音频等更多模态的协同头,或多模态RAG中检索证据与参数知识之间的均衡调节;(4)与对比解码(VCD、OPERA)等输出级方法叠加,检验信息级与输出级校准是否互补;(5)对"任务驱动相变"做动力学建模,用状态空间模型刻画头角色迁移轨迹,实现分阶段的精准校准;(6)分析定理框架在FlashAttention新版本、投机解码等新推理栈下的适配性与开销边界。
复现评估
复现评估:所读正文版本未给出开源代码链接,复现需自行实现,工程门槛中等偏上。利好因素:所用模型LLaVA-1.5-7B、LLaVA-NeXT-7B、Qwen2-VL/2.5-VL-7B、Qwen3-VL-8B、InternVL-7B/3.5-8B均为公开权重,7-8B推理单张24GB级GPU即可,方法免训练;关键超参完整给出($\alpha$ 按模型族与基准取0.4-0.6,$S=10$,冗余阈值 $3\sigma$,$\lambda=2.9652$ 约为2σ水平);POPE、CHAIR、MME、LLaVA-Bench、BLINK-Twice、MMHal-Bench全部公开;附录C.4还提供吞吐、每token延迟、峰值显存与墙钟时间数据。难点:需在KV缓存更新后、注意力核前hook进value向量,式(18)的并行噪声干预与批量DiD张量实现较繁琐,换推理框架(如vLLM的PagedAttention)需重写适配,掩码噪声的均值/方差估计等细节需研读附录。总体估计:熟悉HuggingFace transformers内部机制者数天可复现主结果,完整对齐附录实验约需1-2周。
论文图表
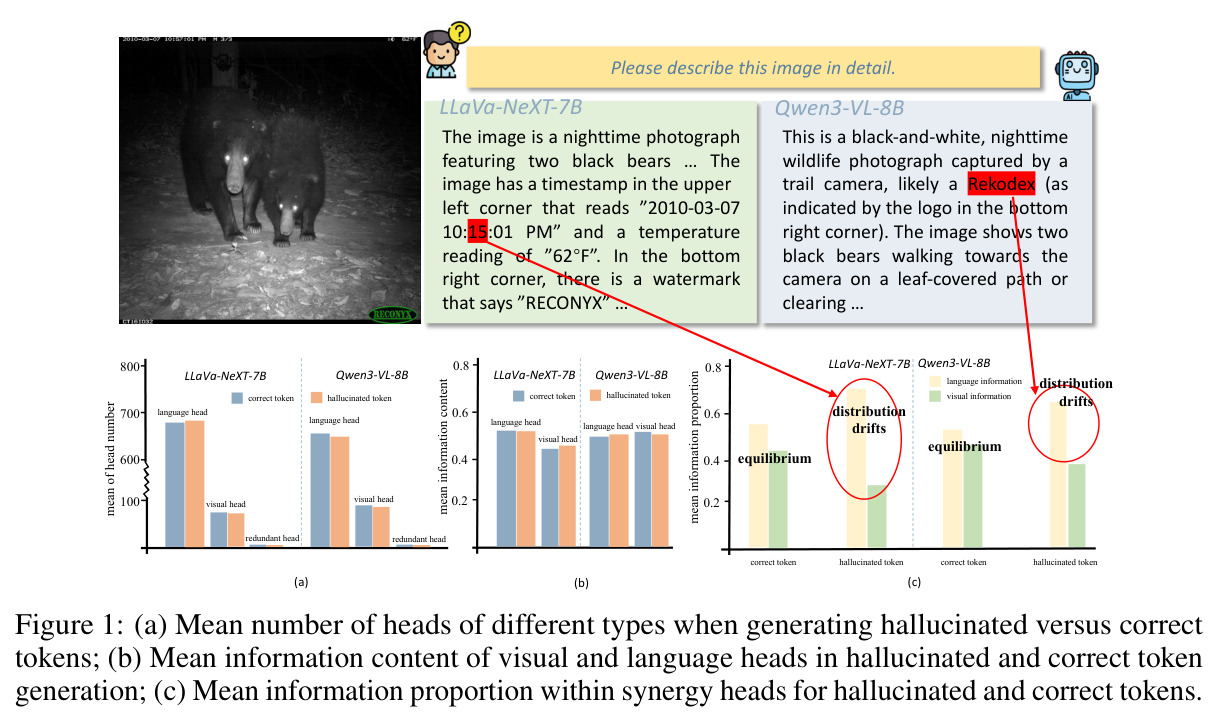
三联统计图:LLaVA-NeXT-7B(正确token)与Qwen3-VL-8B(幻觉token对比)上的统计。(a)显示生成幻觉与正确token时冗余/视觉/语言/协同头的平均数量几乎不变;(b)显示视觉头与语言头的平均信息量在两种token间也无显著差异;(c)显示协同头内部信息比例显著不同——正确token约0.43:0.54,幻觉token漂移到约0.28:0.62,语言占比明显上升。
这张图是全文的立论基础:它排除了"幻觉源于视觉头太少/太弱"的直觉假设,把矛头指向协同头内部的信息分布漂移,是理解动机与后续校准设计(为什么只校准协同头)的关键证据。