全模态流式思考:面向流式音视频推理的声明-验证-撤销框架 Omni-Streaming Thinking
把早期解读存为待验证声明,音频证据到达后验证、纠错并择时作答
前置知识
流式多模态模型
在视频与音频以时间块(chunk)持续到达时进行因果处理的模型:只能利用已观察到的内容、维护有限历史,且必须在某个时刻主动决定何时作答。与拿到完整视频再推理的离线模型不同,流式模型的记忆保留策略与响应时机直接影响答案质量。
OST 的声明-验证-撤销循环、分离保留预算与答案门控全部构建在流式约束之上,不理解流式设定就无法理解为什么验证必须推迟、纠错必须传播。
跨模态过早承诺(premature cross-modal commitment)
论文定义的核心失败模式:模型在支持性证据尚未到达前,就把某一模态(通常是视觉)的早期解读写入工作记忆当作事实。当另一模态(音频)随后给出矛盾证据时,后续推理仍不断复用该早期猜测,错误会扩散到派生摘要与最终答案,且简单撤销原句无法修复所有后代。
这是全文的问题起点,OST 的未来窗口声明、谱系撤销与重写机制都是针对它设计的,标题里的 thinking 指的就是这种可修正的推理。
冻结骨干 + LoRA 低秩适配
LoRA 冻结大模型原始权重,只训练注入各层的低秩矩阵,可训练参数量极小、显存占用低。OST 全程冻结 Qwen3-Omni-30B-A3B-Instruct 骨干,仅训练 forecaster、verifier、gate 三个轻量模块与 LoRA 策略。
理解这一设定才能正确评估论文的训练成本与工程可行性,也解释了为何 OST 可以叠加在任何开源全模态骨干上。
偏好优化与在线强化学习
DPO 类偏好目标用成对样本直接拉开正负响应的对数似然比,绕过显式奖励模型;GRPO/PPO 类在线目标则在策略自身采样的轨迹上用优势估计、比率高下界裁剪与 KL 惩罚更新。OST 先用交叉熵训练 forecaster,再用几何平均概率形式的偏好损失 $\mathcal{L}_{F2}$,最后用在线目标联合训练 LoRA 策略与门控。
论文训练分三阶段(公式 8 与在线目标),没有这些背景就难以理解 forecaster 为何要先 CE 再偏好、策略为何要 on-policy。
信号检测论的 d′(d-prime)
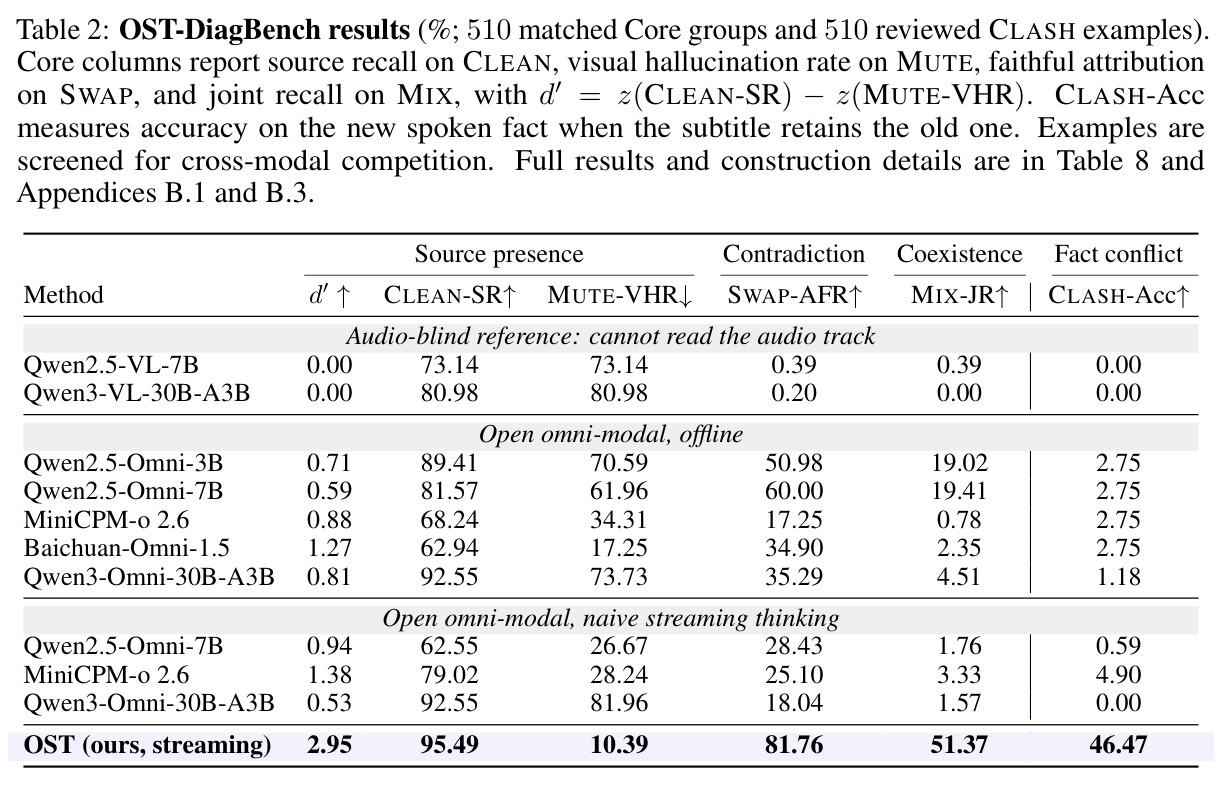
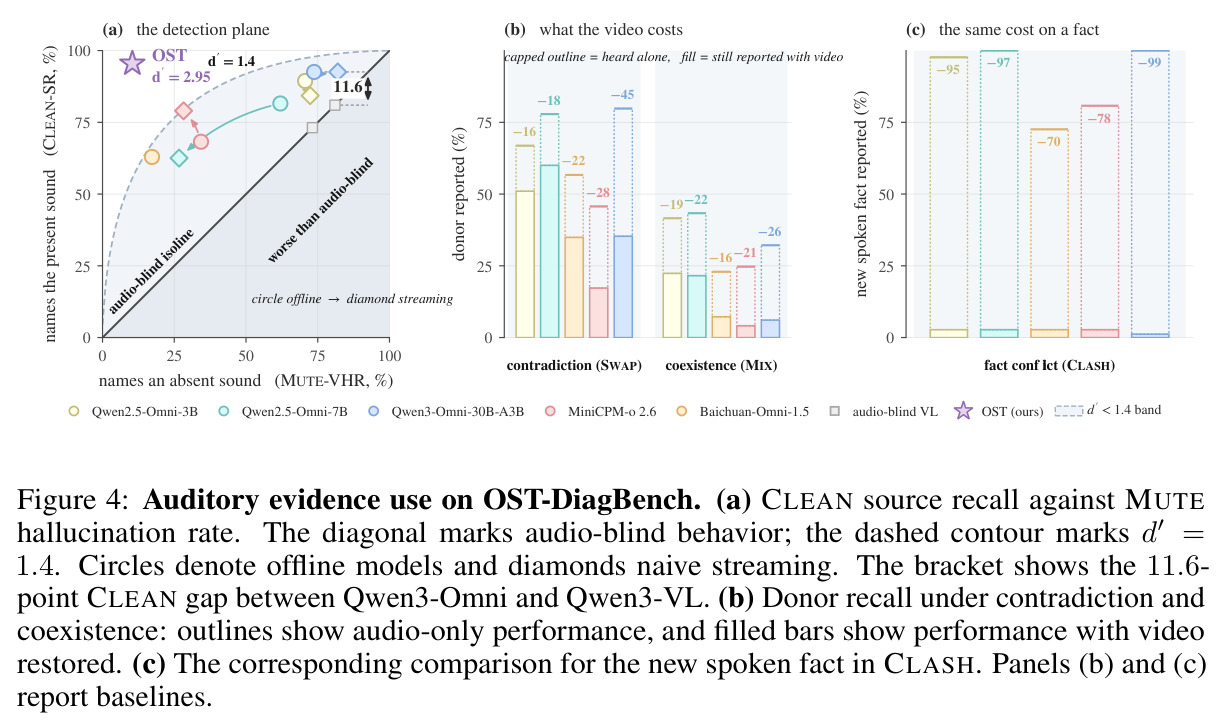
d′ = z(命中率) − z(虚报率),衡量区分信号与噪声的敏感度,不受反应偏置影响。OST-DiagBench 用 $d' = z(\text{CLEAN-SR}) - z(\text{MUTE-VHR})$:CLEAN-SR 是原始音轨下的声音源召回率,MUTE-VHR 是声音被移除后仍报告画面暗示声音的幻觉率,两者差距越大说明模型越真实地依赖听觉证据。
论文最亮眼的指标 d′=2.95(开源基线最高 1.38)需要知道这一定义才能解读,否则容易被高 CLEAN 召回的表层数字误导。
研究动机
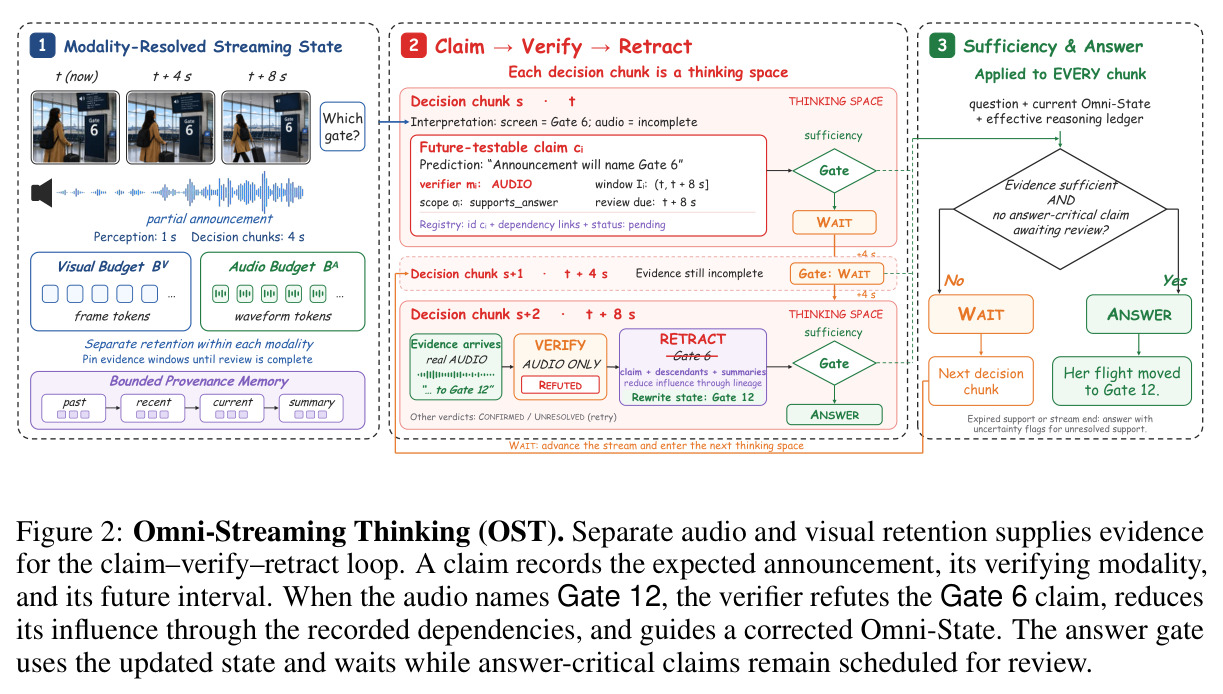
现有流式音视频模型在支持性证据尚未齐全时,就把某一模态(通常是视觉)的早期解读当作事实写入工作记忆。论文给出典型场景:旅客问航班在哪个登机口,屏幕显示 Gate 6,而改到 Gate 12 的广播才刚开始播报;模型从画面推断 Gate 6 并存入记忆,后续推理不断复用这条记录,即使广播播完仍继续输出 Gate 6,论文称之为跨模态过早承诺。数据说明这不是罕见边角案例:Qwen3-Omni-30B-A3B 在 OST-DiagBench 的 CLEAN 条件下源召回率高达 92.55%,说明它完全能听见声音;但改成朴素流式思考后,MUTE 条件(声音被移除)的视觉诱导幻觉率升到 81.96%,CLASH 条件(语音更新事实而字幕保留旧值)准确率跌到 0.00%,而同一个模型在纯音频输入上答对被编辑事实的比例可达 94.12%。也就是说,识别能力完好,视觉线索一旦在场,音频证据就被系统性忽略,且早期猜测会随记忆复用持续扩散到摘要和答案。
本文的目标是本文目标是构建流式全模态推理框架 OST,使模型做到四件事:一,把不确定的早期解读登记为带验证条件的未来可检验声明(claim),而非事实;二,在声明的证据窗口关闭时,用正确的模态(音频、视频或二者)核验该预测;三,核验失败时不仅撤销声明本身,还要沿依赖关系削弱所有继承该声明的派生状态,并用新证据判决条件化地重写记忆;四,用答案门控决定何时作答,等待所有答案关键声明完成核验。作者同时提出 OST-DiagBench:固定视频画面、只编辑音轨(保留/静音/替换/叠加/字幕-语音冲突五种条件),定量测量模型对听觉证据的真实利用程度。最终在冻结的 Qwen3-Omni-30B-A3B-Instruct 骨干上,仅用轻量适配在五个流式与音视频基准取得开源最佳,并在诊断基准上把 d′ 从开源基线最高 1.38 提升到 2.95。
与已有工作不同的是,已有工作分三条线:记忆侧有压缩视觉 token、检索历史观察、把流转成文本记忆的方法;响应时机侧有 Dispider 分离感知-决策-反应、StreamBridge 给离线模型加记忆与激活模型;推理侧有 think-while-watching 维护演化文本状态,以及用 critique 和额外推理修订答案。但这些方法都没有把未来的验证与记忆的纠错连接起来:流式设定下验证必须等待相关观察到达,而纠错必须波及由早期解读派生的全部记忆,这条从早期猜测到持久错误的路径在现有系统中是隐式的。OST 的独特切入是把一条声明同时编码三件事——预期会发生什么、哪个模态在什么时间窗可以验证、哪些下游状态依赖它——让未来测试失败这一事件能自动传播为一次记忆修正。评测侧,OST-DiagBench 也填补了空白:音视频一致时无法区分模型用了哪个模态,该基准固定视频只改音频,暴露了识别与使用之间的鸿沟。
核心方法
直觉上,与其让模型想到什么就信什么,不如强制它把判断写成预测加验证条件加依赖关系,到期用指定模态对账,错了就连带撤销并重写记忆。技术上,OST 以冻结的 Qwen3-Omni-30B-A3B-Instruct 为骨干,感知每秒运行一次,每 4 秒构成一个决策块($\Delta_{\text{chunk}}=4$s),块末时刻 $t_s=\min(s\Delta_{\text{chunk}}, T_{\text{end}})$。每个决策块是一个思考空间:先生成六字段 Omni-State(visual_evidence、audio_state、audio_evidence、conflict、forecast、sufficiency),其中 audio_state 标记声音存在/缺失/不确定;再从上下文 $C_s$ 生成带验证元数据的声明 $c_i=(x_i,m_i,I_i,\sigma_i)$,证据窗 $I_i=(t_s, t_s+\delta_i]$。音频与视觉用独立保留预算并锁定待验证窗口,长期记忆按 4s→16s→64s→长期根四层金字塔合并;窗口闭合时验证器核对声明,失败则触发谱系传播的撤销与判决条件化重写;答案门控在证据充分且无待核验的答案关键声明时放行作答。
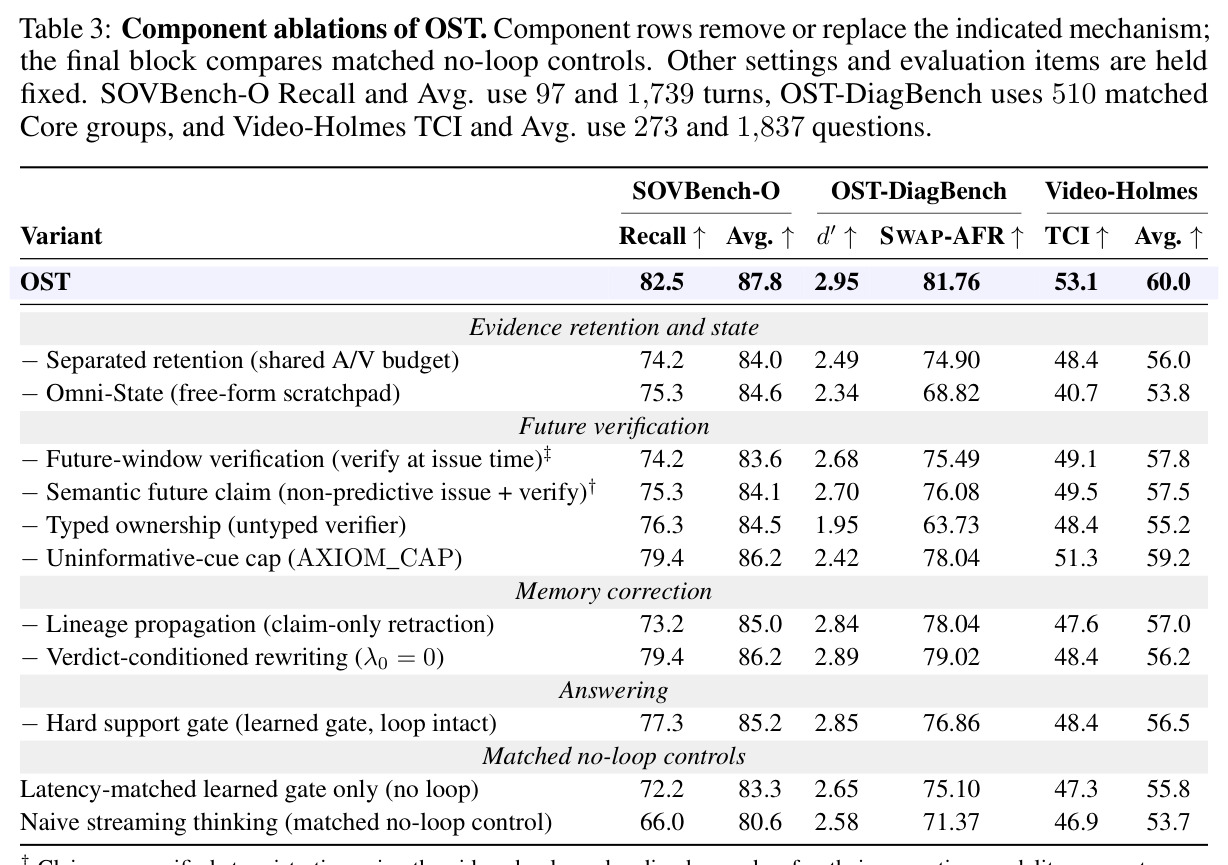
核心创新是声明-验证-撤销闭环把未来证据与记忆纠错绑在一起,有三点本质区别。其一,类型化归属:声明指定验证模态 $m_i$,验证只用该模态的证据,配合分离预算避免稠密视觉 token 挤掉待验证音频(共享预算使 Recall 82.5→74.2)。其二,谱系感知撤销:每次生成都记录支持声明,构成无环溯源图;撤销时按 $\rho_i \leftarrow \min\{\rho_i, \alpha(\gamma_i)\}$ 降低声明可靠性,按 $\bar{\rho}_j=\rho_j\cdot\min_{k\in \mathrm{Anc}(j)}\rho_k$ 传播到全部后代,解码时把 $\log\bar{\rho}_j$ 加到对应 span 的注意力 logits 上;可靠性分数单调不增,改写随记忆压缩与复述持续生效。其三,判决条件化解码:$\tilde{\ell}^s=\ell^+_s+\lambda_s(\ell^+_s-\ell^-_s)$,$\lambda_s=\lambda_0\cdot\frac{1}{|X_s|}\sum_{i\in X_s}\gamma_i$,用临时撤销本次判决的反事实 logits 差作对比方向放大修正——去掉它($\lambda_0=0$)Video-Holmes 平均分 60.0→56.2。
方法步骤详情
第一步(状态重写):每秒编码音视频块,每 4 秒决策块以问题、保留证据、历史状态与声明为上下文 $C_s$,生成状态体 $z^{\text{body}}_s \sim \tilde{p}_\theta(\cdot|C_s)$。第二步(预测声明):forecaster 输出 $c_i=(x_i,m_i,I_i,\sigma_i)$——预测文本、验证模态、时长 $\delta_i$ 的窗口与支持范围(状态/另一声明/答案),登记入带唯一 ID 的注册表,初始可靠性 $\rho_i=1$,后代记录该 ID。第三步(验证):窗口闭合后的首个块边界,验证器 $V_\phi^{m_i}$ 对 $(x_i, O_{m_i}(I_i))$ 输出判决 CONFIRMED/REFUTED/UNRESOLVED 与矛盾裕度 $\gamma_i\in[0,1]$,并用校准上限抑制无信息区间。第四步(撤销与重写):按公式 5 传播可靠性、公式 6 引导解码重写状态体;UNRESOLVED 可重试,过期未决以低置信标志作答。第五步(作答):门控在 $T^\star=\inf\{t_s:\text{Suff}_s=1 \wedge A_s(q)=\varnothing\}$ 作答或流终止时作答。第六步(训练):单模态工具提议时间戳候选,Gemini-3.6-Flash 按 audio/静音视频两遍建事实表;先 CE 再偏好损失训练 forecaster,SFT 训练 LoRA(含保留/移除/替换/叠加音轨的配对样本),最后在线强化学习以准确率、时机、格式奖励联合训练策略与门控。
技术新颖性
新颖性在四个层面。机制上,未来窗口验证要求声明是可证伪预测:换成非预测 issue 使 SOVBench-O Avg 87.8→84.1,登记时刻即验证则→83.6——这把 think-while-watching 的自由文本状态升级为带验证语义的结构。记忆上,可靠性单调不增加溯源图最小值传播,保证撤销经压缩与复述仍成立(Proposition 1),而 Flash-VStream、MovieChat、token 剪枝等记忆方法不携带验证条件与依赖。解码上,verdict-conditioned 生成把反事实重放(临时撤销本次判决得 $\ell^-_s$)作为对比方向,类似对比解码但信号来自验证循环,强度由矛盾裕度 $\gamma_i$ 自适应调节。评测上,OST-DiagBench 用固定视频加五种音轨操作(CLEAN/MUTE/SWAP/MIX/CLASH)与纯音频对照,分离识别与使用,首次给出 d′ 与视觉诱导听觉幻觉率的定量刻画;CLASH 条件下 Qwen3-Omni 朴素流式仅 0.00 分,凸显该问题此前完全未被测量。
实验结果
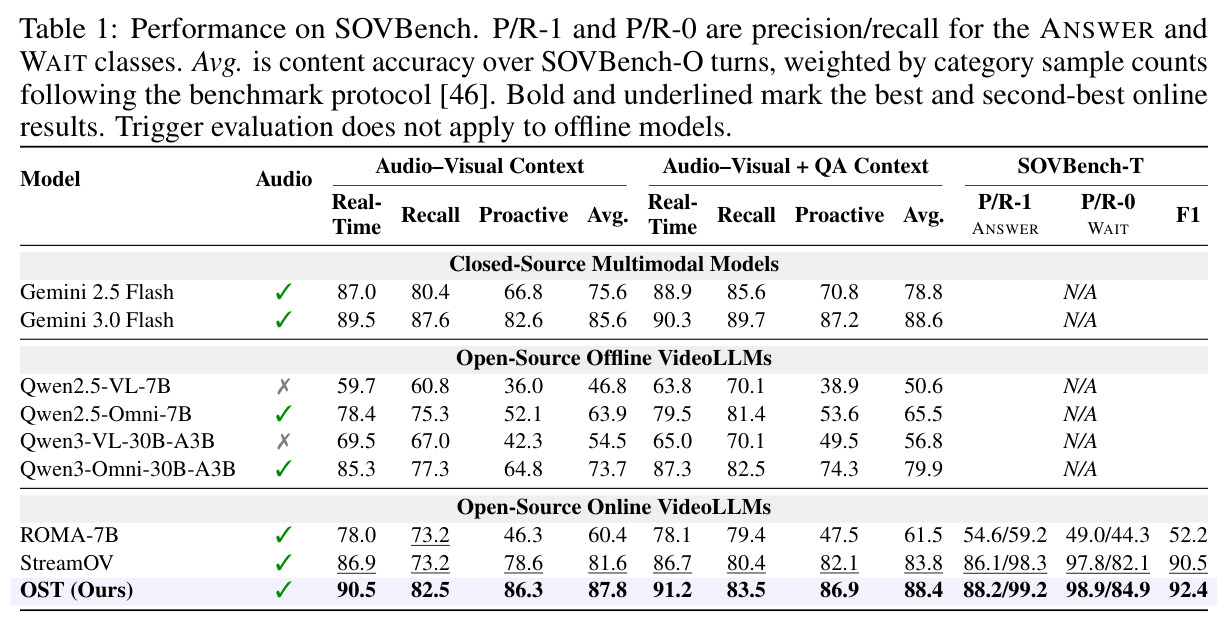
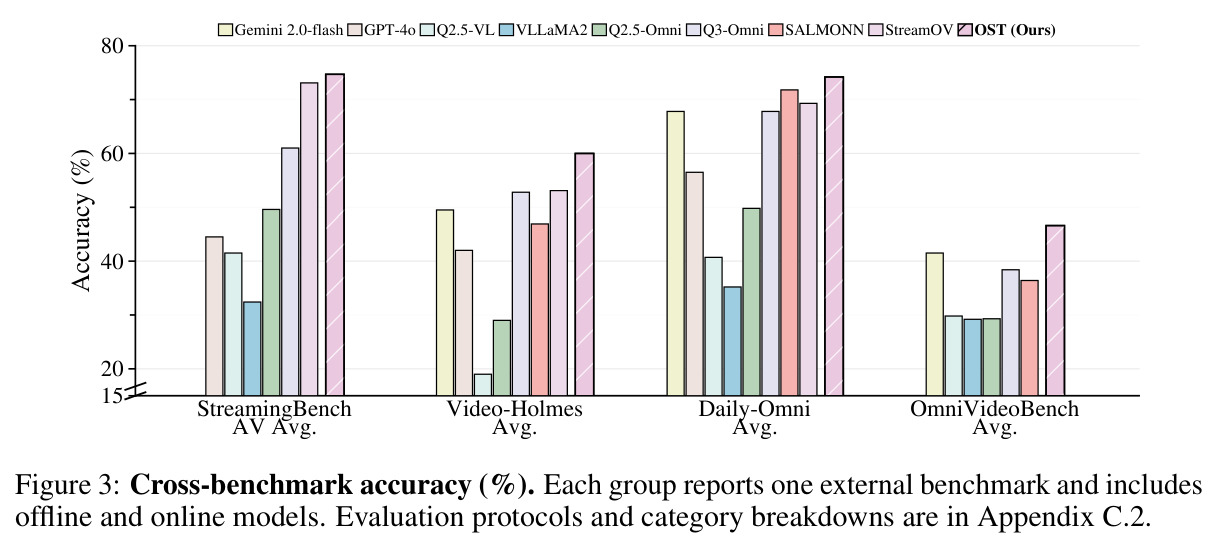
RQ1(SOVBench):OST 音视频上下文平均准确率 87.8,超最强开源在线基线 StreamOV 的 81.6,加 QA 上下文后 88.4 对 83.8;Recall 类问题 73.2→82.5(直接测试早期证据是否保留可用);触发 F1 90.5→92.4(ANSWER P/R 88.2/99.2)。在 StreamingBench、Video-Holmes、Daily-Omni、OmniVideoBench 四个外部基准也全面领先(Figure 3)。RQ2(OST-DiagBench):OST 达 d′=2.95(开源基线最高 1.38),CLEAN 源召回 95.49 与最低 MUTE 幻觉率 10.39 并存,SWAP 归因 81.76、MIX 联合召回 51.37、CLASH 准确率 46.47,而 Qwen3-Omni 朴素流式仅 18.04、1.57、0.00。基线还发现:音频盲模型 d′=0;Qwen3-Omni 纯音频 donor 召回 79.80 优于 Qwen2.5-Omni 的 77.84,加视频后 SWAP 归因反而 35.29 对 60.00——识别与联合使用脱钩。RQ3(消融):共享 A/V 预算 Recall→74.2;自由草稿替代 Omni-State 使 TCI 53.1→40.7;登记时验证→83.6;无类型归属 d′→1.95、SWAP→63.73;仅撤声明不传谱系 Recall→73.2;$\lambda_0=0$ 使 Video-Holmes→56.2;无硬门控→85.2;延迟匹配无循环门控对照 83.3、朴素流式对照 80.6——增益来自闭环本身而非训练技巧。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SOVBench-O(音视频上下文) | 平均内容准确率 | 87.8 | StreamOV 81.6(开源在线最佳);Gemini 3.0 Flash 85.6(闭源) | +6.2(超闭源 Gemini 3.0 Flash 2.2) |
| SOVBench-O(音视频+QA 上下文) | 平均内容准确率 | 88.4 | StreamOV 83.8 | +4.6 |
| SOVBench-O Recall 类问题(长程依赖) | 准确率 | 82.5 | StreamOV 73.2 | +9.3 |
| SOVBench-T 响应触发 | F1 | 92.4(ANSWER P/R 88.2/99.2) | StreamOV 90.5 | +1.9 |
| OST-DiagBench(510 组 Core + 510 条 CLASH) | d′(敏感度) | 2.95 | 开源最佳 1.38(MiniCPM-o 2.6 朴素流式) | +1.57(绝对值,超过 2 倍) |
| OST-DiagBench MUTE 视觉诱导幻觉率(越低越好) | % | 10.39 | Qwen3-Omni 朴素流式 81.96 | 降低 71.57 个百分点 |
| OST-DiagBench CLASH 字幕-语音事实冲突 | 准确率 | 46.47 | 开源最佳 4.90(MiniCPM-o 2.6) | +41.57 个百分点(约 9.5 倍) |
| OST-DiagBench SWAP 换声归因 | 忠实归因率 % | 81.76 | 开源最佳 60.00(Qwen2.5-Omni-7B 离线) | +21.76 |
| StreamingBench / Video-Holmes / Daily-Omni / OmniVideoBench | 平均准确率(Figure 3 分组柱状图) | 四个基准均第一 | 含 Gemini 2.0 Flash、GPT-4o、SALMONN、StreamOV 等 8 个离线/在线模型 | 对最强开源基线每组均有提升 |
局限与改进
作者承认且可观察的局限有:一,全部结果依赖单一骨干 Qwen3-Omni-30B-A3B-Instruct,未验证方法在不同规模或架构上的泛化;二,训练数据依赖闭源 Gemini-3.6-Flash 标注器构建事实表,标注质量上限与成本未披露,正文也未给出训练集规模;三,声明窗口 $\delta_i$ 由模型自己预测,窗口校准误差可能导致验证过早(证据不足)或过晚(等待过久),正文缺乏对窗口预测误差的分析;四,推理开销:每个 4 秒决策块是一个思考空间,验证、反事实重放(需要 $\ell^+_s,\ell^-_s$ 两次计算)与谱系维护都增加延迟,论文只做了延迟匹配对照,未报告端到端时延与吞吐数字;五,OST-DiagBench 规模有限(510+510),且 CLASH 准确率 46.47 说明字幕-语音冲突远未解决;六,d′ 假设正态等方差,对幻觉率接近 0 或 100 的极端值可能不稳健;七,Proposition 1 只保证分数界传播,没有给出修正后答案正确性的理论保证。
独立分析的弱点
弱点一:可靠性传播用祖先最小值再相乘,依赖链一长,$\bar{\rho}_j=\rho_j\min_{k\in\mathrm{Anc}(j)}\rho_k$ 会迅速塌缩,可能过度抑制本来自洽的长推理链;改进方向是引入按证据强度的贝叶斯更新或带衰减的归一化。弱点二:REFUTED 二值判决加连续 $\gamma_i$ 对部分正确的声明(数字对但说话人错)缺乏结构化表达,撤销是全有或全无;可引入字段级冲突定位,只重写受影响的字段。弱点三:音频/视觉分离预算是静态的,语音密集段与画面密集段的最优配比不同;可学习跨模态预算调度器按信息密度动态分配。弱点四:验证器校准依赖手工的无信息上限,没有端到端校准损失,$\gamma_i$ 的可靠性跨数据集未知;可加置信度校准目标。弱点五:答案门控要求充分且无待审声明,对低延迟场景(直播字幕、实时翻译)4 秒决策块加等待可能太慢;需要可变块长或显式的作答时机代价模型。弱点六:训练闭环的奖励依赖事实表质量,若 Gemini 标注在噪声音轨上出错,verifier 会学到系统性偏差。
未来方向
作者方向:把声明机制扩展到更多模态组合与小时级长流;将 OST-DiagBench 扩展为标准诊断套件(源片段与干扰音频已从训练中 held out)。基于成果可延伸:一,把谱系传播从注意力 logit 偏置推广到 KV 缓存淘汰策略,让记忆压缩与纠错统一在一个框架里;二,引入主动证据获取——声明 UNRESOLVED 时主动请求更高帧率、提高音量增益或回放缓冲,把流式感知变成主动感知;三,把声明注册表外化为可查询的符号记忆,支持用户事后质询模型为何曾给出 Gate 6,增强可解释性与可审计性;四,多机位、多麦克风场景下的跨流声明对账;五,理论上论文只给了 Theorem 1 关于引导解码增加目标 token 相对几率的单调性结果,可进一步分析最小值传播在长链上的收敛性与过度抑制的界;六,把配对音轨训练策略(保留/移除/替换/叠加)推广到字幕-画面、文本-图表等其他模态冲突,治疗更广义的模态支配幻觉。
复现评估
复现条件评估:骨干 Qwen3-Omni-30B-A3B-Instruct 开源,OST 只训练 LoRA 与轻量 forecaster/verifier/gate,训练量适中,单节点多卡应可完成(论文未给出确切 GPU 配置)。有利因素:项目页 enjundu.com/blog/ost/ 提供视频演示与资源;训练损失、奖励项与优化设置在附录 A.7,声明记录与准入规则在附录 A.2,OST-DiagBench 构建与筛选细节在附录 B;SOVBench 与四个外部基准均为公开协议,消融表给出 12 个变体在三个基准上的完整数字,复现路径清晰。不利因素:训练数据流水线依赖多个单模态工具与闭源 Gemini-3.6-Flash 事实表标注器,配对音轨数据的具体规模未在正文给出;推理侧需自行实现反事实重放、谱系图维护与逐 token 重算 $\tilde{\ell}^s$,工程量不小;OST-DiagBench 的干扰音频录制若不随代码发布则难以完全重建。总体难度:中高——若官方开源代码与基准,可直接复现主表与诊断;若只有论文,需自行搭建数据流水线,预计数周到一两个月。
论文图表
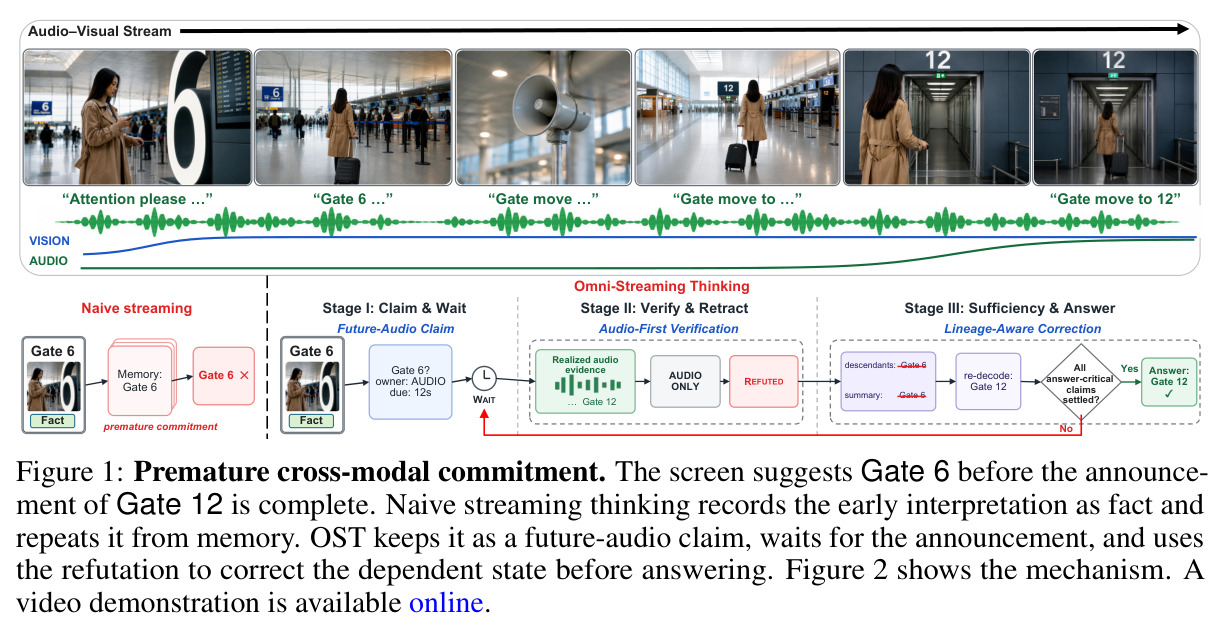
时间线对比图,展示旅客问登机口的例子:画面显示 Gate 6,广播 Attention please → Gate 6 → Gate move → Gate move to 12 逐步播完。上半部分是朴素流式:Gate 6 作为事实写入记忆并被持续复述,即使音频已给出 Gate 12。下半部分是 OST 的三阶段:Stage I 把广播将确认 Gate 6 登记为未来音频声明并 WAIT;Stage II 在验证窗口结束时用纯音频证据驳回 Gate 6(REFUTED),沿依赖链(摘要、答案)传播修正并重写状态为 Gate 12;Stage III 在答案关键声明全部结清后回答 Gate 12。
一张图讲清论文要解决的核心失败模式(过早跨模态承诺)与方法的端到端流程,是全文的电梯图;回答时机(WAIT→VERIFY→ANSWER)与记忆修正(re-decode)的关系一目了然。