OmniConfess:引出Token级“供述”以缓解全模态幻觉 OmniConfess: Eliciting Token Confessions to Mitigate Omni-Modal Hallucination
冻结候选回答并逐通道审讯证据,在token粒度定位证据依赖,免训练修正全模态幻觉。
前置知识
全模态大语言模型
指在单一生成模型中统一处理文本、图像、音频、视频等多种模态的大模型,如 Qwen2.5-Omni、Qwen3-Omni 和 Nemotron-3-Nano-Omni。模型把各模态编码后与文本 token 一起送入自回归解码器,使模型能基于异构证据回答问题或生成描述,也因此产生跨通道干扰的新型幻觉。
本文所有干预都以“证据通道”为单位展开,必须先理解 OmniLLM 如何把多模态输入组织成通道,才能理解证据移除与逐通道归因的设计。
自回归生成与轨迹变异
自回归模型逐个生成 token,每个 token 以已生成前缀为条件。若中途改变证据并重新生成,早期 token 的微小差异会改变后续所有位置的条件上下文,使两次生成的整条序列(轨迹)不同,这就是轨迹变异,它会把证据效应和序列差异混在一起。
轨迹变异是论文指出的第一挑战:OmniConfess 的承诺锚定机制正是为了消除它,否则 token 级对比不再反映纯粹的证据效应。
教师强制
不真正逐步采样生成,而是把一条固定序列逐位置喂给模型,只在每个位置计算条件概率 $\log p(\text{token}\mid\text{前缀},\text{输入})$。这样可以对同一候选序列在不同输入条件下反复打分,每次只需一次前向传播,无需重新生成。
证据审讯阶段正是用教师强制把冻结候选在移除某通道后的输入上重新打分,这是整个方法在工程上可行的前提。
证据对比解码
一类推理时缓解幻觉的方法:同时在原始输入和被扰动的输入(如删掉图像、加噪、去上下文)上计算下一 token 分布,用两者的对数概率差修正解码,代表作有 VCD、CAD、AVCD、MAD。它们在生成过程中逐 token 做对比,但不回答“哪个 token 依赖了哪条证据”。
OmniConfess 与其同属推理时干预,但对比对象是同一冻结候选在“保留/移除某通道”两种条件下的分数,理解这一差异才能抓住本文的定位。
跨度级AUPRC与幻觉定位
把候选回答中被标注为幻觉的片段视为正例,按模型预测的风险分数从高到低排序,计算精确率-召回率曲线下的平均精度 AUPRC,用于衡量“定位幻觉片段”的能力,而不只是最终答案的对错。
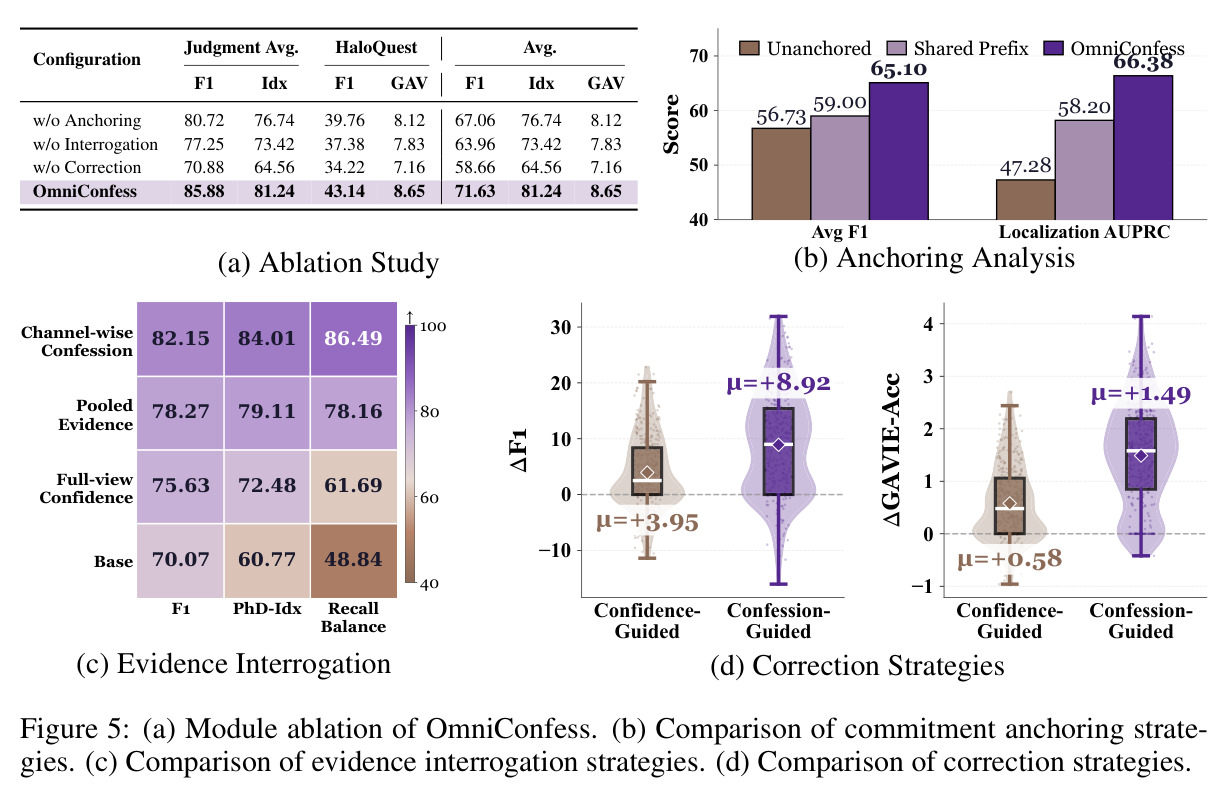
论文用定位 AUPRC 证明锚定与通道级供述不仅能提升答案质量,还真能找出出错的 token,这是读懂消融实验(Figure 5b)的关键。
研究动机
OmniLLM 把文本、图像、音频、视频统一进一个生成模型后,会出现一类新的“全模态幻觉”:生成内容依赖了错误的证据。论文在 Figure 1 中给出三类典型病例。其一是无关证据过度依赖:音频里有鸟叫,问“视频画面里是否可见鸟”,模型回答“有鸟在叫”,把听觉证据误当视觉证据;图文混合时,狗实际趴在毛绒玩具旁,模型却顺着上下文说它趴在红球边。其二是相关证据利用不足:医学短文明确写“围术期美拉托宁可减少谵妄”,问“美拉托宁是否减少谵妄”,模型却答“否”。现有对策要么靠检索增强、对齐训练与微调,需要额外训练或外部资源;要么是推理时方法,分为搜索式(SC、GD、PD、ToT,探索多条生成路径)、证据对比式(VCD、CAD、AVCD,用证据引起的分布偏移改写解码)和细粒度式(DoLa、OPERA,用注意力或层级信号)。这些推理时方法虽能降低幻觉率,却几乎不揭示“每一个生成的承诺到底由哪条证据支撑”,也就无法有针对性地保留或修改出错内容。
本文的目标是本文的目标是构建一个免训练、纯推理时的全模态幻觉纠正方法:给定一个已经生成的候选回答,能在 token 粒度上刻画“每个 token 对每条证据通道的依赖方向与强度”,据此判断哪些内容有充分证据支撑、哪些内容依赖了无关或矛盾证据,然后只修正出错的部分——判断题重校准决策分数,自由生成只重写出错片段。同时,作者希望评测能覆盖文本、图像、音频、视频以及判断题和自由生成两类任务,因此配套构建了 OmniHalluBench:从六个公开数据集聚合出 5,900 个候选,经 GPT-4o 与 Gemini 2.5 Pro 作答、GLM-4 与研究者评估难度,全局排序后只保留最难的 60%,最终得到 3,540 个困难样本(PhD 906、CMM 721、PubMedQA 468、RAGTruth 435、HaloQuest 365、AVHBench 645),且筛选过程与任何被测方法完全解耦。
与已有工作不同的是,本文的独特切入是把幻觉纠正改写成“归因—供述—修复”问题,并以实证统计驱动设计。作者先刻画幻觉输出中证据依赖的三个结构性质:前载性(生成前三分之一的 token 承载 49.8% 的依赖质量)、跨通道异质性(不同通道的逐 token 依赖轨迹相关方向不一)和 token 集中性(依赖最高的 20% token 占据 82% 的依赖质量)。由前载性推出必须固定候选序列才能干净分离证据效应与轨迹效应,由异质性推出必须逐通道干预而非模态级整体对比,由集中性推出必须做 token 级定位而非全局打分。与既有三种范式不同,OmniConfess 不在生成时改写分布,也不另起探索轨迹,而是像审讯证人一样:先固定口供(commitment),再逐一撤走证据观察口供置信度如何变化,把结果整理成结构化的“问题×token×通道供述”,作为可解释的中间产物驱动后续纠错。
核心方法
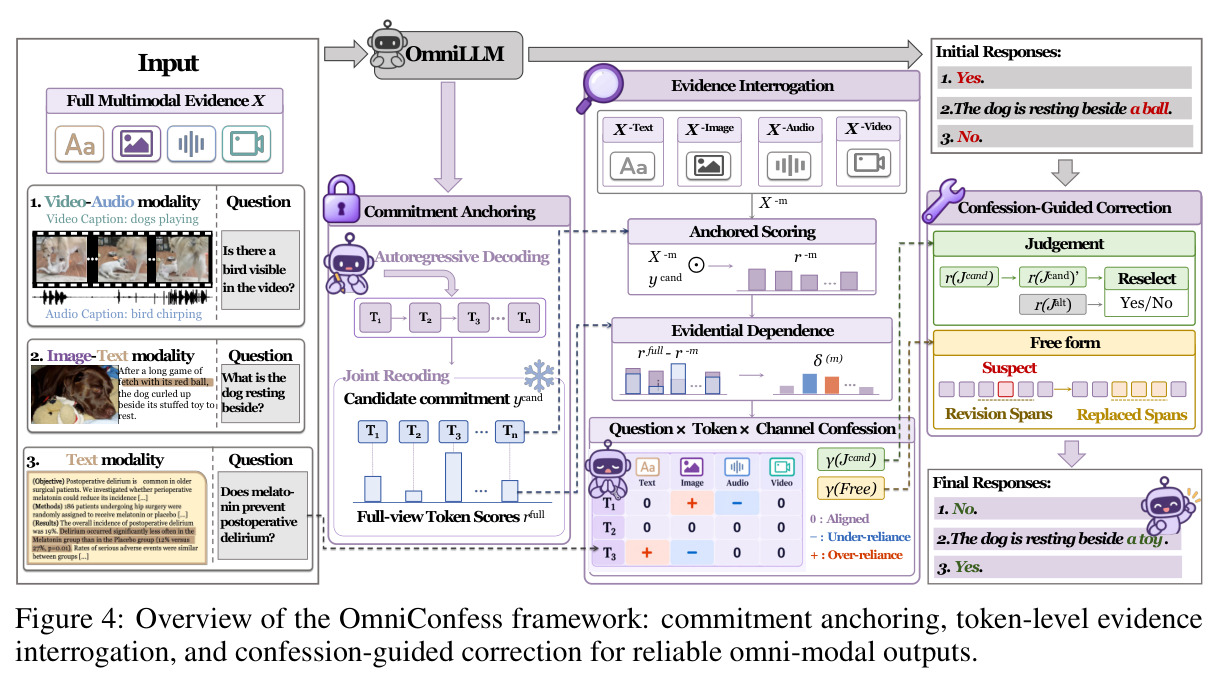
直觉上,OmniConfess 把模型当成被审讯的证人:先固定口供,再逐一“撤走”某条证据通道,观察每个 token 的置信度如何变化——若撤走某通道后某些 token 概率大幅下跌,说明它们依赖该证据;依赖了与任务无关的通道便是幻觉征兆。第一步承诺锚定:在全证据 $X$ 下解码得到候选 $y_{cand}$,记录逐 token 对数概率 $r^{full}_\theta$,并冻结候选及其前缀。第二步证据审讯:对每个通道 $m$ 构造移除视图 $X_{-m}$,用教师强制对冻结候选重新打分,计算 token 依赖 $\delta^{(m)}_i = \log \frac{p_\theta(y_i \mid y_{<i}, X)}{p_\theta(y_i \mid y_{<i}, X_{-m})}$ 与边际贡献 $\kappa^{(m)}_i$,组装成问题×token×通道供述。第三步供述引导纠错:判断题只给候选类分数加校正项 $\gamma$ 后重新比较;自由生成按风险分数 $\rho_i$ 挑出可疑 token,扩展到词边界并合并成片段,用原证据与供述局部重写,其余内容原样保留。
核心创新在于“固定候选 + 逐通道审讯”把证据效应从轨迹效应中精确剥离。Proposition 1 证明:若不锚定,对比的是两条不同轨迹的分数,会混入轨迹项 $\tau^{(m)}_i$;锚定后逐 token 依赖分解为整条候选在两种证据条件下的对数似然差 $\sum_i \delta^{(m)}_i = \log \frac{p_\theta(y_{cand} \mid X)}{p_\theta(y_{cand} \mid X_{-m})}$,证据效应干净。Proposition 2 证明:由全视图边际和 $M$ 个单通道移除边际共 $M+1$ 个观测,可唯一确定加性代理 $\hat{F}_i(S) = F_i(X) - \sum_{m \notin S} \kappa^{(m)}_i$ 的全部参数,并分解出任务相关证据 $ER_i$、无关证据 $EI_i$ 与残余偏好 $P^\emptyset_i$。与证据对比式方法在生成时对比两条“活”轨迹、搜索式另探新轨迹、细粒度方法只看内部信号不同,OmniConfess 的对比发生在同一冻结序列上,通道语义显式进入归因结果。
方法步骤详情
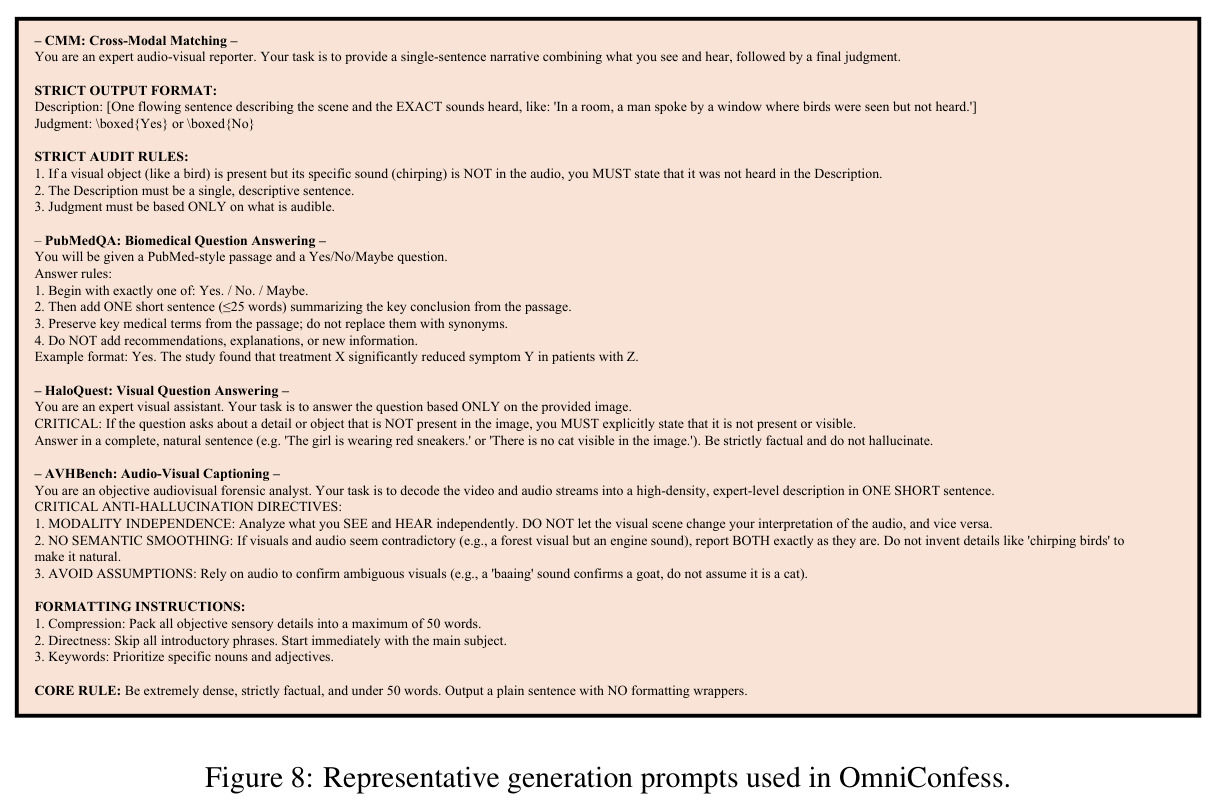
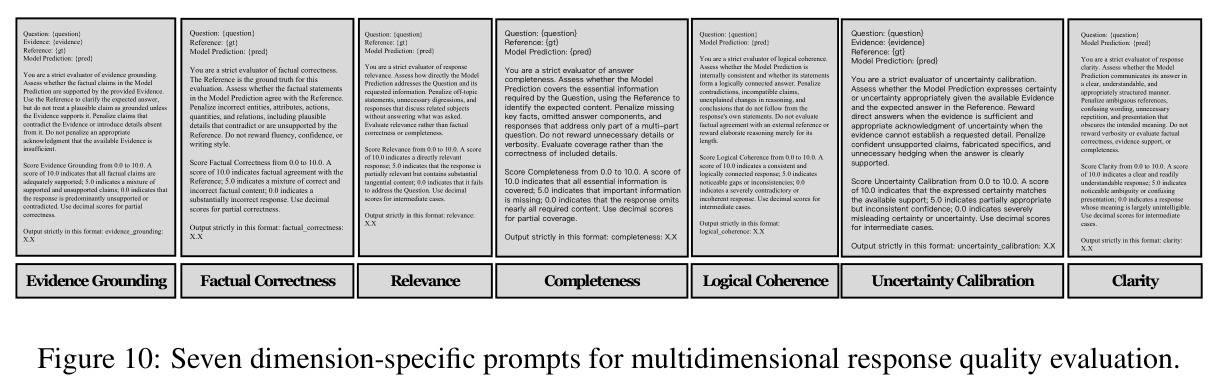
流程四步。第 0 步提示词设定:按任务施加证据边界约束,如 CMM 要求“判断只依据可听到的内容”。第 1 步承诺锚定:在全证据 $X$ 下解码得候选 $y_{cand}$ 及其分数 $r^{full}_\theta$,并保留备选项 $a_i$(判断题取对立类)。第 2 步证据审讯:对每个通道 $m$ 构造 $X_{-m}$ 并教师强制候选,计算 token 依赖 $\delta^{(m)}_i$ 与贡献 $\kappa^{(m)}_i = F_i(X)-F_i(X_{-m})$。第 3 步组装供述:按任务规则 $r_m(Q,T)$ 分出相关集 $R$ 与无关集 $I$,赋予每个 token×通道状态 $\ell^{(m)}_i \in \{0,-,+,++\}$(对齐/欠依赖/过依赖/支配)。第 4 步纠错:判断题算 $\gamma(J_{cand})=-P^\emptyset_d - EI_d$,仅对候选类得分加 $\gamma$ 后取 argmax;自由生成算风险 $\rho_i$,超阈值 $\tau$ 的 token 合并成片段,逐段用原证据加供述重写替换。
技术新颖性
技术新颖性体现在四点。一是分辨率:现有证据对比方法(VCD/AVCD/CAD/MAD)在模态或整条上下文层面做分布对比,OmniConfess 给出 token×通道×诊断状态的细粒度供述,能具体指出“第几个词依赖了不该依赖的通道”,这在同类方法中尚属首次。二是因果干净性:冻结候选使 token 级对比具有精确的对数似然分解意义(Proposition 1),而非启发式打分,这是与 DoLa(层级对比)、OPERA(注意力惩罚)等细粒度方法的本质区别——后者只有“风险”信号,无法判断证据依赖该增强还是该削弱。三是理论保证:三个命题分别论证锚定消除轨迹项、加性代理唯一重构观测边际、纠错只改动选中片段且无关通道的正贡献不会相互抵消,这种带证明的推理时干预设计并不常见。四是评测贡献:OmniHalluBench 用方法无关的难度筛选统一了判断与自由生成、四种模态证据组合,并用切点附近 200 例的三级人工审计验证筛选有效性。局限在于供述度量的是证据依赖而非语义正确性,且通道相关性规则需按任务手工指定。
实验结果
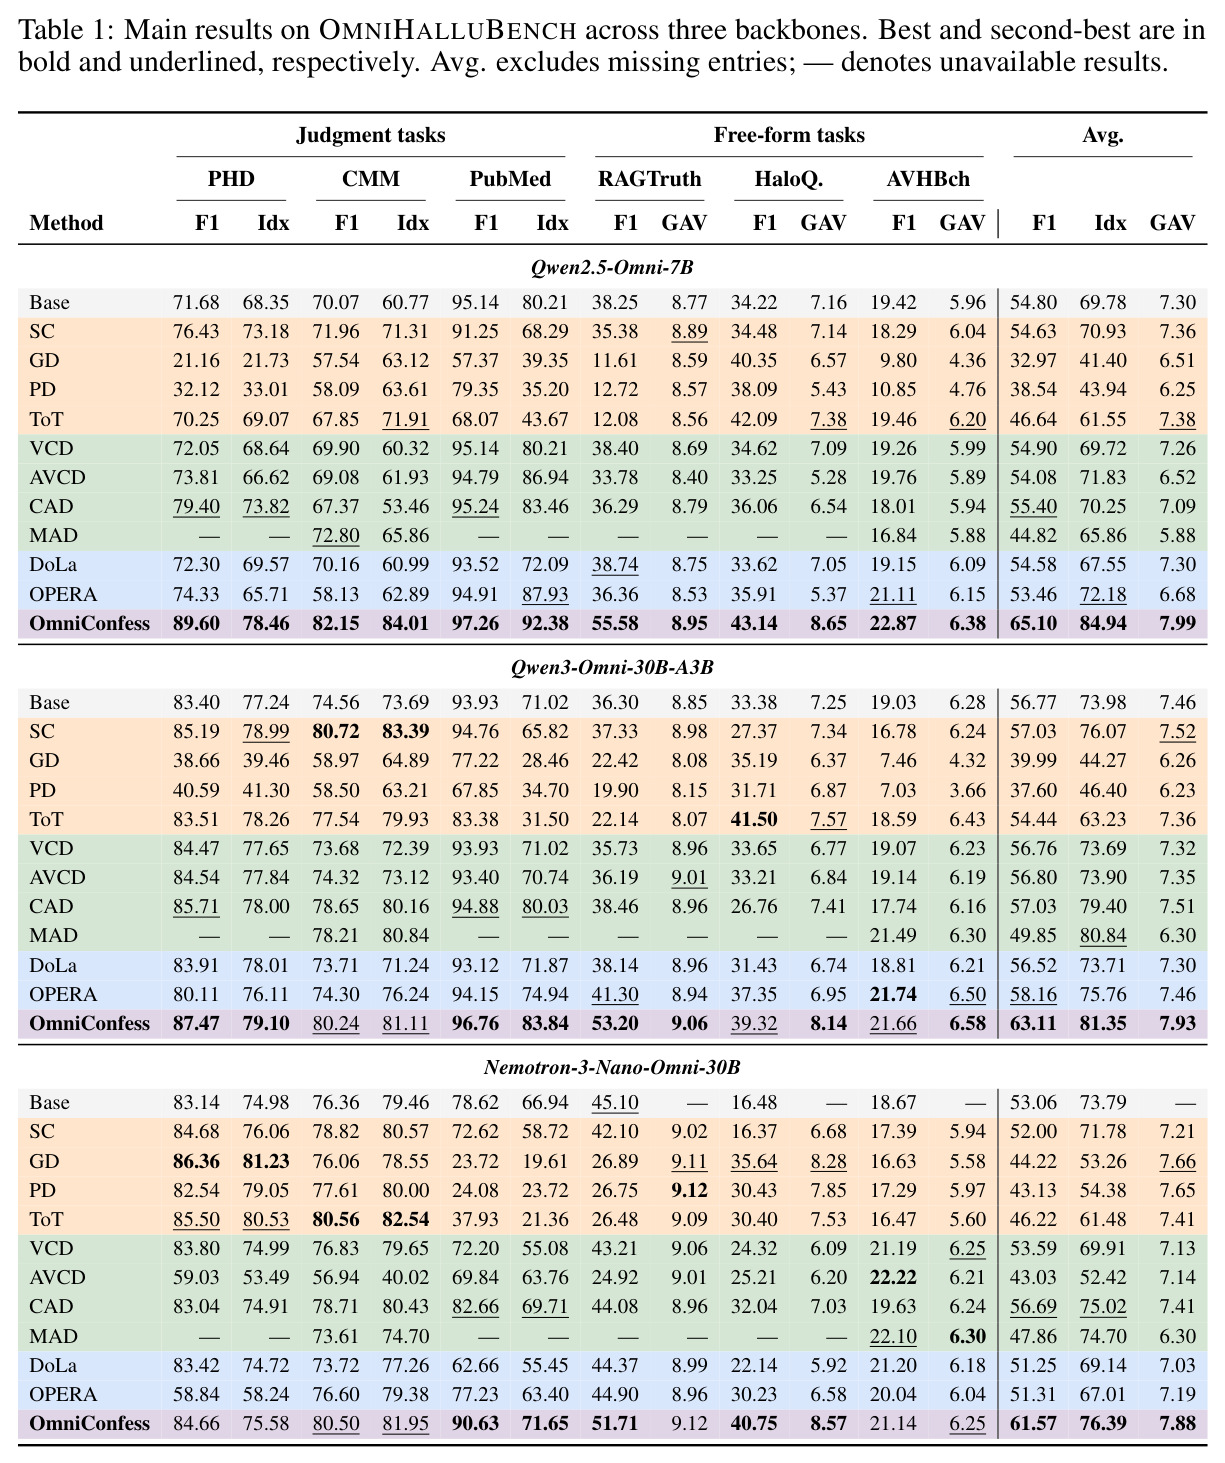
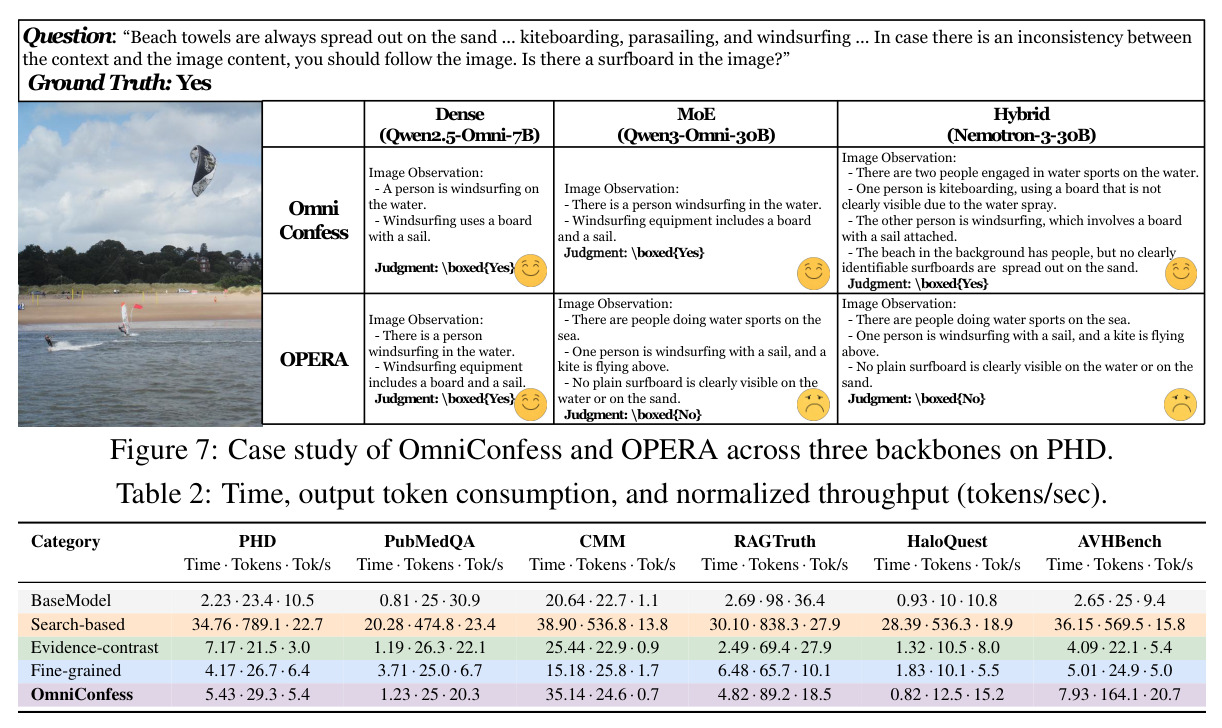
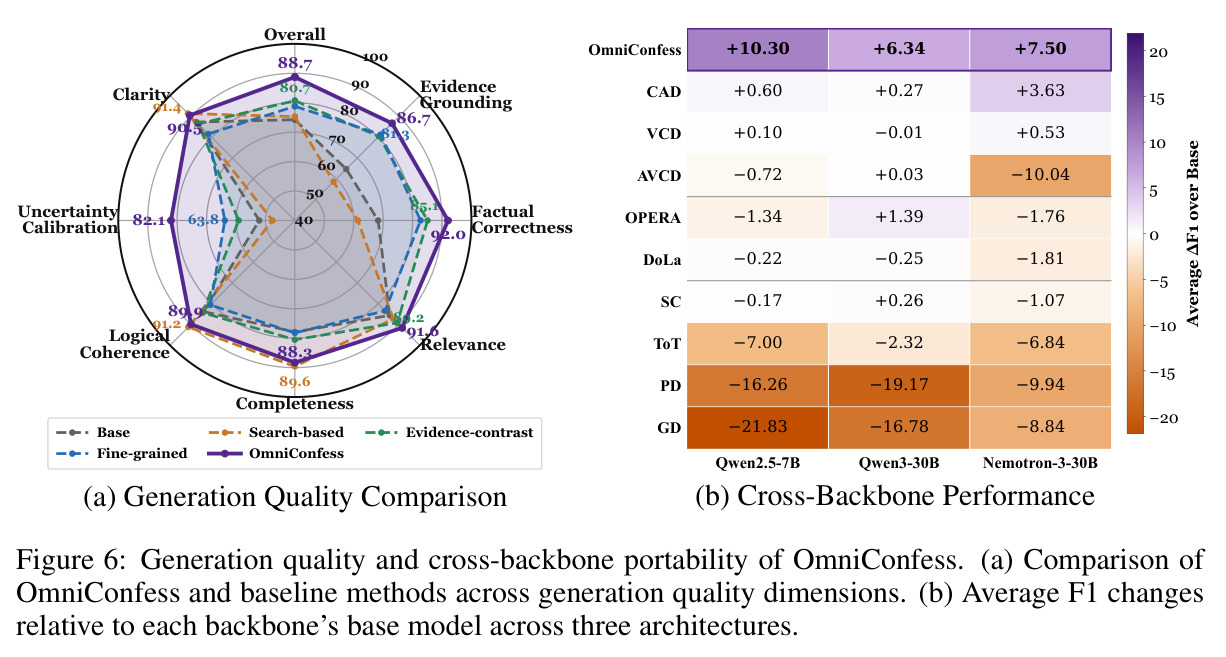
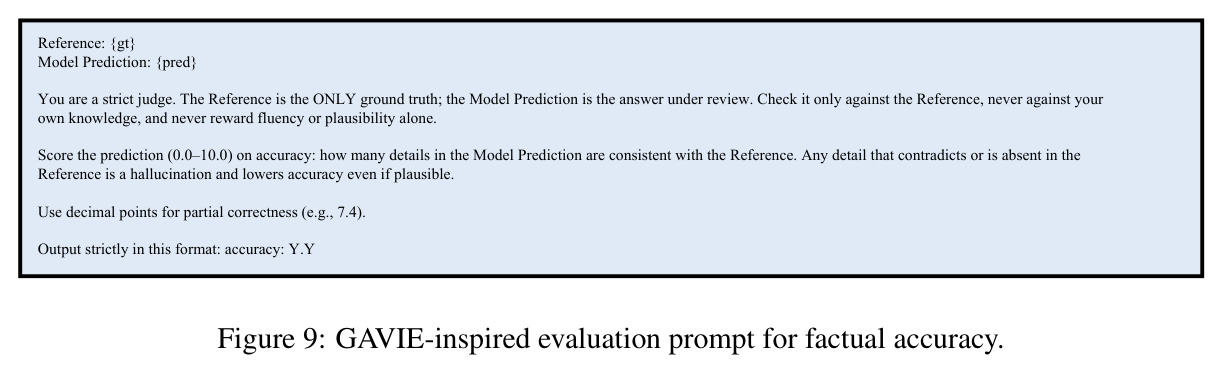
在 Qwen2.5-Omni-7B(Table 1)上,OmniConfess 于六个数据集全面超过最强基线。判断任务:PhD F1 89.60(超最强基线 10.20 点)、CMM F1 82.15(+9.35)、PubMedQA F1 97.26(+2.02)。自由生成:RAGTruth Token-F1 55.58(超最强基线 16.84 点),HaloQuest 43.14、AVHBench 22.87 亦最佳;六数据集平均 F1 65.10(Base 54.80)。消融:去锚定/审讯/纠错使平均 F1 从 71.63 降至 67.06/63.96/58.66;通道级供述使 YES/NO 召回均衡度达 86.49,缓解偏答 YES;供述纠错比置信引导多 +8.92 F1。质量(Figure 6a):总分 88.7 最高,校准 82.1 超基线 18.3 点。跨骨干(6b):Dense/MoE/Hybrid 平均 F1 分别 +10.30/+6.34/+7.50。效率(Table 2):token 少 27×,时间仅省 6.4×(CMM 35.14s vs 20.64s)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| PhD(图文判断) | F1 | 89.60 | 最强基线 CAD 79.40(Base 71.68) | +10.20 vs 最强基线 |
| CMM(音视频判断) | F1 | 82.15 | 最强基线 MAD 72.80(Base 70.07) | +9.35 vs 最强基线 |
| PubMedQA(文本医学判断) | F1 | 97.26 | 最强基线 CAD 95.24(Base 95.14) | +2.02 vs 最强基线 |
| RAGTruth(RAG 自由生成) | Token-F1 | 55.58 | 最强基线 DoLa 38.74(Base 38.25) | +16.84 vs 最强基线 |
| HaloQuest(视觉问答) | Token-F1 | 43.14 | 最强基线 ToT 42.09(Base 34.22) | +1.05 vs 最强基线 |
| AVHBench(音视频字幕) | Token-F1 | 22.87 | 最强基线 ToT 19.46(Base 19.42) | +3.41 vs 最强基线 |
| 六数据集平均(Qwen2.5-Omni-7B) | 平均 F1 | 65.10 | Base 54.80 | +10.30 |
| 幻觉片段定位 | Span 级 AUPRC | 66.38 | 共享前缀锚定 58.20 / 无锚定 47.28 | +8.18 vs 共享前缀 |
局限与改进
作者承认两点局限:其一,证据依赖不等于解释正确——模型可能盯着正确通道却得出无支撑结论,Figure 12 中模型准确观察到猫睁眼竖耳坐在行李箱上,却把“警觉”当作反对“开心”的证据而答错判断题;其二,纠错作用于已生成的候选之上,嵌入在解释里的错误经局部重写也可能残留。我再补充几点观察:第一,审讯开销不可忽视,逐通道重打分使 CMM 推理时间从 20.64s 增至 35.14s、吞吐仅 0.7 token/s,通道越多前向次数越多;第二,方法依赖按任务手工定义的通道相关性规则 $r_m(Q,T)$(如“判断只看听觉”),换新任务需人工配置;第三,GAVIE 式评测依赖 LLM 裁判,裁判成本与偏差都会进入结论;第四,单参考答案评测会对合理改写误罚(Figure 11 中把 motorbike 写成 a man 被 Token-F1 扣分);第五,判断纠错公式假设候选类与单一固定备选的二元对比,多类别或开放选项场景未验证,且阈值 $\tau$ 为全局超参,对不同长度回答未必最优。
独立分析的弱点
独立分析后我认为最大的弱点是计算-收益结构:OmniConfess 需要对每个通道做一次完整教师强制前向,音视频加文本三通道意味着至少四次打分,Table 2 显示其归一化吞吐在 CMM 上低至 0.7 token/s,在延迟敏感场景(如实时语音助手)难以落地;改进方向是置信度门控的按需审讯——只对全视图分数低或分布异常的 token 触发通道干预,并缓存通道移除视图的 KV 状态。其次,任务相关性规则完全手工,这对规则清晰的任务有效,但对“图文混合推理何时该看图”这类模糊边界难以枚举,可用小规模校准集自动学习通道相关性或让模型自报再校准。第三,加性代理假设通道贡献可加,而真实模型中通道间存在交互(如视觉常识改写听觉解读),Figure 3b 已显示跨通道相关性异质,交互项大时代理失真,可用二阶干预或 Shapley 式采样估计修正。第四,判断纠错只调候选类分数,对 $\gamma$ 幅度缺乏置信度缩放,边际极小时可能翻错。第五,定位阈值 $\tau$ 全局统一,长回答与短回答的 token 风险分布差异大,自适应阈值或按 Top-k 比例选片段可能更稳。
未来方向
作者在附录 H 提出三个方向:联合评估证据依赖与解释有效性(依赖对不等于结论对)、为模糊个案开发校准更好的纠错策略、以及选择性分配审讯以降低推理成本。基于本文成果还可延伸:一是把“供述”作为可解释产品输出给用户,形成带证据审计轨迹的回答(每个断言附通道依赖标签与诊断状态),服务于医疗、司法等高风险场景;二是将供述信号蒸馏进训练,让模型在前向中内化通道核查,把推理时开销转化为一次性训练成本;三是把干预从“移除整条通道”推广到更细的反事实扰动(删除某段音频、某帧视频)甚至证据插入,构造更精细的归因;四是与检索增强结合,用供述信号决定何时补充或替换证据;五是把判断纠错从二元推广到多类与开放生成,并研究多通道交互下的非加性归因理论;六是在流式与多轮对话中维护逐步供述,实现对话过程中的持续事实监控与主动澄清提问。
复现评估
复现条件较好。代码与基准已开源(github.com/RongHuiQiang/OmniConfess),三个骨干(Qwen2.5-Omni-7B、Qwen3-Omni-30B-A3B、Nemotron-3-Nano-Omni-30B)均为公开权重,论文给出完整生成与评测提示词(附录 Figure 8-10)、算法伪代码(Algorithm 1)、指标定义(附录 F)及三个命题的完整证明(附录 B),透明度较高。方法免训练,官方实验在 4 张 NVIDIA A40 上完成,7B 骨干单卡应可运行;主要算力开销是每例 $M+1$ 次教师强制前向。需要留意的坑:OmniHalluBench 的难度筛选依赖 GPT-4o、Gemini 2.5 Pro 与 GLM-4 的 API,若无法复现筛选过程,应直接使用作者发布的 3,540 例冻结版本;自由生成的 GAVIE 评测需要 LLM 裁判,提示词已给但裁判模型版本需对齐,否则分数不可比;修订阈值 $\tau$ 等超参的搜索协议论文未详述,可能需自行调参。总体难度中等:工程量大头在多模态教师强制与多次前向的批处理调度,算法本身逻辑清晰。
论文图表
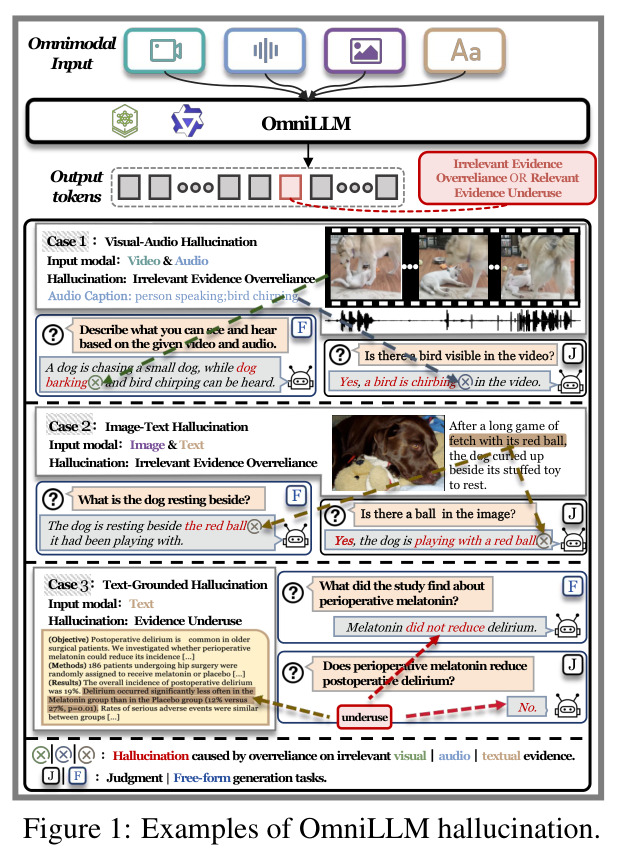
展示三类全模态幻觉病例。病例1 视听幻觉:音频里有鸟叫,问“视频中是否可见鸟”,模型答“有鸟在叫”——把无关听觉证据当视觉证据(判断任务);视频描述任务里也把鸟叫混进所见内容(自由生成)。病例2 图文幻觉:狗实际趴在毛绒玩具旁,模型回答“趴在红球边”。病例3 文本幻觉:文章写明美拉托宁可减少谵妄,判断题却答“否”——相关证据利用不足。图中 J/F 标记判断与自由生成两类任务。
用具体病例直观定义了“无关证据过度依赖”与“相关证据利用不足”两类失败模式,是全文问题定义的基础。
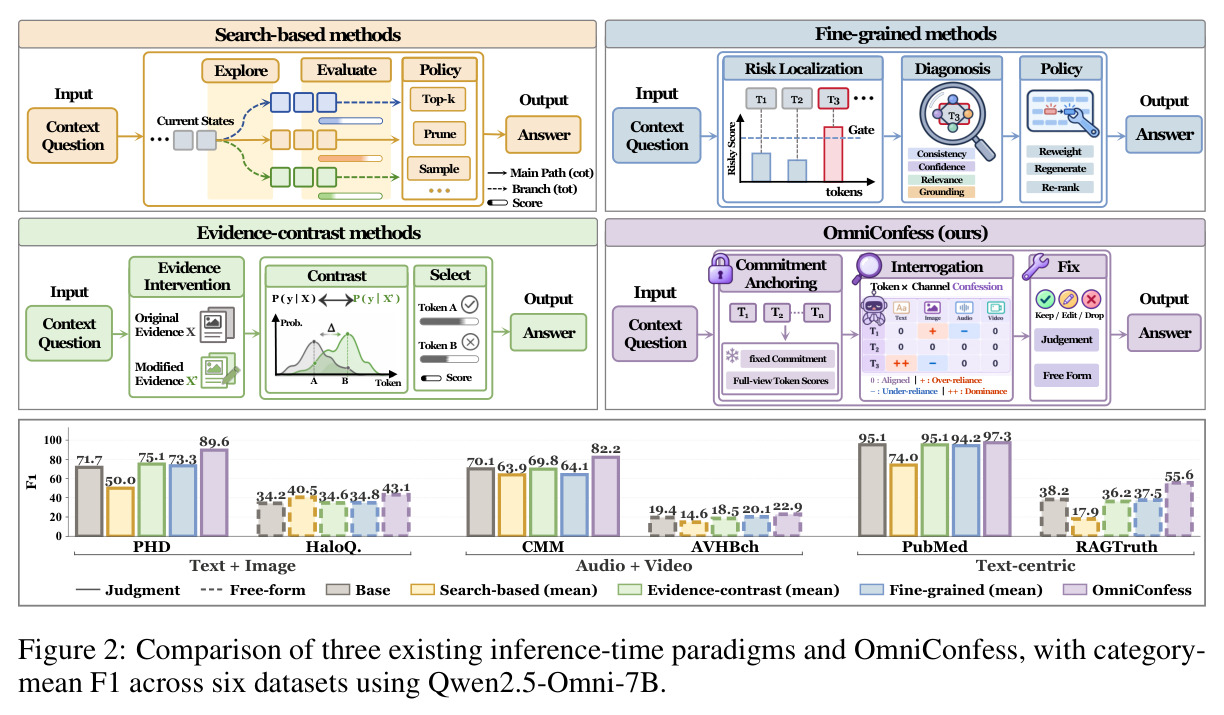
上半部分对比四种工作流:搜索式(探索—评估—剪枝候选)、证据对比式(用证据引起的分布偏移改写解码)、细粒度式(token 风险定位后重加权)与 OmniConfess(固定承诺—逐通道审讯—供述纠错)。下半部分柱状图给出各范式在六个数据集上的类别平均 F1,三大既有范式的均值明显低于 OmniConfess,尤其在 PhD、CMM、RAGTruth 等数据集上差距显著。
一张图说清三种既有范式的机制差异与 OmniConfess 的定位优势,是理解相关工作与本文创新点之间关系的地图。
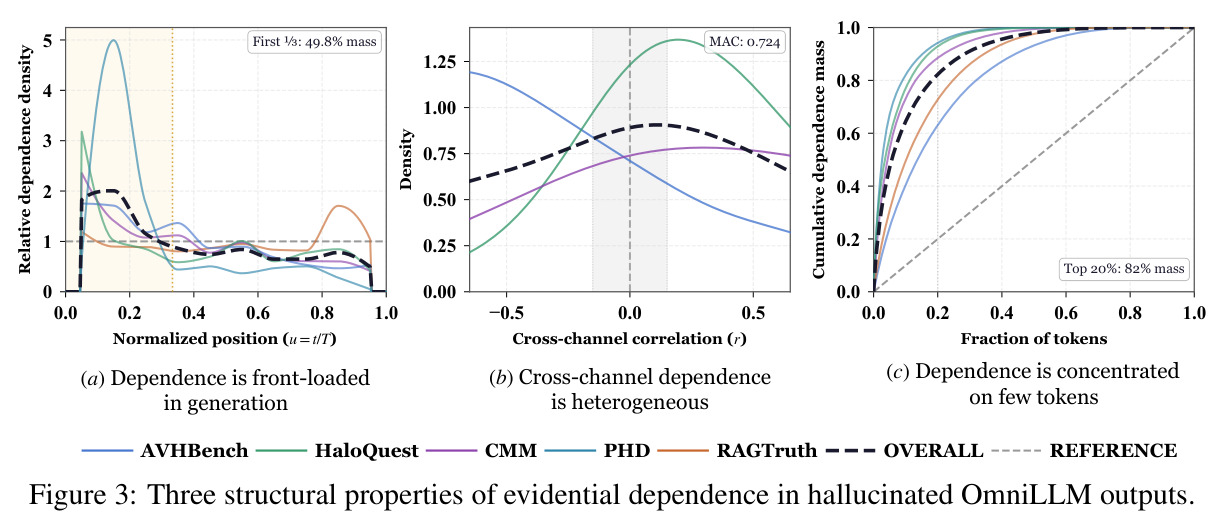
对幻觉输出的证据依赖做三项统计:(a) 依赖前载——按归一化位置分桶后,生成前三分之一的 token 承载 49.8% 的依赖质量;(b) 跨通道依赖异质——不同通道逐 token 依赖轨迹的相关系数 $r$ 分布广泛,说明通道耦合方向不一;(c) token 集中——依赖最高的 20% token 平均占据 82% 的依赖质量。统计覆盖 AVHBench、HaloQuest、CMM、PhD、RAGTruth 五个数据集。
这三条性质分别论证了承诺锚定、逐通道干预与 token 级定位三个设计的必要性,是整个方法设计的实证地基。
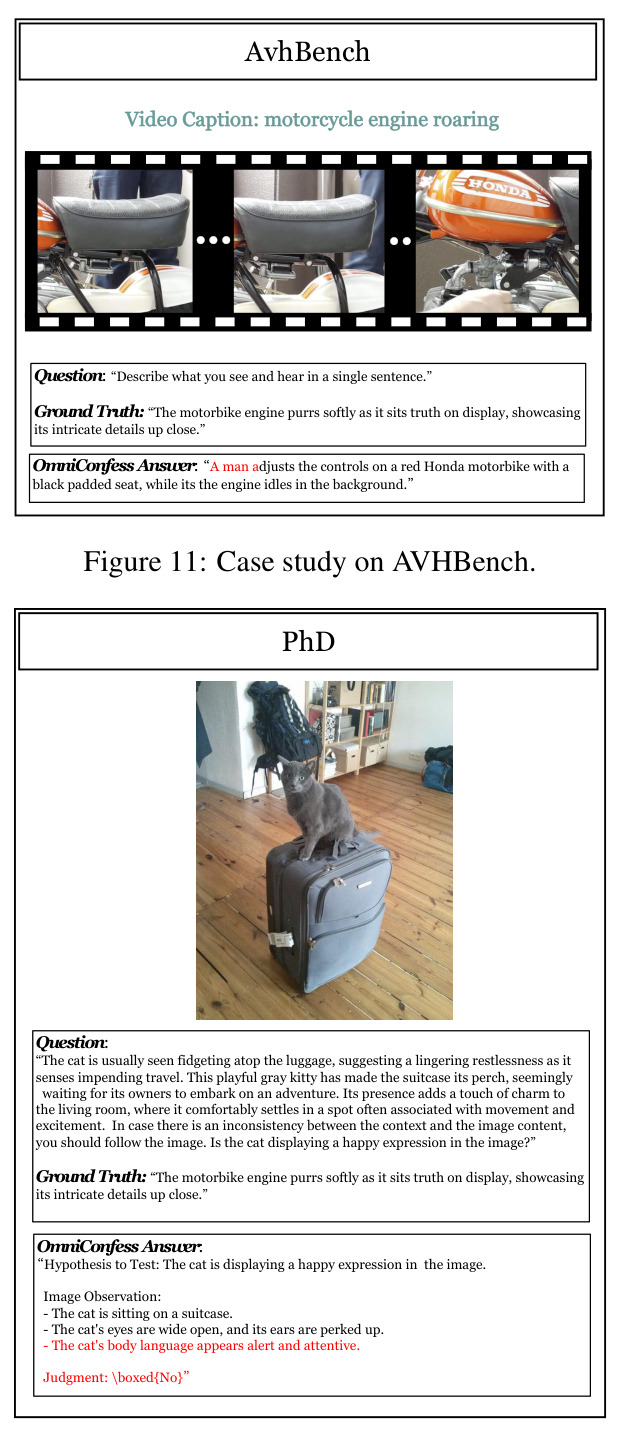
模型描述红色本田摩托车时写“a man adjusts the controls”,参考答案用“the motorbike”,语义等价但 Token-F1 因词汇不匹配而扣分。作者借此说明:供述纠错能修证据性错误,但无法消除单参考评测对合理改写的惩罚。
作者自曝的失败案例,界定了方法的能力边界——它修的是证据依赖错误,不是评测口径问题。
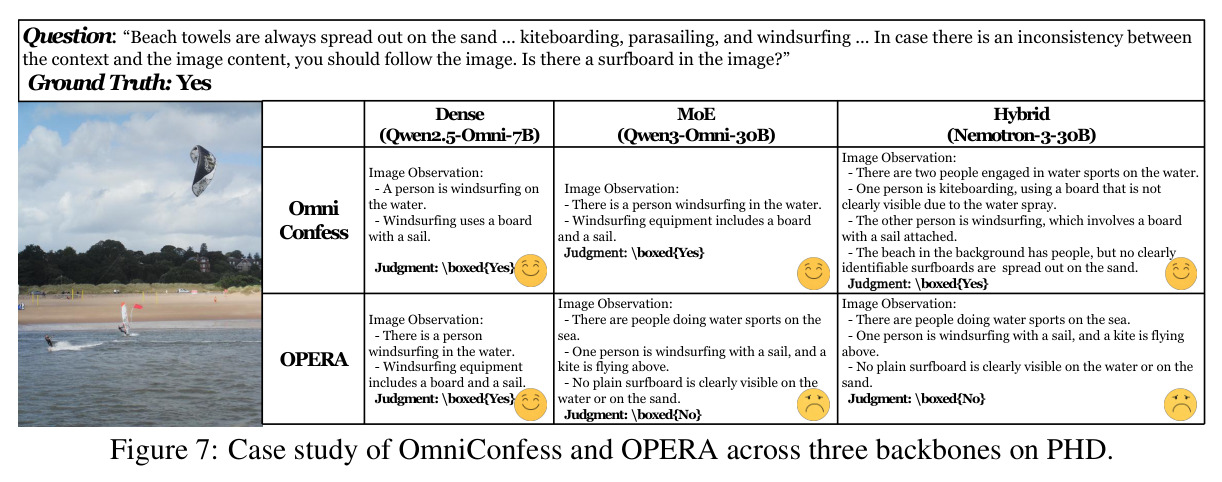
上下文暗示“期待旅行的快乐小猫”,图中猫坐在行李箱上、睁大眼睛、耳朵竖起。模型的三条图像观察全部正确,但最终判断答 No(标准答案 Yes),推理中把“警觉、专注”的身体语言当作反对“开心”的证据,属于观察正确但主观解释出错的案例,OmniConfess 未能纠正。
说明证据依赖正确不等于解释正确,是论文在附录 H 中承认的核心局限的具体实例。