SpecMRL:在参数谱空间中重设计套娃表征学习 SpecMRL: Redesign Matryoshka Representation Learning within Parametric Spectrum
用可学习参数的有序谱基取代固定坐标前缀做嵌套读出,一半维度即超越全维 MRL。
前置知识
Matryoshka Representation Learning (MRL, 套娃表征学习)
一种让单一编码器输出多种维度嵌入的训练方式:训练时对全维表征 $X$ 的多个前缀 $X_{[:, :m]}$(如 1024/512/256/128/64 维)同时施加损失,加权聚合为 $\mathcal{L}_{MRL}=\sum_{m\in\mathcal{M}} w_m \mathcal{L}(X^{(m)}_{MRL})$。推理时可按需截断任意前缀,用低维嵌入节省存储和检索成本。名字来自俄罗斯套娃:大娃套小娃,前面的维度应包含最关键的信息。
本文的全部工作都是对 MRL 的改造:SpecMRL 只替换前缀读出的坐标系,其余 MRL 流程原封不动。不理解 MRL 的嵌套结构和损失形式,就无法理解“换基”这一改动改的是什么。
对比学习与 InfoNCE 损失
嵌入模型的主流训练范式:让 query 与正例的相似度高于与 batch 内/难负例的相似度。损失形如 $-\log \frac{\exp\,\mathrm{sim}(X,X^+;T)}{\exp\,\mathrm{sim}(X,X^+;T)+\sum_{X^-}\exp\,\mathrm{sim}(X,X^-;T)}$,其中温度 $T$ 控制分布尖锐程度。MRL 与 SpecMRL 都在每个嵌套维度上应用该损失。
SpecMRL 不新增任何损失项,对比损失既是 MRL 也是 SpecMRL 的训练信号;论文中所有实验(含 7 个难负例、温度 0.01)都建立在这一范式上。
Gram 矩阵与特征分解(谱定理)
对实对称矩阵 $A$,谱定理保证存在正交矩阵 $U$ 使 $A=U\Lambda U^\top$,特征值可排序 $\lambda_1\ge\lambda_2\ge\cdots$。Gram 矩阵 $A=WW^\top$ 是半正定的,其特征向量构成一组按“能量/重要性”排序的正交基,前 $m$ 个特征向量张成的子空间在秩-$m$ 近似意义下最优(与 PCA 同源)。
SpecMRL 的核心操作就是对 $W_{\mathrm{Proj}}W_{\mathrm{Proj}}^\top$ 做特征分解得到有序谱基 $U$,用 $U$ 的前 $m$ 列替代坐标基做前缀读出——谱排序正是“重要方向排在前面”的数学来源。
幂迭代与 QR 分解
幂迭代通过反复做 $U\leftarrow \mathrm{QR}(AU)$(正交化后的子空间迭代)让 $U$ 收敛到 $A$ 的主特征子空间,避免直接调用昂贵的特征分解求解器;QR 分解(Householder, 1958)把矩阵分解为正交因子,保证基的正交性。热启动(用上一步结果初始化)可让每步只需一次迭代就跟踪缓变的谱。
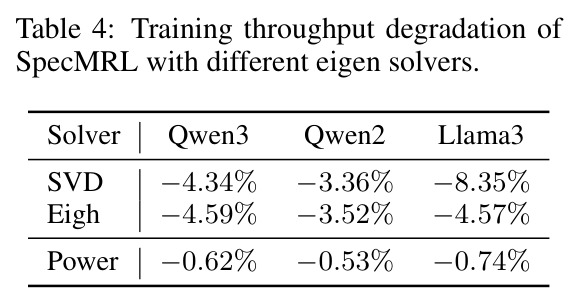
直接用 torch.linalg.svd/eigh 求谱基既慢(吞吐降 3%~8%)又在特征值间隙消失时梯度数值爆炸。SpecMRL 用热启动幂迭代解决这两个问题,这是方法能实用化的关键工程创新。
嵌入空间的各向同性 (isotropy)
理想嵌入集合在方向上应近似均匀分布(各向同性),能量沿重要方向平滑衰减;若能量集中于少数方向(各向异性),相似度计算会被无关主方向主导。论文用谱带能量占比 $E_b$ 度量各带的投影能量份额,尾部谱带异常集中即意味着各向异性被破坏。
SpecMRL 尾部谱带承载 21.72% 能量导致的性能下降、以及谱重排为何能提升低维读出,都需要用各向同性/各向异性的语言来理解。
MTEB 基准
Massive Text Embedding Benchmark,文本嵌入的标准评测集,含 56 个数据集、7 类任务:语义文本相似度(STS)、分类、聚类、配对分类、重排、检索、摘要,各任务用 Spearman/Accuracy/V-measure/AP/MAP/nDCG@10 等指标,报告平均分。
论文所有定量结论(如 16× 压缩下 +3.80 分、半维超全维)都是在 MTEB 上测的,理解任务构成才能看出增益主要来自检索/重排等对几何敏感的任务。
研究动机
标准 MRL(Kusupati et al., 2022)通过联合优化嵌套前缀,让一个编码器同时输出多种维度的嵌入,被广泛用于降低检索与存储成本。但它的嵌套读出只是简单截取全维表征 $X$ 的前 $m$ 维 $X_{[:, :m]}$,训练目标中没有任何显式约束保证“信息量最大的方向恰好排在前面的维度”——维度顺序完全由训练动力学偶然决定,而嵌入空间本身往往各向异性、语义信息在固定坐标轴上分布混乱。后果在激进压缩时非常明显:Qwen3-0.6B 在 MTEB 上 1024 维平均 60.97 分,压到 64 维(16×压缩)只剩 54.73 分,掉了 6 分以上,其中检索从 49.02 跌到 34.38。此前的改进路线(ESE 的 learn-to-compress、MIPIC 的自蒸馏跨维对齐)试图用额外监督修补低维读出,但都保持原始坐标系不动;如果坐标系本身就不适合前缀截断,加再多监督也只是治标不治本。
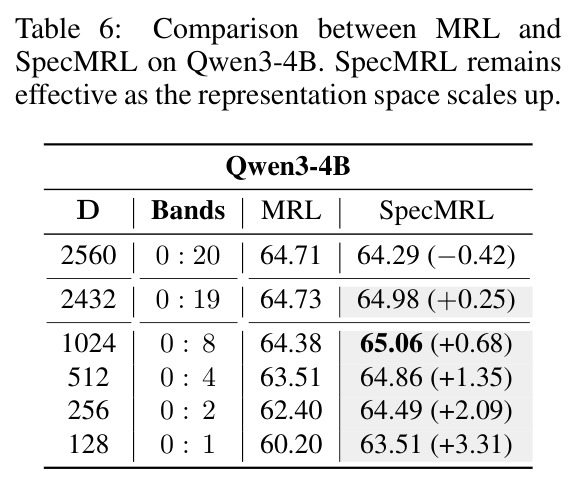
本文的目标是本文的目标是重新组织表征空间的坐标系,让“信息按重要性有序排列”成为表征空间的内建性质,使简单的前 $m$ 维截断天然等价于保留最重要的 $m$ 个方向,把 MRL 隐含的“重要特征应占据前面维度”先验从口号变成显式结构。同时要求方法保持 MRL 的全部工程优点:不新增损失项、不改变训练流程、无新超参、可 drop-in 替换;推理开销可忽略甚至更快(半维检索最高 1.86× 提速);并且能扩展到更大骨干(Qwen3-4B)与更长训练(15K 步过训练),在实现层面还要解决特征分解的算力开销与特征向量梯度的数值不稳定两大障碍。
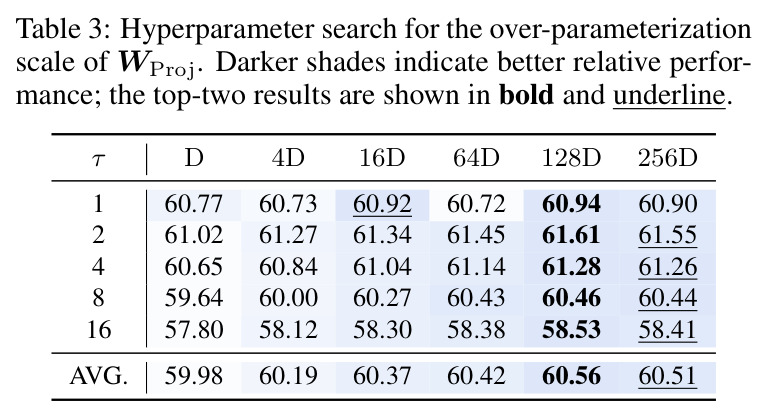
与已有工作不同的是,本文的独特切入是“换基”而非“加损失”。已有方法都在原坐标系上做加法:ESE 用 PCA 压缩目标监督低维前缀,MIPIC 用 KL+CKA 对齐跨维度的 token 关系,MIC 用几何正则减少前缀与残差的冗余,AdaWidth 虽学习正交旋转但不带谱排序。SpecMRL 的观察是:前缀读出的“读出基”本身就应该被设计。作者从参数空间视角出发——$W_{\mathrm{Proj}}$ 的列向量可视为一组缓存的嵌入,其 Gram 矩阵的谱结构编码了嵌入空间的几何——于是用参数导出的有序谱基 $\{u_i\}$(按 $\lambda_1\ge\lambda_2\ge\cdots$ 排序)替代固定坐标基 $\{e_i\}$,MRL 随后在谱空间里照常进行。消融还揭示过参数化($R=128D$)本身带来额外增益,说明参数谱不仅提供排序,还隐式扩张了表征容量,这是此前 MRL 文献未曾触及的角度。
核心方法
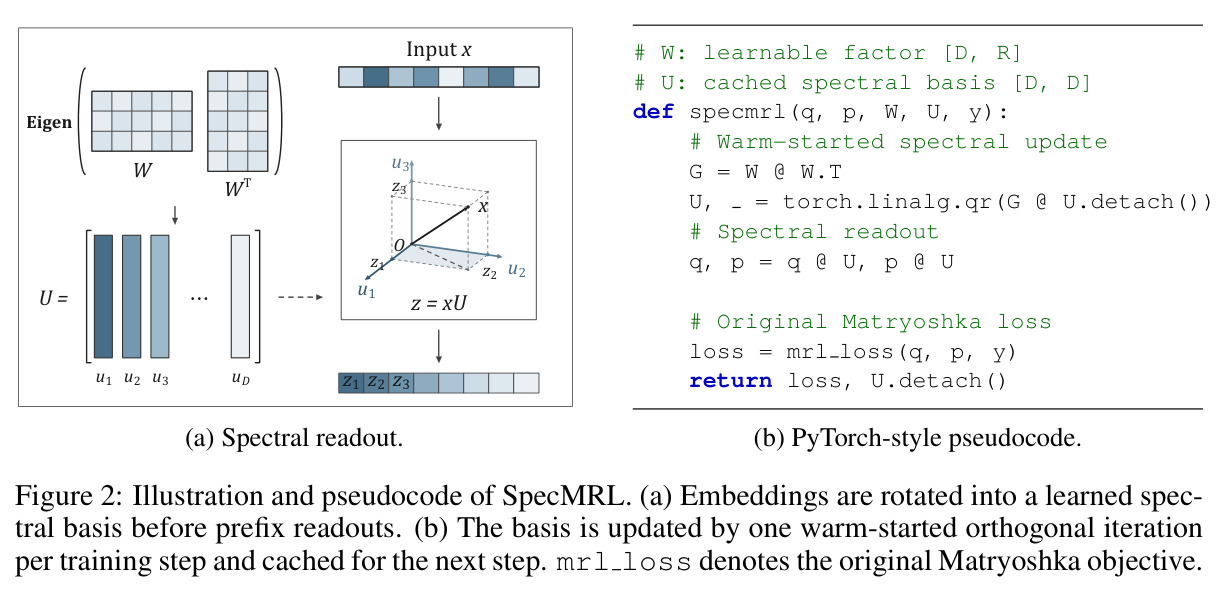
直觉上,俄罗斯套娃的隐喻要求最重要的信息放在最外层(最前面的维度),但标准 MRL 从不检查这一点:前缀读出在原始坐标基 $\{e_i\}$ 下进行,哪个方向排在前面全看训练碰巧学成什么样。SpecMRL 的思路是先显式构造一个按重要性排序的正交基,再做 MRL。技术上:引入可学习矩阵 $W_{\mathrm{Proj}}\in\mathbb{R}^{D\times R}$(实践中 $R=128D$ 过参数化),训练中维护其 Gram 矩阵的有序谱基 $U=\mathrm{Eigen}(W_{\mathrm{Proj}}W_{\mathrm{Proj}}^\top)$,$\lambda_1\ge\lambda_2\ge\cdots\ge\lambda_D\ge 0$;对骨干嵌入 $X\in\mathbb{R}^D$,嵌套读出改为谱前缀 $X^{(m)}_{\mathrm{Spec}}=XU_{[:,1:m]}$;损失仍是 MRL 的加权对比损失 $\mathcal{L}_{\mathrm{Spec}}=\sum_{m\in\mathcal{M}} w_m\,\mathcal{L}\big(X^{(m)}_{\mathrm{Spec}}\big)$,不加新损失项。实现上用热启动幂迭代 $U^{(t)}=\mathrm{QR}\big(W^{(t)}_{\mathrm{Proj}}W_{\mathrm{Proj}}^{(t)\top}U^{(t-1)}\big)$ 代替 SVD/Eigh:每步一次矩阵乘加一次 QR,梯度经 Gram 与 QR 传播、旧基 detach;训练结束后基固定,推理只多一次 $D\times D$ 投影。
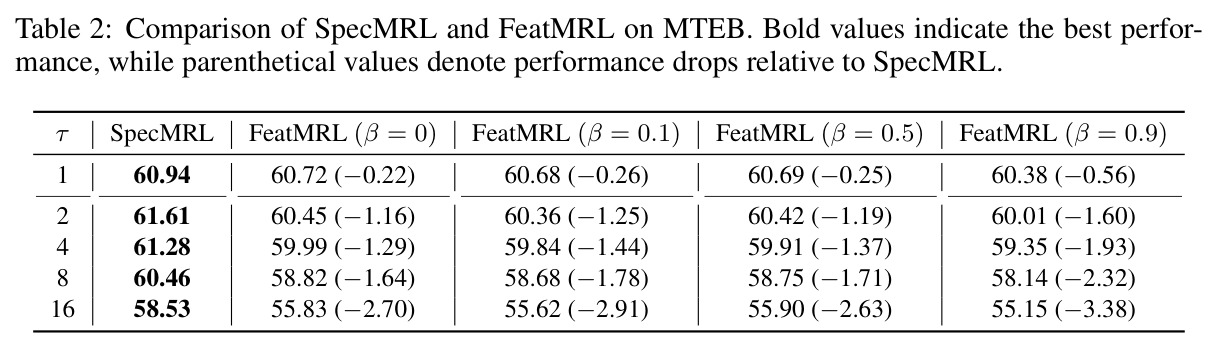
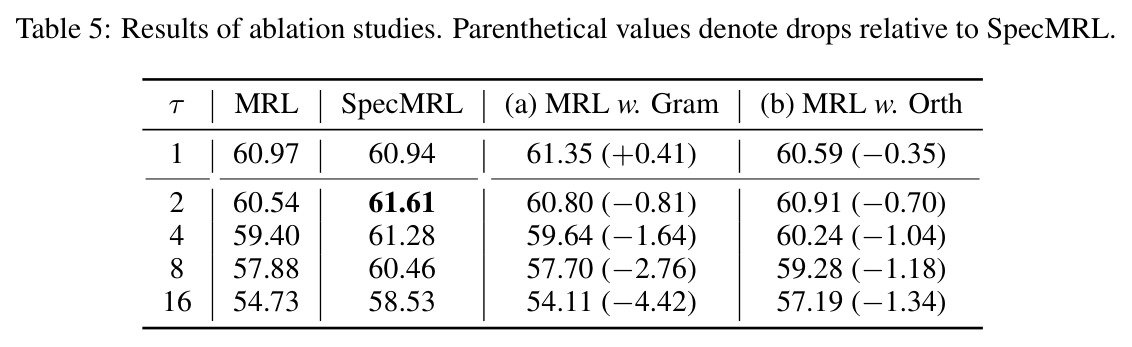
核心创新是把 MRL 的“维度排序”从隐式先验升级为显式的可学习谱组织,与已有方法的本质区别有三点。第一,与 ESE/MIPIC 等跨维度监督路线不同,SpecMRL 不增加任何辅助损失,只改读出基——损失函数、嵌套维度集合 $\mathcal{M}$、权重 $w_m$ 全部不变,因此是无新增超参的 drop-in 改造。第二,谱基来自学到的参数 $W_{\mathrm{Proj}}$ 而非特征统计:对照方案 FeatMRL 直接从当前 batch 特征的 Gram 矩阵 $X^\top X$ 求谱基(并测试了动量平滑 $M^{(t)}=\beta M^{(t-1)}+(1-\beta)X^\top X$),结果在所有维度上都低于 SpecMRL($\tau=16$ 时低 2.70~3.38 分),说明“学习到的参数结构”比“当批特征统计”更能编码稳定的重要性排序。第三,特征分解同时提供“正交”与“有序”两种性质,消融拆解(Table 5)证明二者各有贡献但排序是关键:MRL w. Orth(只保留可学习正交)优于 MRL 但仍显著差于完整 SpecMRL,而 MRL w. Gram(保留 $W_{\mathrm{Proj}}$ 但完全不做谱分解)在 $\tau=16$ 时比 SpecMRL 低 4.42 分。
方法步骤详情
流程分五步。(1) 初始化:$W_{\mathrm{Proj}}\in\mathbb{R}^{D\times R}$ 各元素从 $\mathcal{N}(0,0.02^2)$ 采样,对其 Gram 矩阵做一次特征分解得到初始谱基 $U^{(0)}$。(2) 每个训练步:计算 $A^{(t)}=W^{(t)}_{\mathrm{Proj}}W_{\mathrm{Proj}}^{(t)\top}$,执行一次热启动正交迭代 $U^{(t)}=\mathrm{QR}(A^{(t)}U^{(t-1)})$,旧基 detach、梯度只经 $A^{(t)}$ 与 QR 回传,从而绕开特征向量梯度 $\partial u_i/\partial A=\sum_{j\neq i}\frac{u_ju_j^\top \Delta A\,u_i}{\lambda_i-\lambda_j}$ 在特征值间隙消失时的数值爆炸。(3) 谱读出:query/正例嵌入 $q,p$ 先旋转进谱空间,再取前 $m$ 列得 $X^{(m)}_{\mathrm{Spec}}=XU_{[:,1:m]}$。(4) 计算标准 MRL 加权对比损失并联合训练骨干与 $W_{\mathrm{Proj}}$。主实验配置:KaLM 数据 115.2 万样本(全量约 1/5),每条 1 个 query + 1 正例 + 7 难负例,全局 batch 384(4 卡 + GradCache),长度 512,AdamW 学习率 $10^{-4}$、温度 0.01;骨干为 Qwen3-0.6B/Qwen2-0.5B/Llama-3.2-1B/Qwen3-4B。(5) 推理:从最终 checkpoint 的 Gram 矩阵再做一次 FP32 正交迭代固定基 $U$,之后每个嵌入仅多做一次 $D\times D$ 投影。
技术新颖性
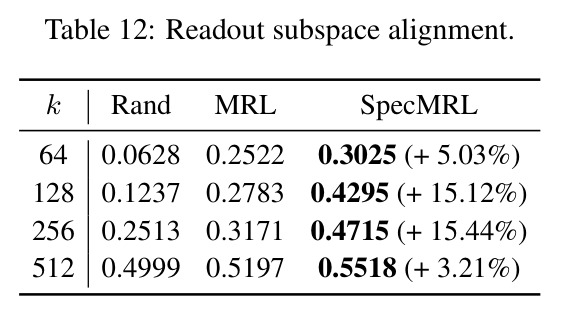
技术新颖性体现在四个层面。(1) 视角新颖:首次把“读出基本身”当作 MRL 的学习/设计对象,指出固定坐标前缀这一默认选择才是低维性能差的根源,而非监督不足——与在损失端加约束的主流路线形成方法论对照。(2) 参数谱构造新颖:用 $W_{\mathrm{Proj}}$ 的 Gram 谱作为特征重要性来源,并用主角度重叠给出参数—几何对应的经验证据(Appendix C):以 $10^6$ 校准句嵌入的 PCA 主子空间为参照,SpecMRL 读出子空间重叠度在 $k=128$ 时 0.4295 对 MRL 的 0.2783(+15.12%),$k=256$ 时 0.4715 对 0.3171(+15.44%),而随机基线仅为 $k/D$;幂迭代解出的基与精确特征基重叠超过 99.9%。(3) 工程实现新颖:热启动幂迭代每步仅约 $F_{\mathrm{extra}}\approx 2RD^2+\frac{3}{2}D^3+2B_{\mathrm{proj}}D^2$ FLOPs(相对骨干 <1%),吞吐损失 0.53%~0.74%,远小于 SVD 的 3.36%~8.35%,思路与 Dion、SOAP 等优化器中用正交迭代省分解一脉相承,但用于训练中的谱基维护是新的。(4) 过参数化设计($R=128D$)让 MRL 隐式享受高维容量而不付高维推理成本,呼应 SimCLR 投影头的过参数化观察,但在 MRL 语境下属首次。
实验结果
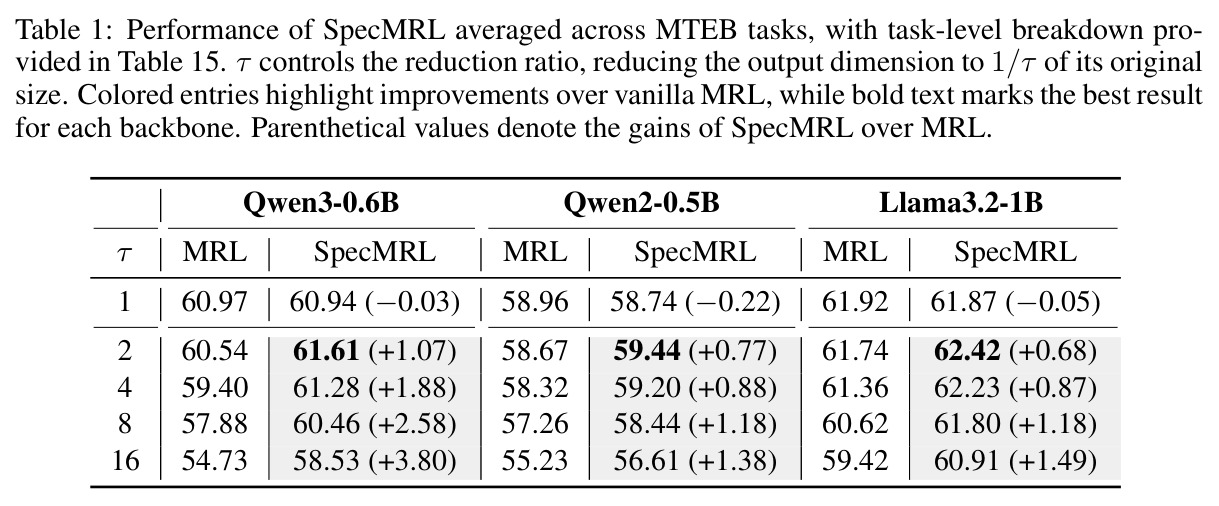
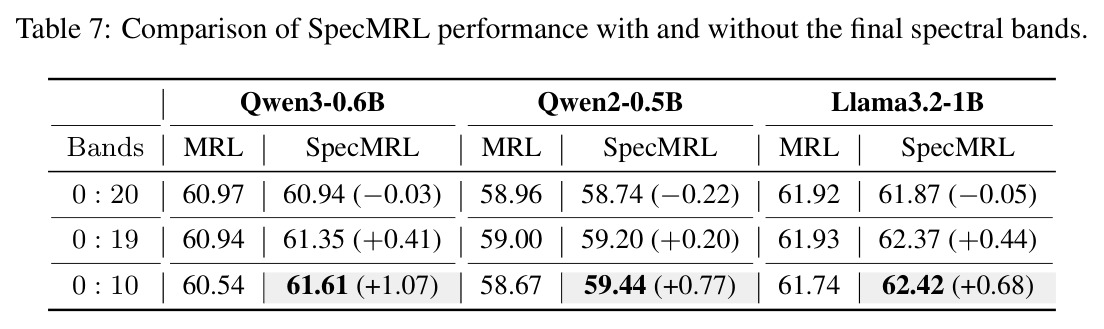
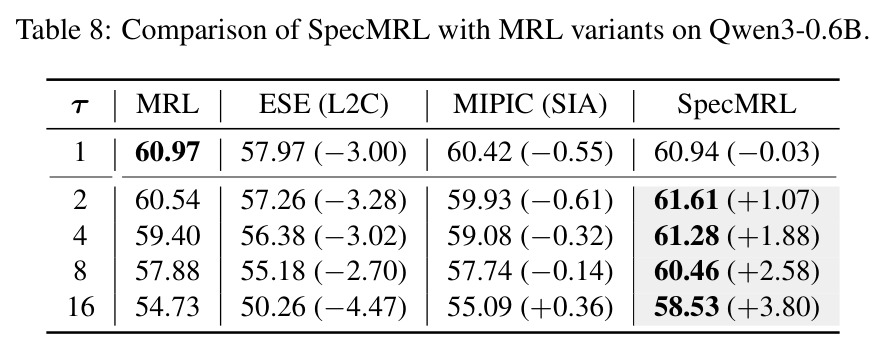
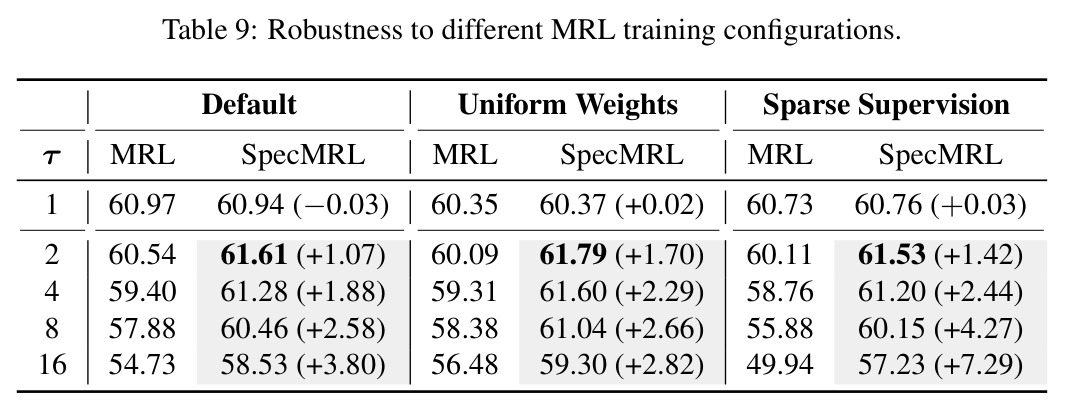
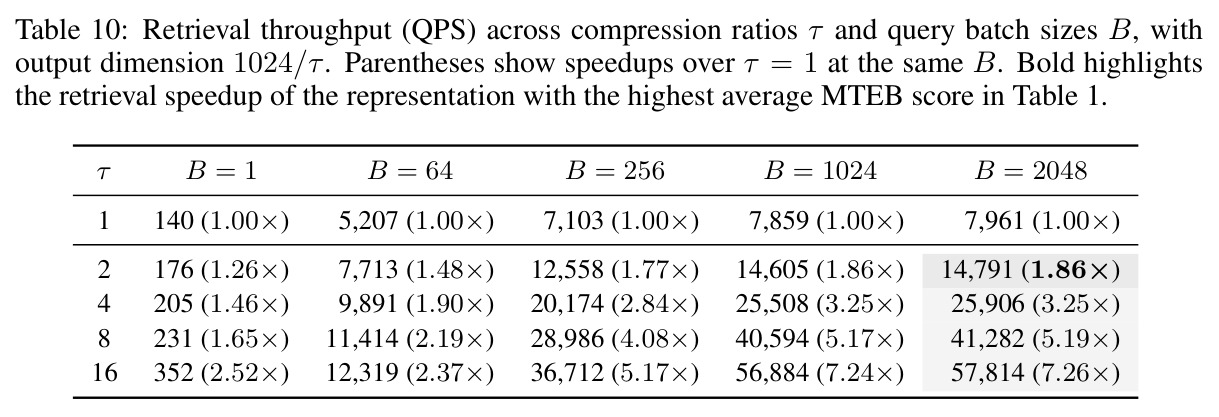
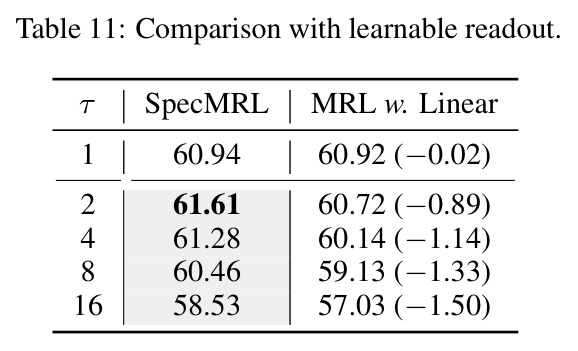
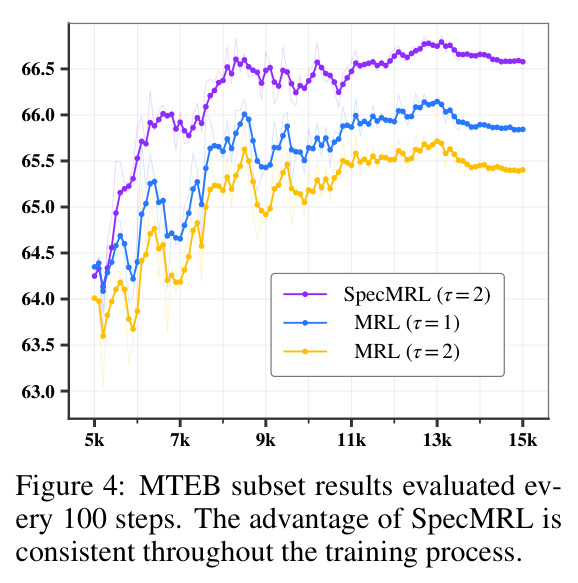
核心结果有五点。(1) 主实验(Table 1,MTEB 56 数据集平均):SpecMRL 在所有压缩率下超过 MRL 且压缩越狠增益越大。Qwen3-0.6B:$\tau=2/4/8/16$ 时分别为 61.61 对 60.54(+1.07)、61.28 对 59.40(+1.88)、60.46 对 57.88(+2.58)、58.53 对 54.73(+3.80,64 维);Qwen2-0.5B 为 +0.77/+0.88/+1.18/+1.38,Llama3.2-1B 为 +0.68/+0.87/+1.18/+1.49;全维($\tau=1$)双方打平(差不超过 0.22)。(2) 性能前沿:半维 SpecMRL 超全维 MRL——Qwen3 512 维 61.61 > 1024 维 60.97,Qwen2 59.44 > 58.96,Llama 62.42 > 61.92;增益集中在几何敏感任务(Qwen3 $\tau=16$:PairClass +8.56、Retrieval +6.41、Rerank +5.55)。(3) 消融与基线(Table 5/8/11):MRL w. Gram 在 $\tau=16$ 低 4.42 分、MRL w. Orth 低 1.34 分、可学习线性读出低 1.50 分;$\tau=16$ 时 MIPIC(SIA) 55.09、ESE(L2C) 50.26 均不敌 SpecMRL 的 58.53。(4) 规模扩展(Table 6/17):Qwen3-4B 上 128 维增益 +3.31;15K 步过训练下 SpecMRL $\tau=2$ 达 63.88,仍高于全维 MRL 的 63.54,证明优势来自更高天花板而非更快收敛。(5) 效率(Table 4/9/10):幂迭代吞吐仅降 0.53%~0.74%(SVD 为 3.36%~8.35%),编码开销 +0.36%,512 维检索最高 1.86× 提速(14,605 QPS 对 7,859);稀疏监督下(去掉 128/64 维损失)$\tau=16$ 优势扩大到 +7.29(57.23 对 49.94),说明低维信息不再依赖逐前缀直接监督。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MTEB 平均(Qwen3-0.6B,16×压缩,64 维) | 56 数据集平均分 | SpecMRL 58.53 | MRL 54.73 | +3.80 |
| MTEB 平均(Qwen3-0.6B,半维 512 维 vs 全维 1024 维) | 56 数据集平均分 | SpecMRL@512 维 61.61 | MRL@1024 维 60.97 | +0.64,用一半维度超过全维 MRL |
| MTEB 平均(Qwen3-4B,128 维) | 平均分 | SpecMRL 63.51 | MRL 60.20 | +3.31 |
| MTEB 平均(Llama3.2-1B,64 维) | 平均分 | SpecMRL 60.91 | MRL 59.42 | +1.49 |
| 与 MRL 改进方法对比(Qwen3-0.6B,64 维) | MTEB 平均分 | SpecMRL 58.53 | MIPIC(SIA) 55.09;ESE(L2C) 50.26 | +3.44 / +8.27 |
| 训练吞吐(相对 MRL,Qwen3/Qwen2/Llama3) | 吞吐变化率 | 幂迭代:-0.62% / -0.53% / -0.74% | SVD:-4.34% / -3.36% / -8.35%;Eigh:-4.59% / -3.52% / -4.57% | 额外开销降低约 3~8 个百分点 |
| MS MARCO 向量检索(512 维,batch=1024,FAISS GPU 精确检索) | QPS | 14,605(1.86×) | 全维 1024:7,859(1.00×) | 1.86× 提速且 MTEB 精度更高 |
局限与改进
作者承认的局限:(1) 全维($\tau=1$)时有轻微退化(最多 -0.22 分),谱重组对原坐标系的全维读出有轻微扰动;(2) 尾部谱带异常——Figure 3 显示保留最后几个谱带时性能意外下降,Table 7 显示只裁掉最后 1/20 个谱带(0:19)反而让全维也反超 MRL(+0.41/+0.20/+0.44),Appendix D 发现最后 5% 的谱方向承载了 21.72% 的投影能量,各向异性增强,但成因尚不明确,目前的处理是经验性裁带;(3) 过参数化收益递减(Table 3:AVG 从 $R=D$ 的 59.98 升到 128D 的 60.56 后,256D 回落至 60.51);(4) 实验限于英文 MTEB 和不超过 4B 的骨干,多语种、多模态未验证。我自己的观察:(1) 推理时多一次 $D\times D$ 稠密投影,在 CPU 或量化部署场景可能不可忽略,论文只测了 A100 GPU;(2) 谱基与骨干联合训练,无法直接用于冻结模型/API 嵌入,而 AdaWidth、Matryoshka-Adaptor 等适配场景未被覆盖或对比;(3) 幂迭代每步的 $O(D^3)$ QR 与 $O(RD^2)$ Gram 构造在更大 $D$ 下会持续增长(作者只验证到 D=2560);(4) 训练数据为单一对比数据集(1 正 7 负构造),指令检索、长文本、跨语言检索等场景的稳健性未知。
独立分析的弱点
弱点 1:尾部谱带能量集中(21.72%)是方法内生的不稳定源,目前靠裁掉最后谱带规避——改进方向是把带能量写入训练目标(如惩罚尾部带投影能量 $\sum_{j\in B_{\mathrm{tail}}} z_j^2$ 或鼓励带能量平滑衰减),让裁带从后处理变成可学习的软约束。弱点 2:Gram 构造 $O(RD^2)$ 与 QR $O(D^3)$ 在超大 $D$ 下占比上升且作者未测 D>2560 的场景——改进方向是只对前 $m$ 个所需特征方向做部分子空间迭代(block power iteration),把复杂度降到 $O(D^2 m)$。弱点 3:谱基编码的是训练集上的全局重要性排序,对单个 query/任务没有自适应能力,而检索中不同 query 的最优子空间可能不同——改进方向是在谱基上引入 AdaWidth 式的按 query 带选择,做“谱基 + 自适应宽度”的组合。弱点 4:FeatMRL 全面落败的原因未被深挖(是 batch 统计噪声,还是“参数 vs 特征”的本质差异?)——改进方向是用全数据集协方差或 EMA 大批量重做特征谱基消融,厘清结论边界。弱点 5:理论解释薄弱,“为什么参数谱优于特征谱”“为什么尾部带会吸能”都只有经验观察——改进方向是从损失景观或核方法角度给出谱读出的优化几何分析。
未来方向
作者提出的方向:(1) 在更大算力预算下验证可扩展性——15K 步过训练已显示更高天花板(63.88),更大骨干与更长训练值得继续;(2) 尾部谱带的异常能量集中现象值得专门研究,作者希望这能催生更有原则的嵌入训练设计;(3) 把“读出空间作为学习目标”的视角推广到更一般的嵌套表征设计。基于本文成果可延伸的方向:(1) SpecMRL 与 ESE/MIPIC 的辅助监督正交(一个换基、一个加损失),“谱基 + 跨维度监督”的组合可能叠加增益;(2) 扩展到多模态嵌入(CLIP/SigLIP 的跨模态对齐空间)与推荐检索场景;(3) 与量化(INT8/二值嵌入)结合,研究谱基排序对量化误差分布的影响;(4) 为冻结模型设计谱适配器(Matryoshka-Adaptor + 谱重排),服务只能调用 API 嵌入的用户;(5) 从理论上把嵌套损失权重 $w_m$ 与谱截断误差联系起来,导出最优权重的设计原则;(6) 探索谱之外的有序读出结构,如可学习的分层或树状基。
复现评估
复现条件总体友好。开源情况:代码已在 GitHub 公开(github.com/CentreChen/spec-mrl),ESE/MIPIC 的适配实现也在仓库中。数据:公开的 KaLM-embedding-finetuning-data(HuggingFace),主实验用 115.2 万样本子集(全量约 1/5),评测为标准英文 MTEB(56 数据集);训练配置在 Table 13 完整列出(各骨干的嵌套维度与损失权重,如 Qwen3-0.6B 为 1024/512/256/128/64,权重 1.0/0.3/0.2/0.1/0.1)。算力需求:0.5B~1B 骨干 + 115 万样本 + 3K 步,单节点 4 卡(全局 batch 384、GradCache、A100 级别)即可复现主实验;4B 骨干与 15K 步过训练需要更多资源;检索测速用的是单张 A100 PCIe 40GB + FAISS GpuIndexFlatIP FP32。实现难度中等偏低:核心改动即 Figure 2(b) 的约 10 行伪代码(Gram 矩阵 + 一次热启动 QR + 谱读出),主要风险点是数值细节——FP32 做正交迭代、旧基 detach、初始化时的一次谱分解,以及 MTEB 全量评测的工程量;附录 A/E 提供了足够的超参与复杂度分析。
论文图表
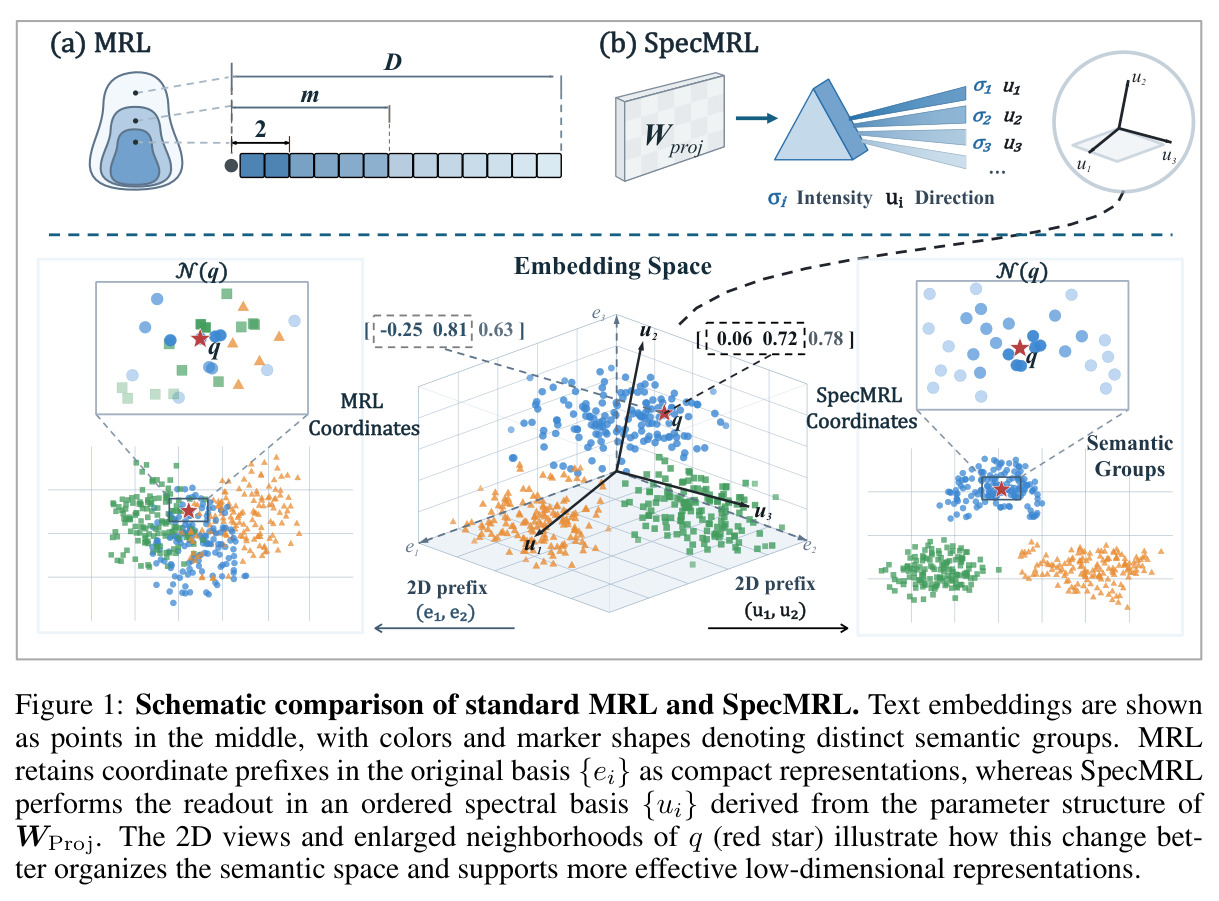
示意图对比标准 MRL 与 SpecMRL:文本嵌入显示为中间的点云,颜色与形状标记不同语义组。MRL 在原始坐标基 $\{e_i\}$ 下直接截取坐标前缀作为紧凑表征;SpecMRL 则在由 $W_{\mathrm{Proj}}$ 参数结构导出的有序谱基 $\{u_i\}$(带 $\sigma_i$ 强度和方向标注)下做读出。下半部分展示 query $q$ 的 2D 前缀视图 $(e_1,e_2)$ 对 $(u_1,u_2)$ 及其放大邻域:谱基下语义组分离更清晰。
这是全文的核心直觉图:一眼看懂“换基”是什么、为什么谱前缀比坐标前缀更保语义,适合放在动机部分引入问题。
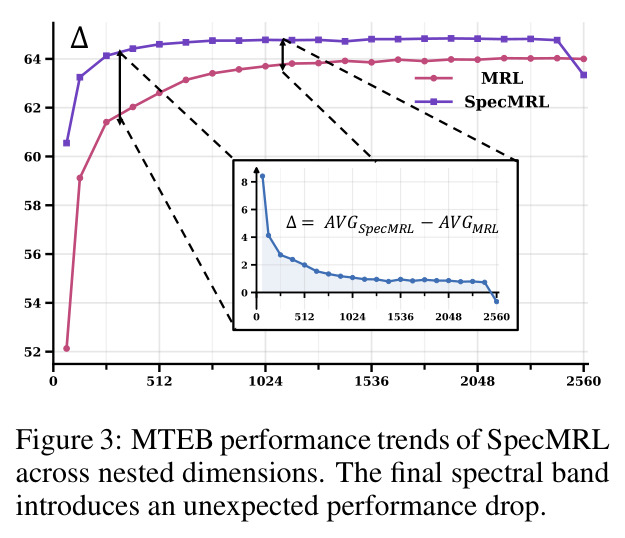
Qwen3-4B(D=2560)上把谱分为 20 个带、按不同保留范围细粒度扫描的 MTEB 趋势:随保留维度增大性能总体上升,谱基在训练未见过的维度上依然稳定有效;但保留最后一个谱带(最小特征值方向)时出现意外的性能下降,图中以 $\Delta=\mathrm{AVG}_{\mathrm{SpecMRL}}-\mathrm{AVG}_{\mathrm{MRL}}$ 标注增益。
揭示了方法最重要的异常现象(尾部谱带吸能导致退化),直接催生了“裁掉最后谱带”的实践和 Appendix D 的能量分析。
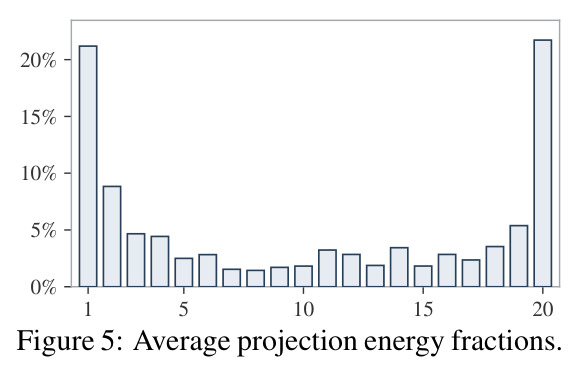
把谱分为 20 个带后,在 100 万条 MS MARCO 校准嵌入上统计各带平均投影能量占比:最后一个带仅占 5% 的谱方向却承载 21.72% 的能量,偏离了“能量沿有序谱带平滑衰减”的理想各向同性形态。
为尾部谱带性能异常提供了定量解释(各向异性被破坏),是理解 SpecMRL 失效模式与裁带实践的核心分析图。