用可训练前缀令牌减少检索嵌入中的表示干扰 Reducing Representational Interference in Retrieval Embeddings with Trainable Prefix Tokens
在输入前拼接可训练[DUMP]令牌吸收非语义噪声,不改架构即可提升检索嵌入质量
前置知识
密集检索(Dense Retrieval)
将查询和文档分别编码为固定维度的向量,通过内积或余弦相似度进行语义匹配的检索范式。与 BM25 等稀疏检索不同,它能捕捉同义改写等语义关系,是 RAG 系统的核心组件。模型通常用对比学习微调:让正例(查询,相关段落)的嵌入互相靠近,负例的嵌入互相远离。
本文全部实验都在该范式上进行,方法价值也以检索指标 nDCG@10 衡量,理解评估方式是读懂结果的前提。
池化策略(Pooling)
把变长序列的多个 token 级隐状态压缩成单个句向量的操作,常见有 [CLS] 池化(取首 token)、mean 池化(取平均)和 last-token 池化(解码器常用)。这一压缩形成信息瓶颈:token 级的噪声信号也会在此过程中被一并压进最终向量。
表示干扰正是在池化时混入最终向量,本文方法声称池化策略完全不变,只改变编码阶段的注意力分布。
注意力汇聚(Attention Sink)
Transformer 中的一种现象:由于 softmax 强制分配注意力,某些位置(通常是序列开头的特殊 token)即使几乎不携带语义,也会吸引不成比例的巨大注意力,并伴随异常高的激活范数(massive activations)。它有助于自回归生成稳定,但会让非语义信息渗入嵌入表示。
这是本文问题陈述的理论起点,[DUMP] 令牌正是要为这类汇聚注意力提供一个新的、专门的存放位置。
InfoNCE 对比损失
检索微调的标准目标:对查询 $q_i$ 及其正例段落 $p_i^+$ 和若干负例,计算缩放相似度 $s(q,p)=\cos(e_q,e_p)/\tau$,再用交叉熵形式拉近正例、推远负例。负例通常取 batch 内其他样本(in-batch negatives)或挖掘的难负例(hard negatives)。
本文不引入任何辅助损失,[DUMP] 令牌的梯度完全来自这一标准检索损失,这是其『即插即用』主张的关键。
寄存器令牌(Register Tokens)
Darcet 等人在 Vision Transformer 中引入的额外可学习 token:它们不对应任何输入图像块,却能在自注意力中吸收高范数离群信息,显著清理特征图中的伪影。这是『给噪声一个专门存放位置』这一思想的来源。
本文把该思想从视觉迁移到检索嵌入训练,是理解其切入角度与相关工作定位的直接参照。
研究动机
嵌入模型必须把变长文本压缩成单个固定维度向量,这一压缩瓶颈本身就是噪声的入口。在编码阶段,token 级信息并非全部服务于语义匹配:循环出现的位置模式、特殊 token 伪影,以及注意力汇聚(attention sink)导致的高范数激活,都会沿着自注意力扩散到内容 token 中,最终被 [CLS] 或 last-token 池化一并压进检索向量。论文指出,当这些非语义信号累积时,会系统性地稀释嵌入的判别力——例如在 BEIR 难负例版本上,多个 100M 级模型在 Natural Questions 上的 nDCG@10 只有 0.38 左右,ettin-decoder-150m 的平均分仅 0.4377。而标准的对比学习微调只在整条向量层面优化查询—段落对齐,对池化之前 token 级信息如何表示和路由完全没有控制力,残差噪声因此被原样保留下来,这是稠密检索优化中长期被忽视的一个缺口。
本文的目标是本文的目标是提供一个即插即用(plug-and-play)的干预手段:在不修改模型架构、不改池化策略、不加辅助损失、不更换检索目标的前提下,减少残差 token 级信息对最终检索表示的污染。具体做法是在输入前拼接少量可训练的 [DUMP] 前缀令牌,让它们在编码过程中充当『语义缓冲区』吸收非语义信号。可衡量的目标是:在编码器与解码器两类架构、标准检索与长上下文检索两类设置下都取得一致的相对提升。最终论文在六个模型上拿到标准基准平均 2.46%、LongEmbed 长文本基准平均 2.41% 的相对改进,同时方法的实现成本几乎为零,只新增几个令牌嵌入作为可训练参数。
与已有工作不同的是,已有工作从三个方向处理压缩瓶颈,但都没碰『编码阶段噪声路由』这个问题:其一是专门化预训练(如 RetroMAE/RetroMAE-2)提升表示空间质量;其二是替换池化方式,如 landmark pooling(LMK>CLS)改变聚合哪些 token;其三是对注意力汇聚现象的分析与缓解(StreamingLLM、SoftPick 等),但主要服务于自回归生成的稳定性。本文的独特之处在于视角转换:不去改变『哪些 token 被聚合』或『损失怎么设计』,而是改变编码过程中非语义注意力的流向。作者从视觉 Transformer 的 register tokens(吸收高范数离群特征)获得直接启发,把『给噪声一个专门的停车位』这一思想首次系统地搬进检索嵌入训练,并且只靠标准对比损失端到端优化,不需要任何额外监督信号。
核心方法
直觉上,这就像在会议室门口修一个杂物间:序列里的无用信号(停用词、位置伪影、汇聚注意力)原本会挤占 [CLS] 等关键位置的注意力预算,现在有了专门的去处。技术上方法极简:向词表加入 $K$ 个可训练令牌(主实验 $K=4$),对查询和段落统一拼接前缀 $\tilde{x}=[\text{DUMP}_1]\cdots[\text{DUMP}_K]\oplus x$,再用完全不变的模型编码 $e_{E_\theta}(x)=\text{pooling}(M_\theta(T(\tilde{x})))$,池化仍作用于默认目标(编码器取 [CLS],解码器取 last token)。训练用标准 InfoNCE:相似度 $s(q,p)=\cos(e_q,e_p)/\tau$,损失 $\mathcal{L}_{\text{NCE}}=-\log\frac{e^{s(q_i,p_i^+)}}{e^{s(q_i,p_i^+)}+\sum_{j=1}^{n}e^{s(q_i,p_{i,j}^-)}}$。训练 110k 样本(100k RLHN 难负例 + 10k MLDR 长文档),1 个 epoch,最大长度 8192,全局 batch 256。
核心创新点是『不改聚合对象,只改注意力几何』。与已有方法的本质区别在于:池化、损失、架构三者全部保持原样,唯一的变量是序列开头多出的几个可训练位置。由于最终池化向量依赖于全序列形成的注意力分布,对比损失的梯度会自然回流到 [DUMP] 令牌的嵌入上,把它们优化成专门的『注意力下水道』——低信息 token 的注意力被重新路由到这些前缀位置,而不是继续灌入 [CLS]。这与 ViT register tokens 有两个关键差异:一是监督信号不同,这里完全由检索对比损失端到端驱动,无任何辅助目标;二是使用方式不同,训练与推理都保持相同的前缀编码,令牌学到的路由模式直接服务于检索判别力。这是一种成本几乎为零、却直接作用于问题根源(池化前的信息路由)的干预,也是全文最值得记住的一句话。
方法步骤详情
完整流程分六步。第一步,扩展分词器:向词表添加 $K$ 个索引化令牌 $[\text{DUMP}_1]\ldots[\text{DUMP}_K]$(主实验 $K=4$),在嵌入矩阵中初始化为可训练参数。第二步,构造输入:对每个文本 $x\in\{q,p\}$ 拼接前缀得到 $\tilde{x}$,查询与段落同样处理。第三步,编码:送入不变的模型 $M_\theta$,按原策略池化(编码器 [CLS]、解码器 last token),前缀不参与池化取值,只通过自注意力影响上下文表示。第四步,计算损失:相似度 $s(q,p)=\cos(e_q,e_p)/\tau$,用 InfoNCE 在每查询 1 个难负例加 batch 内负例上优化。第五步,更新参数:梯度从池化向量经注意力反向传播进 [DUMP] 嵌入,与模型参数联合更新,无辅助损失。第六步,推理:沿用相同前缀编码,训练推理一致。训练数据 110k 条,1 epoch,最大长度 8192,学习率 $1\times10^{-4}$,温度 20.0,bf16 加梯度缓存。
技术新颖性
新颖性可以从三组对比看清。对比前缀/提示微调(prefix/prompt tuning):那类方法用软提示做任务适配,目标是下游任务表现;本文前缀的目标不是适配任务而是路由噪声,评估的是表示判别力而非任务准确率。对比 ViT register tokens:Darcet 等人靠自监督目标在视觉特征图中清理高范数离群值,本文首次把该机制引入文本检索嵌入,并用纯对比损失驱动,证明『噪声停车场』思想可以跨模态、跨目标函数迁移。对比池化改进(landmark pooling 等):那些方法改变『聚合哪些 token』,需要改动推理管线;本文完全不动池化与架构,仅通过输入增强改变注意力分布,是侵入性最低的一类干预。此外,方法与架构无关,编码器和解码器通吃,四个编码器加两个解码器的实验设计也直接验证了这一点,这与多数绑定特定架构的方案不同。
实验结果
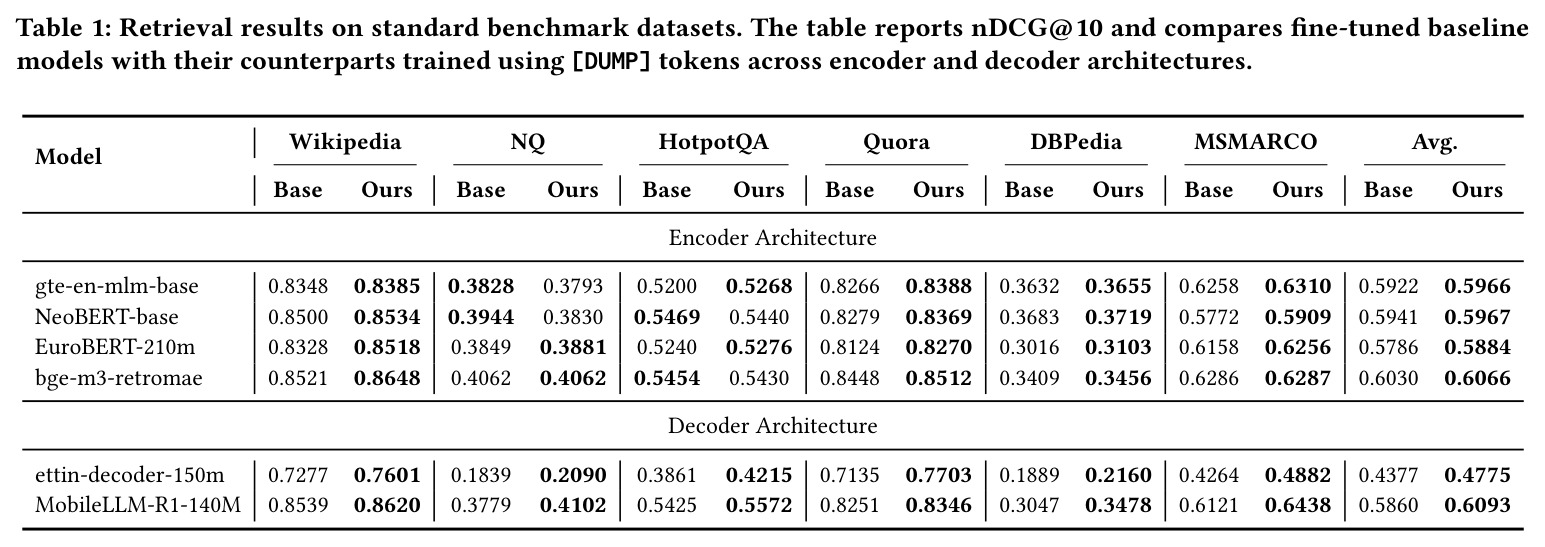
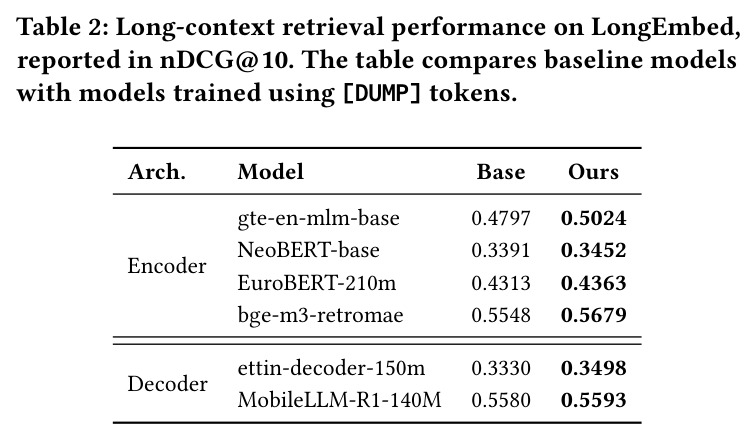
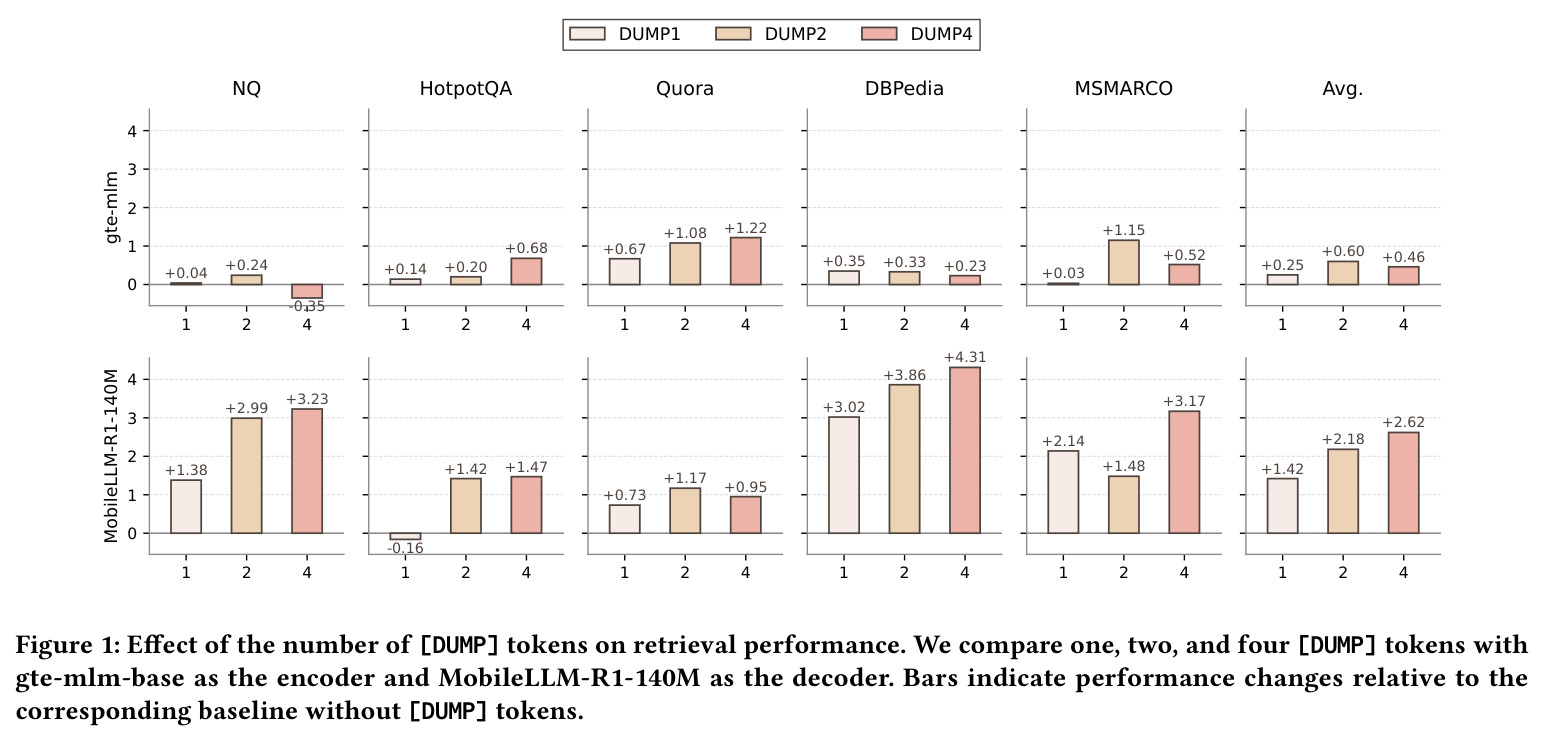
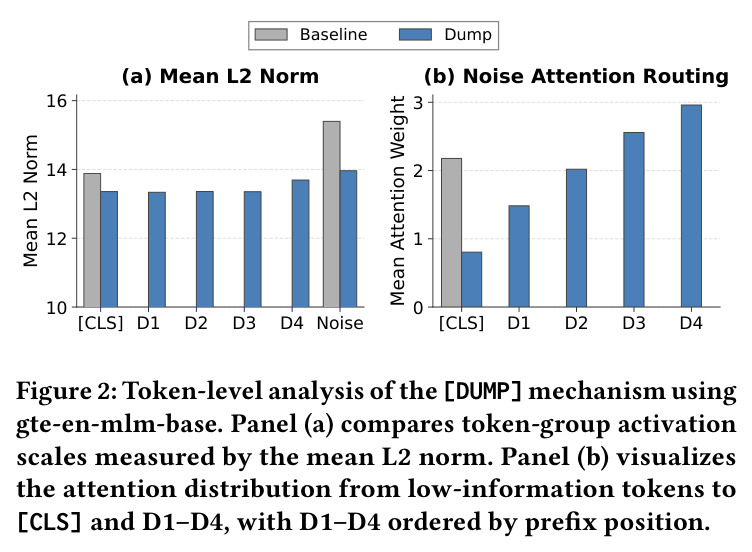
标准检索(Table 1,BEIR 难负例子集 + Wikipedia,nDCG@10):六个模型全部平均提升。解码器受益最大:ettin-decoder-150m 从 0.4377 升到 0.4775(+0.0398,相对约 +9.1%),其中 MSMARCO 从 0.4264 升到 0.4882;MobileLLM-R1-140M 从 0.5860 升到 0.6093。编码器提升较温和:EuroBERT-210m 0.5786→0.5884,gte 0.5922→0.5966,NeoBERT 0.5941→0.5967,bge-m3-retromae 0.6030→0.6066;整体平均相对提升 2.46%。长上下文(Table 2,LongEmbed):gte 0.4797→0.5024 提升最明显,bge-m3-retromae 0.5548→0.5679,ettin-decoder 0.3330→0.3498;但 MobileLLM-R1 几乎持平(0.5580→0.5593),整体平均相对提升 2.41%。Figure 1 显示令牌数 $K$ 非单调:gte 在 $K=2$ 平均增益最佳(约 +0.33),$K=4$ 使 NQ 下降 0.35;MobileLLM 在 $K=4$ 增益最大(+1.47)。Figure 2 的机制分析给出证据:基线中低信息 token 的 L2 范数异常偏高,加入 [DUMP] 后被压低;其流向 [CLS] 的注意力被转移到 D1–D4,支持『注意力重路由』假设。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 标准检索(BEIR 难负例子集 + Wikipedia,解码器 ettin-decoder-150m) | nDCG@10(6 数据集平均) | 0.4775 | 0.4377(微调基线) | +0.0398(相对约 +9.1%) |
| 标准检索(BEIR 难负例子集 + Wikipedia,6 模型整体) | nDCG@10 平均相对提升 | 各模型均提升,解码器增益最大 | 各模型对应微调基线 | 平均相对提升 2.46% |
| 长上下文检索 LongEmbed(gte-en-mlm-base) | nDCG@10 | 0.5024 | 0.4797 | +0.0227 |
| 长上下文检索 LongEmbed(6 模型整体) | nDCG@10 平均相对提升 | 整体平均提升 | 各模型对应微调基线 | 平均相对提升 2.41% |
局限与改进
作者承认的局限:[DUMP] 数量 $K$ 的效果非单调,最佳值因模型和数据集而异,需要调参;个别数据集出现回退(如 gte 在 $K=4$ 时 NQ 下降 0.35,NeoBERT 在 NQ 上 0.3944→0.3830),改进并非逐项保证。我观察到的局限:机制分析只在 gte-en-mlm-base 的 LongEmbed NQ 一个设置上进行,且用 NLTK 停用词充当『低信息 token』的代理,与真正的 attention sink 或高范数离群 token 可能不完全重合;证据是相关性而非因果性——没有排除『额外可训练容量本身带来正则化收益』的替代解释,缺少冻结随机前缀等对照;评测只是 MTEB/BEIR 的小子集(6 个数据集),未覆盖重排序、多语言和指令式嵌入模型(如 NV-Embed、Qwen3-Embedding);6 页短文也没有与 prefix tuning、LMK>CLS 等方法做直接对比,『性价比高』的主张缺乏横向数据支撑。
独立分析的弱点
第一,缺少关键对照组:论文没有报告『冻结的随机前缀』或『普通可训练软提示』的基线,无法判断收益究竟来自噪声路由,还是仅仅因为多了一点点可训练参数。改进方向:补一组 frozen-random-prefix 和 trainable-soft-prompt 对照,若 [DUMP] 仍显著更好,机制主张才真正成立。第二,低信息 token 的定义粗糙:NLTK 停用词只是词法层面的代理,而 massive activations 与 attention sink 研究中的离群 token 往往与位置和高范数相关。改进方向:改用激活范数或注意力熵自动识别离群 token 后再做分析。第三,$K$ 非单调且需逐模型调参:gte 最优 $K=2$、MobileLLM 最优 $K=4$,实际部署增加搜索成本。改进方向:引入可学习的门控或令牌重要性衰减,让模型自己决定吸收容量。第四,只测了前缀位置:把 [DUMP] 放在序列中间或末尾、或每层插入 register(参照 ViT 做法)是否更好值得系统消融。第五,评测面窄:应在完整 BEIR/MTEB、指令式 LLM 嵌入模型和重排序场景验证泛化性。
未来方向
作者方向上把 $K$ 明确定位为可调超参数,暗示后续可以做自动选择;机制上他们展示了注意力重路由的证据,可延伸为对 attention sink 与检索表示质量之间关系的更系统研究。基于成果的自然延伸包括:与 landmark pooling 等池化改进正交组合,验证叠加收益;把 [DUMP] 思想移植到指令式嵌入模型(NV-Embed、Qwen3-Embedding)以及多语言和代码检索;研究 [DUMP] 与 RoPE 位置编码、长上下文扩展的交互,例如在超过 8192 的输入上检验增益是否保持;探索动态数量或逐层 register 的变体;以及在视觉-语言检索中复用该机制。理论上,[DUMP] 令牌学到的嵌入究竟编码了什么,也值得用探测分类器或聚类分析打开黑箱,为『噪声路由』提供更直接的因果证据。
复现评估
复现难度低,是这篇论文对实践者最友好的地方。方法本身只需在分词器加 4 个特殊 token 并拼在输入前,代码量几行;论文给出了完整训练配方:110k 训练对(100k RLHN 重标注难负例 + 10k MLDR)、1 epoch、最大长度 8192、学习率 $1\times10^{-4}$、温度 20.0、每查询 1 个难负例加 batch 内负例、bf16 加梯度缓存、全局 batch 256。六个基座模型(gte-en-mlm-base、NeoBERT、EuroBERT-210m、bge-m3-retromae、ettin-decoder-150m、MobileLLM-R1-140M)与全部数据集(RLHN、MLDR、MTEB/BEIR、LongEmbed)都公开可得。模型在 140M–210M 量级,单张 24GB 显卡配合梯度缓存即可复现,全流程预计 1–2 天。论文未提及官方开源代码,但基于 Sentence-Transformers 或 MTEB 生态重实现没有障碍。风险点主要是 RLHN 数据的具体划分和评测子集难负例版本的对齐,需仔细核对才能精确复现表中数字。
论文图表