OmniSpectra:通用光谱表征学习的统一基础模型 OmniSpectra: A Unified Foundation Model for Universal Spectra Representation Learning
用对数波长连续坐标替代像素序号,12.2M参数统一八台望远镜的光谱表征
前置知识
RoPE 旋转位置编码
将注意力中的 query 和 key 向量按与 token 位置成正比的角度旋转的编码方式。两个 token 的注意力得分只取决于旋转角之差,即相对距离,因此天然具备平移等变性和长度外推能力。OmniSpectra 把旋转角定义在连续的 $\log\lambda$ 轴上而非整数下标上,旋转角变成物理波长比。
本文最核心的性质——红移平移在相对注意力中严格消去——完全建立在 RoPE 只依赖相对距离的机制上,不理解 RoPE 就无法理解跨红移、跨仪器的位置对齐为何成立。
宇宙学红移
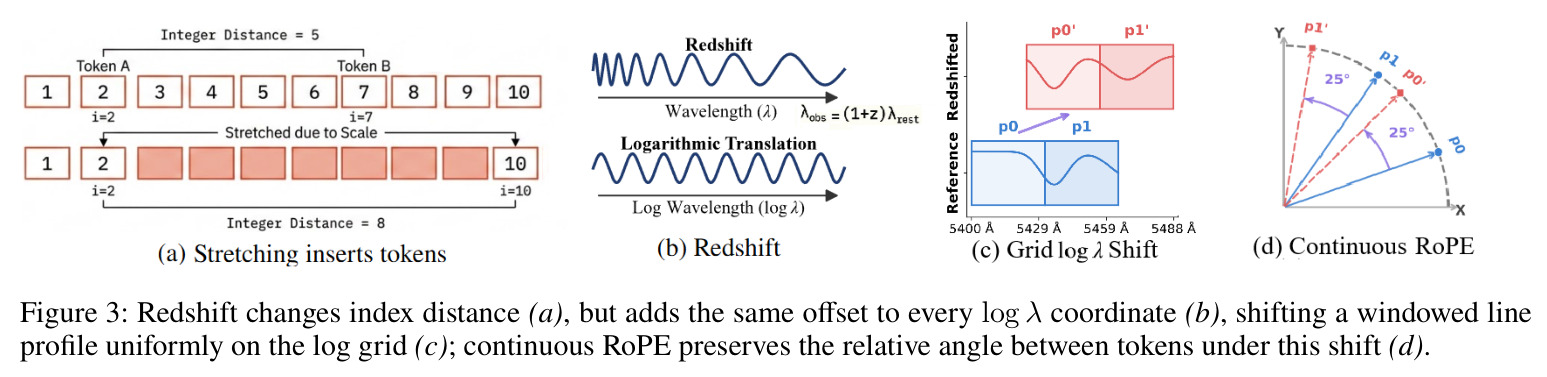
遥远天体退行使其光谱整体向长波端移动,观测波长与静止系波长满足 $\lambda_{\rm obs}=(1+z)\lambda_{\rm rest}$,红移 $z$ 是天文学最基础的测量量。取对数后该乘性缩放变为加性平移 $\log\lambda_{\rm obs}=\log\lambda_{\rm rest}+\log(1+z)$。
论文的核心数学技巧就是把红移在对数空间变成均匀平移,从而让相对位置编码免疫红移、注意力几何与网格解耦;这是全文方法设计的物理出发点。
线扩散函数 (LSF) 与分辨本领
光谱仪的光学系统会把无限窄的谱线展宽成有限宽度的轮廓,该轮廓即线扩散函数 LSF,宽度 $\sigma_{\rm LSF}$ 由仪器决定;通常用分辨本领 $R=\lambda/\Delta\lambda$ 度量,本文语料的 $R$ 从约1500到34000。它是仪器属性而非信号属性,以元数据形式输入模型。
分辨率门控傅里叶解码器直接用 $\sigma_{\rm LSF}$ 衰减超出仪器分辨能力的频率,是阻止模型幻觉不可测细节的关键;不熟悉 LSF 就看不懂解码器设计的物理依据。
隐式神经表示与傅里叶特征
用 MLP 把连续坐标映射到信号值的参数化方式(INR)。普通 MLP 存在频谱偏差,先拟合低频、难表达窄而尖的结构;傅里叶特征 $\gamma(x)=[\sin\omega_k x,\cos\omega_k x]$ 把坐标提升到高频特征空间后即可恢复精细结构,NeRF 系工作大量使用。
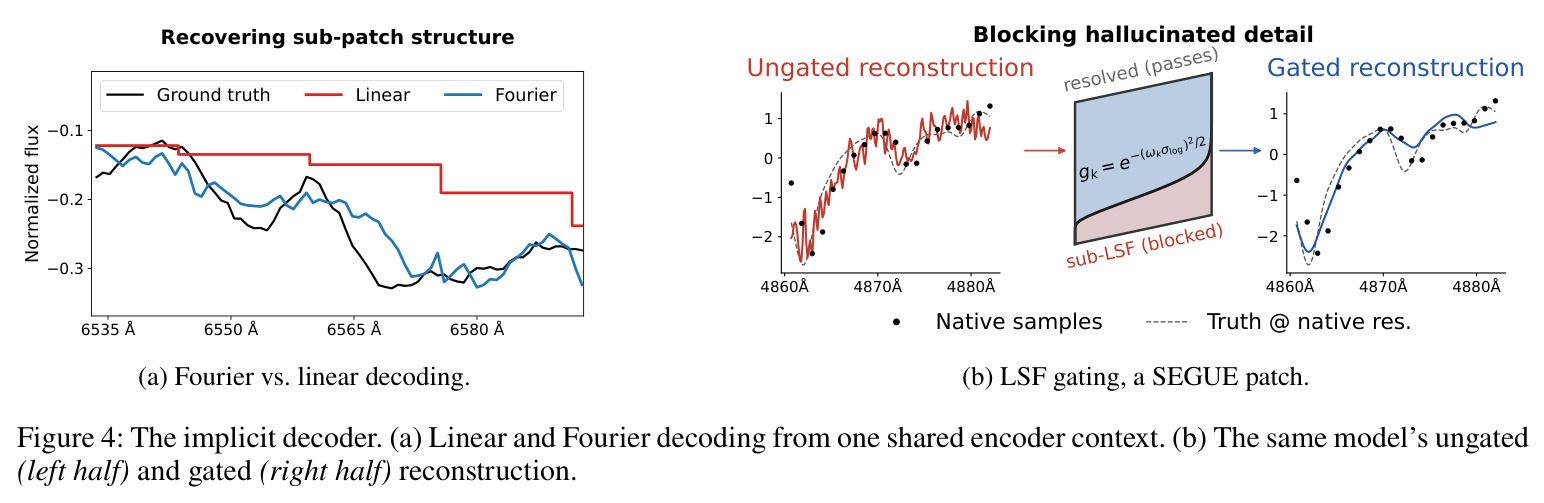
本文解码器在每个原生波长坐标处查询 $f(\lambda)$,依靠对数间隔频率的傅里叶基表达亚 patch 的窄线结构;理解频谱偏差才能明白实验中线性解码器为何失败而傅里叶解码器可行。
掩码自编码预训练
自监督范式:随机遮住输入的一部分(本文每个 patch 独立以0.5概率掩码),让模型从剩余上下文重建被遮内容,由此学到通用表征;下游任务冻结编码器、只训练轻量头。MAE、BERT 均属此类。
这是本文的训练范式与迁移评测协议的基础,理解它才能看懂实验设置中“冻结编码器+10 epoch 微调”以及与用相同语料重训的基线如何保证公平比较。
注意力池化
用一个可学习的全局 query 向量对一组特征做 softmax 加权求和,得到单一汇聚向量,权重由相关性自适应决定而非均匀平均;Set Transformer、Perceiver 等广泛使用。
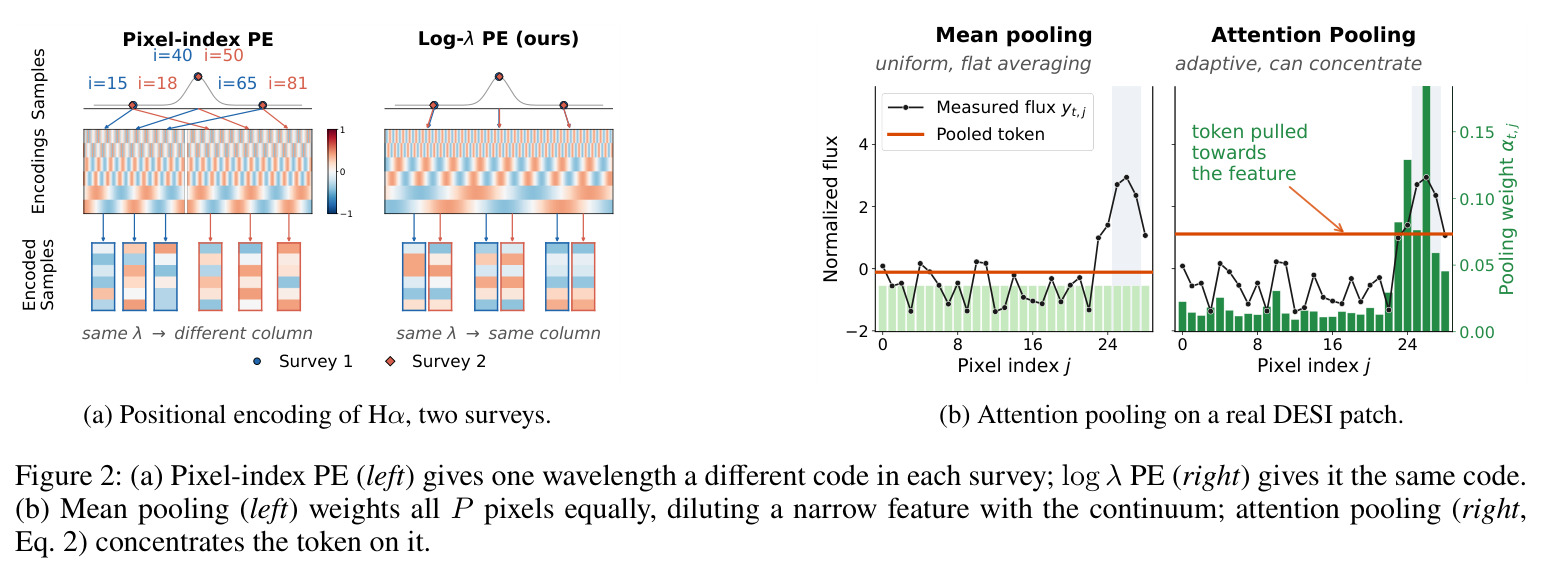
本文 tokenizer 用全局 query 池化 patch 内像素,能自适应聚焦窄吸收线等局部特征而非被连续谱稀释;这是消融实验中 Tokenizer 组件对应的创新点之一。
研究动机
天文光谱巡天已覆盖数亿天体,但不同仪器对同一波长区间的采样密度差异极大:本文语料中八个巡天的原生像素数从3,865到16,384不等,分辨本领 $R$ 跨越约1,500到34,000,采样密度相差可达25倍。标准序列模型按 token 的整数序号编码位置,于是同一条物理谱线(如 Hα)在不同巡天的探测器上落在不同像素列,被赋予完全不同的位置码。这种错配是结构性的:即使 token 本身携带连续波长值,注意力的几何仍绑定在序列下标上。跨仪器共享权重的常规做法是先把所有光谱有损重采样到统一网格,这会模糊窄吸收/发射线等高频特征,并给测量注入插值伪影。已有光谱基础模型各有局限:AstroCLIP 的位置编码不含波长信息;GalSpecNet 与 SpecPT 局限于单一巡天;Spender 需要已知红移 $z$ 才能重采样到静止系固定网格;AION-1 为每台仪器单独设计 tokenizer;Shen 等用 $\lambda$ 的绝对正弦编码,坐标仍是绝对而非相对的。
本文的目标是本文目标是构建一个\u201c波长原生\u201d(wavelength-native)的光谱基础模型 OmniSpectra:单一权重集合直接摄取任意仪器原生网格上的光谱,无需重采样、插值或逐仪器适配。具体技术要求是:同一物理特征在任何网格上获得相同的位置码;宇宙学红移在注意力几何中表现为均匀平移而非网格依赖的畸变;解码时只在每台仪器原生坐标处重建,不产生离散化伪影或幻觉细节。评测目标是:在源分类、恒星参数($T_{\rm eff}$、$\log g$、[Fe/H])、星系性质(sSFR、年龄、金属丰度、质量)与红移估计上达到或超过七类基线(含 AstroCLIP、AION-1 等预训练模型和 GalSpecNet、Spender 等监督模型),同时仅用 12.2M 参数,验证\u201c编码物理结构可以替代参数规模\u201d这一命题。
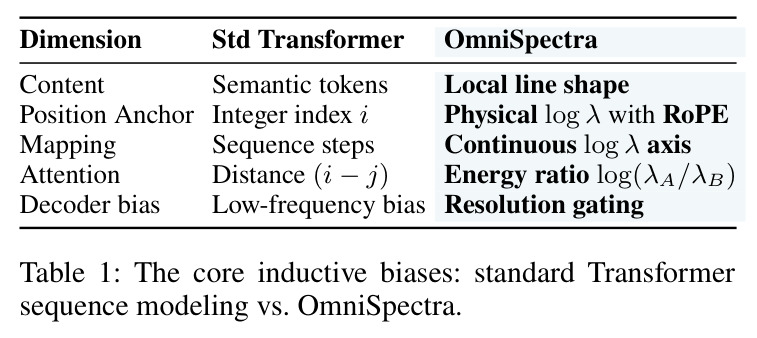
与已有工作不同的是,本文把\u201c坐标错配\u201d识别为跨仪器表征学习的结构性瓶颈,切入点是重新定义 token 距离的物理含义,而非堆数据或参数。核心观察有二:其一,宇宙学红移 $\lambda_{\rm obs}=(1+z)\lambda_{\rm rest}$ 在对数波长空间是加性平移 $\log\lambda_{\rm obs}=\log\lambda_{\rm rest}+\log(1+z)$,任意两条谱线的间距退化为物理波长比 $\log(\lambda_A/\lambda_B)$,恰与原子跃迁的固定能量比 $E=hc/\lambda$ 对齐;其二,序列模型中相对编码与绝对编码本就各司其职。据此 OmniSpectra 把 token 距离定义为连续物理量而非序号差:RoPE 的相对项天然消去共享的 $z$ 平移,使识别谱线无需先知道红移,而绝对 $\log\lambda$ 码保留平移量供红移预测。这个\u201c相对+对数+连续\u201d的三重组合,是以往绝对正弦编码、逐仪器 tokenizer、无波长 PE 等方案都没有同时做到的。
核心方法
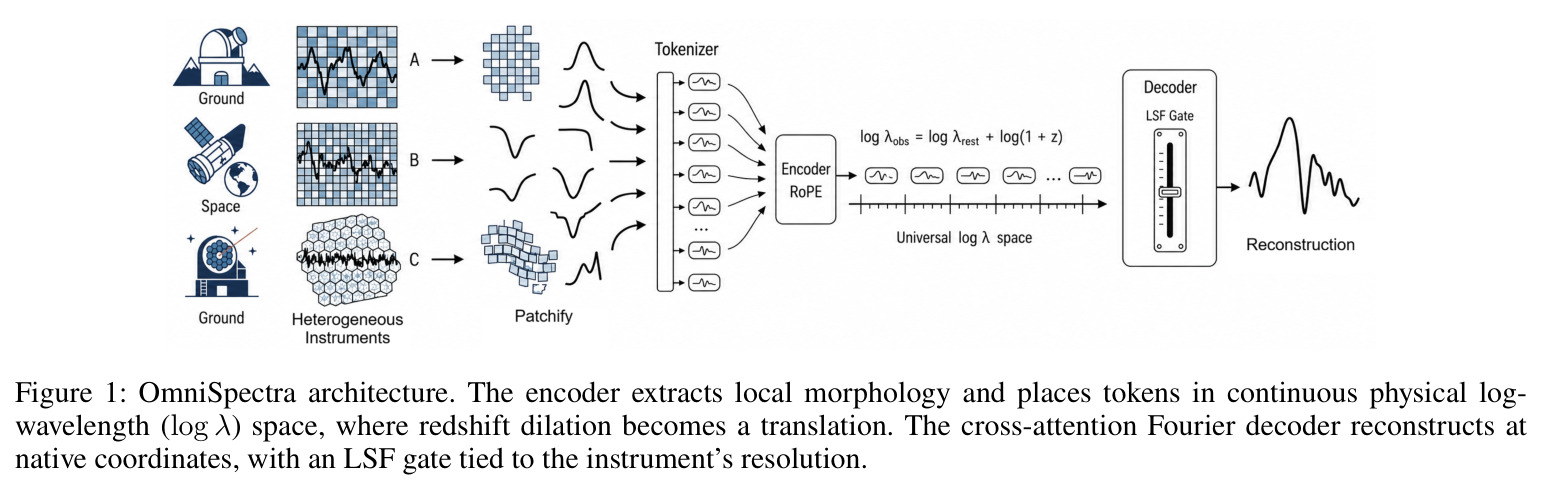
OmniSpectra 把问题因子化为两半:硬件高效的固定像素 patch 提取局部线形(内容),共享的连续 $\log\lambda$ 空间统一 token(位置)。直觉上,探测器像素擅长\u201c看\u201d吸收线的形状,但不该决定这条线\u201c在哪\u201d,位置应完全由物理坐标接管。技术路线:光谱切成 $P=32$ 个连续像素的 patch,经线性嵌入、depthwise 卷积与可学习 query 的注意力池化,得到不含序号和仪器 ID 的内容 token;每个 patch 以掩码平均坐标 $\bar\lambda_t$ 锚定,经连续傅里叶编码 $\gamma(\log\bar\lambda_t-\log\lambda_0;\omega)$ 得到位置码并叠加,再在 $\log\lambda$ 上施加连续 RoPE。384 维 6 层编码器做掩码重建预训练;128 维 4 层解码器用 LSF 门控的傅里叶特征,在任意原生波长坐标逐像素重建。预训练语料为八个巡天共 640 万条光谱,总参数量仅 12.2M。
核心创新是把序列建模的\u201c整数下标\u201d替换为\u201c物理对数波长坐标\u201d,并让相对与绝对位置编码各尽其职。位置码 $p_t=\gamma(\log\bar\lambda_t-\log\lambda_0;\omega)$ 是坐标的连续函数而非查找表,频率 $\omega$ 对数间隔覆盖亚像素到全巡天尺度:更密的网格只是沿同一根物理轴放更多 token,覆盖同一波段的 patch 在任何网格上都得到相近的码。红移在对数空间是加性的:一对谱线的 RoPE 相对角为 $\log(\lambda_{\rm H\alpha}/\lambda_{\rm H\beta})$,与 $z$ 无关,共享平移 $\log(1+z)$ 在相对注意力中严格消去;绝对码则保留平移量供红移预测。第二个创新是分辨率门控的傅里叶解码器:门控 $g_k=\exp[-\tfrac12(\omega_k\sigma_{\rm LSF})^2]$ 按仪器 LSF 宽度衰减超分辨率频率,在基函数层面阻断不可能测得的细节,类似 Mip-NeRF 的抗混叠,而非依赖网络自行忽略。
方法步骤详情
第一步 patch 化:输入 $S^{(n)}=\{(\lambda_i,f_i,\sigma_{{\rm LSF},i})\}$ 按 $P=32$ 个连续像素切成 patch,每像素线性嵌入,depthwise 卷积捕捉线宽与不对称性得 $\tilde e_{t,j}$。第二步注意力池化:可学习全局 query $q$ 按式(2)对 patch 内像素 softmax 加权得到 $x_t$,均匀平均是其特例;吸收线是通量极小值,这种选择性并非偏好大数值。第三步位置编码:以掩码平均坐标 $\bar\lambda_t$ 计算傅里叶码 $p_t$(式3)叠加到 $x_t$,再施加 $\log\lambda$ 上的连续 RoPE。第四步编码:384 维 6 层 Transformer,每个 patch 独立以 0.5 概率掩码,重建损失驱动预训练。第五步解码:对掩码 patch $q$ 用质心生成查询 $p_q$(式6),cross-attention 聚合编码器 token 得 $h_q$(式7);对每个原生像素坐标构造门控傅里叶特征 $\phi_{q,i}$(式8),输出 $\hat f={\rm MLP}[h_q;\phi_{q,i}]$(式9),门控宽度取自仪器元数据。第六步训练:AdamW lr $10^{-4}$,权重衰减 0.05,batch 64,200 epoch,4×A100;下游冻结编码器只训池化头 10 个 epoch。
技术新颖性
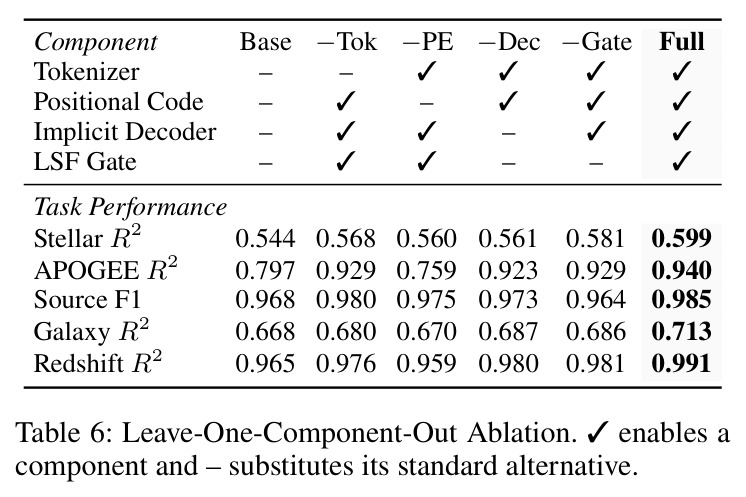
与已有技术的本质区别可从三方面看。对比 Perceiver、NaViT 等变长模型:它们接受变长输入但位置仍按下标识别,同一物理特征在不同采样密度下获得不同码;OmniSpectra 的码是波长的连续函数,可在任意波长求值,这是查找表式编码做不到的。对比 RoPE、ALiBi 等相对位置方法:它们改善长度外推,但 token 距离仍是仪器相关的序号差;OmniSpectra 把距离定义为 $\log(\lambda_A/\lambda_B)$ 这样的物理比值,红移平移被严格消去。对比神经算子、INR、集合模型等连续坐标方法:它们能处理不规则采样但缺乏领域先验;OmniSpectra 额外注入两条物理结构——对数空间使宇宙学红移变为平移、LSF 门控把测量分辨率硬编码进解码基。消融(Table 6)证实各组件贡献任务相关且非加性:位置码在 APOGEE 跨波段迁移上贡献最大(去掉后 $R^2$ 从 0.940 跌至 0.759),LSF 门控主要提升源分类(去掉后 F1 从 0.985 降到 0.964),而部分部分配置反而低于 Base,说明组件间存在交互效应,不能简单拆开理解。
实验结果
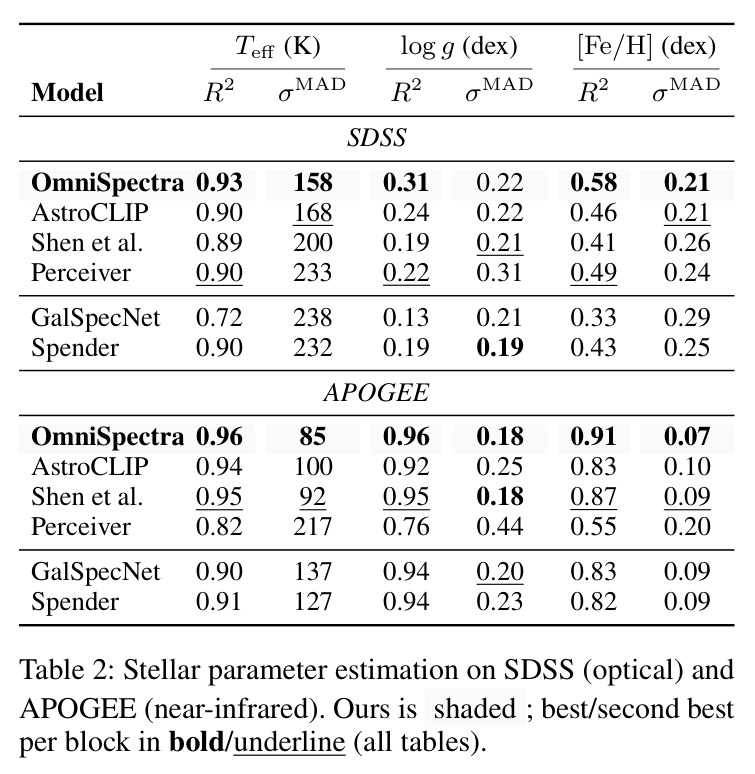
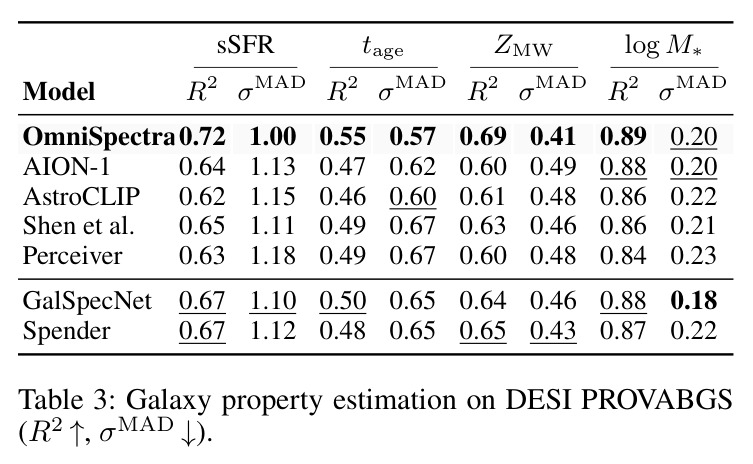
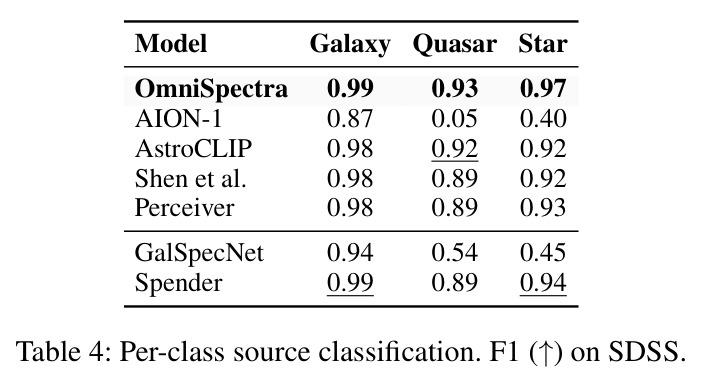
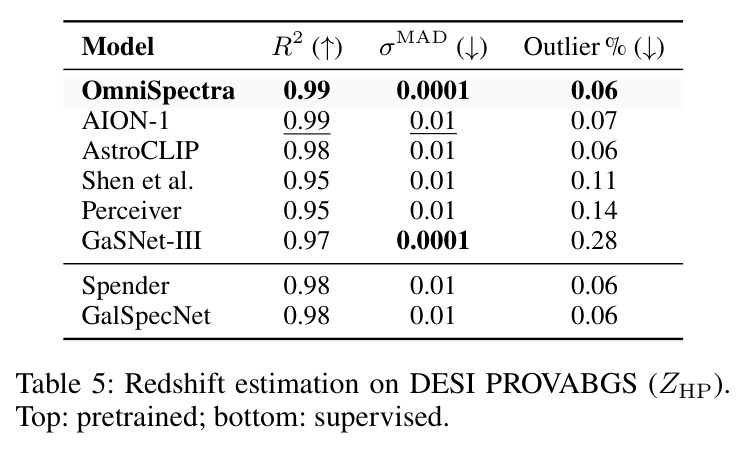
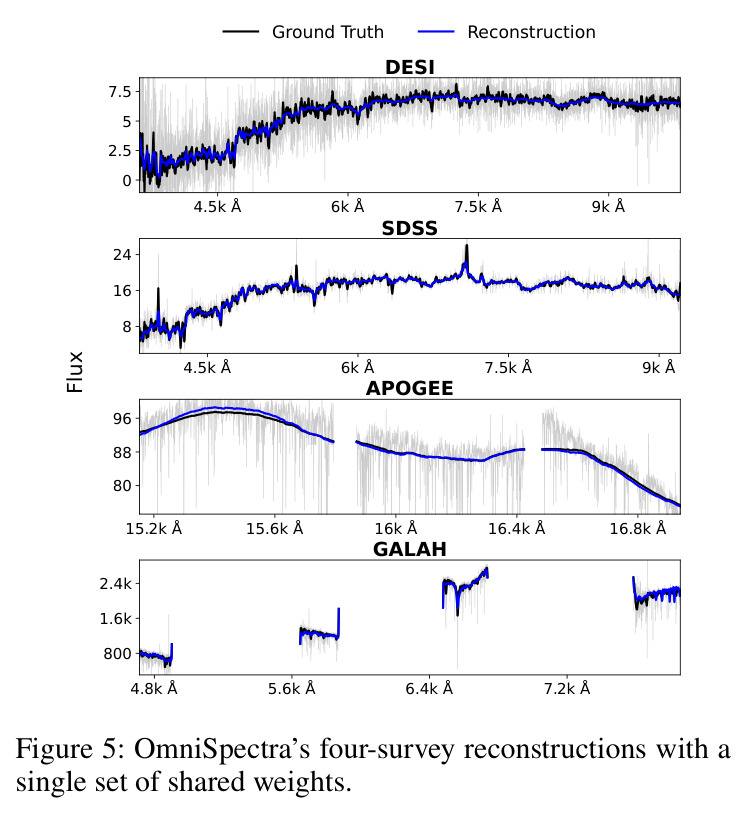
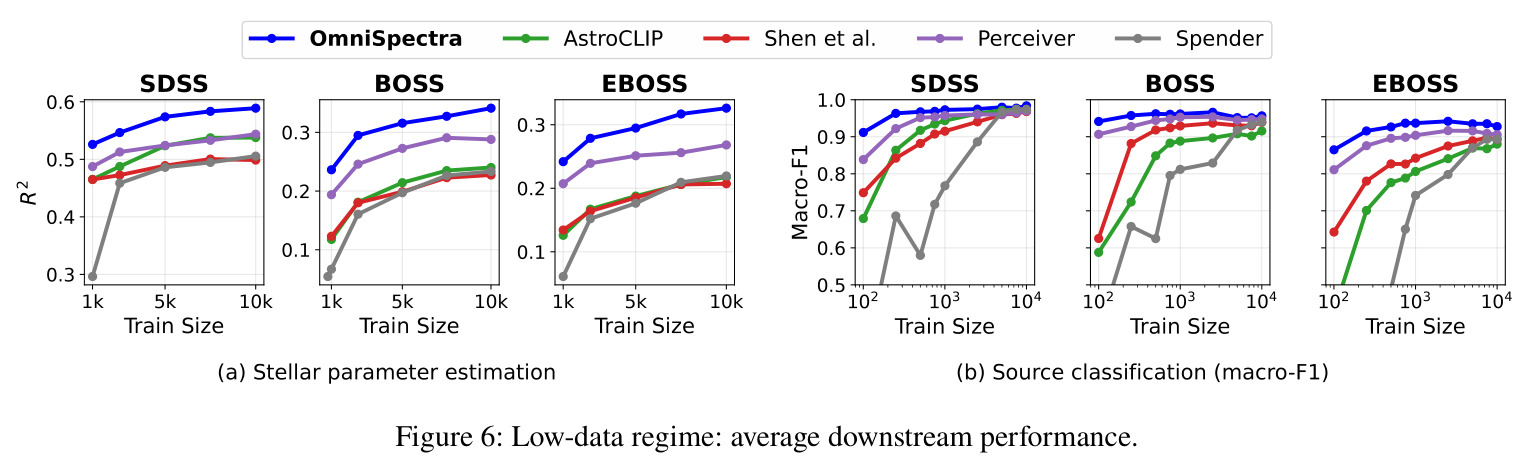
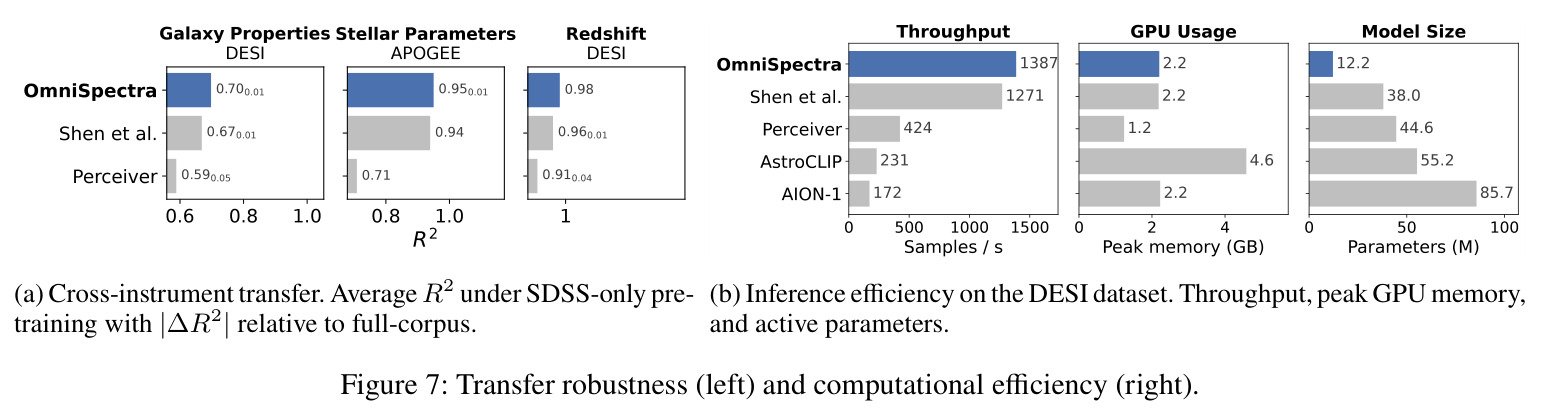
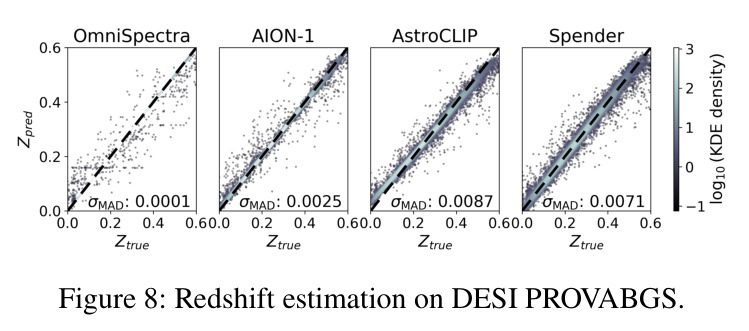
重建:一套共享权重在 DESI、SDSS、APOGEE、GALAH 各自原生网格上重建,曲线紧贴真值(Fig 5),这是一切下游结果的前提。恒星参数(Table 2):SDSS 上 $T_{\rm eff}$ $R^2=0.93$、$\sigma_{\rm MAD}=158$K(AstroCLIP 0.90/168K),APOGEE 上 0.96/85K、[Fe/H] 0.91/0.07dex,六格全部最优,低标签时保持领先(Fig 6a)。星系性质(Table 3,232.7K 样本):sSFR $R^2=0.72$ 对 AION-1 的 0.64,tage 0.55 对 0.47,$\log M_*$ 0.89,三项大幅领先。源分类(Table 4):Galaxy/Quasar/Star F1 为 0.99/0.93/0.97 每类最优,AION-1 的 Quasar 仅 0.05;标签少于 500 时仍显著。红移(Table 5):$R^2=0.99$、$\sigma_{\rm MAD}=0.0001$、离群率 0.06%,与模板法 GaSNet-III 的 σMAD 持平但离群率约 1/5(0.28%)。消融(Table 6):Full 五项均最优(恒星 0.599、APOGEE 0.940、F1 0.985、Galaxy 0.713、红移 0.991)。跨巡天(Fig 7a):仅 SDSS 预训练,对范围外的 APOGEE 几乎不退化。效率(Fig 7b):吞吐最高、显存远低于 370M 的 AstroCLIP 与 314M 的 AION-1,本文仅 12.2M。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 恒星参数估计 $T_{\rm eff}$(SDSS 光学) | $R^2$ / $\sigma_{\rm MAD}$(K) | 0.93 / 158 | AstroCLIP 0.90 / 168 | $R^2$ +0.03,色散降 10K |
| 恒星参数估计 $T_{\rm eff}$(APOGEE 近红外) | $R^2$ / $\sigma_{\rm MAD}$(K) | 0.96 / 85 | AstroCLIP 0.94 / 100 | $R^2$ +0.02,色散降 15K |
| 星系 sSFR(DESI PROVABGS) | $R^2$ | 0.72 | AION-1 0.64 | +0.08 |
| 逐类源分类(SDSS) | F1(Galaxy/Quasar/Star) | 0.99 / 0.93 / 0.97 | AstroCLIP 0.98 / 0.92 / 0.92 | 每类最优,Star +0.05 |
| 红移估计(DESI PROVABGS) | $R^2$ / $\sigma_{\rm MAD}$ / 离群率 | 0.99 / 0.0001 / 0.06% | GaSNet-III 0.97 / 0.0001 / 0.28% | 离群率约降至 1/5 |
局限与改进
作者承认的局限:位置编码的频率周期范围调校到约 3600–18000Å,显著偏离该区间的波长(紫外、中红外)性能未经评估;表征目前是单模态的,与图像、测光的 CLIP 式对齐留作未来工作;LSF 门控是归纳偏置而非严格带限保证,最终预测经过非线性 MLP,仍可能泄漏亚分辨率细节(Fig 4b 显示门控只是大幅减少而非完全消除像素间振荡)。我自己的观察:解码器依赖仪器报告的 $\sigma_{\rm LSF}$ 元数据,若仪器未提供则需额外估计;patch 锚定用掩码平均坐标 $\bar\lambda_t$,不同密度网格间仍存在小残差;基线比较不完全对等——作者用相同语料重训了 Shen 等与 Perceiver 做架构对比,但 AstroCLIP/AION-1 只能用公开 checkpoint,且 AION-1 公开谱权重不覆盖 APOGEE、其 SDSS checkpoint 明显落后,作者也因此在该行做了省略处理;消融中部分组件配置低于 Base,提示组件组合需要联合调参,直接移植到新领域未必顺遂。
独立分析的弱点
第一,波长覆盖的脆弱性:频率 $\omega$ 的周期范围硬编码为约 3600–18000Å,遇到紫外或中红外(JWST)数据需重新设计基,改进方向是学习式频率调度或按输入坐标自适应展宽周期。第二,单模态天花板:表征只有光谱,无法利用图像—光谱互补信息,可与测光或 DESI 图像做 CLIP 式对齐。第三,元数据依赖:$\sigma_{\rm LSF}$ 必须由仪器提供,缺失时需从数据估计,可加轻量 LSF 预测头并用跨仪器一致性损失约束。第四,patch 锚定的残余网格依赖:掩码平均坐标 $\bar\lambda_t$ 使不同密度网格的码仍差一个小量,可引入亚 patch 坐标的二次编码。第五,验证域窄:八个巡天均为恒星/星系的光学—近红外光谱,未覆盖系外行星大气、时序变源等,\u201c通用\u201d声明应打折扣。第六,消融非加性说明超参强耦合,换语料后需整体重调,迁移的工程成本不低。
未来方向
作者明确提出把单模态表征扩展到其他模态,例如通过 CLIP 式对齐与图像对齐,进入全模态天文基础模型的赛道。基于本文成果还可自然延伸:其一,把 $\log\lambda$ 相对编码推广到其他以连续物理坐标定义信号的科学领域——文中已指出质谱的 $m/z$、MRI 的 k 空间坐标、地球观测各波段的中心波长面临同样的坐标错配,对数/平移等变编码有普适潜力;其二,随 LSST、4MOST 与 DESI 后续数据扩充语料与波长覆盖,系统检验周期范围外的外推能力并发展自适应谱基;其三,把 LSF 门控推广为噪声/方差谱感知的解码器,让每个坐标的测量不确定度直接调制频率增益,从\u201c仪器分辨率门控\u201d走向\u201c逐像素信噪比门控\u201d;其四,利用连续解码做生成式应用,如低分辨到高分辨的物理一致超分辨、跨仪器光谱互转、发射线通量反演;其五,12.2M 的小体量适合边缘部署与蒸馏,可研究其作为通用光谱 tokenizer 接入更大规模多模态模型。
复现评估
复现条件总体友好。数据全部公开:八个预训练巡天(SDSS Legacy、BOSS、eBOSS、SEGUE-1/2、DESI、APOGEE、GALAH)均为公共数据,下游标签(PROVABGS 星系性质、恒星参数目录)也有公开版本;主要工程量在 640 万条光谱的下载、原生格式解析与交叉匹配(如 DESI EDR × PROVABGS 得到 232.7K 样本)。模型很小(12.2M 参数:384 维 6 层编码器 + 128 维 4 层解码器),训练预算为 4 块 A100 跑 200 个 epoch,AdamW lr $10^{-4}$、batch 64,学术实验室完全可负担。论文称完整超参数与基线配置在技术附录 C、D,方法公式(1)–(9)给得很完整;但正文未明确提及代码开源,若从零实现,注意力池化与门控傅里叶解码器需自行摸索,数据管道约占一半工作量。总体复现难度评估:中等,门槛在数据工程而非算力。
论文图表
列出八个巡天(SDSS Legacy、BOSS、eBOSS、SEGUE-1/2、DESI、APOGEE、GALAH)的光谱数量、波长覆盖、分辨本领 $R\approx1500$–34000 与原生像素数 3865–16384 等属性。
量化了“异质性”的具体尺度,是理解 25 倍采样密度差与跨波段迁移难度的基础数据。