DiscoveryRSI:递归学习发现有价值的科研假设 DiscoveryRSI: Recursively Learning to Discover Valuable Hypotheses
把假设研发过程变成递归自我改进循环,假设质量从4.86升至5.39
前置知识
RSI(递归自我改进)
指系统利用自己生成的经验来改进自身的循环过程:先执行任务并保留记录,再从记录中提取有效策略更新模型或流程,然后用改进后的系统执行新任务,如此往复。与单次训练不同,RSI 强调多轮迭代且每轮更新都要经过验收,防止退化。
本文的核心命题就是把 RSI 从代码生成、通用智能体任务迁移到科研假设发现场景,理解 RSI 的循环结构(采集-学习-验收-再采集)是读懂全文的骨架。
多智能体进化搜索
用多个角色分工的智能体在解空间中做类似遗传算法的搜索:Generation 生成新提案,Evolution 改进或修补已有提案,Crossover 组合多个父节点,Restart 另起炉灶,Lead 负责选方向和分配资源,Critique 做盲评。提案之间形成父子链接,构成一棵假设树。
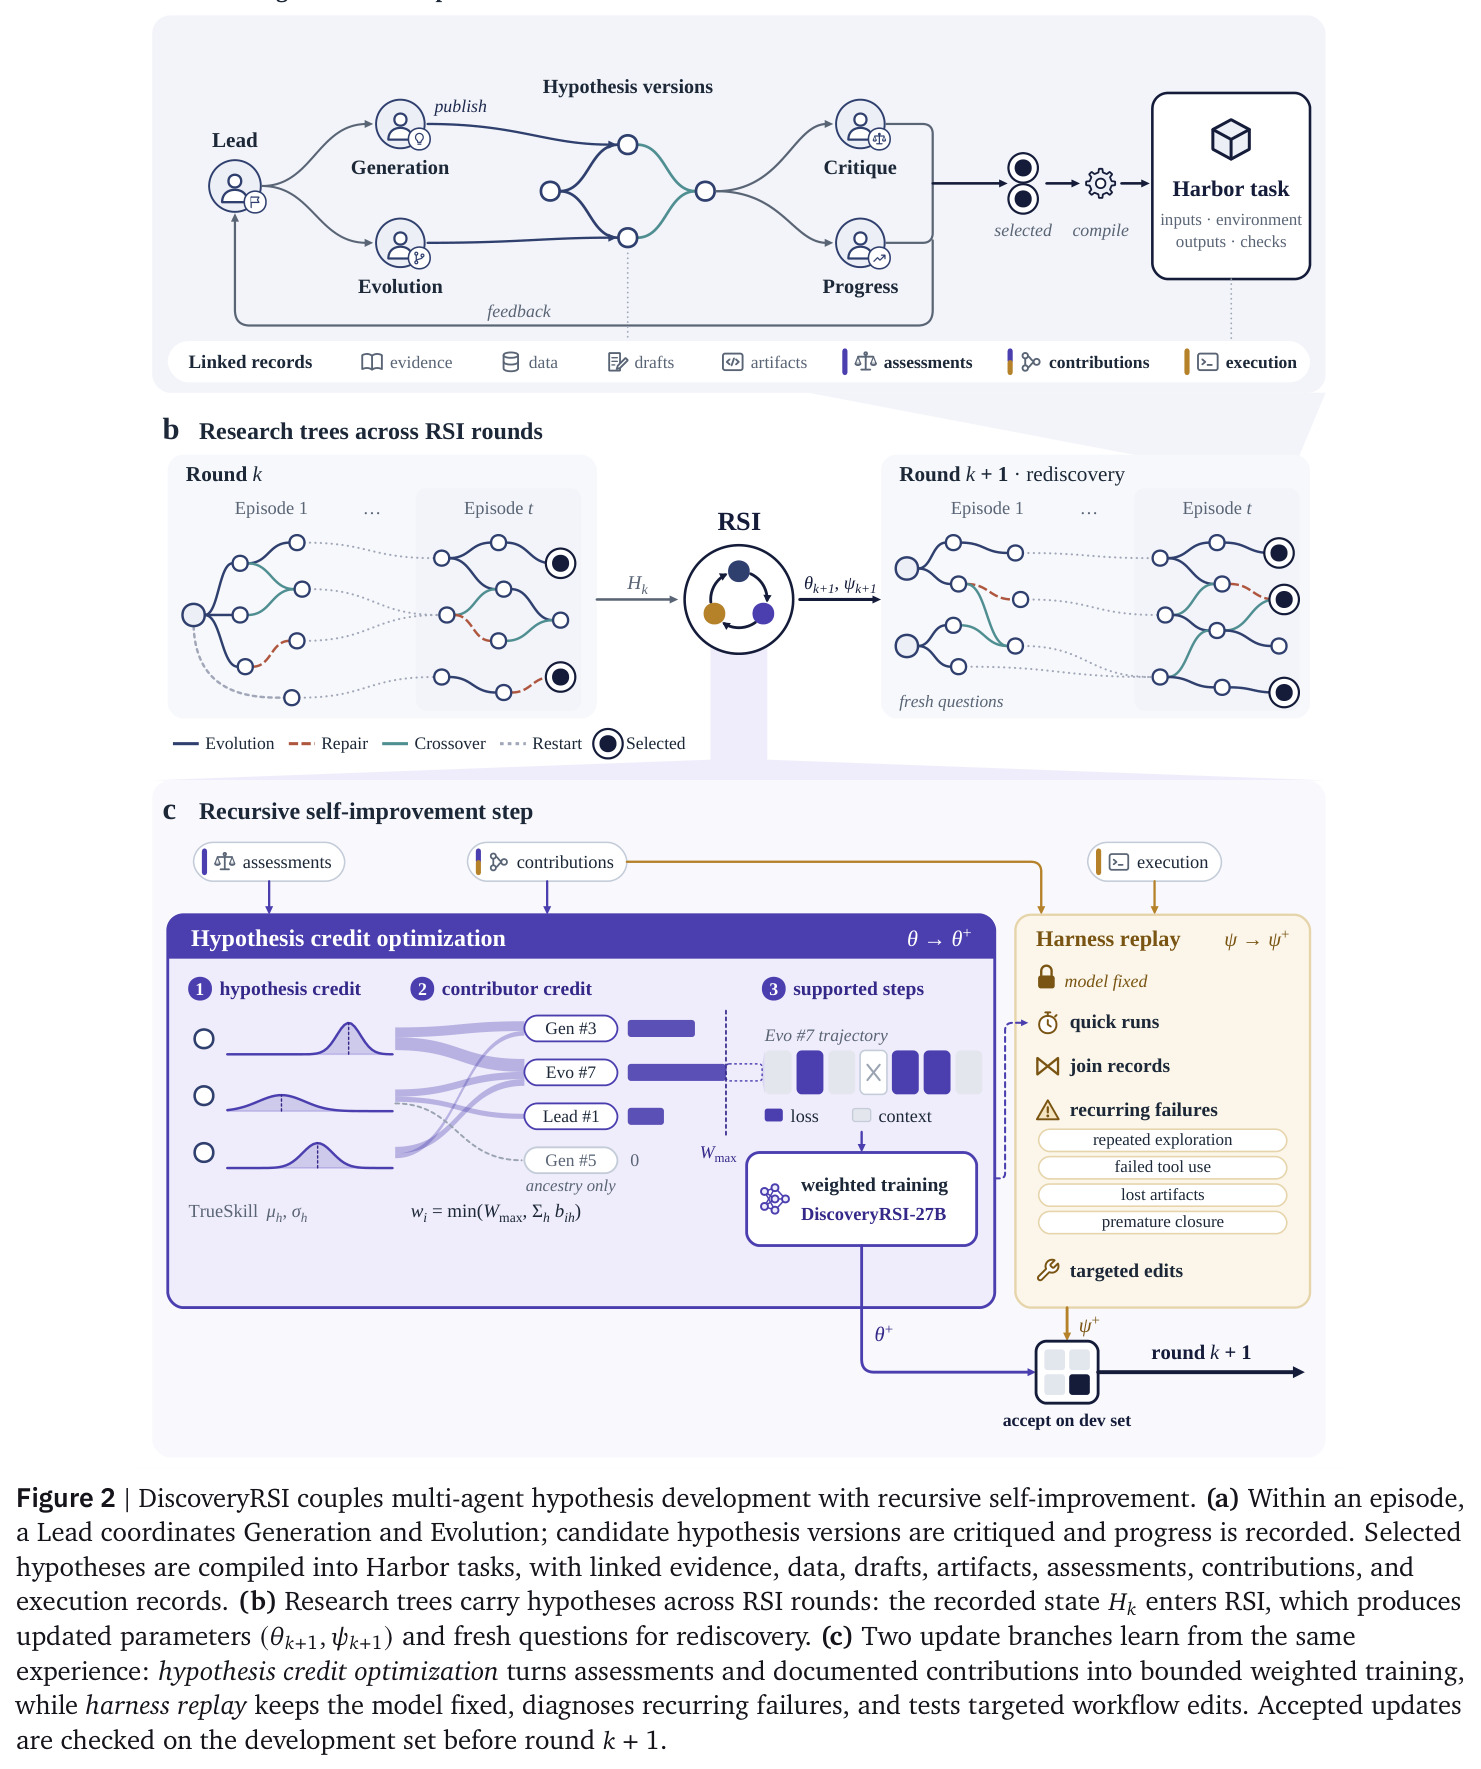
DiscoveryRSI 正是用这种搜索来采集研究经验:假设树上的每个节点、每次操作都是后续训练和流程改进的原始素材。
信用分配(credit assignment)
强化学习中的经典难题:当一个最终结果(好或坏)产生时,如何确定过程中哪些具体动作值得被强化或抑制。在多智能体协作中更复杂,因为最终产物是多角色接力完成的,仅奖励最终产出会埋没中间关键贡献。
本文的'假设信用优化'机制就是为多智能体科研场景设计的信用分配方案:评分属于假设,训练目标属于做出贡献的行动史,这是全文最核心的创新。
TrueSkill 评分
一种贝叶斯评分系统,从成对比较(谁比谁好)中估计每个对象的相对实力:用高斯分布的均值 μ 表示实力、标准差 σ 表示不确定性,每场比较按噪声尺度 β 和平局容差 ε 更新。证据不足时不做更新,天然支持弃权。
论文用 TrueSkill 把盲评智能体对假设的两两偏好汇总为 $(\mu_h, \sigma_h)$,这是后续有界信用分配 $w_i$ 的直接输入。
Harness(智能体脚手架)
指包裹模型权重之外的所有工程设施:智能体间的协调协议、工具接入方式、上下文与文件系统管理、任务分配与评审时机等。同一个模型配上不同的 harness,实际表现可能相差巨大。
论文的三大机制之一'脚手架回放'就是在固定模型权重的前提下,从失败记录中诊断并改进 harness,与改模型权重双轨并行。
研究动机
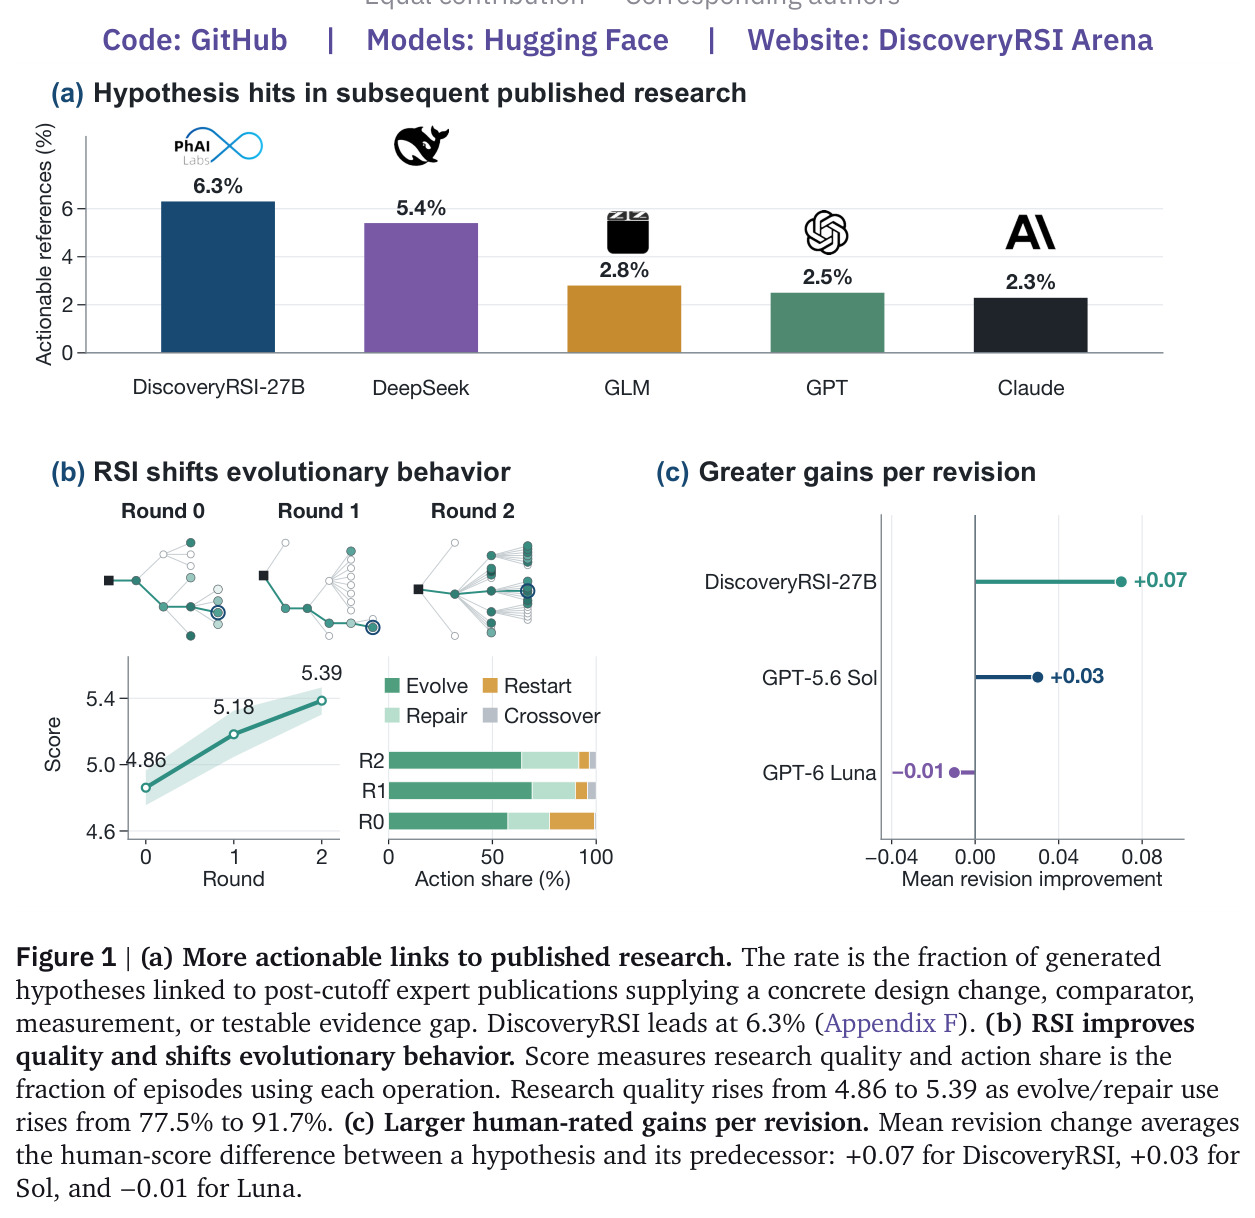
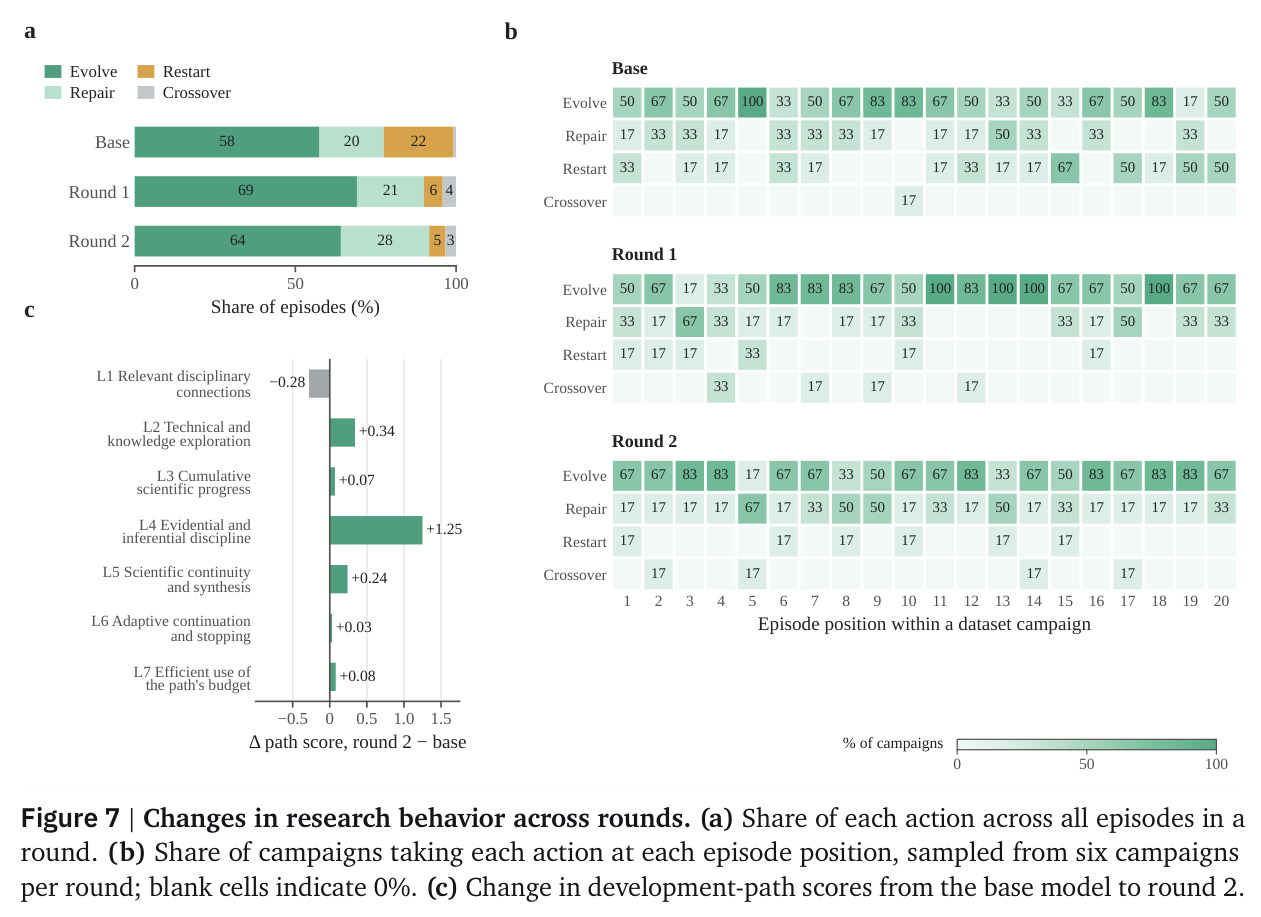
现有科研智能体(如 Co-Scientist 的多智能体假设精炼、AI Scientist-v2 的树搜索实验执行)能生成和筛选假设,但'做完一次研究'并不会让系统变强:评估只落在最终提案上,而产生这个提案的关键决策——谁提出的解释、谁补充的对照实验、谁根据新证据修改了研究方案——都被丢弃。具体带来两个困难:一是把提案变成可执行研究需要落实数据需求与验证标准,同时保住科学问题本身;二是最终评分无法指明该强化哪些贡献,如果只保留最终版本,多智能体协作中的中间贡献就被埋没。结果是研究经验无法转化为模型或工作流的更新,每轮任务都从基座能力起步。本文自动化评测显示,基座模型生成的假设质量分只有 4.86(10 分制),重启操作占比高达 21.7%,说明智能体更倾向于放弃已有方向而不是深耕。
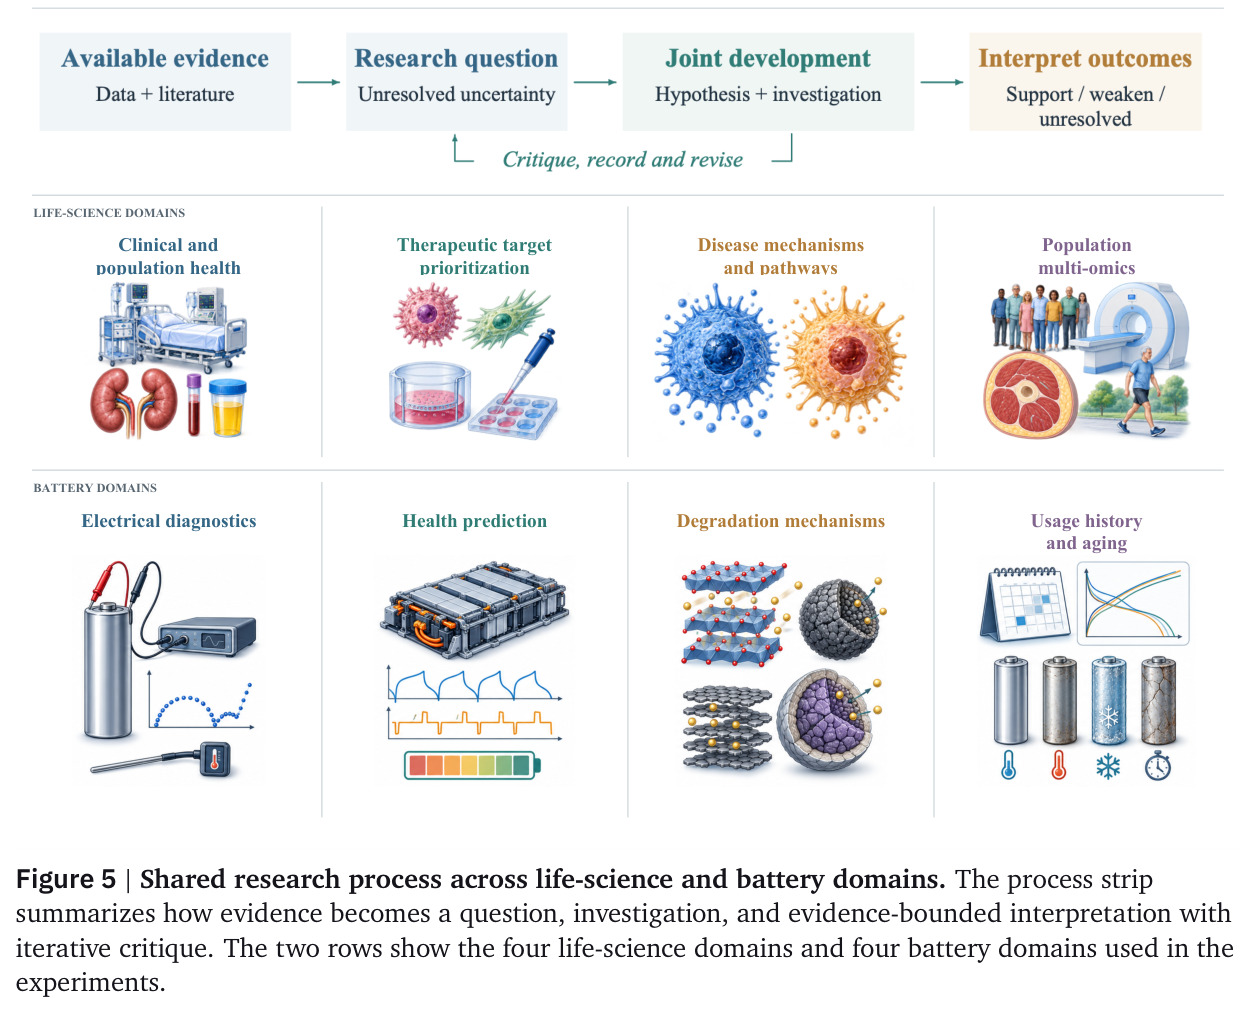
本文的目标是本文要回答的核心问题是:研究智能体如何把假设研发与调查执行变成一个递归学习过程,让每一次研究都能改进下一次研究?具体目标有三层。第一,给出'有价值且可检验的科研假设'的可操作定义(Definition 1),把断言、调查方案、判定标准、替代解释捆成一个可系统评估的联合对象。第二,构建 DiscoveryRSI 框架,把假设树、证据、评估、贡献与执行记录保存为可复用的研究经验。第三,把这些经验转化为两类更新——模型权重(训练出 DiscoveryRSI-27B)和研究脚手架(工作流调整),且所有更新必须在开发集上验收通过才能进入下一轮。最终在临床与人群健康、治疗靶点、疾病机制、群体多组学四个生命科学域以及电池域验证假设质量的可测量提升。
与已有工作不同的是,与已有工作的关键差异在于'学习对象'的选择和归因方式。Co-Scientist、AI Scientist-v2 关注假设产生与实验搜索,不做跨轮次学习;ScienceIDE 从代码库构造学习环境;RAFT、ReST-EM 用筛选样本微调但面对单智能体轨迹。DiscoveryRSI 的独特切入是:把假设当作联合对象 $H=(c,\pi,d,a)$ 保存完整演化史,用'贡献记录'把科学评分与产生它的具体行动史连接起来——评估属于假设层面,训练损失属于历史层面,中间靠有文档的 contributions 做桥。同时它双轨更新:固定模型改脚手架、固定脚手架改模型,候选更新需在开发集上与现任版本配对验收,模型、脚手架、两者或都不变均有可能,这种显式防退化设计在科研智能体文献中是少见的。
核心方法
直觉:如果每次研究都留下'为什么这样改'的完整档案,就可以像教练复盘比赛一样,把高分操作固化进模型、把反复出现的失误固化进流程。技术路线分四步。第一,多智能体进化搜索:Lead 协调 Generation 与 Evolution,通过 evolve/repair/crossover/restart 四种操作在假设树上展开研究,Blinded Critique 盲评科学价值,Progress 对照真实前驱评估实质进展,所有评估与决策都写入链接研究记录。第二,任务编译:被选中的计算方案编译成带具体输入、环境、要求产出与校验的 Harbor 可执行任务,不可获得的数据保持为显式依赖。第三,递归学习三机制:假设信用优化用 TrueSkill 评分经有界分配 $w_i=\min(W_{\max},\sum_h b_{ih})$ 加权训练模型;脚手架回放在固定权重下诊断重复探索、失败工具调用、丢失产物、过早收尾等失误并提出工作流修改;再发现把通过开发集验收的更新 $(\theta_{k+1}, \psi_{k+1})$ 用于全新问题。第四,训练实施:基于 27B 基座全参微调,从 15,792 条研究轨迹经归因与过滤得 2,397 条训练轨迹(634 条 Lead、861 条 Generation、902 条 Evolution),共 2.9112 亿 token,其中仅 618 万(2.12%)受直接监督;256K 上下文、学习率 $5\times10^{-6}$、全局 batch 16、BF16 精度、单 epoch。
核心创新是'假设信用优化',解决多智能体科研中的归因鸿沟:评估对象是科学提案,学习目标是产生它的行动史。做法分三跳。第一跳,Blinded Critique 在可比数据与评审条件下输出偏好、平局或弃权,TrueSkill 将其汇总为后验 $(\mu_h, \sigma_h)$,刻画比较性评估而非'假设为真的概率',证据不足不更新。第二跳,按评估覆盖度、不确定性、有效性与记录的进展计算有界假设权重,再经贡献者共享、重复抑制和科学族预算限制分配到贡献历史,即 $w_i=\min(W_{\max}, \sum_h b_{ih})$——无支持的份额不分配,仅凭祖先关系或参与身份挣不到信用。第三跳,损失只加在被支持的目标上:$\mathcal{L}(\theta) = -\sum_i \frac{\omega_i}{|U_i|} \sum_{u \in U_i} \log \pi_\theta(a_{iu} \mid x_{iu})$,其中 $U_i$ 是该历史中被记录贡献支持的助手 token 位置,工具观测和已知失败动作只作上下文、不直接进损失。与 RAFT/ReST-EM 只筛'好样本'的本质区别在于跨角色贡献追溯:一个假设的高分可以同时强化不同角色历史中的多个关键步骤。
方法步骤详情
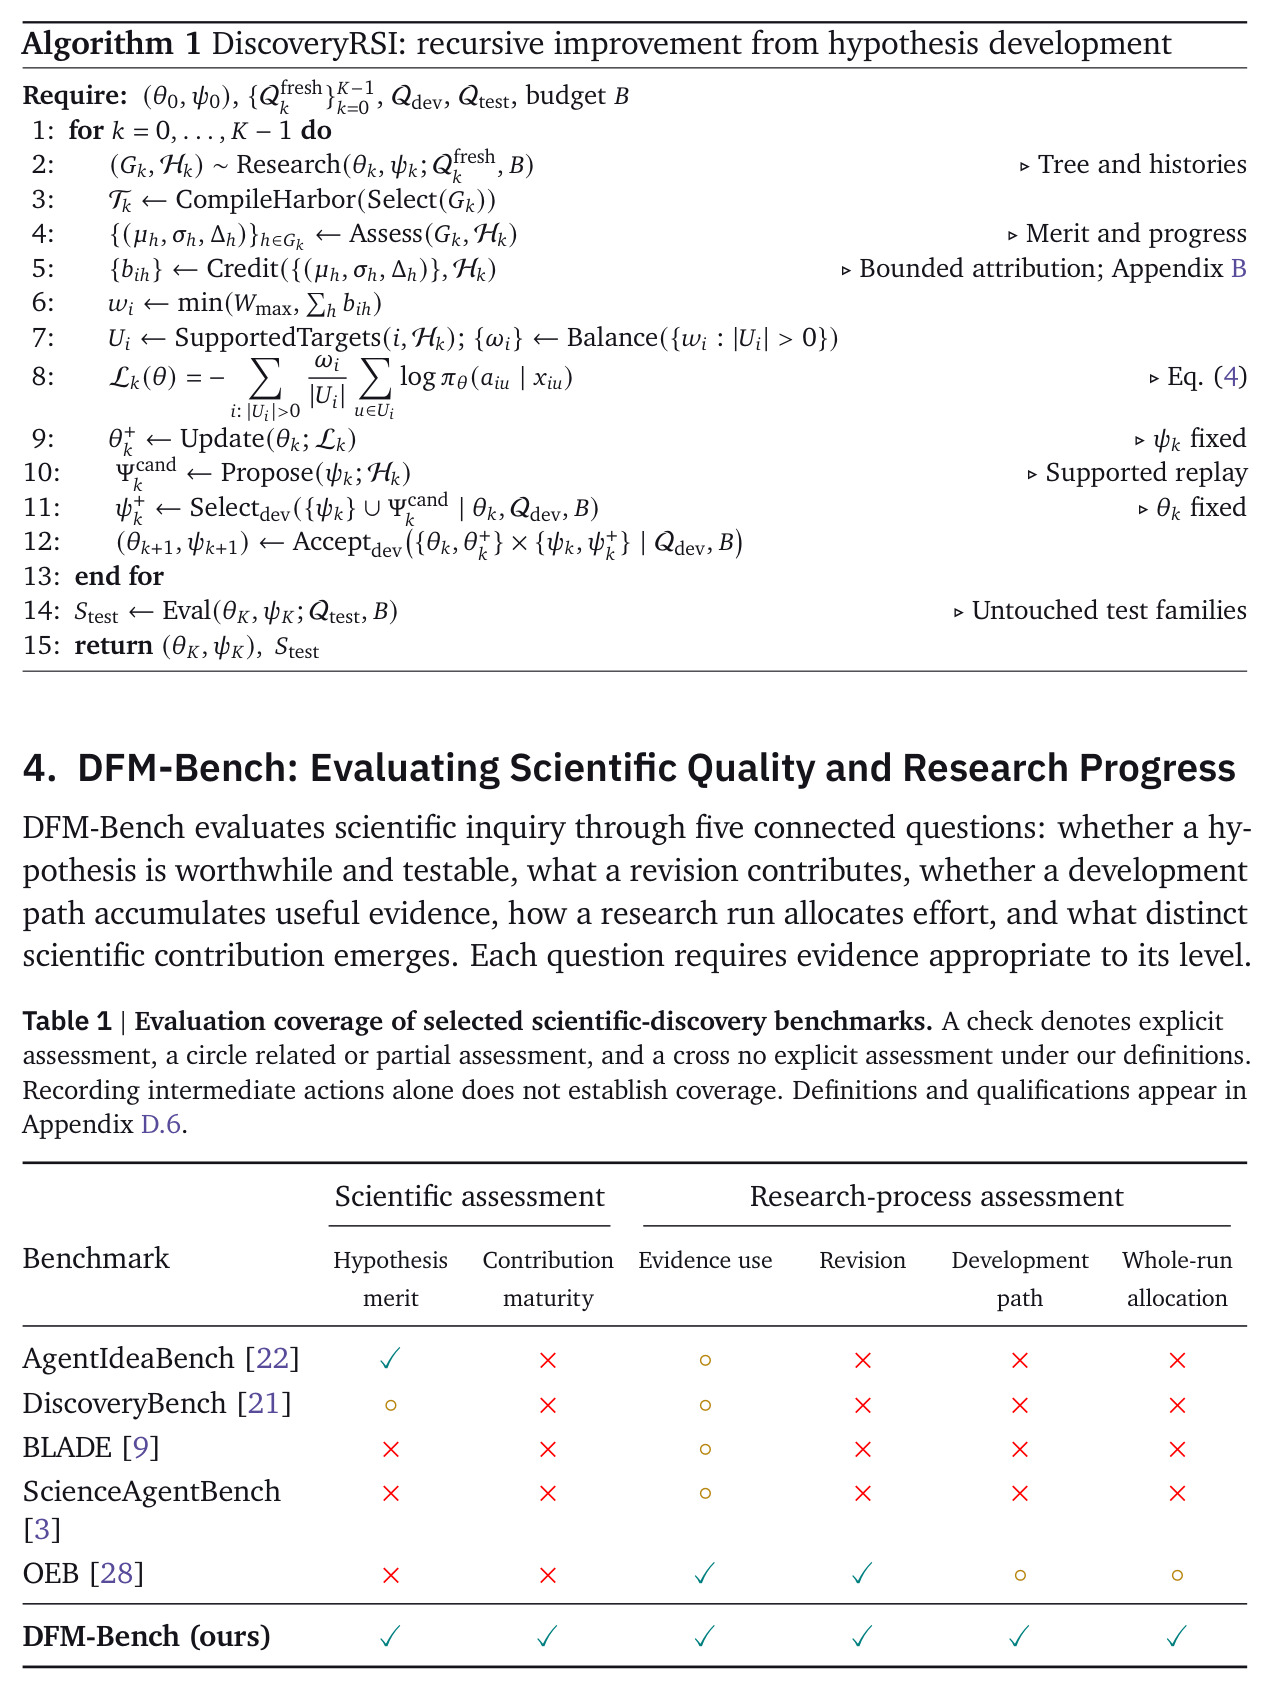
完整循环见 Algorithm 1,输入初始模型与脚手架 $(\theta_0, \psi_0)$、每轮新问题集 $Q^{fresh}_k$、开发集与测试集及预算 $B$。第 1 步研究采集:$(G_k, H_k) \sim Research(\theta_k, \psi_k; Q^{fresh}_k, B)$,得到假设树与行动史。第 2 步编译:Select 选出方案后 CompileHarbor 生成带输入、环境、产出、校验的可执行任务包,执行检查判定计算契约是否满足,科学评估另行判断调查能确立什么。第 3 步评估:Assess 为每个假设输出 $(\mu_h, \sigma_h, \Delta_h)$,其中 TrueSkill 由比较数据驱动——$z_h \sim \mathcal{N}(\mu_{h,0}, \sigma^2_{h,0})$,$t_{h,e} \mid z_h \sim \mathcal{N}(z_h, \beta^2)$,$P(a \succ b \mid z_a, z_b) = \Phi\big((z_a - z_b - \varepsilon)/\sqrt{2\beta^2}\big)$,后验近似 $\mathcal{N}(\mu_h, \sigma^2_h)$。第 4 步信用分配:Credit 产出 $b_{ih}$ 并汇总为 $w_i$,经领域与共享内存组平衡得 $\omega_i$,同时用 SupportedTargets 确定被支持的 token 集 $U_i$。第 5 步模型更新:在被支持位置上最小化加权负对数似然得候选 $\theta^+_k$。第 6 步脚手架回放:$\Psi^{cand}_k = Propose(\psi_k; H_k)$,在开发集与 $\theta_k$ 配对选出 $\psi^+_k$。第 7 步验收:$(\theta_{k+1}, \psi_{k+1}) = Accept_{dev}\{\theta_k, \theta^+_k\} \times \{\psi_k, \psi^+_k\}$,四个组合分别并联合评估。第 8 步再发现:被接受的系统回到新问题集,循环 $K$ 轮后在未触碰的测试族上做最终评估 $S_{test}$。
技术新颖性
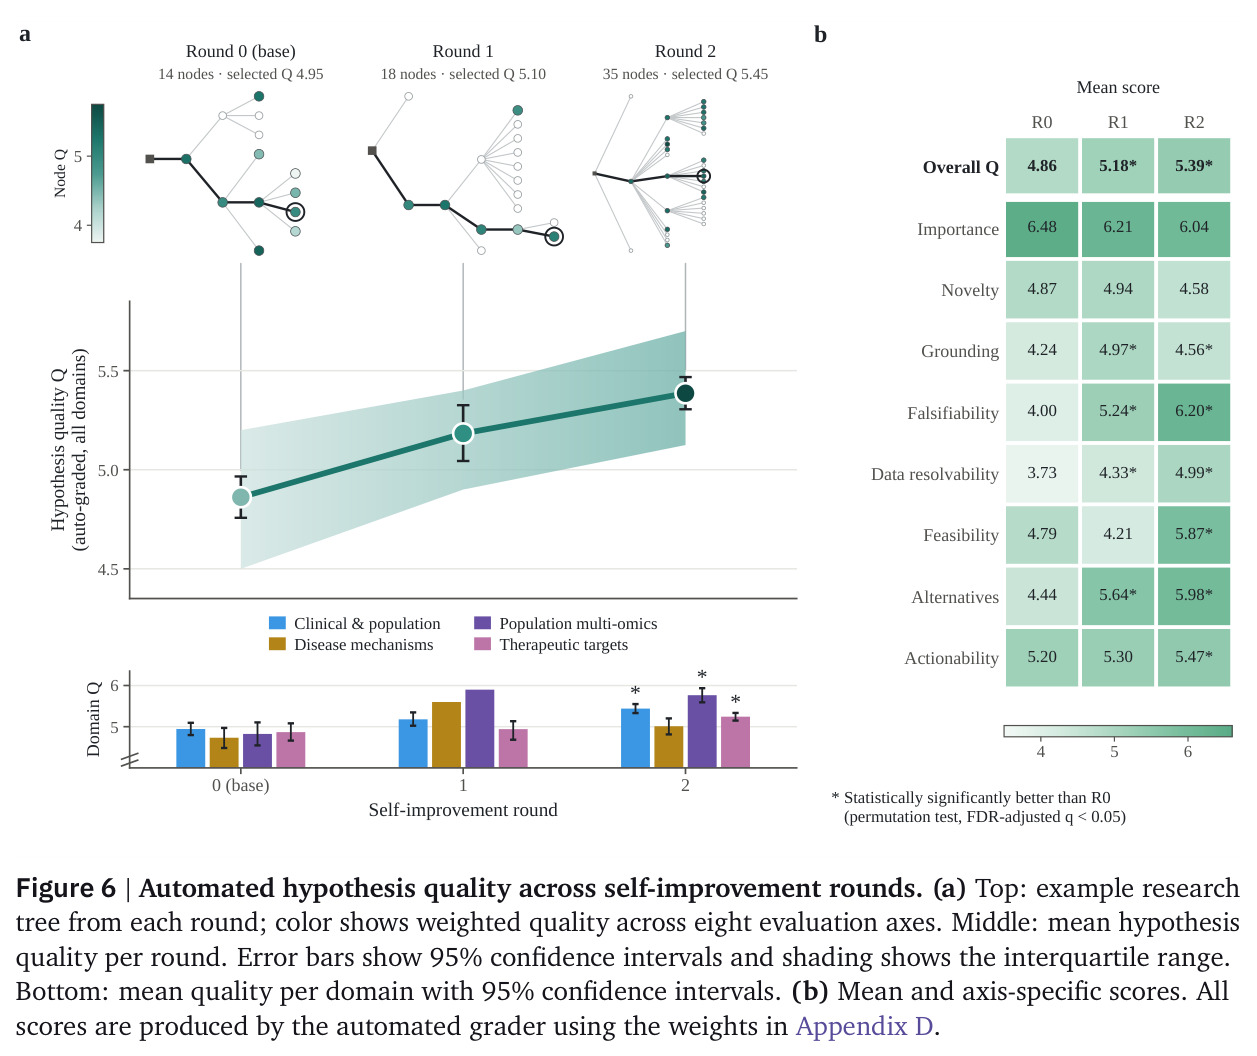
新颖性体现在四个层面。其一,评估对象创新:DFM-Bench 把假设、修订、发展路径、研究轮次、贡献族五级对象变成显式评估物,而 AgentIdeaBench、DiscoveryBench、BLADE、ScienceAgentBench 只覆盖其中一两项,OEB 也缺假设价值评估(Table 1 对比)。其二,归因机制创新:用有界信用与溯源要求把'评分属于假设、损失属于历史'连接起来,要求贡献必须落在被记录的具体行动上,抑制了搭便车学习。其三,双轨更新与验收:模型与脚手架各自产生候选并在开发集上与现任版本比较,可单独或联合更新,这与只改提示词(Reflexion/GEPA/ACE)或只改权重(RAFT/ReST-EM)的方法都不同。其四,概念上的防混淆设计:科学重启(同一研究轮内换方向)与再发现(换系统跑新一轮)被明确区分,开发族与最终评估族保持分离。实证上两轮自改进带来 4.86→5.39 的质量提升,行为从 21.7% 重启转向 91.7% 的深耕,说明学习确实改变了研究策略本身而非仅拟合评分。
实验结果
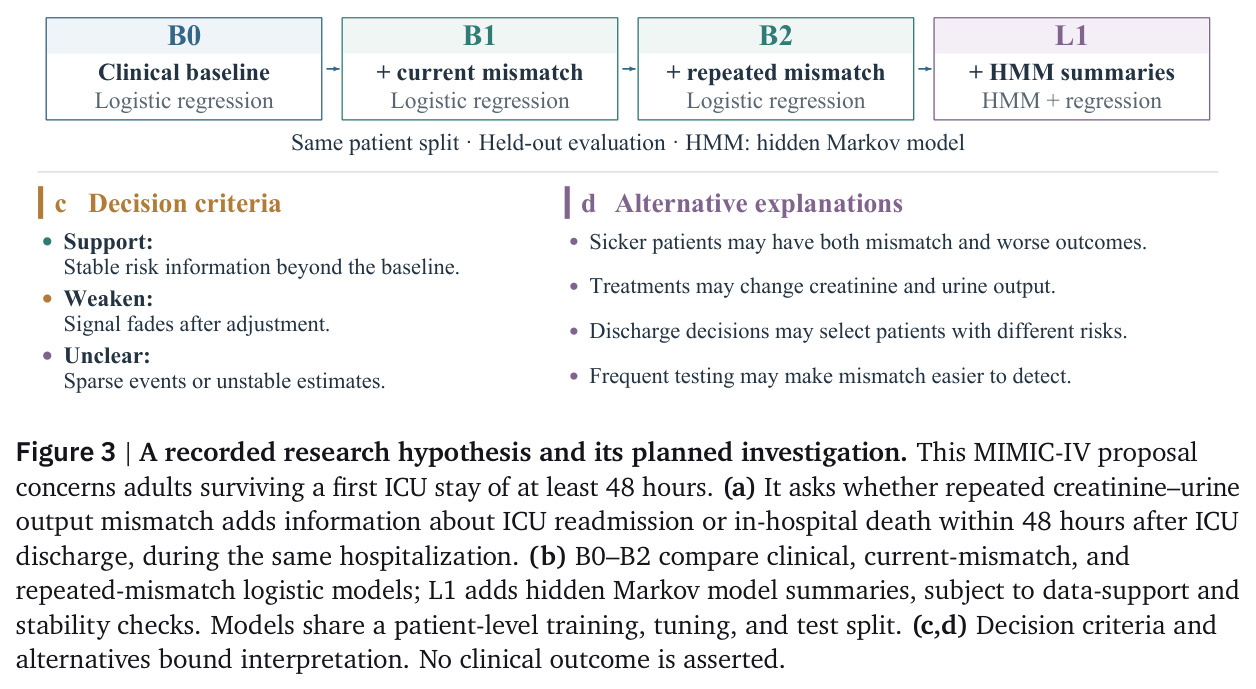
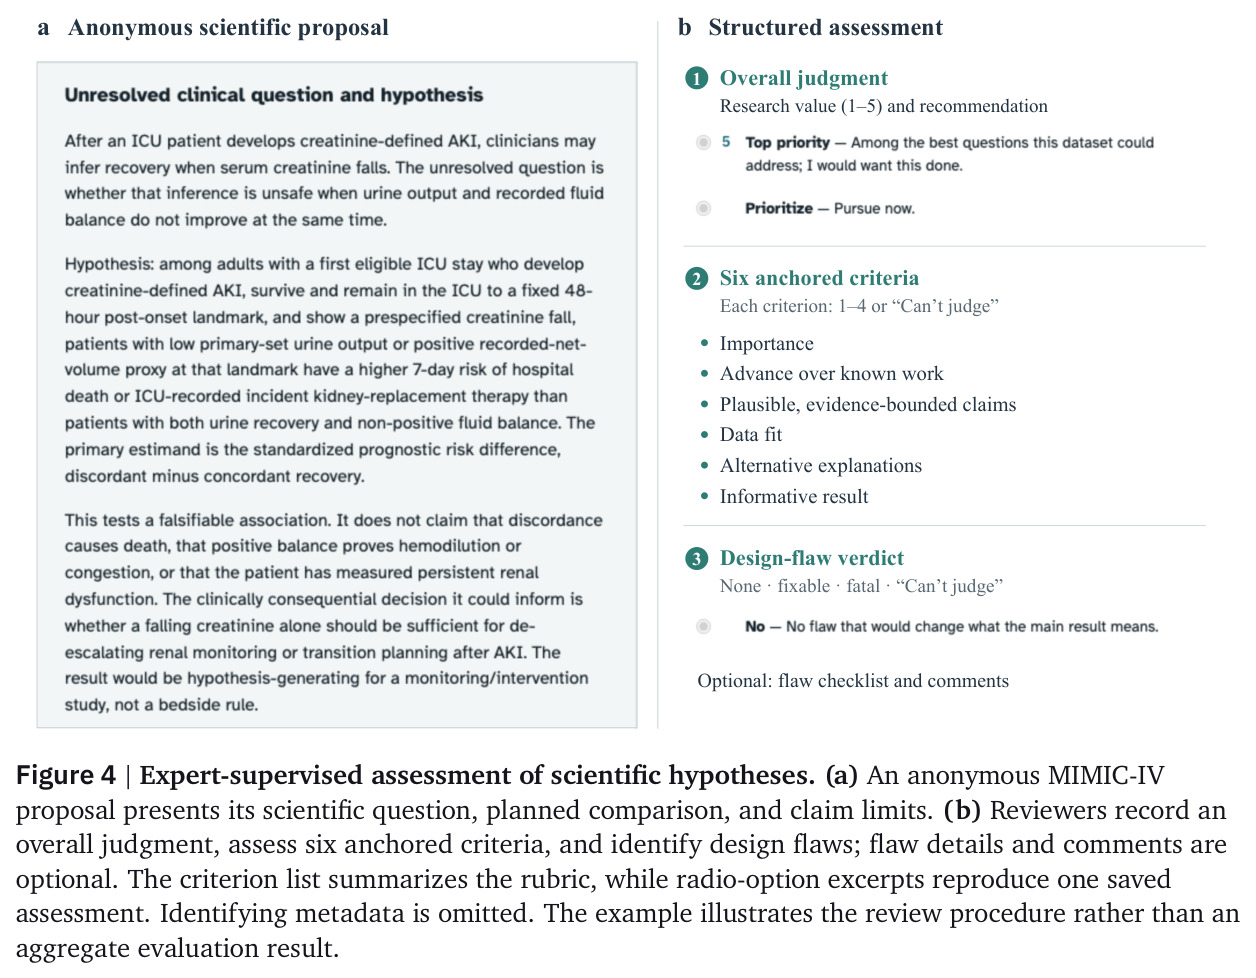
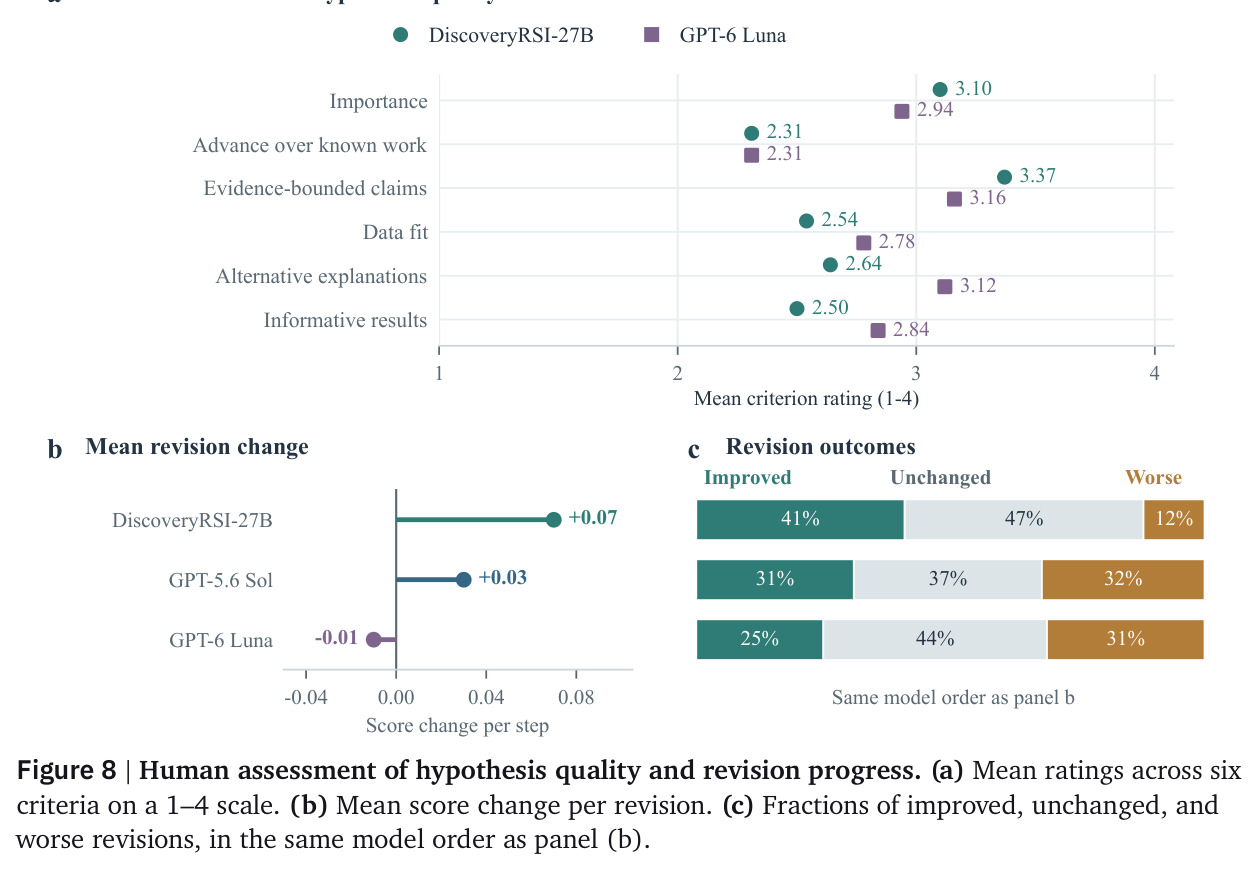
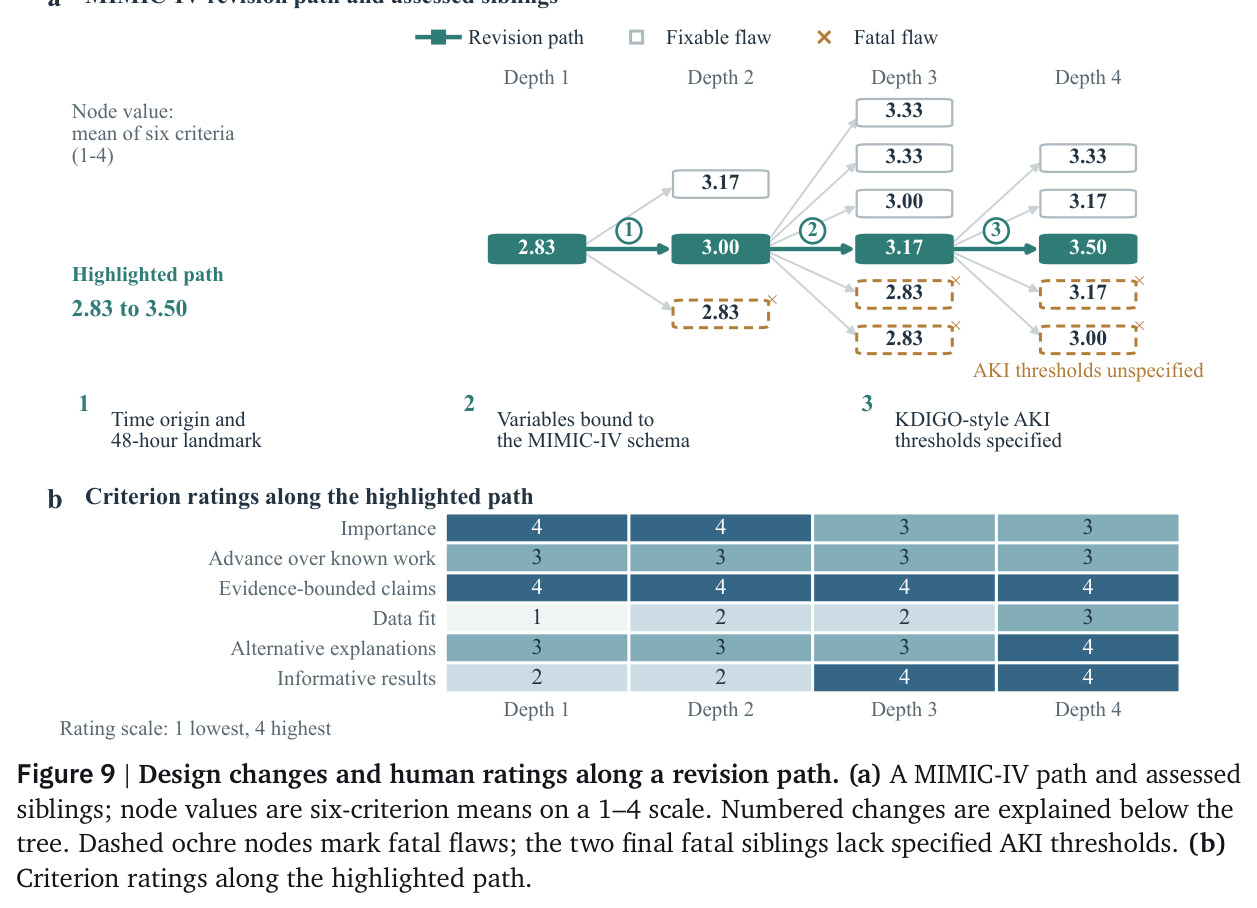
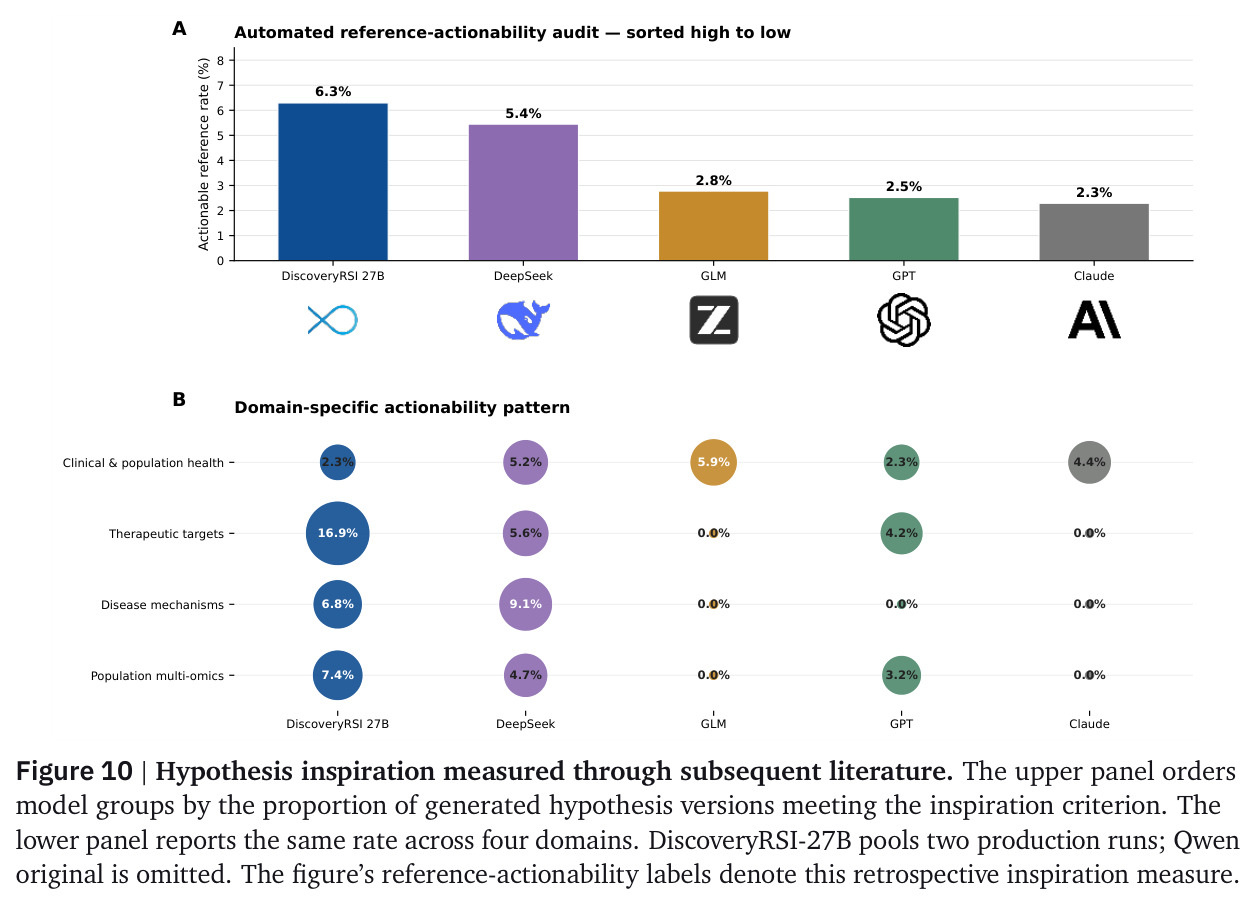
四个研究问题各有定量结论。RQ1(质量提升):GPT-5.6 Sol 自动评审、241 个问题、四个生命科学域下,平均假设质量从基座 4.86 升到第一轮 5.18、第二轮 5.39;四个域全部超越基座,增益从疾病机制的 0.28 到群体多组学的 0.94;分项上可证伪性 4.00→6.20、替代解释 4.44→5.98、数据可解性 3.73→4.99、可行性 4.79→5.87,但重要性 6.48→6.04、新颖性 4.87→4.58 下降——改进集中在'把研究做得可检验'而非问题更重要。RQ2(行为变化):evolve/repair 操作占比 77.5%→90.0%→91.7%,重启 21.7%→5.8%→5.0%;发展路径分上证据与推理纪律 +1.25 提升最大,技术探索 +0.34、科学连续性 +0.24,而学科连接 −0.28。RQ3(人工认可):27 名医学生物背景评审盲评 292 份提案,DiscoveryRSI-27B 每次修订平均 +0.07(GPT-5.6 Sol +0.03,GPT-6 Luna −0.01),修订改善/持平/变差比例为 41%/47%/12%;重要性 3.10 对 Luna 的 2.94、证据有界性 3.37 对 3.16 占优,但 Luna 在数据契合、替代解释、信息量三项更高;MIMIC-IV 示例路径六项均值从 2.83 升到 3.50。RQ4(文献启发):以截断后发表文献是否提供具体设计、对照、测量或可检验证据缺口为标准,1,176 个假设版本中 74 个命中,启发率 6.3%,高于 DeepSeek 5.4%(14/257)、GLM 2.8%(1/36)、GPT 2.5%(59/2,341)、Claude 2.3%(3/131);治疗靶点域最高达 16.9%。电池域泛化:200 回合、351 个假设,平均质量 5.61,实质进展率 58.47%(214/366),完整轨迹均分 81.52,识别出 20 个贡献族、7 个带诊断证据。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 假设质量(四生命科学域,两轮自改进) | 自动化平均质量分(10 分制,GPT-5.6 Sol 评审,241 问题) | 5.39(第二轮) | 4.86(基座模型) | +0.53(第一轮 +0.32,第二轮 +0.21) |
| 假设可证伪性 | 分项评分 | 6.20 | 4.00 | +2.20(八项分轴中增益最大之一) |
| 数据可解性 | 分项评分 | 4.99 | 3.73 | +1.26 |
| 人工评审修订增益(292 份提案、27 名评审盲评) | 每次修订的平均分变化(1-4 分制六项均值) | +0.07 | GPT-5.6 Sol +0.03;GPT-6 Luna −0.01 | 修订改善比例 41% 对 31%/25% |
| 后续文献启发率(截断后文献佐证) | 命中假设版本比例 | 6.3%(74/1,176) | GPT 2.5%(59/2,341)、Claude 2.3%、DeepSeek 5.4%、GLM 2.8% | 绝对领先 0.9-4.0 个百分点 |
| 电池域泛化(DFM 五级评估) | 平均假设质量 / 实质进展率 | 5.61 / 58.47%(214/366) | 无直接对照(首轮面板) | 验证流程跨域可迁移 |
局限与改进
作者承认的局限:自动化评审完全依赖 GPT-5.6 Sol 一个判卷模型,存在评审偏置风险;文献启发率是回顾性描述统计,各模型组的样本量、领域构成、时间截断与检索覆盖不同,多个版本可能同属一个研究族,需要前瞻追踪才能确认研究者真的采纳了这些假设;人工评审显示绝对分数仍有短板,GPT-6 Luna 在数据契合、替代解释、信息量三项上得分更高;重要性 6.48→6.04 与新颖性 4.87→4.58 随轮次下降。我自己的观察:第二轮增益(0.21)小于第一轮(0.32),呈递减趋势;训练仅 2.12% 的 token 受监督,信用分配规则(预算上限 $W_{\max}$、科学族限制)的敏感性未做消融;重启从 21.7% 骤降到 5.0% 可能意味着探索收缩,长期是否损失问题多样性未知;假设只编译到 Harbor 任务层面,完整执行与湿实验验证尚未闭环;Claude 2.3% 的低启发率部分源于提案格式导致检索门槛通过率仅 11.5%(DiscoveryRSI-27B 为 30.2%),用标题查询即可把通过数从 15 提到 95,跨模型比较的公平性存疑。
独立分析的弱点
弱点一:单一 AI 评审。所有自动化质量分都出自 GPT-5.6 Sol,若其偏好某种写作风格,训练与评估会形成同源偏置;改进方向是用多评审模型池交叉验证,或引入人工锚定校准集。弱点二:信用分配规则较启发式。$w_i$ 依赖评估覆盖度、家族预算等手工设定,论文未报告对 $W_{max}$、贡献共享比例等超参的敏感性分析;可做系统消融或学习化的信用分配。弱点三:数据效率低。15,792 条轨迹只产出 2,397 条可用训练数据(约 15%),只有 2.12% 的 token 受监督,意味着扩展轮次需要海量高质量研究回合;可探索更宽松的序列化策略或离线轨迹增强。弱点四:探索-利用失衡风险。重启操作从 21.7% 降到 5.0%,短期分数上升但可能牺牲长期多样性,建议监控跨轮问题分布的熵并设置探索预算下限。弱点五:文献启发率度量易受格式干扰,Claude 案例显示检索门槛对提案长度(中位数 41,134 字符,仅取前 6,000)敏感,需要检索无关的标准化协议。弱点六:闭环缺失,编译的 Harbor 任务只有部分真正执行,'发现→验证→修正'的最后一步仍依赖人工与后续工作。
未来方向
作者提出的方向:用求解器与 RSI-Anything 这类预测世界模型框架真正执行、评估并提炼被选中的假设,把工作从'到达具体假设与编译方案'推进到'完成调查';引入湿实验验证,并研究如何把支持性、阴性、不确定的实验结果都转化为研究决策的改进;把假设发现与 DFM-Bench 扩展到更多科学领域,检验能力泛化。基于成果可延伸的:把假设信用优化与过程奖励模型(PRM)结合,让评分器本身随轮次进化而非固定用 GPT-5.6 Sol;对脚手架回放做系统化的失败模式分类库,沉淀可迁移的科研工作流先验;研究两轮以上自改进的增益递减规律(0.32→0.21),探索课程化的问题生成以维持增益;检验'深耕代替重启'这种行为迁移在开放式探索任务上是否同样有利;以及把文献启发率改造成前瞻性注册-追踪实验,直接度量真实学术界对生成假设的采纳。
复现评估
论文提供了代码(GitHub)、模型权重(HuggingFace)与网站 DiscoveryRSI Arena,开源诚意较好;DFM-Bench 的评估协议、附录 B/C 的信用分配与序列化规则、附录 D 的评分权重都写得相当具体,附录 F 还公开了文献启发率度量的语料构建方法(420 次引文遍历、17,790 条引文边、16,440 篇解析文献)。但复现门槛不低:训练需要 27B 模型在 256K 上下文下的全参微调,2.9 亿 token 的数据量意味着多节点 GPU 集群;数据方面 MIMIC-IV 需 PhysioNet 认证、UK Biobank 需正式申请、eICU 有准入流程,GEO/ArrayExpress 与电池老化数据集相对易得;评估依赖 GPT-5.6 Sol API 有持续成本。最难点是人工评审环节——27 名医学生物背景评审加 3 名资深监督的组织成本几乎不可复制,普通团队只能复用其自动化部分。总体判断:推理与评测部分中等偏易可复现,完整训练与验收闭环属于大算力工程项目。
论文图表
完整伪代码:输入 $(\theta_0, \psi_0)$、新问题集、开发/测试集与预算 $B$;每轮执行研究采集得 $(G_k, H_k)$,编译 Harbor 任务,Assess 输出 $(\mu_h, \sigma_h, \Delta_h)$,Credit 做有界归因并平衡为 $\omega_i$,在受支持 token 上最小化加权负对数似然更新 $\theta^+_k$,Propose 与 Select 在固定 $\theta_k$ 下更新 $\psi^+_k$,Accept 分别并联合验收,$K$ 轮后在未触碰测试族上评估 $S_{test}$。
方法论的权威总结:三机制如何按顺序衔接、验收发生在哪些位置、测试集如何隔离,实现者照此即可搭建完整流水线。