Dream-RSI:通过演化世界实现递归自我改进 Dream-RSI: Recursive Self-Improvement through Evolving Worlds
把探索历史变成回放模拟器,让智能体在梦境中低成本进化探索策略
前置知识
递归自我改进(RSI)
指自主智能体通过迭代循环改进自身组件的范式:生成候选方案、执行评估、吸收反馈、优化后续迭代,如此往复使系统能力自我放大。在算法设计、数学优化等发现型任务中表现为'发现循环'。本文进一步把循环搬到元层——改进'如何探索'的策略本身。
本文标题与目标就是 RSI。读者需要理解对象级发现循环与元层优化的区别,才能明白 Dream-RSI 改进的对象是探索策略而非候选解本身。
世界模型与 Dreamer
基于模型的强化学习思路:从历史交互数据中学一个环境动力学模型,策略的训练与评估在模型'想象'出的轨迹上进行,而不必反复与真实环境交互。Dreamer 系列是代表——智能体在学到的世界模型中'做梦',用想象经验低成本地改进策略。
Dream-RSI 的'梦境式策略改进'直接类比 Dreamer:发现历史树扮演世界模型(论文称 replay simulator)的角色,理解这一类比才能抓住方法的灵感来源。
离线策略评估(off-policy evaluation)
只用已记录的历史交互数据(日志)来评估一个新策略的期望回报,而不实际部署它与环境交互。关键难点在于历史数据由旧策略产生,新旧策略的动作分布不同,通常需要重要性加权或基于模型的回放来校正偏差。
在回放模拟器中测试备选探索策略本质上就是 off-policy 评估:理解它有助于认识确定性回放的偏差风险,以及这套方法的适用边界。
发现树(discovery tree)
Dream-RSI 组织历史的核心数据结构:根节点 $r$ 表示初始工作区,每个非根节点代表一次'生成-评估'尝试,保存继承的工作区快照、生成产物、评估诊断与得分 $s_v$;子节点从父节点的工作区续作。探索策略的动作就是从可选节点集(根与当前叶)中选出批次继续扩展。
回放模拟器完全构建在发现树之上:树的结构决定了哪些备选策略可以被回放评估,是读懂第 3 节形式化推导的前提。
研究动机
递归自我改进(RSI)的核心是一个'生成候选—评估—反馈—再生成'的发现循环,随着智能体能力增强,发现越来越依赖跨越数千次提议-评估循环的长程探索。现有系统的探索策略基本靠手工设计且在整个发现过程中保持固定(如 AlphaEvolve、OpenEvolve、SimpleTES 等进化式发现系统),无法从累积的发现经验中改进,还可能反复把算力浪费在无效方向上。近期工作(如 EvoX)尝试在发现过程中在线优化探索策略,但面临两个根本瓶颈:一是元级反馈延迟且昂贵——评估一个探索策略不能只看单个候选,必须观察它如何塑造后续许多轮提议-评估循环;二是元策略空间巨大,新策略可能表现很差,往往需要试很多备选。代价可以从 SimpleTES 看出:它在 Lasso 求解任务上用了 51,200 次生成才取得强结果,探索层的低效正是长程发现的主要成本来源。
本文的目标是本文的目标是构建一个可扩展、可递归自我改进的元探索框架:让探索策略本身成为可编程、可优化的对象,并在不改变底层编码智能体与评估器的前提下,解决'策略评估反馈延迟、昂贵'的元层优化难题。具体而言,作者希望做到三点:其一,把分支、并行、停止等探索决策从编码智能体中剥离出来,变成一个轻量编排层显式控制的策略代码;其二,提供一种低成本、即时反馈的机制来评估和改进候选探索策略,避免每个候选都要跑一次完整的长程在线部署;其三,保证改进过程单调不退化——新策略在历史回放上的平均得分不差于当前策略——并在算法工程、数学优化、GPU 核工程等多个真实发现任务上同时提升发现质量与计算效率。
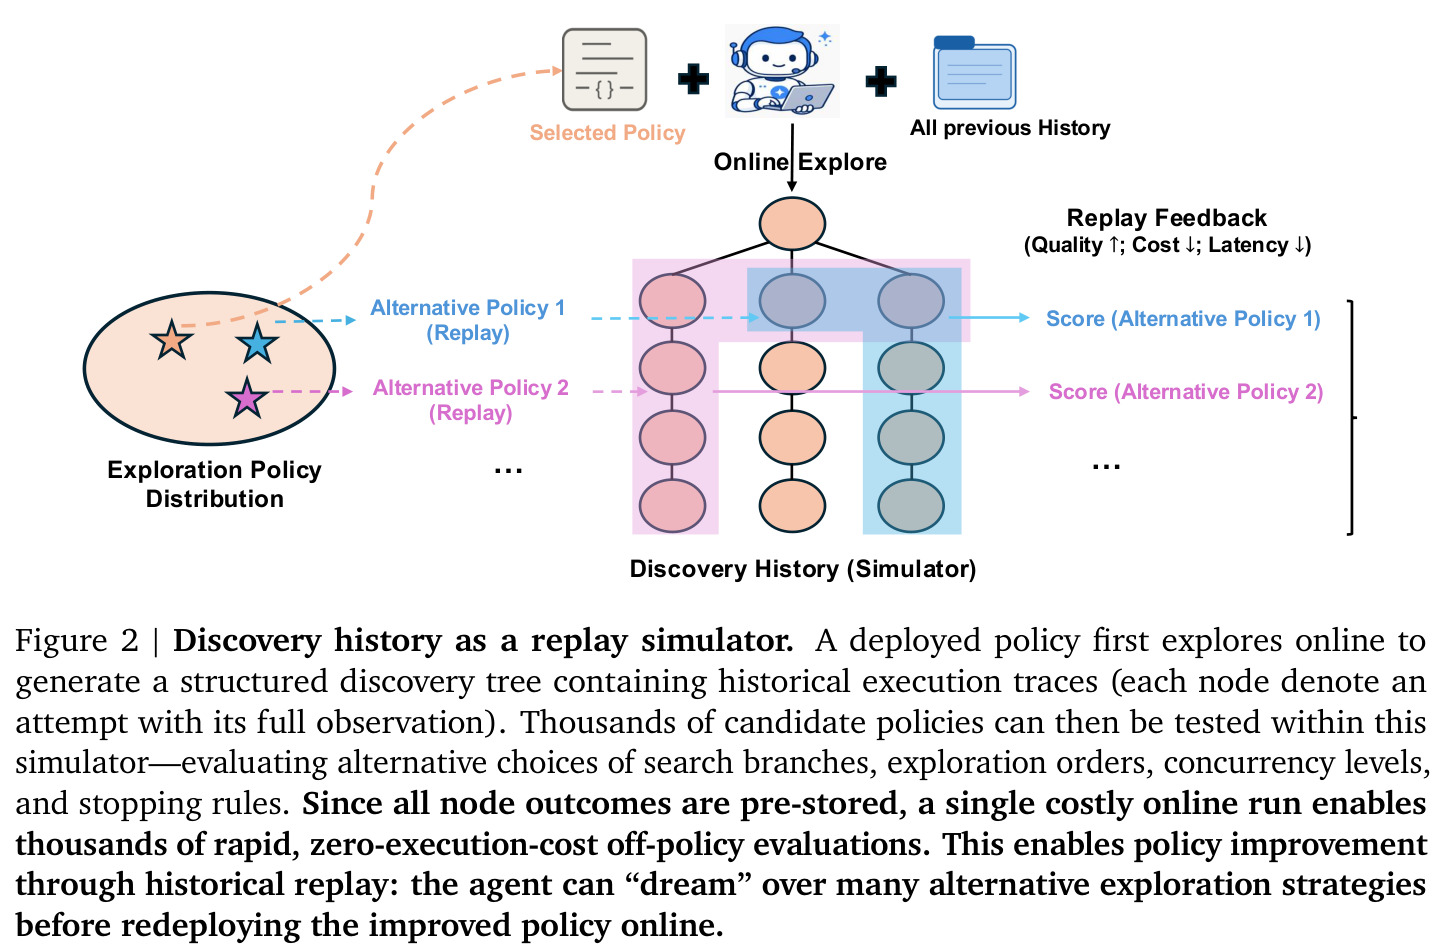
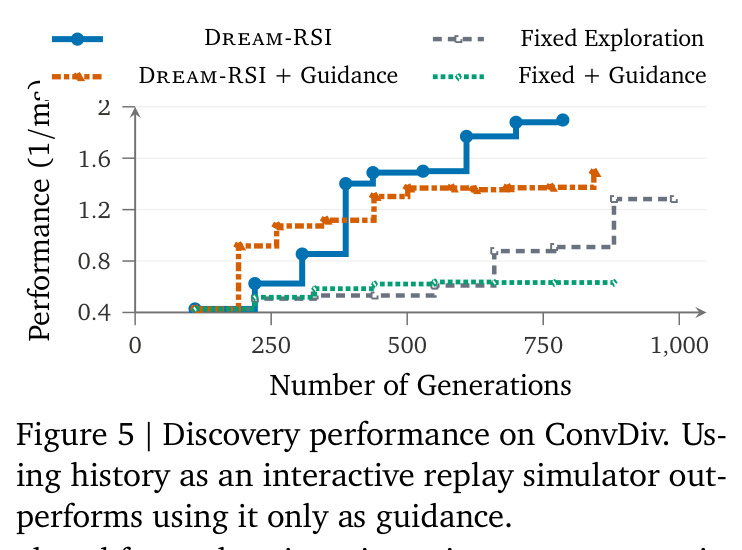
与已有工作不同的是,已有工作对发现历史的利用方式主要有两种:把它当作静态文本上下文注入提示(如把以往轨迹摘要成方向性洞见),或作为权重微调的训练数据。本文的独特切入角度是第三个选项:把已完成的发现历史组织成结构化的发现树,将其视为一个'回放模拟器'(replay simulator / 世界)。由于树中每个节点都保存了完整的执行结果(文件系统快照、生成产物、评估诊断、得分 $s_v$),任何备选探索策略都可以在这棵预录制的树上'重走'不同的分支子集、不同的顺序、不同的并行分组和停止时机,而评估该策略只需读取已存储的记录,完全无需重新运行昂贵的发现智能体。论文的消融实验(Figure 5)进一步证明这种交互式模拟器用法一致优于把历史仅当作提示引导,这是与记忆/上下文类方法的本质区别。
核心方法
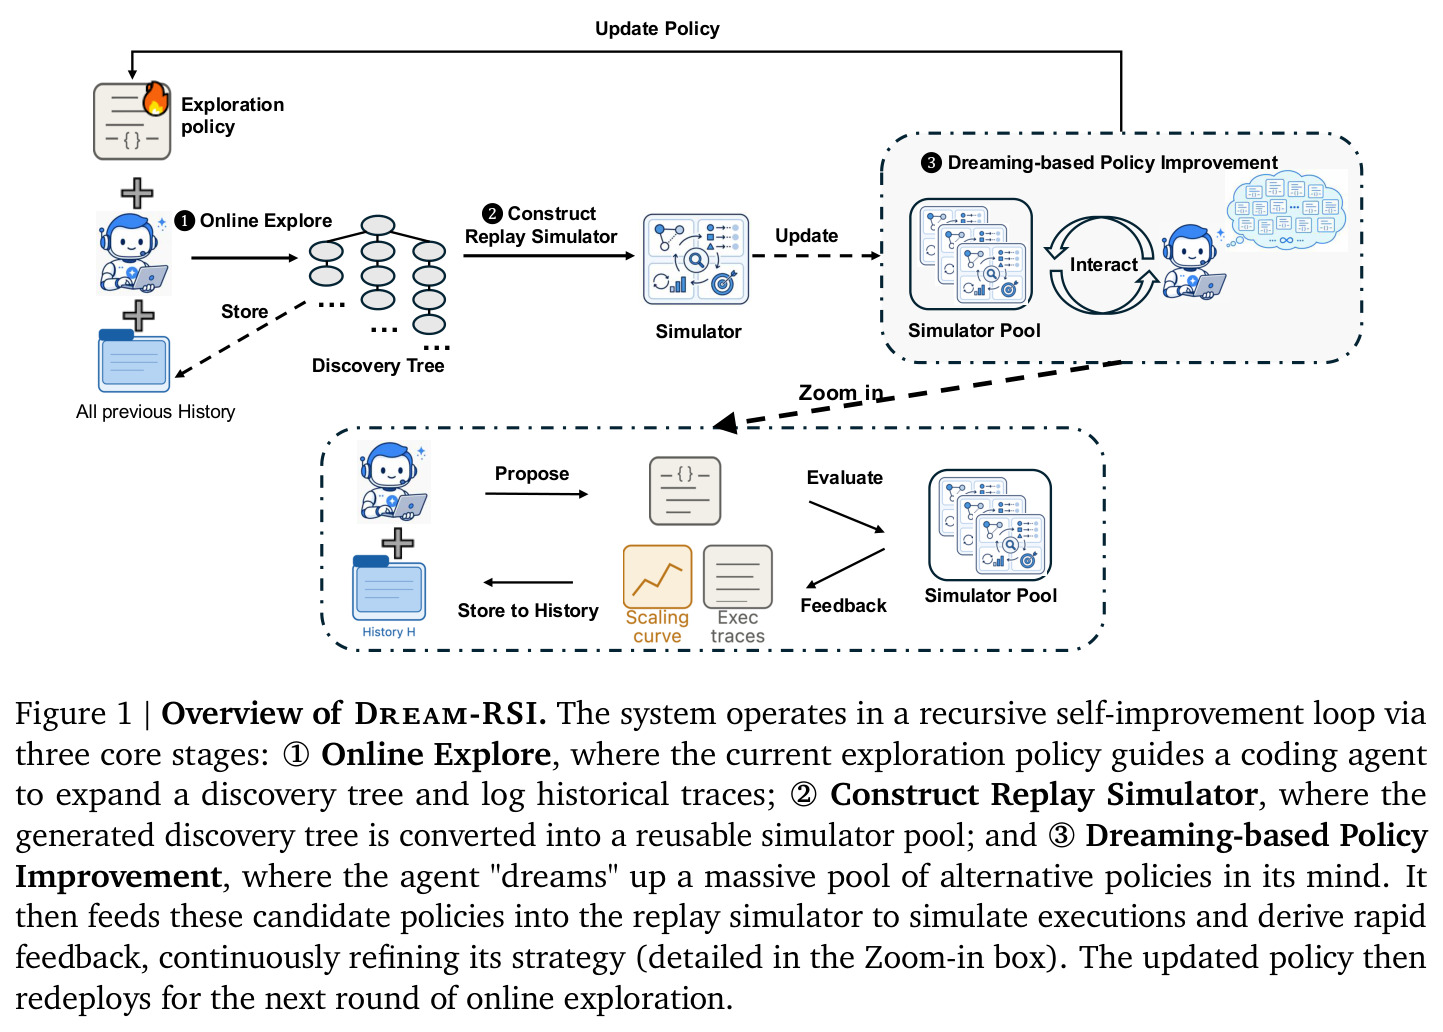
直觉上,这就像一个智能体首次在陌生环境中导航:它可能走弯路、碰壁、折返,但走完之后得到的地图可以复用——新策略可以在地图上规划路线、避开死胡同、重新考虑早期决策,而不必亲自重走每个位置。这正是基于模型的强化学习(Dreamer 系列)'在想象中训练策略'的思想。落到技术上,Dream-RSI 由一个轻量编排层驱动闭环:第 1 步在线探索,当前策略 $\pi_t$ 指导固定的发现智能体扩展发现树并记录全部执行痕迹;第 2 步模拟器构建,把生成的发现树转成可复用的回放模拟器池;第 3 步梦境式策略改进,策略开发智能体在模拟器中'做梦'——生成大量候选策略并用历史记录快速评估打分,选出最优者部署到下一轮在线探索。如此循环,模拟器池随历史增长不断扩张,形成元探索层的 RSI。整个过程中底层模型(Gemini-3.1 Pro 或 Gemini-3.7-Flash)、评估器与执行接口始终固定,只有探索策略代码在进化。
核心创新是'历史即回放模拟器'。回放与在线执行共用同一决策接口:策略面对已揭示的树 $\mathcal{T}^{m,k}_{i}$,从可行批次集 $\mathcal{A}(\mathcal{T};W)=\{C\subseteq\mathcal{A}(\mathcal{T}):|C|\le W\}$ 中选动作,区别只在转移函数——在线转移随机生成新子节点,回放转移则确定性揭示树中已记录的子节点。策略版本 $m$ 在历史树 $i$ 上的回放评分为 $$V^{m}_{i}=\max_{v\in\mathcal{T}^{m,k^{\star}_{m,i}}_{i}} s_{v}-\beta_1 N^{m}_{i}+\beta_2\frac{N^{m}_{i}}{\max\{1,k^{\star}_{m,i}\}}$$ 三项分别度量发现质量(路径最优得分 $s_v$)、执行成本(揭示的非根节点数 $N^m_i$,即代表的生成-评估请求数)与并行度奖励(每决策轮平均尝试数,奖励善于并行的策略)。每个版本在全部 $t$ 棵历史树上取平均得 $V_m$,选 $m^{\star}\in\arg\max_m V_m$;因候选集包含当前策略 $\pi^{t}_{0}=\pi_t$,自动满足 $V_{m^{\star}}\ge V_0$,保证改进单调不退化。
方法步骤详情
循环分三步。第 1 步在线探索:第 $t$ 轮中策略 $\pi_t$ 指导发现智能体,至多 $K_1$ 轮决策;每轮从可选节点(根 $r$ 与叶)中选出批次 $C^{t}_{k}\in\mathcal{A}(\mathcal{T}^{t}_{k};W)$,每个节点分配给一个并行 worker,智能体从该节点保存的工作区快照恢复上下文、生成新候选,评估器打分后把新子节点挂上树;选出空批次或达 $K_1$ 轮即结束,树 $\mathcal{T}^{t}$ 追加进历史 $\mathcal{H}_{t}$。第 2 步模拟器构建:历史树本身即模拟器池,已记录节点可在回放中被确定性揭示。第 3 步梦境式改进:从 $\pi^{t}_{0}=\pi_t$ 开始,策略开发智能体检视回放轨迹与得分,找出成功与失败模式,修订可执行策略代码得 $\pi^{t}_{m+1}$;每版本在每棵历史树上独立回放(至多 $K_2$ 轮;叶节点返回其唯一已记录子节点,根节点揭示最早创建的未展示分支),$M$ 个版本后按平均分 $V_m$ 选出 $\pi_{t+1}$ 部署上线。实验配置:Gemini-3.1 Pro 每轮 10 工作区 × 11 步 = 110 次调用,3.7-Flash 为 32 × 20 = 640 次。
技术新颖性
技术新颖性体现在四个层面。第一,把探索从隐式启发式变成显式可编程对象:分支、并行分组、停止规则全部由可执行的策略代码控制,底层编码智能体与评估器完全不动,这使'改进探索'成为定义良好的代码优化问题。第二,off-policy 的元层评估:与 EvoX 等在线优化搜索策略的方法相比,Dream-RSI 用一次昂贵的在线运行换取大量零执行成本的离线策略评估(论文称数千次),把元级试错从在线部署搬进模拟器,绕开了'每个候选策略都要跑长程 rollout 才有反馈'的瓶颈。第三,历史的用法从'上下文/记忆'升级为'可交互的世界':Figure 5 的消融显示,把历史抽象成方向性引导注入提示反而会过度约束搜索、一致劣于无引导基线,而回放式使用能提升性能。第四,带保证的选择机制:候选集包含当前策略,选择满足 $V_{m^{\star}}\ge V_0$,从机制上排除了策略退化。
实验结果
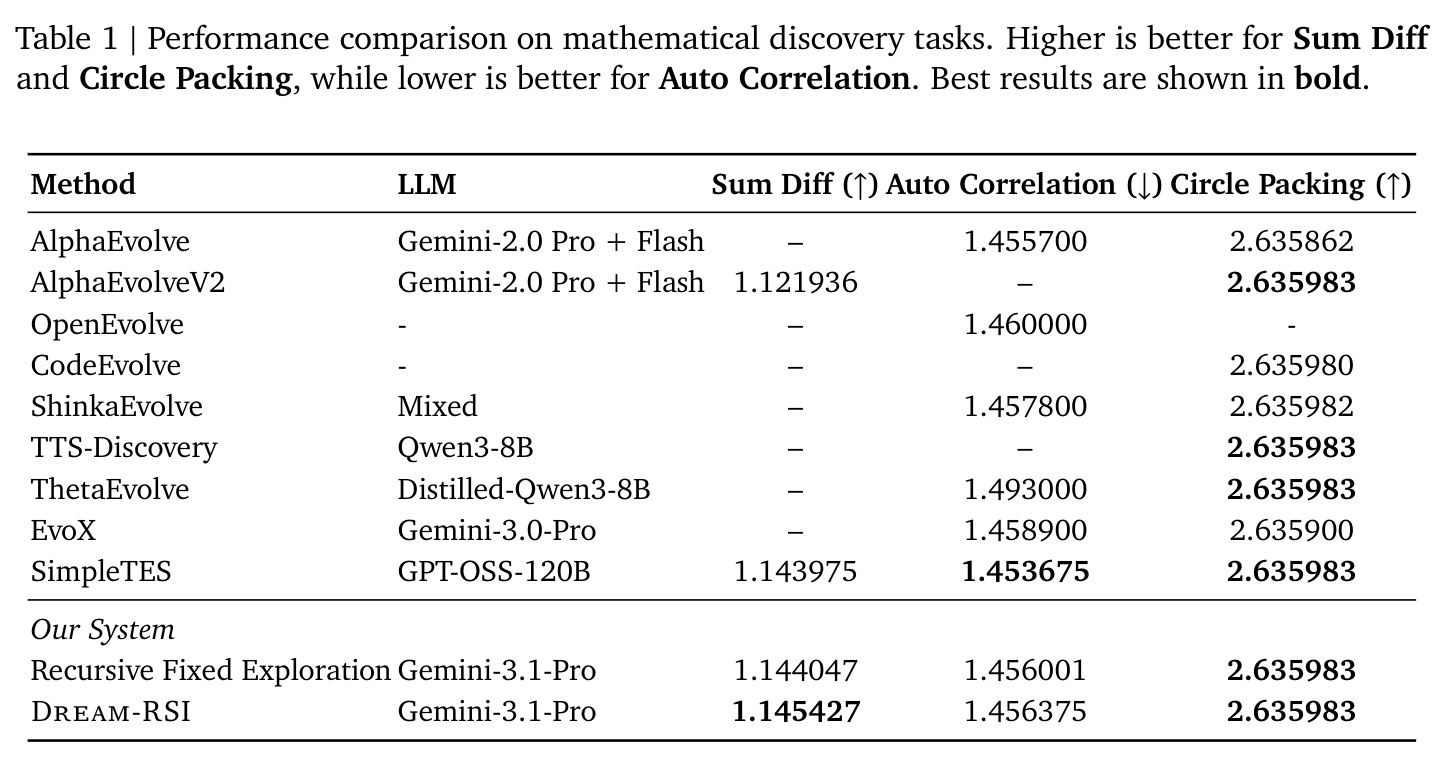
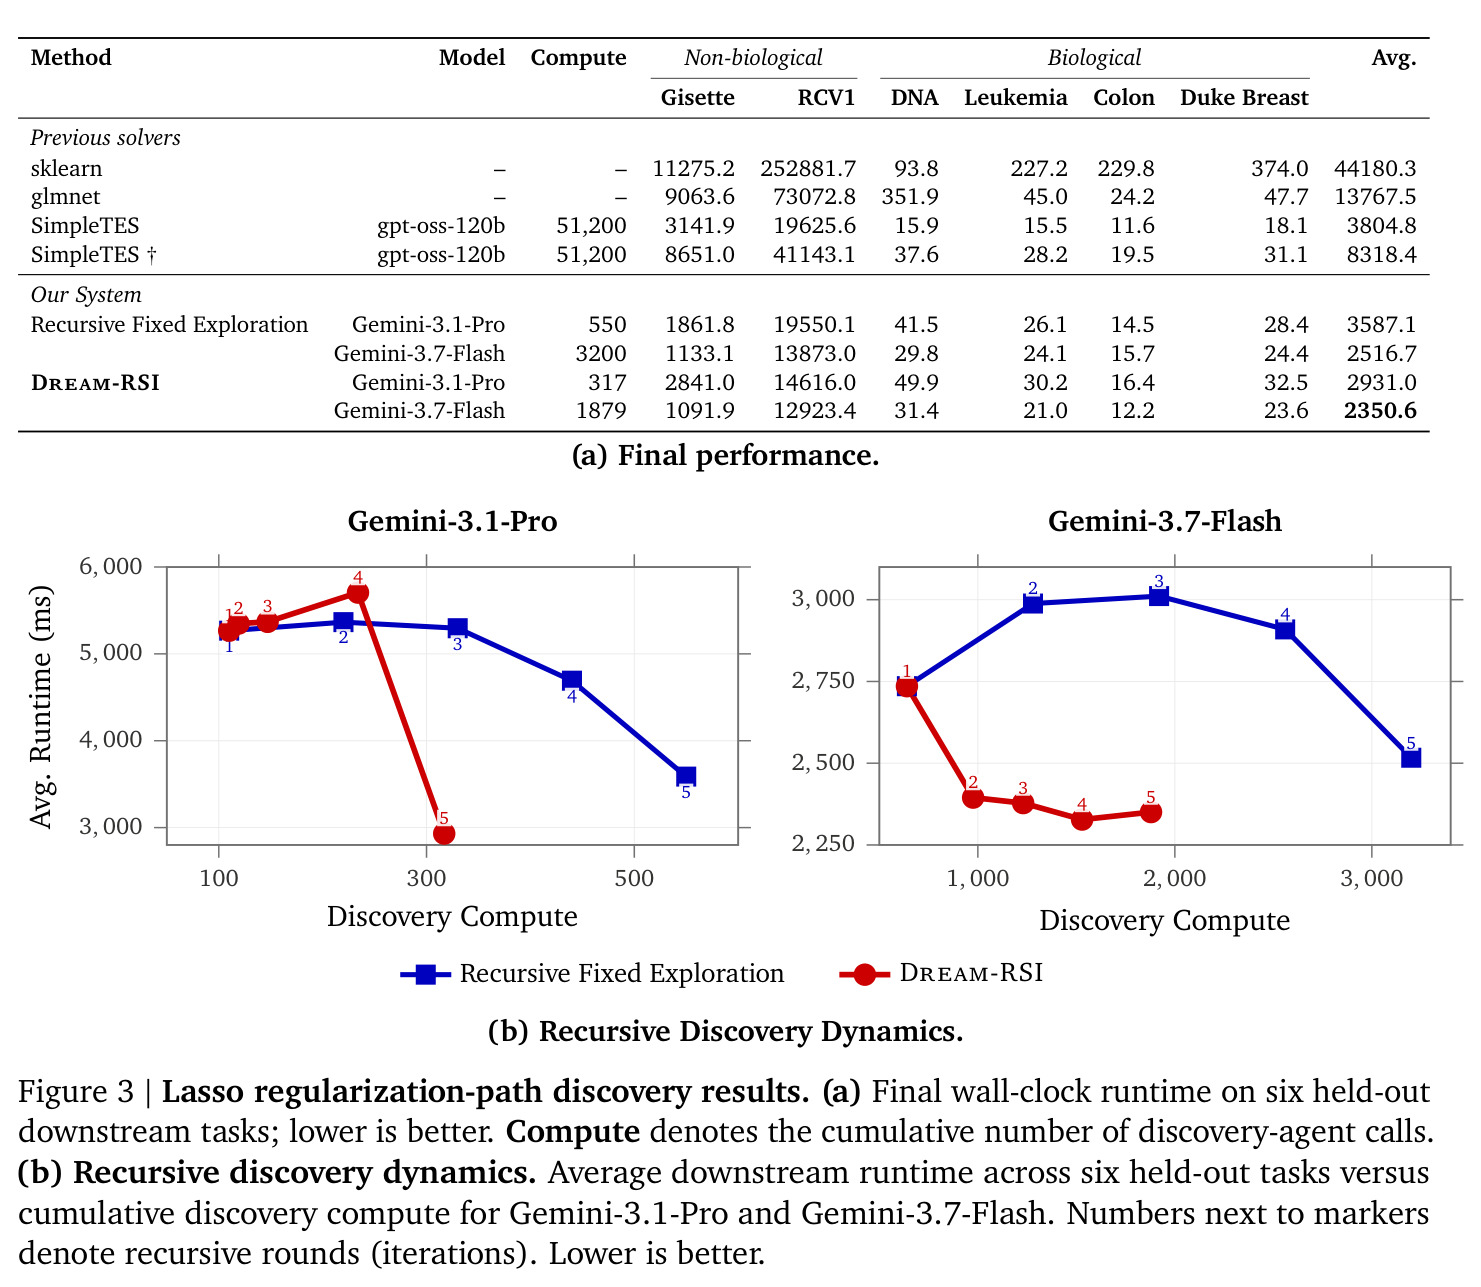
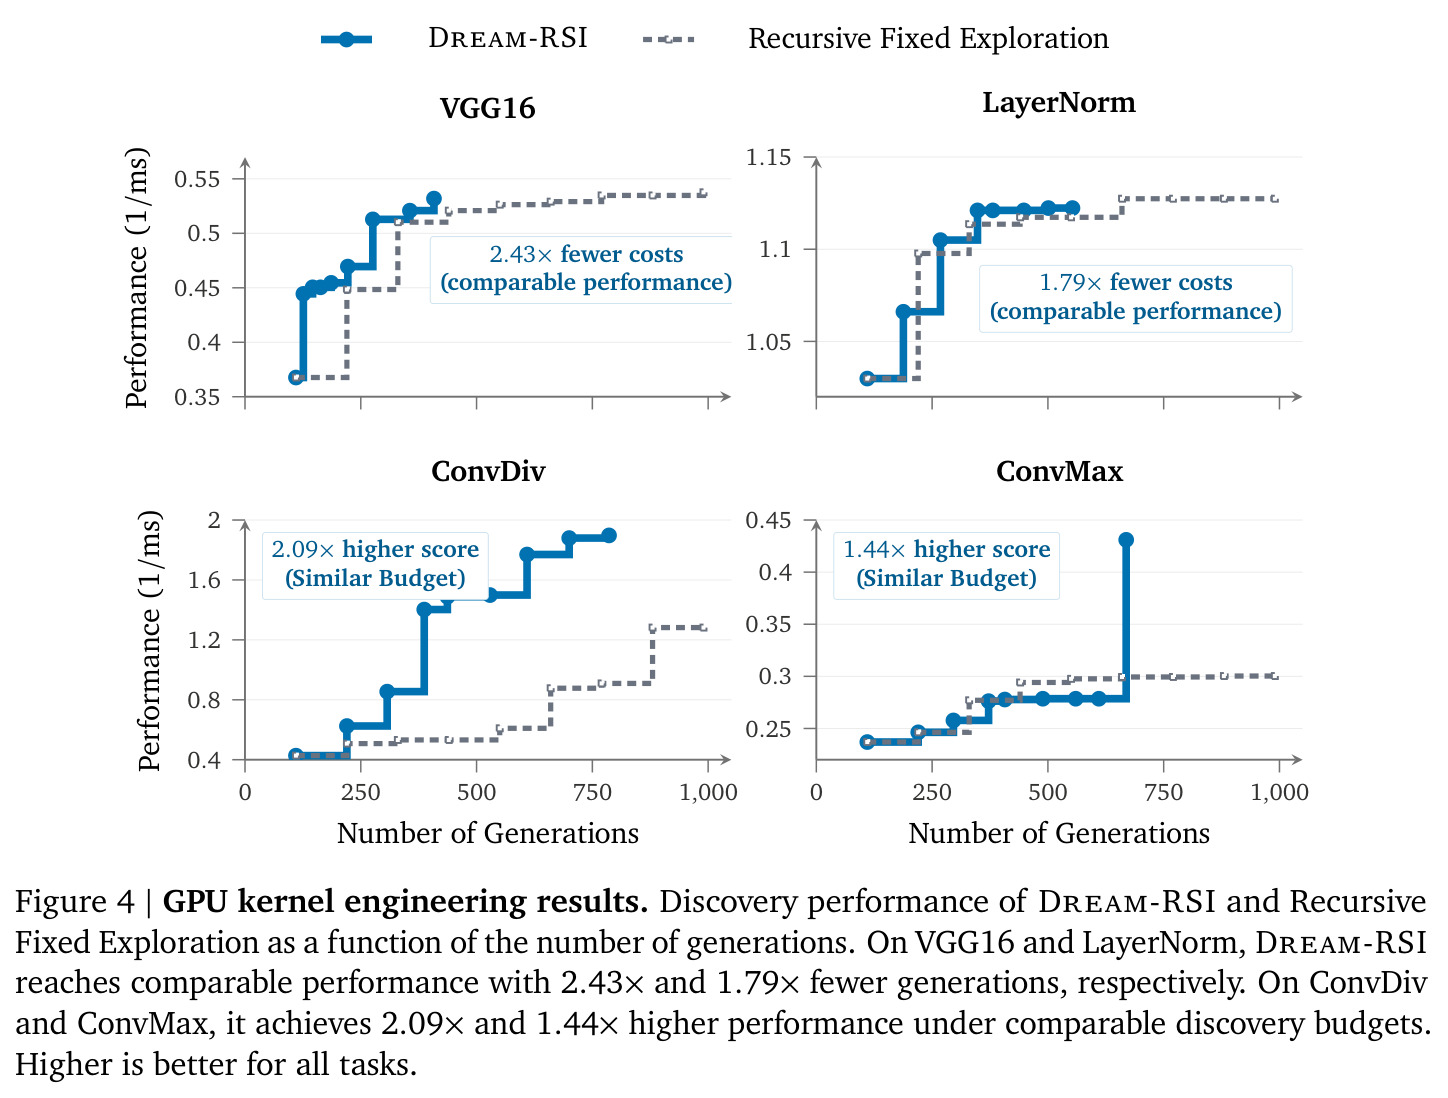
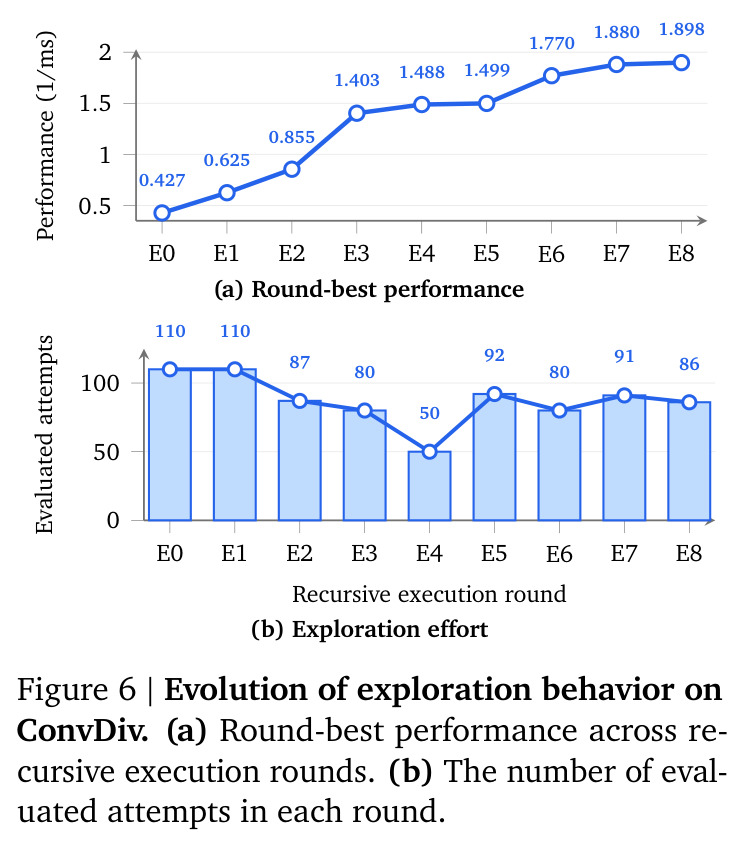
论文在 8 个发现任务、3 个领域上验证。Lasso 求解:Gemini-3.1 Pro 上仅用 317 次调用,把 6 个留出数据集平均求解时间从固定探索的 3587.1 ms 降至 2931.0 ms(固定探索用 550 次);Flash 上从 2516.7 ms 降至 2350.6 ms(1879 对 3200 次),且全部 6 个数据集优于 sklearn 和 glmnet;相对用 51,200 次生成的 SimpleTES,调用减少约两个数量级(最高 162×)。数学优化:Sum-Difference 得 1.145427(超过 SimpleTES 的 1.143975 与固定探索的 1.144047),Circle Packing 达 2.635983 与最强持平,Autocorrelation 得 1.456375,用不到 1,000 代完成,预算比 SimpleTES 的 51,200 代节省 50×。KernelBench:VGG16 与 LayerNorm 分别以 2.43× 和 1.79× 更少代数达到可比性能;ConvDiv 与 ConvMax 在相近预算下性能(1/ms)分别高 2.09× 和 1.44×。消融显示回放模拟器一致优于把历史当提示引导(Figure 5);Figure 6 显示学到的策略先收缩(110→50 次尝试)再在平台期扩张,对应轮最优性能从 0.427 升至 1.898 (1/ms)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Lasso 正则化路径求解(算法工程) | 6 个留出数据集平均运行时间 / 发现调用次数 | 2931.0 ms,317 次调用(Gemini-3.1 Pro) | 递归固定探索:3587.1 ms,550 次调用 | 调用减少约 1.7×,运行时间缩短约 18% |
| Lasso 求解 vs SimpleTES | 平均运行时间 / 发现计算量 | 2350.6 ms(Gemini-3.7-Flash,1879 次调用) | SimpleTES(gpt-oss-120b):3804.8 ms,51,200 次生成 | 调用减少约两个数量级(至多 162×),且运行时间更快 |
| Sum-Difference 数学优化 | 目标得分(越高越好) | 1.145427 | SimpleTES 1.143975;递归固定探索 1.144047 | 取得所有对比方法中的最优得分 |
| Circle Packing 数学优化 | 目标得分(越高越好) | 2.635983 | AlphaEvolveV2 / TTS-Discovery / ThetaEvolve 等为 2.635982–2.635983 | 与最强报告结果持平 |
| Autocorrelation 不等式 | 目标得分(越低越好)/ 生成代数 | 1.456375,用不到 1,000 代 | SimpleTES:1.453675,需 51,200 代 | 得分接近 SOTA,预算节省约 50× |
| KernelBench:VGG16 / LayerNorm 核发现 | 达到可比性能(1/ms)所需生成代数 | 分别减少 2.43× / 1.79× | 递归固定探索 | 同性能下计算量显著下降 |
| KernelBench:ConvDiv / ConvMax 核发现 | 核性能(1/ms),相近预算下 | 分别高 2.09× / 1.44× | 递归固定探索 | 同预算下性能显著提升 |
局限与改进
作者承认并可以观察到的局限:其一,回放模拟器只能覆盖'已实现的搜索空间',回放转移严格沿着已记录的父子顺序进行,无法产生 $\mathcal{T}_i$ 之外的新结果,因此对真正开辟全新方向的策略给不出评估信号——模拟器只能随在线探索而扩张,改进幅度受历史多样性约束。其二,回放是确定性的,而在线转移是随机的(同一工作区可能生成不同结果),这种分布偏移可能使离线最优策略并非在线最优,论文未给出偏差分析。其三,冷启动依赖手工初始策略,第一轮与固定探索行为完全相同,改进完全依赖历史积累。其四,式 (1) 中 $\beta_1,\beta_2$ 以及 $K_1,K_2,M,W$ 等均为固定系数,论文未提供这些超参的敏感性分析或消融。其五,实验每任务只跑 5–10 轮递归、每域任务数有限,底层模型固定为 Gemini 系列,向其他模型与更长程发现的扩展性尚待验证。
独立分析的弱点
独立分析四个弱点。第一,确定性回放 vs 随机在线的 gap:回放会系统性高估'在历史上恰好踩中好节点'的策略,长期可能导致对历史过拟合;改进方向是为回放子节点得分引入噪声模型,或对多棵结构相似的历史树做交叉回放取平均。第二,探索边界锁死:树只含已访问分支,策略无法在模拟中评估'更早放弃当前支线、开辟新支线'的价值,因为新支线在历史中不存在;改进方向是引入轻量生成式世界模型对未观测分支做低成本外推,形成'回放+想象'的混合模拟器。第三,评分函数较粗糙:式 (1) 只看最优得分 $s_v$、节点数与批大小,忽略了真实墙钟时间、失败诊断质量等异构成本;改进方向是让成本项按实际执行耗时加权。第四,改进只发生在编排层:发现智能体本身的推理能力不随循环提升,能力天花板未动;改进方向是把回放反馈蒸馏为底层模型的微调信号,形成编排层与模型层的双层 RSI。
未来方向
作者在结论中指出方向是把'从静态上下文到可回放模拟器'的思想推广到更广的元优化场景。在此基础上可延伸:其一,理论侧补上 off-policy 回放评估的偏差界与收敛性分析,刻画确定性回放相对随机在线转移的误差如何随历史树规模衰减;其二,把模拟器池从单任务扩展为跨任务共享,让在 Lasso 树上学到的探索策略迁移到 KernelBench 等新任务,实现任务间的元知识复用;其三,与进化算法的种群管理、主动学习结合,用回放分数决定在线预算在'利用已知支线'与'开辟新支线'之间的分配,缓解历史之外探索无法评估的问题;其四,向真实科学发现(湿实验、物理仿真)扩展——那里单次评估更昂贵,'先在历史世界做梦再上线'的价值更大;其五,让 $\beta_1,\beta_2$ 与停止规则自适应调节,甚至允许策略开发智能体同时修订回放评分函数本身。
复现评估
复现条件中等偏友好。论文给出代码仓库 github.com/zhengkid/Dream-RSI 与项目主页 dream-rsi.com。方法本体是一个轻量编排层,无需训练模型权重,主要成本是 LLM API 调用:单任务 5–10 轮递归,每轮 110(Gemini-3.1 Pro,10 工作区 × 11 步)或 640(3.7-Flash,32 × 20)次调用,总计数百到数千次生成-评估循环。数据与基准基本公开:Lasso 任务沿用 SimpleTES 的 17 个合成实例与 6 个留出数据集,GPU 核任务来自公开的 KernelBench(VGG16、LayerNorm、ConvDiv、ConvMax),三个数学优化任务的形式化定义在附录。主要障碍是依赖 Gemini-3.1 Pro / 3.7-Flash 的 API 访问(跨模型效果未验证),以及策略开发智能体的提示词与回放模拟器实现细节的完整程度;若仓库发布完整,研究生规模的团队即可复现。
论文图表