HypoEvolve:遗传算法驱动多智能体LLM发现科学假设 HypoEvolve: Genetic Algorithms Enable Multi-Agent LLMs to Discover Scientific Hypotheses
世代遗传算法协调专用LLM智能体进化科学假设,药物重定位任务全面超越六大基线
前置知识
遗传算法(Genetic Algorithm)
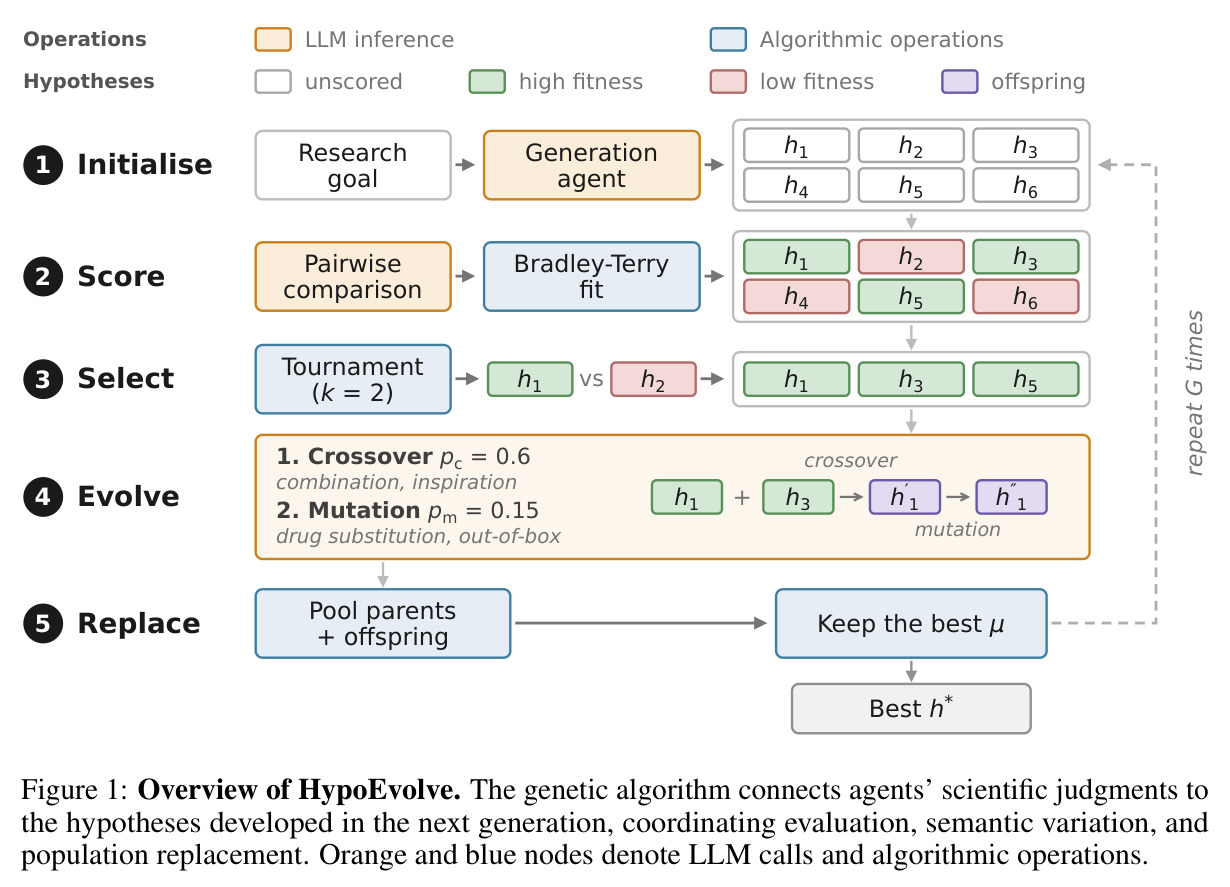
模拟生物进化的随机搜索算法:维护一个候选解种群,通过选择(优者更易繁殖)、交叉(两个父代组合出子代)、变异(对单个个体扰动)和替换(保留最优个体)不断迭代,使种群整体适应度逐代提升。本文采用世代(generational)模式:每代批量产生全部子代后再统一筛选进入下一代。
HypoEvolve 的整个搜索骨架就是世代遗传算法,只有理解选择、交叉、变异、替换四个算子各自的作用,才能看懂方法设计以及消融实验在检验什么。
Bradley-Terry 模型
一种把成对比较结果转换为潜在强度分数的统计模型:假设每个项目有正强度 $\pi_i$,则 i 胜过 j 的概率为 $\pi_i/(\pi_i+\pi_j)$。给定所有两两比较的胜负记录,可通过最大似然估计出各项目强度,从局部两两对比得到全局排序与连续分数。
论文中评分智能体只做两两比较,需靠 Bradley-Terry 把每代 167 次左右的比较聚合成种群适应度并锚定到可比尺度(均值 50、极差 60 分),这是评分机制的核心。
(μ+λ) 进化策略
进化计算中的一类替换规则:把 μ 个父代与 λ 个子代合并成同一候选池,按适应度统一排序后保留前 μ 个作为下一代种群。「+」意味着父代与子代同台竞争,新个体必须排进前 μ 才能存活,防止劣质后代稀释种群质量。
HypoEvolve 用 (μ+λ) 截断替换把比较判断与种群更替直接连接起来,是论文强调的关键设计,也是与 Co-scientist 扩张池方案的本质区别之一。
锦标赛选择(Tournament Selection)
一种父代选择策略:每次从种群随机抽出 k 个候选,取其中适应度最高者作为父代,k 越大选择压力越大。本文 k=2:随机抽两个假设取优者。六个严格排序的假设下,最强者赢约 1/3 的锦标赛,第五名也能赢 1/15,兼顾优选与多样性。
它决定哪些假设被送去做交叉与变异;论文的关键消融正是把适应度引导的锦标赛换成均匀随机选择,从而隔离出协作规则的因果贡献。
DepMap CRISPR 筛选
DepMap 项目用全基因组 CRISPR 敲除筛选,系统测量每个基因对各癌细胞系存活的必要性(依赖性分数)。本文的选择性指标是:某药各靶点在该癌症中的中位依赖性减去其泛癌中位依赖性,再取所有注释靶点中的最大值,以剔除「到处都必需」的基因带来的假高分。
DepMap 选择性是论文两个外部评价指标之一,理解它的构造才能明白实验如何客观检验 LLM 生成假设隐含的「靶点与该癌症相关」这一生物学主张。
Open Targets
一个整合遗传关联、文献挖掘、已知药物、临床试验等多通道证据的靶点-疾病关联数据库,为每个「靶点-疾病」对给出 0 到 1 的关联分数,分数越高说明现有证据越支持该靶点与疾病相关。各通道可拆分查看,例如遗传关联、文献、已知药物与临床试验。
它是与 DepMap 互补的第二外部指标,提供独立于 CRISPR 筛选的证据来源;论文按通道拆分后发现遗传关联证据上优势最大(+0.334)。
多智能体LLM科学发现系统
把生成、批判、综合、排序等科研角色分配给多个专门化的 LLM 智能体,各自用不同提示词与职责协作完成任务,模拟科研团队的分工与互相校验。代表工作包括 ResearchAgent、SciAgents、AI Scientist 与 Co-scientist 等。
本文的研究问题正是「如何组织这些智能体的协作」,先理解多智能体分工这一范式,才能体会把协作规则显式化并做控制实验的价值。
研究动机
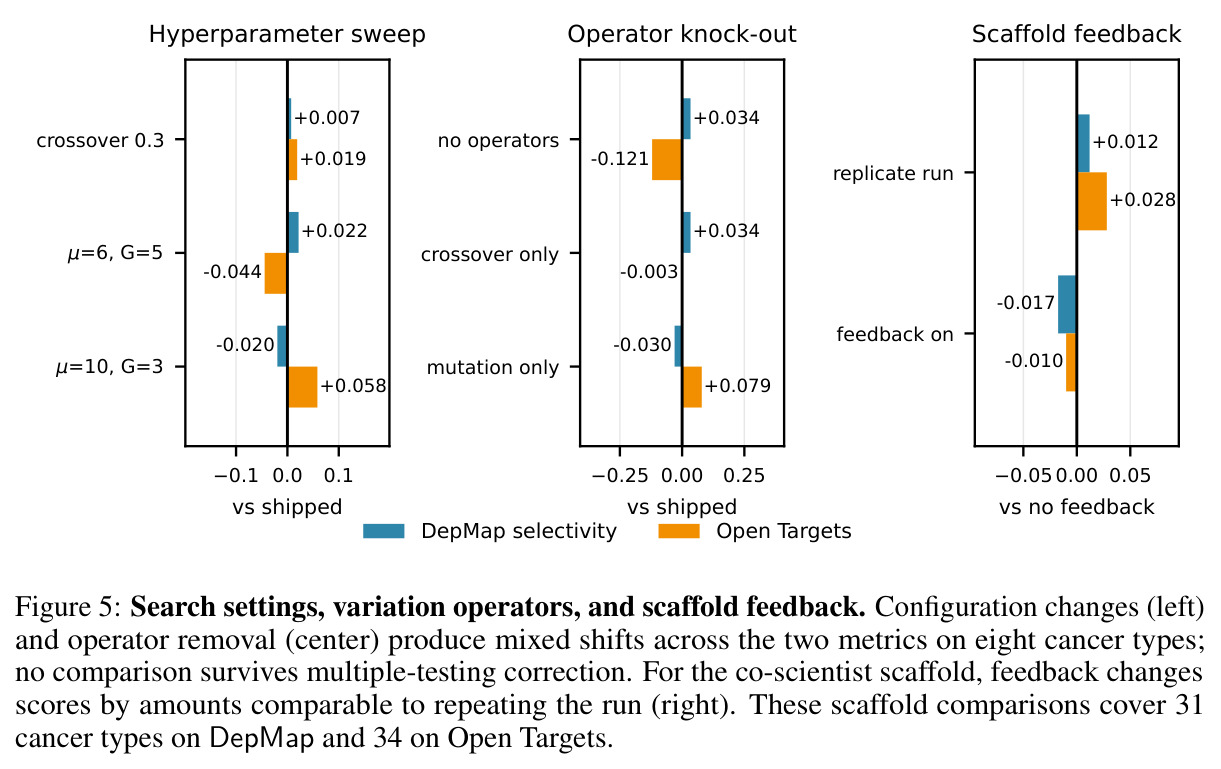
现有 LLM 科学假设发现系统把智能体角色与搜索组织混在一起,导致性能归因不清。例如最接近的 Co-scientist 系统用生成、辩论、排名、进化智能体加 Elo 锦标赛在扩张池中排序假设,但其表现同时反映智能体本身的科学能力和组织它们工作的协作规则,两者无法区分——我们无法回答「哪种协作设计真正提升假设质量」。论文的对照实验直观展示了这种混淆:Co-scientist 中开关生成器反馈仅使 DepMap 分数变化 −0.017,而重复同一实验本身就有 +0.012 的波动,反馈效果淹没在噪声里。此外,假设质量评估长期依赖昂贵的前瞻性实验(如湿实验验证),多数系统只在自我评估、多样性等内部指标上验证,缺少可规模化、客观的外部生物学证据来判断生成的假设是否真有科学价值。
本文的目标是本文的目标是构建一个能把「智能体的科学角色」与「协作的搜索规则」分离的假设发现框架,使协作设计第一次成为可操控的实验变量、假设质量成为可测量的结果。具体而言:用世代遗传算法显式定义种群如何被选择、变异和替换,同时保持生成、评分、进化三类 LLM 智能体的角色定义、提示词和科学评判标准完全固定;在药物重定位任务上引入 DepMap 选择性与 Open Targets 关联两个只在搜索结束后才启用的外部生物学指标,覆盖 34 种癌症类型(33 种 TCGA 癌型加慢性粒细胞白血病),检验进化出的假设是否获得独立证据支持,并量化协作规则(如父代选择策略)对假设质量的因果影响。
与已有工作不同的是,已有工作各占一端而未打通两者:科学智能体系统(SciMON、ResearchAgent、Co-scientist)关注角色分工,但搜索规则隐式嵌在流程里,无法单独替换研究;进化搜索系统(FunSearch、EvoPrompt、EvoDiverse)有显式的选择与变异规则,但作用对象是程序、方程等能被自动 Oracle 打分的产物,难以处理开放式科学主张。HypoEvolve 的独特切入是把结构化科学假设(标题+摘要+主张+论证)当作进化对象,用智能体自身的两两科学判断作为适应度来源,同时把 DepMap/Open Targets 等外部证据严格隔离在搜索结束之后。这使协作规则——父代选择、交叉/变异概率、替换方式——可以在角色与评价不变的前提下被单独替换和消融,例如把适应度引导的锦标赛选择换成均匀随机选择,直接测量「协作设计」对假设质量的因果贡献。
核心方法
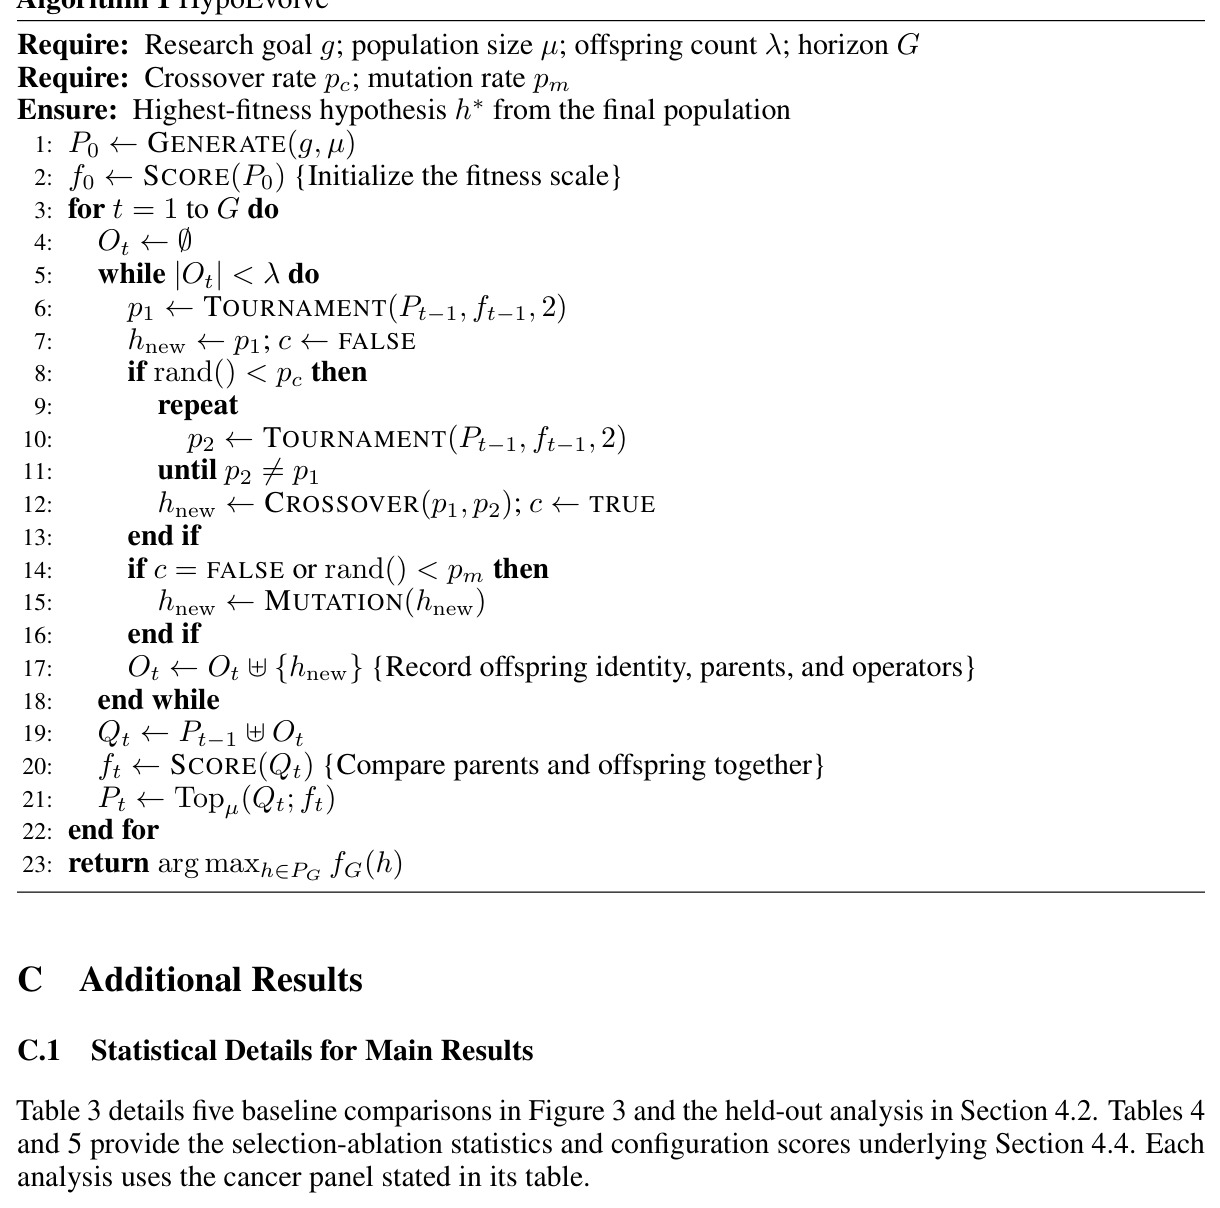
直觉上,HypoEvolve 把假设开发当作有限种群搜索:让一群结构化科学假设像生物种群一样逐代进化,由三类专门 LLM 智能体充当「遗传算子」,而遗传算法本身只负责调度种群更新。形式化地,给定自然语言研究目标 g,每个候选假设 h 是含标题、摘要、假设陈述与支持论证的结构化文档,搜索在 μ=6 的种群上运行 G=3 代、每代产生 λ=6 个子代,返回最终种群中适应度最高者 $h^* = \arg\max_{h\in P_G} f_G(h)$。每代执行三步:$Q_t = P_{t-1} \uplus O_t$ 合并父代与子代,$f_t = \mathrm{Score}(Q_t)$ 由两两比较聚合出适应度,$P_t = \mathrm{Top}_\mu(Q_t; f_t)$ 保留前 μ。生成智能体负责文献检索与初始化,评分智能体输出两两比较,进化智能体执行语义交叉与变异;全程使用 gpt-5.4-mini 与 Tavily 检索,DepMap 与 Open Targets 外部评分只在搜索结束后进行,绝不进入适应度。实验共完成 94 次运行。
核心创新是把「协作」显式化为种群更新规则,使其第一次成为可做控制实验的变量。与 Co-scientist 的 Elo 锦标赛加扩张池不同(无交叉、变异与种群替换),HypoEvolve 采用固定规模的 (μ+λ) 截断替换:父代与子代合并评分后保留前 6,新假设必须在与亲代的直接竞争中胜出才能存活,从而把比较判断与后续搜索方向锁定在一起。交叉与变异被重构为对科学主张与论证的语义推理而非文本重组:combination 融合两个父代的机制论证成连贯解释,inspiration 以父代想法为跳板提出面向同一目标的全新解释;drug substitution 在 61 种药物词表内替换化合物但保留机制论证,out-of-box 重新审视假设的前提假设、探索替代机制。Bradley-Terry 把两两判断聚合成锚定适应度(初始均值固定 50、极差 60 分,后续只平移偏置 $b_t$),保证适应度轨迹跨代可比,配完整谱系记录使每个假设的演化可审计。
方法步骤详情
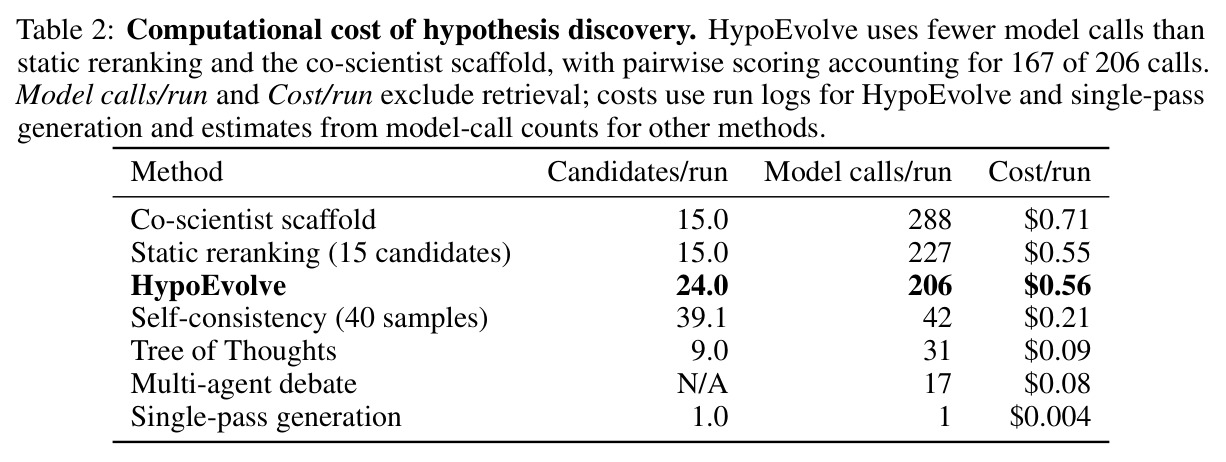
第一步文献初始化:生成智能体从研究目标 g 派生检索查询,用 Tavily 拉取相关文献并综合,提出 μ=6 个覆盖不同机制与通路的假设。第二步两两比较:评分智能体按癌症特异性、靶点证据与可证伪性三项任务标准比较种群中每个无序对,可判平局;第 0 代 15 对,此后每代对 12 个候选比较 66 对。第三步适应度聚合:Bradley-Terry 将比较结果转为强度 $\pi_{t,h}$,$P(h_i \succ h_j) = \pi_{t,h_i}/(\pi_{t,h_i}+\pi_{t,h_j})$,$f_t(h) = a\log\pi_{t,h} + b_t$;首代定 a 使均值 50、极差 60 分,后续仅平移 $b_t$。第四步父代选择与变异:锦标赛抽 2 取优,交叉概率 $p_c=0.6$,变异概率 $p_m=0.15$,每个算子在其两个变体间均匀选择;算子返回为空则产生不变的父代副本以保持子代数。第五步联合替换:每代 206 次调用中 167 次为两两比较,父代子代合并取前 6,全部子代记录谱系。重复 G=3 代,输出最终种群最优假设及其提出药物。
技术新颖性
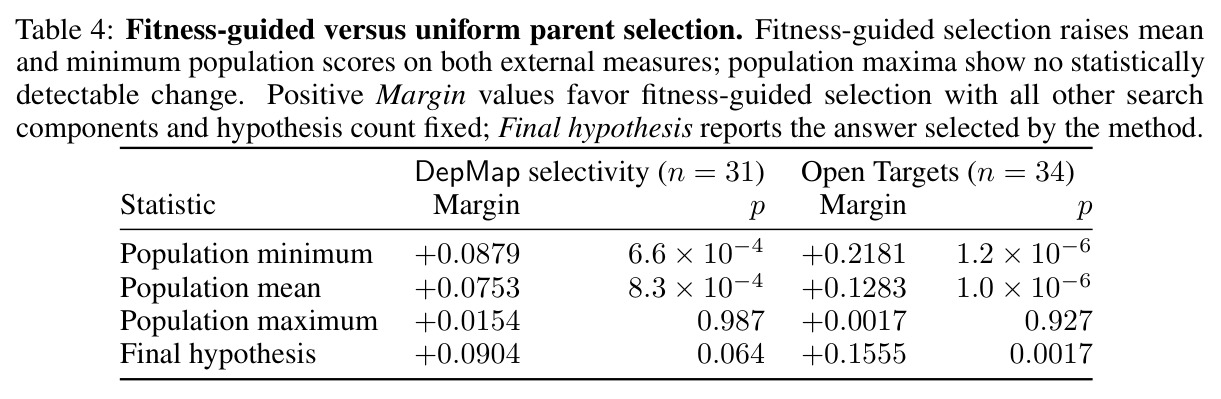
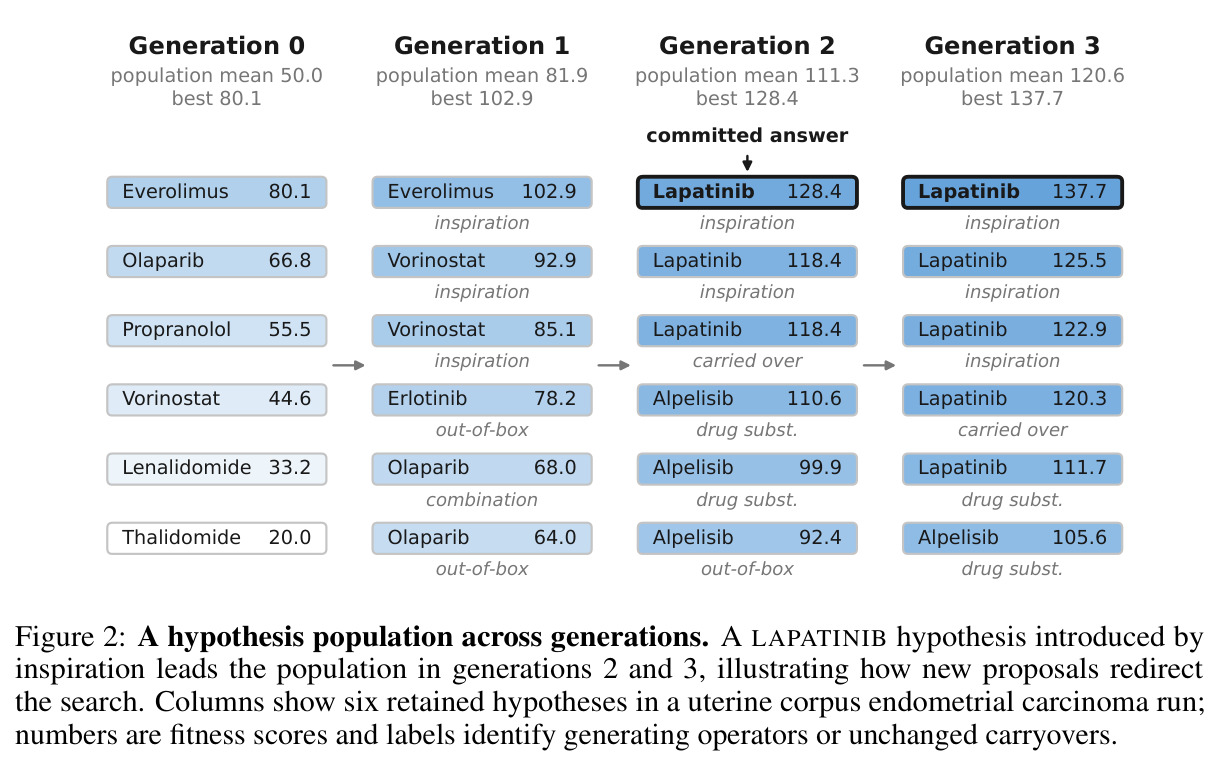
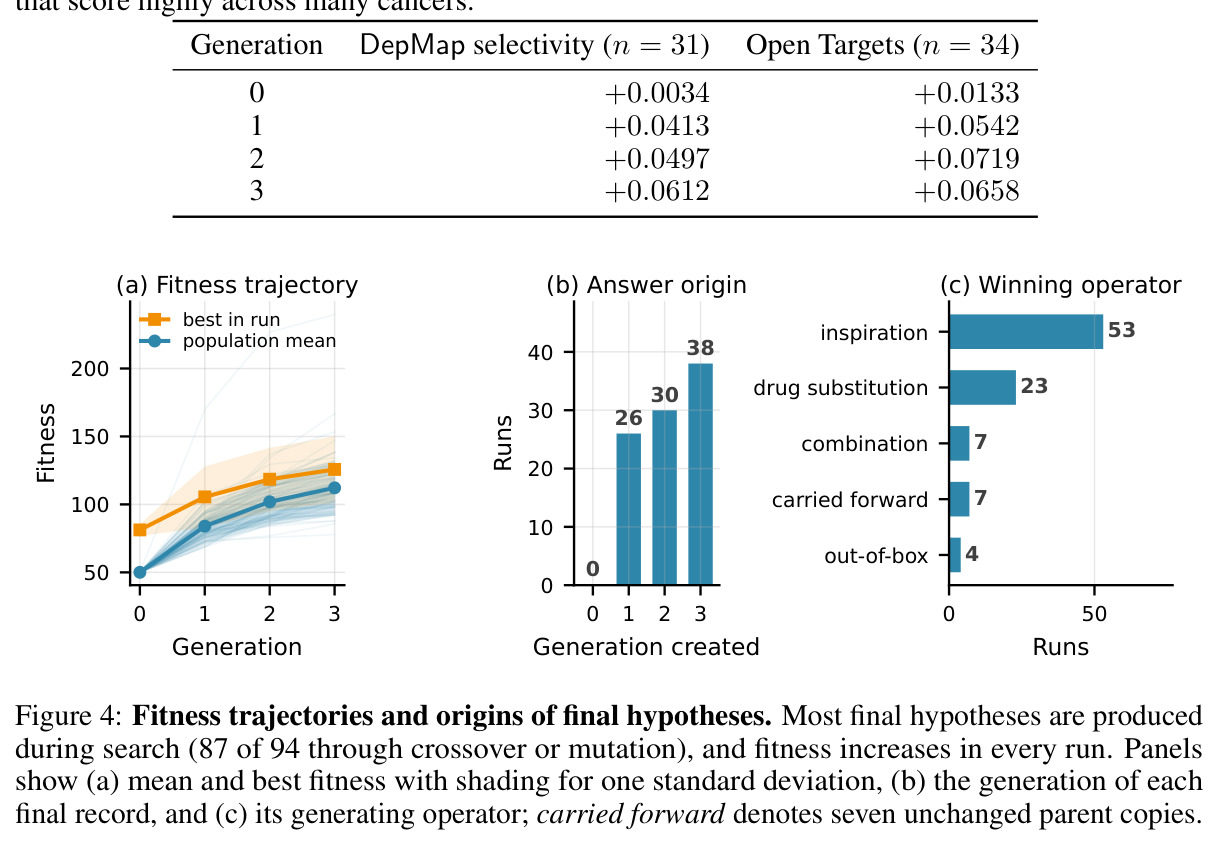
技术新颖性有四点。其一,进化对象是结构化科学假设而非程序、方程或提示词,不存在自动 Oracle,适应度完全来自智能体的科学判断——这与 EvoDiverse(温度控制多种群加领域 Oracle)、FunSearch(程序加测试用例)、EvoPrompt(提示词进化)本质不同,外部生物证据只在搜索后使用。其二,变异算子是语义化的推理操作(换药保论证、重审前提),而非词法扰动,使交叉与变异能产生真正的科学替代方案,案例中黑色素瘤的 TRAMETINIB 被替换为 VEMURAFENIB、胰腺癌的 OLAPARIB 论证收窄到 BRCA1/BRCA2/PALB2 分层。其三,完整的谱系记录(父代、算子、代次)让每个假设的演化可审计,1692 条子代记录显示四个算子使用均衡(27.6%/24.8%/22.9%/17.1%)。其四,通过把协作规则参数化,论文首次给出协作设计对假设质量的因果证据:仅把适应度引导选择换成均匀选择、其余全部固定,种群最弱成员的 DepMap/OT 分数即分别低 0.088/0.218。
实验结果
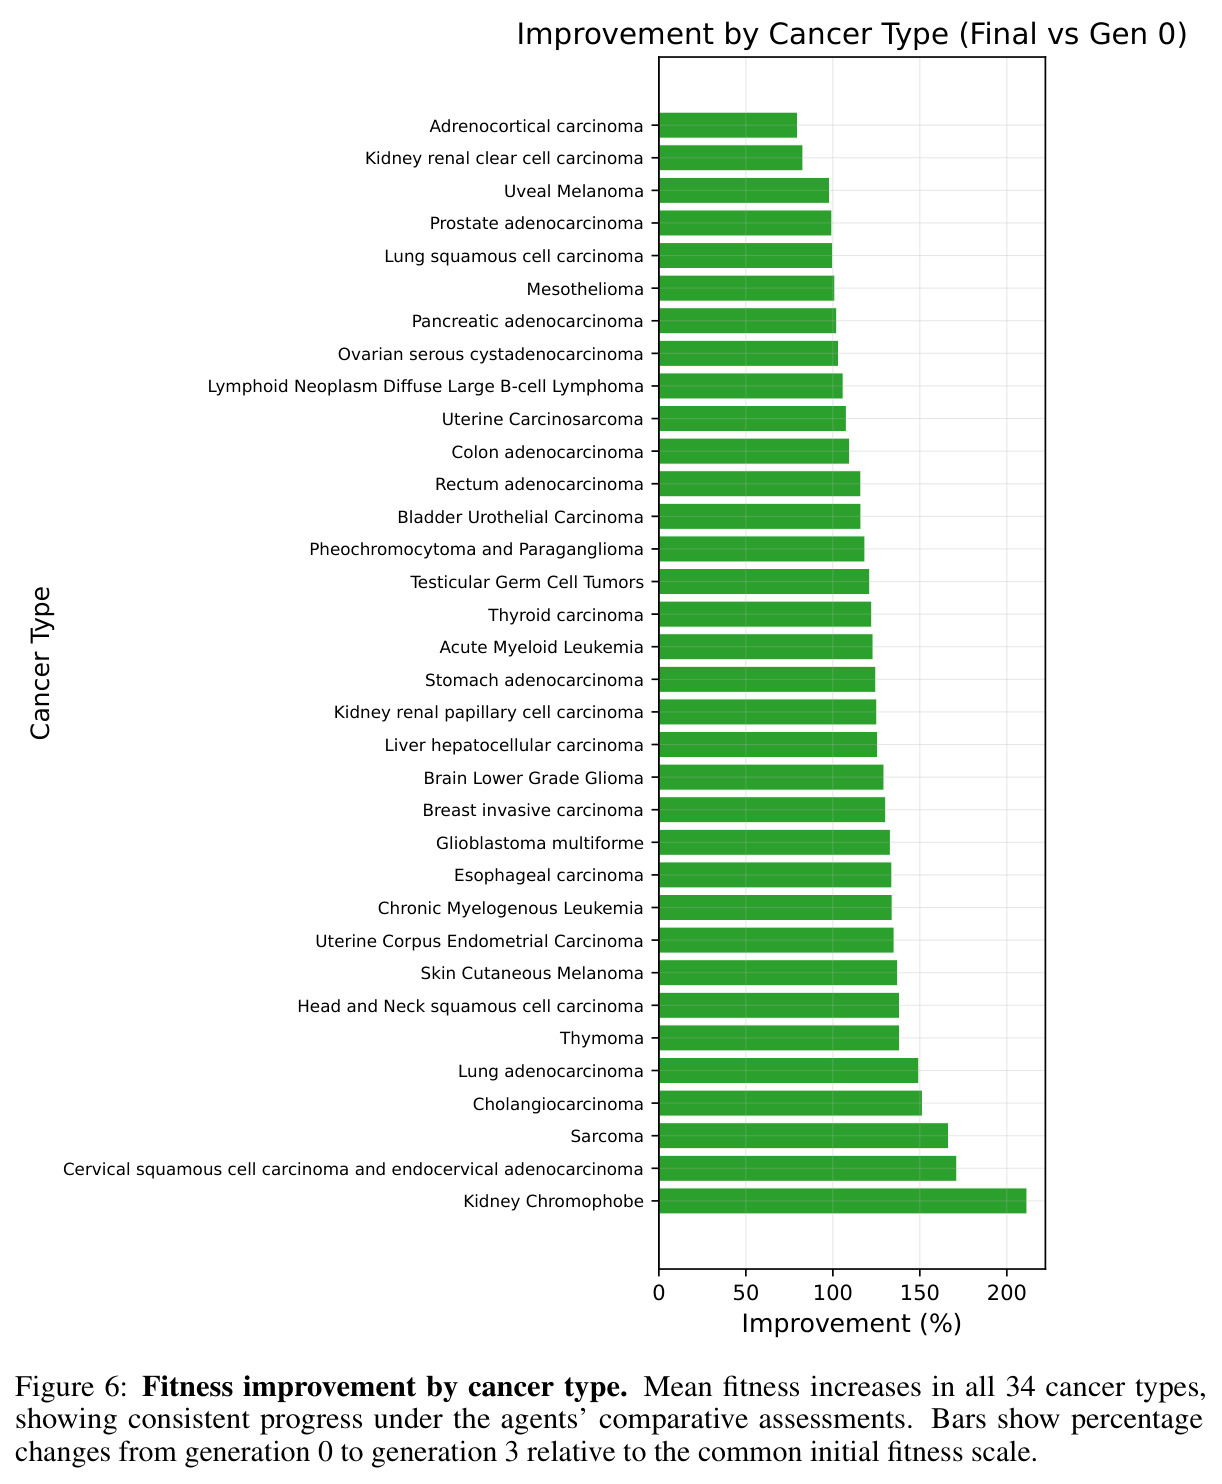
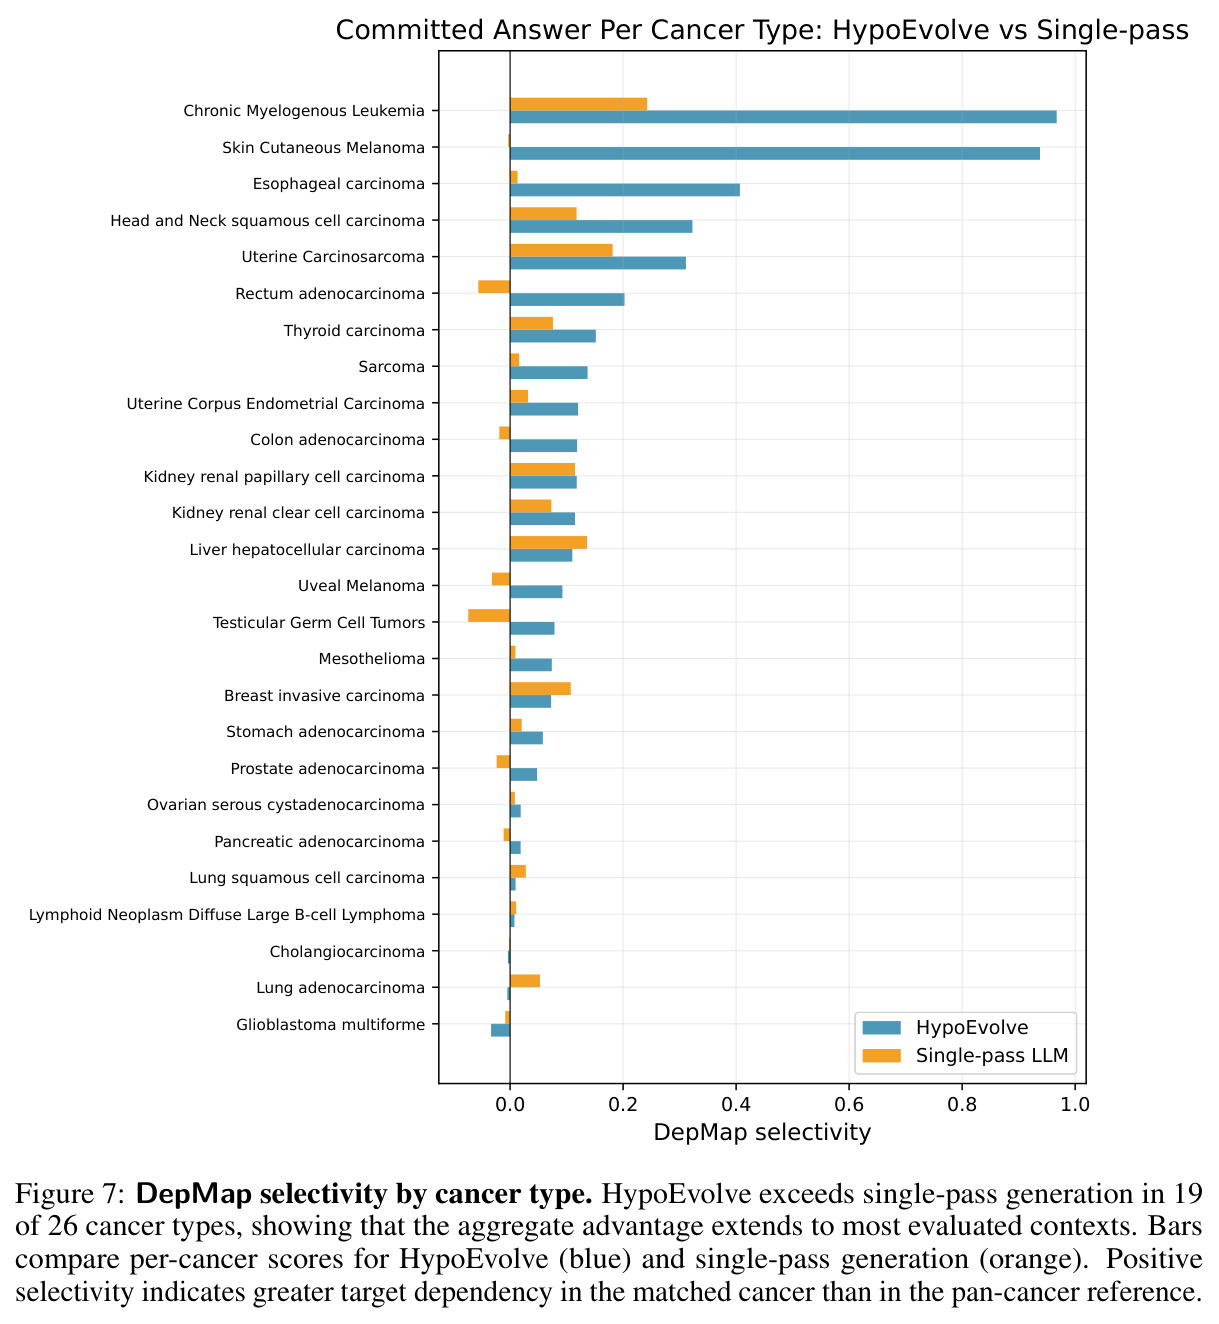
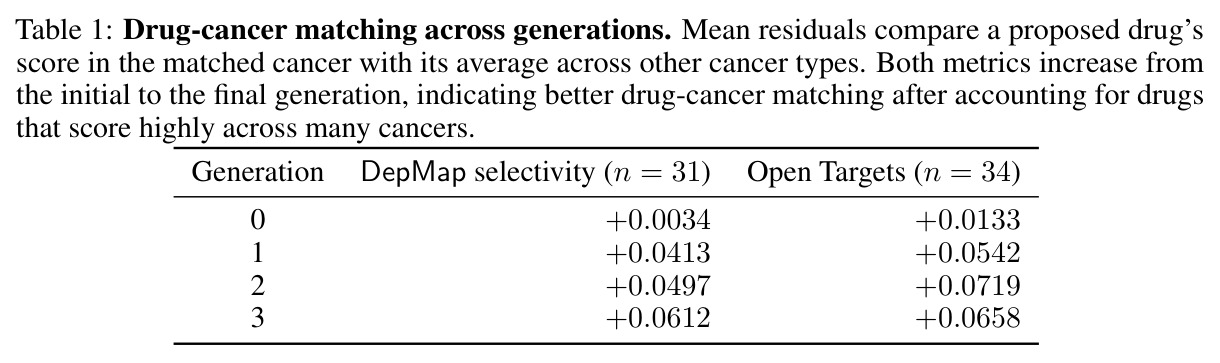
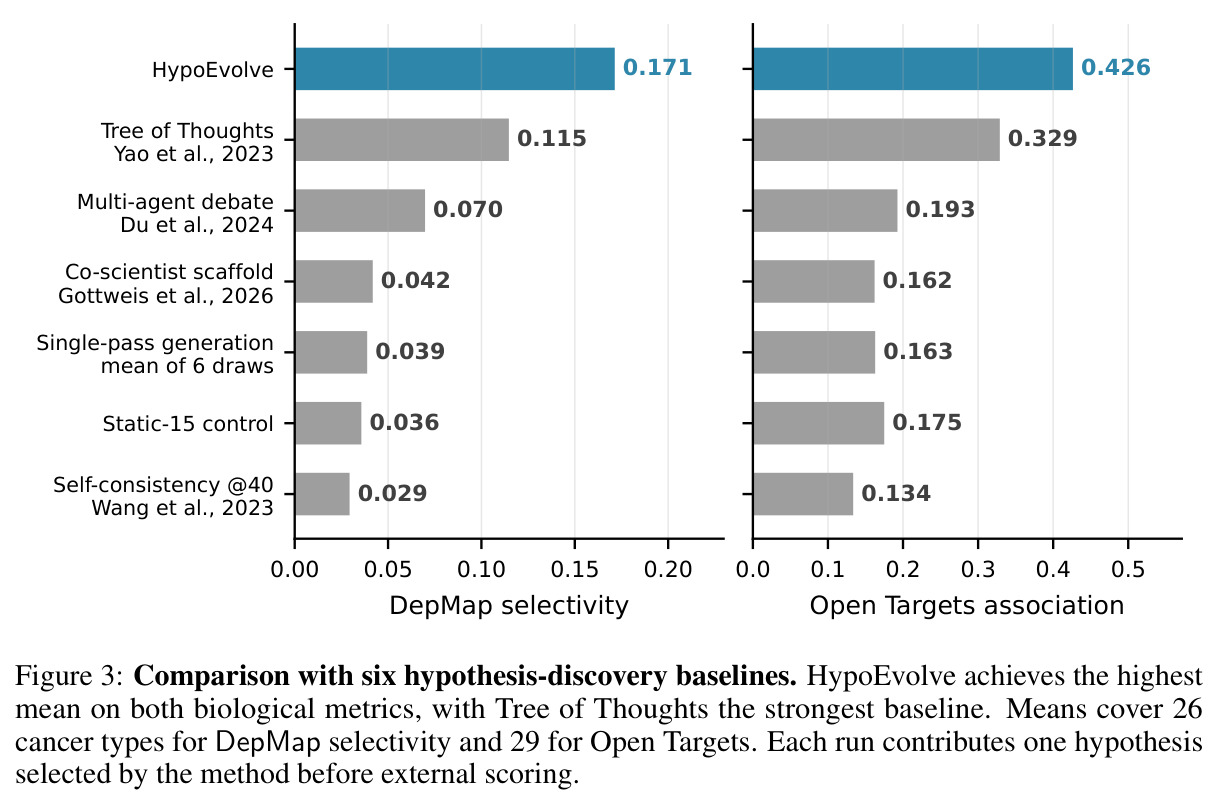
主实验在 34 种癌症上对比六个基线:HypoEvolve 的 DepMap 选择性达 0.171(26 型),最强基线 Tree of Thoughts 为 0.115,单次生成仅 0.039,配对差 +0.133;Open Targets 关联达 0.426(29 型),领先 ToT 0.329、单次生成 0.163 达 +0.097/+0.263。泛化到 27 个 held-out 癌型:Open Targets +0.280、DepMap +0.111,遗传关联通道优势最大(+0.334)。匹配残差逐代上升:DepMap +0.0034→+0.0612,Open Targets +0.0133→+0.0658;94 次运行适应度全升(均值 50.0→112.2);87/94 个最终假设由交叉或变异产生。消融中 μ=10、G=5、算子敲除均无 Holm 校正后显著差异,但适应度引导选择优于均匀选择:最弱成员 +0.088/+0.218、均值 +0.075/+0.128。成本 206 次调用/0.56 美元,低于 Co-scientist 288 次/0.71 美元。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 药物重定位假设发现(26 个共有癌型) | DepMap 选择性 | 0.171 | Tree of Thoughts 0.115;单次生成 0.039 | 较 ToT +0.057,较单次生成 +0.133(19 胜 7 负) |
| 药物重定位假设发现(29 个共有癌型) | Open Targets 关联分数 | 0.426 | Tree of Thoughts 0.329;单次生成 0.163 | 较 ToT +0.097,较单次生成 +0.263(26 胜 3 负) |
| Held-out 泛化(27 个留出癌型) | 对外部指标均值 | Open Targets +0.280;DepMap +0.111(24 型) | 单次生成 | 冻结配置下无需任何改动即保持优势 |
| 父代选择消融(31/34 个癌型) | 种群最弱成员外部分数 | 适应度引导锦标赛选择 | 均匀随机选择 | DepMap +0.088、Open Targets +0.218;种群均值 +0.075/+0.128 |
| 药物-癌症匹配残差(逐代) | 相对其他癌症的平均分数残差 | DepMap +0.0034→+0.0612;Open Targets +0.0133→+0.0658 | 第 0 代初始种群 | DepMap 21/31 型、Open Targets 25/34 型匹配改善 |
局限与改进
作者坦承:外部指标只检验「靶点与癌症相关」这一隐含生物学主张,不能确立完整机制与疗效,前瞻性实验仍然必要;消融实验(种群规模、代数、算子概率、算子敲除、基线反馈)在 Holm 多重检验校正后均不显著,说明在 8 个癌型的小样本上搜索超参数的效果方向不稳定;LLM 可能已从预训练语料接触过药物-疾病配对,遗传证据通道 +0.334 的优势不能完全排除记忆效应,作者自己注明 prior exposure may still contribute。我补充几点观察:其一,评分输入与外部证据可能同源——61 种药物词表取自 DepMap 覆盖注释靶点的药物,检索文献与 Open Targets 的文献通道可能重叠,存在间接信息泄漏风险,论文虽做了检索替代设置的鲁棒性检查(附录 C.5)但未彻底排除;其二,两两比较占 167/206 次调用,评分智能体的偏见会直接塑造适应度,却没有对评分质量的校准或人评验证;其三,只在药物重定位一个领域验证,且选择压力下出现 LAPATINIB 一类假设占据种群多席的现象,多样性维持值得警惕。
独立分析的弱点
弱点一:适应度锚定机制较脆弱——首代固定乘子 a、后续只平移偏置 $b_t$,若评分智能体早期系统性误判,会通过选择压力长期放大且无法自我纠正;改进方向是引入周期性重锚定或多位评审聚合(不同模型交叉评分)。弱点二:种群太小(μ=6),15 对比较即可决定整个初始排序,统计功效低;且末代种群中同一药物(如 LAPATINIB 占 4 席)反复出现,提示早熟收敛与多样性塌缩风险,可引入质量-多样性目标(如 MAP-Elites 按机制通路分桶)。弱点三:$p_c=0.6$、$p_m=0.15$ 的敏感性未知,消融只测了一组替代值(0.3/0.4)且在 8 个癌型上无显著差异,缺乏系统的超参数响应面。弱点四:外部指标只到「靶点-疾病相关」粒度,完全无法评估机制论证本身的科学质量(可证伪性、新颖性),应补充专家盲评或通路富集分析作为第三评价维度。弱点五:全部结论基于 gpt-5.4-mini 单一模型,协作设计的收益对更强或更弱模型的迁移性未验证,评分者与生成者能力差距如何影响进化动力学仍是空白。
未来方向
作者提出的方向是把「团队组织」与「个体能力」一起设计评估:将协作规则本身作为搜索对象做元级进化(自动优化超参数、算子集合与选择策略),并把框架推广到药物重定位之外、能为每类假设定义可外部检验隐含主张的领域(材料、化学、机器学习研究想法)。基于本文成果可延伸:把「搜索-验证解耦」做成通用范式——任何领域只要有可查询的外部证据库(知识图谱、实验数据库)即可套用;引入实验反馈闭环(类似 Robin 的湿实验回流),让真实实验结果参与适应度;用谱系记录训练过程奖励模型,学习「什么样的科学论证会被采信」,反过来提升评分智能体;结合质量-多样性搜索保持机制多样性并研究多样性假设的长期科学价值;以及系统研究种群规模、评分模型能力与搜索收益之间的缩放规律,为自主科研团队的组织设计提供工程指南。
复现评估
复现难度中等偏低。依赖闭源模型 gpt-5.4-mini 与 Tavily 检索 API,但成本极低:单次运行 206 次调用约 0.56 美元,94 次运行预算仅数十美元,无 GPU 需求。超参数完整给出(μ=6、λ=6、G=3、$p_c=0.6$、$p_m=0.15$),附录 B 提供算法伪代码,附录 D 提供各角色提示词与 61 种药物词表。评价数据全部公开:DepMap CRISPR 依赖性与 Open Targets 关联分数均可下载,选择性指标(减泛癌中位数、取靶点最大值)定义明确。主要不确定性:正文未提及开源代码仓库,Tavily 检索结果随时间变化带来非确定性,两两比较依赖模型版本可能漂移;建议复现时固定检索缓存与模型快照,并优先复算 Table 1 的逐代残差与 Figure 4 的适应度轨迹作为正确性检查。一名熟悉 Python 的研究生按附录细节可在数天内搭起完整管线。
论文图表