SwarmRSI:通过演化科学智能体群体实现递归自我改进 SwarmRSI: Recursive Self-Improvement through Evolving Scientific Agent Swarm
把假设、程序、证据与需求作为可继承状态演化,群体借彼此反馈与组件复用实现递归自我改进。
前置知识
递归自我改进(Recursive Self-Improvement, RSI)
指一个系统利用自身运行产生的经验来改进指导其后续行为的机制,形成'做实验→从经验中学习→做得更好'的闭环。在 LLM agent 语境下,被改进的对象可以是代码(AIDE 保留被接受的代码修改)、策略(Dream-RSI 精炼探索策略)、工作流(MASS)或研究提案(AQuA)。与普通的自我反思不同,RSI 强调改进产物会被持久保留并成为下一轮改进的基础。
本文的核心主张是:RSI 的正确演化对象不是单个 agent 的内部机制,而是群体成员相互继承的研究状态。理解 RSI 的已有定义才能看出 SwarmRSI 把演化对象从'个体'搬到'群体遗传物质'这一步新在哪里。
科学智能体群体(Scientific Agent Swarm)与假设/程序进化
科学 agent 是承担假设提出、程序开发或证据分析等角色的研究策略。'程序进化'路线(AIDE、AlphaEvolve、MLEvolve)用执行反馈迭代精炼代码;'假设进化'路线(AI co-Scientist、Arbor、HypoEvolve)通过假设的生成与评估迭代改进研究方向。群体(swarm)指多个这类 agent 共享信息、各自推进不同方向,一个 agent 的发现和实现可以推进另一个的研究。
本文的方法和实验全部围绕'假设—程序—证据'这条科学研究的链条展开,三大机制分别作用于链条的不同环节;分不清假设进化和程序进化,就看不懂 H-mutation 与 P-mutation 的区别。
遗传算子:变异、交叉与换基(rebase)
来自遗传算法的搜索算子:变异(mutation)对单个个体做局部修改产生新候选;交叉(crossover)组合两个个体的片段产生后代;协同进化(cooperative coevolution)进一步让多个部分适应度子组件相互组合。本文的 rebase 类似 git 变基:保留假设内容不变,把它的实现搬到另一个 agent 的程序基座上。
SwarmRSI 的两大生成机制正是这些算子在 LLM 科学发现场景的实例化:反馈引导变异对应 H/P 两类变异,互补重组对应 rebase 与 crossover。交叉的 donor 选择按逐实例优势而非总体适应度,这是全文最巧妙的复用设计。
折扣上置信界(discounted UCB)与多臂老虎机
多臂老虎机问题研究如何在'利用已知好选项'与'探索未知选项'间分配预算。UCB 策略给每个臂打分 $\hat{\mu}+\beta\sqrt{\log t/N}$:均值高或被采样次数少的臂优先。折扣版(Garivier & Moulines 2011)用 $N\leftarrow\rho N+1$ 这类折扣更新让近期回报权重更大,适合非平稳环境。
Recursive Swarm Evolution 用折扣 UCB 的变体在'改假设'与'改程序'两个前沿间分配预算,是整个框架的调度大脑;消融显示去掉它导致平均增益 $g$ 跌幅最大(8.2)。不懂 UCB 就读不懂式 (6)-(8)。
执行反馈、代码审计与指标 $g$
程序进化依赖'跑代码拿分数'的执行反馈,但有效分数可能掩盖问题: proposed 修改可能根本没被执行。本文用代码审计(比对父子源码语法树、检查新增函数是否被引用、比对提交输出是否相同)与科学审计来验证干预被忠实实现。NatureBench 用方向校正改进 $g_i=d_i(m_i-m_i^{\text{SOTA}})/|m_i^{\text{SOTA}}|$ 衡量相对已发表 SOTA 的提升,$g\ge 0$ 记 Match-SOTA、$g>0.1$ 记 Surpass-SOTA。
'失败是假设错了还是代码错了'是全文动机问题的核心,而审计机制和 $g$ 指标是回答这个问题、解读所有实验表格的基础。
研究动机
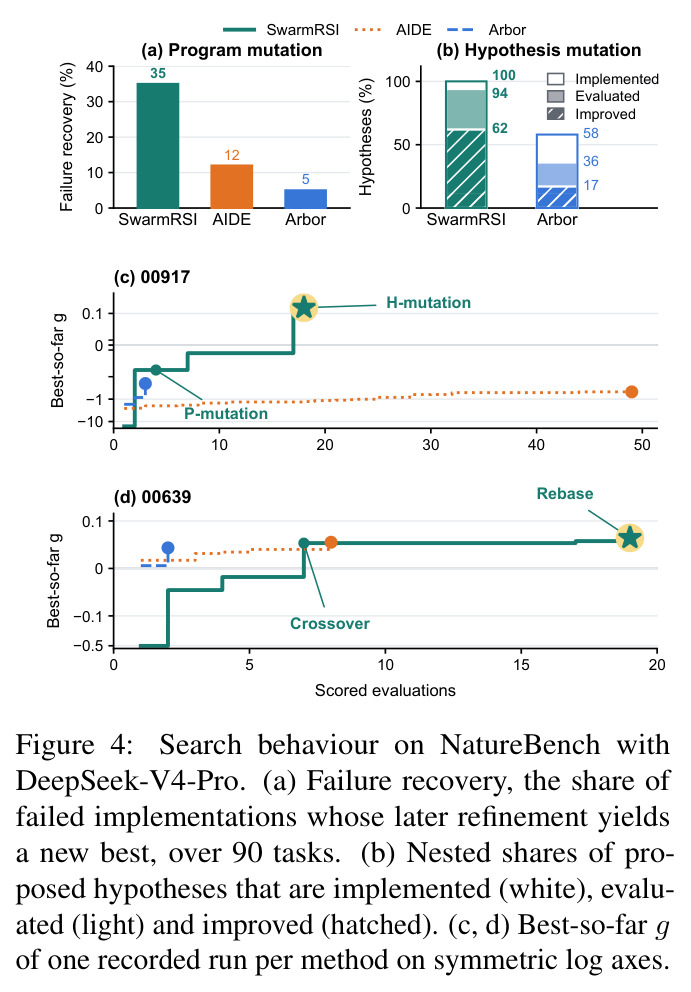
现有科学编码智能体分两条路线:程序进化(AIDE、AlphaEvolve 用执行反馈精炼代码)与假设进化(AI co-Scientist、Arbor 用假设树引导研究方向),但在多智能体群体追求 RSI 时遇到两个相互关联的障碍。第一,归因困难:假设的价值取决于实现质量和测试严谨性,一次实验失败后系统无法判断是研究方向错了还是代码实现错了。论文 Figure 1 上图给出典型场景:Agent A 的假设本可在更好的实现下成功,却因一次差结果被当作坏方向整体放弃,即'有前景的假设被过早抛弃'。第二,中间结果被低估:一个整体分数无增益的程序里可能藏着对其他 agent 后续研究至关重要的组件,但现有系统按总体性能筛选,导致'有用组件被忽视'(Figure 1 下图)。论文用数据证实这种浪费的规模:在 NatureBench 上 AIDE 的停滞率(不改进的评分候选占比)达 63%、Arbor 达 70%;失败的实现中后来被修复成新最佳程序的比例 AIDE 仅 12%、Arbor 仅 5%——大量实验经验和半成品组件在现有框架中被白白丢掉。
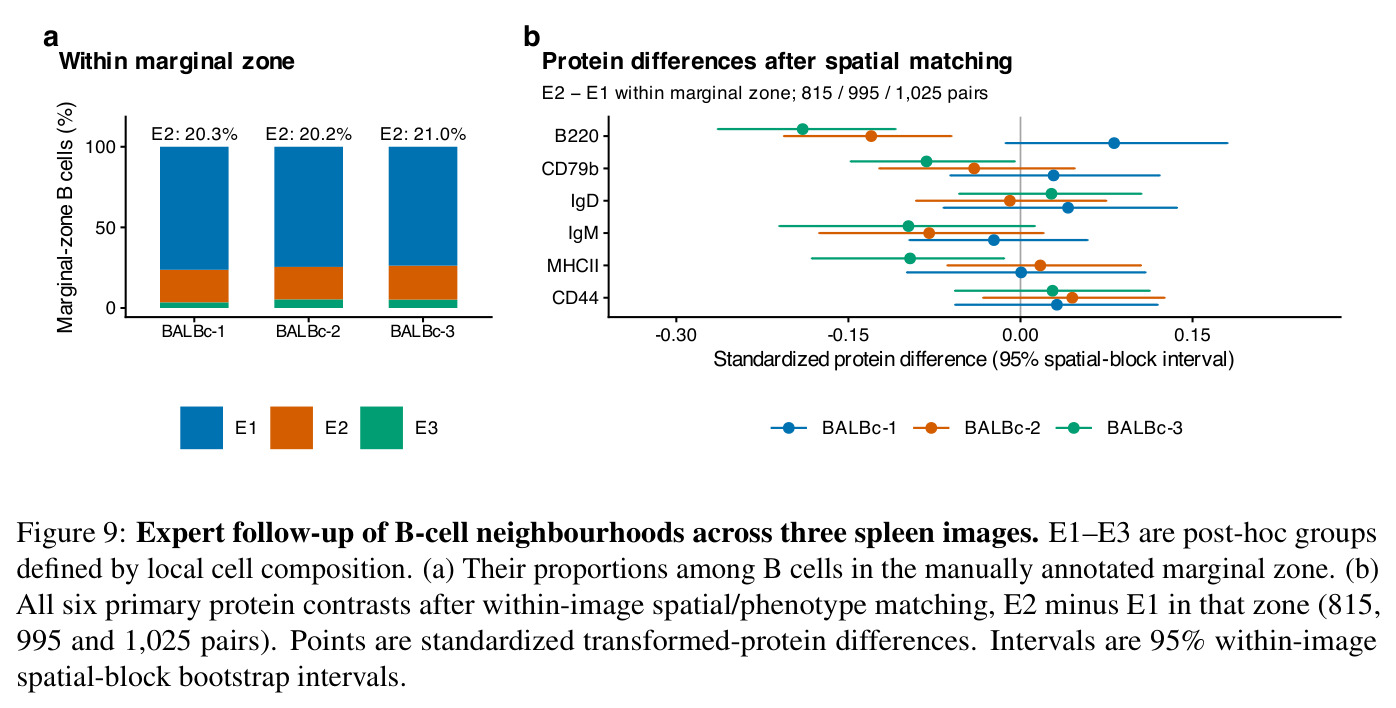
本文的目标是本文要回答的中心问题是:科学智能体群体如何通过自己的实验经验实现递归自我改进。具体目标是把 RSI 形式化为'可继承研究状态'的演化:每次实验的结果——无论成功、失败还是无增益——都更新假设、程序、实验证据和未解决需求四类状态,使后续 agent 总是从更新后的状态 $s_{t+1}$ 出发。方法上要达成三件事:(1) 用其他 agent 的实验反馈(跨实例的表现差异与实现证据)判断失败应归因于假设还是实现,决定修改方向;(2) 让被保留的假设能在别的 agent 的程序基座上重新实现(rebase),让整体无增益程序中的局部优势组件能被交叉移植(crossover);(3) 用自适应调度决定每一步该改假设还是改程序。最终在 OpenProblems(6 个单细胞分析任务)、NatureBench(90 个科学编码任务)、MLE-Bench Lite(22 个机器学习竞赛)共 118 个任务、两个 backbone 上验证群体级 RSI 的有效性,并请生物学家实际复现演化出的程序用于肠道与脾脏免疫的后续分析。
与已有工作不同的是,已有 RSI 方法各自改进不同对象:AIDE 保留被接受的代码修改作为后续自我改进的基础;Dream-RSI 用回放模拟器精炼探索策略;MASS 交替演化工作流与模型微调;AQuA 用记录的实验指导后续提案;最接近的 Arbor 在持久假设树上关联假设-程序-证据,SAGE 评估竞争性失败解释来指导干预。这些方法的演化对象都是单个 agent 的代码、策略、工作流或提案。SwarmRSI 的独特切入点是把'群体成员相互继承的研究状态'本身作为演化对象:跨 agent 的反馈解决归因问题(该改假设还是改代码,由他人的表现差异和实现证据说话),跨 agent 的重组解决部分结果被低估的问题(好假设换基座重生、无增益程序贡献局部组件),并通过共享图把每个实验的结局变成后续搜索的输入。这相当于从'改进单个研究者'跳到'改进研究群体的遗传物质',思想上呼应协同进化算法(Wiegand et al. 2001)与 POET 一系的开放式搜索,但落地于 LLM 科学发现场景。
核心方法
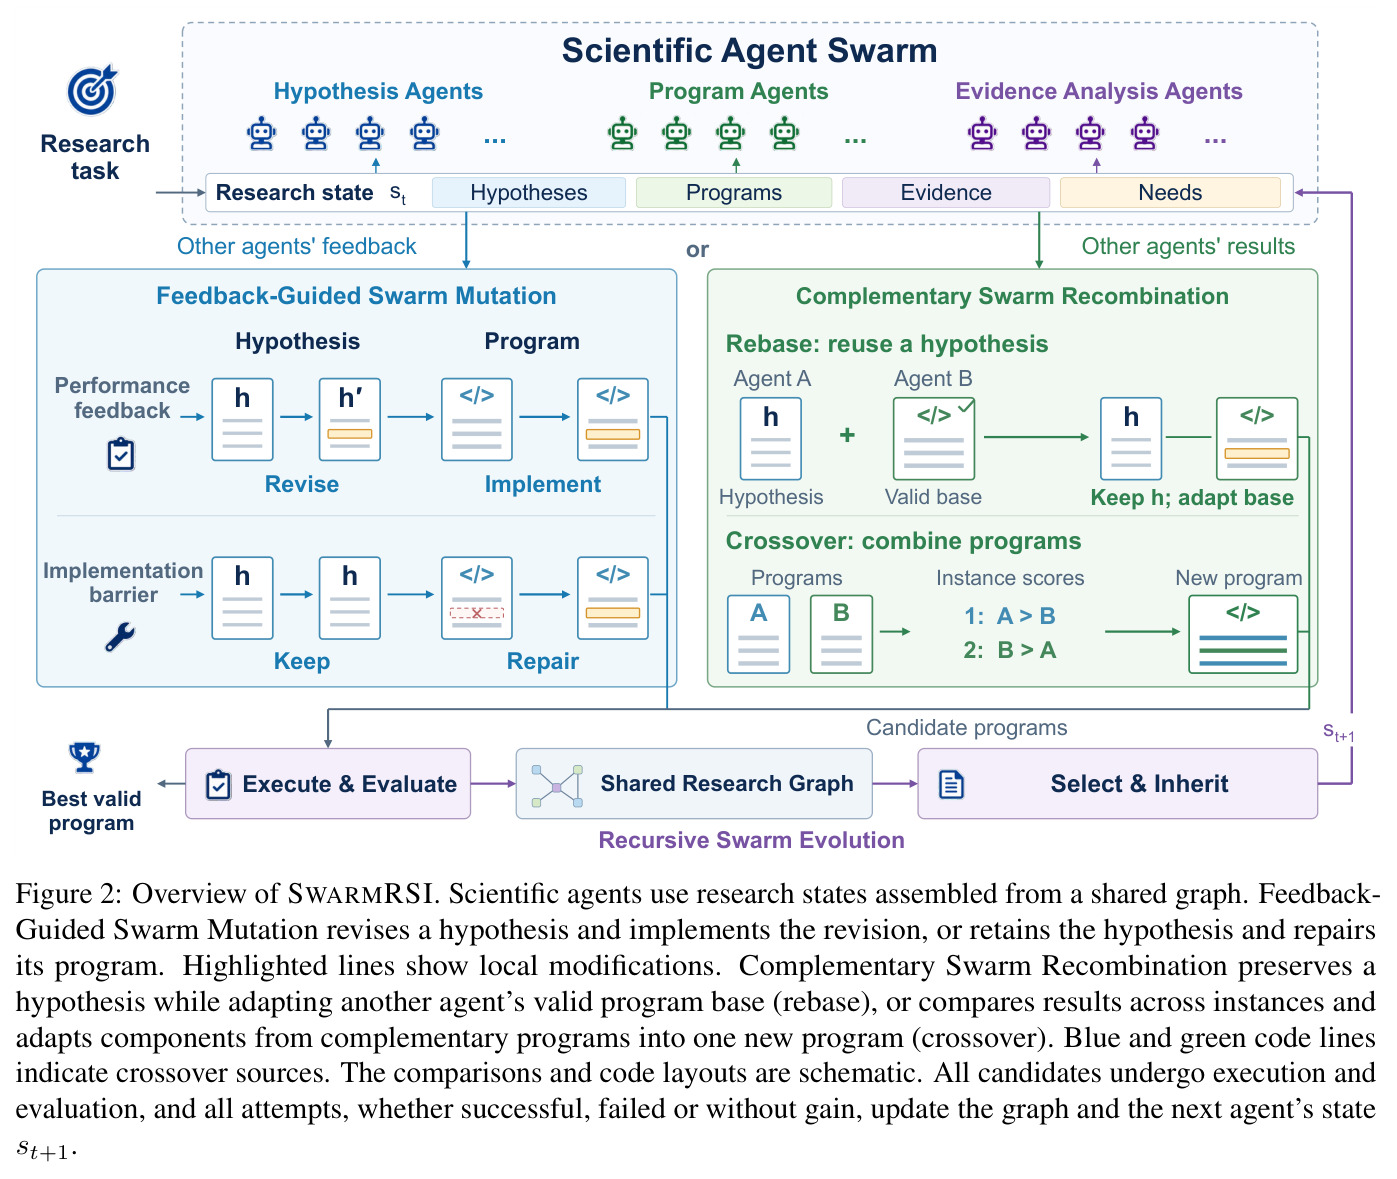
直觉上,SwarmRSI 把智能体群体当作一间共同维护“实验记录本”的实验室:每个成员的假设、代码、证据和未解决的问题都写在同一张共享研究图上,任何人随时可以翻旧账、借工具、接着别人没走完的路走。技术路线上,acting agent 在步骤 $t$ 持有研究状态 $s_t=(H_t,P_t,E_t,U_t)$——假设、程序、实验证据、未解决需求——从共享图 $G_t$ 检索相关记录组装而成;每条记录 $\xi_i=(H_i,P_i,X_i,E_i)$ 保存被测假设、父子程序、结局和执行/实现证据,失败与无增益的尝试同样保留。生成候选有三条路:反馈引导的群体变异用跨 agent 的实例级表现差异和实现证据决定修改假设(H-mutation)还是修复程序(P-mutation);互补群体重组包含 rebase(保留假设、换到别人的有效程序基座上重新实现)与 crossover(按逐实例优势从多个 donor 程序摘组件拼新程序)。所有候选进入统一的执行-评估循环(代码审计+科学审计),每条记录写回图使 $G_{t+1}=\text{Update}(G_t,\xi_t)$;同时用折扣 UCB 风格打分在假设前沿与程序前沿间分配预算,直至预算 $B$ 耗尽,返回 $p_B^\star=\arg\max_{p\in\mathcal{P}_{\text{valid}}(B)} u(p)$。
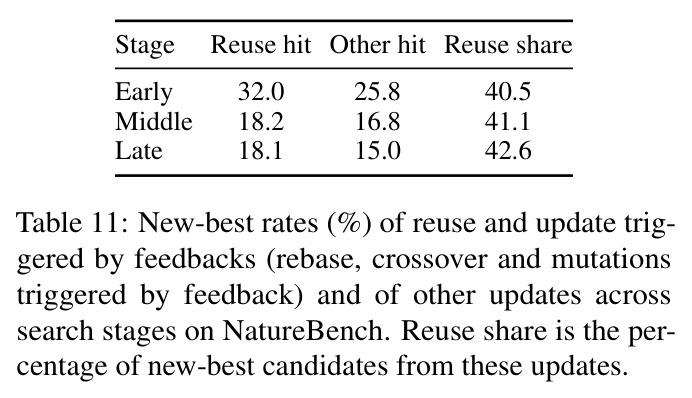
核心创新是把“群体共享、可继承的研究状态”当作一等演化对象,而非任何单个 agent 的内部机制。与已有方法的本质区别有三。第一,归因外化:失败后该改假设还是改代码,不由单个 agent 自我反思决定,而由群体证据决定——跨实例(数据集/子任务)的表现分岐提示研究方向需要修正(发 H-mutation),执行失败或未实现的干预提示实现有障碍(发 P-mutation);即 $\text{Propose}(q,h_t,p_t;s_t)$ 中的 $s_t$ 本身就包含他人记录。第二,价值重估:程序的价值不由当前总分决定——rebase 让“好假设+差实现”有机会在别人的好基座上重生;crossover 按 $D(p_t)=\{p_k^\star: u_k(p_k^\star)>u_k(p_t)\}$ 逐实例择优($p_k^\star$ 为实例 $k$ 上已观察到的最佳程序),把“整体差但有局部绝活”的程序组件移植出来,这是“中间结果的价值在于与后续发现的组合”这一洞见的算子化。第三,全量记账:失败与无增益尝试同样进入共享图并发出 deepen(深化实现)/broaden(拓宽方向)请求,请求又进入调度指标,使每次实验都真实改变后续 agent 的起点 $s_{t+1}$——这正是标题中“递归”的机制含义。
方法步骤详情
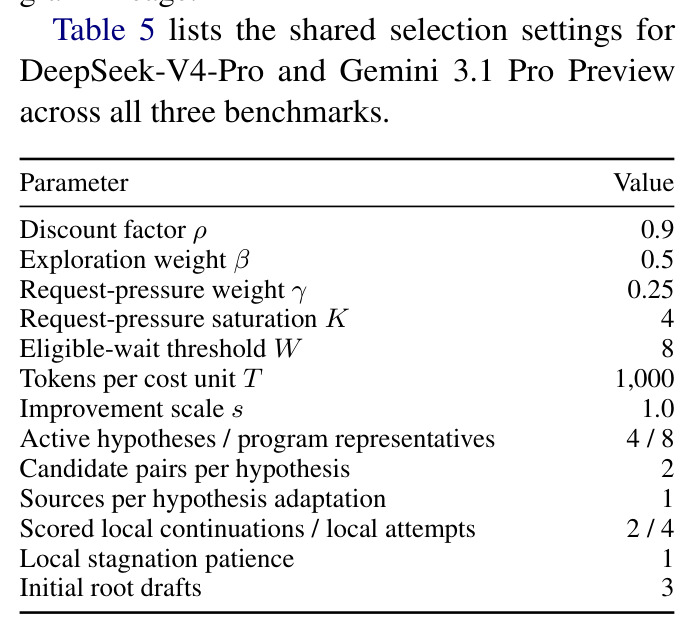
完整流程六步。第 1 步初始化:由起始程序 $p_0$ 生成 3 个根草稿,建立假设前沿 $\mathcal{F}_H$(活跃假设至多 4 个)与程序前沿 $\mathcal{F}_P$(incumbent 加每个实现家族最佳,至多 8 个代表)。第 2 步前沿选择:按 $S_f=\hat{\mu}_f+\beta\sqrt{\log(1+N_H+N_P)/N_f}+\gamma\psi_f$ 打分,$\hat{\mu}_f=G_f/C_f$ 为每 token 成本的近期改进($\rho=0.9$ 折扣),$\psi_f=\min(U_f,K)/K$ 为需求压力($K=4$),$\beta=0.5$、$\gamma=0.25$;未采样或久等的前沿优先。第 3 步候选生成:H-mutation 由 planner 提出修订计划 $(\tilde{h}_t,\delta_t)$;P-mutation 保持 $\tilde{h}_t=h_t$ 只修代码;rebase 按需求-机制标签重叠度从 $\mathcal{F}_P$ 选基 $b_t$;crossover 选至多两个 donor、按逐实例优势取组件(donor 赢的实例用 donor 组件,其余保留父代)。第 4 步实现与执行:coder 得 $\tilde{p}_t=\text{Implement}(p_t,\tilde{h}_t,\delta_t;s_t)$;执行 harness 检查完成度与合规性,代码审计比对父子源码与提交输出(检测未变更语法树、无引用新函数、相同输出),科学审计核查实现证据;通过检查的有效评分候选获得“假设信用”。第 5 步评估与记账:计算 $g_i=d_i(m_i-m_i^{\text{SOTA}})/|m_i^{\text{SOTA}}|$,记录 $\xi_t$ 写入图;实现失败发 deepen 请求,实例级混合增益发 broaden 请求,新 incumbent 为旧程序上的假设发 deepen 请求。第 6 步循环至预算耗尽,返回最佳有效程序。
技术新颖性
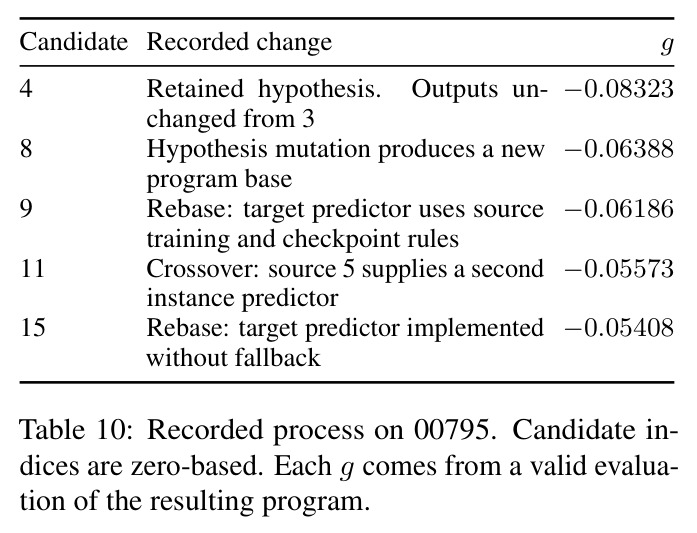
技术新颖性体现在四个层面。形式化层面:首次把科学 agent 群体的 RSI 定义为可继承研究状态 $(H,P,E,U)$ 的演化,而此前 RSI 文献的演化对象(AIDE 的代码树、Dream-RSI 的策略、MASS 的工作流)都是单体内部机制。搜索机制层面:把协同进化与遗传算法的交叉算子引入 LLM 科学发现,但 donor 选择不按总体适应度而按逐实例优势 $\Delta_t(d)=\max_{k:p_k^\star=d}\,u_k(d)-u_k(p_t)$,使“整体差但有局部绝活”的程序能贡献组件;rebase 则像 git 变基,把未兑现的假设移植到更强代码基座上——00795 任务的完整记录展示了“假设被保留→在新基座上首次真正执行→产生改进”的全过程。调度层面:把折扣 UCB 扩展为带请求压力项 $\gamma\psi_f$ 的双前沿分配器,改进按每 token 成本归一($\hat{\mu}_f=G_f/C_f$),把算力意识嵌入探索-利用平衡,区别于固定交替或纯启发式调度。验证层面:代码/科学双审计加“假设信用”门槛,防止有效分数掩盖未真正执行的修改(如 00838 任务中氨基酸替换被下游代码覆盖、评估从未测试该修改),这区别于只看执行分数的进化系统,也是失败分析能把 93.3% 的失败归为“忠实但无增益”的前提。
实验结果
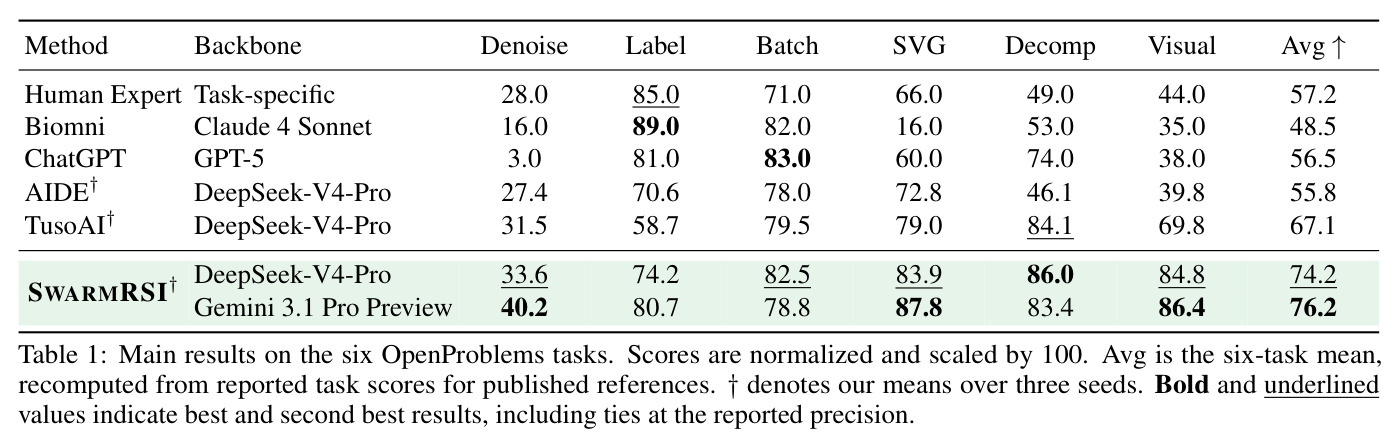
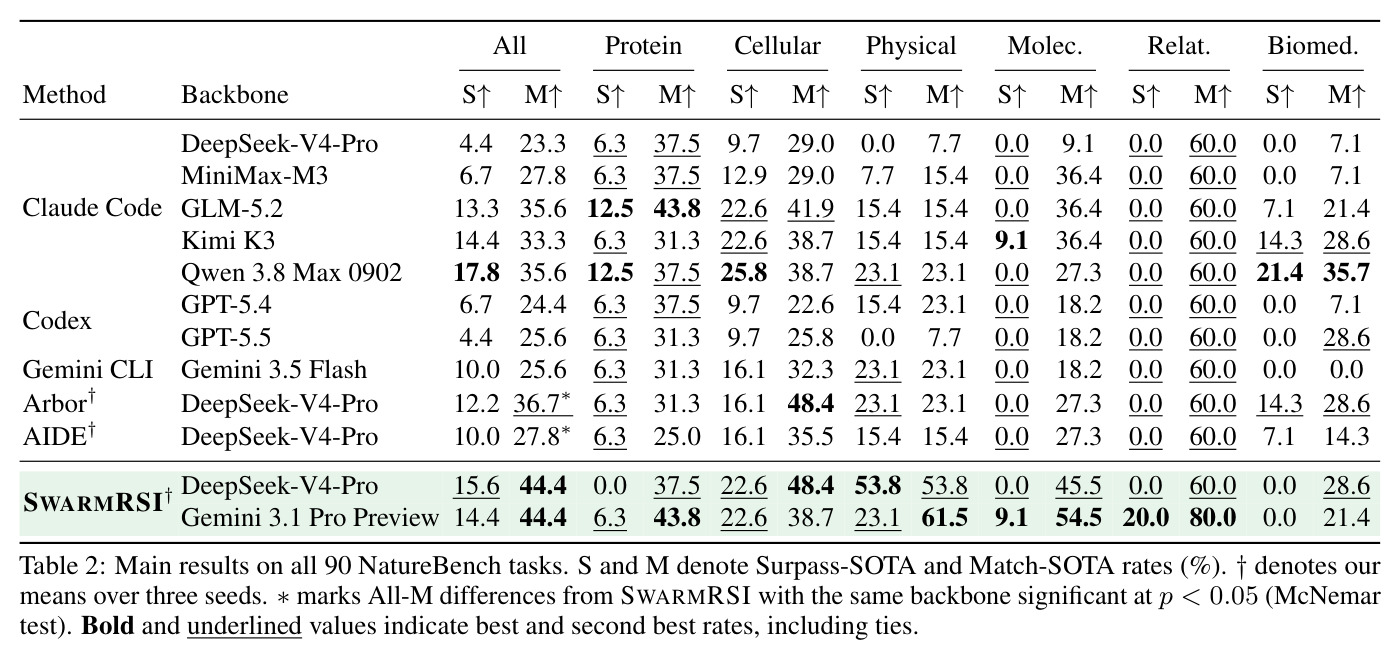
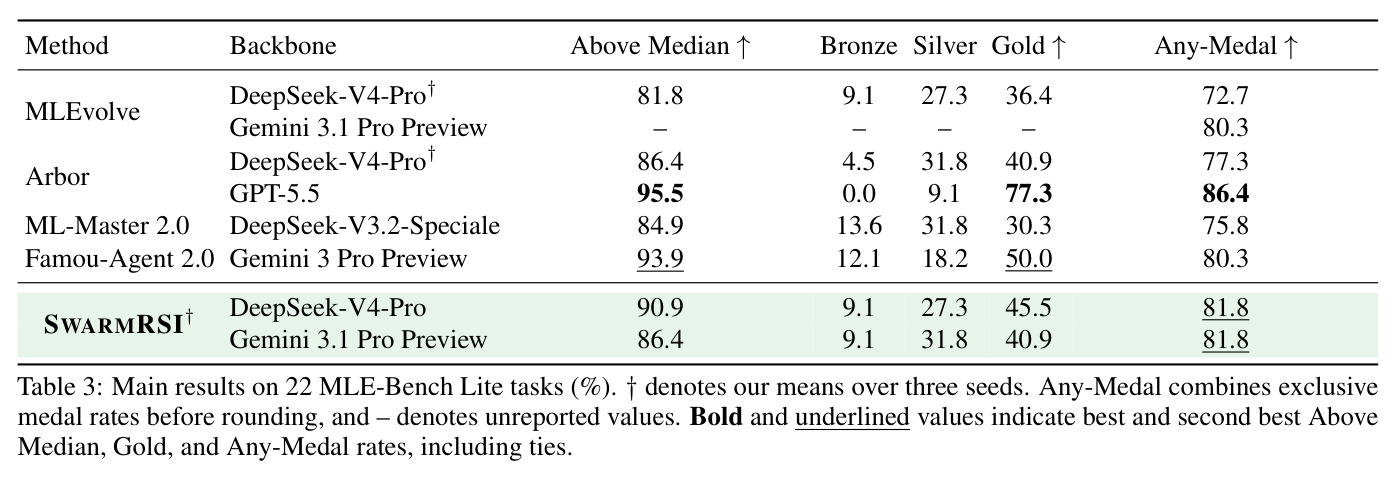
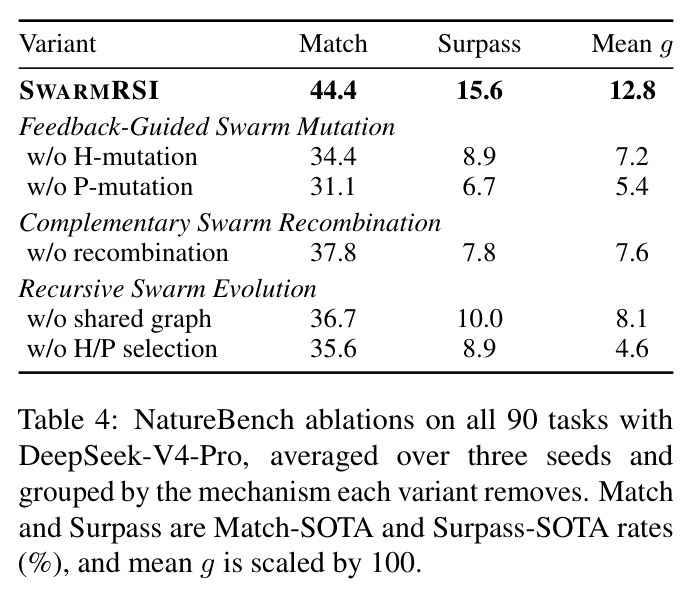
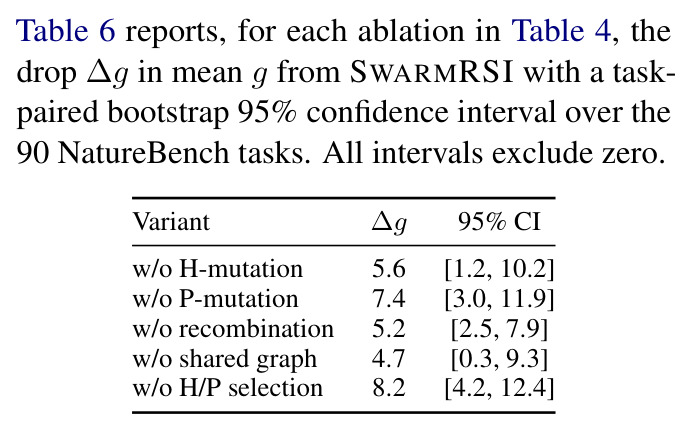
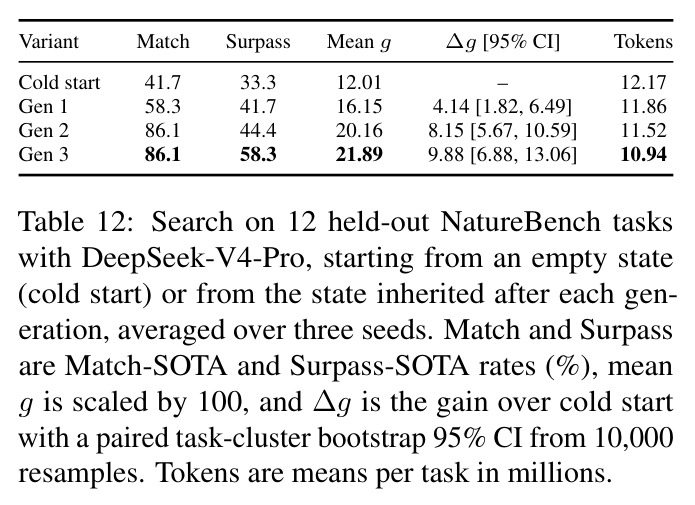
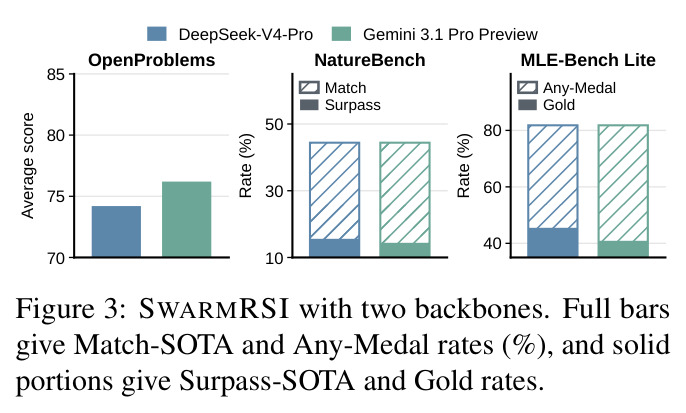
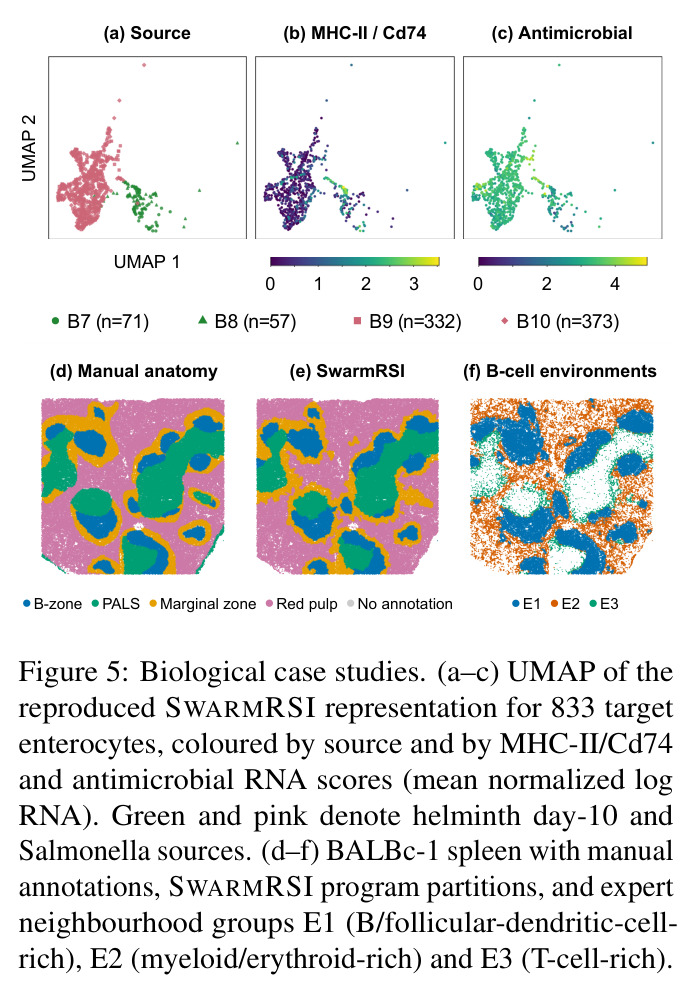
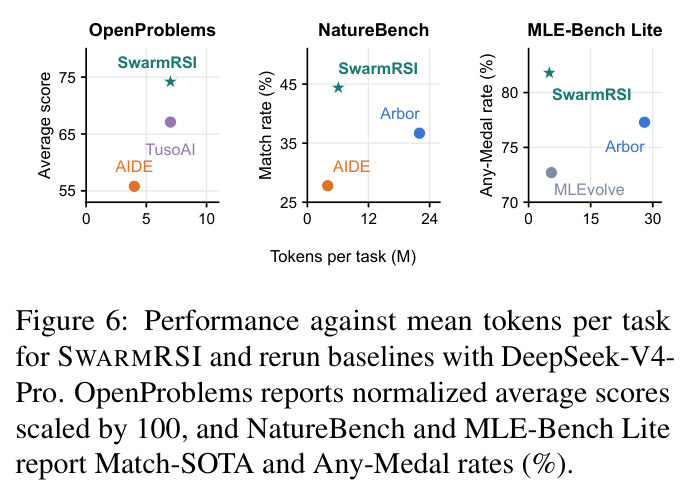
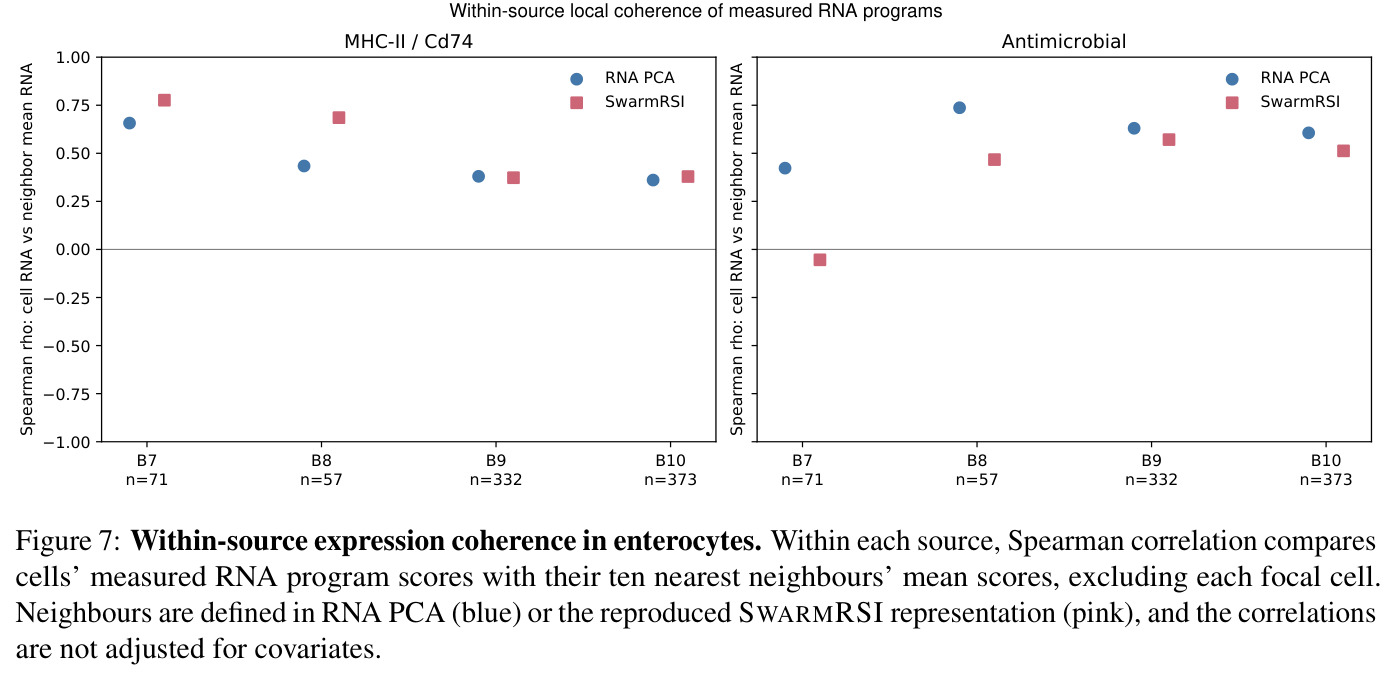
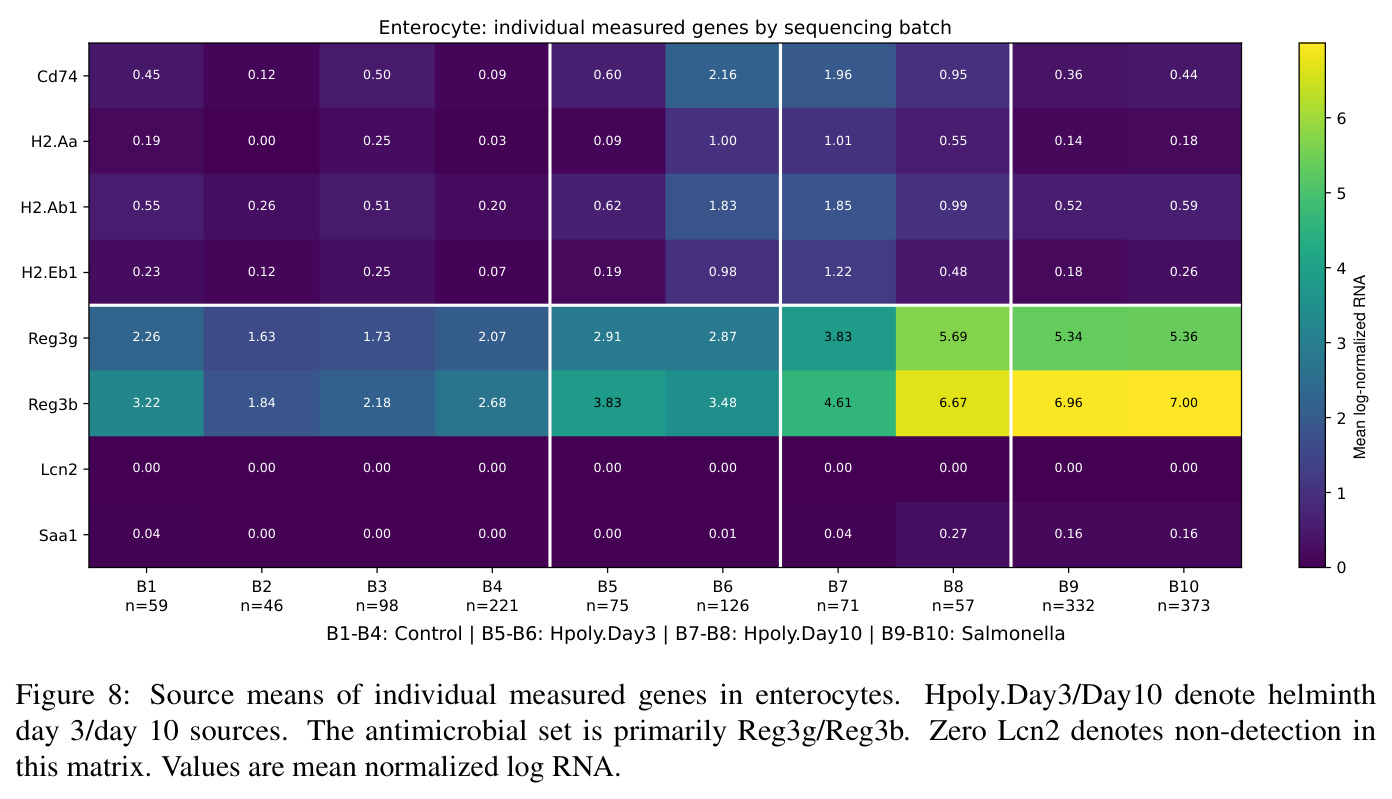
论文围绕四个研究问题在 118 个任务、两个 backbone、三个随机种子上评估。RQ1:OpenProblems 六个单细胞任务上,SwarmRSI 以 DeepSeek-V4-Pro 平均得 74.2、Gemini 3.1 Pro Preview 达 76.2,超过 TusoAI(67.1)、AIDE(55.8)、ChatGPT(56.5)与人类专家(57.2)。NatureBench 90 任务上 Match-SOTA 率 44.4%(两 backbone 相同、全场最高),超同 backbone Arbor 7.8pp(95% CI [2.2,13.3],$p=0.015625$)、AIDE 16.7pp($p=0.0000610$)、Claude Code 21.1pp;Surpass-SOTA 15.6%(Arbor 12.2%)。MLE-Bench Lite 上 Any-Medal 81.8%、Gold 45.5%,超过 Arbor(77.3%)、MLEvolve(72.7%)、Famou-Agent 2.0(80.3%),token 亦低于 TusoAI 与 Arbor(Arbor 约 20.19M/任务)。RQ2 消融:去 P-mutation 掉 13.3pp、去 H-mutation 掉 10.0pp、去 H/P 选择致 mean $g$ 跌幅最大(-8.2)、去共享图掉 7.8pp、去重组掉 6.7pp(Surpass 15.6%→7.8%),95% CI 均不含零。RQ3:失败实现被修复成新最佳的比例 35%(AIDE 12%、Arbor 5%);假设转化为改进的比例 62%(Arbor 17%);停滞率 43%(对比 63%/70%);约 77% 最终最佳程序血统含 rebase、crossover 或反馈触发更新,其新最佳率 28.4% 高于总体 21.9%。RQ4:644 个失败尝试中 93.3% 为忠实执行但无增益,6.7% 是实现/执行问题($\kappa=0.92$)。三代继承把 12 个 held-out 任务的 mean $g$ 从 12.01 提至 21.89、Match-SOTA 从 41.7% 提至 86.1%,token 反降 10%;生物学家成功复现其肠道与脾脏免疫分析程序。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OpenProblems(6 个单细胞分析任务) | 六任务平均归一化分 | 76.2(Gemini 3.1 Pro Preview)/ 74.2(DeepSeek-V4-Pro) | TusoAI 67.1、AIDE 55.8、人类专家 57.2、ChatGPT 56.5 | +9.1 分(vs 最佳基线 TusoAI);+19.0 分(vs AIDE) |
| NatureBench(90 个科学编码任务) | Match-SOTA 率($g\ge0$) | 44.4% | Arbor 36.7%、AIDE 27.8%、Claude Code(同 backbone)23.3% | +7.8pp vs Arbor($p=0.0156$)、+16.7pp vs AIDE($p<0.0001$)、+21.1pp vs Claude Code |
| NatureBench(90 个科学编码任务) | Surpass-SOTA 率($g>0.1$) | 15.6%(DeepSeek) | Arbor 12.2%、AIDE 10.0% | +3.4pp vs Arbor;消融显示其中近半收益来自重组机制 |
| MLE-Bench Lite(22 个 Kaggle 竞赛) | Any-Medal 率 | 81.8%(两个 backbone 相同) | Famou-Agent 2.0 80.3%、Arbor 77.3%、MLEvolve 72.7% | +1.5pp vs 最强对比方法;+4.5pp vs 同 backbone Arbor |
| MLE-Bench Lite(22 个 Kaggle 竞赛) | Gold 奖牌率 | 45.5%(DeepSeek-V4-Pro) | Arbor 40.9%、MLEvolve 36.4%、ML-Master 2.0 30.3% | +4.6pp vs Arbor |
| NatureBench 搜索过程诊断 | 失败实现恢复率(失败实现被后续精炼成新最佳的比例) | 35% | AIDE 12%、Arbor 5% | +23pp vs AIDE、+30pp vs Arbor |
| NatureBench 跨任务迁移(12 个 held-out 任务) | Match-SOTA 率 / mean g | 86.1% / 21.89(三代继承后) | 冷启动(空状态)41.7% / 12.01 | +44.4pp / +9.88(95% CI [6.88,13.06]),token 反而降 10% |
局限与改进
作者在附录 F 承认:系统依赖可执行评估器,无执行反馈的研究形式不在范围内;执行反馈不总能揭示干预是否被忠实实现;性能增益本身不能确立科学机制;rebase 的需求-标签匹配是启发式,不度量程序实际能力;crossover 只适用于报告逐实例分数的基准;H/P 选择借用折扣 UCB 但未继承其理论保证,收益纯属经验性。评估范围上,跨任务迁移证据只来自 6 个源任务、12 个 held-out 任务和单一 backbone,且继承代数与见过的源任务数量混淆;未单独评估文献综合、想法质量与评审质量。我的补充观察:其一,93.3% 的失败是“忠实但无增益”,说明假设产生环节仍低效,群体反馈回路主要在实现层面增值,对研究方向本身的判断力有限;其二,所有基准都有标准答案和自动评分器,真实科研中评估往往昂贵、缓慢或主观,共享图的反馈质量会随之退化,论文未测试评估噪声对 H/P 分配的污染;其三,两 backbone 下 NatureBench Match-SOTA 均为 44.4%,提示收益主要来自框架而非模型,但缺少异构模型混合群体的实验;其四,token 绝对成本仍高(约每任务 10-12M),且未报告性能-预算敏感性曲线。
独立分析的弱点
独立分析几点弱点。其一,组件复用依赖“机制标签”:rebase 用记录需求与程序机制标签的重叠度选基座,标签由 LLM 生成,标签错则 rebase 选错基座;改进方向是学习程序能力的向量表示或用执行轨迹做内容级检索。其二,crossover 需要 per-instance 分数,聚合单分的任务(多数真实科研评测)无法使用;可改用组件级消融或因果归因定位局部优势组件。其三,共享图随搜索无限增长,Assemble 依赖相关记录检索,90 任务规模下未见瓶颈报告,但数百任务、数千实验的长周期场景中图的摘要、索引与遗忘机制会成为关键问题。其四,93.3% 的失败是无增益干预,说明假设空间先验太弱、搜索仍近乎盲目;可引入文献接地(把已发表机制的先验注入假设生成)或显式假设多样性约束。其五,评估器噪声会直接污染 $\hat{\mu}_f$ 与假设信用:论文用三种子平均,但未研究评估方差对前沿分配的影响,可加入序贯显著性检验或置信区间门槛再记账。其六,双审计只能证明“代码没白写”,不能证明科学上正确——02316 任务中负二项混合加 Potts 先验正确运行却把所有位置坍缩成一个簇(ARI 为 0)仍被记为有效评估;需要领域特定的合理性检查接口或人工抽样机制。
未来方向
作者提出的方向包括:把评估扩展到完整科研工作流(文献综合、想法产生、同行评审质量需要单独评估);在论文列举的未测场景(法律推理、零样本实体抽取、对话推荐、购物研究)验证泛化;把安全性与代码执行隔离纳入审计范围;为部署设置人工监督与凭据隔离。基于其成果可自然延伸的方向:其一,异构群体——让不同能力、不同成本的模型共存于同一张图,用请求压力机制 $\gamma\psi_f$ 把难问题路由给强模型、 routine 修复交给便宜模型;其二,把跨任务迁移从 6 任务 3 代扩展为持续学习式长生命周期,重点研究图的压缩与知识沉淀(毕竟 77% 的最终程序受益于继承,继承收益何时饱和值得量化);其三,理论层面为带请求压力的双前沿分配器证明遗憾界,或至少刻画其与标准折扣 UCB 的偏差;其四,与湿实验闭环,让评估器从 GPU 脚本扩展为真实实验室协议,此时 deepen/broaden 请求就自然变成向人类实验员下的实验订单;其五,把失败分类(忠实无增益 vs 实现失败)自动化,替代人工标注,让失败分析本身成为反馈回路的一部分。
复现评估
复现条件较透明但有门槛。有利因素:三个基准全部公开(OpenProblems 开源、NatureBench 有公开排行榜、MLE-Bench Lite 有官方仓库与排行榜);指标定义明确($g_i$ 公式、Match/Surpass 阈值、无效结果计入分母);超参完整披露($\rho=0.9$、$\beta=0.5$、$\gamma=0.25$、$K=4$、$W=8$、$T=1000$ tokens/成本单位、活跃假设/程序代表 4/8 等);时间预算(每任务 8h/4h/12h)、硬件(OpenProblems 4 CPU+50GB、NatureBench 每任务 1 GPU、MLE-Bench Lite 21 vCPU+234GB+1 GPU)、三种子聚合与显著性检验方法(配对 bootstrap 10,000 次、McNemar 精确检验)全部给出;生物案例数据(GEO GSE92332、三张 CODEX 脾脏图像)与专家分析流程在附录 E 逐步说明。不利因素:正文未给出开源代码链接,双审计、请求系统、图检索等工程细节需自行实现;复现主表需大量 API 调用,每任务约 10-12M tokens,90 任务 × 3 种子约 30 亿 token 量级,成本不低;完整消融还需五组同等规模运行。总体:方法论复现难度中等偏高,单任务机制验证(如复现 00795 的 rebase 序列)难度中等。
论文图表
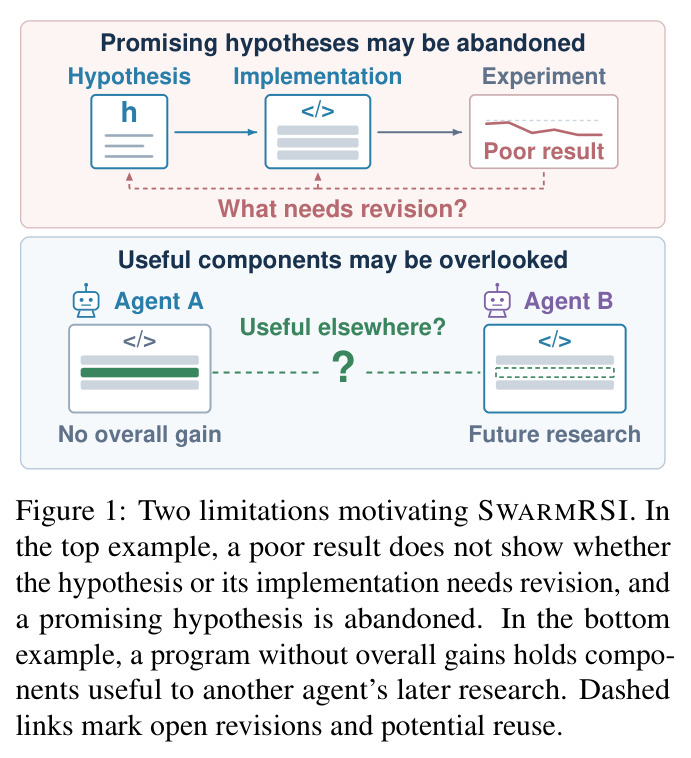
动机示意图,分上下两格:上格中 Agent A 的实验结果差,但无法区分是假设还是实现的问题,导致有前景的假设被整体放弃;下格中 Agent B 的程序整体无增益,其中却含有对 Agent A 后续研究有用的组件而被忽视。虚线标出未完成的修订和潜在的复用机会。
这张图一图道尽全文动机——归因失败与组件低估两大障碍,后续三大机制(反馈引导变异、rebase、crossover)正是分别针对这两个问题设计的。