HexaShell:探索VLM编码智能体操控机器人极限的薄壳适配器 HexaShell: A Thin Harness for Exploring the Limits of VLM Agents as Robot Coding Agents
薄壳适配器让编码智能体写工具操控双臂机器人,三角测量定位登顶RoboDojo
前置知识
编码智能体(Coding Agent)
在软件仓库中自主工作的LLM智能体:读代码、运行测试、根据报错修改代码,并把修复以代码形式持久保留(如Codex CLI)。它把'失败信息→代码修改'变成一个可无限迭代的循环,且每次修复都沉淀在仓库里供下次复用。
HexaShell的整个框架就是把这一循环原样搬到机器人上:一个失败的机器人episode相当于一次失败的测试,工具库相当于仓库代码,优化智能体相当于修bug的程序员。理解这个类比才能理解全文动机。
VLM与VLA策略
视觉语言模型(VLM)接收图像和文本、输出文本;视觉-语言-动作模型(VLA)在世界动作模型基础上从大量机器人演示中端到端学习,直接输出机械臂动作。RoboDojo排行榜此前由VPP2、PhysicalRSI等学习型策略占据前列。
本文的对照组就是这两类:学习型策略(演示驱动、有接触优势)和无工具的VLM智能体(GPT-6-Astra仅22.5%)。HexaShell的定位是在两者之间开辟'编码智能体+几何工具'的第三条路线。
多视图三角测量
像素加上相机内外参定义了一条世界坐标系中的射线 $r(t)=o+td$,单条射线定不出深度;若两个标定相机看到同一个点,两条射线近乎相交,交点(或公垂线中点)即该点的3D位置。这是经典多视图几何,用OpenCV即可实现,无需任何学习模型。
这是本文定位工具的核心机制:模型只负责在两幅图像中指出同一目标像素,工具算出交点。论文证明它比深度网络可靠得多(中位误差从41-100mm降到毫米级),是39.7%成绩的直接来源。
平面扫描(plane sweep)
对一组候选平面高度,把一台相机的图像按该平面的单应变换warp到另一台相机的视角,逐高度计算两幅warp后图像的一致性,一致性最高的高度即为真实平面高度。table_plane工具用它episode内测得桌面高度约0.765m,三对相机结果一致性在1mm内。
已知平面是'射线+平面=点'定位法的第一约束:桌面、方块顶面、碗沿等水平面高度一旦测得,其上任何像素的射线与平面相交即得3D点。没有这一步,纯RGB定位无从谈起。
主动感知(active perception)
主动移动传感器以获得更好的观测视角。在RoboDojo中每个任务有步数上限(200-1900步,push T为600步即24秒机器人时间),移动腕部相机去看一眼也消耗步数,而静止观测和思考免费——'看'由此变成显式预算内的开销。
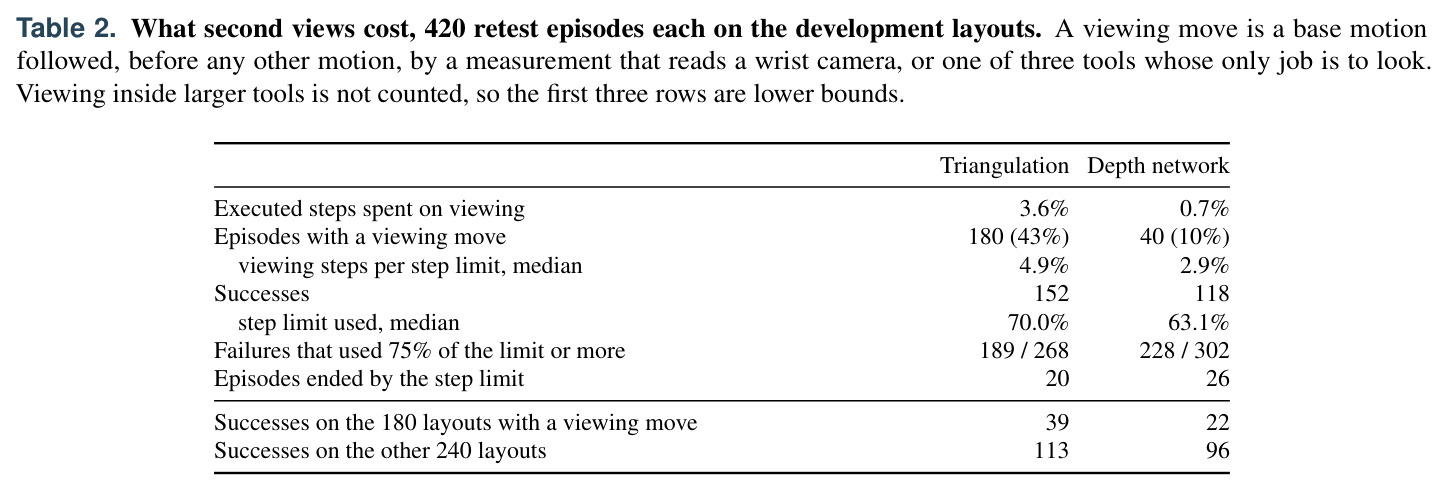
论文首次定量刻画了这一权衡:观看动作占执行步数至少3.6%(深度网络版仅0.7%),但在用到观看的180个布局上39:22胜过深度网络($p=0.002$)。理解步数经济性是理解方法设计的关键。
薄壳适配器(thin harness)
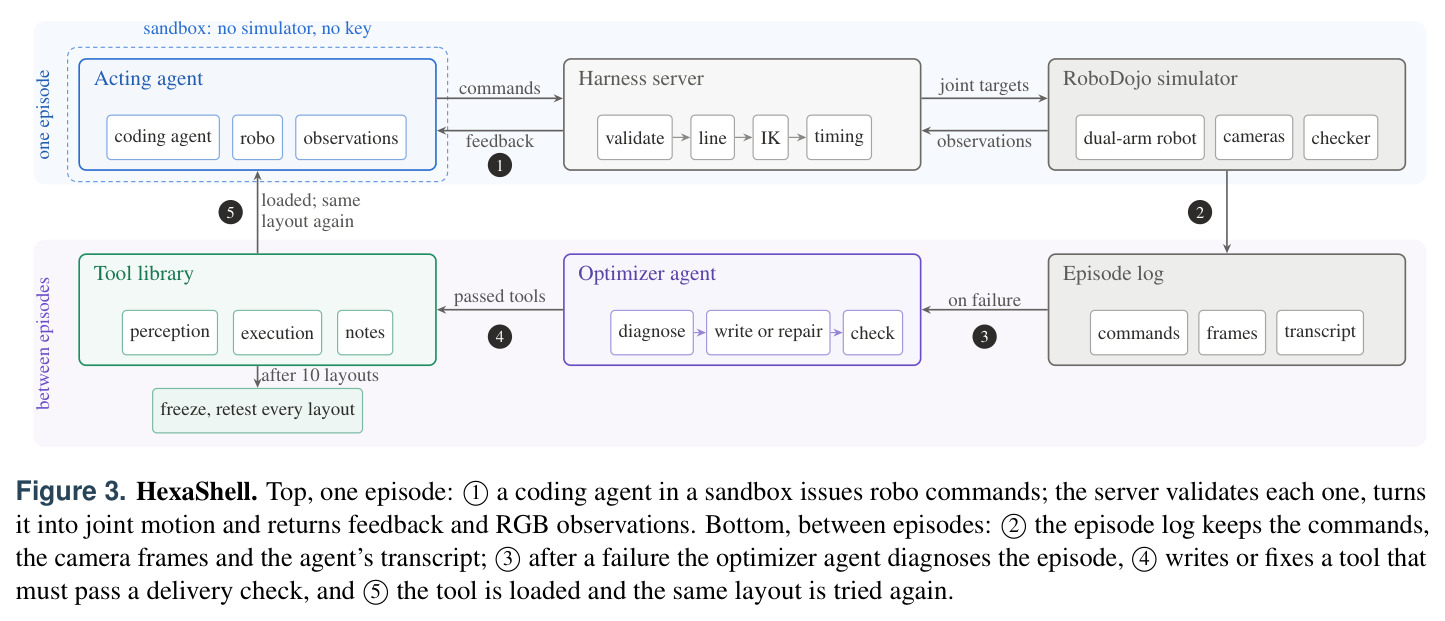
只做'命令→运动'翻译、不做任何决策的机器人接口层:校验命令、以2cm间距插值笛卡尔直线路径、用cuRobo逐路点解逆运动学、梯形速度规划、按25Hz经官方take_action执行。无运动规划器、无碰撞模型(仅机械臂和桌子)、容器内无模拟器和API密钥。
薄壳设计保证测得的成功率完全归因于智能体自己写的工具而非适配器的隐藏智能——这是本文能声称'测量编码智能体上限'的架构前提,也是与Show-Harness等固定适配器工作的本质区别。
研究动机
机器人操作排行榜长期由学习型策略主导:视觉-语言-动作模型(VLA)和世界动作模型从大规模演示数据中学习并直接输出动作。以RoboDojo排行榜(2026年10月14日快照)为例,最好的学习型策略VPP2(世界动作模型)成功率仅32.26%、进度分39.26,PhysicalRSI为31.38%/36.27,且它们在杂乱场景下大幅退化(VPP2从46.4%跌至12.6%)。另一方面,让VLM直接当策略用效果很差:GPT-6-Astra通过基准作者写死的固定适配器选夹爪目标,成功率只有22.48%。核心瓶颈是'把像素变成位置':抓取需要约1厘米精度的世界坐标,而标准观测没有深度图;单目深度网络Depth Anything V2即使用桌面平面固定尺度,在头部相机的中位误差仍有41mm、腕部相机约100mm,Depth Pro和MoGe也只能把腕部误差压到21-72mm;VLM本身对图像中的度量距离判断同样很差,无法支撑厘米级操作。
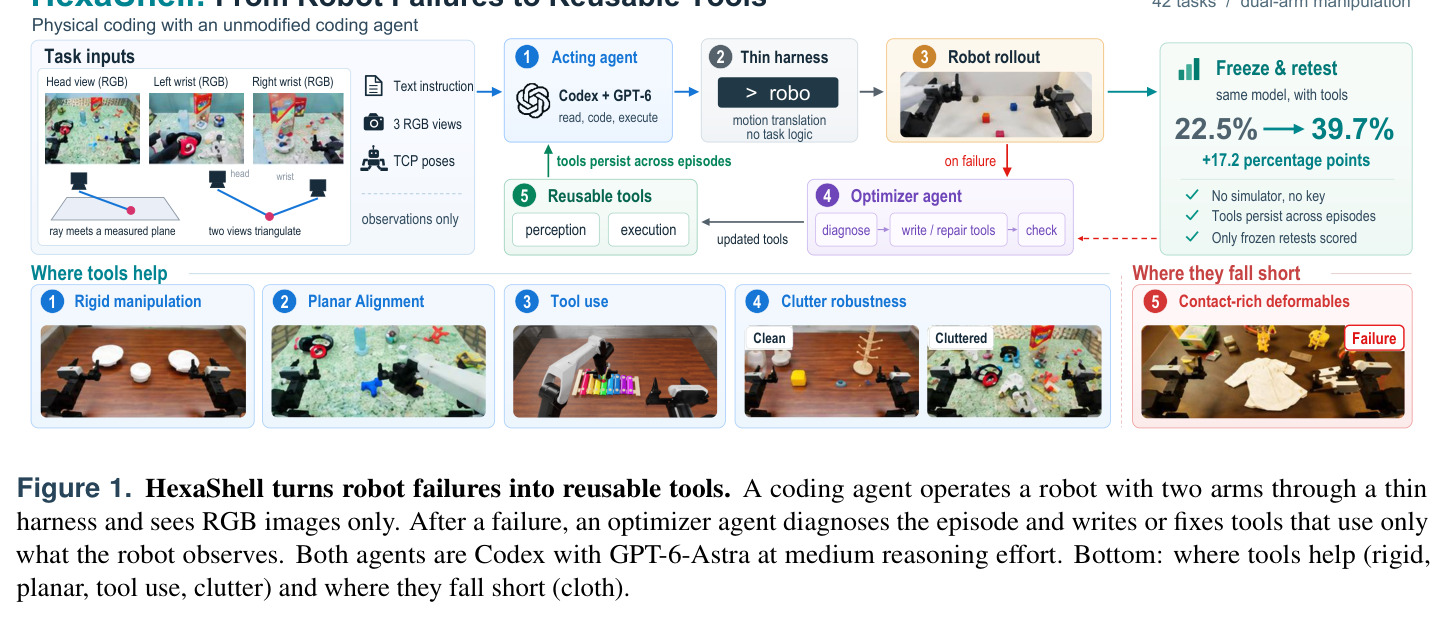
本文的目标是本文想回答两个问题:当一个软件世界的编码智能体(coding agent)去操控机器人而不是电脑时,它能走多远、又在哪里停下?具体目标是在不修改模型、不收集机器人演示数据、不做任何训练的前提下,让未经改动的Codex + GPT-6-Astra(medium reasoning档)通过一个极薄的适配器驱动双臂机器人,把每次失败episode转化为可复用、带单元测试的小工具代码,从而:(1) 在RoboDojo全部42个任务上超越所有学习型策略;(2) 定量刻画VLM智能体在物理世界的能力边界——哪些任务类型(推动、记忆、语言理解)可以成功,哪些(紧凑插入、布料)无法完成,以及每次失败究竟是感知缺陷还是执行缺陷。整个系统只需一块RTX 4090和每任务12小时开发预算。
与已有工作不同的是,独特切入是'颠倒分工'加上'测量而非构建'。此前Code as Policies、VoxPoser、ReKep、SayCan等工作里,人类编写感知与控制原语,语言模型为每条指令生成一段用完即弃的程序;HexaShell反过来:智能体编写并持续优化的原语(工具)跨episode持久存在且正是被优化的对象,而每集程序很短。与URAI、MEMENTO、Gao et al.等并行工作的定性展示不同,本文的核心贡献是测量:在完整基准的10个开发布局上构建工具后冻结,再在从未见过的10个新布局上盲测,从而量化这类方法的上限与停点。第三个差异点是用标定相机的三角测量几何替代深度网络做纯RGB定位——'模型选像素、代码测世界'——并把主动感知的每次'多看一眼'显式计入任务步数预算,使看的成本与收益第一次变得可测量。
核心方法
直觉:就像编码智能体在软件仓库里读代码、跑测试、看报错、修代码并保留修复,HexaShell让智能体在机器人上做完全相同的事——把学到的经验固化为带单元测试的小工具。技术路线分三部分。(1) 薄壳适配器:沙箱容器里未改动的编码智能体只有一个robo命令行和一份约60行的手册,服务端把命令变成运动——校验、按2cm间距插值笛卡尔直线路径、用cuRobo逐路点解逆运动学、梯形速度规划、按25Hz采样经官方take_action执行——此外不做任何决策,无运动规划器、无碰撞模型(仅机械臂和桌子)。(2) RGB测量工具:只用标定几何定位,三种约束——平面扫描测得的桌面(三相机对一致性1mm内,约0.765m)、任意已知水平面(方块顶面、碗沿、槽口)、双视图三角测量;需要第二视角时移动腕部相机(消耗步数)。(3) 进化循环:执行智能体尝试布局,失败后同模型的优化智能体读episode日志诊断、写或修工具并跑单元测试,同一布局重试(每布局至多5次编辑),10个开发布局跑完后冻结工具,在新布局上盲测。
核心创新是与已有工作的三点本质区别。其一,'学习成果=代码工具':Code as Policies、SayCan等每次丢弃程序、人类写原语,这里智能体写的原语跨episode持久存在且正是被优化的对象;与Voyager、Reflexion、Eureka等自改进智能体不同,脚手架、提示与基础接口全部固定,只允许改任务工具,且接受标准是同一布局的一次全新真实执行(由基准官方检查器判定),而非自我评估——避免了自我评判的漂移。其二,'模型选像素、代码测世界'的分工:VLM只负责在图像上指出目标像素(它擅长的事),工具用OpenCV多视图几何把射线变成坐标——两条射线相交、或射线与已知平面相交——不训练任何视觉模型;同一管线对比Depth Anything V2高8.7个百分点,配对布局57胜23负(McNemar $p<0.001$)。其三,把主动感知的代价显式化:第二视角消耗至少3.6%的执行步数,在有步数上限的基准上'看'成为可量化的权衡,而非免费的工程细节。
方法步骤详情
第一步,搭建观测与接口:容器内运行原版Codex CLI(无网络直连、无API密钥),obs/目录提供三路640×480 RGB(头部+双腕)、各相机内外参、双臂TCP位姿与关节角,无深度图;基础命令为move/rotate/point/gripper/home/wait/obs/status/done,每条返回规划结论与剩余预算。第二步,episode内测量:table_plane工具首次调用时免费做平面扫描测桌面高度(不耗步数);物体顶面(方块顶面、碗沿、槽口)高度测得后,其上像素的射线与该平面相交即得3D点;遮挡或角度不佳时,移动腕部相机到目标上方做双视图三角测量,对应像素由智能体指定或由模板匹配、轮廓、圆拟合求出。第三步,进化循环:按布局0-9逐个尝试;失败后优化智能体读命令日志、每条命令的相机帧和工具代码,写诊断到skill.md,编辑工具(中位+118/-6行)并跑单元测试,交付检查(文件完整、可加载、接口文本不含任务/物体名)通过后重启仿真重试,至多5次。第四步,冻结重测:冻结后在10个开发布局和10个新布局(seed 0的布局10-19)各跑一次,正式成绩只统计后者。
技术新颖性
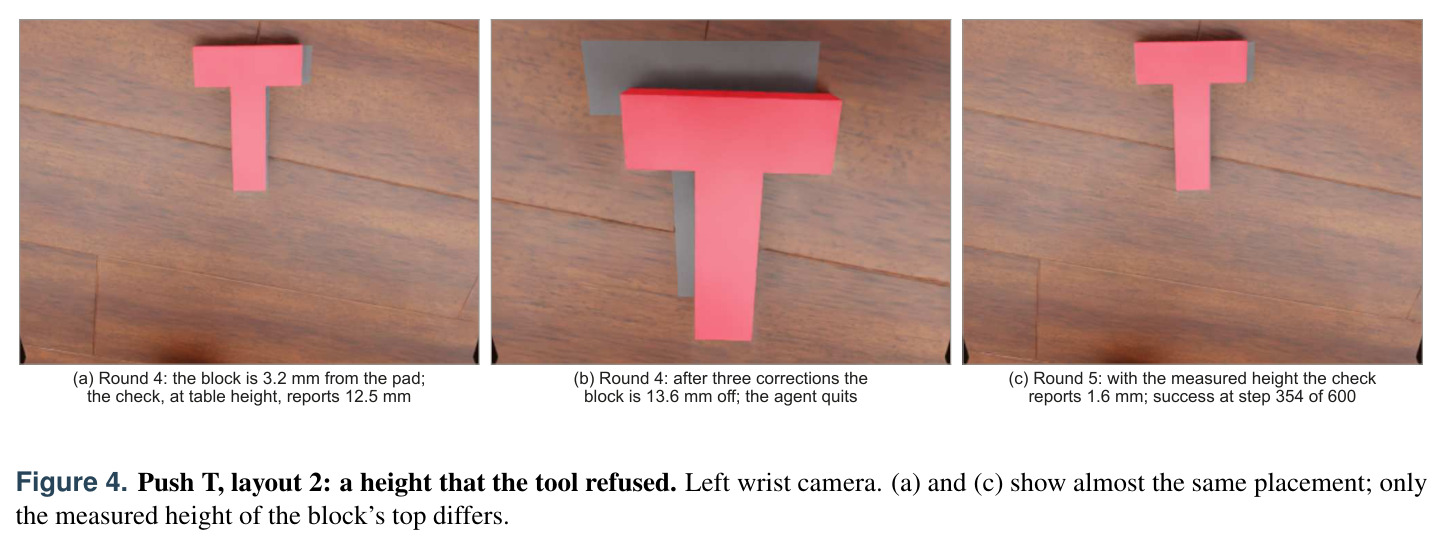
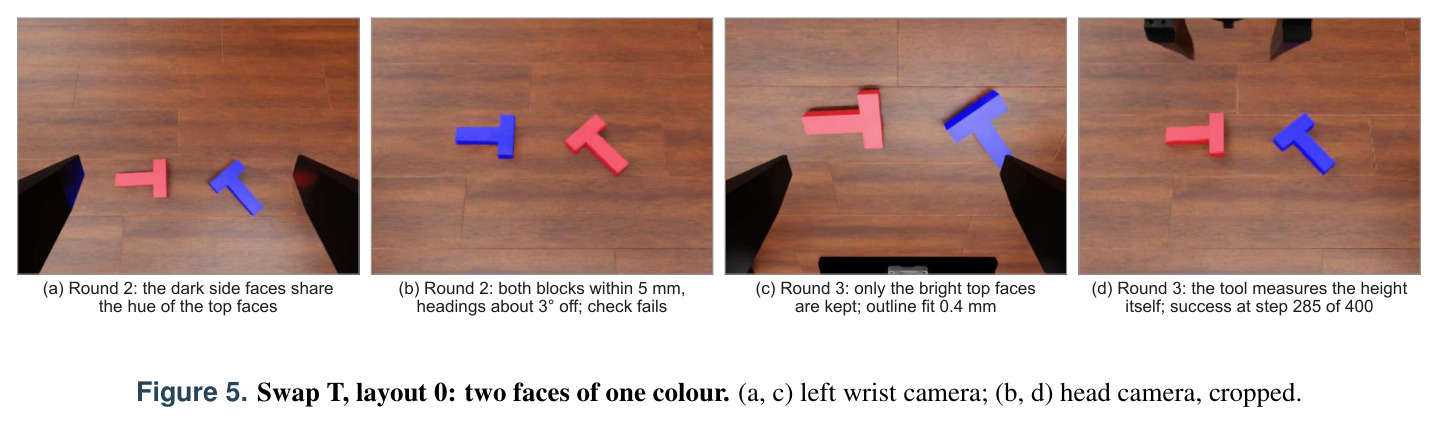
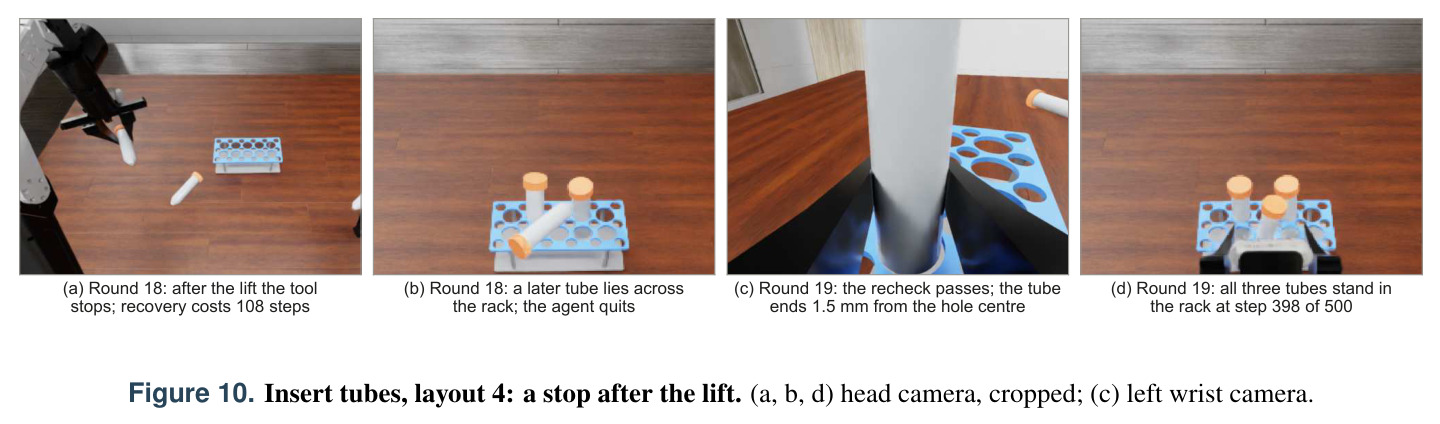
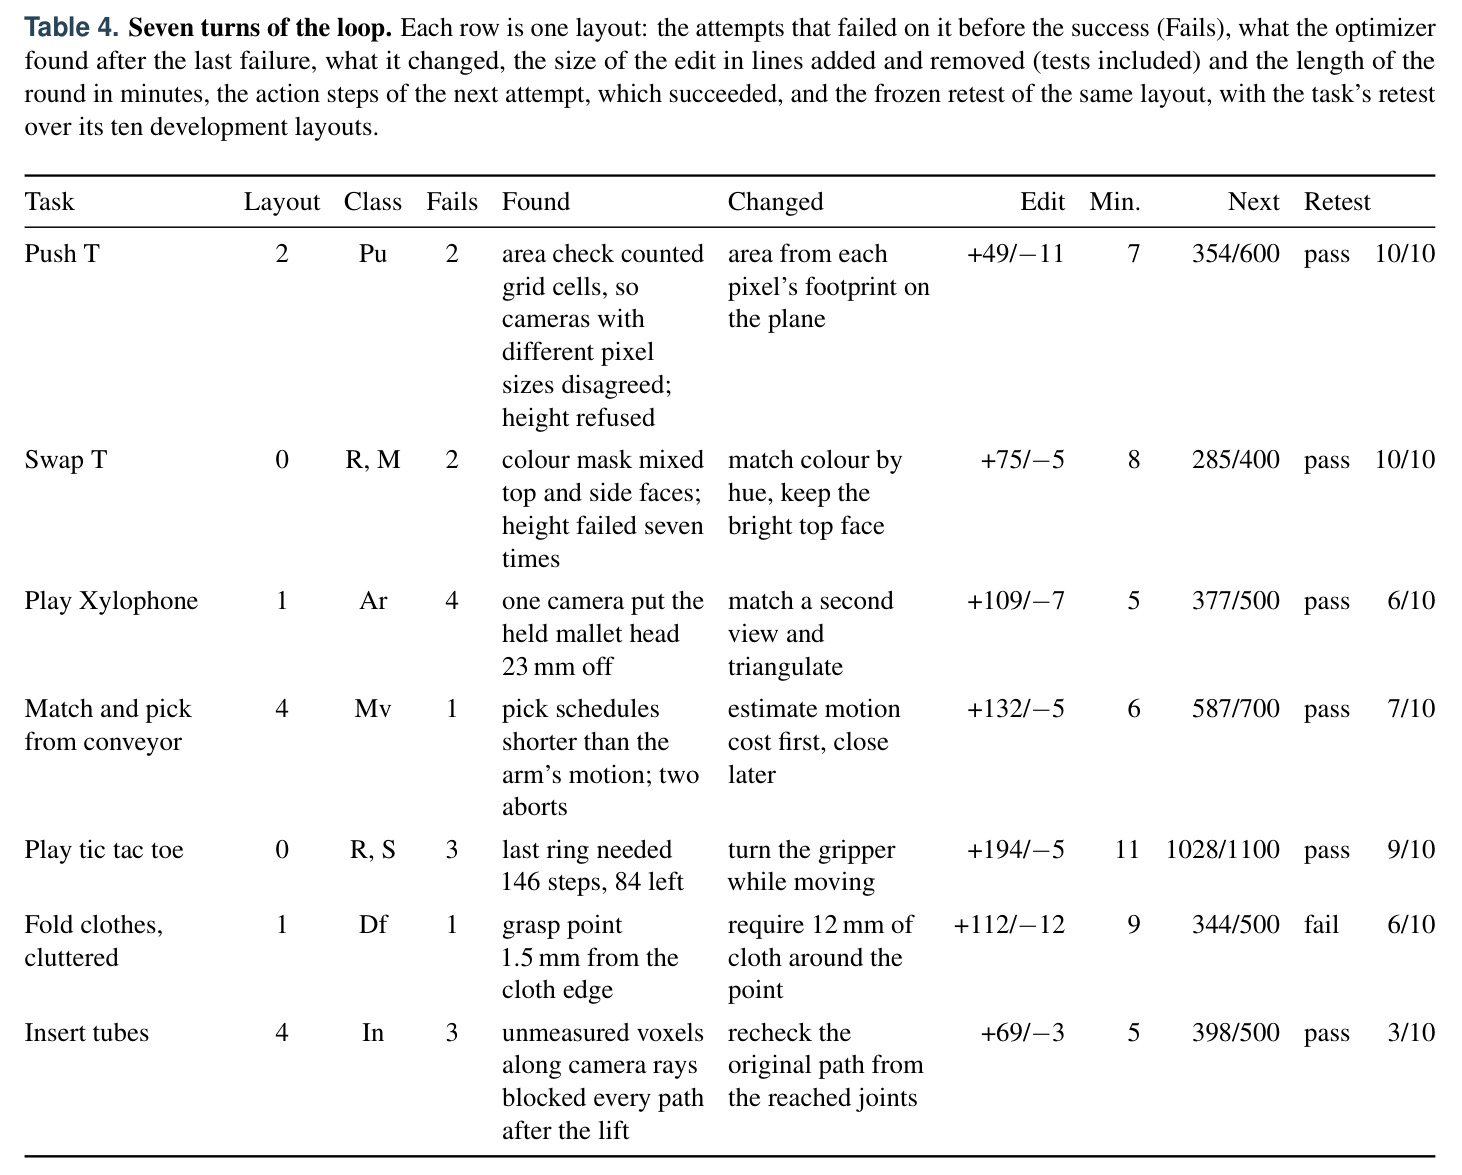
技术新颖性有四点。(1) 系统极简但边界清晰:适配器只做'命令→运动'翻译,容器里没有模拟器、任务逻辑和评分代码,成功与否完全由基准官方检查器判定、由智能体写的工具决定,这使'编码智能体上限'第一次成为可测量的量。(2) 纯RGB测量管线的工程化与防泄漏审计:所有关于物体的数字必须在episode内测得,禁止使用基准资产/布局/配置;事后审计逐字面量比对工具代码与任务定义,发现7个任务残留固定几何常量,替换为episode内测量后从3/70归零重测——这种诚实审计在同类工作中罕见。(3) 主动感知成本的首次定量刻画:观看动作占执行步数至少3.6%(深度网络版0.7%),43%的episode含观看移动;但在用到观看的180个布局上39:22胜过深度网络($p=0.002$),且观看并未加剧步数紧张(耗尽步数的episode为20对26),证明'花步数去看'是划算的。(4) 七个端到端修复案例(Table 4)完整展示失败→日志诊断(7个案例中5个优化器不看图像)→局部修复→单元测试→复测的闭环。
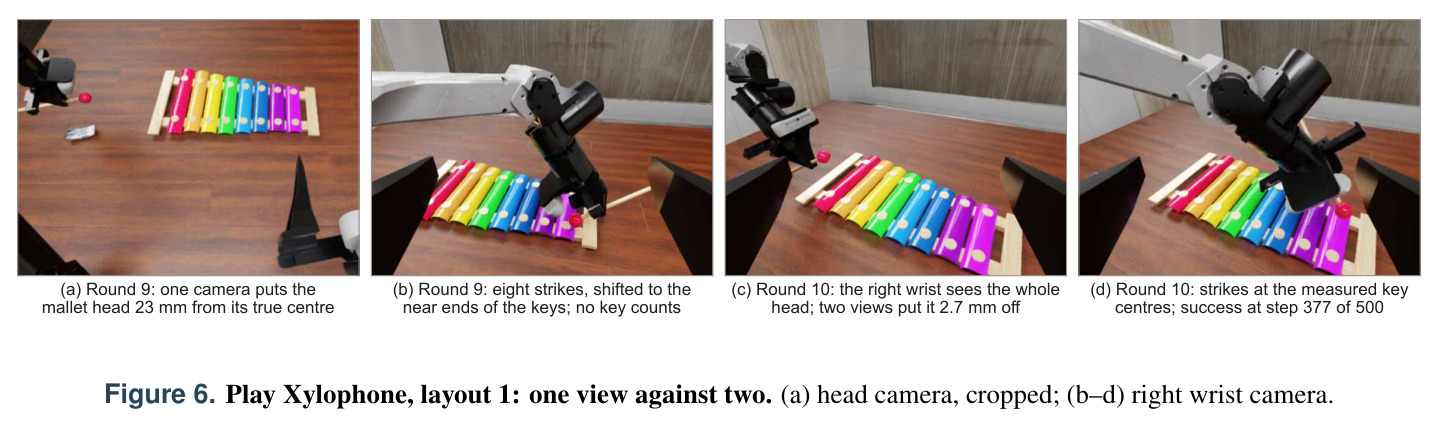
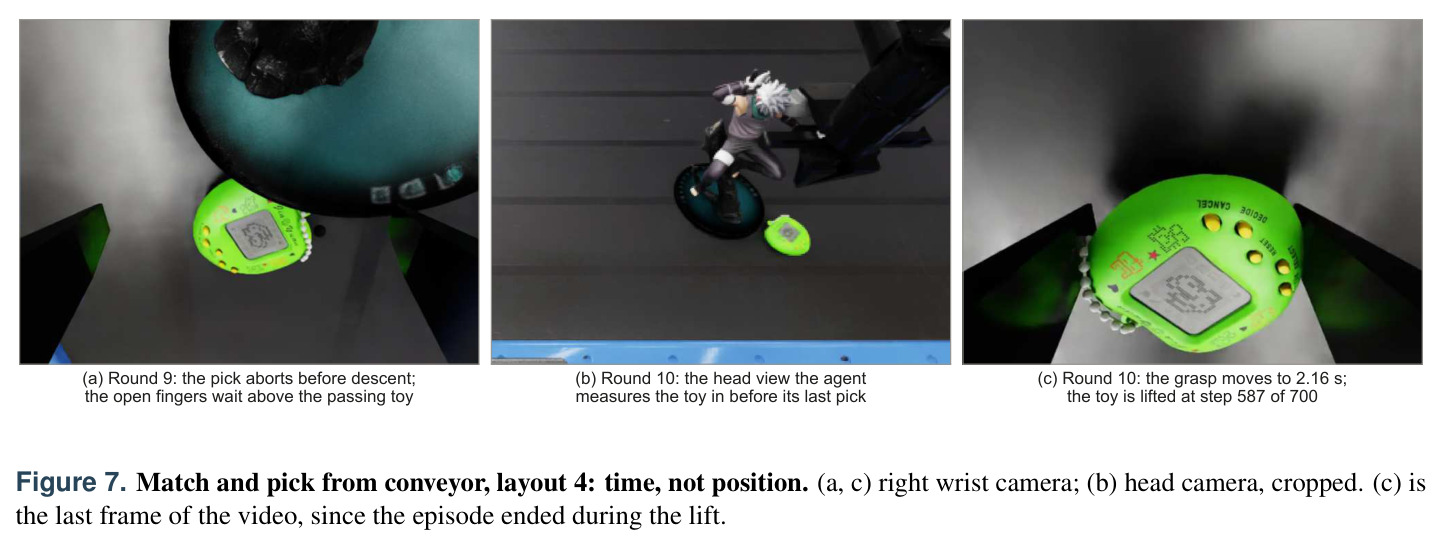
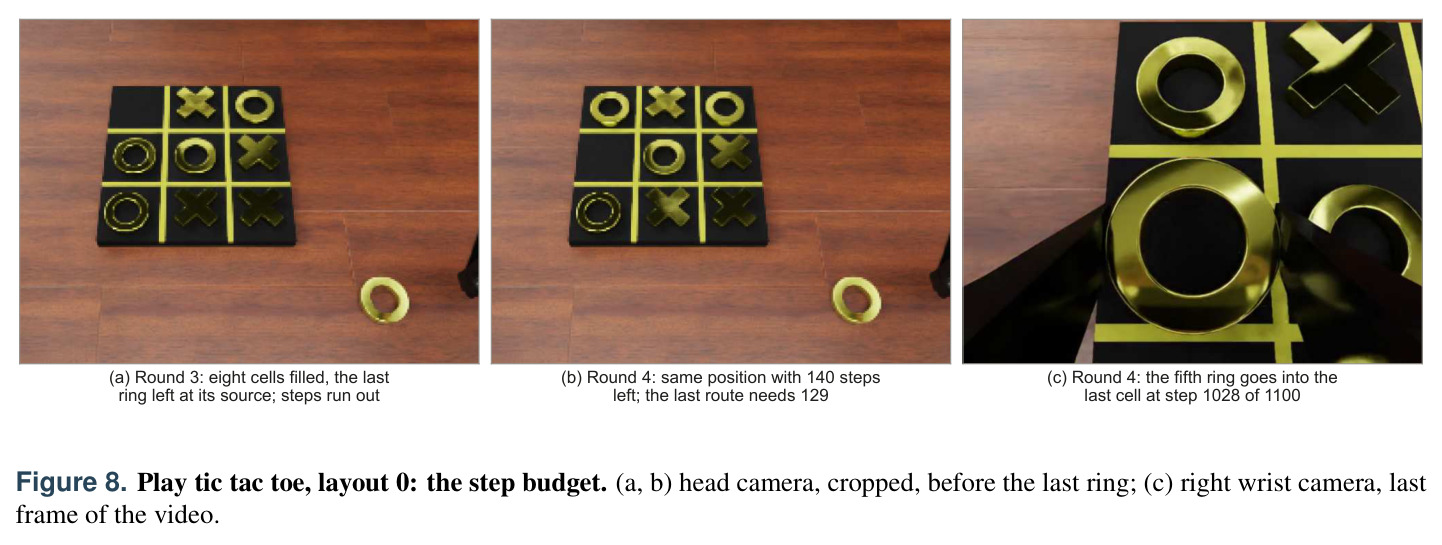
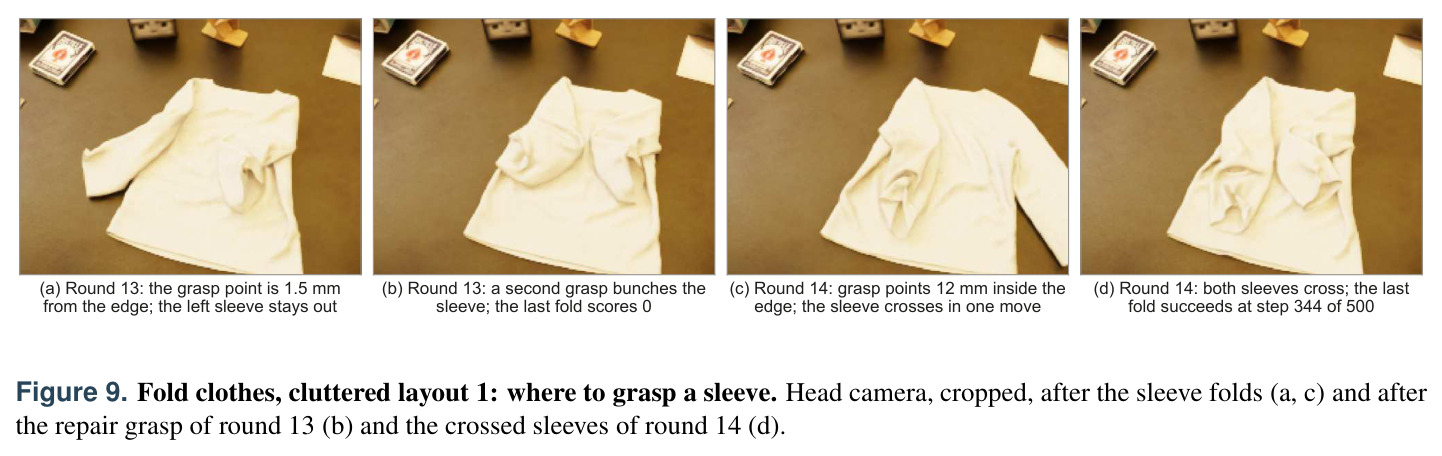
实验结果
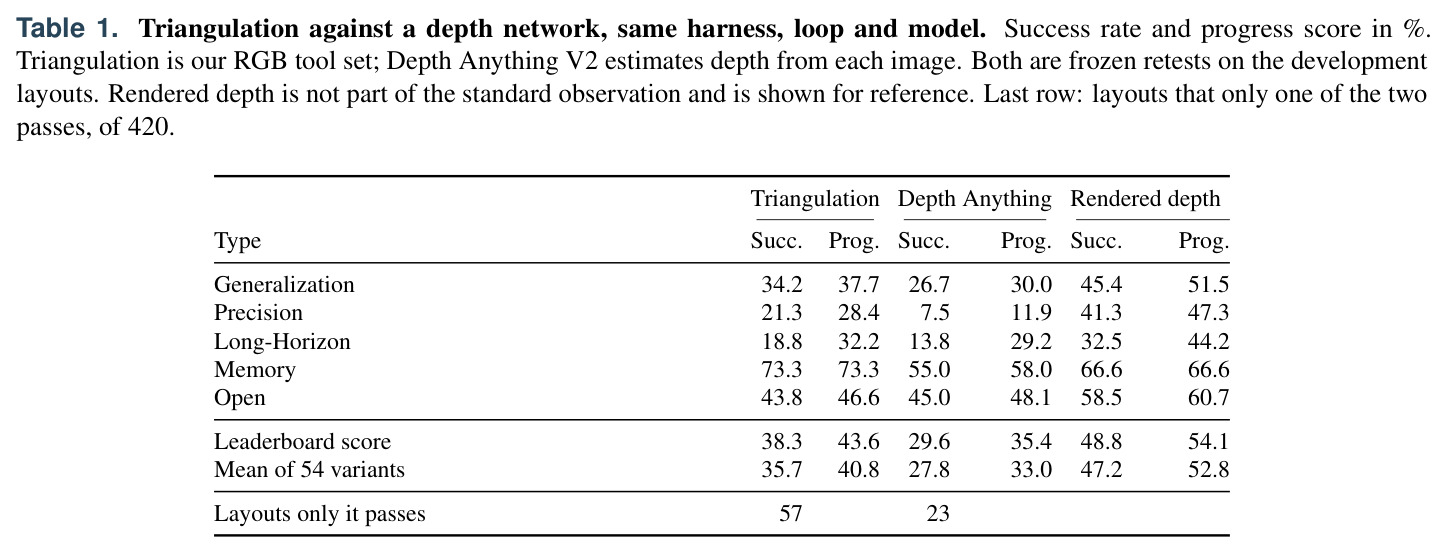
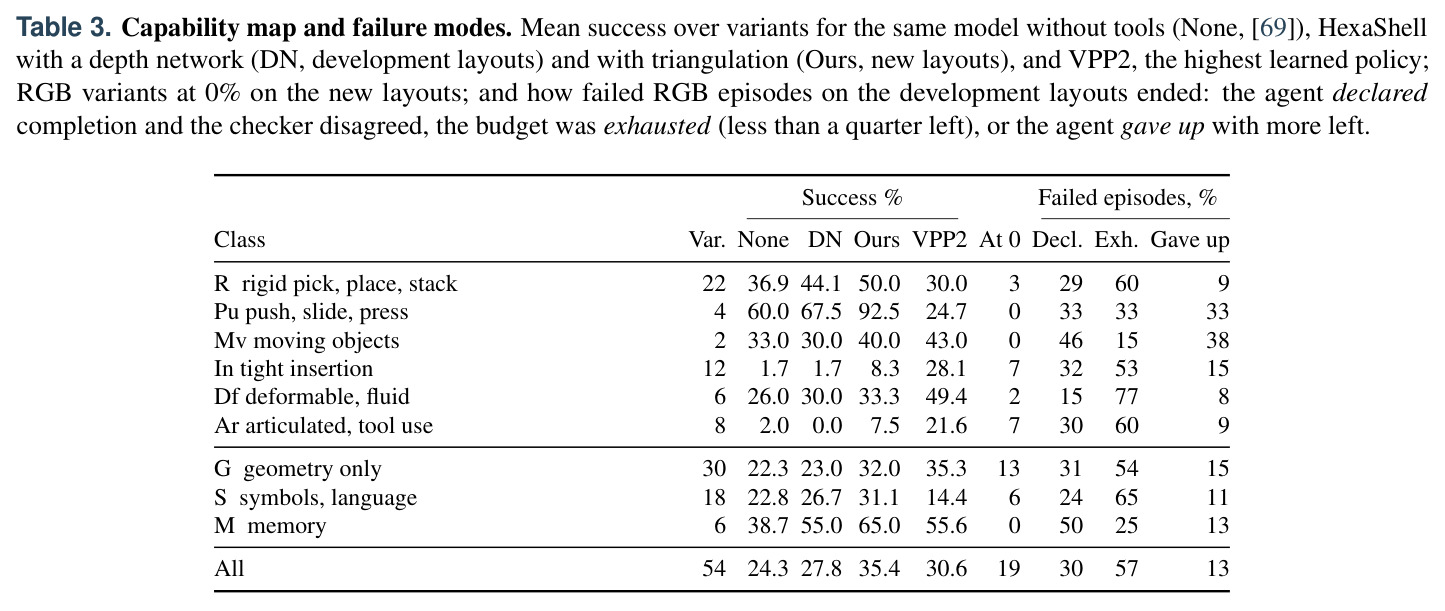
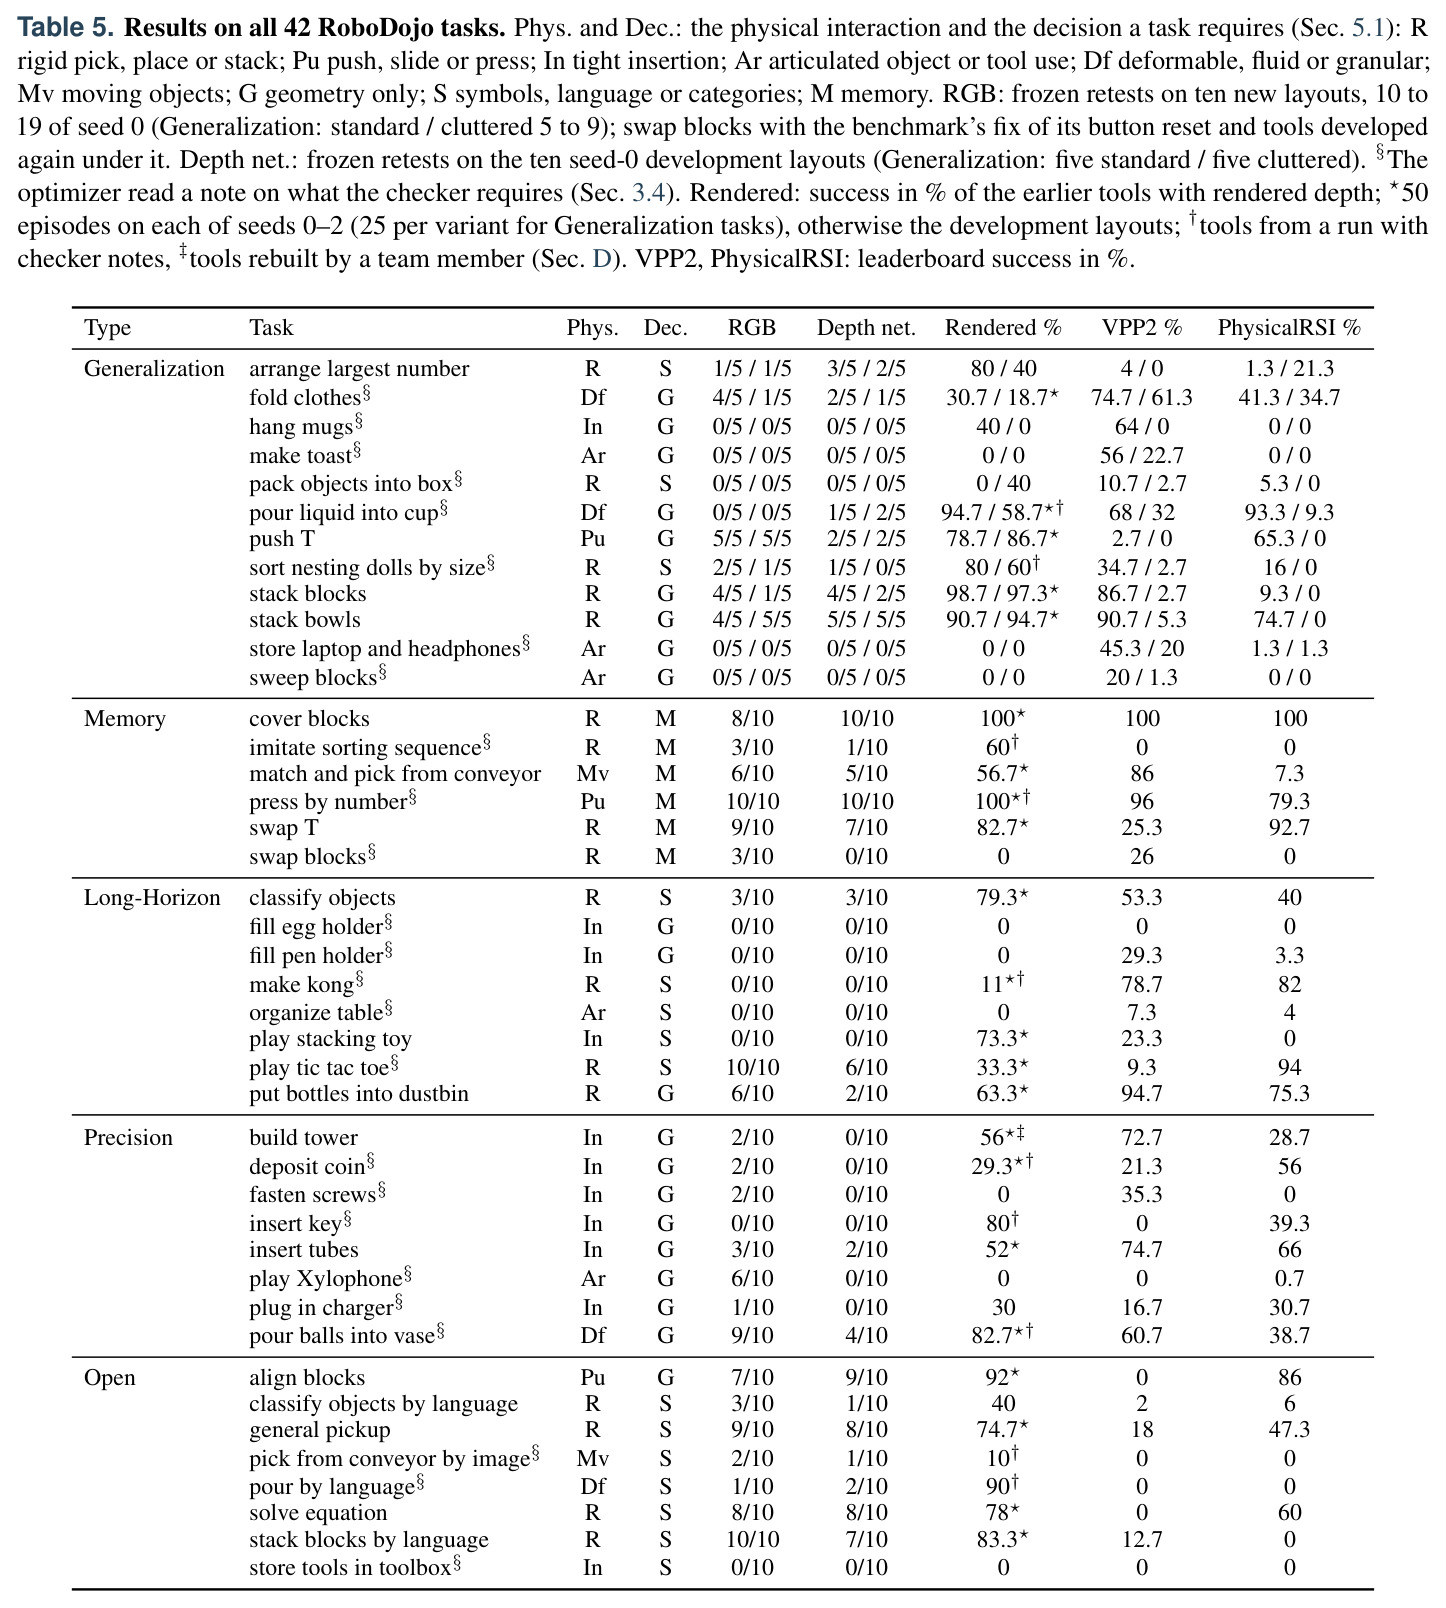
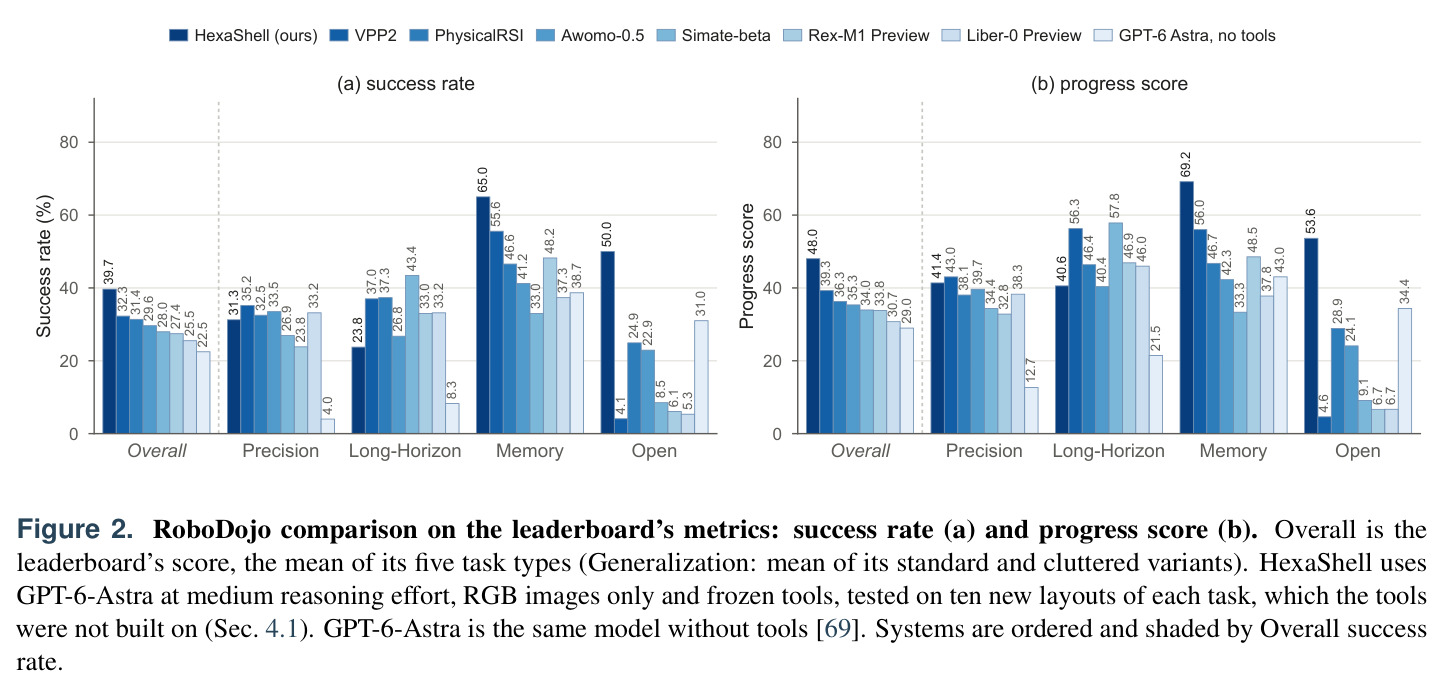
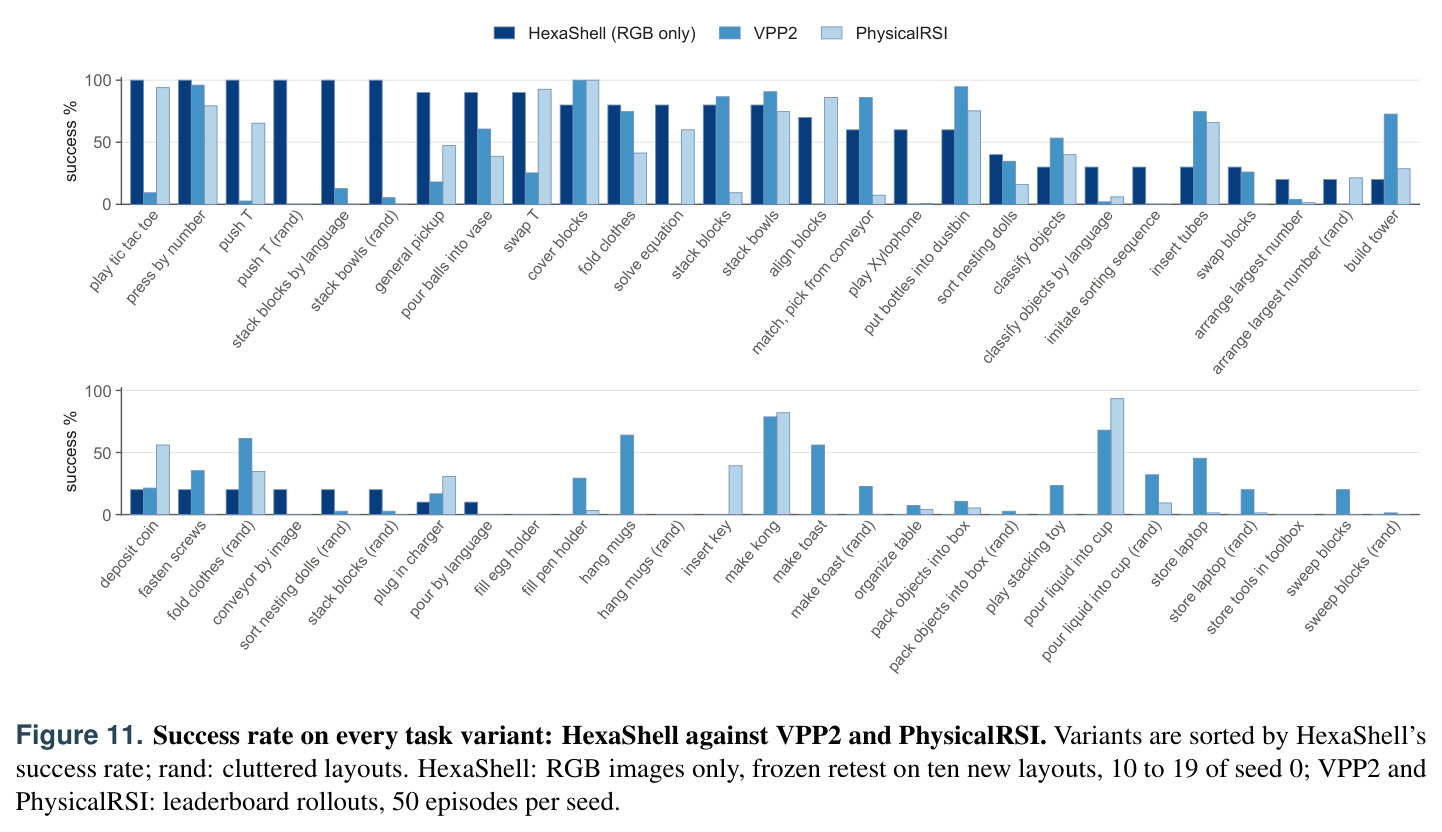
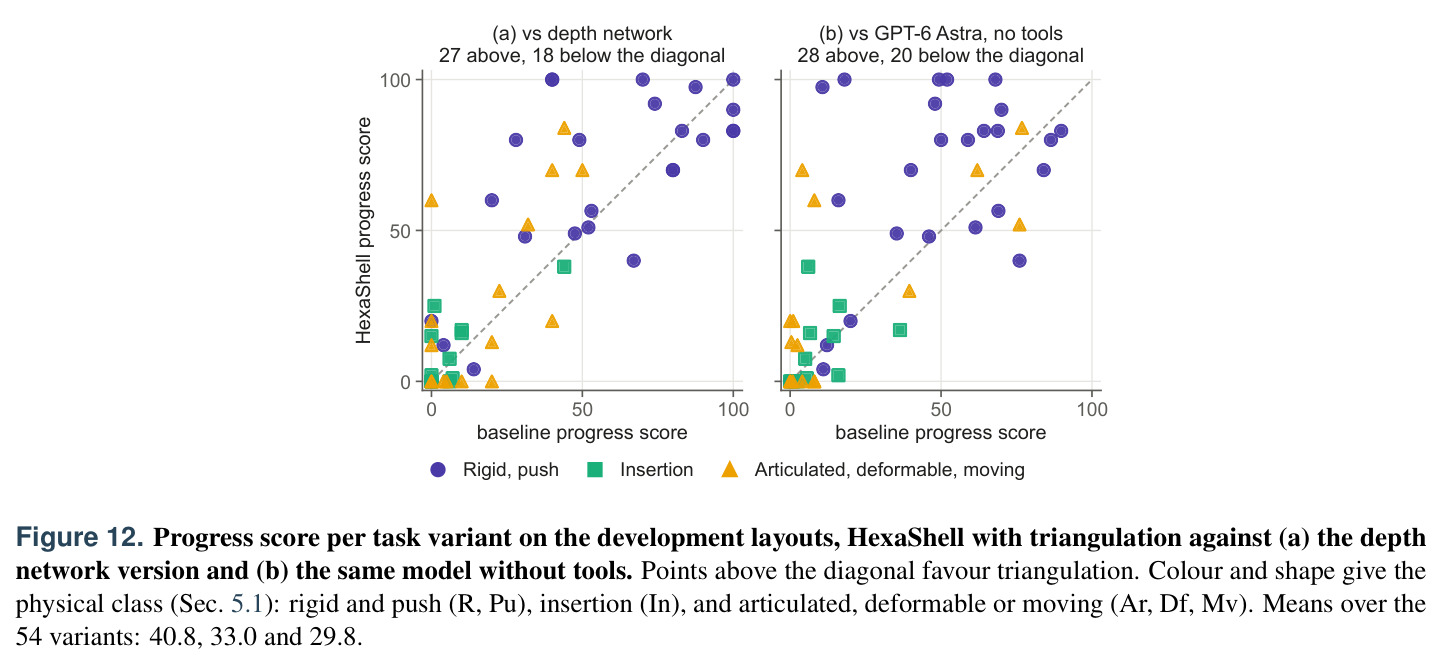
在RoboDojo全部42任务、每任务10个未见布局上(冻结工具重测),HexaShell达到39.7%成功率、48.0进度分,超过学习型策略:最强基线VPP2为32.3%/39.3,无工具同款模型仅22.5%/29.0。分类型:Memory 65.0%(此前最高55.6%)、Open 50.0%(此前最高31.0%)、推动类92.5%、刚性操作50.0%;但Precision 31.3%低于VPP2的35.2%、Long-Horizon 23.8%低于37.0%。抗杂乱突出:加13-18个干扰物后仍保持95%成功率,而30个学习型策略中位只剩18%(VPP2跌至12.6%)。定位消融:三角测量比Depth Anything V2高8.7分(配对57胜23负,$p<0.001$),增益集中在push T与play Xylophone;深度网络中位误差头部41mm/腕部约100mm;渲染深度参考线48.8%,差距集中在紧凑插入(30.1% vs 8.3%)。失败分析:268个失败episode中57%耗尽步数预算、30%声称成功被拒、13%带预算放弃,失败方式可区分感知缺陷与执行缺陷。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboDojo总分(排行榜指标,五类任务均权平均) | 成功率 / 进度分 (%) | 39.7 / 48.0 | VPP2 32.3 / 39.3(无工具GPT-6-Astra为22.5 / 29.0) | +7.4 / +8.7 个百分点,新SOTA |
| 54个任务变体平均成功率 | 成功率 (%) | 35.4 | VPP2 30.6、PhysicalRSI 26.1、无工具 24.3 | +4.8 个百分点(对最强基线VPP2) |
| Memory类任务 | 成功率 (%) | 65.0 | 此前排行榜最高 55.6(无工具 38.7) | +9.4 个百分点 |
| Open类任务 | 成功率 (%) | 50.0 | 此前排行榜最高 31.0(无工具 22.8) | +19.0 个百分点 |
| 定位方式消融(同harness/循环/模型,开发布局配对重测) | 排行榜成功率 (%),配对胜负 | 三角测量 38.3 / 43.6,57胜23负 | Depth Anything V2 29.6 / 35.4 | +8.7 个百分点,McNemar $p<0.001$ |
| Generalization杂乱变体鲁棒性(13-18个干扰物) | 相对标准布局的成功保持率 (%) | 95(35.0%→33.3%) | 无工具 87;30个学习型策略中位 18(VPP2 46.4%→12.6%) | 中位数高出约77个百分点 |
| Push类任务(推、滑、按压) | 成功率 (%) | 92.5 | 无工具 60.0、VPP2 24.7 | +32.5 个百分点(对无工具) |
| 紧凑插入In类任务 | 成功率 (%) | 8.3(12个变体中7个为0) | VPP2 28.1、渲染深度版 30.1 | 落后VPP2 19.8个百分点(诚实披露的核心短板) |
局限与改进
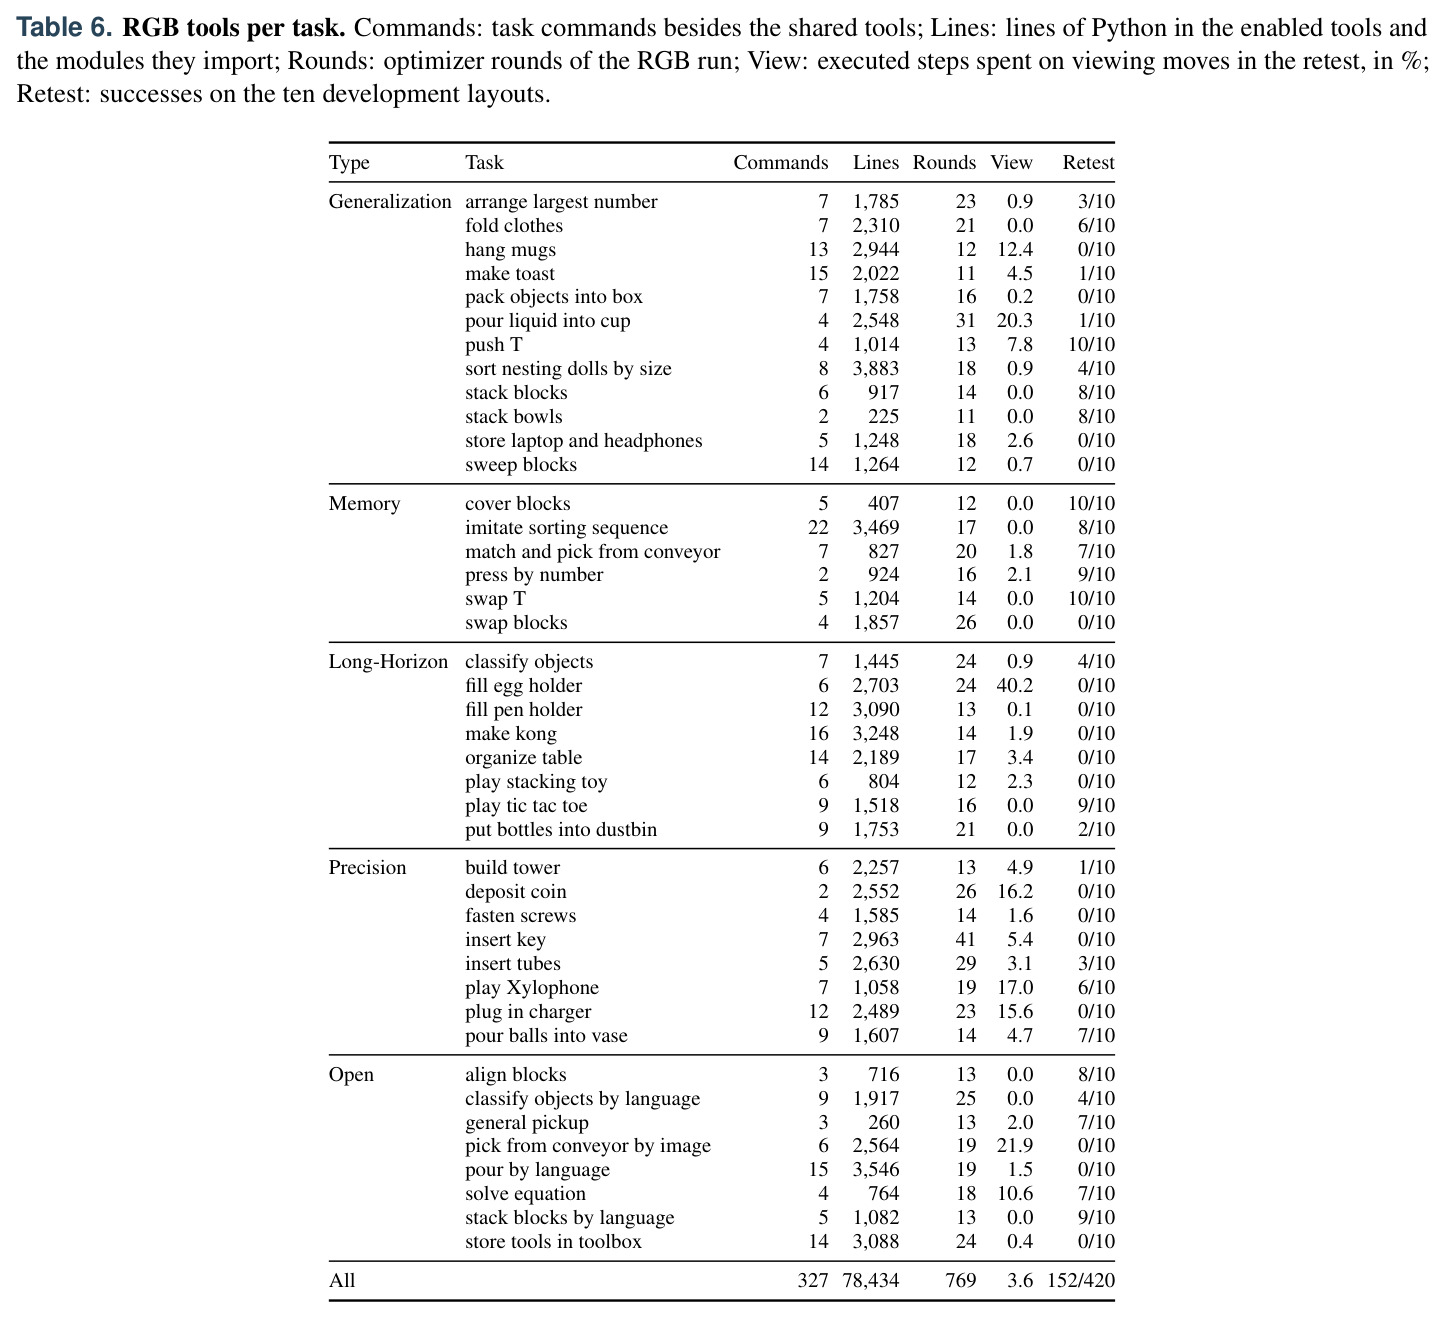
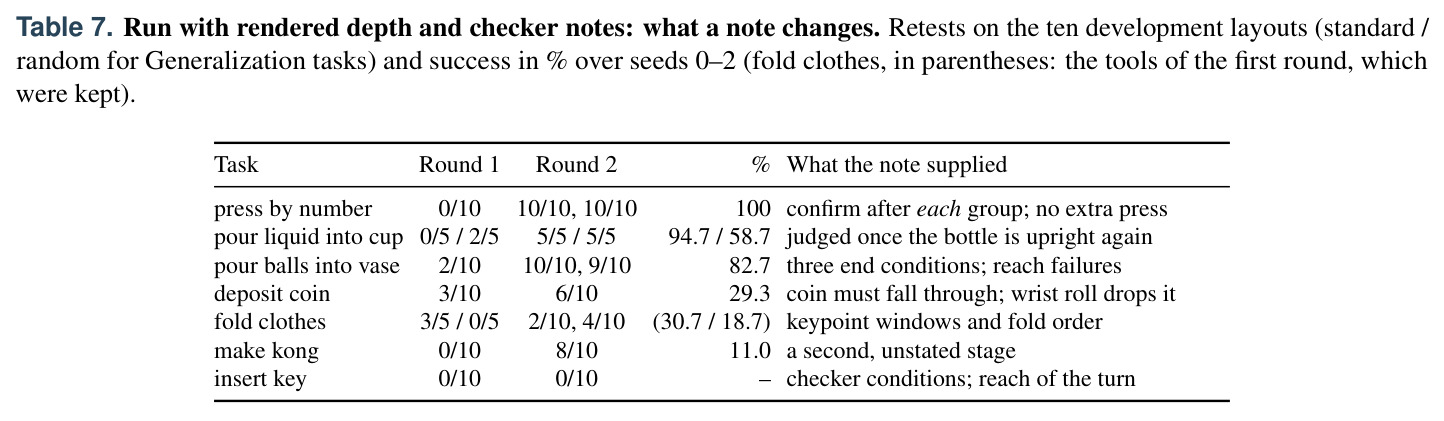
作者承认的局限:紧凑插入仅8.3%(12个变体中7个为0),因为插入要求孔与零件在同一坐标系内毫米级对齐——头部相机一个像素在桌面上覆盖2-3mm,而能分辨孔的腕部视角必须在夹持零件时获得;布料类工具反而不如无工具的逐步纠错智能体(fold clothes 50% vs 72%),因为工具固化了一种解释和一条预先规划的轨迹,无法中途察觉并修正;多数失败是'看见失败但动作做不出来'(57%耗尽步数预算)。我补充的观察:(1) 全部结果来自Isaac Sim仿真,无真实机器人实验,标定近乎完美、无噪声的相机是三角测量精度的前提;(2) 强依赖特定闭源前沿模型(GPT-6-Astra + Codex脚手架),换模型结论是否成立未知;(3) 25/42任务的优化器读过作者依据公开任务定义手写的'检查器要求'笔记,且7个任务靠人工审计才发现残留固定几何常量,说明'无真值泄漏'的保证需要持续人工监督;(4) 769轮优化共读约4.87亿输入token,加上每任务12小时开发预算,成本不低;(5) 327个任务命令、约7.8万行Python的任务特定工具,规模随任务数线性增长,长期可维护性存疑。
独立分析的弱点
弱点一:接触密集任务全面失利(插入8.3%、铰接/工具使用7.5%),根源是'先测量、后规划、开环执行'范式——接触中毫米级偏差没有闭环修正通道,insert tubes最后只能靠松爪让管子'掉进去'。改进:夹持零件状态下用腕部相机持续双目测量、接触中流式微调轨迹。弱点二:可变形材料感知脆弱,fold clothes的工具靠颜色连通性找衣服,杂乱下从4/5跌到2/5。改进:引入形状先验或小型学习型分割模块,保持'工具可测试'性质。弱点三:30%的失败以'声称成功但检查器拒绝'告终,记忆类高达50%,暴露VLM终态判断和细粒度视觉差异的缺陷(swap T中同色相明暗两面被混淆)。改进:把完成判据工具化,用几何量(位姿误差阈值)而非视觉印象做终态检查。弱点四:观看步数在必须边夹持边测量的任务上集中爆发——鸡蛋托40%的执行步数用于观看且全部失败。改进:增加固定机位、镜面等免费视角,或学习'何时值得多看一眼'。弱点五:工具全部任务特定,共享池只有不可修改的pick和table_plane,重复造轮子(7.8万行代码)。改进:建立带检索的跨任务工具库,让'像素足迹面积'等修复跨任务复用。
未来方向
作者明确提出的:结论指出下一步是'在夹持零件时持续测量、在接触过程中修正运动的工具',即从开环规划走向闭环接触控制,以攻下紧凑插入这座堡垒。基于成果可延伸的方向:(1) 迁移到真实机器人,检验标定误差、相机噪声和遮挡下三角测量管线的鲁棒性,这是仿真到真实的关键一跳;(2) 跨任务工具检索与泛化——把327个命令中的共性模式(平面高度测量、双视图三角化、沿沿拟合、像素足迹面积)抽成可检索的通用库;(3) 模型无关性消融:用其他前沿或开源模型替换GPT-6-Astra,检验'薄壳+工具'范式的可移植性与结论的普适性;(4) 与学习型策略混合:能力图谱显示两者几乎互补(本文推动92.5%对VPP2的24.7%,插入8.3%对28.1%),可让几何工具负责粗定位与感知、VLA接管接触段;(5) 用自动终态验证器消除30%的'误报成功'失败;(6) 工具库的自动压缩与整合,控制7.8万行代码随任务数膨胀;(7) 更长视野的自我改进:让优化智能体跨任务总结playbook.md,沉淀可复用的设计模式库,而非每个任务从旧工具冷启动。
复现评估
复现评估:论文开源了进化出的工具库(github.com/HexaFuture/HexaShell),实验协议描述得异常细致:开发布局为seed 0前10个布局,冻结后在布局10-19(新布局)重测,并与排行榜2026年10月14日快照对比;Table 5给出全部42任务逐任务结果,Table 4给出7个修复案例的逐轮细节(编辑行数、耗时、步数),附录E/F完整公开了执行智能体的约60行手册和优化智能体的62行角色描述。复现门槛有三:(1) 需要GPT-6-Astra的API访问(经Codex CLI、medium档)——优化器全程读4.87亿输入token、写380万输出token,API费用可观;(2) 需要RoboDojo基准(Isaac Sim 5.1、ARX X5双臂仿真、42任务)和一块RTX 4090,每任务12小时开发预算,一轮失败修复中位6.3分钟;(3) 论文未明确harness服务端代码是否随工具一同开源,缺失时需按3.1节自行实现。总体难度:中高——链路长但每一步都有量化规格,最大不确定性在模型API可得性与harness代码完整性。
论文图表