RoboHarness:让LLM智能体凭一个简单外设超越VLA与世界动作模型 RoboHarness: A Simple Harness Outperforms VLA and World Action Models
无需训练模型,给LLM装上几何控制外设即可在长程机器人任务上超越VLA与世界动作模型。
前置知识
VLA(视觉-语言-动作模型)
把预训练视觉语言模型改造成能直接输出机器人动作的模型。一类做法把离散动作编进词表做自回归预测(RT-2、OpenVLA,FAST用频域压缩动作块);另一类在VLM后接流匹配动作专家或扩散transformer头输出连续动作块(π0、GR00T N1)。它们需要大量机器人动作数据与额外后训练。
本文的核心论点是反对这条'训练模型输出动作'的路线,理解VLA的数据与训练成本才能理解RoboHarness'零训练'主张的分量。
WAM(世界动作模型)
通过学习动作条件下的世界变化模型来提升泛化的机器人模型,通常以视频生成或世界模型为骨干(文中涉及Faster-WAM、OpenWAM-α、LingBot-VA等)。与VLA相比,它把动作生成建立在'预测世界如何变化'之上,但依然依赖机器人数据。
论文标题要同时击败VLA和WAM两条路线,实验部分专门比较了三类WAM在100物体泛化测试上的表现。
Coding Agent 与 Harness(外设/脚手架)
编码智能体(如Claude Code)是围绕LLM构建的工具调用环境:LLM通过读写文件、执行命令等原子工具与外部世界交互。经验法则是少量简单、正交的原子工具胜过大量预定义功能与重型脚手架。Harness即连接LLM能力与外部系统的接口层。
RoboHarness正是把这套'最小工具集'哲学搬到机器人上:LLM完全冻结,所有具身能力都来自外设提供的工具。
光流跟踪与深度反投影
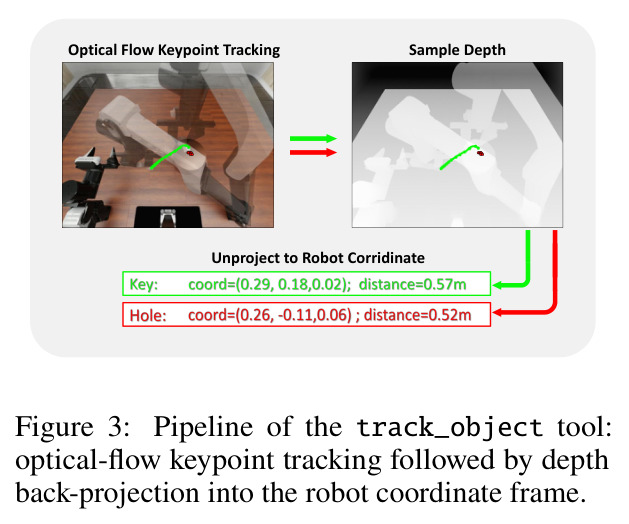
光流跟踪在连续视频帧之间估计每个像素/关键点的运动,从而跨帧追踪2D位置;深度反投影把2D像素坐标结合深度值还原为相机坐标系下的3D点。两者组合即可让LLM标一次点,之后持续获得该点的实时3D坐标。
这是RoboHarness'几何状态'机制的技术核心,解决了VLM'会标点但不擅3D推理'的短板,是视觉与机器人控制之间的桥。
SE(3) 刚体变换与几何约束
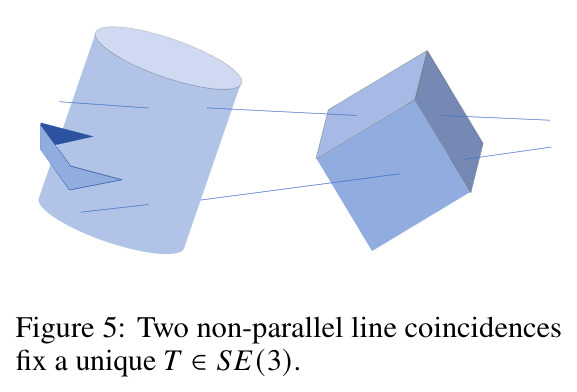
SE(3)是三维旋转加平移构成的刚体变换群,描述两物体间的相对位姿。几何约束指用点、线、面之间的关系(重合、共线、垂直、平行等)限制位姿自由度:每条约束削减部分自由度,足够的独立约束即可唯一确定一个SE(3)变换。
论文第4节的完备性证明就建立在SE(3)上:命题2证明两条不平行线重合约束可唯一确定任意相对位姿,这是'工具集够用'的数学根据。
BEHAVIOR-1K 基准与 q-score
BEHAVIOR-1K是斯坦福基于OmniGibson仿真的长程家务任务基准,任务如开收音机、收玩具、布置圣诞装饰等,动辄数百上千仿真步(ticks)。q-score是其官方评测指标,综合任务完成度与子目标完成率;2025年挑战赛排行榜用它给参赛系统排名。
主实验即BEHAVIOR Challenge 2025前10个任务,所有与VLA、挑战赛冠亚军的对比都以平均q-score(每任务5实例均值)呈现。
研究动机
要让LLM在物理世界中行动,主流路线是训练模型直接生成动作:VLA把动作离散进词表(RT-2、OpenVLA、FAST)或在LLM后接流匹配/扩散动作头(π0、GR00T N1),这需要采集大量机器人动作数据并做后训练,而真实世界的动作数据采集昂贵、难以覆盖多样的物体、场景与任务。为此出现了世界动作模型WAM(如Faster-WAM、OpenWAM-α、LingBot-VA),试图靠学习动作条件的世界模型改善泛化,但同样离不开数据规模。另一条路线是把抓取、放置、导航等子任务封装成可调用函数供LLM编排(Code as Policies、ASPIRE技能库),但函数覆盖由预定义的任务、物体和策略决定——每来一个新物体或新任务就要新增函数,LLM被困在人类预设的动作空间里;CaP-X的系统实验也发现,去掉人类设计的高层抽象后性能会退化。问题因此可以归纳为:动作接口要么太贵(训练),要么太窄(预定义函数)。
本文的目标是本文的目标是证明一个反直觉的命题:不需要训练任何模型,一个现成的通用LLM只要配上一副'简单而完备'的机器人外设,就能直接完成长程家务操作并在基准上超过最先进的VLA和WAM。具体而言,作者要构造一个把LLM已有的任务分解、规划、空间推理、工具使用能力接入物理世界的最小接口——RoboHarness:用视觉标点、关键点跟踪和几何约束组成'视觉-几何控制面板',让LLM直接理解并调用具身任务;同时用数学证明这个接口的最小完备性(任何抓取位姿、任何手内物体与目标物体的空间关系都能用该接口表达);最终在BEHAVIOR Challenge 2025的10个任务和100物体泛化测试上用开放模型Qwen3.8-Flash-Next验证,全程零微调、开源实现。
与已有工作不同的是,作者的独特切入点是重新划定'模型推理'与'机器人控制'的边界。此前所有工作都在训练侧做文章(VLA/WAM)或在人类抽象侧做文章(技能函数库),而本文把边界放在一个可解析求解的几何接口上:模型权重完全不动,动作表达权交给关键点+约束。与关键点类工作(RoboPoint、PIVOT、MOKA、HAMSTER)相比,本文不止于经验性使用,而是证明三点式表示的解析双射完备性;与约束类工作(CoPa、OmniManip、ReKep)相比,本文把约束封装成LLM友好的快速请求并用持续跟踪的几何状态闭环执行。这一角度直接反驳了CaP-X'低层接口必然退化'的结论——只要接口选得数学上完备,低层并不牺牲表达力,反而让开放模型零训练即可超越数千小时数据训出的专用模型。
核心方法
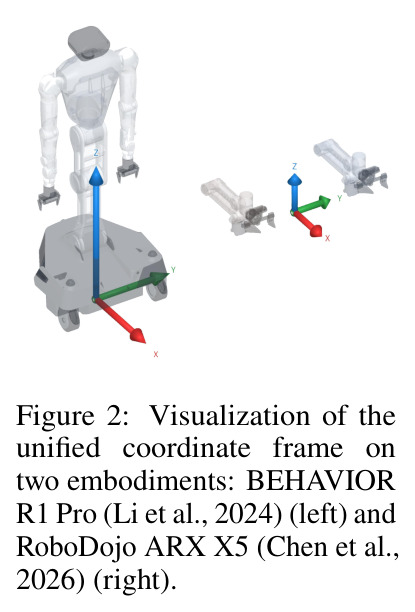
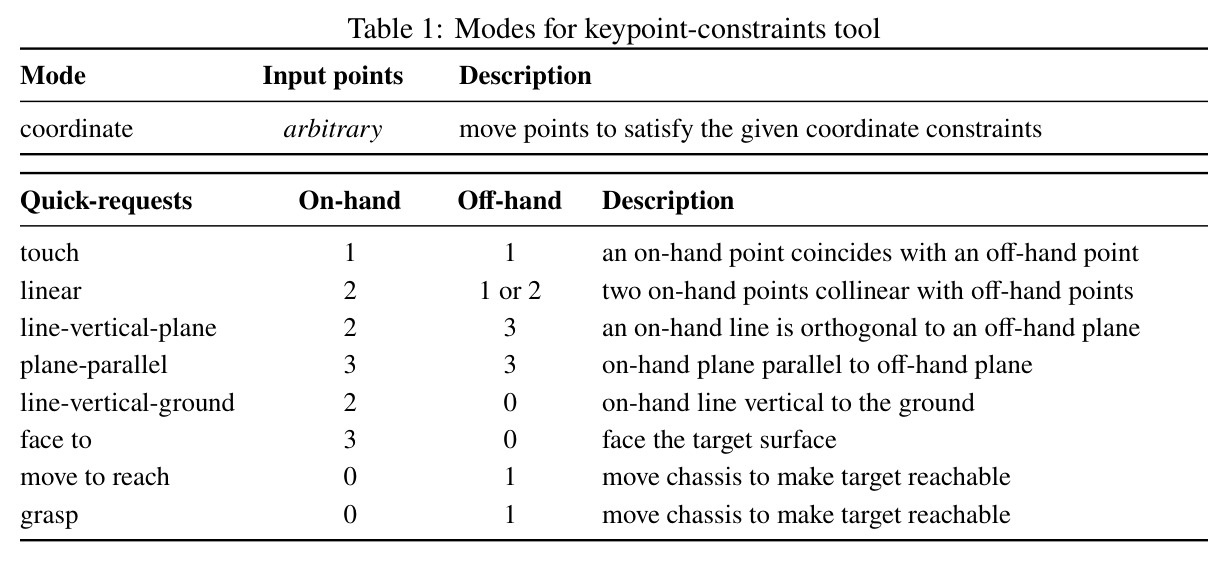
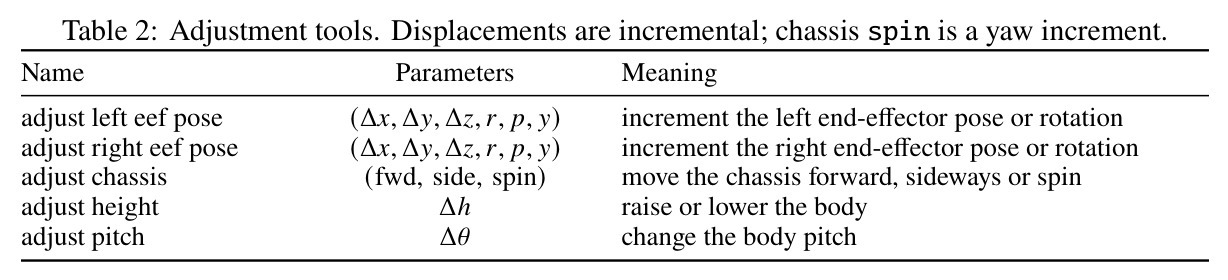
直觉来自编码智能体的经验教训:一组简单、正交的原子工具胜过层层封装的预定义功能与重型脚手架。技术上,作者把操纵任务分解为两阶段——夹爪先与物体建立空间关系(抓取),然后末端执行器驱动物体满足它与另一物体的几何关系(如钥匙插入锁孔需共线且中心对准)。RoboHarness据此提供三件事:一是统一相机坐标系(x向前、y向左、z向上),在R1 Pro与ARX X5两种本体上保持一致,方便LLM直接读写空间关系;二是track_object几何状态工具:LLM在头相机2D图像上标出感兴趣点,Harness用光流跨帧持续跟踪,再把最新2D位置投到深度图得到度量距离并反投影回机器人坐标系(例如持续回报Key: coord=(0.29,0.18,0.02), distance=0.57m);三是最小动作工具集,包括关键点约束工具(8种快速请求)和增量式低层调节工具。整套系统即插即用,任何模型、任何编码智能体外壳都能挂载。
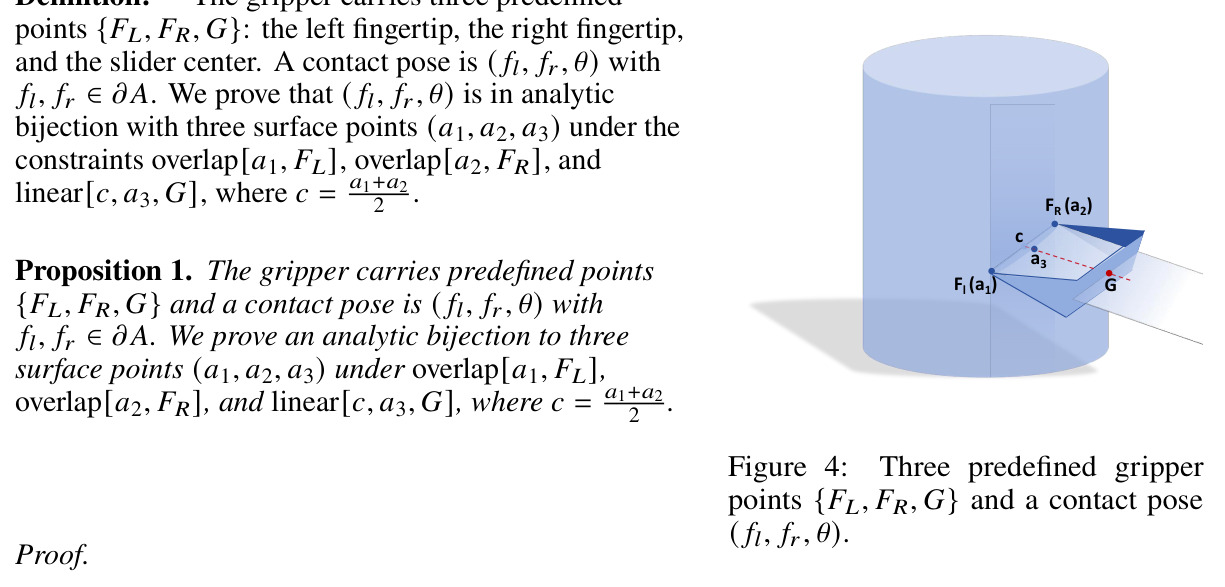
核心创新是'最小且完备'的形式化保证,这是与已有方法的本质区别。命题1证明:夹爪携带三个内禀点——左指尖$F_L$、右指尖$F_R$、滑块中心$G$,任意接触位姿 $(f_l, f_r, \theta)$($f_l, f_r \in \partial A$)与三个表面点 $(a_1, a_2, a_3)$ 在约束overlap、overlap、linear$[c,a_3,G]$($c=(a_1+a_2)/2$)下构成解析双射,旋转角由 $\tan\theta = \frac{(a_3-c)\cdot v_2}{(a_3-c)\cdot v_1}$ 唯一确定。命题2证明:任意相对位姿 $T_{true} \in SE(3)$ 可由两条不平行直线重合约束唯一确定——第一条消去四个自由度,第二条经$XY$投影解出唯一旋转角$\theta$与沿$Z$的平移$d$。换言之,不学任何动作分布,纯几何约束接口在数学上就能表达任意抓取和任意手内-目标物体关系,工具集因此既极简又无损。
方法步骤详情
完整流程六步。1)LLM读取几何状态:兴趣点以统一坐标回报(如Key: coord=(0.29,0.18,0.02), distance=0.57m)。2)LLM利用VLM的grounding能力在头相机2D图像上点选关键点。3)Harness用光流跨帧跟踪每个标记点,把最新2D位置投到深度图获得度量距离,反投影回机器人相机坐标系并持续刷新回报。4)LLM下达关键点约束指令,须区分on-hand点(可驱动)与off-hand点(场景固定);Harness执行四步管线:采样满足约束的动作候选→丢弃IK不可行或不可达者→规划从当前位姿到目标位姿的轨迹→执行。5)约束失效(如物体滑出夹爪)或需精调时调用调节工具:adjust_left_eef_pose以(Δx,Δy,Δz,r,p,y)六自由度增量微调(右臂同理),另有adjust_chassis(fwd,side,spin)、adjust_height、adjust_pitch。6)闭环:每步后几何状态刷新,LLM校验约束满足(如钥匙与锁孔共线)才进入下一子目标。
技术新颖性
新颖性体现在四个层面。范式层面:与RT-2/OpenVLA/FAST把动作编进词表、与π0/GR00T N1外挂动作专家头不同,RoboHarness不碰模型权重,绕开了动作数据采集、灾难性遗忘、知识绝缘(阻止动作专家梯度进入VLM主干的训练设计)等全部训练难题。理论层面:首次给出关键点约束表示的完备性证明(命题1解析双射、命题2两线重合唯一性),把'接口够不够用'从经验问题变成定理,直接回应CaP-X关于抽象层级的实证担忧。系统层面:把常用模式封装成8种快速请求(touch、linear、line-vertical-plane、plane-parallel等),配合持续几何状态反馈形成感知-行动闭环,LLM友好且可验证。泛化层面:同一外设跨本体(R1 Pro、ARX X5)、跨模型(Qwen3.8-Flash-Next、Qwen3.8-27B、GPT-6-luna)即插即用,0机器人数据小时即超过数千小时数据训出的VLA与WAM。
实验结果
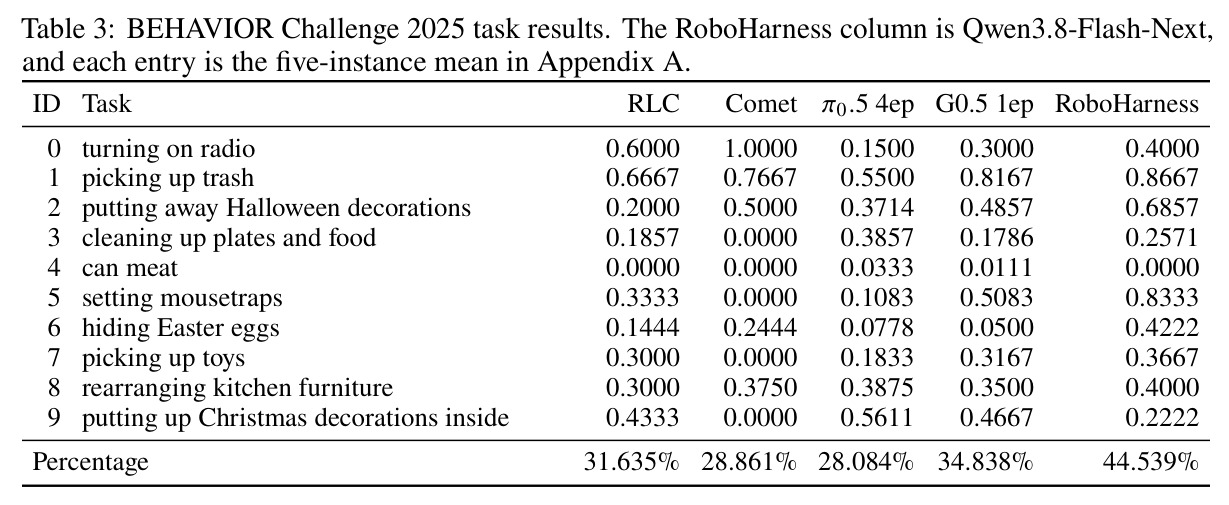
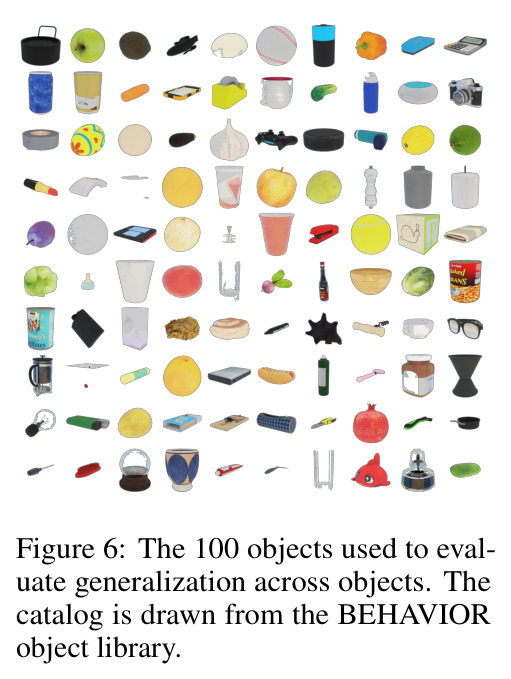
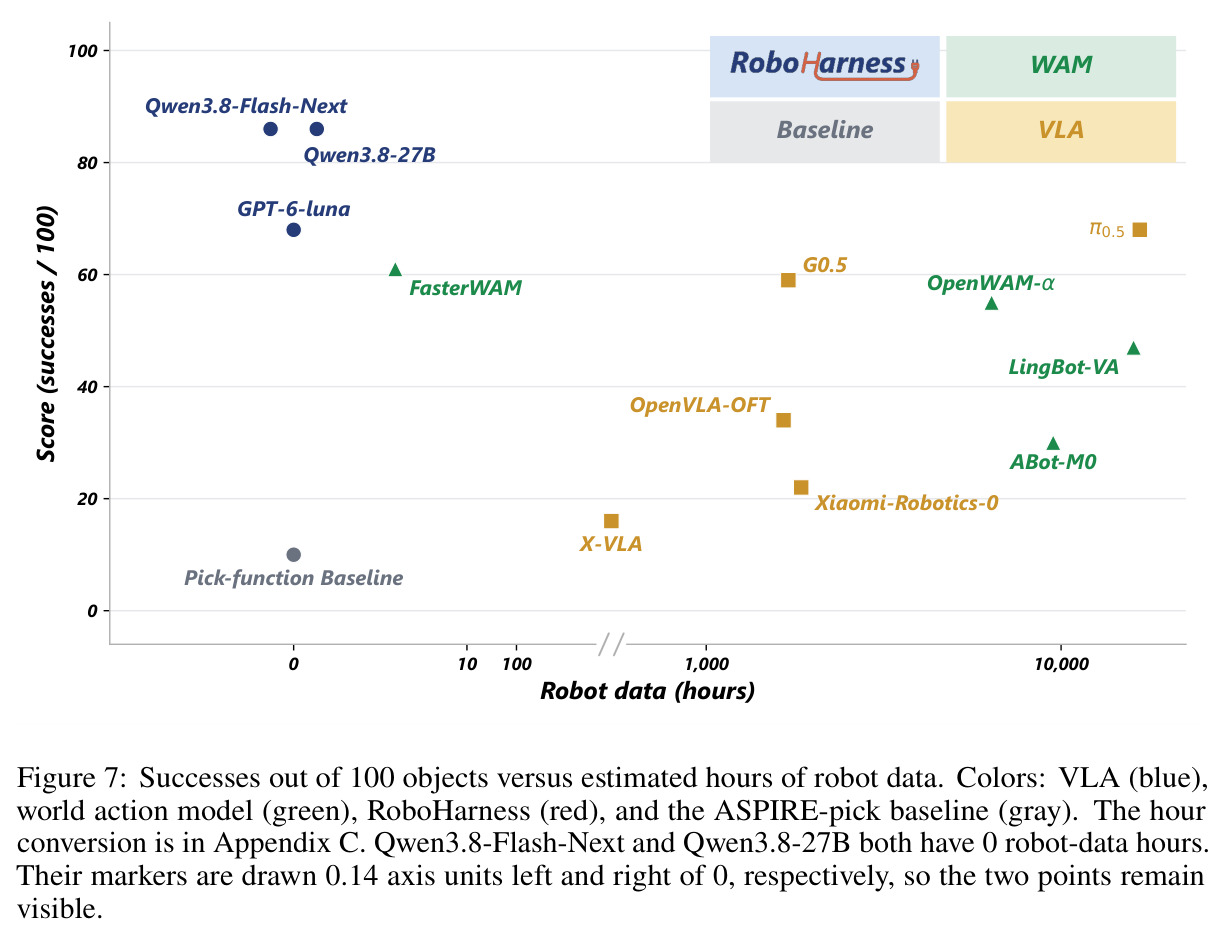
主实验在BEHAVIOR Challenge 2025前10个长程家务任务上(每任务5实例,seed 20260911,槽位0/3/5/7/9):RoboHarness挂Qwen3.8-Flash-Next零微调,平均q-score 44.539%,超过挑战赛冠军RLC 31.635%、亚军Comet 28.861%、π0.5(4ep)28.084%、G0.5(1ep)34.838%,较G0.5提升约9.7个百分点。逐任务看优势在几何精密操作:setting mousetraps 0.8333(G0.5仅0.5083)、picking up trash 0.8667、Halloween decorations 0.6857;弱点是can meat 0.0000(所有方法近零)、Christmas decorations 0.2222低于π0.5的0.5611。泛化实验用BEHAVIOR库100个刚体(尺寸≤0.21m、质量≤1.2kg)做抓起测试,判据 max $z - z_0 \geq 5$ cm、上限2000 ticks:RoboHarness两点(Qwen3.8-Flash-Next与Qwen3.8-27B)0机器人数据小时得68–86分,超过数小时演示的Faster-WAM(61/100)和数千小时训练的OpenVLA-OFT等VLA。结论:泛化与数据量不正相关,多模态能力比参数量更重要。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BEHAVIOR Challenge 2025 前10个长程家务任务(移动操作) | 平均 q-score(每任务5实例均值) | 44.539%(Qwen3.8-Flash-Next,零微调) | G0.5 1ep 34.838%;挑战赛冠军RLC 31.635%;亚军Comet 28.861%;π0.5 4ep 28.084% | 相对最优基线G0.5提升约9.70个百分点(+28%相对提升) |
| 100物体抓取泛化测试(物体尺寸≤0.21m、质量≤1.2kg) | 成功数/100(max z - z0 ≥ 5cm,2000 ticks) | 68–86 成功(Qwen3.8-27B 与 Qwen3.8-Flash-Next,均为0机器人数据小时) | Faster-WAM 61/100(数小时演示);数千小时级VLA如OpenVLA-OFT更低;其余WAM(OpenWAM-α、LingBot-VA)高于多数VLA但不及本文 | 零机器人数据下领先最强WAM约7个物体、领先多数VLA约25个以上物体 |
| setting mousetraps(单任务,几何约束密集) | q-score(5实例均值) | 0.8333 | G0.5 0.5083;RLC 0.3333;π0.5 0.1083;Comet 0.0000 | 超过最强基线0.325,体现几何约束工具在精密操作上的优势 |
局限与改进
作者明确承认:LLM虽然能提出出色的计划,但经常无法落地到机器人本体的物理约束上,典型失败包括撞倒物体、摔倒、卡住;为了在BEHAVIOR长程移动操作上缓解这一点,团队为每个任务手工编写了规定执行步骤和行为边界的专属提示词——这实际上是方法不可忽视的隐性人力成本。我自己的观察还有几点:实验全部在仿真(BEHAVIOR/OmniGibson)中完成,没有任何真机结果,光流跟踪与深度反投影在真实相机的噪声、标定误差、遮挡下表现未知;评测预算有限,每任务仅5个实例、单一seed,且提示词由人类针对每个任务专门撰写并在实例间共享,与端到端VLA的对比公平性存疑;weak任务暴露短板——can meat为0.0000、Christmas decorations仅0.2222,说明多物体复杂场景仍吃力;完备性证明依赖'夹爪与被抓物体刚性连接'和三点式平行夹爪模型,对可形变物体与接触丰富任务(擦拭、插拔柔性线缆)不适用;约束执行用采样候选+IK过滤,未报告单步成功率与失败恢复统计。
独立分析的弱点
最突出的弱点是每任务手写提示词:作者自己承认这是为规避'计划好但物理落地失败'而搭的手工脚手架,相当于把任务先验从模型转移到了提示工程师身上,改进方向是把执行步骤先验蒸馏进模型,或让harness从失败轨迹中自动演化约束模板(ASPIRE式技能库可直接嫁接)。其次是感知链路的脆弱性:光流跟踪在遮挡、快速运动、光照变化下易丢点,论文未给出跟踪成功率,改进方向是引入关键点重检测、多假设跟踪或与可微渲染对齐。第三,约束执行管线用'采样候选+IK过滤',长程任务中单步失败率会连乘放大,可用解析IK、模型预测控制(MPC)或ReKep式优化提升每步可靠性。第四,评测设计:5实例×单seed规模太小,提示词在实例间共享可能高估泛化,应扩大实例数、报告方差并测试未见过的提示风格。第五,动力学盲区:纯几何约束不含力/接触信息,插钥匙这类任务在仿真中可行,真机上的接触力控制仍是空白,需引入触觉反馈与柔顺控制。第六,对动态场景(运动物体、人机共处)完全未覆盖,时变约束的框架扩展尚缺。
未来方向
作者在Limitation中明确提出未来方向:通过训练模型或演化harness进一步缩小'会规划但难落地'的物理接地差距。在此基础上可以延伸出多条路线:其一,把VLM的点选能力微调到直接预测3D约束(融合深度与多视角),减少对2D标点+反投影的依赖;其二,将关键点约束与技能库结合——把成功验证过的约束序列沉淀为可复用宏工具,实现新任务零提示词泛化;其三,把命题2的刚体线重合约束推广为软约束优化以覆盖可形变物体(绳、布、食物);其四,接入真机与触觉传感,用闭环力控补充纯几何约束,检验仿真结论的迁移性;其五,与WAM互补——用世界模型预测约束满足后的场景状态,做模型预测式约束规划;其六,安全性形式化:把行为边界(不得碰倒花瓶、不得穿越禁区)编码为可在线验证的约束集合,利用本文'执行可验证'的天然优势做safe RL式保障。
复现评估
复现条件相当友好。代码开源(github.com/BinceQu/RoboHarness),项目主页bincequ.github.io/RoboHarness提供演示;方法不需要训练算力,成本集中在两处:LLM推理(Qwen3.8-Flash-Next、Qwen3.8-27B、GPT-6-luna,本地或API均可)和仿真rollout机时——BEHAVIOR长程任务单实例可达数千ticks,复现主表需10任务×5实例批量评测。环境依赖OmniGibson/BEHAVIOR仿真栈与物体库,安装配置有一定复杂度但文档公开。评测协议透明:seed 20260911、槽位0/3/5/7/9、每任务tick上限(附录A)、逐实例分数与rollout存档(附录A)、100物体清单(Figure 6与附录D)、机器人数据小时换算(附录C)均已给出。风险点是任务提示词:提示词为人类逐任务定制,若发布版未附全文,精确复现q-score会有波动;泛化实验涉及闭源模型GPT-6-luna,推理成本需自付。总体:有仿真经验的小团队复现主结果难度中等,复现泛化结论较容易。
论文图表
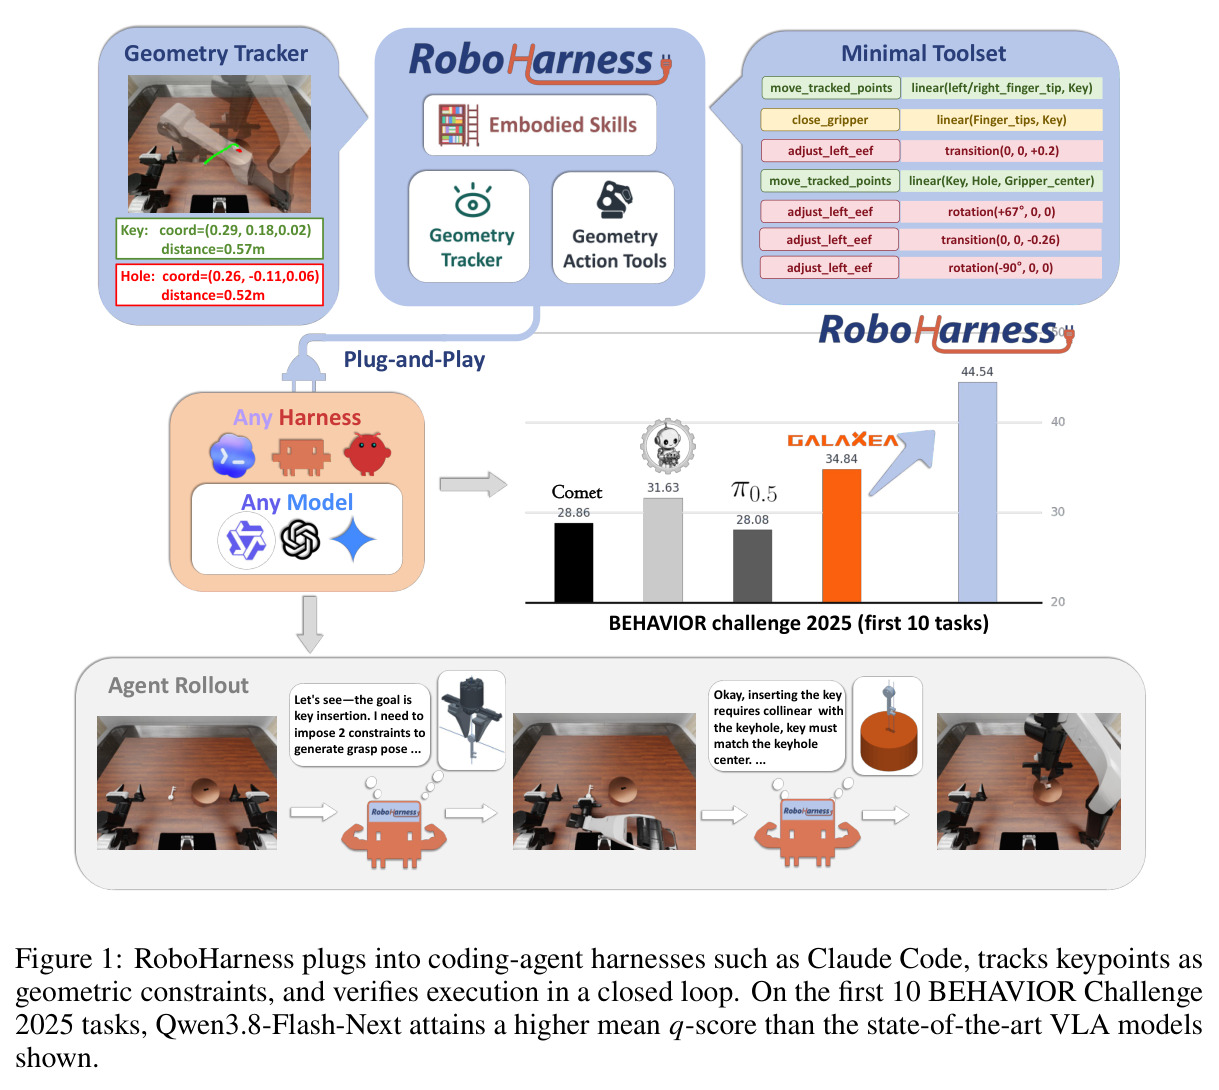
首图全景展示方法与结果:左侧是插钥匙任务场景,LLM通过Geometry Tracker持续读取Key/Hole的3D坐标(如Key: coord=(0.29,0.18,0.02), distance=0.57m),右侧Minimal Toolset列出LLM发出的约束指令序列(move_tracked_points、linear(left/right_finger_tip, Key)、adjust_left_eef的平移旋转等),中间标注'Plug-and-Play: Any Harness, Any Model',并给出Agent Rollout的推理片段('插入钥匙需要共线约束、钥匙中心对准锁孔中心')。
一图看懂全文核心主张:LLM不需要被训练成动作模型,只需一个几何控制面板即可操作机器人;图中q-score对比也预告了主实验结论。