AlphaBet:面向 LLM 事件预测智能体的强化学习 AlphaBet: Reinforcement Learning for LLM Event Forecasting Agents
用多日期结局反馈的智能体强化学习,联合训练 LLM 的证据检索与概率报告能力
前置知识
严格适当评分规则(strictly proper scoring rule)
一类评估概率预测的损失函数,如 Brier 分数与对数分数。其定义性质是:对任意真实结局分布 $q$ 和报告分布 $p$,有 $\mathbb{E}_{Y\sim q}[S(q,Y)] \ge \mathbb{E}_{Y\sim q}[S(p,Y)]$,且等号当且仅当 $p=q$。也就是说在期望意义上"如实报告真实概率"是唯一最优策略。它既是评估标准也是训练信号——只需知道最终实现的结局 $Y$ 而无需观测潜在的"真值概率",就能对报告的分布打分。
本文整个训练框架建立在"把适当评分规则当 RL 奖励"之上:Proposition 1 的遗憾分解和 Proposition 2 对 GRPO 归一化的分析,全部依赖严格适当性这一数学性质,不读懂它就无法理解论文的理论贡献。
Brier 分数
多分类 Brier 分数定义为 $\text{Brier}(p,y)=\sum_{k=1}^{K}\left(p_k-\mathbf{1}[k=y]\right)^2$,衡量报告分布 $p$ 与 one-hot 真实结局 $y$ 的均方差,取值 $[0,2]$、越低越好。Murphy (1973) 分解 $\text{Brier}=(UNC-RES)+REL$ 可把它拆成不确定度 UNC、分辨率 RES 与可靠性 REL 三项:可靠性差意味着"报告的概率值和实际频率对不上"(校准问题),分辨率差意味着"能否区分会发生和不会发生的情况"。
本文主奖励是负 Brier 分数,主结果表、纵向增益分析和 GRPO 消融都以 Brier 为核心指标,并用 Murphy 分解定位 std 归一化损害在可靠性而非分辨率上。
GRPO(组相对策略优化)
一种无需学习价值函数的 RL 算法:对同一输入采样 $G$ 条 rollout 构成一组,用组内奖励均值作基线构造相对优势。标准版优势为 $A^{(i)}=(R^{(i)}-\bar{R})/(\sigma_R+\epsilon)$,其中 $\sigma_R$ 是组内标准差。本文采用"去 std"变体:仅做均值中心化 $A^{(i)}_{Q,t}=R^{(i)}_{Q,t}-\bar{R}_{Q,t}$,不除以标准差,以保留奖励的原始尺度。
本文核心理论贡献之一是证明:在多分类适当评分下,GRPO 的 std 归一化会按各类奖励尺度重新加权结局类别($\tilde{q}(k)\propto q(k)/(\sigma_{S,k}+\epsilon)$),扭曲被引导的概率报告目标,实证上表现为过度自信。
纵向事件预测(longitudinal forecasting)
同一个未解决问题在到期结算前的多个日期被反复预测:问题固定,但可用信息语料随日期单调扩展($\mathcal{I}_{\le\tau_t}\subseteq\mathcal{I}_{\le\tau_{t+1}}$),预测者需要在新证据到来时更新信念,每个日期的预测都对照最终结局评分。为防泄漏,日期 $\tau_t$ 的检索严格限制在"不晚于该日期"发布的资料上。
本文的"多日期训练"正源于此设定:一个已结算事件可以在多个信息状态下监督多次预测决策,这是它与以往单日期训练方法的本质差异,也是消融实验的重点对象。
信息差距与报告差距
给定日期语料目标 $q^{Q,t}(k)=\Pr(Y=k\mid Q,\tau_t,\mathcal{I}_{\le\tau_t})$(用全部可用信息可推出的贝叶斯最优预测)与获取上下文目标 $q^{H}_{Q,t}(k)=\Pr(Y=k\mid Q,\tau_t,H_t,M_{t-1})$(仅用检索到的证据 $H_t$ 与笔记本 $M_{t-1}$ 可推出的最优预测),预测期望遗憾可分解为信息差距 $\mathcal{D}_S(q^{Q,t},q^{H}_{Q,t})$(证据没找够)与报告差距 $\mathcal{D}_S(q^{H}_{Q,t},p^{Q,t})$(证据在手却报不准)之和。
这一分解(Proposition 1)是论文的分析骨架:实验中的"证据-读者交换"设计正是按这两项分别归因 AlphaBet 的性能增益,理解它才能读懂第 4.3 节。
研究动机
现实中的事件预测问题(政策走向、选举结果、经济指标等)往往要数周甚至数月才结算,期间相关证据持续累积;人类超级预测者的做法正是纵向预测——反复重访同一未解决问题并随信息演进更新信念。然而现有的基于结局(outcome-based)训练的 LLM 预测方法(如 Halawi et al. 2024、Turtel et al. 2025、OpenForecaster)通常只在单个预测日期上、用预先检索拼装好的固定证据训练"概率报告"这半个环节,证据获取完全处于学习回路之外,也没有任何学习信号告诉模型:随着新信息到来,预测应当如何演化。本文复现的 OpenForecaster 就是典型:它在固定检索上下文上做 RL,测试时每条预测只调用 8.3 次工具(base 模型为 12.4 次),在更薄的证据基础上做报告改进——这正是论文所说的只优化了报告差距、而信息差距原封未动。结果就是这类方法的 Brier 分数改进有限,甚至可能不如简单的提示工程方案。
本文的目标是本文的目标是把"找证据"和"报概率"放进同一个可学习的策略中,用真实结局端到端训练:让一个工具调用型 LLM 策略在同一未解决问题到期前的多个日期反复访问,在每个日期主动搜索、阅读、计算当时可得的证据,并提交一个覆盖 $K$ 个互斥且穷尽结局的概率分布 $p_{Q,t}\in\Delta^{K-1}$;每个日期的预测都用严格适当评分规则(主实验用负 Brier 分数)对照最终结局打分,从而让一个已结算事件同时监督多个信息状态下的搜索与报告决策。配套的理论目标是:刻画该目标的严格适当性(预测遗憾如何分解为信息获取差距与概率报告差距),并分析 GRPO 的组内标准差归一化在多分类适当评分下会如何扭曲被引导的概率报告目标。
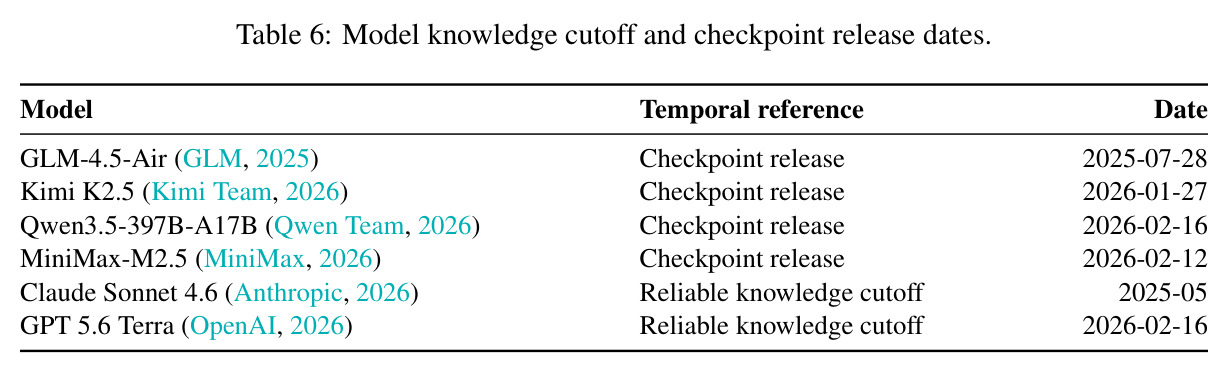
与已有工作不同的是,本文的独特切入有三点。其一,任务形式化上的跨越:以往 outcome-based RL(Turtel et al. 2025、OpenForecaster)把预测当作孤立的单日期、固定上下文的静态任务,本文借助 Forecast-Dojo 可重放、按时间索引的研究环境,把带日期的智能体交互正式化为纵向 RL 问题,每个日期都有 proper-score 反馈,且所有训练事件都晚于模型检查点发布日期(GLM-4.5-Air 为 2025-07-28,训练问题日期为 2025-08-01 至 2026-02-28),从机制上排除对结局的记忆。其二,理论刻画:提出把预测遗憾分解为信息差距与报告差距(Proposition 1),使端到端增益可被分别归因。其三,归一化分析:把 Bereket & Leskovec (2025) 的二元随机结局分析推广到多分类适当评分,证明均值中心化只按正因子缩放报告梯度,而 std 归一化会按 $\tilde{q}(k)\propto q(k)/(\sigma_{S,k}+\epsilon)$ 重新加权结局类别、改变被引导的概率目标。
核心方法
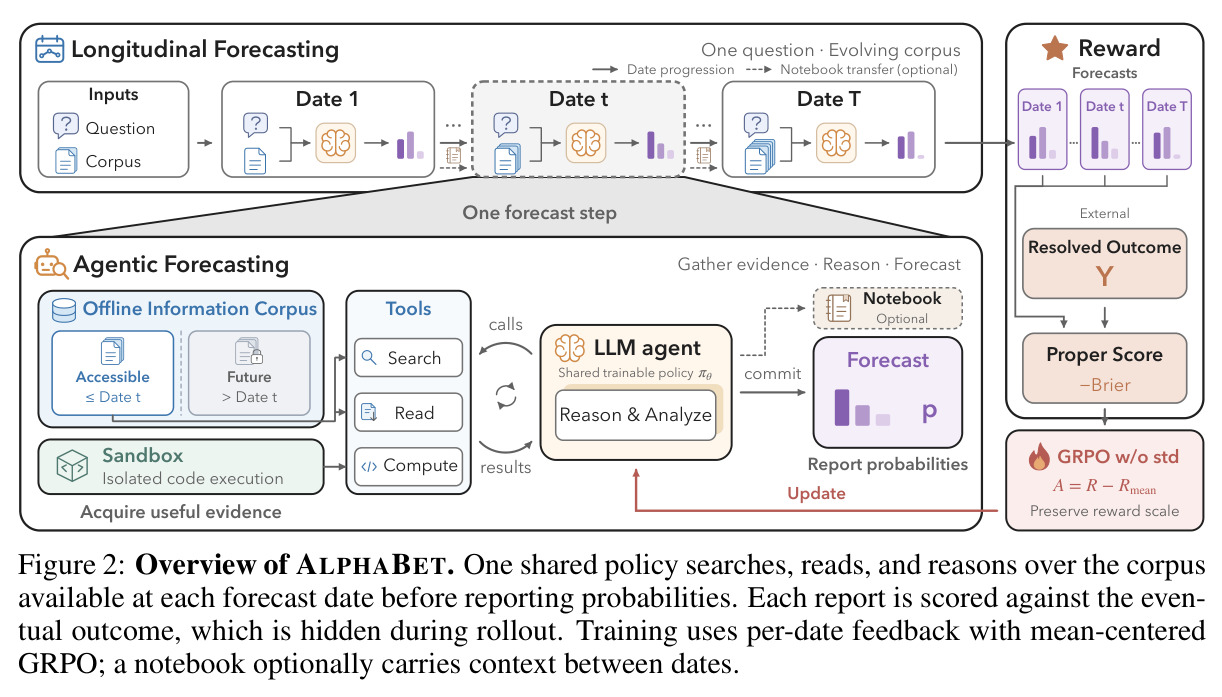
直觉上,AlphaBet 把"像超级预测者一样工作"变成一个可优化的 RL 问题。在每个预测步骤:智能体拿到问题 $Q$、预测日期 $\tau_t$(以及上一步的信念笔记本 $M_{t-1}$,若开启记忆),在"不得晚于该日期"的时间索引新闻语料 $\mathcal{I}_{\le\tau_t}$ 上交替进行推理和三类工具调用——SEARCH(返回按日期过滤的 top-k 文章快照)、READ(抓取文章全文)、COMPUTE(在沙箱中执行 Python 做数值分析、基率估计或模拟),最后以 JSON 提交概率分布 $p_t$ 并结束本步。环境随后推进到下一个日期 $\tau_{t+1}$,可用语料随之扩展。每个日期的奖励是 $R_t = S(p_t, Y) + R_t^{\text{format}}$,其中 $S$ 是负 Brier 分数,格式奖励约束答案与工具调用接口;结算结局 $Y$ 在 rollout 时对智能体隐藏。训练用去 std 的 GRPO(优势 $A=R-\bar{R}$),按"问题×日期"分组。共有三个变体:单日期(每事件一个固定日期)、多日期无记忆(memory-free,每个日期从头开始)与多日期带笔记本(memory-on,跨日期携带信念状态)。
核心创新是"多日期结局监督 + 去归一化的适当评分奖励"这一组合。第一,同一事件的最终结局 $Y$ 对每个日期的预测都是有效的评分对象,因此一个已结算事件可以监督 $T$ 个不同信息状态下的决策——这第一次把证据获取正式纳入学习回路,而以往方法只在单日期、固定证据上训练报告。第二,Proposition 1 证明在无泄漏假设下,最大化期望评分 $J_{\text{forecast}}$ 恰好等价于最小化 $\sum_t [\mathcal{D}_S(q^{Q,t},q^{H}_{Q,t}) + \mathcal{D}_S(q^{H}_{Q,t},p^{Q,t})]$,即"信息差距+报告差距",且格式奖励在可行性假设下不改变最优解集合——说明该目标同时奖励找证据和报对概率。第三,本文去掉 GRPO 的组内 std 归一化(Proposition 2):均值中心化保留期望报告梯度方向(仅缩放 $1-1/G$ 倍),而 std 归一化在大组极限下等价于把目标扭曲为 $\tilde{q}^{H}_{Q,t}(k)=\frac{q^{H}_{Q,t}(k)/(\sigma^{S}_{Q,t,k}+\epsilon)}{\sum_j q^{H}_{Q,t}(j)/(\sigma^{S}_{Q,t,j}+\epsilon)}$,按结局类别的奖励尺度重新加权——只有当各类奖励标准差相等时目标才不漂移,失真形态可以是过度锐化、拉平或跨类移动。
方法步骤详情
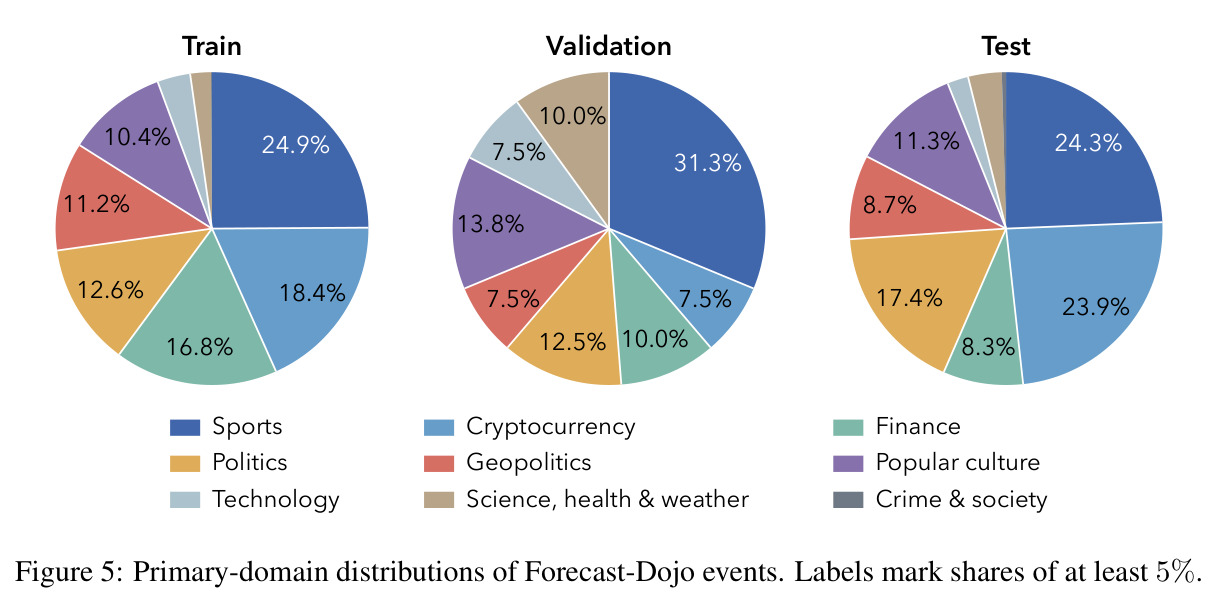
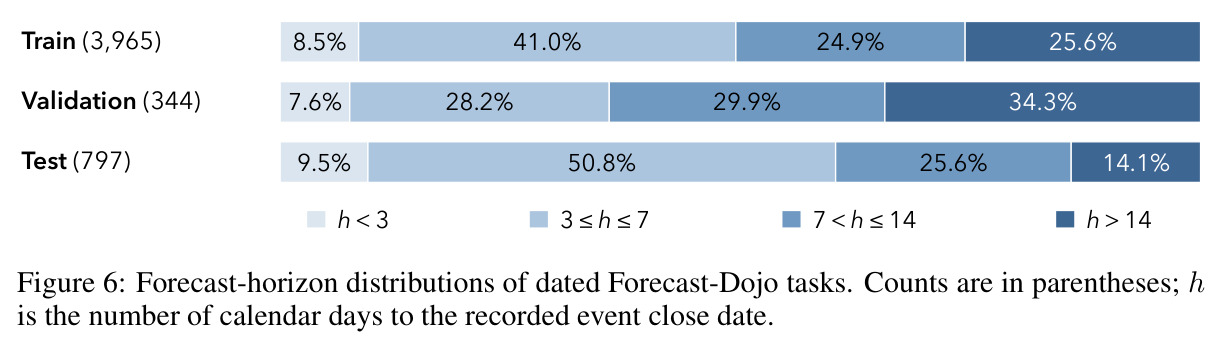
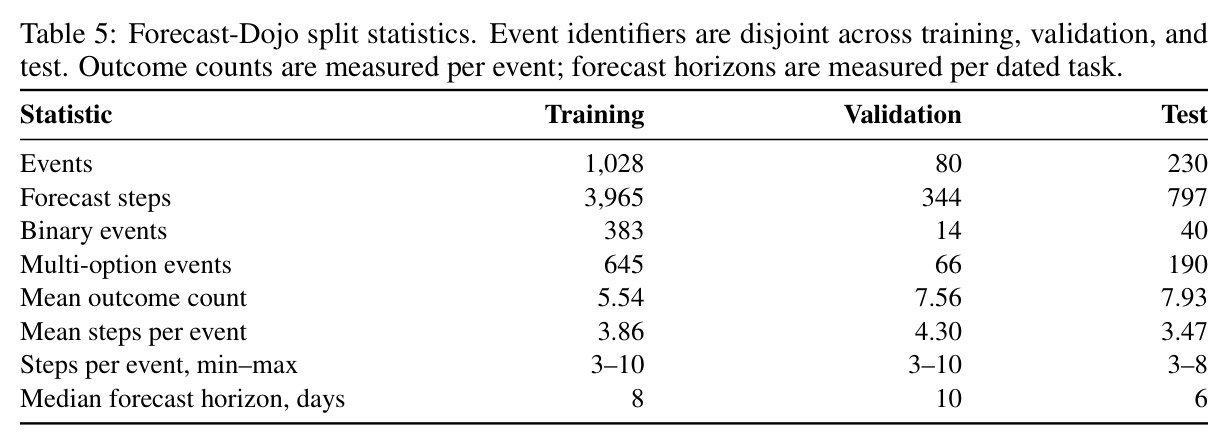
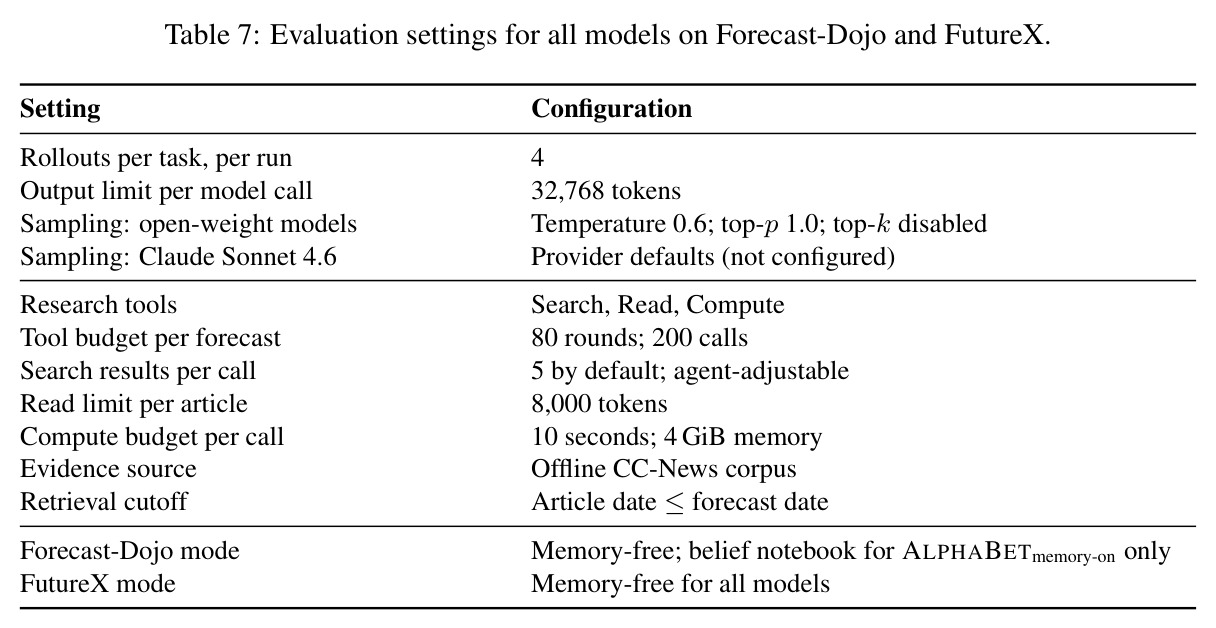
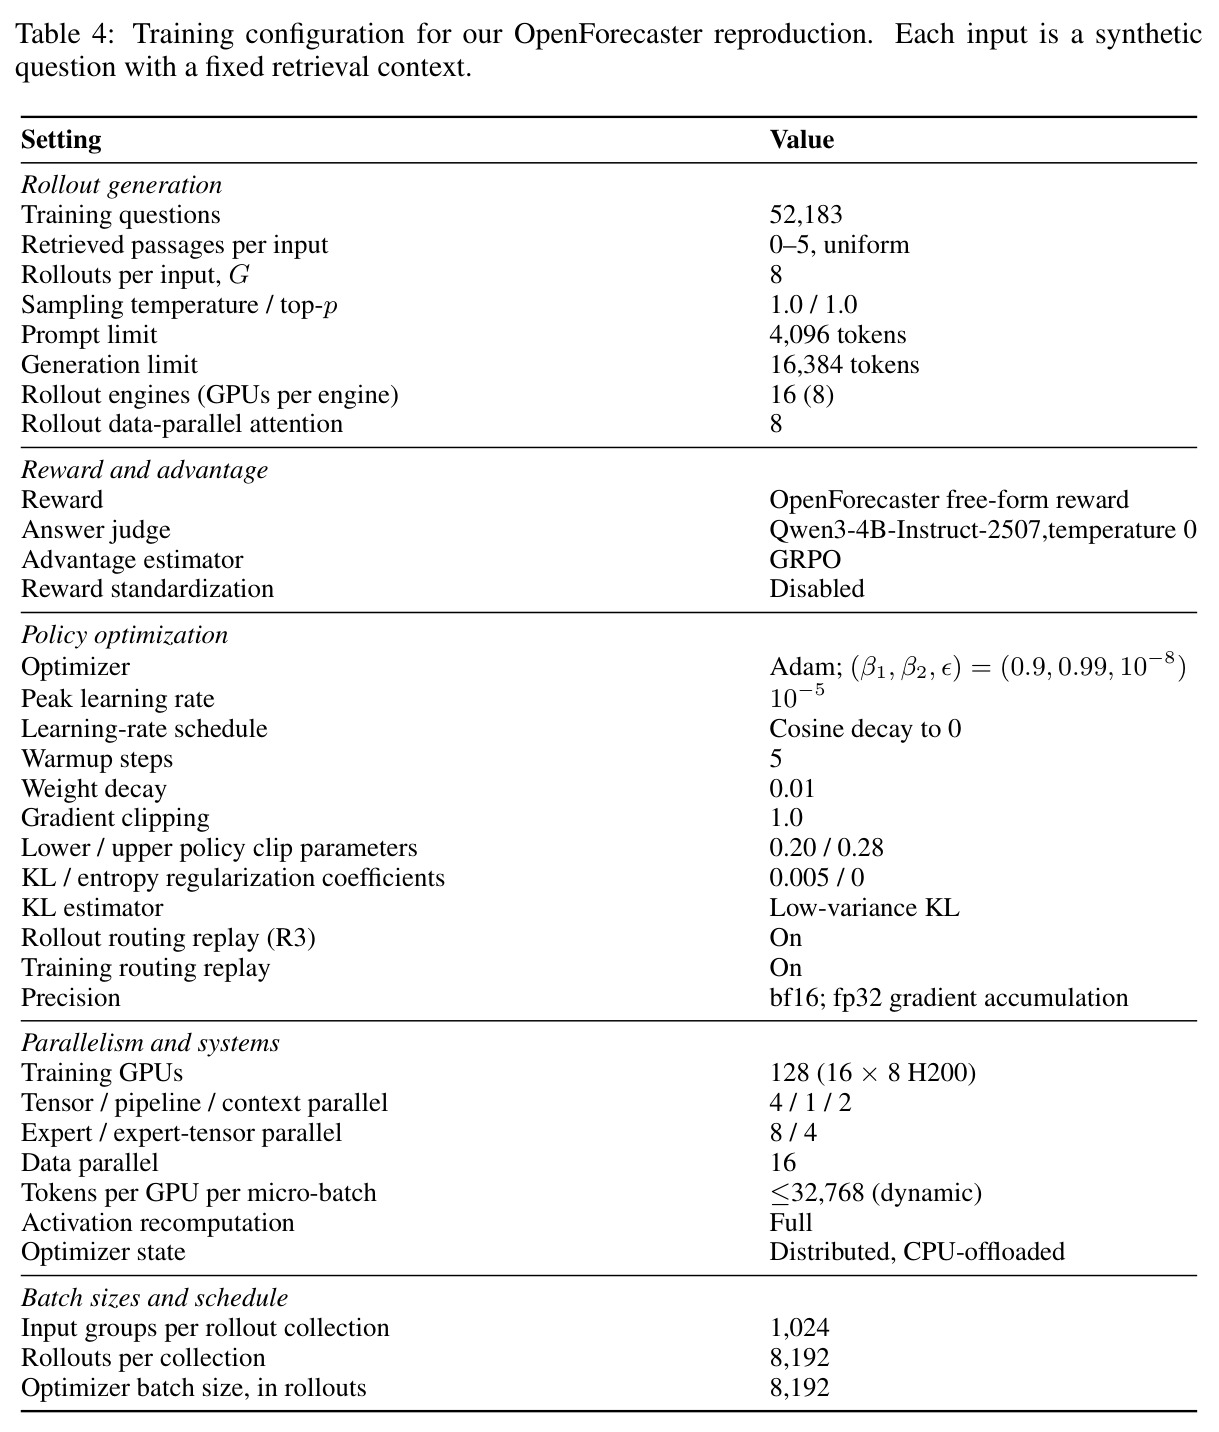
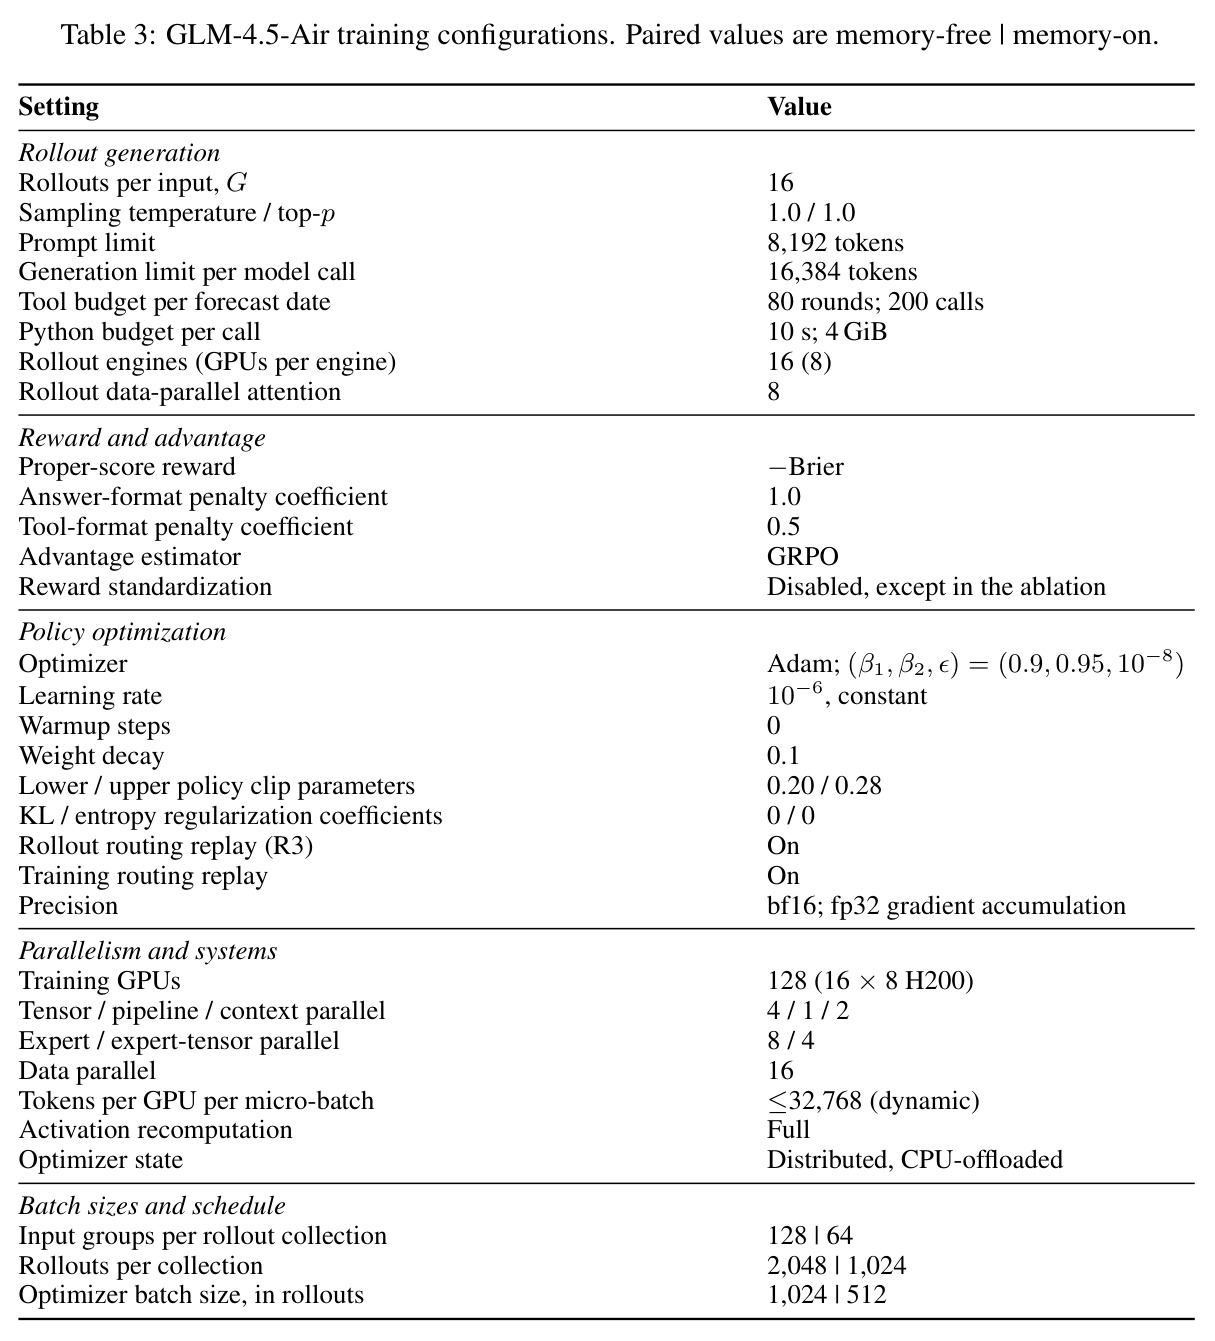
第一步,环境构建:基于 Forecast-Dojo 的 Polymarket 训练划分(1,028 个二元/多选项事件、3,965 个事件-日期任务,预测日期 2025-08-01 至 2026-02-28),配置 2025-03 至 2026-02 的 CC-News 时间索引语料(约 18.8M 篇文章的 FAISS 索引,Qwen3-Embedding-8B 做查询编码),检索严格按日期截断;另留 2026-01-01 至 02-28 结算的事件作验证集。第二步,rollout:每个预测步骤输入问题、日期与(可选)笔记本;智能体每日期最多 80 轮、200 次工具调用,COMPUTE 沙箱限 10 秒/4GiB;本步 Search/Read 结果记为 $H_t$;结束时提交概率(负值截断、归一化后需落在容差内),memory-on 模式还须产出与答案分布逐项差 $\le 0.05$ 的信念笔记本。第三步,打分与优势计算:奖励 $R_t = S(p_t,Y) + 1.0\,f_t^{\text{ans}} - 0.5\,(1-f_t^{\text{tool}})$;memory-free 每组为同题同日期的 $G=16$ 条 rollout,memory-on 则采样 $G$ 条完整 episode、在每个日期的对应步上跨 episode 分组;优势只做组内均值中心化,不除标准差,不做跨日期信用分配。第四步,策略更新:GRPO 裁剪目标作用于该步所有生成 token(推理、工具调用、概率报告、笔记本),提示与工具返回被 mask;学习率恒定 $10^{-6}$,无 warmup、无 KL/熵正则,clip 参数 0.20/0.28,bf16 精度;128 张 H200 上 120 步约 62 小时(memory-on 每步约 2.3 倍耗时)。
技术新颖性
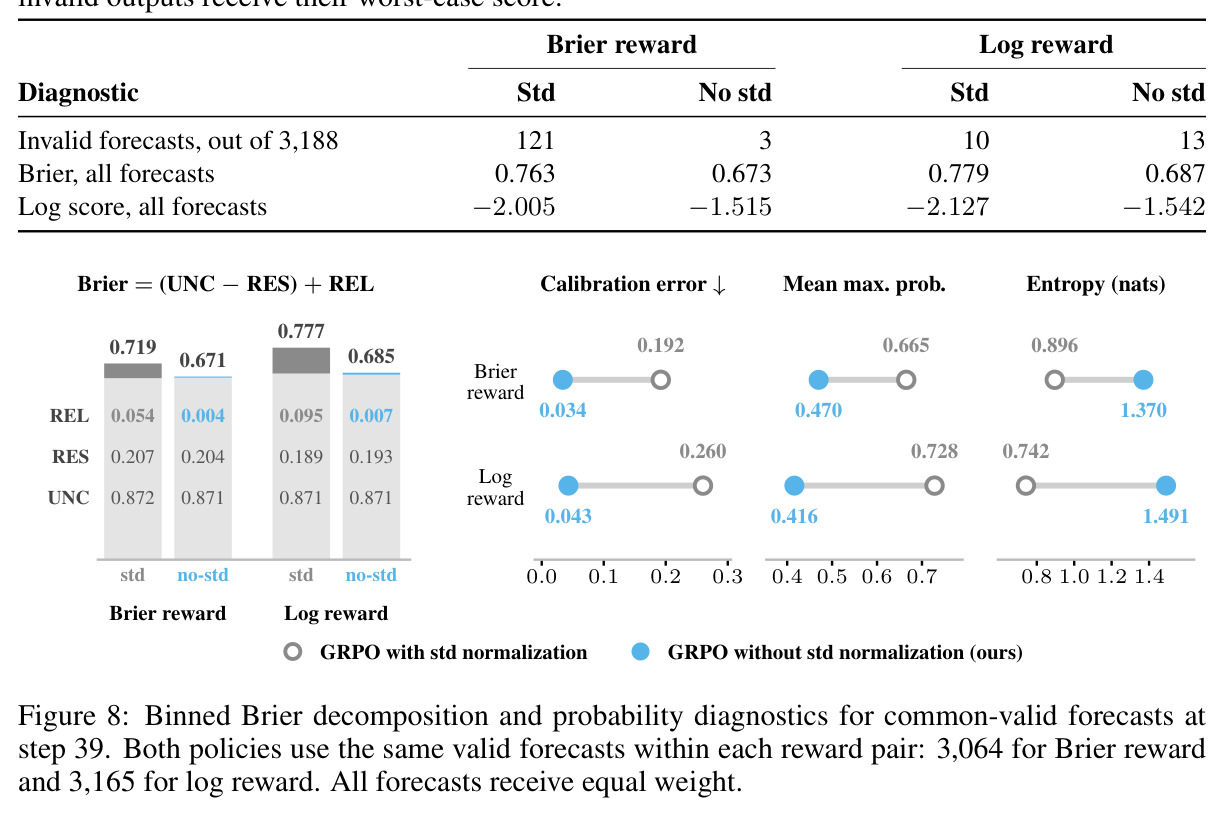
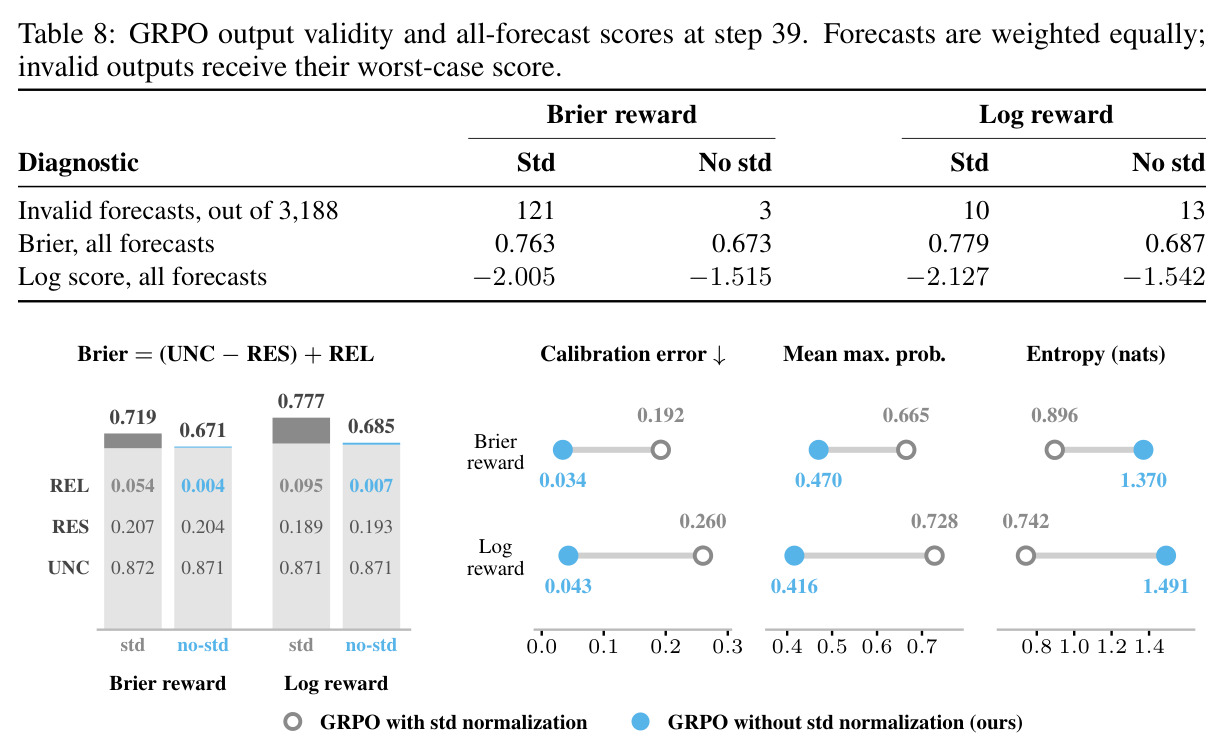
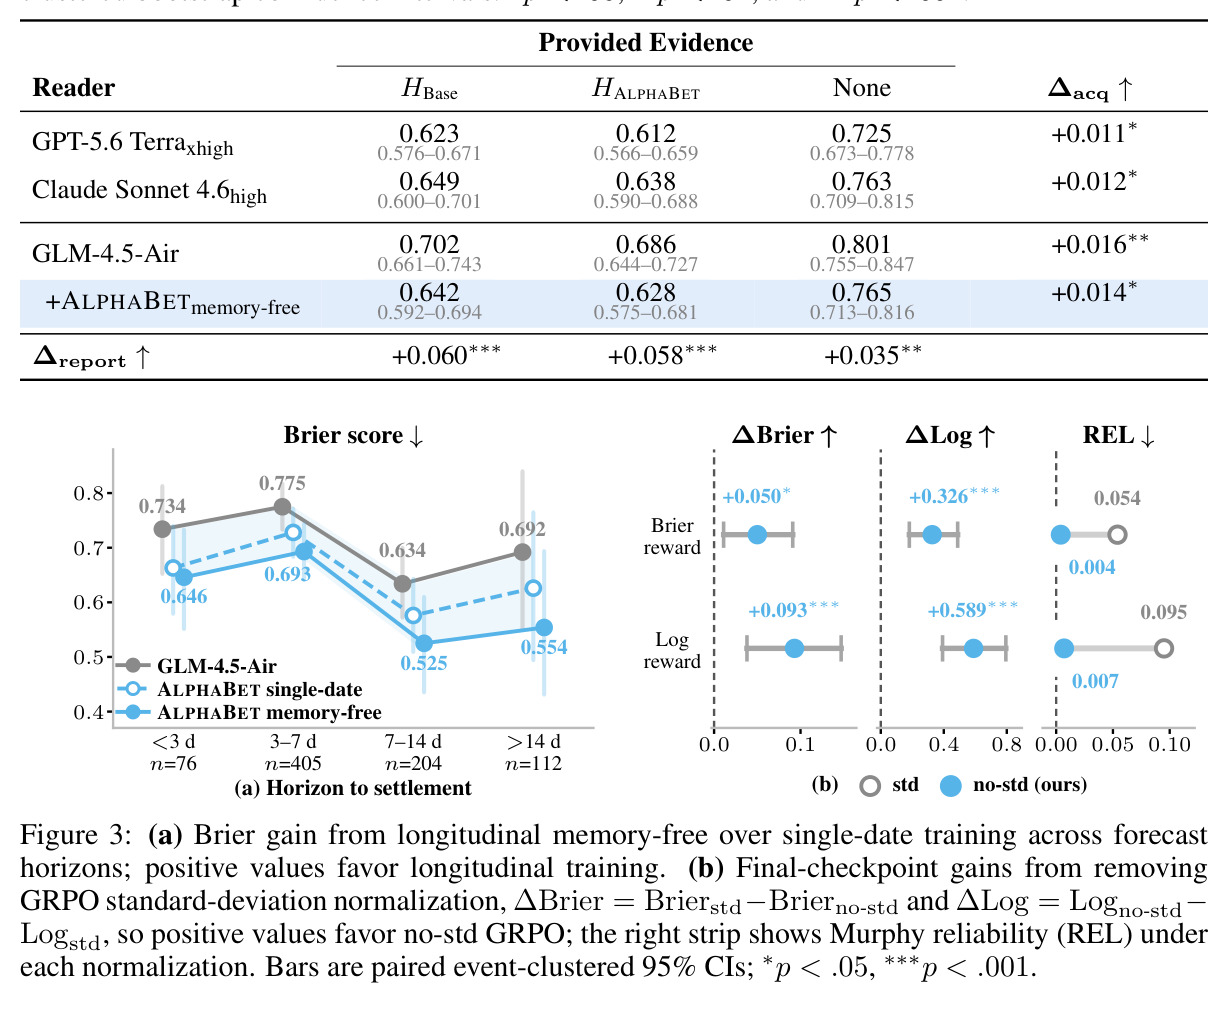
技术新颖性分三层。任务层:首次把"同一事件多日期主动取证 + 概率报告"作为单一 RL 目标训练一个共享策略——此前 outcome-based RL(Turtel et al. 2025 的 FutureX 风格训练、OpenForecaster 的新闻合成问题+离线检索)都只在孤立单日期上优化报告,Forecast-Dojo 环境本身只做了轨迹 SFT,而 AlphaBet 把带日期交互转化为 outcome-based 智能体 RL 训练问题。理论层:Proposition 1 给出智能体预测目标的严格适当性分解(信息差距+报告差距),并证明格式奖励不改变最优集;Proposition 2 把二元 GRPO 过度自信分析(Bereket & Leskovec 2025)推广到多分类适当评分,给出大组极限下的等价扭曲目标 $\tilde{q}$,并指出失真方向不必固定为过度自信——这比"std 归一化导致过自信"的旧结论更一般。实证层:用证据-读者交换实验(含独立的 GPT-5.6 Terra 与 Claude Sonnet 4.6 读者)分离两种能力的贡献,并用 Murphy 分解把 std 归一化的损害精确定位到可靠性项(log 奖励下 REL 0.554 vs 去 std 后的 0.095),而非分辨率。
实验结果
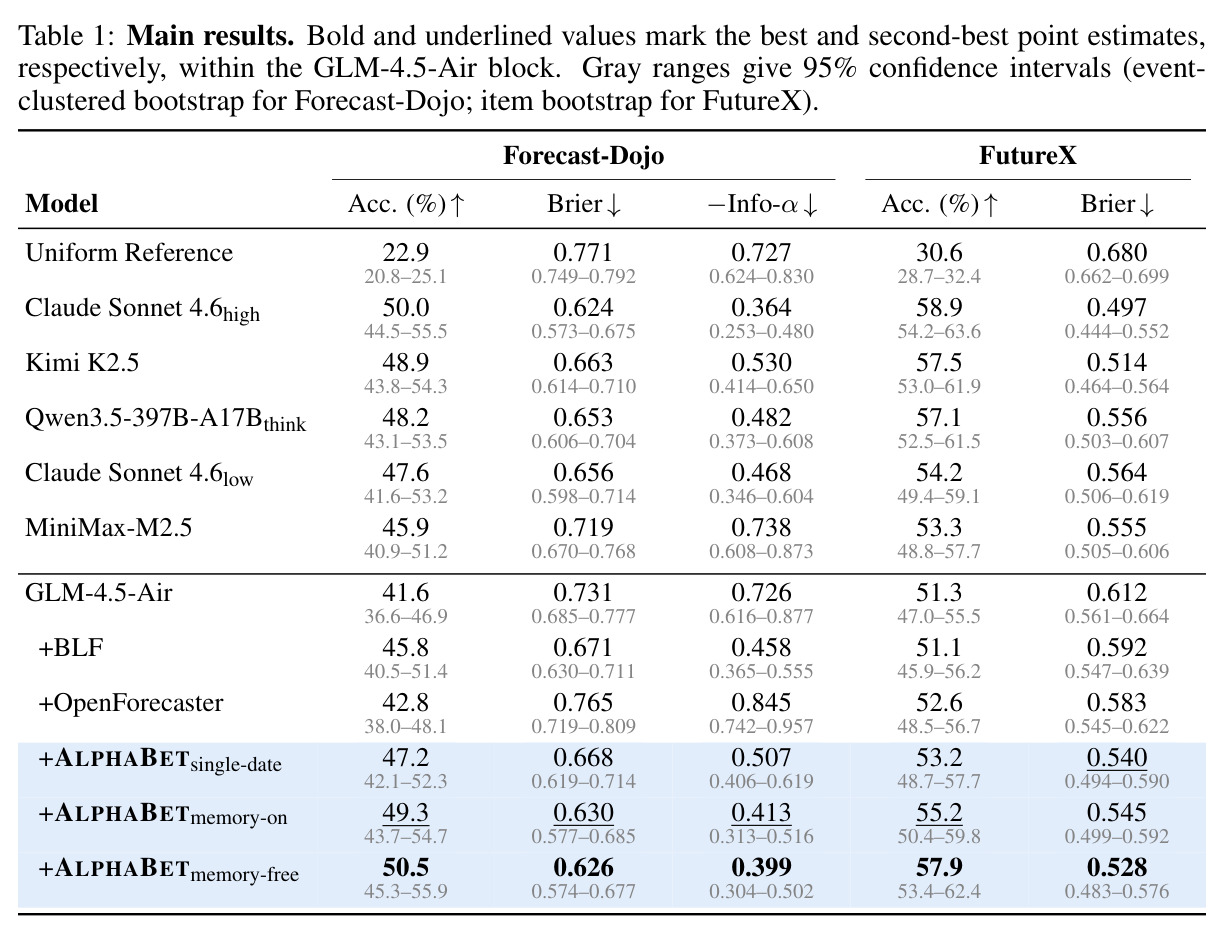
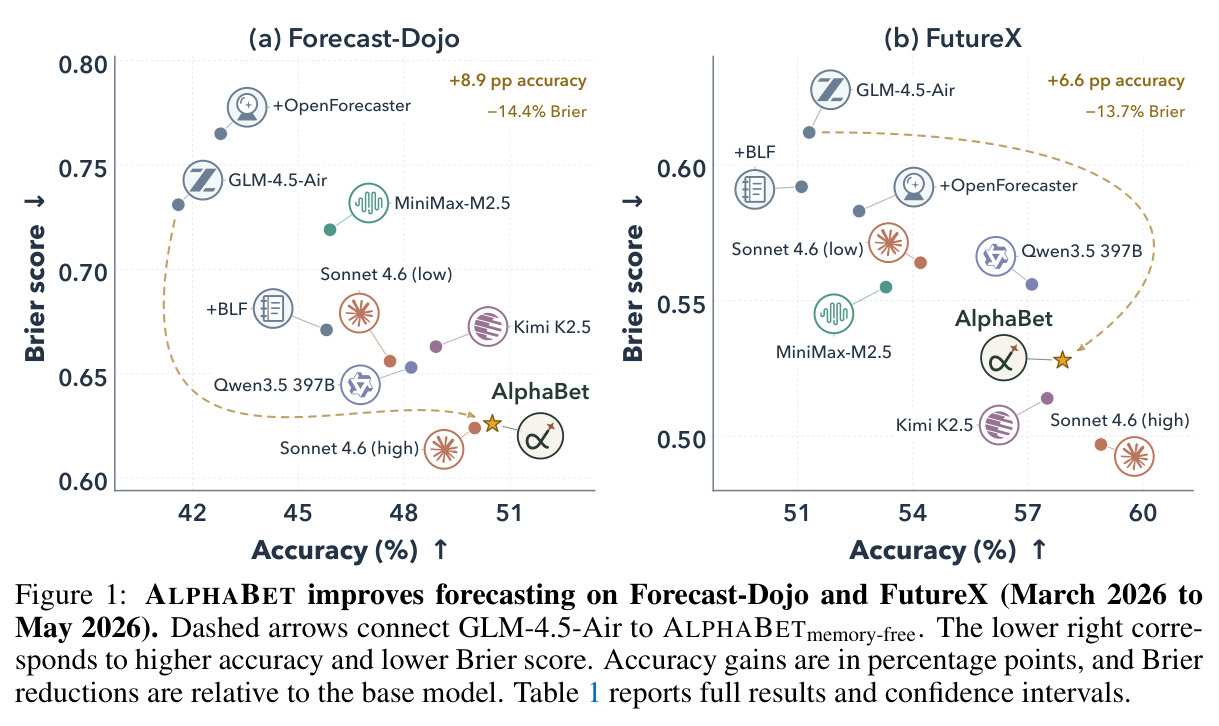
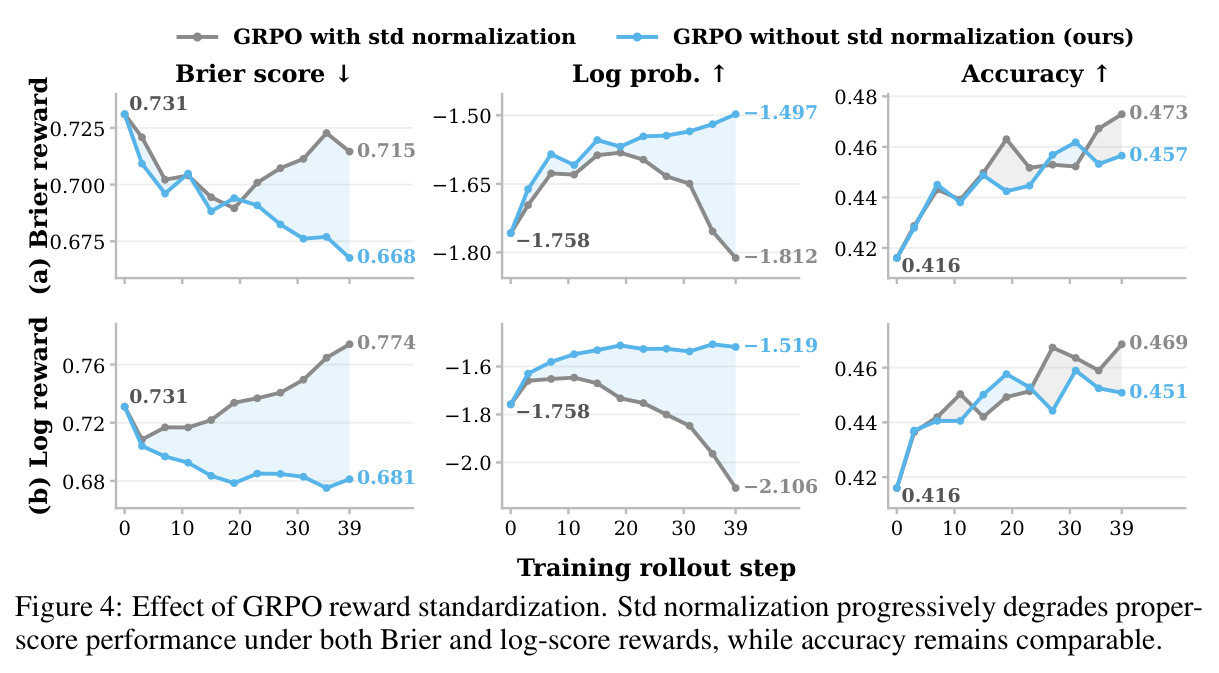
主结果(Table 1):在 Forecast-Dojo 评测集(2026 年 3–5 月,230 事件、797 事件-日期对)上,AlphaBet memory-free 把 GLM-4.5-Air 从 41.6% 准确率 / 0.731 Brier 提升到 50.5% / 0.626(准确率 +8.9 个百分点,Brier 相对下降 14.4%);在 FutureX L1–L2(343 事件)上从 51.3% / 0.612 提升到 57.9% / 0.528(+6.6pp,−13.7%)。它明显超过同底座的提示工程方案 BLF(45.8%/0.671)与 RL 基线 OpenForecaster(42.8%/0.765,且其测试时只调 8.3 次工具 vs base 的 12.4 次,印证了固定检索上下文限制信息获取),并逼近大得多的 Claude Sonnet 4.6 (high)(50.0%/0.624;58.9%/0.497),超过 Kimi K2.5(48.9%)、Qwen3.5-397B(48.2%)、MiniMax-M2.5(45.9%)。增益归因(Table 2):把检索到的证据集冻结后换读者验证,包括独立的 GPT-5.6 Terra 与 Sonnet 4.6 在内的所有读者在 $H_{\text{AlphaBet}}$ 上都比 $H_{\text{Base}}$ 好 0.011–0.016 Brier($\Delta_{\text{acq}}$,均显著),说明检索到的是普遍更有用的证据;同证据下 AlphaBet 的报告比 base 好 0.058–0.060 Brier,无证据问题条件下好 0.035($\Delta_{\text{report}}$)——两种能力都确实提升。纵向监督(Fig 3a):memory-free 比同预算的单日期训练 Brier 0.668→0.626、准确率 47.2%→50.5%,增益随结算距离增大(>14 天 +0.072,7–14 天 +0.051,3–7 天 +0.035,<3 天 +0.017)。GRPO 消融(Fig 3b/4):去掉 std 归一化显著改善适当分数(Brier 奖励下 $\Delta$Brier +0.050*,log 奖励下 +0.093***;$\Delta$Log +0.326***/+0.589***),而准确率无显著差异(p=0.099/0.114),Murphy 分解显示损害集中在可靠性(log 奖励 REL 0.554→0.095),表现为过度锐化(std 版平均最大概率 0.742 vs 0.728、熵更低)。一个反直觉发现:memory-on 在每个指标上都略差于 memory-free,作者归因于逐日期独立奖励使笔记本得不到跨日期信用。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 事件预测(Forecast-Dojo 评测集,2026-03~05,230 事件) | Top-1 准确率(%) | 50.5 | GLM-4.5-Air base 41.6(BLF 45.8,OpenForecaster 42.8,单日期变体 47.2,Claude Sonnet 4.6 high 50.0) | +8.9 个百分点(相对 base) |
| 事件预测(Forecast-Dojo 评测集) | 多分类 Brier 分数(↓) | 0.626 | GLM-4.5-Air base 0.731(BLF 0.671,OpenForecaster 0.765,单日期变体 0.668) | −0.105(相对下降 14.4%) |
| 事件预测(FutureX L1–L2,343 事件) | 官方答案匹配准确率(%) | 57.9 | GLM-4.5-Air base 51.3(BLF 51.1,OpenForecaster 52.6,Sonnet 4.6 high 58.9) | +6.6 个百分点(相对 base) |
| 事件预测(FutureX L1–L2) | 多分类 Brier 分数(↓) | 0.528 | GLM-4.5-Air base 0.612 | −0.084(相对下降 13.7%) |
| 信息优势(Forecast-Dojo) | −Info-α(对数分数相对人群基线 $p_{\text{crowd}}$ 的增益取负,↓) | 0.399 | GLM-4.5-Air base 0.726 | −0.327(信息优势大幅提升) |
| 证据获取增益(Table 2:冻结证据、更换读者) | Brier 分数(↓) | 读者在 $H_{\text{AlphaBet}}$ 上的 Brier:0.612–0.686 | 同一批读者在 $H_{\text{Base}}$ 上:0.623–0.702 | $\Delta_{\text{acq}}$ +0.011~+0.016(四种读者均显著) |
| 概率报告增益(Table 2:同证据、更换读者) | Brier 分数(↓) | AlphaBet memory-free 作为读者:0.575–0.628 | GLM-4.5-Air 作为读者:0.638–0.702 | $\Delta_{\text{report}}$ +0.058~+0.060(无证据条件 +0.035) |
| GRPO 去 std 消融(最终检查点,log 奖励) | Brier / 对数分数 / REL(Murphy 可靠性) | no-std:Brier 0.687,Log −1.542,REL 0.095 | std 归一化:Brier 0.779,Log −2.127,REL 0.554 | $\Delta$Brier +0.093***,$\Delta$Log +0.589***,准确率无显著差异 |
| 多日期 vs 单日期训练(按结算距离分层) | Brier 增益(memory-free − single-date,↓越小越好) | >14 天 +0.072,7–14 天 +0.051,3–7 天 +0.035,<3 天 +0.017 | 单日期训练(同 1,028 事件、同 rollout/更新预算) | 整体 Brier 0.668→0.626,准确率 47.2%→50.5%,距离结算越远增益越大 |
局限与改进
作者明确承认的局限:训练问题全部来自 Polymarket,选题与措辞受其用户兴趣影响,覆盖面偏窄;语料用 CC-News,受出版商覆盖与英文过滤限制,忽略了非英语或其他来源(社交媒体、专业数据源)的证据;训练限于预定义结局集的多选概率预测,不支持自由形式预测。实验结果层面,memory-on 变体在每个指标上都略差于 memory-free(如 Forecast-Dojo 49.3%/0.630 vs 50.5%/0.626),作者解释为每个日期独立给奖励、笔记本动作得不到跨日期信用分配,并把它留作未来工作——这意味着"带记忆"这一直觉上更合理的设定在当前框架下尚未兑现价值。我自己的观察还有几点:其一,Proposition 2 只刻画固定获取上下文、仅评分项的局部更新方向,不保证训练完成的完整智能体的校准性,理论结论外推有限;其二,对数分数奖励用了 $10^{-3}$ 的概率下限,作者在附录 A.3 承认这破坏了全单纯形上的严格适当性;其三,主结果只在 GLM-4.5-Air(106B-A12B)一个底座上验证,没有跨模型家族或规模的证据;其四,评测只覆盖 2026 年 3–5 月的两个基准,且近端预测(<3 天,n=76)的纵向增益只有 +0.017,临近结算时多日期训练收益有限;其五,OpenForecaster 基线的弱势可能部分源于复现配置(合成问题、每题固定检索 0–5 段落、$G=8$),而非方法本身不行。
独立分析的弱点
第一,笔记本的跨日期信用缺失:memory-on 中早期日期写笔记本的动作不获得后期奖励,导致带记忆反而全面略差(Forecast-Dojo 49.3%/0.630 vs memory-free 的 50.5%/0.626),这是框架内最明显的未兑现设计。改进方向:用 episode 回报或学习价值函数做跨日期信用分配,或对笔记本的一致性、信息增量给予过程奖励。第二,报告增益的归因有混杂:$\Delta_{\text{report}}$ 的 0.058–0.060 中有 0.035 来自无证据条件下的默认报告偏置差异,"从阅读中提取更多价值"的真实增益只占一部分,需要更干净的对照设计(例如匹配证据集的随机化实验)。第三,算力门槛极高:128 张 H200、120 步 62 小时,memory-on 还要 2.3 倍时间,学术实验室难以复现;可探索 LoRA/更小底座上的缩放规律,或者降低 rollout 数的方差控制技巧。第四,奖励设计只覆盖格式与 Brier,没有针对检索质量(查全率/查准率)、日期间信念稳定性(是否过度摇摆)的塑形信号;对搜索——而非报告——的行为也没有任何中间诊断指标。第五,std 归一化分析假设大组极限($G\to\infty$)与评分项主导,而实际 $G=16$ 且存在格式惩罚时扭曲的定量形态未给出;另外失真表现为过度锐化只是"本运行的观察",何时锐化、何时拉平缺乏可操作判据。第六,报告目标 $q^{H}_{Q,t}$ 依赖检索语料的覆盖度,语料偏差会直接转化为系统性的概率偏差,论文未做语料敏感性分析。
未来方向
作者提出的方向:跨日期信用分配——用 episode 回报或学习到的价值估计来训练笔记本更新,使早期信念写入能获得后期预测奖励;让策略学习在日期间分配共享研究预算,权衡笔记本复用与全新检索;扩展事件来源(超越 Polymarket 的选题偏好)、引入多语言与结构化证据同时保留时间访问控制;把概率训练扩展到自由形式答案,这需要在对语义等价答案一致打分的同时保持概率报告的激励。基于本文成果还可以延伸:把去 std GRPO 的适当评分分析推广到其他组相对算法(RLOO、REINFORCE 基线族)和其他输出概率的任务(医疗诊断预后、金融风险、地缘政治分析),检验"归一化扭曲多分类概率目标"的普适性;在 ForecastBench/FutureX 的真在线(live)评测上检验纵向训练智能体的持续适应能力;研究不同日期预测之间的联合校准与时间一致性约束(例如避免临近结算时的剧烈摇摆);量化语料覆盖度与信息差距 $\mathcal{D}_S(q^{Q,t},q^{H}_{Q,t})$ 的关系,为"该何时停止检索"提供原则性准则;以及探索更小的组规模 $G$ 下无 std 训练的方差缩减方法。
复现评估
可复现性总体较好但算力门槛高。论文标注了 Data & Models、Code 和 Website 三个公开入口;底座 GLM-4.5-Air(106B-A12B)公开权重可得;训练数据是 Forecast-Dojo 公开训练划分(Polymarket 1,028 事件、3,965 事件-日期任务)加公开 CC-News 语料(约 18.8M 篇文章构建 FAISS 索引);评测用 Forecast-Dojo held-out 与 FutureX L1–L2,均有严格时序防泄漏设计(检索按日期截断、训练事件晚于检查点发布)。附录非常详尽:奖励系数($\lambda_{\text{ans}}{=}1.0$、$\lambda_{\text{tool}}{=}0.5$)、全部超参(lr $10^{-6}$ 恒定、$G{=}16$、clip 0.20/0.28、无 KL)、并行配置(Table 3)、基线复现配置(Table 4)以及完整的四套系统提示词(附录 F)。主要门槛是基础设施:17 节点 × 8 张 H200(141GB),其中 128 卡用于训练与 rollout、8 卡跑检索栈(vLLM 托管 Qwen3-Embedding-8B + FAISS GPU 索引),软件栈为 SLIME + Megatron-LM + SGLang + Ray,120 步 memory-free 约 62 小时、memory-on 每步约 2.3 倍。概念验证级复现(缩小模型、减少步数)难度中等;完整复现属于大厂级配置,小团队更可能依赖其开源产物直接使用。
论文图表