语言智能体中行动与预测的协同进化 Co-Evolving Acting and Forecasting for Language Agents
让智能体在RL训练中同时预测自己未来的动作序列,无需额外模型即可显著提升样本效率。
前置知识
GRPO(Group Relative Policy Optimization)
免 critic 的强化学习算法:对每个任务从旧策略采一组 $G=8$ 条轨迹,用组内归一化优势 $\hat{A}_i=(Y-\mu)/(\sigma+\delta)$ 替代价值基线,再按 PPO 式裁剪比率目标更新策略。奖励是轨迹级终值,组内每步动作共享同一优势。
COPE 的主损失就是 GRPO,全文的增量都建立在对 GRPO 局限的诊断之上;论文还用理想化 GRPO 的期望更新方向推导出它只拟合单步后见分布这一关键事实。
稀疏终局奖励
长程智能体任务只在轨迹结束时给出二值成功信号 $Y\in\{0,1\}$(如 AppWorld 要求全部状态断言通过、WebShop 得分恰为 1.0),中间步骤无即时奖励,学习目标为 $J(\theta)=\mathbb{E}_\tau[Y(\tau)]$。
正因为每条轨迹只提供约一个比特的监督,而 rollout 又涉及大量交互步与工具调用、成本高昂,如何从有限交互中榨取更多学习信号成为全文的出发点。
后见之明分布 / 成功条件化(hindsight distribution)
用终局结果作条件重解轨迹:$\Pr^+(\cdot)=\Pr^\pi(\cdot\mid Y=1)$。给定历史 $h_t$,后见动作块 $q(a_{t:t+K}\mid h_t)$ 表示「从这里出发、最终成功的轨迹实际走的后续动作」的分布,正比于策略提议概率乘以成功概率。
COPE 的动作预测目标正是这个分布。理解它才能理解「成功如何进入训练信号」:成功是筛选轨迹的条件,而不是逐步分配的标签,这是 COPE 与价值型方法在数学上的分水岭。
观察预测辅助损失(ECHO / RWML)
在 GRPO 外增加预测下一观测的辅助目标:ECHO 对同条 rollout 的下一观测 token 加交叉熵损失;RWML 先在 $(h_t,a_t,o_{t+1})$ 三元组上预训练世界模型再跑 GRPO。观察 token(HTML、日志)大多与决策无关,且只覆盖单步转移。
这是本文最主要的对照系。COPE 的核心主张就是用「多步动作目标」替代「单步观察目标」,读懂 ECHO/RWML 才能理解消融和主表的对比设计。
动作分块与延迟集成(action chunking)
机器人模仿学习技术(如 ACT):一次预测未来 $K+1$ 步动作。Lazzati 等人将其收益归因于「延迟预测」——在缺少最近 $k$ 个观测的历史处预测 $a_t$ 即延迟-$k$ 预测器,分块策略相当于这些预测器的集成,ACT 在测试时显式平均。
COPE 的多步预测损失在形式上就是对延迟 $0..K$ 的集成,但通过共享骨干在训练中隐式吸收,推理时仍逐步执行、零开销。这是理解其「预测反哺行动」机制和消融设计的关键背景。
研究动机
标准智能体 RL 的训练瓶颈在于长程 rollout 代价高昂(每条轨迹包含大量交互步与工具调用),却只从终局一个标量奖励中学习,过程监督(中间动作与环境观测)基本被浪费。已有两类利用中间监督的方案各有硬伤:(1) 价值目标(过程奖励模型、步级信用分配)——一条轨迹只记录一个终局结果 $Y\in\{0,1\}$,每个中间步只能被同一个标签标注,而结果的随机性主要来自后续的动作和观测而非当前步本身,因此目标噪声极大;要区分步与步,需要步级人工标注、从中间状态额外采样、或不同 rollout 间状态精确重现,成本都很高。(2) 观察目标(如 ECHO 拟合下一观测)——在网页导航或代码任务里,下一观测(HTML DOM 树、冗长的 pytest 终端日志)中绝大多数 token 与决策无关(Figure 1a 用一段含 numpy 报错的 pytest 输出做了直观展示),预测损失被复现无关内容占据;而且目标只覆盖单步转移,想看得更远只能链式预测,误差会逐步复合。结果是:长轨迹贵、信号少,而已有的补信号方式要么噪声大、要么浪费在噪声上。
本文的目标是本文的目标是构造第三种训练目标——多步动作目标,在几乎不增加成本的前提下显著提升稀疏奖励下智能体 RL 的样本效率。具体而言:在 GRPO 之外,对成功的 on-policy 轨迹增加一个动作预测辅助损失,让共享骨干从当前历史 $h_t$ 直接预测该轨迹后续真实执行的动作块 $a_{t:t+K}$(跳过中间观测),并且每个动作同时在多个历史处被监督,形成时间集成。作者设定了三条可检验的验收标准:(1) 在多个基准上总体性能超过 GRPO 与观察预测基线;(2) 样本效率有明确倍数提升;(3) 不需要额外模型、单独的预训练阶段或任何推理时开销。随后在五个基准上逐一验证:三个模拟环境 ALFWorld、ScienceWorld、WebShop,两个真实应用 $\tau^2$-bench(带用户模拟器的客服)与 AppWorld(跨消费级应用的 API 编排)。
与已有工作不同的是,本文的独特切入在于「目标类型」的选择。价值目标把终局成功稀释成所有步共享的同一标签,噪声大且步间无区分;观察目标保真但充满与决策无关的 token、且只能看一步。COPE 注意到一个被忽视的事实:动作本身短小、简洁且完全决策相关(Figure 1a 中一个动作只有几个 token),而成功轨迹中每个历史后面真实发生的动作序列天然就是「多步、步级特异」的监督——只要以成功为条件筛选轨迹(后见之明式),中间观测就在分布中被自动边缘化,既不需要显式世界模型,也不需要链式预测。第二个独特角度是把机器人学习中「动作分块 = 延迟预测器集成」的最新理论(Lazzati et al., 2026)迁移到 LLM 智能体 RL:多步预测让每个动作同时被最近 $K$ 个历史以不同延迟监督,形成隐式时间集成;与 ACT 在测试时显式平均不同,COPE 让共享骨干在训练中吸收集成效应,推理时保持逐步执行、零开销。
核心方法
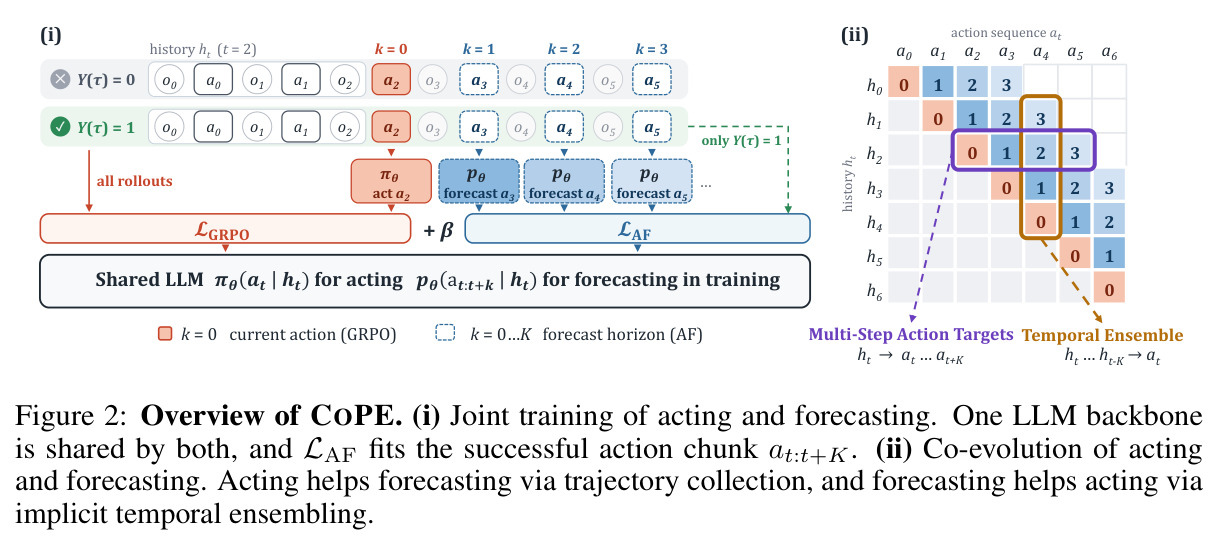
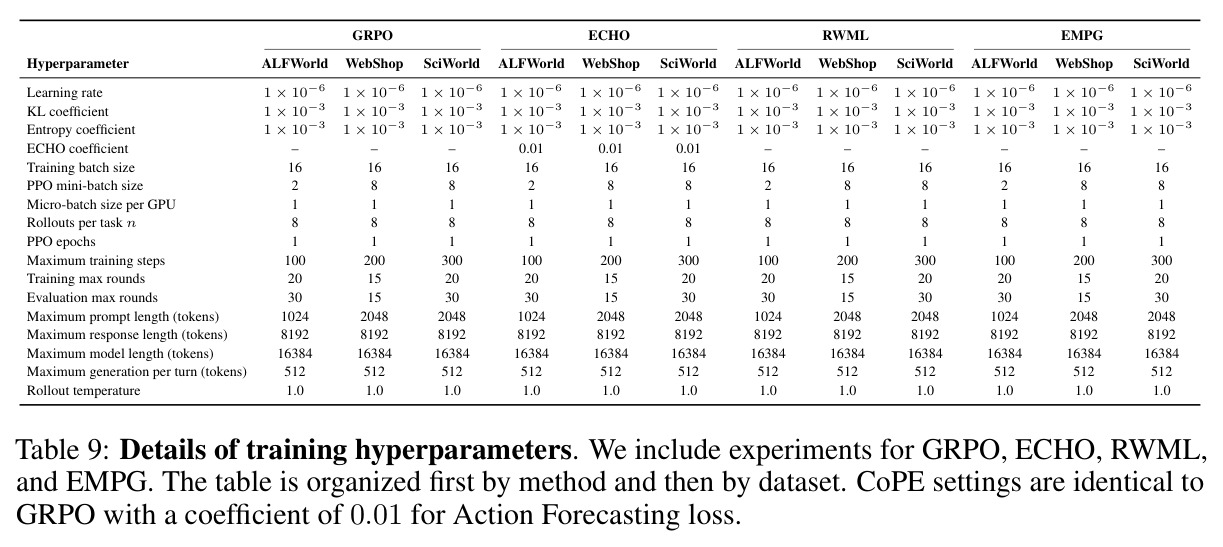
直觉上,一条成功轨迹不仅告诉策略「这一步该做什么」(GRPO 已在学),还告诉它「从这里看未来几步该怎么走」;把后者变成辅助监督,可迫使策略表示在每步就编码通向成功的多步计划。技术路线:COPE 在同一 LLM 骨干上实例化行动策略 $\pi_\theta(a_t|h_t)$ 与动作预测器 $p_\theta(a_{t:t+K}|h_t)$,靠附加的预测指令区分。每轮先用旧策略对每个任务采 $G=8$ 条轨迹做 GRPO 更新,再对成功轨迹的每个历史 $h_t$ 追加「列出接下来 $k$ 个动作」的指令,以真实执行的 $K+1$ 个动作(默认 $K=2$)为目标算交叉熵,联合优化 $\mathcal{L}=\hat{\mathcal{L}}_{\text{GRPO}}+\lambda\hat{\mathcal{L}}_{\text{AF}}$($\lambda=10^{-2}$)。推理时只保留行动模式、逐步生成,零额外开销。行动为预测提供越来越多的成功轨迹,预测经共享参数反哺行动,形成协同进化。
核心理论贡献是证明:理想化 on-policy GRPO 的期望更新方向恰好拟合单步后见分布,$\nabla\mathcal{L}_{\text{GRPO}}\propto\nabla\,\mathbb{E}_{\Pr^+}[\sum_t\text{CE}(q(a_t|h_t),\pi_\theta(a_t|h_t))]$,从不要求 $h_t$ 预期后续动作 $a_{t+1:t+K}$。COPE 把监督扩展到完整视野 $q(a_{t:t+K}|h_t)=\Pr^+(a_{t:t+K}|h_t)$;由贝叶斯法则 $q\propto\Pr^\pi(a_{t:t+K}|h_t)\cdot\Pr^\pi(Y{=}1|\cdot)$,即「策略提议×成功概率」,成功过滤以拒绝采样实现后者。与已有方法的本质区别有三:(1) 目标步级特异——每个历史被自己真实发生的后续动作标注,而非共享终局标签;(2) 目标决策相关——动作 token 短小,损失不浪费在无关观测上;(3) 多步视野形成隐式时间集成——每个动作被 $K+1$ 个历史以延迟 0 到 $K$ 监督,经共享骨干吸收进策略。
方法步骤详情
算法 1 每轮流程:(1) 每任务用旧策略采 $G=8$ 条轨迹;(2) 组内归一化优势 $\hat{A}_i=(Y-\mu)/(\sigma+\delta)$,奖励为二值终局信号 $Y$;(3) 按逐步比率 $\rho_{i,t}=\pi_\theta/\pi_{\theta_{old}}$ 做 PPO 式裁剪的 GRPO 更新;(4) 对成功轨迹的每个历史 $h_t$,在截断对话末尾追加「Plan ahead: 列出接下来 $k$ 个动作」,以真实执行的 $a_{t:t+K}$ 为目标(越过轨迹末尾在终局 token 截断;τ² 目标取首个 tool_call 块);(5) 预测损失 $\hat{\mathcal{L}}_{\text{AF}}$ 为成功轨迹上各历史 $-\log p_\theta(a_{t:t+K}|h_t)$ 的组内平均,消除成功数增长带来的梯度放大;(6) 联合最小化 $\hat{\mathcal{L}}_{\text{GRPO}}+\lambda\hat{\mathcal{L}}_{\text{AF}}$。实现基于 verl 与 AgentGym-RL。
技术新颖性
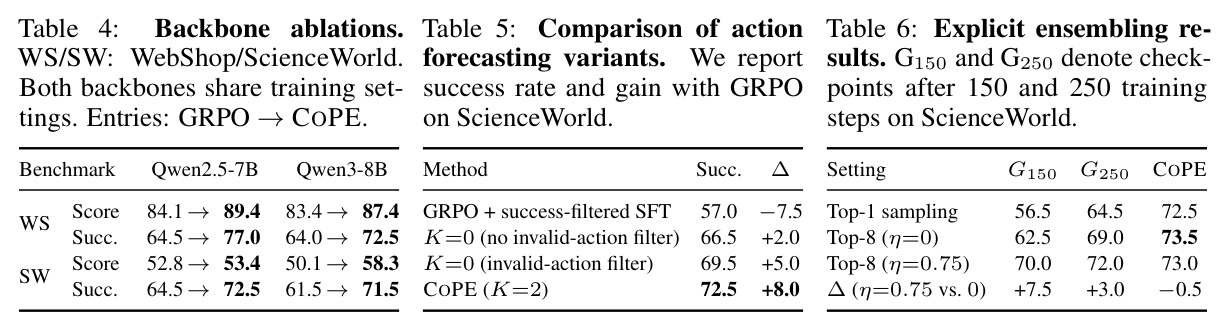
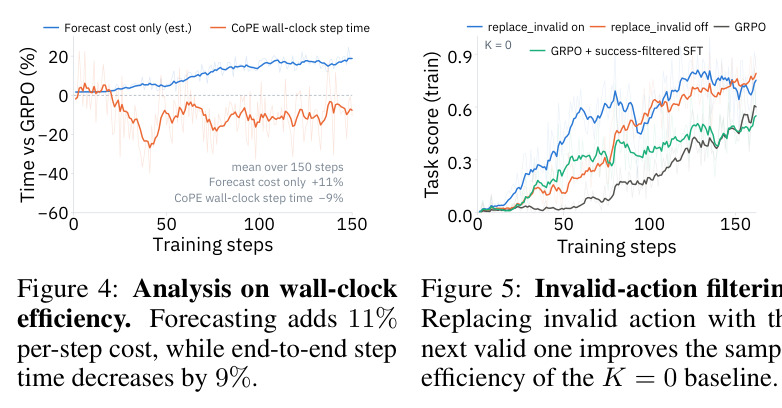
新颖性体现在四层。(1) 目标层面:首次在智能体 RL 中系统提出「多步动作目标」这一第三类过程监督,填补价值目标(逐步噪声大)与观察目标(单步且噪声 token 多)之间的空白;成功条件化使目标携带长程信用,却不需要步级标注、额外 rollout 或显式世界模型。(2) 理论层面:把 GRPO 的期望更新方向精确刻画为对单步后见分布的交叉熵拟合,把「扩展监督视野」化为良定义的最大似然问题,并证明成功过滤加组归一化的估计量期望上等于原目标(至多差一个正标量),不改变最优解。(3) 机制层面:用「延迟预测器集成」解释收益——表 5 显示延迟 0 的成功过滤 SFT 为 −7.5,$K=0$ 为 +2.0,单一环境指定延迟 +5.0,全延迟集成 +8.0,与机器人分块结论同构,但把 ACT 的显式测试时集成变为训练时隐式吸收。(4) 系统层面:单一骨干、无预训练、推理零开销,预测仅 +11% 单步时间,rollout 变短使端到端步时 −9%。
实验结果
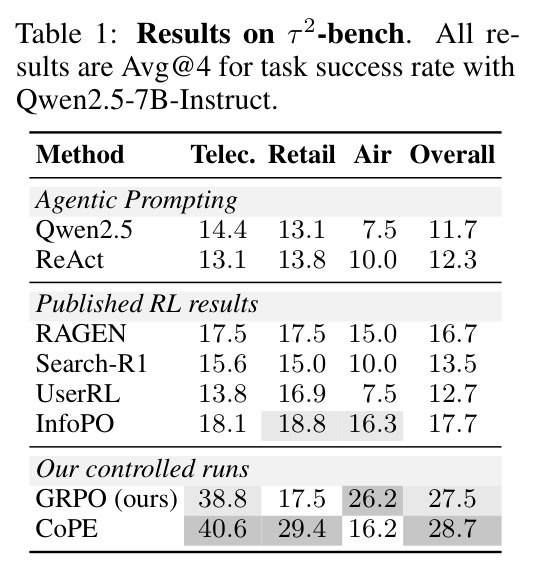
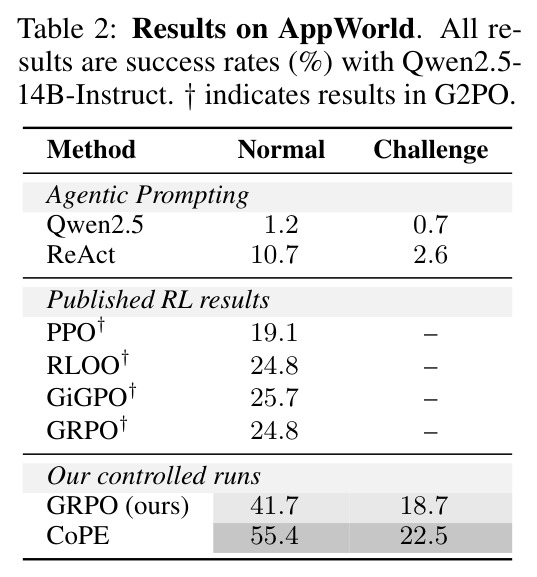
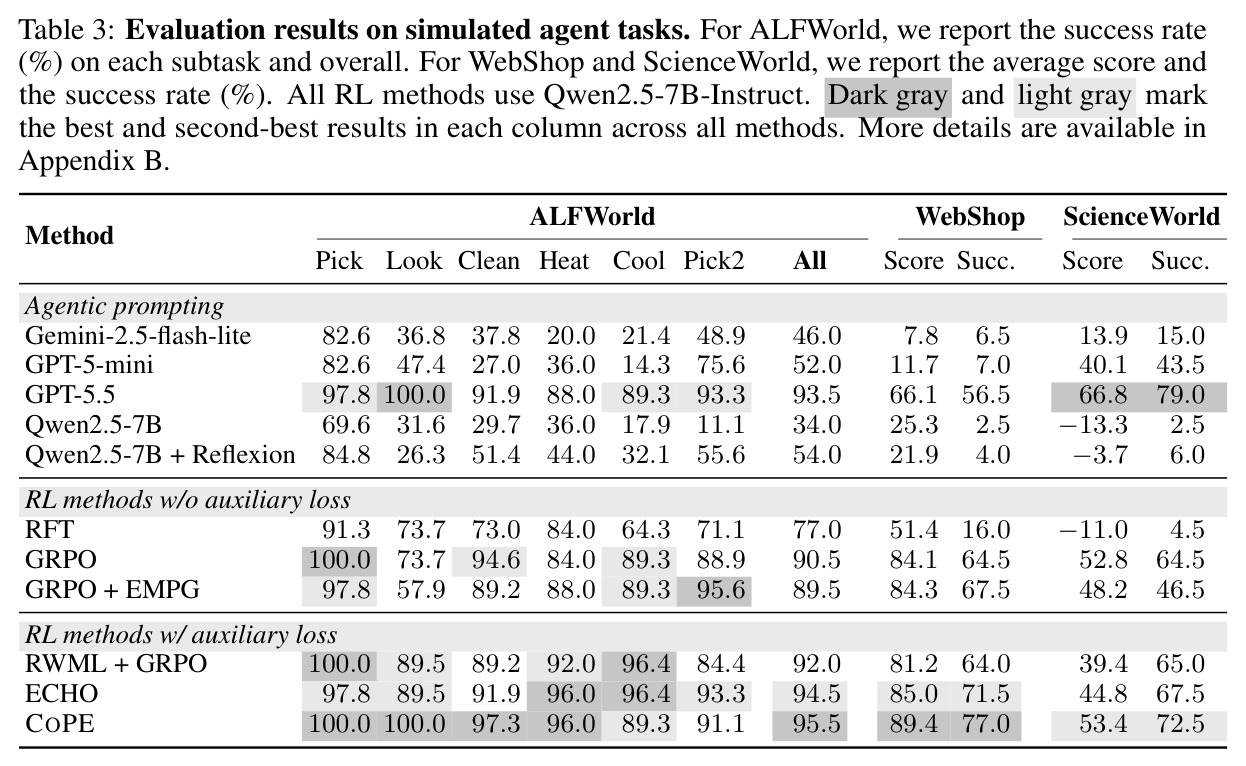
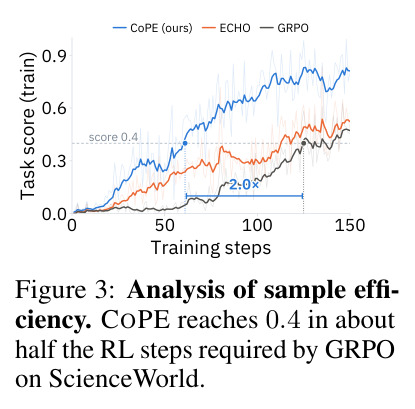
实验覆盖三个模拟环境(ALFWorld/ScienceWorld/WebShop)与两个真实应用(τ²/AppWorld),用 Qwen2.5-7B/14B。①性能:ALFWorld 成功率 95.5%(GRPO 90.5,+5.0);WebShop 77.0%(64.5,+12.5);ScienceWorld 72.5%(64.5,+8.0),均超最强基线 ECHO。真实应用:τ² 总体 27.5%→28.7%,Retail 17.5→29.4,但 Airline 26.2→16.2 下滑;AppWorld 正常集 41.67%→55.36%、挑战集 18.71%→22.54%。②样本效率:AppWorld 达分 0.5 少用 1.6× 步;ScienceWorld 提速 2.0×(vs GRPO)、1.7–1.9×(vs ECHO)。③开销:预测 +11% 单步、端到端步时 −9%。消融:$K\ge1$ 均优于 GRPO、$K=2$ 最佳;$\lambda=10^{-2}$ 最优;Qwen3-8B 复现。独立预测器重排使 GRPO +13.5 点、对 COPE 无增益。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
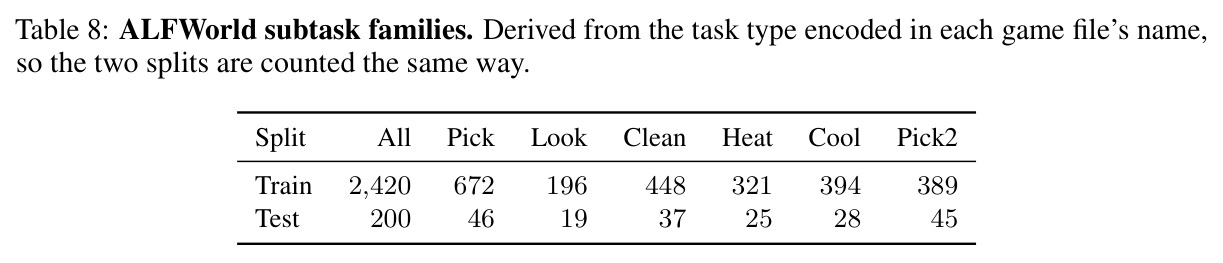
| ALFWorld(模拟家务,6 类子任务,Qwen2.5-7B) | 总成功率 (%) | COPE 95.5 | GRPO 90.5;ECHO 94.5;RWML 92.0;RFT 77.0 | +5.0 点(vs GRPO),+1.0 点(vs ECHO) |
| WebShop(网页购物,Qwen2.5-7B) | 成功率 (%) / 平均得分 | 77.0 / 89.4 | GRPO 64.5 / 84.1;ECHO 71.5 / 85.0;RWML 64.0 / 81.2 | +12.5 点成功率、+5.3 得分(vs GRPO);+5.5 点成功率、+4.4 得分(vs ECHO) |
| ScienceWorld(科学实验,Qwen2.5-7B) | 成功率 (%) / 平均得分 | 72.5 / 53.4 | GRPO 64.5 / 52.8;ECHO 67.5 / 44.8;RWML 65.0 / 39.4;GRPO+EMPG 46.5 | +8.0 点成功率(vs GRPO),+5.0 点(vs ECHO),RL 方法中最佳 |
| τ²-bench(客服,三域等权均值,Avg@4,Qwen2.5-7B) | Overall 成功率 (%) | 28.7(Telecom 40.6 / Retail 29.4 / Airline 16.2) | GRPO(ours) 27.5(38.8 / 17.5 / 26.2);已发表最佳 InfoPO 17.7(协议不同) | 总体 +1.2;Retail +11.9;Telecom +1.8;Airline −10.0(负结果) |
| AppWorld(API 智能体,Qwen2.5-14B) | 成功率 (%):test_normal / test_challenge | 55.4 / 22.5 | GRPO(ours) 41.7 / 18.7;已发表 RL 最佳 GiGPO 25.7(仅 normal,协议不同不可直接比较) | +13.7 / +3.8 点(vs 同协议 GRPO) |
| ScienceWorld 样本效率 | 达到同等得分所需 RL 步数 | 第 86 步达 0.6 奖励;0.4 分约用 GRPO 一半步数 | GRPO(需 2.0× 步数);ECHO(需 1.7–1.9× 步数,53/114 步里程碑) | 最高 2.0× 提速(vs GRPO)、1.9×(vs ECHO) |
| AppWorld 样本效率 | 达到训练分 0.5 所需 RL 步数 | 1.6× 更少步数 | GRPO | 1.6× 提速 |
| 训练开销(ScienceWorld) | 端到端每步墙钟时间 | −9%(预测前向仅 +11% 单步成本,rollout 更短反超) | GRPO | 净加速,且无额外模型/预训练/推理开销 |
局限与改进
作者重点分析的局限是 τ² Airline 域的负结果:该域奖励检查最终数据库的状态断言,38% 任务期望数据库不变(Retail 仅 4.4%),「拒绝即可满分」的任务早期成功率 52%,远高于需改库任务的 8.9%;于是成功轨迹——预测损失唯一数据来源——被拒绝动作主导,而「该拒绝」与「该行动」的历史几乎相同,预测器把拒绝泛化到需行动的任务上,失败又进一步强化拒绝偏斜,形成自增强回路。根源是结果条件化模仿的经典缺陷:成功轨迹可能过度代表简单任务(Paster et al., 2022; Eysenbach et al., 2022)。我的补充观察:(1) 分析实验只在 ScienceWorld 上做,$K=2$、$\lambda=10^{-2}$ 最优未必跨环境成立;(2) 预测损失依赖组内存在成功轨迹,成功率极低的难任务拿不到辅助信号,而这恰是最需加速的场景;(3) 训练只用二值奖励,WebShop 要求得分精确 1.0,分级信息被丢弃;(4) 实验限于 Qwen 家族 7B–14B,规模扩展性未知;(5) 含随机用户模拟器的环境下目标噪声未被量化。
独立分析的弱点
独立分析四个弱点。弱点一:零成功组的信号真空——若某任务 8 条 rollout 全部失败,预测损失没有数据,最难任务反而得不到加速;改进方向是跨迭代回放成功轨迹(配合 off-policy 修正)或难度分层采样。弱点二:简单任务过表征——Airline 案例显示成功条件化会放大难度分布偏斜且自增强;改进方向是按任务类型/难度在预测损失内再加权或去偏,或对「拒绝类」目标做受控负采样。弱点三:延迟 0 目标保留绕路与无效动作——success-filtered SFT 达 −7.5 点,因为后来才纠正的绕路动作也被当作目标;改进方向是给不同延迟加不确定性权重,或结合有效性过滤器($K=0$+过滤为 +5.0),但过滤器依赖环境特定信号,普适化是开放问题。弱点四:固定 $K$ 的折中——过小丢多步结构、过大引入远期不可约噪声($K=4$ 回落),且与任务地平线的匹配未被建模;可探索基于预测熵的自适应视野。此外,「隐式集成」只有间接证据(表 6),缺少表示层面的直接探测与理论保证。
未来方向
作者希望这项工作能推动更多样本高效的长程智能体 RL 研究。可延伸方向:(1) 与显式步级信用分配结合——COPE 不改变 GRPO 的轨迹级优势,在 $k=0$ 项叠加过程奖励或步级加权可能互补;(2) 自适应/可学习预测视野,用预测置信度动态决定每个历史看多远,适配不同地平线的任务;(3) 面向拒绝偏斜域的去偏机制,如按断言类型(改库 vs 保持不变)分层组织成功轨迹;(4) 与观察预测建立统一比较并按环境混合——在观测本身决策相关的任务(如密集文档阅读)中两类目标或各有所长;(5) 把隐式时间集成与 Lazzati 等人的延迟分析理论对接,给出 LLM 智能体设定下的方差缩减或收敛保证;(6) 扩展到更大规模骨干与多模态 GUI 智能体,检验增益是否随规模保持;(7) 利用学到的多步计划分布做轻量推理增强——表 6 已证明用预测分布重排候选动作能把 GRPO 提升约 7.5 点,可发展为免训练的解码策略或测试时选择性集成。
复现评估
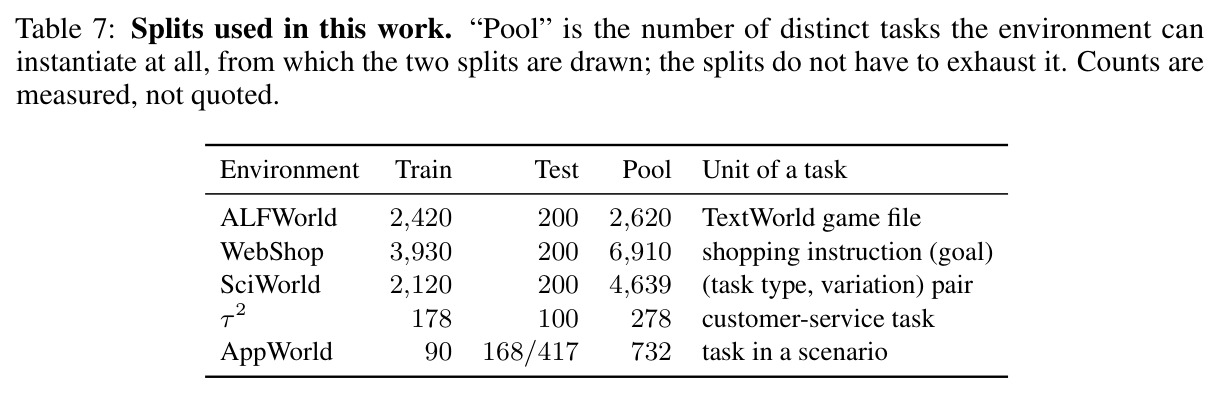
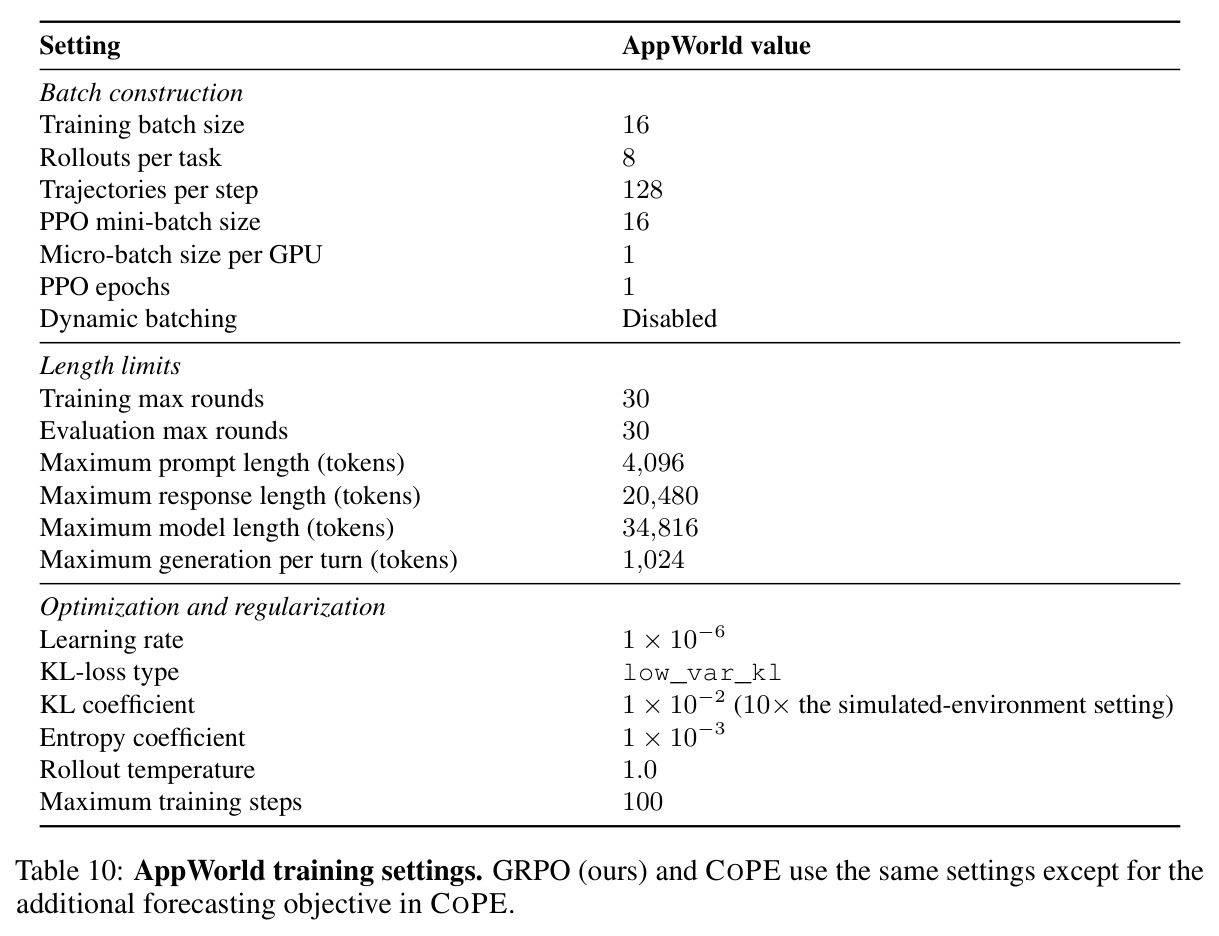
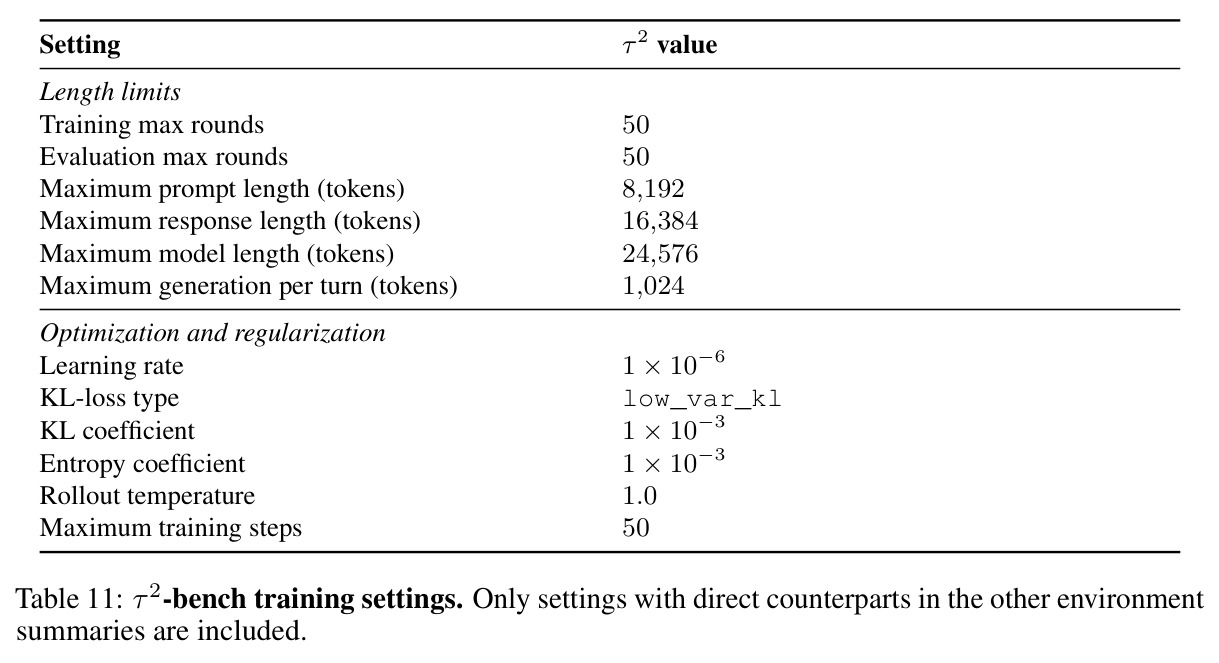
复现条件良好。代码承诺发表后开源(GitHub: ulab-uiuc/CoPE),附每方法完整配置与训练代码;基础设施公开:verl v0.2.0.post2 + AgentGym-RL,AppWorld 与 τ² 适配器自研但附录给出精确配置。数据划分在表 7 实测列出:ALFWorld 2420/200、WebShop 3930/200(1000 商品配置,与常见 12087 指令配置不可比)、SciWorld 2120/200、τ² 178/100、AppWorld 90/168+417。模型全开源(Qwen2.5-7B/14B-Instruct、Qwen3-8B,Apache 2.0);超参数表 9–11 完整,附录 C 逐字给出提示词与预测指令模板。算力为 7B–14B on-policy RL,需多卡节点但属常规实验室规模;AppWorld 仅 90 个训练任务、τ² 仅 178 个,交互成本可控,但 τ² 每轮调用 GPT-4o-mini 客户模拟器有 API 费用且环境随机。整体难度中等:需熟悉 verl 类框架,方法本身只是辅助交叉熵损失,工程量主要在环境适配。
论文图表
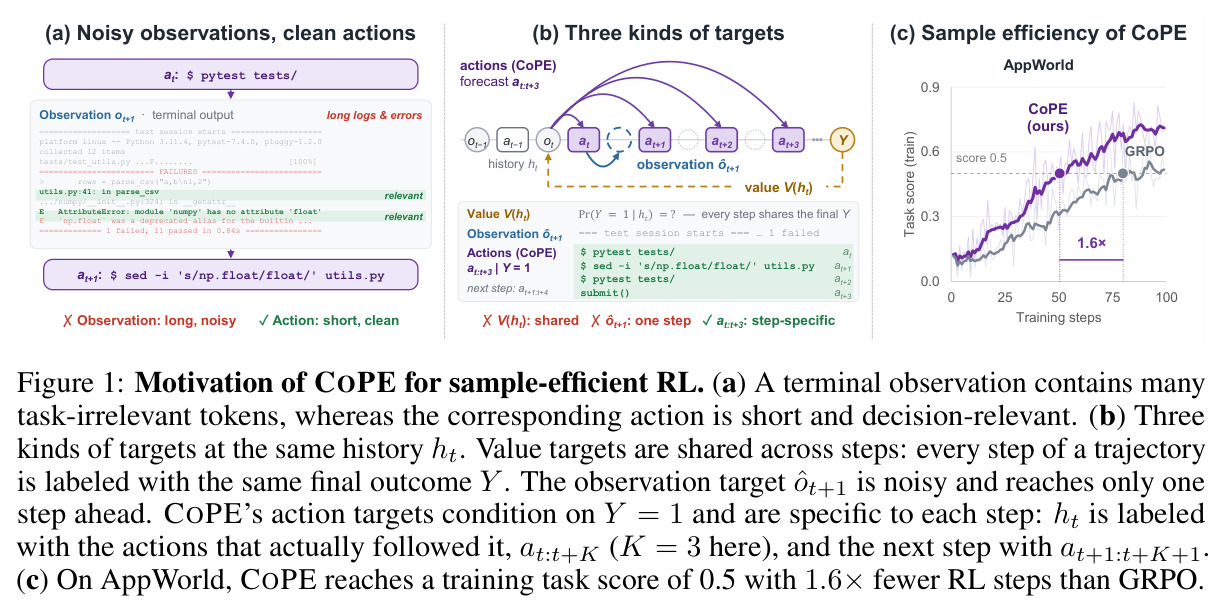
三联动机图。(a) 对比同一交互步的观测与动作:一段 pytest 终端输出冗长嘈杂、绝大多数 token 与任务无关,而对应动作 $at: $ pytest tests/ 短小且完全决策相关。(b) 在同一历史 $h_t$ 处并列三类训练目标:价值目标 $V(h_t)$ 使每步共享同一终局 $Y$,观察目标 $\hat{o}_{t+1}$ 嘈杂且只前瞻一步,COPE 的动作目标 $a_{t:t+3}$ 以 $Y=1$ 为条件、步级特异且覆盖多步(下一历史标注 $a_{t+1:t+4}$)。(c) AppWorld 训练曲线上 COPE 比 GRPO 少用 1.6× RL 步数达到训练分 0.5。
一张图讲清全文动机:为什么价值目标与观察目标难以构造好、多步动作目标好在哪,以及样本效率主张的直观证据,是理解论文定位的入口。
比较 $K=0$ 基线在加入「把无效动作替换为下一个有效动作」(replace_invalid on)过滤器前后的样本效率:开启过滤后得分曲线明显高于关闭状态,说明单一延迟的修正目标已能带来提升,但需要环境特定的无效性信号。
支撑讨论部分 Q2 的延迟视角论证:它是「延迟 0(−7.5/+2.0)→ 单一指定延迟(+5.0)→ 全延迟集成(+8.0)」这条证据链中的关键一环。
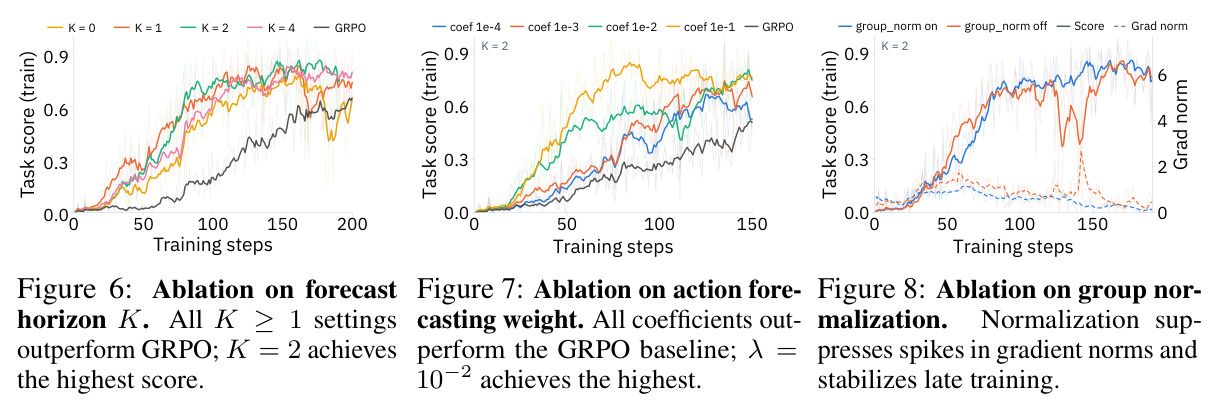
固定 $K=2$,把预测损失权重 $\lambda$ 从 $10^{-4}$ 扫到 $10^{-1}$:所有取值在整个训练过程中都稳定优于 GRPO;$\lambda$ 主要控制学习节奏——大值加速早期收益,$10^{-2}$ 与 $10^{-1}$ 收敛到相近的最高分,更小的值轨迹相似但延迟。
证明方法对权重超参数鲁棒(数量级跨度内全部有效),并给出全任务统一采用的 $\lambda=10^{-2}$。
对比预测损失的组归一化开关:关闭时随策略变强、成功轨迹数增多,预测梯度线性放大,导致梯度范数出现尖峰(Grad norm 曲线)并伴随奖励波动;开启 $1/\max(1,|S|)$ 平均后梯度范数平稳、训练后期更稳定。
解释公式 (5) 中组归一化因子的必要性,是方法在策略变强后仍能稳定训练的关键设计,对应方法的稳定性论证。
ScienceWorld 上不同动作监督变体的成功率及相对 GRPO 的增量:GRPO + success-filtered SFT 57.0(−7.5,直接模仿成功动作反而有害);$K=0$ 无过滤 66.5(+2.0);$K=0$ 加无效动作过滤 69.5(+5.0);COPE($K=2$)72.5(+8.0)。
以控制变量方式分离「成功过滤、延迟目标、多延迟集成」三个成分的贡献,是支撑延迟集成机制解释的核心证据。
用独立训练的 LoRA 预测器对 8 个候选动作按多视野预测集成重排($\log\pi$ 与 $K=2$ 个延迟预测的 $\eta$ 混合):GRPO 检查点 G150/G250 从 Top-1 的 56.5/64.5 提升到 $\eta=0.75$ 时的 70.0/72.0(Δ +7.5/+3.0),而对 COPE 模型本身同样的重排几乎无增益(73.5→73.0,Δ −0.5)。
为「预测通过隐式时间集成反哺行动」的协同进化机制提供最直接的经验证据:GRPO 缺的信息要靠外部预测器补,COPE 已内化。