前瞻性后见之明:基于预测—现实差距的自校准强化学习 Prospective Hindsight: Self-Calibrating Reinforcement Learning via Prediction-Reality Gaps
用行动前预测与事后结果的差距加权梯度,让校准能力随训练自动涌现
前置知识
GRPO(组相对策略优化)
GRPO 是一种省去价值网络的策略梯度方法:对同一查询采样一组 rollout,用组内奖励的均值和方差把回报归一化成相对优势 $A_i=(r_i-\mathrm{mean})/\mathrm{std}$,再据此更新策略。它广泛用于数学、代码等有可验证对错判定的 LLM 后训练场景。
本文把 PH 作为可插拔的加权层叠加在 GRPO 等“基础损失”之上,理解 GRPO 的组内归一化结构才能明白 PH 的重加权为何能保持底座方法内部结构不变。
在线蒸馏(OPD)与 SDPO
OPD 在学生行动之后,利用事后才可见的特权上下文(标准答案、下一步环境状态)构造一个“事后教师”的动作分布,再用 token 级 KL 散度把该分布蒸馏给学生。SDPO 是 Salesforce 提出的 OPD 具体实现,是本文单轮实验的基础损失。
OPD 是“特权事后信息”最典型的来源,也是 PH 展示最大增益的底座:多轮实验中 OPD 块的 Avg 从 54.0 提升到 69.3(+15.3),是三个底座方法中涨幅最大的。
校准与过自信
校准指模型的主观置信度与实际成功率一致:预测“90% 会成功”的样本应当真的约 90% 成功。过自信指任务失败却被高置信预测,危险在于智能体会沿错误轨迹一错到底、不触发兜底;欠自信则相反,明明会做却不敢确信。OFR(预测成功之中的失败率)是本文核心校准指标。
PH 的全部目标就是让校准作为优化的副产品自动出现;OF/US 两类失准单元格的含义以及“单轮过自信、多轮欠自信”的模式翻转,是理解实验结论的前提。
过程奖励模型(PRM)
PRM 不只给最终答案打分,而是逐步(per-step)评判智能体每个动作的好坏,常以 LLM 担任裁判实现。多轮任务中,下一步环境状态对裁判可见、对行动时刻的智能体不可见,这正是“特权信息”的来源,也决定了结果标签 $y_t$ 的随机性更高。
多轮实验用 LLM-PRM 作为事后评估器产生 $y_t$,PH 再用前瞻预测 $z_t$ 与 $y_t$ 的分歧构造 surprise 信号;因为 PRM 有随机性,多轮场景需要采 $M=3$ 个预测做多数投票。
特权信息学习(LUPI)
LUPI 框架研究训练时可用、决策时不可用的信息如何改进学习器(经典例子是 SVM+)。本文用全方差公式把结果方差分解为不可约的偶然噪声与非负的特权信息差距 $I^\star(s_t,a_t)=\mathrm{Var}(\mathbb{E}[y_t|s_t,a_t,c_t]\mid s_t,a_t)$,后者是任何只用行动时信息的预测器都无法消除的部分。
Proposition 1 把 prediction–reality gap 解释为 $I^\star$ 的逐 rollout 体现,这是全文的理论支点:surprise 大的样本恰是行动时信息最不足、事后标签最“无信息”的地方。
停止梯度(stop-gradient)
指在计算图中把某个量视为常数、不向其回传梯度。本文中 surprise 指示子 $\xi_t$ 以停止梯度方式进入损失 $\ell^{PH}_t=(1+\alpha\xi_t)\ell^{base}_t$,即它只调节各 rollout 的梯度放大倍数,本身不接收梯度、不被直接优化。
正因 $\xi_t$ 不接收梯度,前瞻预测器精度(PAcc)从约 30% 提升到约 80% 完全是共享参数策略优化的副产品,这是本文“校准免费涌现”这一核心卖点成立的机制基础。
研究动机
当今 LLM 智能体的 RL 训练信号几乎全部是“事后”的:GRPO 在观察到环境结果后用组内归一化分配信用;OPD/SDPO 类方法利用事后才可见的特权上下文(标准答案、下一状态)构造教师分布再蒸馏;过程奖励模型(PRM)逐步检视后续状态打分。作者把这一共同结构称为“后见之明陷阱”:所有学习信号都由行动之后的量计算得到,而智能体在行动时刻的前瞻信念——它预期能否成功——从不进入梯度,形式化地即 $\mathbb{E}[\nabla_\theta\ell^{base}\mid z_t,y_t]=\mathbb{E}[\nabla_\theta\ell^{base}\mid y_t]$,与 $z_t$ 无关。后果是结果相同的 rollout 得到相同更新:自信的成功和碰运气的成功被同等强化,能预见的失败和出乎意料的失败被同等惩罚。已有校准工作要么停留在推理时修补(置信度提示、温度缩放),要么在 RL 中加显式置信度目标(如 CaOPD),后者会与任务目标互相拉扯,造成能力—校准权衡。而在长视野智能体场景中,最致命的恰是“带着自信犯的错”:错误轨迹会持续恶化且不触发重试或人工兜底。
本文的目标是本文的目标是在完全不改动任何基础方法(GRPO、OPD 或两者组合)的 rollout 采样分布、优势结构与内部正则化的前提下,把智能体行动前的预测与事后验证器/PRM 结果之间的差距转化为一等公民的训练信号,从而在提升任务成绩的同时自动改善自我校准。具体拆成四个可检验的目标:(1) 训练后的智能体在预测自己成功时应当真的更容易成功,即预测成功率下的失败率 OFR 显著下降,且预测—现实的总体失配率(surprise 率)同步下降;(2) 校准改善不依赖任何额外的校准损失,而是作为优化的副产品出现,从而绕开已知的能力—校准权衡;(3) 前瞻预测器与策略共享参数、共同演化,随差距闭合重加权自动衰减,不需要为 surprise 权重另设调度;(4) 同一条原理和同一个超参数默认值($\alpha=1$)能跨单轮可验证任务、多轮个人助理任务以及不同模型规模(OLMo-3-7B-Instruct 到 GPT-OSS-20B)一致生效。
与已有工作不同的是,独特切入在于视角反转:此前所有工作把“预测与结果的差距”当作校准的诊断指标来测量,或在推理时修补;本文则把它当作梯度权重来消费。理论上,作者用全方差公式证明,给定行动时信息 $(s_t,a_t)$ 时结果的残余方差可分解为不可约的偶然噪声加上非负的特权信息差距 $I^\star(s_t,a_t)=\mathrm{Var}(\mathbb{E}[y_t|s_t,a_t,c_t]\mid s_t,a_t)$,把智能体 RL 纳入特权信息学习(LUPI)框架——surprise 大的 rollout 恰是行动时信息相对事后信息最不足、结果标签最无信息的地方,因此最值得放大梯度。工程上,前瞻预测器不做外挂头部,而是直接用不同提示词再询问同一个策略模型,二者共享参数、共同演化:随预测—现实差距收敛,重加权自动熄灭,形成自适应课程。这与 CaOPD 等显式校准损失路线形成本质区别:后者加第二目标、报告两目标互损;PH 让校准与能力共享同一个下降方向。
核心方法
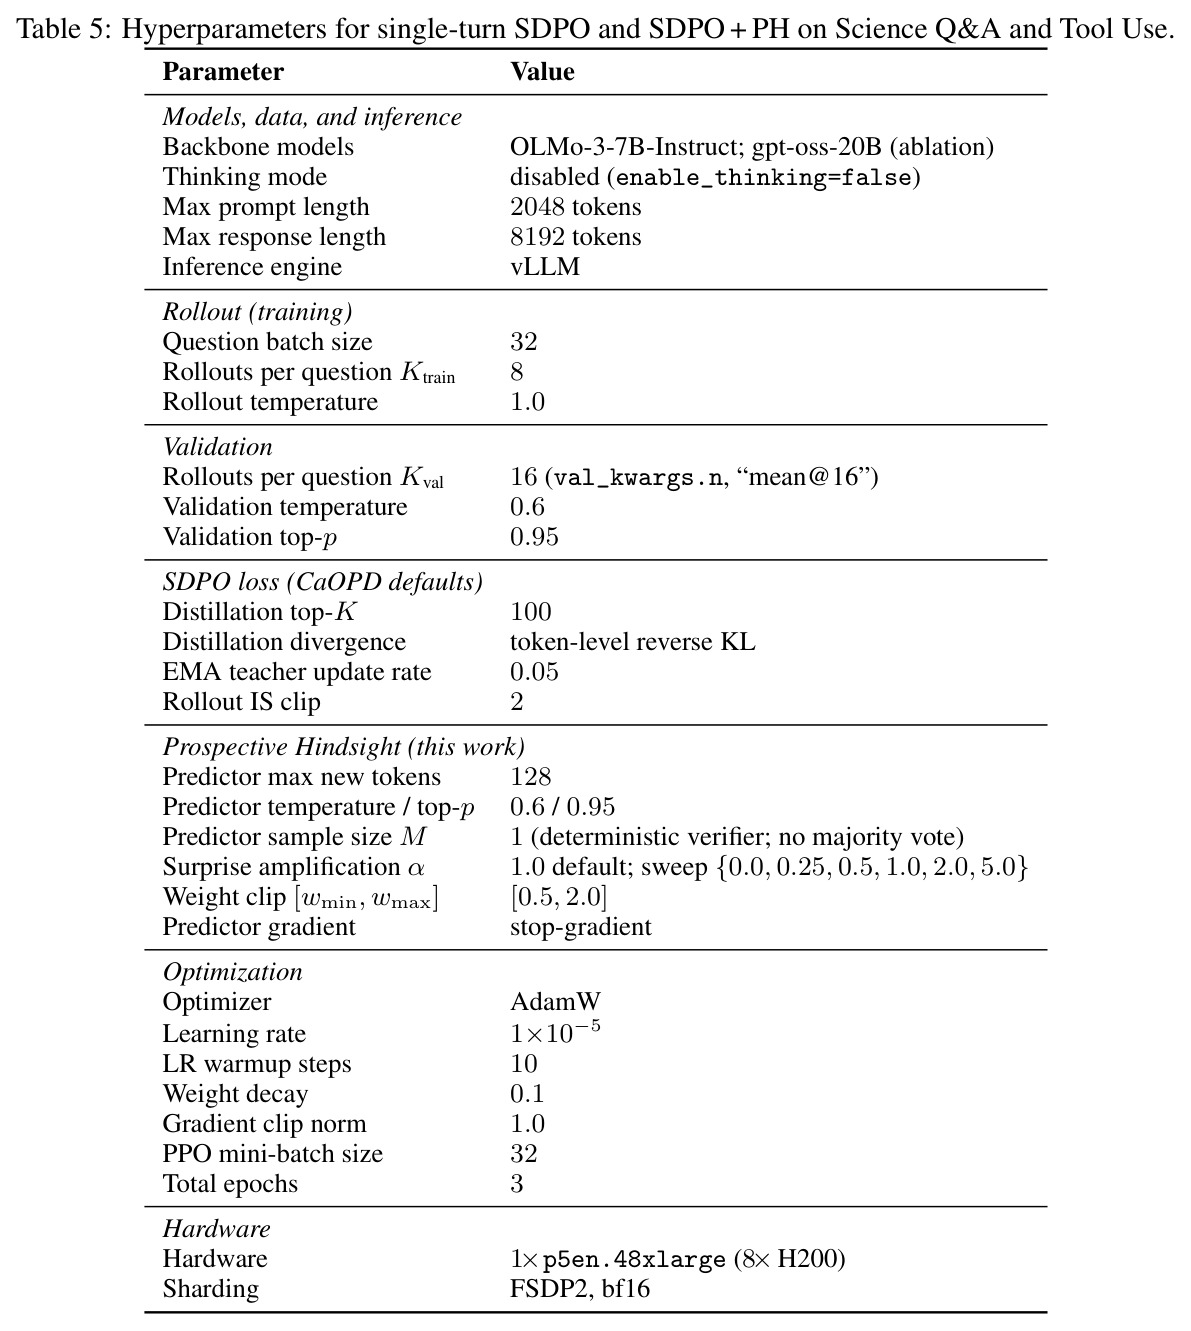
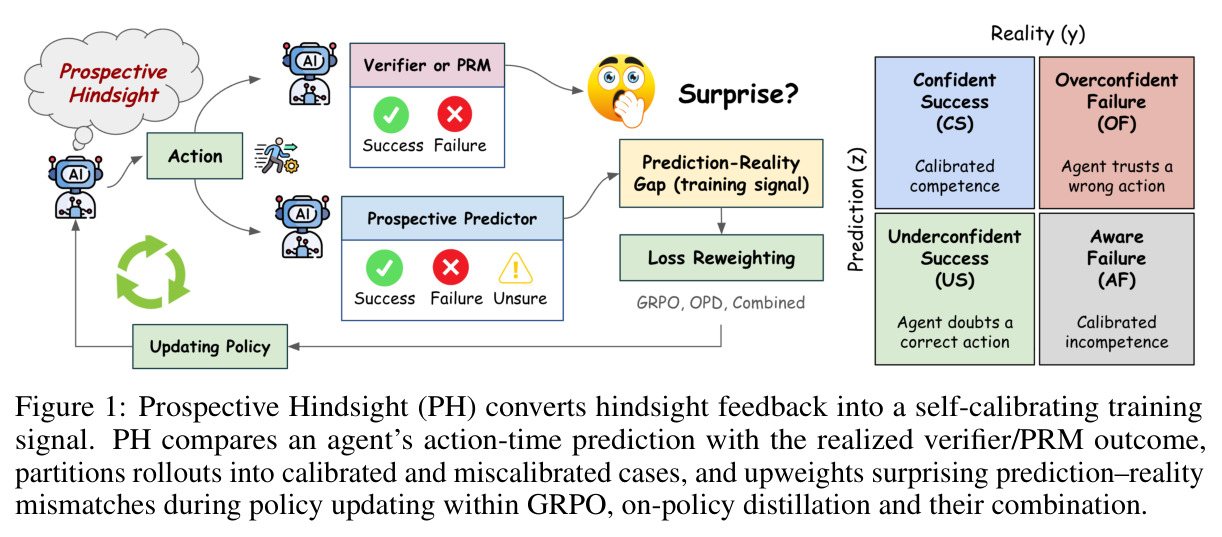
PH 的直觉:若 rollout 结果令智能体自己“吃惊”(预测与结果相反),说明其自我模型在那里最不准,该样本应获得更多梯度。第一步,在 rollout 打分前,用另一个提示模板重新询问同一个策略 $\pi_\theta$:“你认为 $a_t$ 最终会成功吗”,解析三元前瞻信念 $z_t\in\{-1,0,+1\}$;预测器只看 $(s_t,a_t)$ 不看特权上下文 $c_t$,单轮采 $M=1$、多轮随机 PRM 采 $M=3$ 个样本做多数投票。第二步,把 $z_t$ 与事后结果 $y_t=\mathbb{1}[r_t>0]$ 配对,得二值 surprise 指示子 $\xi_t=\mathbb{1}[(z_t,y_t)\in\{OF,US\}]$。第三步,以停止梯度一行改写基础损失:$\ell^{PH}_t=(1+\alpha\xi_t)\ell^{base}_t$。校准样本权重不变,“惊讶”样本梯度放大 $(1+\alpha)$ 倍,默认 $\alpha=1$;开销仅每步 $M$ 次前向。预测器与策略共享参数,权重随差距闭合自动衰减,无需另设调度。
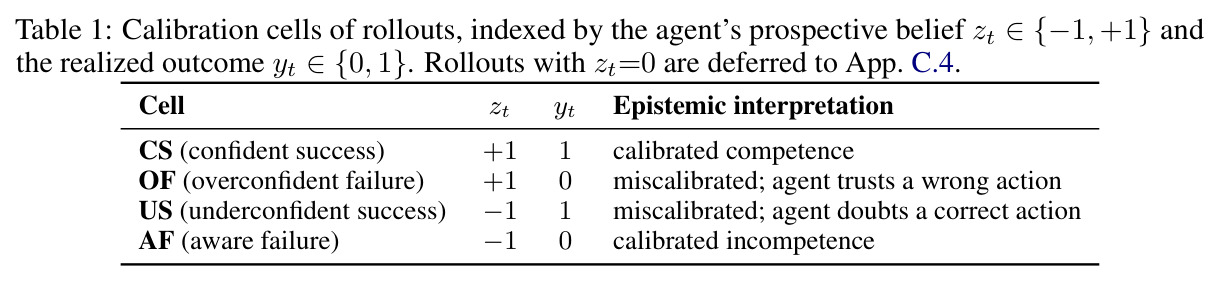
核心创新是“把校准信号从诊断变成驱动力”,与已有工作有三层区别。损失结构上,显式校准路线(如 CaOPD)给训练加第二目标并报告能力—校准互损;PH 不加任何校准损失,只用预测—现实分歧 $\xi_t$ 决定哪些基础梯度值得放大 $(1+\alpha)$ 倍,校准与能力共享同一下降方向。概念上,提出四格分类法:按 $(z_t,y_t)$ 把 rollout 划入 CS(自信成功)、OF(过自信失败)、US(欠自信成功)、AF(知情失败),对角格校准、非对格失准;OF 是自模型背书被拒动作(最危险),US 是未自我识别的隐藏能力。理论上,Proposition 1 把结果方差分解为偶然噪声加特权信息差距 $I^\star(s_t,a_t)\ge 0$,surprise 正是 $I^\star$ 的逐样本实现;残差恒等式 $R(\theta)=c(\theta)\mathcal{M}(\theta)$($\mathcal{M}=\mathbb{E}[\xi_t]$ 为失准率)说明每个 PH 梯度步要么压低 $\mathcal{M}$、要么压低 $c$,校准作为优化副产品涌现。
方法步骤详情
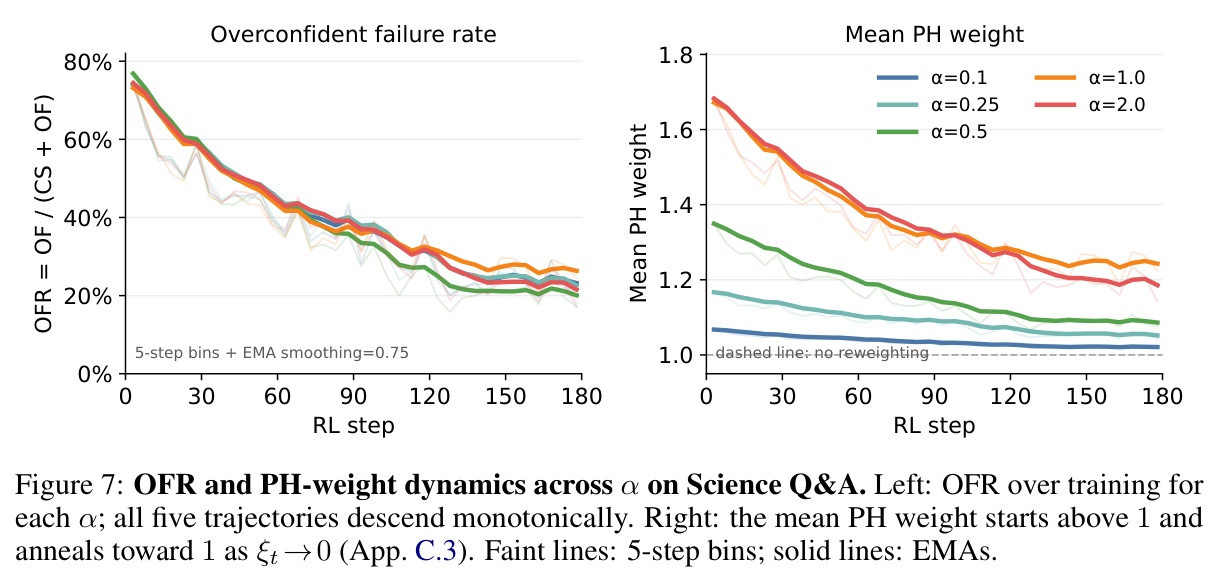
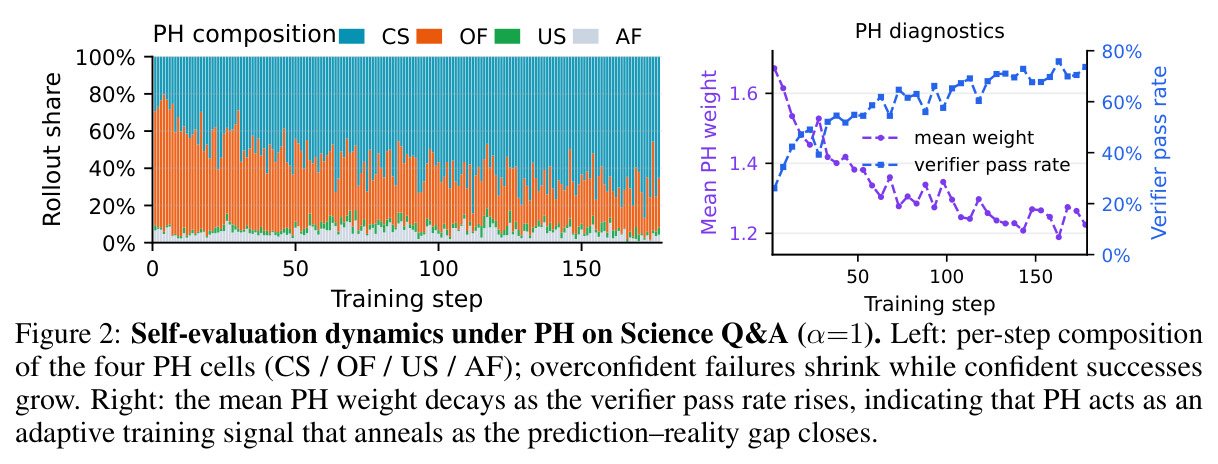
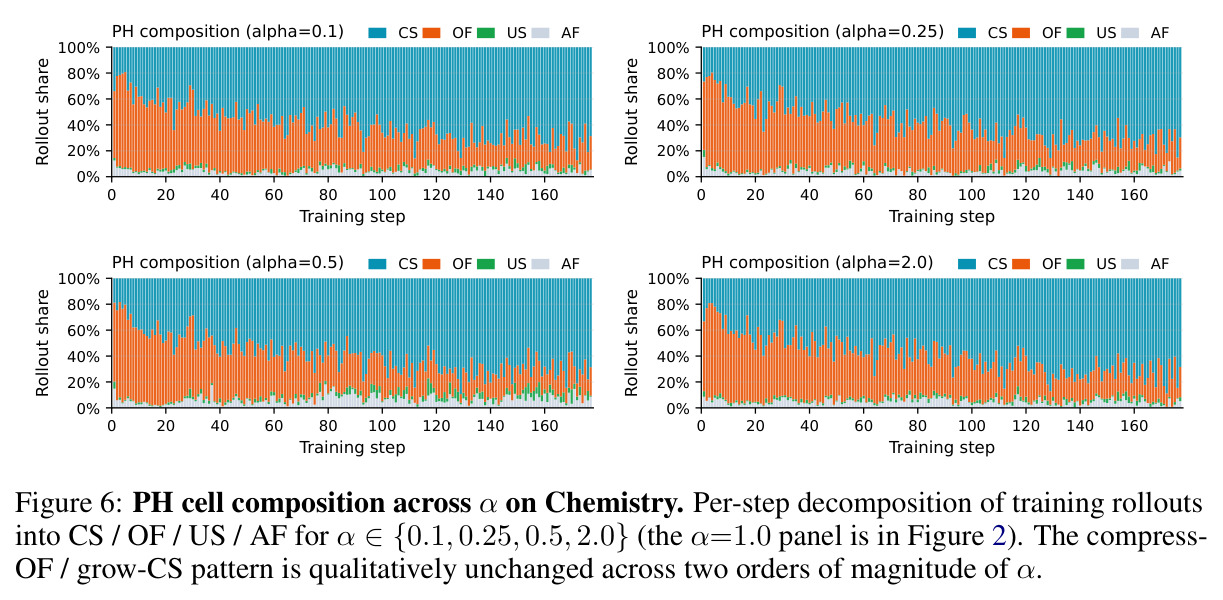
分四步(附录 Algorithm 1)。第一步,采样动作:策略 $\pi_\theta$ 在 $s_t$ 生成 $a_t$,环境返回 $r_t=R(s_t,a_t,c_t)$;$c_t$ 为评估器可见、行动时刻不可见的特权上下文(单轮为标准答案,多轮为下状态)。第二步,前瞻自评:打分前用只含 $(s_t,a_t)$ 的提示让同一模型预测动作成败得 $z_t\in\{-1,0,+1\}$;单轮取 $M=1$,多轮取 $M=3$ 投票 $z_t=\mathrm{maj}(z_t^{(1..M)})$,$z_t=0$ 作中性类。第三步,重加权:$\xi_t=\mathbb{1}[(z_t,y_t)\in\{OF,US\}]$(停止梯度),损失变为 $\ell^{PH}_t=(1+\alpha\xi_t)\ell^{base}_t$,超参 $\alpha\ge 0$ 默认 1。第四步,联合更新与自熄灭:$p^{eval}_\theta$ 与策略共享参数,更新同时改变动作分布与前瞻信念;Figure 2 显示 OF 单调收缩、CS 增长,平均权重随通过率上升而衰减,形成数据自控的自适应课程。
技术新颖性
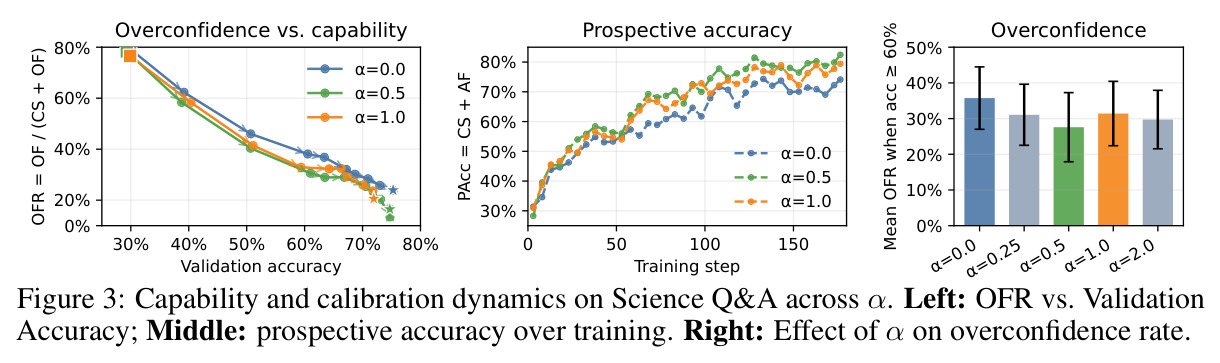
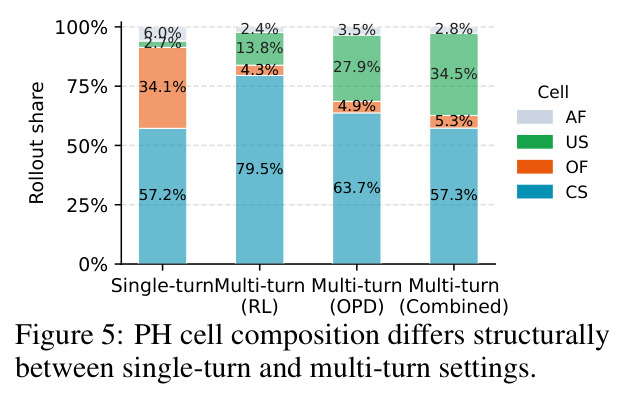
新颖性在四个层面。理论上,首次把后见之明陷阱形式化为梯度不变性 $\mathbb{E}[\nabla_\theta\ell^{base}|z_t,y_t]=\mathbb{E}[\nabla_\theta\ell^{base}|y_t]$,经全方差公式连接 LUPI 框架,给出特权信息差距 $I^\star$ 这一可解释量。方法上,PH 是“一行改动”级即插即用原则,保持底座方法全部内部结构,同一 $\alpha=1$ 无需重调即跨两类任务、三种底座、两个规模(7B 到 20B)迁移。机制上,预测器不做参数外挂而是提示复用同一策略,二者共同演化——$\xi_t$ 停止梯度使预测器收不到直接梯度,前瞻精度 PAcc 却从约 30% 升到约 80%(基线约 73%),证明校准是共享参数通道上的优化副产品。实证上,单轮与多轮的主导失准模式结构性翻转——单轮 OF 主导(34.1%,US 仅 2.7%),多轮 US 主导且递增(RL 13.8% < OPD 27.9% < Combined 34.5%)——同一更新律治愈两种模式,说明被放大的不是特定失败类型,而是预测—现实分歧本身。
实验结果
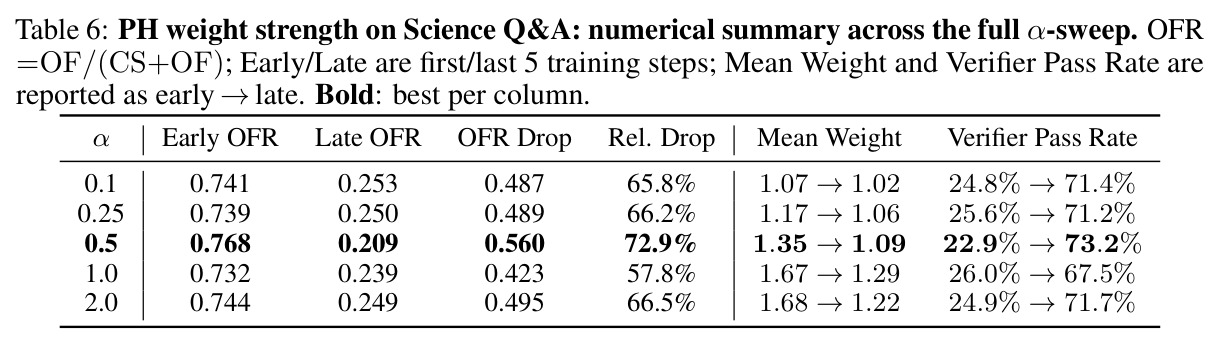
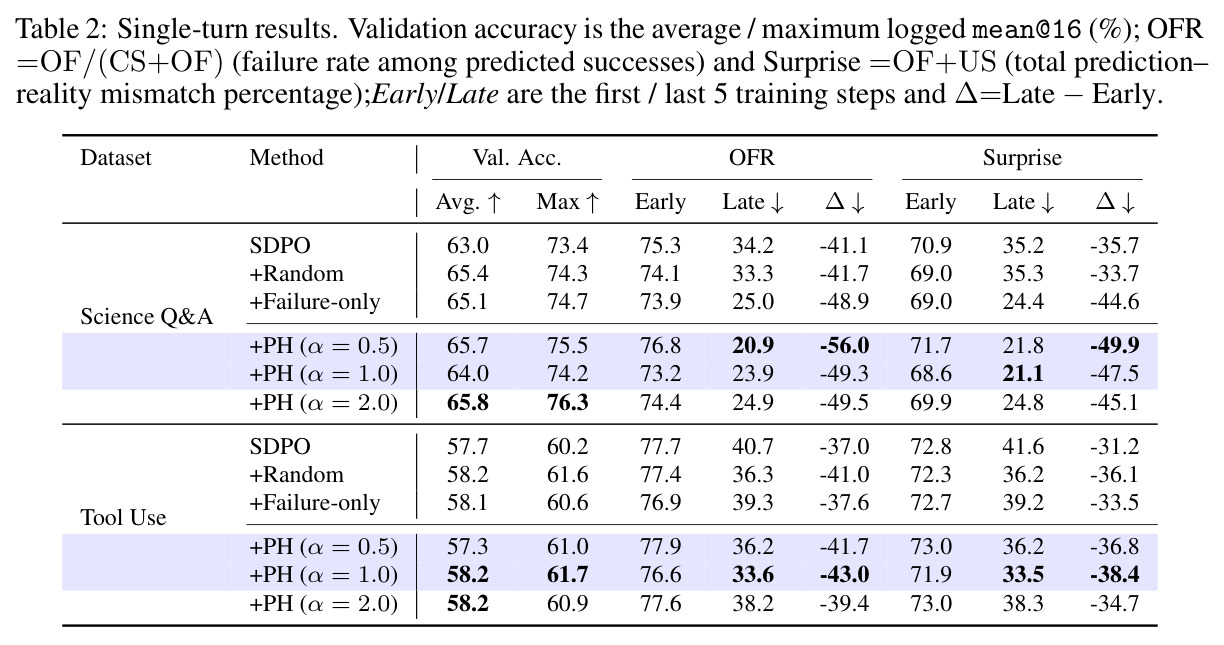
单轮(Table 2):Science Q&A 精度均值 63.0%→65.7%,后期 OFR 34.2%→20.9%;Tool Use 上 $\alpha=1.0$ 同时最佳(58.2%/61.7%,OFR 33.6% 对 40.7%)。对照显示增益来自“选择”而非额外梯度:Random Reweight 仅把 OFR 降到 33.3%;Failure-only 到 25.0% 但 surprise 落后(24.4% 对 21.8%)。多轮(Table 3):RL 块 GRPO 68.6→75.8,OFR 5.3%→3.1%,前瞻精度 83.5%→87.8%;OPD 块增益最大,54.0→69.3(+15.3),OFR 15.9%→2.6%;Combined 块 61.2→66.5。增益还迁移到 GPT-OSS-20B:OFR 11.5%→9.1%。Figure 3 显示 PAcc 从约 30% 升至约 80%;Figure 5 证实单轮 OF 主导、多轮 US 主导的模式翻转。注意 $\alpha=2$ 时 OFR 最低(2.5%)但预测器塌缩为常数 $z_t=-1$。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 单轮 Science Q&A(可验证问答,SDPO 基础) | 验证精度 mean@16 均值 / 后期 OFR | SDPO+PH(α=0.5):65.7% / 20.9% | SDPO:63.0% / 34.2% | 精度 +2.7 个百分点,OFR 下降 13.3 个百分点 |
| 单轮 Tool Use(可验证工具调用,SDPO 基础) | 验证精度 mean@16(均值/最高)/ 后期 OFR | SDPO+PH(α=1.0):58.2% / 61.7% / 33.6% | SDPO:57.7% / 60.2% / 40.7% | 精度 +0.5/+1.5 个百分点,OFR 下降 7.1 个百分点 |
| 多轮个人助理(OpenClaw-RL,GRPO 基础,GPT-4.1 模拟器) | 个性化评估分 Avg / Best / OFR / 前瞻精度 | RL+PH(α=1.0):75.8 / 82.9 / 3.1% / 87.8% | GRPO:68.6 / 77.7 / 5.3% / 83.5% | Avg +7.2、Best +5.2、OFR -2.2 个百分点、PAcc +4.3 个百分点 |
| 多轮个人助理(OpenClaw-RL,OPD/SDPO 基础) | 个性化评估分 Avg / OFR / 前瞻精度 | OPD+PH(α=1.0):69.3 / 2.6% / 81.9%(α=0.5 时 OFR 1.5%、PAcc 86.3%) | SDPO:54.0 / 15.9% / 62.8% | Avg +15.3(最大单块增益)、OFR 最多下降 14.4 个百分点、PAcc 最高 +23.5 个百分点 |
| 多轮个人助理(OpenClaw-RL,RL+OPD Combined 基础) | 个性化评估分 Avg | Combined+PH(α=0.5):66.5 | RL+OPD:61.2 | +5.3(三块中增益最小,与其 US 份额最高 34.5% 形成反差) |
局限与改进
作者承认的局限:评估限于二值验证器与逐步 PRM,尚未覆盖软件工程、终端、GUI 等更长视野任务;前瞻预测的输出解析依赖 \boxed{} 格式提示,多轮随机 PRM 需 $M=3$ 采样投票,带来每步 $M$ 次前向开销;校准分析被明确定位为“动机性”而非逐点保证,恒等式 $R(\theta)=c(\theta)\mathcal{M}(\theta)$ 的解释只在 $c(\theta)$ 远离零的训练窗口内有效。我的补充观察:其一,$\alpha=2.0$ 时 RL 块预测器塌缩为近似常数 $z_t=-1$,OFR 降到 2.5% 但前瞻精度停在 84.0%,说明阈值型校准指标可被退化行为钻空子,须与 PAcc、surprise 率联合解读;其二,单轮 Tool Use 的能力增益很小(均值仅 +0.5 个点),主要收益在校准侧;其三,Combined 块 US 份额最高(34.5%)但 PH 增益反而最小(+3.9~5.3),作者只称之为“部分例外”而未给出机制解释;其四,$z_t$ 只在训练时使用,其部署时的推理价值未被探索;其五,头条数字为 3 个种子聚合,正文未报告置信区间。
独立分析的弱点
第一,surprise 是二值阈值,丢弃了 $z_t$ 与 $y_t$ “差多远”的信息,与连续最优预测器 $f^\star=\mathbb{E}[y_t|s_t,a_t]$ 不匹配;可让权重取软值(如 $|f_\theta-y_t|$)平滑聚焦盲点。第二,$\alpha$ 是全局常数,而四格语义重要性不对称——OF 远比 US 危险,安全关键场景更应压 OF;可差异化设置 $\alpha_{OF}>\alpha_{US}$ 或随阶段调度。第三,$\alpha=2.0$ 时预测器塌缩为常数输出,暴露自评估与策略共享参数的内在风险:策略压力会拖垮自模型;可引入轻量正则或 EMA 影子副本稳定预测器。第四,$z_t=0$(诚实不确定)被当中性类忽略,浪费了“主动弃权”这一最有价值的校准行为;可把弃权率纳入优化,在高 $I^\star$ 状态奖励弃权。第五,“现实”完全信任验证器/PRM,其噪声直接污染 surprise(多轮需 $M=3$ 投票即佐证);应对 $y_t$ 做不确定性建模。第六,Tool Use 能力增益微弱提示:底座接近任务上限时,PH 的边际能力收益有限。
未来方向
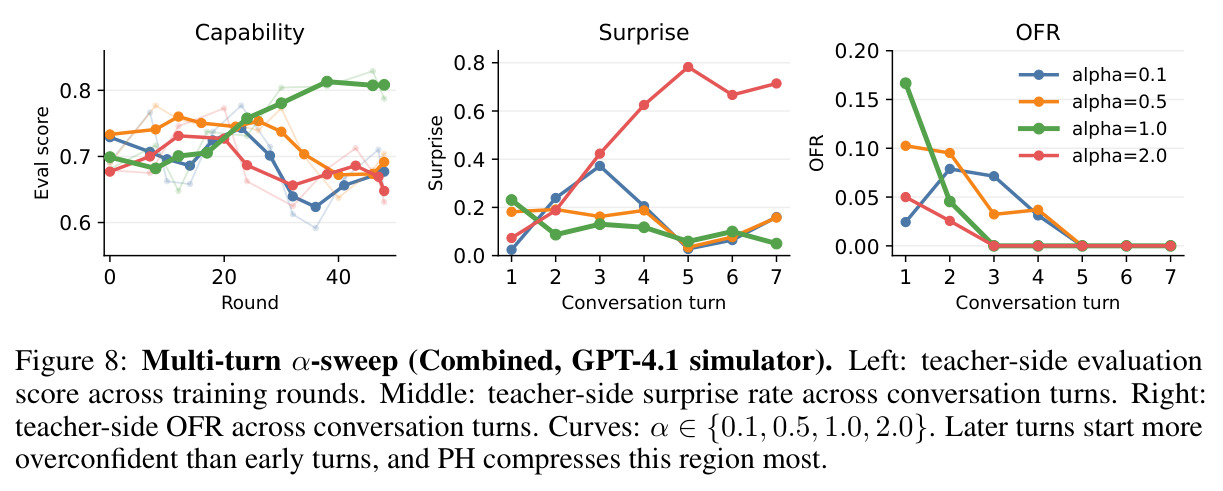
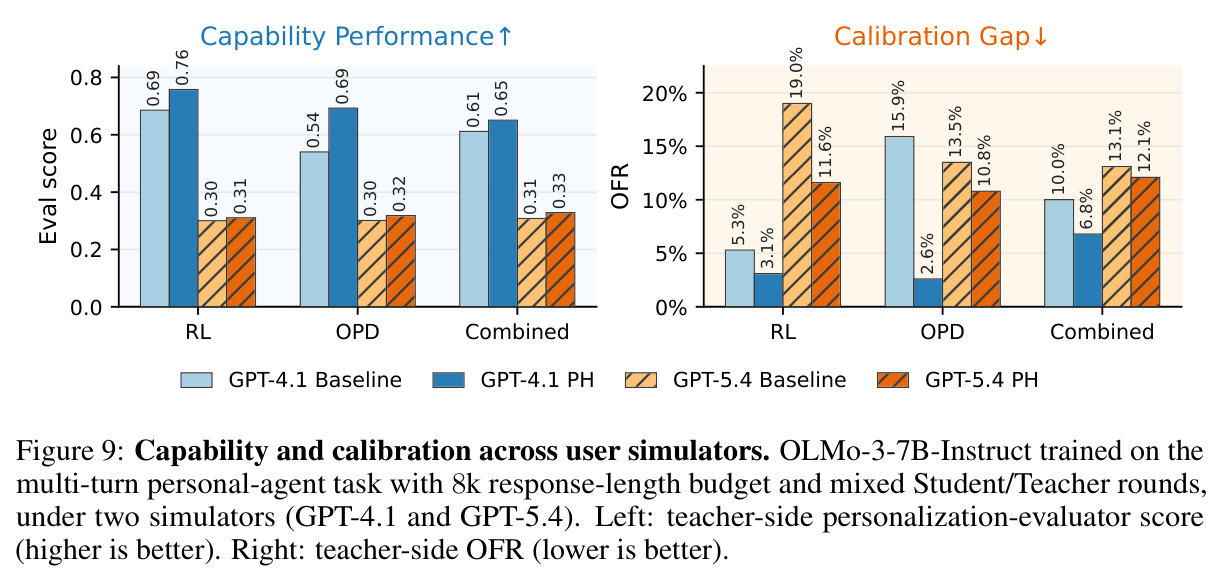
作者提出的方向:把 PH 从二值验证器与逐步 PRM 推广到软件工程、终端、GUI 与科研智能体等更长视野任务;接入更多基础方法。基于成果可延伸:(1) 推理时利用 $z_t$——前瞻预测器已相当校准(PAcc 最高 87.8%),可让低置信动作触发重试、回退或人工请求,把训练时信号变成部署时风险控制;(2) 把 $\xi_t$ 推广到连续 surprise,探索与 $I^\star$ 显式估计的连接,例如用事后教师与行动时学生的 KL 差作经验代理;(3) 单轮/多轮失准模式翻转提示可设计“模式感知”调度,在不同阶段差异化放大 OF/US,并解释 Combined 块为何例外;(4) 与过程级信用分配结合,逐步前瞻预测有望定位轨迹中最早出现分歧的一步;(5) 刻画 $R(\theta)=c(\theta)\mathcal{M}(\theta)$ 两通道的收敛速度,把“动机性分析”升级为校准改善的首个正式保证;(6) Figure 9 显示换用 GPT-5.4 模拟器仅保留定性一致,可在真实用户数据上复检定量结论。
复现评估
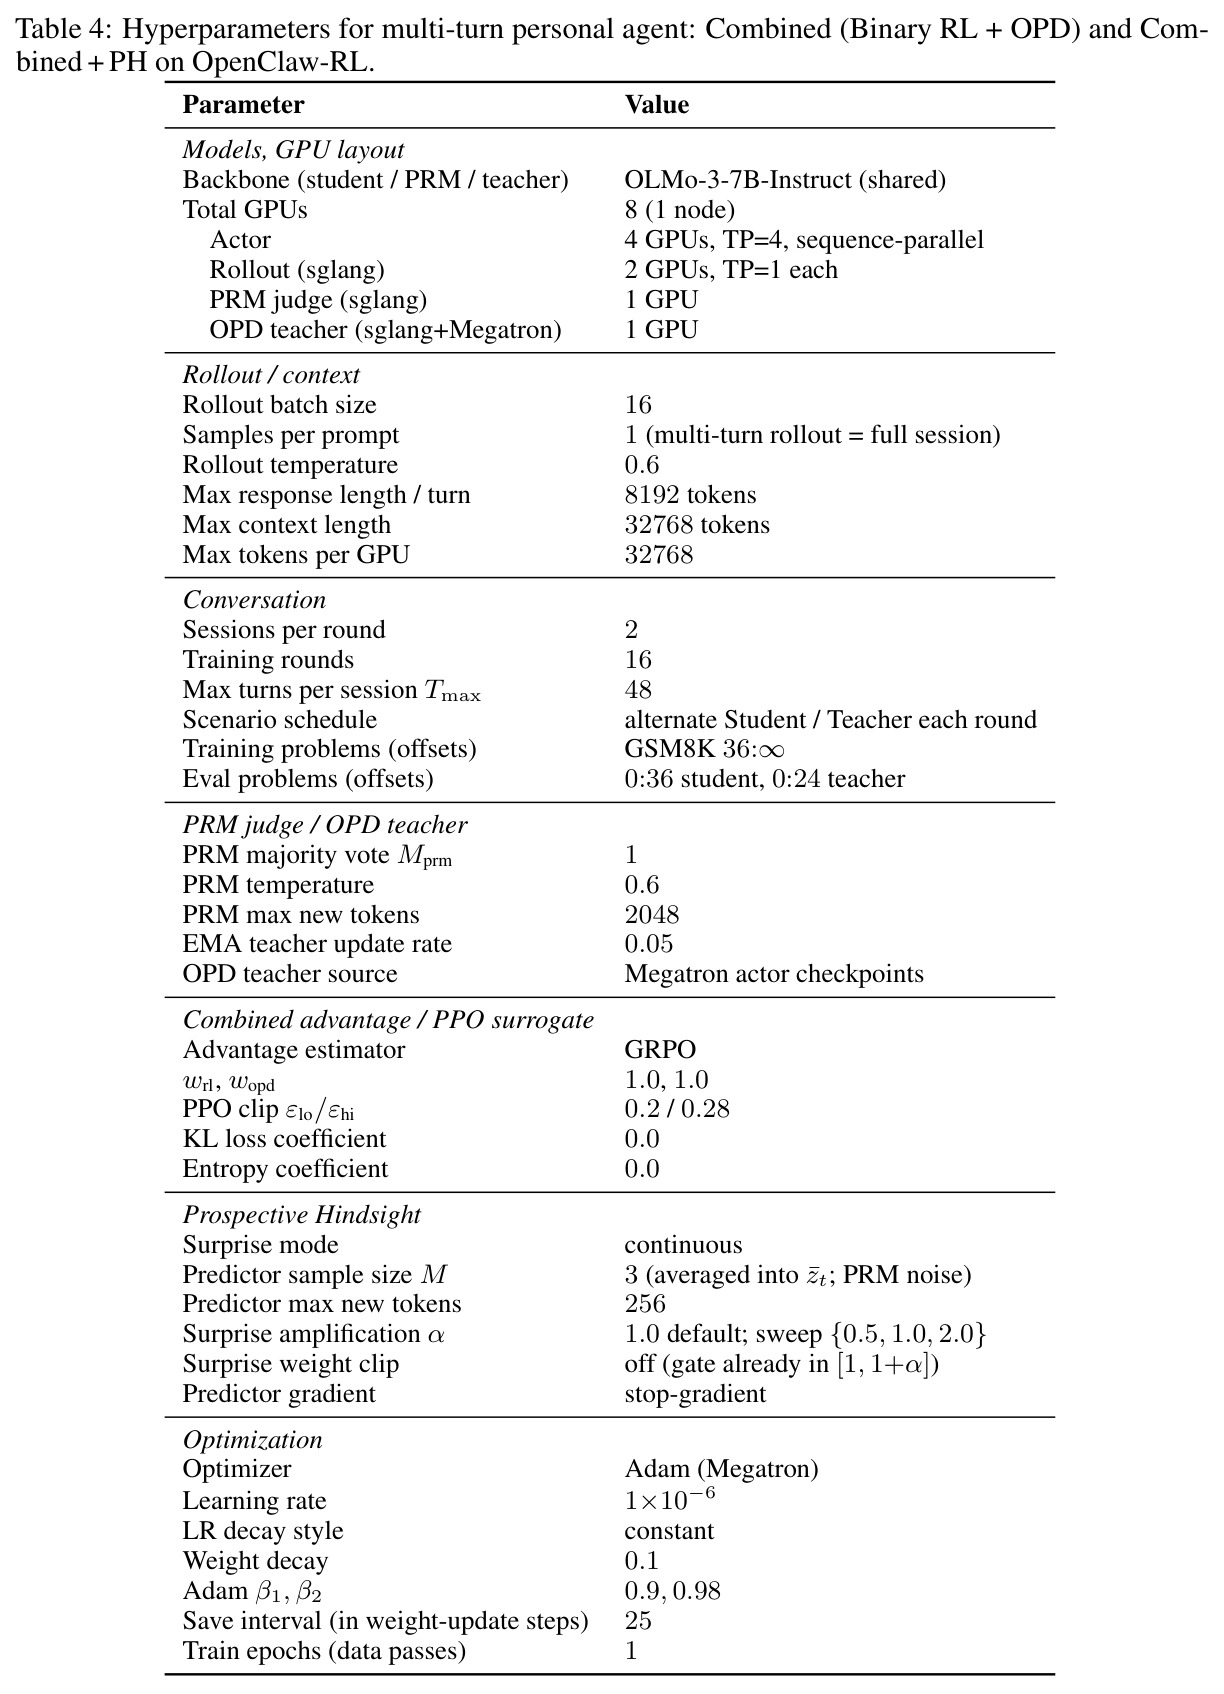
复现评估:论文为 Preprint,正文未给出开源代码链接,算法(Algorithm 1)、完整提示模板与超参数表放在附录 C/D/F,需等待附录文件确认完备性。有利因素很多:方法本身只有 $\alpha$ 一个超参数且默认 1,实现自由度极小;主实验用 OLMo-3-7B-Instruct 同一模型兼任策略与自评器(只换提示、共享参数),无需训练额外网络;训练时开销仅为每 rollout 步 $M$ 次额外前向(单轮 $M=1$、多轮 $M=3$),远小于训练一个独立奖励模型;数据集 SCIENCE Q&A 与 TOOL USE 均为公开基准,OpenClaw-RL 个人助理任务开源,且 GRPO/OPD/Combined 三种底座都在 OpenClaw-RL 统一栈中实现。门槛与成本:多轮实验依赖 OpenClaw-RL 异步训练栈加 GPT-4.1 用户模拟器,API 费用与基础设施是主要障碍,换成 GPT-5.4 模拟器还需额外 API 预算;单轮部分在数张 A100/H100 上应可复现(3 个种子聚合),整体难度中等偏上,多轮部分复现成本明显高于单轮。
论文图表