OpenGCUA:面向通用计算机使用的全开源技术栈 OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use
开源GCUA全栈:代码执行与决策移交使8个前沿模型OSWorld-v2均分提升19.6
前置知识
计算机使用代理(CUA)
让大模型像人一样操作电脑完成任务的智能体:观察屏幕截图,输出鼠标点击、拖拽、滚动、打键等动作,循环执行直到任务完成。传统 CUA 只通过 GUI 交互、每步一个动作;本文将其推广为还可通过 shell、辅助功能树、API 等程序化接口工作的通用计算机使用代理(GCUA)。
全文的评测对象和改进基线都是 CUA,理解其“截图-动作”循环,才能看出 GCUA 到底放宽了哪些约束、放宽后收益来自哪里。
辅助功能树(Accessibility Tree, AX 树)
操作系统为无障碍访问维护的界面结构化表示,记录每个 UI 元素的角色、名称、值和层级。程序可直接读取元素或对其执行动作,无需屏幕坐标,不需要把窗口带到前台,也不会移动用户的鼠标。macOS、Windows 与浏览器 DOM/ARIA 均提供此类接口。
AX 树是 GCUA 四大接口之一;真机上“不打扰用户”的后台操作,以及让程序直接读到“按钮是否可用”等条件判断,都依赖它。
执行框架(Harness)
包裹模型的工程外壳:负责拼接上下文、解析模型输出、在目标机器上执行动作、回传观测并管理历史。同一模型配不同 harness 成绩可差十几分。论文的 OSWorld-v2 harness 在 Python 运行时中提供 PyAutoGUI 与 bash();真机 harness 则采用五层架构。
本文核心论点就是“框架该管什么、模型该管什么”:harness-to-model 决策移交正是在系统性地改写 harness 里的固定规则。
OSWorld-v2 与 partial score
OSWorld-v2 是在真实操作系统环境中执行计算机任务的基准:任务在受控机器里运行,由检查器核对最终状态打分。v2.1 的离线子集共 82 个任务(另 26 个需联网的任务被排除)。partial score 按检查项给部分分(0-100),binary success 则要求全部检查项通过。
所有主实验数字(+19.6 分、GPT-6 Astra 75.7 等)都来自该基准的这两个指标,不理解打分方式就无法正确比较各配置。
提示缓存与缓存命中率(Cache hit)
API 对重复出现的输入前缀按折扣计费并可加速推理:新请求与旧请求共享的前缀部分直接从缓存读取。智能体多轮对话天然适合缓存,但一旦修改历史中段(例如删除一张旧截图),其后所有前缀的缓存都会失效,需要重新计费计算。
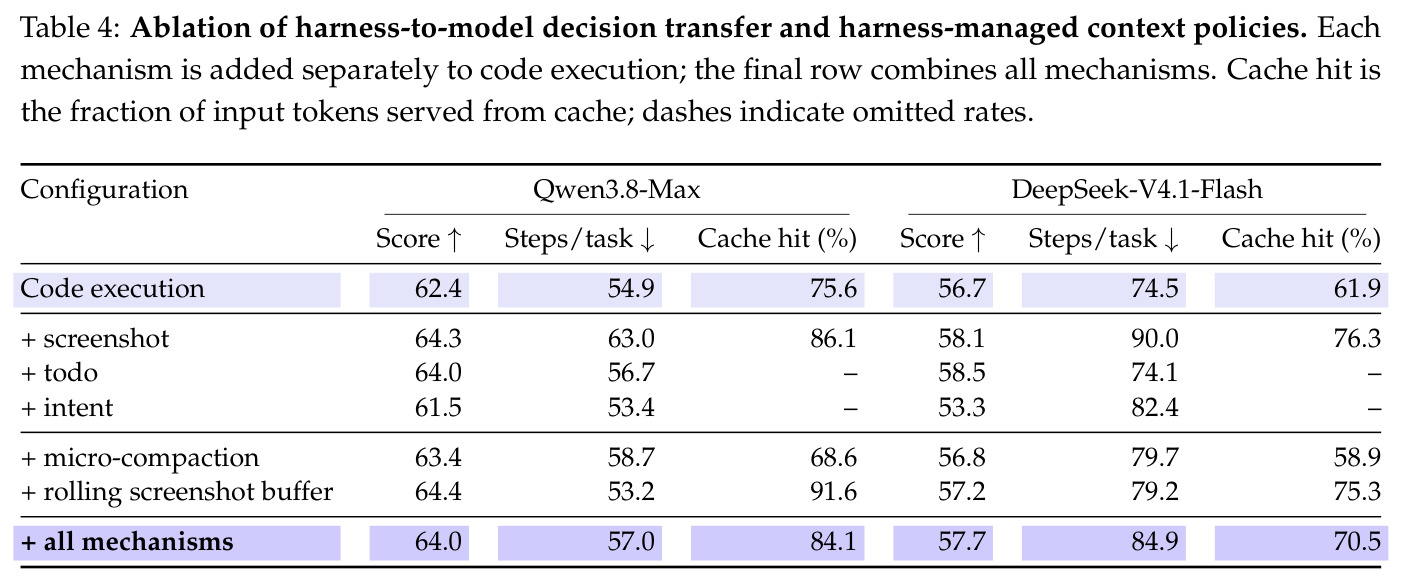
按需截图、滚动截图缓冲等机制的价值主要用缓存命中率衡量(分别 +10.5/+14.4 和 +16.0/+13.4 个百分点),这是本文效率分析的关键指标。
批量动作(Batched Actions)
一次模型调用输出一串动作(如点击 A、输入 B、按回车),由 harness 依序执行,以减少往返次数。但整个序列在生成时就已固定:模型必须在看到第一个动作结果之前决定后续所有动作,无法根据中间结果调整。作者称之为“没有控制流的程序”。
批量动作是本文所有对比的基线,也是理解代码执行价值(循环、条件、断言在运行时才决定)所必需的对照物。
研究动机
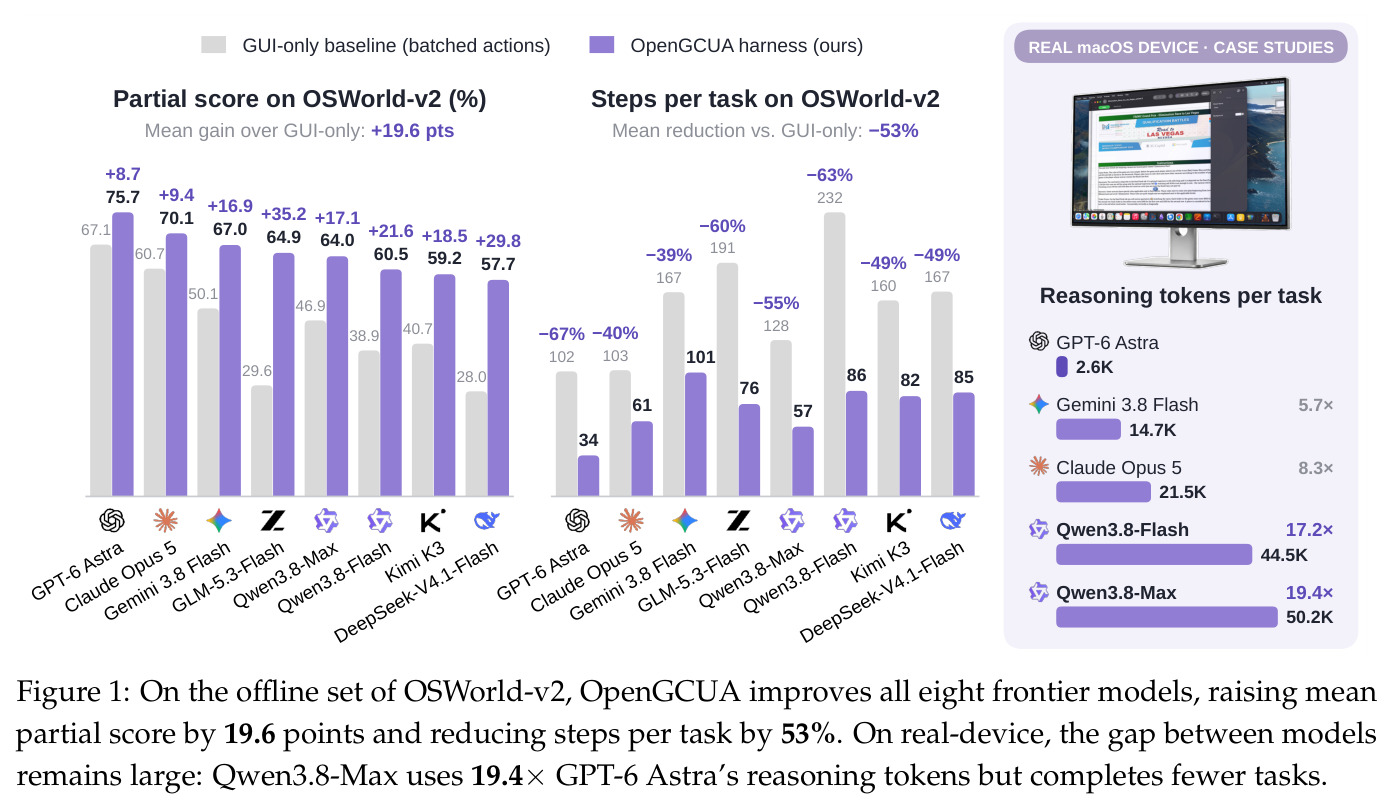
计算机使用(computer use)正从“只会点 GUI”走向“用一切手段完成任务”,但研究生态严重割裂。一方面,GPT-6 Astra 把计算机使用作为核心能力主打,OpenAI 官方指南已开始推荐模型编写并运行短程序(如 PyAutoGUI、Playwright)来代替逐次鼠标键盘操作,并报告其完成 OSWorld 2.0 任务比上代快约 47%;但其模型权重、完整提示词、真实设备执行框架、设备控制 SDK 与执行轨迹全部闭源,社区无法复现这些系统行为、无法比较替代设计。另一方面,学术文献大多仍把 CUA 当作 GUI-only 智能体来研究:每步只看一张截图、只做一个鼠标键盘动作。在 OSWorld-v2 离线集上用这种方式跑八个前沿模型,每任务平均要 100-232 步,最弱的 DeepSeek-V4.1-Flash 均分只有 28.0。此外基准环境为任务预初始化、机器由智能体独占,无法覆盖用户真实电脑上人机共享控制、窗口互相遮挡、请求中途变化等挑战。
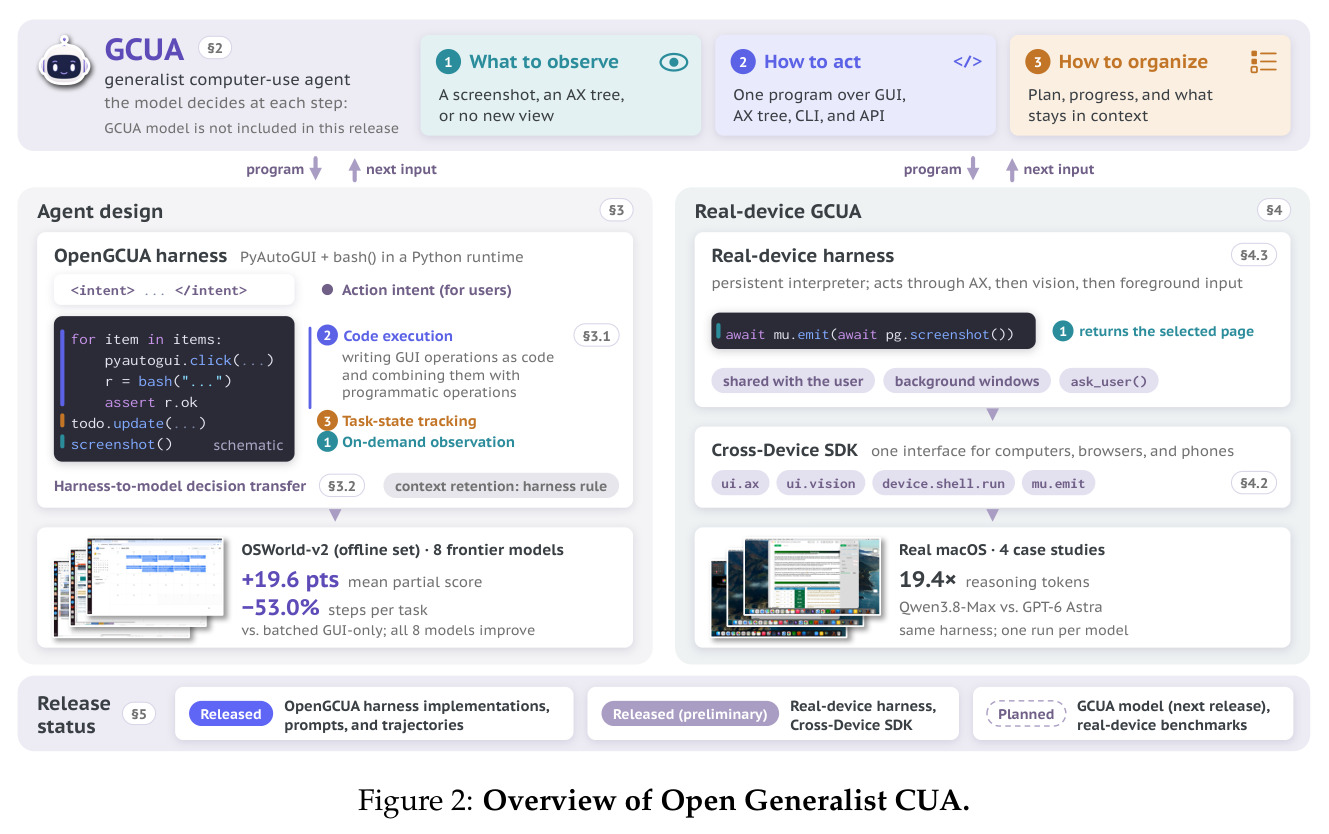
本文的目标是本文的目标是定义并开放“通用计算机使用代理”(GCUA)的完整技术栈。具体包括四件事:(1) 给出 GCUA 的可操作定义——模型在每一步自主决定“观察什么、如何行动、如何组织工作”,并证明 GUI 智能体、CLI 智能体、多智能体混合、GUI+CLI 混合都是它的受限特例;(2) 不训练新模型,而是用提示词和执行框架验证两项核心设计——代码执行与 harness 到模型的决策移交——能否让现有前沿模型普遍受益;(3) 在 OSWorld-v2 的 82 任务离线子集上对 Claude Opus 5、GPT-6 Astra、Gemini 3.8 Flash 等 8 个模型做系统评测,并开源全部实现、提示词与评测轨迹;(4) 发布初步版本的真实 macOS 设备 harness 与跨设备 SDK,报告 4 个真实任务上的初步结果与案例研究。
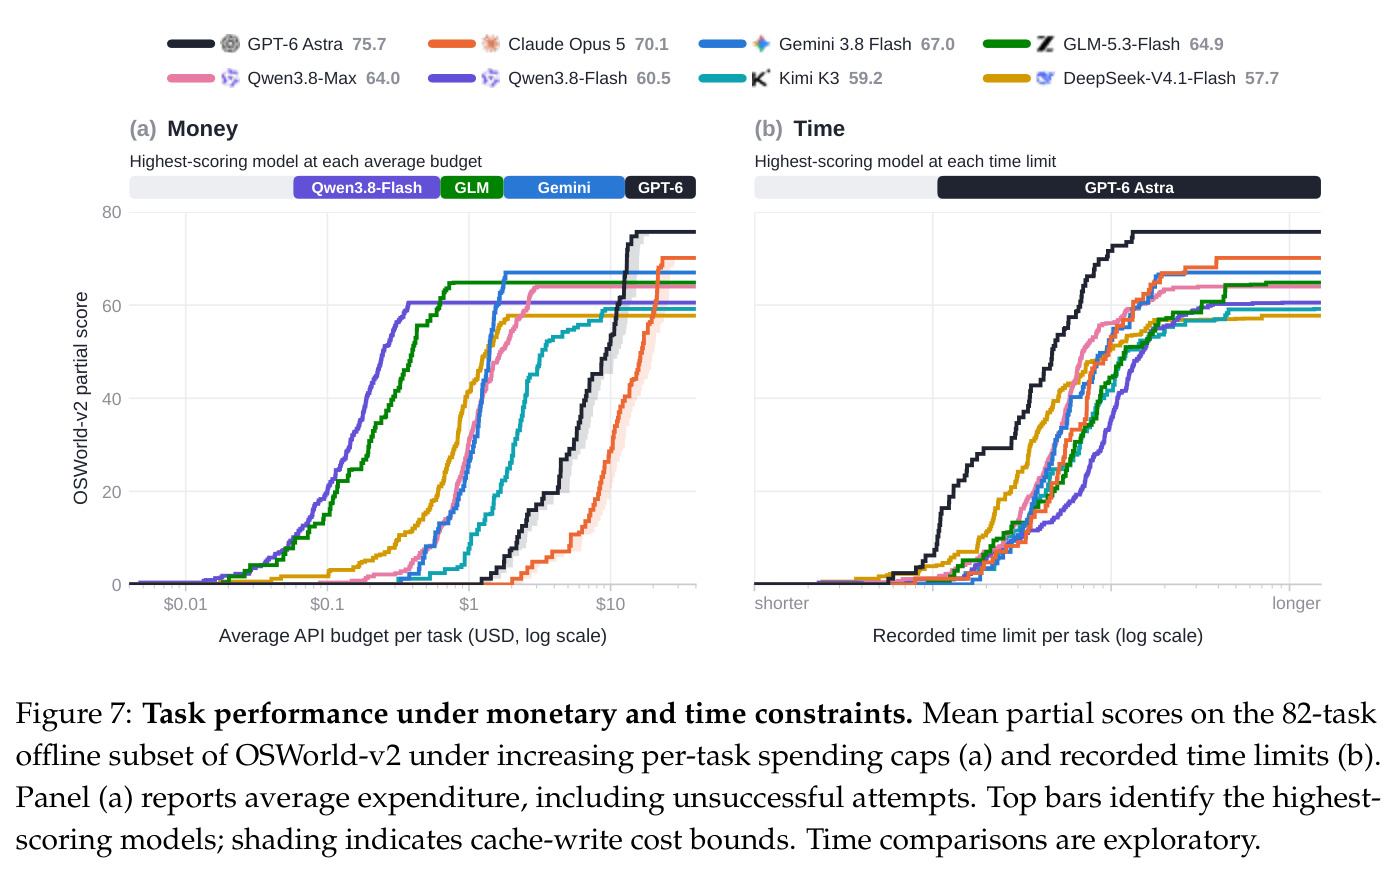
与已有工作不同的是,本文的独特切入角度有三点。第一,定义视角不同:此前的 Agents' Last Exam 按五层组件(大脑、眼睛、身体、手、脚)划分智能体,但组件齐全不代表会用——一个智能体可能点十几屏去做一条 shell 命令能做的事。本文改为按“每一步谁做决策”来定义 GCUA(公式 1 中的三元组 $q_t, p_t, m_{t+1}$),使不同智能体家族可在同一形式化下比较,并清晰呈现“逐步把约束还给模型”的研究路线。第二,把执行效率当一等公民:除成功率外,系统报告每任务步数、输出 token、推理 token 和美元成本,并给出预算-性能与时间-性能曲线,指出低分模型在紧预算下可能才是最优选择。第三,不止步于基准分数:提出 harness-to-model 决策移交这一新概念,把“何时截图、如何记录任务状态”等原本写死在框架规则里的决策交给模型,并直面真实设备与基准环境的差异。
核心方法
直觉:现代大模型本身就会写代码,那么操作计算机的最高效形式,就是把 GUI 动作、shell 命令、AX 树操作和 API 调用写进同一段 Python 程序,让循环、条件、断言在一次模型调用内完成原本十几次往返的工作。形式化上,设 $s_t$ 为第 $t$ 步电脑状态、$m_t$ 为工作状态、$o_t$ 为上一步观测,GCUA 策略 $\pi_\theta$ 每步联合采样 $(q_t, p_t, m_{t+1}) \sim \pi_\theta(\cdot \mid m_t, o_t)$:$q_t \subseteq \mathcal{Q}=\{\text{screenshot}, \text{AX tree}\}$ 选择额外观测视图($q_t=\varnothing$ 即不要新视图),$p_t$ 是调用 $\mathcal{A}=\mathcal{A}_{GUI}\cup\mathcal{A}_{AX}\cup\mathcal{A}_{CLI}\cup\mathcal{A}_{API}$ 中原语的程序(可用循环、分支、变量),$m_{t+1}$ 是更新后的计划与上下文;执行后观测为 $o_{t+1}=\langle e_t, \{v_q(s_{t+1})\}_{q\in q_t}\rangle$,$e_t$ 为程序输出。实现上,harness 每步提取 块、语法检查后在目标机器执行,运行时提供 PyAutoGUI、Playwright 与 bash(),并把 stdout、stderr 与退出码回传模型。
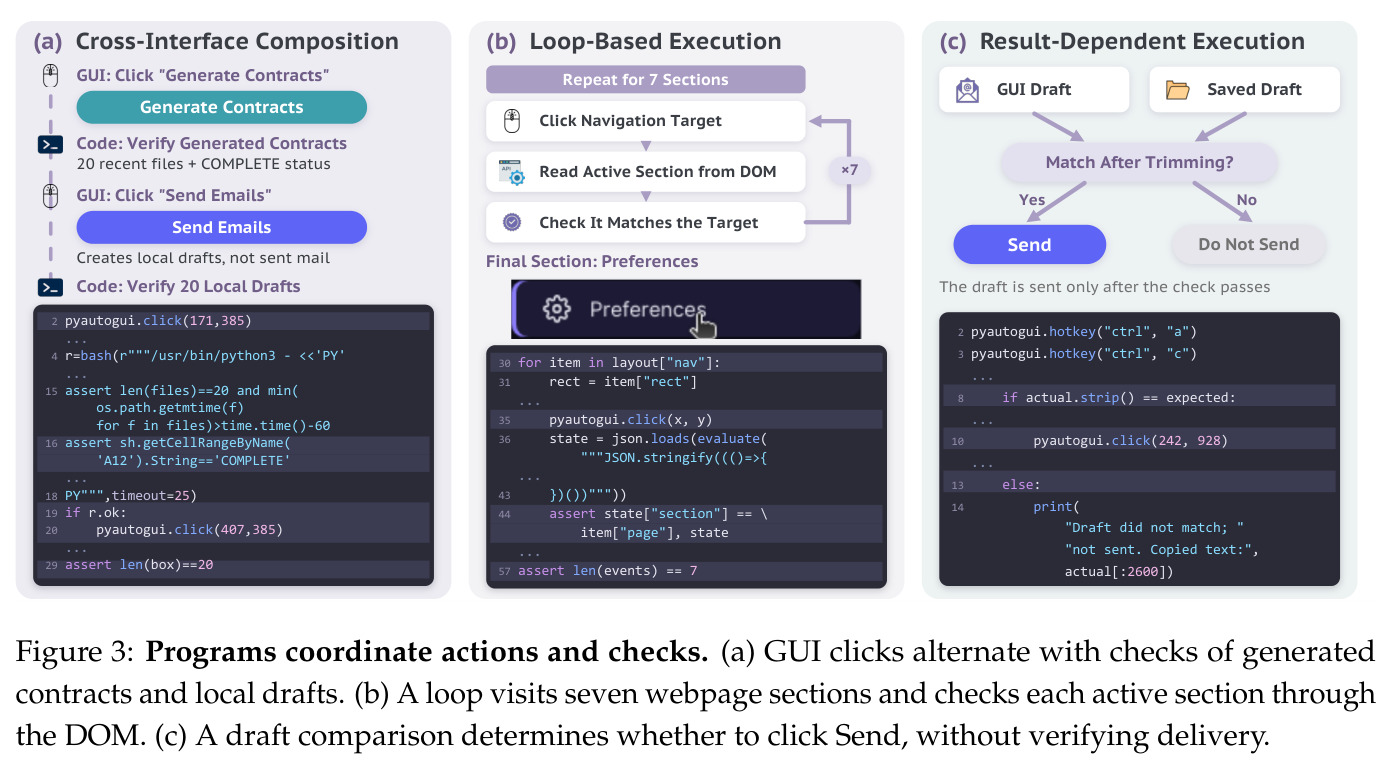
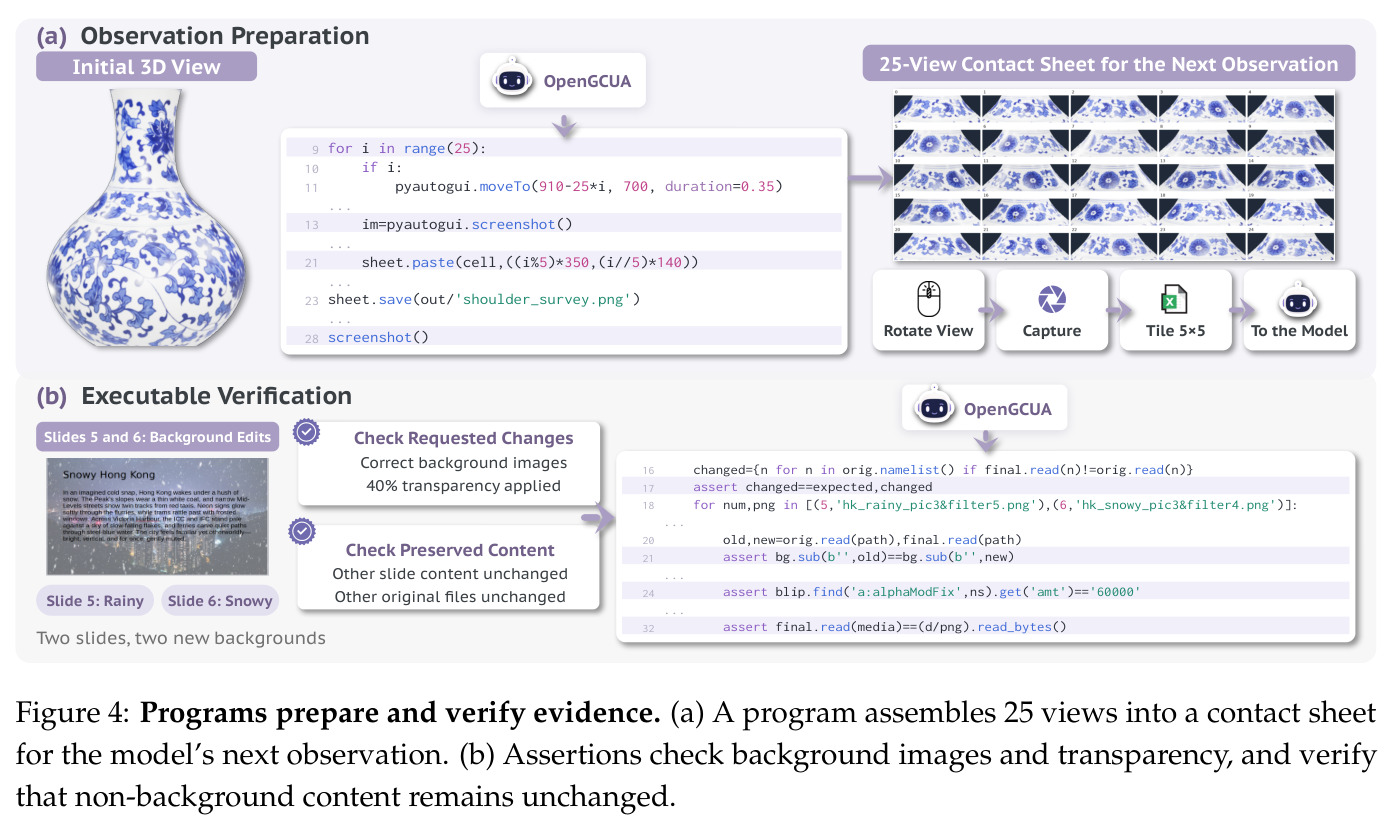
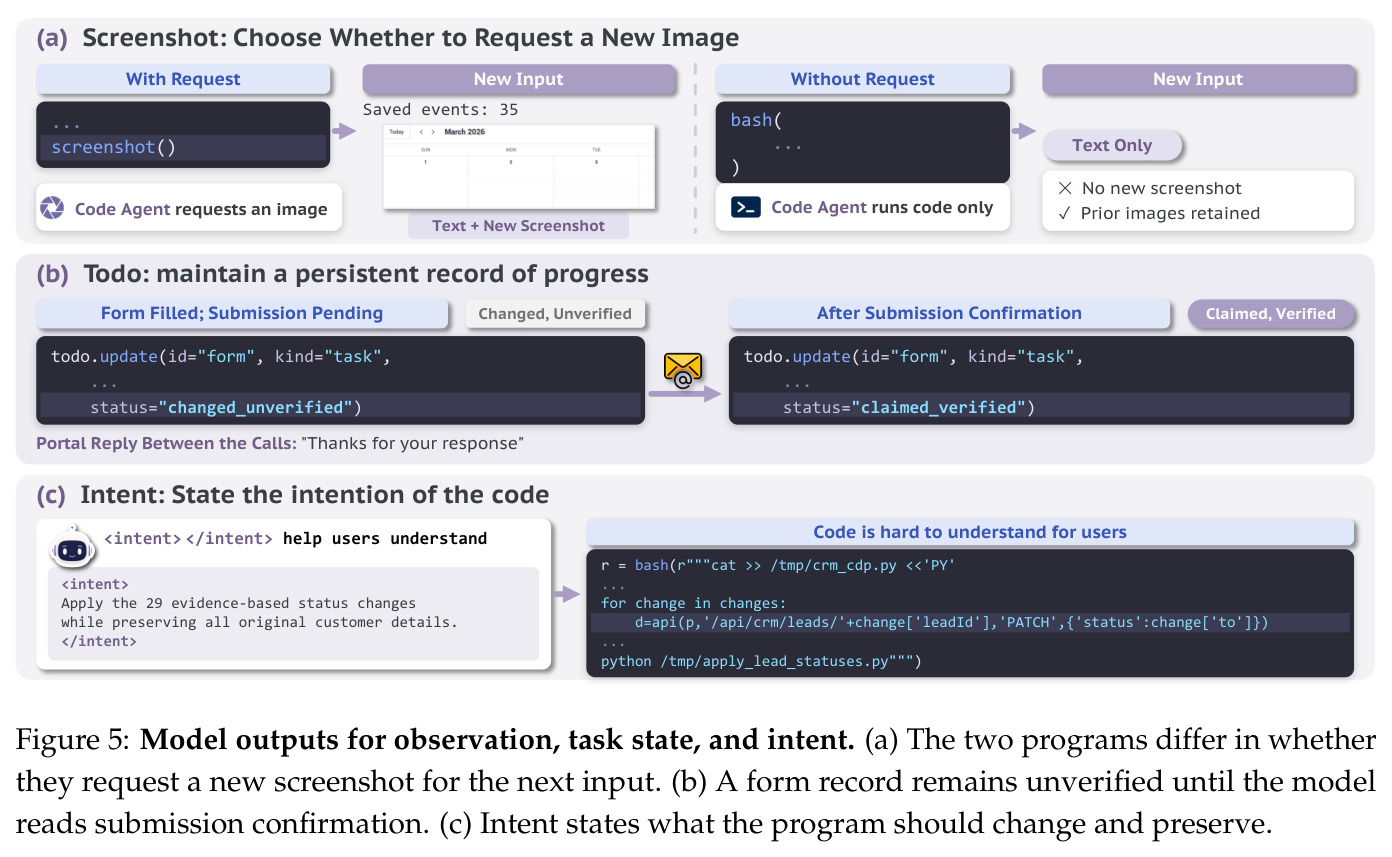
核心创新有二。其一是代码执行:与批量动作(一次调用生成一串固定动作)相比,程序的控制流在运行时才决定,单个调用内因此可以做条件(若对话框可见则关闭)、循环(为每行填三个字段)和校验(断言状态已变为 Saved)——用作者的话说,“批量动作就是没有控制流的程序”。对 GPT-6 Astra 轨迹的案例研究归纳出五种反复出现的模式:跨接口组合(GUI 点击与文件/应用状态检查交替)、基于循环的执行(遍历 7 个网页导航项并在每次循环内用 DOM 断言)、结果依赖执行(邮件草稿与存档逐字比对通过才点发送)、观测准备(把 25 个 3D 视角裁剪拼成联络表再请求一次视觉观测)、可执行验证(断言幻灯片背景已改且其余 64 个包条目未变)。其二是 harness-to-model 决策移交:screenshot() 让模型自己决定下一步是否需要新截图;todo.update()/todo.list() 让模型维护 pending、changed_unverified、claimed_verified 等任务状态记录; 块要求模型在程序执行前声明意图,供真机用户理解;而截图滚动缓冲与微压缩等上下文保留策略仍留在 harness 侧。
方法步骤详情
完整流程如下。(1) 提示词设计:系统提示规定可用接口(OSWorld-v2 为 PyAutoGUI+bash(),真机加 Playwright),要求每步输出一个 块并给出组合示例。(2) 程序执行:harness 抽取代码块并语法检查,在目标机器的持久解释器中执行,变量、导入与工作目录跨轮保留,支持增量执行。(3) 执行反馈:回传 stdout/stderr 与退出码;程序内调用 screenshot() 则附新截图(环境每步仍截图,只是不都给模型);真机可按请求返回 AX 树。(4) 决策移交机制:screenshot() 按需观测、todo 记录任务状态、 声明意图。(5) 上下文管理:滚动截图缓冲按批移除旧图、微压缩把旧工具输出替换为短占位符,均以批为单位保护提示缓存。(6) 跨设备 SDK:操作绑定显式资源句柄(phone=mu.device(“phone”)、mac、web、app、tab),ui.ax/ui.vision 分离语义与视觉观测,mu.emit 只投递程序筛选后的信息,平台差异经 .android/.macos/.browser 命名空间显式暴露,macOS 复用 trycua 的 Cua Driver。(7) 真机五层架构:模型写程序→运行时执行并管上下文与人在环→SDK 绑资源→驱动层管元素身份、按“AX 优先、窗口坐标次之、前台输入最后”选择投递策略并返回类型化错误→应用与 OS 是事实来源。
技术新颖性
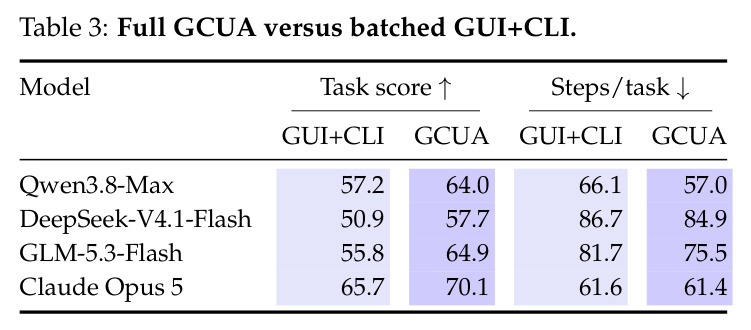
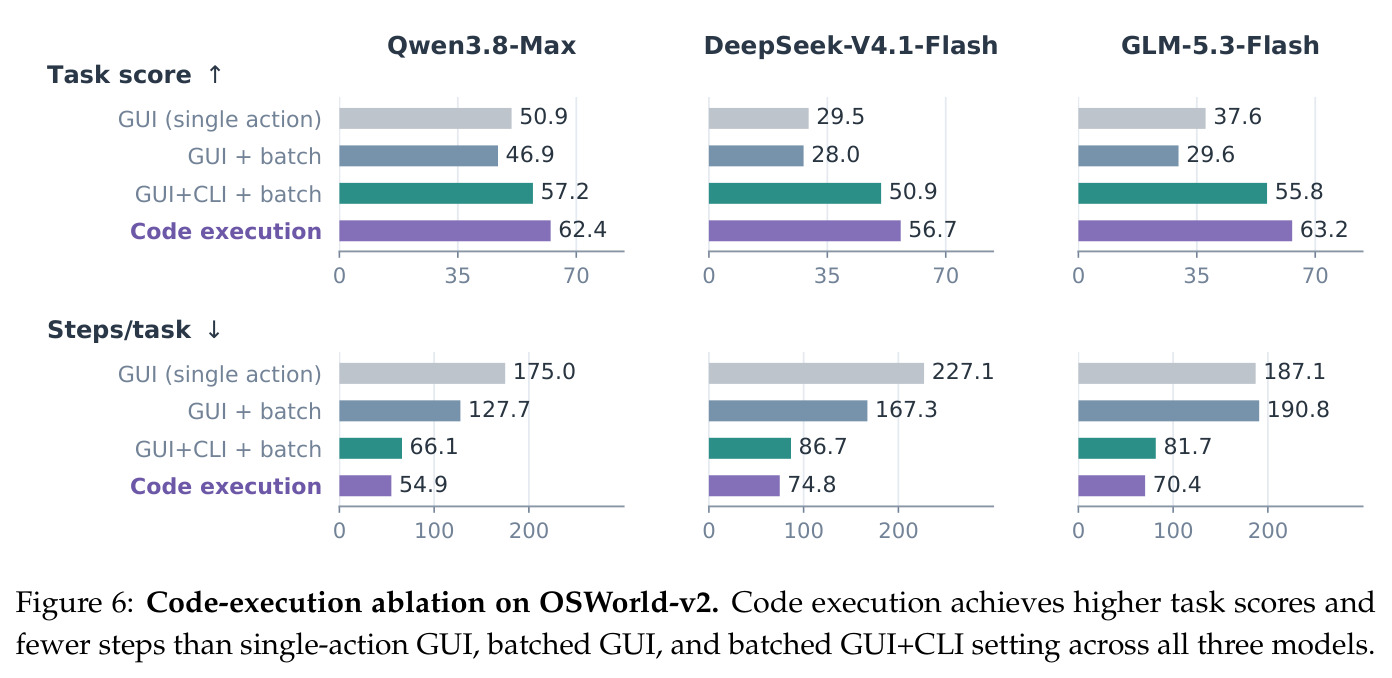
技术新颖性体现在四点。(1) 用“决策归属”而非“组件清单”统一刻画现有智能体家族(表 1):GUI 智能体固定全部三个决策($q_t\equiv\{\text{screenshot}\}$、$p_t\in\mathcal{A}_{GUI}$、$m_{t+1}=h(m_t,o_t)$);CLI 智能体固定观测与接口;多智能体系统由编排器按子任务固定接口;作者自家的 Qwen-UI-Agent 已让模型逐动作选择 GUI 或 shell,但仍固定每步截图与上下文规则。这一形式化让“逐步放宽约束”的路线清晰可比。(2) 首次系统分离“接口访问”与“执行控制”两个因素:表 3 与图 6 表明,仅给 GUI+CLI 接口(批量)不如让模型写程序——相同接口下均值再 +6.1 分、步数再降 14.8%,说明价值来自运行时控制流而非多给一个 shell。(3) 决策移交是新的设计维度:随模型能力增强,harness 应退居为提供可靠机制,把“何时看、记什么”逐步让渡给模型,这与提示工程的静态调优有本质区别。(4) 效率作为一等指标并给出预算-性能曲线(图 7),挑战“只报最高分”的评测文化。
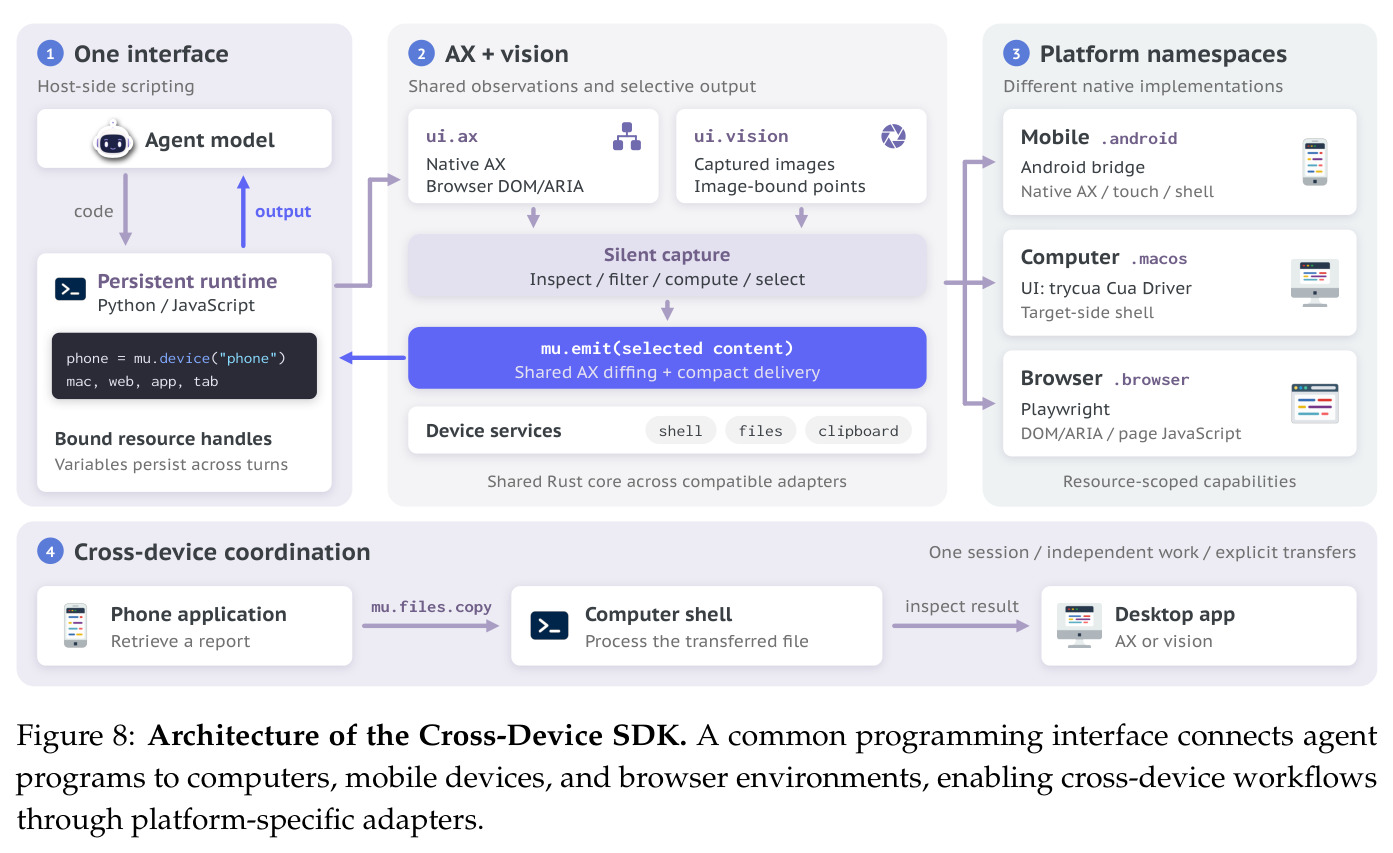
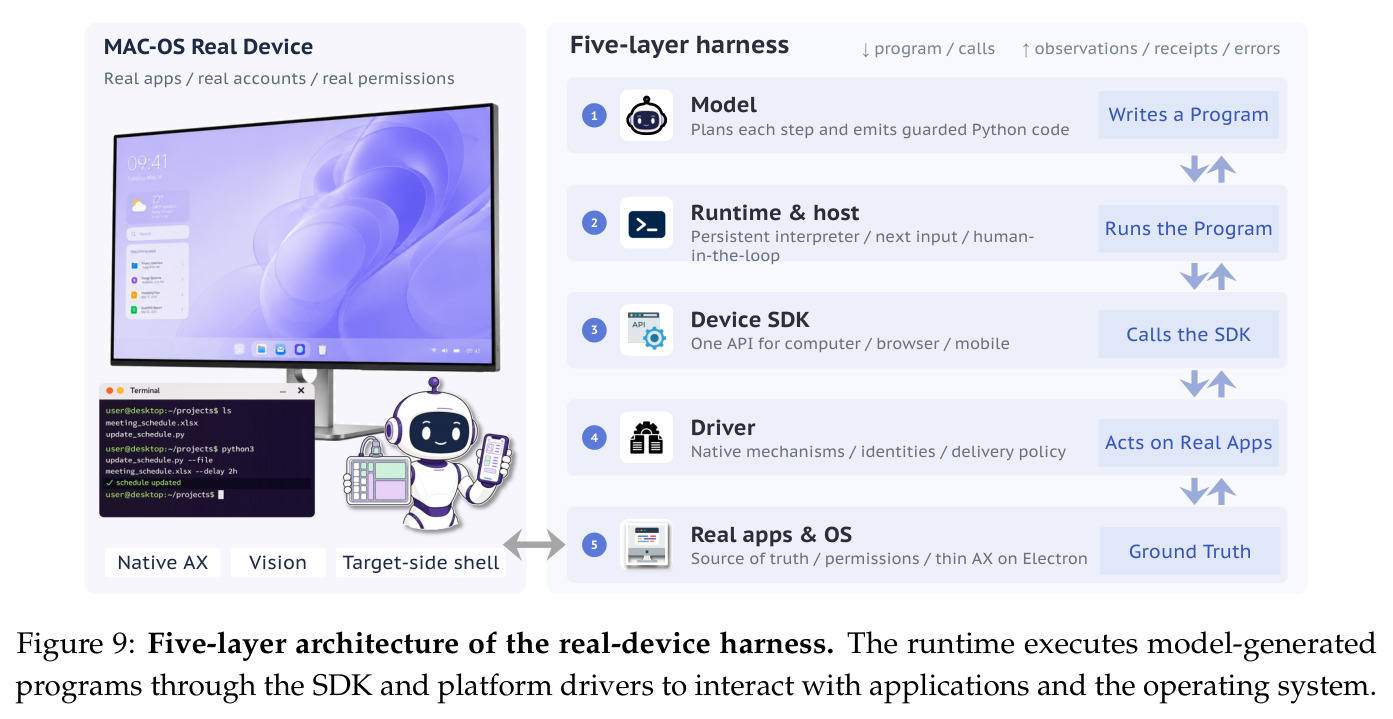
实验结果
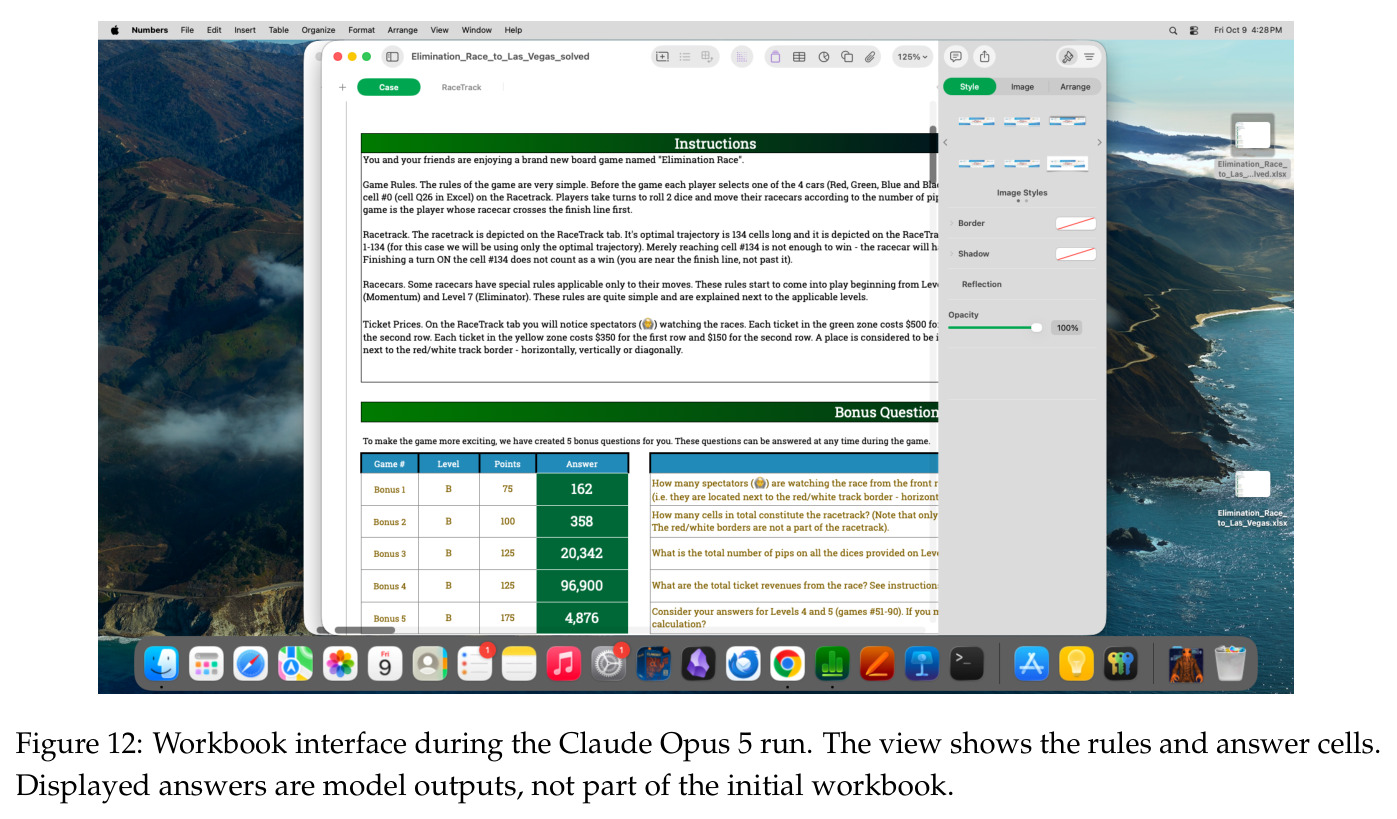
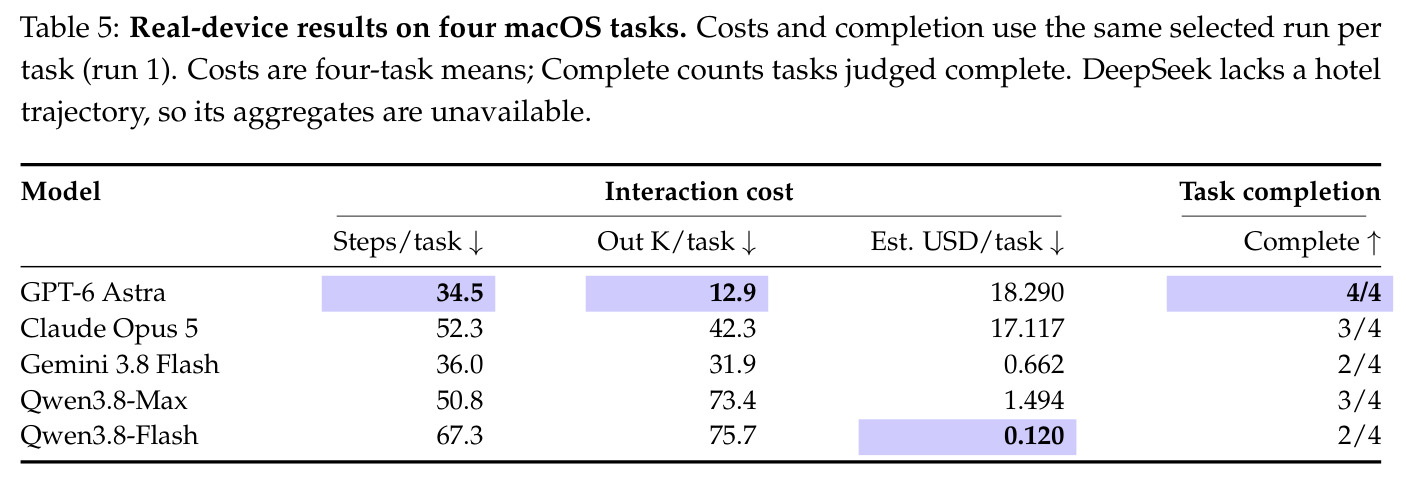
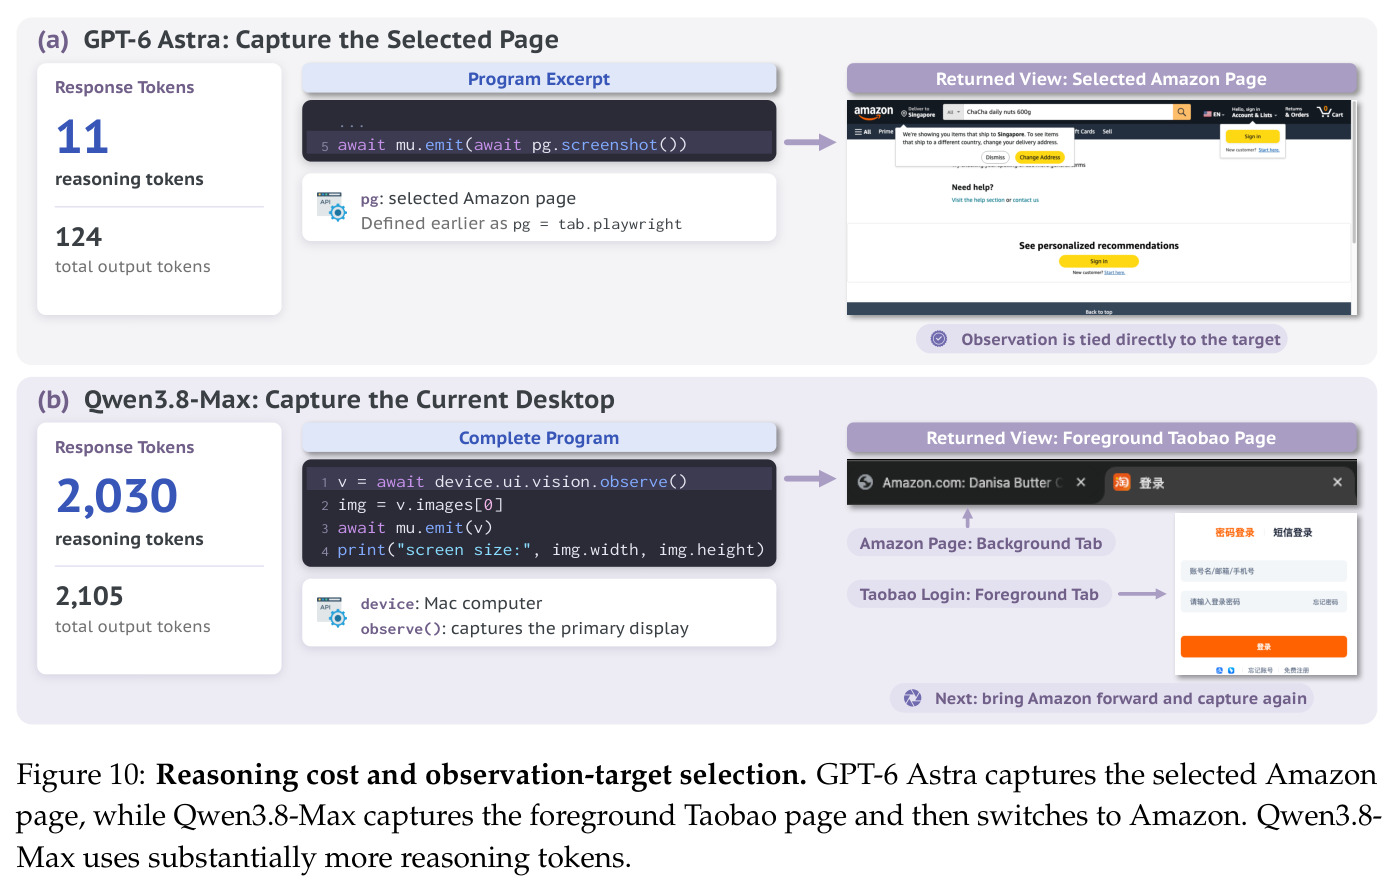
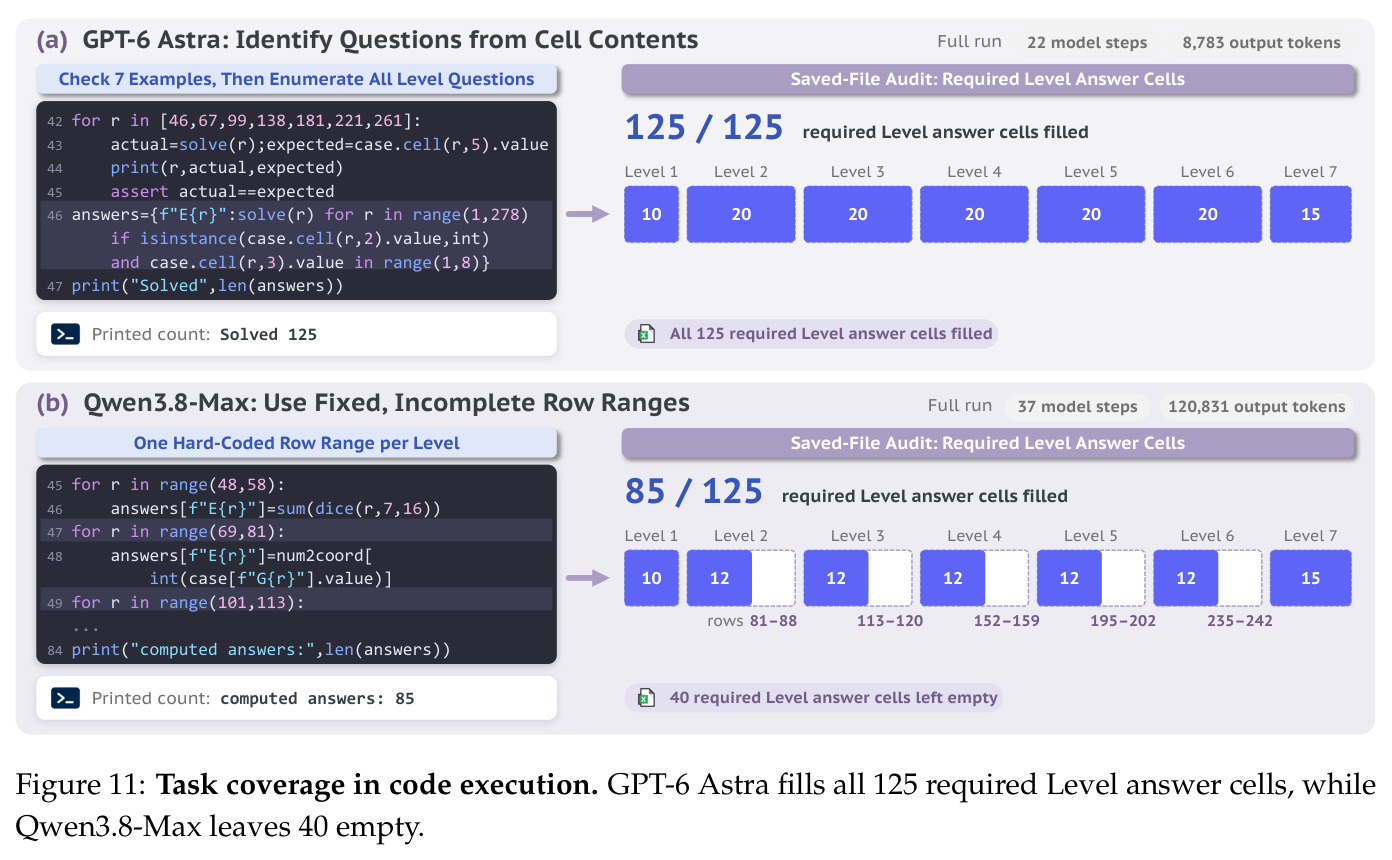
主结果(表 2,OSWorld-v2 82 任务离线集):全量 GCUA 对比批量 GUI-only,8 个模型全部提升,均值 partial score 45.3→64.9(+19.6),步数平均降 53.0%,输出 token 降 27.2%。分模型:GLM-5.3-Flash 29.6→64.9(+35.2)、DeepSeek-V4.1-Flash 28.0→57.7(+29.8)、Qwen3.8-Flash 38.9→60.5(步数 232.0→86.2);最强的 GPT-6 Astra 67.1→75.7、步数 102.1→33.5(−67.2%);Claude Opus 5 输出 378.3K→89.3K token/任务,而 GPT-6 Astra 持平(30.8K→31.9K),说明步数与 token 是独立维度。代码执行消融(图 6):相同接口下比批量 GUI+CLI 均值 +6.1 分、步数 −14.8%,比批量 GUI 高 15.5-33.6 分。决策移交消融(表 4):按需截图使缓存命中率 +10.5/+14.4pp 且分数不降;todo +1.6/+1.8 分;intent 略降分(目标是可解释性);滚动缓冲 +16.0/+13.4pp,微压缩反而 −7.0/−3.0pp。预算曲线(图 7):$0.38/任务时最优是 Qwen3.8-Flash(60.5 分),$15.26 才轮到 GPT-6 Astra(75.7)。真机(表 5,4 个 macOS 任务):GPT-6 Astra 4/4 完成、34.5 步、12.9K 输出(推理仅 2.6K)、$18.29/任务;Qwen3.8-Max 3/4、50.8 步、73.4K 输出(推理 50.2K,为前者 19.4 倍)但仅 $1.49。案例研究:同样截屏一步,Qwen3.8-Max 花 2,105 token(推理 2,030),GPT 仅 124(推理 11);工作簿任务 GPT 自查 7 个样例后填满 125/125 个答案格,Qwen 用固定行区间只覆盖 85/125、留下 40 个空格且未察觉——差距不在会不会写循环,而在能否用代码完整覆盖任务并自查。
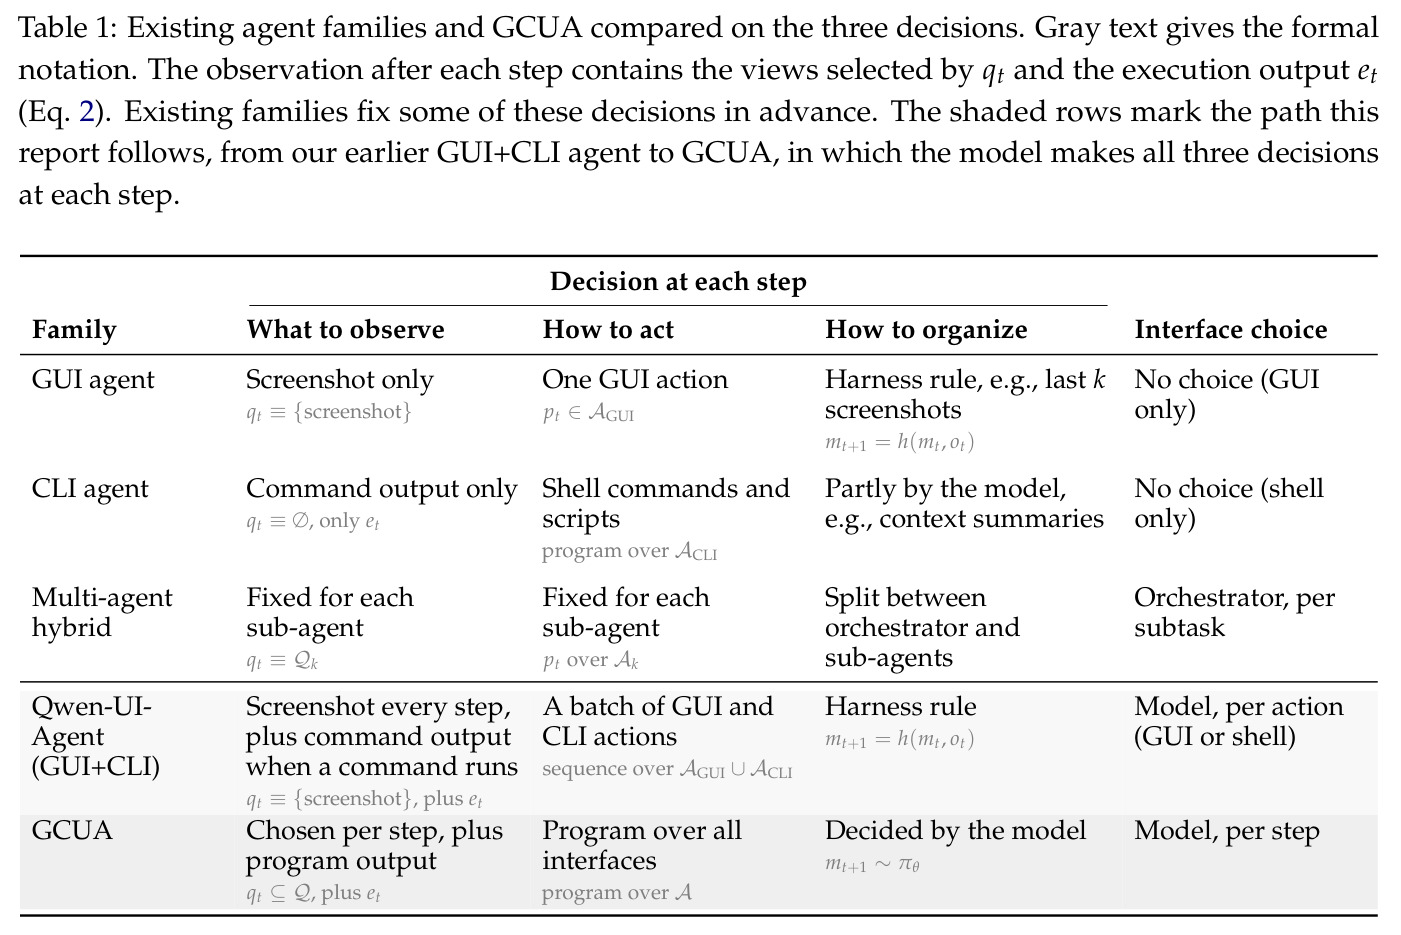
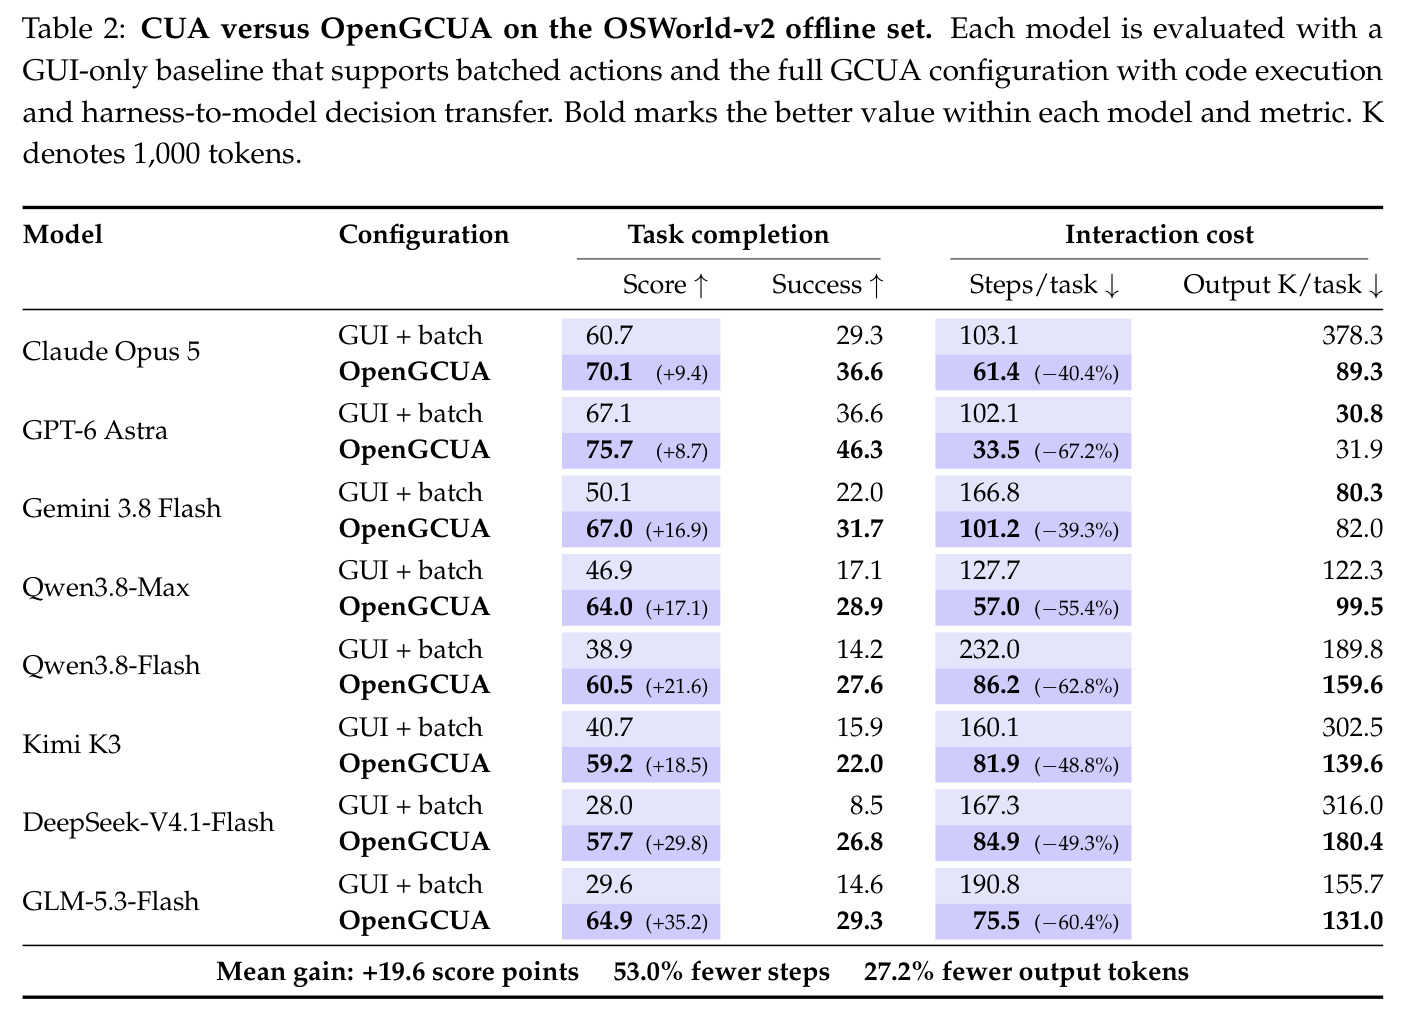
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OSWorld-v2 离线集(82 任务)多样计算机任务 | Mean partial score | 64.9(8 模型均值,OpenGCUA 全配置) | 45.3(批量 GUI-only CUA) | +19.6 分(8 模型全部提升,最大单模型 +35.2) |
| OSWorld-v2 离线集 | Steps/task(每任务模型调用数) | GPT-6 Astra 33.5;8 模型平均相对下降 53.0% | 批量 GUI-only:GPT-6 Astra 102.1;各模型 102.1-232.0 | 各模型 −39.3% ~ −67.2% |
| OSWorld-v2 离线集 | Binary success(全任务成功率) | GPT-6 Astra 46.3%、GLM-5.3-Flash 29.3% | 批量 GUI-only:GPT-6 Astra 36.6%、GLM-5.3-Flash 14.6% | 8 模型全部上升(如 GLM +14.7 个百分点) |
| 代码执行消融(Qwen3.8-Max/DeepSeek-V4.1-Flash/GLM-5.3-Flash) | Partial score | 62.4 / 56.7 / 63.2(代码执行) | 批量 GUI+CLI:57.2 / 50.9 / 55.8 | +4.4 ~ +7.4 分(均值 +6.1),步数再降 14.8% |
| 按需观测(决策移交消融,两模型) | Cache hit(缓存命中率) | Qwen3.8-Max 86.1%、DeepSeek-V4.1-Flash 76.3% | 仅代码执行:75.6%、61.9% | +10.5 / +14.4 个百分点,且任务分数不降反升 |
| 真实 macOS 设备(4 任务,同一 harness) | 推理 token/任务 | GPT-6 Astra 2.6K | Qwen3.8-Max 50.2K | Qwen3.8-Max 耗 19.4 倍推理 token 且完成更少任务(差距证据) |
| 真实 macOS 设备(4 任务) | Complete(完成任务数) | GPT-6 Astra 4/4($18.29/任务) | Qwen3.8-Flash 2/4($0.12/任务)、Gemini 3.8 Flash 2/4 | 同一 harness 下模型真实设备能力差距显著 |
局限与改进
作者承认的局限:(1) 本发布不含训练好的 GCUA 模型,结论来自提示词驱动的现有模型,真机 harness 与 SDK 均为初步版;(2) 主实验仅 82 任务离线子集(排除 26 个需联网任务),且多处标注 selected runs(挑选的运行而非全部种子);(3) 时间曲线受 API 带宽、限流、并发环境数等未控制因素影响,仅作探索性证据;(4) 真机仅 4 个 macOS 任务、每模型 1 次选中运行,作者自述只“刻画被测配置而非建立模型排名”;推理 token 为模型上报值。我的观察:(5) 最强配置离饱和仍远——GPT-6 Astra partial 75.7 但 success 仅 46.3%,多数任务只能部分完成;(6) 批量动作并非普适改进:Qwen3.8-Max 从单动作 50.9 降到批量 46.9,编排策略与模型特性存在交互,论文未分析原因;(7) 微压缩损害缓存命中率(−7.0/−3.0pp),与省上下文的目标冲突,缺乏选用准则;(8) intent 拖低任务分数,可解释性与性能的权衡未解决;(9) 真机依赖 PyAutoGUI 坐标点击,在分辨率/DPI 变化或窗口移动下脆弱,论文未量化坐标类操作的失败率。
独立分析的弱点
独立弱点分析:(1) 关键结论依赖 selected runs 且无多种子统计——代码执行相对批量 GUI+CLI 的 +6.1 分可能落在运行间噪声内。改进方向:报告多种子均值与置信区间,公开轨迹选择协议。(2) 成本结构极端化:GPT-6 Astra 真机约 $18.29/任务、基准上 $15.26,Qwen3.8-Flash 仅 $0.12-0.38,预算敏感场景用不起最强模型。改进方向:把 GPT 式“少想多做”风格蒸馏进小模型或加推理长度正则。(3) 安全与权限模型缺位:模型程序可直接跑 bash()、一次修改 29 条 CRM 记录,真机目前只靠 展示意图,缺少风险分级、沙箱与高危操作确认门。改进方向:把 SDK 资源句柄与能力声明扩展为按后果分级审批的权限系统。(4) 观测通道薄弱:论文自述 Electron 应用 AX 树很薄,纯视觉回退又丢结构化信息。改进方向:为 Electron、Flutter 等跨平台框架做语义适配器。(5) 评测生态偏英文与海外应用,对中文本地化软件覆盖未知。改进方向:借开源真机基准补充多语言任务。(6) ask_user 人机协作未量化:打扰频率、用户响应延迟、中断恢复正确率无数据。改进方向:定义协作开销指标并做用户研究。
未来方向
未来方向。作者明确提出的:(1) 下一发布版训练 GCUA 模型,统一计算机与浏览器使用,把代码执行、按需观测、任务状态跟踪从提示词技巧变成学到的能力,尤其强化真机场景;(2) 优化推理效率——让常规操作的思考更简洁、缓解过度思考(overthinking),并在 harness、上下文管理与基础设施层面提效;(3) 把 harness/SDK 扩展到跨电脑、浏览器乃至手机的任务,重点研究可靠目标选择、执行失败恢复、用户打断或改需求后的任务连续性;(4) 建设真实设备(尤其 macOS)的环境与基准,覆盖更多应用、真实用户交互与动态设备状态,度量“真实运行条件下能否完成有用工作及耗时耗资”;(5) 继续研究还有哪些工作流决策应从 harness 规则移交给模型。基于本文成果可延伸的:(6) 利用已开源的 8 模型轨迹做轨迹蒸馏或训练过程奖励模型,专门压缩冗余推理;(7) 把图 7 的预算-性能曲线扩展为在线模型路由策略,按剩余预算与任务难度动态切换模型;(8) 做程序级信用分配——定位失败由哪条语句导致——为后续 RL 训练提供密集信号;(9) 对 与 ask_user 做人类因素研究,量化信任、打扰与效率的权衡。
复现评估
复现评估:开源程度较高。实现与提示词、8 个前沿模型的完整评测轨迹、初步版真机 harness 与跨设备 SDK 均已发布(GitHub 仓库 + 项目网站 + 在线交互实验室)。数据方面,评测使用公开的 OSWorld-v2 (v2.1) 82 任务离线子集,运行时不需外网,可在本地虚拟机中搭建;真机部分需要一台 macOS 实体机并授予辅助功能与屏幕录制权限,macOS 适配器直接复用 trycua 的 Cua Driver。算力与成本:无需任何训练,只需调用各家 API;按论文公开价格估算,复跑 8 模型全量实验的开销主要由基线下的 Claude Opus 5(378.3K 输出 token/任务)和 GPT-6 Astra(约 $15.26/任务)贡献,小模型部分很便宜(Qwen3.8-Flash 约 $0.38/任务),单模型单配置预计数百美元量级。难度:中等。直接跑开源 harness 复现基准表格是可行的;但 selected runs 的挑选标准未完全说明,精确复现表中数字存在不确定性;真机 4 任务样本太小,复现时应关注趋势而非对齐具体数值;跨设备 SDK 尚为初步版本,API 可能变动。
论文图表