NorthCUA:以大规模经验飞轮加速计算机使用智能体 NorthCUA Technical Report: Turbocharging Computer-Use Agents through Experience at Scale
用执行底座+经验飞轮+三阶段学习,让开源 CUA 在六大基准达到 SOTA
前置知识
Computer-Use Agent(CUA,计算机使用智能体)
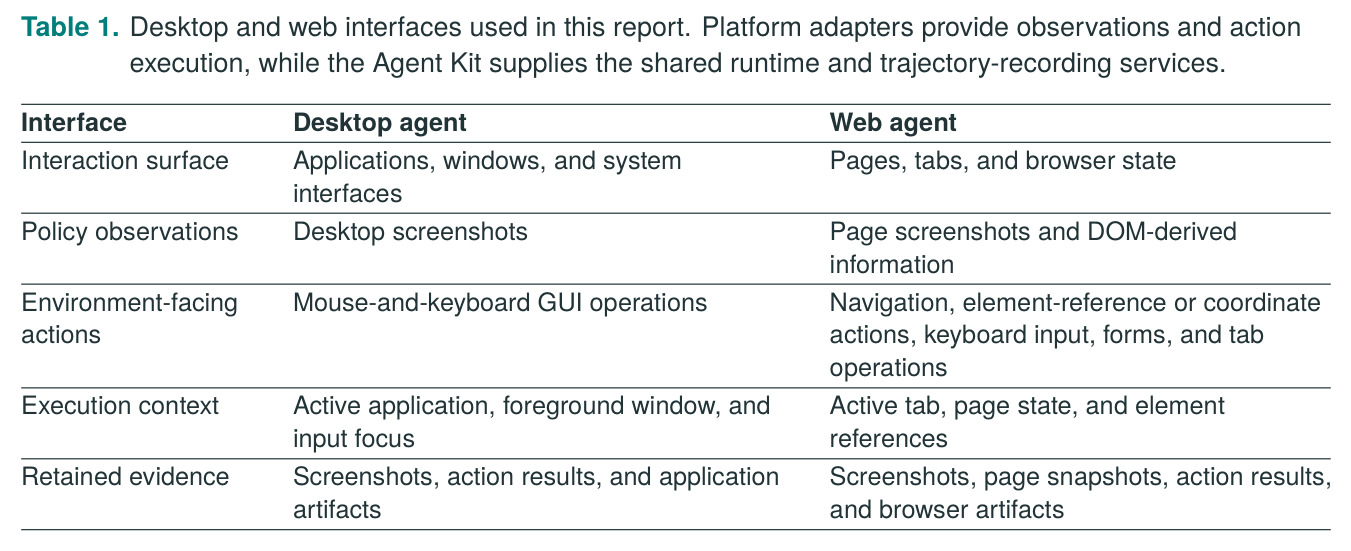
让大模型直接操作计算机的智能体:观察桌面截图或网页截图+DOM,通过鼠标点击、键盘输入、滚动、拖拽等 GUI 动作完成用户目标。桌面端跨应用操作文件与软件,Web 端通过浏览器工具导航与操作元素,二者都遵循观察-行动-反馈循环,最终以文件产物或软件状态判断成败。
本文的全部系统(Harness、经验飞轮、三阶段学习)都围绕如何训练 CUA 展开,理解任务形态是读懂一切设计的前提。
GUI Grounding(界面定位/视觉定位)
给定一张截图和自然语言查询(如"定位缩放工具"),模型直接预测目标控件在原图中的像素坐标 $(x,y)$。它只做一次预测、不迭代,是 CUA 的原子能力:定位不准,后续动作全部落空。ScreenSpot-Pro 与 OSWorld-G 是该能力的两个代表性基准。
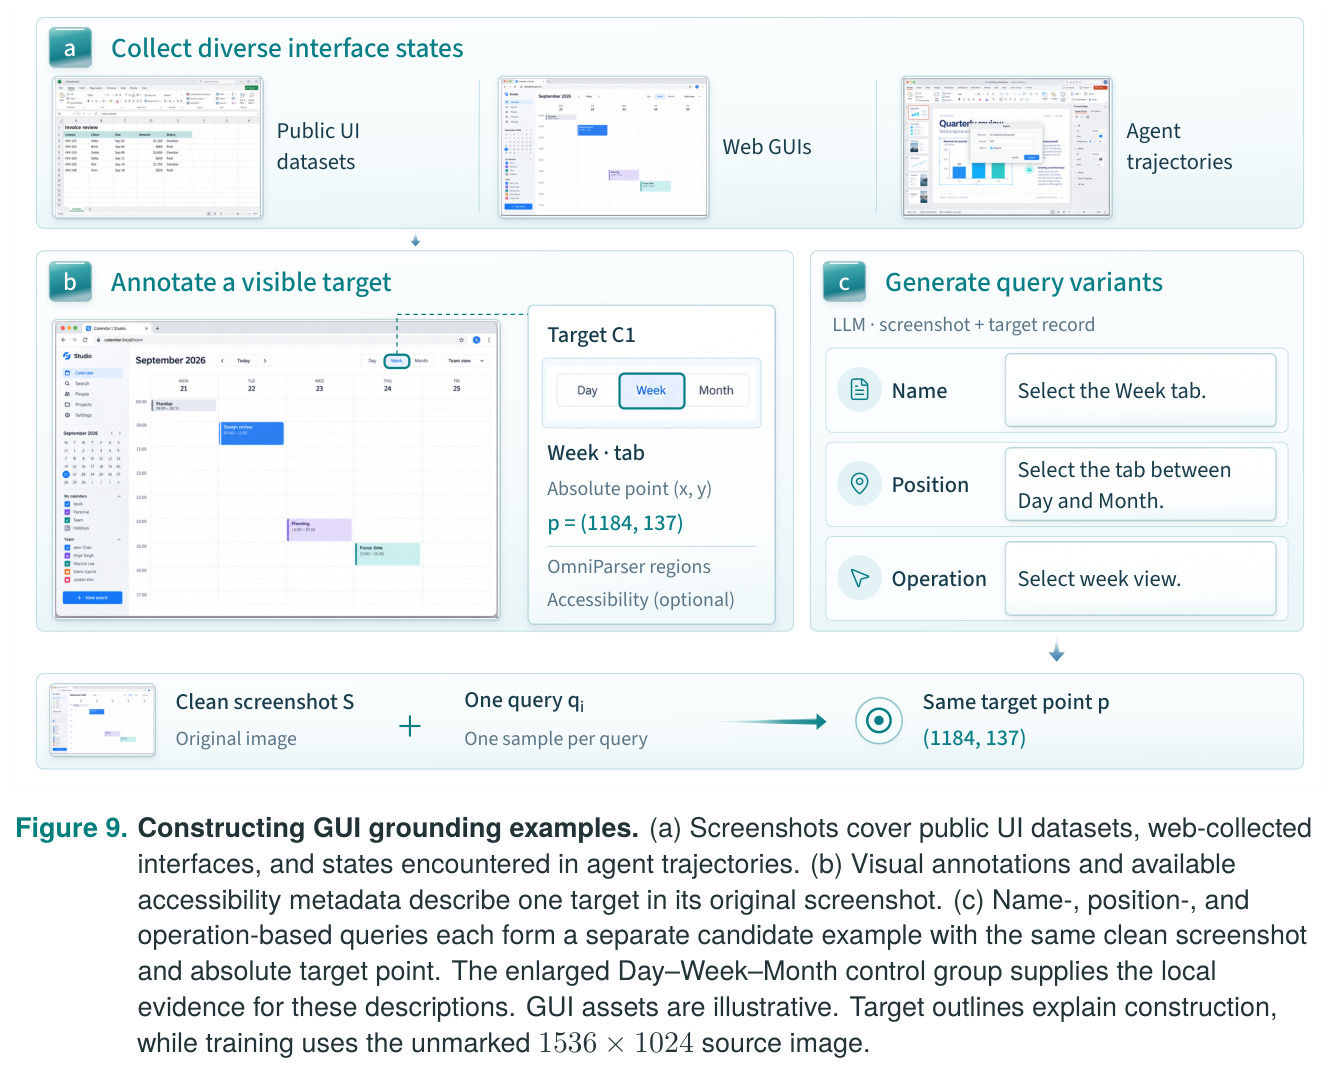
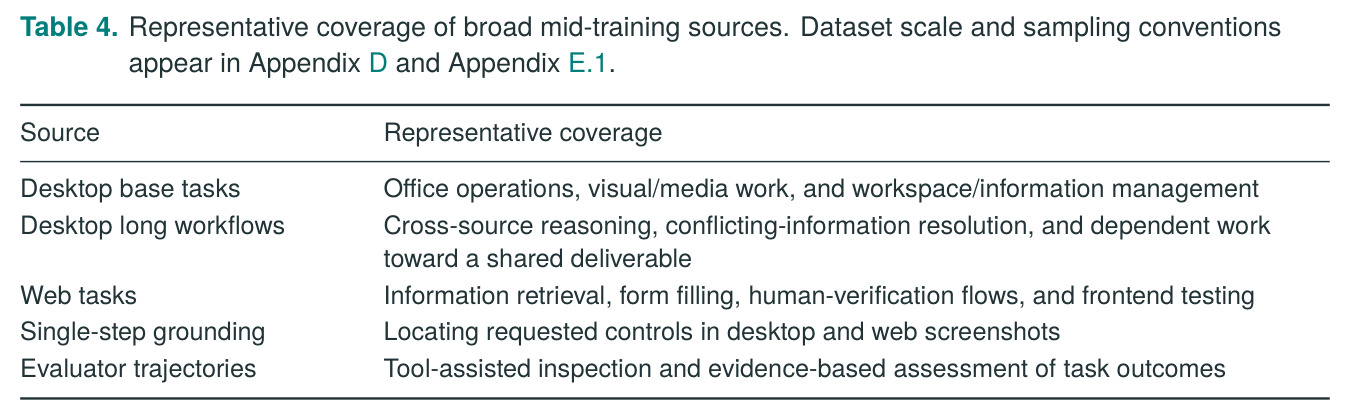
论文的经验飞轮一半产能用于构造 grounding 数据(截图-查询-坐标三元组),中训练阶段的坐标统一用 $[0,1000]$ 归一化表示,是理解数据构造与评测的关键。
GRPO(组相对策略优化)
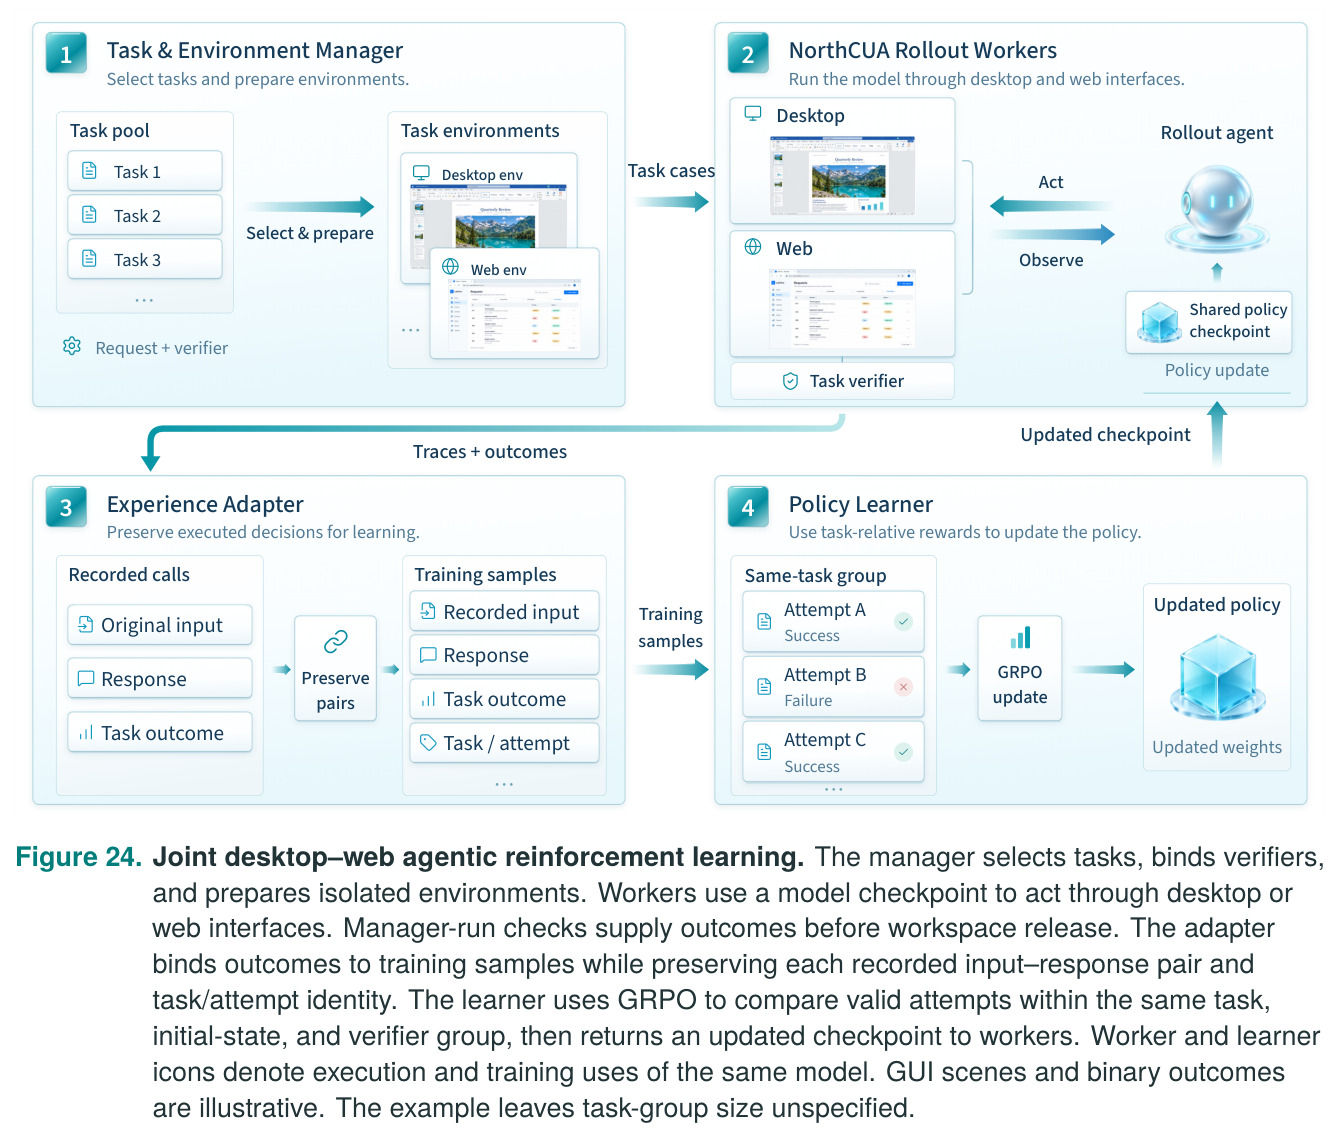
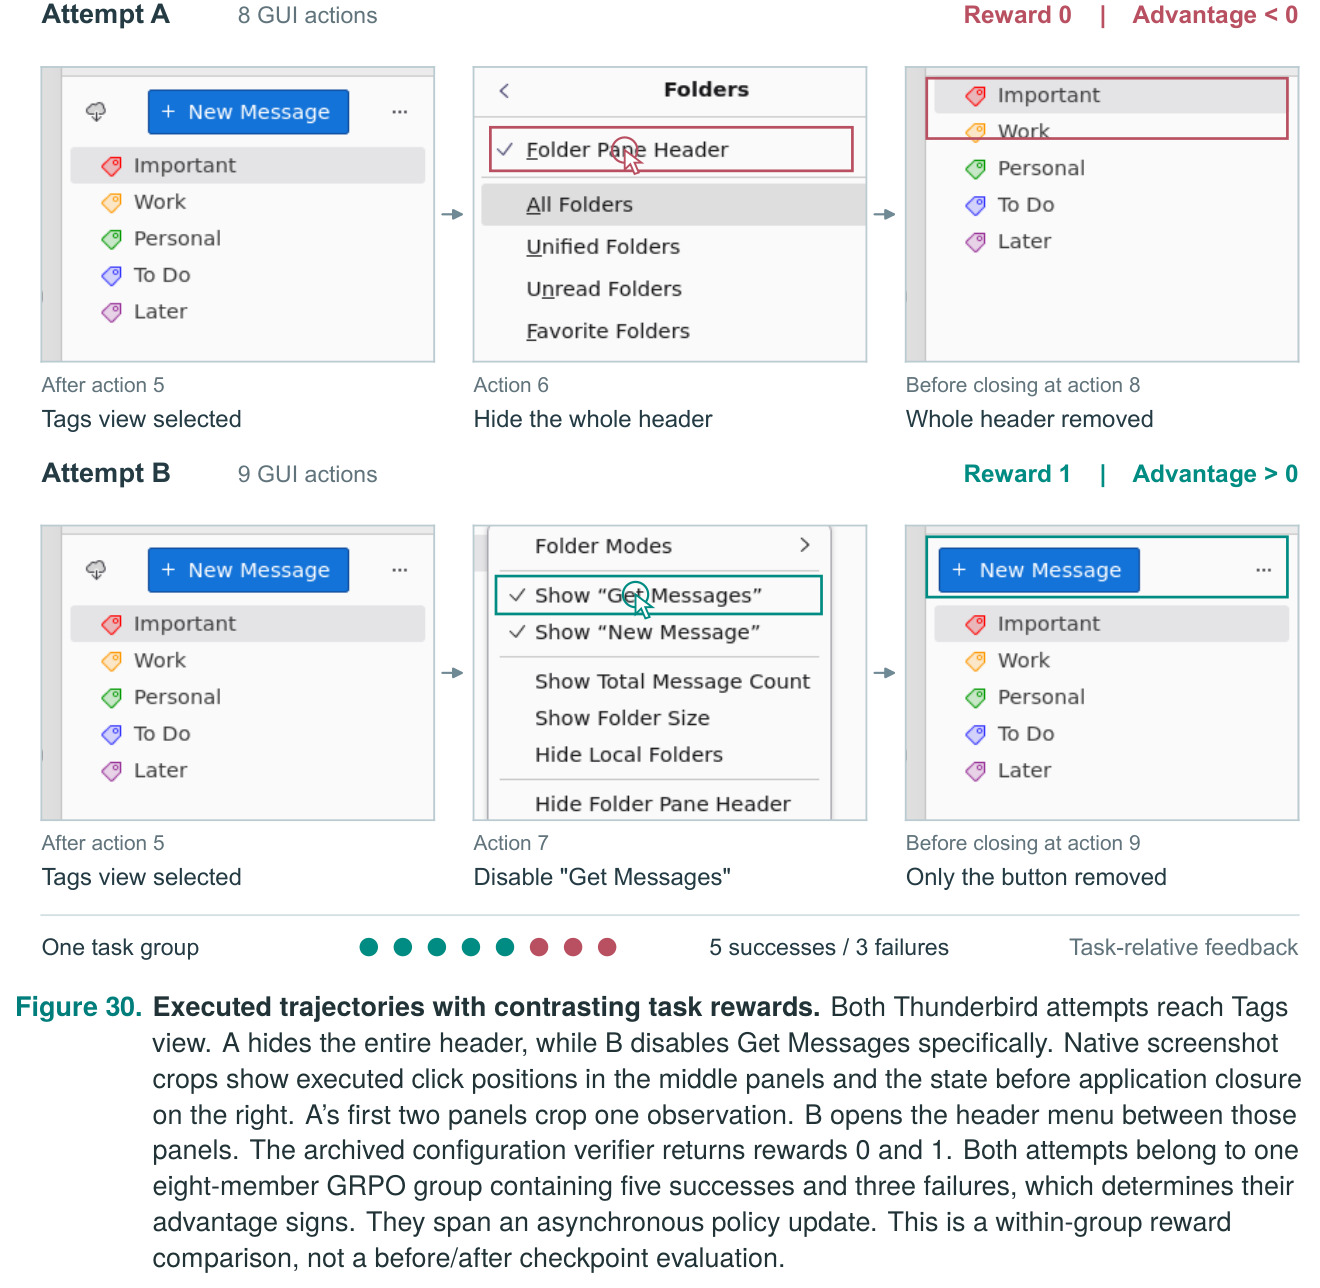
一种无需价值网络的在线强化学习算法:对同一任务用当前策略采样一组(group)完整尝试,用可执行验证器给每个尝试打终局奖励,组内相对奖励(如减组均值)作为该尝试的优势 $A_i$,据此做带裁剪的策略梯度更新。成功与失败尝试分别获得正/负优势,即使失败奖励为 0 也保留有效失败信号。
本文第三阶段学习就是桌面+网页联合 GRPO,其任务筛选(SFT 策略 rollout 结果要有差异)、样本构造(attempt 级共享优势)全部围绕 GRPO 的组比较机制展开。
Agent-as-a-Judge(智能体裁判)
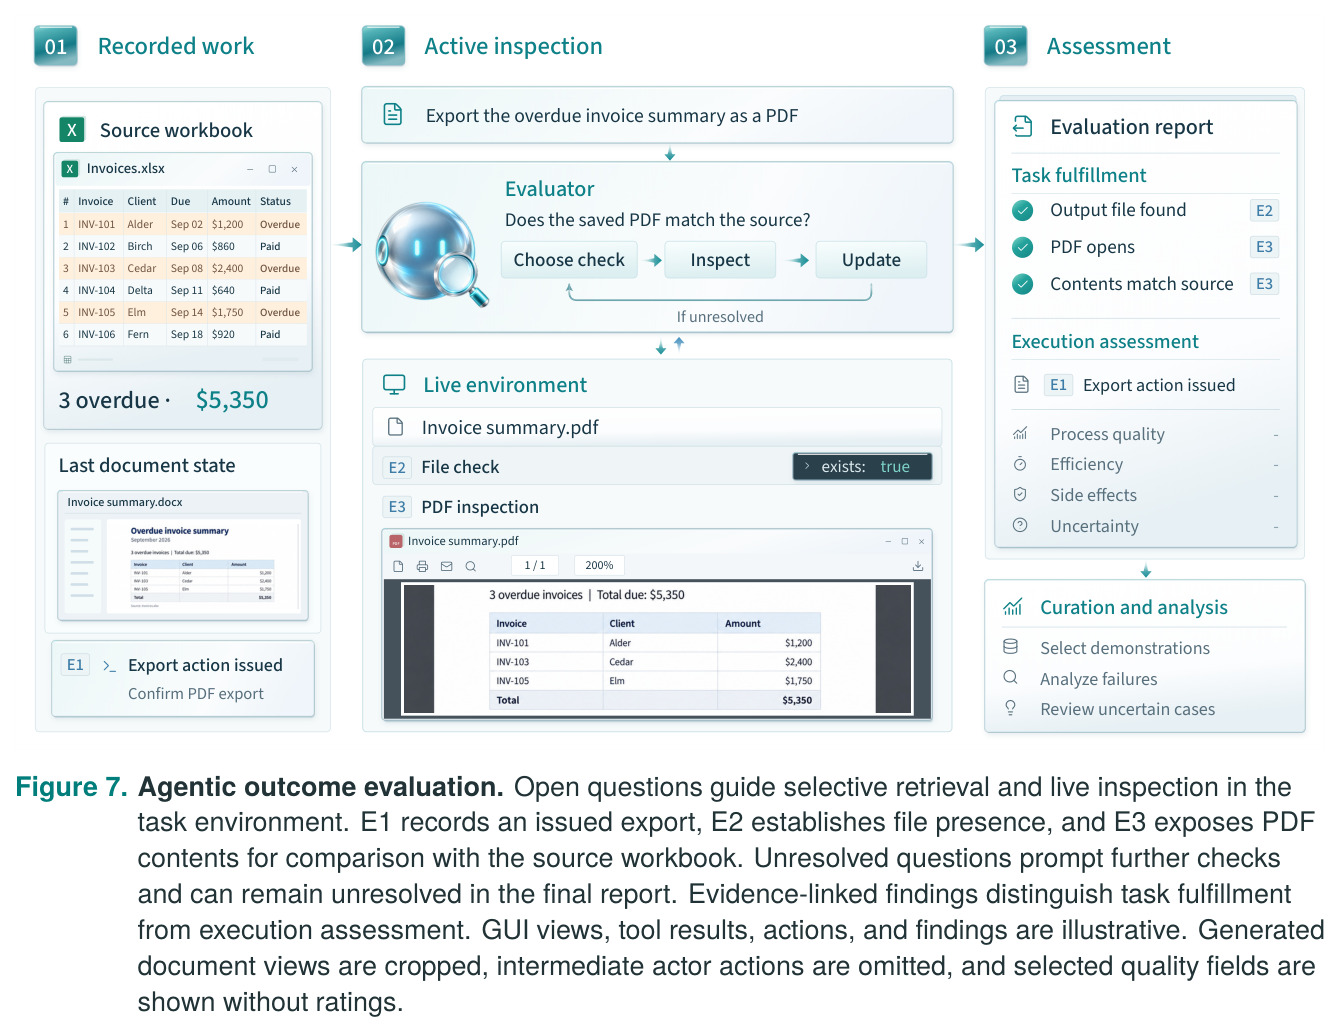
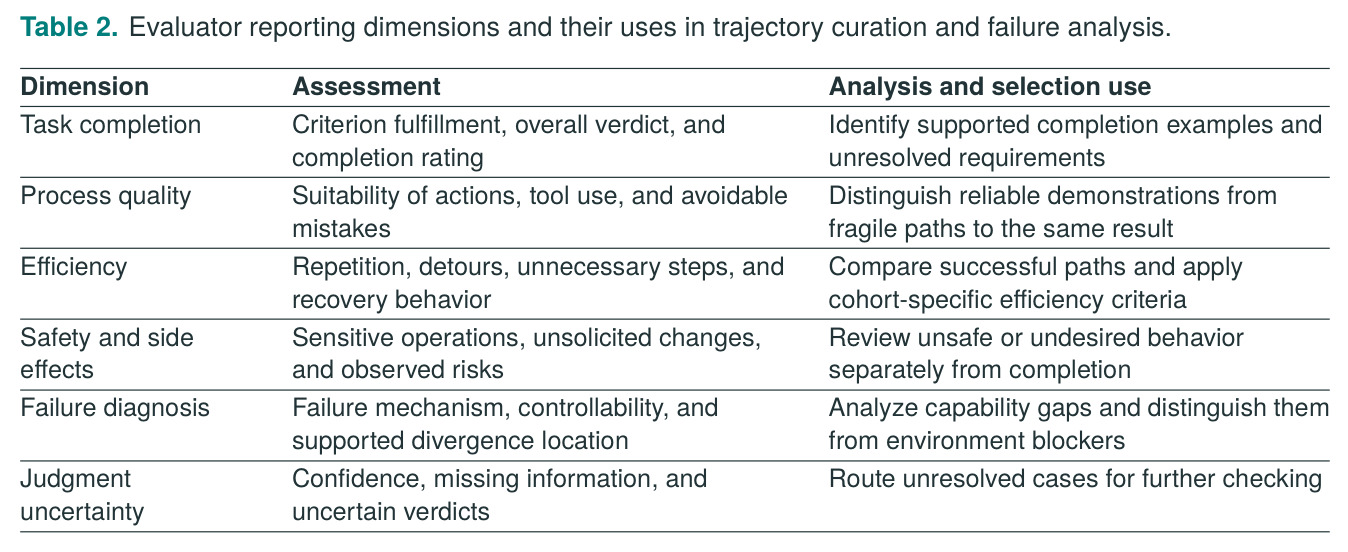
用一个配备了工具的智能体来评估另一个智能体的工作:它不只是看最终截图,还能检索轨迹记录、用 shell/GUI/浏览器工具活体检查原工作区(如打开导出的 PDF 与源表逐项比对),按 rubric 输出带证据链接的多维度报告(完成度、过程质量、效率、副作用、失败诊断、不确定性)。
可扩展、可验证的结果判断是本文经验飞轮的瓶颈环节:没有可靠的裁判,就无法从海量尝试中筛出可信演示、也无法给 RL 提供正确奖励。
递归自我改进(RSI)与检查点搜索
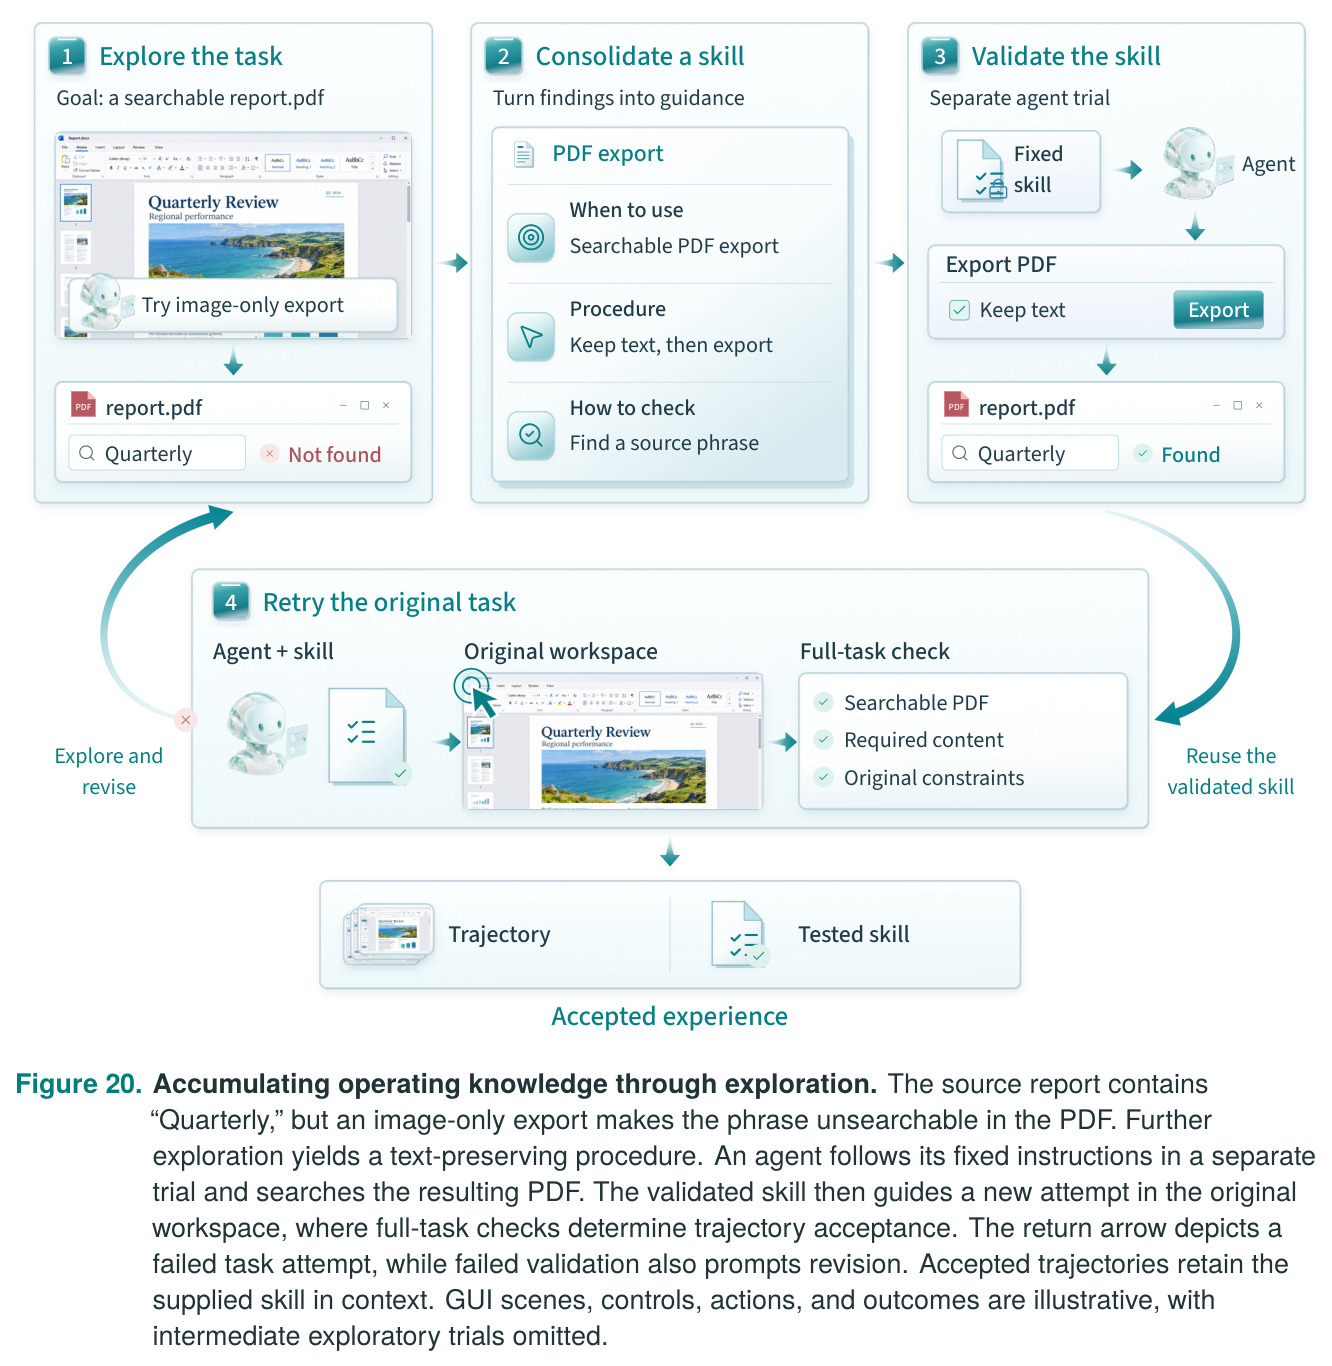
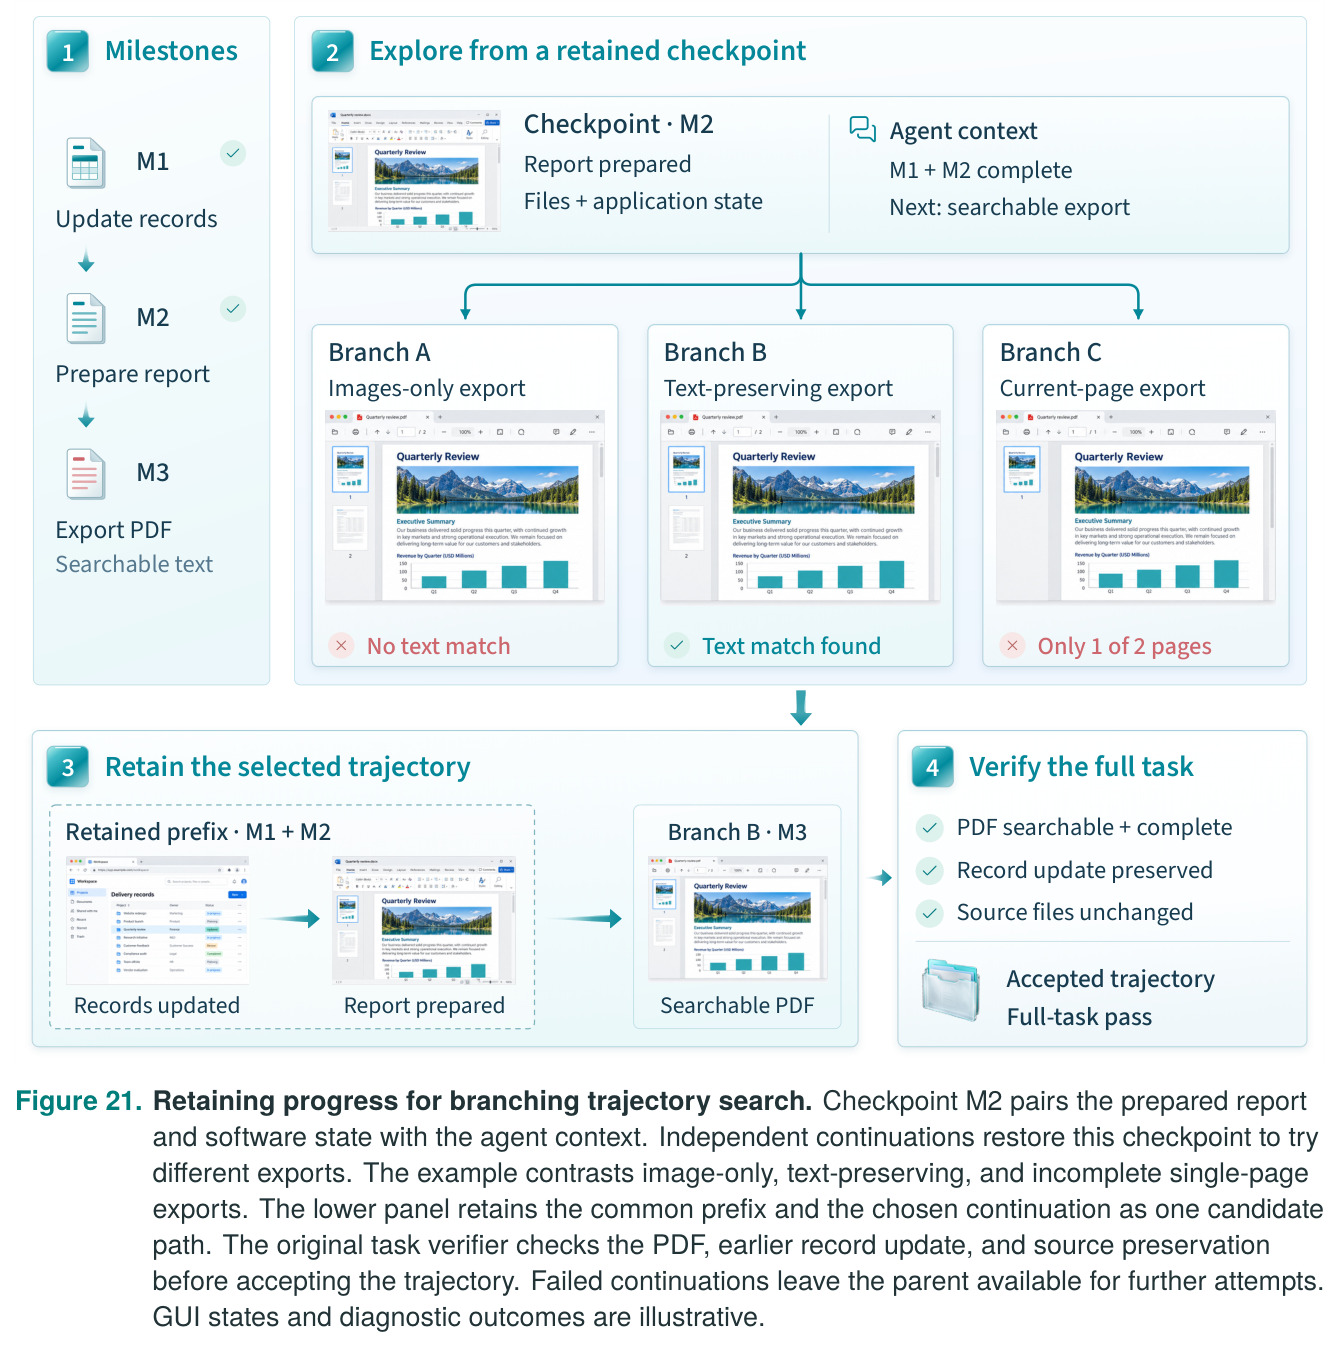
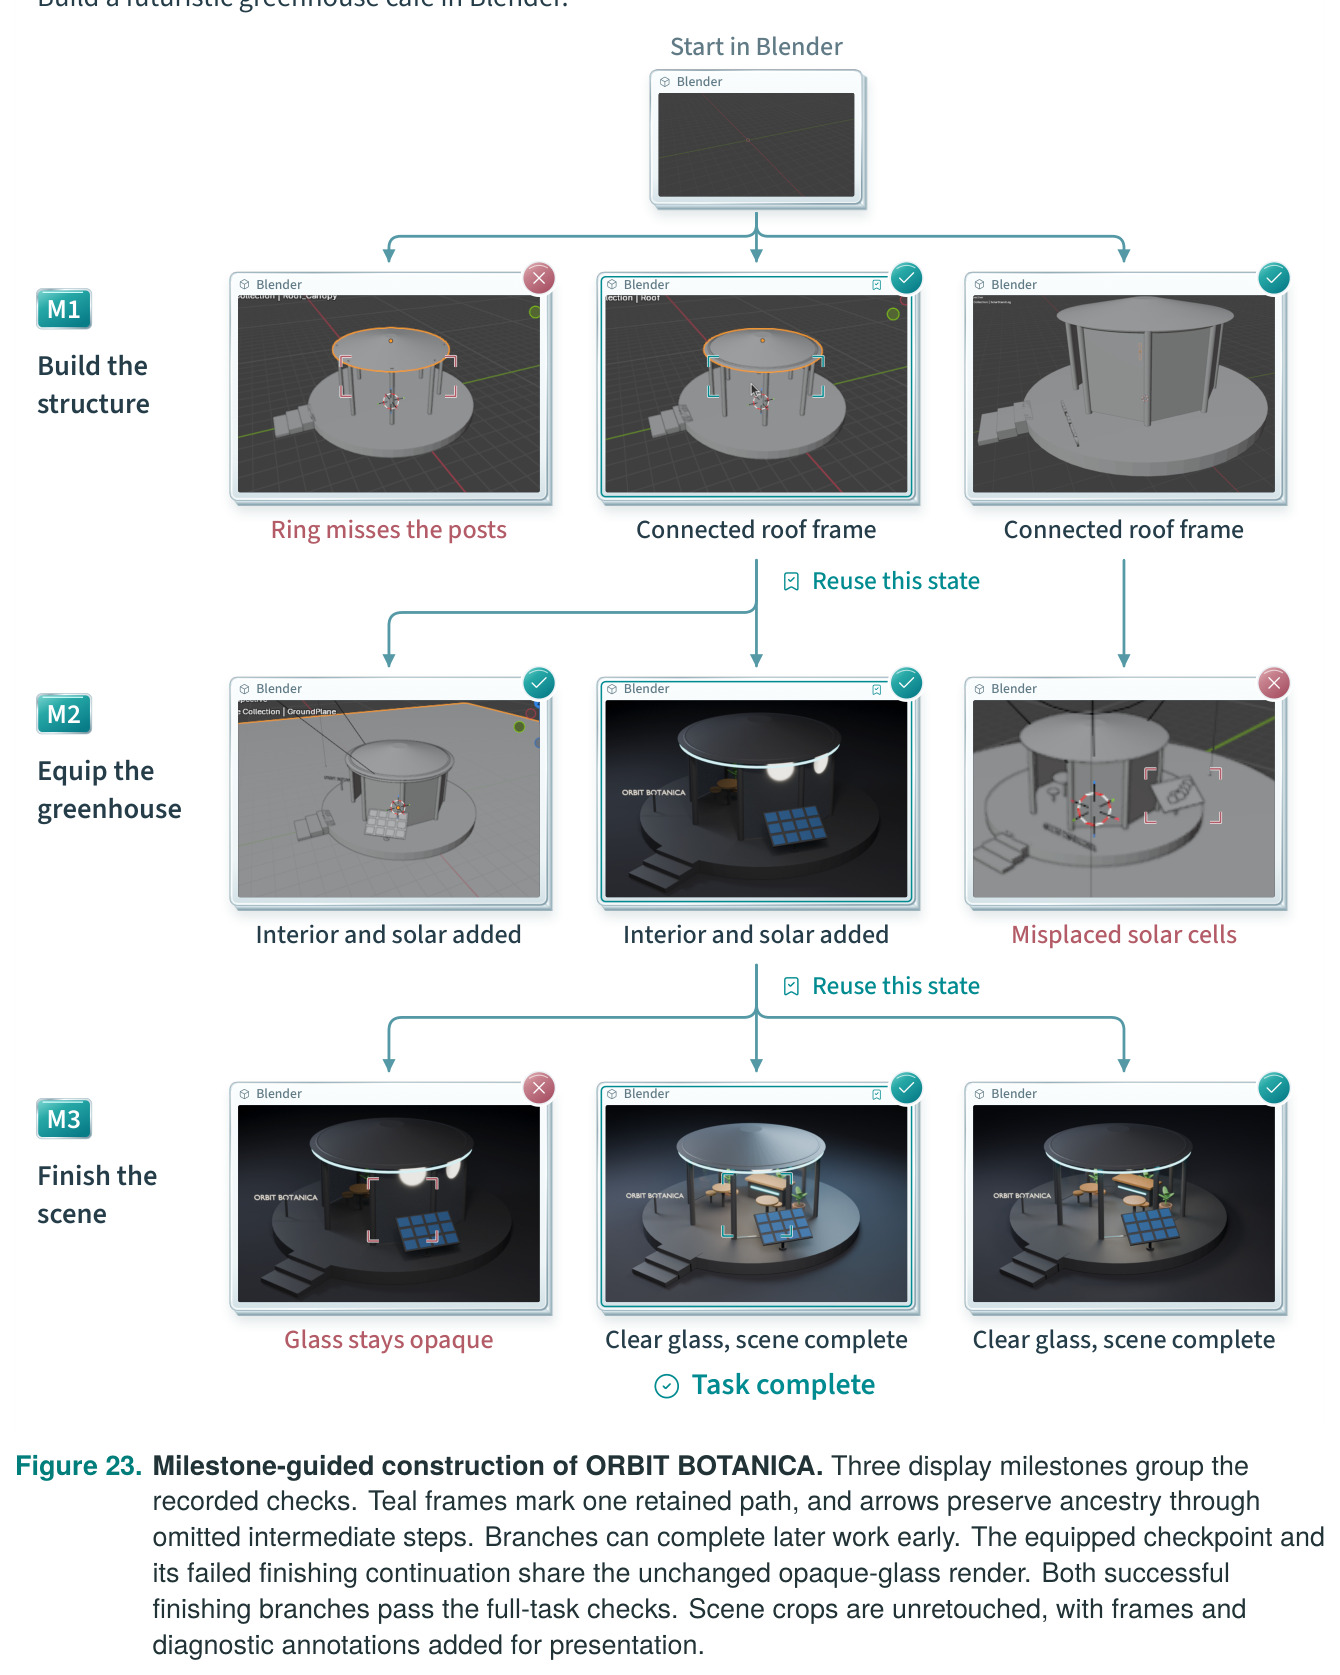
针对普通预算下解不出的难任务的两条采集管线:技能引导探索把试错发现固化为"何时用/怎么做/怎么验证"的文本技能,先由独立智能体验证再投入使用;里程碑引导搜索把长任务分解为可检查的中间目标,通过的子目标连同 E2B 工作区快照与智能体上下文存为检查点,后续尝试从检查点分支续采(类似 Go-Explore 的"回到有希望的状态再探索")。
这是本文获取最难任务演示的独特手段,理解检查点与技能的沉淀-验证-复用循环,才能理解其长程 SFT 数据从何而来。
E2B 沙箱与批量 rollout 服务
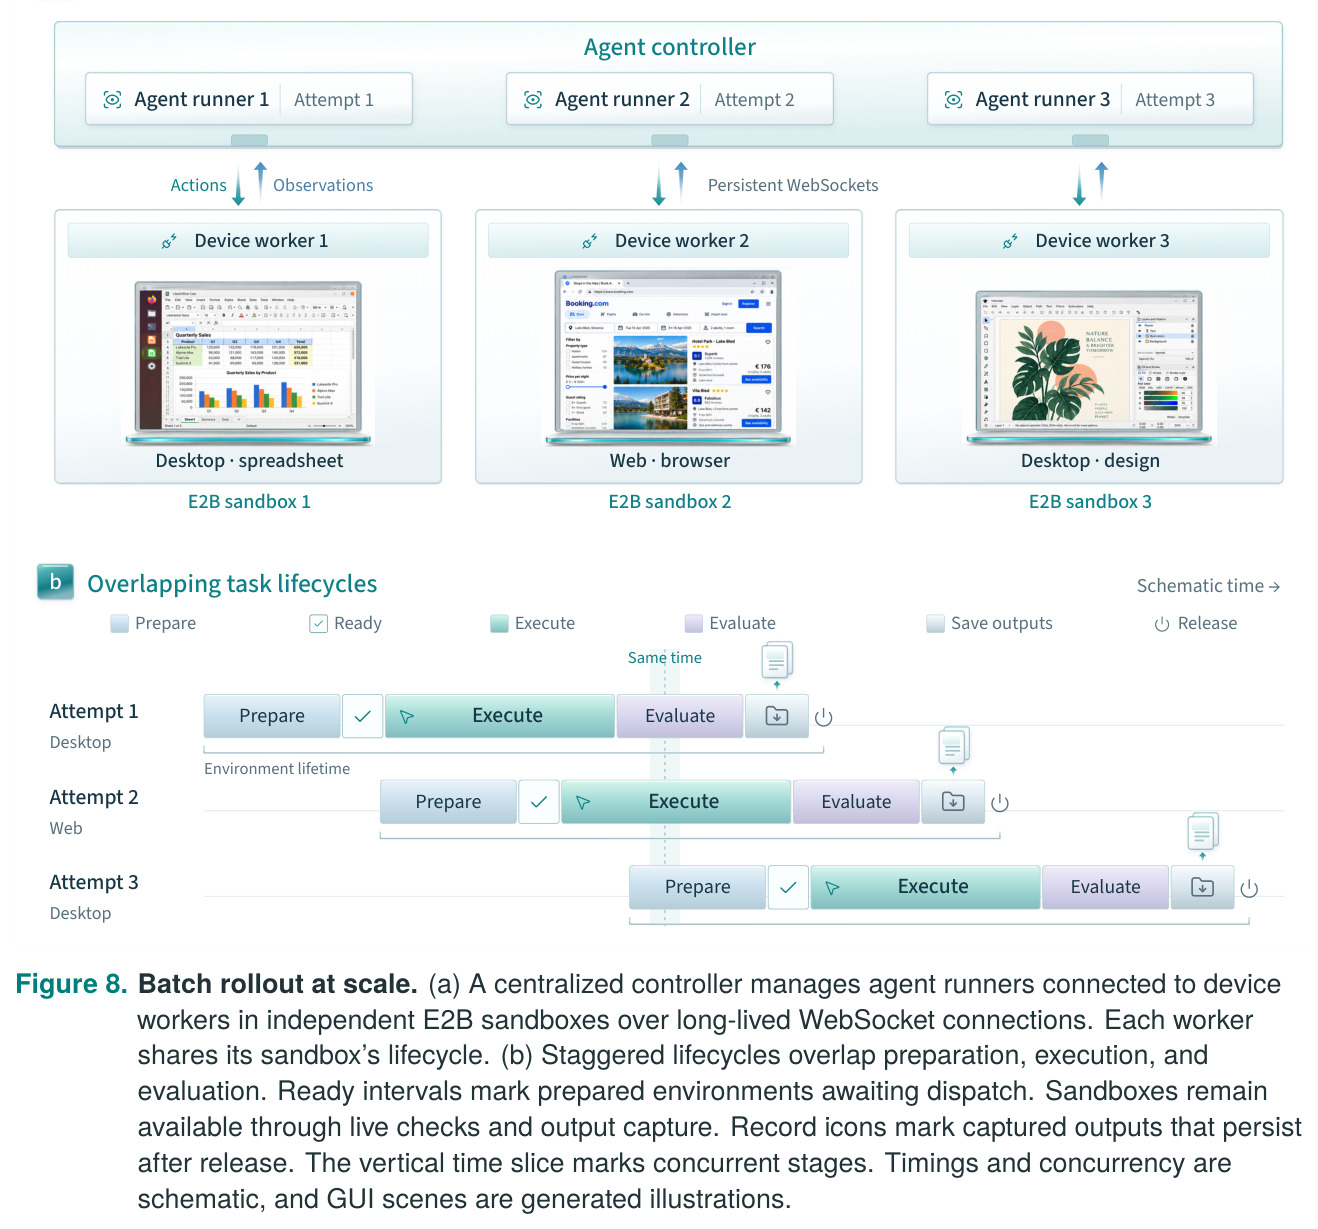
E2B 是隔离的云端沙箱运行环境(带桌面扩展),每个任务尝试获得独立初始化的工作空间,互不污染;本文的 Batch Rollout Service 用中央控制器+每任务一个设备 worker(长连 WebSocket)的方式并行管理成百上千个沙箱生命周期,准备、执行、评估三阶段流水线化重叠,并做阶段级并发限制与故障恢复。
CUA 的经验采集与 RL 训练都以海量隔离环境为物质基础,论文的工程指标(如 110.9 GiB→2.7 GiB 的图像压缩)都发生在这一层。
研究动机
计算机使用智能体(CUA)要把自然语言目标变成跨应用、多步骤的真实软件工作,而训练它需要的"经验"必须把一次次决策与完整任务结果连起来,这种经验在大规模获取上有三重困难。其一,任务构造难:每个可执行任务需要三件套齐备——有依据的请求、可用的初始软件环境、可靠的成败判据,缺一不可,而公开资源往往只提供其中一两件。其二,长流程执行难:真实工作(如从电子表格读数、填入文档、再导出 PDF)中后面的动作依赖前面发现的事实与约束,而重复的截图与工具反馈让上下文迅速膨胀,早期信息极易丢失;失败尝试的中间成果若不保留就只能全部重来。其三,可验证监督稀缺:SFT 演示只能覆盖演示中出现过的状态,策略自主执行会进入演示之外的状态,必须靠新鲜交互与结果反馈继续改进。结果就是差距明显:本文写作时开源 CUA 在 OSWorld-Verified 上最好成绩仅约 80.5%(UI-Venus-2-27B)、OpenCUA-72B 只有 45.0%,与闭源通用大模型和 Qwen-CUA(86.2%)差距大;而最难的桌面/3D 类任务在普通预算下反复尝试常常无法完成。已有工作要么只解决单点(grounding、单一采集路线),要么把任务、执行、评估、学习割裂在不同系统中,无法形成持续改进的闭环。
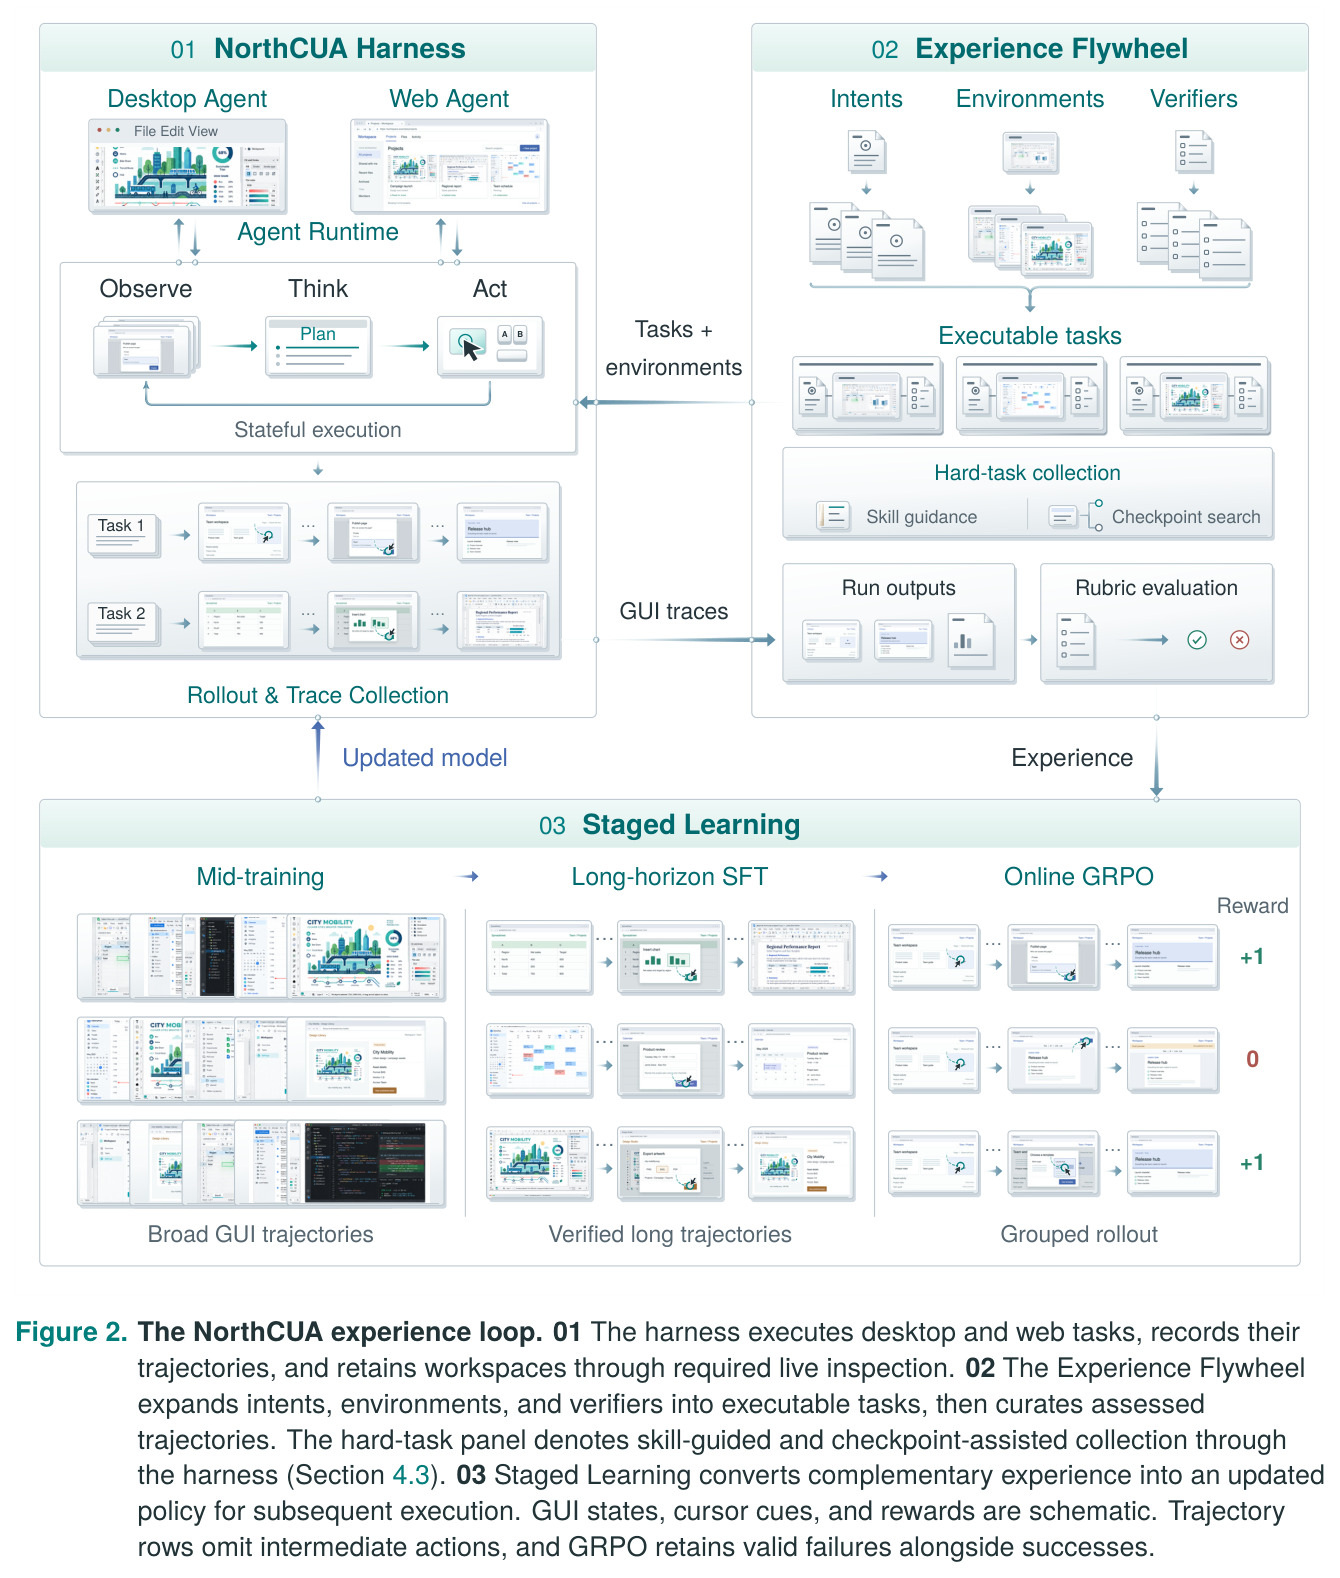
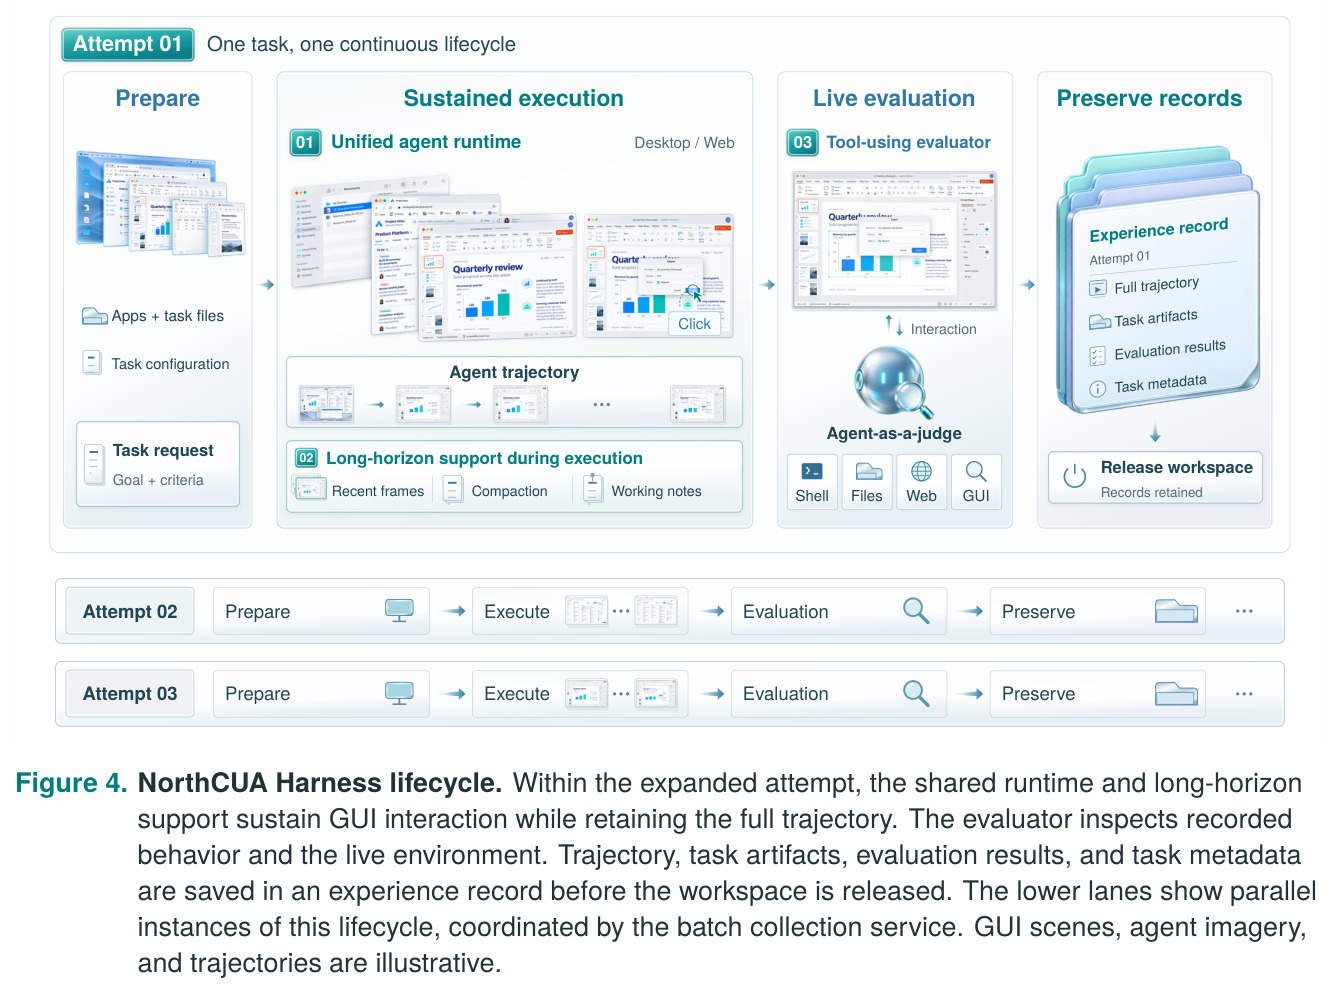
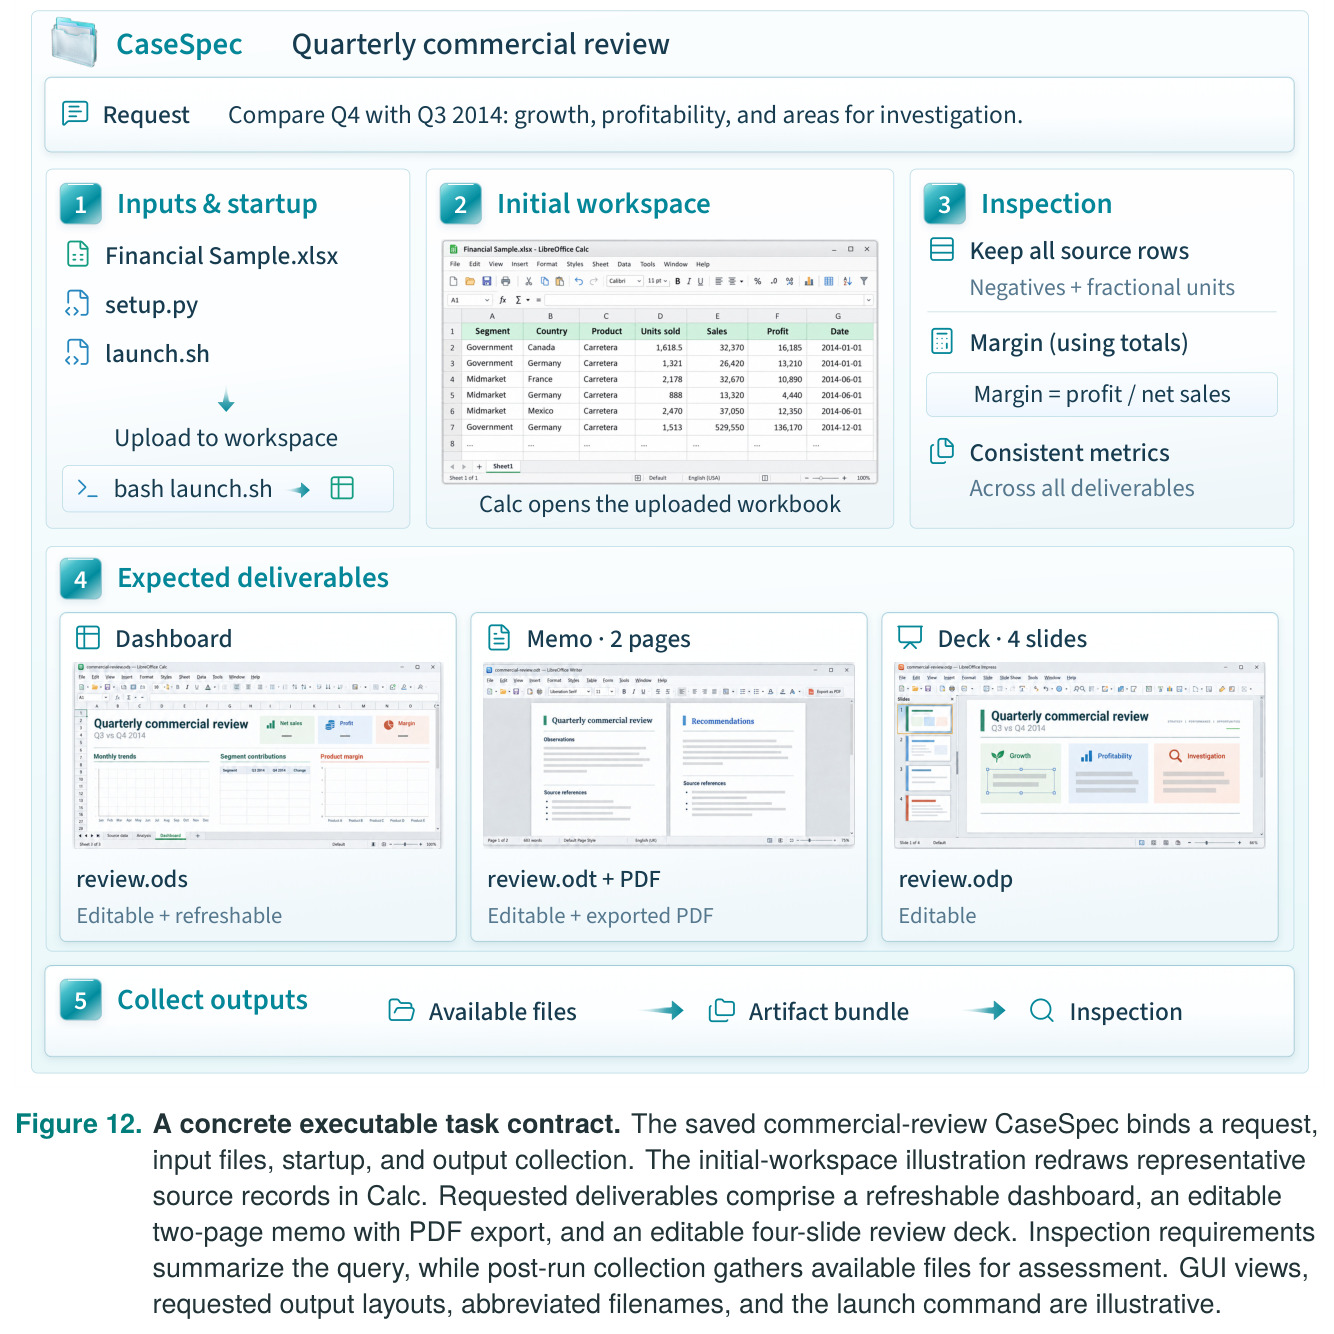
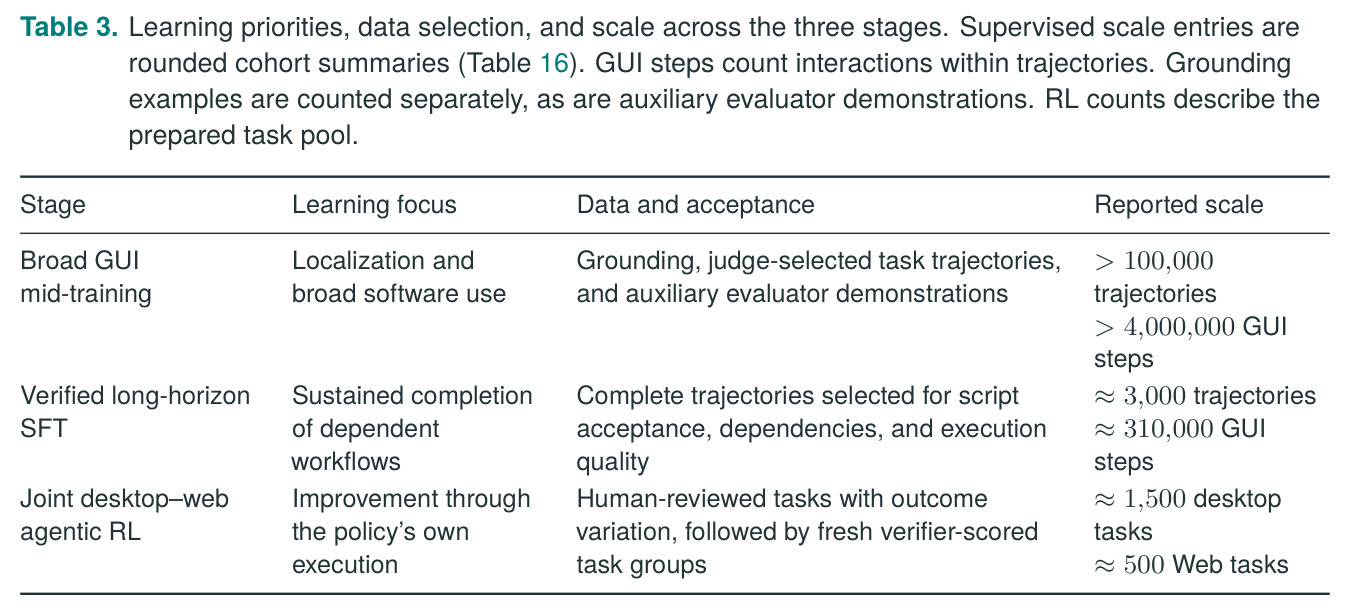
本文的目标是本文要构建一个把"经验的生产"与"经验的使用"协同设计的完整系统 NorthCUA,具体目标分三层。基础设施层:设计全生命周期的 NorthCUA Harness,从环境准备、执行、评估到记录保存,把每个任务尝试变成可检查、可追溯的经验记录,并用批量服务高效并行化。数据层:用经验飞轮(Experience Flywheel)大规模构造两级监督——单步 grounding 样本(截图-查询-坐标)与经过评估筛选的完整任务轨迹,任务构造走 Scaling Intents(从软件与内容生成请求)、Scaling Environments(为 sourced 请求补建环境、从参考 URL 重建网站)、Scaling Verifiers(联动改编任务-验证器对)三条互补路线;对普通采集解决不了的难任务,用技能引导探索与里程碑引导搜索两条递归自我改进(RSI)管线补齐。学习层:通过"广度 GUI 中期训练(>10 万条轨迹、>400 万 GUI 步)→ 验证长程 SFT(约 3000 条经脚本验证的完整长轨迹)→ 桌面/网页联合 GRPO 强化学习"三阶段把经验转化为策略能力,最终让 Nano(9B)、Mini(35B/3B 激活)、Pro(397B/17B 激活)家族在 GUI 定位、桌面执行、Web 交互三类共六个基准上达到开源模型中的最优,并额外探索 Ultrafast 直接动作选择来降低长任务的决策时延。
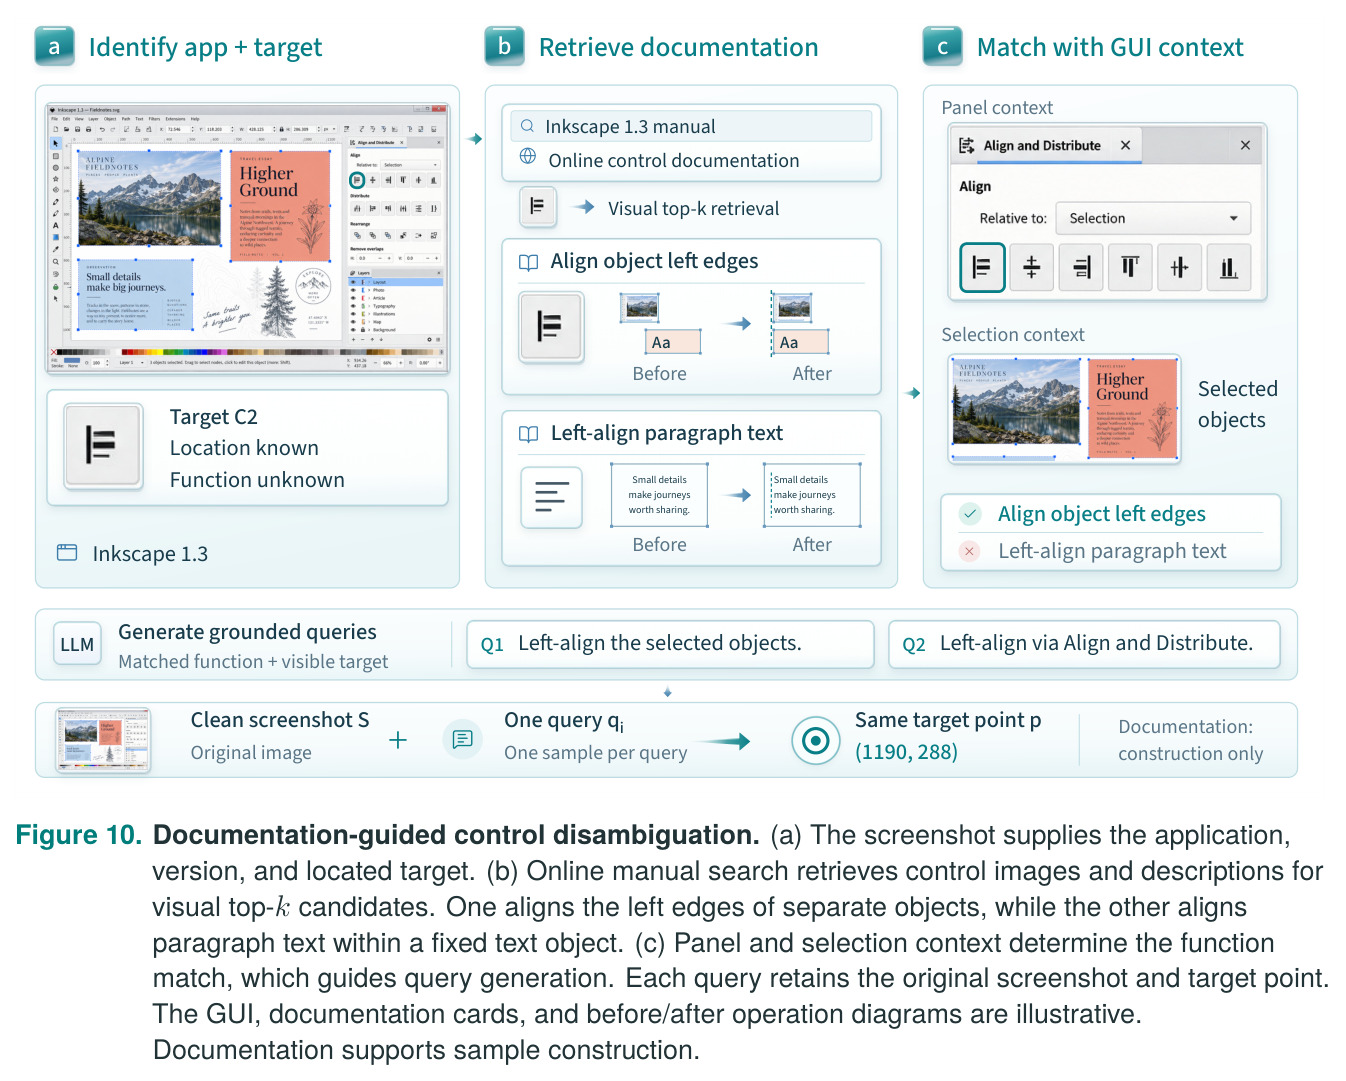
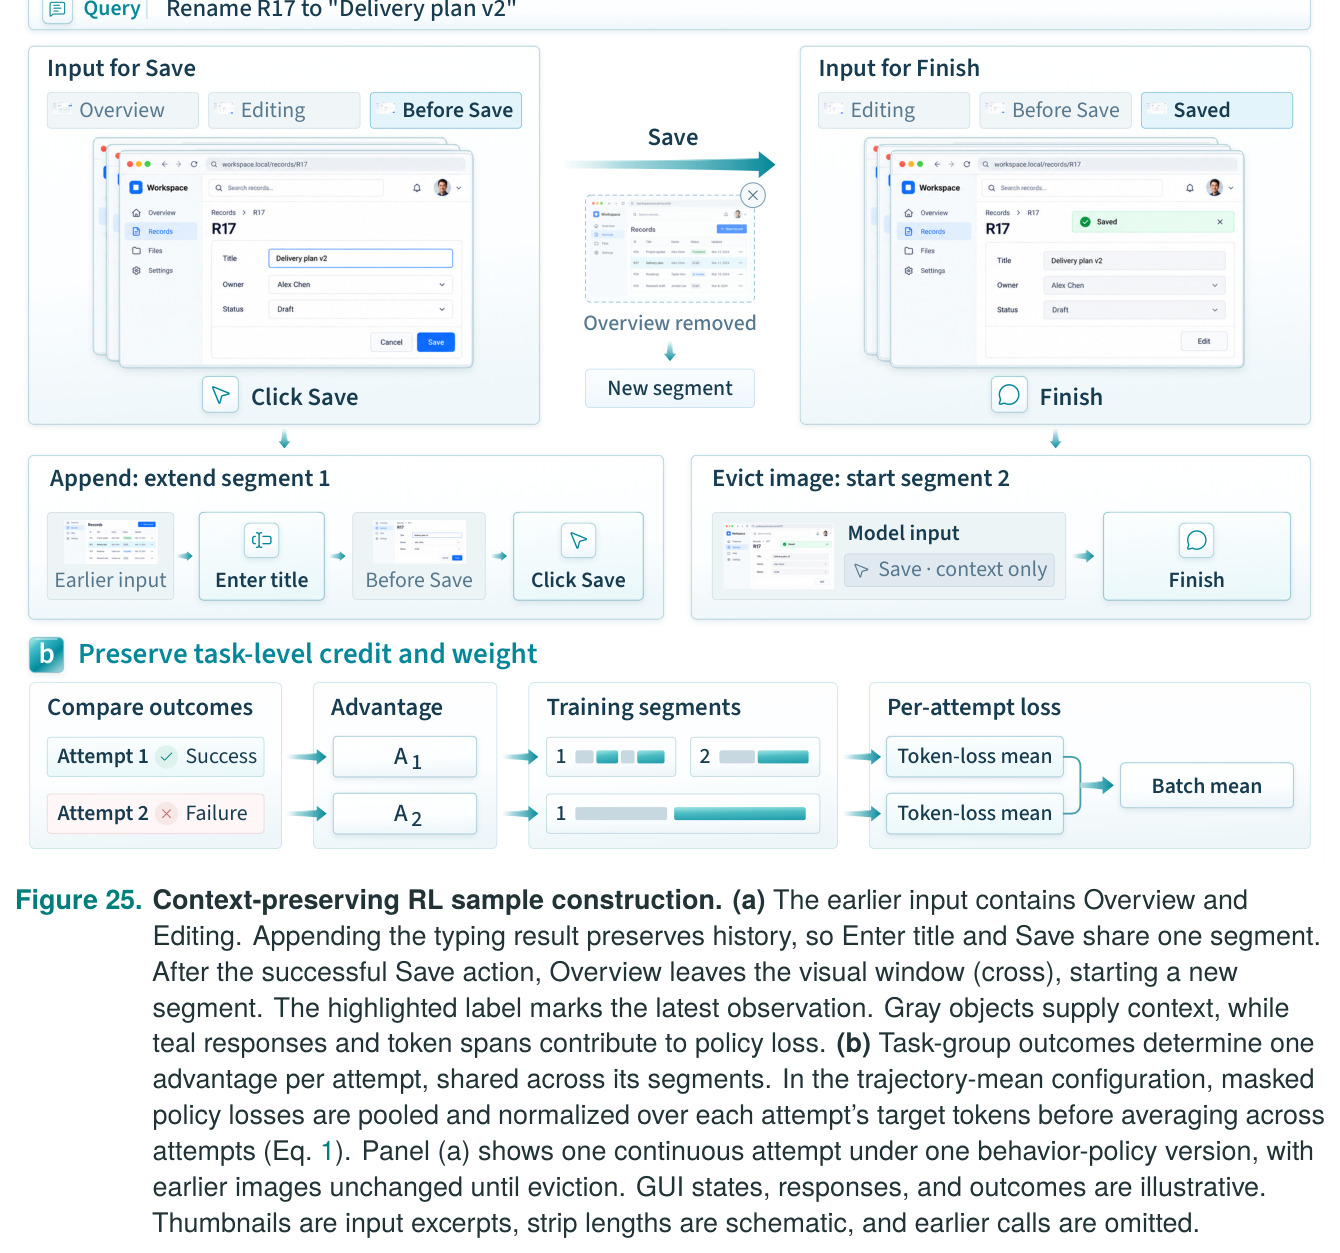
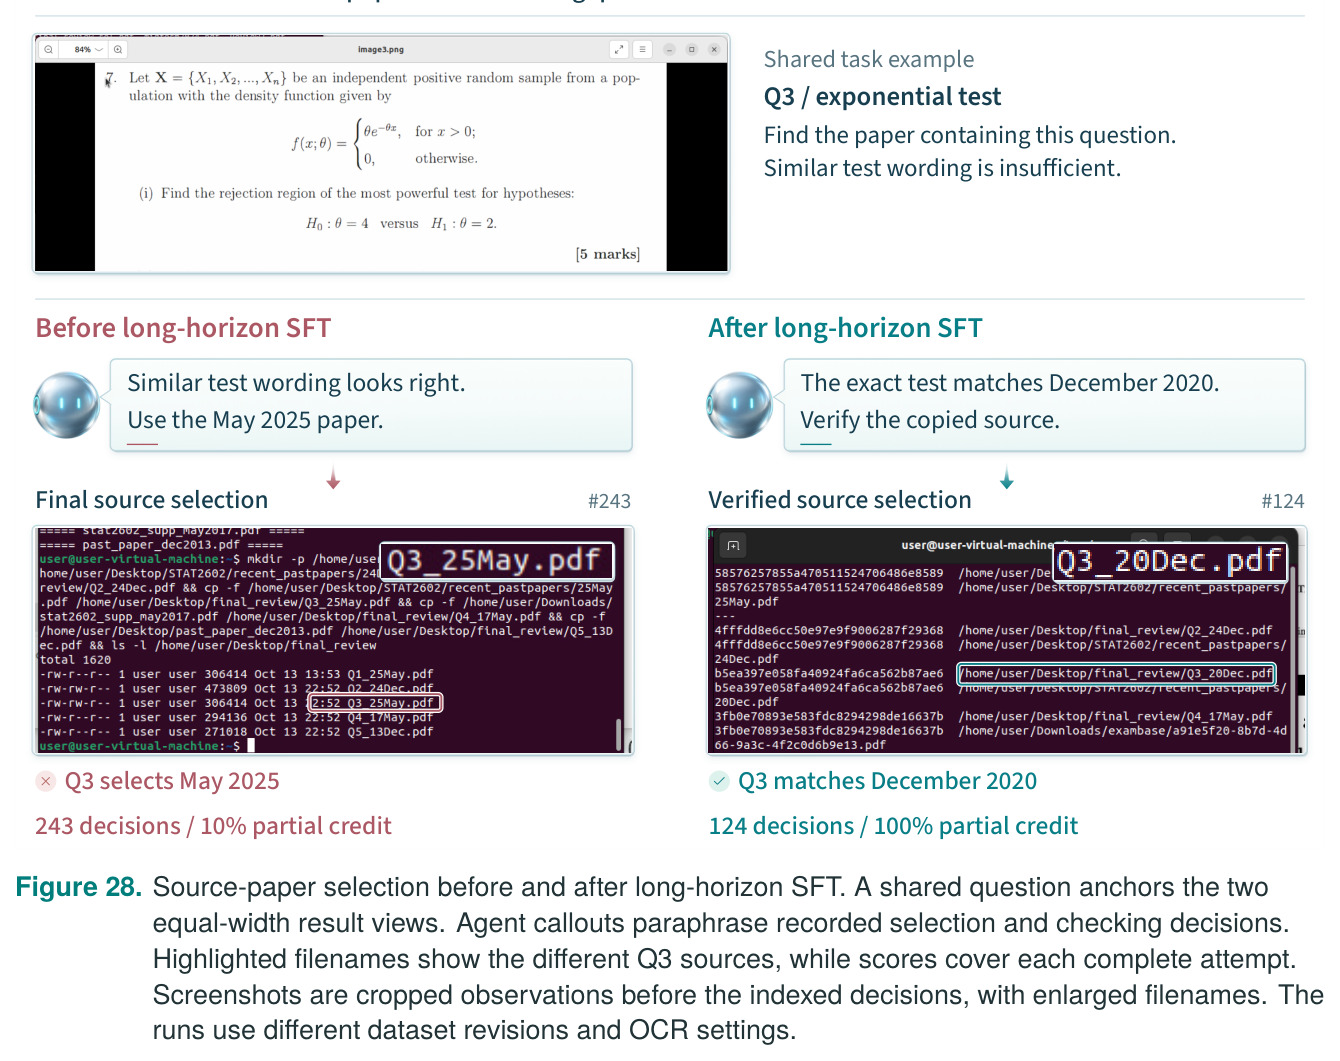
与已有工作不同的是,本文的独特切入角度是"协同设计经验的产生与消费",让软件交互本身成为持续的学习来源,而不是把采集与训练当成两个独立工程。具体体现在四个别人没有同时做到的点。第一,同一套接口贯穿始终:任务用统一的 CaseSpec 契约(请求+输入材料+环境配置+验收要求)表达,执行与评估共用同一 Harness 运行时,于是 SFT 数据采集与在线 RL 在同一基础设施上闭环——策略更新后可以回到同一个 Harness 继续采集新经验。第二,grounding 数据引入"文档锚定的功能定位":现有管线只解决"控件在哪",本文用官方手册检索+图像嵌入 top-k 候选+GUI 上下文匹配来解决"这个控件是干什么的",专门处理长得一样但功能不同的控件(如 Inkscape 中对齐对象与对齐段落的同形图标)。第三,难任务的双积累 RSI:技能线保留"经过验证的操作知识",里程碑线保留"经过验证的软件状态+决策上下文",且最终验收始终绑定原始任务验证器,失败分支不会拼接进成功轨迹。第四,RL 样本构造显式保留"决策时输入":图像被动作叠层替换或淘汰、历史被压缩、策略版本变更时开启新训练 segment,但整个 attempt 共享同一优势与权重,防止上下文管理改变学习问题本身。
核心方法
直觉上,软件操作能力由三层叠加:界面熟悉度(哪里有什么控件、一个动作会产生什么效果)、长流程完成度(把早期发现的事实与约束带到后期决策、出错后恢复)、以及结果驱动的改进(从自己尝试的成败中学习)。NorthCUA 的技术路线就是按这个递进组织的三阶段学习。第一阶段 Broad GUI mid-training 用飞轮产出的广泛经验打底:超过 10 万条轨迹、超过 400 万个 GUI 交互步骤,覆盖几十个应用与数百个操作族,另加约 4 万条单步 grounding 样本,还混入评估器轨迹教模型如何查证结果。第二阶段 Verified long-horizon SFT 收敛到约 3000 条、约 31 万 GUI 步的精选长轨迹,每条都必须通过可执行任务验证器、且后续动作确实使用了早期结果。第三阶段是桌面+网页联合 GRPO 强化学习:任务池约 1500 个桌面任务+500 个网页任务,先用 SFT 策略对每个候选任务跑至少 5 次 rollout,只保留"结果有差异"的任务进入训练。支撑这套学习的是两大系统:NorthCUA Harness(共享 ReAct 运行时、动作感知视觉上下文、任务保持压缩、结构化工作记忆、agent-as-a-judge 评估器、批量 rollout 服务)负责把任务变成带证据的经验记录;经验飞轮负责持续供给任务与数据。所有空间坐标统一表示为 $[0,1000]$:原图宽 $W$ 高 $H$ 的像素 $(x,y)$ 归一化为 $(1000x/W,\ 1000y/H)$,使模型在不同分辨率下有一致的坐标约定。
核心创新是把"可执行任务 → 可检查经验 → 策略更新"做成一个飞轮,让每次软件交互都同时是采集、评估和学习的素材。与已有工作的本质区别有三。其一,经验质量由"证据链"保证:评估器像审计员一样工作,先检索已保存的轨迹与产物(E1 记录导出动作已发出),再做活体检查(E2 确认文件存在,E3 打开 PDF 与源表逐项比对),每条判据必须绑定证据、不确定性和评估器自身操作;rubric 把"任务完成度"与"过程质量/效率/副作用"分开打分,使不同数据用途可以设不同阈值(教恢复的数据可以保留有用的纠错探索)。其二,难任务的知识+进度双积累:技能线把试错发现固化成三段式文本技能(何时用/怎么做/怎么验证),必须经独立智能体在独立环境中验证后才上岗(如 PDF 导出技能要真的导出并搜到源文档短语);里程碑线把通过的子目标连同 E2B 快照与智能体上下文存为检查点,续采从检查点分支探索,失败的兄弟分支保留父节点供再试,最终必须通过原始验证器才算完整演示。其三,RL 的样本保真:Experience Adapter 记录每次模型调用的输入、响应、生成 log-prob 与行为策略版本,只有当文本+有序图像历史(图像以内容摘要为身份)构成确认的前缀扩展时才合并 segment;损失用轨迹均值归一化 $\mathcal{L}=\frac{1}{N}\sum_i\frac{\sum_{s\in S_i}\sum_t m^i_{s,t}\ell^i_{s,t}}{\max(1,\sum_{s\in S_i}\sum_t m^i_{s,t})}$,使分段次数不改变该次尝试的学习权重。
方法步骤详情
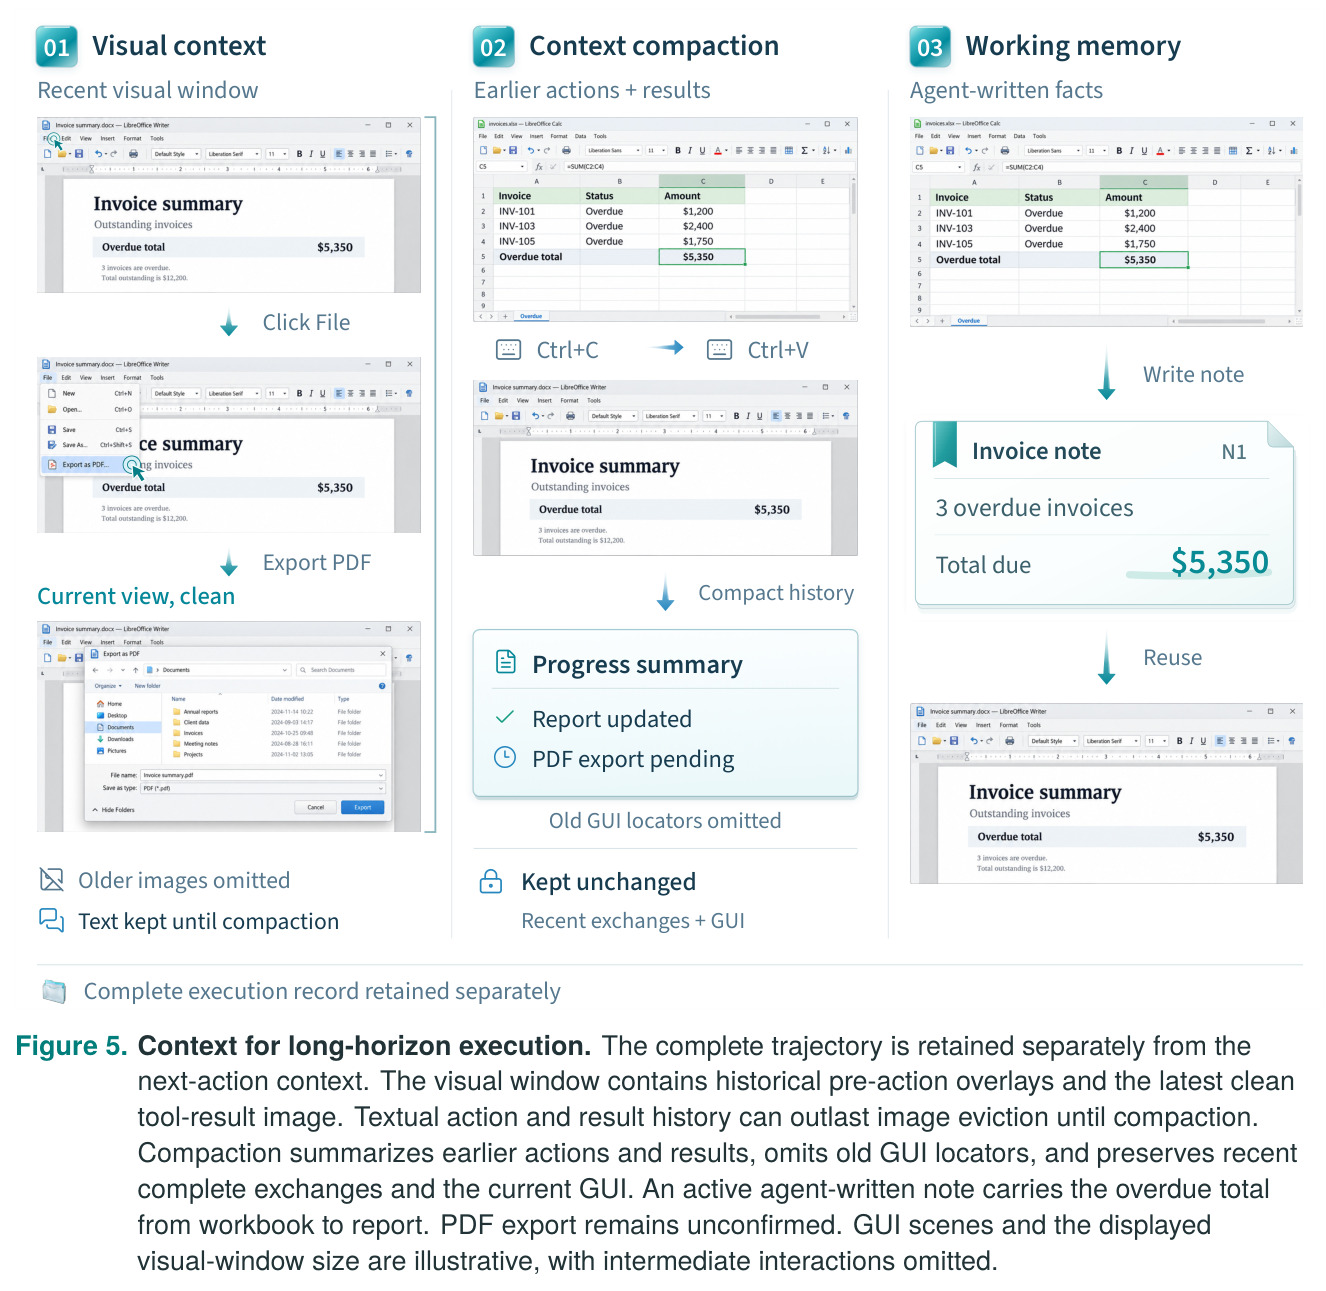
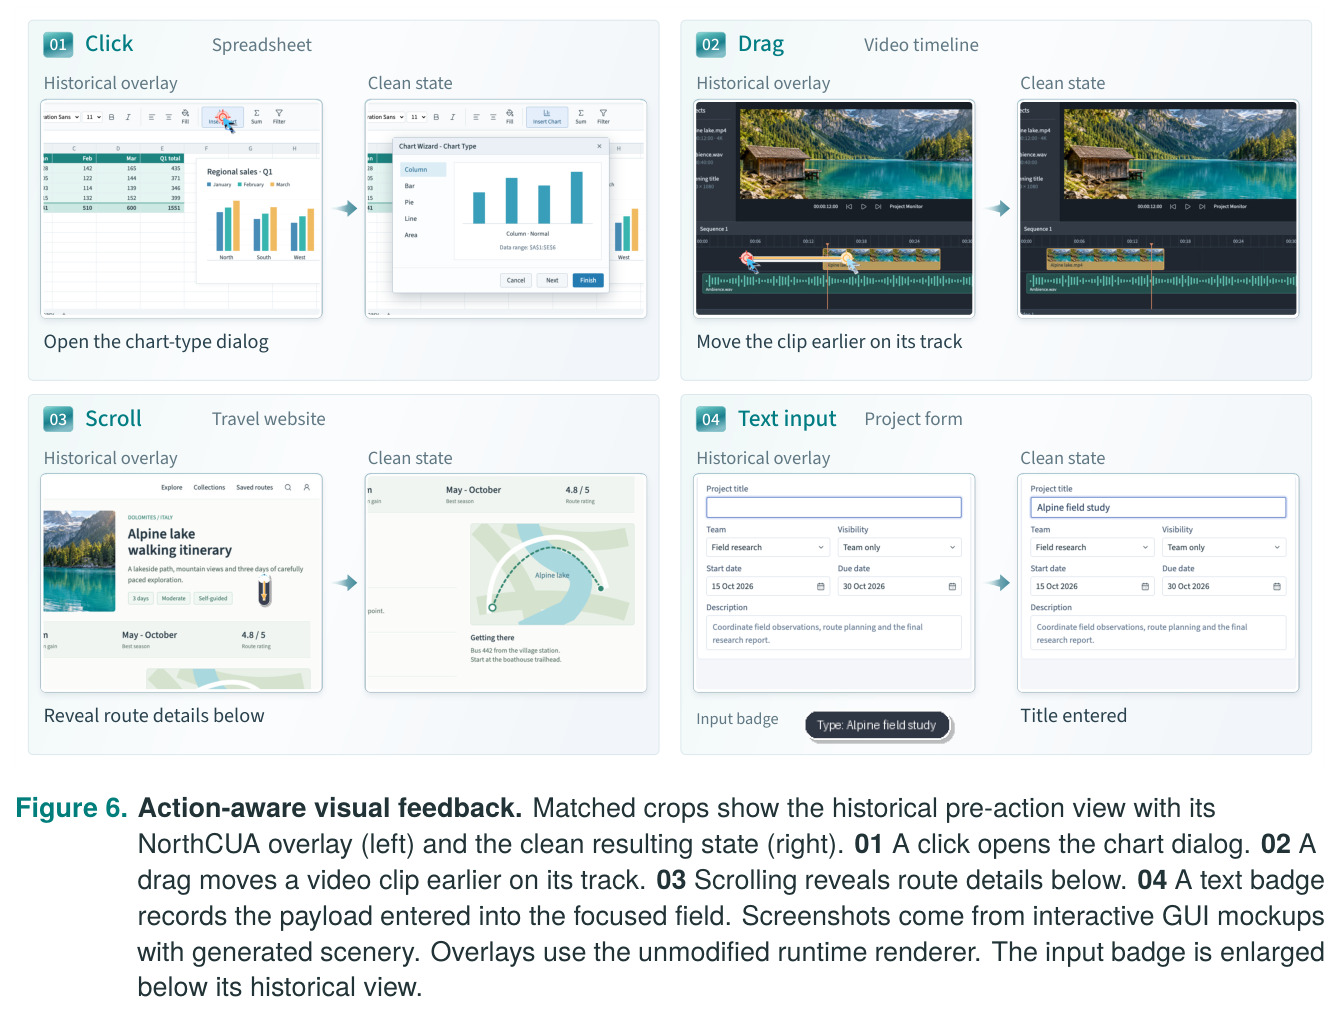
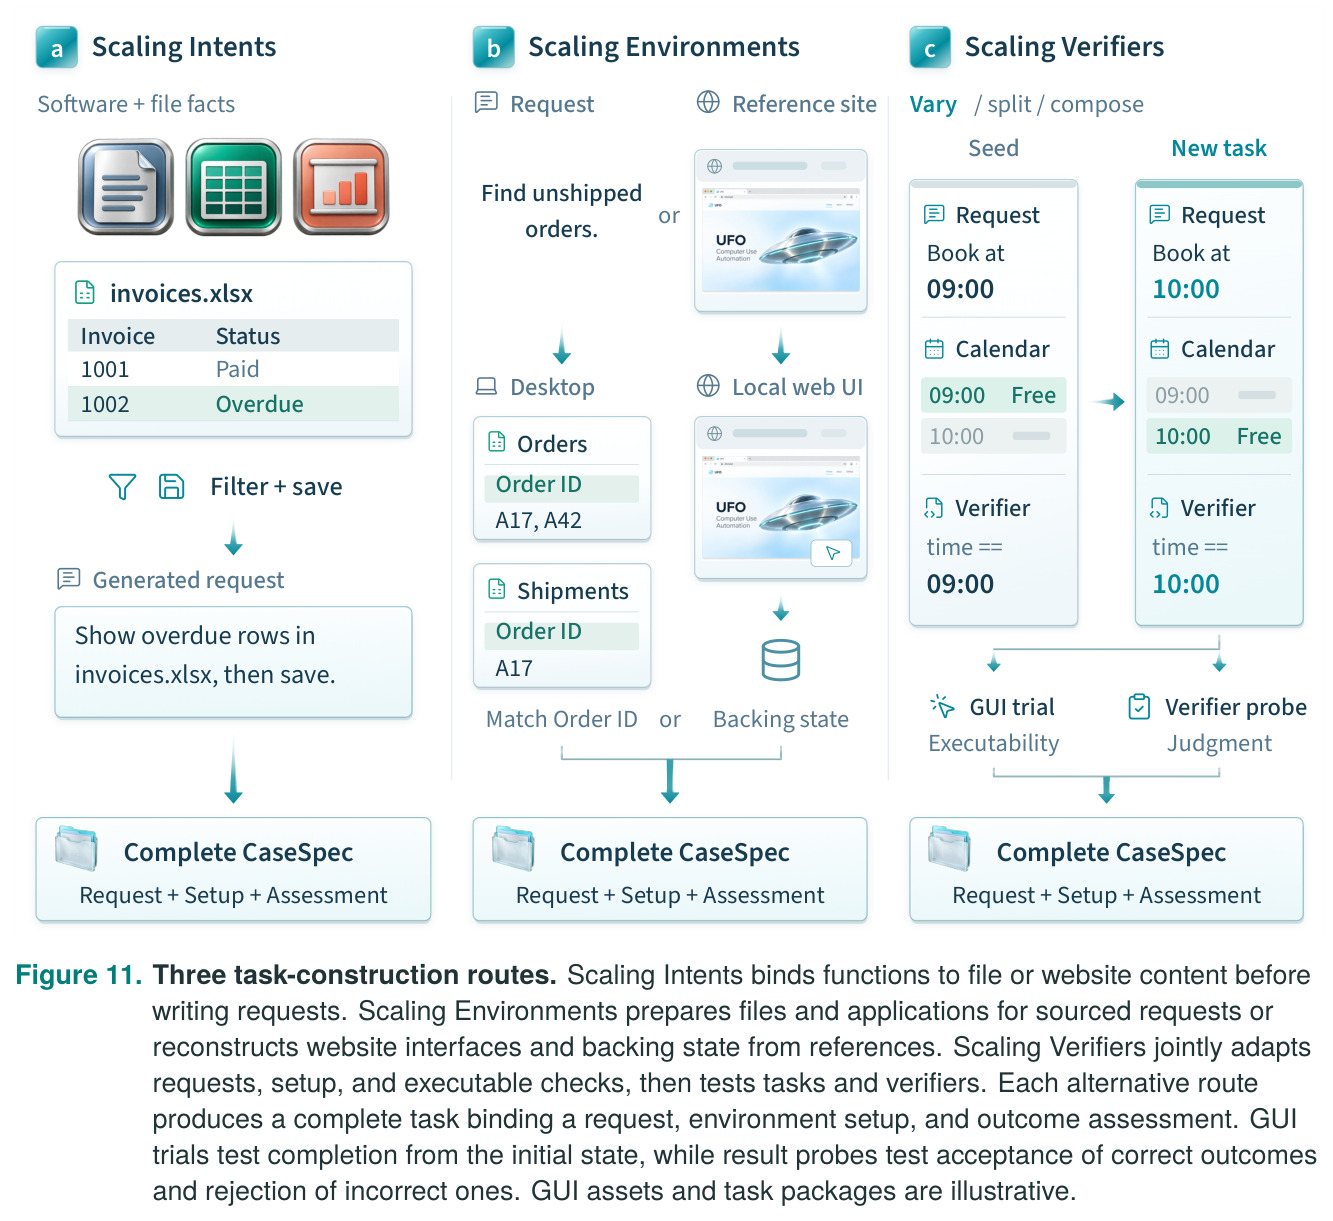
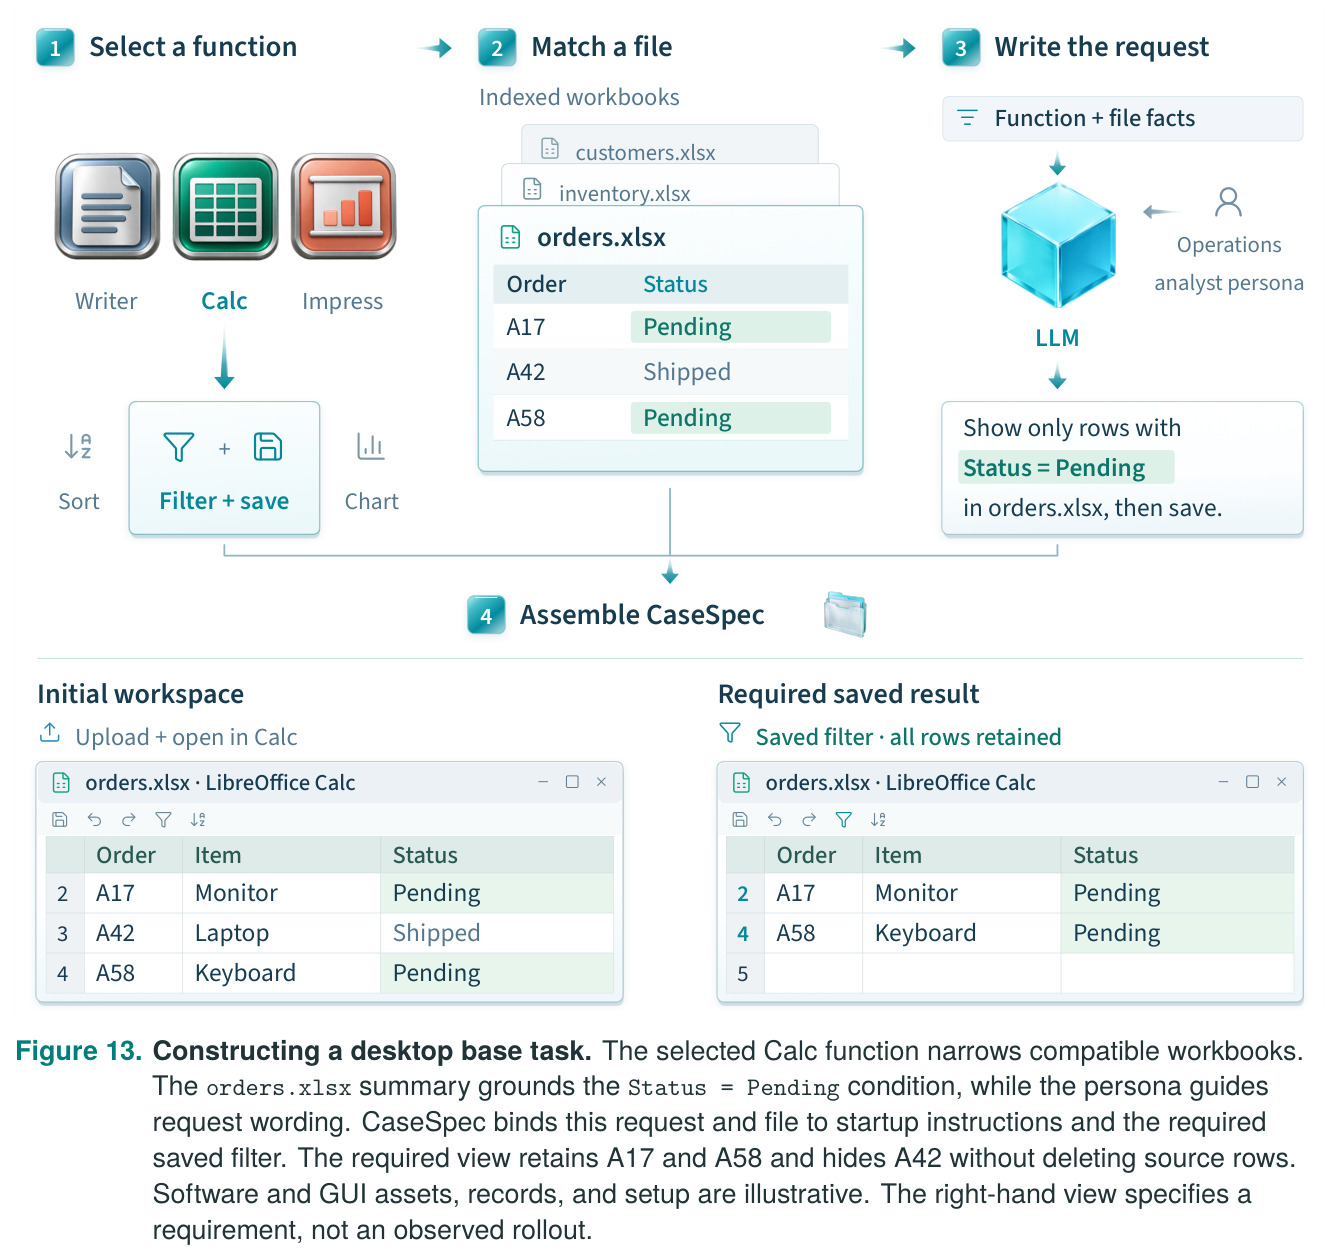
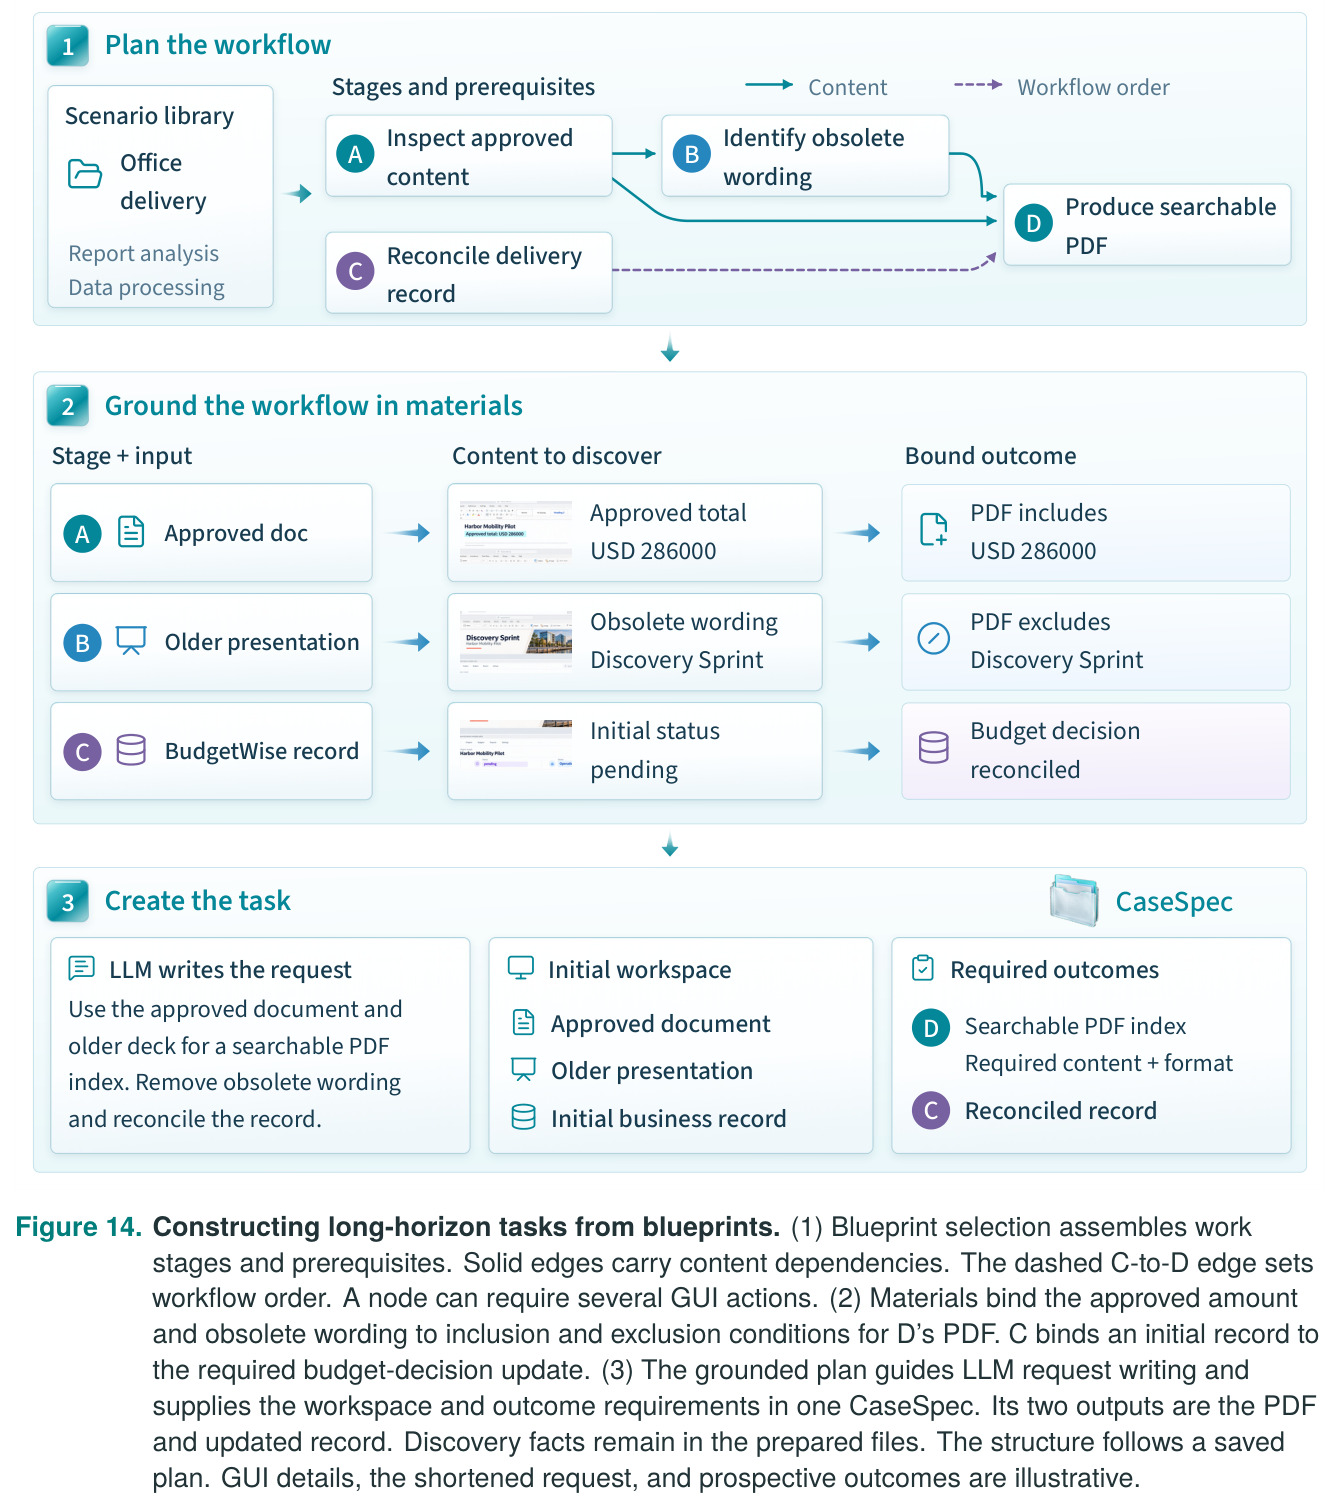
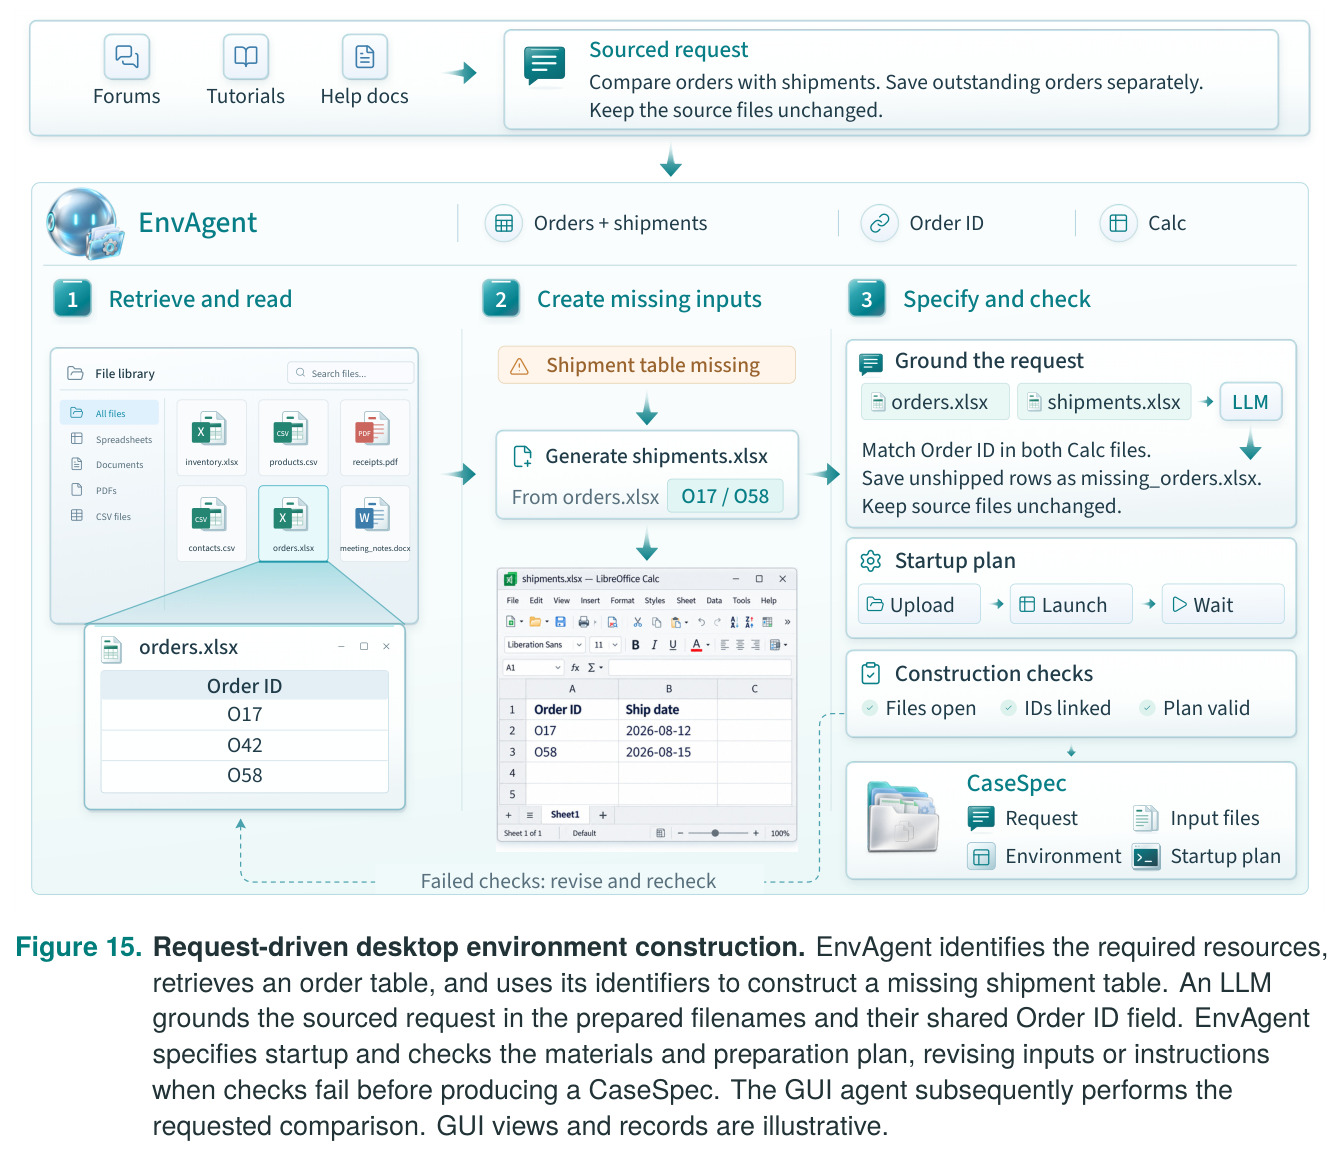
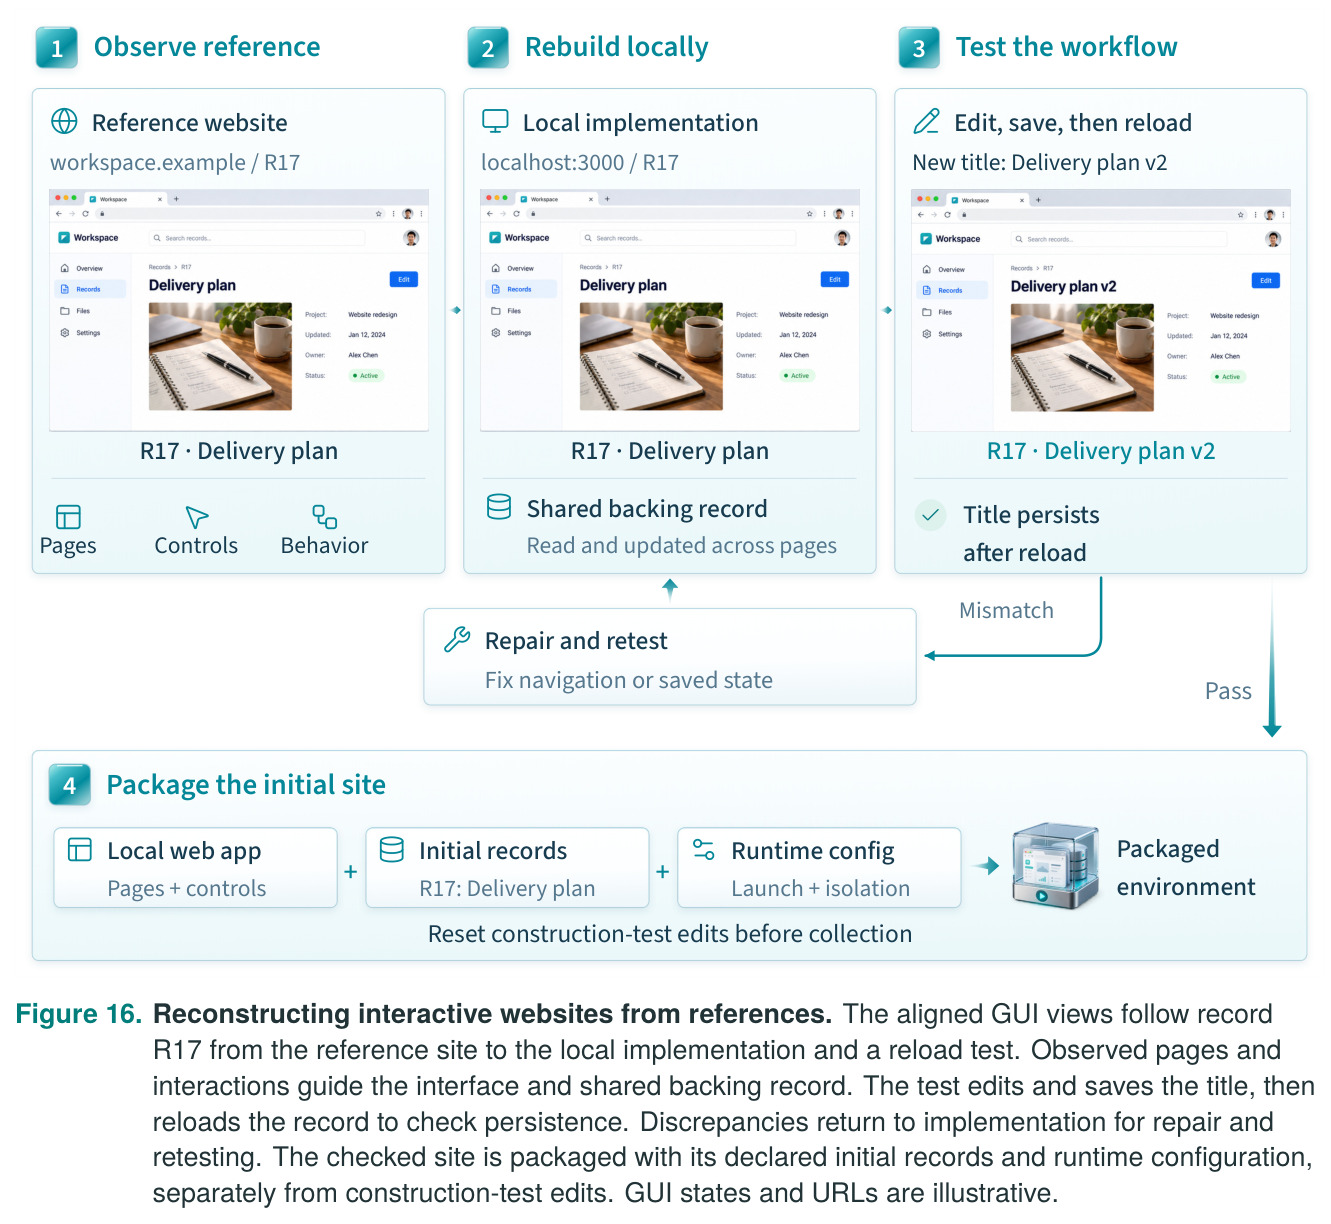
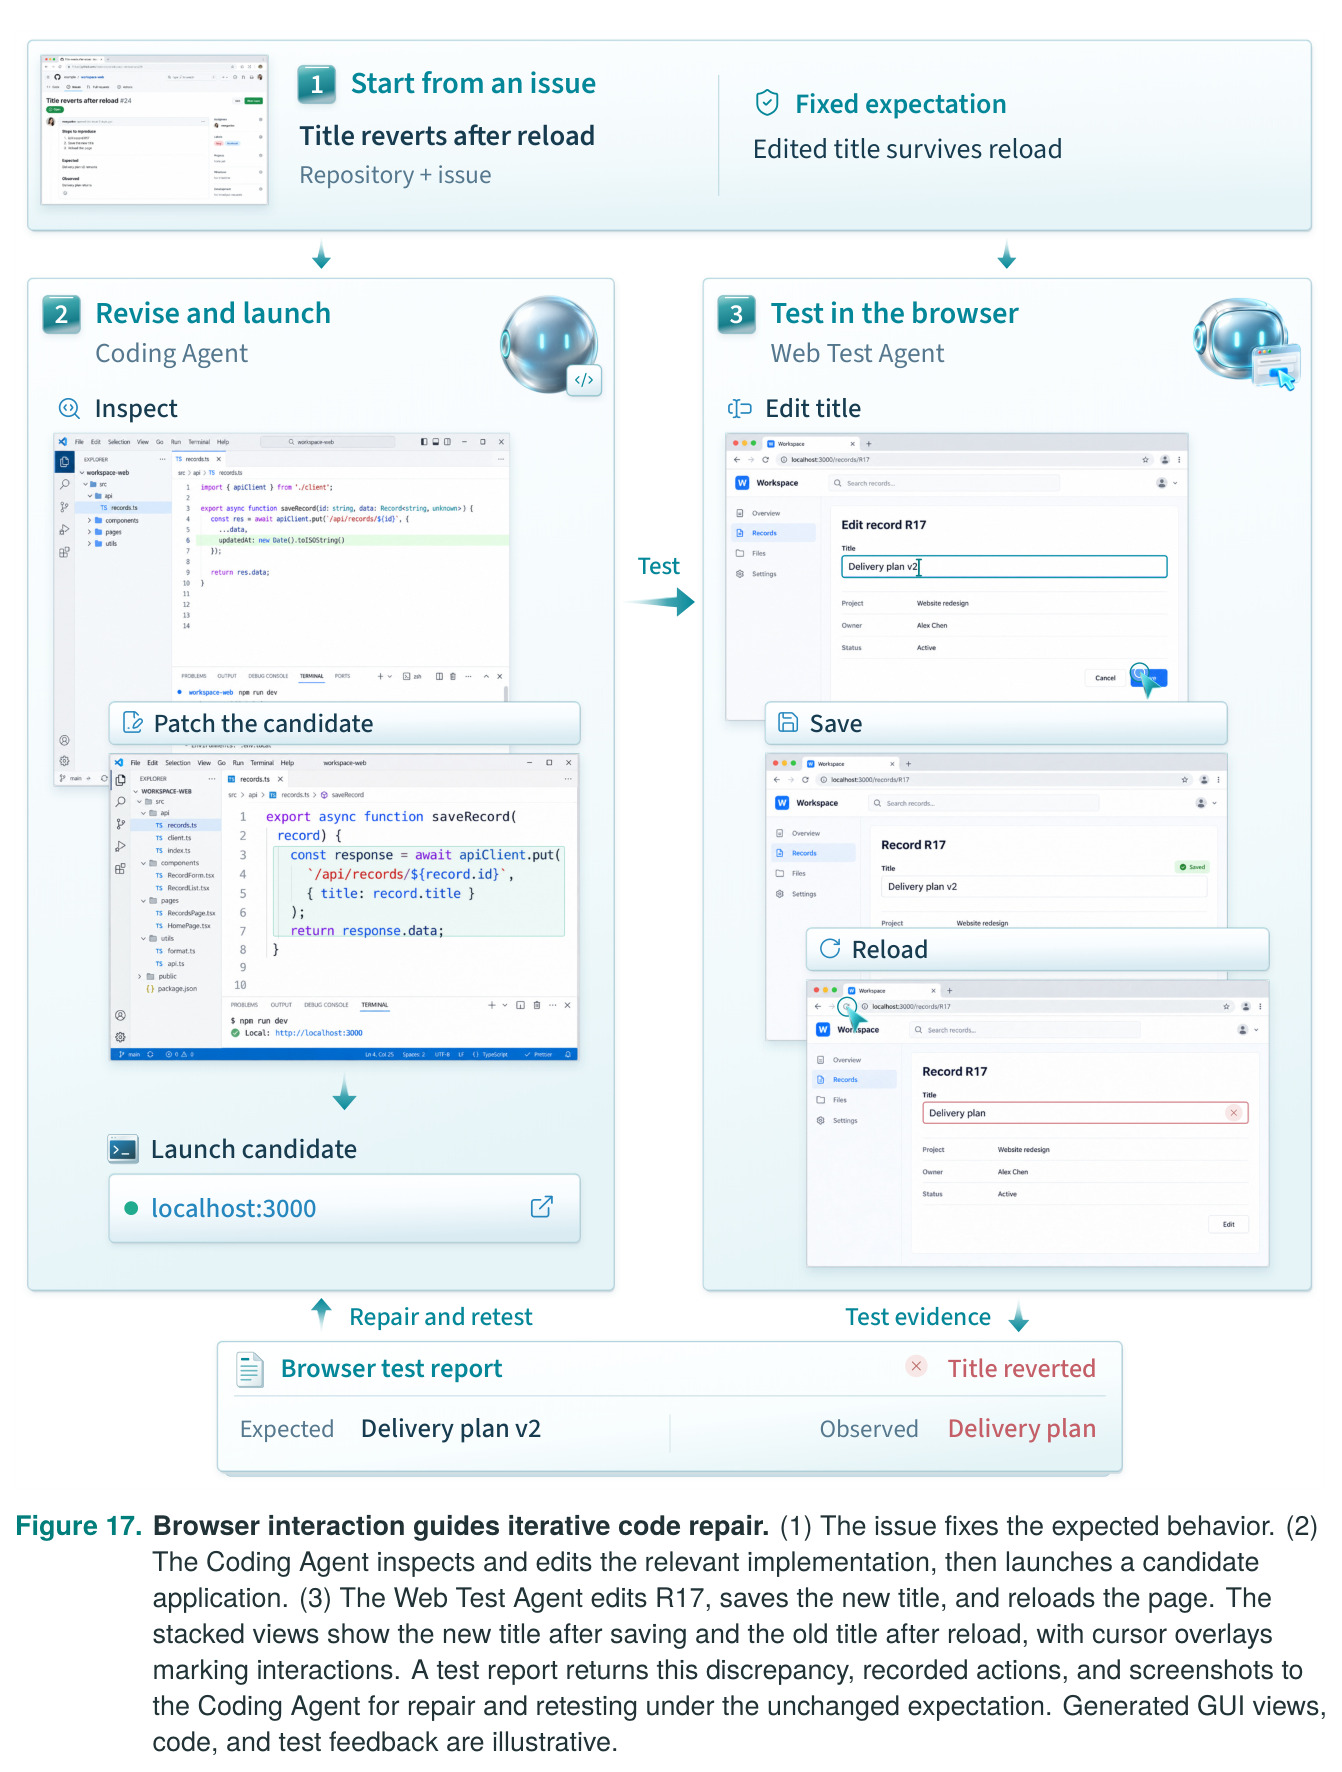
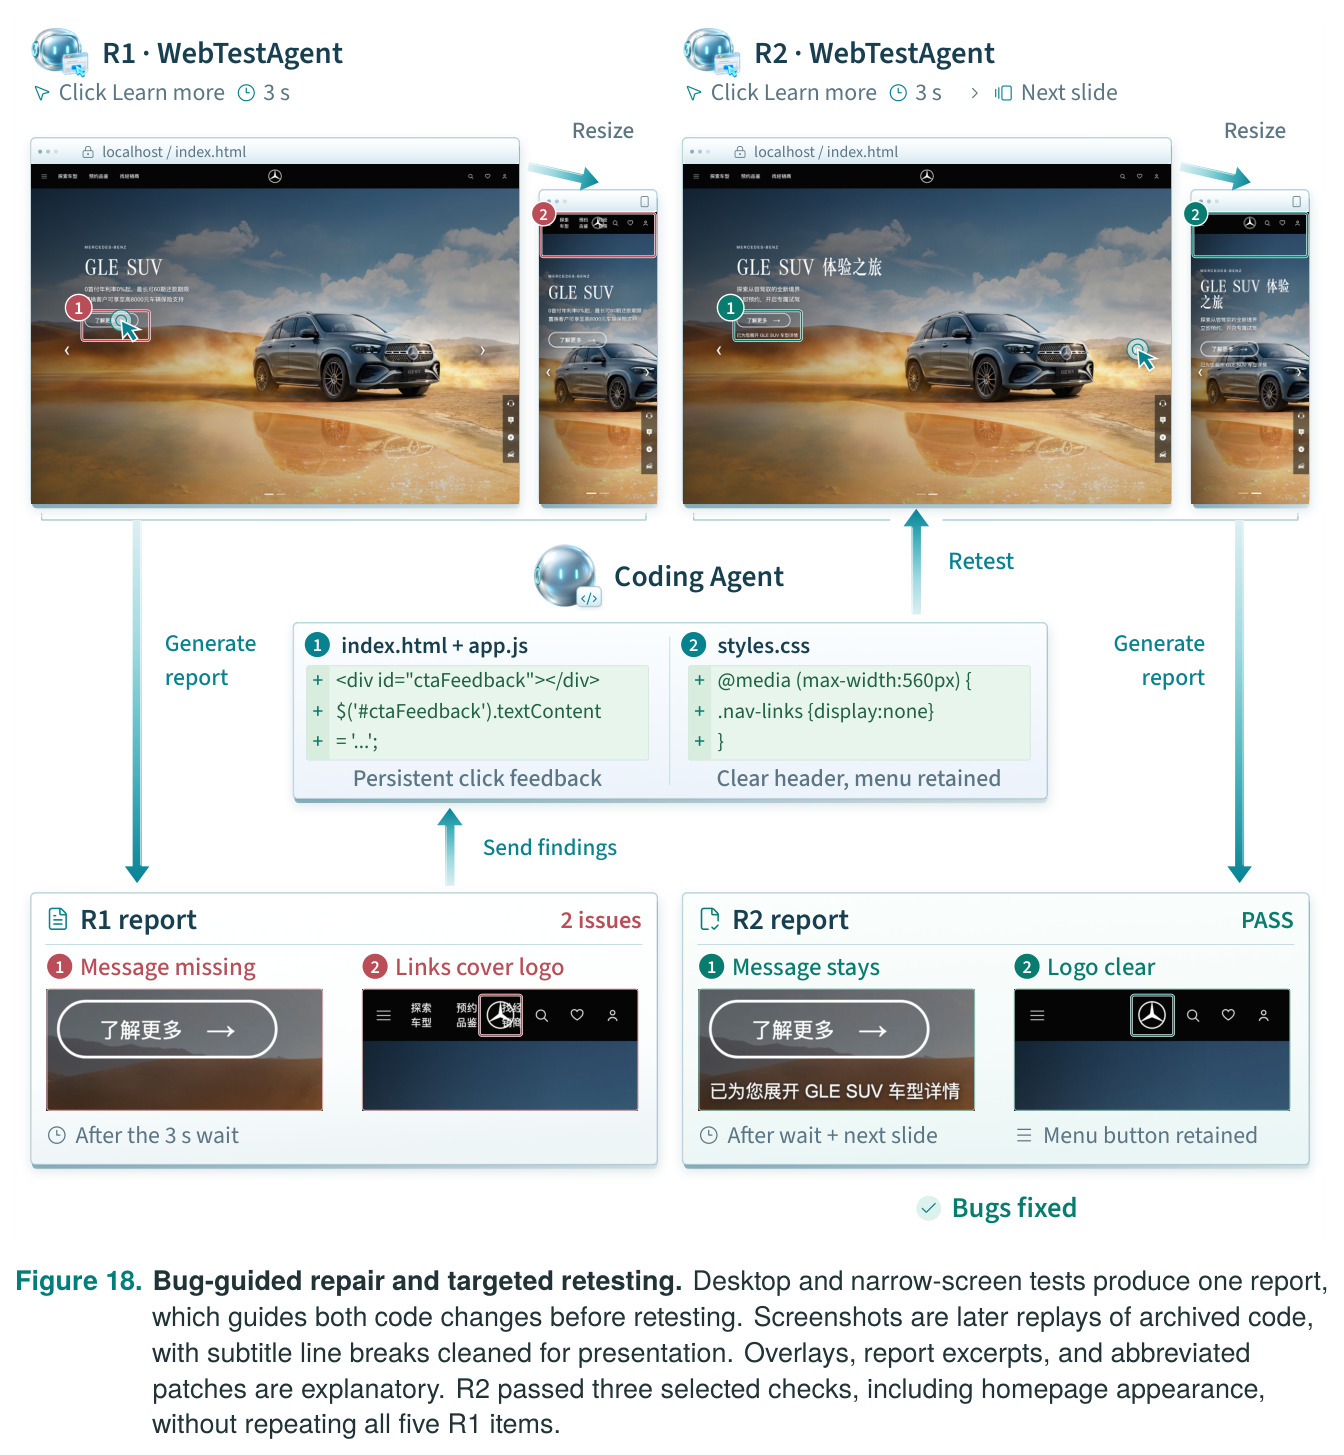
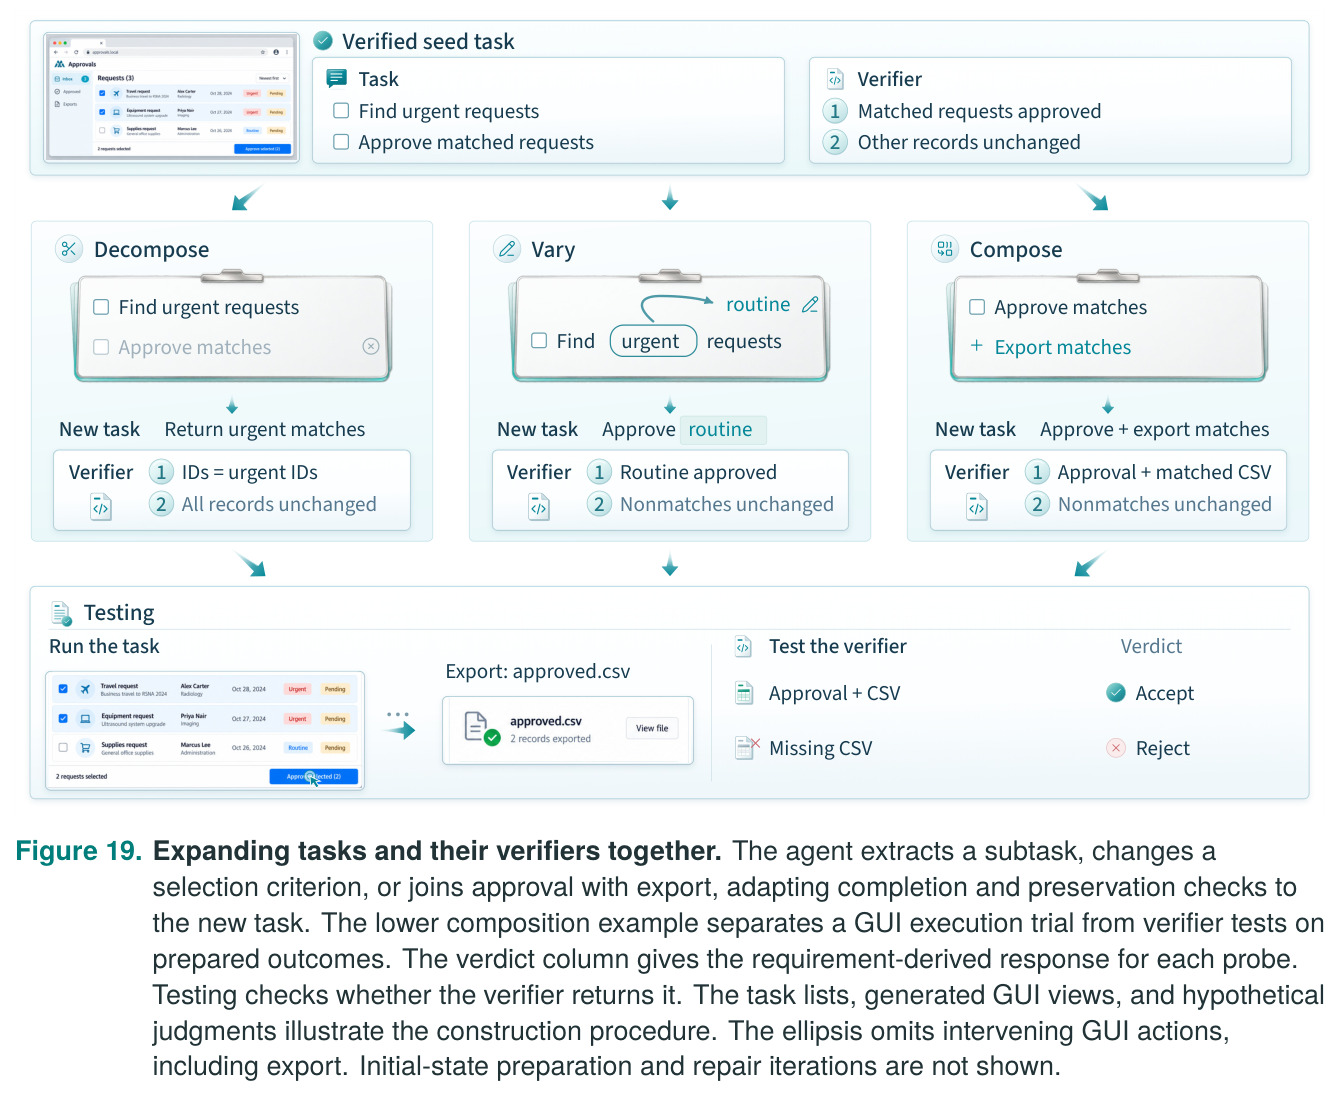
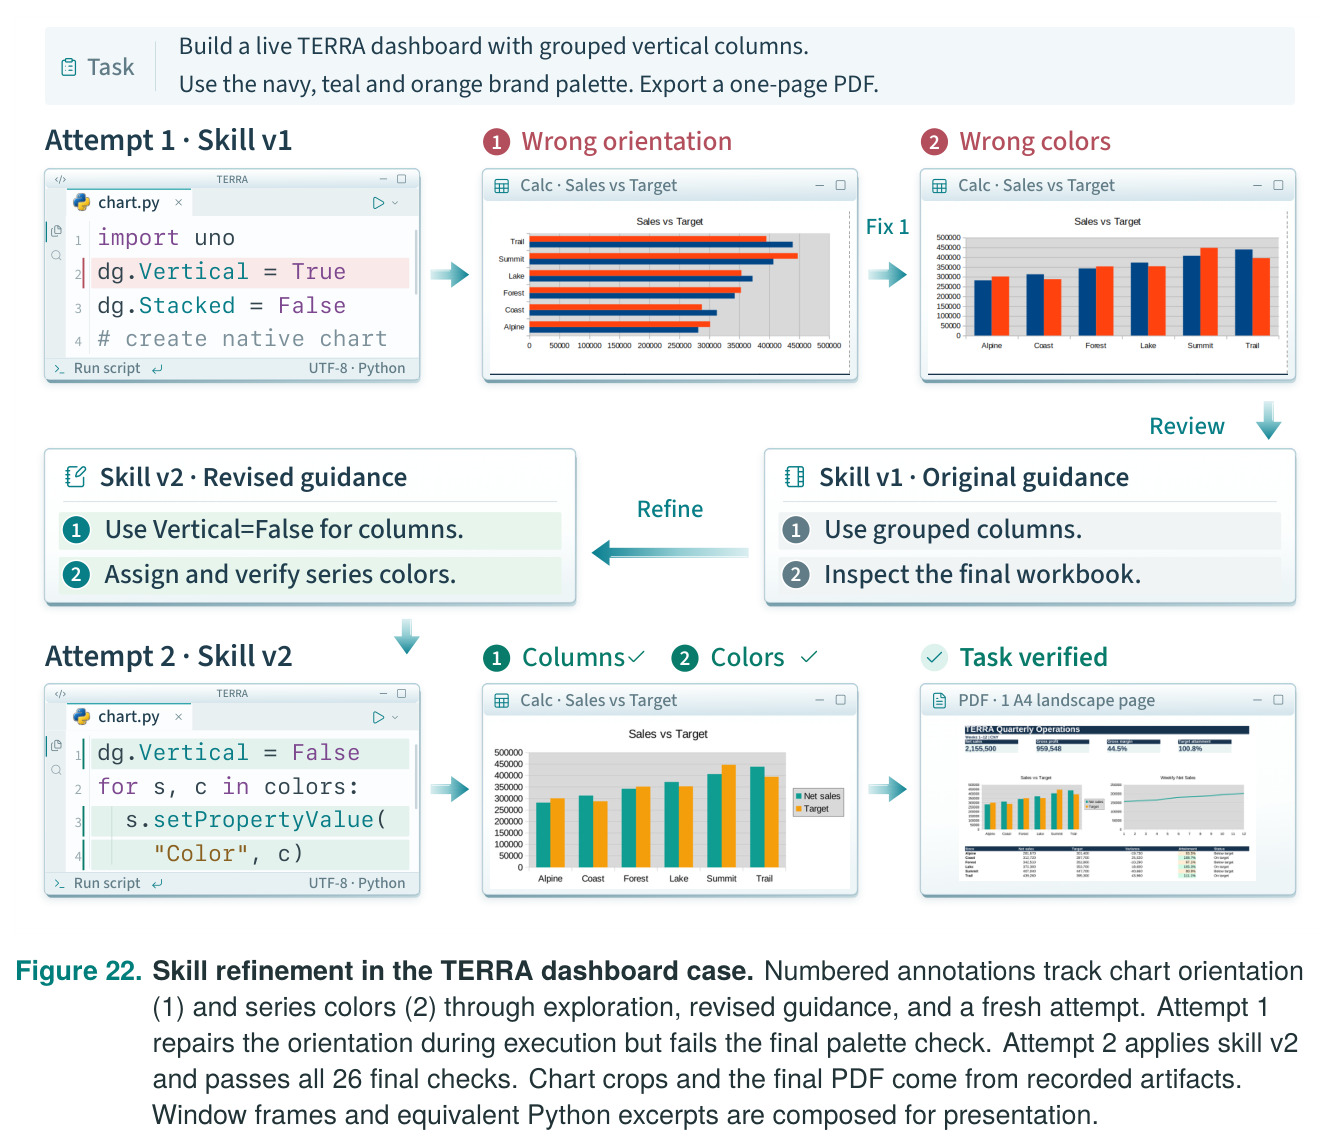
完整流程可按五步走。第一步,任务构造(飞轮上游)。Scaling Intents:先选应用与功能(如 Calc 的筛选),从数万份公开文件索引中按格式与内容摘要匹配素材(如含 Status 列的 orders.xlsx),LLM 结合用户人设写出落地的请求("只显示 Pending 行并保存"),再组装 CaseSpec:上传文件、启动命令、验收要求(保存后 A17/A58 可见、A42 隐藏但源行不删)。长流程则先把场景蓝图实例化为 DAG——如办公室交付场景 A 检查批准文档→B 在旧演示稿中找过时措辞→C 对账更新业务记录→D 产出可搜索 PDF,并把"批准金额 USD 286,000 必须出现在 PDF、过时词 Discovery Sprint 必须排除"等事实埋进文件。Scaling Environments:EnvAgent 为论坛/wikiHow 收集的请求补齐缺失输入(为 orders.xlsx 构造共享 Order ID 的 shipments.xlsx)、指定启动计划并自检;网页侧基于 WebAnything 从参考 URL 观察页面与交互→本地重建界面与后备数据→浏览器测试(编辑标题、保存、刷新验证持久化)→重置初始数据打包;前端测试场景则让 Coding Agent 与 WebTestAgent 以 issue 为固定预期做"修复→浏览器测试→报告→再修复"迭代。Scaling Verifiers:对种子任务-验证器对做分解/变体/组合三种改编,同步改请求、初始态、验证器,然后 GUI 试跑+验证器探针(完整结果应接受、缺导出的更新应拒绝、受保护记录被改应拒绝)双重测试。第二步,执行与评估(Harness)。每个尝试在独立 E2B 沙箱中进行,准备队列流水线化;智能体用滑动窗口视觉上下文(近 $k$ 帧+历史帧上的动作叠层:点击标记、拖拽路径、滚动提示、文本徽章)、预算触发的任务保持压缩(保护当前交互、总结任务进度、过滤过期 GUI 坐标)、以及结构化笔记工具(记录逾期总额 $5,350 之类后续要用的事实)维持长程;结束后评估器检索记录+活体检查,输出六维度报告。第三步,广度中期训练:grounding 样本直接监督坐标预测,轨迹样本按响应级目标(推理、回复、工具调用)训练,评估器轨迹单独教判断。第四步,验证长程 SFT:只用通过可执行验证器的完整长轨迹,保留原始动作-观察序列(包括真实纠错),技能/里程碑引导产生的演示保留其决策时上下文。第五步,联合 RL 与 RSI:RL 每个任务组在同一初始态的隔离沙箱并行 rollout,验证器给 0/1 终局奖励,GRPO 组内比较更新共享策略;RSI 技能线走"探索→固化技能→独立验证→带技能重试"循环(TERRA 仪表盘案例:v1 技能导致图表方向和配色错误,v2 记录 Vertical=False 与 chart2 显式配色后第二次尝试通过全部 26 项检查),里程碑线走"分解 M1/M2/M3→存快照→分支搜索→原始验证器终验"(Blender 温室咖啡馆 ORBIT BOTANICA 案例:结构-装备-渲染三里程碑各保留通过分支,失败的分支如上环未接柱、太阳能板错位、玻璃不透明被淘汰)。
技术新颖性
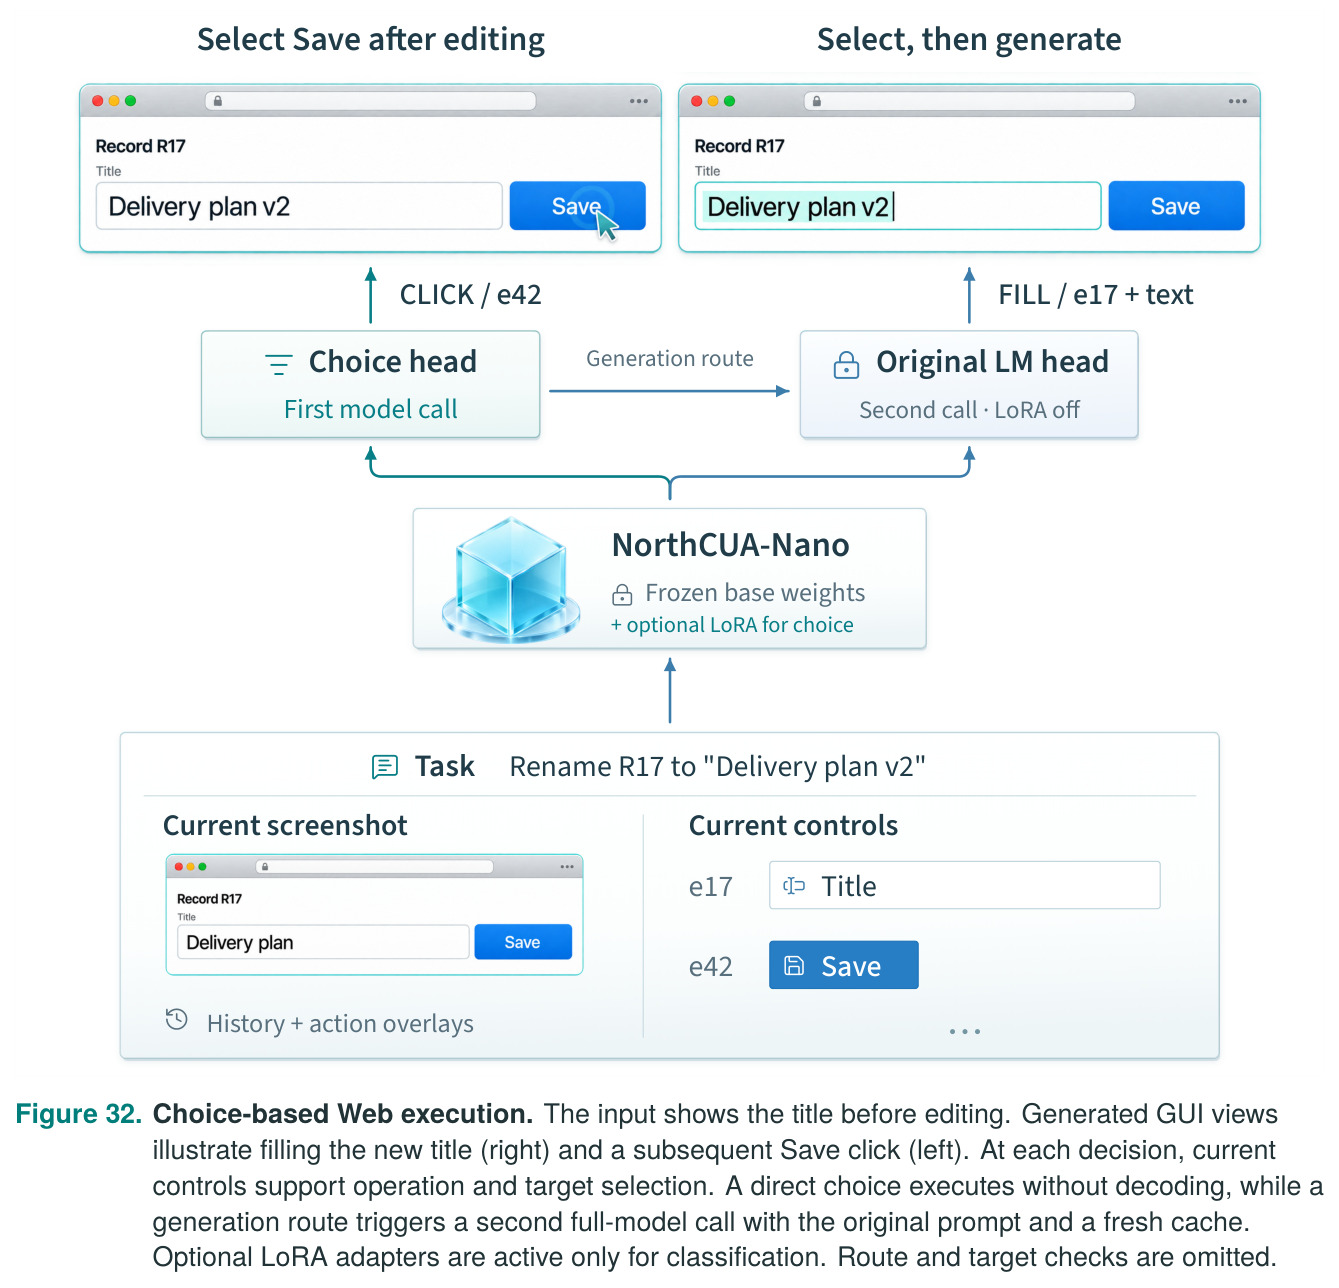
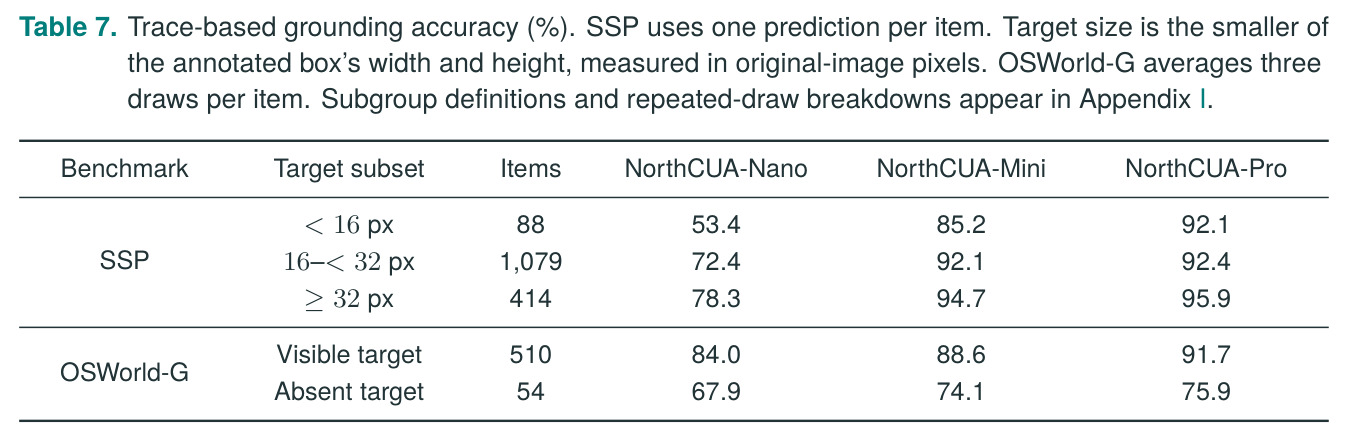
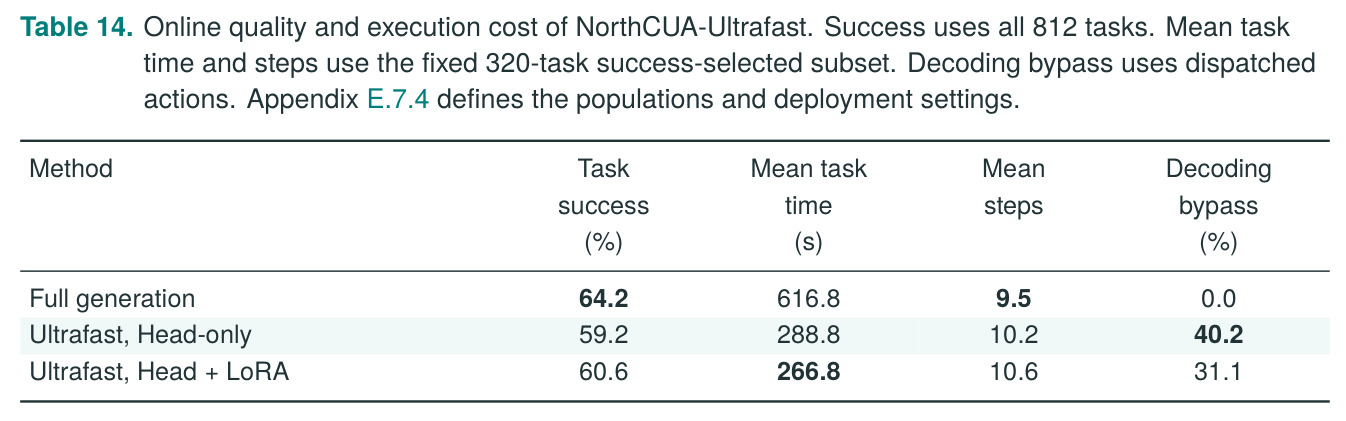
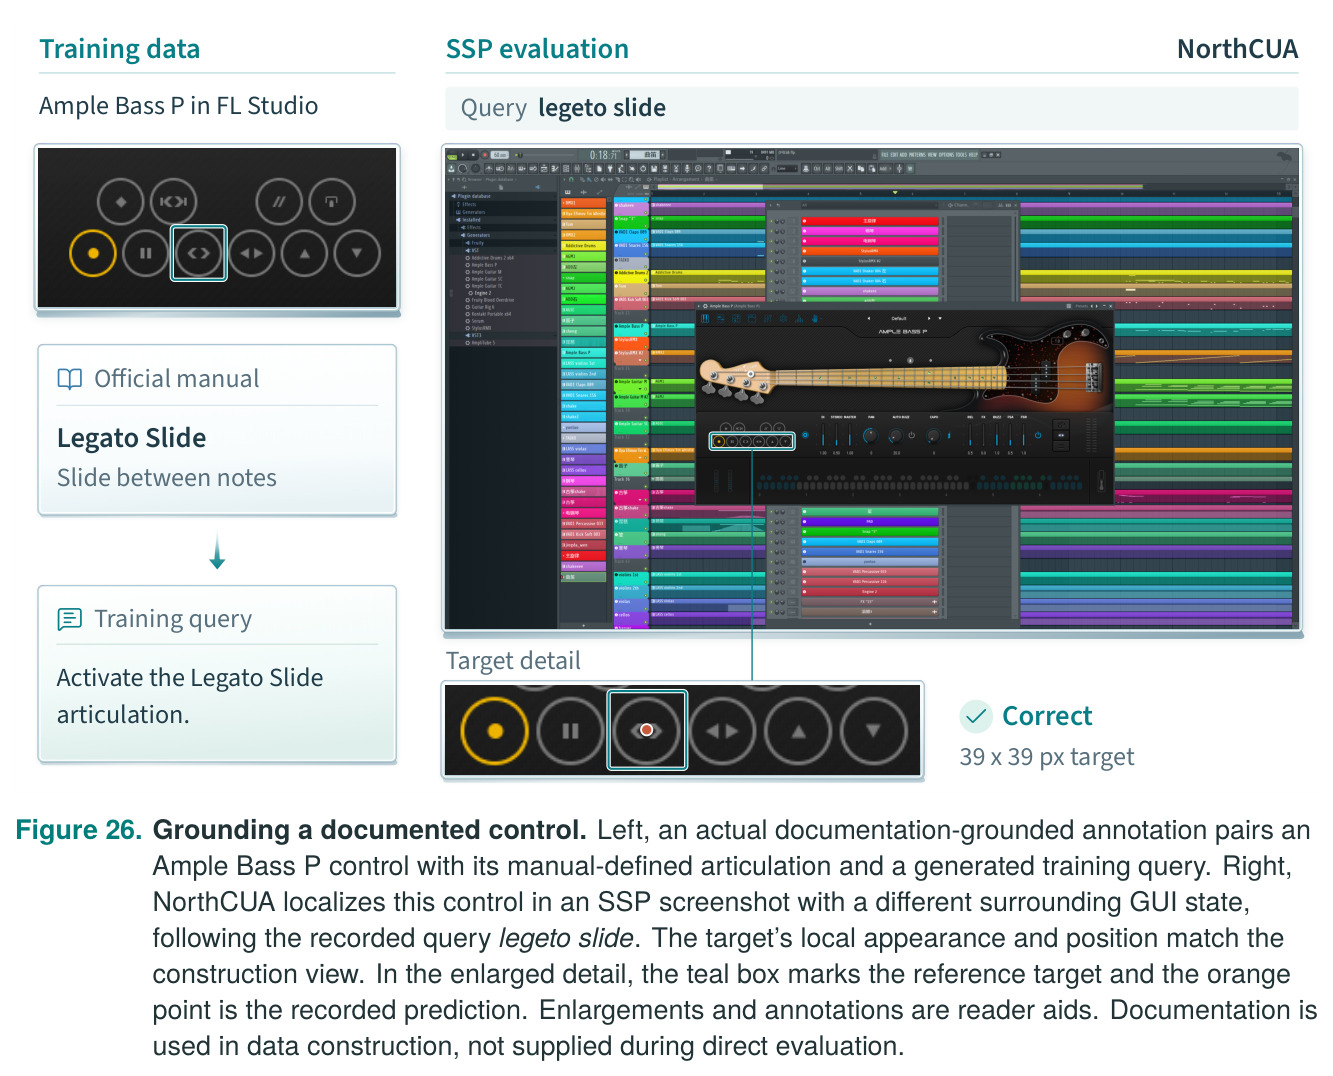
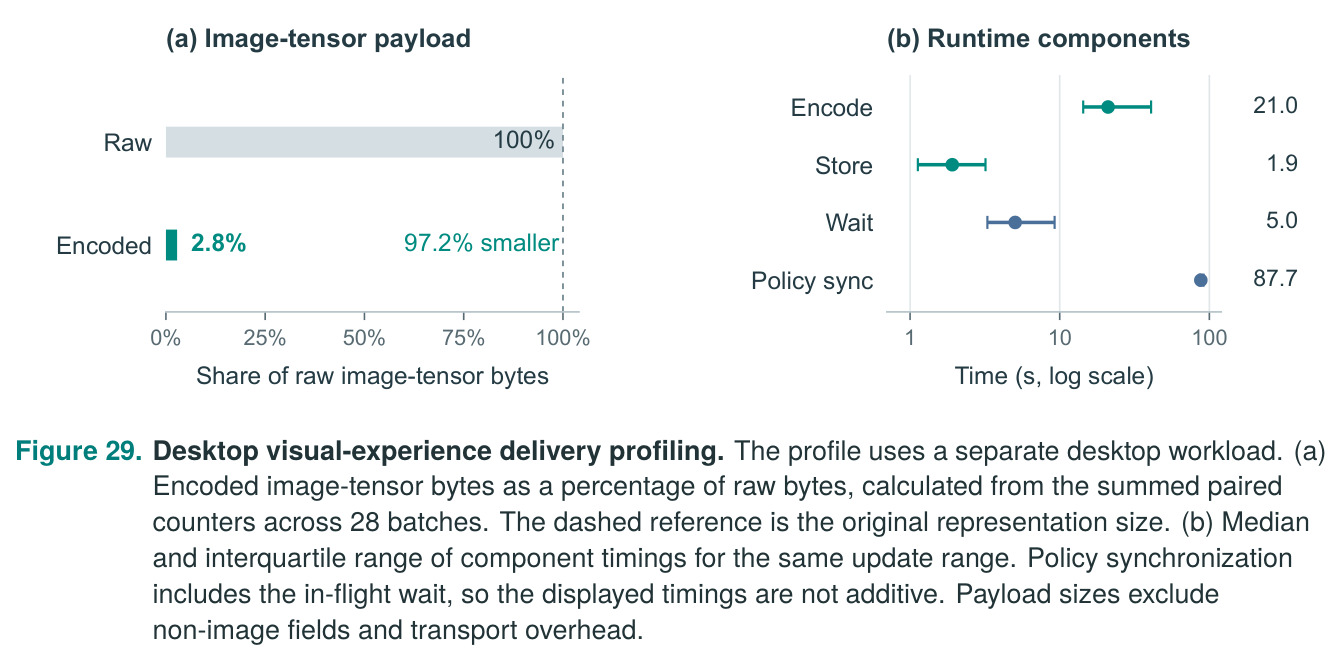
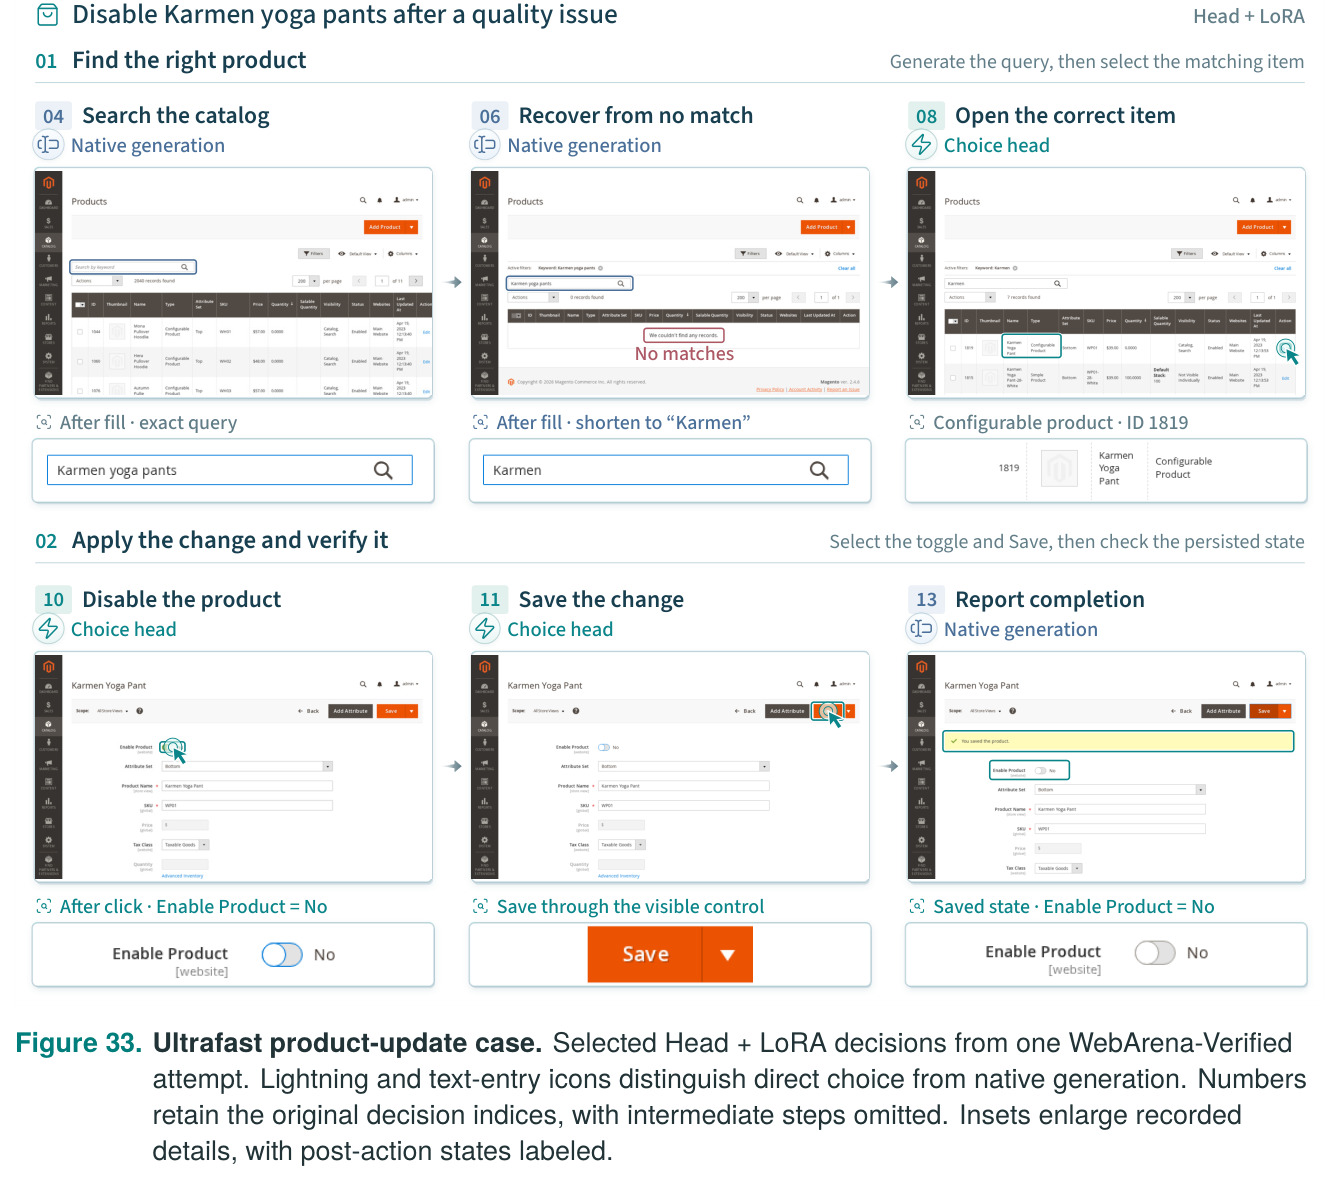
技术新颖性可以从四个相对已有工作的增量来看。一是文档锚定的功能定位:OmniParser 类管线只回答"控件在哪",本文新增"控件是什么功能"的消歧——识别应用与版本(Inkscape 1.3)→在线手册检索并保留插图与功能描述→图像嵌入相似度取 top-k→结合面板上下文与选中对象判定真功能→生成继承原坐标的查询变体。SSP 上图标类目标的巨大差距(Pro 90.2% vs Nano 55.0%)印证了这类监督的价值。二是 RSI 双管线:与 Work2Skill/WebXSkill 从人类演示提取技能不同,本文从智能体自己的失败尝试中提炼技能并独立验证;与 Go-Explore 类回放不同,保留的是真实工作区 E2B 快照+决策上下文(而非抽象状态编码),且验收绑定原始验证器、失败兄弟分支不拼接,保证演示真实可达。三是把"上下文管理"变成训练问题:滑动窗口替换干净帧为动作叠层、图像淘汰、摘要重写、策略版本切换都会断开前缀,Adapter 相应开启新 segment 并保存行为 log-prob,配合 Eq.1 的轨迹均值归一化与历史掩码(早期响应只在后段作上下文、不再计入损失),系统解决了长 GUI rollout 中输入漂移与信用分配两大难题,这与 ScaleCUA 的掩码、Qwen-CUA 的切片信用保留互补且更完整。四是工程与推理侧创新:图像张量无损压缩使中位 batch 从 110.9 GiB 降到 2.7 GiB(-97.2%);异步策略同步(暂停新调用→等在途调用→换权重→恢复,全程 87.7s)允许进行中任务跨版本继续;Ultrafast 把 Jev 式"有限动作直接选择"接入 CUA——一次前向同时给语言头与 choice head,离散动作(点击/悬停/复选)零解码执行,填表等开放输出回落到原生成路径,Head-only 仅训 4.21M(0.045%)参数就能 bypass 40.2% 的动作。
实验结果
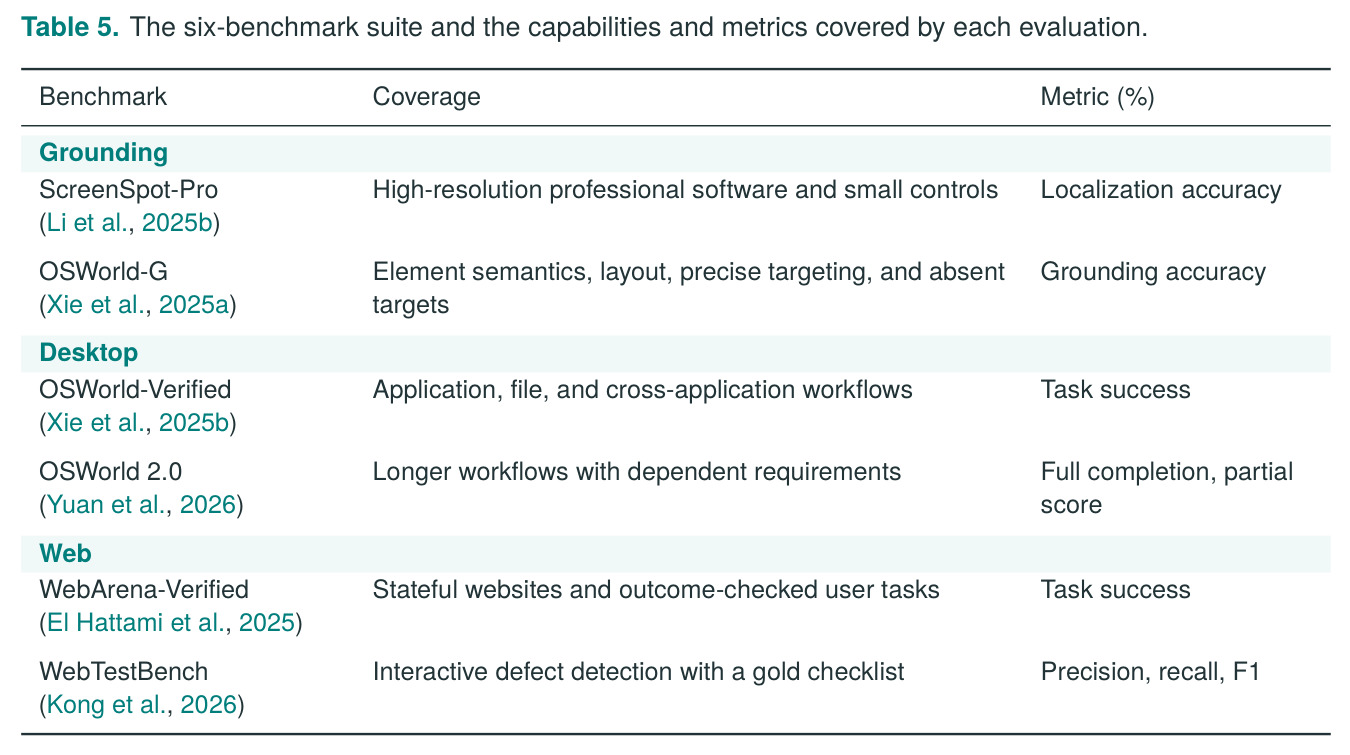
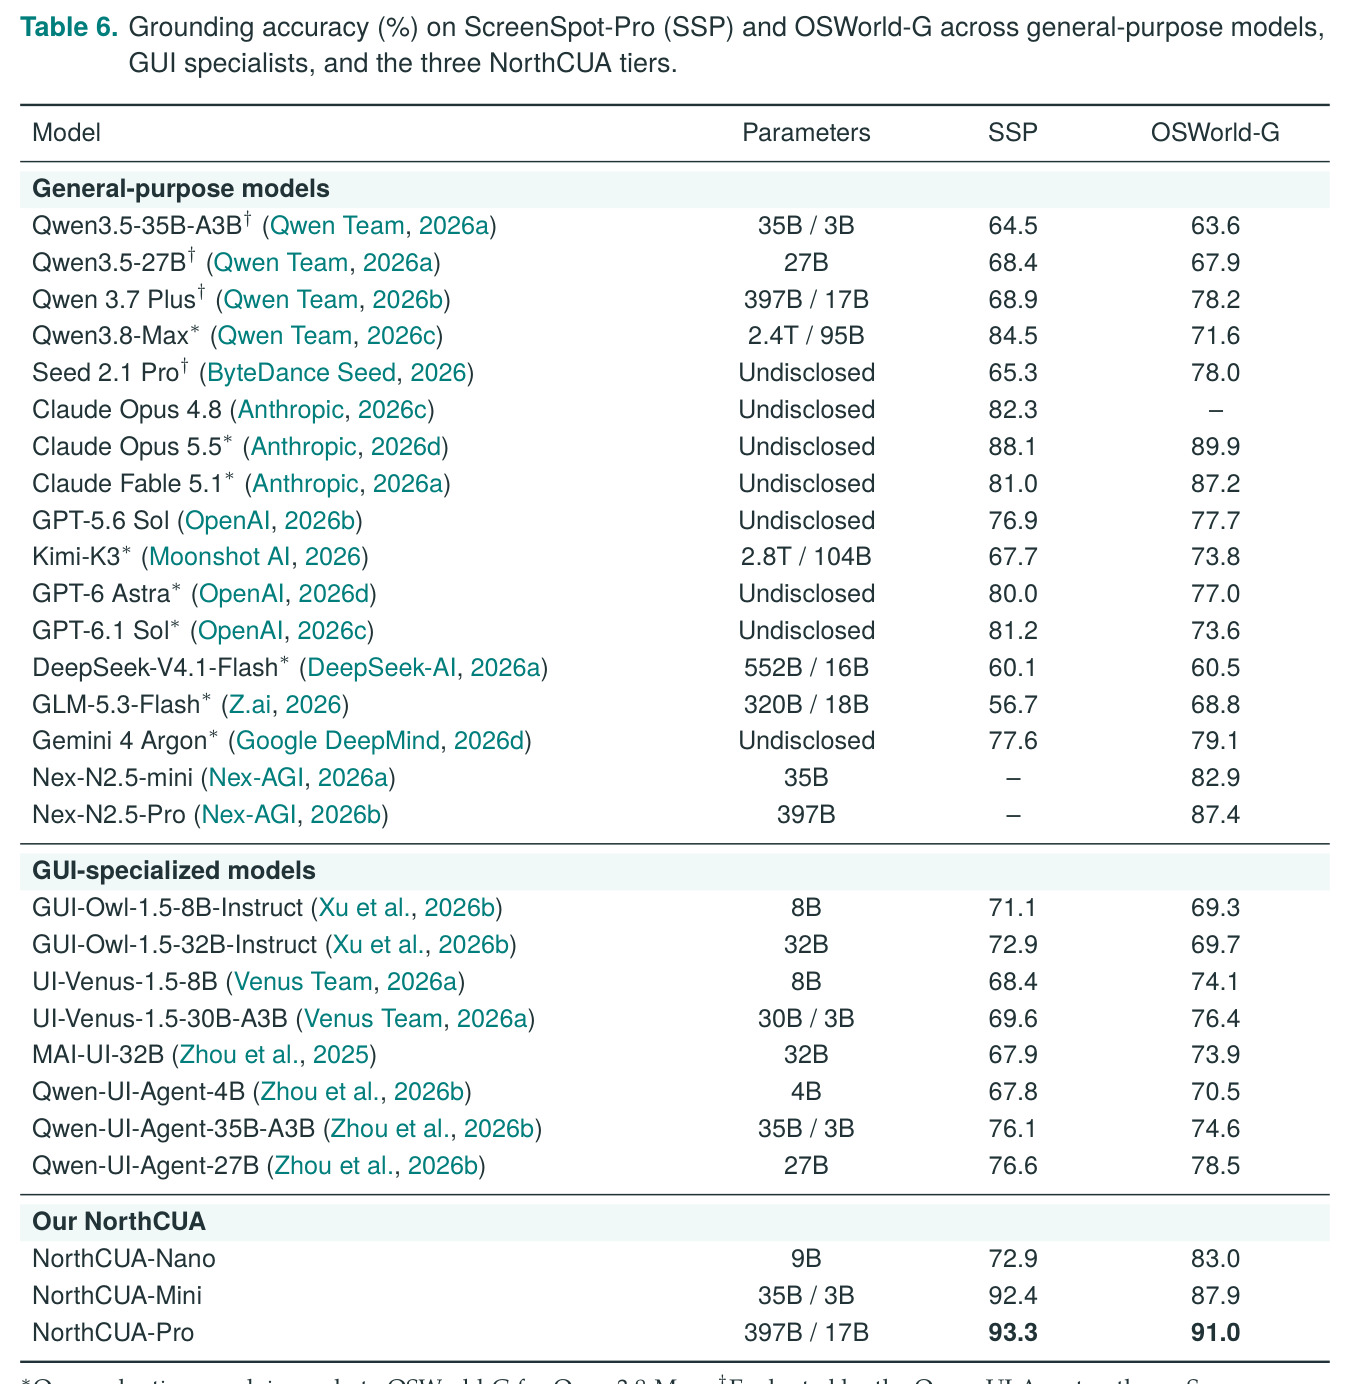
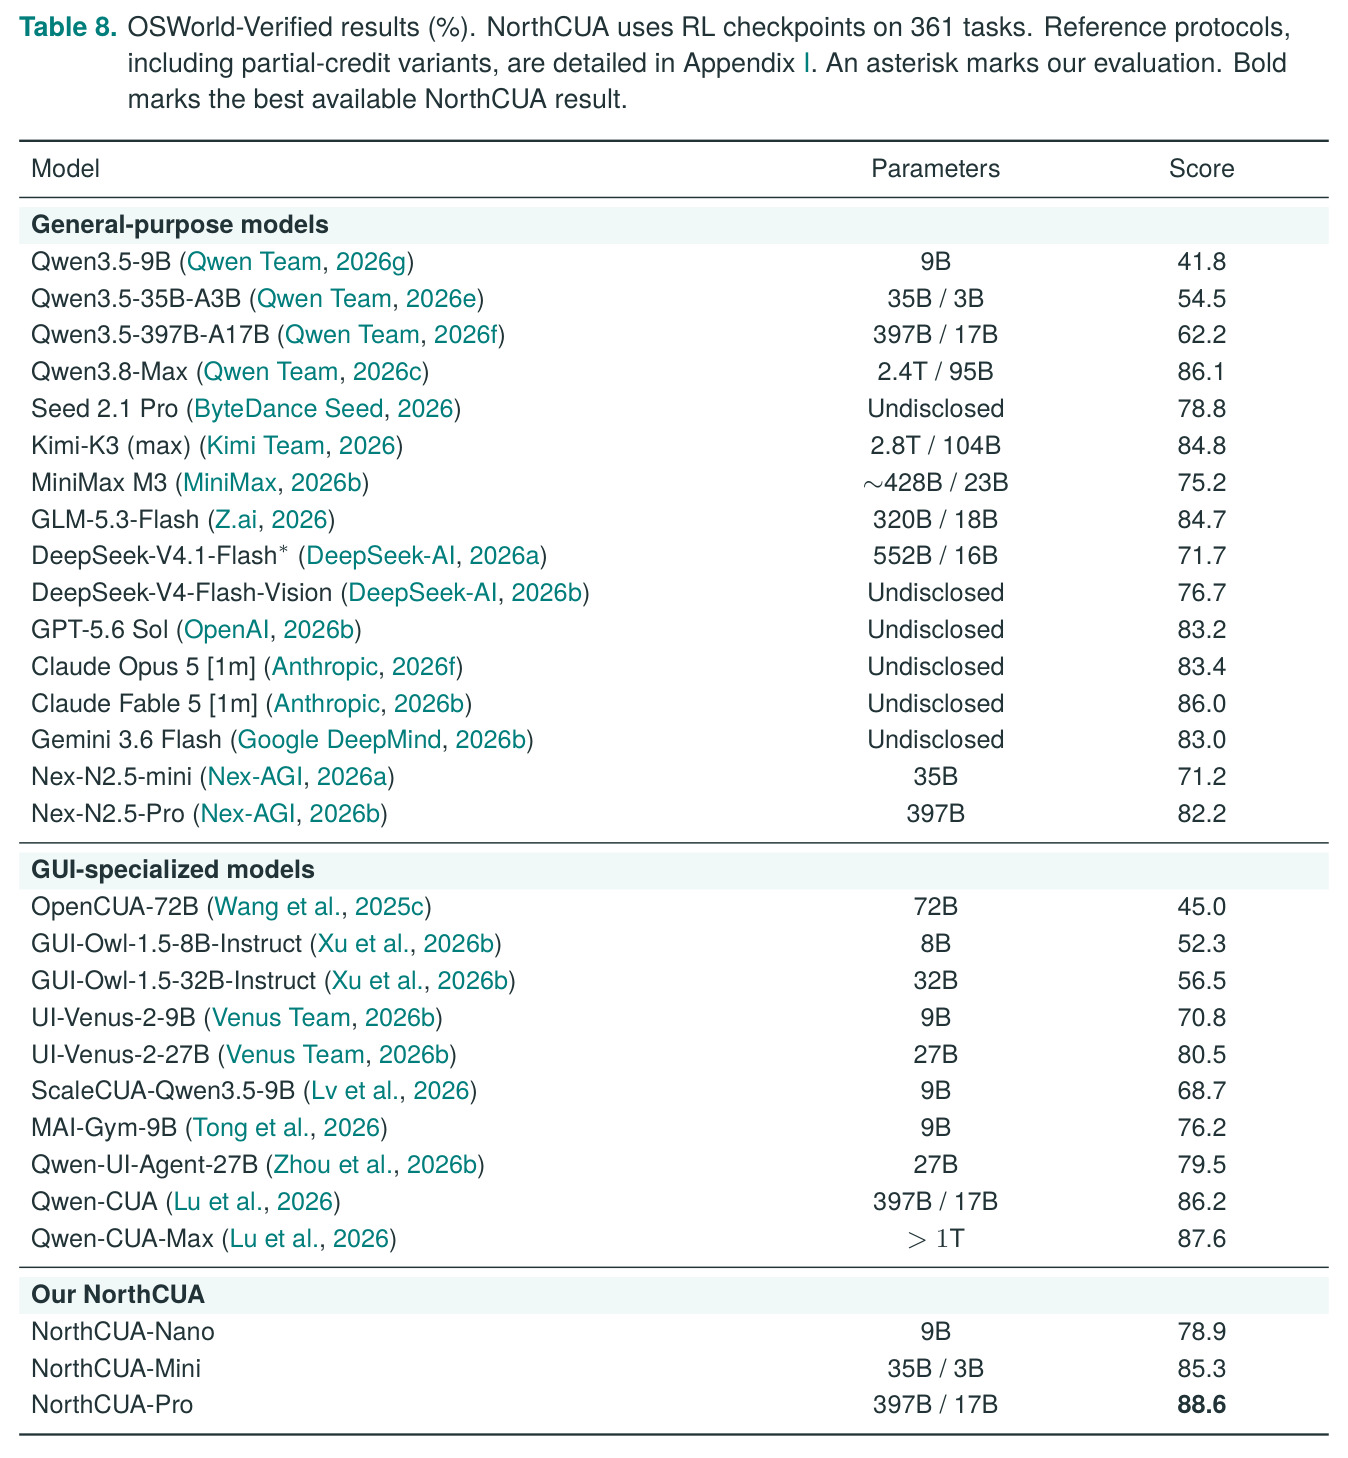
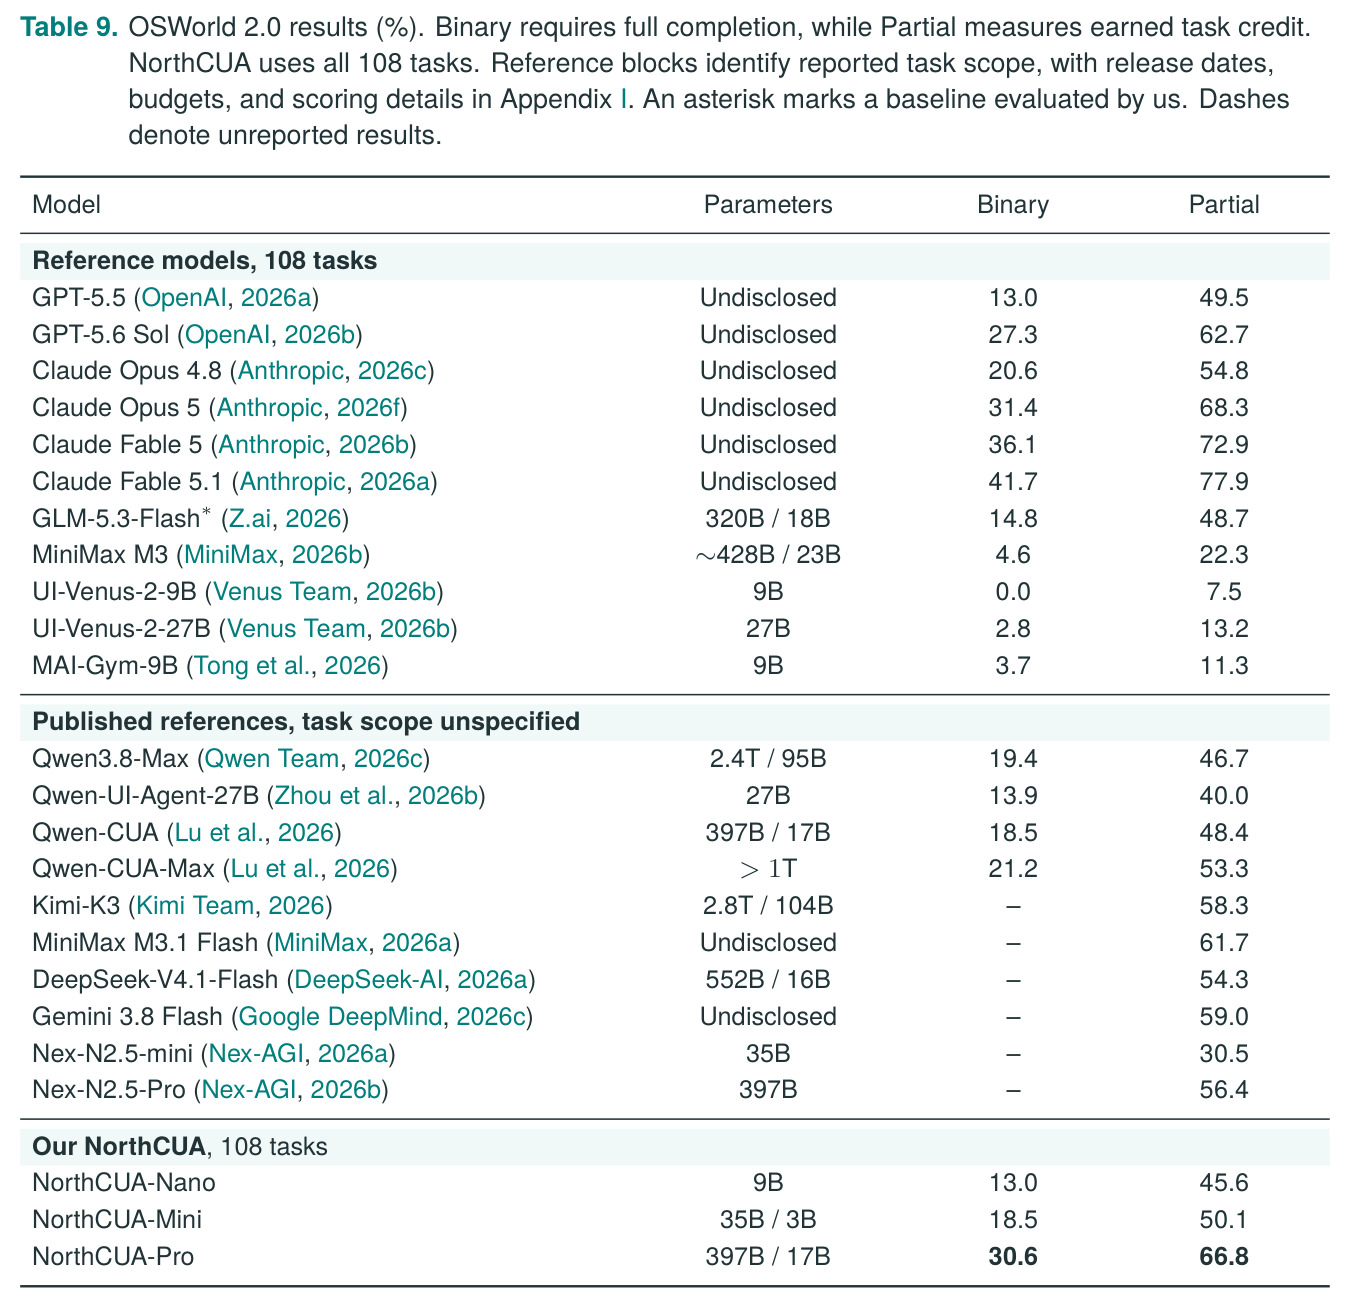
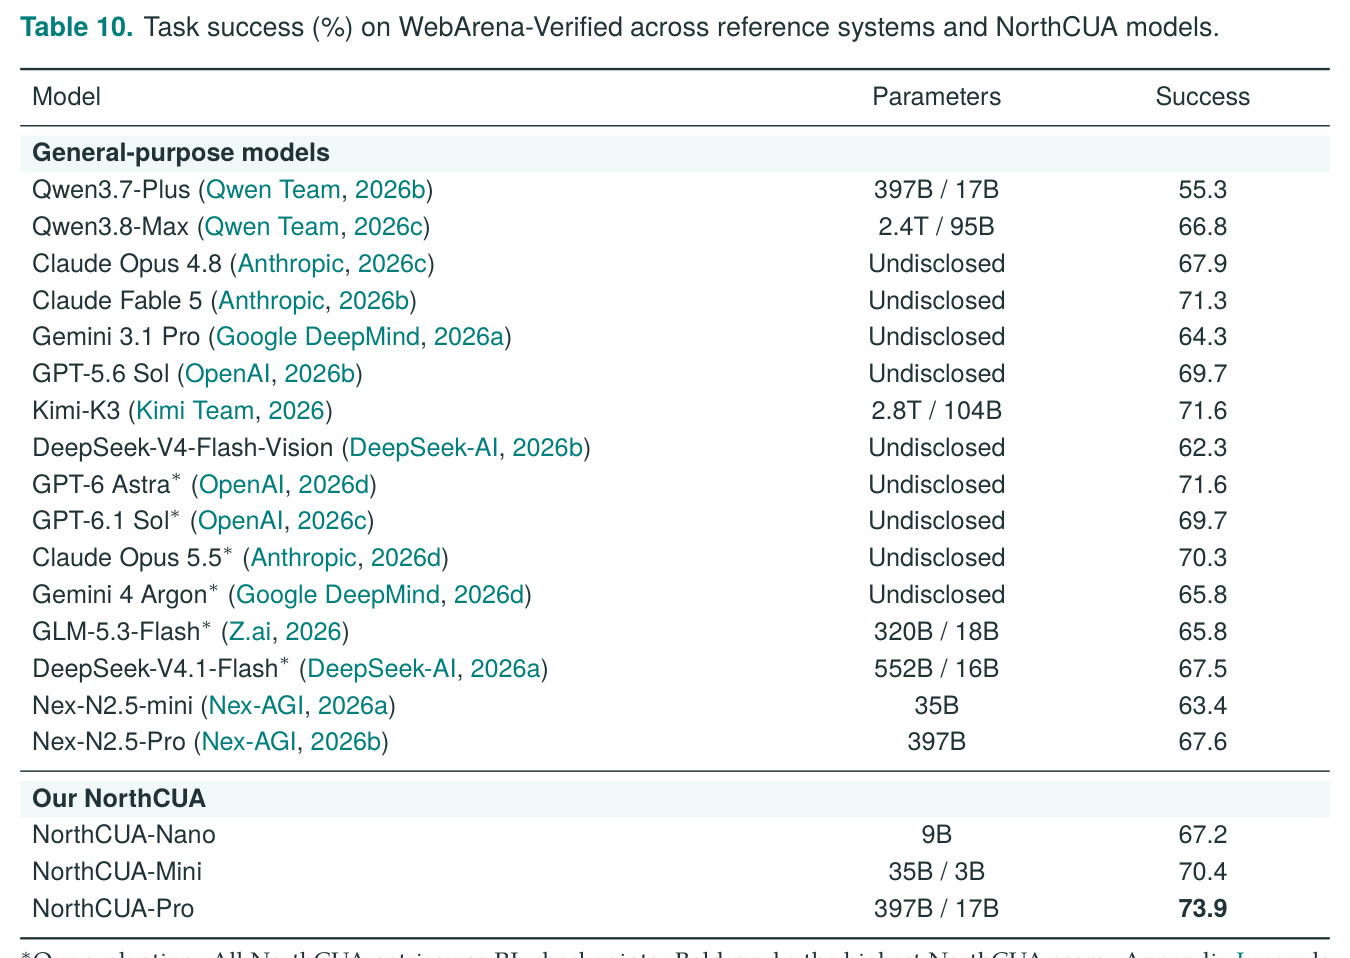
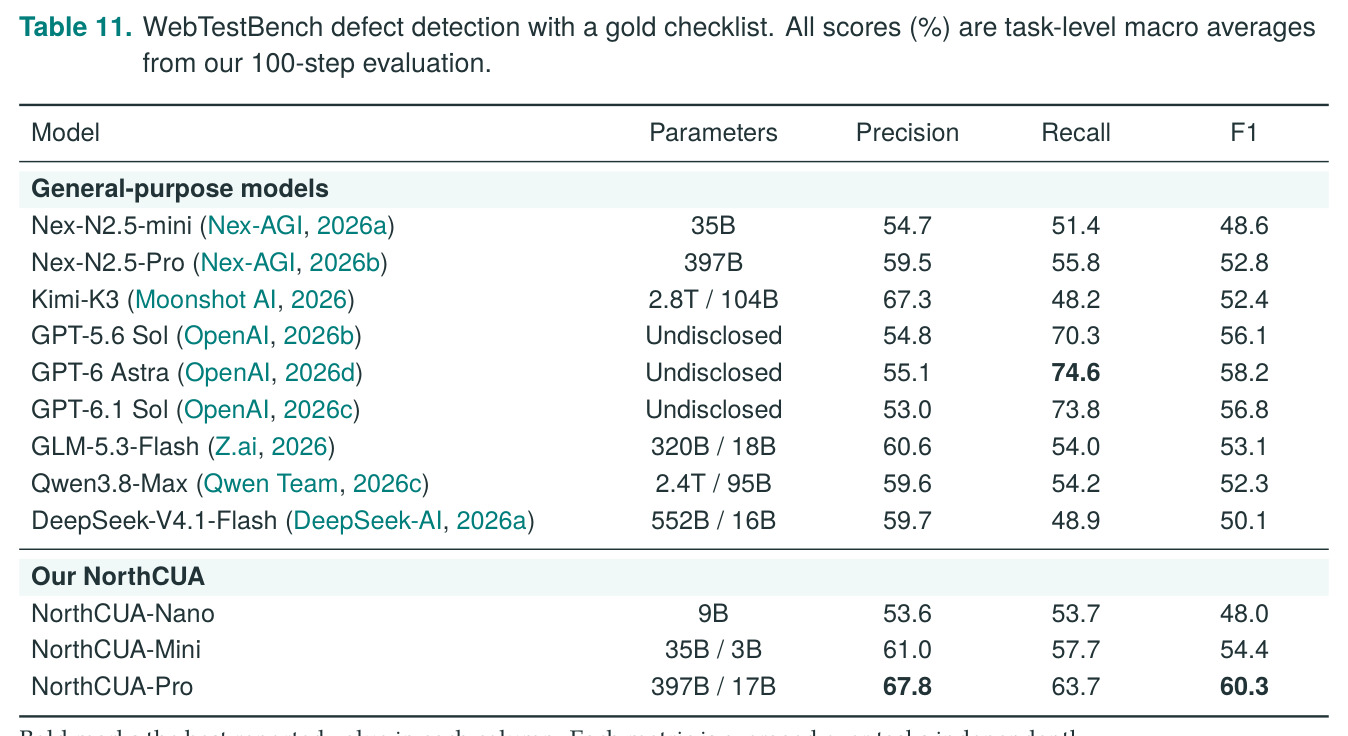
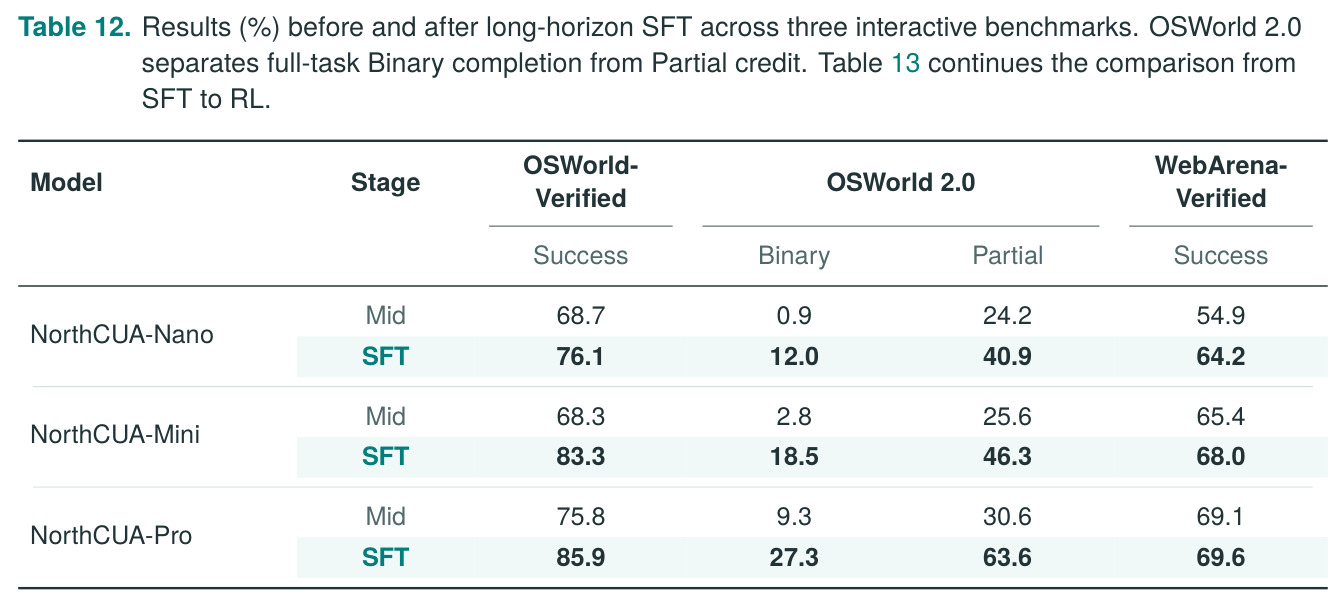
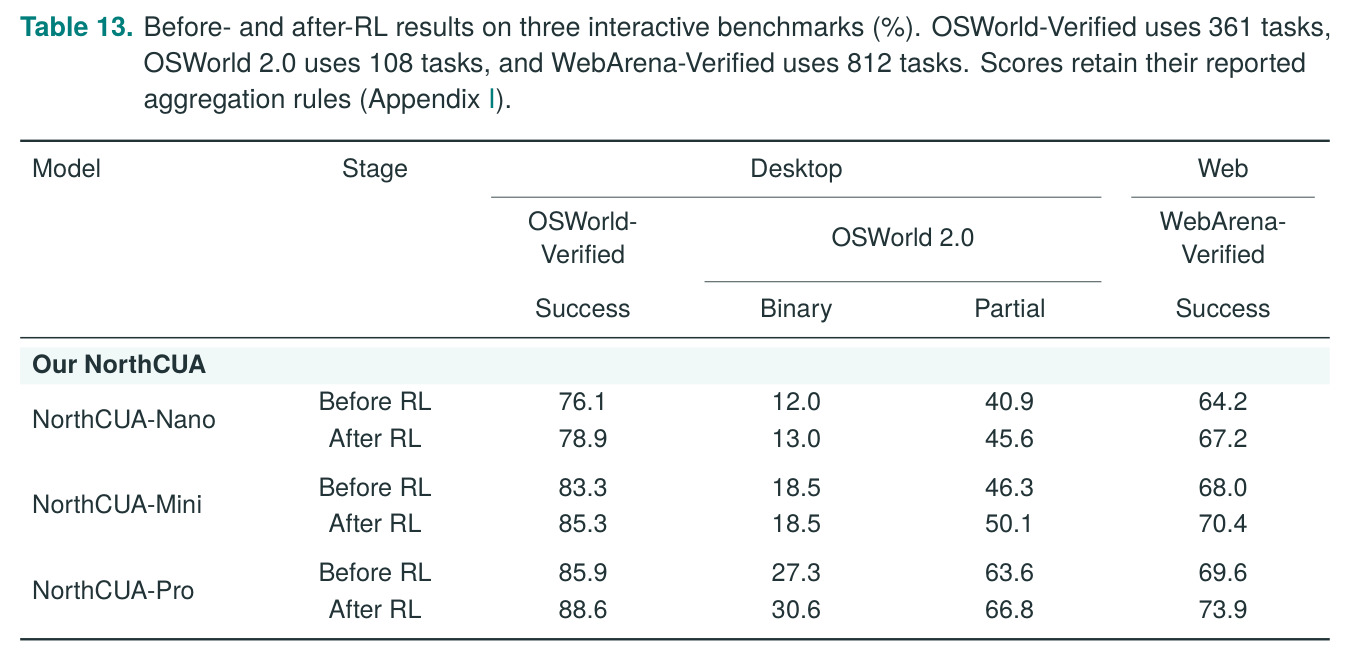
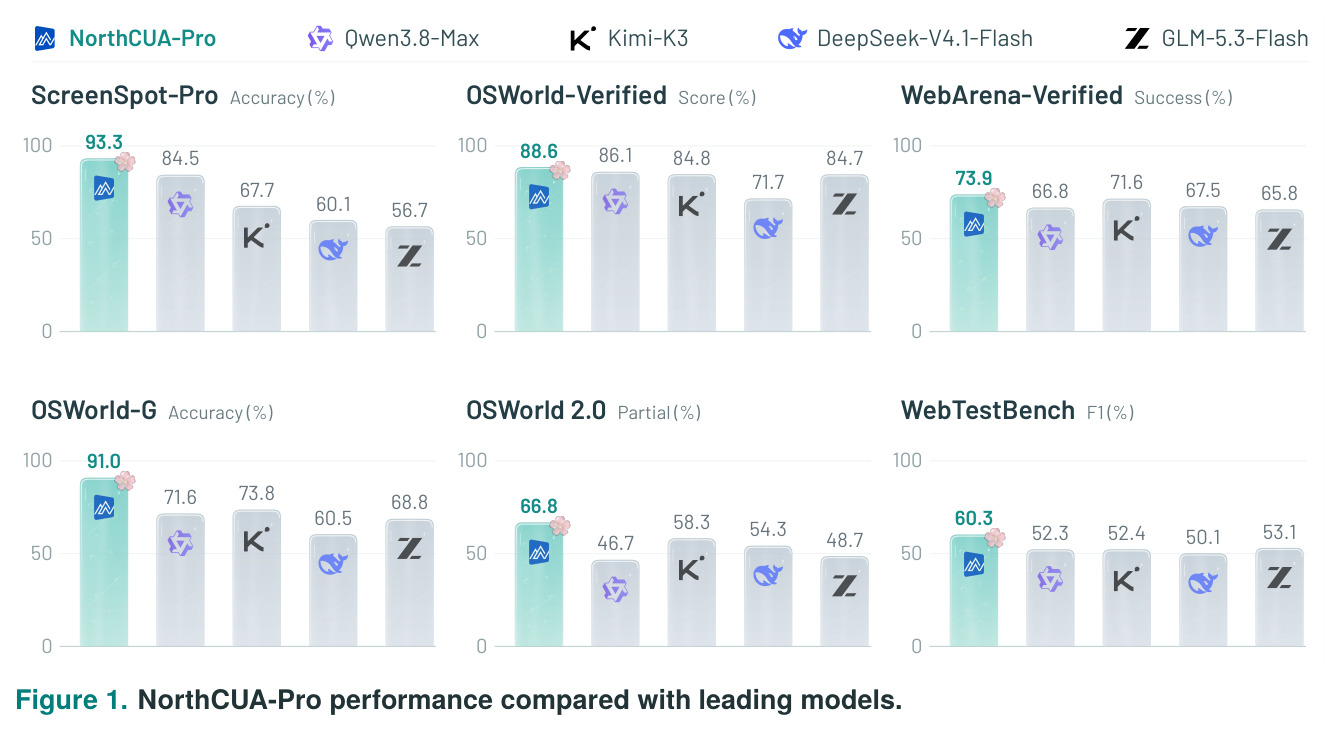
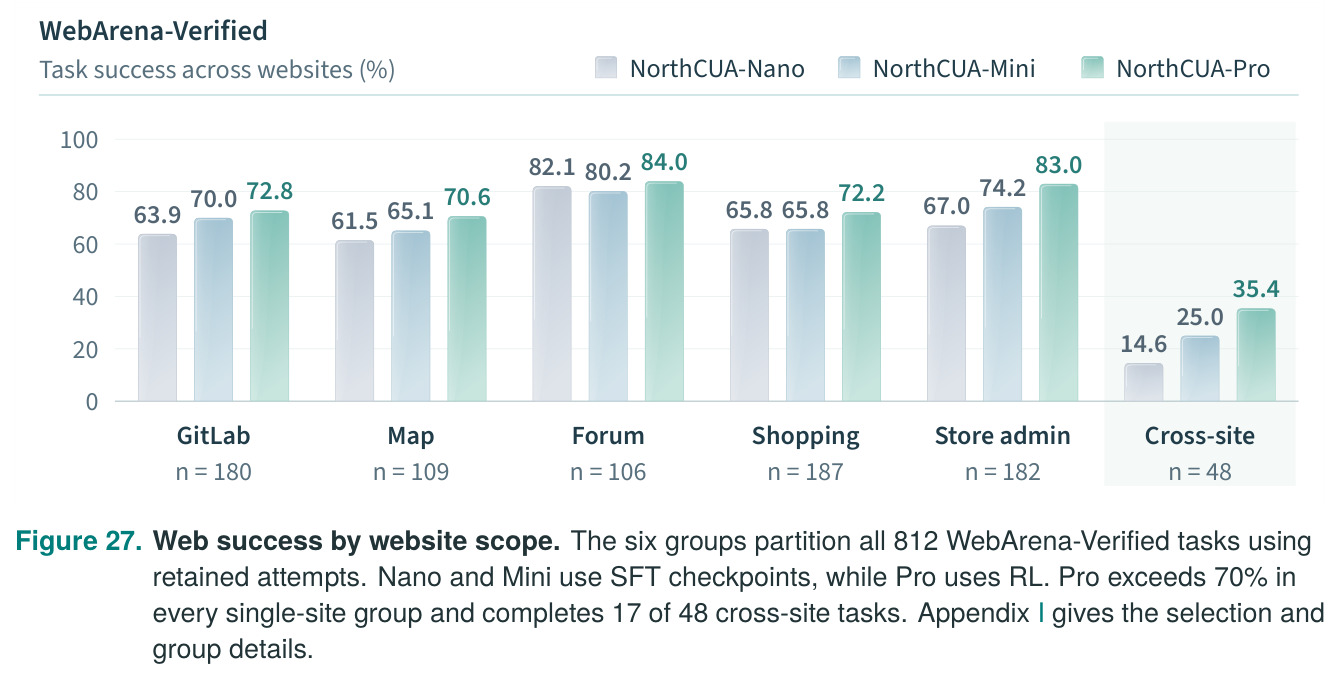
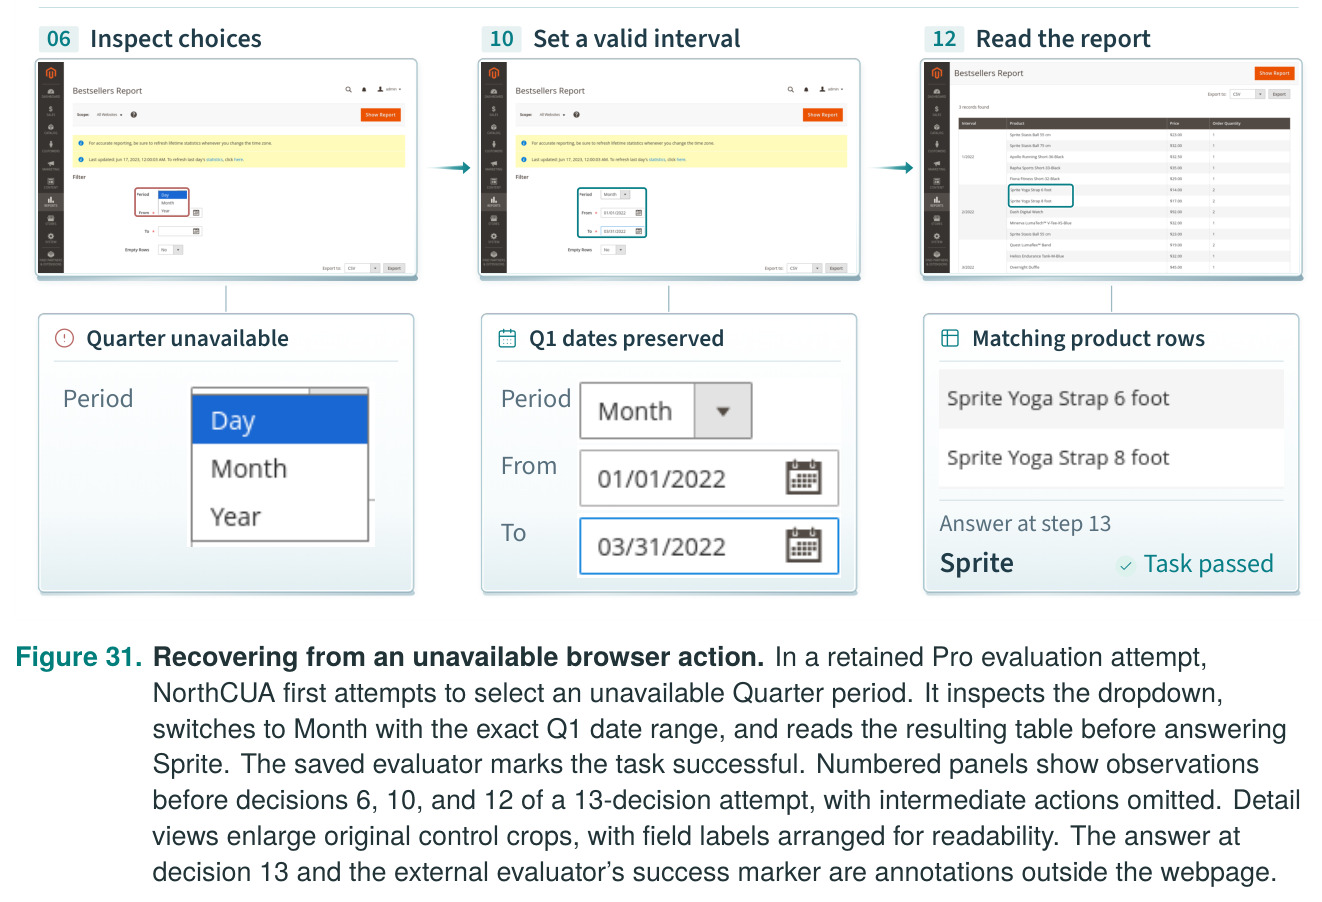
论文在六个基准上系统对比了 Nano/Mini/Pro 与通用大模型、GUI 专用模型。GUI 定位:SSP(1581 例,直接推理不缩放)Pro 93.3%、Mini 92.4%、Nano 72.9%,Pro 超最强对照 Claude Opus 5.5(88.1%)5.2 个百分点、超 Qwen3.8-Max 报告值(84.5%)8.8 个百分点;OSWorld-G(564 条 Refined 指令)Pro 91.0%,超 Opus 5.5 的 89.9%。细分显示进步集中在最需要的地方:最小目标(<16px)准确率从 Nano 53.4%→Mini 85.2%→Pro 92.1%;图标目标 Pro 90.2% 而 Nano 仅 55.0%;Pro 的 OSWorld-G pass@3 达 94.0%(564 例中 489 例三次全对),可见目标 91.7%、缺席目标正确拒答 75.9%。桌面执行:OSWorld-Verified(361 任务、≤100 步)Pro 88.6%、Mini 85.3%、Nano 78.9%,Pro 超 Qwen-CUA-Max(87.6%,>1T 参数)1.0pp、超 Qwen3.8-Max(86.1%)2.5pp;OSWorld 2.0(108 任务、≤500 步)Pro 二元完成 30.6%、部分分 66.8%,在 108 任务参考组内超 GPT-5.6 Sol 3.2/4.1pp,但低于 Claude Fable 5.1(41.7%/77.9%)。Web 交互:WebArena-Verified(812 任务)Pro 73.9%,超并列最高的 Kimi-K3/GPT-6 Astra(71.6%)2.3pp;五个单站点组全部 >70%(论坛 84.0%、商店后台 83.0%),但跨站点任务只有 17/48=35.4%(单站点 76.3%);Pro 全程 14,604 次决策,成功尝试中位数 10 步、失败 15.5 步,26.1% 的失败任务消耗了 38.4% 的决策。缺陷检测:WebTestBench F1 Pro 60.3%(精确率 67.8/召回率 63.7 双第一)超 GPT-6 Astra 58.2%,Mini 54.4% 超同尺寸 Nex-N2.5-mini 48.6%。阶段消融清晰:Mid→SFT 使 OSWorld-Verified 提升 +7.4/+15.0/+10.0pp,OSWorld 2.0 部分分 +16.7/+20.7/+33.0pp(Pro 二元 9.3%→27.3%),说明长程 SFT 主要修"完全做完";SFT→RL 再加 OSWorld-Verified +2.9/+2.0/+2.8pp、WebArena +3.0/+2.5/+4.3pp。Ultrafast(pre-RL Nano)上 Head+LoRA(47.49M 可训参数)成功 60.6%,保留全生成 64.2% 的 94.4%,但均任务时间 616.8s→266.8s,2.3× 加速,31.1% 动作绕过解码;Head-only 仅 4.21M 参数即达 59.2%、bypass 40.2%。工程上,图像张量无损编码把中位 batch 载荷从 110.9 GiB 压至 2.7 GiB,编码中位耗时 21.0s,策略同步全周期 87.7s。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GUI 定位 ScreenSpot-Pro(专业软件小控件,1581 例直接推理) | 定位准确率 (%) | NorthCUA-Pro 93.3(Mini 92.4 / Nano 72.9) | Claude Opus 5.5 88.1;Qwen3.8-Max 84.5(2.4T 参数) | 较最强对照 +5.2pp |
| GUI 定位 OSWorld-G(564 条功能/空间指令) | 准确率 (%) | NorthCUA-Pro 91.0(Mini 87.9 / Nano 83.0) | Claude Opus 5.5 89.9;Nex-N2.5-Pro 87.4 | +1.1pp |
| 桌面工作流 OSWorld-Verified(361 任务,≤100 步) | 任务成功率 (%) | NorthCUA-Pro 88.6(Mini 85.3 / Nano 78.9) | Qwen-CUA-Max 87.6(>1T);Qwen3.8-Max 86.1 | 较 Qwen-CUA-Max +1.0pp |
| 长程桌面 OSWorld 2.0(108 任务,≤500 步) | 二元完成 / 部分分 (%) | NorthCUA-Pro 30.6 / 66.8 | GPT-5.6 Sol 27.3 / 62.7(同参考组);Claude Fable 5.1 41.7 / 77.9 更高 | 较 GPT-5.6 Sol +3.3pp / +4.1pp(开源内最优) |
| Web 任务 WebArena-Verified(812 任务,≤100 步) | 任务成功率 (%) | NorthCUA-Pro 73.9(Mini 70.4 / Nano 67.2) | Kimi-K3 71.6;GPT-6 Astra 71.6;Qwen3.8-Max 66.8 | +2.3pp |
| Web 缺陷检测 WebTestBench(gold checklist,按任务宏平均) | F1 (%)(精确率/召回率) | NorthCUA-Pro 60.3(67.8 / 63.7) | GPT-6 Astra 58.2(55.1 / 74.6);Nex-N2.5-mini 48.6 | +2.1pp;Mini 较同尺寸 Nex-N2.5-mini +5.8pp |
| 9B 级桌面执行(开源小模型对比) | OSWorld-Verified 成功率 (%) | NorthCUA-Nano 78.9 | MAI-Gym-9B 76.2;ScaleCUA-Qwen3.5-9B 68.7 | +2.7pp |
| Ultrafast 网页执行时延(WebArena 320 任务成功子集,单 GPU 副本) | 成功任务平均耗时 (s) | Head+LoRA 266.8(成功率 60.6%);Head-only 288.8(59.2%) | 全生成 616.8(成功率 64.2%) | 2.3× 提速,成功率保留 94.4% |
局限与改进
作者承认的局限有三:一是泛化与覆盖——对陌生软件和不断演变的界面约定仍然吃力,文档引导的 grounding 和 RSI 只能部分缓解,把覆盖扩展到新软件并保持可靠性是持续方向;二是反馈质量——可执行验证器依赖谓词覆盖,开放式内容的判断依赖模型校准,长工作流把大量决策的信用压缩到一个终局奖励,中间反馈不足会影响信用分配与效率;三是负责任部署——真实软件操作需要授权访问、最小权限与敏感操作确认,外部页面可能携带间接提示注入。我自己的观察补充四点:其一,OSWorld 2.0 二元完成率 30.6% 仍明显低于闭源 Claude Fable 5.1 的 41.7%,跨站点任务 35.4% 对单站点 76.3%,说明"跨应用/跨站点搬运信息并完全做对"仍是明显短板,而基准中跨站点任务仅 48 个,训练侧对这类任务的构造投入未见单独披露;其二,RSI 产生的演示在决策上下文中带有技能/里程碑提示,推理时没有这些提示,存在 train-test 分布不一致的风险,论文未报告去掉提示的消融;其三,RL 任务池仅约 2000 个任务且按"SFT 策略结果有差异"筛选,会系统性跳过 SFT 已稳定掌握和完全无能为力的任务,Mini 的 OSWorld 2.0 二元分在 RL 后持平(18.5%→18.5%)提示部分收益只是部分分提升而非真正完成;其四,Ultrafast 基于 pre-RL Nano,成功率损失 3.6pp 未与 RL 策略组合验证,且 bypass 率只有 31-40%,剩余 60% 以上动作仍走昂贵解码。另外部分基线分数取自各自论文/模型卡,协议不完全统一,跨模型比较需谨慎。
独立分析的弱点
独立分析出五个弱点并给改进方向。第一,终局稀疏奖励:一次长任务几十步决策共享一个 0/1 奖励,Thunderbird 案例里 A/B 两次尝试前五个动作完全相同,仅第六步不同就决定了奖励差异,信用分配噪声大。改进方向是引入里程碑级过程奖励——本文的里程碑检查点机制天然可复用为 RL 的中间验证信号,或训练过程奖励模型对子目标打分。第二,技能条件的分布偏移:RSI 演示带技能提示、推理时没有,可能让策略学到"依赖提示"的伪相关。改进方向是训练时混合有/无技能提示的条件化样本,或把技能库做成运行时可检索的工具并纳入 RL 动作空间,让模型自己决定何时取用。第三,跨站点能力弱:35.4% vs 76.3% 的落差说明信息跨域搬运是硬骨头,而基准只含 48 个跨站点任务。改进方向是在 Scaling Verifiers 的"组合"算子上专门规模化构造跨站点任务链,并把网页重建管线扩展为多站点联邦环境。第四,验证器依赖可脚本化结果:对"报告写得好不好"这类开放式交付物只能靠评估器判断,评估器自身的偏差会直接变成训练信号的偏差。改进方向是定期用人类标注校准评估器一致性、扩充验证器探针库、对不确定判定路由人工复核(论文已有不确定性字段,可更主动地利用)。第五,Ultrafast 与 RL 脱节且覆盖率有限:choice head 只在 pre-RL Nano 上训练,且仅覆盖部分离散动作。改进方向是对 RL 后的策略重新蒸馏 choice head、扩大候选控件绑定与回退策略,或采用投机解码式混合方案在保证成功率的同时提高 bypass 率。第六(工程面),Appendix D 的分域数据计数"待报告",训练语料的精确构成尚不可核验。
未来方向
作者明确提出的方向包括:把覆盖扩展到新软件并应对界面演变;设计更有信息量的中间反馈以改善信用分配、减少无效动作;对发布材料做许可、隐私与凭证审查;针对间接提示注入做对抗测试;以及通过移动端扩展(运行时已预留观察/触摸接口)走向更多平台。基于其成果可自然延伸的研究有:其一,把里程碑检查点升级为 RL 的密集奖励或训练价值模型,缓解终局稀疏信号;其二,把验证过的技能库做成跨任务持久资产,支持检索式复用与 RL 联合训练,形成真正的"经验复利";其三,引入世界模型模拟 UI 状态转移(论文已引用 Computer-Using World Model 思路),在沙箱预算之外做廉价的前瞻规划与反事实训练;其四,用重建网站规模化构造跨站点/跨应用组合任务,直击 35.4% 的短板;其五,对 RL 后策略蒸馏 Ultrafast choice head,或研究成功率-时延的帕累托前沿;其六,评估器的自我校准与不确定性驱动的主动学习,让"哪些判定不可靠"驱动数据补采;其七,开源生态方向——Harness 已开源,围绕 CaseSpec 契约建立社区共享的任务-验证器市场是可行的下一步。
复现评估
开源情况较好:三个模型(HuggingFace beipo-ai/NorthCUA-Pro 等)、完整的 NorthCUA Harness 代码(GitHub china-qijizhifeng/NorthCUA-Harness)和技术报告均已发布,这比大多数只发模型不发基础设施的工作强得多。但要注意:训练数据集本身未完整发布,Appendix D 自述分域计数"待报告",grounding 语料、10 万条轨迹、约 2000 个 RL 任务的原始数据可得性不明,因此"从零复现训练"目前不可行。算力门槛:Pro 为 397B 总参/17B 激活的 Qwen3.5 基座,推理即需多卡;OSWorld-Verified(361 任务)、OSWorld 2.0(500 步预算)、WebArena(812 任务)的评估都需要数百个 E2B 沙箱级别的并行与不短的墙钟时间;全量训练(400 万 GUI 步中训+长程 SFT+GRPO RL)需要可观的沙箱预算与 GPU 集群。可行的复现路径分三档:低门槛——下载 released 模型+Harness 代码跑六基准验证论文数字,或复现 Ultrafast(只需约 22.6 万决策状态、4.21M/47.49M 可训参数,单 GPU 部署);中门槛——用 Harness 复现采集/评估管线,自建小规模任务集体验飞轮流程;高门槛——完整三阶段训练复现,需要披露的数据落地后才可能。总体评估:系统与模型可复现、数据与训练不可完整复现,属于"开源结果验证友好、训练复现困难"的类型。
论文图表
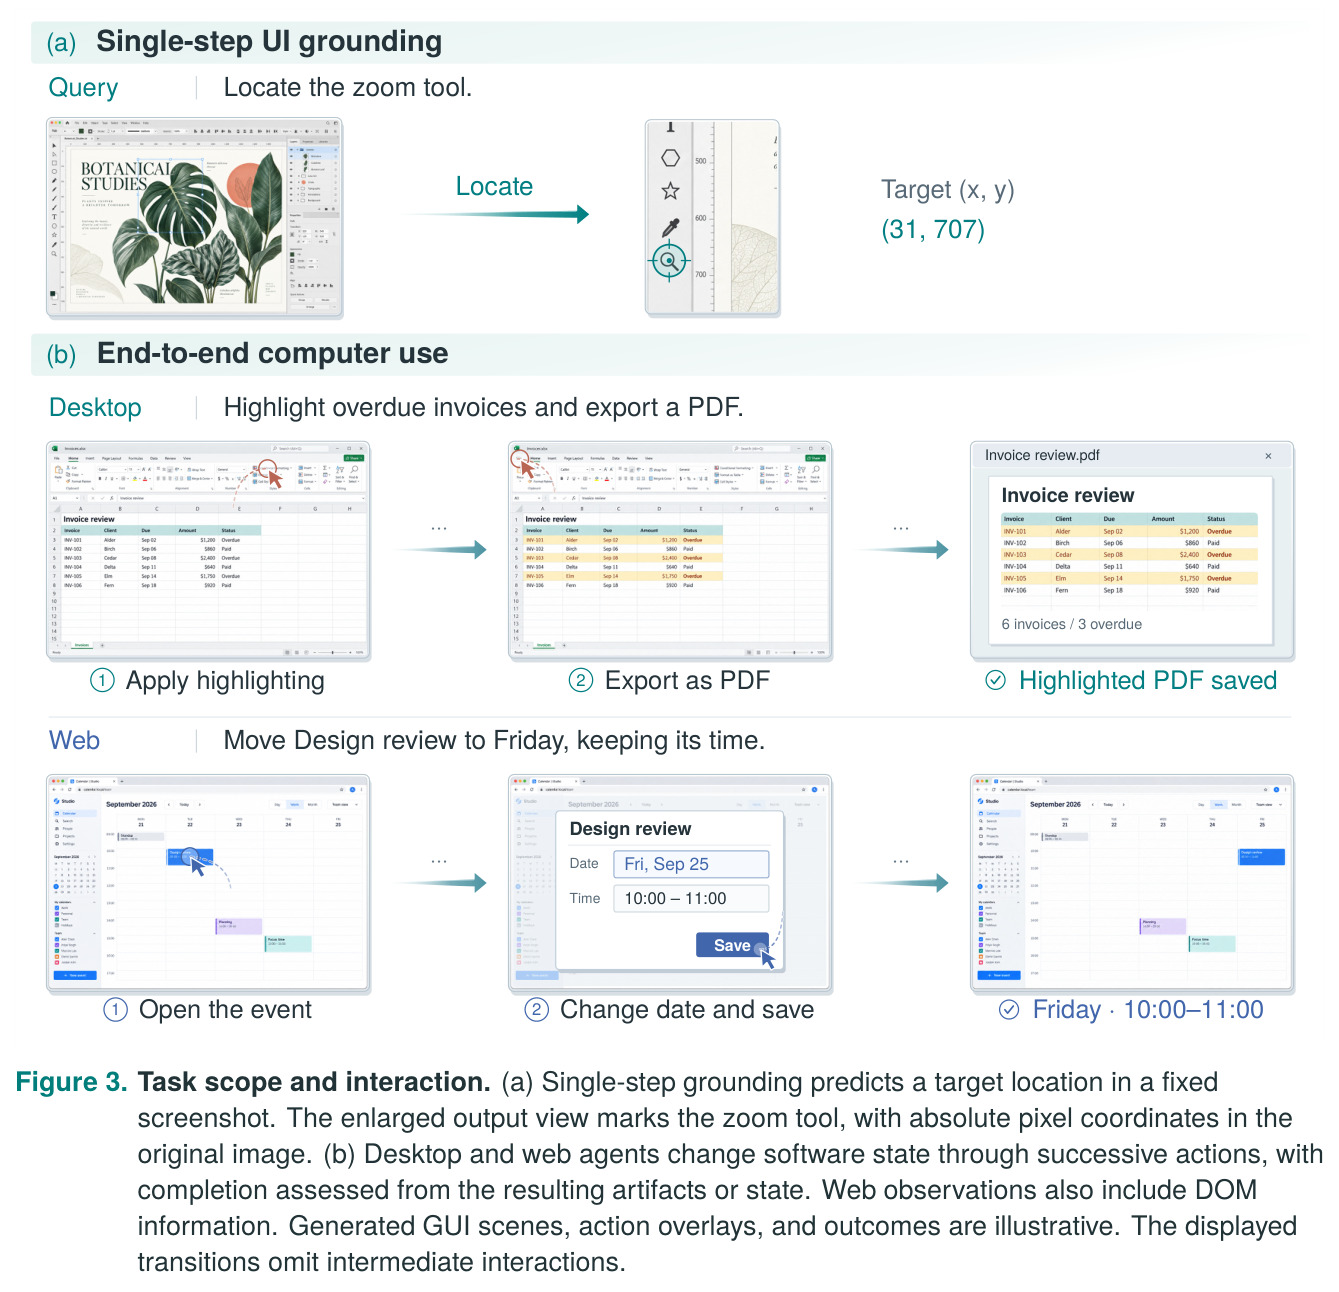
(a) 单步 grounding 示例:查询"Locate the zoom tool"预测原图坐标 (31,707);(b) 端到端示例:桌面任务"高亮逾期发票并导出 PDF"和 Web 任务"把 Design review 移到周五并保持时间",各含初始界面、中间动作与最终产物。
界定了论文研究的两级任务(定位 vs 完成工作)与桌面/Web 两种交互形态,是评测协议的基础。