选择不等于学习:为模型挑选未来 Selection Is Not Learning: Choosing Model Futures
自进化训练应实证确认每次更新而非盲目继承,并把参数继承与经验继承解耦
前置知识
自进化语言模型循环
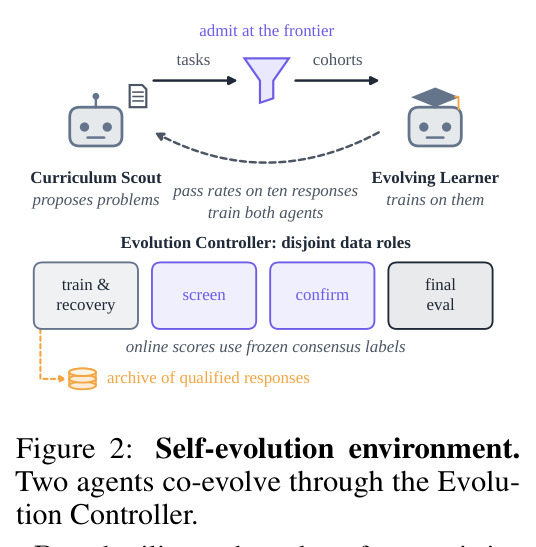
R-Zero、Agent0、Skill Self-Play 等范式:由 Curriculum Scout 生成任务、Evolving Learner 在其上训练,两智能体共同演化。由于任务是模型自己出的,每轮的继承决策会同时改变学习者和后续课程,进步与退步都会逐轮复利累积,甚至出现先把指标推高再整体崩塌的 rise-and-collapse 现象。
本文的全部动机与实验都架设在这类循环之上;HEIRCOMMIT 和 EVOHEIR 正是插在『每轮结束时继承哪个模型』这一决策点上的改进方案。
正确目标负对数似然(correct-target NLL)
在已知参考答案的题目上,模型对正确答案 token 序列的平均负对数似然。更新前后的差值称为 NLL 增益,度量这次更新是否让正确答案变得更可信。它比准确率更细粒度:一个更新可能没改变答题对错,却在概率分布上系统性地偏移。
论文用它定义『有用/有害更新』:对 96 个 Skill-SP 更新和每宿主 64 个原生更新的审计中,NLL 增益是否为正是核心判据。
前向 KL 散度与知识蒸馏
前向 KL 记作 $d(P\Vert Q)=\sum_{v} P(v)\log\frac{P(v)}{Q(v)}$,期望在教师分布 $P$ 上取,倾向让学生覆盖教师的所有模式(mode-covering)。蒸馏即冻结教师网络,训练学生逐 token 匹配其输出分布,是压缩和知识迁移的标准手段。
Experience Recovery 的核心吸收机制就是冻结教师加 LoRA 学生,用前向 KL 损失(式 4)同时实现『修复失败』与『保留成功』两个目标。
选择偏差与联合界(winner's curse)
从 $K$ 个候选中挑分数最高者时,即便每个候选的估计都无偏,被选中者的分数也系统性偏高(乐观偏差)。若复用同一批打分证据去做接受/拒绝决定,错误概率要对全部 $K$ 个分支取联合界 $K\exp(-m\beta^2/2\sigma^2)$,随候选数线性放大;换一批新鲜证据则无此惩罚。
命题 2 与定理 1 是本文理论核心,解释了为什么筛选和确认必须用不相交的题池,也是『重用筛选证据验收分支』被否定 formal 原因。
LoRA 低秩适配
冻结原模型权重,只训练一对低秩矩阵,即 $\Delta W = BA$(本文 rank 8、$\alpha=16$,作用于 $q_{proj}$ 和 $v_{proj}$),训练开销和显存占用都极小,训练完可把 $\Delta W$ 合并回主干权重,推理时零额外开销。
Recovery 用 LoRA(rank 8、至多 16 步优化)做轻量经验吸收,接受后合并成下一轮原生根状态,是整个框架能每轮快速迭代的工程前提。
研究动机
现有自进化循环(R-Zero、Agent0、Skill Self-Play)用任务侧信号决定收哪些任务——通过率、双模型分歧度、距能力前沿的距离——然后无条件继承每次训练更新得到的新模型。作者的系统审计显示这条路有严重的『选择-更新间隙』:在冻结检查点后抽取的独立新回答下,Agent0 有 52.2%、R-Zero 有 42.0% 被录取的任务实际离开了模型能力前沿;即便把范围缩小到答案精确有效的任务,96 个真实 Skill-SP 优化更新中仍有 60 个(62.5%)没有降低正确目标 NLL。更危险的是,自训练可以把目标指标先抬上去再在同一训练战役内崩塌,而每轮无条件继承意味着负向更新会与课程一起复利累积。
本文的目标是把继承决策的依据从『这个任务看起来可学』改为『这个更新实际产出了什么状态』:冻结训练得到的后继模型,在新鲜的探针题上与当前模型做配对比较,只有确实更好才继承(HEIRCOMMIT);进一步追问继承的粒度——让下一轮学习器的参数与它吸收的经验可以来自不同来源(EVOHEIR),使有用经验即使产生它的模型被拒绝也能留存。理论上要刻画选择乐观性、证明任务侧信号的不可识别性,并把每轮遗憾分解为筛选、吸收、确认三类误差。
与已有工作不同的是,已有工作的切入点要么全在任务侧:自动课程用学习进度或掌握率选任务(Graves 2017、Matiisen 2020,且 Willems 2020 已论证学习进度信号有缺陷);要么做整状态验收:AlphaGo Zero 在每局自博弈后验收整个网络状态而 AlphaZero 干脆不验收;要么只门控局部组件:APE 验收候选微调、pre-commit 技能验证和 anytime-valid 证书门控 agent 更新但基座模型保持冻结。本文的独特追问是:一个有用的经验捐赠者,是否必须同时提供下一个学习器的参数?把『选参数接收者』与『选经验来源』解耦,再对吸收完成后的最终状态做一次新鲜确认,是被所有先前方案跳过的自由度。
核心方法
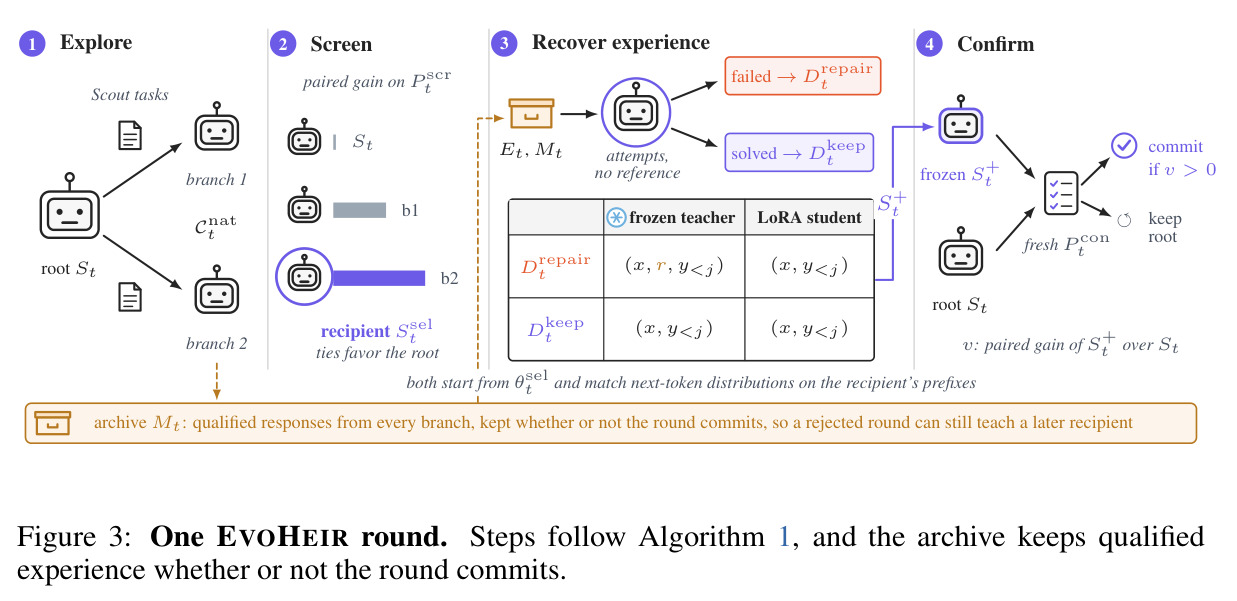
直觉上,本文把一次训练更新当成一个需要审判的『候选未来』,而不是默认继承的产物。每轮四步(Figure 3 / Algorithm 1):(1) Explore——从根状态 $S_t$ 用宿主原生目标训练两个隔离分支,端点连同可恢复训练状态构成候选集 $C^{\text{nat}}_t$;(2) Screen——冻结全部候选后,在与训练不相交的筛选池 $P^{\text{scr}}_t$ 上用配对的根相对分数选出接收者 $S^{\text{sel}}_t$(分支端点或根本身,平局偏向根);(3) Recover——用当前轮与存档 $M_t$ 中的合格参考解,修复接收者做不出的题、同时保住它原本会做的题,产出提案 $S^+_t$;(4) Confirm——HEIRCOMMIT 把 $S^+_t$ 冻结后在新鲜确认池 $P^{\text{con}}_t$ 上与根做配对比较,仅当增益 $v>\tau_t$(实证取 $\tau_t=0$)才继承,否则完整回滚根状态。无论提交与否,合格经验都进入有界存档供后续轮次使用。
两个本质区别。其一,HEIRCOMMIT 是『来源无关』的最终验收规则:它不信任任何产生候选的过程——不看好不容易的筛选分数、不看好不容易的任务难度,只在吸收完成后的冻结状态上用新鲜证据做配对比较。定理 1 量化了这一点:复用筛选证据验收要支付对 $K$ 个分支的联合界 $K\exp(-m_{\text{scr}}\beta^2/2\sigma^2_{\text{scr}})$,而新鲜确认池把这个尾部概率压成与 $K$ 无关的 $\exp(-m_{\text{con}}\beta^2/2\sigma^2_{\text{con}})$。其二,参数继承与经验继承解耦:传统循环里『接受这个模型』与『保留它产生的数据』是绑定的,EVOHEIR 让存档更新走独立路径,被拒绝的轮次仍可作为经验捐赠者——后续干预实验证明 10 个弱于当前模型的捐赠者有 8 个仍能提升接收者。
方法步骤详情
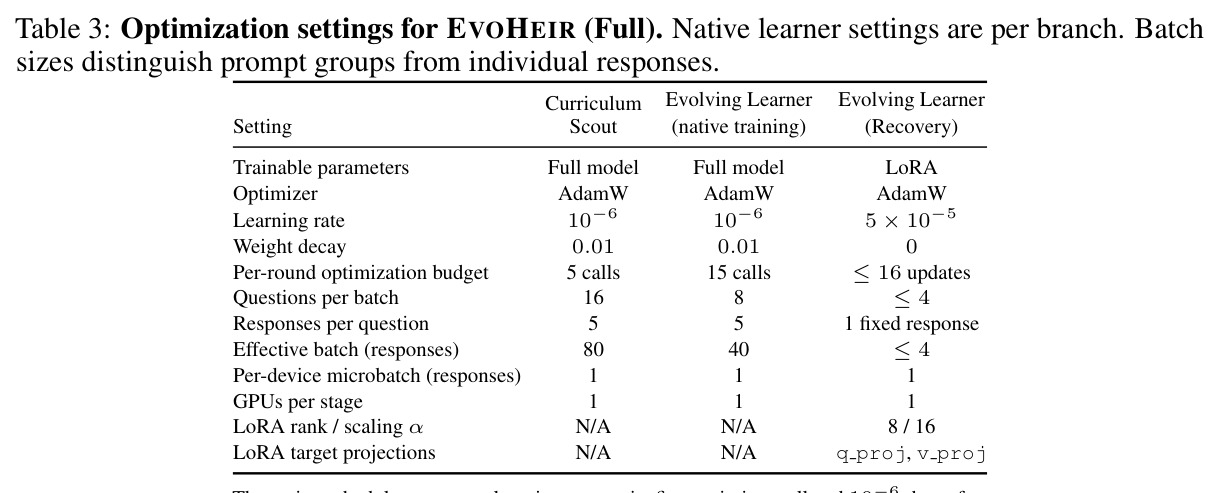
按 Algorithm 1 展开。第一步,Scout 每轮批量发起 1,024 次任务生成尝试,原生录取依据十次学习者回答的共识标签(最大答案簇支持度 $\geq 0.7$ 才能成为探针题)。第二步,原生探索从同一根状态训练两个隔离分支,每支一个 64 题 cohort,AdamW 学习率 $10^{-6}$、每支 15 次优化调用;端点携带优化器矩、学习率调度器和随机数发生器等可恢复状态进入 $C^{\text{nat}}_t$,合格回答进入 $E_t$。第三步,冻结所有候选,在 16 题筛选池上每题抽 4 个新鲜回答,按配对根相对增益选接收者。第四步,Recovery 资格化 $E_t\cup M_t$ 中的记录(完整性、答案有效、按归一化题目去重),用精确检查点缓存或一次 rollout 批拿到接收者的无参考尝试,同一答案等价规则下『失败且有合格参考』进 $D^{\text{repair}}_t$、『尝试成功』进 $D^{\text{keep}}_t$。第五步,冻结教师与学生都从 $\theta_{\text{sel}}$ 初始化,损失为 $\mathcal{L}_{\text{rec}}(\theta)=\langle d(T^j_{\text{repair}},P_{\theta,j})\rangle_{D^{\text{repair}}_t}+\lambda_{\text{keep}}\langle d(T^{\text{keep}}_j,P_{\theta,j})\rangle_{D^{\text{keep}}_t}$,其中修复教师额外看到参考解 $r$,保留教师与学生只见题目,三个分布在同一接收者前缀 $y_{0$ 则继承(LoRA 权重合并为下一轮原生根、优化器与调度器重置),否则完整回滚根状态(含调度器与随机数)。第七步,合格记录无条件写入存档 $M_{t+1}$(上限 256 条,冲突标签与不完整回答被排除,按轮次/来源分层轮转准入)。
技术新颖性
理论上是首次把『选择-更新间隙』形式化:命题 1 证明仅凭更新前行为观察 $O_t$ 无法识别更新价值——存在两个可微学习世界,根行为、目标有效性与步长完全相同,而更新后价值分别为 $+\Delta$ 和 $-\Delta$,任何只看 $O_t$ 的持久化规则最坏期望遗憾至少 $\Delta/2$;命题 2 证明筛选赢家必然乐观 $\mathbb{E}[\hat V_{k^*}-V_{k^*}]\geq 0$;定理 1 给出新鲜确认的指数尾部界以及跨自适应轮次 $\sum_t\delta_t\leq\delta$ 的同时有效界;推论 1 给出遗憾分解 $R_t\leq 2\epsilon_{\text{scr}}+d_{\text{rec}}+\epsilon_{\text{con}}+\tau$。方法上,Recovery 把蒸馏(Hinton 2015)和 Learning without Forgetting(Li & Hoiem 2017)改造成『接收者条件化』版本:修复与保留的分组对当前接收者重新判定,因此一个存档里的旧成功,只要当前接收者复现不了,就自动变成修复材料。与 AlphaGo Zero 的整状态验收相比,EVOHEIR 额外保留了经验通道,使参数演化停滞时学习仍可经存档继续。
实验结果
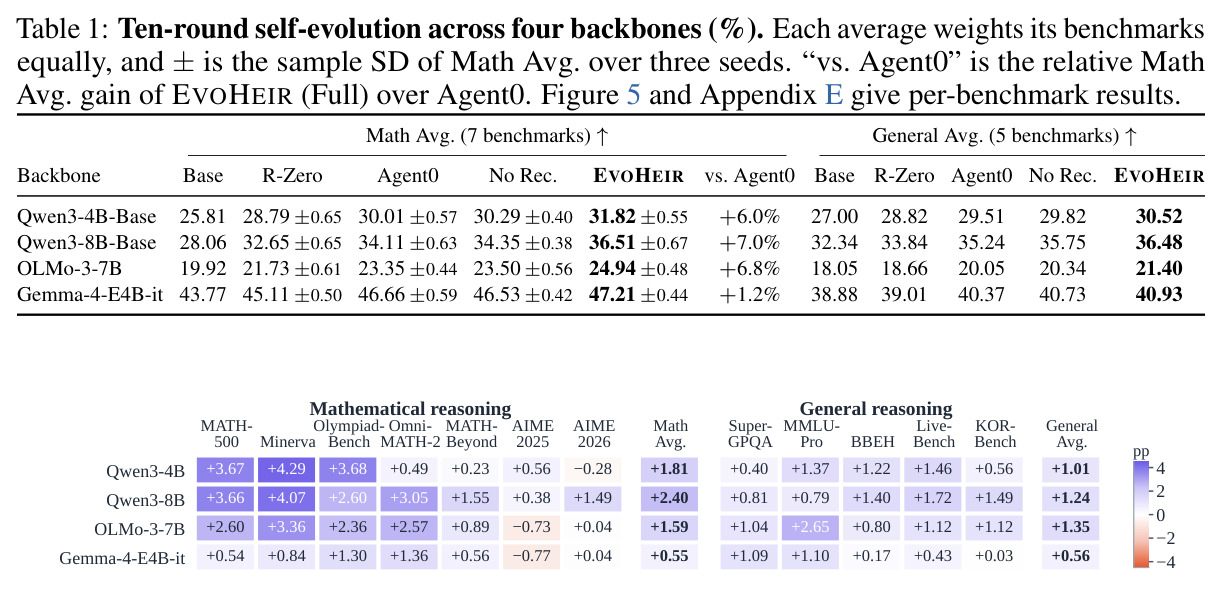
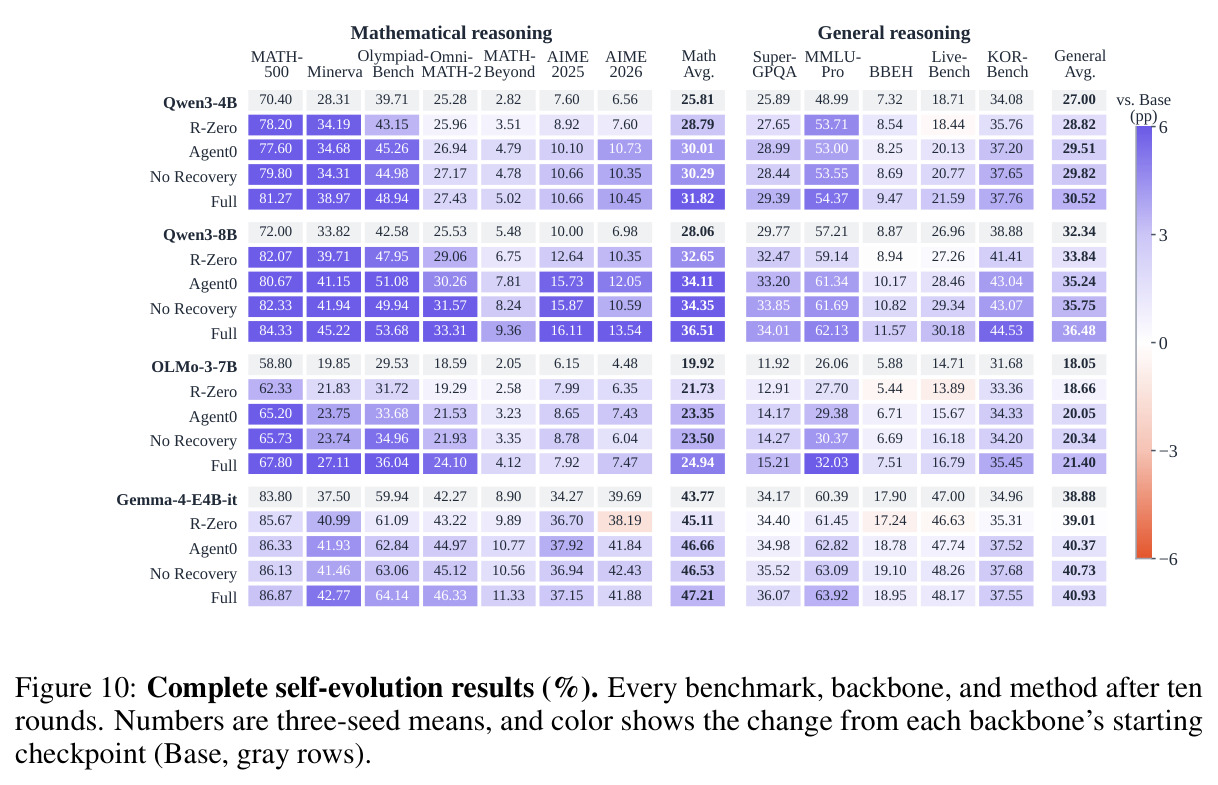
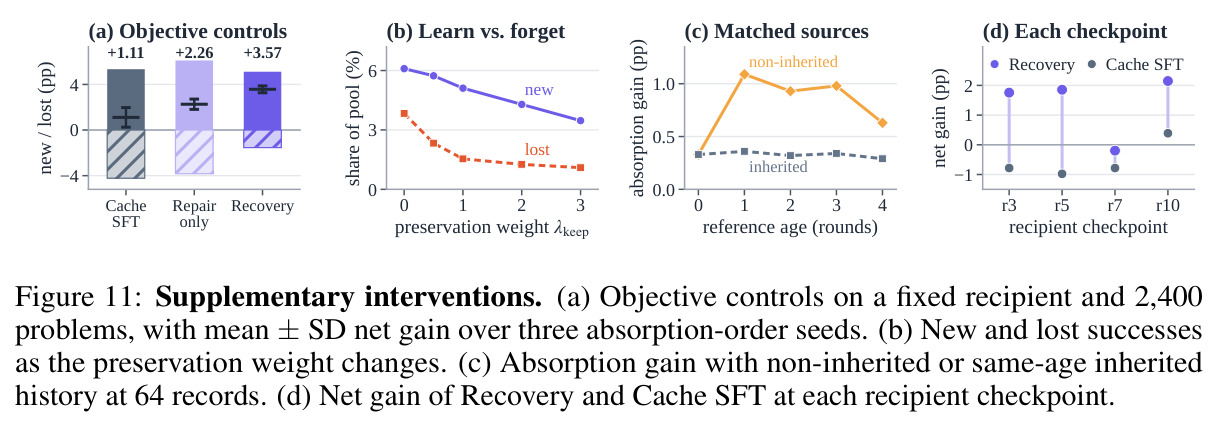
逐一分析五组实验。(1) 任务选择不预测学习(Figure 4a,b):Agent0 的选择目标乐观性(目标在被选回答上的支持度减去新鲜回答上的支持度)为 8.60 pp、R-Zero 为 4.10 pp,而目标与回答无关的固定目标对照仅 0.20 和 $-0.10$ pp;新鲜回答下 52.2% 的 Agent0 录取任务和 42.0% 的 R-Zero 录取任务离开原生前沿;96 个精确有效任务上的 Skill-SP 更新中 60 个(62.5%)正确目标 NLL 增益非正。(2) HEIRCOMMIT 审计(每宿主 64 个原生更新,Figure 4c,d、Table 4):提交覆盖率 23–52%,有害提交占比从无条件继承的 47–77% 降到 13–16%,在相同接受率下比随机提交相对降低 68–83%,同时保留 78–87% 的有用更新;池均值 NLL 增益上 R-Zero 从 $-23.17$ 翻正到 $+10.19$、Skill-SP 从 $-3.47$ 到 $+2.49$(单位 $10^{-3}$ NLL),Agent0 从 $+2.80$ 增至 $+14.35$,约五倍。(3) 十轮自进化(Table 1):四个骨干的数学平均全部最高——Qwen3-4B 31.82(基座 25.81、Agent0 30.01)、Qwen3-8B 36.51(28.06/34.11)、OLMo-3-7B 24.94(19.92/23.35)、Gemma-4-E4B-it 47.21(43.77/46.66);对最强基线 Agent0 提升 +1.59 到 +2.40 pp(相对 6.0–7.0%,摘要口径为数学平均相对提升 5.3%),唯一指令微调起点 Gemma 余量最小仅 +0.55 pp;对基座的数学平均提升 7.9–30.1%;12 基准 × 4 骨干共 48 对中 45 对胜过 Agent0,3 个例外全是只有 30 题的 AIME 集。(4) 经验干预(Figure 7):16 次捐赠者干预中,10 个弱于当前根的捐赠者有 8 个仍提升接收者,其平均捐赠者增益 $-1.09$ pp 但平均吸收增益 $+0.71$ pp;同样 64 条参考下 Recovery 净 $+1.39$ pp 而 Cache SFT 为 $-0.54$ pp(前者得 2.54 失 1.15,后者得 2.08 失 2.61),四个检查点全胜、平均领先 1.93 pp;历史资格从仅当前轮 $+0.39$ pp、加已提交轮历史 $+0.73$ pp、到含被拒绝轮的全部历史 $+1.39$ pp,且在匹配替换记录数后,非继承来源的记录在年龄 1–4 轮仍贡献 0.34–0.73 pp(逐点 95% 层次 bootstrap 区间为正)。(5) 消融与等预算(Table 2、Figure 9):去掉确认的 NoConfirm 掉得最多(Math 31.82→29.80,General 30.52→29.33),三个经验来源消融各掉 0.97–1.28 pp Math;Full 默认配置计费 123.7 单位(单流基线 100),预算只有 0.8 倍时 Full 均值最差、1.0 倍起最优;候选数 4 与确认池 32/64 接近默认配置,$\lambda_{\text{keep}}=1$ 净吸收增益最大。
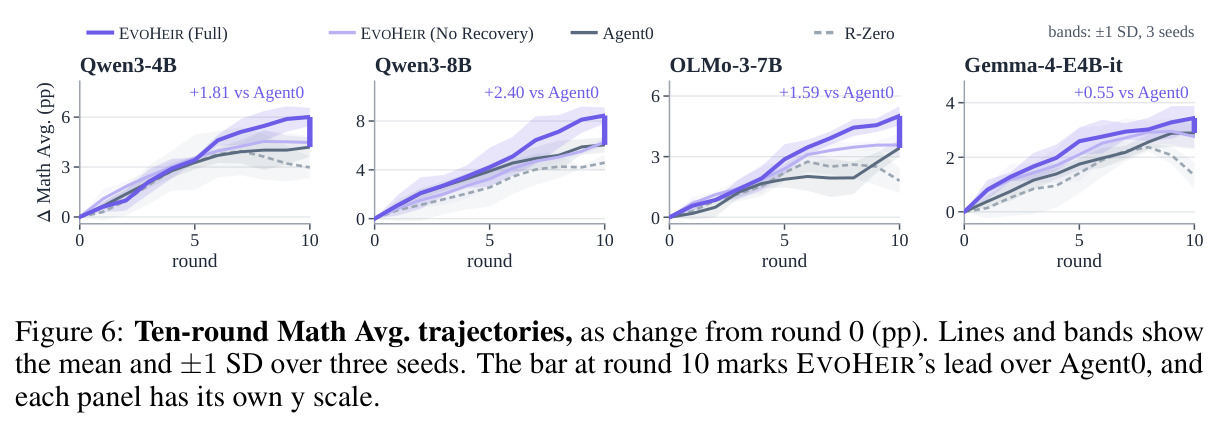
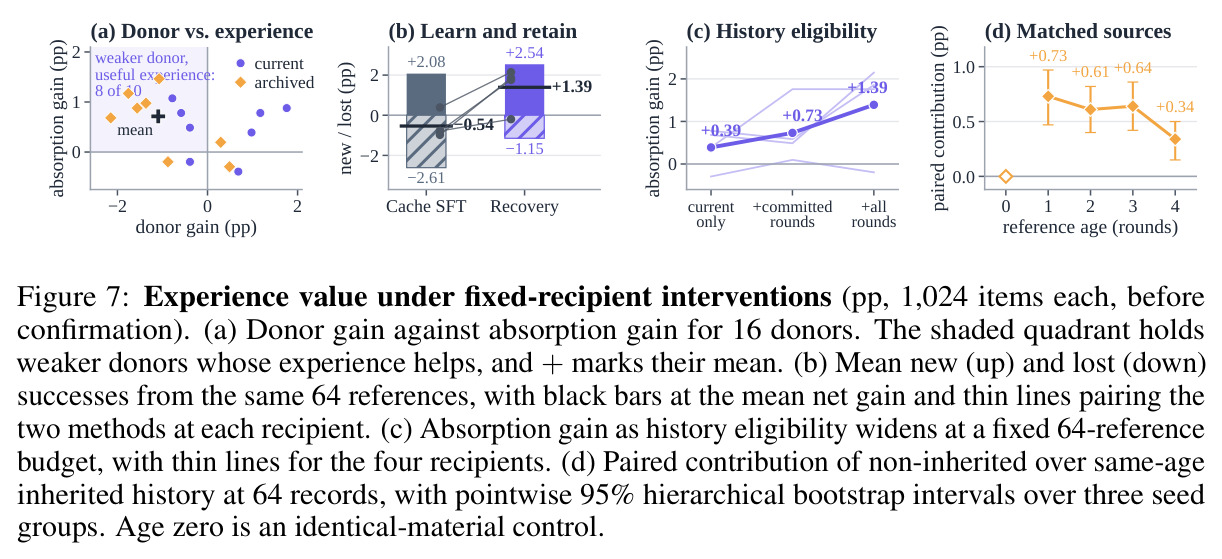
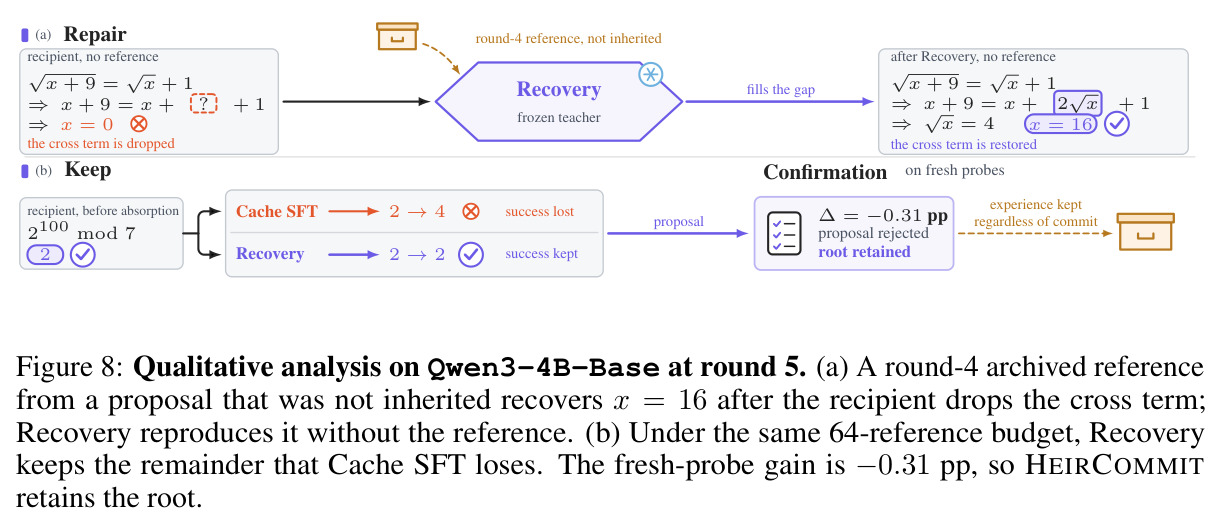
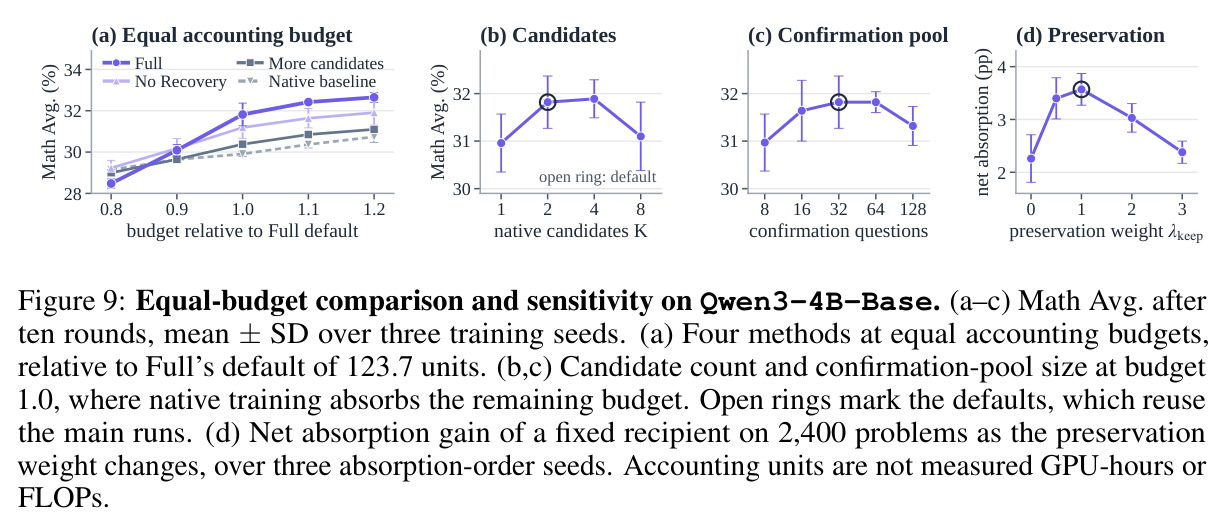
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 更新继承审计(R-Zero / Agent0 / Skill-SP,各 64 个原生更新) | 有害提交占比(接受更新中增益为负的比例) | 13–16%(HEIRCOMMIT) | 47–77%(无条件继承 commit-all) | 同接受率下相对随机提交降低 68–83% |
| 十轮自进化数学平均(Qwen3-8B-Base) | Math Avg(7 个基准等权,%) | 36.51 ±0.67 | Agent0 34.11;基座 28.06 | +2.40 pp(+7.0%)vs Agent0;+30.1% vs 基座 |
| 十轮自进化数学平均(Qwen3-4B-Base) | Math Avg(%) | 31.82 ±0.55 | Agent0 30.01;基座 25.81 | +1.81 pp(+6.0%)vs Agent0 |
| 十轮自进化数学平均(OLMo-3-7B) | Math Avg(%) | 24.94 ±0.48 | Agent0 23.35;基座 19.92 | +1.59 pp(+6.8%)vs Agent0 |
| 十轮自进化数学平均(Gemma-4-E4B-it,指令微调起点) | Math Avg(%) | 47.21 ±0.44 | Agent0 46.66;基座 43.77 | +0.55 pp(+1.2%)vs Agent0 |
| 跨 12 基准 × 4 骨干的配对比较 | 对 Agent0 的逐格胜率 | 45/48 格为正增益 | Agent0(最强基线) | 3 个负例均为仅 30 题的 AIME 小集 |
| 固定接收者经验干预(同样 64 条参考) | 接收者净吸收增益(pp,1024 题) | Recovery +1.39 | Cache SFT −0.54 | +1.93 pp(4 个检查点平均,且全胜) |
局限与改进
作者承认的局限:有害提交没有降到零(仍剩 13–16%),实证采用的零阈值 $\tau_t=0$ 下采样噪声仍可能放行有害提案,严格保证需要定理 1 的正余量认证模式 $\tau_t=\sigma_{\text{con}}\sqrt{2\log(1/\delta_t)/m_{\text{con}}}$;吸收本身可能丢成功——round-7 的 Recovery 净增益就是 $-0.20$ pp;修复依赖验证质量,一个通过验证器的坏参考仍会带偏修复教师;主结果都是固定轮数比较,Full 单轮需 8–9 墙钟小时、十轮 80–90 小时(2×96GB GPU),构造开销 23.7%,且等预算研究中预算只有 0.8 倍时 Full 反而最差。我自己的观察:确认池仅 32 题、筛选池 16 题(每题 4 个回答),对零点几 pp 量级的真实增益统计功效有限;共识伪标签取最大答案簇,意味着『模型的多数派』定义对错,可能系统性地强化模型已有的共同错误模式,也让『离开前沿』的度量存在循环性;任务域几乎全是竞赛数学,General Avg 提升幅度小得多(+0.56 到 +1.35 pp),向开放域、工具调用和 agent 场景的迁移完全未验证;存档上限 256 条、吸收至多 16 步优化是明显的能力天花板;此外没有与其他验收基线(如 APE 式候选微调验收、SOAR 的实际改进信号)做数值对比,只在整状态验收这条线上比较。
独立分析的弱点
第一,确认功效不足:32 题 × 4 回答的确认池对接近阈值的增益判定噪声很大,理论上正余量模式才严格安全但实证全用 $\tau=0$——改进方向是引入 anytime-valid 序贯检验(如 e-process 或置信序列),在题目上动态加抽、早停,用同样算力换取更高的判定功效。第二,共识标签的循环偏置:伪标签来自当前模型回答的最大簇,理论上等价于让『模型已经相信的东西』当裁判,可能强化共同错误——可引入外部验证器(SymPy 符号验算、代码执行、单元测试)替代或校正答案等价规则。第三,域窄:任务生成为竞赛数学、答案必须是 boxed 形式,Recovery 的资格化与蒸馏对 agent 轨迹、长程工具使用任务需要重新设计;General Avg 增益小也提示经验迁移到非数学域并不自动成立。第四,生成利用率低:每轮 1,024 次任务生成尝试最终只喂出 2 支 × 64 题的训练 cohort,绝大部分生成被浪费——可跨轮复用任务池或学习一个廉价的任务价值过滤器。第五,存档只存『题目-参考答案』文本对,不含轨迹级信用分配,也无法在不同骨干间迁移;被拒绝提案的全部推理过程只留下少数合格记录,信息损失严重。
未来方向
作者提出的方向:把定理 1 的认证模式(正余量阈值与跨轮 $\delta_t=\delta/[t(t+1)]$ 分配、支持无界视界)真正部署到实证中,权衡接受灵敏度与错误率;HEIRCOMMIT 作为来源无关验收器,通过适配器接给更多宿主系统(论文已在 R-Zero、Agent0、Skill-SP 三个宿主上验证此路线)。基于本文成果可延伸的方向:与 SOAR/APE 的『实际改进作为课程信号』结合,形成筛选-吸收-确认三级课程;构建跨骨干共享的经验存档,检验捐赠者经验是否跨模型家族迁移(本文已暗示弱捐赠者也能教);把 Recovery 从前向 KL 蒸馏推广到 RL 目标(如对修复组施加优势加权),可能提升吸收上限;研究长期演化中存档的质量衰减、污染防御与淘汰策略;把遗憾分解框架扩展到非平稳任务分布和多提案比较的场景。
复现评估
复现难度中等偏上,但论文的信息完备度很高。四个骨干全部是公开 HuggingFace 检查点(Qwen/Qwen3-4B-Base、Qwen/Qwen3-8B-Base、allenai/Olmo-3-1025-7B、google/gemma-4-E4B-it);Appendix A 与 Table 3 给出完整超参(原生训练 AdamW lr $10^{-6}$,Recovery lr $5\times10^{-5}$、LoRA rank 8 / $\alpha$ 16 作用于 $q_{proj},v_{proj}$、至多 16 步吸收),Appendix B.4 给出 token 级损失聚合、存档准入与回滚语义,Appendix H 给出全部 prompt 模板与验证规则,Algorithm 1 覆盖轮次编排。算力门槛:2 块约 96GB 的 GPU,Full 十轮 80–90 墙钟小时、评测另需 4–5 小时,即单骨干单方法约 4–5 GPU 天,四个骨干加消融与干预研究的总量对学术实验室可行但不算便宜。主要不确定性在于:正文与附录未给出代码开源链接,虽然伪代码和 prompt 足够细,但精确检查点缓存、状态快照/回滚、与三个宿主系统的适配器需要自行实现,这是最大的隐性工程成本;此外审计类实验(96/64 更新)依赖宿主提供可恢复检查点接口。
论文图表
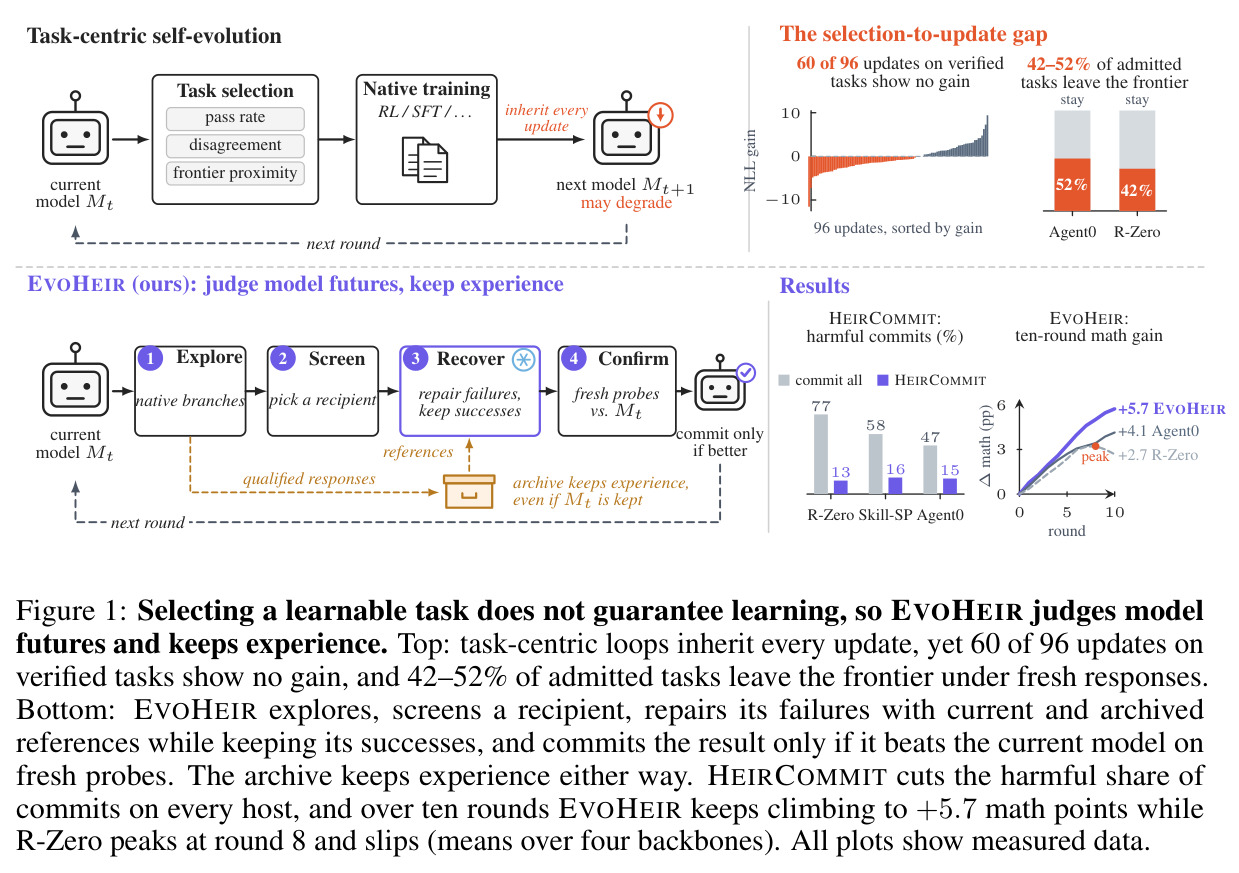
总览图。上半部分:任务中心循环(任务选择→原生训练→无条件继承)的失效证据——96 个已验证任务上的更新中 60 个无增益,42–52% 被录取任务在新鲜回答下离开前沿。下半部分:EVOHEIR 的四步循环(探索、筛选接收者、用当前与存档参考修复并保留、新鲜探针确认后才提交),存档无论提交与否都保留经验;右侧给出结论数字:HEIRCOMMIT 在每个宿主上削减有害提交,十轮 EVOHEIR 数学增益 +5.7 pp,而 R-Zero 在第 8 轮见顶后回落。
一页看懂论文的问题、方法和主结果,是向他人介绍这篇论文时的最佳入口。
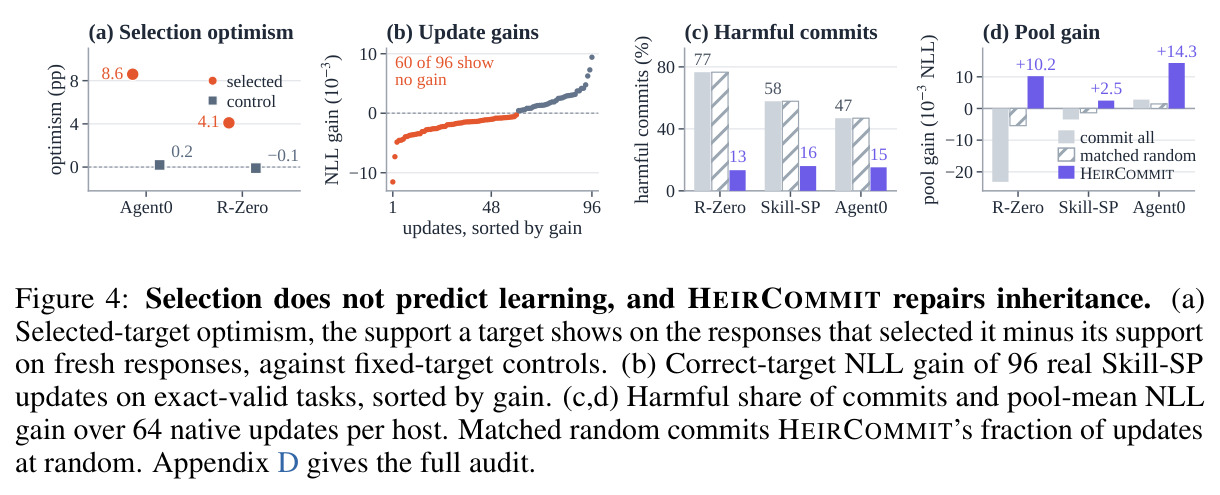
四个审计面板:(a) 选择目标乐观性——Agent0 8.60 pp、R-Zero 4.10 pp,固定目标对照近零(0.20/−0.10 pp);(b) 96 个真实 Skill-SP 更新的正确目标 NLL 增益排序图,60 个非正;(c) 每宿主 64 个更新的有害提交占比,commit-all 58/47/77% 降至 HEIRCOMMIT 的 13/16/15%,同率随机提交无效;(d) 池均值 NLL 增益,R-Zero 与 Skill-SP 由负翻正,Agent0 增益约五倍。
支撑论文两个核心主张的全部审计证据:任务侧选择信号失效 + 新鲜确认修复继承,数字密度最高。
12 个基准 × 4 个骨干的热力图,显示 EVOHEIR 相对 Agent0 的逐基准增益:Qwen3-4B 数学平均 +1.81 pp、Qwen3-8B +2.40 pp、OLMo-3-7B +1.59 pp、Gemma +0.55 pp;48 格中 45 格为正,3 个负格均为 30 题 AIME 集(如 Qwen3-4B 的 AIME-2026 −0.28 pp)。
展示结论的粒度与稳健性:优势不是个别基准的产物,且诚实地暴露了小样本基准上的例外。
Qwen3-4B 上的组件消融:Full 31.82/30.52;Same-Lineage 30.77/29.99;Random Experience 30.54/29.87;Current-Round Only 30.85/30.04;NoConfirm 29.80/29.33。去掉确认的损失最大(−2.02 Math),三个经验来源消融各损失 0.97–1.28 pp。
量化每个机制的边际贡献,证明定向经验复用与最终确认决策两者缺一不可。
Figure 4c,d 背后的完整审计数字:三个宿主上 commit-all / 匹配随机 / HEIRCOMMIT 的覆盖率、有用更新保留率、有害提交占比与池均值增益。如 R-Zero:commit-all 有害 76.56%、池增益 −23.17;HEIRCOMMIT 覆盖 23.44%、保留 86.67%、有害 13.33%、池增益 +10.19。
HEIRCOMMIT 主张(68–83% 有害削减)的原始数据,也是检验『保留有用更新』这一权衡的关键。