质疑问题:维持推理模型的自进化 Questioning the Questions: Sustaining Self-Evolution in Reasoning Models
给自生成问题加上有效性与新颖性双重质检,让推理模型自进化十轮持续涨点
前置知识
GRPO(组相对策略优化)
DeepSeekMath 提出的强化学习算法:对每个输入采样一组响应(本文8条),用组内奖励减去组均值得到相对优势作为策略梯度信号,无需训练价值网络,并以 KL 惩罚约束策略不偏离参考模型。训练成本低,是当前推理模型 RL 的主流选择。
本文所有训练环节——解题器的有效性初始化、出题器更新、解题器更新——全部建立在 GRPO 之上,不理解组内相对优势就读不懂奖励设计如何影响行为。
出题器–解题器自博弈框架
同一基础模型分饰两角的零数据自进化范式(R-Zero 为代表):出题器生成新题,其奖励是解题器答题的一致性 $s(q)$,在 $s=1/2$ 处最大,从而偏向“半会半不会”的中等难度;解题器再用多数投票伪标签做 GRPO 更新,两角色交替进化。
本文诊断的性能崩塌正发生在这个循环里,R-Quest 的两项反馈直接插入出题器奖励与解题器训练数据构造,不先理解框架就不知道改在哪里。
答案一致性过滤与伪标签
无真实标签时构造监督的常用手段:每题采样 $M$ 条解答,取主流答案为伪标签,一致性 $s(q)=\frac{1}{M}\sum_{j}\mathbb{1}[a_j=\tilde{a}(q)]$;R-Zero 只保留 $s(q)\in[0.3,0.8]$ 的题进入解题器训练集,过易或过难的题被丢弃。
本文发现这一过滤反而放大无效问题占比(第5轮有效率降至27.64%),这是动机部分最反直觉、最关键的证据之一。
BLEU 词面聚类去重
R-Zero 的多样性控制:用成对 BLEU 距离把生成问题聚成簇,并按簇大小 $|C(q)|/B$ 施加重复惩罚。BLEU 只度量 n-gram 词面重叠,改措辞、换符号或换数值就能让同一道数学题落入不同簇,惩罚随簇碎片化而失效。
这是本文要取代的基线机制:词面相似漏判了数学上等价的重复任务,直接导致题型坍缩,理解其缺陷才能体会语义新颖性判定的价值。
平衡准确率(Balanced Accuracy)
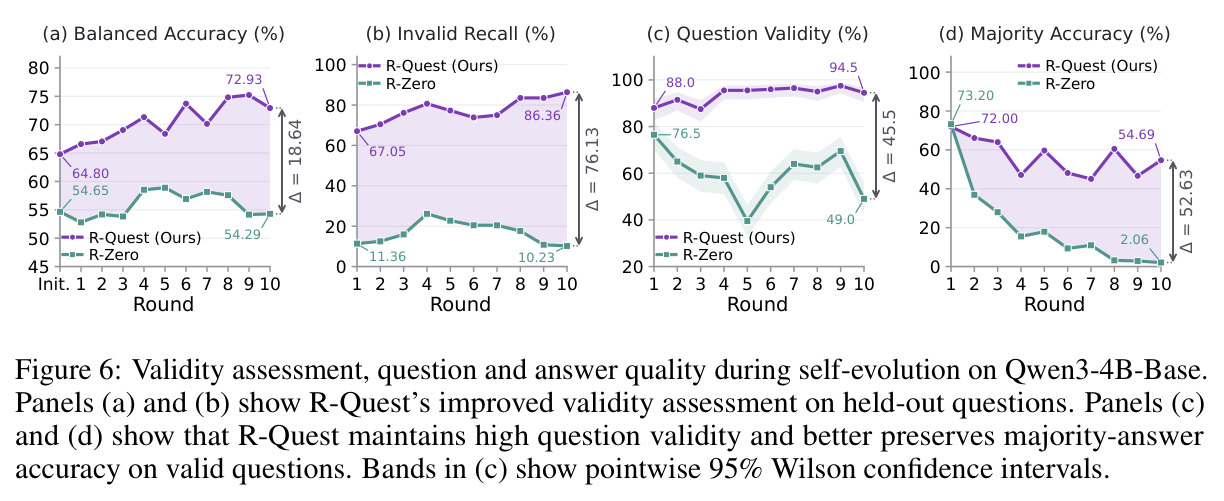
评估二分类器(尤其在“全盘接受”也能刷高单项指标时)的指标,本文定义为 $\frac{1}{2}(\text{Recall}_{valid}+\text{Recall}_{invalid})$,即有效题接受率与无效题拒判率的均值。来者不拒的判官两项分别为100%和0%,恰得50%分。
评估解题器判题能力时靠它排除“来者不拒”的假高分,论文还额外报告无效题召回率,图6(a)(b)的分析完全依赖这两个指标。
研究动机
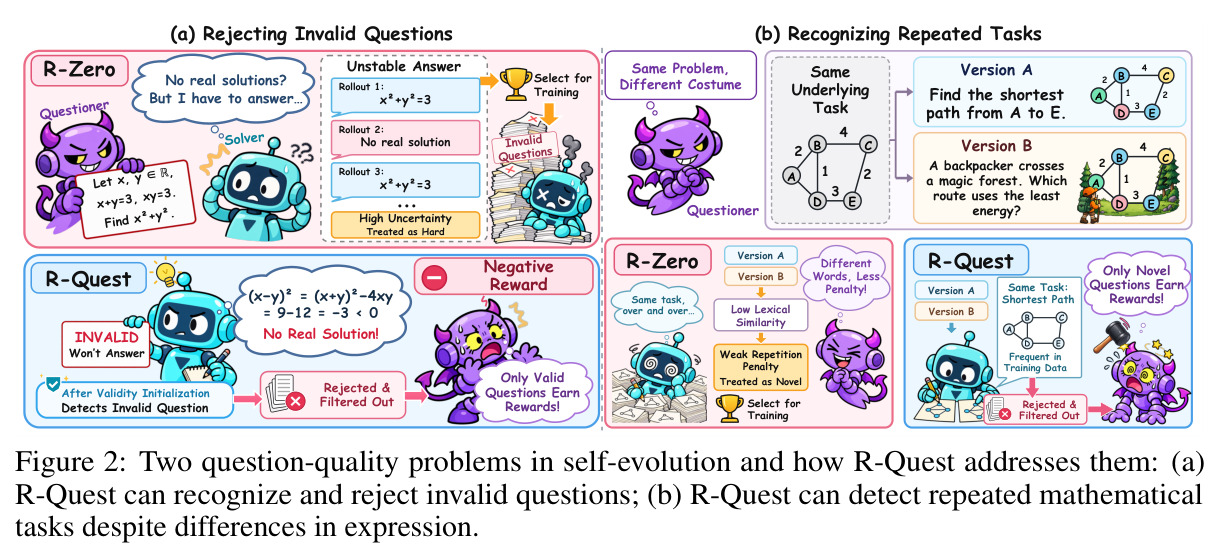
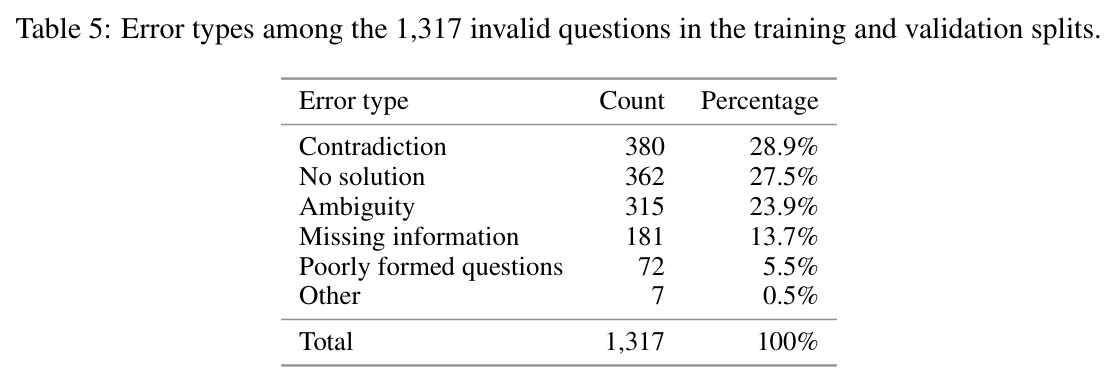
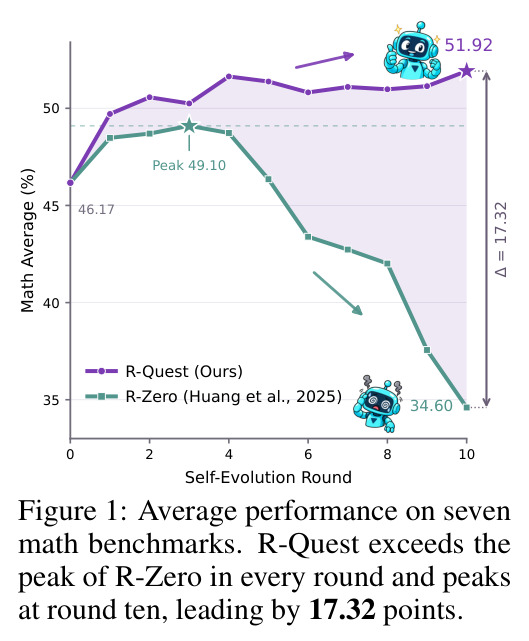
自进化推理模型靠自生成问题训练,但反复自训练会性能崩塌。以 R-Zero 为例,在 Qwen3-4B-Base 上七个数学基准平均分第3轮冲到峰值49.10后持续下滑,第10轮只剩34.60,比不做任何训练的基线46.17还低11.57分。作者抽样诊断发现两类质量问题:其一,无效问题(矛盾、无解、歧义、条件缺失等)随轮次恶化——用 GPT-5.6-Sol 每轮评审200题,有效率从第1轮的76.5%跌到第5轮的39.5%;更糟的是按答案一致性 $s(q)\in[0.3,0.8]$ 过滤后,第5轮训练集中有效率进一步降到27.64%,即过滤反而富集了无效题。其二,重复:第5轮样本中最大的三种题型合计占59.5%,而 R-Zero 基于 BLEU 的聚类把最大题型拆成22个簇,按簇大小施加的重复惩罚因此被稀释,同构数学题换个措辞、符号或数值即可绕过惩罚。控制变量实验进一步坐实因果:在各自含1,273题、共享766道有效题的配对数据集上,把507道无效题换成修复版后训练解题器,七基准平均分从46.54升至49.91(+3.37),说明无效题确实是退化的成因之一。
本文的目标是目标是找出并拆除自进化循环中的两个质量瓶颈,让自进化收益能够跨越十轮持续积累,而不是三四轮见顶后崩塌。具体包含三层:第一,让模型在不调用更强外部模型(如 VHG 依赖的 GPT-5.4 级判官)的前提下,自主识别并拒绝无效问题,并把这一判断能力作为反馈信号约束出题器,从源头抑制无效题进入训练集;第二,把“重复”的判定从词面相似度提升到数学任务结构层面——两题只要数学设置和所求任务相同就算重复,无论措辞、记号或数值如何变化——并用语义层面的新颖性信号控制出题器的探索方向;第三,两项反馈都必须留在自进化闭环内部自给自足。最终衡量标准是:在 Qwen 与 Llama 两个模型家族、跨数学推理/代码生成/通用推理共12个基准上取得最高的域平均分,且在长达十轮的自进化中保持稳定增益,第10轮仍创新高。
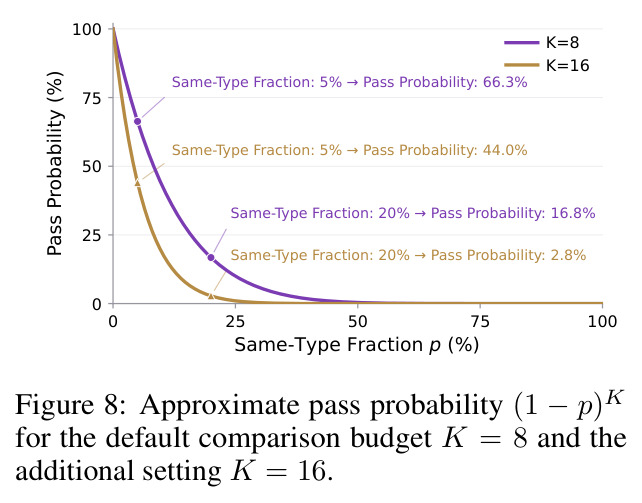
与已有工作不同的是,已有稳定化方案各有妥协:VHG 依赖 GPT-5.4 等更强外部模型在线验证生成题目,破坏了自进化“自我反馈”的前提;OCNR 用解题器隐层表示训练单类新颖性检测器打分;R-Diverse 则要外挂 Qwen2.5-Coder-7B 代码生成器与 Jina 代码嵌入模型来判断解题路径是否重复,均引入额外模型,且判定粒度不在“数学任务本身”。本文的独特切入是把问题质量当作一等公民:先做“中间训练”(mid-training)把拒判无效题的技能注入解题器,再用它做在线有效性门控;同时把新颖性判定归约为一个原子判断——“这两道题是不是同一数学任务类型的变体”——交由一份冻结的基础模型副本完成,每题只需批内 $K=8$ 次随机两两比较。由此既不需要外部更强模型,也不需要额外编码器,把有效性与新颖性两类反馈都收进自进化闭环。
核心方法
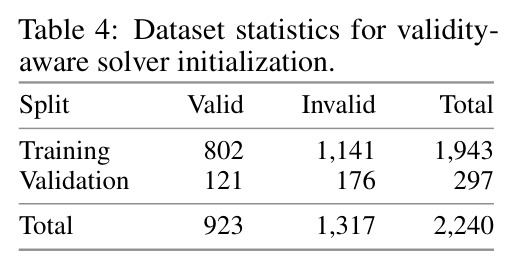
直觉上,自进化崩塌不是因为题目太难解不出,而是“考卷本身”出了问题:题是病题(无效),解题器只能在未声明假设上编造推理并强化这类伪推理;或者题是旧题换皮(重复),出题器靠换措辞刷分导致题型坍缩、课程失去信息量。技术路线分三步。第一步,有效性感知初始化:用 GPT-5.6-Sol 标注2,240道来自 R-Zero 前五轮的问题(923有效/1,317无效),以 GRPO 训练基础模型“能解则解题,发现题有缺陷则答 INVALID”,把拒判能力装进解题器;第二步,语义新颖性判定:用冻结的基础模型副本做两两比较,判断两题是否同属一个题型,每题随机抽 $K=8$ 个参照,任一同型即拒;第三步,把两路反馈接进出题器奖励:先生效性门 $g_{valid}(q)=\frac{1}{2}-u(q)$($u(q)$ 为9次采样中答 INVALID 的比例),通过者再乘新颖性门 $g_{novel}(q)$ 与不确定性奖励 $\min\{s(q),1-s(q)\}$,随后按 R-Zero 流程构造数据训练解题器,并混入10%初始化数据回放以防拒判技能遗忘。两角色如此交替更新。
核心创新有二。其一是把“判断题目是否有效”变成解题器一项可训练、可随自进化持续强化的技能:初始化奖励为 $R_{init}(q,a)=\mathbb{1}[a=a^*(q)]-\lambda\,\mathbb{1}[a=\text{INVALID}\wedge a^*(q)\neq\text{INVALID}]$($\lambda=0.5$,另对空答案框罚 $-0.1$),既奖励正确解题与正确拒判,又惩罚误拒好题以防过度拒答;自进化中出题器奖励被门控为 $g_{valid}(q)=\frac{1}{2}-u(q)$,被判无效的题直接拿负奖励。其二,把多样性控制从“表示距离”改为“任务语义”:两题共享本质相同的数学设置且所求任务同类即判同型,改常数、变量或措辞不算新题。与 R-Zero 的 BLEU 词面聚类、OCNR 的隐层单类检测、R-Diverse 的解题路径嵌入相比,这是唯一不外挂模型、且判定标准直接对齐“什么算同一道数学题”的方案;冻结判官副本的设计还保证判定标准在整个进化过程中漂移最小。
方法步骤详情
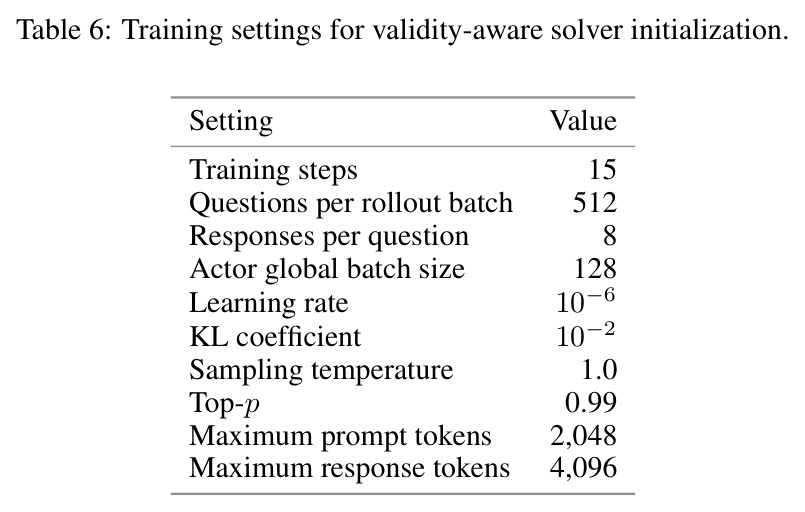
完整流程如下。(1) 数据构建:从 R-Zero 前五轮解题器训练集去重后等额抽题,GPT-5.6-Sol 两阶段标注——先解题并判有效性(A~F 六类,仅 A 算有效),再独立求解有效题生成参考答案,经审计复核后得2,240题(训练1,943/验证297)。(2) 有效性初始化:GRPO 训15步(批512题×8响应,学习率 $10^{-6}$,KL 系数 $10^{-2}$)。(3) 出题器更新:每轮批内约2,048个候选,冻结解题器每题采9次有效性响应得 $u(q)$,$g_{valid}(q)<0$ 者奖励即 $g_{valid}$;通过者抽8个批内参照做新颖性判定得 $g_{novel}$,奖励为 $g_{novel}\cdot\min\{s(q),1-s(q)\}$,$s(q)$ 来自另采的10条解答。(4) 解题器更新:新出题器每轮生成约10,000题,过同样有效性检查后每题采10个解答,保留 $s(q)\in[0.3,0.8]$ 且多数票非空者作伪标签,混入10%初始化回放数据(沿用有效性任务与奖励)做 GRPO。(5) 两角色交替,循环十轮。
技术新颖性
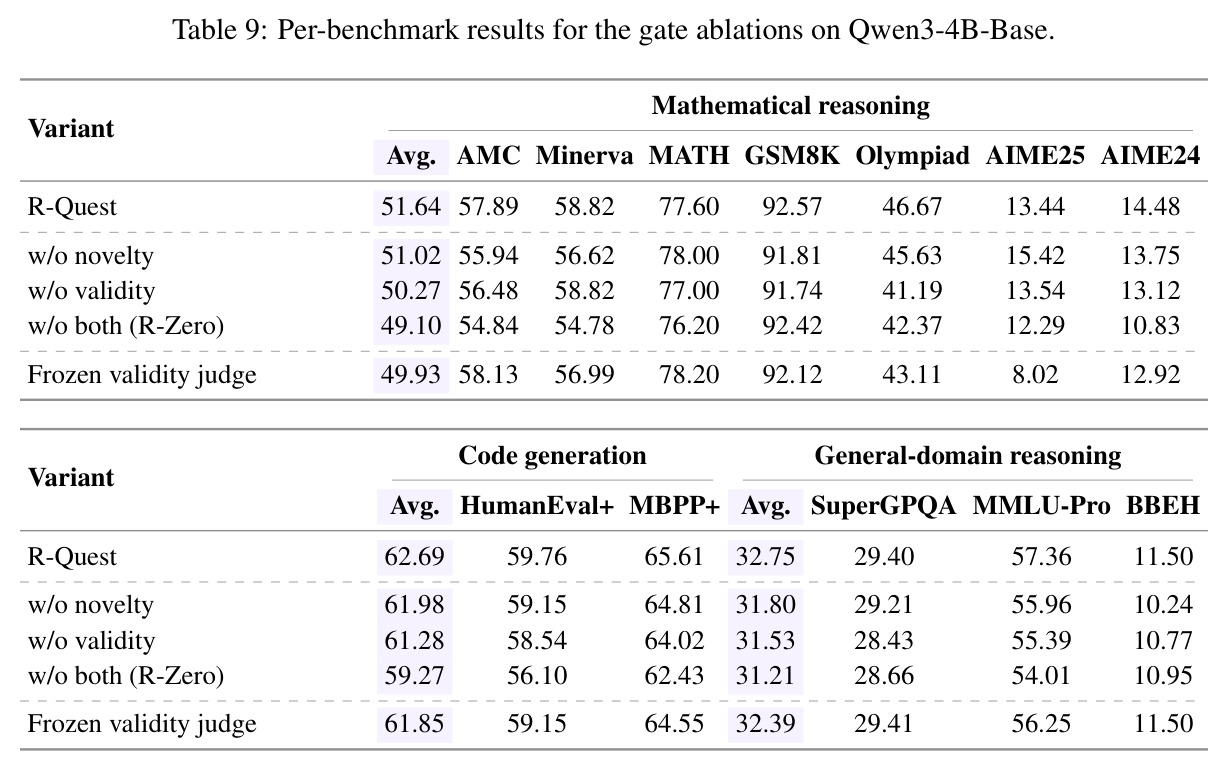
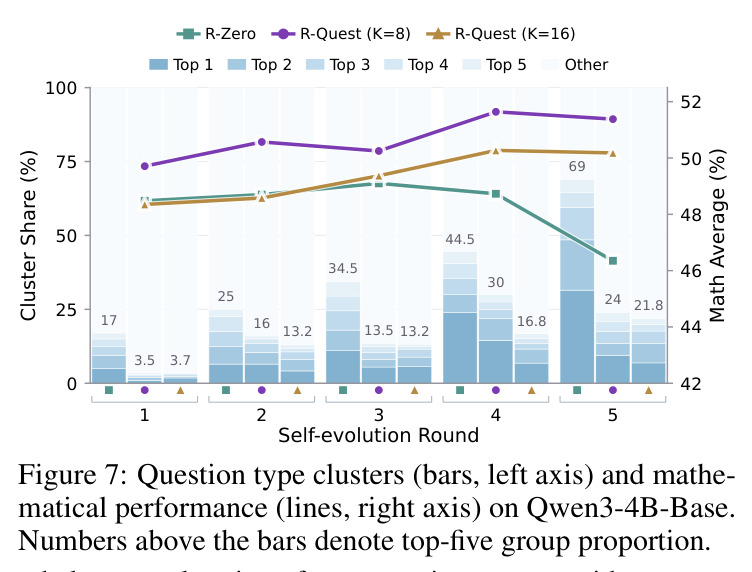
技术新颖性体现在四点。第一,诊断本身即有贡献:首次量化了“一致性过滤放大无效题”这一反直觉现象(第5轮有效率从39.5%再降到27.64%)和“BLEU 聚类碎片化削弱重复惩罚”(最大题型被拆成22簇),为后续工作提供了清晰的问题刻画与可复用的测量协议。第二,把拒判能力做成可持续进化的“中间训练”而非一次性数据清洗:消融显示若换成每轮固定不变的冻结有效性判官,数学均分从51.64掉到49.93,证明随进化持续训练判官本身是必要的。第三,新颖性判定的原子化与成本控制:不需要嵌入模型或表示学习,只做“同型/不同型”的两两判断,$O(B^2)$ 的穷举门 $\prod_{j\neq i}(1-p_{ij})$ 被均匀无放回采样松弛为 $O(BK)$,通过概率有解析近似 $\Pr(\text{pass}\mid p)\approx(1-p)^K$,使 $K$ 从玄学超参变成可事先按题型分布预估的旋钮(如 $p=20\%$、$K=8$ 时通过率仅16.8%)。第四,两个门控在训练中均不引入新参数,冻结判官避免判定标准漂移,符合自进化“自我反馈”的初衷。
实验结果
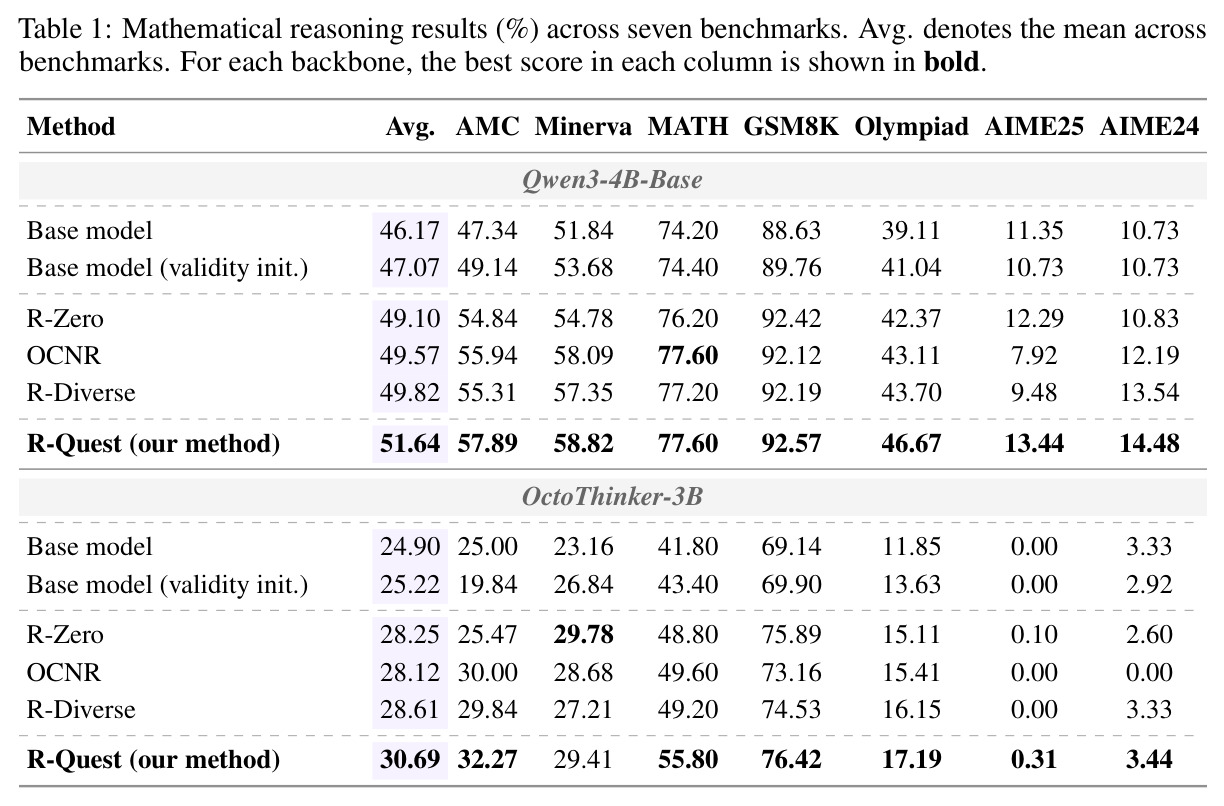
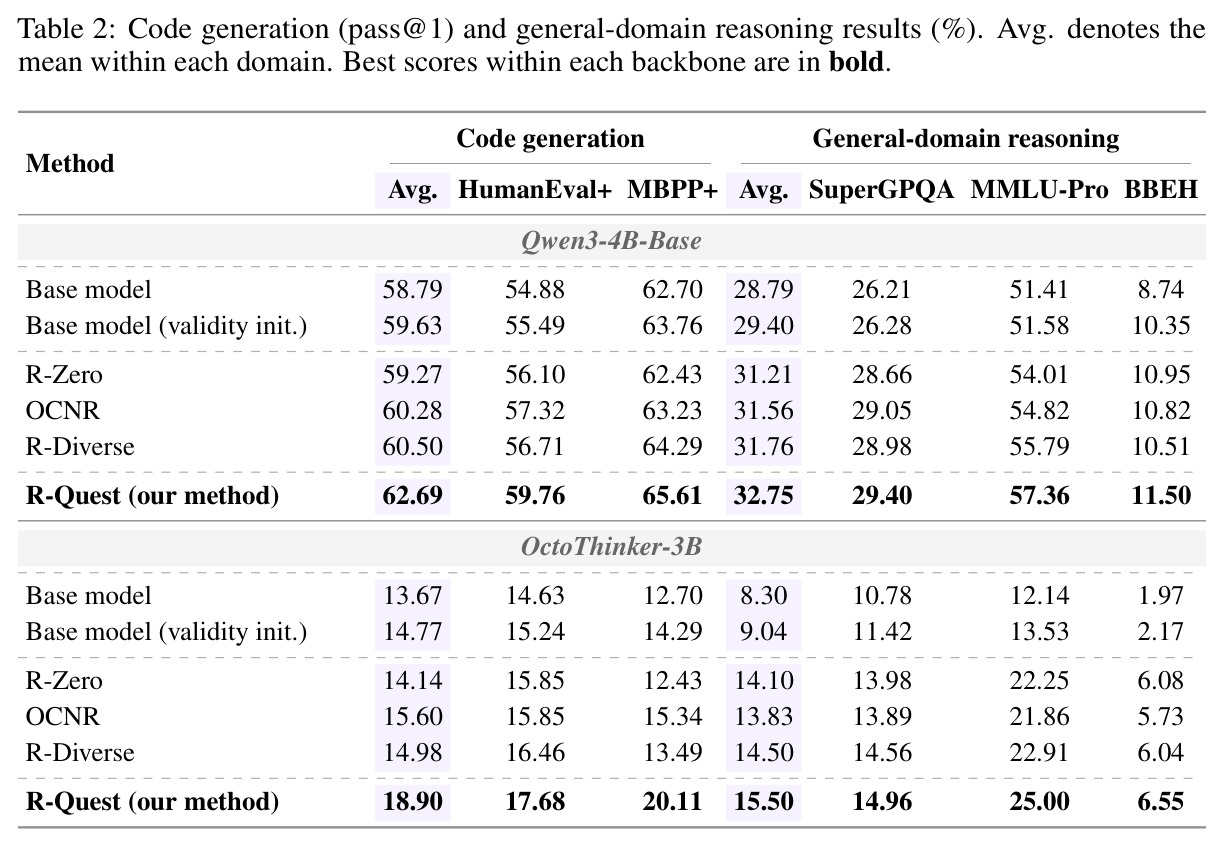
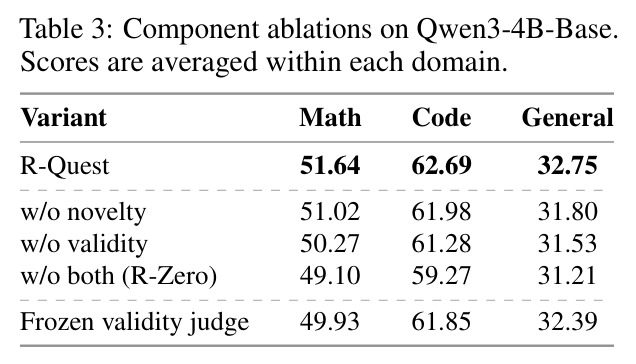
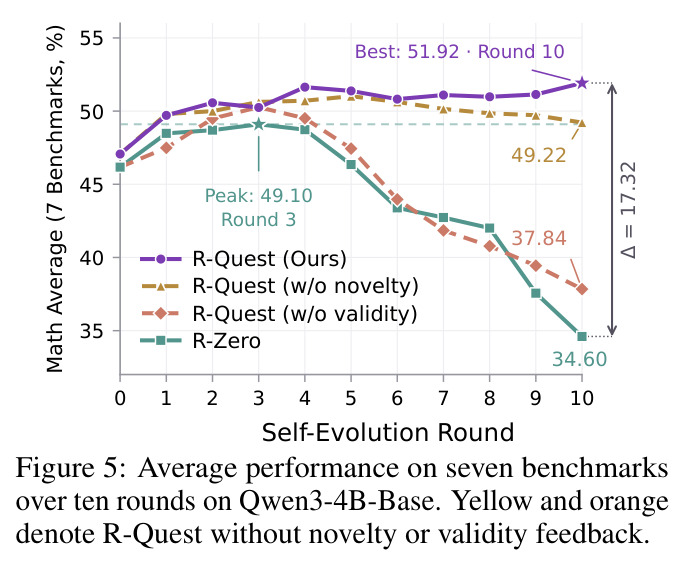
实验覆盖 Qwen3-4B-Base 与 OctoThinker-3B 两骨干、12个基准。数学:R-Quest 在 Qwen 七基准均分51.64,高于 R-Zero(49.10) 与最佳基线 R-Diverse(49.82),较基线46.17提升5.47分,增益为 R-Zero 的1.87倍。十轮实验(图5):R-Zero 第3轮见顶49.10后跌至第10轮34.60;R-Quest 每轮都超过其峰值,第10轮达51.92,领先17.32分。消融(表3):去新颖性51.02、去有效性50.27、全去49.10、冻结判官49.93。机制追踪(图6):判题平衡准确率升至72.93%,无效题召回86.36%(R-Zero 仅10–26%);生成题有效率升至94.5%以上(R-Zero 跌至49.0%);多数答案准确率保持54.69%(R-Zero 崩至2.06%)。多样性(图7):R-Zero 前五题型占比涨至69.0%,R-Quest 第5轮仅24.0%。代码与通用推理亦全场最高:Qwen 代码62.69(+3.90),OctoThinker 18.90(+5.23)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(AMC/Minerva/MATH/GSM8K/OlympiadBench/AIME25/AIME24 平均,Qwen3-4B-Base) | 平均准确率(%,AMC 与 AIME 为 mean@32) | 51.64 | R-Zero 49.10;OCNR 49.57;R-Diverse 49.82 | 较最佳基线 R-Diverse +1.82,较 R-Zero +2.54,较基线模型(46.17) +5.47 |
| 数学推理(7基准平均,OctoThinker-3B) | 平均准确率(%) | 30.69 | R-Zero 28.25;R-Diverse 28.61;基线模型 24.90 | 较 R-Zero +2.44,较基线模型 +5.79 |
| 十轮持续自进化(7数学基准平均,Qwen3-4B-Base,第10轮) | 平均准确率(%) | 51.92(十轮新高,高于基线5.75) | R-Zero 34.60(其峰值49.10出现在第3轮) | +17.32 |
| 代码生成(HumanEval+ 与 MBPP+ 平均,Qwen3-4B-Base) | pass@1(%,EvalPlus) | 62.69(HumanEval+ 59.76,MBPP+ 65.61) | R-Zero 59.27;R-Diverse 60.50;基线模型 58.79 | 较最佳基线 R-Diverse +2.19,较基线模型 +3.90 |
| 代码生成(HumanEval+ 与 MBPP+ 平均,OctoThinker-3B) | pass@1(%,EvalPlus) | 18.90(HumanEval+ 17.68,MBPP+ 20.11) | OCNR 15.60;R-Zero 14.14;基线模型 13.67 | 较最佳基线 OCNR +3.30,较基线模型 +5.23 |
| 通用推理(SuperGPQA/MMLU-Pro/BBEH 平均,Qwen3-4B-Base) | 准确率(%,贪心解码) | 32.75(MMLU-Pro 57.36,BBEH 11.50) | R-Diverse 31.76;OCNR 31.56;R-Zero 31.21 | 较最佳基线 R-Diverse +0.99,较 R-Zero +1.54 |
局限与改进
作者承认的局限:有效性门依赖解题器9次采样的多数投票,初始化后平衡准确率仅64.80%、十轮后也只有72.93%,误判仍会漏进病题或错杀好题;新颖性采样是概率性抑制,K=8 会放过一部分同型题(占比20%的题型仍有16.8%通过率),K=16 又因过严压低成绩,暴露出“抑制重复”与“保留同型内更难变体”的两难。我自己的观察:其一,初始化数据与全部诊断分析(有效性评审、修复实验、题型分组)都依赖 GPT-5.6-Sol,虽然自进化闭环内不调外部模型,但系统构建阶段仍依赖更强模型,判官偏差会内化为模型先验;其二,新颖性判定只在批内进行,跨轮次重复没有被显式惩罚,长期靠采样偶然性兜底;其三,每轮10,000题预算叠加每题9次有效性采样、10次解题采样与8次新颖性比较,推理开销显著高于 R-Zero,论文未报告总算力对比;其四,仅验证了3–4B规模与数学课程,向更大模型和其他领域的迁移未测;其五,各域均报告最佳检查点,实际部署需要额外的检查点选择机制。
独立分析的弱点
独立分析几点弱点。第一,多数投票判官存在系统性盲区:出题器与判官同源,模型出的题倾向落在模型自身认知边界附近,“模型认为是病题”与“客观是病题”之间有分布差,十轮后仍有约27%无效题未被召回,改进方向是引入异源信号,如 Absolute Zero 式的代码执行校验或轻量符号检查器。第二,批内 K 次采样的新颖性门全局无记忆:同一题型这轮被拒、下轮换个批次仍可能通过,也无法在某题型被穷尽后主动切换领域,改进方向是维护跨轮次题型记忆库,把“与随机8题比”改为“与历史代表题比”。第三,不确定性奖励 $\min\{s(q),1-s(q)\}$ 在答案可靠性崩塌时(图6d 中 R-Zero 多数答案准确率仅2.06%)会把噪声伪标签当作课程,R-Quest 靠有效性门缓解但未根治,可为题目增加“答案可验证性”评分。第四,初始化数据依赖 GPT-5.6-Sol 标注,成本与可复现性受限,可用开源大模型加自我一致性流水线替代。第五,K 为静态超参,理想策略应随题型浓度分布动态调度探索–利用比例,图7中 K=16 的过抑制现象正是静态选择的代价。
未来方向
作者在结论中把“评估自生成问题的能力”确立为持续自我提升的关键组件,这为多个方向留出空间。(1) 跨领域课程:将有效性门控迁移到代码(可用测试执行提供客观有效性信号,部分替代判官)、多模态(如文中提及的 Visplay)与文档/工具环境类自进化框架。(2) 学习型判官:用297题验证集与逐轮追踪协议训练专门的验证器,替代多数投票,并研究判官与出题器共进化时的对抗动态。(3) 主动课程:把 $K$ 变成随题型浓度动态调度的量,在探索新题型与深挖同型内更难变体之间自动平衡,直接回应图7的过抑制发现。(4) 理论刻画:对通过概率 $(1-p)^K$ 与题型分布演化的耦合建模,给出自进化不崩塌的充分条件与 $K$ 的最优调度。(5) 规模与周期外推:本文止步十轮、3–4B模型,百轮尺度和更大模型下有效性技能是否饱和、判官是否会漂移值得检验。(6) 跨轮记忆:把新颖性判定扩展为带历史记忆的在线去重,消除批内采样的随机性漏洞。
复现评估
复现条件总体友好。论文附 Project Page 与 Code 链接,附录完整公开流水线:A 部分含初始化数据构建、标注/复核 prompt(A.1–A.5)、奖励函数与训练超参;B 部分含语义比较 prompt(B.1)与通过概率解析式;C 部分含出题/解题 prompt、采样参数(温度1.0、每题9次有效性+10次解题采样)与 GRPO 设置;D 部分给出三个基线的复现配置。骨干均为开源模型(Qwen3-4B-Base、OctoThinker-3B-Hybrid-Base),评测基准全部公开。主要门槛:一是初始化标注与复核依赖 GPT-5.6-Sol(2,240题多阶段调用),有 API 成本,换判官则923/1,317的有效性分布会变;二是算力不小——两个3–4B模型交替 GRPO 十轮,每轮约10,000题候选、每题近30次采样,需多卡环境且论文未给 GPU 时数;三是两个基线为作者按论文复现,细节可能与原实现有出入。综合评估属于材料齐全、中高难度的复现。
论文图表
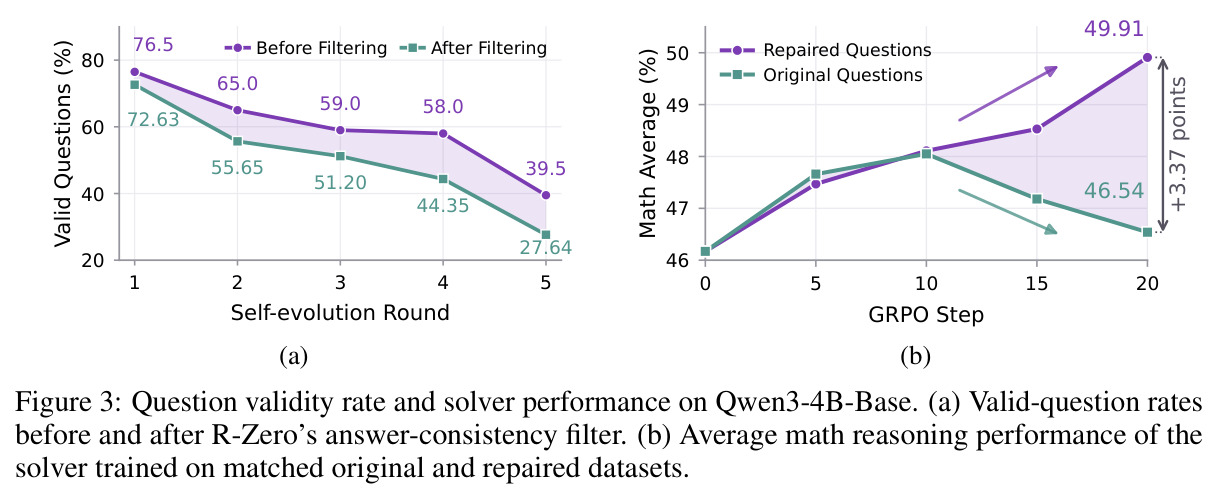
(a) 每轮抽样200题的有效率:过滤前从第1轮76.5%降至第5轮39.5%,经一致性过滤后第5轮仅剩27.64%,证明过滤反而富集无效题;(b) 配对修复实验:同样1,273题、修复507道无效题后训练,最终均分49.91对原始46.54(+3.37)。
这是论文诊断部分最硬的因果证据:不仅展示无效题越来越多的相关性,还用控制变量实验证明无效题确实是性能退化的成因,直接支撑方法设计。
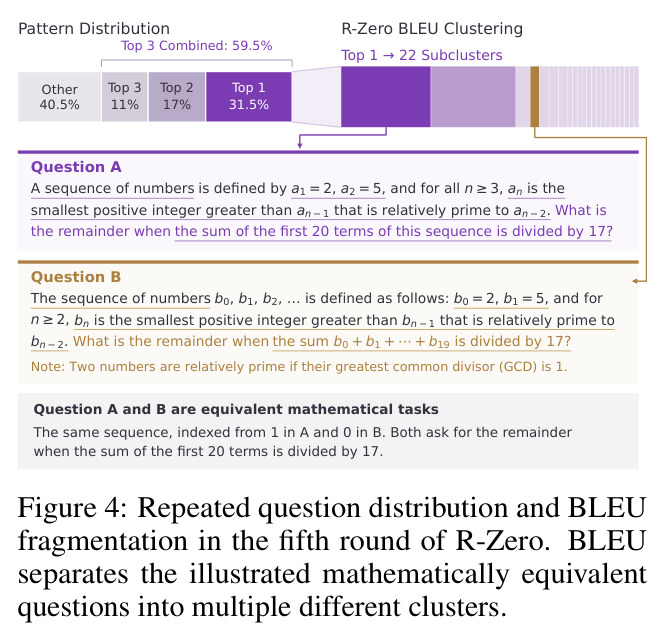
左:第5轮过滤后200题按题型分组,前三题型合计占59.5%(Top1 31.5%),而 R-Zero 的 BLEU 聚类把最大题型拆成22个子簇;右:一道数列题的两个数学等价版本(仅措辞与下标起点不同)被 BLEU 判入不同簇。
直观暴露了词面相似度去重的根本缺陷——“同题换皮”绕过惩罚,是引入语义层面新颖性判定的直接动机。
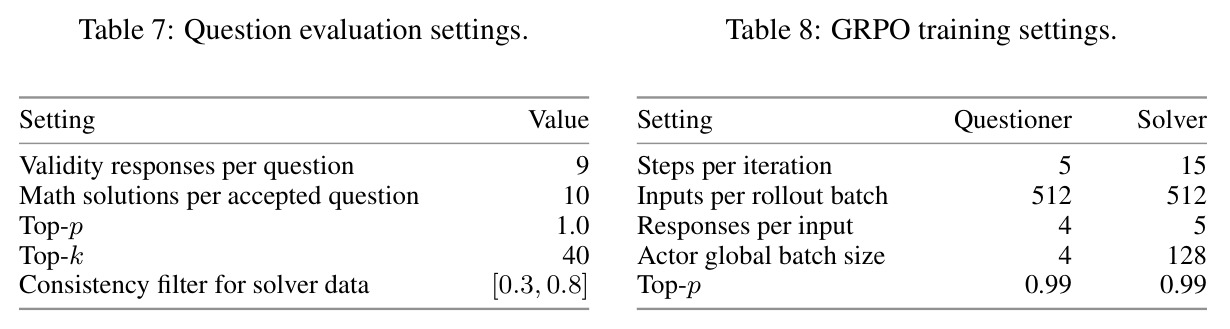
出题器与解题器的 GRPO 设置对比:每轮步数5/15、批512输入、每输入4/5个响应、全局批4/128、top-p 0.99。
复现主循环训练的必要信息,两者步数与批量的不对称也反映了两个角色任务粒度的差异。