程序验证的视觉语言模型自进化 Program-Verified Self-Evolution for Vision-Language Models
用固定程序在结构化解析上算出答案,以逐断言校验取代多数投票,让 VLM 可靠自进化
前置知识
自进化(Self-Evolution / 自博弈)训练
让模型在没有人工标注的情况下给自己造训练数据:模型从无标注图像自动生成问题,再作答,然后用问答对训练自己。典型做法是把一个模型拆成“提问者”(proposer)和“求解者”(solver)两个角色,循环迭代:提问者出题、求解者答题、筛掉低质量样本、更新求解者。整个过程没有任何金标准答案。
本文的全部背景:VQS 就是一种自进化框架,而它要解决的核心痛点——自生成问题没有金标准答案,如何可靠地标定答案——正是理解这篇论文贡献的入口。
多数投票伪标签(Majority-Vote Pseudo-Label)
当没有标准答案时,让模型对同一问题采样多个答案(如 5 次),把出现频率最高的答案当作“伪标签”用于训练;或由一个模型裁判(model judge)从候选答案中挑一个。这是 R-Zero、VisPlay、EvoLMM 等自进化方法普遍采用的验证手段。
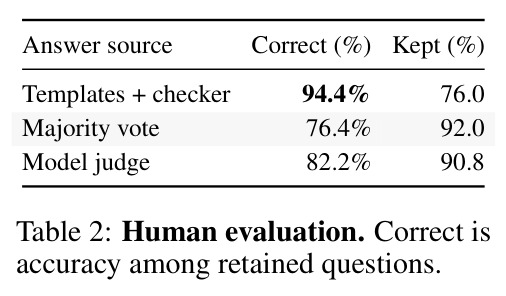
本文实测多数投票标签有 24% 是错的、模型裁判有 18% 是错的,且错误率随训练轮数上升。VQS 的动机就是用程序计算答案彻底替代这两种启发式。
GRPO(Group Relative Policy Optimization)
DeepSeekMath 提出的强化学习算法:对每个问题采样 n 个回答(一组),用组内奖励的均值和标准差做归一化得到优势 $A_i = (r_i - \mathrm{mean})/(\mathrm{std}+\epsilon)$,再用带裁剪的目标函数和 KL 惩罚更新策略。相比 PPO 不需要训练价值网络,是当前可验证奖励 RL(RLVR)的主流选择。
VQS 用 GRPO 训练求解器:每个问题的奖励就是答案与程序计算答案的精确匹配。读懂 Eq.(3)(4) 和训练细节需要理解 GRPO 的组内归一化机制,也解释了为什么难度带要过滤“全对/全错”的问题——那样的组内优势为零,没有学习信号。
模式约束解码(Schema-Constrained Decoding)
在解码时强制模型输出符合给定 JSON Schema 的结构化文本(如 vLLM 的 guided decoding):每个字段必填、不允许额外字段,因此输出在语法上一定是合法的、完整的结构化记录。数值不可辨认时可记为 null 而不是让模型猜测。
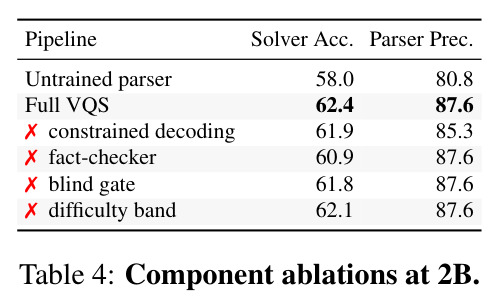
VQS 的解析器对每张图输出必须符合四个领域(照片/图表/示意图/信息图)各自 schema 的解析记录,这是后续“程序可以在解析上确定性执行”的前提;消融显示去掉约束解码会让求解器掉 0.5 分。
场景图(Scene Graph)与结构化解析
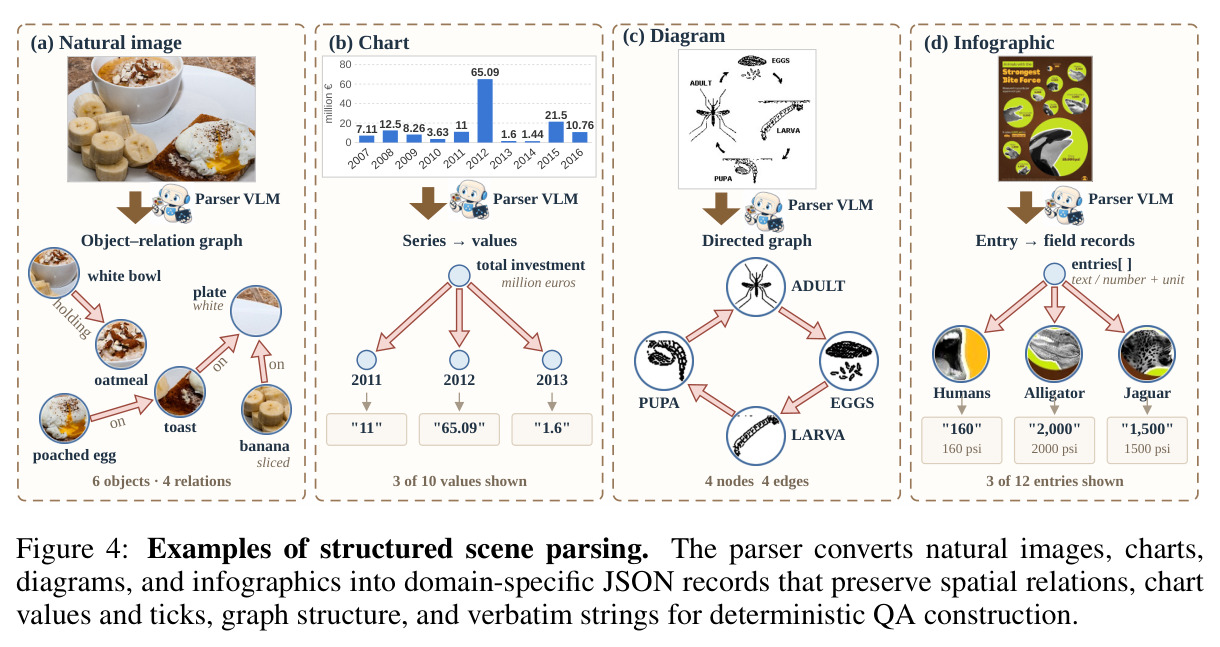
把图像内容表示成机器可遍历的结构:照片解析为对象(名称、属性、边界框、关系谓词如 on/left of)组成的图;图表解析为系列、类别和数值点;示意图解析为节点和有向边;信息图解析为带原文数值和单位的条目。CLEVR 和 GQA 数据集最早用场景图上的功能程序生成带标准答案的问题。
VQS 直接继承 CLEVR/GQA 的思想:只有当图像变成可遍历的结构,固定模板才能像执行程序一样算出问题及其答案,答案的正确性因此归结为“解析是否正确”这一可逐条核验的问题。
LoRA 适配器
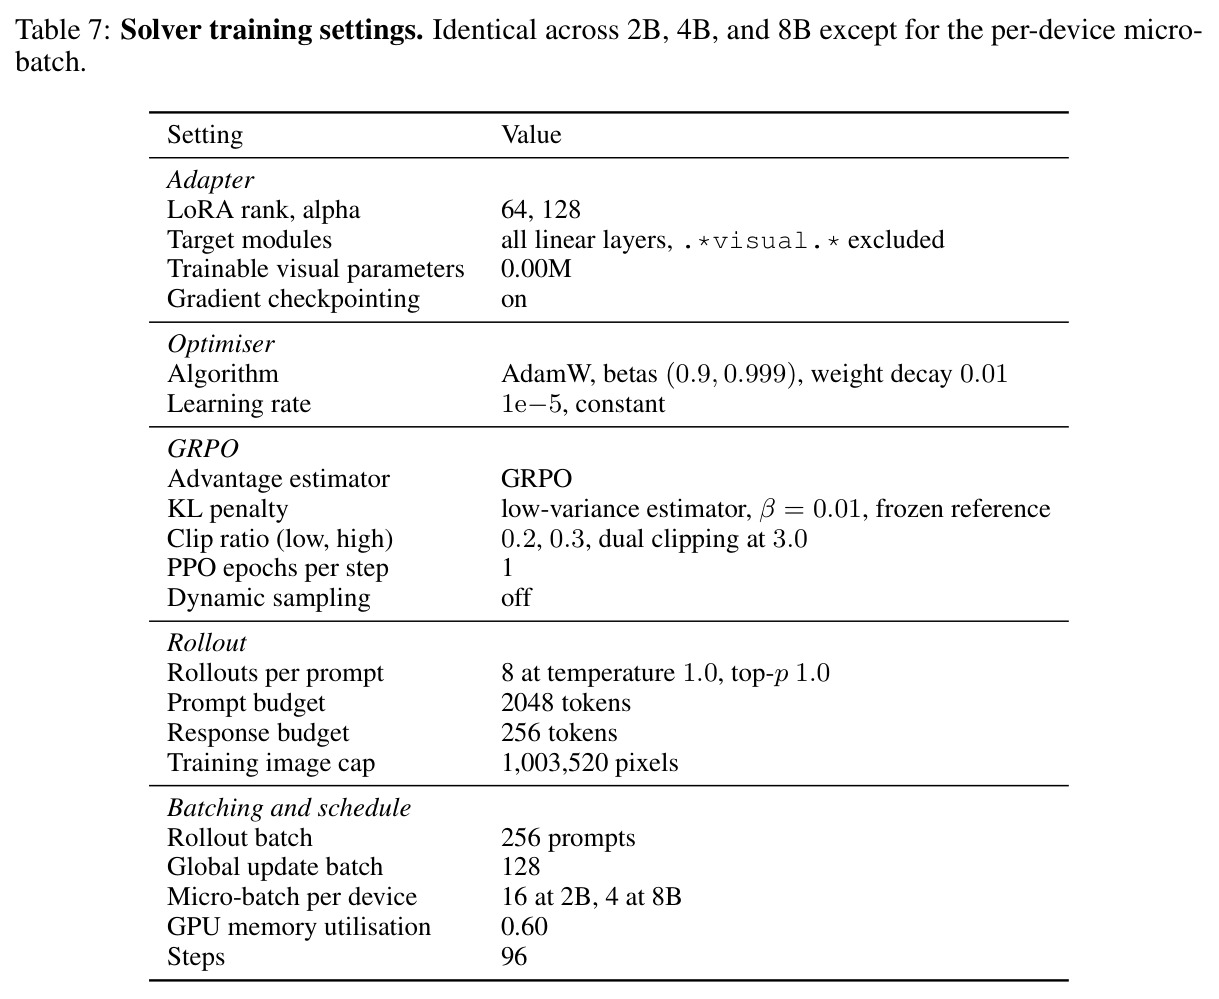
低秩适配微调:冻结原模型权重,只训练注入到各线性层的低秩矩阵(本文 rank=64、alpha=128),大幅降低显存和训练成本。本文对所有线性层加 LoRA 但排除视觉塔(vision tower),即视觉编码器完全不训练。
VQS 的求解器训练和循环合并(每轮把上一轮 LoRA 权重合并后再开新一轮)都依赖 LoRA;附录 Table 7 给出完整配置,是复现的关键细节。
研究动机
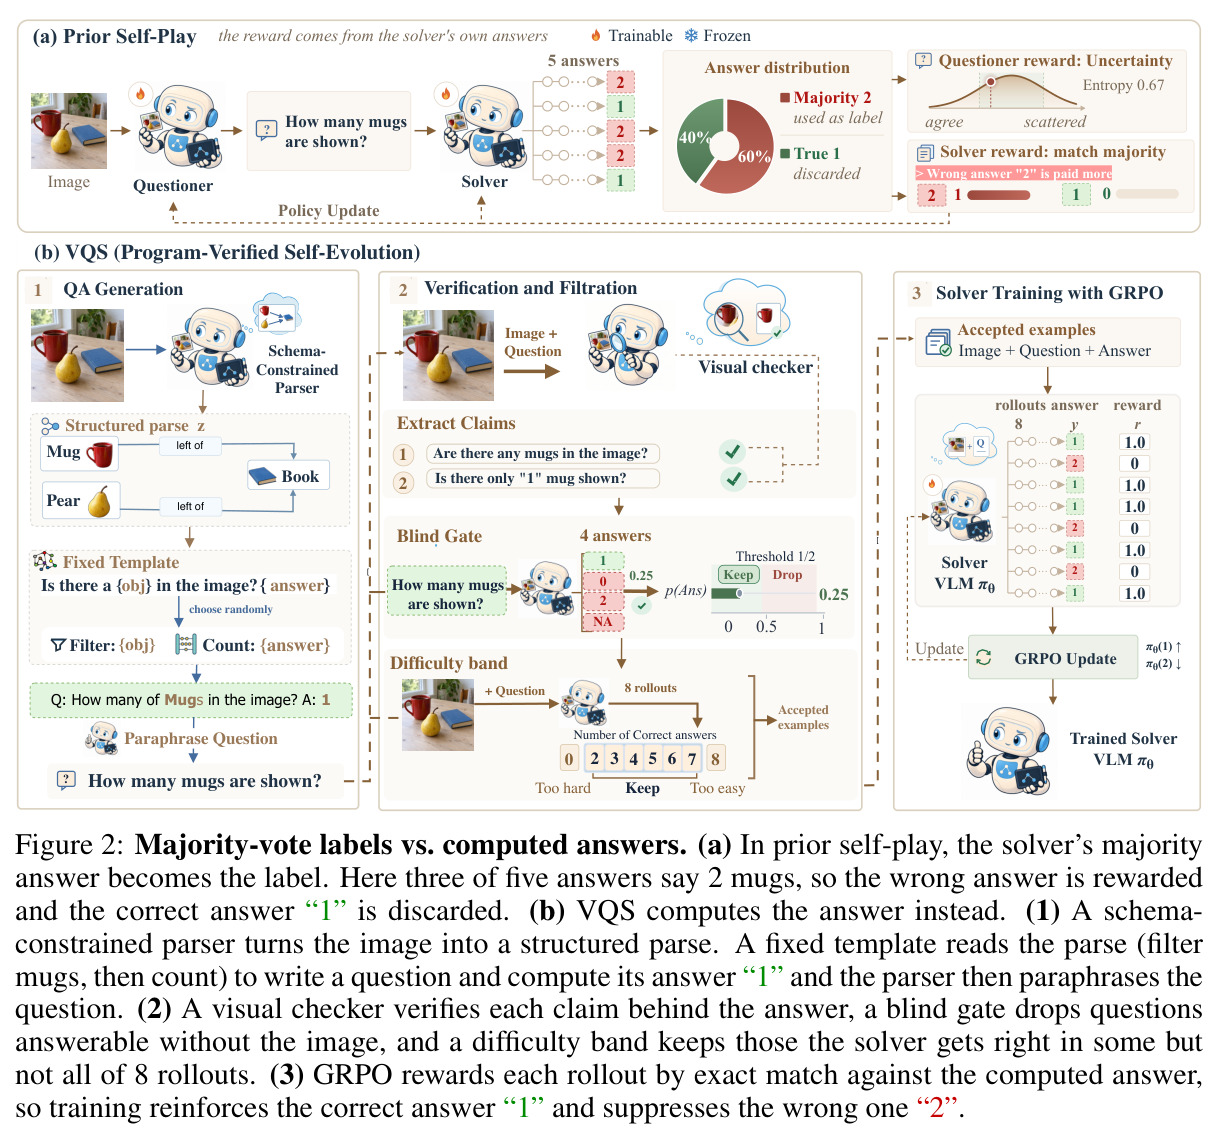
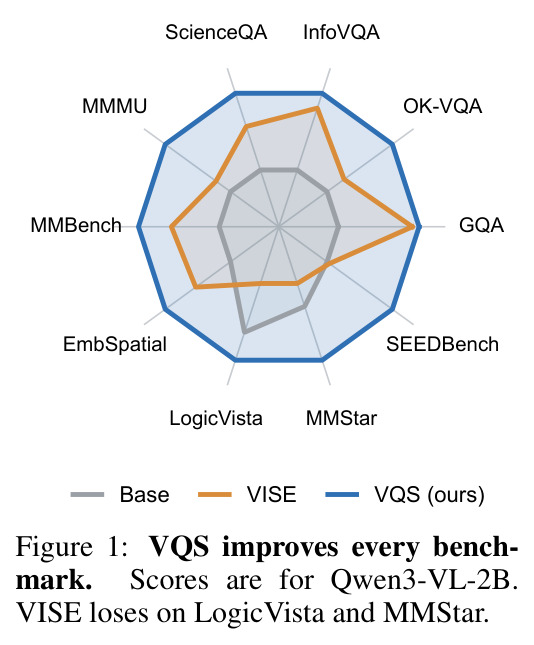
自进化视觉语言模型(如 R-Zero、VisPlay、EvoLMM、iReasoner)让模型从无标注图像自己出题、自己作答、再用问答对训练自己,从而摆脱人工标注。但自生成的问题没有金标准答案,标签只能靠代理手段产生:对多次采样做多数投票、看推理步骤一致性、或让一个模型当裁判。作者做了 500 道自生成问题的人工评测,发现多数投票产生的标签有 24% 是错的,模型裁判的标签有 18% 是错的——也就是说每训练四五道题就有一道在教模型错误答案。更糟的是错误会随迭代累积:VisPlay 的伪标签准确率三轮内从 72% 跌到 61%,R-Zero 从 79% 跌到 63%,因为提问者越强、题目越难,投票和裁判就越不可靠;此前工作(Shafayat et al., 2025)也独立证明多数投票自奖励最终会偏爱“自信但错误”的答案并导致训练崩溃。具体到基准上,这类方法的提升很小且不稳定:最强的 VISE 在 Qwen3-VL-2B 上平均只涨 1.01 分,而且在所有规模上都会让 LogicVista 和 MMStar 不升反降(2B 上分别 -3.12 和 -0.60)。
本文的目标是本文的目标是重构自进化回路中“答案从哪来、如何验证”这一最脆弱的环节:不再从模型自己的输出分布里估计答案,而是让答案被确定性地计算出来。具体包括四点:(1) 把照片、图表、示意图、信息图四类图像解析成结构化记录,用人工写好的固定模板程序在其上遍历,同时生成问题和它对应的答案;(2) 设计逐断言(claim-level)的视觉校验,只确认程序读取的每一条原子视觉事实,一旦有事实不成立就丢弃该题;(3) 用同样的逐断言校验无标注地筛选解析器的训练目标,让解析器也自进化;(4) 在 2B/4B/8B 三个规模、十个基准上超过所有已有自进化方法,并在相同图像上多轮训练持续提升而不崩溃。
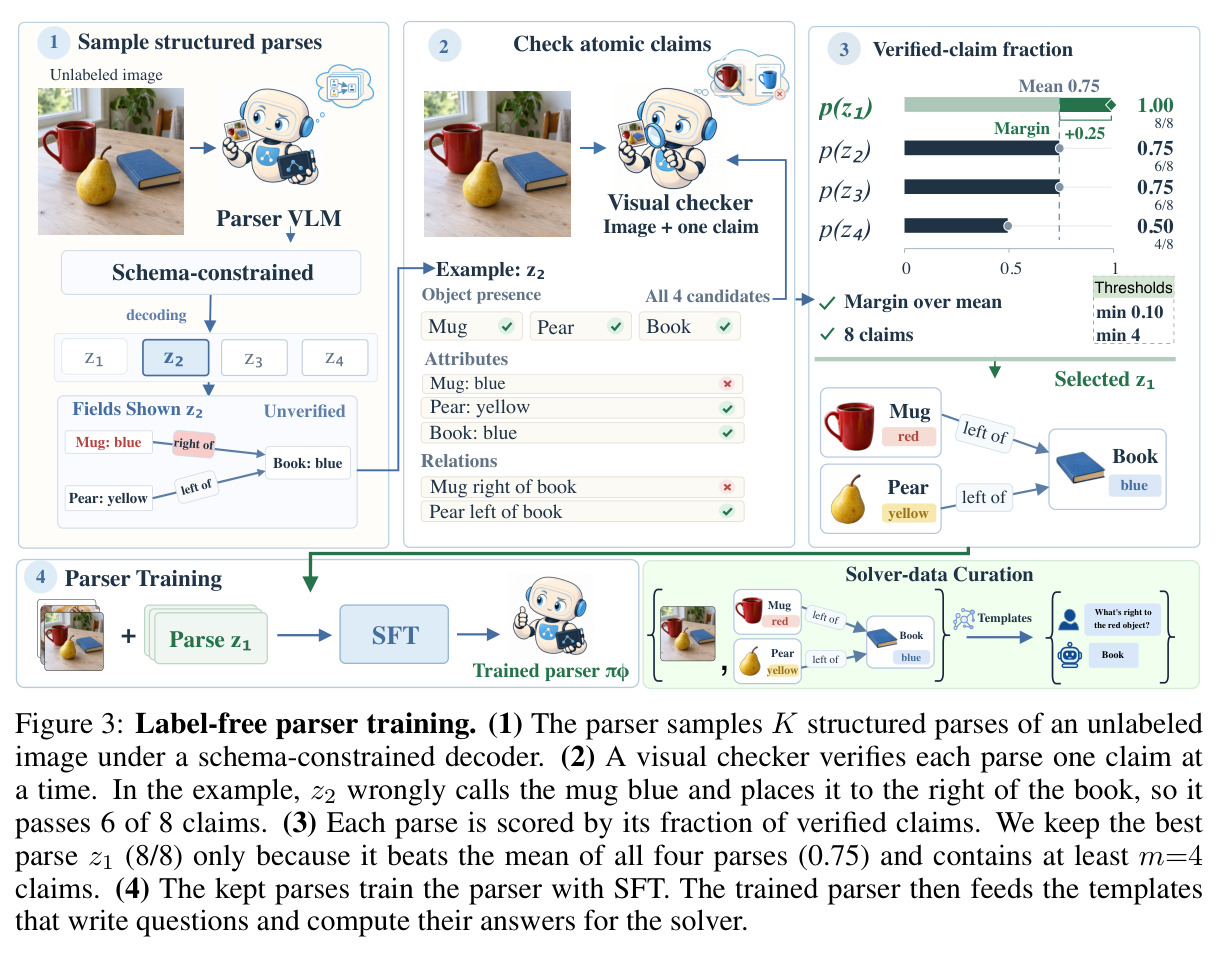
与已有工作不同的是,已有自进化方法的共同点是“奖励来自模型输出”——无论投票、一致性还是裁判,都在模型自己认为的答案空间里打转,错误无法被系统性排除。本文的独特切入是把 CLEVR/GQA 的“程序生成问题”传统搬到自进化场景:答案不是被“猜”出来而是被“算”出来,等于把标签正确性问题约化为解析正确性问题;而解析正确性可以进一步拆成一条条短小的原子断言(“图里有马克杯吗”“马克杯是蓝色吗”),逐条用是/否校验,这比让模型一口气判断整个结构或整个答案可靠得多。另一个巧妙的再利用是:同一套逐断言校验器原本只为筛选问答对,作者却让它给 K 个候选解析打分(已核实断言占比),从而第一次实现了完全无标注的解析器自我改进——验证机制同时充当了另一个模块的训练信号。
核心方法
直觉上,VQS 把“模型自己出题自己批改”改成了“模型抄题、程序批改”:图像先被解析成机器可读的结构化记录,问题由人工写好的模板程序在记录上生成,答案也由同一个程序计算出来,因此答案和图像之间只隔着“解析是否正确”这一个环节。技术路线上,一个训练循环分三步(Algorithm 1):第一步先训练解析器 $\pi_\phi$——对每张图采样 $K=4$ 个符合领域 schema 的解析,用视觉校验器逐断言核验,按“已核实断言占比”打分,只保留明显优于平均分且断言数足够的最佳解析做 SFT;第二步用训好的解析器贪心解码每个图像,让每个适用的模板 $t$ 读出解析并返回 $(q, a, h)=(t(z))$(问题、计算出的答案、跳数),再把模板问题改写成自然语言;第三步是三重过滤(事实校验、盲测门、难度带),幸存的问题用 GRPO 训练求解器 $\pi_\theta$,奖励就是答案与程序计算答案的精确匹配。整个系统只从同一个预训练模型初始化,解析器、校验器、盲测模型共用同一份权重,模板库 $T$(70 个模板族)人工写好后永不训练。训练完的求解器可以重新解析图像、开启下一轮循环。
核心创新是“程序计算的答案键 + 原子断言校验”取代“模型输出上的统计标签”。以往方法让求解器答 5 次取多数作为标签,本质是拿模型当前的信念当真值,模型错得越自信、错得越一致,伪标签就错得越离谱,而且随着提问者变强错误率单调上升。VQS 中答案 $a$ 是模板在解析 $z$ 上的确定性计算结果(如 filter 出所有马克杯再 count 得到 1),与求解器完全无关,所以 RL 训练可以放心地把模型推向它原本不倾向的答案——人工评测中 94.4% 的 VQS 答案正确,而多数投票只有 76.4%。第二个创新是把“验证”拆到断言粒度:模板每读一个字段就断言一条原子事实,二值校验器 $v(c,x)\in\{0,1\}$ 逐条回答是/否。逐条校验既保证答案背后的每条事实都成立,又给出一个有梯度的分数(已核实断言占比 $P(z)$),使无标注的解析器 best-of-K 选择成为可能——这是一石二鸟的设计:同一套校验同时守护求解器的训练数据和解析器的训练目标。
方法步骤详情
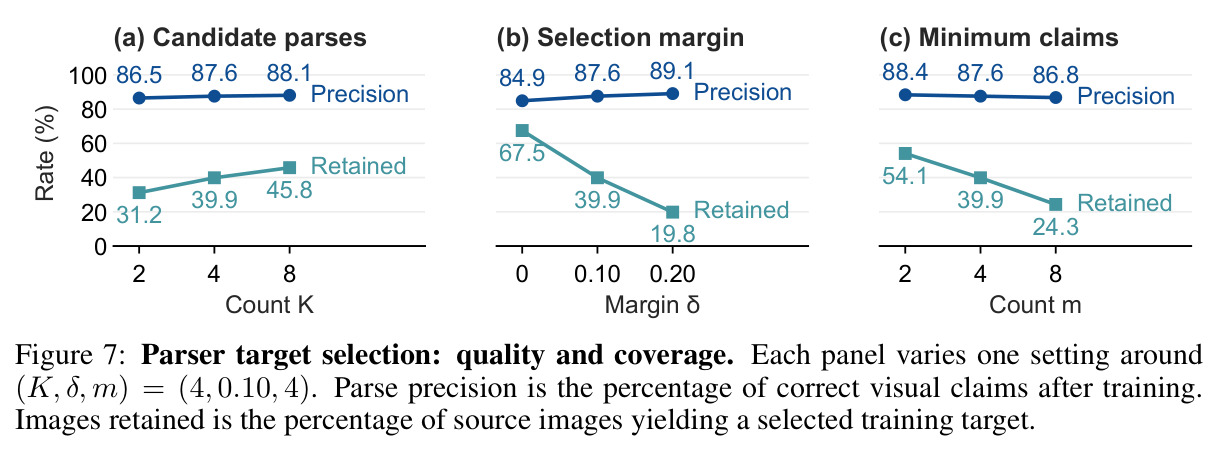
完整流程如下。解析阶段:解析器对图像 $x$ 做 schema 约束解码得到解析 $z$——照片解析为带名称/属性/0-1000 坐标框/关系谓词的对象图,图表解析为系列的(类别、印刷值、数值)点列和轴刻度,示意图解析为节点和有向箭头,信息图解析为带文本/数值/单位的条目;数字不可辨认记为 null,模板会跳过。出题阶段:每个适用模板 $t$ 读解析返回问题 $q$、答案 $a$、跳数 $h$,支持的操作包括 filter、读字段、count、max/min、沿关系走、rank、比较、算术、读趋势、数箭头、框转粗粒度方位;随后解析器把 $q$ 改写成自然措辞 $\tilde{q}$,禁止增删条件、只用原词。过滤阶段(Eq. 1)依次过三关:事实校验要求 $\bigwedge_{c\in C(t,z)} v(c,x)=1$,即程序读取的每条原子事实都被逐一确认为真;盲测门让无图像的同一模型答 $J=4$ 次,正确率 $\le\lambda=0.5$ 才保留,防止不看图也能答的世界知识题;难度带让待训练求解器采 8 个 rollout(温度 1.0、256 token),只在 $0<\hat{p}<1$(部分正确)时保留,因为全对全错的组内优势归零、无学习信号。求解器训练:奖励 $r=0.9\,\mathrm{eq}(y,a)+0.1\,\mathrm{fmt}(y)$(精确匹配加格式分),用 GRPO 更新——每题 8 个 rollout 组内归一化优势,KL 系数 $\beta=0.01$、裁剪 0.2/0.3 双重裁剪 3.0,LoRA rank 64 冻结视觉塔,恒定学习率 $10^{-5}$,96 步;问题按模板族内跳数从少到多排课程。解析器训练(先于出题):每图采 $K=4$ 个解析,逐断言核验得 $P(z)=\frac{1}{|F(z)|}\sum_{c\in F(z)}v(c,x)$,只当最佳解析满足 $P(z^\star)-\frac{1}{K}\sum_k P(z^{(k)})\ge\delta=0.10$ 且 $|F(z^\star)|\ge m=4$ 时保留 $(x,z^\star)$ 做交叉熵 SFT——12,000 张图产出 4,792 个目标。
技术新颖性
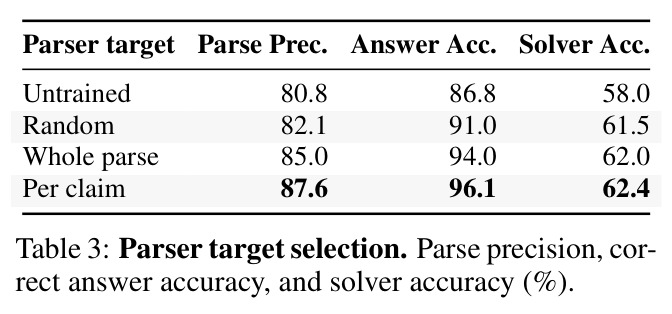
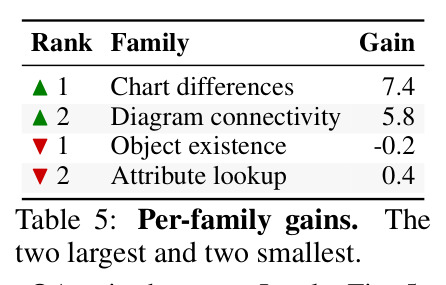
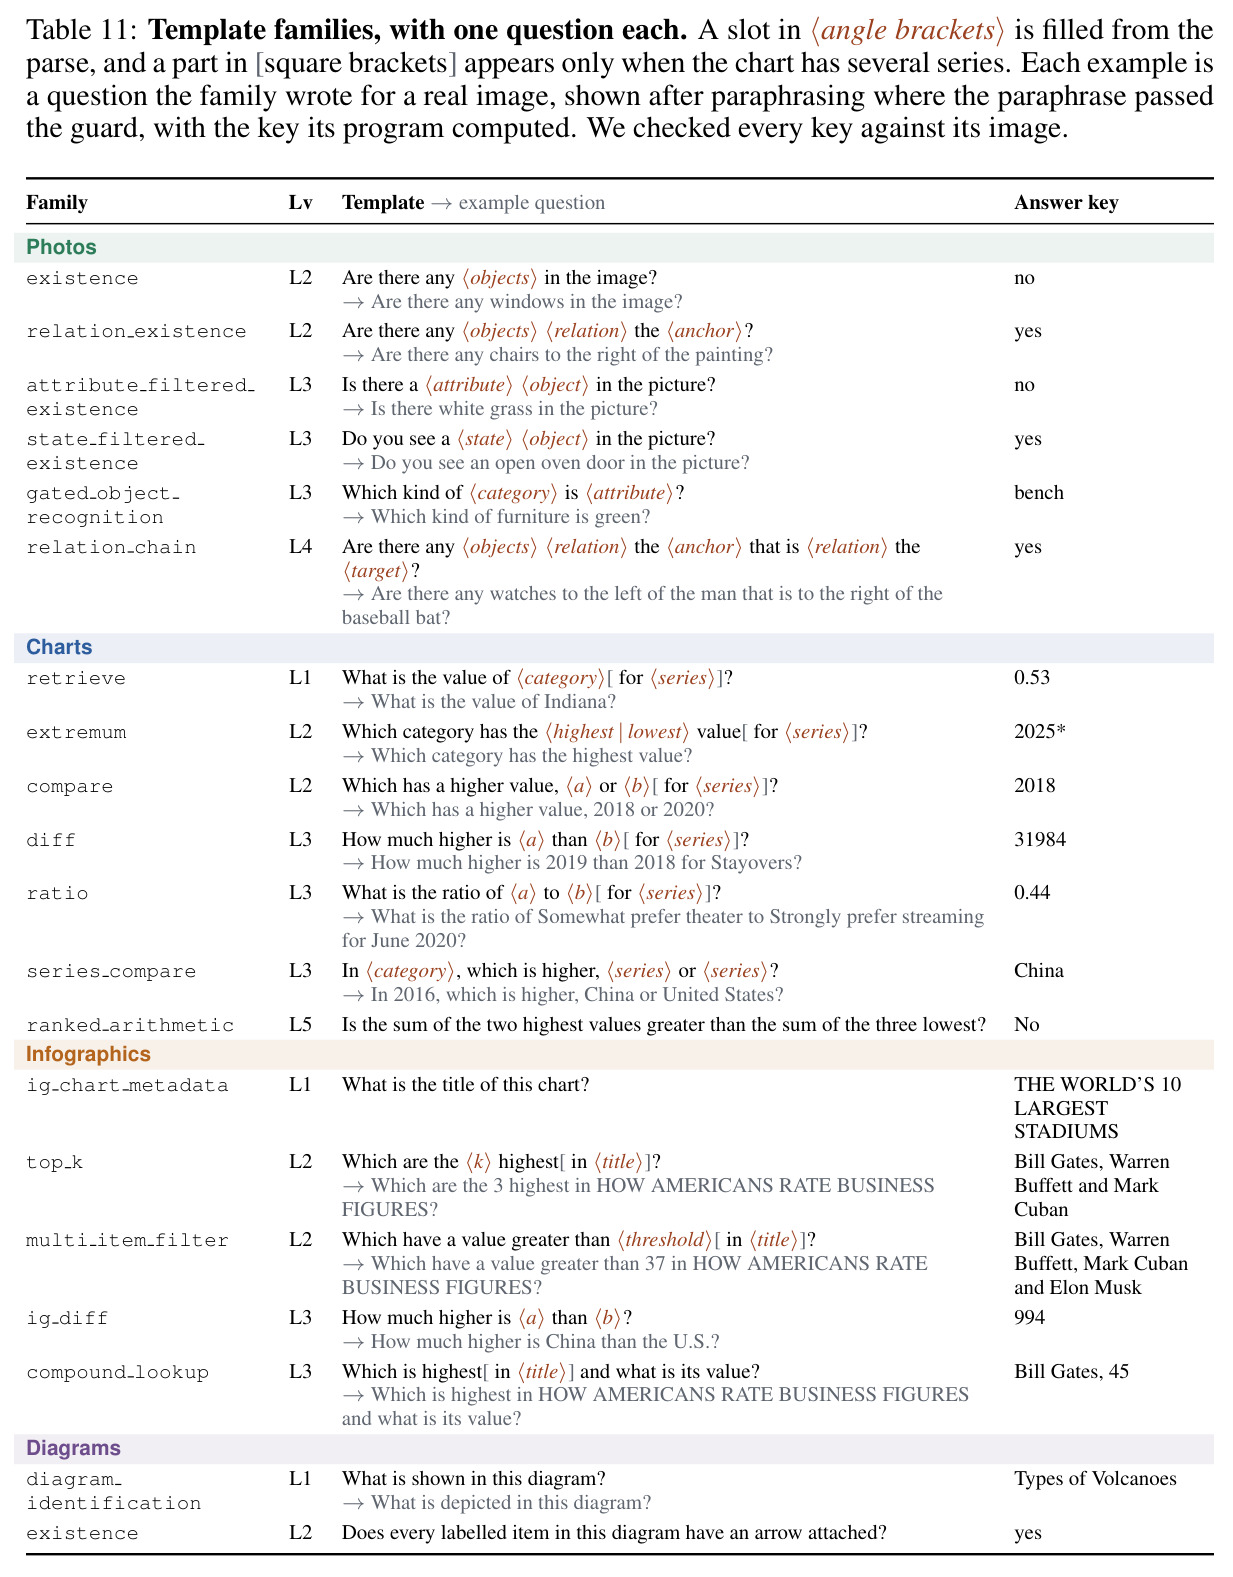
与已有工作的本质区别有四层。第一,与 R-Zero/VisPlay/EvoLMM 等“模型输出即奖励”的方法相比,VQS 的标签来自程序在解析上的执行,与模型信念解耦,从机制上排除了“自信错误答案被奖励”的崩溃模式,因此能连续三轮训练不退化。第二,与 ProVision/SpatialVLM 等程序化生成工作相比,它们只产 SFT 数据、从不验证生成的断言,VQS 则给每条被读取的事实配一个校验动作,并把校验从“整体判一次是/否”细化到逐断言——消融显示逐断言比整体判断的解析精度高 2.6 分(87.6 vs 85.0)。第三,无标注解析器训练是新的:用“已核实断言占比超过候选均值的 margin”作为保留条件,同时借用了 RL 中“中等难度样本信号最强”的思想设计难度带。第四,模板库覆盖四个图像域并带跳数 $h$,使课程学习和逐族收益分析成为可能;消融证明 70 个模板族中多步组合族(图表差值 +7.4、示意图连通性 +5.8)贡献最大,单步族几乎无效,这与主结果中 MMMU/ScienceQA 涨幅最大的现象互相印证。
实验结果
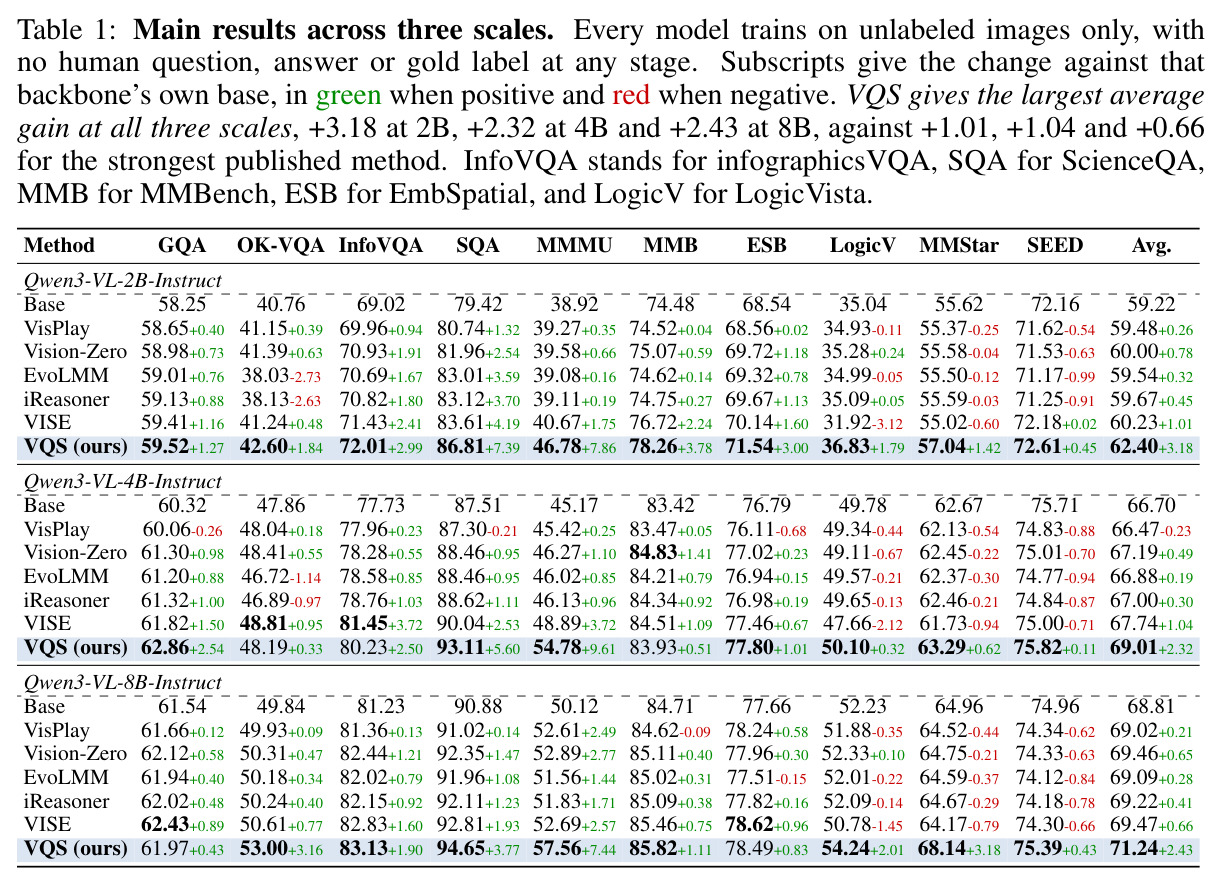
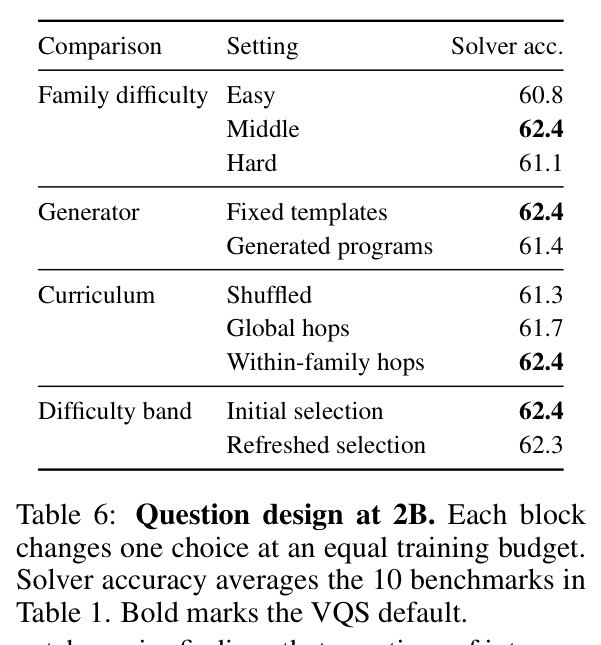
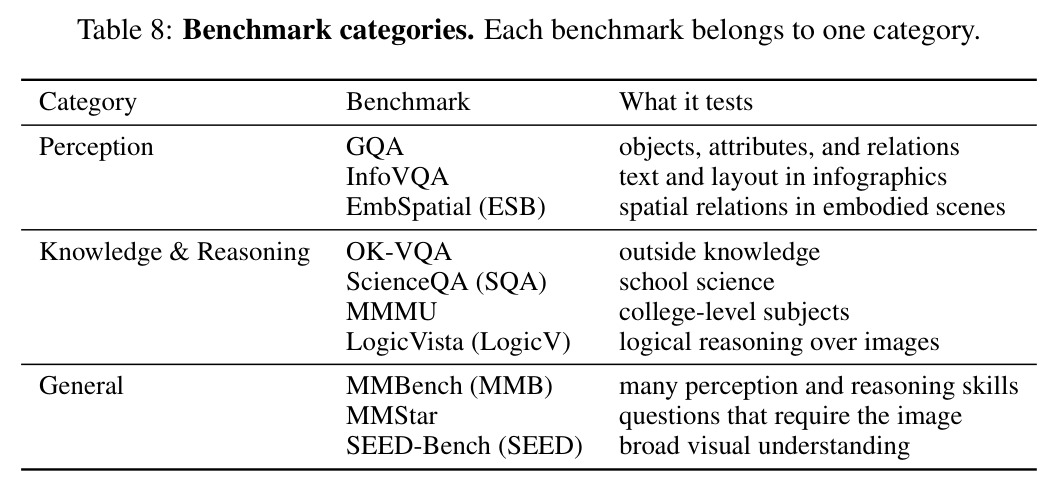
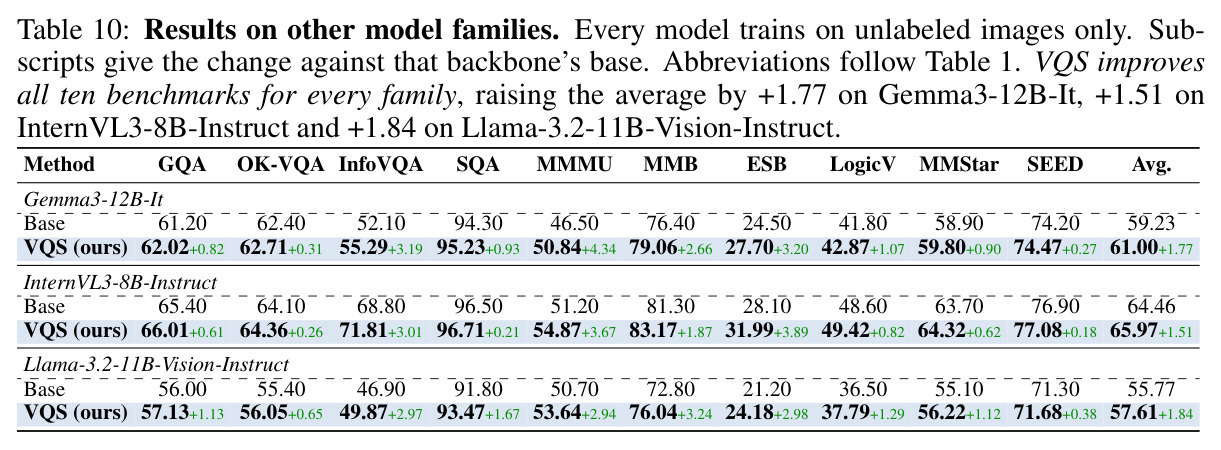
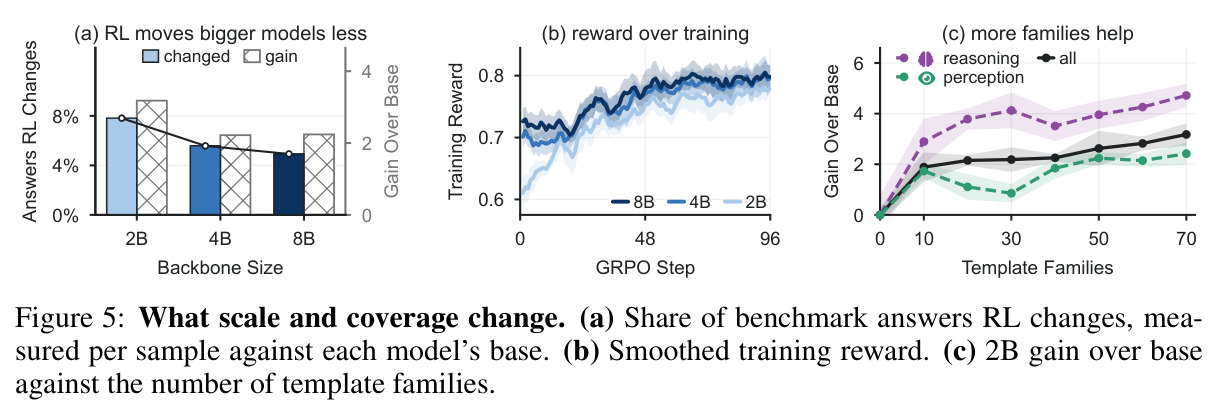
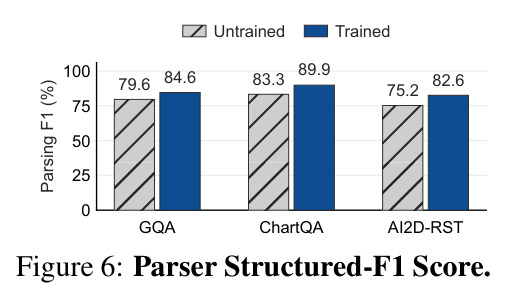
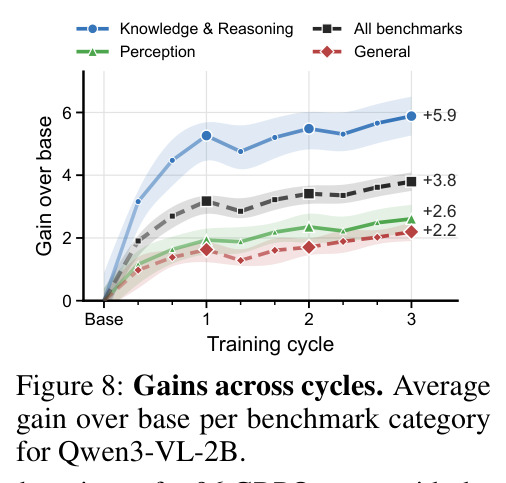
主实验(Table 1)在 GQA、OK-VQA、InfoVQA、ScienceQA、MMMU、MMBench、EmbSpatial、LogicVista、MMStar、SEEDBench 十个基准上对比五个自进化基线:Qwen3-VL-2B 平均分从 59.22 提到 62.40(+3.18),4B 从 66.70 到 69.01(+2.32),8B 从 68.81 到 71.24(+2.43),每个规模都显著超过最强基线 VISE(分别 +1.01/+1.04/+0.66),且十个基准全部上涨。2B 上最亮眼的是 MMMU +7.86(38.92→46.78)、ScienceQA +7.39(79.42→86.81),是任何基线的五倍以上;VISE 在所有规模都损害 LogicVista(2B -3.12)和 MMStar,而 VQS 分别 +1.79 和 +1.42。规模效应(Fig. 5a):RL 实际改写的基准答案占比从 2B 的 7.82% 降到 8B 的 4.93%,虽然三个规模训练奖励都到约 0.80,说明大模型学会了生成任务但迁移更少。标签质量(Table 2):500 题人工评测中 VQS 答案正确率 94.4%(保留 76% 的题),多数投票 76.4%(保留 92%)、模型裁判 82.2%(保留 90.8%)。解析器无标注训练(Fig. 6):对 GQA 场景图/ChartQA 表格/AI2D-RST 示意图标注的结构化 F1 分别提升 5.0/6.6/7.4 分,最难的示意图从 75.2 升到 82.6;Table 3 显示逐断言选择(解析精度 87.6、答案准确率 96.1、下游求解器 62.4)全面优于随机和整体判断,而用未训练解析器出题甚至会把求解器拉到基准线下(58.0 < 59.22)。消融(Table 4):去掉解析器训练损失最大(62.4→58.0),其次是事实校验(→60.9,即 unchecked 答案单独损失 1.5 分),约束解码 -0.5、盲测门 -0.6、难度带 -0.3。题目设计(Table 6):中等难度族 62.4 优于难题 61.1 和易题 60.8;让模型自己写程序生成问题(PROVE 式)掉 1.0 分,因为只有 85.3% 的问题与程序一致;族内按跳数排序课程最好(62.4 vs 打乱 61.3)。模板覆盖(Fig. 5c):模板族从 10 加到 70,平均增益从 1.9 涨到 3.18 且仍在上升。多轮循环(Fig. 8):合并 LoRA 后在相同图像上再训练,2B 增益 3.18→3.41→3.84,第三轮增量(+0.43)反而大于第二轮(+0.23),知识推理类三轮累计 +5.94(ScienceQA +8.53、MMMU +8.44),十个基准中九个逐轮上升。迁移性(Table 10):Gemma3-12B +1.77、InternVL3-8B +1.51、Llama-3.2-11B +1.84,全部十个基准上涨。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 十大基准平均(Qwen3-VL-2B) | 平均分 | 62.40(+3.18) | 基座 59.22;最强基线 VISE 60.23(+1.01) | 超基线 2.17 分,增益是 VISE 的 3.1 倍 |
| MMMU(Qwen3-VL-2B) | 准确率 | 46.78(+7.86) | 基座 38.92;最强基线 VISE 40.67(+1.75) | +7.86,涨幅是任何基线的 4.5 倍 |
| ScienceQA(Qwen3-VL-2B) | 准确率 | 86.81(+7.39) | 基座 79.42;最强基线 VISE 83.61(+4.19) | +7.39,比最强基线多 3.2 分 |
| MMMU(Qwen3-VL-8B) | 准确率 | 57.56(+7.44) | 基座 50.12;最强基线 VisPlay 52.61(+2.49) | +7.44,约为最强基线的 3 倍 |
| 生成答案正确率(500 题人工评测) | 正确率 | 94.4%(保留 76.0% 的题) | 多数投票 76.4%(保留 92.0%);模型裁判 82.2%(保留 90.8%) | +18.0 分 vs 多数投票 |
| 十大基准平均(Qwen3-VL-8B) | 平均分 | 71.24(+2.43) | 基座 68.81;最强基线 VISE 69.47(+0.66) | 增益是 VISE 的 3.7 倍 |
| 多轮自进化(Qwen3-VL-2B,三轮) | 相对基座平均增益 | 第 3 轮 +3.84 | 第 1 轮 +3.18(所有投票类基线未展示多轮不崩溃证据,VisPlay 三轮伪标签 72%→61%) | 三轮累计多 +0.66 分且曲线未趋平 |
| 跨模型家族迁移(Llama-3.2-11B / Gemma3-12B / InternVL3-8B) | 十大基准平均增益 | +1.84 / +1.77 / +1.51 | 各自基座(55.77 / 59.23 / 64.46) | 三个家族十个基准全部上涨 |
局限与改进
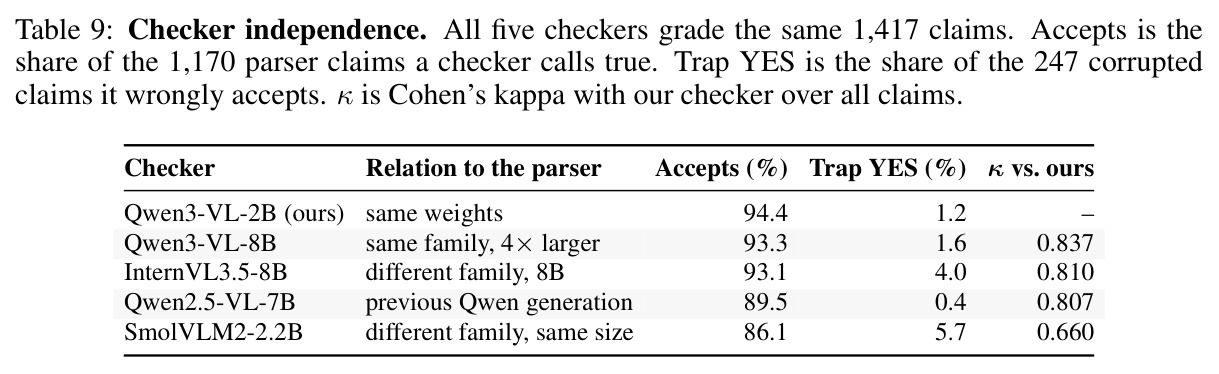
作者坦承并实测的局限:第一,解析错误仍会传导为错误答案——答案正确率 94.4% 意味着仍有约 6% 的训练标签是错的,因为答案是在解析上计算的,解析错则答案错;附录中追溯卡片展示了一个漏网案例:中国 2016 年值被误读为泰国的 189.3,但比较结果恰好不变,事实校验和盲测门都没拦住。第二,校验器与解析器共享权重,可能共享盲区——跨家族审计显示被自家校验器接受的断言中,其他校验器会拒绝 26.7% 的示意图箭头和 8.3% 的图表数值,说明这两类断言最需要更强的独立校验。第三,改写问题这一步没有校验器覆盖,8B 模型在 437 题中有 4 题(0.9%)改写时交换了年份导致答案键失效。第四,增益随规模递减(+3.18→+2.43),大模型改写的答案份额明显更小。我自己的观察:模板库只有 70 个族且答案都是单词/数字/选项字母,训练信号偏感知与多步组合读取,缺少长推理链、开放式生成和对话类能力;单步模板族(对象存在 -0.2、属性查找 +0.4)几乎无效,说明该方法的上限受模板表达力约束;盲测门和难度带需要大量额外采样(每题 4+8 次推理),数据工程成本不低;评测全部为单答案精确匹配型基准,无法说明对自由文本任务的迁移。
独立分析的弱点
弱点一:模板表达力是硬上限。所有训练问题都由 70 个人工模板族生成,答案空间被限制为单跳查找到五步聚合运算(如‘最高两值之和是否大于最低三值之和’),无法覆盖开放描述、多轮推理或需要外部知识的问答;单步族收益为零甚至为负(对象存在 -0.2),意味着容易的部分已被基座掌握,继续扩族边际成本会越来越高。改进方向:让模型在 schema 约束下合成可执行的程序(论文的 PROVE 式消融只做到 85.3% 程序-问题一致,可以用执行反馈+重试把一致率提上去,同时保留程序可验证性)。弱点二:校验器与解析器同源。两者共享 Qwen3-VL-2B 权重,校验器可能确认解析器的系统性误读(如图表数值识别错误),Table 9 显示 8B 跨家族一致性(κ=0.877)高于自家 2B 与 8B 的一致性(κ=0.837),暗示规模比家族多样性更重要。改进方向:训练后期切换到更大规模或异构家族的校验器做仲裁,或对图表数值、示意图箭头这类高风险断言强制双校验器一致。弱点三:解析错误仍可穿透。比较型问题中单值误读可能不改变最终答案而通过事实校验(泰国/中国值混淆的实例),6% 的残余错误率会随轮数累积进入训练集。改进方向:把校验从‘读回字段’升级为‘带扰动重采样’——对关键数值多次采样取一致性,或对进入多步计算的中间值做交叉验证。弱点四:三重过滤的计算开销大(每题约 12 次额外推理),且难度带在多轮循环中固定用基座行为判定,循环内刷新无收益(62.3 vs 62.4),说明筛选信号与模型更新不同步。改进方向:复用 GRPO 训练中的 rollout 作为难度信号,免去独立的筛选采样。
未来方向
作者方向:(1) 扩展模板库与图像域——Fig. 5c 显示增益随模板族数量仍在上升,自然延伸是覆盖 3D 场景、视频帧、文档版面等更多域,以及更深的组合运算(当前最深 L5 级比较聚合);(2) 加强校验器独立性——Table 9 指出示意图箭头(26.7% 被其他校验器质疑)和图表数值(8.3%)是薄弱点,可用更大模型或异构家族做仲裁校验;(3) 多轮循环尚未饱和——第三轮增量(+0.43)大于第二轮(+0.23),值得继续跑到收敛并研究崩溃条件。基于成果可延伸的方向:(4) 把‘程序计算答案’思想移植到文本域,用代码执行验证自生成数学/推理题,与 VQS 形成多模态统一框架;(5) 探索答案键与模型免费午餐的边界——用 VQS 蒸馏出的解析能力反过来改进感知模块(当前视觉塔完全冻结);(6) 与测试时强化学习(TTT/TTT-RL)结合,在推理阶段对新图像现场生成经验证的 QA 做自适应;(7) 研究数据配比——知识推理类基准 +5.94 远超感知类 +2.62,说明多步读取训练对下游推理有外溢效应,值得系统性消融‘合成多步读取数据 → 通用推理能力’的因果链。
复现评估
复现条件较好。代码已在 GitHub 开源(github.com/ahmedheakl/VQS),训练图像直接取自 VISE(Venkatraman et al., 2026)并丢弃其问答标注,全程无人工标注;训练框架是公开的 EasyR1(GRPO)和 LLaMA-Factory(解析器 SFT),解析用 vLLM 的 guided decoding 强制 JSON schema,评测用 lmms-eval 标准超参。附录给出了近乎完整的复现细节:LoRA rank 64/alpha 128、AdamW 恒定学习率 $10^{-5}$、KL $\beta=0.01$、裁剪 0.2/0.3(双重裁剪 3.0)、每题 8 rollout(温度 1.0、响应 256 token)、图像上限 1,003,520 像素、96 步、rollout batch 256/更新 batch 128;解析采样 K=4(温度 1.0、top-p 0.95、2048 token)、保留条件 $\delta=0.10$、$m=4$;四个领域的完整 JSON schema 和所有提示词(含基线提示)都在附录 A.4/A.5。硬件为 8 张 AMD MI210,属于单节点八卡量级,2B/4B/8B 共享同一配置(仅微批次不同),对有 8xA100/MI210 级别资源的团队难度中等;主要工程量在模板库实现(70 族模板+执行器+断言提取)和数据管线串联,模板与执行器的对应关系可参考附录 Table 11 和 A.5.2 的示例代码。
论文图表