HarnessDev:LLM 能否创建并进化自己的智能体执行框架 HarnessDev: Can LLMs Create and Evolve Their Own Agent Harness?
首个把评测单元从任务答案换成可运行基础设施的基准,测 LLM 建框架与养框架的能力
前置知识
Agent Harness(智能体执行框架)
包裹在模型权重之外的执行基础设施,负责运行循环、工具调用、上下文管理、持久状态、生命周期控制(重试/超时/恢复)与结果验证,把模型输出转化为实际动作。它对成绩影响巨大:同为 GPT-5,在 Terminal-Bench 2.1 上于 Terminus 2 内解决 35.2% 的任务,换到 Codex CLI 内则达 49.6%。
本文的评测对象正是 harness 本身而非任务答案;理解执行循环、工具、上下文、状态、生命周期、验证这六大构成模块,是读懂基准设计和实验分析的门槛。
Creator/Executor 分离与 Self-Eval/Unified-Eval
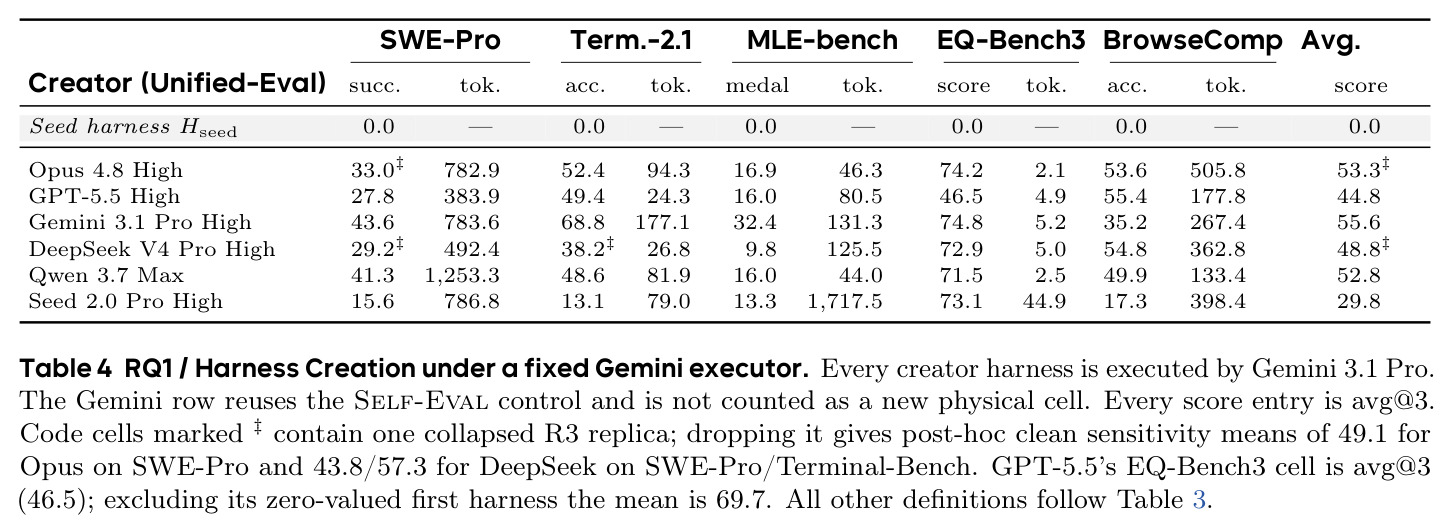
基准把开发 harness 的模型(creator,记作 $\mathcal{L}_C$)与在 harness 里跑下游任务的模型(executor,记作 $\mathcal{L}_E$)分开。Self-Eval 让创建者兼任执行器,衡量完整系统;Unified-Eval 统一用 Gemini 3.1 Pro 执行所有 harness,隔离执行器能力差异,专测 harness 设计质量与跨模型可移植性。
论文多个关键结论(如 Opus 建的 harness 换 Gemini 执行后 SWE-Pro 从 69.3 跌到 33.0)完全依赖这一区分;不懂这组概念就无法理解为何同一 harness 有两套分数。
弱种子(Weak Seed $H_{seed}$)
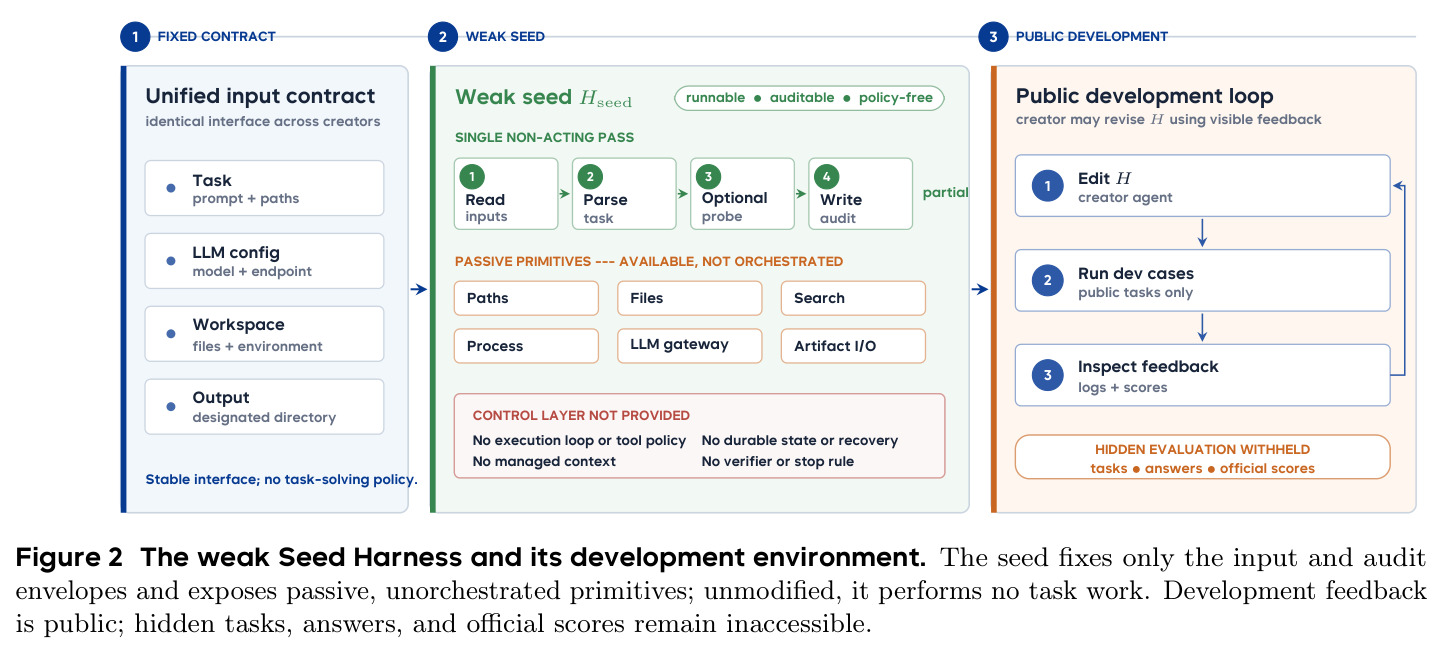
所有创建者共享的起点:一个可运行的兼容层,只解析任务与模型配置、暴露路径/文件/搜索/进程/LLM 网关等被动原语并写审计工件;没有执行循环、工具策略、上下文管理、状态、验证器和停止规则,不做任何任务工作,未修改时所有下游基准得 0 分。
它保证任何非零 Creation 得分只能来自创建者自己新增的执行逻辑,使『从零设计 harness 的能力』可被公平归因,这是基准有效性的基石。
反馈集与 Held-out 泛化
进化阶段中,反复评测的 SWE-Pro-100 与全部 89 个 Terminal-Bench 任务是可见的反馈集;另有 630 条从不展示给创建者的 SWE-Pro 实例构成 held-out 集,只在轨迹冻结后补测。同一 commit 重复运行的对分波动约 ±4.75 分,反馈集上的提升可能是噪声或对反馈集的过拟合。
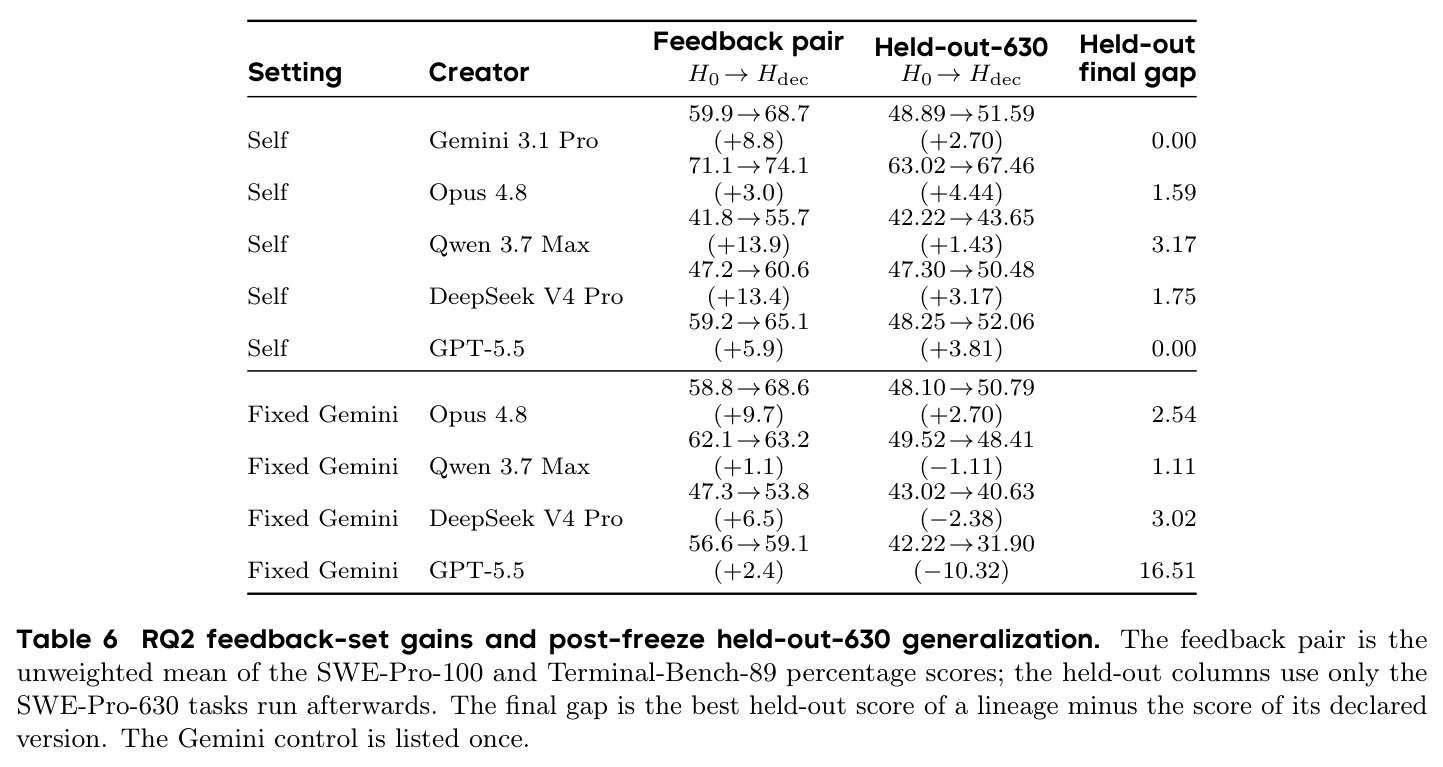
论文核心结论『进化收益不稳定、难以迁移』来自反馈集增益与 held-out 增益的系统性背离(方向一致率仅 53.1%),必须理解这组对照才能读懂 Table 6 和 Figure 8。
执行 Token 成本(Efficiency 轴)
冻结后的 harness 部署求解下游任务时消耗的 executor 模型 token 总量与单任务均值(创建者开发时的 token 不计入)。它与任务成功率并列为第二评测轴,论文刻意不把二者折算成单一分数。
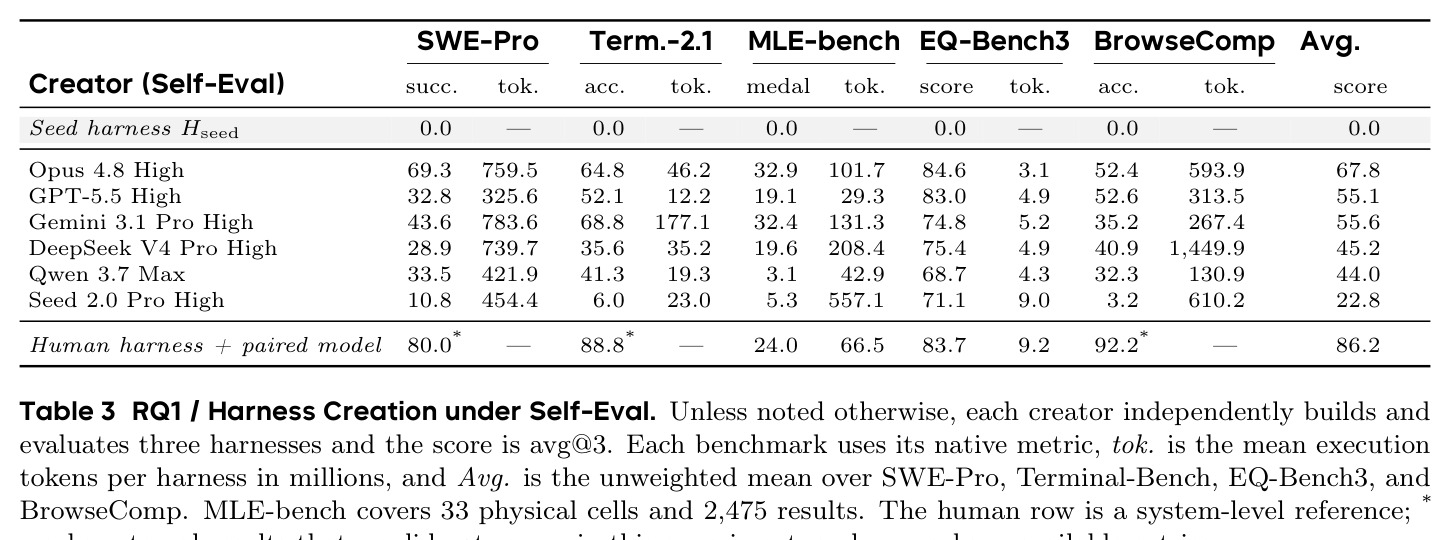
实验发现 MLE-bench 上不同 harness 的执行成本相差约 19 倍而分数相近(GPT-5.5 花 29.3M 得 19.1,DeepSeek 花 208.4M 得 19.6),不看成本轴会误判 harness 优劣。
研究动机
主流智能体评测(SWE-bench、GAIA、WebArena、τ-bench、AgentBench 等)都把 harness 当作实验配置:研究者选定一个脚手架,汇报模型在其内的下游得分,harness 本身从不是被开发、被评测的对象。但 harness 的杠杆极大——同样权重,GPT-5 在 Terminal-Bench 2.1 上于 Terminus 2 内得 35.2%,在 Codex CLI 内得 49.6%,相差 14.4 个百分点。工业界只能靠 FDE(前沿部署工程师)等人力角色弥合『能干的模型』与『可用的系统』之间的差距。更关键的是,harness 工程不同于普通代码编辑:改的是模型观察、规划、恢复的执行基底,改动能影响之后所有任务,因此要求模型能从执行轨迹中识别自身行为缺陷、诊断系统结构瓶颈、做出可持续积累的定向修改。此前工作要么只测固定 harness 下换模型(Harness-Bench),要么只测一次性构建(Meta-Agent Challenge),要么只测优化给定的 harness(HarnessOpt-Bench、Evo-Bench),没有把『创建 + 持续进化』作为整体来系统评测。
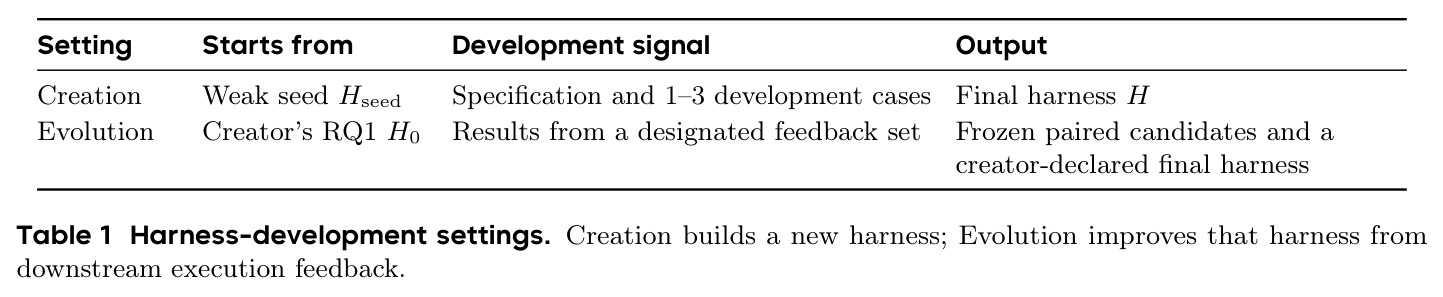
本文的目标是本文提出 HarnessDev,把评测单元从『单次任务答案』换成『可运行、可检查、可复用的基础设施』,回答两个研究问题:RQ1 创建——模型能否从一个刻意弱小但可运行的种子 $H_{seed}$、任务族规范和 1-3 个开发样例出发,构建出完整执行系统并泛化到未见任务;RQ2 进化——模型能否从自己的 RQ1 成品 $H_0$ 出发,利用下游执行反馈(SWE-Pro-100 反馈集加全部 89 个 Terminal-Bench 任务)持续改进它。每个冻结 harness 沿两轴评测:能力(held-out 下游任务的原生指标得分)与效率(executor token 成本),并与成熟的人类工程参考系统对比。评测覆盖 6 个创建者模型、4 个领域、5 个下游基准共 2,207 个独立下游实例,且隐藏评估任务对开发过程不可见。
与已有工作不同的是,本文的独特切入有五点。第一,评测对象是持久基础设施而非一次性输出:提交物是被冻结后跨任务复用的 runnable harness。第二,创建与进化两阶段串联——进化从创建者自己的成品出发,考察的是持续维护能力而非从头设计。第三,严格分离 creator 与 executor,提供 Self-Eval 与 Unified-Eval(统一 Gemini 3.1 Pro)两种视图,把 harness 设计质量与模型能力解耦,并度量跨执行器迁移。第四,防作弊约束可检验而非建议性:分数路径与 harness 隔离(SWE-Pro 积分只认工作区里真实的仓库 diff,Terminal-Bench 积分只认最终环境状态,harness 自报的成功状态不是评分输入),并对每次运行的源码与执行工件做事后审计,本研究报告了零违例的审计结果。第五,同一冻结工件在自运行与固定运行时下双测,且对轨迹中每个官方版本补测 630 条不相交 held-out 实例,把『对反馈的在线适应』与『held-out 泛化』分开报告——这是现有同类基准都没有做到的。
核心方法
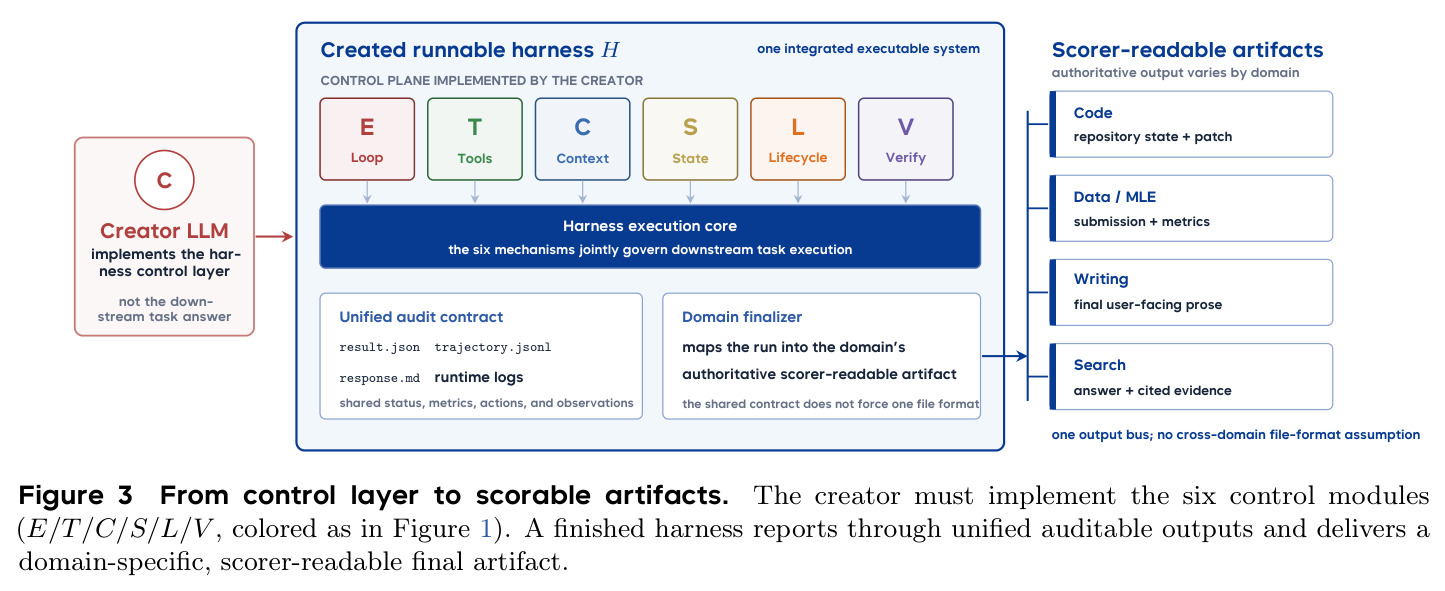
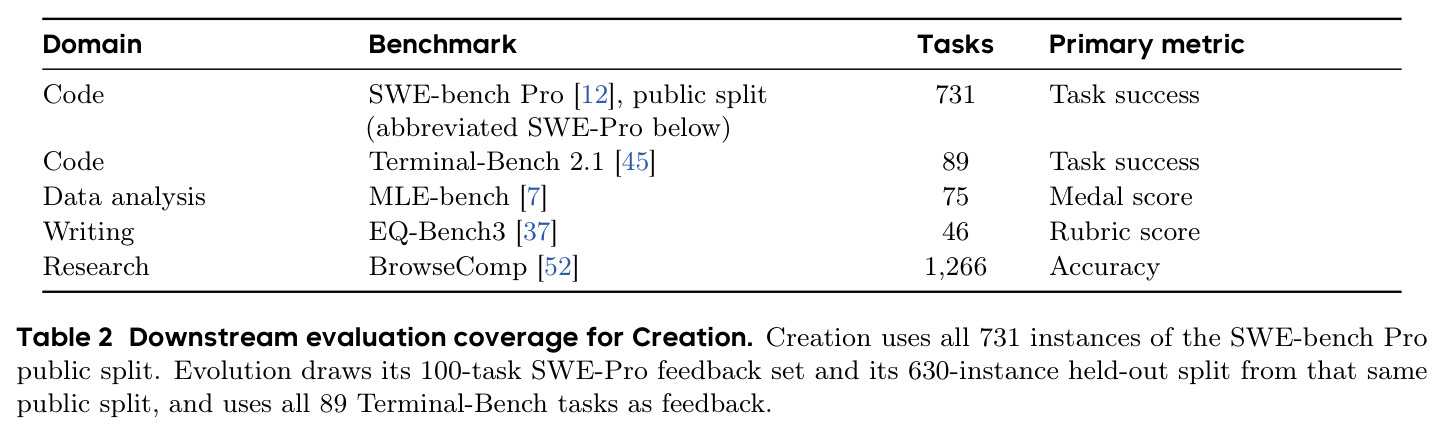
直觉是:想知道一个模型会不会『造工具』,就给它一块白板和几件样品,看它造出的生产线在没见过的订单上跑得如何、耗多少电,然后让它根据产线的废品率反复改造产线。技术路线遵循式 (1):$(\mathcal{L}_C, \mathcal{D}) \to H$,$(H, \mathcal{L}_E, x) \to y \xrightarrow{J} \text{score}$——创建者 $\mathcal{L}_C$ 在开发环境 $\mathcal{D}$(Claude Code 2.1.177,GPT-5.5 用 Codex 0.144.3)内产出可运行 harness $H$;随后 $H$ 被冻结,由执行器 $\mathcal{L}_E$ 代入求解下游任务 $x$,评分器 $J$ 只读最终工件。$H$ 必须实现六大控制模块 E/T/C/S/L/V——执行循环、工具、上下文、状态、生命周期、验证——并通过统一审计契约(result.json、trajectory.jsonl、response.md、运行日志)输出共享状态与动作,再由领域定稿器把运行结果映射为各域可评分的最终工件(代码补丁、提交加指标、最终文稿、带引用证据的答案)。下游基准为 SWE-bench Pro 公开切分(731 题)、Terminal-Bench 2.1(89 题)、MLE-bench(75 题)、EQ-Bench3(46 题)、BrowseComp(1,266 题)。
核心创新是把『可运行、持久、可审计的基础设施』确立为评测单元,并用三个机制保证测的是设计能力而非记忆或作弊。其一,弱种子设计刻意避开两个极端:空仓库会把 harness 设计与命令行、文件格式等杂务混在一起;成熟智能体则会泄露正被测试的规划与验证结构。$H_{seed}$ 只给被动原语、不给任何策略,未修改时五个基准全为 0 分,从而任何非零分都可归因于创建者新增的执行逻辑。其二,分数路径隔离让作弊在机制上不可行:SWE-Pro 的积分只来自任务工作区留下的真实仓库 diff,Terminal-Bench 的积分只来自最终环境状态,harness 的自我声明永远不是评分输入,配合源码与执行工件的事后审计形成闭环。其三,创建者-执行者分离直接回应了『Harness 更新不等于 Harness 收益』的方法论批评——同一冻结工件在自运行与固定 Gemini 运行时下双测,把共适应与设计质量分开。与最近的并行工作相比,HarnessOpt-Bench 只优化给定 harness,Evo-Bench 只在固定运行时下改进共享种子并只评最终修订版,而 HarnessDev 连接创建与进化、对全轨迹每个版本做 held-out 回测、并度量 token 成本。
方法步骤详情
第一步,发放弱种子:包含固定输入契约(任务、LLM 配置、工作区、指定输出目录)、被动原语(路径、文件、搜索、进程、工件 IO、LLM 网关)与审计契约;无执行循环无策略,只允许一次连通性探测,原样运行产出 partial 状态、五个基准全 0 分。第二步,创建(RQ1):给创建者任务族规范、工具与权限约束、简短设计教程和 1-3 个开发样例;模型可在公开样例反馈下自测修订,但看不到人类实现与隐藏评估集;产出冻结为 $H$。每个创建者-基准对独立构建 3 次、报 avg@3;先 Self-Eval(创建者兼任执行器),再 Unified-Eval(统一 Gemini 3.1 Pro 执行所有 harness)。第三步,评分:在 held-out 下游任务上运行,记录基准原生指标得分与执行 token(总量及单任务均值)。第四步,进化(RQ2):控制器先在 SWE-Pro-100 与 Terminal-89 上评估 $H_0$;此后每个候选版本必须在同一 commit 上完成两基准的完整官方评测对才能进入官方轨迹;两次正式评测之间最多可用 2 次固定前 5 任务的诊断探针(探针结果不计分);总预算 10 对;创建者最终声明一个非 $H_0$ 的版本。第五步,泛化回测:全部轨迹结束后,对每个官方版本补测 630 条与反馈集不相交的 SWE-Pro 实例,对分 $\bar{P}_t = \frac{1}{2}(P_t^{\text{SWE100}} + P_t^{\text{Term89}})$,这些分数从不反馈给创建者。第六步,审计:检查交付源码与执行工件是否存在硬编码实例解、访问隐藏测试等违禁路径。
技术新颖性
技术新颖性体现在五个层面。(1) 弱种子的归因设计:与 Meta-Agent Challenge 直接给沙盒不同,$H_{seed}$ 刻意处于『能运行但不能解题』的状态,把失败精确归因到创建者缺失的执行逻辑,而非环境配置或样板代码。(2) 机制性防作弊:不靠提示词约束而靠评分路径隔离(只认 diff 与环境状态)加全量审计,文中报告这是 null result——没有 harness 通过违禁路径得分。(3) 双执行器视图:呼应『harness 更新不等于 harness 收益』的批评,用同一工件测自运行与固定运行时,首次系统量化 creator-executor 共适应(如 Opus harness 的去重规则只适配原模型,换执行器后重复查询率从 10.1% 飙到 88.2%)。(4) 全轨迹 held-out 回测:不是只评最终版,而是对 73 个官方版本逐一补测 630 条 held-out 实例,从而能观察到版本选择过拟合——反馈分上升只在 53.1% 的切换中与 held-out 同向。(5) 工程质量指标:组件证据密度分析(机制是否在真实运行中触发、新增函数是否可达)提供了超越分数的诊断维度,例如 26,679 条已记录轨迹中未出现任何一次 checkpoint 事件,这类发现对 harness 工程实践有独立价值。
实验结果
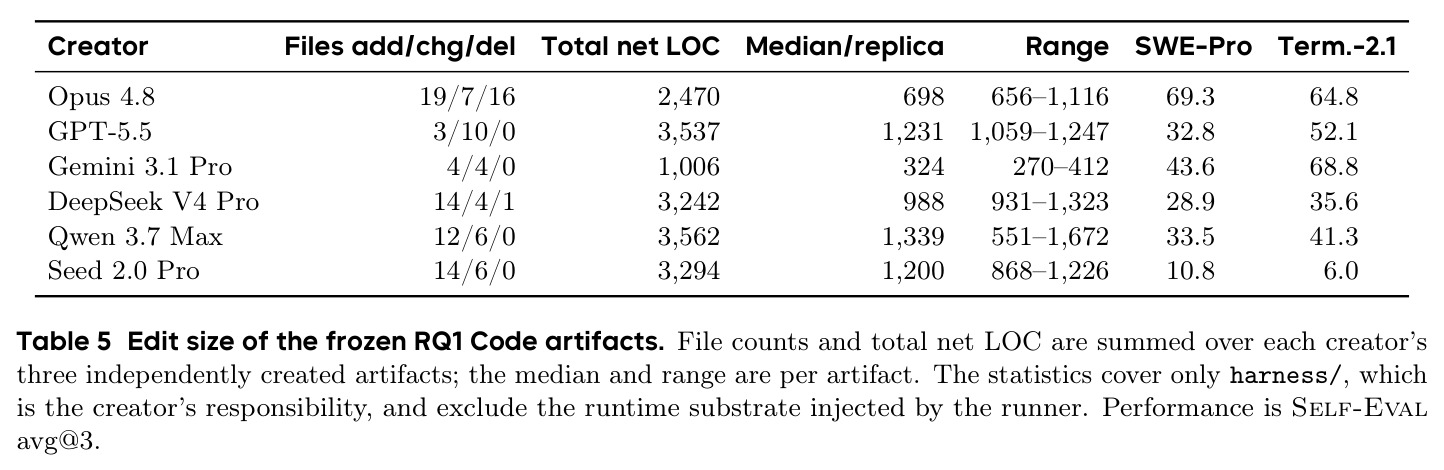
创建(RQ1,Self-Eval,avg@3):Opus 4.8 综合最高(平均 67.8),但仍低于人类工程参考的 86.2;Seed 2.0 Pro 最弱(22.8)。分领域看,写作接近或超过参考(Opus 84.6、GPT-5.5 83.0,参考 83.7);机器学习实验超过参考(Opus 32.9、Gemini 32.4,参考 24.0);代码明显落后(SWE-Pro 最佳 69.3 对 80.0,Terminal-Bench 最佳 68.8 对 88.8);搜索研究差距最大(BrowseComp 最好约 52.6 对 92.2)。执行成本差异巨大:MLE-bench 上约 19 倍,高成本不保证高分。77.8% 的 Data 失败任务归因于 harness 缺陷而非执行器能力。工程质量普遍堪忧:18 个 Code 工件净增 17,111 行但行数与性能无关(Gemini 仅加 1,006 行却拿下 Terminal-Bench 最佳 68.8);108 个 Code 组件实例中 18 个从未触发(全是状态/内存类),Writing 587 个特征中 124 个为死代码;441/2,325 个 Data 任务产生退化提交且无一被检测;自测次数与下游分的 Spearman 相关仅 0.13-0.26(不显著),修订调用次数达 0.57。进化(RQ2):9 条谱系共产出 73 个官方版本、64 次版本切换。反馈对上五个自运行谱系全部提升(Qwen +13.9、DeepSeek +13.4、Gemini +8.8、GPT-5.5 +5.9、Opus +3.0),但 held-out-630 上收益缩水:自运行仍全为正(+1.43 至 +4.44,均值 +3.11,Opus 最佳);固定 Gemini 下仅 Opus 为正(+2.70),GPT-5.5 反而 −10.32(最终差距 16.51)。64 次切换中 27 次增益落在 ±4.75 噪声带内、仅 2 次有超出噪声的正证据;169 个新增函数/类中 25 个无调用者、31 个仅经死代码可达;声明版本仅 2/9 是 held-out 最优。正例是 Opus 发现 100 次运行 99 次自报成功而实际仅 48 通过,定位早停缺陷并加完成门,held-out +4.44。
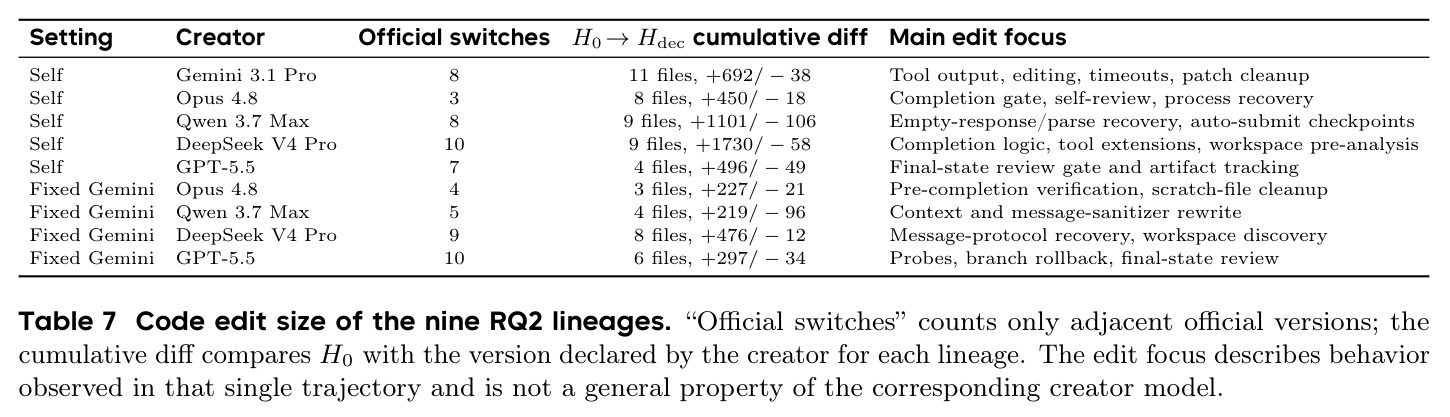
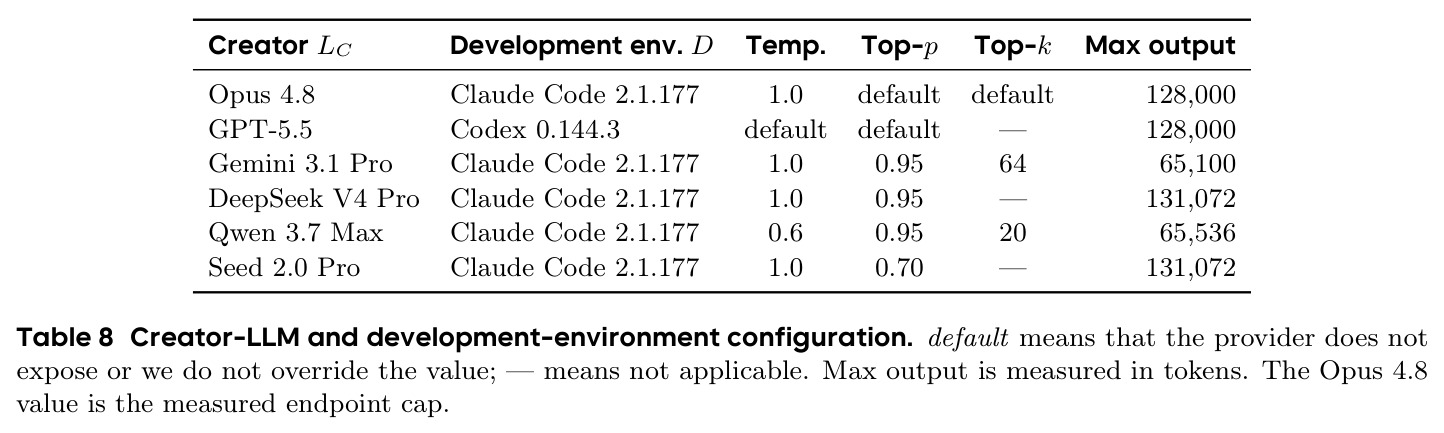
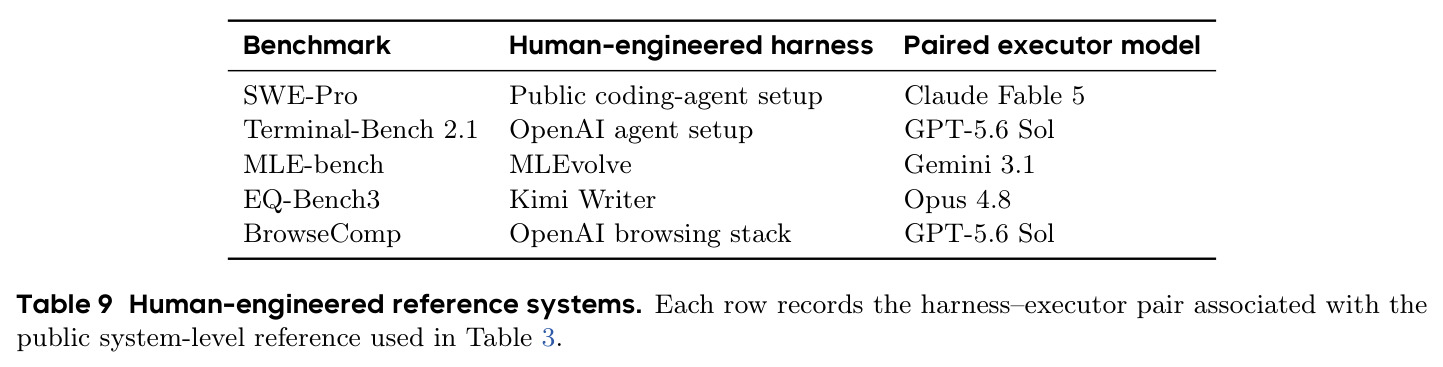
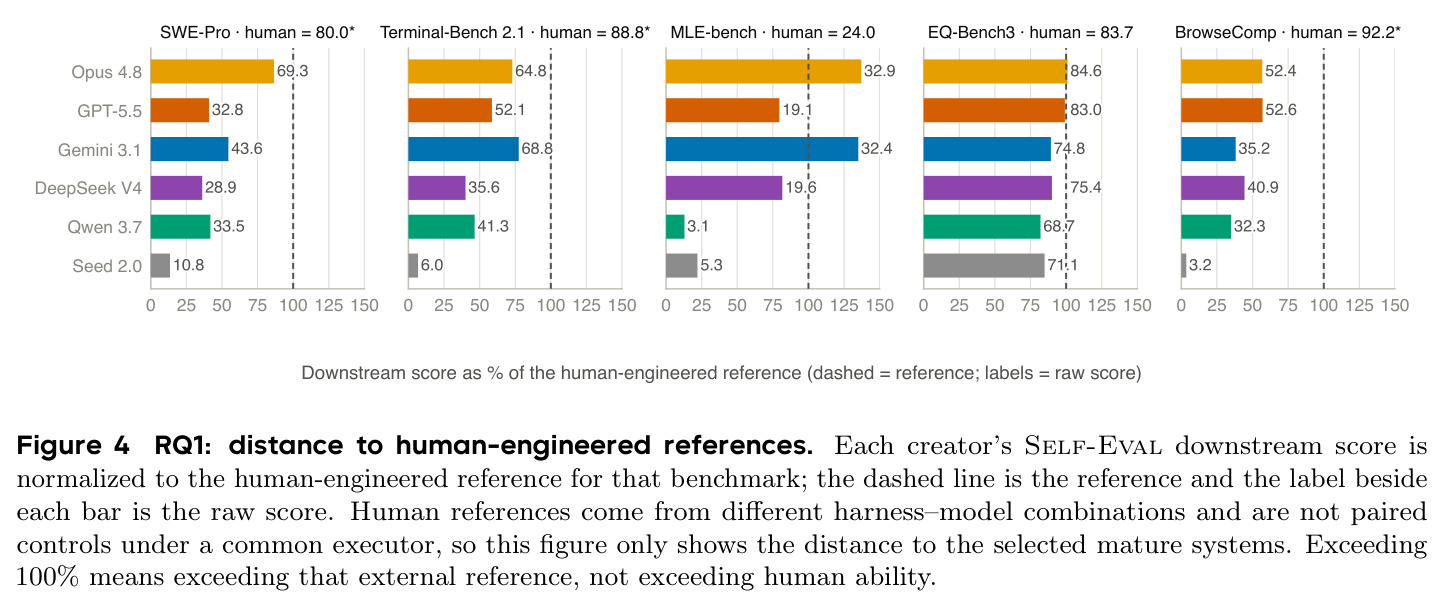
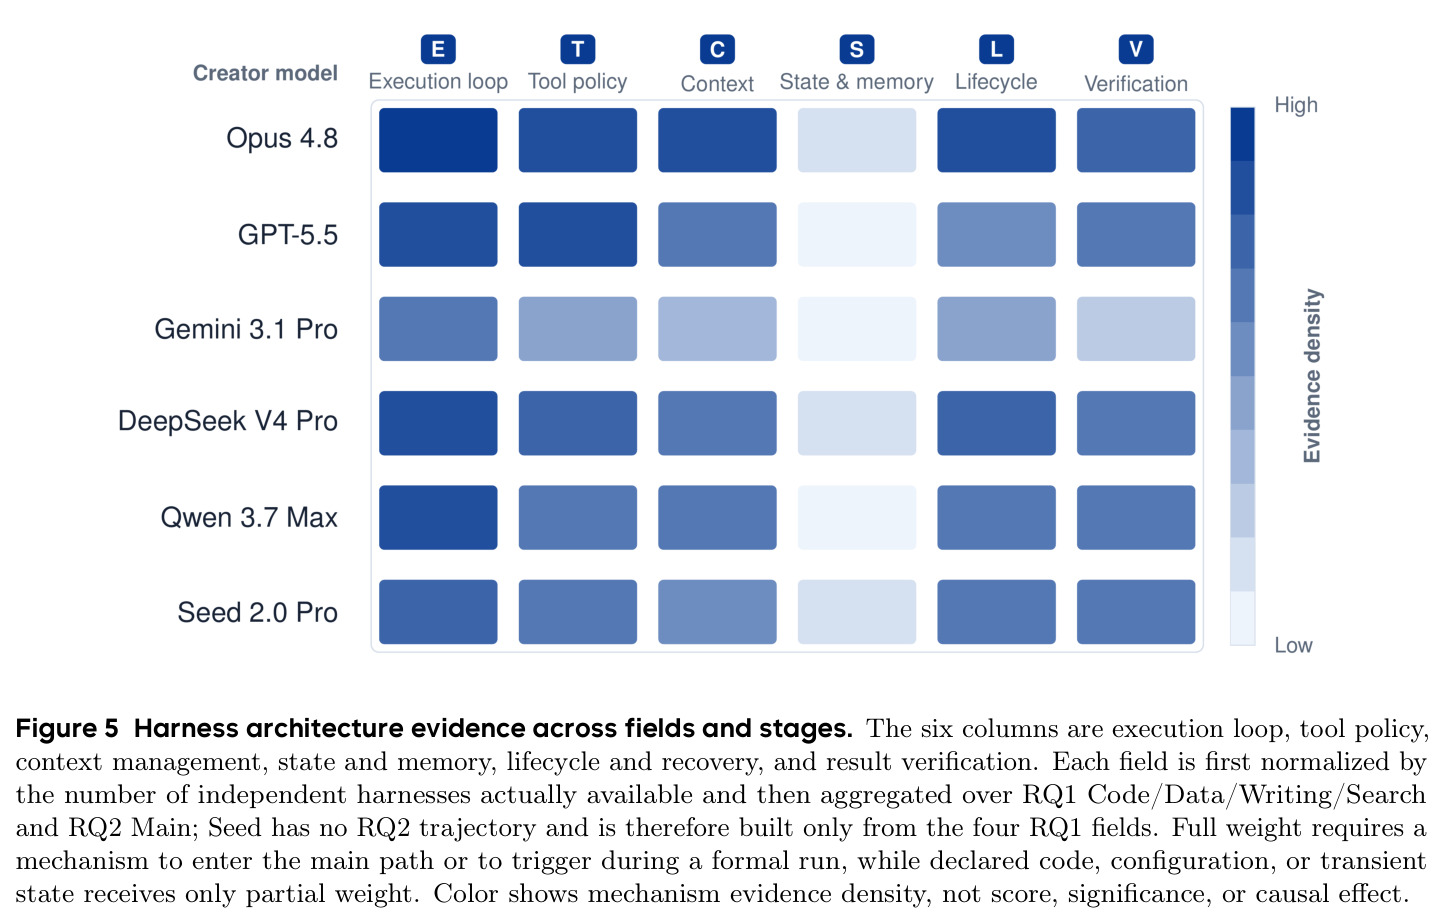
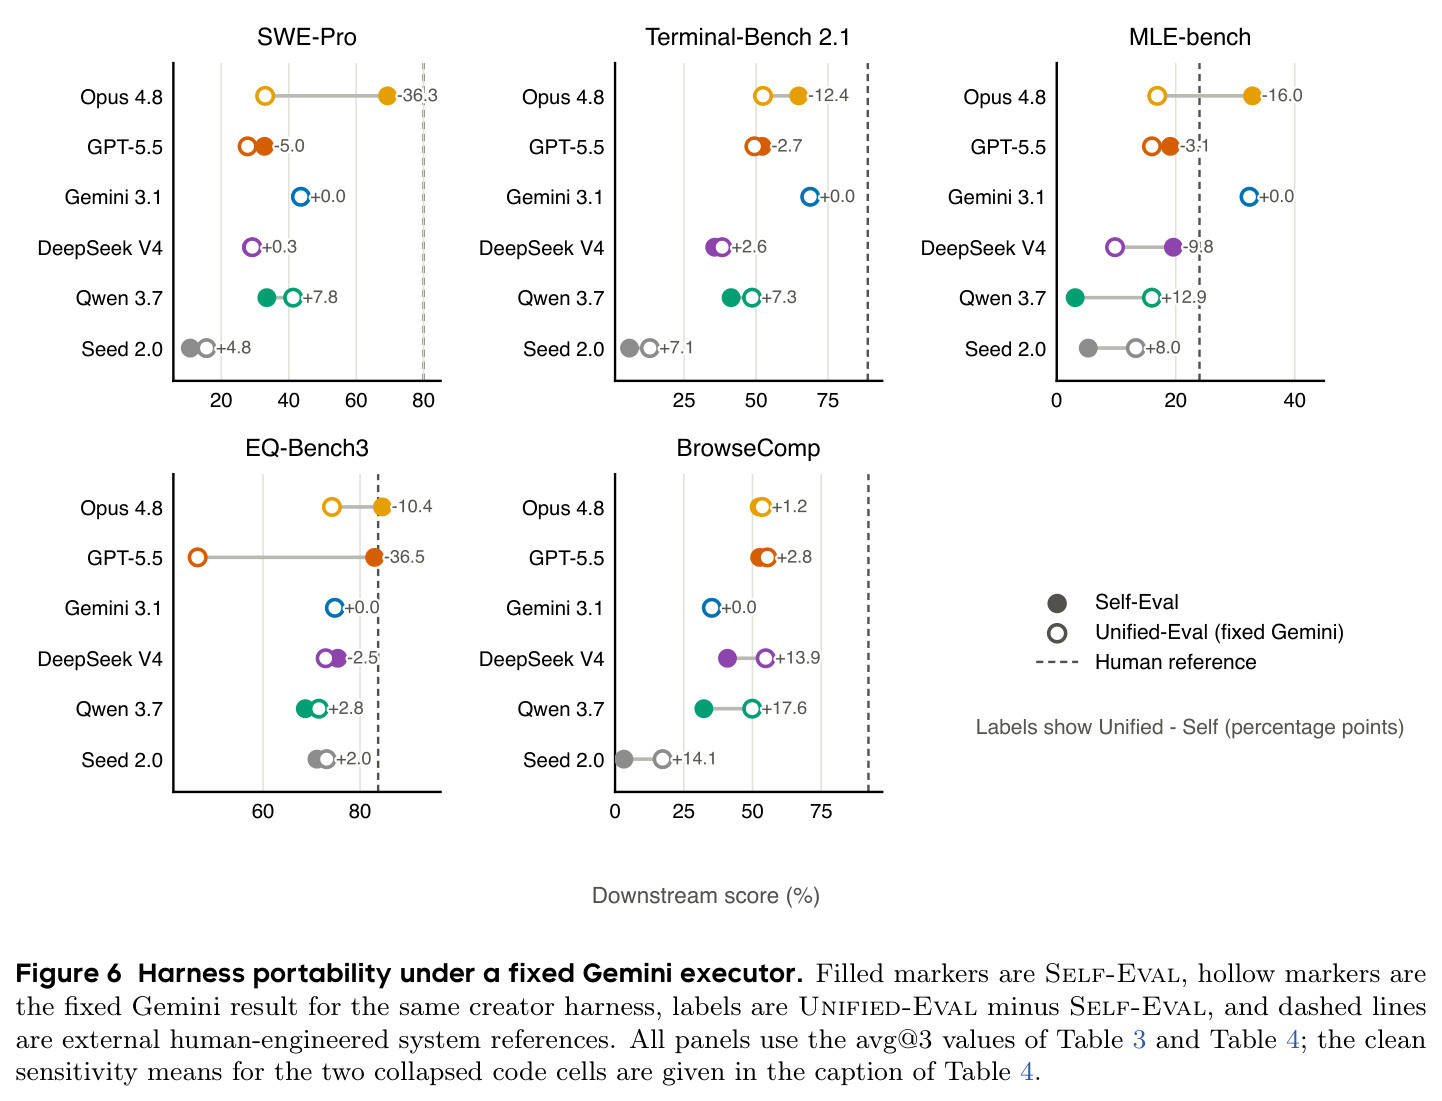
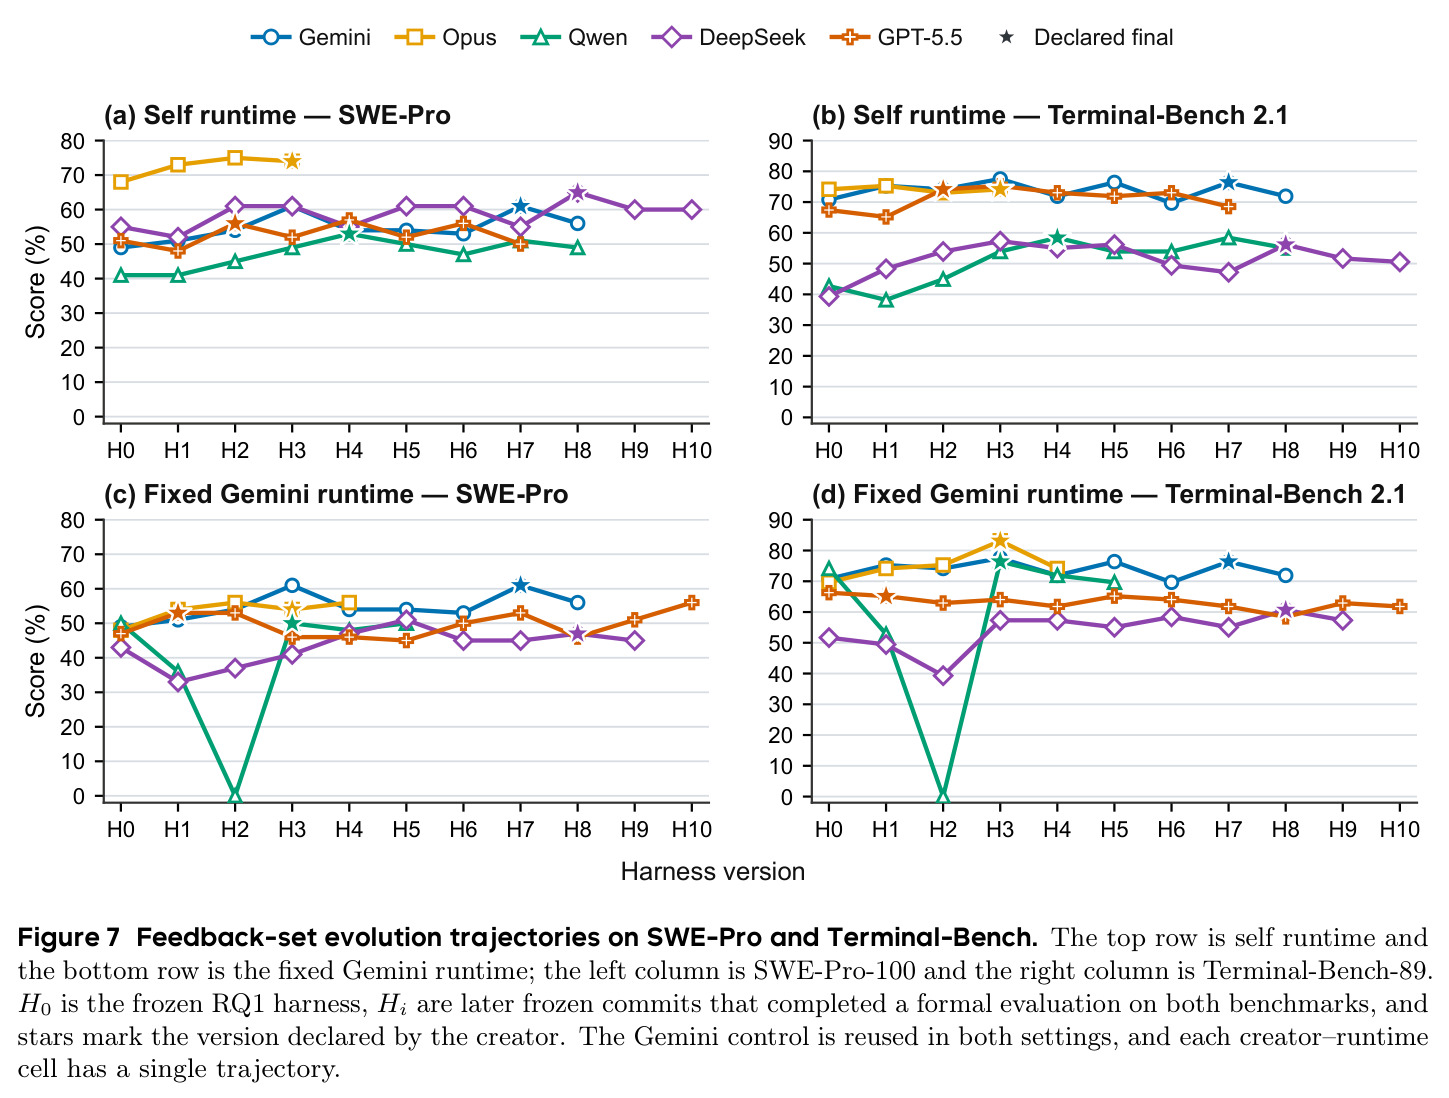
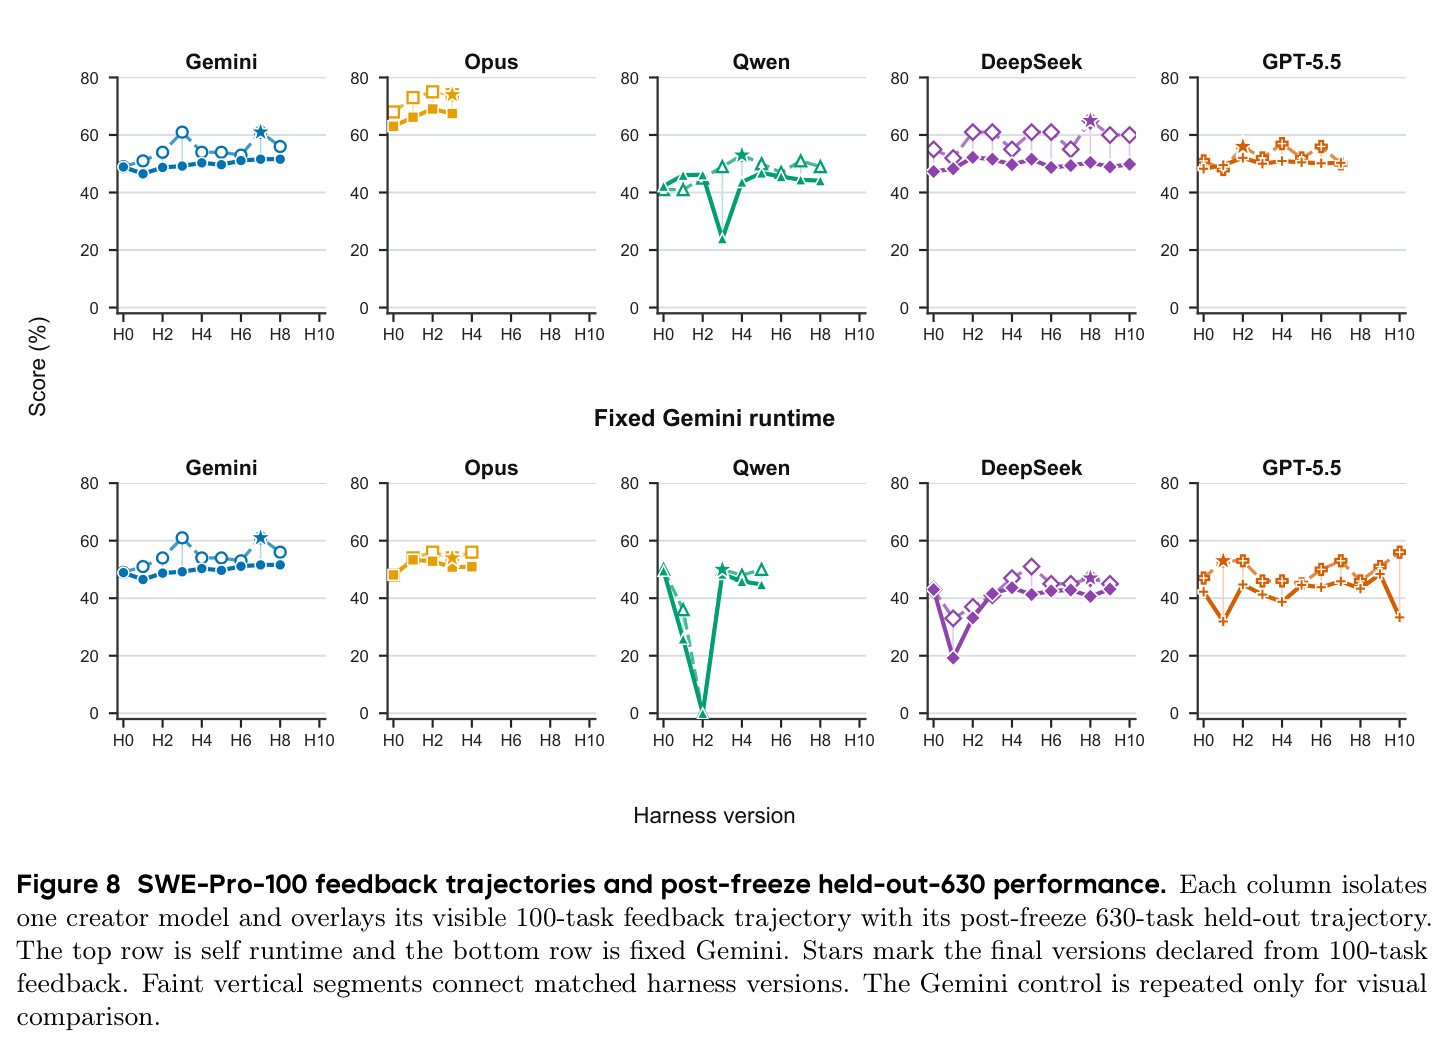
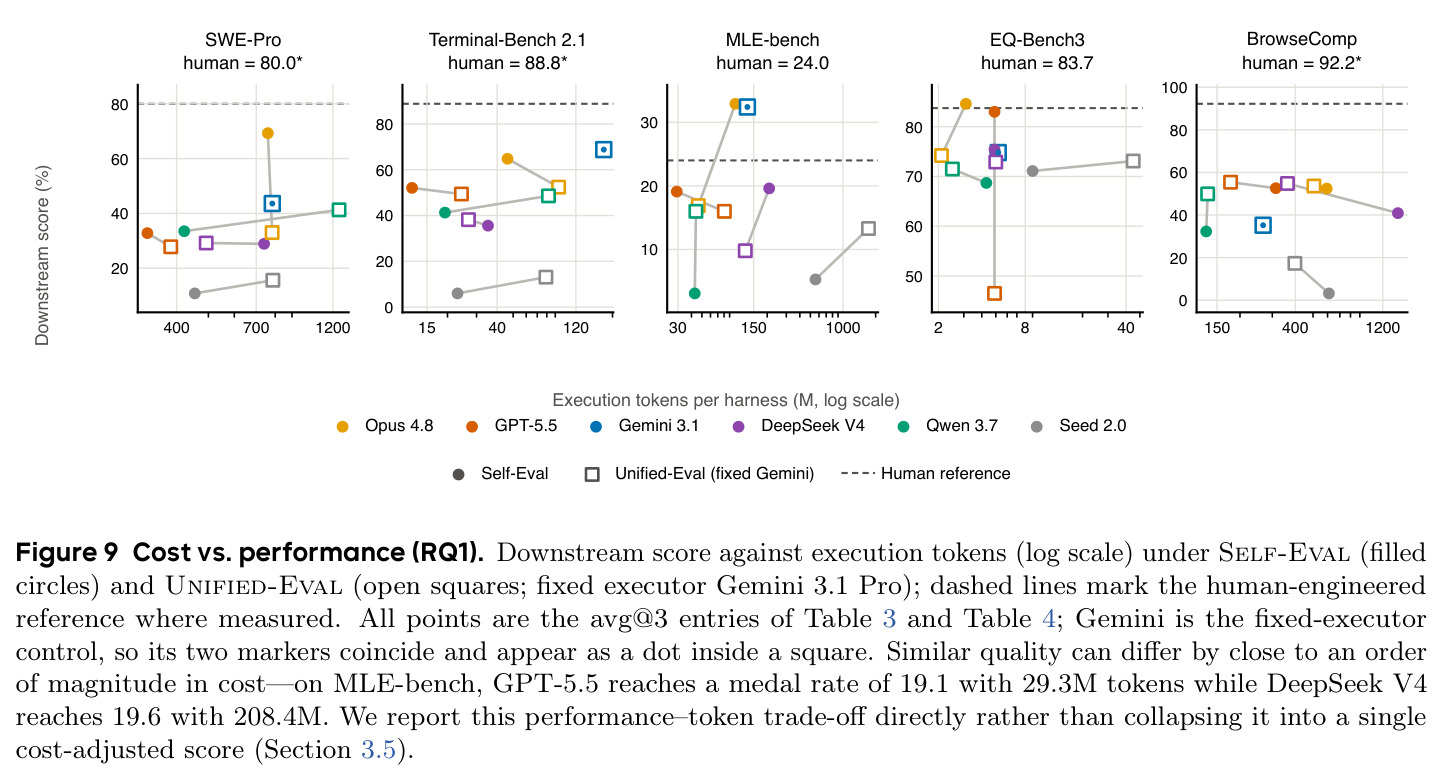
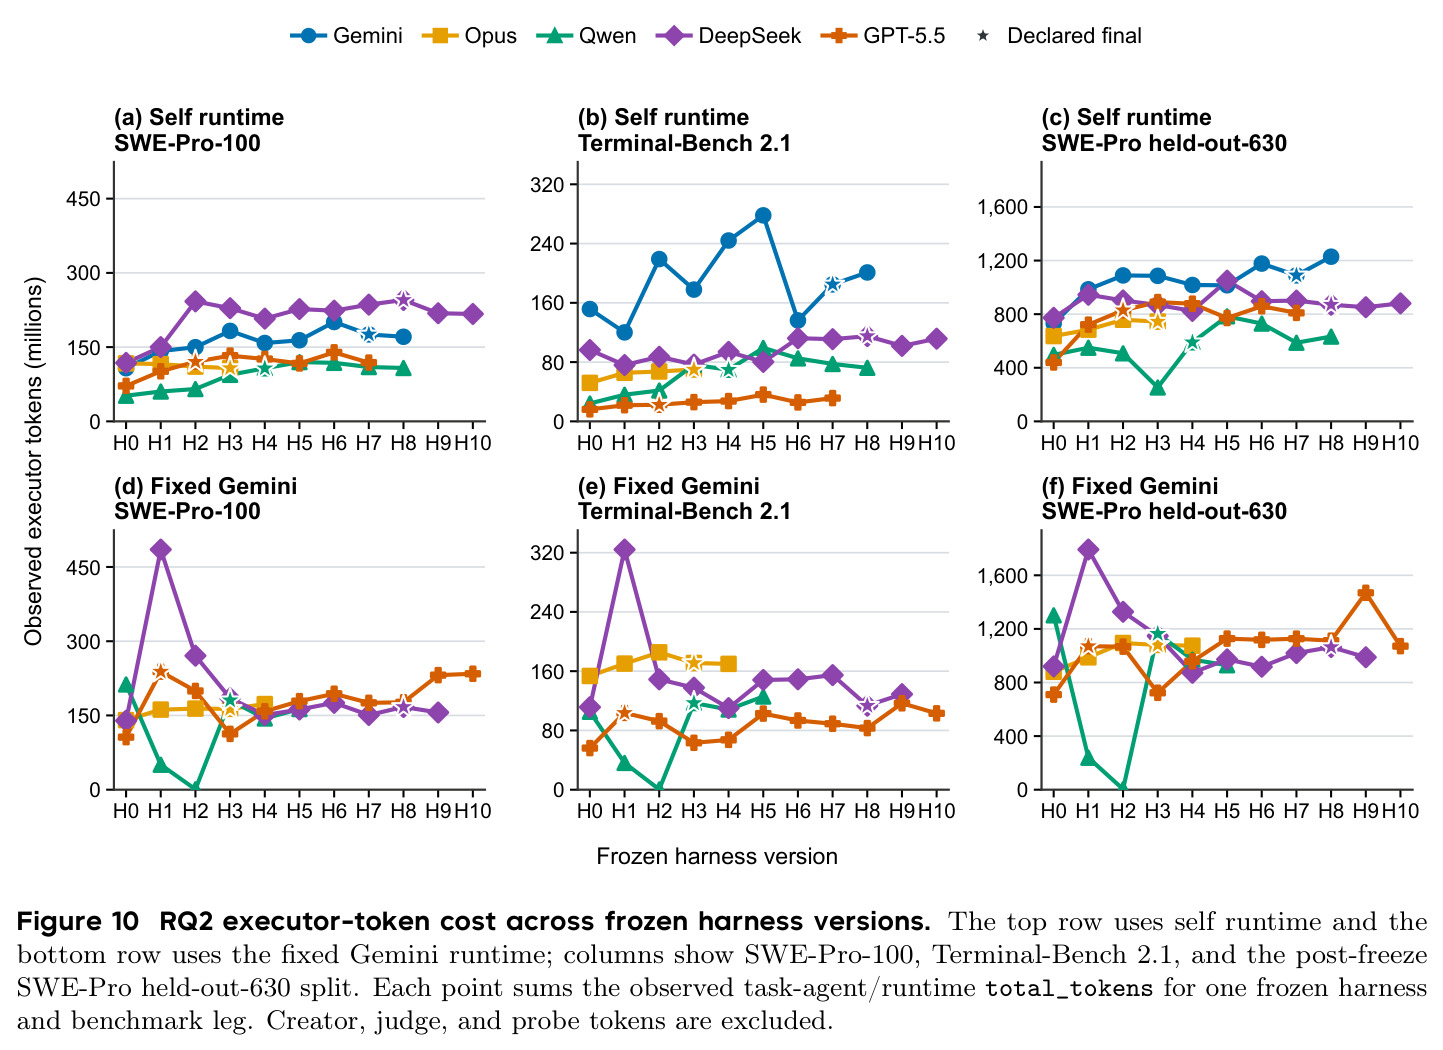
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RQ1 创建·综合(五基准均值,Self-Eval) | 平均分 | Opus 4.8 建的 harness 67.8 | 人类工程参考 86.2;弱种子 0.0 | 距人类参考 −18.4,但对种子从 0 到 67.8 |
| RQ1 创建·SWE-bench Pro 公开切分 | 任务成功率 (%) | Opus 4.8:69.3 | 人类参考(Claude Fable 5)80.0 | −10.7;换 Gemini 执行后跌至 33.0(硬编码 120 步上限) |
| RQ1 创建·Terminal-Bench 2.1 | 任务成功率 (%) | Gemini 3.1 Pro:68.8 | 人类参考(GPT-5.6 Sol)88.8 | −20.0,且 Gemini 仅加 1,006 行代码 |
| RQ1 创建·MLE-bench | 奖牌率 (%) | Opus 4.8:32.9(Gemini 32.4) | 人类参考(MLEvolve + Gemini 3.1)24.0 | +8.9,超过人类参考;成本差约 19 倍(29.3M vs 208.4M token) |
| RQ1 创建·EQ-Bench3 写作 | Rubric 分 | Opus 4.8:84.6(GPT-5.5 83.0) | 人类参考(Kimi Writer + Opus 4.8)83.7 | +0.9,基本追平人类参考 |
| RQ1 创建·BrowseComp 研究 | 准确率 (%) | GPT-5.5:52.6(Opus 52.4) | 人类参考(GPT-5.6 Sol)92.2 | −39.6,所有领域中的最大差距 |
| RQ2 进化·反馈对(SWE-Pro-100 + Terminal-89) | 对分 $\bar{P}_t$ 变化(百分点) | Qwen +13.9、DeepSeek +13.4、Gemini +8.8(自运行) | 各自的 RQ1 冻结版 $H_0$ | 五个自运行谱系反馈集全部为正 |
| RQ2 进化·held-out-630 泛化(自运行) | SWE-Pro-630 成功率变化 | Opus +4.44(最佳),均值 +3.11 | $H_0$(48.89-63.02 区间起点) | 收益缩水至反馈增益的约 1/3 但全部为正 |
| RQ2 进化·held-out-630 泛化(固定 Gemini) | SWE-Pro-630 成功率变化 | 仅 Opus +2.70;GPT-5.5 −10.32 | 同一起点在 Gemini 运行时下 | 换运行时后 3/4 谱系泛化转负,GPT-5.5 最终差距 16.51 |
局限与改进
作者承认的局限:四个领域类别覆盖许多但非全部真实部署;人类基线不均衡且不保证最优,且是外部系统级成绩而非同一执行器下的配对对照;Unified-Eval 减少但无法完全消除执行器差异,因为 harness-模型交互复杂;行为比较是描述性的且基准覆盖不全;进化每个 creator-运行时单元只有一条轨迹(还有一个未完成的主运行时单元,即 Seed 无 RQ2 轨迹),held-out 回测只覆盖 SWE-Pro,因此轨迹不支持不确定性估计或总体层面比较;开发环境 $\mathcal{D}$ 在两阶段保持不变,进化后的 harness 能否充当进一步进化的开发环境留待未来;基准只测模型外部学习,不声称启发式学习可替代参数训练。我自己的观察:人类参考取自不同 harness-模型组合的公开最高分(如 SWE-Pro 80.0 来自 Claude Fable 5),『距人类差距』的绝对数值只能作方向性参考;同 commit ±4.75 分的噪声带使得单轨迹上的多数进化结论在统计上脆弱;BrowseComp 等检索基准可能存在创建者预训练数据污染风险,论文未讨论;效率轴只统计 executor token,未折算不同模型的单价差异或创建阶段的开发成本。
独立分析的弱点
独立分析出五个弱点。第一,统计功效不足:同 commit 波动 ±4.75 分而典型进化增益只有 2-4 分,且每单元单轨迹,27/64 的『增益』无法与噪声区分——改进方向是官方协议强制重复运行并报告置信区间,或采用序贯检验决定停止。第二,反馈消费接口薄弱:专用轨迹接口在全部轨迹中只被调用 2 次,显式检查的失败案例仅占 189 个反馈任务的 0.5%-40.2%,模型依赖自写脚本和小探针,而探针会系统性误导(GPT-5.5 候选 5/5 探针通过却在全量集只得 0.584)——应给创建者提供结构化的轨迹检索、失败聚类与分层抽样评估工具。第三,进化仅限代码域:写作、搜索、数据 harness 是否可反馈驱动进化完全未知,而那恰是创建阶段表现最好的领域。第四,执行器耦合普遍:硬编码步数上限(Opus 的 120 步)、模型特化的去重与停止规则导致换模型即崩,改进方向是把执行器相关配置外部化为声明式预算文件并在统一运行时验证。第五,人类参考不可配对:各域参考来自不同 harness-模型组合的外部报告,改进方向是在同一执行器下重跑至少一个开源参考系统形成真正的配对对照。另外 441 个 Data 任务的退化提交无 harness 检出,说明验证模块(V)是最弱一环,值得专门的诊断基准。
未来方向
作者提出的方向:同等预算下的朴素搜索基线对照(matched-search evaluation)以判断反馈驱动进化是否真优于盲目搜索;测试进化后的 harness 能否作为进一步进化的开发环境;扩充行为比较的基准覆盖并支持不确定性估计。基于本文成果可延伸:(1) 把 E/T/C/S/L/V 证据密度作为可优化信号,仿照 Harness-R1 思路训练专门的 harness 工程师模型,用『失败批次到验证补丁』的数据闭环做后训练,弥补本文发现的失败诊断短板;(2) 在开发循环中注入回归测试套件与可达性/死代码静态检查,直接针对 25 个无调用者函数、31 个死代码可达函数与 27 次噪声增益问题;(3) 跨执行器鲁棒性协议:要求 harness 把步数上限、停止规则、token 预算声明为配置,并在两个以上运行时下验证后才能冻结,从制度上消除 Opus 式的 120 步硬编码失败;(4) 把能力-成本权衡呈现为帕累托前沿而非单点分数,并按模型单价折算真实部署成本;(5) 把进化协议扩展到 BrowseComp 式长程检索与 MLE 式实验域,检验『创建强、进化弱』的格局是否跨域成立;(6) 结合模型外部学习与参数训练:进化产生的高频修复模式可蒸馏回模型权重,两条智能积累路径的互补性值得系统研究。
复现评估
复现评估:作者承诺随基准发布弱种子参考实现、审计脚本、held-out 任务划分,以及各人类参考系统的角色分配、commit 哈希与许可证钉扎清单,项目页为 self-developing-agents.github.io,ArXiv 编号 2609.01437,论文细节(种子骨架代码、系统提示词、RQ1/RQ2 完整案例)写在附录 C/E/F/G 中,透明度高。模型侧需要 6 个前沿商业 API(Opus 4.8、GPT-5.5、Gemini 3.1 Pro、DeepSeek V4 Pro、Qwen 3.7 Max、Seed 2.0 Pro),均有官方或 OpenRouter 通道,但 API 费用可观。算力方面:MLE-bench 每任务需 1×A800-80GB GPU、14 vCPU、227 GiB 内存、36,000 秒墙钟(34,200 秒给 harness、1,800 秒留给判分器),RQ2 代码基准每任务 500 步/7,200 秒上限;RQ1 要求 avg@3(论文报告 33 个物理单元、2,475 次结果,共 26,679 条 Code 轨迹),RQ2 产生 73 个官方版本且每个版本都要跑 100+89 题官方对再加 630 题 held-out。完整复现表 3/4/6 需要数千次长时容器运行,属于高成本;单创建者-单基准单元的子集复现(数十次运行、数天时间、单机数卡)为中等难度。利好是评分路径完全客观(真实 diff 与环境状态),五个下游基准全部公开,不依赖主观 LLM 评审,结果可核验性强。
论文图表
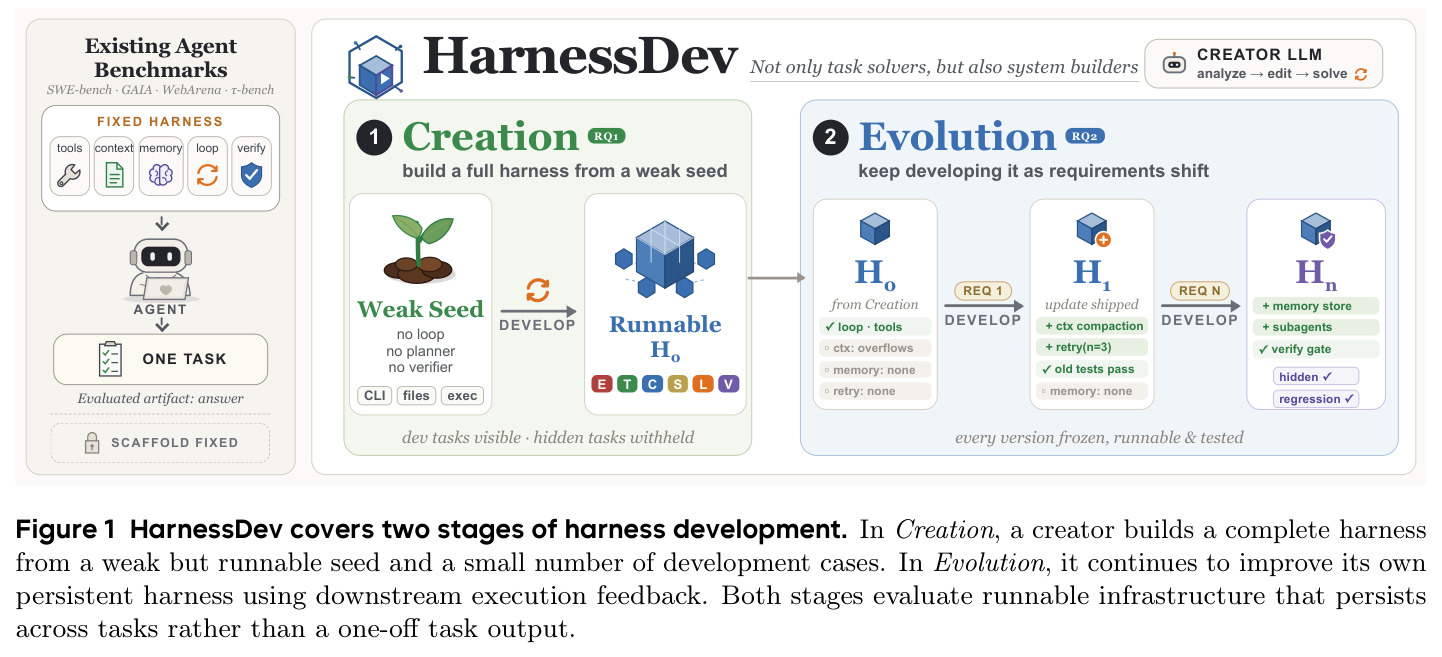
总览图。左侧是现有评测范式:固定 harness 当作配置,模型只做任务求解者。右侧是 HarnessDev:创建者 LLM 先从弱种子 $H_0$ 构建完整执行系统(RQ1 Creation),再利用下游执行反馈在自己的持久 harness 上持续开发、每个版本冻结可运行可测试(RQ2 Evolution),评测对象是跨任务持久的基础设施,下游基准包括 SWE-bench、GAIA、WebArena、τ-bench 等,隐藏任务扣留、开发任务可见。
一图看懂基准的两阶段结构和『从解题者到造系统者』的评测对象转换,是理解全文组织方式的入口。