VITAL:从视觉运动到精确动作 VITAL: From Visual Motion to Precise Action
视觉骨架定主目标、度量残差补精度,一步流匹配生成轨迹,残差RL有界精修
前置知识
世界-动作模型(World-Action Model)
把视频预测(世界模型)与动作生成(策略)耦合的驾驶框架,通常采用混合Transformer结构:动作token通过注意力机制读取视频专家的特征后再解码自车轨迹,代表工作有Drive-WM、DriveLaW、SUV、SimWAM。理想是“模型学会预测世界如何运动,就顺带学会如何行动”。
本文的核心批评正是针对这类模型:两个专家只交换特征、不共享预测目标,动作专家学的仍是独立于视觉动态的轨迹坐标编码,这就是所谓“视觉-动作表示鸿沟”,理解这一背景才能明白VITAL为何要改造动作目标本身。
流匹配(Flow Matching)
一种生成式建模方法:学习速度场 $v_\theta(z_t, t)$,把高斯噪声沿插值路径 $z_t = (1-t)\epsilon + t z^\star$ 输运到数据分布,训练目标是回归目标速度 $u = z^\star - \epsilon$,推理时用欧拉积分从噪声采样到数据,积分步数越少推理越快但误差越大。
VITAL的动作专家就是一个流匹配模型,“单步欧拉采样即可生成高质量轨迹”是其低延迟卖点的技术基础,论文还专门推导了单步积分误差上界来解释为什么一步就够。
动作分词器(Action Tokenizer)
把连续动作序列压缩成紧凑latent码、再解码还原的模块:FAST用离散化、VQ-BeT用向量量化、LAPA/RepWAM从视觉状态转移中推断latent action。tokenizer决定了策略要预测的目标的几何结构和信息容量,直接影响下游规划精度与可预测性。
VITAL的本质贡献就是一个新的动作tokenizer——视觉骨架码加配对度量残差码,全部三个训练阶段(目标构造、模仿学习、残差RL)都围绕这一表示展开,读懂tokenizer设计就读懂了全文。
残差策略学习(Residual Policy Learning)
在已训练好的基础策略之上学习一个修正项,最终动作等于基策略输出加上修正 $\tau_\phi = \tau_{IL} + \Delta$,由Johannink等人在2019年系统化。修正空间通常被约束以保证稳定性和安全性,训练信号来自与环境的奖励交互。
VITAL的残差RL把修正严格限制在tokenizer自带的残差PCA坐标里,并用径向限制器把解码位移限幅在1米/0.2弧度内,零修正时精确还原基策略——这是其“结构保持后训练”区别于一般RL微调的关键。
NAVSIM基准与PDMS指标
NAVSIM是基于nuPlan/OpenScene数据的非反应式驾驶规划仿真基准。v1的PDMS由无责碰撞(NC)、可行驶区域合规(DAC)、自车进度(EP)、碰撞时间(TTC)、舒适度(C)五个子项(多为乘性门控)综合而成;v2的EPDMS扩展为九个子项并修正了打分协议,navhard则用两阶段反应式续接场景考察执行。
论文所有核心数字(90.8 PDMS、91.1 EPDMS、navhard 38.6)都在这套协议上报告,且DAC等乘性门控正是“11.4厘米修正导致PDMS从98.7归零”这一安全案例的机制来源,不理解指标无法解读结果与局限。
研究动机
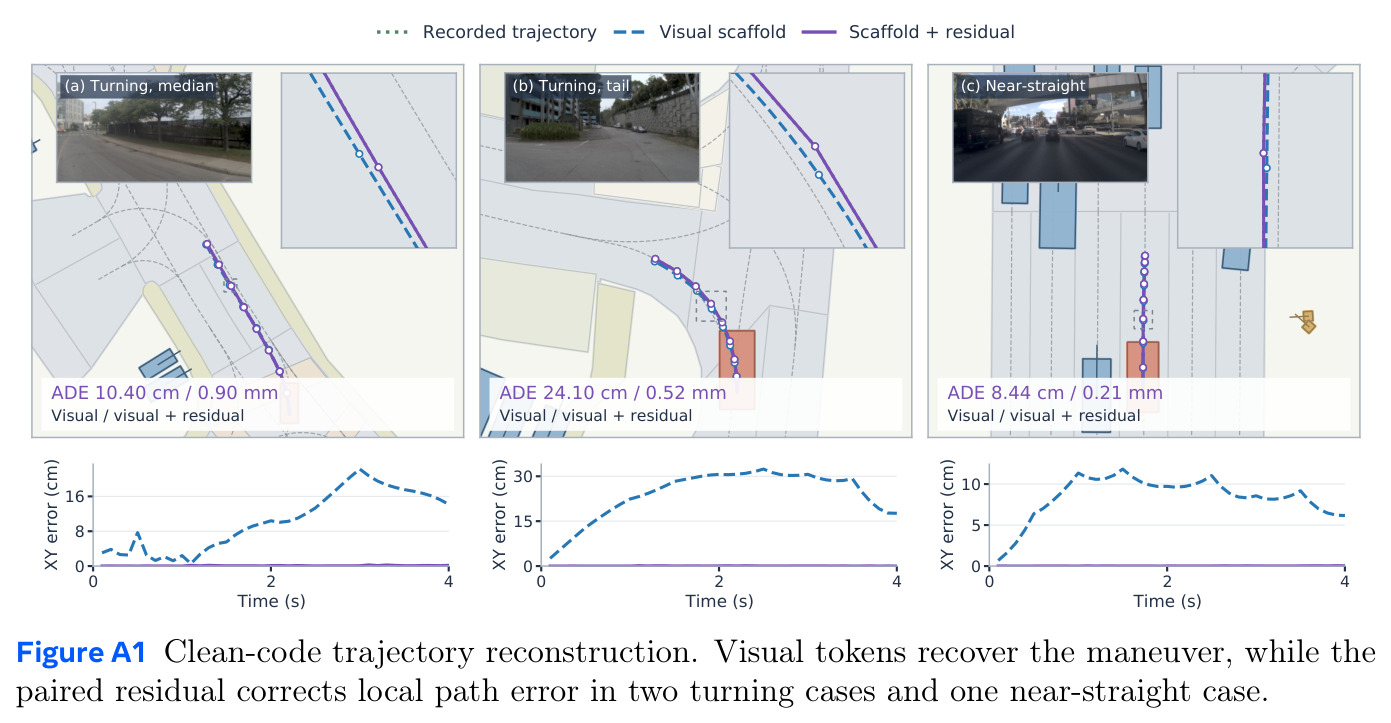
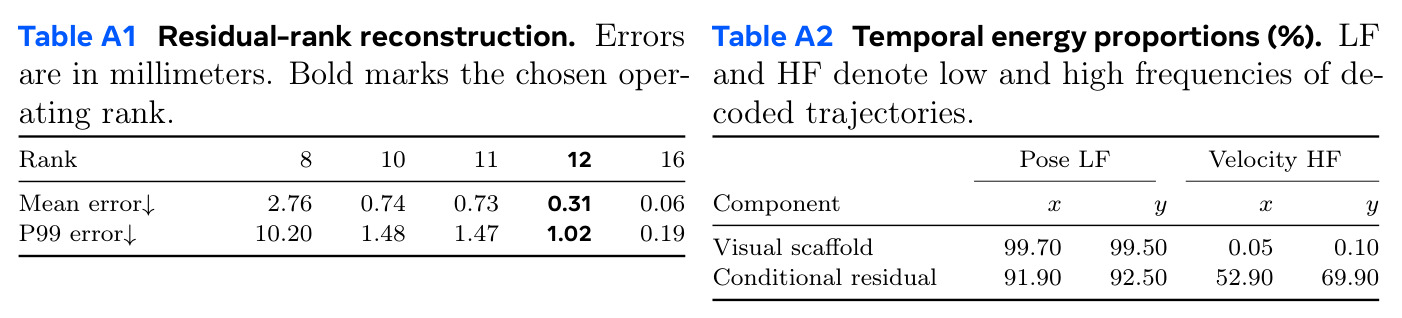
现有世界-动作模型(DriveLaW、SUV、SimWAM等)用注意力把视频专家和动作专家连接起来,但两者没有共享的预测目标:视频专家预测场景演化,动作专家却回归一个只由轨迹坐标定义的编码,同一段物理运动被两套独立构造的表示描述,形成“视觉-动作表示鸿沟”。作者用一个刻意简化的实验量化这一鸿沟的代价:把问题退化为“给定录制好的当前帧和未来帧、重建自车轨迹”(完全不需要预测未来),在NAVSIM全部18,179个验证场景上,纯视觉重建的平均位移误差(ADE)仍高达123.6 mm、末端误差(FDE)221.6 mm,重建轨迹的高频速度能量占比(HF)仅0.1%——得到的是一条平滑的“运动骨架”,丢失了厘米级度量细节;而在道路边界附近,几厘米的偏差就足以让看似合理的轨迹违反可行驶区域约束(论文后文给出一个11.4 cm修正使PDMS从98.7归零的实例)。
本文的目标是本文的目标是设计一个动作表示,让“视觉运动”成为动作预测的主目标、同时不牺牲执行精度,并且部署时不需要生成未来图像。具体拆成三个子目标:其一在表示层,把视觉可恢复的平滑骨架与视觉恢复不了的度量残差分开编码,通过PCA白化让厘米级小修正获得独立、标准化的学习尺度;其二在预测层,用流匹配从当前图像、自车状态和导航指令联合预测两组码,单步采样即可输出可执行的四秒轨迹;其三在改进层,在冻结基策略与编解码器的前提下,复用残差坐标做有界强化后训练,部署时只附加一次确定性修正,无需奖励评估、候选搜索或额外去噪。
与已有工作不同的是,本文的独特切入角度有三点。第一是诊断先行:作者不是直接提方法,而是先用“录制未来重建”这个比世界-动作建模更简单的任务,把“表示容量”与“预测难度”分离,证明即使未来已知,视觉重建也只剩平滑骨架(HF仅0.1%),说明精度缺口本质上是表示问题而非预测问题。第二是表示构造的差异:与RepWAM、LingBot-VA 2.0、RLA-WM等在视觉特征空间重构视觉过渡的latent action不同,VITAL的残差目标是“视觉解码轨迹骨架与示范轨迹之间的物理坐标度量差”,轨迹监督把骨架锚定在真实世界尺度上。第三是一份表示服务三个阶段:残差不只是重建补丁,它同时充当流匹配的联合预测目标之一和后续有界RL的修正坐标系,把目标构造、模仿学习、策略改进统一在同一套可执行表示之下。
核心方法
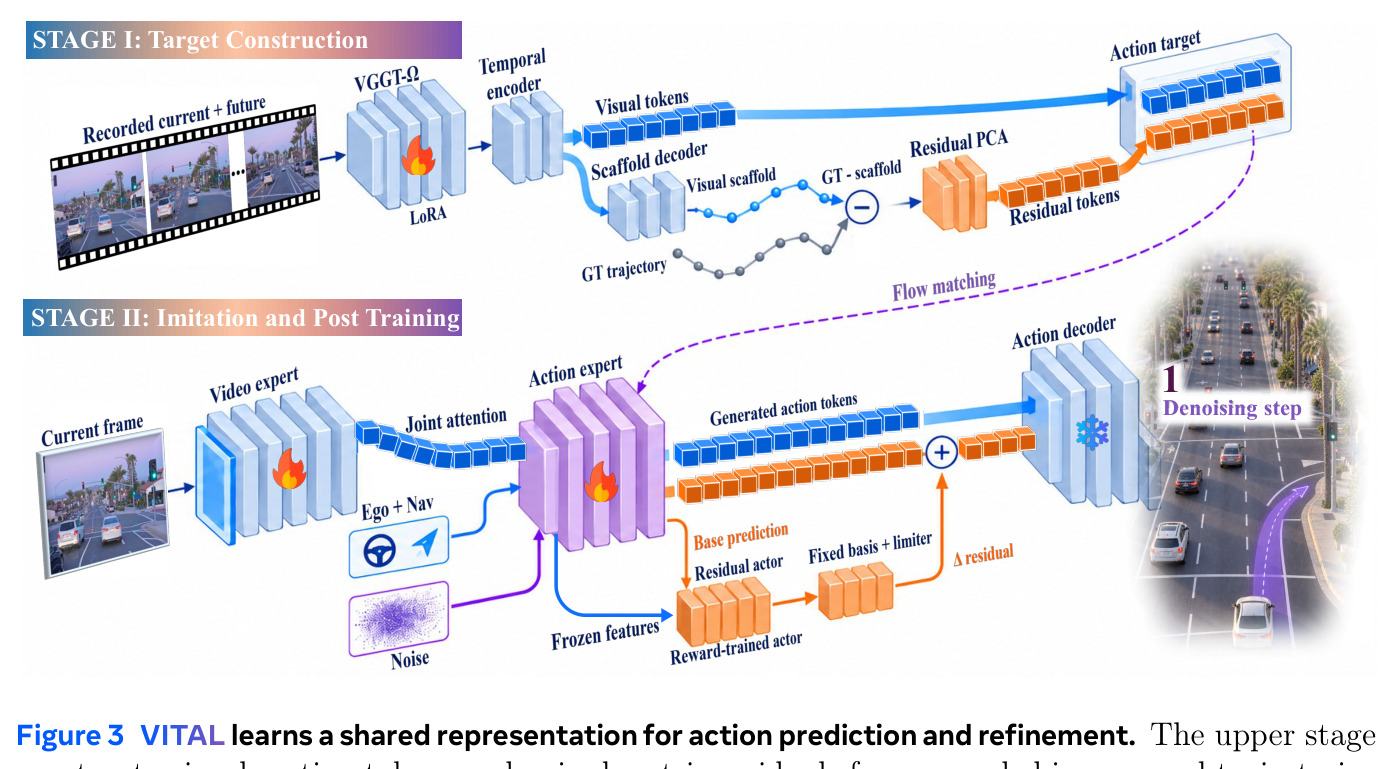
直觉上,让“从画面里能看出来的运动”承担轨迹主干,把“视觉说不清的那几厘米”单独装进一个小口袋,并给这个小口袋独立的标准化尺度——主干有视觉依据所以好预测,修正小而精所以有独立量纲。技术路线分三阶段:Stage I 构造目标——冻结的视觉分词器 $E_v$(VGGT-Ω骨干加LoRA,读取0/1/2/3/4秒五帧)产出4个64维运动token,解码成40点@10Hz的轨迹骨架 $\tau^{v^\star}$;对骨架误差 $e^\star = \mathrm{vec}(\tau - \tau^{v^\star})$ 做PCA得统计量 $\mu, U, S$,配对残差码为 $z_r^\star = S^{-1}U^\top(e^\star - \mu)$,每秒区间12个系数,构成4×76的动作接口。Stage II 模仿学习——动作专家用流匹配从部署可见的上下文 $h(c)$ 联合预测两组码,损失包含流匹配项、视频流项和解码轨迹项(残差支路加stop-gradient),未来视频token被因果掩码隔离。Stage III 残差RL——冻结动作生成器与整个codec,训练一个123万参数的小actor,在6维有界修正空间里用NAVSIM打分器做对偶高斯策略梯度,部署时只施加一次均值修正。
核心创新是把动作表示按信息来源拆分:视觉骨架码由录制未来图像导出、承担主预测目标,使动作学习与视觉动态对齐;度量残差码编码骨架重建误差、经PCA系数标准化后给厘米级修正独立的学习尺度。与已有工作的本质区别有三。其一,RepWAM、LingBot-VA 2.0、RLA-WM的latent/residual都在视觉特征空间里重构视觉变化,而VITAL的残差目标是物理坐标下的轨迹度量差,配对后可达亚毫米级复原(ADE 3.11×10⁻⁴ m)。其二,主流少步生成方法(MeanFlow、Consistency Policy、Shortcut Models)靠改变流场或蒸馏实现少步采样,VITAL保留标准流匹配目标、只更换喂给它的动作目标,配对表示天然适配一步预测。其三,残差RL被严格限制在tokenizer自带的残差坐标的6维子空间且限幅1 m/0.2 rad,修正与模仿学习共享同一物理解码映射 $D(z_v, z_r) = D_v(z_v) + \mathrm{unvec}(\mu + M z_r)$,零修正精确还原基策略,这是“结构保持”的含义。
方法步骤详情
第一步,拟合视觉分词器:VGGT-Ω骨干经LoRA适配五帧前视图,时间编码器融合相机特征、register摘要与相对相机运动特征,输出4个64维token;宽256解码器预测车体系速度与偏航率,积分到40点@10Hz轨迹网格,训练后整体冻结。第二步,拟合配对残差:对训练集骨架误差 $e^\star = \mathrm{vec}(\tau - \tau^{v^\star})$ 按秒区间做PCA,扫描秩{2,…,30}后选12维(均值误差0.31 mm),统计量 $\mu, U, S$ 冻结,构成4×76动作接口。第三步,模仿学习:从SimWAM的IL权重出发(继承13万更新预训练),最终阶段2.6万更新、AdamW峰值学习率 $2\times10^{-5}$、batch 64、8×H200;动作专家只经首帧key/value适配器读当前帧特征,因果掩码隔离未来视频token;流匹配权重视觉:残差=1:2,外加解码轨迹损失(残差支路stop-gradient)。第四步,一步推理:单次欧拉更新 $\hat z^{(1)} = \epsilon + v_\theta(\epsilon, 0, h(c))$,FP32解码出4秒轨迹。第五步,残差RL:6个解析扰动模板(纵向/横向 $\rho^p$,$p \in \{2,3,4\}$)投影进残差解码空间并白化得 $B \in \mathbb{R}^{48\times6}$,径向限制器强制1 m/0.2 rad限幅;actor(4528→256→256→6,1.23M参数)读冻结策略隐状态与上下文,对17,013个难场景做对偶高斯策略梯度(每场景8对、$\sigma=1$),6,598个高分anchor做零修正正则,1600次更新共约41万次奖励查询,部署时 $\xi=0$ 只加一次均值修正。
技术新颖性
技术新颖性体现在四个层面。表示层:首次在驾驶动作表示中把“视觉可恢复的运动”与“视觉不可恢复的度量细节”显式分离为双码,并用PCA系数标准化 $S$ 让小修正获得与大运动相当的梯度量级。理论层:给出三元误差分解 $\|\tau - \hat\tau\|_Q \le \varepsilon_{\mathrm{codec}} + L_v\|\hat z_v - z_v^\star\|_F + \|M\|_{2\to Q}\|\hat z_r - z_r^\star\|_2$,把表示容量、视觉预测误差、残差预测误差分开分析,并推导单步欧拉积分误差上界 $\|e_D(z_1) - e_D(z_E)\|_Q \le L_D \sup_t \|a(t)\|_2 / 2$,为“一步够用”提供理论支撑。训练层:证明不改流匹配目标、只换动作目标即可获得一步生成能力,避免了蒸馏(Consistency Policy)或候选集成(DRIFT聚合48个提案)。后训练层:残差RL把干预限制在tokenizer残差坐标的6维有界子空间,基策略、视觉前缀、解码器全部冻结,训练用NAVSIM打分器而部署零奖励开销,与AD-R1需要学习世界模型内部critic的做法形成鲜明对比。
实验结果
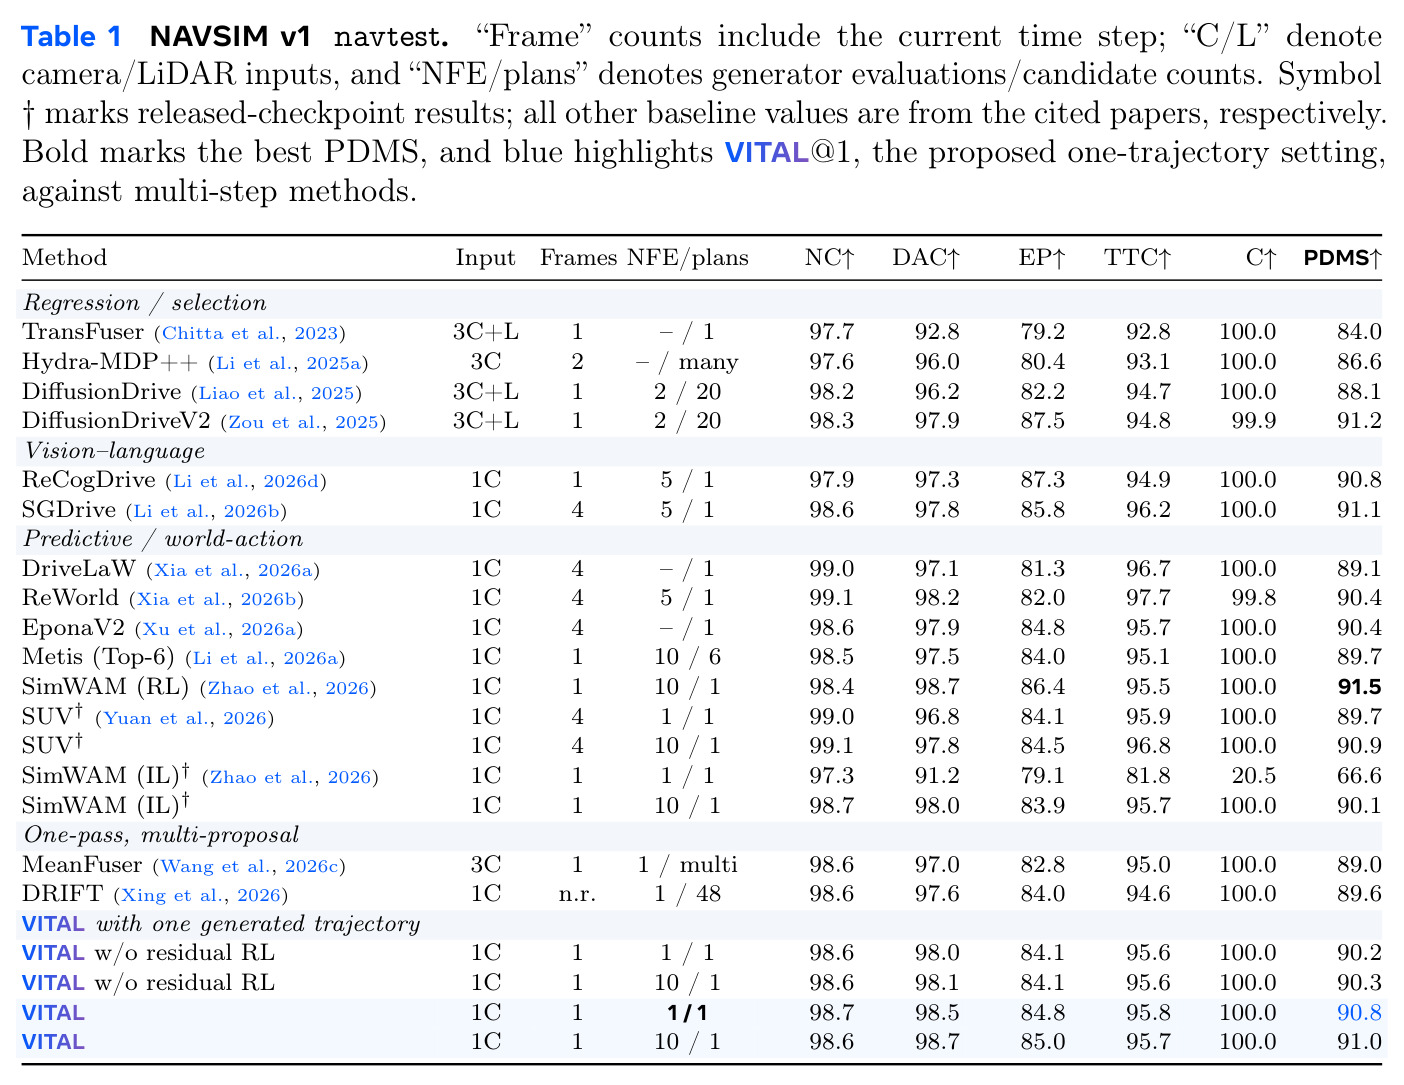
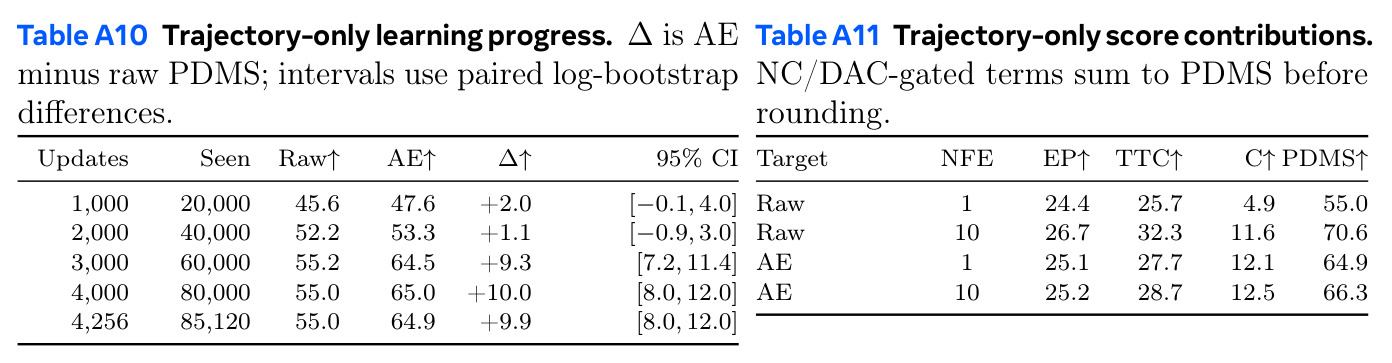
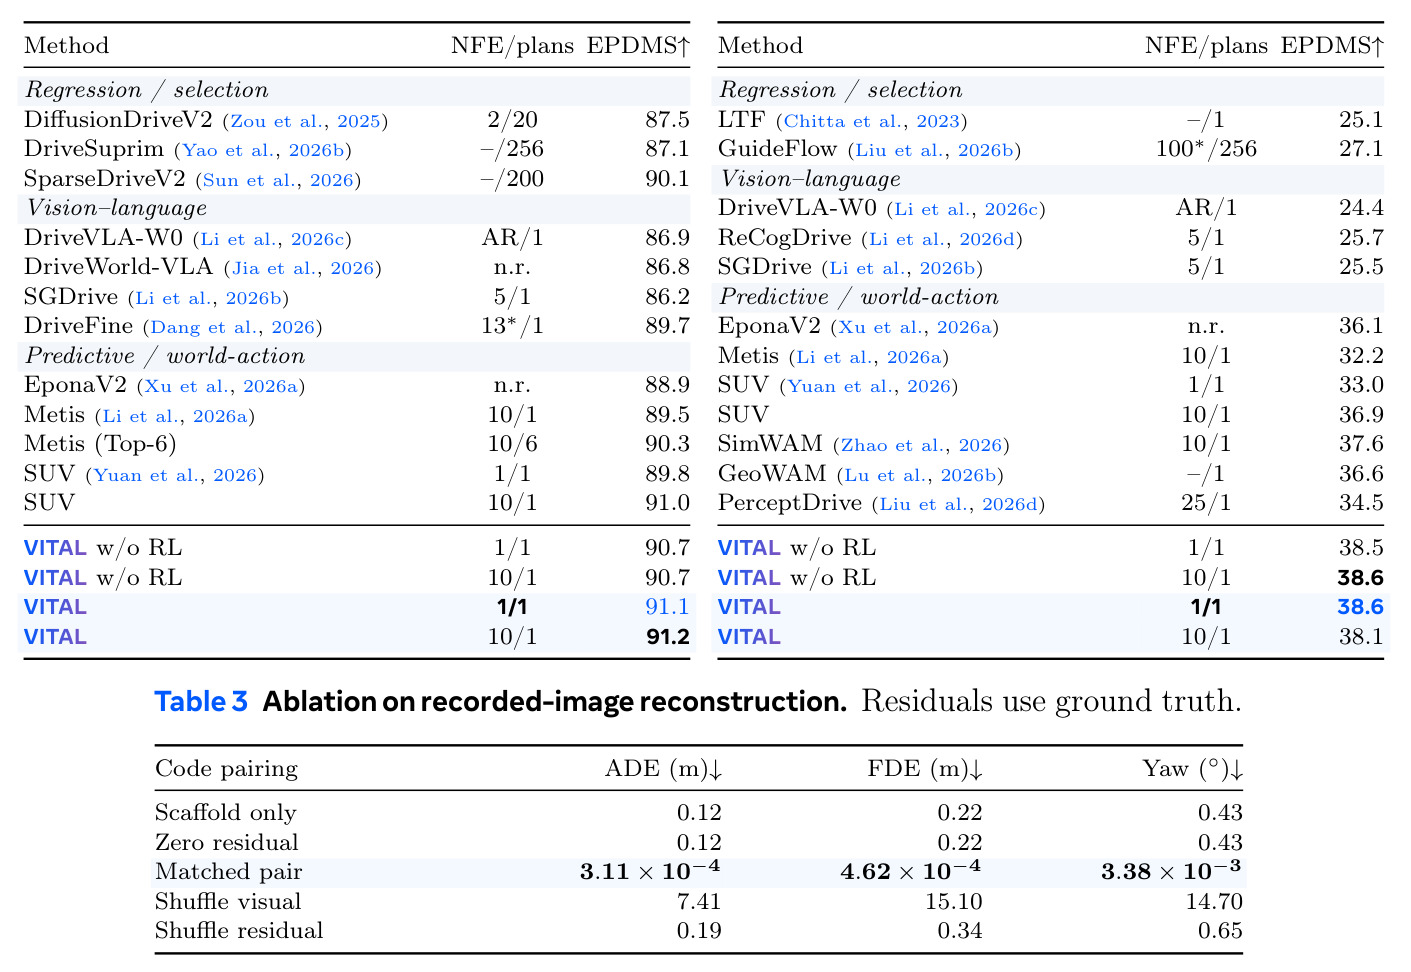
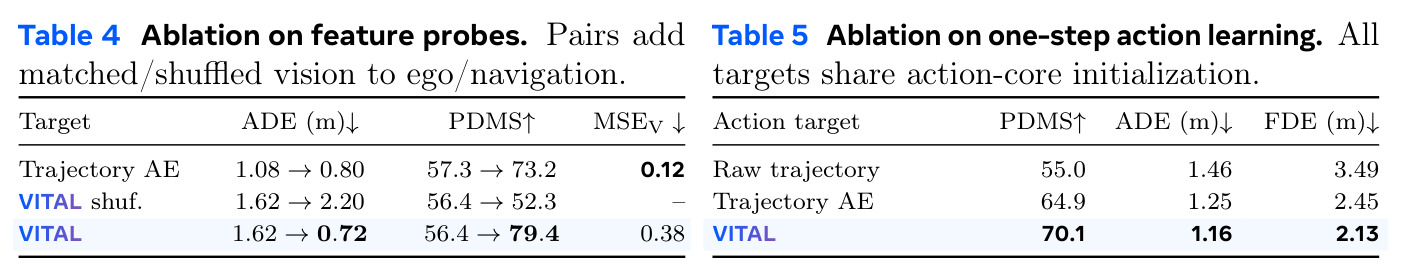
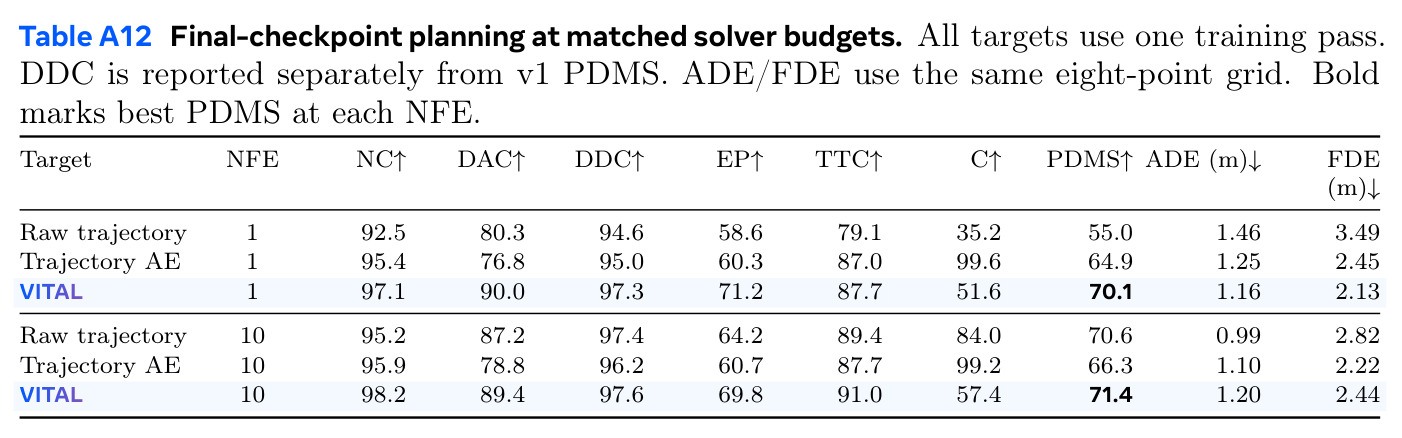
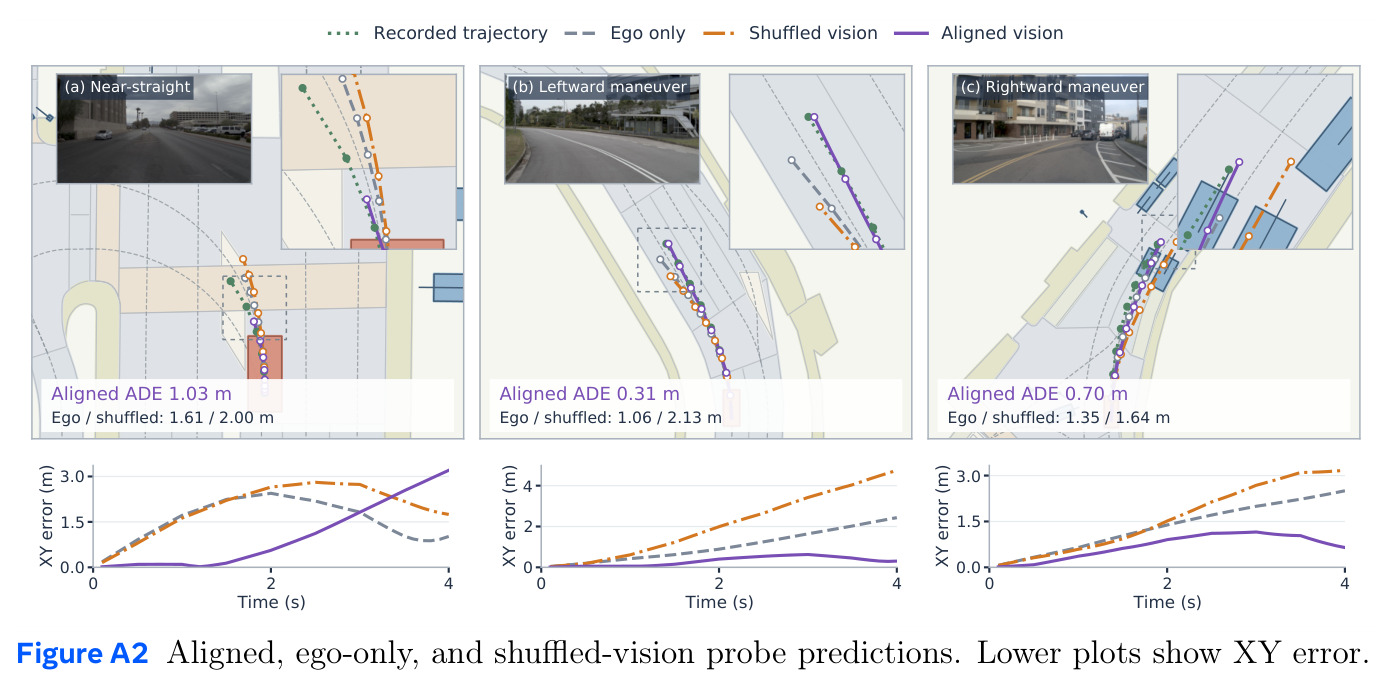
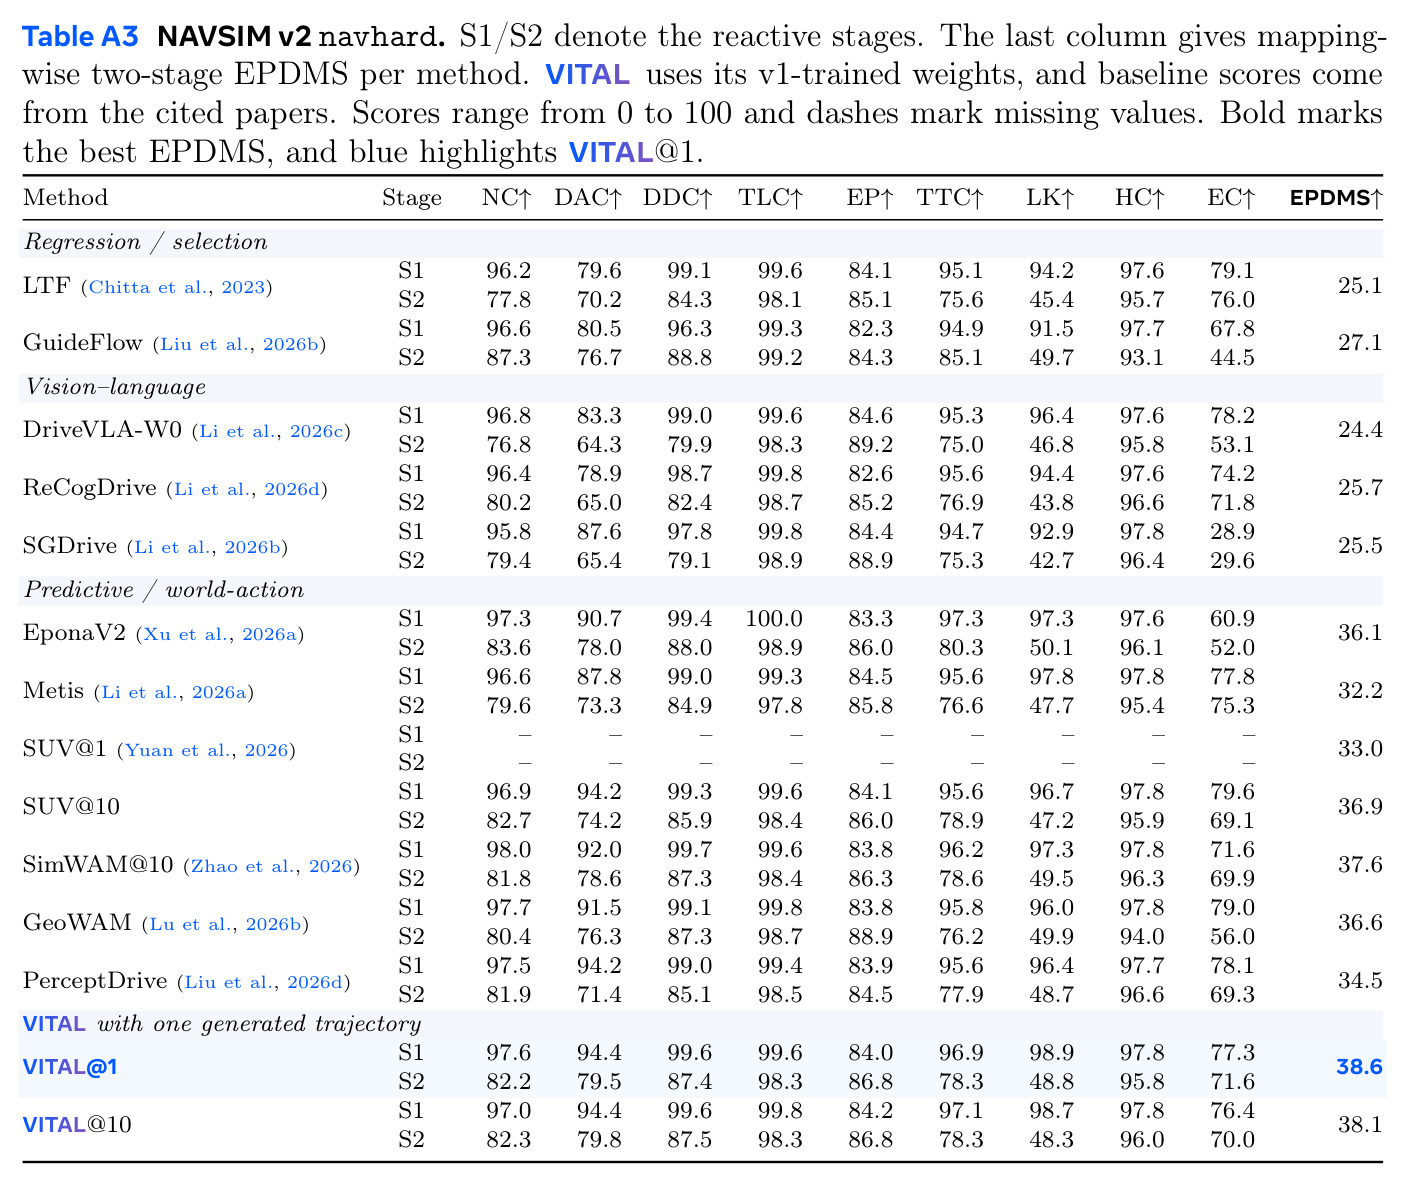
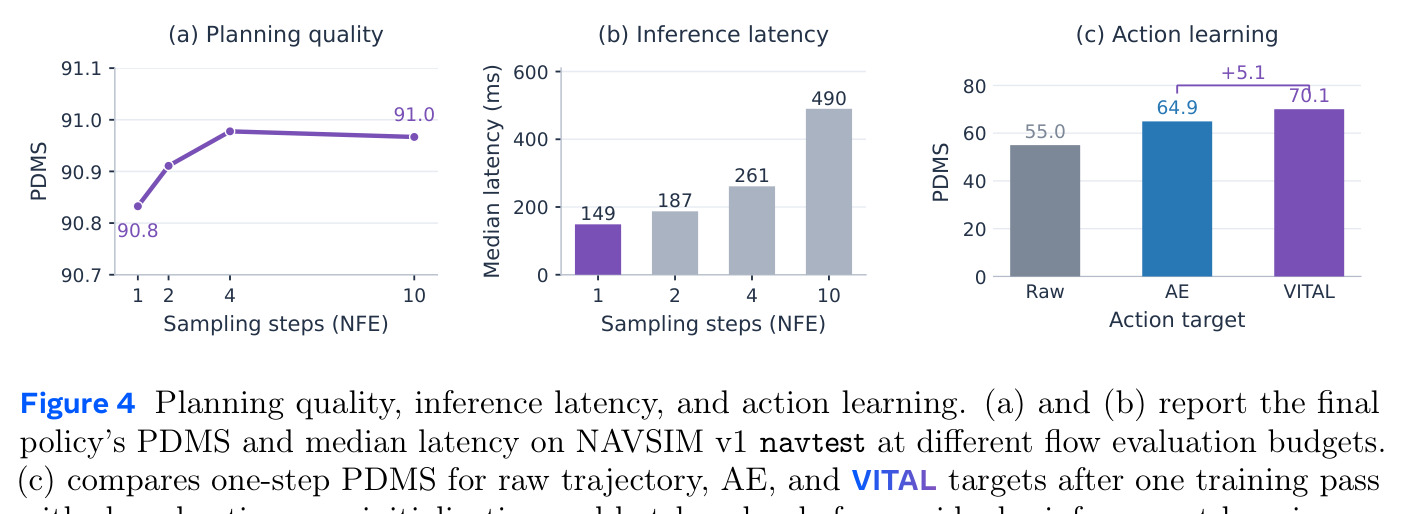
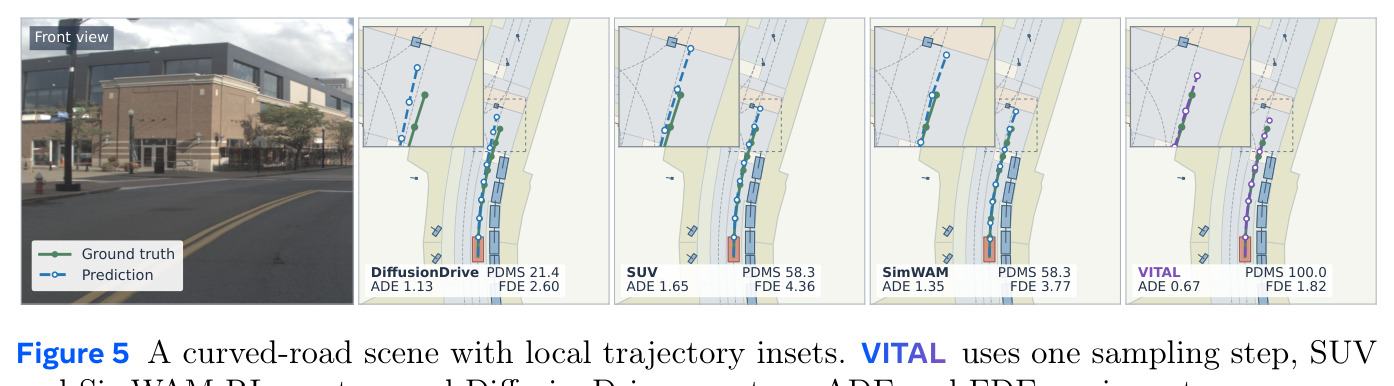
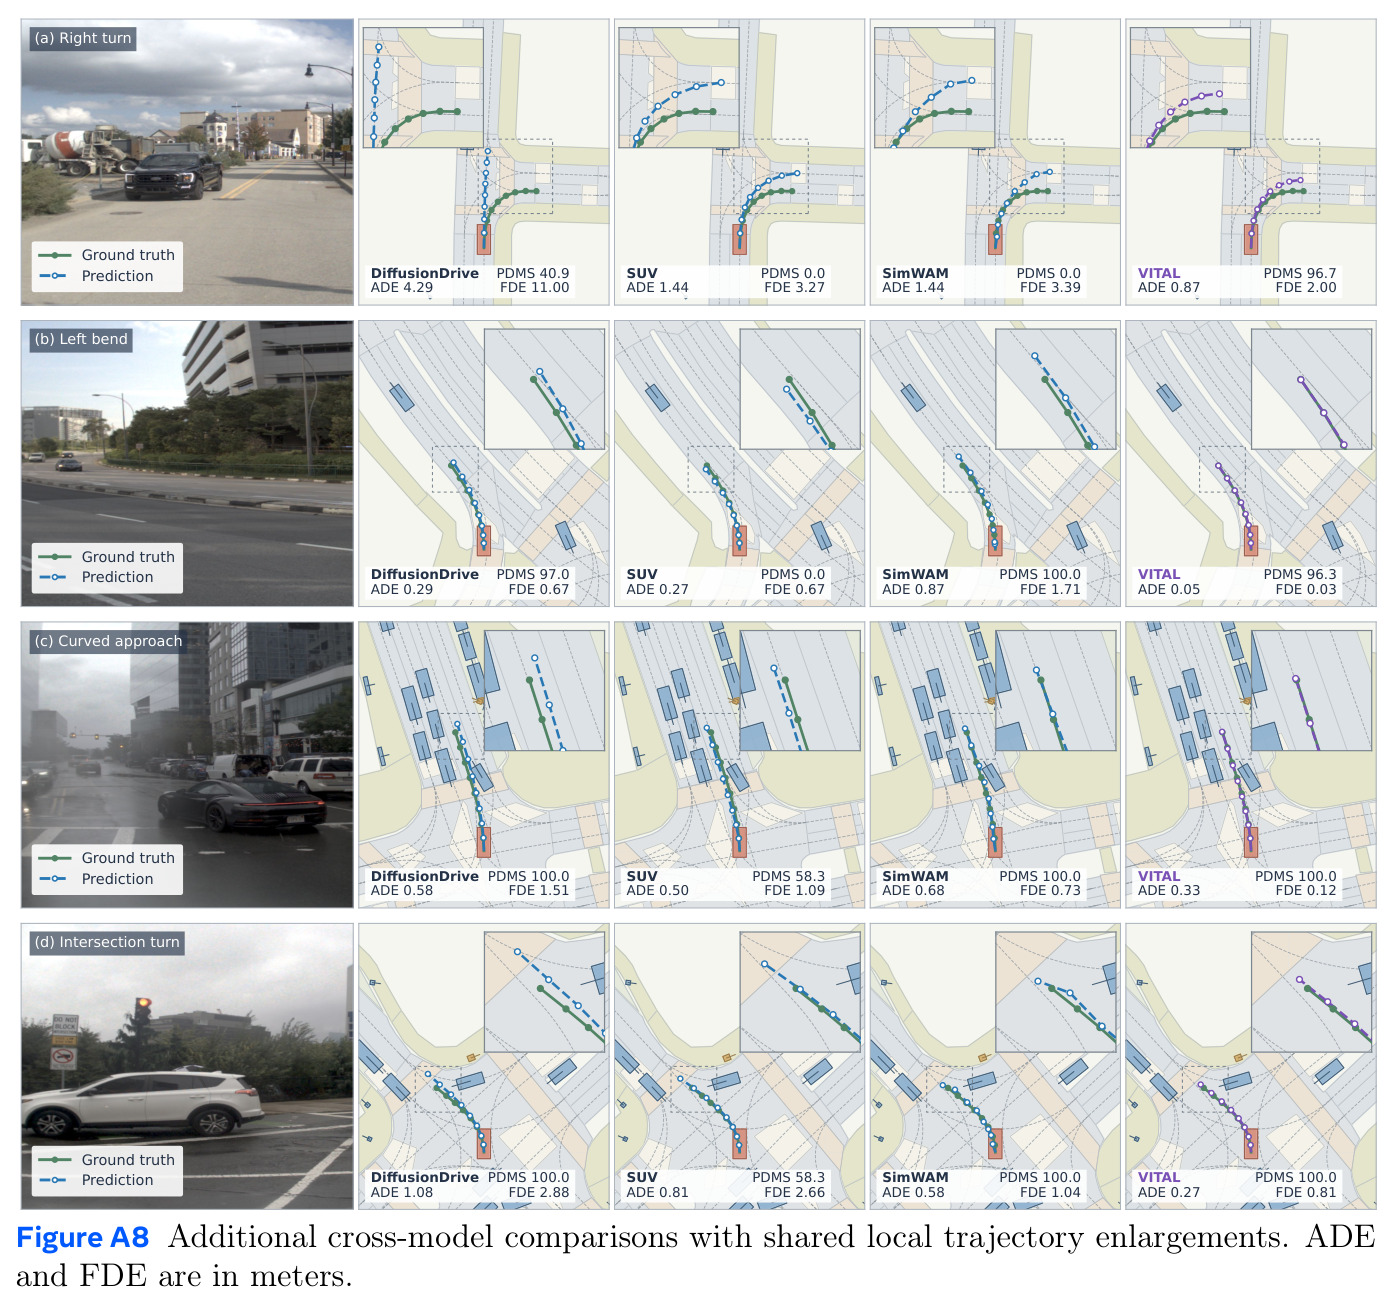
核心结果分五块。(1) 主基准:NAVSIM v1 navtest上VITAL单步(NFE=1)达90.8 PDMS,十步91.0,延迟149 ms对490 ms(3.29×加速,含图像编码);RL前90.2/90.3,RL后+0.6/+0.7;对比SimWAM(IL)†单步仅66.6、SUV†单步89.7、ReCogDrive 90.8(5 NFE)、SGDrive 91.1、SimWAM(RL) 91.5(10 NFE)。(2) 迁移:v2 navtest修正EPDMS 91.1@1步(91.2@10),超十步SUV的91.0与Metis Top-6的90.3;navhard反应式两阶段38.6@1步(38.1@10),高于SimWAM 37.6、SUV 36.9、GeoWAM 36.6、PerceptDrive 34.5。(3) 重建容量:录制图像+真值残差把ADE从0.12 m降至3.11×10⁻⁴ m、PDMS 92.1→94.7;打乱视觉码ADE暴涨至7.41 m,只打乱残差仅0.19 m,证明骨架定路径、残差补细节。(4) 可预测性探针:仅自车/导航输入时AE的ADE(1.08 m)优于VITAL(1.62 m),加入匹配视觉后反转为VITAL 0.72 m/79.4 PDMS对AE 0.80 m/73.2;打乱图像后VITAL跌至2.20 m/52.3,说明优势来自真实视觉对应。(5) 公平动作学习:同初始化、同数据一轮训练后VITAL 70.1对AE 64.9对原始轨迹55.0 PDMS(十步71.4对66.3),单步+5.1,增益主要来自进度与TTC。定性上(Figure 5)弯道场景VITAL单步100 PDMS、ADE 0.67/FDE 1.82 m,优于SimWAM-RL十步的58.3、1.35/3.77 m。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| NAVSIM v1 navtest 闭环规划 | PDMS | 90.8(NFE=1,单条轨迹);91.0(NFE=10) | DiffusionDrive 88.1(2 NFE/20提案);SimWAM(IL)† 66.6@1步;ReCogDrive 90.8(5 NFE);SimWAM(RL) 91.5(10 NFE) | 单步即超越多数多步方法,较SimWAM(IL)†单步提升24.2分;距最强SimWAM(RL)@10步差0.7分但只需1/10计算 |
| NAVSIM v2 navtest(修正EPDMS,v1权重直接迁移) | EPDMS | 91.1(1步);91.2(10步) | SUV 91.0(10步);Metis Top-6 90.3(10步/6提案);EponaV2 88.9 | 较十步SUV +0.1,较Metis Top-6 +0.8,且采样步数为其1/10 |
| NAVSIM v2 navhard 反应式两阶段续接 | EPDMS(两阶段映射) | 38.6(1步);38.1(10步) | SimWAM 37.6(10步);SUV 36.9(10步);GeoWAM 36.6;PerceptDrive 34.5(25 NFE) | 较最强基线SimWAM@10步 +1.0,且无需重训练 |
| 录制未来图像轨迹重建(18,179验证场景) | ADE | 3.11×10⁻⁴ m(骨架+真值残差);纯骨架0.12 m | 纯视觉骨架重建 0.12 m(123.6 mm) | 约390倍精度提升,PDMS同步从92.1升至94.7 |
| 单步动作学习公平对比(同初始化、同数据一轮) | PDMS | 70.1(VITAL目标,ADE 1.16 m / FDE 2.13 m) | Trajectory AE 64.9;原始轨迹回归 55.0 | 较AE +5.2、较原始目标 +15.1;十步时仍领先(71.4 vs 66.3) |
| 端到端推理延迟(RTX 4090,batch 1,含图像编码与残差修正) | 中位延迟 | 149 ms(NFE=1) | 490 ms(NFE=10,同一策略) | 3.29×加速,PDMS仅损失0.2分(90.8 vs 91.0) |
局限与改进
作者承认的局限:其一,有界残差修正只做局部精修,无法挽救错误的高层机动选择——navhard上残差RL改善Stage 1却轻微降低Stage 2 EPDMS,说明场景因自车行为演化、需要重选机动时该机制失效;其二,干净码重建精度不等于条件预测质量,二者必须分开评估(重建0.3 mm不代表部署误差也是0.3 mm);其三,实验全部在NAVSIM仿真内完成,对未见城市、恶劣天气、传感器失效的泛化未被验证;其四,有界修正仍可能越过道路边界——附录C.3给出实例:一次11.40 cm的修正使DAC从1变0,乘性门控把PDMS从98.7打到0.0,且全量配对评估中64个场景在NC/DAC/TTC/DDC至少一项发生回退。我自己的观察:第一,表示质量强依赖视觉分词器与VGGT预训练,单前视相机设定下侧后方来车、遮挡场景的骨架可信度存疑;第二,绝对PDMS并非SOTA(SimWAM(RL)@10步91.5),卖点是单步效率,且跨模型对比中各方法的预训练、输入设定并未完全对齐(作者也坦承这点并用公平对比实验补位);第三,残差RL用非反应式scorer做奖励,与navhard的反应式评估存在分布差异;第四,6维多项式模板修正族表达能力有限,对需要急促、非光滑修正的场景可能不够。
独立分析的弱点
第一个弱点是平均奖励掩盖个体风险:残差RL在平均PDMS上+0.6,但有64个场景在安全分量上回退,最严重者一次11.4 cm修正令PDMS从98.7归零。改进方向是把可行驶区域/碰撞约束做成限制器内的硬投影(对 $B q_\phi$ 施加安全集投影),或在奖励中对DAC类回归施加乘性惩罚而非线性罚项。第二个弱点是修正层级受限:actor只能动6个光滑系数、视觉token冻结,遇到需要换道的续接场景无能为力(Stage 2回退即此因)。改进方向是引入有界的scaffold修正(允许小幅调整视觉token),或设计机动级+度量级双层级actor,并配合反应式world-model critic做在线适配。第三个弱点是骨架的度量性来源单一:图像单目平移被明确当作非度量,尺度完全靠轨迹监督回补,一旦监督分布外的场景(异形路口、陡坡)出现,骨架本身可能失准。改进方向是融合LiDAR深度或多相机几何提供度量锚点,或引入车速先验做尺度校准。第四个弱点是工程门槛高:表示建立在约11亿参数的VGGT-Ω骨干和SimWAM的13万更新预训练之上,小团队难以从头复现。改进方向是研究残差表示对更小骨干的可迁移性,或只微调codec适配已有规划器的输出分布。
未来方向
作者提出的方向:把方法扩展到更广的视觉上下文(多相机、更长时间窗)和更具交互性的规划设定;训练时显式建模周围交通对自车行为的反应(reactive训练)以解决Stage 2回退;对视觉骨架提供更广泛的控制能力并引入显式安全约束,因为有界修正仍可能越界;在恶劣天气、传感器损坏下系统评估视觉骨架的鲁棒性。基于成果可自然延伸的方向:其一,把“骨架+残差”接口推广到机器人操作等具身任务——残差坐标天然适合接触丰富任务中毫米级精修;其二,残差RL的对偶高斯梯度估计器可替换为更样本高效的估计或离线RL,减少40.96万次奖励查询的开销;其三,探索自适应秩/自适应区间划分的残差基,或学习式(非解析模板)修正族以提升修正表达能力;其四,与一致性模型或蒸馏叠加,把“一步流+一次修正”进一步压缩延迟;其五,用世界模型生成的未来替代录制未来做目标构造,在无轨迹标注数据上自监督地学习动作目标,打通VITAL与无动作标注视频数据的结合。
复现评估
开源情况:论文给出了项目页(worldbench.github.io/vital)和GitHub仓库(worldbench/VITAL),附录A极为详尽——所有损失权重(位置1、增量0.25、关键帧0.75、航向0.1等)、残差秩扫描{2,…,30}、奖励乘子自适应规则 $\lambda \leftarrow \mathrm{clip}_{[0,2]}[\lambda + 0.02(\bar c - 0.001)]$、actor结构4528→256→256→6、限制器公式全部公开,文档质量很高。数据全部为公开集:nuPlan、nuScenes、OpenScene(注意nuScenes/OpenScene为CC BY-NC-SA许可,含非商业条款);评测用NAVSIM v1/v2(Apache 2.0);依赖VGGT-Ω(FAIR非商业研究许可,商用受限)、Depth Anything 3、LingBot-VA 2.0及SimWAM公开权重。算力需求:主模型训练为单机8×H200,最终阶段2.6万更新(不含继承的13万更新预训练);残差RL是123万参数小actor、1600次更新、40.96万次奖励查询(scorer可并行但耗时);推理在RTX 4090 batch 1下149 ms。综合评估复现难度为中高:完整复现需要多卡训练预算、SimWAM预训练权重与NAVSIM环境;但只复现诊断实验(重建分析、线性探针、公平动作学习对比)的门槛低得多,这些只需tokenizer拟合与轻量探针训练。
论文图表
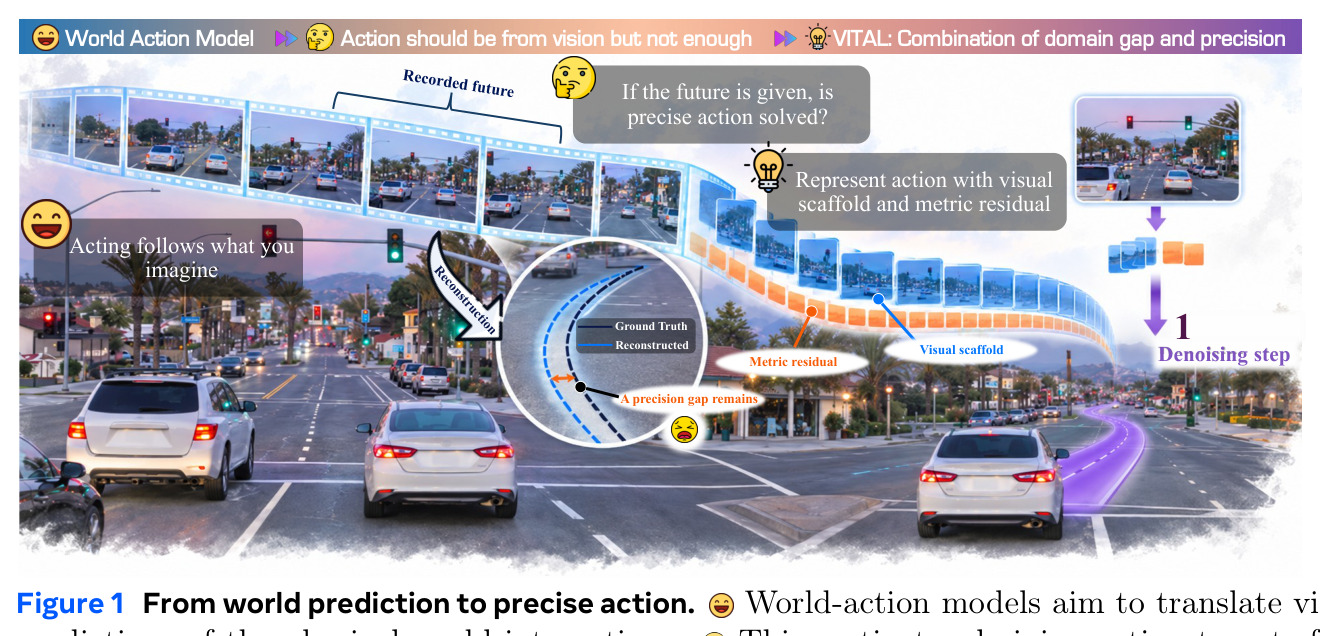
对比式概览图:上半部分展示世界-动作模型的常规范式——动作虽源自视觉,但训练目标独立于视觉动态,注意力的信息交换不等于共享预测目标;下半部分展示即使给定录制的未来图像,重建仍留下局部度量误差(“精度缺口”),VITAL用视觉骨架加配对度量残差的表示同时解决域差与精度两个问题。
一张图讲清论文的问题定位(视觉-动作表示鸿沟)与核心主张(骨架+残差配对),是理解全文动机的入口。
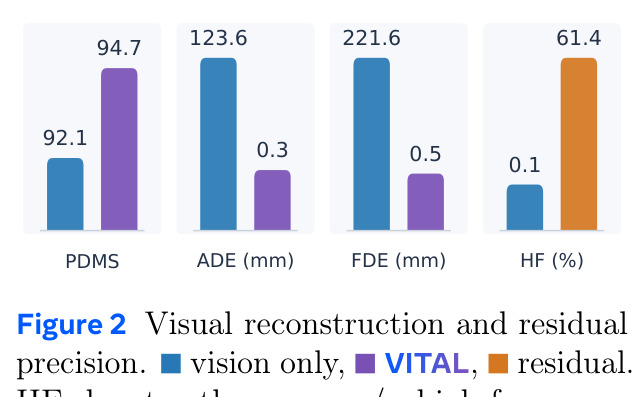
四组柱状数字对比:纯视觉重建的ADE为123.6 mm、FDE 221.6 mm、PDMS 92.1、高频速度能量占比(HF)仅0.1%;加入真值残差后ADE/FDE降至0.3/0.5 mm、PDMS升至94.7,而残差分量的HF高达61.4%——视觉重建只余平滑骨架,缺失的正是高频度量细节。
这是论文的核心诊断实验:证明精度缺口是表示问题而非预测问题,直接引出“给残差独立表示与学习尺度”的设计,所有后续方法都建立在这组数字之上。
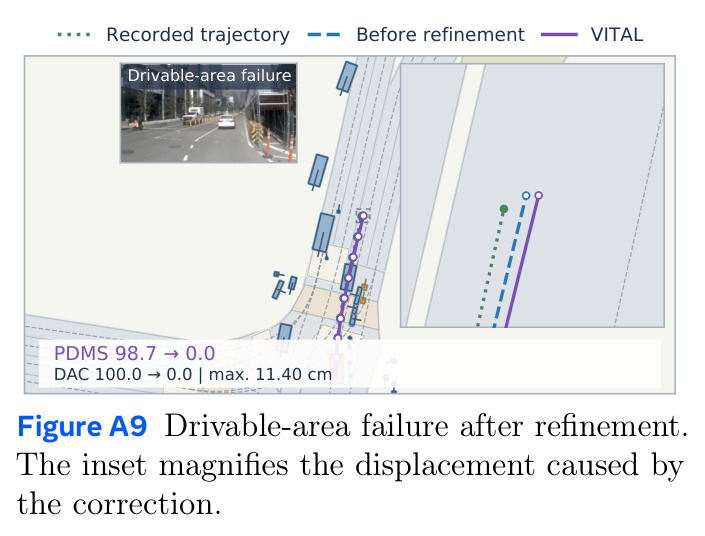
残差精修的失败案例:一次最大11.40 cm的修正使轨迹越过可行驶区域边界,DAC从1变0,乘性门控把PDMS从98.7直接归零,插图放大了修正造成的位置偏移;全量配对评估中共64个场景在NC/DAC/TTC/DDC至少一项回退。
具体展示了有界修正的安全风险——局部精修可能触发乘性门控的灾难性失分,是理解论文局限性(作者在D.2中明确承认)的关键证据。