ActionPiece:面向自回归视觉-语言-动作模型的动作分词再思考 ActionPiece: Rethinking Action Tokenization for Autoregressive Vision-Language-Action Models
提出物理秩一致性指标PRC与联合监督的ActionPiece动作分词器,提升VLA策略成功率
前置知识
VLA 模型与动作分词器
自回归视觉-语言-动作(VLA)模型以图像和指令为输入,把机器人控制转化为下一 token 预测。动作分词器是连接连续演示与离散 token 的桥梁:训练时把连续动作块压缩成离散 token 作为策略的学习目标,执行时再把预测出的 token 解码回可执行的机器人指令。常见方案有 RT-2/OpenVLA 的坐标分箱、FAST 的频域压缩加 BPE,以及学习式向量量化。
本文全部讨论都围绕动作分词器应该保留什么信息展开,不理解这一组件在 VLA 中「训练目标+执行接口」的双重角色,就无法理解 PRC 指标和两个训练目标的动机。
残差向量量化(RVQ)
把一个向量逐级量化的离散化技术:第一级码本近似原向量,第二级码本近似第一级的残差,依此类推,最终表示为 Q 级码本索引的拼接。每个码本 K 个码字,深度 Q 时可表达的离散组合达 $K^Q$,却只需 $O(QK)$ 个码字参数,比单一超大码本高效得多。FASTerVQ、OAT 等动作分词器均属此类。
ActionPiece 的编解码器建立在 RVQ 之上:QR 正则化直接作用于码字软分配分布,PRP 的表示距离也混合了量化前后的特征距离,不懂 RVQ 无法理解这两个目标的落点。
SO(3) 测地线旋转距离
三维旋转群 SO(3) 上两个旋转之间的最短等效转角:对相对旋转取矩阵主对数的旋转向量形式再求模,$d_{SO(3)}(R,R') = \|\mathrm{Log}(R^\top R')^\vee\|_2$。相比欧拉角或四元数的欧氏距离,它物理含义明确、无万向锁问题,是机器人学中度量旋转差异的标准做法。
论文定义的物理距离 $d_{phys}$ 由归一化平移、该旋转距离和夹爪状态三项加权组成,它决定了「近邻/远邻」动作的选取、两个训练目标和 PRC 指标的全部分析基础。
Spearman 秩相关
衡量两组数据排序是否一致的非参数统计量:不看具体数值大小,只比较两次排序中元素相对位置是否吻合,取值范围 [-1, 1]。它对单调非线性变换和数值缩放不敏感,天然适合度量「保序性」这类关系结构,而非逐点精度。
PRC 的定义正是对每个 anchor 的 k=32 个近邻,计算物理距离在重建前后的 Spearman 相关 $\rho_S$,理解秩相关才能读懂这一核心评价指标。
Jensen-Shannon 散度
两个概率分布相似度的对称度量:$JS(p,q) = \frac{1}{2}KL(p\|\mu) + \frac{1}{2}KL(q\|\mu)$,其中 $\mu = (p+q)/2$。相对 KL 散度,它对称、有界且总有限,适合比较离散码字上的软分配分布这类多峰分布之间的距离。
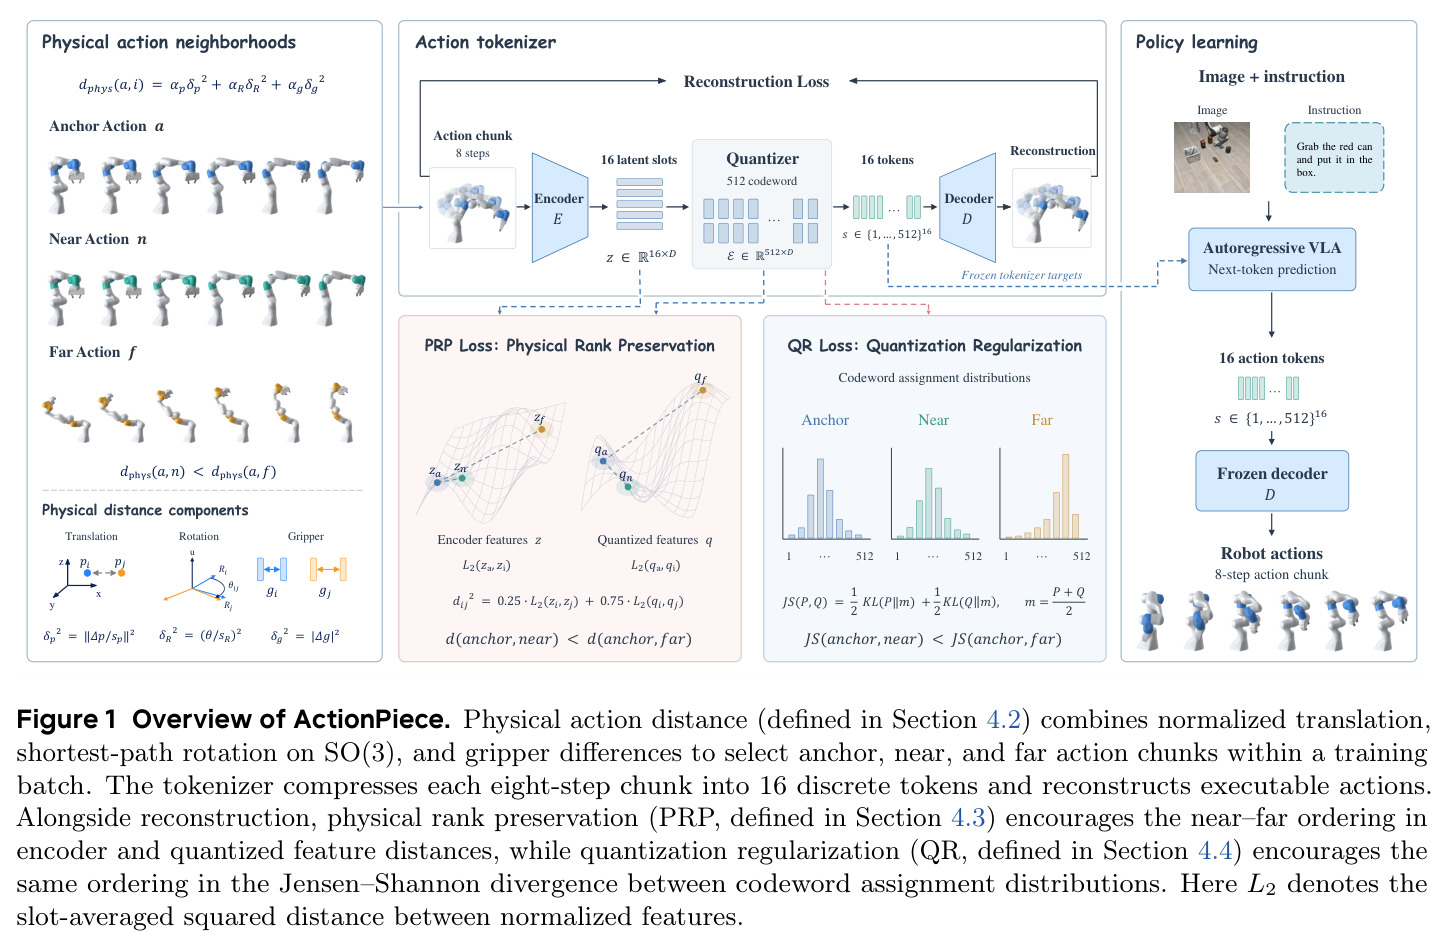
QR 正则用各 slot 平均的 JS 散度 $d_{JS}$ 作为「离散距离」,要求近邻动作的码字分配分布比远邻更接近,把物理序关系从连续特征延伸到量化阶段。
LIBERO 与 LIBERO-Plus 基准
LIBERO 是仿真操作基准,含 Spatial/Object/Goal/Long 四组共 2000 次评测,训练数据来自人类遥操作演示;LIBERO-Plus 在此基础上对相机、机器人本体、语言指令、光照、背景、噪声、布局七类因素做扰动,共 10030 次评测,专测分布外泛化,无需额外训练数据。
表 1 和表 4 的主结果都在这对基准上,「分布内 LIBERO vs 分布外 LIBERO-Plus」的对比是论文关于泛化性核心主张的直接证据。
研究动机
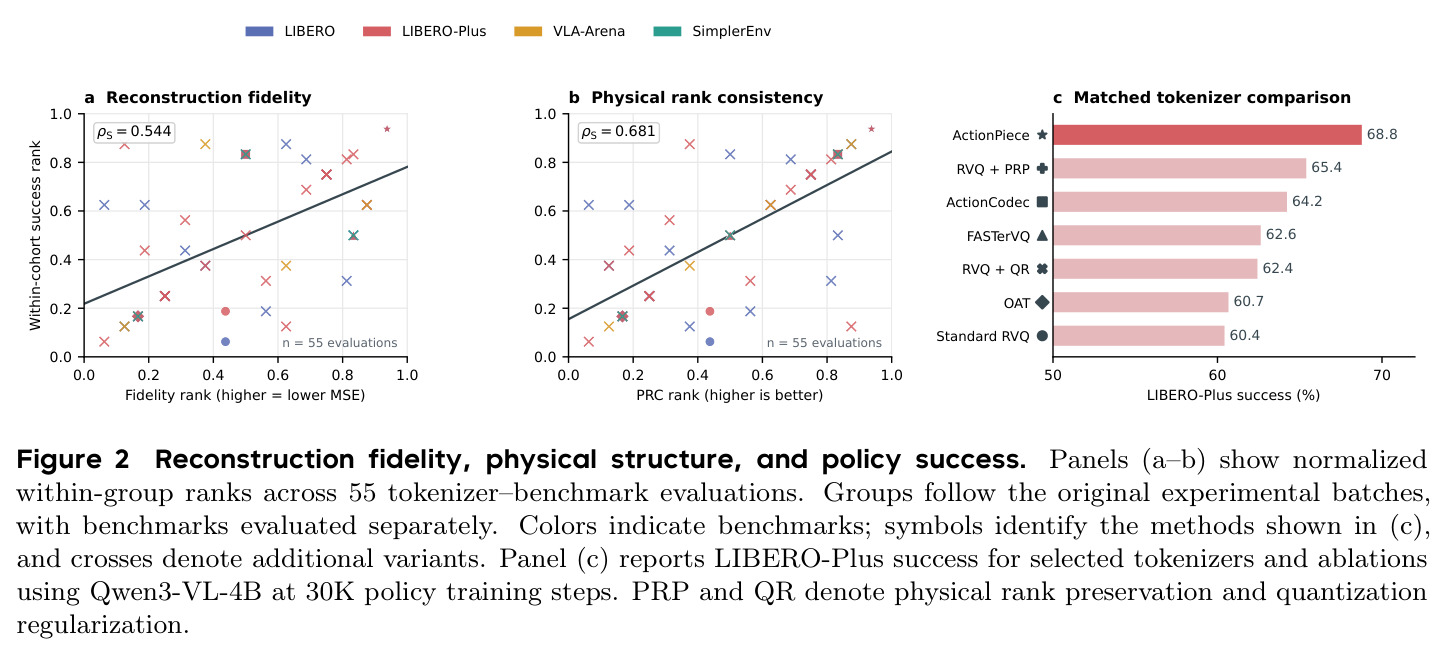
现有自回归 VLA 模型(RT-2、OpenVLA、FAST 等)依赖动作分词器把连续演示压缩为离散 token,而这些分词器普遍用逐点重建误差(MSE)作为保真度标准。MSE 只约束单个动作的重建精度,不协调不同演示之间误差的方向。论文指出一个具体失效场景:同一任务的多条演示中,相似动作会因物体位置、机器人状态、执行阶段不同而带有细微调整,在精细对准、抓取、接触类操作中这些小差异直接决定成败。对两个演示块 $x_i, x_j$,重建差满足 $\hat{x}_j - \hat{x}_i = (x_j - x_i) + (e_j - e_i)$,第二项压缩误差可能削弱、扭曲甚至反转原始差异方向;即使策略把 token 全部预测正确,解码器执行的仍是失真的重建动作。作者用 55 组「分词器×基准」评测实证了这一担忧:重建保真度与策略成功率的 Spearman 相关只有 0.544,说明单靠逐点精度不足以解释下游表现。
本文的目标是论文要回答「动作分词器到底应该保留什么才能支撑精确控制」。具体目标有三:其一,提出超越逐点精度的评价维度——物理秩一致性(PRC),在解码后的动作空间中度量局部物理距离排序是否被保留,使不同词表大小、序列长度、解码器架构的分词器能在同一物理参照下比较;其二,构造 ActionPiece 分词器,把动作间的物理远近关系显式注入表示学习和码字分配两个压缩阶段,与重建目标联合训练;其三,在统一的 Qwen3-VL-4B 策略协议下,跨 LIBERO、LIBERO-Plus、SimplerEnv、VLA-Arena 四个基准做受控对比与消融,验证物理关系监督能同时提升 PRC(从标准 RVQ 的 0.902 到 0.953)和策略成功率(LIBERO-Plus 从 60.4% 到 68.8%)。
与已有工作不同的是,已有工作的改进集中在「压得更短、排得更顺、与视觉语言对得更好」:FAST 用 DCT+BPE 压缩序列但频基固定;FASTerVQ 用 RVQ 加结构化动作 patch;OAT 用有限标量量化加嵌套 dropout 得到粗到细 token;ActionCodec 研究 token 预算、对齐与残差语法;X-Tokenizer 引入视觉-语言教师的语义监督。它们共同的盲点是:都以逐点重建为核心,从不显式约束「动作与动作之间」的关系结构。论文的独特切入是把分词器当作一个「保持关系结构的压缩器」来要求——把度量学习里保序的思想首次引入动作 token 化:不仅每个动作要重建得准,动作之间的物理远近(近的仍近、远的仍远、次序不颠倒)也要在离散化和解码后存活。配套的 PRC 指标也填补评价空白,让「关系保真」第一次可量化、可跨方法比较。
核心方法
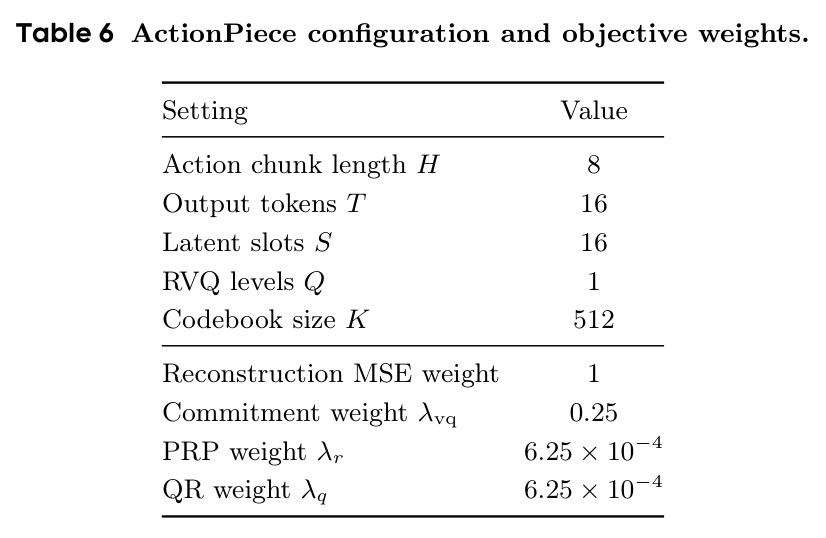
直觉:压缩演示不该只求「单个像」,还要让「谁离谁近」不变。技术路线是把物理距离监督同时施加在连续特征几何与离散码字分配上。编解码器为浅层 Transformer:编码器 $E_\phi$ 把 8 步动作块映射为 16 个 latent slot,深度 Q 的 RVQ(每级 512 码字)把每个 slot 表示为 $q_s = \sum_{r=1}^{Q} e^{(r)}[z_s^{(r)}]$,共 16 个 token;解码器 $D_\omega$ 一次前向重建整块。物理距离 $d_{phys}$ 融合归一化平移、SO(3) 测地线旋转与夹爪差,在 batch 内为每个 anchor 选 5% 分位近邻与 95% 分位远邻。训练目标在 MSE 与 commitment 损失之上叠加 $\lambda_r\mathcal{L}_{rank}$ 与 $\lambda_q\mathcal{L}_{quant}$($\lambda_r = \lambda_q = 6.25\times10^{-4}$,$\lambda_{vq} = 0.25$)。训练后分词器冻结,索引并入 VLM 词表。
核心创新是把「保序」作为动作分词的第一性要求,并用两个互补目标落实。物理秩保持(PRP)作用于表示层:对 LayerNorm 加 L2 归一化后的编码特征 $\bar{h}$ 与量化后码字 $\bar{e}$,计算 slot 平均距离 $d_{enc}, d_{quant}$,加权混合 $d_{rep}^2 = 0.25\,d_{enc}^2 + 0.75\,d_{quant}^2$,用 softplus 合页损失 $\mathcal{L}_{rank}$ 惩罚「近邻表示距离反而大于远邻」的违例(margin $m_r = 0.1$),梯度经可微码字估计器穿过离散选择。量化正则(QR)作用于分配概率:取各 slot 码字软分布的平均 JS 散度 $d_{JS}$,要求近邻对小于远邻对(margin $m_q = 0.1$),把物理序约束直接加在决定离散输出的概率上。与已有方法的本质区别:FAST、OAT、ActionCodec 等以逐点重建为主、关系结构只是副产品;ActionPiece 首次把动作间物理序作为显式监督,覆盖「学特征」与「映射到码字」两个压缩阶段。
方法步骤详情
流程分四步。第一步:数据按各基准频率采样(LIBERO 20 Hz、VLA-Arena 10 Hz 等)切成动作块,用 AdamW(学习率 $1\times10^{-4}$、batch 128、100K 步)训练分词器。第二步:对 batch 内每个 anchor $A_i$,用物理距离 $d_{phys}$(平移/旋转/夹爪加权)排除自身后排序,取 5% 分位为正样本 $j_i^+$、95% 分位为负样本 $j_i^-$。第三步:联合优化总损失 $\mathcal{L}_{tok}$——MSE 在归一化坐标上算重建误差;PRP 在 $d_{rep}$(0.25 编码 + 0.75 量化特征)上做 softplus 排序;QR 在码字分配的 JS 散度上做同样排序;可微码字估计器保证梯度可传。第四步:冻结编解码器,把 16 个 token 索引(码本 512)并入 Qwen3-VL-4B 词表,按 StarVLA 协议训练(学习率 $1\times10^{-5}$、DeepSpeed ZeRO-2、8 卡 RTX PRO 6000),推理时冻结解码器把 token 还原为动作块执行。
技术新颖性
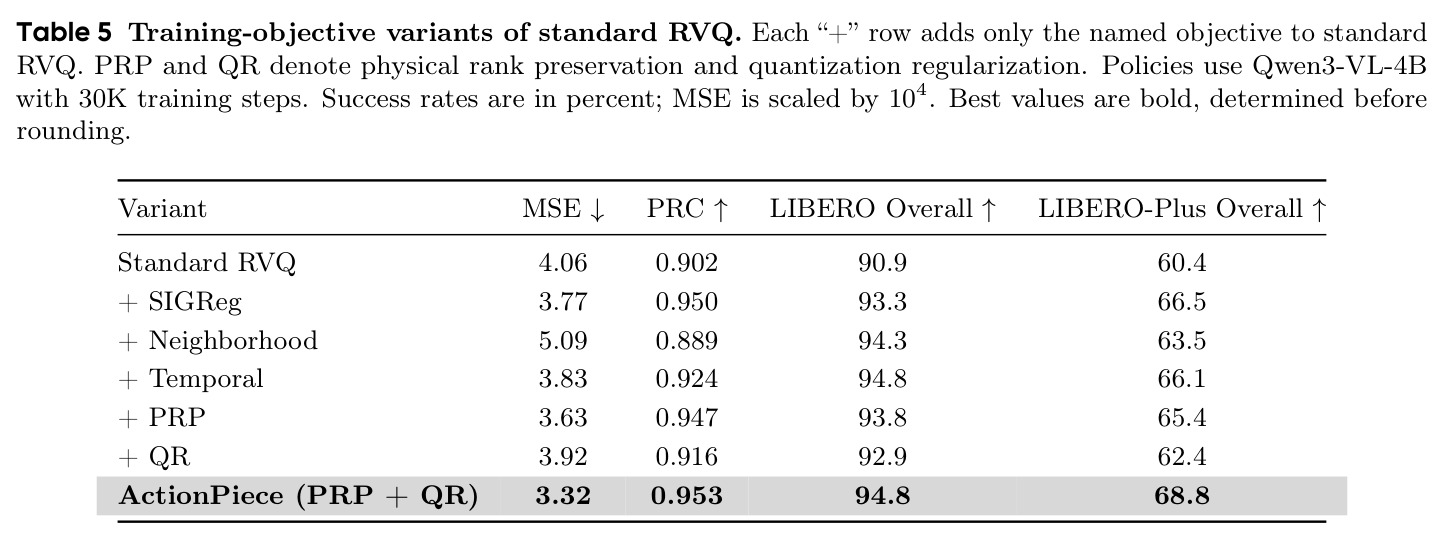
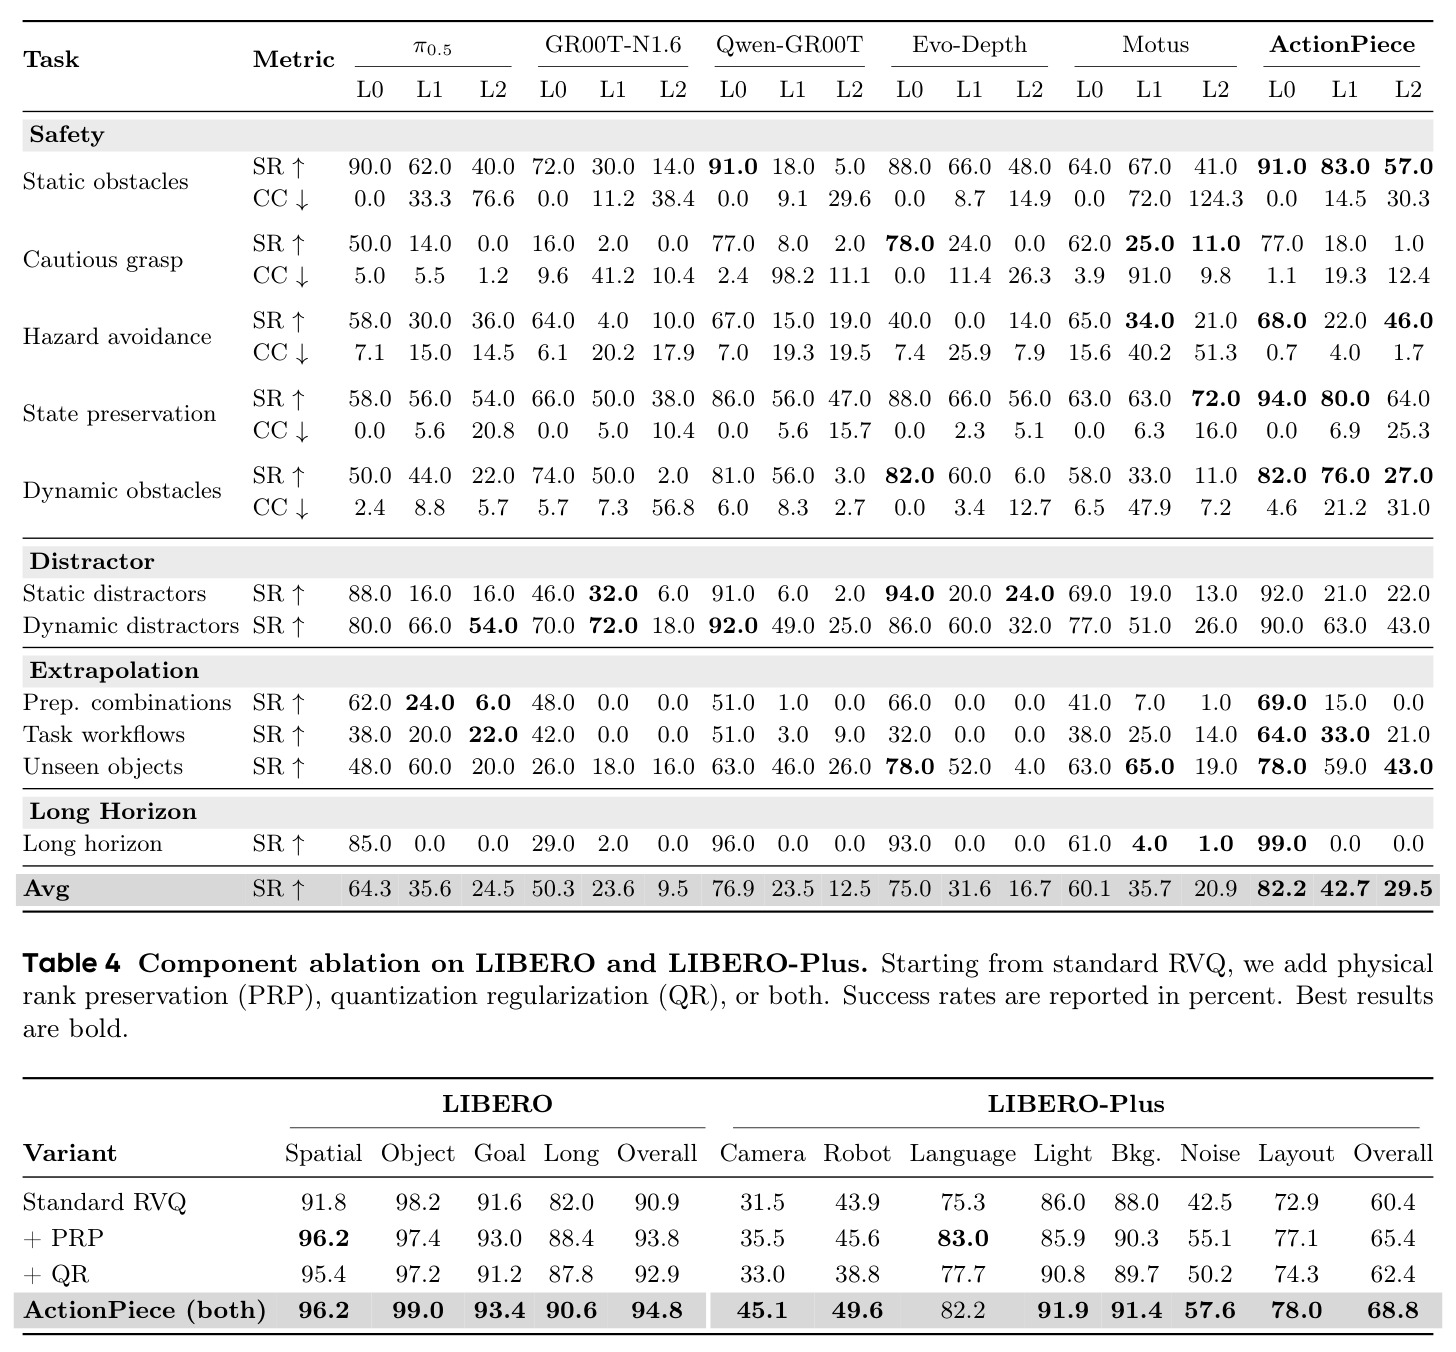
技术新颖性体现在三点。第一,问题形式化新颖:论文用 $\hat{x}_j - \hat{x}_i = (x_j - x_i) + (e_j - e_i)$ 的分解说明压缩误差项可以抵消真实动作差异,把「逐点 MSE 达标但关系失真」这一隐性失败模式首次明确化,并给出 PRC 作为可测指标。第二,监督信号设计新颖:物理距离融合平移、SO(3) 测地线旋转 $\|\mathrm{Log}(R^\top R')^\vee\|_2$ 与夹爪状态,尺度在训练动作上拟合,保证跨 embodiment 一致;PRP 的 0.25/0.75 加权刻意让梯度主导落在离散表示上。第三,约束位置新颖:QR 把排序约束从特征空间延伸到码字软分配分布的 JS 散度,直接塑造决定离散输出的概率几何,是以往 RVQ 训练(仅重建+commitment)从未触及的自由度。消融证明两者互补:PRP 单独把 PRC 提到 0.947,QR 单独到 0.916,联合 0.953,且 LIBERO-Plus 相机扰动从 PRP 单独的 35.5% 提到 45.1%。
实验结果
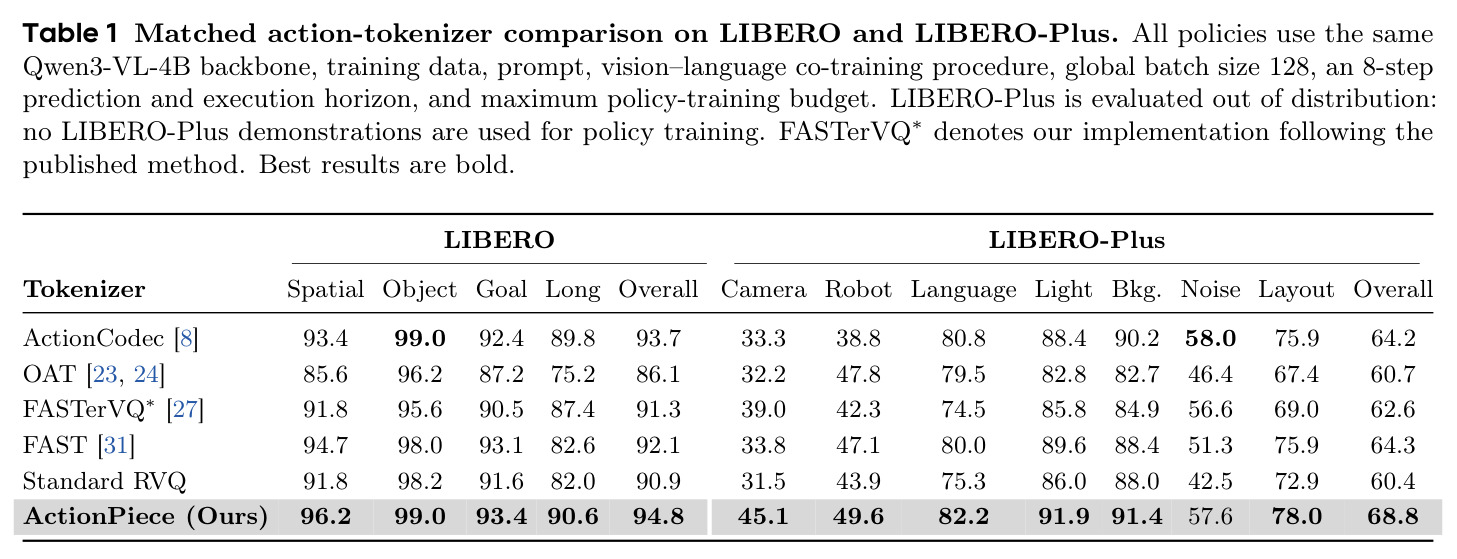
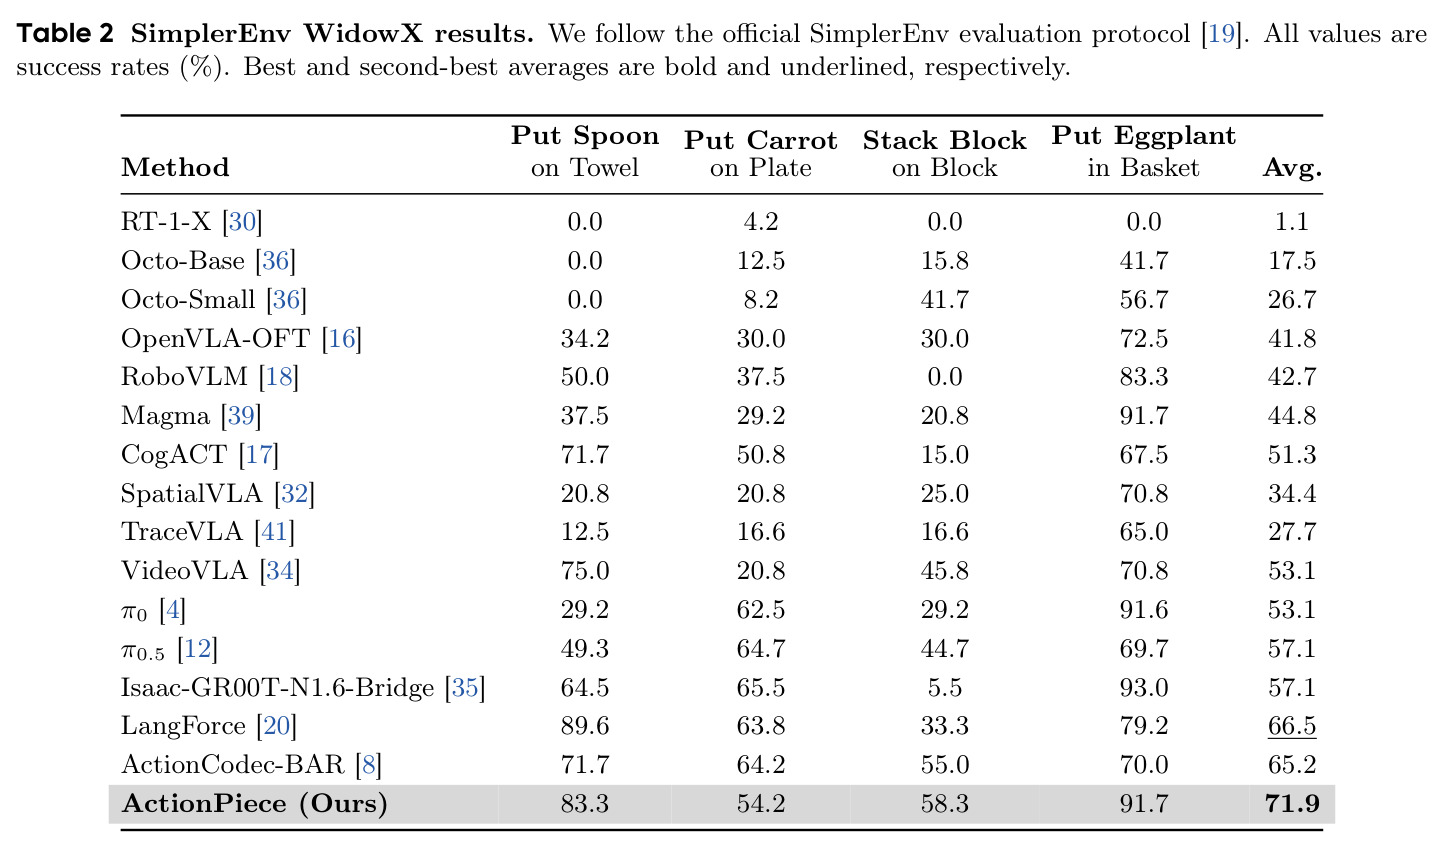
核心发现有四组。第一,关系结构比逐点精度更能预测成功:跨 55 组评测,PRC 与策略成功的 Spearman 相关达 0.681,高于重建保真度的 0.544。第二,受控对比中,LIBERO 上 94.8%,超最强基线 ActionCodec 的 93.7% 约 1.1 点;分布外 LIBERO-Plus 达 68.8%,超最强基线 FAST 的 64.3% 达 4.5 点,七个扰动类别中六个领先。第三,跨数据源泛化:SimplerEnv 真到仿迁移四任务宏平均 71.9% 居首(次优 LangForce 66.5%);VLA-Arena 仅用 L0 数据训练,L0/L1/L2 成功率 82.2%/42.7%/29.5%,33 格等权均值 51.5% 最高,L1/L2 平均超次优 7.0 和 5.0 点。第四,消融归因清晰:标准 RVQ 为 90.9%/60.4%,+PRP 达 93.8%/65.4%,+QR 达 92.9%/62.4%,联合达 94.8%/68.8%;PRC 相应从 0.902 升至 0.947/0.916/0.953,证明收益来自物理结构保留。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO(4 组任务,2000 次评测,分布内) | 成功率 (%) | 94.8(Spatial 96.2 / Object 99.0 / Goal 93.4 / Long 90.6) | ActionCodec 93.7;FAST 92.1;FASTerVQ 91.3;标准 RVQ 90.9 | +1.1 点(对最强基线 ActionCodec) |
| LIBERO-Plus(7 类分布外扰动,10030 次评测) | 总体成功率 (%) | 68.8(相机 45.1 / 机器人 49.6 / 语言 82.2 / 光照 91.9 / 背景 91.4 / 噪声 78.0 / 布局 57.6) | FAST 64.3;ActionCodec 64.2;FASTerVQ 62.6;标准 RVQ 60.4 | +4.5 点,7 类扰动中 6 类领先 |
| SimplerEnv WidowX(真到仿迁移,4 任务宏平均) | 平均成功率 (%) | 71.9(勺子 83.3 / 胡萝卜 54.2 / 叠方块 58.3 / 茄子 91.7) | LangForce 66.5;ActionCodec-BAR 65.2;π0.5 57.1;Isaac-GR00T 57.1 | +5.4 点(对最强基线 LangForce) |
| VLA-Arena L0–L2(11 套件×3 难度=33 格等权,3400 次评测) | 平均成功率 (%)(L0/L1/L2) | 51.5(82.2 / 42.7 / 29.5),L2 安全成本更低(静态障碍 CC 30.3) | Evo-Depth 41.1(75.0/31.6/16.7);π0.5 41.5;Motus 38.9;GR00T-N1.6 27.8 | 总体最高;L1/L2 平均分别领先次优 7.0 与 5.0 点 |
局限与改进
作者承认任务级表现有波动:SimplerEnv 放胡萝卜仅 54.2%,低于 π0.5 的 64.7%;VLA-Arena 长程任务 L1/L2 直接降到 0%,谨慎抓取 L2 仅 1.0%,说明物理结构监督并未解决长时序组合与安全接触类难题。训练预算也有限:图 2c 的匹配对比固定在 Qwen3-VL-4B、30K 步,未验证结论是否随骨干规模(如 7B)或真机部署稳定。我的补充观察:其一,PRC 用 k=32 近邻和 Spearman 相关,只度量局部排序,对全局几何扭曲不敏感,且所有评测在仿真完成,缺乏真机验证;其二,margin $m_r = m_q = 0.1$、0.25/0.75 加权、5%/95% 分位选点等关键超参均未做敏感性分析;其三,物理距离尺度在训练动作上拟合,跨 embodiment 迁移时的鲁棒性未知;其四,对比基线虽多,但未在同一协议下纳入 π0、GR00T 等连续/扩散头路线的对照,「离散 token 路线上限」的问题仍然开放。
独立分析的弱点
弱点一:近/远样本选择依赖 batch 内随机性,5%/95% 分位近邻随每次迭代的 batch 组成变化,小 batch 或数据稀疏区域监督噪声大;改进方向是引入 memory bank 或离线预计算的近邻图。弱点二:PRC 只看排序不看幅度,两个分词器可以秩一致但距离比值严重失真(近邻被拉近十倍),对精细插孔等需要精确幅度调整的任务可能不够;改进方向是补充保比重的度量或把距离比值保持纳入训练目标。弱点三:margin 与权重为固定常数,$m_r = m_q = 0.1$ 与 0.25/0.75 加权未随词表规模、chunk 长度自适应,换 32 步 horizon 或 4096 码本可能要重调;改进方向是让 margin 随距离分布自适应。弱点四:物理距离组权重在 embodiment 内固定,但任务间重要性不同(拿鸡蛋时夹爪占主导),单一全局加权可能错配;改进方向是按任务或物体属性学习权重。弱点五:长程任务收益消失(VLA-Arena L1/L2 长程为 0),说明 chunk 级局部保序覆盖不了跨 chunk 的时序一致性,需要序列级或轨迹级的关系约束。
未来方向
作者方向:把物理关系监督扩展到更多压缩阶段(如 RVQ 各残差级的独立监督)、利用 per-embodiment 尺度拟合接口验证跨机器人本体迁移、在真机数据上检验 PRC 与成功率的关联是否维持 0.681 量级。基于成果可延伸:其一,把 PRC 从评价指标升级为策略侧正则,在 VLA 训练中对预测 token 的解码动作施加保序约束,而不只在分词器训练期;其二,结合连续动作头(如 π0.5 的流匹配专家),用 PRP/QR 约束离散-连续混合表示,检验混合架构下关系保真是否同样带来分布外增益;其三,把物理距离扩展到力、接触阻抗等模态,服务接触丰富任务;其四,用 PRC 做数据配比与课程设计,优先采样能提升关系保真的演示;其五,理论上分析 softplus 排序损失与 Spearman 相关的联系,解释为何 PRC 对成功率的预测力(0.681)高于 MSE 保真度(0.544);其六,探索把保序结构用于推理期,如一致性解码或束搜索的安全剪枝。
复现评估
复现条件较高但路径清晰。关键超参齐全:分词器 AdamW 学习率 $1\times10^{-4}$、batch 128、100K 步,$\lambda_{vq} = 0.25$、$\lambda_r = \lambda_q = 6.25\times10^{-4}$、margin 0.1、0.25/0.75 加权、5%/95% 分位选点、16 slots×512 码字×8 步块;策略侧 StarVLA 协议、Qwen3-VL-4B、学习率 $1\times10^{-5}$ 余弦退火、DeepSpeed ZeRO-2、8 卡 RTX PRO 6000。评测:LIBERO 2000 次、LIBERO-Plus 10030 次、VLA-Arena 3400 次 rollouts,SimplerEnv 每任务 5×24 集。开源情况:正文给出项目主页,但未明确承诺代码与权重开源;FASTerVQ 为作者自行复现(标 *)。主要门槛是四个基准环境搭建、8 卡训练算力,以及 RVQ 加两个排序目标的工程实现(可微码字估计器在附录 B.1)。若代码开源属中等偏上难度。
论文图表