Interlock:以类型化完成图贯通局部正确与任务完成的长程智能体任务合成框架 Interlock: From Local Correctness to Task Completion in Long-Horizon Agents
把任务需求建成证据-决策-效果完成图,合成可验证长程任务并用完整轨迹微调智能体
前置知识
长程智能体与完成差距(completion gap)
指 LLM 智能体在跨越数十次工具调用、需要综合多份记录与规则的任务中,每一步可以局部正确,但最终交付物漏掉部分必需效果的现象,例如改了资源分配却没同步预算和日程,或多个输出共享同一个无依据假设。它源于证据、决策与效果之间的关系在长执行中丢失,是本文要度量和解决的核心问题。
论文的问题定义、评分标准设计与全部案例研究都围绕这一差距展开,理解它才能明白为什么“局部正确”不等于“任务完成”,以及为什么作者要把关系保留作为合成约束。
类型化完成图(typed completion graph)
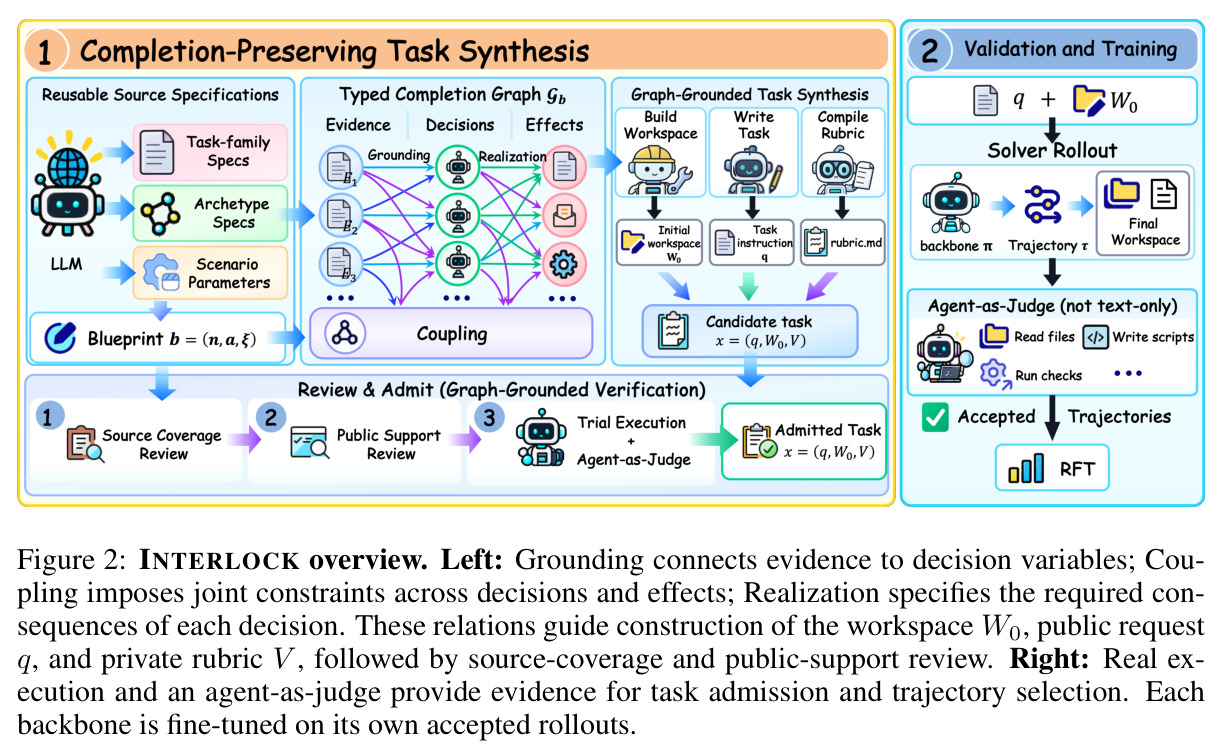
论文的核心数据结构:$G_b=\langle E_b, D_b, Y_b, R^G_b, R^C_b, R^R_b\rangle$。$E_b$ 是证据/规则节点,$D_b$ 是求解者要定的决策与共享状态,$Y_b$ 是必需效果节点;grounding 边 $R^G_b\subseteq E_b\times D_b$ 连证据与决策,coupling 超边施加联合条件,realization 边 $R^R_b\subseteq D_b\times Y_b$ 连决策与全部下游效果。它是合成过程的单一事实来源。
工作区、公开请求、私有 rubric 都从这张图编译而来,评审协议按图逐边追踪,案例研究按 grounding/coupling/realization 三栏展示,不掌握这套语言就无法读懂方法部分。
超边与联合约束(coupling hyperedge)
普通边只连两个节点,超边一次连接一组组件。论文中 coupling 关系 $(S,\psi)\in R^C_b$($R^C_b\subseteq 2^{D_b\cup Y_b}\times\Psi_b$)把多个决策或效果 $S$ 绑定到同一公共条件 $\psi$ 上,例如多个分配共享一个容量上限、多份交付物必须遵循同一条规则。它形式化了“各自局部正确、合在一起不合法”的失败。
这是任务真正需要全局一致的机制来源:回收计划中供给、整单服务与成本必须出自同一方案;理解超边才能看懂案例里 970>770、3920>3250 这类组合越界错误为何被重点考察。
拒绝采样微调(RFT)
一种自我改进训练法:策略对每个任务从重置环境采样多次,用验证器筛出成功轨迹,仅对成功子集做监督微调。本文的变体是 completion-filtered RFT:每个 backbone 独立执行合成任务、用 $A_V(x,\tau)=1$(全部必需判据通过)筛选,各自保留 8957 条自己的轨迹、约 154M 监督 token 做 SFT,训练 5 个 epoch。
这是主实验的训练协议:Table 1 对比的 Interlock-RFT 与 ClawGym-SFT 差异正在于“用谁生成的什么轨迹训练”,理解 RFT 才能正确解读两组对比的因果含义。
Agent-as-Judge(可执行验证的智能体裁判)
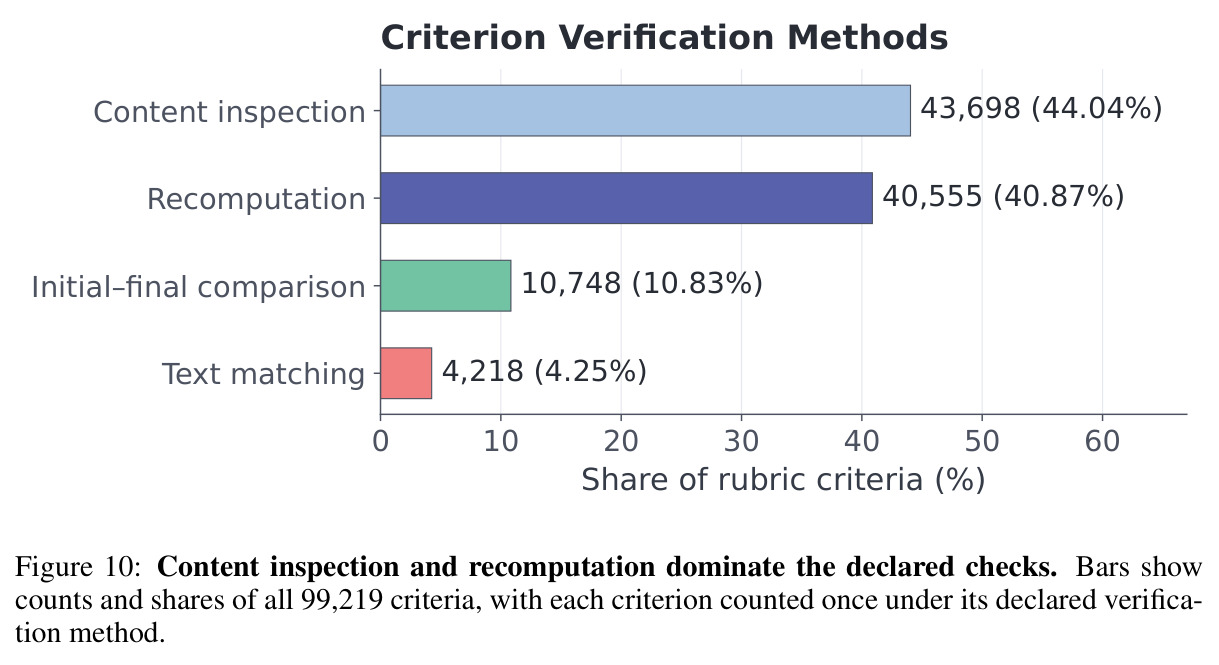
让一个带终端权限的裁判模型主动收集证据来评分:不只读固定的文本快照,而是检查初始/最终工作区及其 diff、读写文件、必要时编写并执行验证脚本,对 rubric 中每条二元判据给出通过/失败。$A_V(x,\tau)=1$ 表示所有必需判据通过且质量阈值达标。本文 99219 条判据中内容检查占 44.04%、重算占 40.87%。
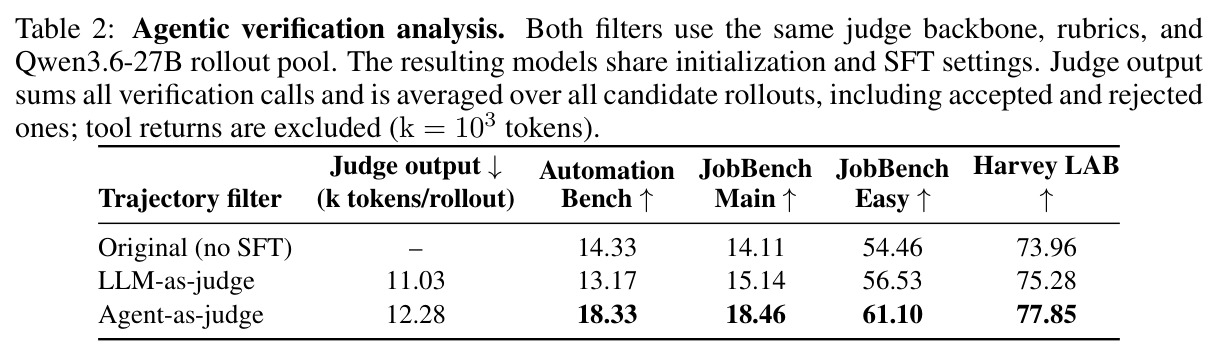
Table 2 专门证明:在相同 rollout 池与预算下,agent-as-judge 过滤的轨迹比文本 LLM-as-judge 过滤带来约 5 个点的下游提升,这是论文验证方法学最关键的消融证据。
研究动机
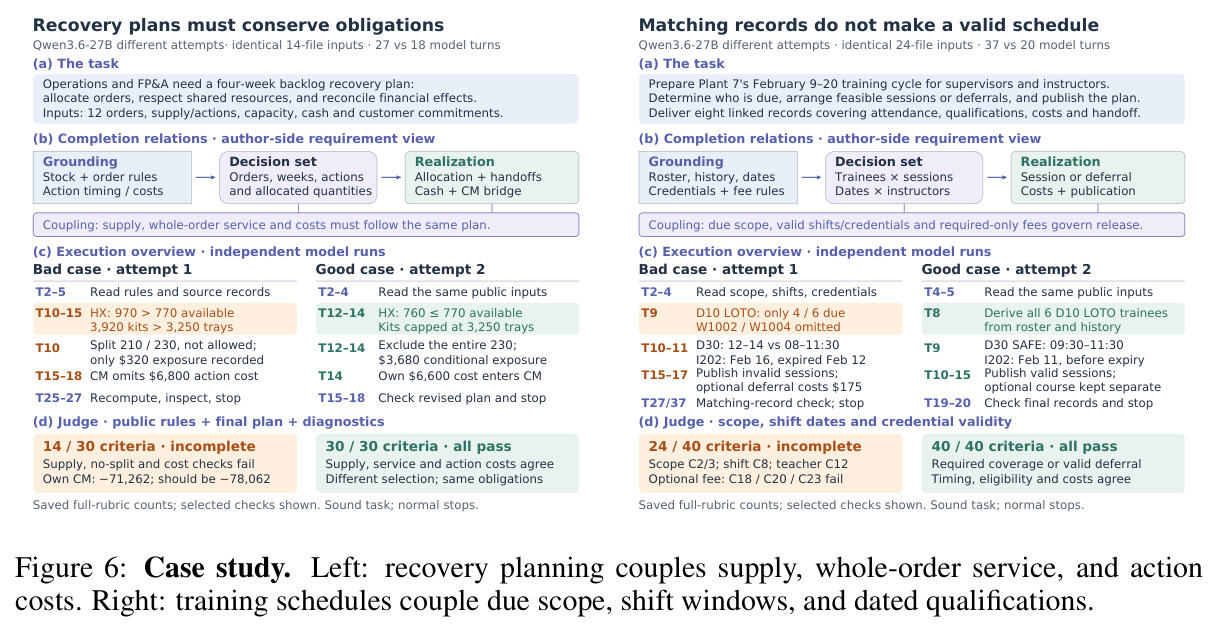
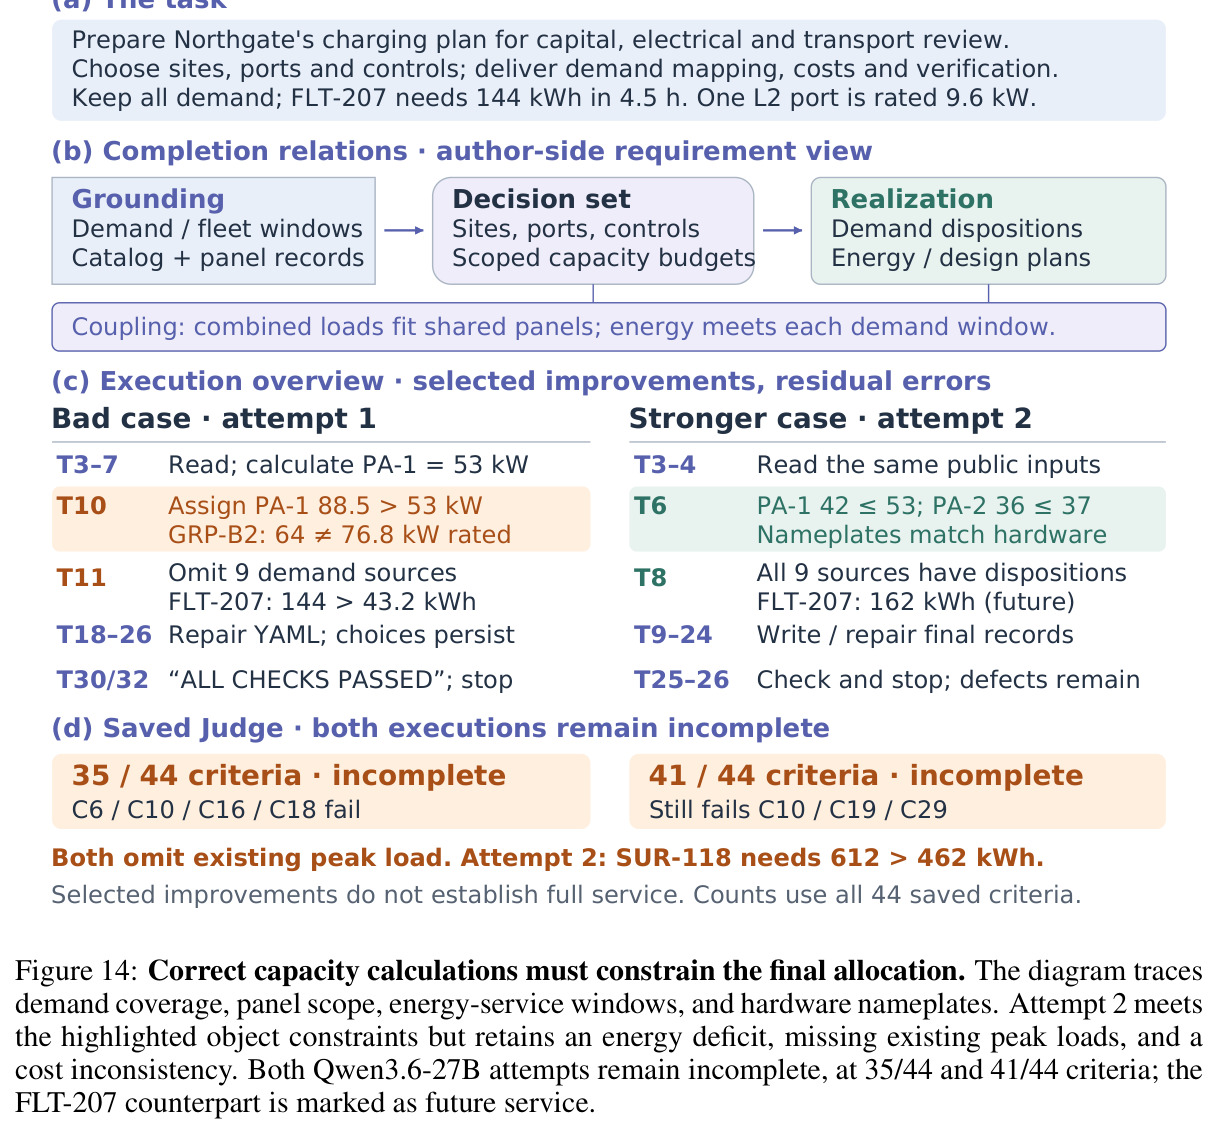
长程智能体要在证据碎片化、状态部分完成、资源相互依赖的环境中工作,但现有模型普遍出现“局部正确、整体不完整”的失败:一个正确的航班预订仍可能把日程与预算更新抛在脑后,多个相互一致的输出也可能共享同一个无依据的假设。论文的案例把这种失败具体化了:在薪资结账任务中,Qwen3.6-27B 把 E1004 的待决金额记成 34.50 美元而公开来源支持 448.50 美元(26 小时 × 17.25 美元/时);在园区充电规划中,模型算出面板 PA-1 只有 53 kW 余量,却给它分配了 88.5 kW,还把 144 kWh 的 FLT-207 需求交给一个 4.5 小时内最多只能供 $9.6\times4.5=43.2$ kWh 的 9.6 kW 端口;在训练排期任务中,模型安排了一位 2 月 16 日授课的讲师,而其资质 2 月 12 日就过期。失败的根源不在单步推理,而在证据—决策—下游效果之间的关系没有在长执行中被保持。基线水平也印证了完成差距的普遍性:原始 Qwen3.6-27B 在 AutomationBench 600 个任务上的通过率只有 14.33%,Qwen3.6-35B-A3B 只有 9.00%。而已有任务合成工作(ToolLLM、APIGen、AgentGen、TaskCraft、ScaleEnv、SkillSynth 等)围绕工具覆盖、环境规模、技能路径或任务组合来组织数据,没有把“一个完整结果所要求的全部条件义务”当作合成的组织单元,因此生成任务无法系统性训练和检验这种关系性失败。
本文的目标是本文的目标是构建一个任务合成与训练框架 INTERLOCK,使条件义务(什么对象在什么条件下必须呈现什么结果)在任务生成、执行与评估的全链路中被显式保留,并把“义务全部兑现”的执行轨迹转化为可迁移的训练经验。具体拆成三件事:其一,把任务完成形式化为类型化完成图,用 grounding、coupling、realization 三类关系连接公共证据、后果性决策、联合约束和必需效果;其二,把同一张图确定性地编译为可重置工作区 $W_0$、公开请求 $q$ 和私有评分标准 $V$,并用互补的双重评审保证“原始需求没有在生成中丢失”且“每条评分标准都能被求解者可见的材料支撑、可从执行工件判定”;其三,用 completion-filtered 拒绝采样微调,让 Qwen3.6-27B 与 Qwen3.6-35B-A3B 各自在自己全部判据通过的轨迹上做 SFT,并在 AutomationBench、JobBench Main/Easy、Harvey LAB 三个独立编写的外部基准上度量迁移增益,最终实测提升达到 3.20–6.64 个点。
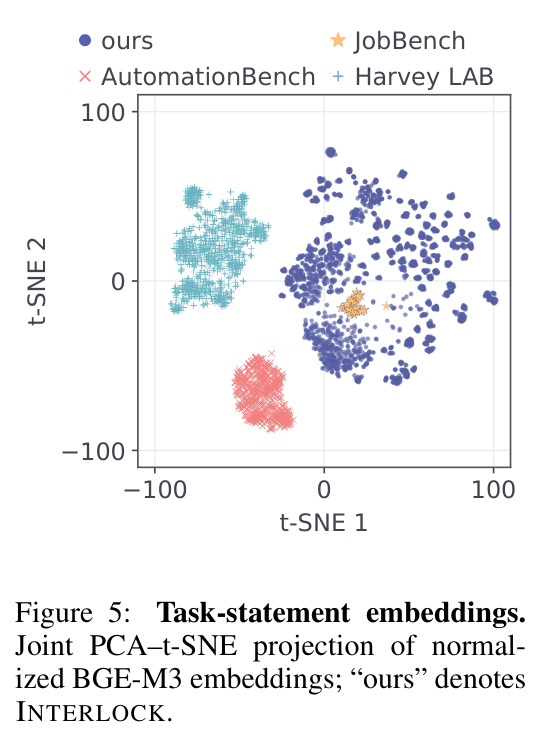
与已有工作不同的是,本文的独特切入在于合成的组织单元:不是工具连通性(ScaleEnv、EnvFactory)、技能路径(SkillSynth)或任务组合(TaskCraft、AgentSynth),而是“一个完整结果所需的条件义务全集”。这个选择带来三个差异化设计。第一,完成图被明确界定为需求表示而非执行顺序 DAG:它约束“什么必须成立”,不规定“按什么步骤做”,把解题过程自由完全留给智能体。第二,引入 carrier map($\mu_W, \mu_T, \mu_V$)记录每条图关系在工作区、请求契约与 rubric 中的具体落点(如某条政策条款、某个契约条目、某条判据),使“语义是否保留”的审查从整体印象判断变成逐项定位检查。第三,双向评审互补:source-coverage 评审从冻结的源规范出发反向追踪每条关系在必需阶段的存续,即使公开请求与 rubric 联合遗漏了某条义务,冻结源仍能兜底发现;public-input critic 只看求解者可见的 $(q, W_0, V)$,正向检查每条判据都有公开依据、联合条件一致、且可从执行工件判定。此外,任务收录只要求一次正常终止的验证执行与健全的包质量,不要求验证策略解出任务,从而把有挑战的难题保留在训练集中。
核心方法
直觉上,“把一件事做完整”可以画成一张图:证据支撑决策、决策之间必须联合可行、每个决策必须落到每一个下游工件。INTERLOCK 把这个直觉工程化为可执行的合成管线。形式上,任务包为 $x=(q, W_0, V)$:$q$ 是公开用户请求,$W_0$ 是初始工作区,$V$ 是求解者不可见的结构化私有 rubric。完成图定义为 $G_b=\langle E_b, D_b, Y_b, R^G_b, R^C_b, R^R_b\rangle$(式 (1)),三类关系满足 $R^G_b\subseteq E_b\times D_b$、$R^C_b\subseteq 2^{D_b\cup Y_b}\times\Psi_b$、$R^R_b\subseteq D_b\times Y_b$(式 (2))。技术路线分四段:(1) 由可复用蓝图 $b=(n,a,\xi)$(任务族 $n$、原型 $a$、场景参数 $\xi$)构建图 $G_b=\mathrm{BuildCompletionGraph}(O_n, \rho_a, \xi)$(式 (3));(2) 三个生成角色(builder/setter/compiler)把同一张图分别编译为工作区、请求与 rubric,并各自产出 carrier map;(3) source-coverage 与 public-input 双重评审,外加一次真实执行的 agent-as-judge 判定,共同决定任务收录;(4) 每个 backbone 独立做 $M=5$ 次 rollout,保留 $A_V(x,\tau)=1$ 的轨迹做 SFT,损失为 $\mathcal{L}^{(k)}_{\mathrm{RFT}}(\theta_k)=-\mathbb{E}_{(x,\tau)\sim\mathcal{D}^{(k)}_{\mathrm{RFT}}}\sum_{t\in\mathcal{J}(\tau)}\log\pi_{\theta_k}(z_t\mid q,h_t)$(式 (6)),监督覆盖推理、回复与工具调用 token。
核心创新是用任务完成关系本身作为合成约束,这与既有工作有本质区别。三类关系各自携带一个可检验的生成约束:grounding 要求控制性证据与规则在 workspace 中在场、且决策保持未决(不预联证据、不预先解决冲突);coupling 作为超边 $(S,\psi)$ 把多个决策或效果绑到同一公共条件上(如多个分配共享同一容量、多份输出共享同一决策),必须真正约束组合选择;realization 要求每个声明的下游接受者都有可观察的必需效果与对应的结果检查。每个效果用四元组 $y=(B_y, \Omega_y, \alpha_y, \phi_y)$ 刻画——义务的公共依据、对象总体、适用条件与结果条件,形式化为 $\alpha_y(q,W_0,W^1_\tau)=1\Rightarrow\phi_y(W_0,W^1_\tau)=1$(式 (7))。与 Anchor 用统一约束程序防止 artifact 漂移、CodeMidas 从既有代码派生任务、ClawGym 提供一次性演示数据都不同:INTERLOCK 锚定的是需求本身在 workspace→请求→rubric 三阶段产物中的存续,且每个 backbone 在自己完成的完整执行上自筛选训练,从机制上避免了演示分布与被训练模型不匹配的问题。
方法步骤详情
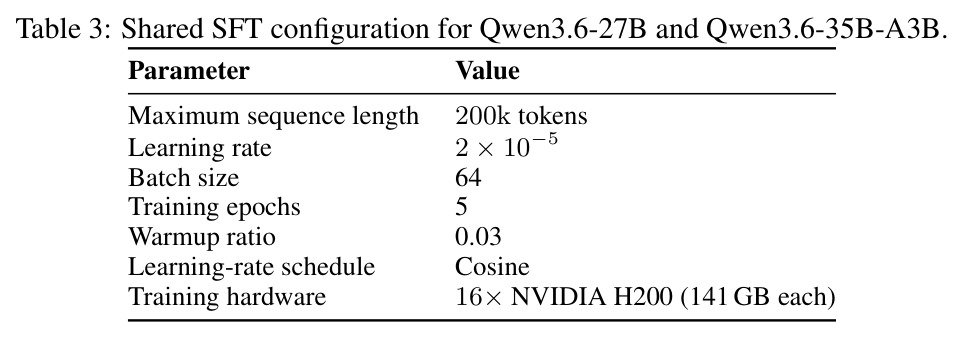
完整流程见 Algorithm 1。第一步,离线编写冻结源规范与蓝图 $b=(n,a,\xi)$,由义务集 $O_n$、原型关系模式 $\rho_a$ 与场景参数 $\xi$ 生成完成图 $G_b$,代码检查引用完整性与阶段义务(如每条关系必须有 rubric 覆盖和至少一个公开输入阶段)。第二步,三角色编译(式 (4)):BuildWorkspace 产出初始工作区 $W_0$、证据索引 $I$ 与 carrier map $\mu_W$,要求保留独立可辨的来源、原始冲突与未决对象;WriteTask 产出公开请求 $q$ 与私有交付契约 $H$(每条契约义务必须在 $q$ 或公开工作区有依据)及 $\mu_T$;CompileRubric 产出原子二元判据构成的 $V$(rubric_spec.json 与可读版 rubric.md)及 $\mu_V$。第三步,评审:source-coverage judge 从冻结源规范出发,对 $\Gamma_b=R^G_b\cup R^C_b\cup R^R_b$ 中每条关系在每个必需阶段检查 carrier 是否保留公共依据、适用性、范围与结果条件,要求 $P(c)=P_{\mathrm{spec}}(c)\prod_{\gamma\in\Gamma_b}\prod_{s\in S(\gamma)}P_s(\gamma)=1$(式 (5));public-input critic 只读 $(q, W_0, V)$,检查判据的公开可支撑性与联合一致性。第四步,执行式收录:验证策略从 $W_0$ 的新副本执行,agent-as-judge 对比初始/最终工作区、运行验证脚本,逐判据给出通过/失败并评估包质量;确认缺陷回送生成角色修订并重新评审,修订有界且版本化。第五步,completion-filtered RFT:每个 backbone 每任务 $M=5$ 次尝试,$\mathcal{D}^{(k)}_{\mathrm{RFT}}=\{(x,\tau)\in \mathrm{Tok}^{(k)}:\mathrm{normal}(\tau)=1,\ A_V(x,\tau)=1\}$,各保留 8957 条轨迹,以最大序列 200k、学习率 $2\times10^{-5}$、batch 64 训练 5 个 epoch。
技术新颖性
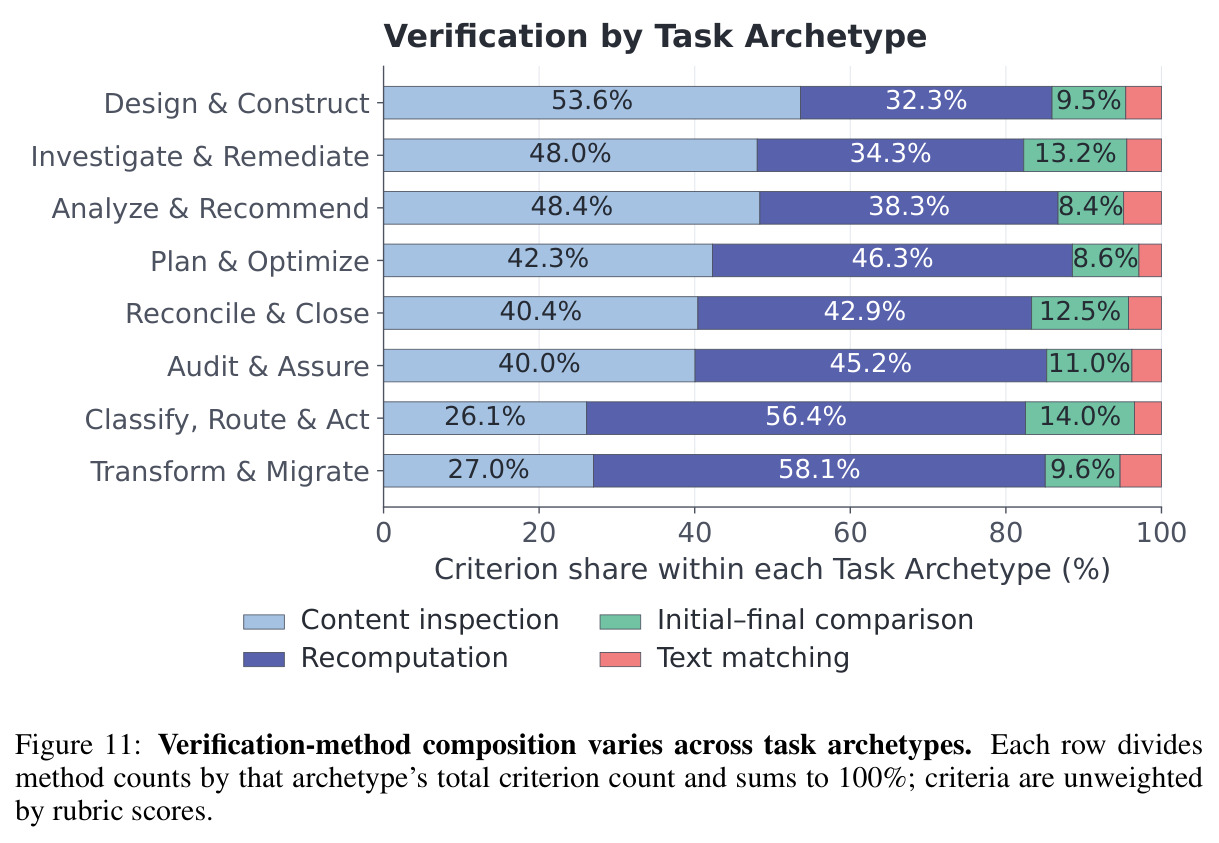
技术新颖性可从四个层面看。表示层:类型化完成图把“完整性”从经验描述升格为带类型边的形式对象,并明确区分需求图与判据依赖图——rubric 的 depends_on 边只用于传播部分得分(式 (9) 的 $\tilde{m}_i=m_i\prod_{j\in D_i}\tilde{m}_j$),不定义任务语义,这个分离避免了评分结构与任务含义混淆。机制层:carrier map 让每个图元素在各阶段的落点可先由代码核对存在性、再由评审员阅读内容,审查对象从“整体像不像”变成“每一处具体载体是否保留公共依据与适用范围”;双向评审的互补性(source anchor + public support)构成对“请求与 rubric 联合遗漏义务”这一最隐蔽故障的防御。评估层:rubric 以原子二元判据为主——99219 条判据中内容检查占 44.04%(43698 条)、重算占 40.87%(40555 条)、初始-最终对比占 10.83%、文本匹配占 4.25%——agent-as-judge 有终端权限、可写并执行验证脚本,Table 2 证明这种可执行验证在相同预算下比纯文本 LLM-as-judge 每条轨迹多花约 1.25k 判定 token(11.03k→12.28k,+11.3%),却把 AutomationBench 从 13.17 提到 18.33。训练层:per-backbone RFT 各自筛选各自的接受轨迹(两模型共 17914 条),避免跨模型演示分布失配,而对照的 ClawGym-SFT 在多数指标上反而低于原始 checkpoint,凸显了这一设计的重要性。
实验结果
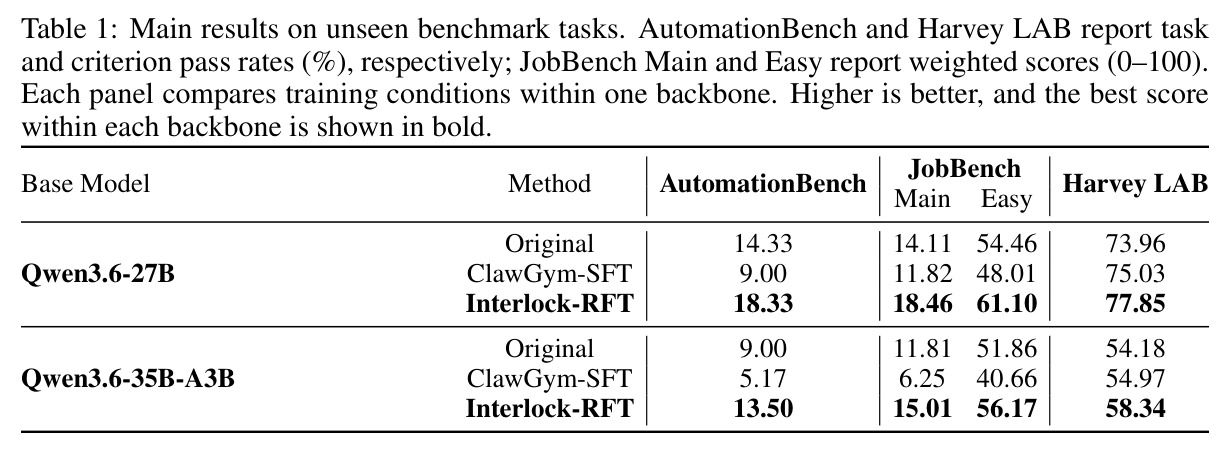
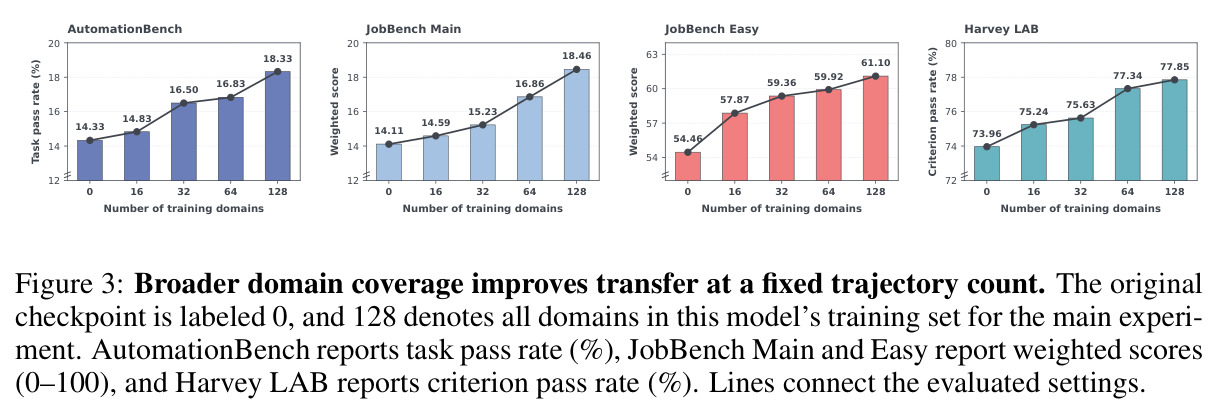
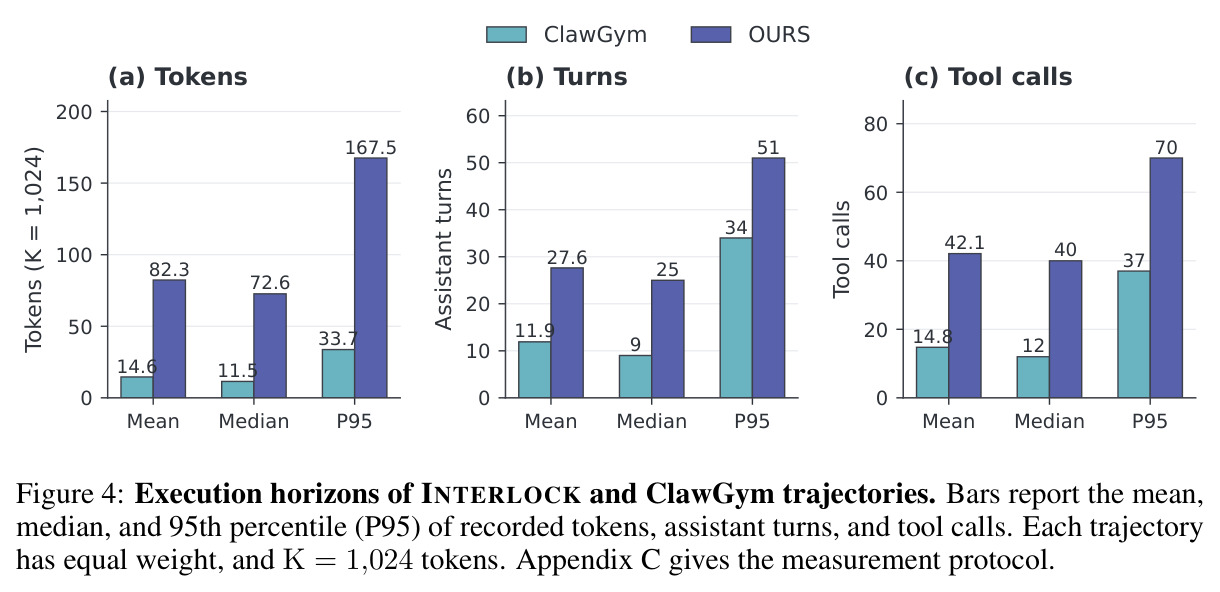
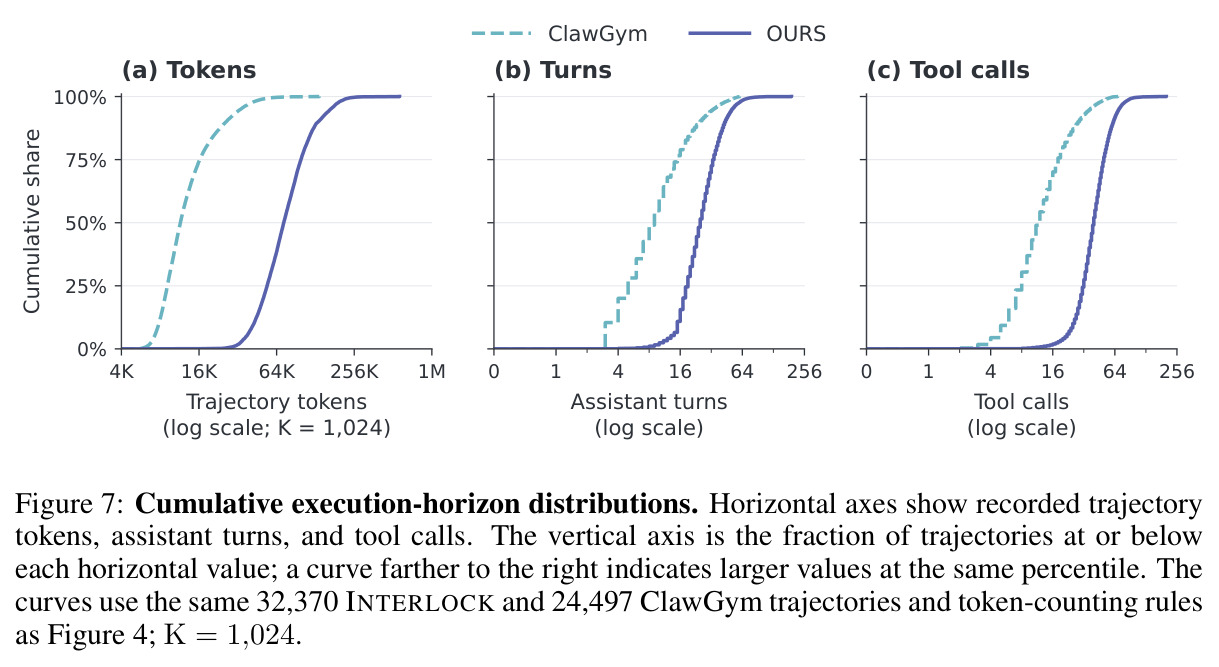
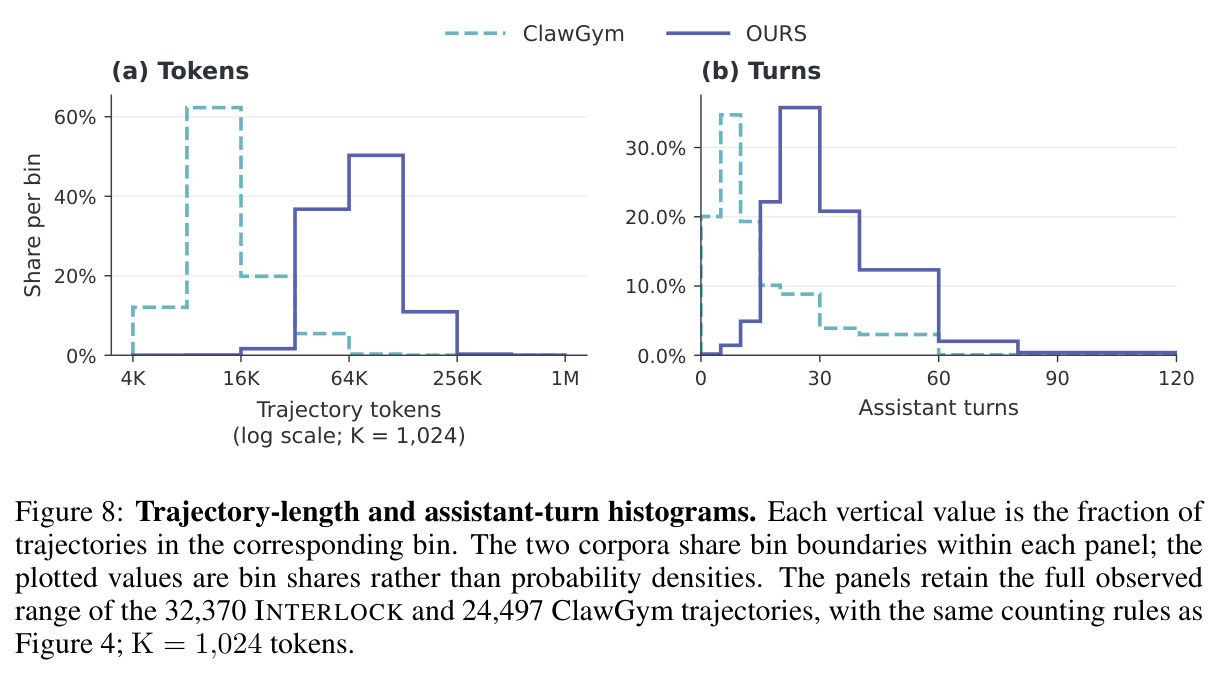
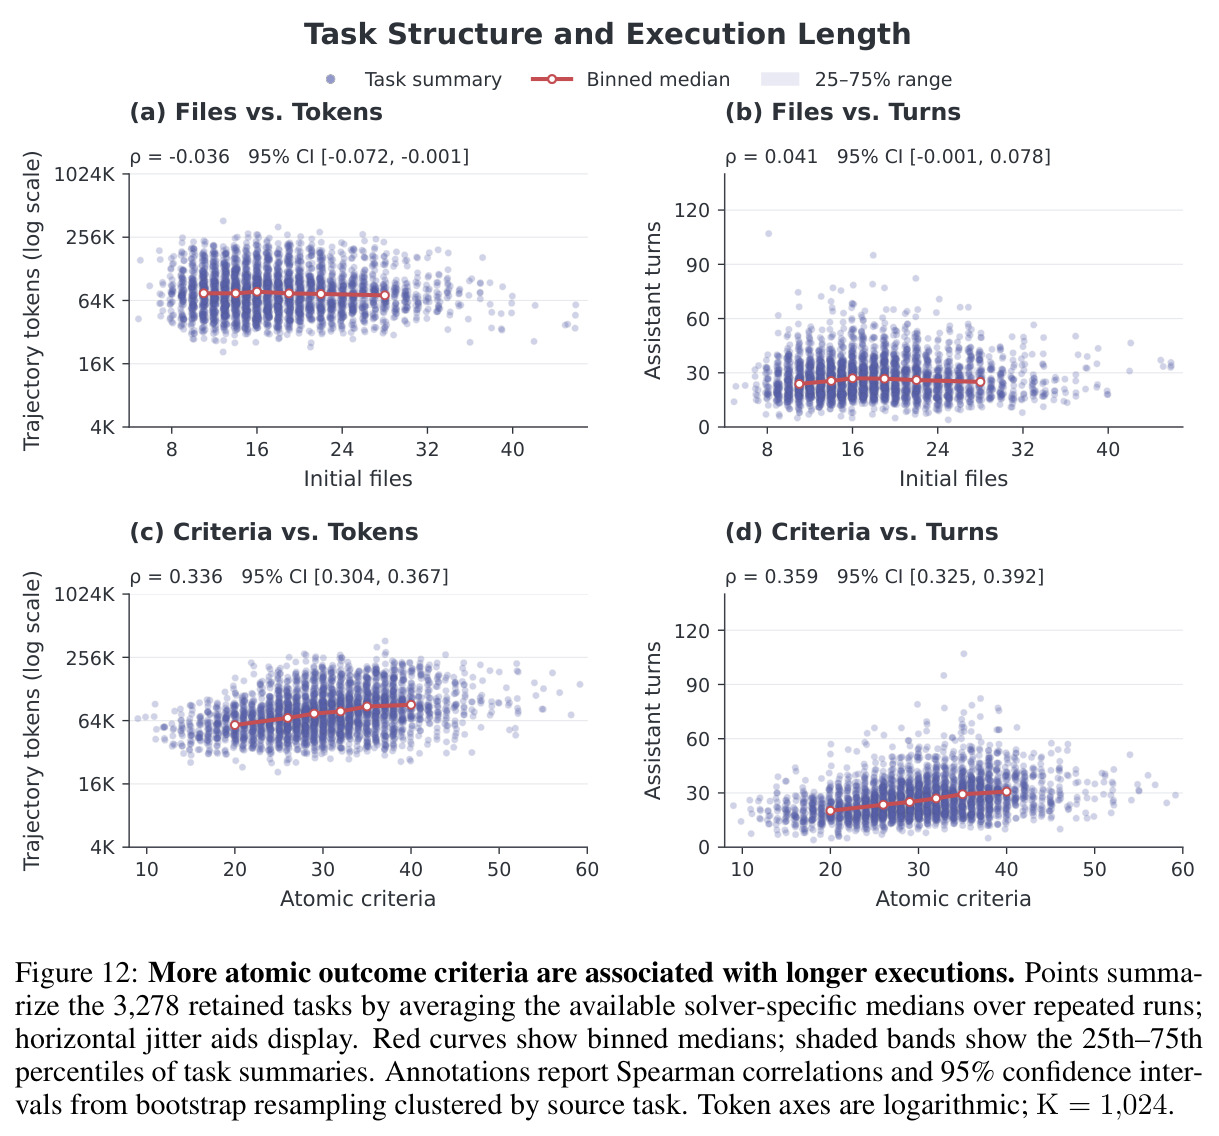
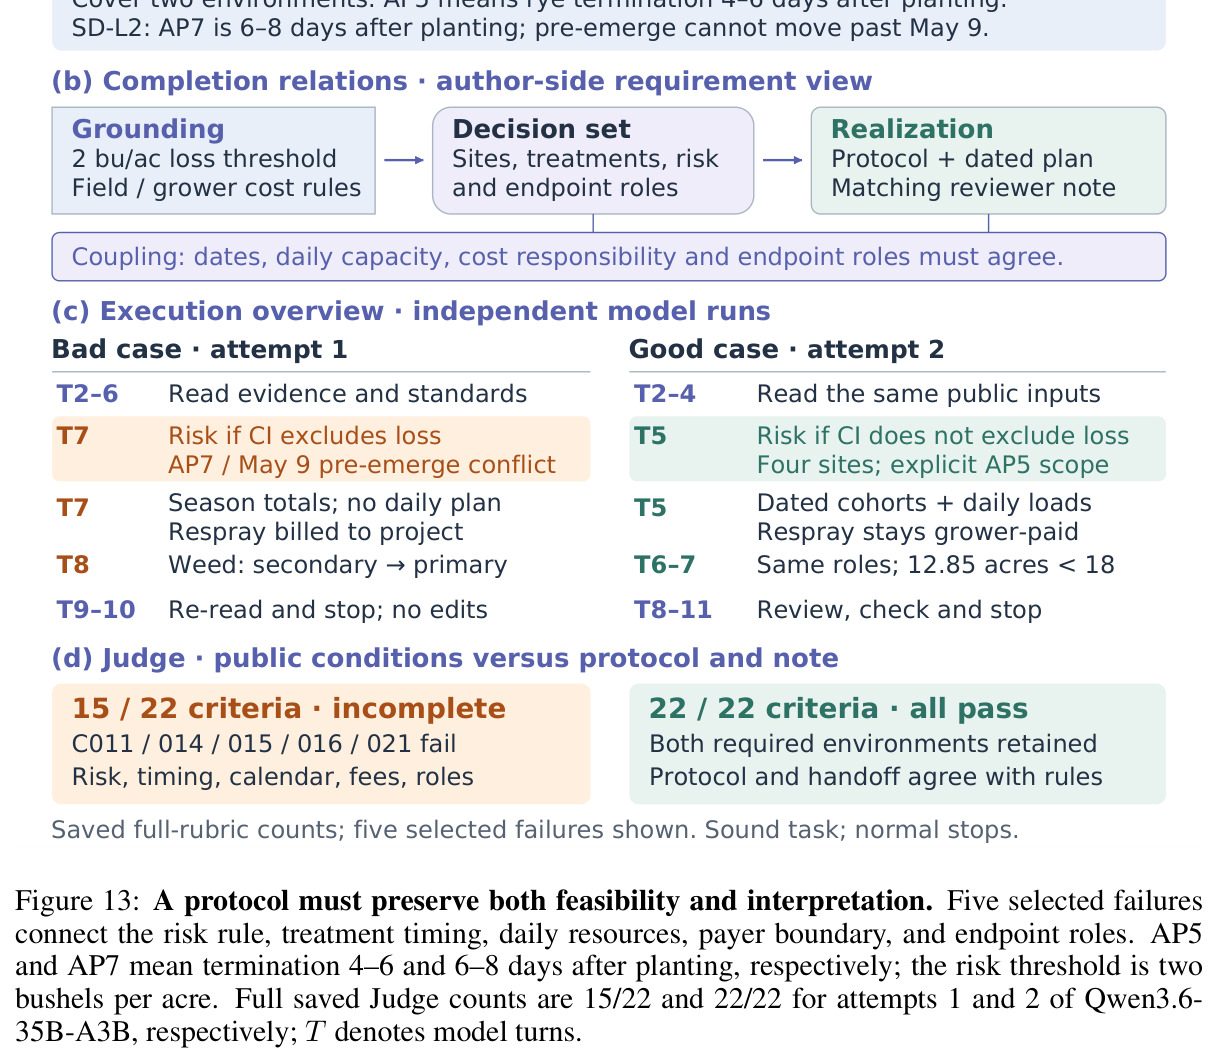
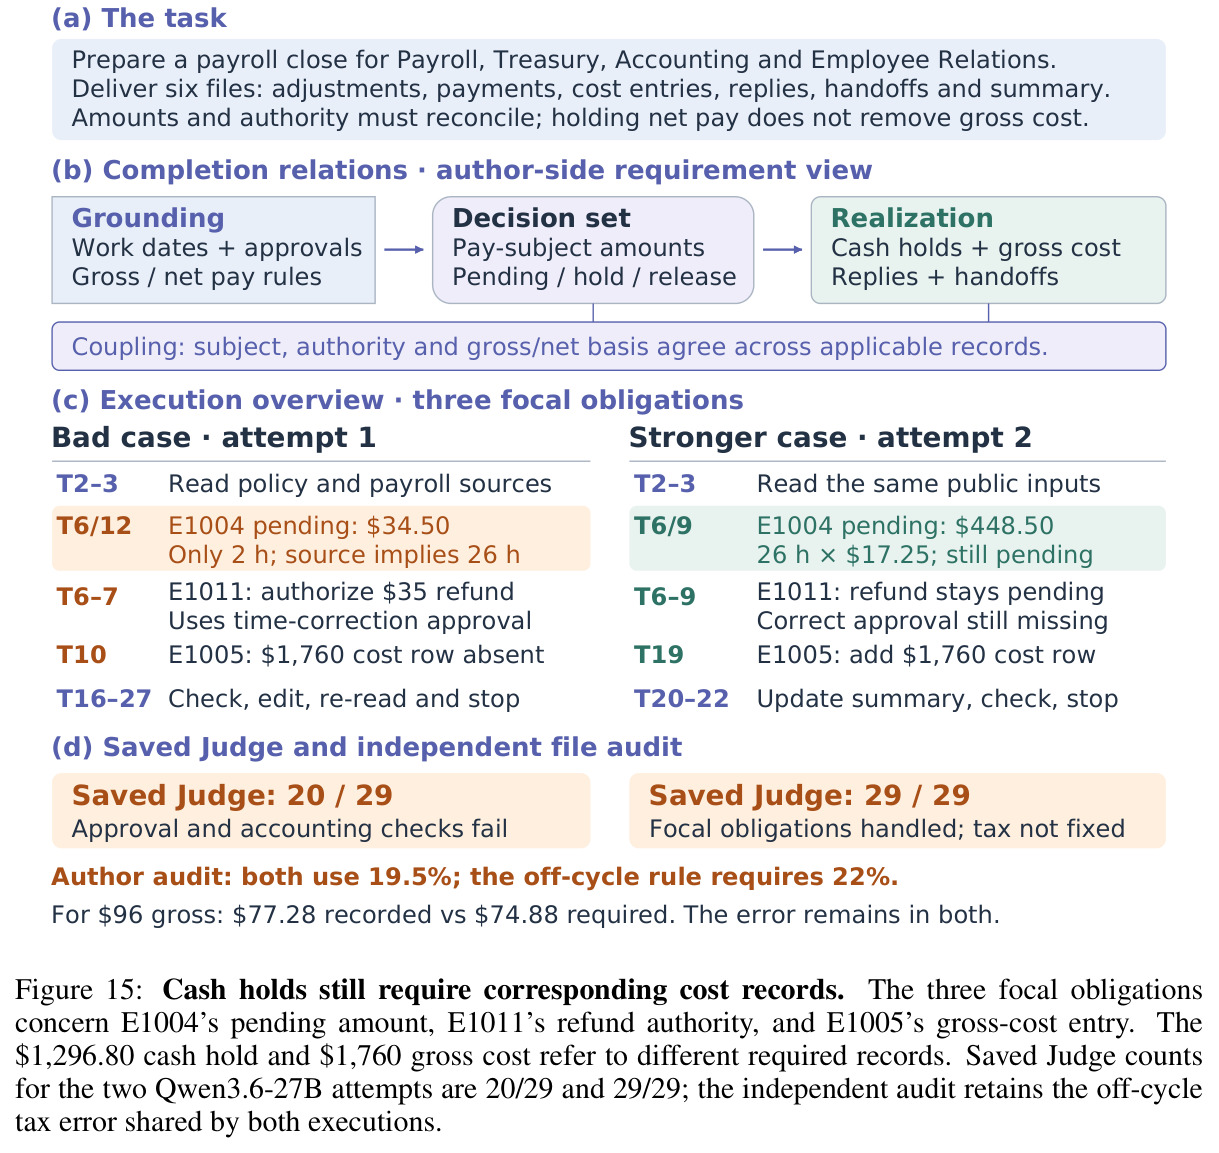
主结果(Table 1)显示 Interlock-RFT 在两个 backbone 的全部四个评测列上均为最优。Qwen3.6-27B:AutomationBench 任务通过率从 14.33% 提升到 18.33%(+4.00pp),JobBench Main 加权分从 14.11 到 18.46(+4.35),JobBench Easy 从 54.46 到 61.10(+6.64),Harvey LAB 判据通过率从 73.96% 到 77.85%(+3.89pp);Qwen3.6-35B-A3B 对应为 9.00%→13.50%(+4.50pp)、11.81→15.01(+3.20)、51.86→56.17(+4.31)、54.18%→58.34%(+4.16pp)。值得注意的是 ClawGym-SFT 大多低于原始 checkpoint(27B 在 AutomationBench 上仅 9.00%、JobBench Main 11.82),说明外部演示数据甚至可能有害,而自产自筛的完整执行经验持续为正。验证器消融(Table 2):固定 rollout 池与训练预算,agent-as-judge 过滤在四个指标上全面优于文本 LLM-as-judge(18.33/18.46/61.10/77.85 vs 13.17/15.14/56.53/75.28),代价是每条候选轨迹多约 1.25k 判定 token。域扩展(Figure 3):固定 8957 条轨迹,训练域从 16 增至 128,四个指标逐级单调上升,128 域最优,说明增益来自更多样的完成关系实例而非数据量。执行长度(Figure 4、7、8):32370 条正常终止轨迹平均 84293 tokens、27.63 轮助手回合、42.10 次工具调用,是 ClawGym 24497 条轨迹(14940/11.92/14.76)的 5.64×/2.32×/2.85×;中位轮数 25 vs 9、中位工具调用 40 vs 12。结构-长度相关(Figure 12):原子判据数与 tokens、轮数的 Spearman 相关为 $\rho=0.336$(95% CI [0.304, 0.367])与 $\rho=0.359$(CI [0.325, 0.392]),而初始文件数几乎无关($\rho=-0.036/0.041$),支持“完成关系密度而非材料数量驱动长执行”的解释。案例(Figure 6、13–15)显示同一模型在同一输入下两次尝试可从 14/30 判据跃至 30/30,也可能在 29/29 通过的薪资任务里留下两次共有的 19.5% vs 22% 税率错误。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AutomationBench(600 个跨应用 API 编排任务) | 任务通过率 (%) | Qwen3.6-27B: 18.33;Qwen3.6-35B-A3B: 13.50 | 原始 checkpoint: 27B 14.33 / 35B-A3B 9.00;ClawGym-SFT: 27B 9.00 / 35B-A3B 5.17 | 较原始 checkpoint +4.00pp(27B)与 +4.50pp(35B-A3B);较 ClawGym-SFT +9.33 与 +8.33pp |
| JobBench Main(65 个需多源调和的职业任务) | 任务平均加权分 (0-100) | Qwen3.6-27B: 18.46;Qwen3.6-35B-A3B: 15.01 | 原始 checkpoint: 27B 14.11 / 35B-A3B 11.81;ClawGym-SFT: 27B 11.82 / 35B-A3B 6.25 | 较原始 checkpoint +4.35(27B)与 +3.20(35B-A3B)分 |
| JobBench Easy(65 个自含工作区任务) | 任务平均加权分 (0-100) | Qwen3.6-27B: 61.10;Qwen3.6-35B-A3B: 56.17 | 原始 checkpoint: 27B 54.46 / 35B-A3B 51.86;ClawGym-SFT: 27B 48.01 / 35B-A3B 40.66 | 较原始 checkpoint +6.64(27B)与 +4.31(35B-A3B)分 |
| Harvey LAB(1251 个 24 个法律执业领域的任务) | 判据通过率 (%) | Qwen3.6-27B: 77.85;Qwen3.6-35B-A3B: 58.34 | 原始 checkpoint: 27B 73.96 / 35B-A3B 54.18;ClawGym-SFT: 27B 75.03 / 35B-A3B 54.97 | 较原始 checkpoint +3.89pp(27B)与 +4.16pp(35B-A3B) |
局限与改进
作者承认或可见的局限:其一,JobBench 与 Harvey LAB 都用 GPT-5.5 做裁判,评测结论部分依赖第三方裁判模型;其二,保留语料要求 Qwen3.6-27B 与 Qwen3.6-35B-A3B 各至少一次通过(得 3278 个任务),这一筛选会把两个模型都解不出的最难完成图结构排除在外,语料难度分布有偏;其三,任务收录要求一次正常终止的验证执行,410 次异常执行的处理细节未展开。我观察到的额外局限:训练只用 RFT/SFT,没有 RL 或负样本利用——32370 条正常轨迹中约 14456 条未通过(32370−2×8957)被直接丢弃,而这些恰是“局部正确”失败模式的一手数据;绝对性能仍然很低(AutomationBench 最高 18.33%),完成差距远未解决;rubric 覆盖不完备的风险真实存在——薪资案例中 judge 给出 29/29,独立文件审计却发现两次执行都把离线周期税率 22% 写成 19.5%(96 美元毛工资记 77.28 而非 74.88 美元净额),说明收录评审没能保证判据集合的完备性;应用域集中在专业文书、运营与法律场景,对代码、GUI、操作系统类任务的外推未知;正文与附录均未见代码或语料的开源发布声明,且结果绑定在 Qwen3.6 私有模型家族上,跨模型家族的通用性未验证。
独立分析的弱点
弱点一:rubric 覆盖不完备与 judge 盲区。薪资案例中判据全过但税率错误逃逸,说明“每条判据二元可判”不等于“判据集合完备覆盖了公开规范”。改进方向:在收录阶段加入对抗性覆盖 critic,专门寻找公共规范中未被任何判据覆盖的义务,或把独立文件级 diff 审计设为第三道常设评审。弱点二:任务保留标准偏易。要求两个 backbone 都至少通过一次,最难的关系结构可能被系统性过滤掉;可改为按难度分桶保留配额,或允许带更多尝试次数、更强工具配置的求解器补跑困难任务后再筛选。弱点三:只学正例。RFT 丢弃了大量“局部正确但整体不完整”的失败轨迹,而这正是论文想解决的失败模式的数据富矿;可用 DPO/KTO 类偏好目标,把 Figure 6 那种同任务同输入的近距成功/失败配对(14/30 vs 30/30)转化为负梯度信号。弱点四:成本高昂。每条轨迹平均 84293 tokens、每 backbone 16390 次执行、训练需 16 张 H200 跑 5 个 epoch;可探索对完成图做子集分解的课程化训练,用短任务先学关系再拼长任务。弱点五:评测集中于单一裁判家族(GPT-5.5)且未量化裁判偏置,也未报告多次评测的方差;应补充多裁判一致性或人工校验子集。弱点六:域扩展实验(Figure 3)只扫到 128 域且四个设置共用同一轨迹数,域数与轨迹数的交互(scaling law 形态)尚未刻画。
未来方向
作者在附录 B 已铺出方向:行为诊断协议用 follow-through rate $\mathrm{FTR}=\sum_i u_i e_i/\sum_i u_i$(式 (11))度量“上游决策正确时下游效果是否兑现”,并规划组合迁移实验(保留特定域-关系组合)与环境干预诊断(改变影响适用性的公共事实、用语义保持重排作对照),这些能把“完成行为”从结果指标细化到关系级指标。在此基础上可延伸:把完成图从数据筛选约束升级为 RL 奖励的结构化模板——按 grounding/coupling/realization 逐关系给奖励,而非 0/1 整体通过,缓解长程任务的稀疏奖励问题;跨 backbone 蒸馏,用强模型的接受轨迹训练弱模型,检验完成关系结构是否可跨模型迁移;基于完成图训练过程奖励模型或做失败归因(定位是哪类关系的兑现失败);把框架扩展到多模态工件(PDF、电子表格、仪表盘)与真实企业系统沙盒(ERP/CRM);系统研究 coupling 超边的规模效应——联合约束数量与任务难度、执行长度、通过率之间的定量关系;以及在语料中保留被拒轨迹,研究“接近成功”的对比式训练对完成行为的额外增益。
复现评估
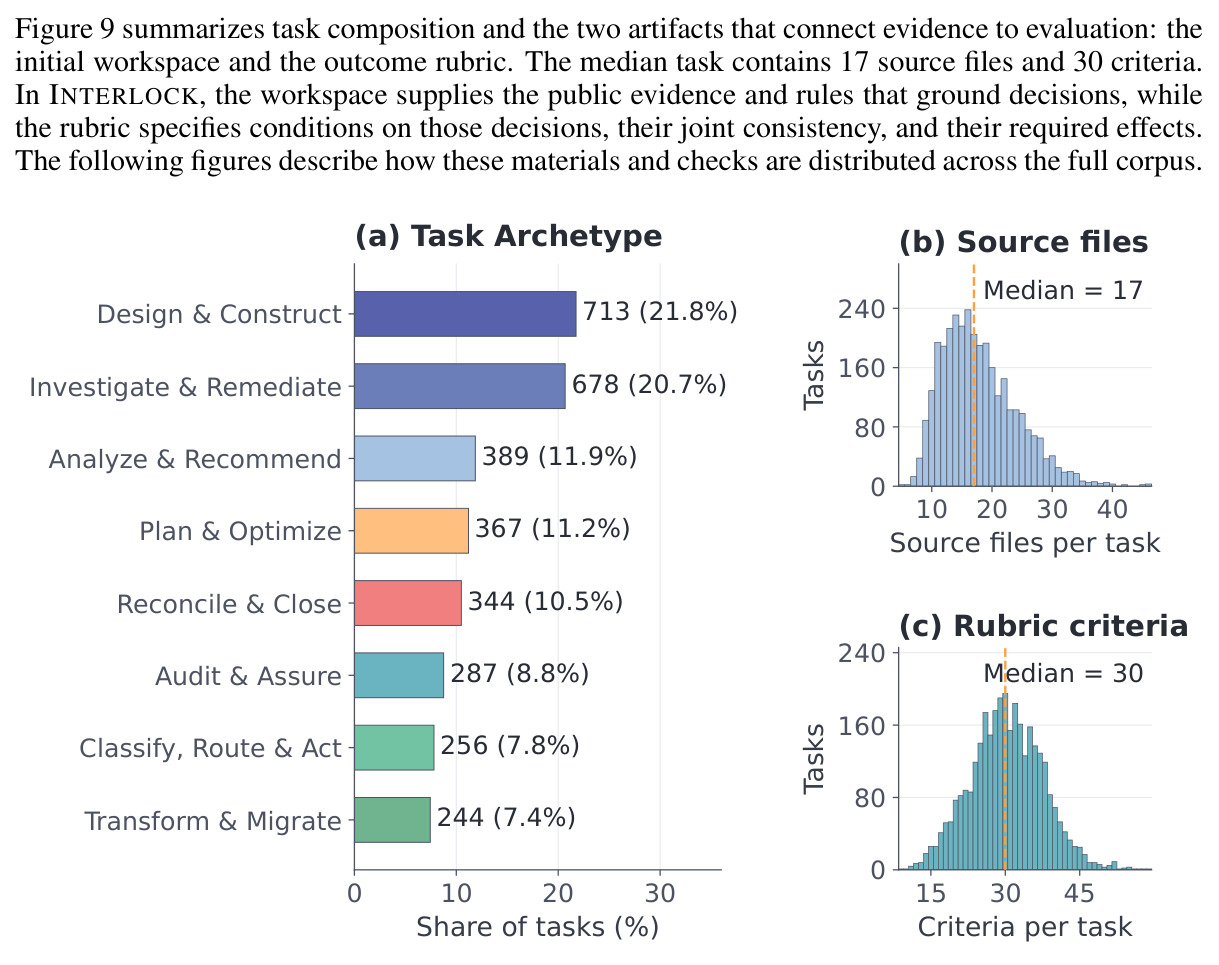
复现难度:高。开源情况:论文未提供代码仓库、prompt 全集或 3278 个任务语料的发布声明;附录 H 给出现行实现的 6 段 prompt 摘要(世界构建者、任务设定者、rubric 编译器、source-coverage judge、public critic 等,自中文模板翻译)与 4 个数据契约(completion_graph、carrier 映射、rubric_spec.v6、source_review.v1)的字段级说明,信息量较大但并非可直接运行的完整实现。三个评测基准(AutomationBench、JobBench、Harvey LAB)有公开版本,评测协议(OpenCode harness、GPT-5.5 裁判、加权分公式)在附录 G.2 交代清楚。数据与算力:合成需要多角色 agent 管线和大量 LLM 调用,保留语料中任务中位数含 17 个源文件、30 条判据,共 99219 条判据;rollout 侧每 backbone 16390 次执行(各保留 8957 条),训练侧需 16 张 NVIDIA H200(141GB)、最大序列 200k、学习率 $2\times10^{-5}$、batch 64、5 个 epoch,骨干为 Qwen3.6-27B 与 Qwen3.6-35B-A3B(thinking 模式)。若无法获得同版骨干与同等 rollout 预算,可先在小域数(Figure 3 显示 16 域已带来部分增益)与更小骨干上验证管线有效性,但完整复现主表数字需要可观的工业级资源。
论文图表
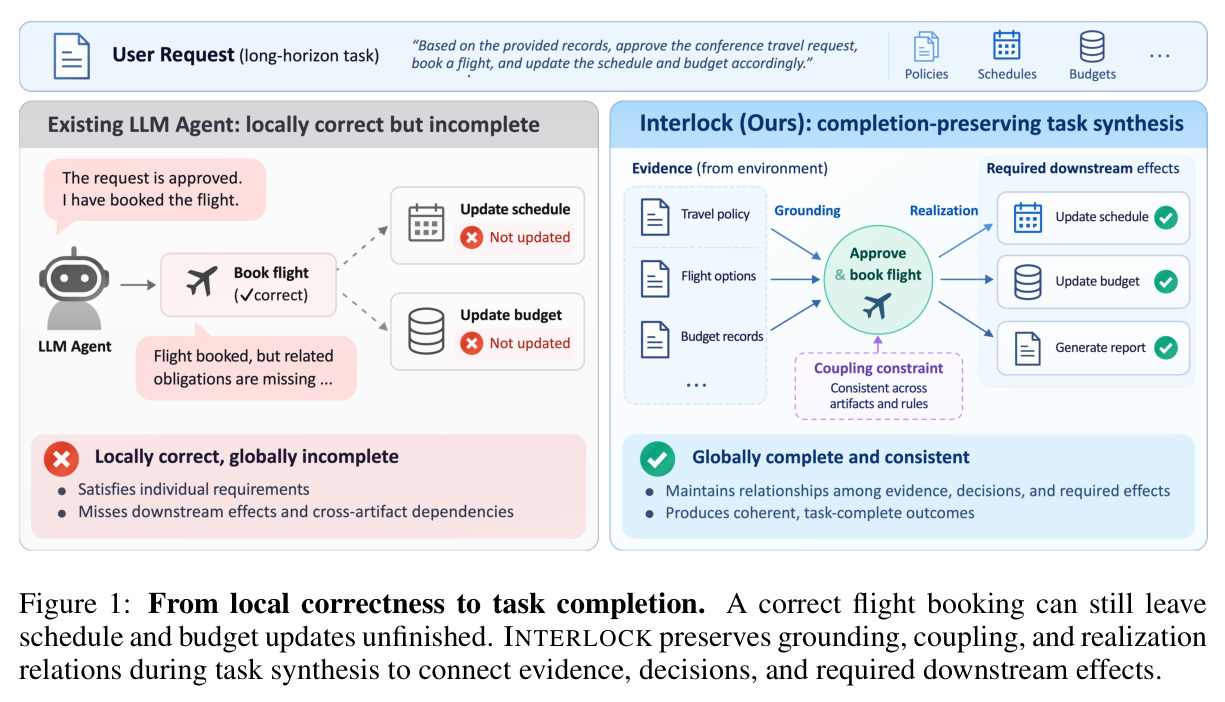
用一个机票预订的直观例子展示“局部正确但任务未完成”:预订本身正确,但日程更新与预算调整这两项下游效果没有兑现。图中标出 grounding(证据支撑决策)、coupling(组件间联合约束)、realization(决策到全部下游效果)三类关系。
这是全文问题定义的图示:完成差距不是单步错误而是关系丢失。理解这张图就理解了论文为什么要以“关系保留”为合成约束。