你的长程基准真的“深”吗?终端任务深度的度量与合成 Is Your Long-Horizon Benchmark Really Deep? Measuring and Synthesizing Depth in Terminal Tasks
提出“深度”指标度量终端任务:94%合成任务三轮内通过,新方法造出的任务前沿模型通过率不足一半
前置知识
长程终端任务(long-horizon terminal task)
指智能体在命令行终端里通过多轮交互完成复杂任务的基准形式:每轮发出一批 shell 命令,读取输出后再决定下一步,可能需要安装软件、配置服务、调试程序。一个任务通常捆绑三要素——自然语言指令、Docker 初始环境和自动验证器,验证器对环境状态做检查来判定通过与否。
本文的研究对象就是这类任务,理解“指令—环境—验证器”的结构是理解深度定义、审计方法与任务合成流水线的全部前提。
工作量与深度(Work/Depth)
源自并行计算理论(Blelloch, 1996)的一对对偶量:工作量 $W^{*}$ 是环境状态已知时完成任务所需的全部操作数(本文用参考解的非空非注释行数估计);深度 $D^{*}$ 是必须串行执行的轮数——每轮命令必须读完上一轮输出才能写出来。二者相互独立:大量可并行的独立操作可以一轮脚本做完,不构成深度。
这是全文的核心度量框架,审计与合成都围绕这两个量展开;不区分二者就无法理解“现有合成只加了工作量、没加深度”这一核心发现。
轮数上限评估(turn-capped evaluation)
测量深度的实验协议:在指令中明确告知智能体本轮任务最多可用 $T$ 轮,达到上限即强制停止,取能通过任务的最小上限作为深度估计 $D=\min\{T\in\mathcal{T}: P^{T}=1\}$,上限集合为 $\mathcal{T}=\{1,2,3,5,10,20,40,80\}$。它测的是任务本身的约束,而非模型在宽松条件下“习惯用几轮”。
这是论文测量深度的关键工具,也是审计六个数据集、证明“报告轮数严重虚高”的方法基础。
Harbor 任务格式与验证器
任务形式化为 $\tau=(I, e_0, \sigma, V)$:指令 $I$、Docker 初始状态 $e_0$、参考解 $\sigma$(shell 脚本)和验证器 $V$(一组对环境状态的检查,$V_s(e)=\bigwedge_{c\in V_s} c(e)$)。多段形式下 $k$ 个段的指令、解、验证器逐一交付于同一容器,后一段在前一段留下的状态上进行。
本文的深度估计、任务合成与验收重放全部建立在 Harbor 格式上;参考解行数即工作量估计,验证器设计规则直接决定任务能否“看见”关键步骤。
pass@1 与秩偏相关
pass@1 是单次运行通过率,先在每个任务内对多次运行取平均、再跨任务平均。秩偏相关(rank partial correlation)先把变量换成秩,再在去掉第三个变量(如工作量 $W$)的线性影响后计算两变量的相关性,用来回答“控制工作量之后,深度是否仍预测难度”这类因果式问题。
论文靠这两个统计量证明:深度而非轮数才是难度的真实预测因子(−0.31 对 +0.06),这是全文实验结论的统计支柱。
研究动机
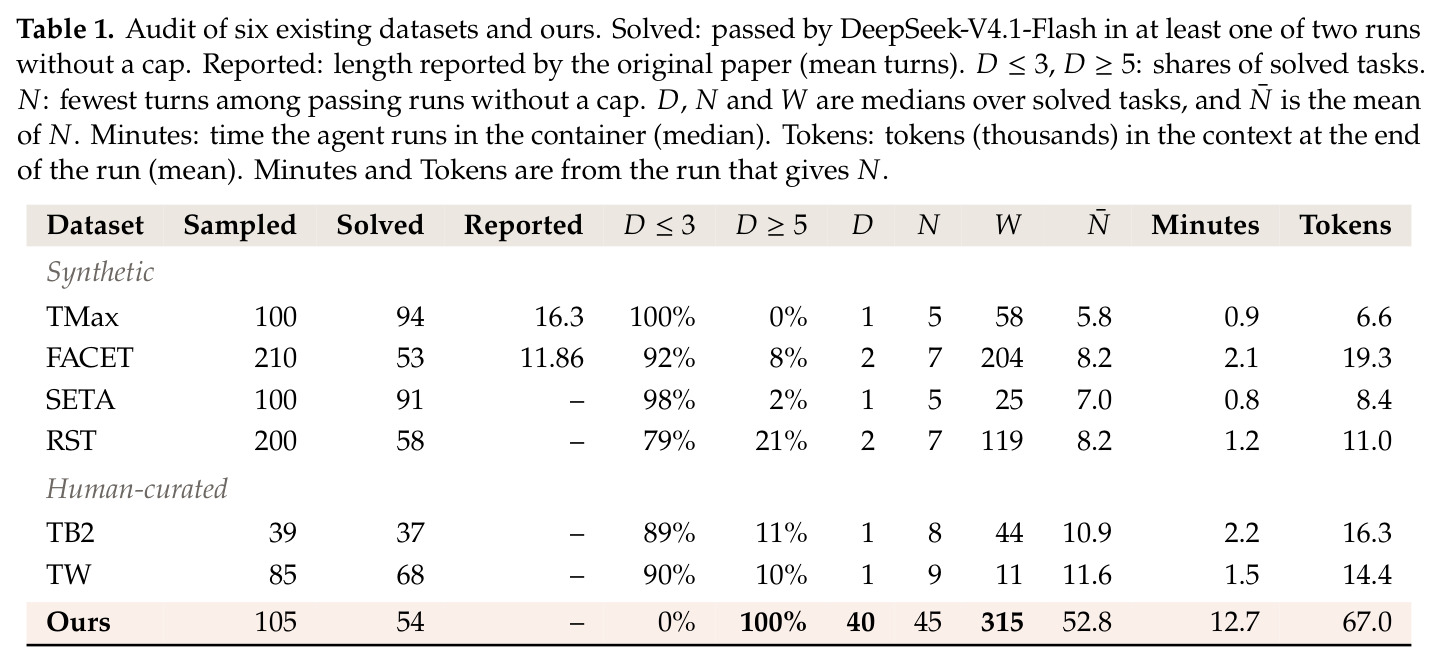
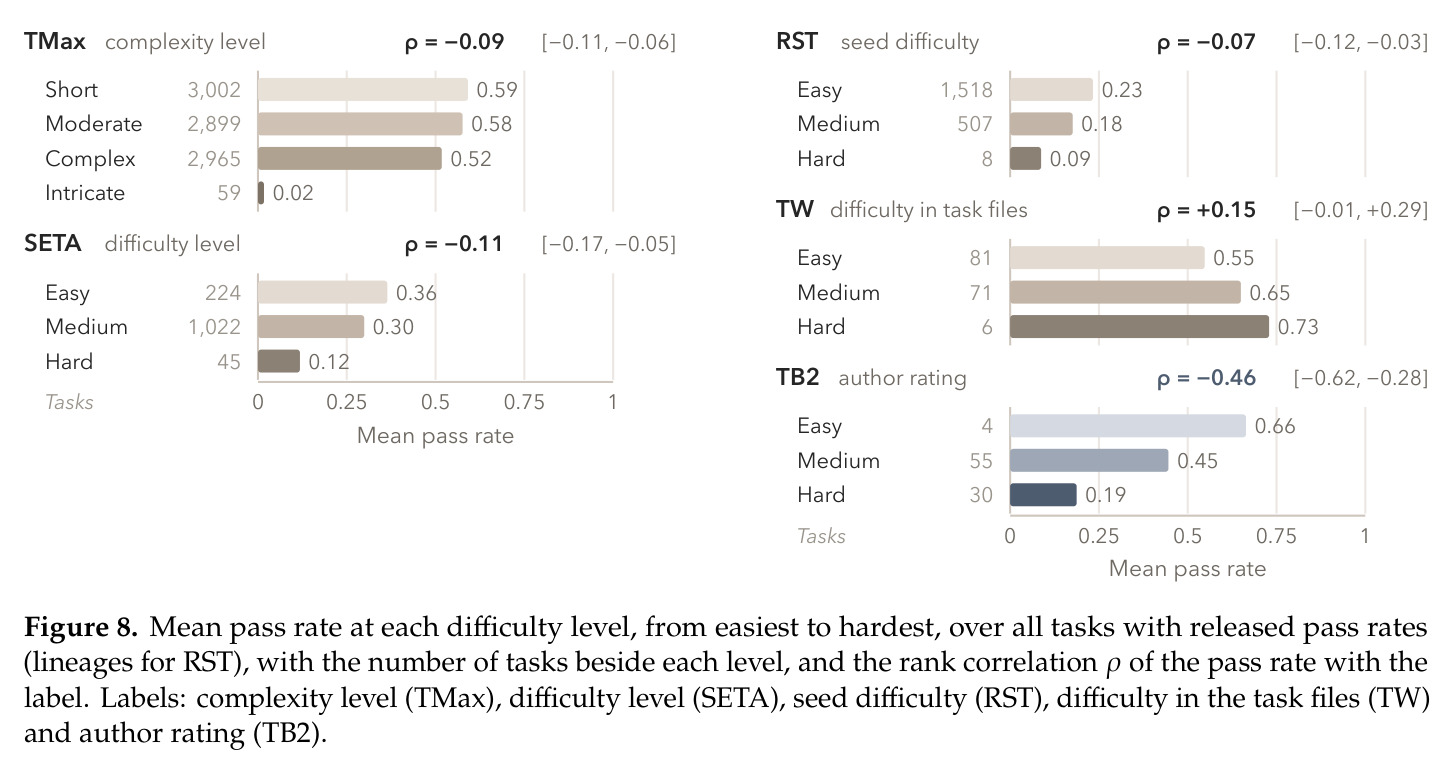
长程终端任务同时服务于智能体评测与训练,但供给两端都不健康。人工策展的数据集(Terminal-Bench 2.0、TerminalWorld-Verified)可靠却规模小、扩展昂贵;自动合成方法(TMax、SETA、CLI-Gym、FACET、RST 等)可以批量产出,但衡量“长”的方式有根本缺陷:它们普遍把任务长度报告为宽松轮数上限下模型实际使用的轮数,而轮数很大程度上反映模型习惯(爱合并还是拆分命令)而非任务需求;难度则依赖生成时 LLM 自打的标签,这些标签与真实通过率的相关只有 −0.07 到 −0.11。作者用轮数上限评估审计后发现更严重的问题:绝大多数合成任务三轮内就通过,TMax 和 SETA 近九成已解决任务深度为 1——模型第一轮就把所有命令发完、从不读任何输出,任务退化成单轮生成。例如 TMax 原论文报告平均 16.3 轮,但其已解决任务的中位深度只有 1;六数据集中无上限轮数在 6–10 之间的 170 个任务里,96 个深度为 1。无论用于评测还是训练,这类“虚长的任务”都在误导社区。
本文的目标是论文要回答“什么才让终端任务真正长”,并据此同时解决测量与合成两个问题。测量上,作者希望找到一个不依赖模型习惯、能反映任务内在结构的长度指标,用它横跨审计四个合成数据集(TMax、FACET、SETA、RST)和两个人工数据集(TB2、TW),判断合成方法是否真的造出了长任务;统计上,要验证新指标在控制工作量后仍能预测模型通过率,证明深度与难度的关联。合成上,作者要生成“工作量”和“深度”两个维度都很大的任务——既有大量操作、又必须反复读输出才能决定下一步——使前沿模型也不能轻易通过,并把评测运行产生的轨迹转化为训练数据,最终用微调小模型在既有基准上的提升来闭环验证任务质量。
与已有工作不同的是,本文的独特切入有三点。其一,借用并行计算理论中工作量 $W^{*}$ 与深度 $D^{*}$ 的区分(Blelloch, 1996),首次把终端任务的“长”拆成两个正交维度:独立操作多可以一轮脚本做完,只有“必须读了上一轮输出才能写下一轮命令”的串行依赖才构成深度。其二,用“最小通过轮数上限”而非实际轮数来测量深度,并用模型集合取最小值来避免单一模型低估;作者的关键观察是:真实深度来自环境里不可预知的软件细节——特定版本的默认配置、旧版命令行接口、真实格式的截断文件——修好一个问题常常暴露下一个,而语言模型对这类罕见且随版本变化的知识恰恰很弱。其三,据此设计“先执行再写”的分段生成:生成智能体在真实软件环境中逐段执行后再落成指令与参考解,让深度来自环境本身而非指令措辞,这是与“拼接子任务+LLM 判断依赖”类方法的本质区别。
核心方法
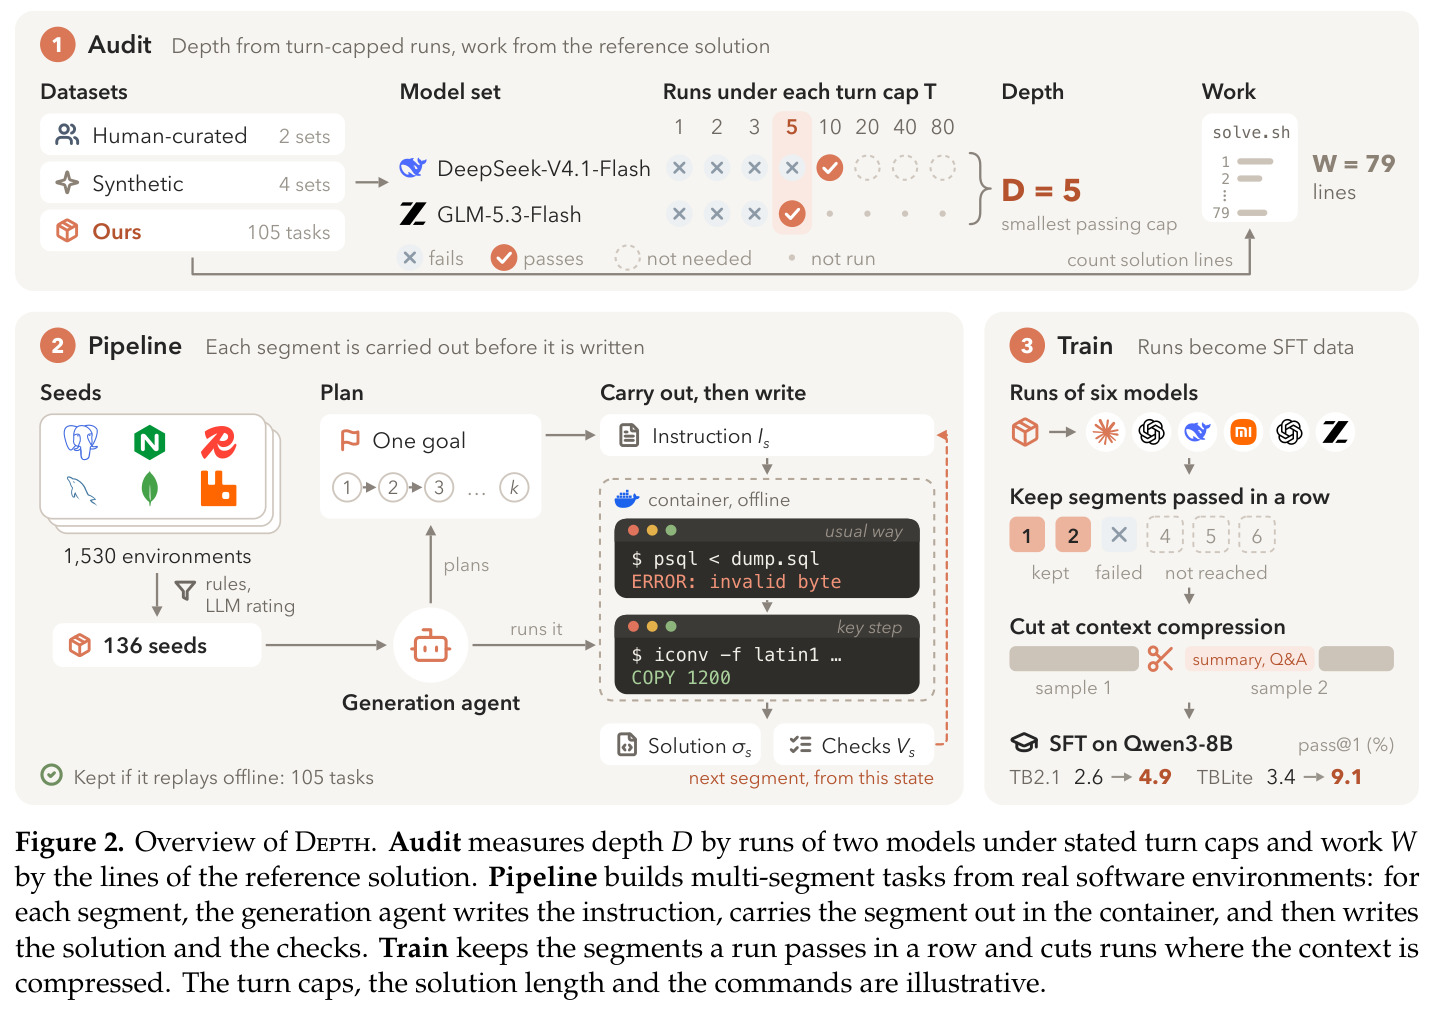
Depth 方法分测量与合成两部分。测量上,任务被形式化为 Harbor 格式 $\tau=(I,e_0,\sigma,V)$,用两个量刻画长度:工作量 $W^{*}=\min_{a\in\mathcal{A}}|a|$ 是环境状态已知时完成任务所需的最少命令行数,用参考解的非空非注释行数 $W$ 估计;深度 $D^{*}=\min_{\pi}\max_{e\in\mathcal{E}(\tau)} n_{\pi}(e)$,即最坏合法初始状态下最优策略所需的最少轮数,$\mathcal{E}(\tau)$ 是指令未言明的环境细节(版本、默认配置等)构成的初始状态集合。实证估计用轮数上限评估:在 $\mathcal{T}=\{1,2,3,5,10,20,40,80\}$ 中找最小通过上限,并用 DeepSeek-V4.1-Flash 与 GLM-5.3-Flash 两个测量模型取最小 $D$ 以免低估。合成上,生成智能体在离线真实软件环境中逐段生成任务:每段先在容器里执行、再写成指令/参考解/验证器,后一段从前一段留下的状态出发,最后整体重放验收,模型轨迹再转成 SFT 训练数据。
核心创新是“深度来自环境而非指令”这一洞见及其落实机制。已有合成流程靠拼接子任务、加跳数、按依赖图串任务,或让 LLM 读任务和轨迹判断依赖,这只能保证操作上有关联,不能保证智能体必须读输出——一个可以在批内分支解决的依赖不增加任何轮数。本文要求每段都有一个“关键步骤”:按常规做法执行会报错或静默失败、只有真正运行命令才能暴露的问题(如版本默认配置不符、latin1 编码的 dump 导入报错)。段间依赖被形式化为 $R_s=\mathrm{res}(e_s)\setminus\mathrm{res}(\tilde{\sigma}_s(e_{s-1}))$ 非空——下一段必须使用只有做完关键步骤才存在的产物,迫使评测智能体读输出、改计划。验证器则必须“看见”关键步骤:要求 $V_s(e_{s-1})=0$ 且 $V_s(\tilde{\sigma}_s(e_{s-1}))=0$,同时检查要通过软件自身接口(客户端查询、服务响应、官方校验器)而非比对具体命令。依赖不是声明出来的,而是被真实执行和重放验证出来的。
方法步骤详情
第一步,种子环境:从 TerminalWorld 的 1,530 个软件包出发,经规则过滤和 LLM 评审(软件真实性、多组件协作、少见度、可支撑段数),每类系统至多留一个,得到 136 个种子环境,全程离线以保证坑位一致、参考解可重放。第二步,分段生成:生成智能体先探索环境、规划一个真实用户会追求的总目标并切成 $k$ 段(3–6 段);对每段 $s$,先写指令 $I_s$(只说目标、交付物与约束,检查依赖的名字逐字出现但不透露解法),再在容器中实际执行该段,然后据软件的真实行为写参考解 $\sigma_s$ 与验证器 $V_s$;同时用干净容器重放 $e_s=\sigma_s(e_{s-1})$,确保解不依赖手工改动。第三步,依赖构造:每段必须含关键步骤,$s<k$ 时下一段必须使用 $R_s$ 中的产物,末段做全系统操作且早期成果保留。第四步,验收:离线重放完整参考解,每段 $V_s(e_s)=1$ 才接受,77% 通过。第五步,训练:收集六个模型共 1,272 条无上限运行,保留从头连续通过的段,在上下文压缩点切分接续,得到 4,941 条样本微调 Qwen3-8B。
技术新颖性
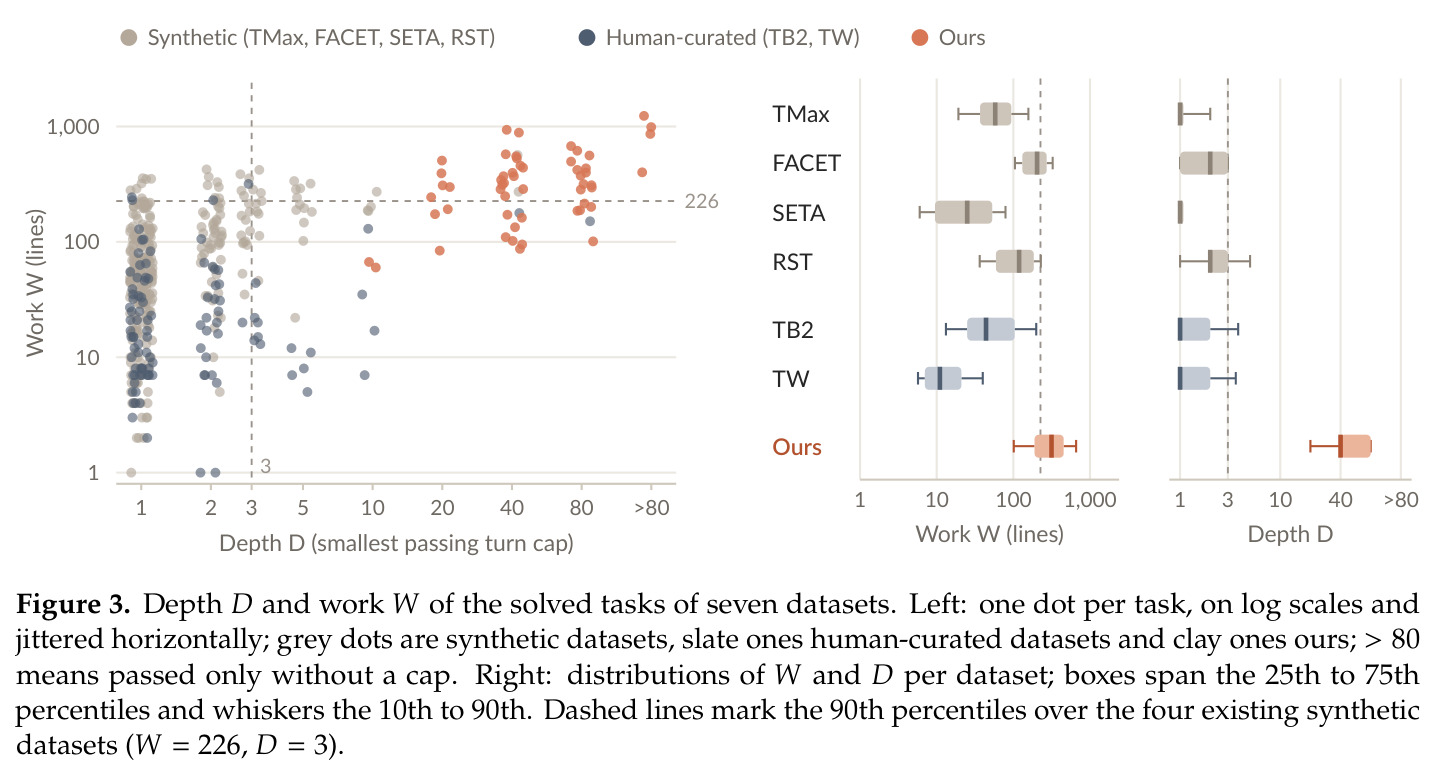
技术新颖性体现在四个层面。度量层面:首次把并行计算的 work/depth 框架引入智能体基准分析,证明“最小通过轮数上限”是可操作、可跨数据集比较的深度估计量,并用模型集合取最小来控制模型习惯造成的偏差——加入 GLM-5.3-Flash 使 25% 现有任务和 7% 本文已解决任务的 $D$ 下降。审计层面:用同一把尺子横跨四个合成与两个人工数据集共 734 个任务,首次量化出“合成只加了工作量没加深度”(296 个已解决合成任务中 94% 深度 $\le 3$)。合成层面:先执行再写的分段生成把依赖从“声明”变成“执行产物”,配合关键步骤与验证器三规则,实测 99.0%(598/604)的验证器能检测关键步骤缺失、84.2%(421/500)的情况下删掉关键步骤会让下一段失败。统计层面:用秩偏相关在控制工作量后证明深度独立预测难度(−0.31),而轮数不能(+0.06),为“报告深度而非轮数”给出实证依据。
实验结果
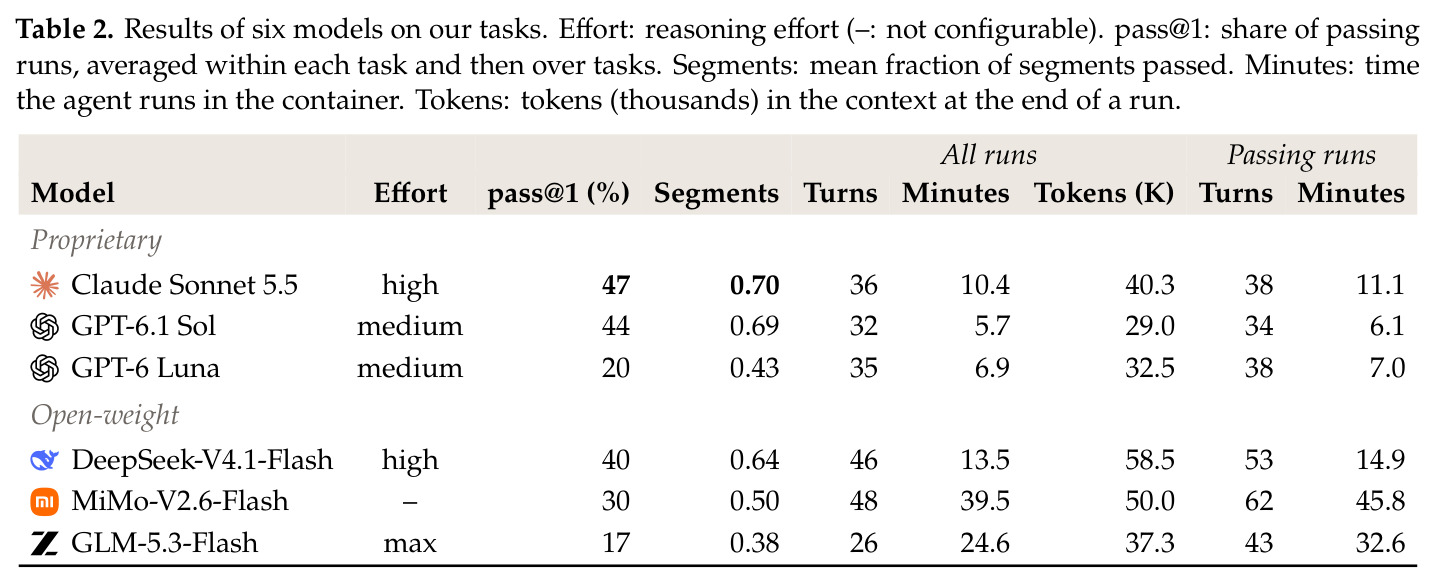
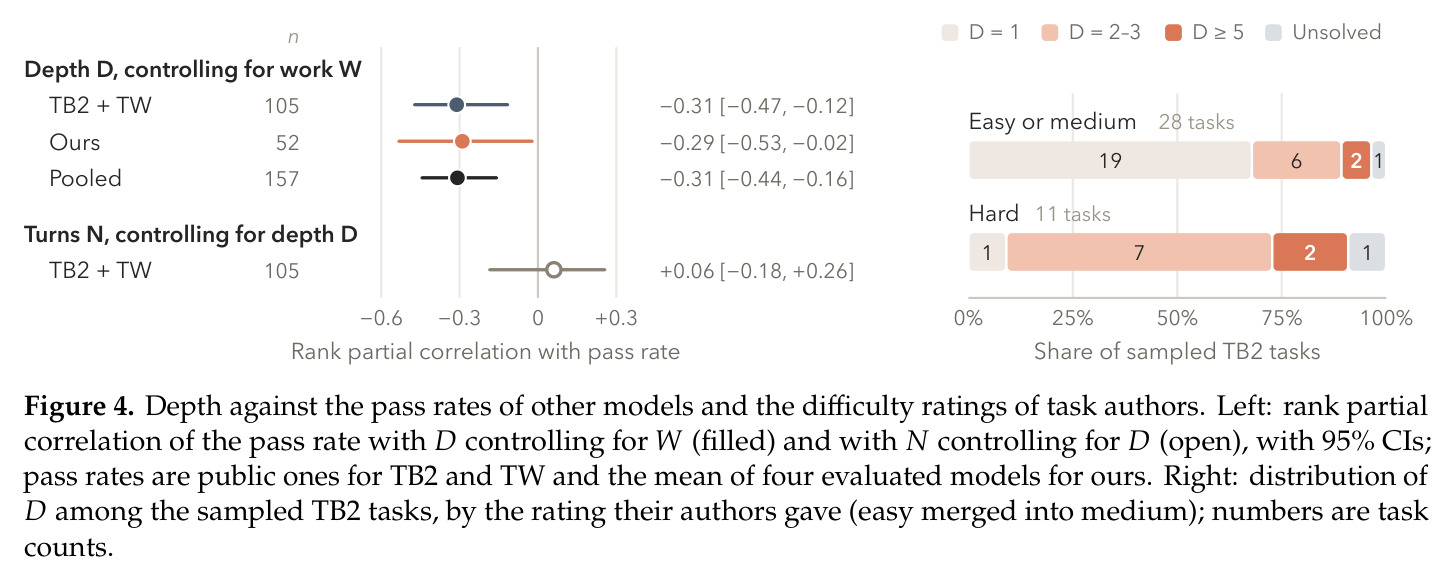
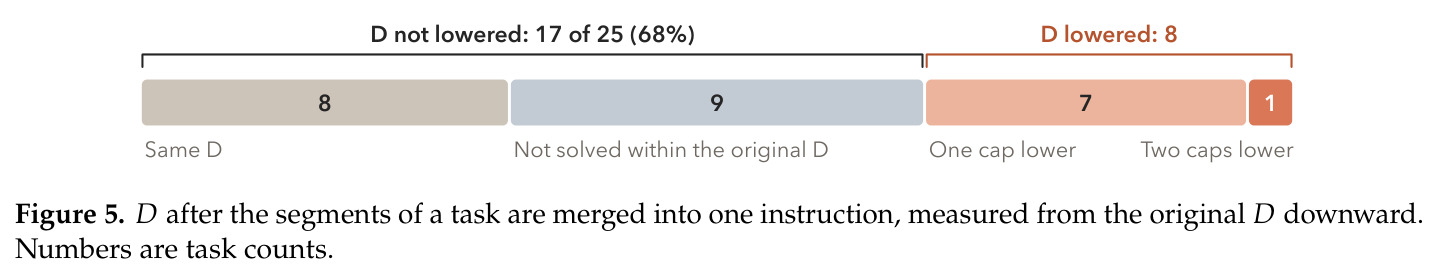
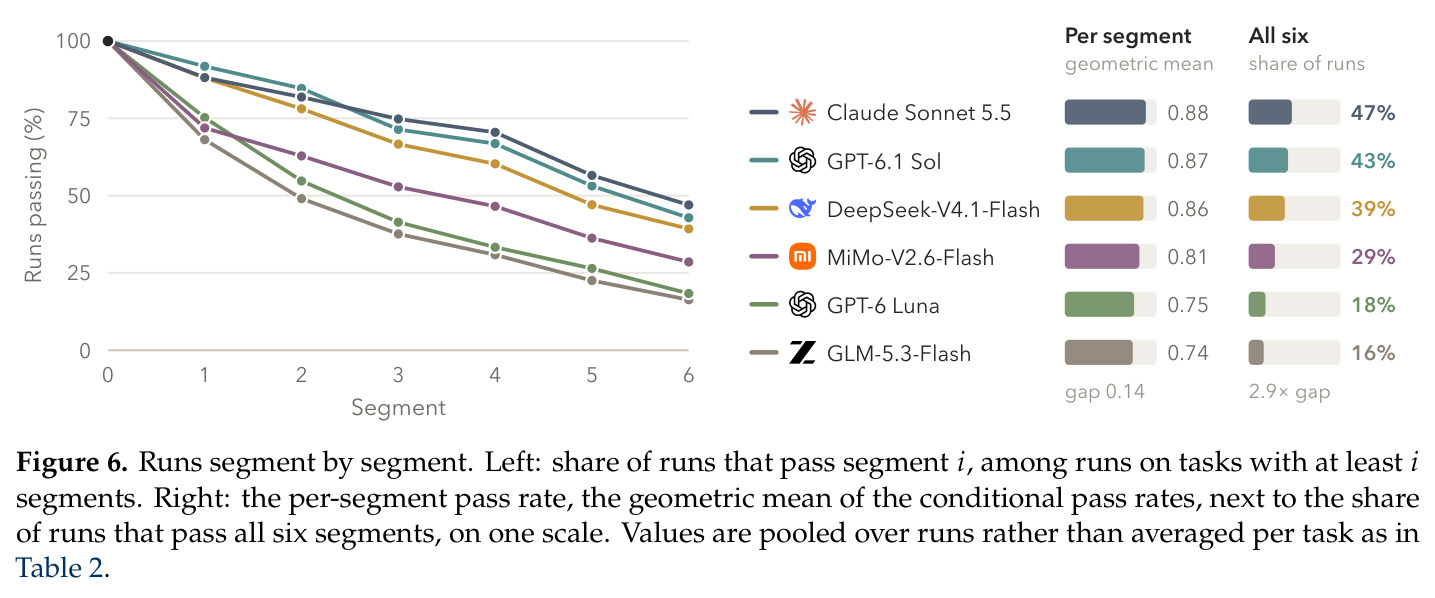
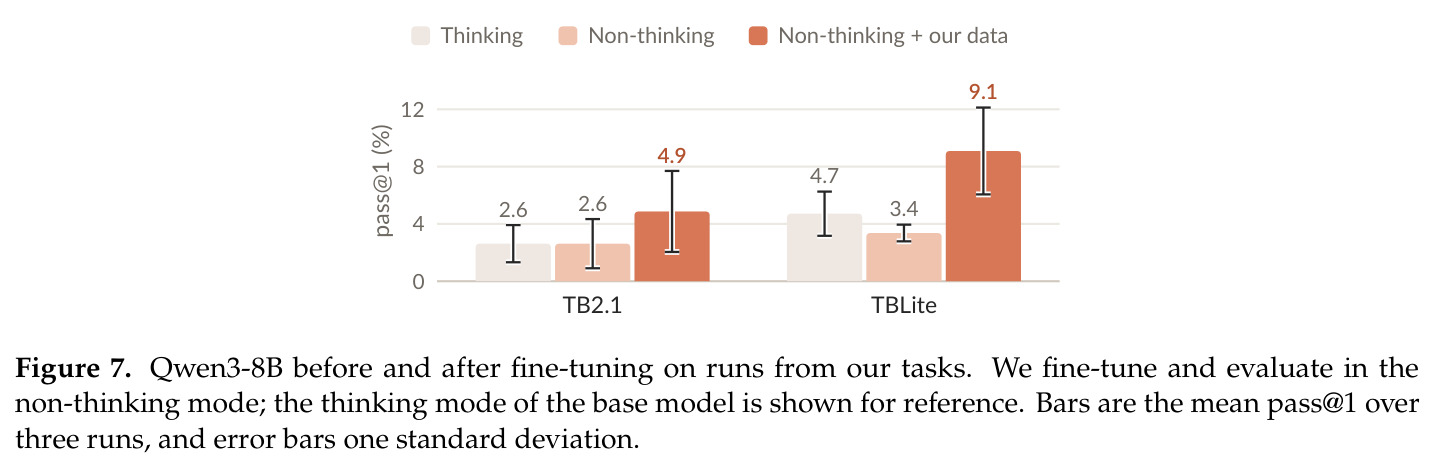
审计:734 个抽样任务中,296 个已解决合成任务的 94% $D\le 3$,TMax 与 SETA 近九成 $D=1$,仅 6% 达 $D\ge5$、低于人工策展的 10%。深度预测难度:控制工作量后通过率与 $D$ 的秩偏相关为 −0.31,本文任务 −0.29;轮数 $N$ 控制 $D$ 后仅 +0.06 不显著;TB2 作者评级与 $D$ 相关 +0.55,LLM 生成标签仅 −0.07 到 −0.11。新任务共 105 个、3–6 段:中位 $W=315$ 行、中位 $D=40$,44/54 个已解决任务 $D\ge40$;25 个任务合并成单指令后 68% 深度不降;与同环境原任务配对 35 对全部更深($p=5.8\times10^{-11}$)。模型评测:pass@1 从 GLM-5.3-Flash 的 17% 到 Claude Sonnet 5.5 的 47%,无一过半,29 个任务无模型通过;单段可靠性 0.88 对 0.74,六段后放大 2.9 倍。微调 Qwen3-8B:TB2.1 上 2.6%→4.9%,TBLite 上 3.4%→9.1%,均超思考模式。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Qwen3-8B 用本文任务轨迹 SFT 后在 Terminal-Bench 2.1 评估 | pass@1(每任务 3 次运行) | 4.9% | 基模型非思考模式 2.6%(思考模式 2.6%) | +2.3 个百分点,约 +88% 相对提升 |
| Qwen3-8B 用本文任务轨迹 SFT 后在 OpenThoughts-TBLite 评估 | pass@1(每任务 3 次运行) | 9.1% | 基模型非思考模式 3.4%(思考模式 4.7%) | +5.7 个百分点,约 +168% 相对提升,且超过思考模式 |
| 本文 105 个深度任务上评测六个前沿模型 | pass@1 | 最高 Claude Sonnet 5.5 47%,GPT-6.1 Sol 44%,DeepSeek-V4.1-Flash 40% | 最低 GLM-5.3-Flash 17%,GPT-6 Luna 20%;90 个任务中 29 个无模型通过 | 所有模型通过率低于 50%,模型区分度达 30 个百分点 |
| 审计四个合成数据集(TMax/FACET/SETA/RST,共 610 个抽样任务) | 中位深度 D 与 D≤3 占比 | 中位 D 仅 1–2,94% 已解决任务 D≤3,中位工作量 68 行 | 原论文报告的平均轮数 11.86–16.3 轮 | 揭示报告轮数约为真实深度的 5–16 倍,虚高严重 |
局限与改进
作者承认深度估计 $D$ 依赖测量模型集合、harness(terminus-2)和单一初始状态 $e_0$,是估计而非下界——加入第二个测量模型就使 25% 现有任务的 $D$ 下降;未解决任务无法给出估计,本文任务仅 54/105 被解决,深度统计只覆盖已解决子集。审计排除了需要 GPU、大下载或特权容器的任务,种子只来自 TerminalWorld 一个来源。我自己的观察:工作量用参考解行数是粗糙代理,不反映单条命令的语义复杂度;轮数上限是明确告知智能体的,模型在不知上限时的行为可能不同;TB2 抽样仅 39 个任务,人工策展侧样本偏小;段合并实验只有 25 个任务;TB2.1 上 +2.3 个百分点的绝对提升幅度小,训练收益的统计功效有限。
独立分析的弱点
第一,深度测量是“用模型测模型”:测量集合里的两个模型能力有限,换成更强的模型集合后 $D$ 的分布可能整体下移,跨论文比较仍需统一模型与 harness,且文中未给出每个任务 $D$ 的置信区间。第二,工作量代理太粗糙:行数不区分一条 trivial 的 echo 与一段复杂的数据迁移,两个高 $W$ 任务的实际认知负担可能相差悬殊,这也削弱了“控制 $W$ 后比较 $D$”的说服力。第三,验收依赖重放参考解,只能保证参考解路径上的关键步骤可检测,不能排除智能体找到绕过检查的非预期解;验证器“通过软件接口观测”的规则缓解但不杜绝。第四,任务全部离线、无网络访问,与真实运维场景(联网装包、云服务交互)有差距;105 个任务对一个基准来说规模仍小,深度分辨率受上限集合 $\{1,2,3,5,10,20,40,80\}$ 的粒度限制,$D$ 只能落到 8 个档位。改进方向:用多模型集合给出 $D$ 的区间估计;引入执行代价加权的工作量度量;加密上限档位;加入联网环境并扩大合成规模。
未来方向
作者最直接的呼吁是:基准与训练数据构建者应在轮数之外同时报告深度与工作量。可延伸的方向包括:把深度框架推广到其他智能体领域(网页、GUI、SWE-bench 式代码仓库任务),定义领域相应的工作量与深度代理;用深度可控的任务做课程学习或 RL 奖励设计,研究“深度能力是否可教”;训练一个不运行模型就能预测深度的廉价代理模型,降低测量成本(当前每个任务要在 8 个上限 × 2 个模型下运行);扩大种子环境来源与任务规模,刻画任务深度与训练收益之间的 scaling 关系;探索“关键步骤”的自动化挖掘,例如用故障注入或混沌工程手段系统性地制造环境级意外;微调实验也提示深度轨迹对单指令基准有迁移效应,值得在更大模型和 RL 阶段进一步验证。
复现评估
复现条件较好。论文提供了 Code 与 Dataset 链接,任务基于公开的 Harbor/terminus-2 框架和 TerminalWorld 的 1,530 个环境包构建;生成本身成本很低——136 个种子共 $113.66,接受 105 个任务,合约 $1.08/个,不需要专用训练算力。真正的开销在评测与深度测量:每个任务要在 8 个轮数上限 × 2 个测量模型下运行,本文任务单次运行容器时间中位 12.7 分钟、结束时上下文约 6.7 万 token,审计 734 个任务的总量可观但用 API 可承受;微调部分为 4,941 条样本训练 Qwen3-8B,8B 规模少量 GPU 即可完成。主要门槛是 DeepSeek-V4.1-Flash 与 GLM-5.3-Flash 的 API 访问、Docker 环境以及离线重放的一致性维护。总体难度中等:无特殊硬件要求,工程量主要在环境搭建与批量评测调度。
论文图表
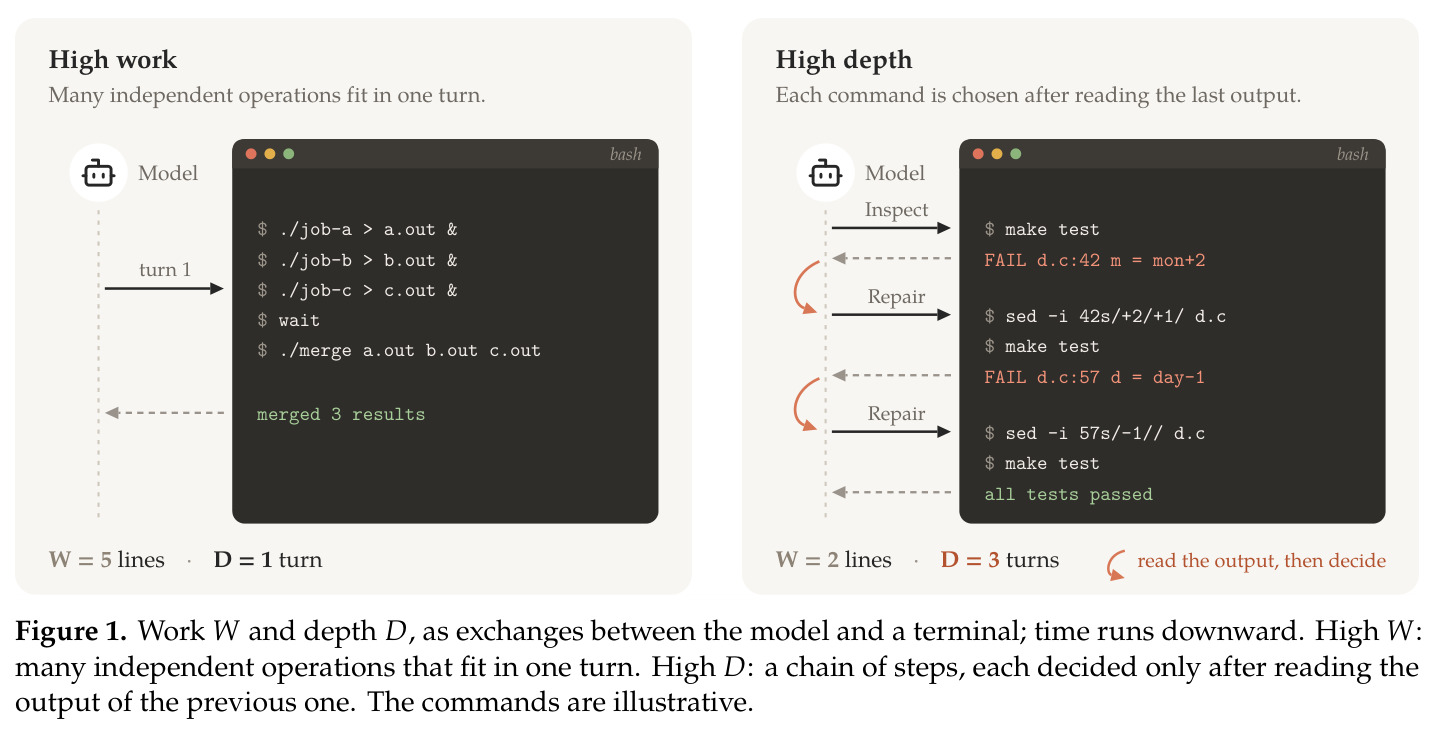
左右对照两种任务形态:高工作量例子里模型在第一轮并行发起三个作业再合并结果(W=5 行命令,D=1 轮,因为操作相互独立);高深度例子里模型先跑测试、读到失败行号后修一处、再跑测试、再修下一处(W=2 行,D=3 轮),每条命令都必须读完上一轮输出才能写出。
用最直观的对比例子定义了全文最核心的两个量——工作量和深度,说明“操作多”和“必须串行读输出”是两回事,是理解后续审计与合成方法的概念基础。