面向长程终端智能的智能体数据规模化合成 Scaling Agentic Data for Long-Horizon Terminal Intelligence
自动合成保留探索-修正-验证全程行为的长程终端数据,3K轨迹SFT在12个基准全面领先
前置知识
终端智能体(Terminal Agent)
在命令行/终端这一通用接口中自主完成任务的 LLM 智能体。终端把代码、数据、工具和执行反馈汇聚到同一工作区,智能体通过发出 shell 命令、读取输出、迭代修改来推进任务,被广泛用于软件开发、系统运维和科学计算。其执行回路通常由 harness(如本文使用的 Terminus-2)驱动:模型每轮生成动作,环境返回观察,循环往复直到私有验证器对最终状态打分。
本文的任务环境、训练轨迹与评测基准(Terminal-Bench 等)全部构建在终端交互界面上,不理解这一载体就无法理解轨迹与长程的含义。
长程轨迹与智能体行为模式
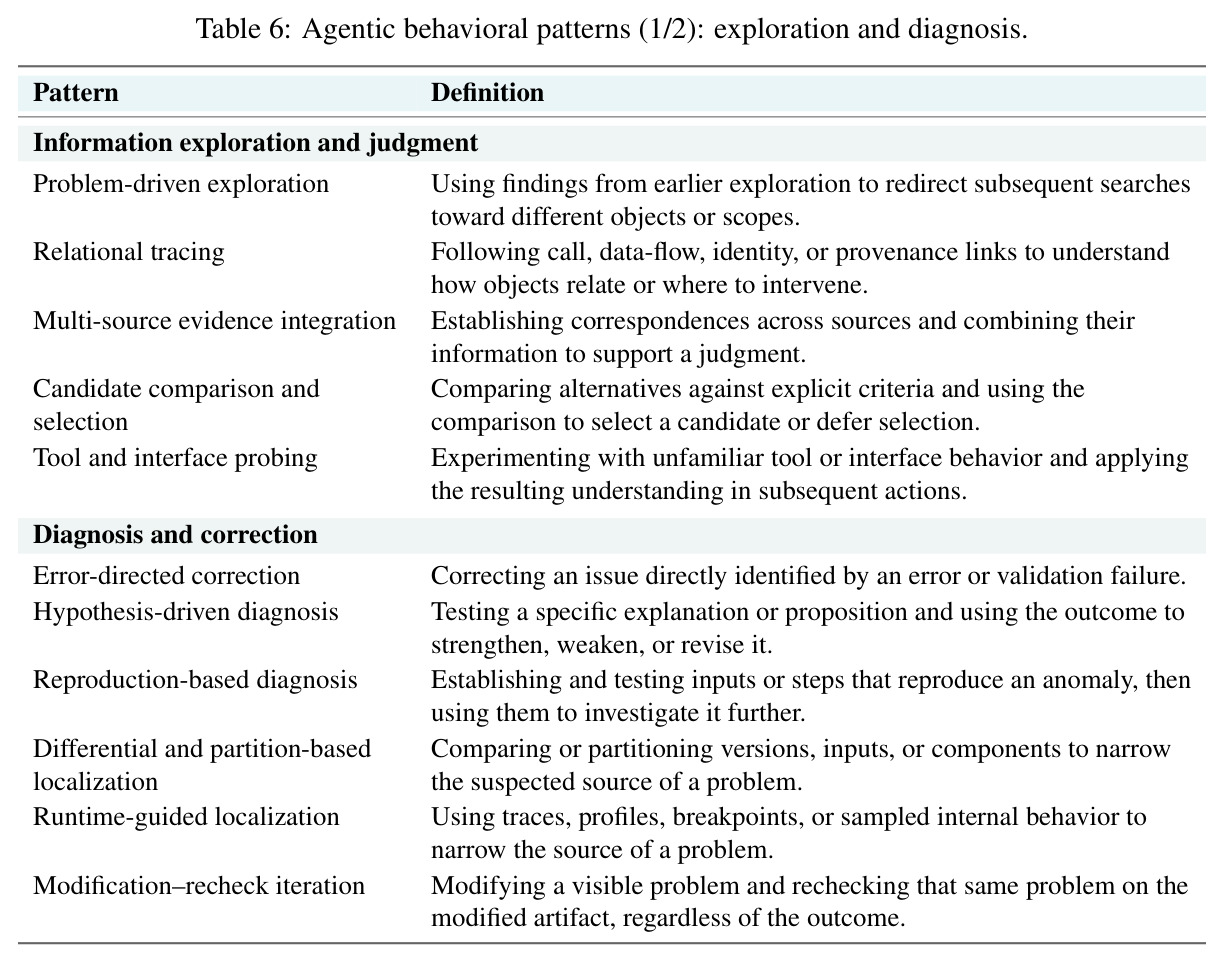
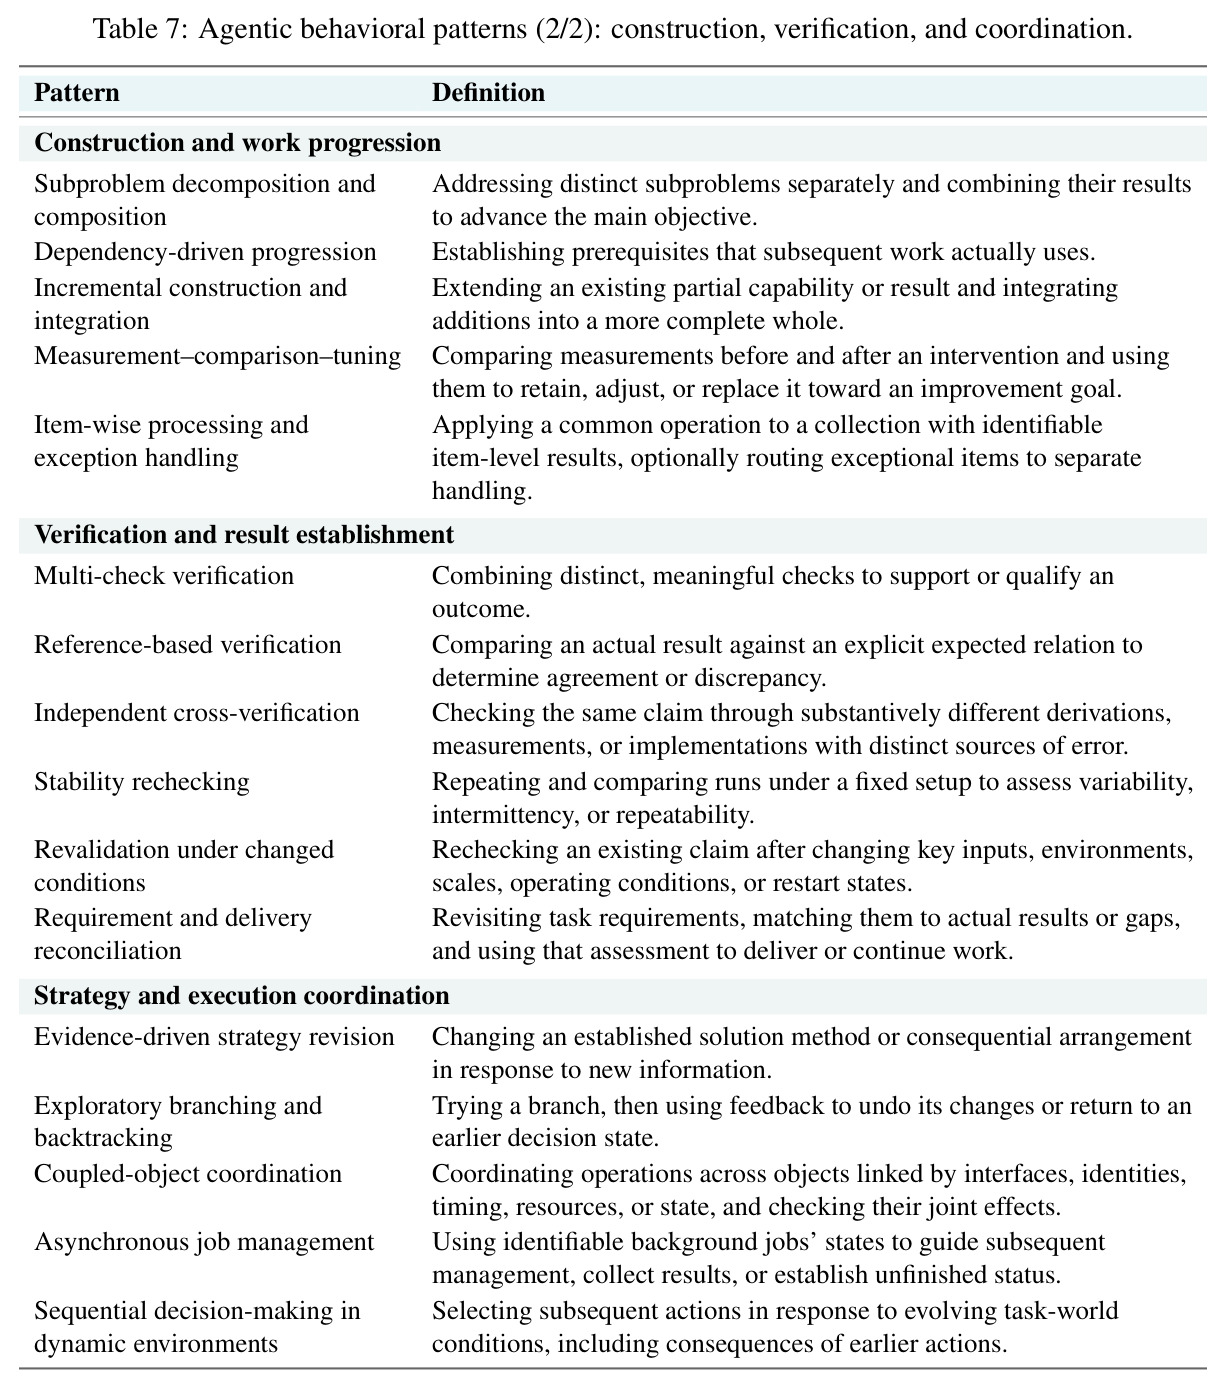
短轨迹只演示几步命令调用;长程轨迹则覆盖持续数十轮的问题求解过程。作者把其中可复用的行为结构归纳为 27 种行为模式,分五大类:信息探索与判断、诊断与纠错、构建与推进、验证与确证、策略与执行协调,例如关系追踪、假设驱动诊断、修改-复查迭代、多路校验等。模式描述的是动作-观察-后续决策之间的连接结构,而非孤立的命令。
论文的核心论点是训练价值来自这些模式及其跨阶段连接,这是理解其合成引擎设计目标的前提。
任务包形式化 $T=(I,E,S,V,M)$
论文把可执行终端任务抽象为五元组:公开指令 $I$、可执行环境 $E$、参考解 $S$、私有验证器 $V$、执行配置 $M$;智能体执行时只能看到公开部分 $P(T)=(I,E)$,通过交互收集信息,最后由 $V$ 评分。论文要求验证器检查的完成条件必须能从公开指令与环境的可发现证据推出,即 $C_{\mathrm{sem}}(V) \subseteq \mathrm{Sem}(I, O_{\mathrm{pub}}(E))$——测试数据可以私有,但评分不得引入智能体无法发现的要求。
这一形式化贯穿构建、挑战、重构、扩展每个环节,是读懂方法章节的骨架。
教师轨迹蒸馏与 SFT
用强模型(教师)在环境中解题并记录完整的动作-观察序列,再对轨迹做质量筛选,用监督微调把解题行为注入学生模型。本文用 DeepSeek-V4-Pro-0813 作教师、Terminus-2 作执行框架,每任务采 2 条轨迹,由 LLM 审查者按过程导向标准过滤后保留 2,852 条,对 Qwen3.5-27B 做 3 个 epoch 的全参数 SFT。
本文的模型改进完全来自 SFT(无 RL),数据质量与教师能力直接决定效果上限,是评估其结果的基础。
RSI(递归自我改进)与 RSI-Exam
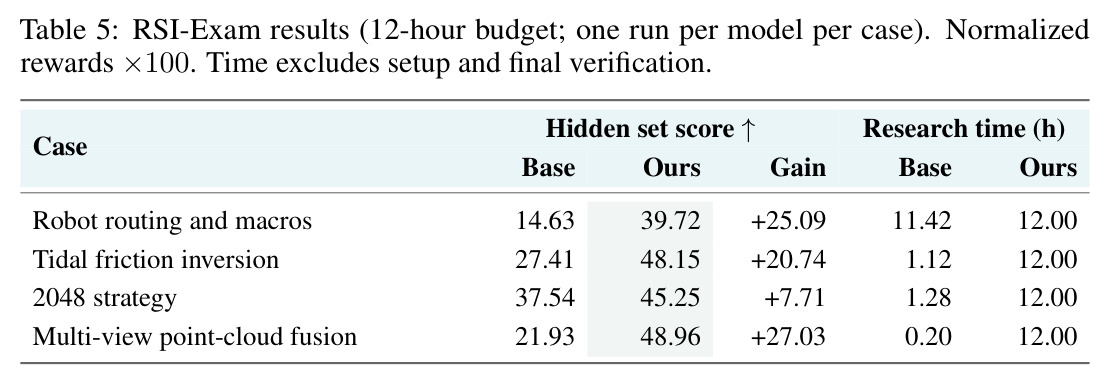
RSI 任务要求智能体在得到初始可行解后继续实验:设计更有信息量的诊断实验、依据反馈修正方法、并把有效改进保留到最终交付物中。RSI-Exam 是对应的长程研究型基准,本文给每个案例 12 小时自主研究预算,用隐藏测试集给最终提交评分,案例包括多视角点云融合、潮汐摩擦场反演、2048 策略优化、仓库机器人路由与宏压缩。
RSI 案例是论文展示长程行为模式带来质变的最直观证据,也是理解其核心主张的关键。
研究动机
终端智能体的训练数据长期短缺。现有终端环境合成方法(技能组合、技术证据接地、递归扩展等)虽然扩大了任务覆盖面,但产出的轨迹平均都很短:论文在同一教师协议下实测,Endless Terminals 平均只有 3.87 轮、Terminal-Lego 4.50 轮、最长的 CLI-Gym 也仅 15.60 轮。短轨迹只能教会模型执行 ls、cat、grep 这类局部操作,无法展示智能体如何跨阶段积累证据、依据反馈修正策略、把中间结果变成最终交付物。更关键的是,任务更复杂并不等于预期行为会出现:环境合成本身可能提前完成或简化了本应由智能体执行的关键工作。论文附录 H 给出了实证:射电干涉定标任务初始构建时把 solve-bandpass、solve-gain 等数值拟合工具直接打包进环境,独立挑战者虽通过了任务,却完全跳过了实现定标算法的核心工作;福利登记任务中待审文档已被标为已核验,智能体只需按固定序列操作。这些缺口使采集到的轨迹缺乏真实存在的探索、实现与验证过程。
本文的目标是目标是构建一个全自动的数据合成引擎,使生成的任务环境真正保留而非预支智能体应完成的工作,并让探索、诊断、构建、验证、策略协调这些行为模式在单次问题求解过程中真实出现且跨阶段连接。量化目标包括:自动构建约 1.5K 个任务环境、采集约 3K 条长程训练轨迹,平均交互轮数大幅超过现有方法的 3-15 轮;仅用这些数据做 SFT,使 Qwen3.5-27B 在覆盖编码智能体、真实生产力任务和通用推理的 12 个基准上全面超越基座模型;并通过多个 12 小时预算的 RSI 案例验证模型能超越初始解持续实验、依反馈改进方法、并把有效改进保留到最终交付物中。
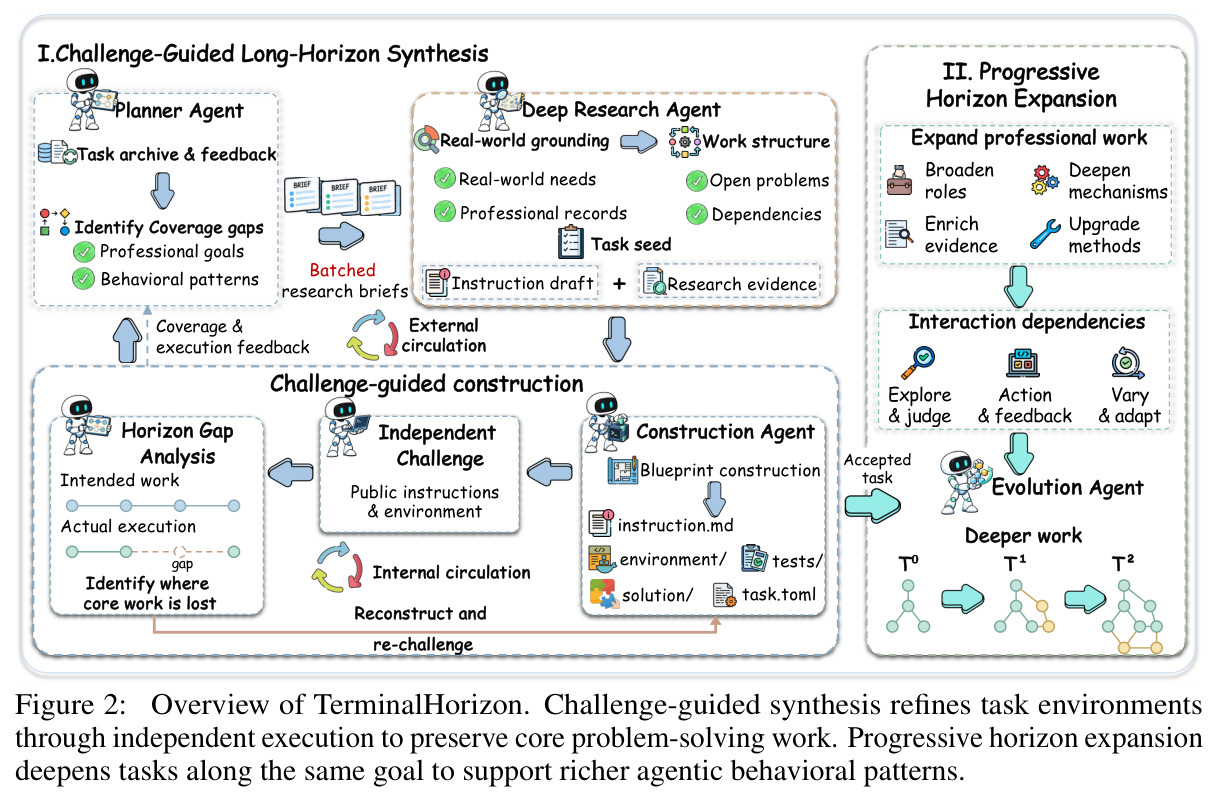
与已有工作不同的是,本文的独特切入角度是把数据质量的评价标准从任务难度与覆盖面转向行为模式及其跨阶段连接。已有工作用技能组合或递归参考解扩展增加复杂度,但从不检验预期行为是否真的发生在解题过程中。本文为此引入两个机制:一是独立挑战——让一个未参与构建的智能体仅凭公开部分 $P(T)$ 解题,用真实轨迹诊断构建阶段遗漏或预支了哪些工作(Horizon Gap Analysis),据此重构环境,形成任务级内循环与批间外循环;二是同目标渐进扩展——不更换任务,而是在同一目标下引入必须依赖先前结果与执行反馈的新需求,让行为模式自然延伸到后续阶段,而非靠更难的题目或更多的交互轮数硬凑长度。这种以执行证据驱动环境重构的闭环是已有合成方法都缺失的。
核心方法
直觉上,这套引擎像一个严格的出题-试做-返工-加码流程:先从真实职业工作出发出题,请一位与出题无关的考生试做;如果考生发现题目早已替他完成了关键步骤,就把题返工,把关键工作还给考生;题目合格后再在同一目标下追加新要求,且新要求必须建立在此前结果之上。技术上分两阶段。阶段一为挑战引导的长程合成:Planner 智能体根据已接受任务集 $D_b$ 与累积记录 $F_b$ 生成研究简报 $Q_b=\mathrm{Plan}(D_b,F_b;n_b)$;Deep Research 智能体调研文档、代码库、issue 与专业资料形成任务种子;Construction 智能体据此联合构建任务包 $T=(I,E,S,V,M)$;随后独立挑战者仅凭 $P(T)$ 执行,产出轨迹 $\tau_r$、验证得分 $\rho_r$ 与诊断 $d_r$,用于差距分析与重构 $T_{r+1}=\mathrm{Refine}(T_r;z,\tau_r,d_r)$,循环直到通过审查。阶段二为渐进水平扩展:Evolution 智能体在已接受的父任务上沿四个方向提出扩展提案 $\delta^{(g)}$,生成候选 $\tilde{T}^{(g+1)}=\mathrm{Expand}(T^{(g)};\delta^{(g)})$,验收后成为下一代的父任务。
核心创新是任务通过不等于预期工作发生这一洞察及其工程化。已有合成方法默认任务可解且可验证就足够,但环境可能在构建时就替智能体完成了探索、实现或验证。本文用独立挑战者的真实轨迹作为证据来检测这一点:比较任务种子规定的预期工作与轨迹中实际发生的工作,把被省略的工作追溯到初始材料、对象关系或工具行为上的具体构建选择,然后精准重构——例如删掉环境内置的拟合程序、把故障安装移到客户端启动之前使应用层恢复路径真正被触发——同时保持公开规格不变。第二个创新是扩展方式:不靠更难的任务或更多轮次,而是在同一目标下引入必须消费先前证据、动作效果和实例状态的新需求,通过三种交互依赖设计(证据依赖决策、动作-反馈链接、实例变异与适配)让行为模式跨阶段连接,而非每个阶段重新开始。这把数据质量从静态属性变成了可用执行证据检验和迭代的动态过程。
方法步骤详情
完整流程分七步。第一步批量规划:Planner 读取已接受任务的目标、解法与反馈及历史研究审查记录,为每批产出 $n_b$ 份研究简报,指定工作范围、未覆盖的需求与待调研的真实来源。第二步深度研究:Deep Research 智能体按简报调研文档、代码库、issue 与专业资料,确定智能体需要发现什么、哪些问题需进一步分析/实现/调试、一个结果如何支撑后续工作,产出任务种子 $z_{b,i}$(公开指令草案加支撑证据)。第三步联合构建:Construction 智能体从种子合成具体实例,控制初始状态与验证条件,联合生成指令、环境、参考解、验证器与执行配置,满足 $C_{\mathrm{sem}}(V)\subseteq\mathrm{Sem}(I,O_{\mathrm{pub}}(E))$。第四步独立挑战:未参与构建的挑战者仅凭 $P(T_r)$ 执行,$\tau_r\sim\mathrm{Rollout}(\pi_B;P(T_r))$,验证器给出 $\rho_r$,综合审查 $d_r=\mathrm{Asyn}(T_r,\tau_r,\rho_r)$ 记录运行缺陷、信息泄漏、评分不一致及预期工作是否保留。第五步差距分析与重构:对比种子与轨迹,把遗漏工作归因于构建选择,用 $T_{r+1}=\mathrm{Refine}(T_r;z,\tau_r,d_r)$ 修订初始状态、对象关系、实现要求或工具反馈,回到第四步复检;通过的任务并入 $D_{b+1}$,反馈更新 $F_{b+1}$ 供下批规划。第六步渐进扩展:Evolution 智能体沿更广角色、更深机制、更丰富证据、方法升级四个方向提案,选择三种交互依赖设计落地,生成并验收 $T^{(g+1)}$。第七步轨迹采集与过滤:以 DeepSeek-V4-Pro-0813 为教师、Terminus-2 为框架每任务采 2 条轨迹,由 gpt-5.6-luna 按轨迹有效性、环境接地的进展、多轮训练价值三项标准审查,从约 3,070 条中保留 2,852 条构成 TerminalHorizon-3K。
技术新颖性
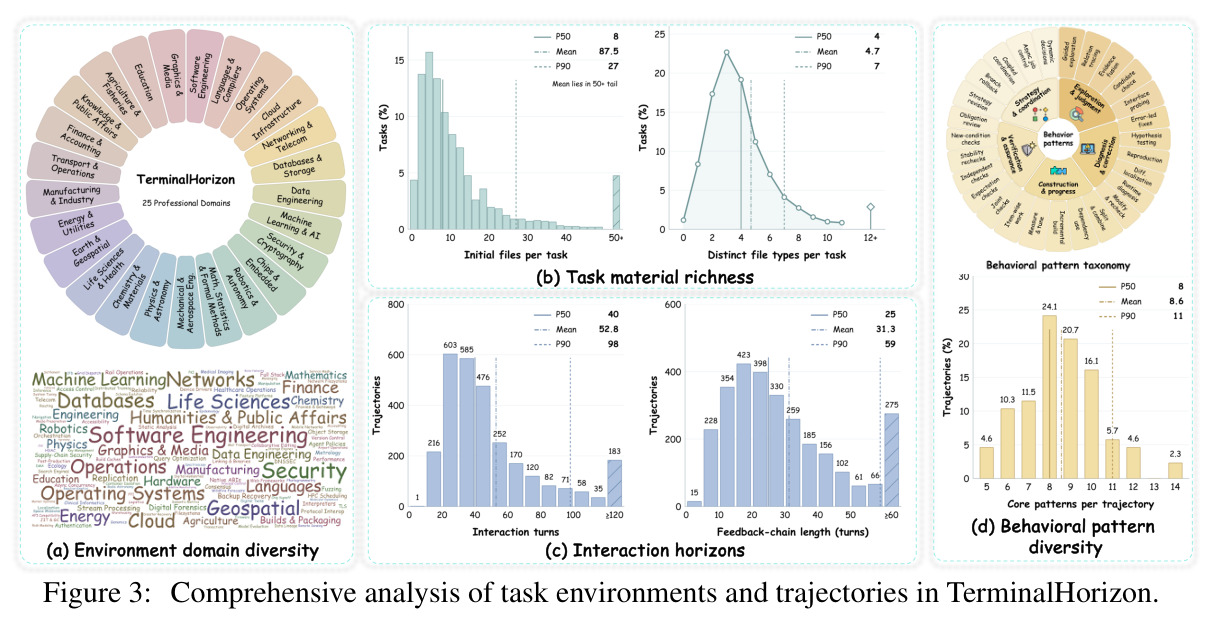
与已有工作的具体区别有四点。其一,相对技能组合类方法(Terminal-World、SkillSynth、CLI-Universe 等)与证据接地合成(FACET 等),本文不只扩展任务覆盖,而是用独立执行证据检验预期行为是否在解题中真实发生,并以重构闭环修复被预支的工作——从生成任务升级为验证行为保留。其二,相对递归参考解扩展(RST)靠堆复杂度拉长轨迹,本文靠同目标下依赖先前结果的新需求让模式自然延伸,轨迹长度是行为连接的副产品(平均 52.8 轮、P90 98 轮)。其三,轨迹过滤采用过程导向三标准,明确允许保留含失败与纠错的未完成任务,而非只按最终成败取舍。其四,提出 27 种行为模式、五大类的分类学,为什么是高质量长程数据给出了可操作的定义与标注框架,并用中位 25 轮的连续反馈动作链等指标度量模式连接强度。
实验结果
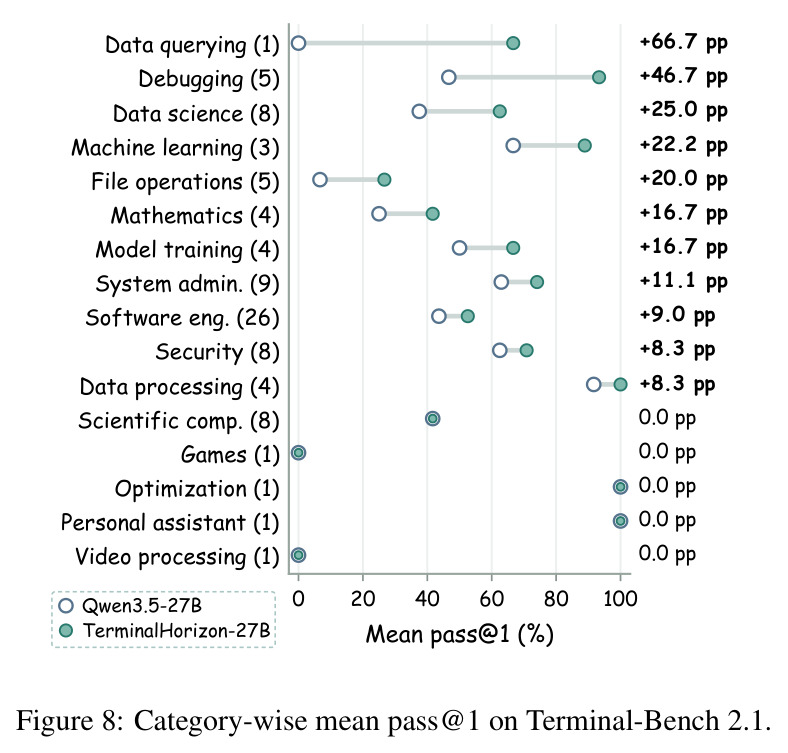
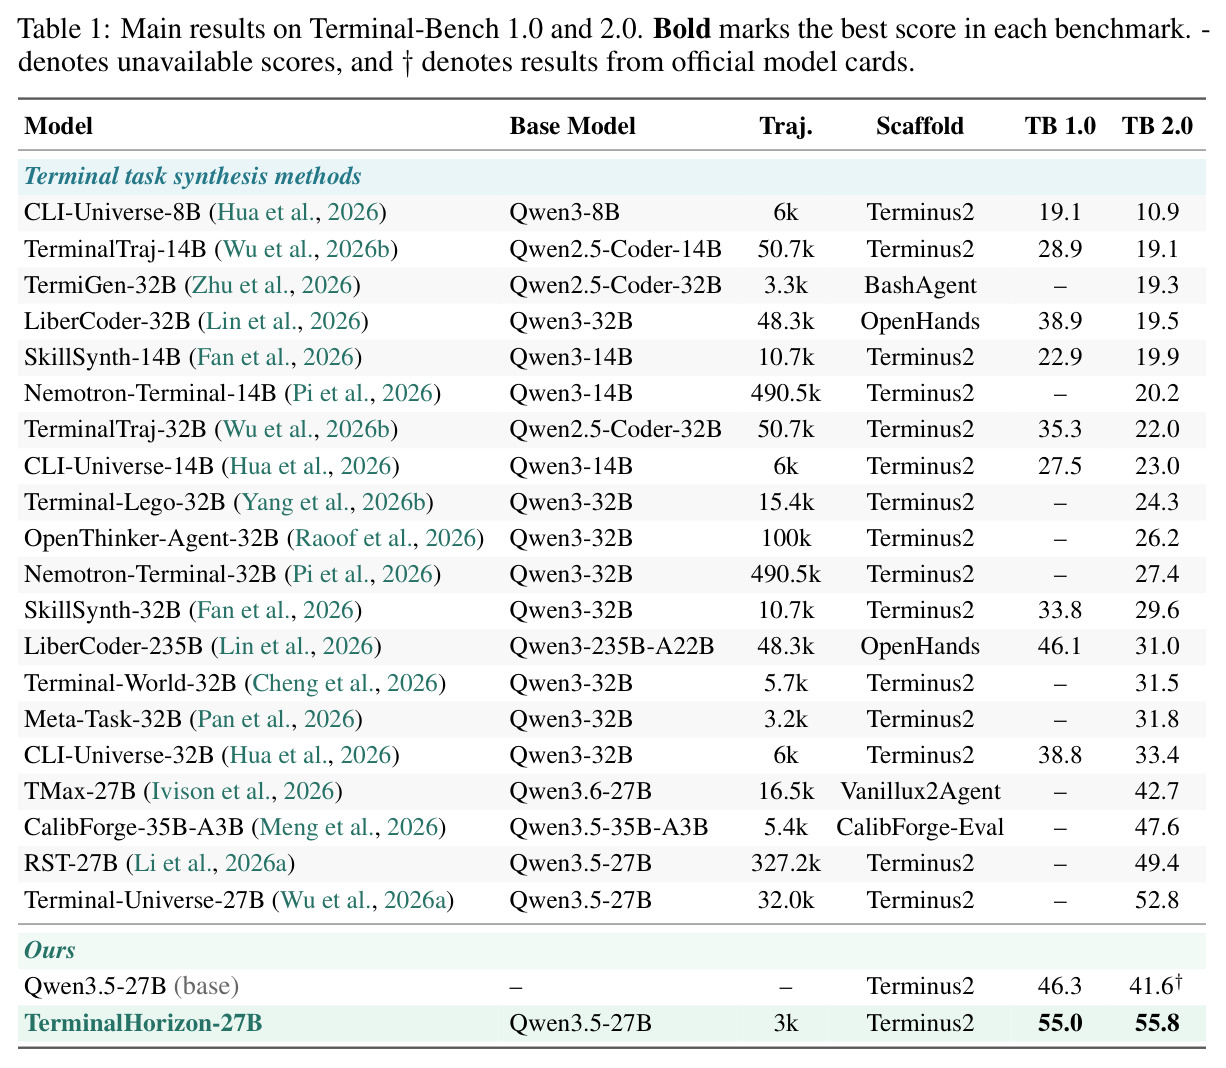
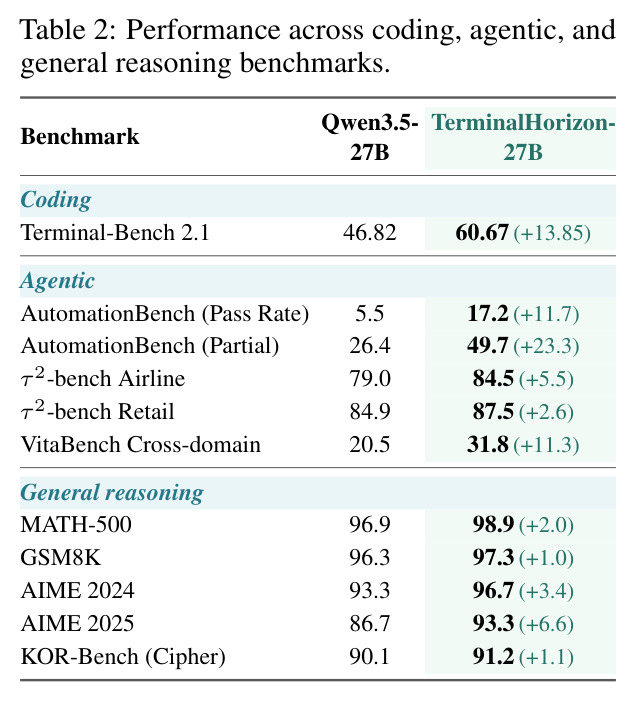
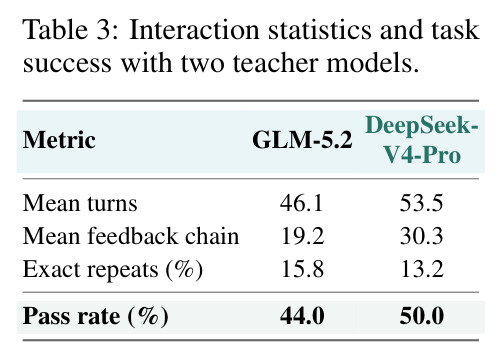
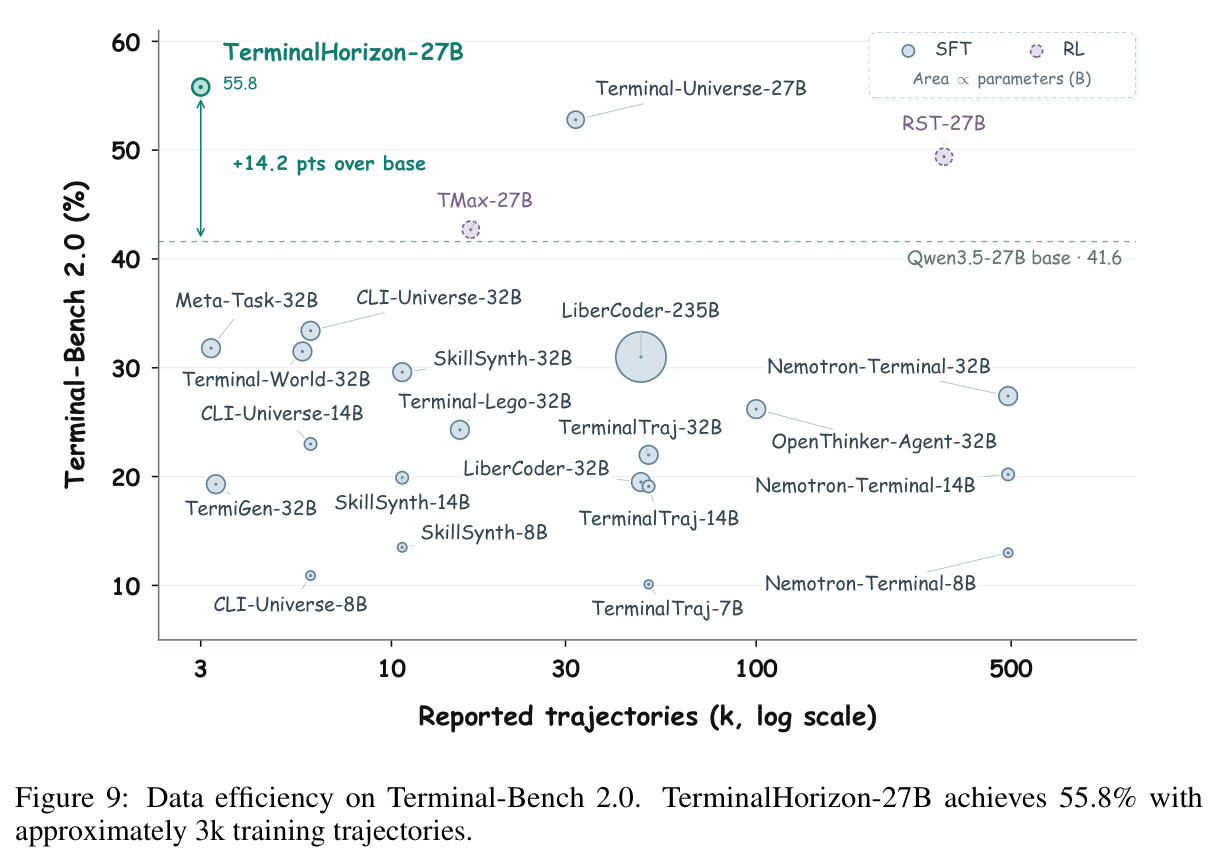
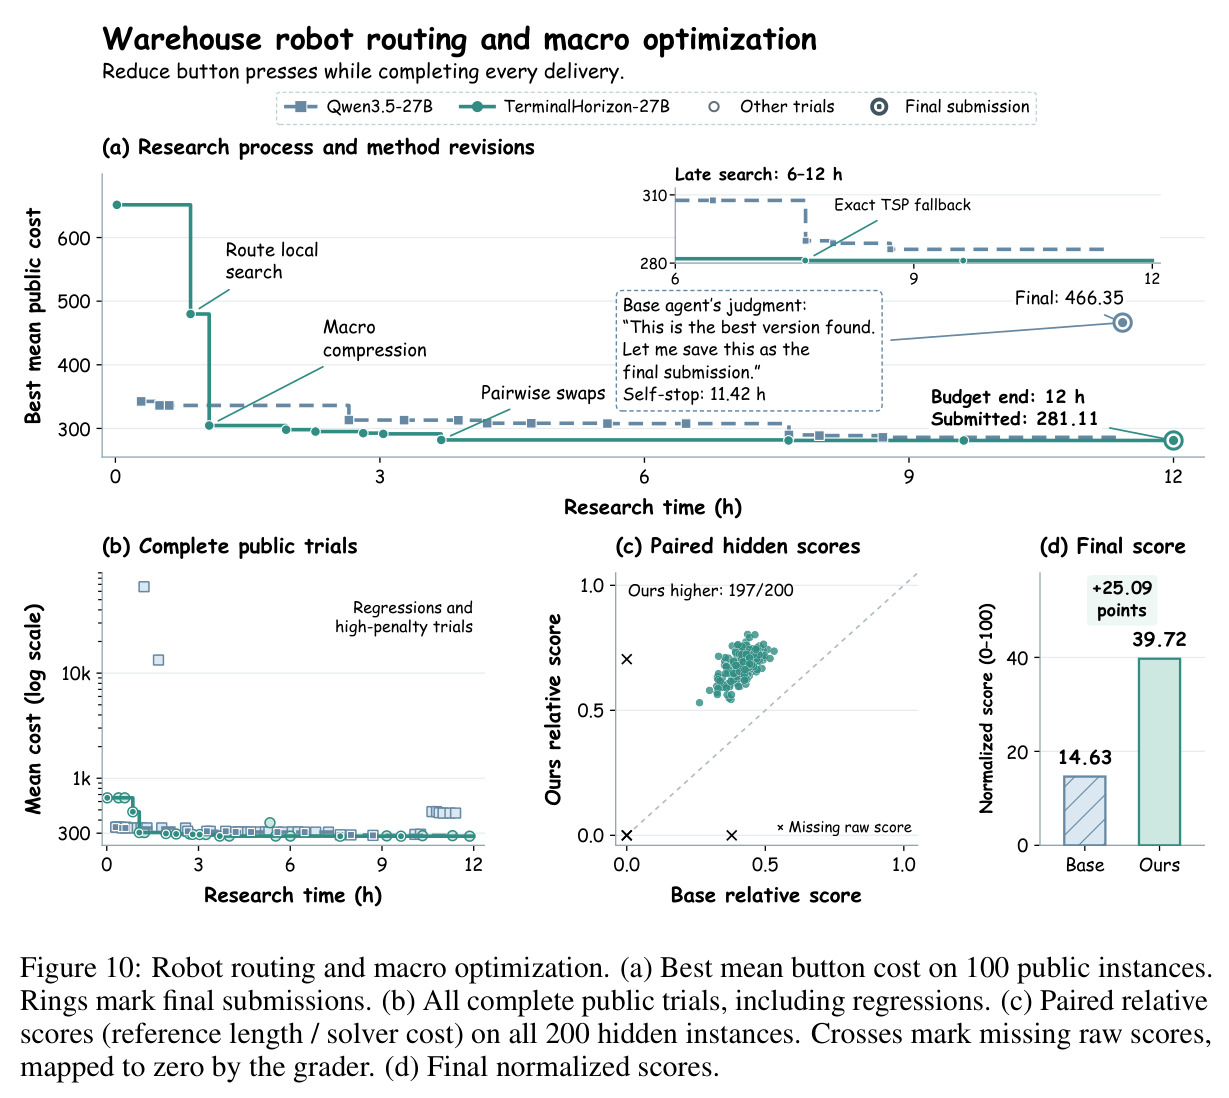
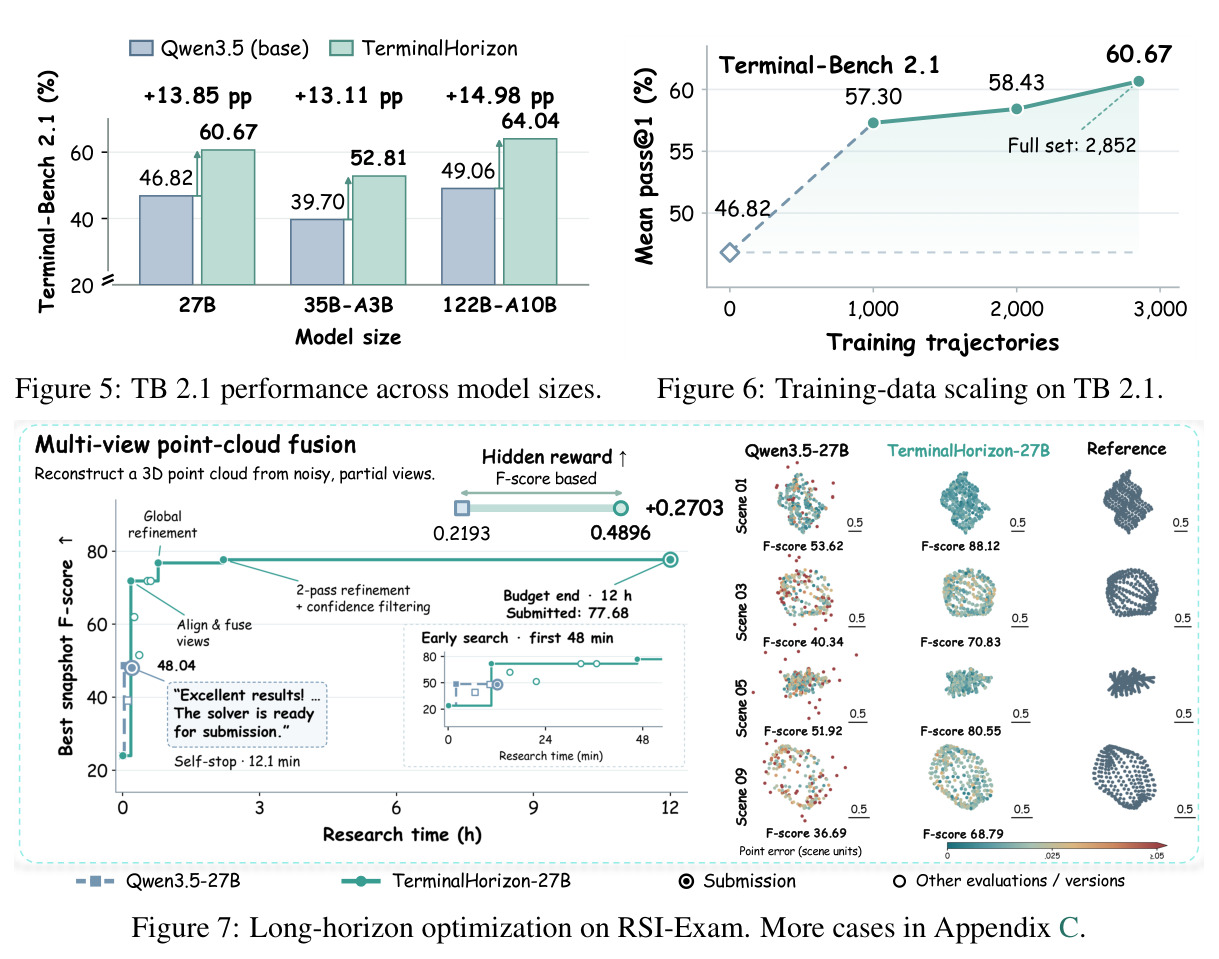
数据侧:TerminalHorizon 自动生成 1,535 个任务环境,覆盖芯片、物理、天文、教育、农业、医疗、金融等 25 个专业领域;轨迹平均 52.8 轮(P50 40、P90 98),远超对比方法的 3.87-15.60 轮;中位连续反馈动作链 25 轮;平均每条轨迹含 8.6 种核心行为模式。教师对比(100 任务抽样):DeepSeek-V4-Pro 平均 53.5 轮、反馈链 30.3、精确重复率 13.2%、通过率 50.0%,全面优于 GLM-5.2 的 46.1/19.2/15.8%/44.0%,故选为主教师。主结果:TerminalHorizon-27B 在全部 12 个基准上超越 Qwen3.5-27B 基座——Terminal-Bench 1.0/2.0/2.1 分别为 55.0/55.8/60.67,提升 +8.7/+14.2/+13.85;AutomationBench Pass Rate 5.5→17.2(+11.7)、Partial 26.4→49.7(+23.3);τ²-bench Airline 79.0→84.5、Retail 84.9→87.5;VitaBench 跨域 20.5→31.8(+11.3);通用推理不降反升:MATH-500 98.9(+2.0)、GSM8K 97.3(+1.0)、AIME 2024 96.7(+3.4)、AIME 2025 93.3(+6.6)、KOR-Bench 91.2(+1.1)。数据效率突出:仅约 3K 轨迹即超过用 32K 轨迹训练的同基座同框架 Terminal-Universe-27B 3.0 分(55.8 vs 52.8),也远超用 32.7 万轨迹的 RST-27B(49.4)。规模泛化:35B-A3B 与 122B-A10B 在 TB 2.1 分别提升 13.11 与 14.98 个百分点;训练数据从 1,000 扩到约 3,000 条时 TB 2.1 升至 60.67 且无饱和迹象。分类别看(TB 2.1,16 类):11 类提升,数据查询 +66.7、调试 +46.7、数据科学 +25.0、机器学习 +22.2 个百分点。四个 RSI 案例(各 12 小时预算,隐藏集归一化分):点云融合 21.93→48.96(隐藏 F 均值 48.04→77.68)、机器人路由 14.63→39.72、潮汐反演 27.41→48.15(隐藏 RMSE 降约 57.1%)、2048 策略 37.54→45.25。行为差异同样显著:基座常因代理指标漂亮而提前自停(12.1 分钟至 11.42 小时不等),训练后模型会质疑代理指标(引入 leave-one-view-out 诊断)、回退更复杂但更差的候选、并把最佳方案保留到最终提交。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Terminal-Bench 2.0(终端任务求解) | pass@1 | 55.8 | 基座 Qwen3.5-27B 41.6;最强竞品 Terminal-Universe-27B 52.8(32K 轨迹) | +14.2(对基座);+3.0(对最强竞品,轨迹量不足其 1/10) |
| Terminal-Bench 2.1 | pass@1 | 60.67 | 基座 46.82 | +13.85 个百分点 |
| Terminal-Bench 1.0 | pass@1 | 55.0 | 基座 46.3 | +8.7 个百分点 |
| AutomationBench(企业自动化) | Pass Rate / Partial | 17.2 / 49.7 | 基座 5.5 / 26.4 | +11.7 / +23.3 个百分点 |
| VitaBench 跨域(真实生活服务) | 成功率(Avg@4) | 31.8 | 基座 20.5 | +11.3 个百分点 |
| τ²-bench Airline / Retail | 任务成功率 | 84.5 / 87.5 | 基座 79.0 / 84.9 | +5.5 / +2.6 个百分点 |
| AIME 2025(通用推理) | 准确率 | 93.3 | 基座 86.7 | +6.6 个百分点 |
| RSI-Exam 多视角点云融合 | 隐藏集归一化奖励 | 48.96 | 基座 21.93 | +27.03(隐藏 F 均值 48.04→77.68) |
| RSI-Exam 潮汐摩擦场反演 | 隐藏集归一化奖励 | 48.15 | 基座 27.41 | +20.74(隐藏 RMSE 0.021873→0.009386,降 57.1%) |
| RSI-Exam 机器人路由与宏优化 | 隐藏集归一化奖励 | 39.72 | 基座 14.63 | +25.09(公开最优成本 286.05 vs 281.11,但基座最终提交 466.35) |
局限与改进
作者承认的局限:RSI-Exam 每个模型每个案例只跑一次,结论属于案例研究而非统计显著的对比;教师模型在自建任务上的通过率仅 50%,约半数任务未产出成功演示(尽管过程过滤后部分失败轨迹因含纠错示范而被保留);训练仅限 SFT,未在合成环境上探索 RL。我的补充观察:其一,引擎重度依赖强教师与强审查模型(DeepSeek-V4-Pro-0813、gpt-5.6-luna),教师行为偏差可能被蒸馏进学生;其二,提升分布不均,TB 2.1 上科学计算、博弈、优化、个人助理、视频处理 5 个类别提升为 0,长尾类别受益有限;其三,评测集中在 Qwen3.5 家族(27B/35B-A3B/122B-A10B 同系),跨家族泛化未验证;其四,验证器本身由 LLM 构建,其正确性只有独立挑战这层间接保障,缺乏形式化证明;其五,未报告数据合成的 API 成本与 token 消耗,工程开销不透明。
独立分析的弱点
第一,教师上限锁死数据质量:DeepSeek-V4-Pro 通过率仅 50%,在更高扩展代 $T^{(g+1)}$ 上可能更低,导致困难任务的成功示范稀缺。改进方向是在这些自带私有验证器的环境上接入 RL(如 GRPO),用失败轨迹加奖励信号替代对教师成功示范的依赖。第二,审查环节主观性:轨迹过滤、差距分析与去污染语义审查全由 LLM 完成,审查者偏差无法量化。改进方向是开发可程序化的行为模式检测器(基于轨迹结构的规则或小型分类器)并用人工抽检校准。第三,跨阶段连接性只有间接指标:论文用平均 8.6 个模式/轨迹衡量,但未验证学生学到的是连接能力而非表面模仿。可设计消融——把轨迹阶段打乱重组后训练,对比下游长程任务表现差异。第四,部分类别零提升:TB 2.1 中科学计算等 5 类无增益,可能因证据链过长、验证器难写,可让 Planner 针对弱类别定向生成研究简报。第五,RSI 案例单次运行方差大(2048 仅 +7.71),需多种子重复才能支撑强结论。
未来方向
作者方向:继续扩大高质量长程轨迹规模——Figure 6 显示 3K 处无饱和,扩展空间明确;覆盖更多模型尺寸(已在 27B/35B-A3B/122B-A10B 验证)。基于成果可延伸的方向:一是在合成环境上做在线 RL 或自我博弈,让模型从自身失败中学习而非只模仿教师;二是利用渐进扩展的代数 $g$ 构建课程学习,从 $T^{(0)}$ 到 $T^{(g)}$ 逐步加难;三是把挑战-重构闭环推广到终端之外的 GUI、Web 与多智能体协作环境;四是把 RSI 式长预算任务变成训练环境,将持续实验-修订-交付作为可优化目标而非仅是评测;五是多教师集成,按行为差异(如 DeepSeek 反馈链长、GLM-5.2 更保守)定向采样融合;六是研究行为模式连接性对学生模型内部表征的影响机制,为数据合成提供理论指导。
复现评估
复现难度中等偏上。有利因素:训练配置完整公开(Table 4:LLaMA-Factory 全参 SFT,AdamW 学习率 $1\times10^{-5}$、cosine 调度、5% warmup、3 epochs、262,144 序列长、BF16+ZeRO-3+FlashAttention-2);评测协议详尽(Appendix A.2:vLLM 部署、Terminus-2/Harbor2 框架、温度与步数上限、运行次数);轨迹过滤与去污染提示词全文给出(Appendix J),去污染流程严谨——1,535 训练任务对 3,251 个评测实例,精确 13/14-gram 零命中,5-gram Jaccard 最大 0.006024,190 对候选经语义审查零污染。不利因素:合成管线依赖闭源强模型(教师 DeepSeek-V4-Pro-0813、审查 gpt-5.6-luna)且多角色循环编排复杂,复现引擎本身最难;27B 全参 SFT 用了 144 块 H20-141GB(18 节点)门槛高,但数据仅 3K 条,缩小模型或 LoRA 可大幅降低成本;评测需 8 块 H20 服务 vLLM。预印本标注了 Project Page 与 Data & Model 链接,若数据与模型如期开源,复现训练与评测的难度会显著下降。
论文图表
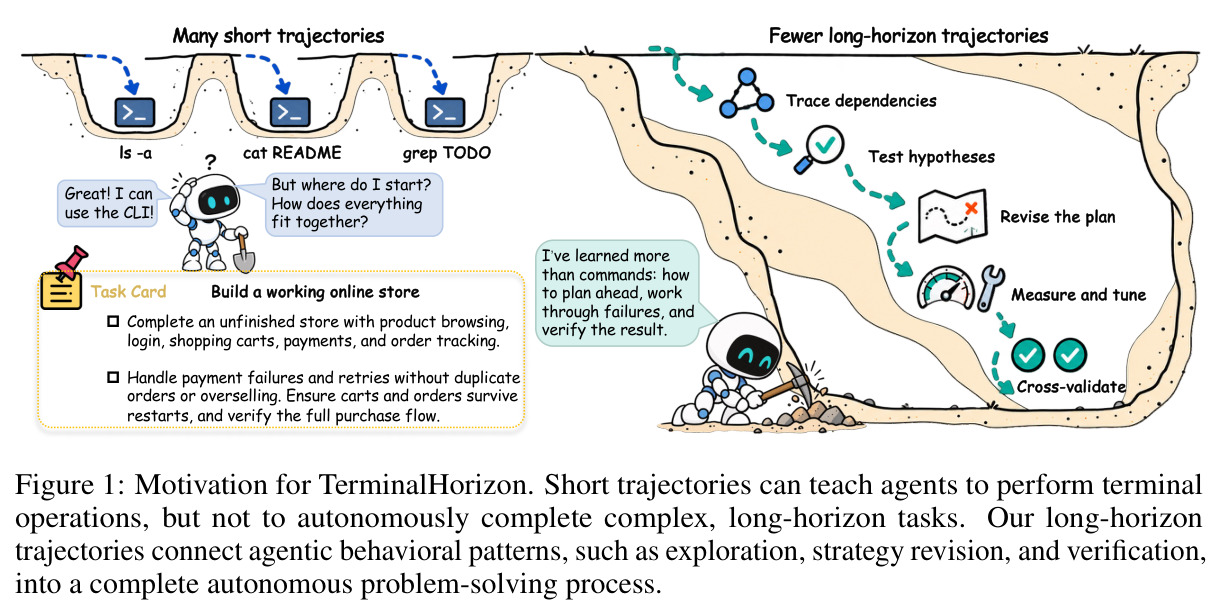
左右对比图。左侧多条短轨迹只演示 ls -a、cat README、grep TODO 等孤立命令调用;右侧一条长程轨迹对应任务卡构建一个带商品浏览、登录、购物车、支付与订单追踪的在线商店,并把追踪依赖、检验假设、修订计划、失败后推进、度量调优、交叉验证等行为连接成完整的自主解题过程。
一图点明论文出发点——短轨迹教操作、长程轨迹教解题,是理解全文动机的最快入口。