TextVerifier:超越识别的中文文字渲染验证器 TextVerifier: Seeing Beyond Recognition to Verify Chinese Text Rendering
用IDS结构先验逐字验证生成图像中的汉字渲染错误,并可作RL奖励反向修正生成模型
前置知识
IDS(表意文字描述序列)
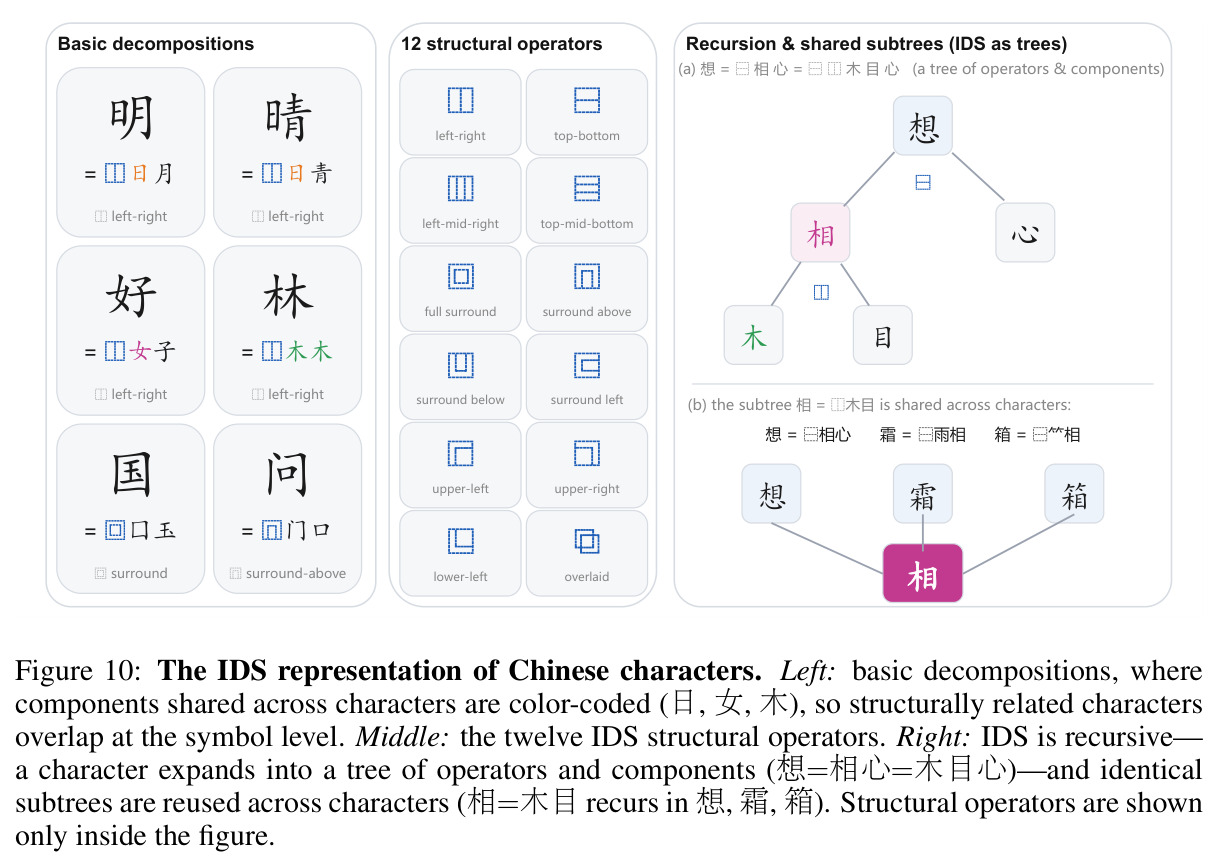
Unicode 标准定义的汉字分解方案:用约12个结构算子(左右⿰、上下⿱、全包围⿴等)加约965个部件,把每个汉字唯一写成符号序列,如“好=⿰女子”,且可递归展开成树(想=⿱相心=⿱⿰木目心)。它把字形的层级空间结构线性化,共享部件的字在序列层面天然相近。
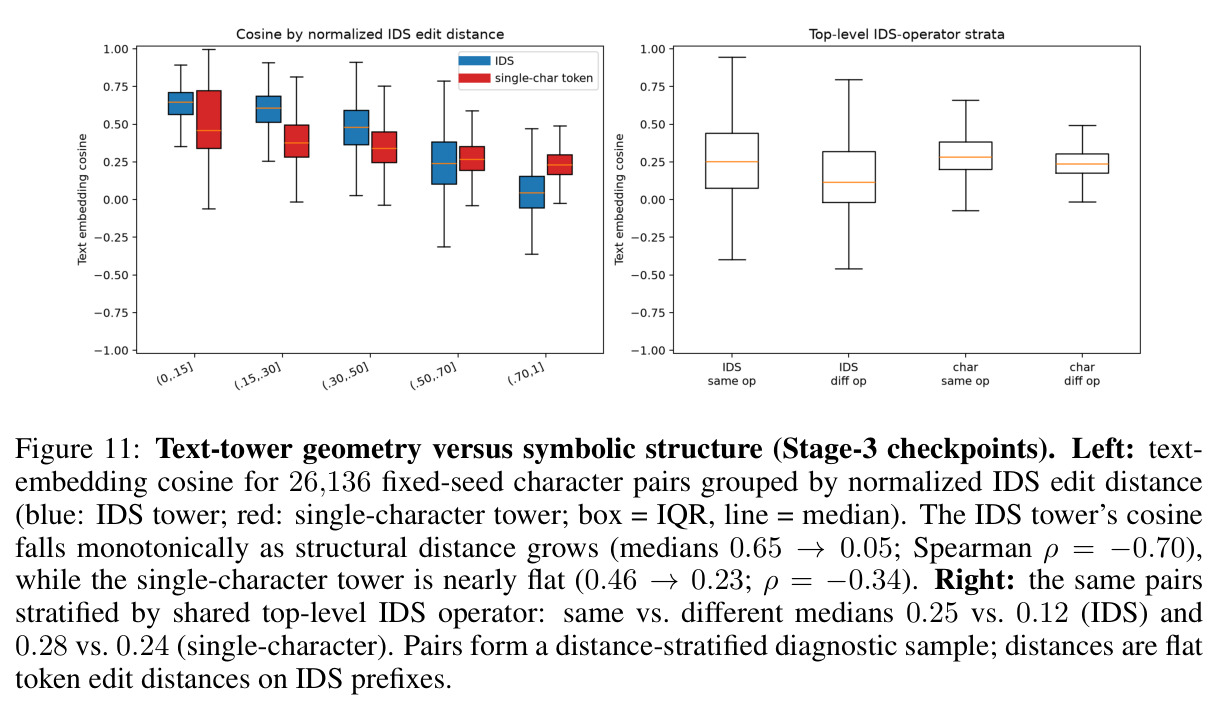
本文文本塔的输入不是汉字本身而是其 IDS,这是全部结构敏感性的来源;不理解 IDS 就无法理解方法设计、消融实验为何掉点以及附录B的嵌入几何分析。
CLIP 式双塔与 InfoNCE 对比学习
图像编码器和文本编码器分别把两种模态映射进共享空间,用双向 InfoNCE 损失拉近匹配图文对、推远批内非匹配对(批内其他样本充当负例),匹配度用余弦相似度衡量,嵌入做 ℓ2 归一化。
TextVerifier 的骨架就是这种双塔,但做了关键改动:负例要做“同字掩码”,文本侧输入换成 IDS。理解 InfoNCE 才能看懂三阶段损失如何递进。
目标条件异常检测
不是预测样本属于哪一类,而是在给定目标类(这里为目标汉字)的前提下,判断样本是否落在该类合法样本构成的流形上。一个字跨字体、书法、风格有很多合法写法,渲染错误只是离这个多峰流形很近的小偏离。
这是论文对任务的形式化定义:OCR 只负责提供目标字,验证器只回答“像不像这个字的合法写法”。三阶段的绝对/相对损失和推理期的多原型读出都由此推导。
Flow-GRPO 与文生图 RL 后训练
Flow-GRPO 把流匹配生成模型转化为随机策略,用在线强化学习按奖励信号做后训练。奖励可以来自 OCR 字符串匹配(便宜但对字形盲目、易被钻空子)或 VLM 裁判(每样本一次大模型前向、只给离散判定)。
论文把验证器的连续分数映射为逐字奖励接入 Flow-GRPO,是其第二大贡献;不懂 RL 后训练中奖励函数的角色,就看不懂为何“字形感知奖励”是提升 Glyph-Acc 的关键。
OCR 的识别不变性
OCR 为内容恢复而训练,刻意对字体、风格、形变、模糊保持不变,目标是把字“读对”。于是多一笔或缺一笔的错字仍被读成原字并给出极高置信度——PP-OCRv6 对明显多笔的错字“基”给出 0.9989 的置信度。
这是全文动机的基石:识别与验证目标相反,所以 OCR 置信度不能当正确性判据,基线全线失效的原因也在于此。
研究动机
文生图基础模型已能生成整句甚至整段中英文,文字渲染成为核心能力与模型间比较的关键维度,但最强的模型仍会在汉字上犯局部错误:某一笔多画、少画或部件变形。这类错误的隐蔽性在于句子整体仍可读——OCR 和视觉语言模型都是为“内容恢复”训练的,刻意对字体、风格、形变不变,因此恰恰对定义渲染错误的那类结构偏差不敏感:PP-OCRv6 对一个明显多笔的错字“基”仍给出 0.9989 的置信度;直接提示通用 VLM 也不行,最好的 Gemini 3.7 Flash 在基准上也只能召回 54% 的错误字。已有唯一的系统性尝试 TextPecker 把模糊、形变、错位与字形错误混为一种“结构异常”,且不条件于目标字、缺乏“哪些写法合法”的模型,导致误报极高(精确率仅 0.480,召回 0.765),其 8B 骨干也难以大规模部署或用作训练期奖励。中文有六千到八千个笔画稠密、按层级结构组装的汉字,错误往往不是读不出的乱码而是“一眼扫过去都对”的可读句子;在出版、教育等零容忍场景,一个错字就让整张图作废,而此前没有可靠的自动逐字验证工具。
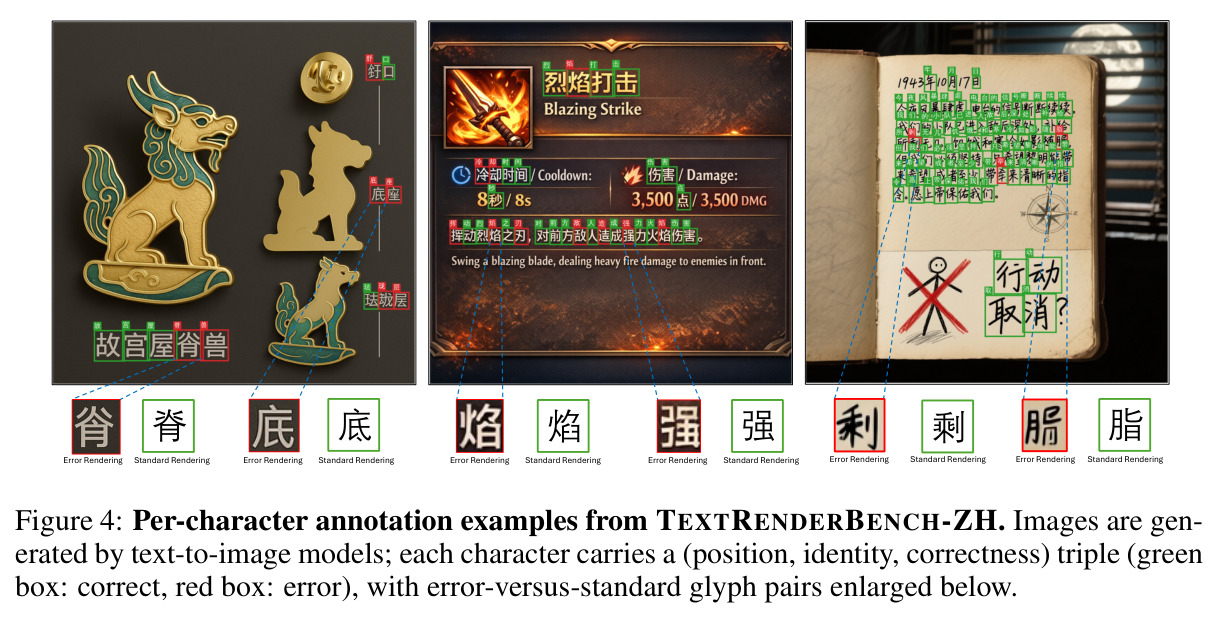
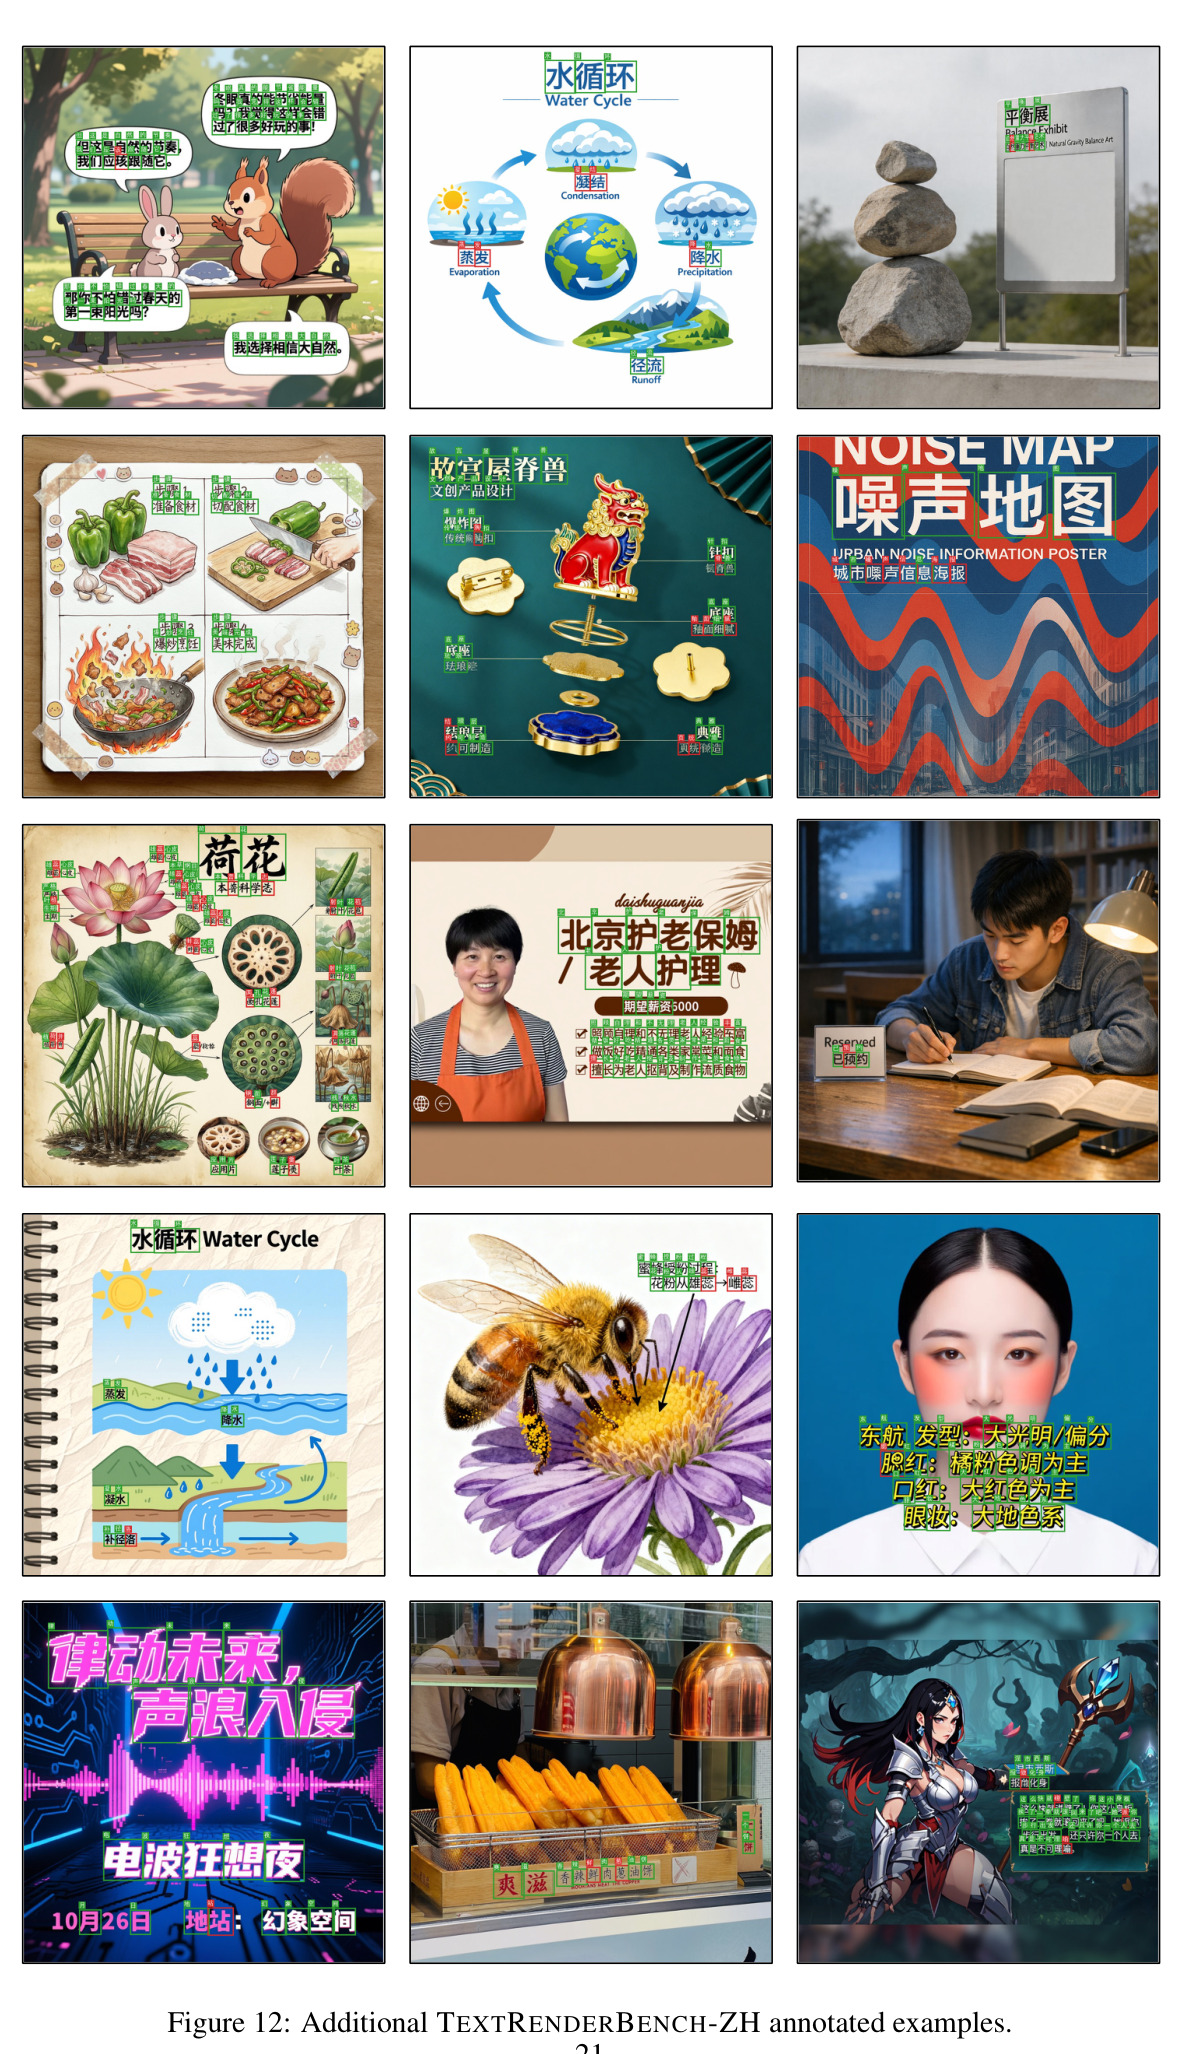
本文的目标是本文的目标是把“生成图像中的中文文字渲染验证”形式化为目标条件问题:给定上游识别器提供的目标字符 $c$ 和对应图像裁剪 $x$,判断 $x$ 是否是 $c$ 的一次正确渲染,并输出连续、校准、逐字的分数 $\mathrm{score}(x,c)$,经阈值 $\delta$ 判错。围绕该目标有三件具体的事:其一,构建一个对笔画级结构偏差敏感、又不惩罚字体书法风格差异的专用验证器,且足够小、足够快(0.36B 参数、每字 7.6ms),能被用作训练期奖励;其二,设计一套几乎无需人工标注的数据构造与三阶段训练课程,让模型先学字间身份、再学绝对对错、最后学相对优劣;其三,建立 TextRenderBench-ZH——第一个对生成中文文本逐字标注(位置、身份、正确性)三元组的基准(308 张图、7,358 个字、642 个人工确认错误),使验证器本身可以被精确评测,并验证该分数作为 Flow-GRPO 的逐字奖励能否实际降低生成模型的字形错误。
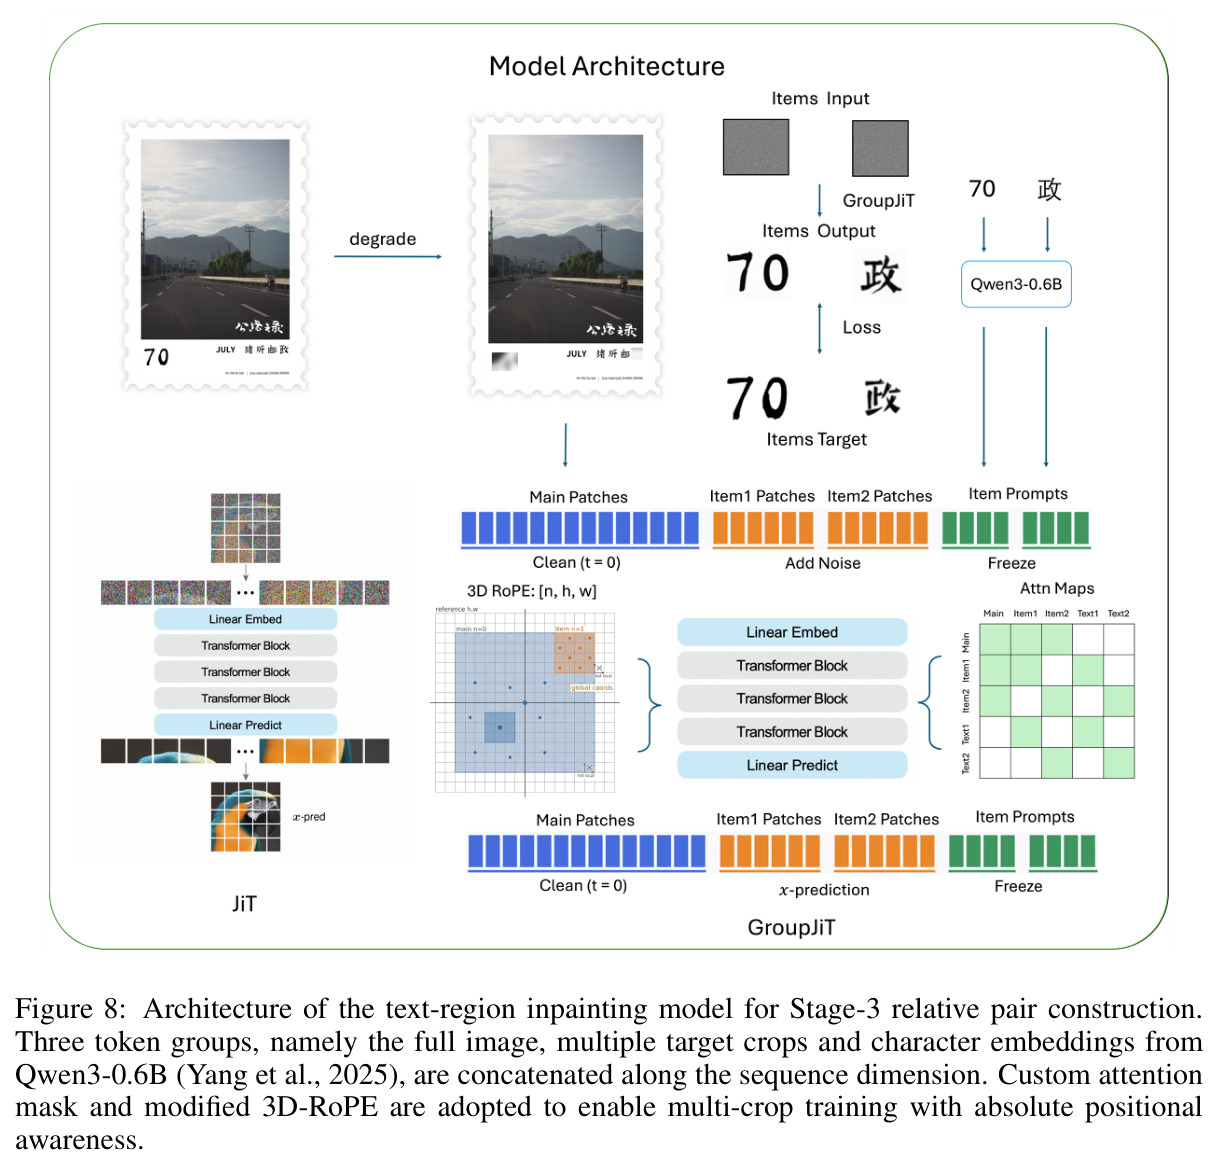
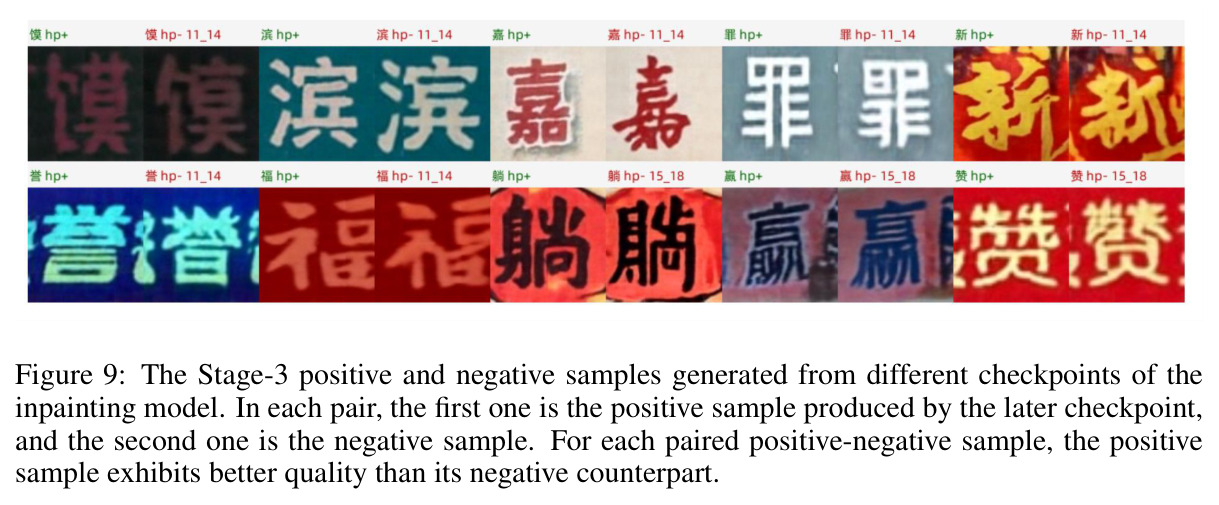
与已有工作不同的是,本文的独特切入有三点。第一,明确区分“识别”与“验证”这两种目标相反的能力:识别追求对形变不变,验证追求对结构偏差敏感,因此 OCR 只负责提供目标字与位置,正确性判断交给专门训练的验证器,两者解耦而非复用。第二,把问题定义为逐字的条件异常检测:一个字跨字体、书法、风格构成合法渲染流形,错字只是离流形很近的小偏离——这解释了为何推理时要用多原型读出而非单点相似度阈值。第三,文本塔输入从单个字符 token 换成 IDS 序列,让共享部件或结构的字(如“想、霜、箱”共享子树“相=⿰木目”)在序列与嵌入层面结构性相近;这与把 IDS 用于零样本识别(Yu et al., 2023)或把手写字解码成 IDS 再比对检错(部件级替换)都不同,因为生成错误是像素级的断笔、粘连与风格化偏移,必须靠流形距离而非符号比对。监督构造也是新的:除合成扰动外,从文字区域修复模型的训练轨迹中免费挖掘“同字不同质”的早/晚检查点对,用相对标签监督最接近真实分布的困难负例。
核心方法
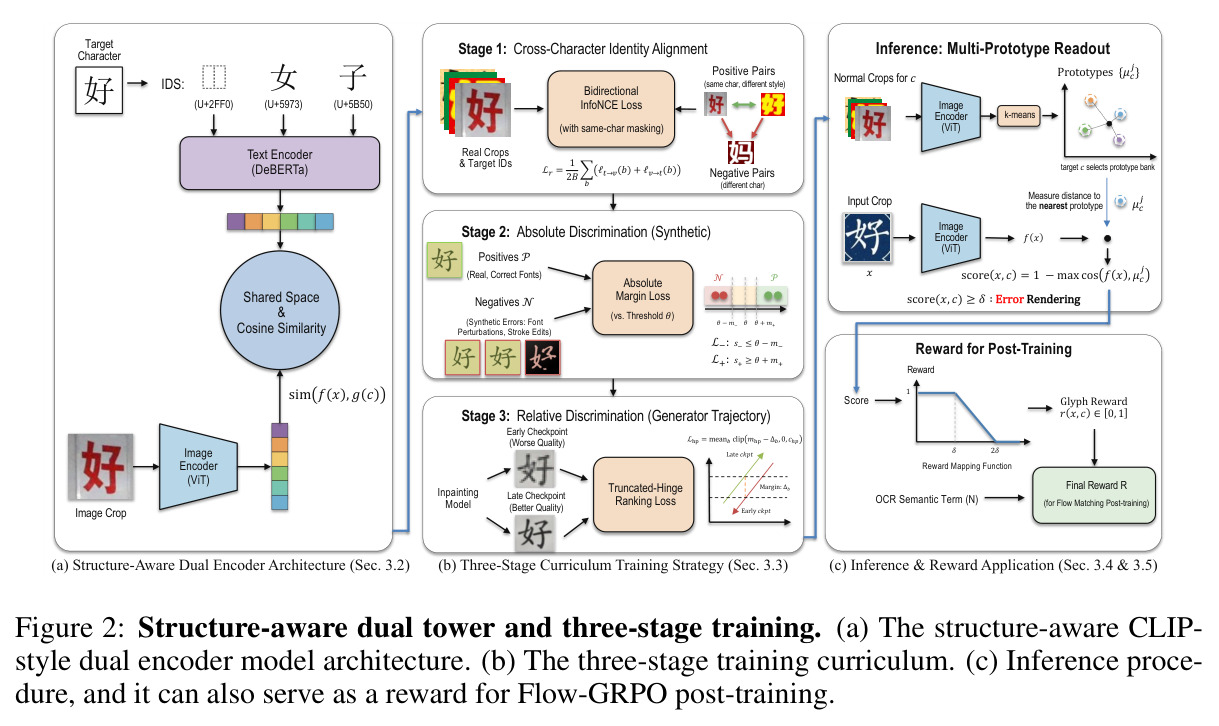
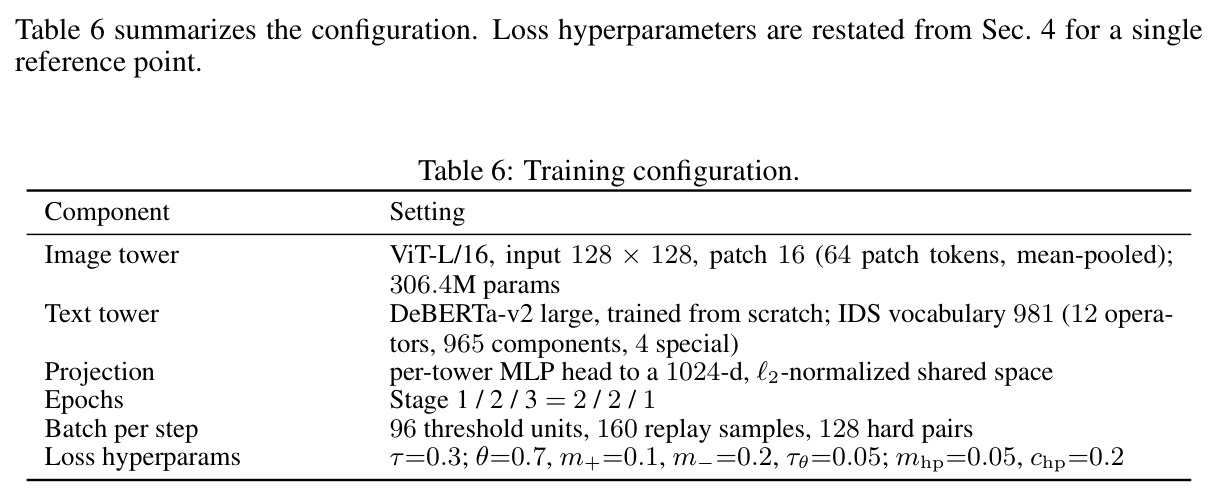
直觉上,验证器要回答“这个裁剪像不像目标字的合法写法”,而不回答“这是什么字”。技术路线是 CLIP 式双塔加三阶段课程。图像塔是 ViT-L/16,文本塔是从头训练的 DeBERTa-v2 large,词表仅 981 个 IDS 符号(12 算子、965 部件),两侧各接 MLP 投影头进入 1024 维共享空间,匹配度用余弦相似度 $\mathrm{sim}(f(x), g(c))$,合计 0.36B 参数。训练分三阶段递进:第一阶段用约 1273 万真实裁剪-IDS 对做跨字身份对齐(带同字掩码的双向 InfoNCE);第二阶段用约 175 万合成正负样本做绝对判别(阈值锚定、两侧留边距的软加损失);第三阶段用约 70 万对来自修复模型训练轨迹的“同字不同质”样本做相对判别(截断铰链排序损失)。推理时不直接阈值化图文相似度,而是给每个字维护 $K=10$ 个由正常裁剪 k-means 得到的原型,分数取到最近原型的余弦距离,阈值取训练分布的 90 分位。最后把分数线性映射为 $[0,1]$ 的逐字奖励,与 OCR 语义项加权后接入 Flow-GRPO。
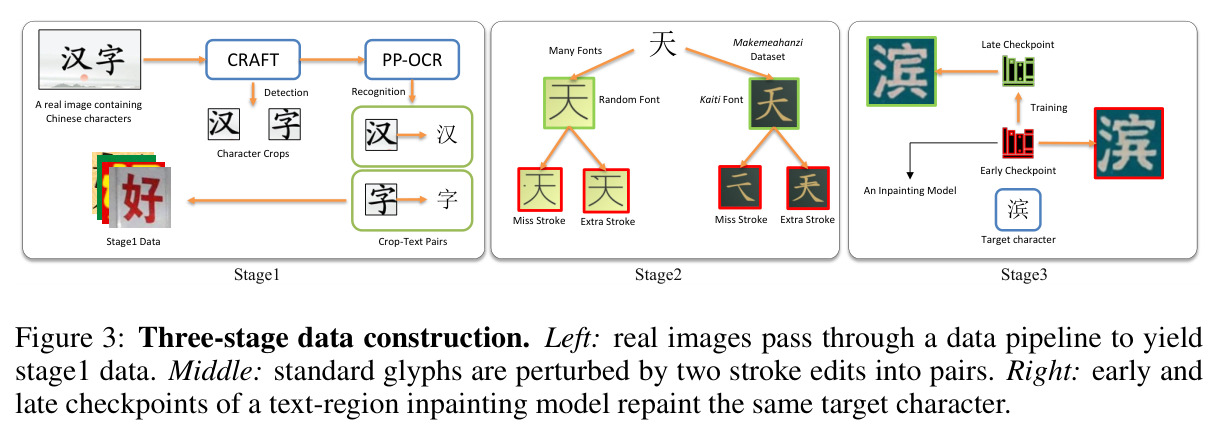
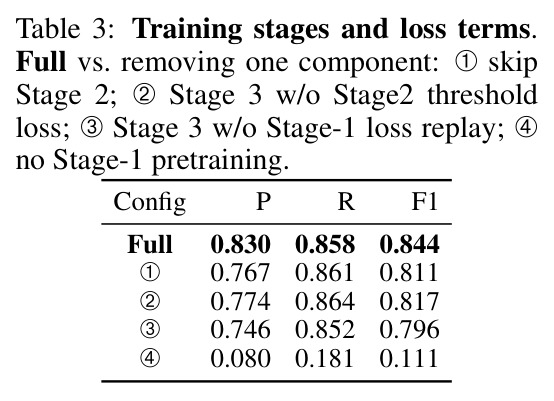
核心创新是“结构条件化 + 标签语义分层”的课程设计,与已有方法的本质区别有二。其一,TextPecker 等异常评估器把坏样本当作目标无关的无条件异常,而本文始终以目标字的条件流形为参照,只判断“是否属于该字的合法写法”,字体、书法、艺术风格差异因此天然不被误判;同时文本塔输入 IDS 而非字符 token,字与字之间不再是查表式的独立类别,结构差异被显式编码——消融显示去掉 IDS 后三阶段 F1 分别掉 10.4/7.1/10.1 个点,第三阶段召回从 0.858 跌至 0.648 而精确率反而微升,证明结构先验正是笔画级敏感性的来源。其二,对监督标签语义的细分:真实生成错误最难标注,作者利用“正在训练中的文字修复模型会沿训练轨迹留下同字不同质样本”(早检查点笔画常错、晚检查点大多正确,纹理背景几乎不变)这一事实,免费获得约 70 万对相对标签样本,并用截断铰链损失消费它,避免把“晚不差于早”的相对信号误当绝对对错;同时回放第一阶段的身份损失、保留第二阶段的绝对阈值损失,三者各司其职。
方法步骤详情
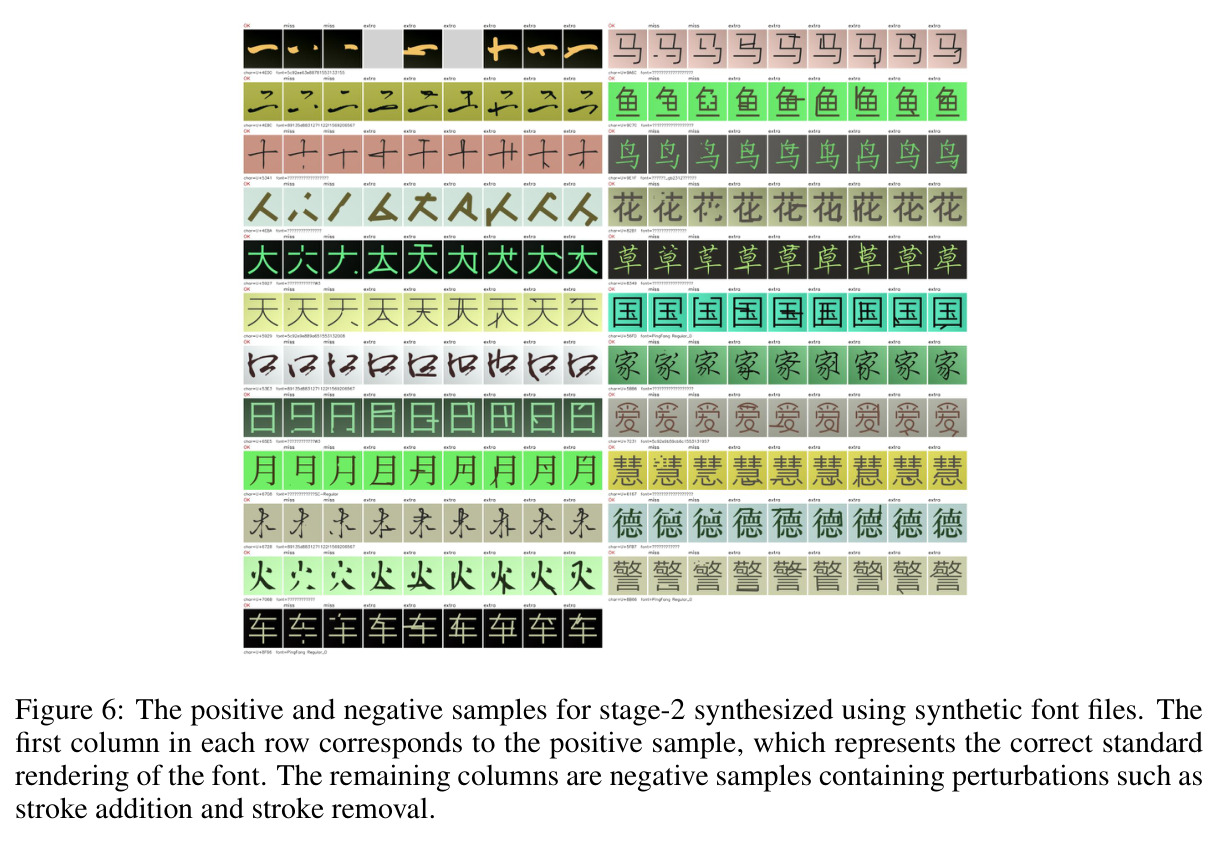
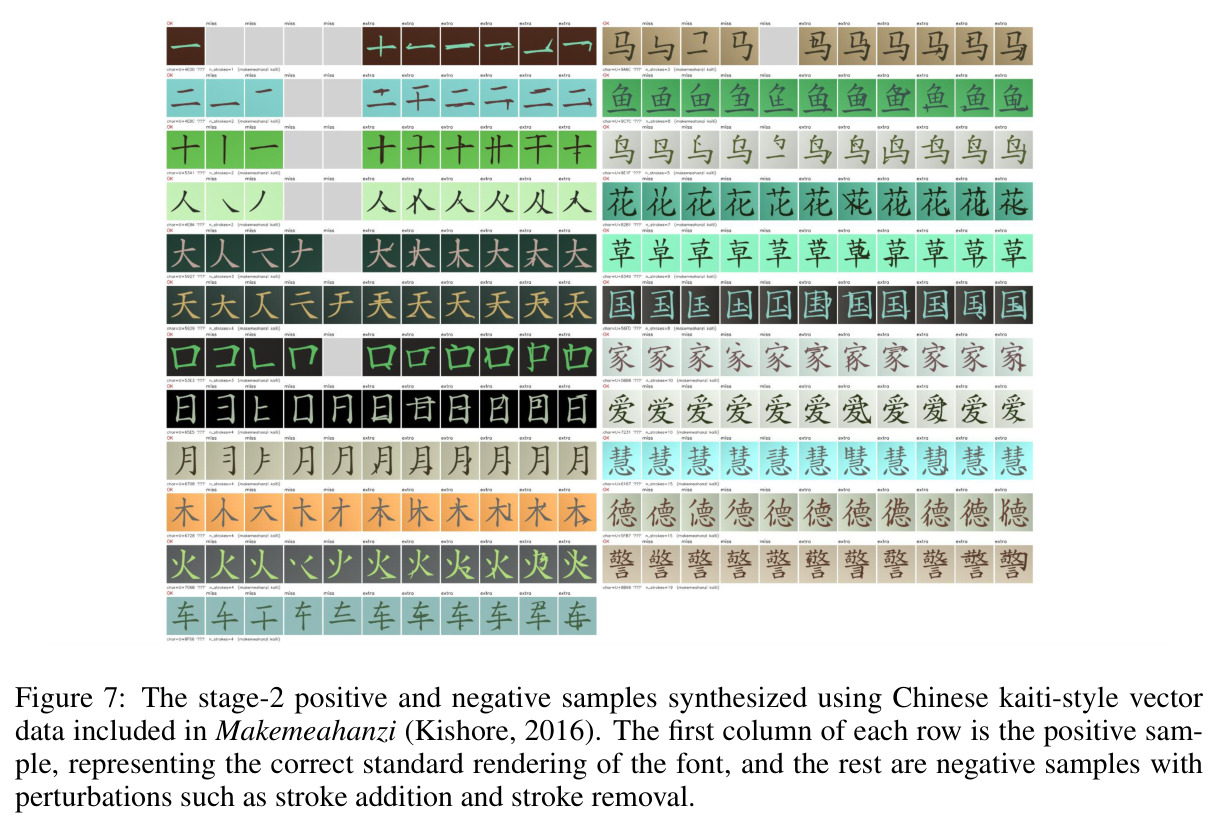
流程:①前端——CRAFT 检出字符框,PP-OCRv6 识别目标字 $c$,得裁剪 $x$;②阶段1——250 万图像过滤得 1013 万对(8,189 字),长尾字补齐到约 1273 万裁剪-IDS 对,同字掩码双向 InfoNCE 训 2 epoch;③阶段2——30+ 字体字形做缺笔/多笔扰动,Makemeahanzi 楷体矢量做整笔级精细编辑,得约 175 万绝对标签样本,阈值锚定软加损失训练并回放阶段1损失;④阶段3——自训约 1B JiT 修复模型,早/晚检查点重绘同一(位置,目标字)得约 70 万对,截断铰链损失训 1 epoch;⑤读出——每字 500 裁剪 k-means 成 $K=10$ 原型,$\mathrm{score}=1-\max_j\cos(f(x),\mu_j^c)$,阈值 $\delta$ 取训练分数 90 分位;⑥奖励——$r$ 在 $\delta$ 内为 1、$2\delta$ 外为 0、中间线性,$G=0.9\bar r+0.1\min r$,$N=1-\mathrm{NED}$,$R=0.8G+0.2N$ 接入 Flow-GRPO。
技术新颖性
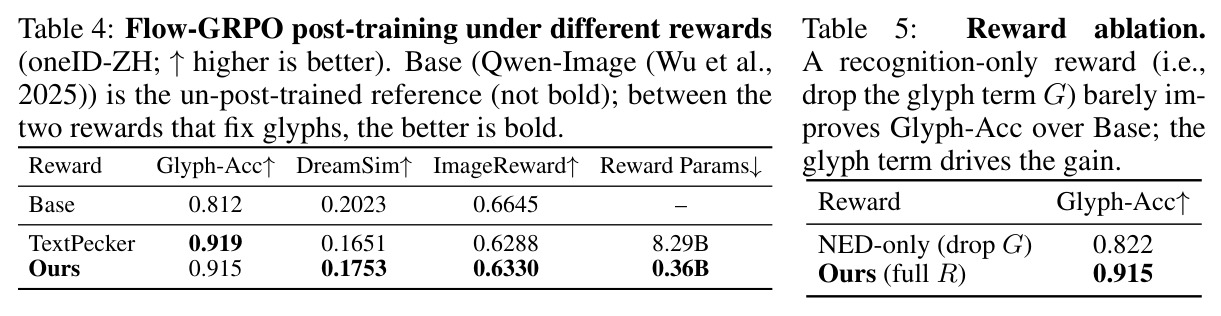
技术新颖性可从四个层面分析。任务层面:此前没有对生成中文文本的逐字验证形式化与基准——TextPecker 的“结构异常”是目标无关的,TIQA 只回归感知质量,Type-R 靠词级 OCR 差分查错别字,都不是目标条件、逐字、连续、校准的判定。表示层面:把 IDS 从零样本识别(图像-IDS 对齐)和手写检错(解码成 IDS 再符号比对,假设错误是部件级替换)迁移为验证条件,并论证生成错误是像素级的断笔、粘连与风格化偏移,落在合法流形附近而非变成另一个字,因此必须靠嵌入空间的流形距离而非符号比对。数据层面:三路无人工标注的监督——真实图像自动管线、字形矢量精确扰动、生成器训练轨迹挖掘——其中“同字不同质对”是巧妙的免费难负例来源,且作者区分绝对与相对标签并配以不同损失。应用层面:验证分数首次作为逐字连续奖励进入 Flow-GRPO,与 OCR 语义奖励互补而非替代;实验证明只有字形感知奖励能真正提升 Glyph-Acc(0.822→0.915),而奖励模型比 8B VLM 方案小 23 倍、快约 42 倍。
实验结果
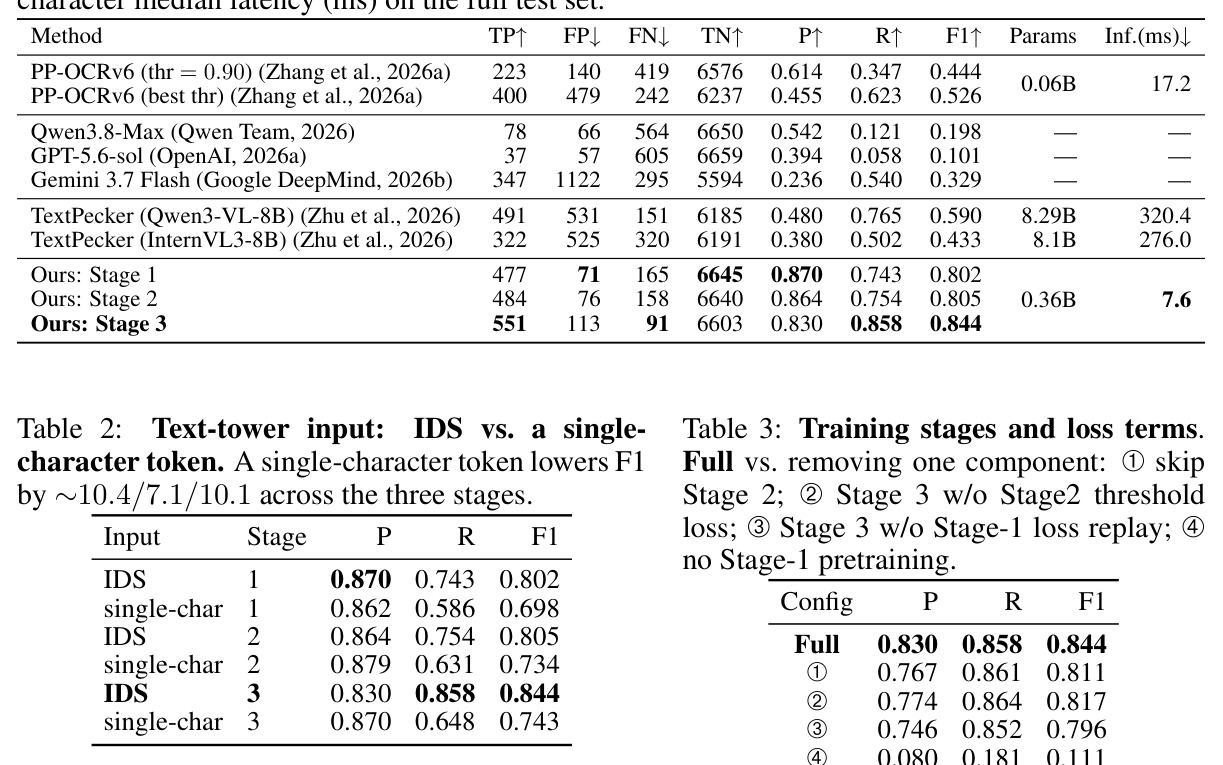
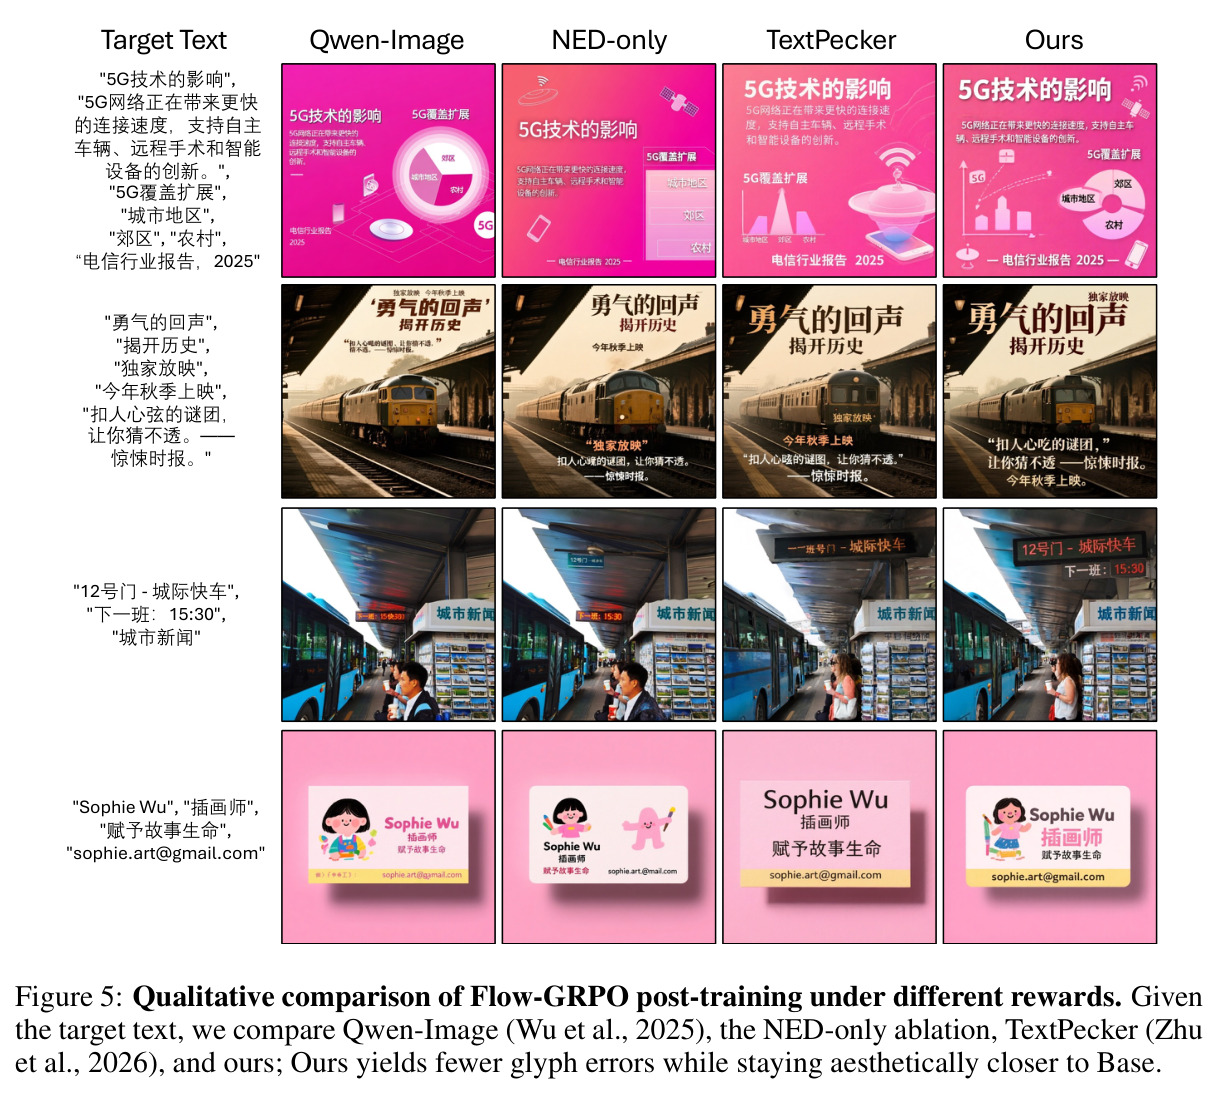
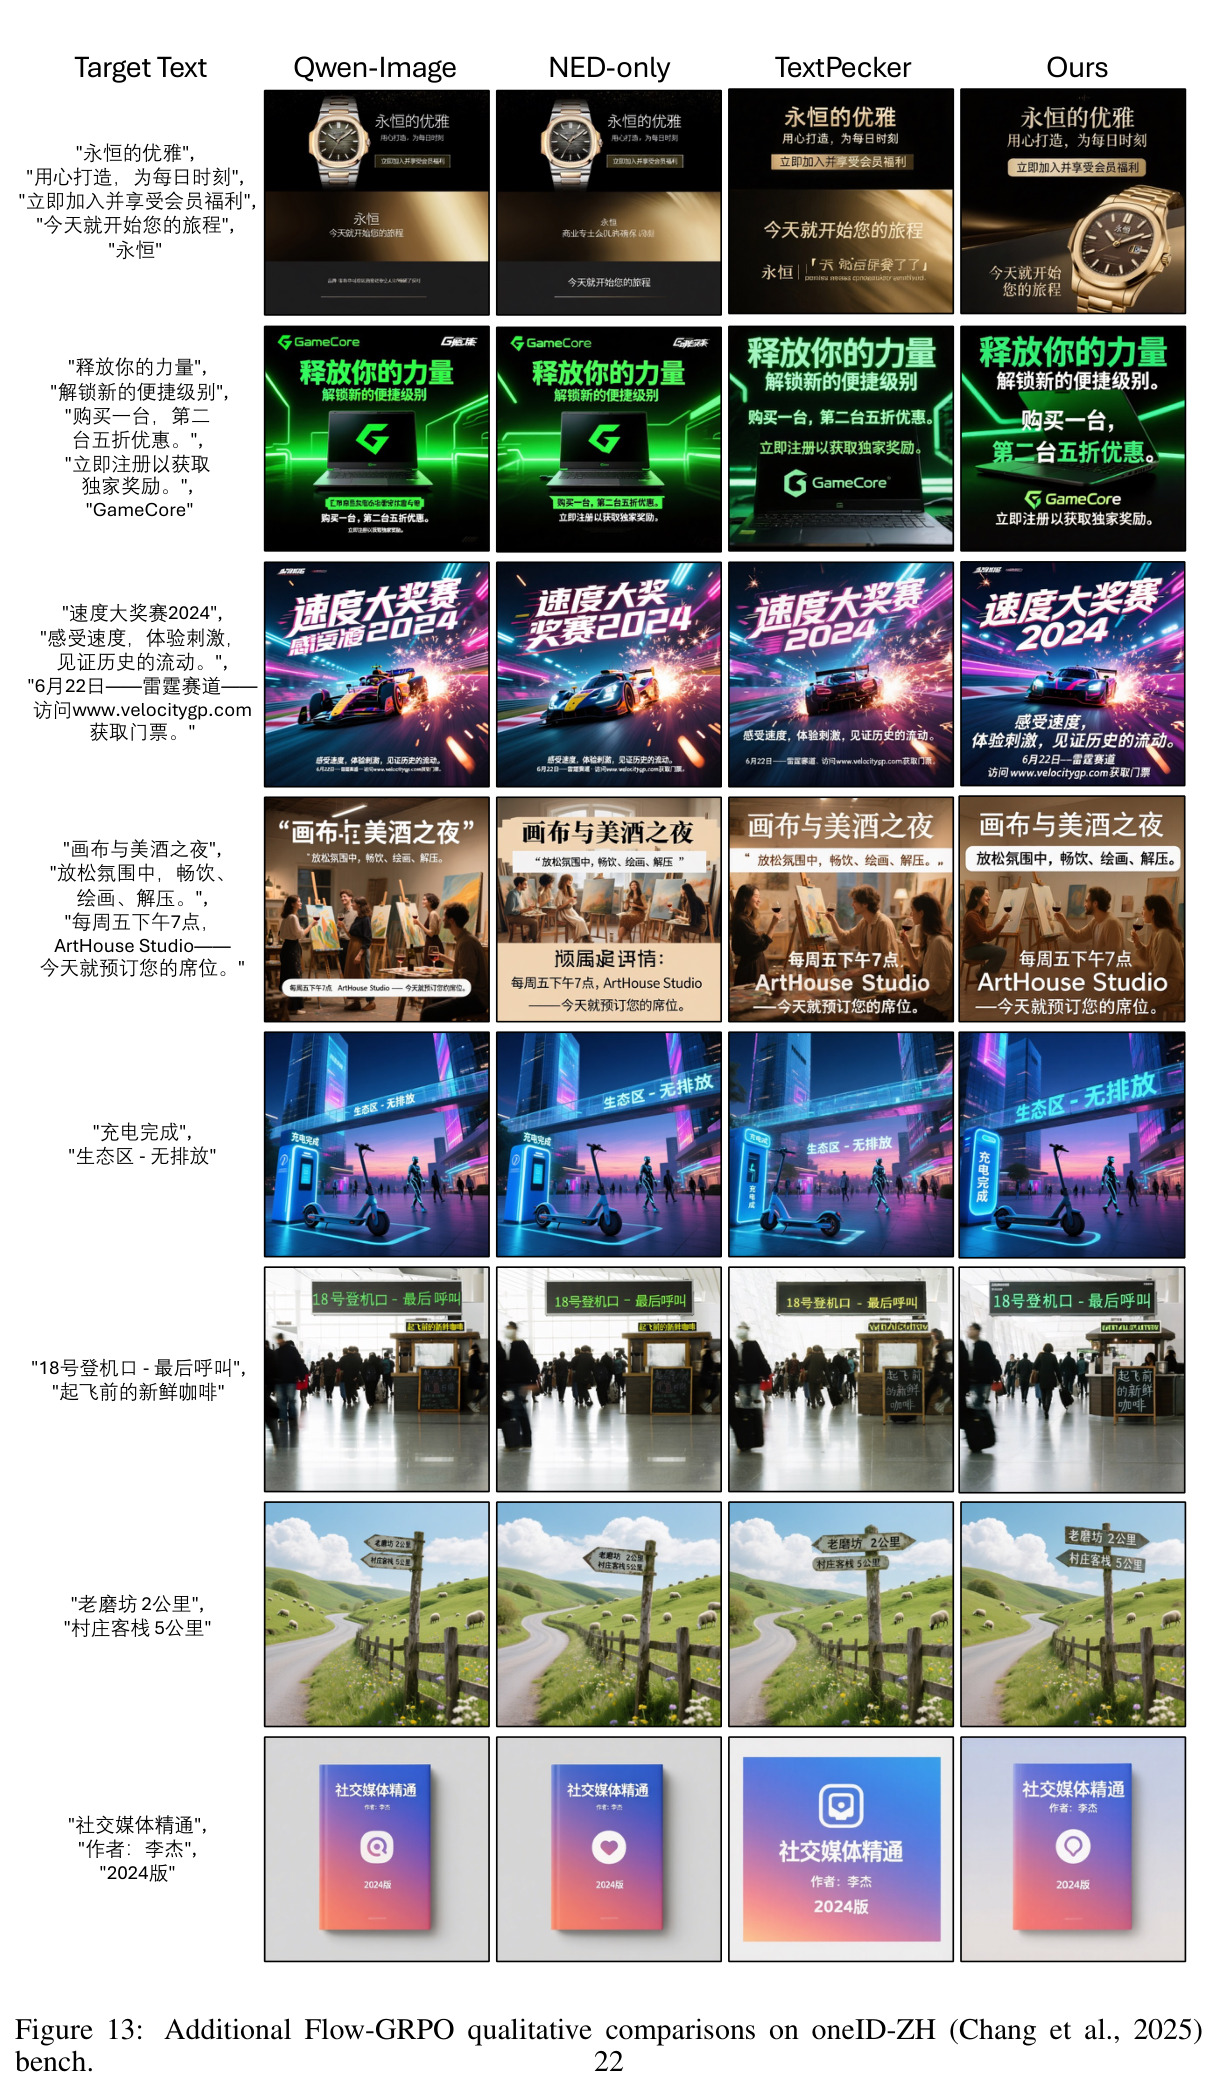
在 TextRenderBench-ZH(308 图、7,358 字、642 错误)上,TextVerifier 达 P 0.830、R 0.858、F1 0.844:PP-OCRv6 置信度调阈仅 0.526;通用 VLM 几乎不可用:Qwen3.8-Max 0.198、GPT-5.6-sol 0.101 不报错,Gemini 3.7 Flash 精确率仅 0.236;TextPecker 两权重 0.590/0.433 且误报高。效率上仅 0.36B 参数(1/23 于 TextPecker)、7.6ms/字,较 17.2/320.4ms 快 2.3 与约 42 倍。消融:单字 token 替代 IDS 使三阶段 F1 降 10.4/7.1/10.1 点(召回 0.858→0.648);损失项均必要,无阶段1预训练崩至 0.111。Flow-GRPO:Glyph-Acc 0.812→0.915 追平 TextPecker(0.919),多样性 0.1753 vs 0.1651、美学 0.6330 vs 0.6288 保留更好;NED-only 仅 0.822,字形项是增益来源。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 生成图像中文逐字渲染验证(TextRenderBench-ZH) | F1 | 0.844(P 0.830 / R 0.858) | TextPecker(Qwen3-VL-8B) 0.590;PP-OCRv6 最优阈值 0.526;Gemini 3.7 Flash 0.329;Qwen3.8-Max 0.198;GPT-5.6-sol 0.101 | 较最强基线 TextPecker +0.254(相对提升约 43%) |
| 逐字验证效率 | 中位延迟(ms/字)与打分模型参数量 | 7.6 ms/字;0.36B | PP-OCRv6 17.2 ms / 0.06B;TextPecker(Qwen3-VL-8B) 320.4 ms / 8.29B;TextPecker(InternVL3-8B) 276.0 ms / 8.1B | 比 PP-OCRv6 快 2.3 倍、比 TextPecker 快约 42 倍且参数小 23 倍,同时精度最高 |
| Flow-GRPO 后训练字形准确率(oneID-ZH) | Glyph-Acc | 0.915 | Base(Qwen-Image) 0.812;TextPecker 奖励 0.919;NED-only 奖励 0.822 | 较 Base +0.103,追平 8B VLM 奖励(差距仅 0.004)且奖励模型小 23 倍 |
| Flow-GRPO 后训练副作用控制 | DreamSim(多样性)/ ImageReward(美学) | 0.1753 / 0.6330 | Base 0.2023 / 0.6645;TextPecker 0.1651 / 0.6288 | 在真正降低渲染错误的方案中,对多样性与美学的扰动最小 |
局限与改进
作者承认的局限包括:验证依赖前端 CRAFT+PP-OCRv6 提供裁剪与目标字,定位或识别一旦出错,验证条件就随之出错;基准仅 308 张图、642 个正例,规模有限,且图像全由文生图模型生成,未必覆盖手写、极端艺术字等分布;阈值 $\delta$ 取训练分布的 90 分位,校准只在训练分布内有保证。我自己的观察:其一,分数只回答“是否正确”,不定位错在哪个笔画、部件,也不给改法,纠错只能依赖成本高的 RL 后训练,推理期定点修复(局部重绘)这一更自然的闭环并未探索;其二,每字需存 500 个正常裁剪并聚成 10 个原型,8,189 字的原型库在新增生僻字、异体字时需要额外工程,IDS 词表 981 个符号也未覆盖全部分解;其三,第三阶段相对标签依赖“晚检查点不差于早检查点”的假设,训练不稳定或风格漂移时可能失效,论文未分析噪声对占比;其四,奖励中 0.9/0.1 与 0.8/0.2 的权重为经验设定,敏感性未报告;其五,只在 Qwen-Image + Flow-GRPO 一种组合上验证,对自回归离散生成器等架构的泛化未知。
独立分析的弱点
独立分析几个弱点。第一,前端级联误差:整个系统建立在 OCR 能正确定位并识别目标字之上,而论文恰恰论证了 OCR 在风格化文本上不可靠——若 OCR 把错字“认成”另一个字,验证器会去验证错误的条件,反而放行错误;改进方向是对 top-k 候选字联合打分取最优,或并行训练一个不依赖目标字的无条件异常分支做交叉校验。第二,验证-修复闭环缺失:把分数当 RL 奖励需要整轮后训练,代价高;更实用的是把逐字分数接入推理期局部重绘做即时修复,论文训练的修复模型已具备此能力但未被串联。第三,基准正例仅 642 个,精确率/召回率置信区间较宽,且缺笔、多笔、部件错位、整字错误等类型未分层报告,无法判断模型对哪类错误最弱,建议按错误类型细分评测。第四,跨分布校准:$\delta$ 由训练分数分布决定,面对未见过的艺术字体或非平面媒介(霓虹灯、刺绣)可能系统性偏移,可引入逐字校准或保形预测给出个性化阈值。第五,IDS 覆盖面:981 符号只覆盖标准分解,扩展区生僻字、简化部件可能缺分解,长尾字全靠字体字形补齐,对真实风格化写法的验证上限存疑。
未来方向
作者方向上,验证器作奖励已被验证有效,自然延伸包括:把 $R$ 奖励迁移到其他后训练范式(DPO、偏好对齐)与其他生成器(自回归、编辑式模型);将逐字分数接入推理期搜索(best-of-N、噪声重采样)或局部重绘,实现免训练即时纠错;把 TextRenderBench-ZH 扩展为多语言基准(日文汉字假名混排、韩文)并公开。基于本文成果可继续挖掘的方向:一是错误定位与可解释验证——利用 ViT patch token 或 IDS 部件子树输出归因,指出“哪一笔错了”,进而驱动笔画级精准修复;二是校准与不确定性——为每个字、每种字体风格估计个性化阈值,输出带置信度的判定而非硬性二值;三是识别与验证的统一——训练一个既能读出字又能验证正确性的结构感知模型,摆脱对前端 OCR 的依赖,消除级联误差;四是数据引擎自动化——把“从生成器训练轨迹挖掘难负例”推广为通用配方,任何正在训练的生成模型都能为验证器提供免费监督,形成生成-验证协同进化闭环;五是覆盖手写体、书法、艺术字以及印刷品实拍场景的验证评测。
复现评估
复现评估:论文正文与附录均未提供开源代码、权重或基准的发布链接,这是最大的复现障碍。可复用的公开组件较多:Makemeahanzi 提供楷体逐笔矢量路径,CRAFT 与 PP-OCRv6 公开可跑,ViT-L/16 与 DeBERTa-v2 有开源实现,Flow-GRPO、Qwen-Image、oneID-ZH、DreamSim、ImageReward 均公开。难点有三:约 250 万张含中文的真实图像与 308 张基准图的人工标注(7,358 字逐字三元组)需自备数据与标注人力;第三阶段依赖一个自训的约 1B 参数 JiT 文字修复模型(含定制注意力掩码与 3D-RoPE),细节虽全但工程量不小;训练总算力未披露,不过验证器本体仅 0.36B、三阶段合计 5 个 epoch,推测单节点 8 卡即可承担,主要开销在修复模型训练与 Flow-GRPO 后训练;推理实测环境为 4×H800(bf16,batch=1)。总体判断:对有大模型训练经验的团队,复现验证器本体为中等难度(架构与全部超参已给出),复现完整数据管线与 RL 实验为中高难度;若作者后续开源,成本将大幅下降。
论文图表
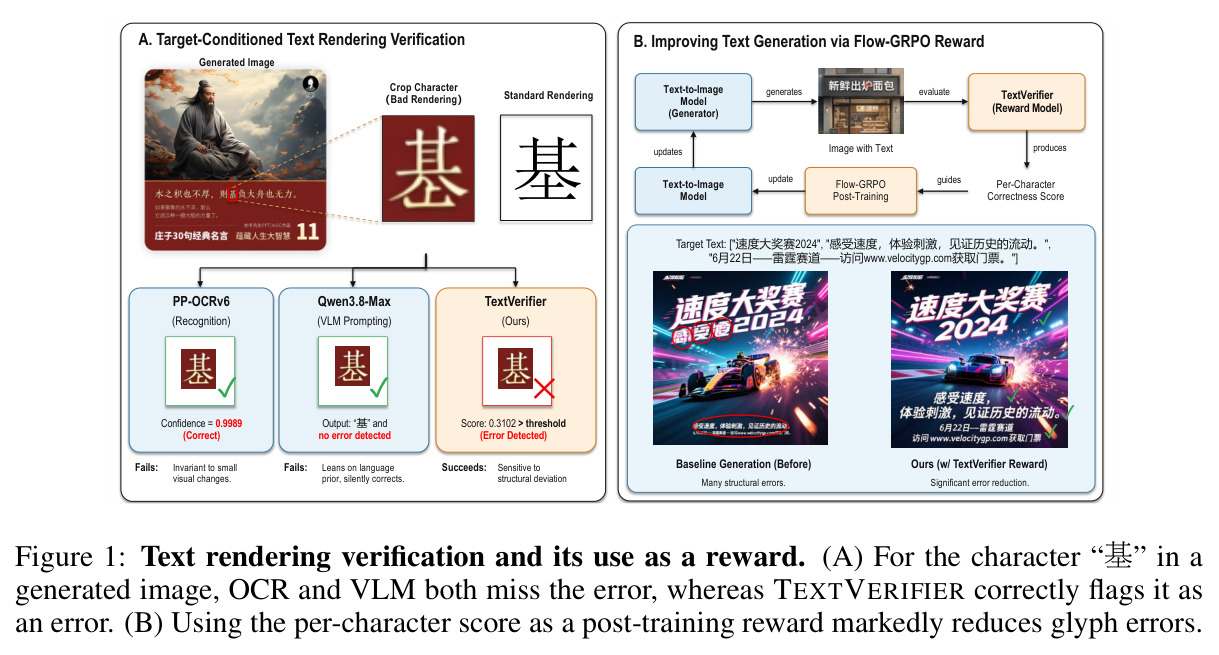
teaser 图分两部分:(A) 目标条件的文字渲染验证示意——对生成图中的“基”字,PP-OCRv6 给出 0.9989 的高置信度(漏检),Qwen3.8-Max 依语言先验也判定无误(漏检),而 TextVerifier 给出 0.3102 的分数(高于阈值,正确检出);(B) 把逐字分数作为 Flow-GRPO 后训练奖励,基线生成的多处结构错误在加入奖励后显著减少。
一张图同时呈现了问题(OCR 与 VLM 为何失灵)、解法(目标条件验证)和应用(作 RL 奖励纠错),是理解全文动机与贡献的最快入口。
主结果表:各方法的 TP/FP/FN/TN、精确率、召回率、F1、参数量与每字中位延迟。TextVerifier 三阶段 F1 0.844(P 0.830/R 0.858),远超 PP-OCRv6(0.444/0.526)、三个通用 VLM(0.101–0.329)与 TextPecker 两权重(0.590/0.433);0.36B 参数、7.6ms/字,比 TextPecker 小 23 倍、快约 42 倍。
全文最核心的证据表,所有关于“验证器是否有效、多高效”的结论都来自这里。
奖励消融:去掉字形项 G、只留识别语义项 NED 后,Glyph-Acc 仅从 Base 的 0.812 升到 0.822;完整奖励 $R=0.8G+0.2N$ 达到 0.915。
证明增益来自字形感知项而非 OCR 字符串匹配,直接支持“OCR 字符串奖励对字形盲目”的论点。
原型数 K 的扫描(冻结 90 分位阈值、阶段3模型):K=1 时 F1 0.789,K=10 达峰值 0.844(δ=0.0214),K∈[8,16] 内平稳(0.834–0.844),K=20 回落至 0.828;小 K 欠拟合多峰合法写法,大 K 碎片化降低精确率。
证明多原型读出对 K 不敏感、设计稳健,同时解释了读出机制与合法流形多峰性之间的联系。