PixText:基于像素空间分组图像生成的高效场景文本精修 Efficient Scene-Text Refinement via Pixel-Space Grouped Image Generation
PixText 在像素空间按组只重绘出错文字区域,四步生成使单图成本低于 1 GPU 秒
前置知识
流匹配(Flow Matching)
一类生成建模框架:在噪声分布与数据分布之间构造线性插值路径 $z_t = t x_1 + (1-t)\epsilon$,训练网络预测沿路径的速度场,推理时从纯噪声出发沿速度做 Euler 积分逐步走到数据端。相比标准扩散模型它路径更直、采样更简洁。
PixText 的训练目标(公式 1-2)、采样更新(公式 5)和 MeanFlow 蒸馏全部建立在流匹配框架上,不熟悉这套记号就读不懂方法章节。
VAE 潜空间压缩及其重建瓶颈
主流文生图模型不直接生成像素,而是先训练变分自编码器(VAE)把图像压缩成低分辨率潜变量(通常空间下采样 8 倍),生成网络只在潜空间工作,最后由解码器重建图像。压缩会丢失高频细节,小字笔画、精细纹理在编码-解码往返中容易被破坏。
本文的核心动机正是 VAE 重建会毁掉约 20 像素高的小字,且局部解码再贴回会产生色偏(Figure 2、3),理解这一瓶颈才能理解为何要回像素空间。
JiT 与 x-prediction
JiT(Let denoising generative models denoise,Li & He)主张去噪模型应直接预测干净图像 $\hat{x}_1$,而不是噪声或瞬时速度,再把预测转换成速度算损失、做采样;配合像素空间 DiT 使用极轻量的线性输出头,参数和计算量远小于 VAE 解码器。
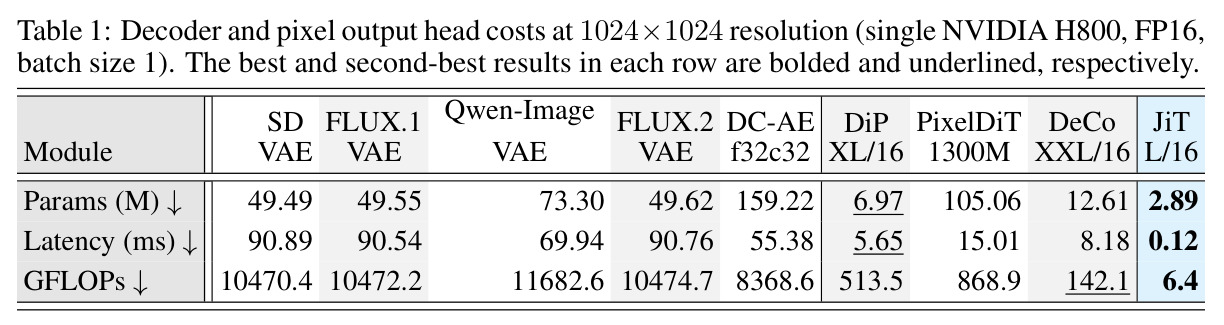
PixText 的骨干就是 32 个改造后的 Group JiT Blocks,其输出头仅 2.89M 参数、0.12ms 延迟(Table 1),是效率主张的根基。
MeanFlow 与少步蒸馏
MeanFlow 学习时间区间 $[t,s]$ 上的平均速度 $u$,满足恒等式 $u = v_\phi + (s-t)D_t u$($D_t$ 为沿教师速度的全导数),使学生无需逐点拟合瞬时速度即可少步(1-4 步)生成;论文用 DDE 有限差分估计 $D_t u$,对数值精度敏感。
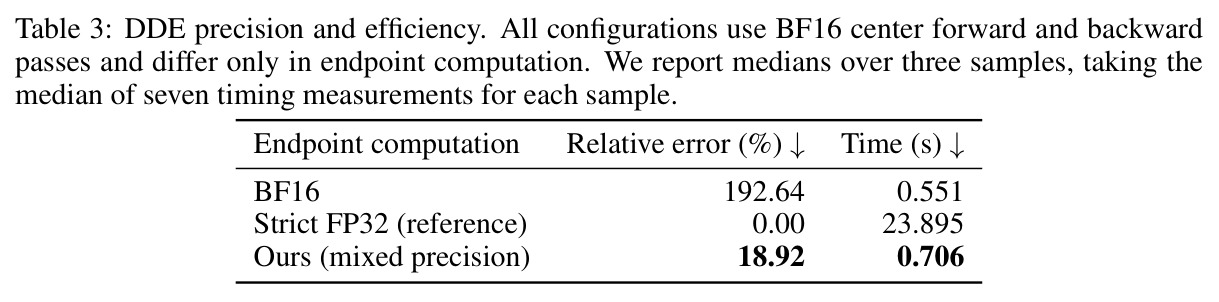
PixText 的四步快速版本靠 MeanFlow 蒸馏实现,论文还专门分析了 DDE 的混合精度方案(Table 3),是复现的关键细节。
3D RoPE 与位置编码
RoPE(旋转位置编码)通过把坐标相关的旋转作用到 query/key 上来注入位置信息,天然支持相对位置与外推。本文用三维坐标 $(n, (y-H/2)/p, (x-W/2)/p)$:第一维区分图像角色(0 主图/1 条目/2 字形),后两维是连续的物理像素坐标除以 patch 大小。
CCPE(中心化连续位置编码)靠它把任意偏移的裁剪区域与主图在同一坐标系对齐,是「分组生成」能工作的核心机制(公式 3、Figure 8)。
无分类器引导(CFG)
训练时以一定概率随机丢弃条件(这里以 0.1 概率丢字形条件),推理时同时计算有条件与无条件预测,按 $\hat{x}^{CFG} = \hat{x}^{uncond} + \gamma(t)(\hat{x}^{cond} - \hat{x}^{uncond})$ 外推,用引导尺度 $\gamma$ 换取条件服从度。
PixText 用字形条件 CFG(scale 3.3,仅在 $0.1<t<1$ 激活)提升文字准确性,附录 B 说明其在 MeanFlow 中如何等价地作用于平均速度。
研究动机
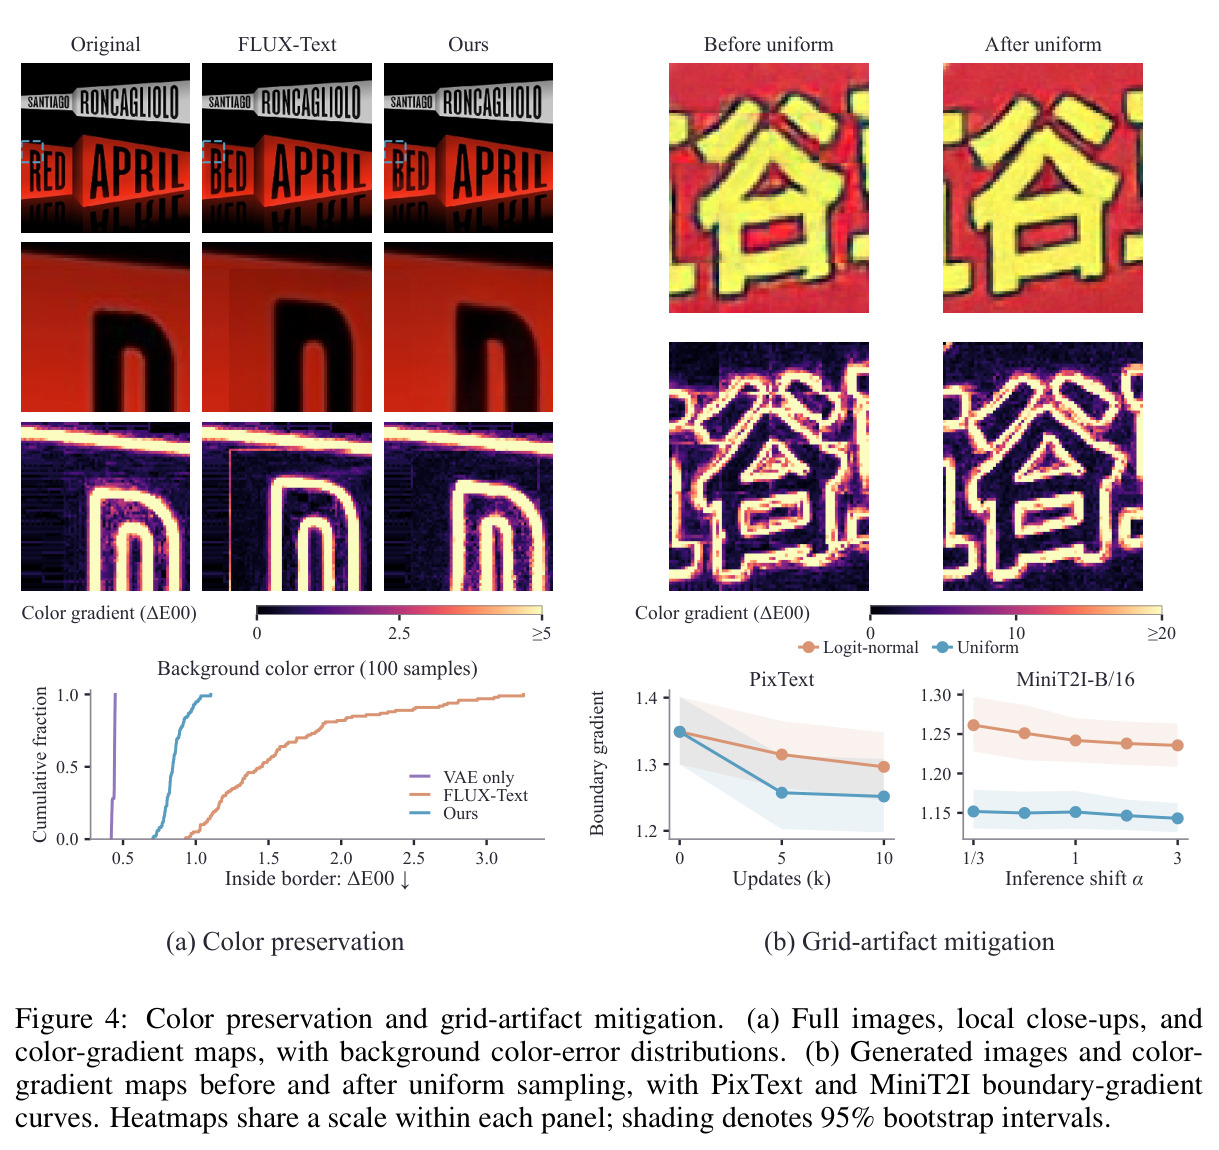
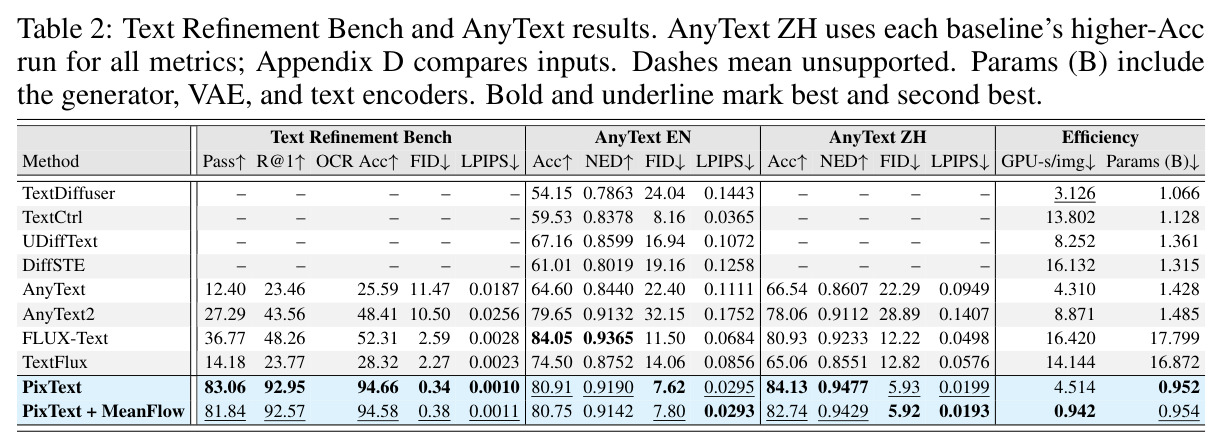
大型文生图模型生成的图像整体布局与内容已经很连贯,但小字号文本和笔画复杂的汉字仍频繁出错,这些错误只占画面极小区域,却直接决定海报、广告等场景图的可读性与可用性。在通用模型内部继续压榨文字精度存在两难:LongCat-Image 的预训练经验表明,加入合成文本数据能提升文字准确率却损害整体视觉连贯性,只能后期动态下调采样比例甚至移除;对文字奖励做过强的后训练优化又会把文字变得过大过突兀,破坏美感。现有场景文本编辑方法(AnyText、AnyText2、FLUX-Text 等)几乎都构建在 VAE 潜空间之上,对整图潜变量做修补再解码:一方面 VAE 压缩会让约 20 像素高的小字在重建后难以辨认(SD、FLUX.1、Qwen-Image 三家 VAE 全部中招),另一方面局部解码再贴回会引入超出 VAE 本身重建误差的背景色偏与粘贴接缝(加 32 像素上下文也不行)。此外这些方法要加载大型生成网络与 VAE 编解码:FLUX-Text 参数量 17.8B、单图 16.42 GPU 秒,拿来做几个字的局部修正既浪费又难以同时满足准确性、保持性、效率三重要求。
本文的目标是论文的目标是把「局部文字精修」从通用图像生成中剥离出来,做成一个独立、轻量、可控的修补模型:给定一张已有小错的生成图和每个错误区域的目标文字,模型只重绘这些文字区域——忠实写出正确字形(准确性)、保证未编辑区域的像素与背景颜色完全不变(保持性)、把单图修正的计算成本压到实用水平(效率)。具体量化目标包括:在自建的 Text Refinement Bench(1,034 张图、2,638 个修复目标)上大幅超越现有文本编辑基线的 Pass 与 OCR 准确率;在传统 AnyText Bench 的中英文文字生成上保持竞争力(中文句子准确率 84.13% 为全场最高);通过四步 MeanFlow 蒸馏把摊销生成成本降到 1 GPU 秒/图以下(实测 0.942 GPU-s/img),使局部修字能嵌入日常生成流水线。同时作者希望填补评测空白:AnyText Bench 只评常规文字生成,缺少针对生成图局部文字错误、带字符级标注的可复现基准,因此还要构建统一评测协议(修正准确率 + 背景保持 + 推理效率)并公开。
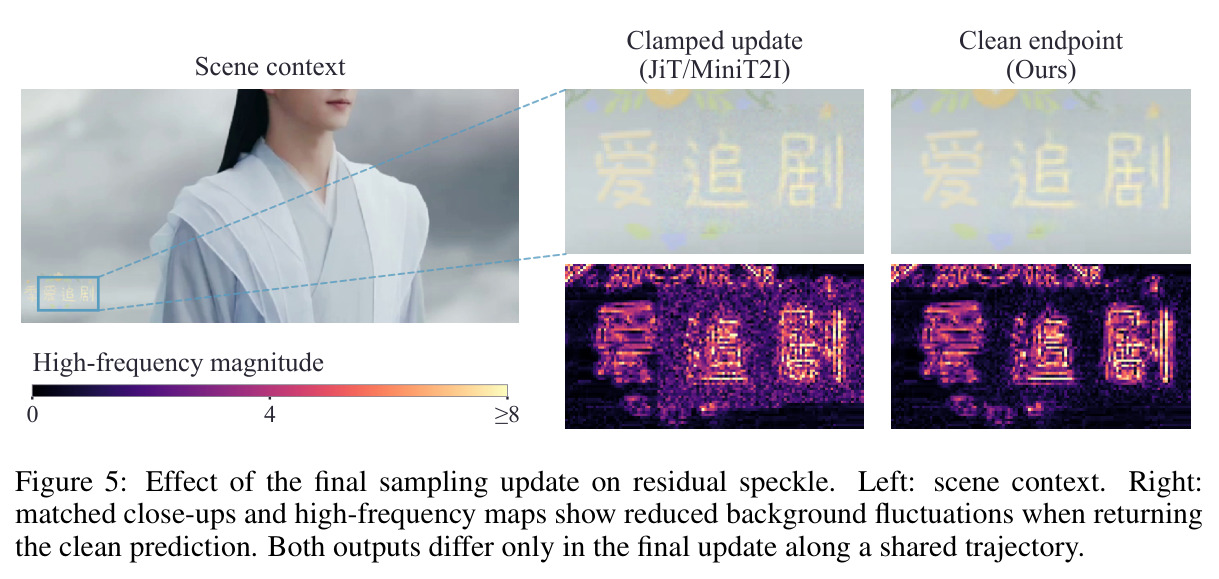
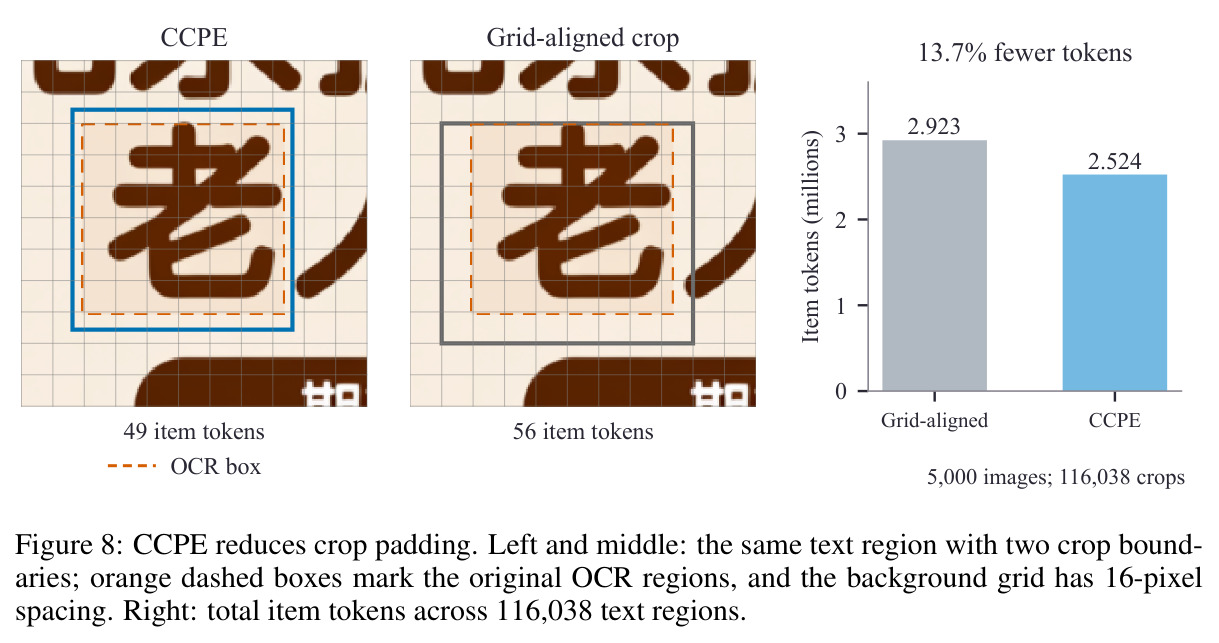
与已有工作不同的是,本文的独特切入角度是把文字精修重新表述为「像素空间中的分组图像生成」,同时跳出了两个行业默认假设。其一是「文字编辑必须在 VAE 潜空间做」:作者用实验证明 SD、FLUX.1、Qwen-Image 的 VAE 都会让约 20px 的小字难以辨认、局部解码贴回必然色偏,于是彻底抛弃 VAE,直接在像素空间建模,用 JiT 的轻量输出头(2.89M 参数、0.12ms、6.4 GFLOPs,不足被测 VAE 解码时间的 1%)替代解码器。其二是「编辑就要整图重绘」:作者把上下文与生成目标解耦——原图(擦除错字后)作为 main 图像提供场景信息,待修区域打包成一组 item 图像,模型只预测 item 像素再贴回原图,生成范围随编辑区域大小伸缩,未编辑像素零改动。配套的中心化连续位置编码 CCPE 让任意偏移的裁剪与主图同坐标系对齐,比网格对齐裁剪省 13.7% 的 token。再叠加两个训练/推理小改进(uniform 时间步采样缓解网格伪影、采样终点直接返回干净预测消除残斑)和 MeanFlow 四步蒸馏补齐效率短板。这套组合拳此前没有人对文字精修任务做过。
核心方法
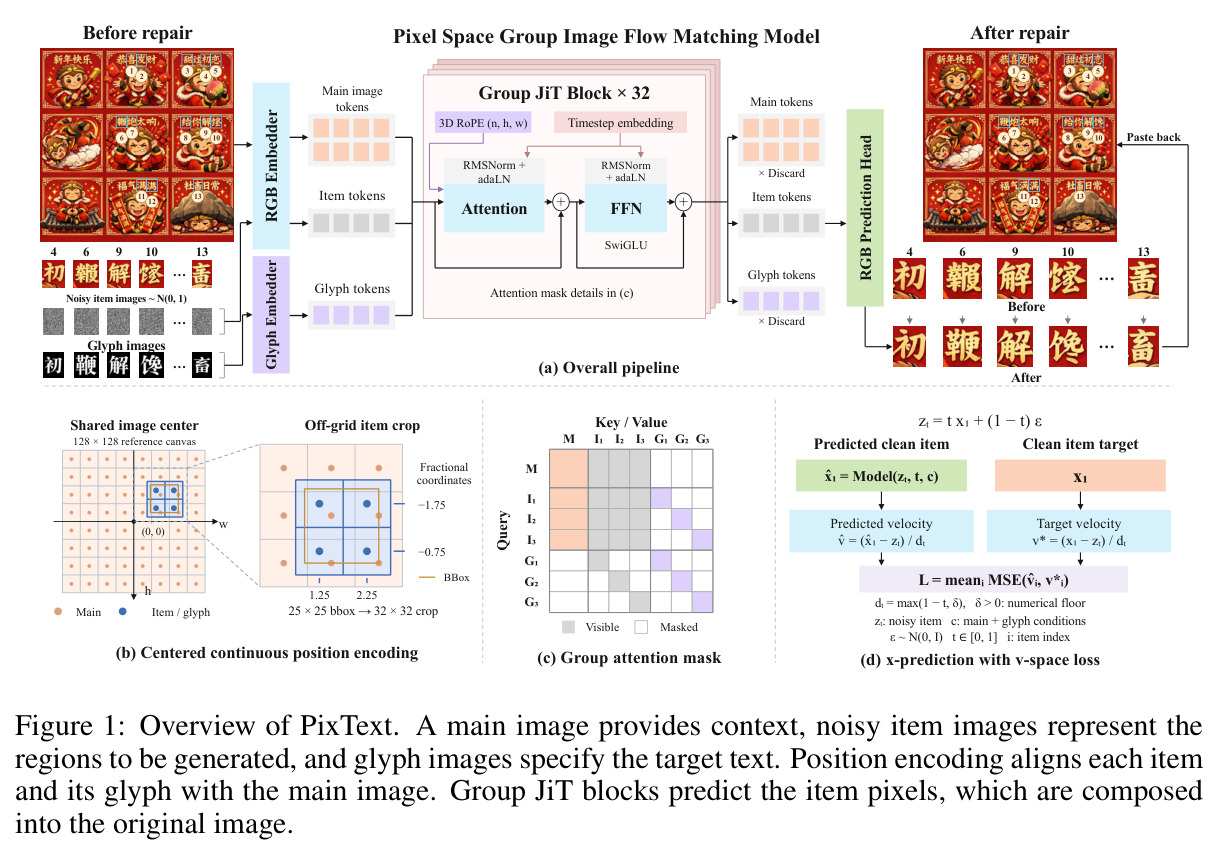
PixText 的思路是:不编辑整图,而是按组生成几个小图块再贴回原图。模型是像素空间流匹配 Transformer:主图(错字已局部模糊擦除)、item 图像(初始化为高斯噪声的裁剪区域)、字形图像(PIL 渲染的目标文字灰度图)三类 token 拼接,经 32 个 Group JiT Blocks(hidden 1280、patch 16)联合处理,直接预测 item 的干净像素 $\hat{x}_1$。训练用线性噪声路径 $z_t = t x_1 + (1-t)\epsilon$,把干净预测转成速度 $\hat{v}_t = (\hat{x}_1 - z_t)/d_t$($d_t = \max(1-t, 0.05)$)与目标速度做 MSE,损失逐 item 等权平均。推理从噪声出发,用 25 步 Euler 或四步 MeanFlow 学生更新 item,再把预测像素贴回原图。时间步经 adaLN-Zero 注入:item 用当前 $t$,主图与字形固定为干净端 $t=1$;推理用字形 CFG(scale 3.3)。模型仅 0.952B 参数,不含 VAE 与文本编码器。
核心创新是把文字精修表述为「分组图像生成」并配套定制机制,与已有方法的区别有三层。第一,上下文与生成目标分离:现有方法(FLUX-Text 等)采用整图 inpainting,即便只改几个字也要更新并解码整图潜变量,导致背景色移与粘贴接缝;PixText 只把 item 区域放进噪声分支,输出天然是局部贴片,未编辑像素保证逐位不变。第二,CCPE 中心化连续位置编码:用 3D RoPE 坐标 $(n, (y-H/2)/p, (x-W/2)/p)$ 编码主图(n=0)、item(n=1)、字形(n=2),字形与配对 item 共享空间坐标、靠角色坐标区分,裁剪可从任意像素位置开始,不受主图网格约束,116,038 个文本区域上省 13.7% token。第三,注意力掩码精确编码交互规则:主图与 item 双向交互、item 之间互看以共享场景上下文,每个字形只与配对 item 跨图交互,保证字与区域的对应;配合 FlexAttention 块稀疏掩码做变长分组批训练。主图与 item 共享 RGB embedder、字形独立 embedder,目标文字全由字形图像指定,省掉文本编码器。
方法步骤详情
流程分三步。(1) 数据准备:CRAFT 检测文本区域、PaddleOCR 识别内容构造字形条件;中文按字符级、英文按词级区域;训练集约 253 万条中英文记录。(2) 训练:目标区域先模糊擦除原字,主图取擦除后的图;item 加噪 $z_t = t x_1 + (1-t)\epsilon$,预测干净 item 转速度后按公式 (4) 算 MSE;两阶段渐进分辨率(约 13 epoch 限主图 ≤512² 像素、再约 15 epoch ≤1024²),AdamW lr=1e-4;时间步先用 logit-normal(µ=−0.8, σ=0.8)后切 uniform 以抑制网格伪影;以 0.1 概率整组丢弃字形条件支持 CFG。(3) 采样:25 步 Euler,关键改动是最后一步直接返回干净预测——若沿用 $d_t=\max(1-t,0.05)$ 的钳制速度,终点只走完 40% 路程、残留 60% 噪声成斑点;四步版用 MeanFlow 蒸馏:学生从教师 EMA 初始化、以区间端点 $s$ 为条件,用 DDE 中心差分(h=0.005)估计全导数,按区间平均速度走 4 步。
技术新颖性
技术新颖性有四点。其一,「像素空间 + 局部分组」的组合是新的:像素空间生成(JiT、MiniT2I 等)此前面向整图文生图,场景文本编辑此前依赖潜空间,本文首次把两者嫁接到文字精修上,任务特性(只生成小块、有原图上下文)恰好化解像素空间计算量大的弱点。其二,CCPE 是对 RoPE 的巧妙复用:连续坐标让任意偏移裁剪天然对齐、角色坐标区分图像身份,一个公式同时解决跨尺度对齐与省 token 两个问题。其三,修复两个被忽视的缺陷:网格伪影可通过把时间步从 logit-normal 换成 uniform 显著缓解——PixText 边界梯度配对差 −0.0573(CI 不含零),MiniT2I-B/16 上同样有效(1.2419→1.1511),可迁移到其他 JiT 系模型;采样终点把「速度分母钳制」换成直接返回干净预测,消除共有背景残斑。其四,工程洞见:DDE 有限差分对精度极敏感(BF16 端点误差 192.64%),混合精度(端点 FP32、矩阵乘 TF32、中心 BF16)把误差降到 18.92%,比严格 FP32 快约 34 倍。这些改进构成可复用的像素空间局部生成配方。
实验结果
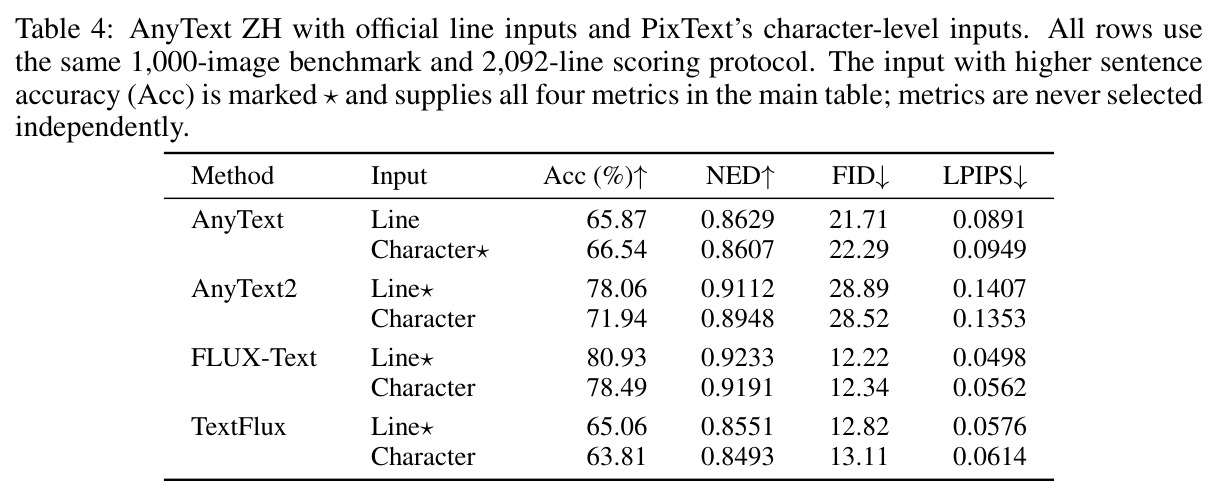
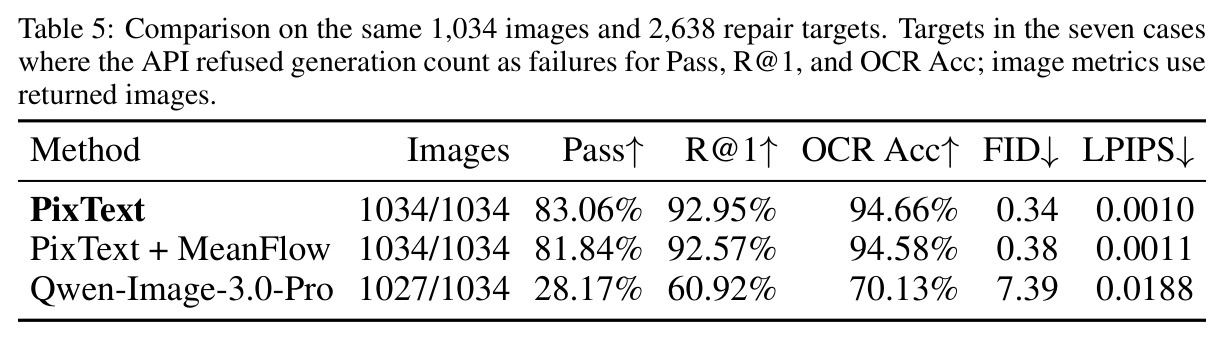
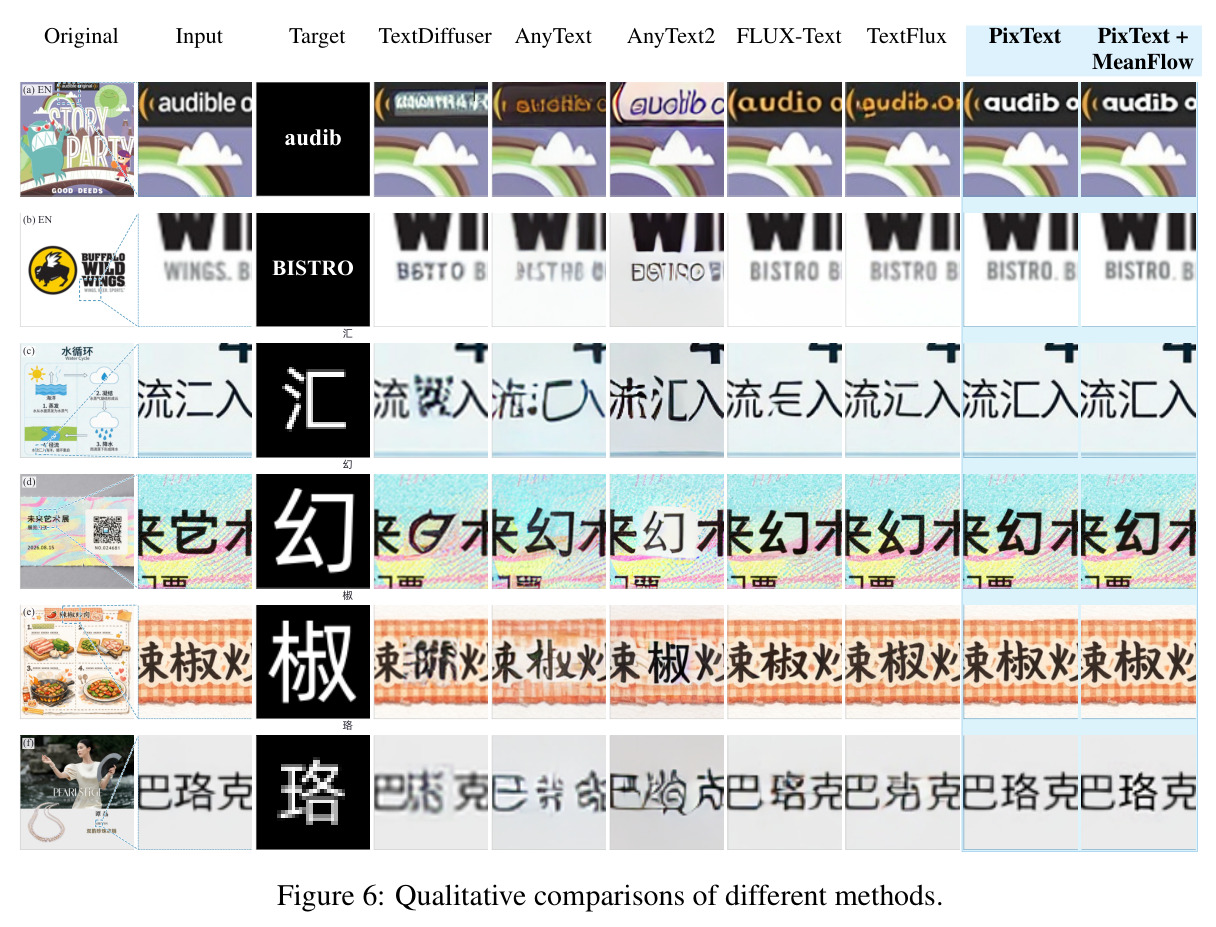
主实验在自建 Text Refinement Bench(1,034 图、2,638 目标)和 AnyText Bench 展开。前者上 PixText 取得 Pass 83.06%、R@1 92.95%、OCR Acc 94.66%、FID 0.34:最强基线 FLUX-Text 仅 Pass 36.77%、OCR 52.31%、FID 2.59。四步 MeanFlow 版 Pass 81.84%、OCR 94.58%,仅低教师 1.21 个百分点,摊销成本从 4.514 降到 0.942 GPU-s/img,参数 0.954B vs FLUX-Text 17.8B。AnyText ZH 上句子准确率 84.13% 全场最高(FLUX-Text 80.93%);AnyText EN 上 80.91% 居第二。Qwen-Image-3.0-Pro 编辑 API 仅 Pass 28.17%、OCR 70.13%,且 7 图拒绝生成。消融:uniform 时间步显著降低 patch 边界梯度;DDE 混合精度把导数误差 192.64%→18.92%,比严格 FP32 快约 34 倍。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 局部文字精修(Text Refinement Bench) | Pass ↑ | 83.06%(MeanFlow 4 步:81.84%) | FLUX-Text 36.77% | +46.29 个百分点(约 2.26 倍) |
| 局部文字精修 | OCR Acc ↑(PP-OCRv6) | 94.66% | FLUX-Text 52.31% | +42.35 个百分点 |
| 局部文字精修 | FID ↓ | 0.34 | FLUX-Text 2.59(全场次低为 TextFlux 2.27) | 较最强基线降低 86.9% |
| 局部文字精修 | GPU-s/img ↓ | 0.942(MeanFlow 4 步) | TextDiffuser 3.126(基线中最低) | 约 3.3 倍加速;较 25 步教师 4.514 快 4.8 倍 |
| 中文视觉文字生成(AnyText ZH) | 句子准确率 Acc ↑ | 84.13% | FLUX-Text 80.93% | +3.20 个百分点(全场最高) |
| 英文视觉文字生成(AnyText EN) | 句子准确率 Acc ↑ | 80.91% | FLUX-Text 84.05% | −3.14 个百分点(位居第二) |
| 与通用编辑大模型对比(Text Refinement Bench) | Pass ↑ | 83.06% | Qwen-Image-3.0-Pro API 28.17% | +54.89 个百分点,且 API 有 7 图拒绝生成 |
局限与改进
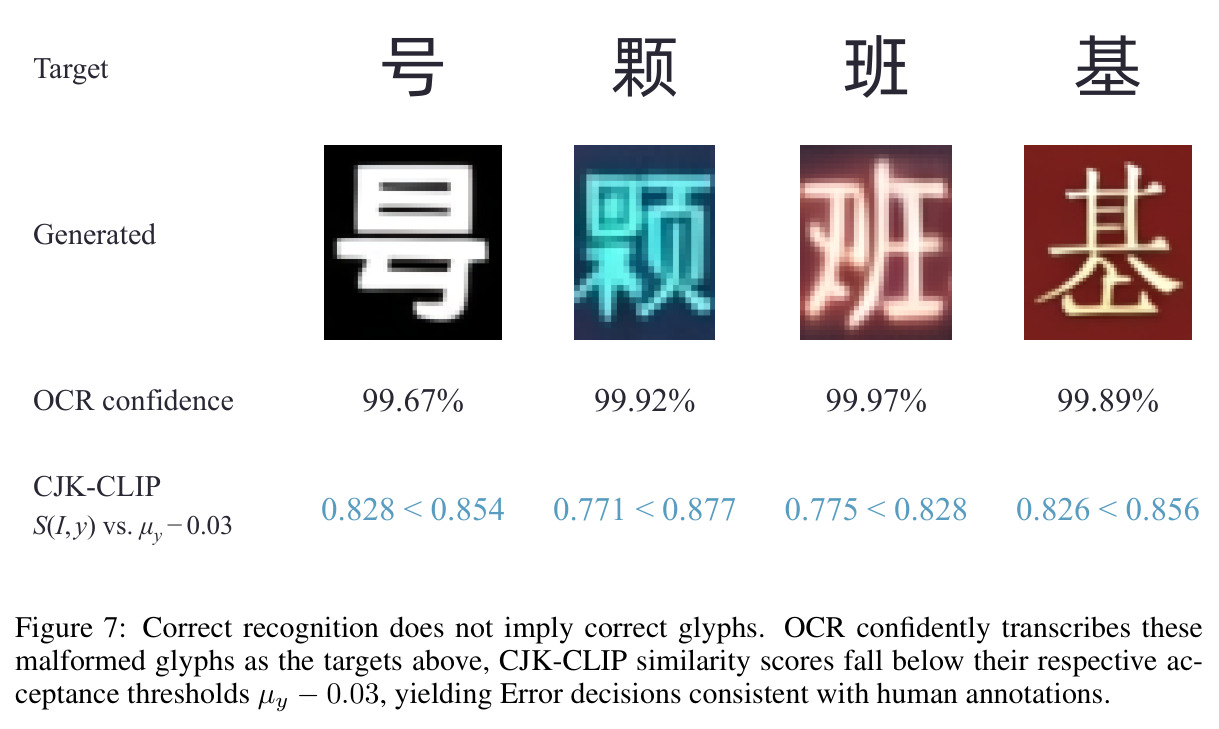
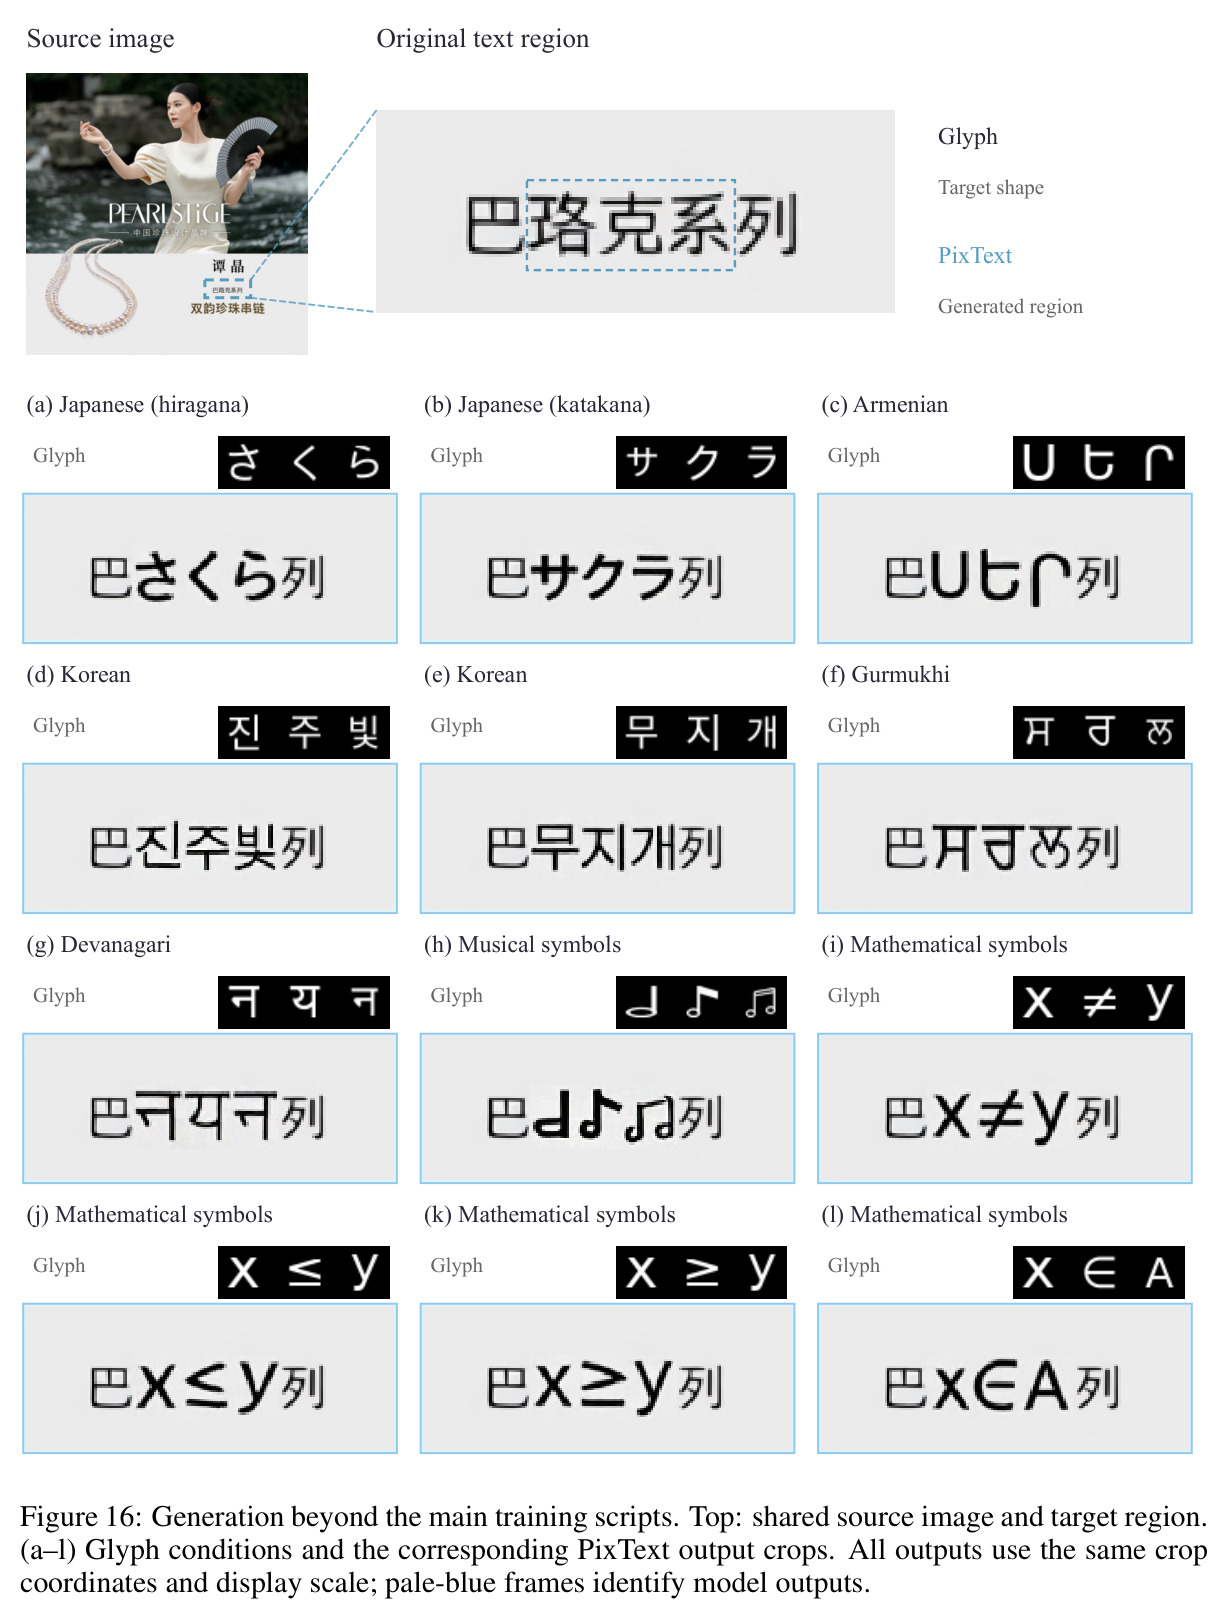
作者承认或可推知的局限:(1) 训练数据以中英文为主,其他文字系统未训练——附录 H 展示了凭字形条件泛化到日韩文、天城文及数学符号的定性结果,但明确定位为探索,无定量保证;(2) 核心评测依赖 CJK-CLIP 这一内部字形识别器,论文注明其尚在审稿、模型「将公开发布」,发布前 Pass/R@1 无法复算;(3) 基准由模型生成图构建,错误类型分布受限于现有生成模型的失败模式,对真实拍摄场景(运动模糊、透视等)的覆盖未知;(4) 使用前提是已给定错误区域 bbox 与目标文字,端到端「自动发现并修正错字」未解决——而 Figure 7 表明 OCR 恰恰经常察觉不到字形错误(高置信度错误转录);(5) AnyText EN 上仍落后 FLUX-Text 3.14 个百分点,0.95B 像素空间小模型在英文长文本重建上有差距。我的观察:粘贴回填假设局部文字不需要与背景做光照、透视的全局协调,对弯曲路面透视大字、布料印花字等深度耦合场景可能不适用;四步学生与教师间 1.21 个百分点的 Pass 差距,暗示极端复杂字形可能仍需多步。
独立分析的弱点
独立分析几个弱点。第一,错误检测与目标文字来源未闭环:流水线假设已有字符级 bbox 和正确文本,而真实场景中最麻烦的恰是「OCR 认不出错误」(Figure 7 中错字形以 99% 以上置信度被正确转录),可探索用 CJK-CLIP 分数对生成图全量文字扫低分区域、与 OCR 交叉验证形成闭环。第二,评测对内部组件依赖强:CJK-CLIP 发布前 Pass/R@1 不可复现,建议并行报告公开可算的替代指标(多 OCR 投票一致率、笔画级结构相似度)。第三,擦除用局部模糊,对水面、格栅等复杂纹理背景会破坏待重建的纹理,模型需「脑补」被抹掉的内容,可研究更保守的掩码或背景修补先验。第四,分组生成要求一次处理所有目标区域,多区域大图的 token 数上升,论文未报告极端多区域情况的开销与质量,可用区域采样或级联分组缓解。第五,四步学生在复杂字/长英文词上的失败模式缺乏系统分析,可做步数自适应路由:简单修复走 4 步、疑难字回退 25 步教师。第六,uniform 时间步缓解网格伪影目前是经验发现,值得从频谱偏差或 score 方差角度给出理论解释。
未来方向
论文方向之外可自然延伸:(1) Figure 16 展示的字形条件泛化(日韩文、音乐/数学符号)可系统化为多语言统一修字模型——字形渲染天然跨语言、无需文本编码器,适合开放词表文字编辑;(2) 把 Text Refinement Bench 与生成流水线串联,形成「生成→自动检测低分文字→局部精修→回贴」的标准后处理环节,并研究检测器召回-精度权衡;(3) 将 uniform 时间步采样与终点干净预测推广验证到更多像素空间模型(PixelDiT、DiP、DeCo),沉淀为通用训练准则;(4) MeanFlow 原生支持一步生成,可探索 1–2 步局部修字,把单图成本压到百毫秒级;(5) 与底层生成模型协同:在文生图训练中引入「PixText 式局部重绘」作为一致性正则或数据增强,从源头减少错字;(6) 扩展到视频:对生成视频中的文字逐帧精修需保证时序一致,分组框架可扩展为跨帧共享 item 与字形条件;(7) 构建包含真实拍摄图、透视/形变文字、多语言混排的更大规模基准,并研究基于「OCR 高置信但 CJK-CLIP 低分」矛盾信号的错字自动挖掘。
复现评估
复现评估:论文未提及开源代码或权重(仅承诺 CJK-CLIP 将公开,且其论文在审);Text Refinement Bench 承诺公开(1,034 图、2,638 目标,人工复核标注)。评测协议细致:CJK-CLIP 相似度以阈值 $\mu_y-0.03$ 判 Pass、PP-OCRv6 做 OCR Acc、GPU 计时协议(H800、batch 1、32 张抽样)均有公式与数字。训练成本高:8×H800、约 253 万条中英文数据、13+15 epoch 渐进分辨率训练加约 3,000 步 MeanFlow 蒸馏,估计数百 GPU 时。模型仅 0.952B 参数(32 层 DiT),关键实现与超参(FlexAttention 变长批训练、DDE 混合精度、lr 1e-4、CFG 3.3、DDE h=0.005)均已披露,复现难度中等:最大门槛是内部数据不公开,其次是 CJK-CLIP 发布前 Pass/R@1 不可复算。验证消融可用公开 MiniT2I 权重低成本复现 uniform 时间步与终点更新对照。
论文图表
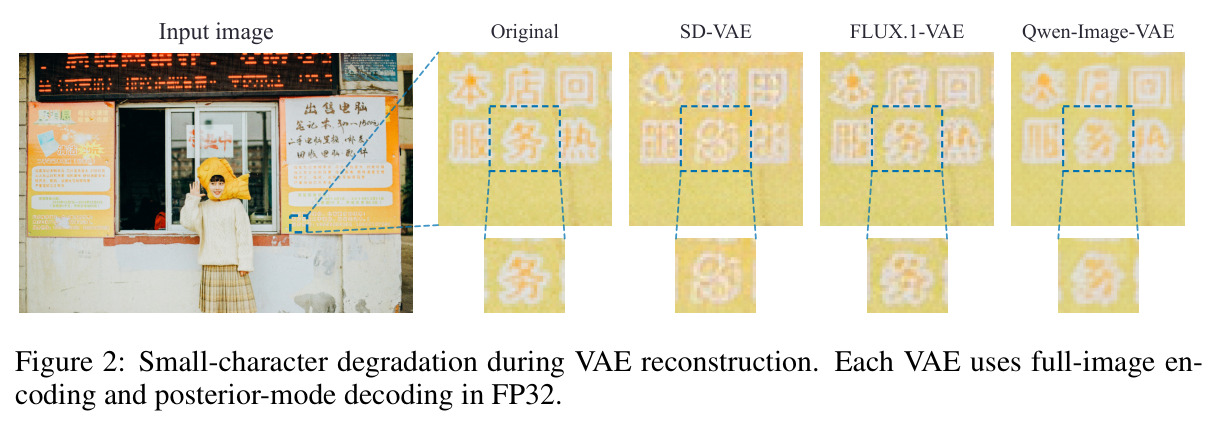
一个约 20 像素高的字符分别经过 SD-VAE、FLUX.1-VAE、Qwen-Image-VAE 的全图编码与后验模式解码(FP32)后变得难以辨认,原图与三个重建结果并排对比。
这是「为什么必须抛弃 VAE、回到像素空间」的核心证据,直接支撑论文最根本的动机主张。
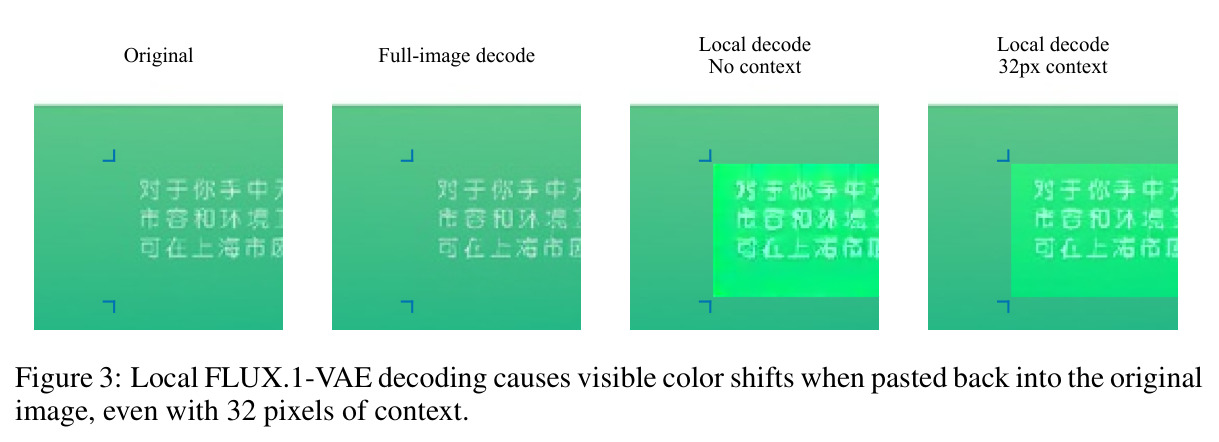
对同一全图潜表示分别做全图解码与仅目标区域局部解码(无上下文 / 32px 上下文两种设置),局部解码结果贴回原图出现肉眼可见的颜色不匹配。
证明「潜空间局部编辑+局部解码再贴回」这条看似便宜的捷径无法保证颜色一致性,为像素空间分组生成提供了第二个动机证据。