UltraText Bench:面向图像生成中视觉文字渲染的双语综合评测基准 UltraText Bench: A Comprehensive Bilingual Benchmark for Evaluating Visual Text Rendering in Image Generation
432条双语密集文字提示与整图VLM评审,全面检验图像模型的长文本渲染能力
前置知识
文生图扩散模型(T2I)
一类从噪声逐步去噪生成图像的深度生成模型,以文本编码器(如 CLIP、T5)的输出为条件控制画面内容。现代主流实现多为 DiT 或 UNet 架构的潜空间扩散模型,图像先经 VAE 压缩为潜变量再建模,其连续生成机制天然容忍近似相似。
本文评测对象正是这类模型。理解扩散模型「近似即可」的连续生成原理,才能明白为何离散、逐字符精确的文字渲染对它格外困难,也才能理解 Base/Turbo 加速对文字保真度的影响。
视觉文字渲染(Visual Text Rendering)
指在生成图像中渲染出可读、拼写正确且位于指定位置的文字,载体包括招牌、海报、菜单、收据、表单、代码等。与普通语义对齐不同,文字是离散的组合结构,错一个字符、漏一段文字或贴错载体都算失败。
这是本文的评测任务本身:基准的场景分类学、难度分层、区域标注和六项评分细则全部围绕「密集文字能否被正确复现」这一目标设计。
VLM-as-Judge(以视觉语言模型作评审)
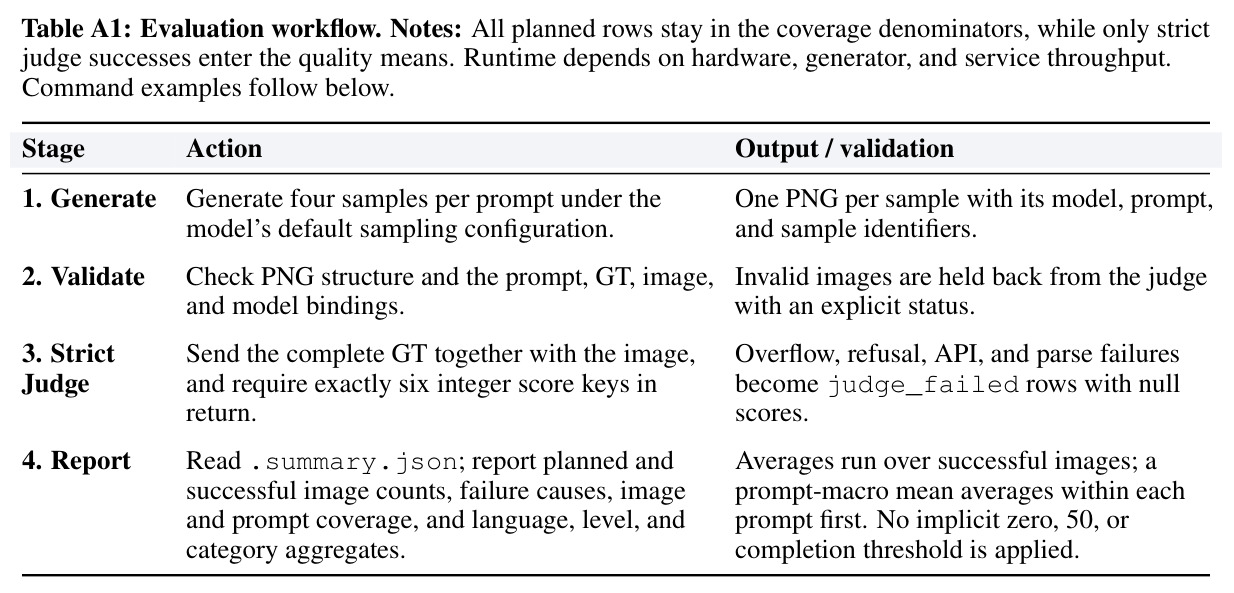
用多模态大模型代替人工或 OCR,按给定评分细则(rubric)对生成图像打分:评审模型接收图像和结构化参考,按约定格式输出分数。本文使用 Q-Judger,温度 0.0、关闭思考、严格校验六键 JSON 输出,失败响应不折算成分数。
UltraText 的全部排行榜分数由 VLM 评审产生。理解其工作方式与失效模式(漏检可见文字、给残缺小字打满分)是正确解读实验结果与基准可信度的前提。
OCR 与文本保真度指标
OCR 从图像中识别文字后与目标串比对,计算准确率、编辑距离或 PNED 等指标;PNED 把词当作无序集合匹配并惩罚多余项。OCR 结果依赖检测器、识别器、字体、尺度和语言设置,VLM 读取还可能「默纠」图中实际写错的字符。
本文论证单一 OCR 分数无法反映位置、载体与可读性,这正是它改用「整图 VLM 评审 + 结构化区域参考」的核心动机,也是读懂相关工作对比的关键。
研究动机
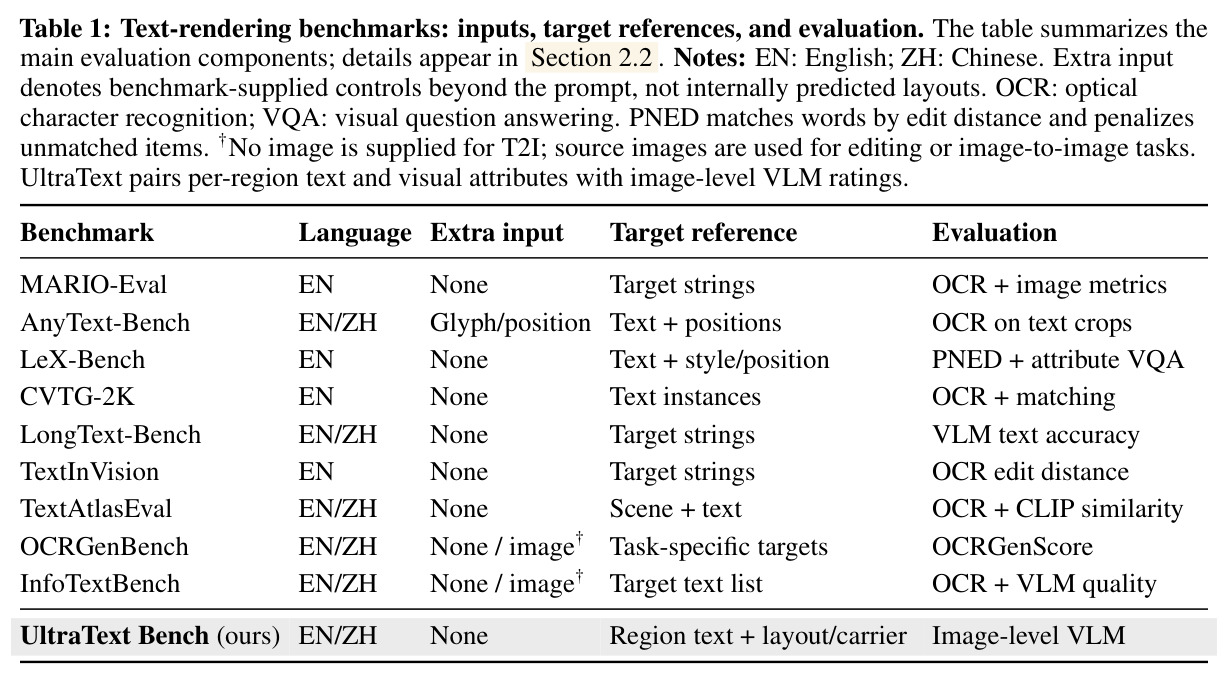
现有文生图模型在短文本渲染上已大幅进步(GPT Image、Qwen-Image、FLUX 等),但真实应用——海报、产品包装、收据、发票、表单、界面——要求在多个区域持续渲染数百到数千个字符:标题、正文、小字辅助区域必须同时正确且可读。价格错一位、营业时间写错,即使整体构图和字体看起来无懈可击,图像传达的信息也已经错了。而现有评测彼此割裂:MARIO-Eval 只测短关键词;CVTG-2K 用 OCR 匹配,PNED 这类指标把词当无序集合,完全不知道文字落在哪个载体上;STRICT 只在空白页上变长单一序列;最接近的 InfoTextBench 给目标串列表并用 OCR/VLM 打分,但缺少统一的区域级参考(文字应在哪个位置、写在什么表面上)。更关键的是,局部成功会掩盖整图失败:一张店招渲染完美,画面其余五个区域却可能缺失、错字、不可读、放错位置或与载体脱节,而现有协议大多无法系统性暴露这类整图级错误。
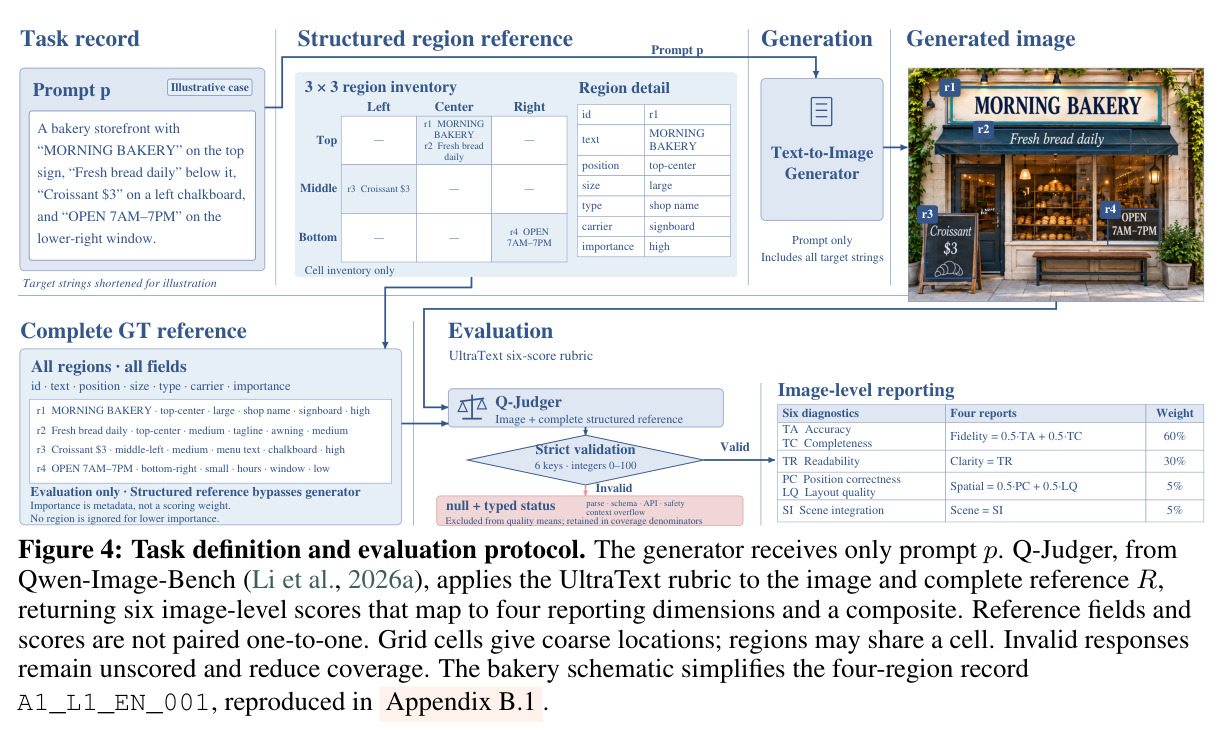
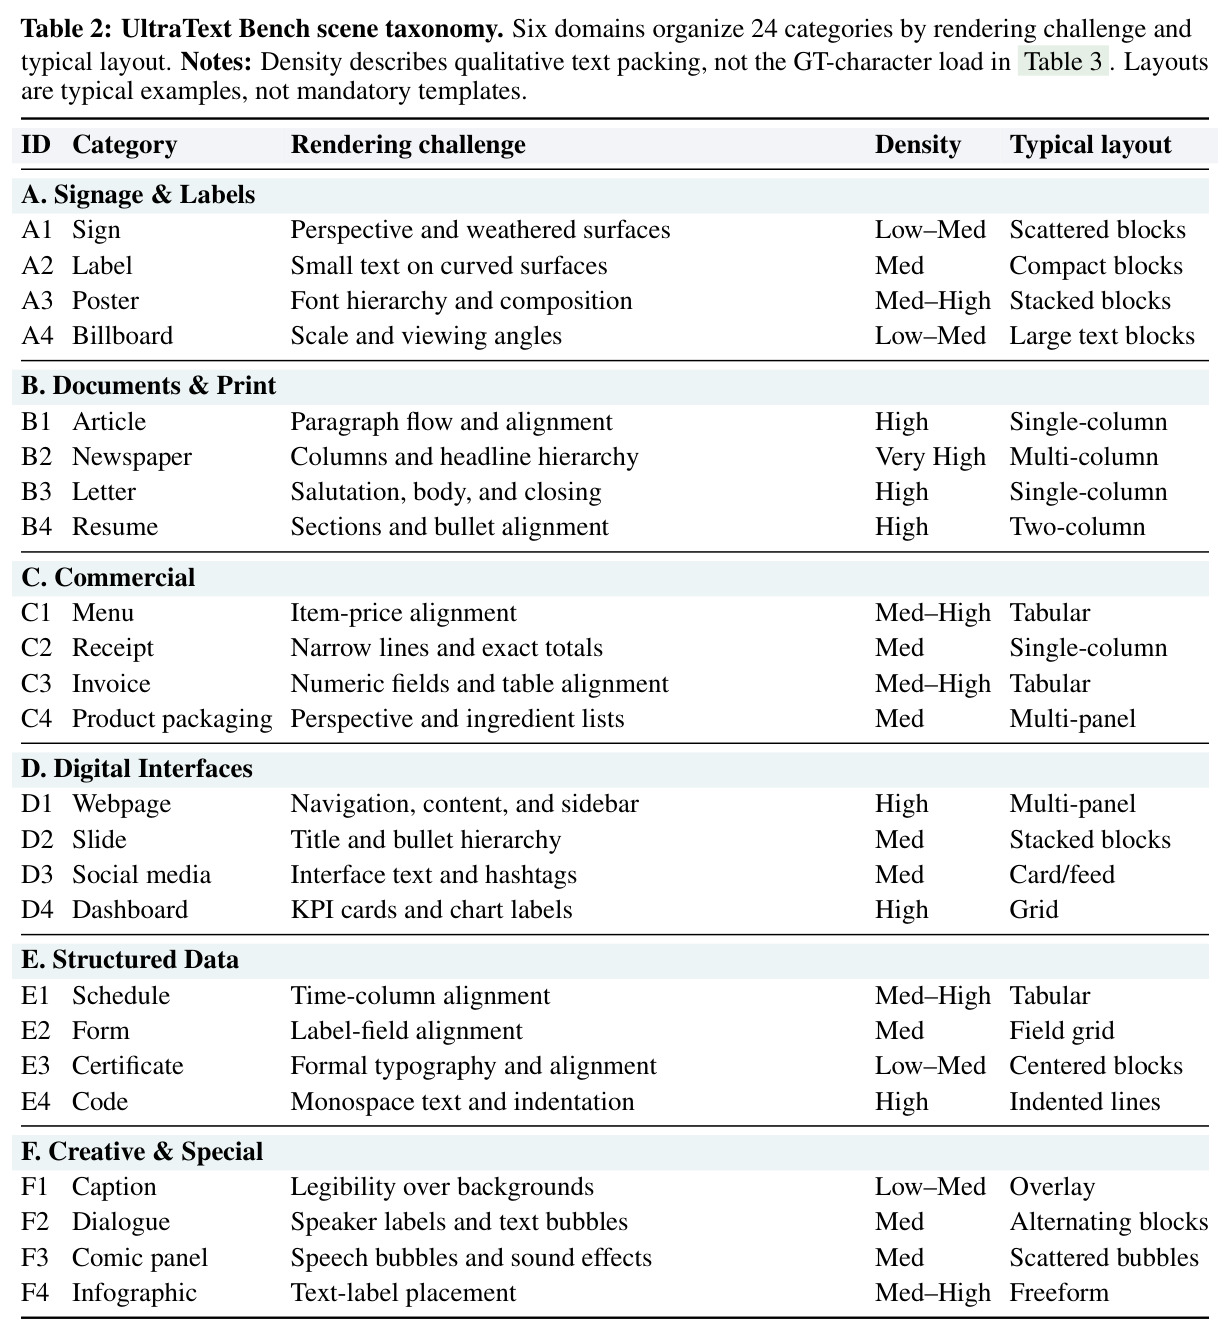
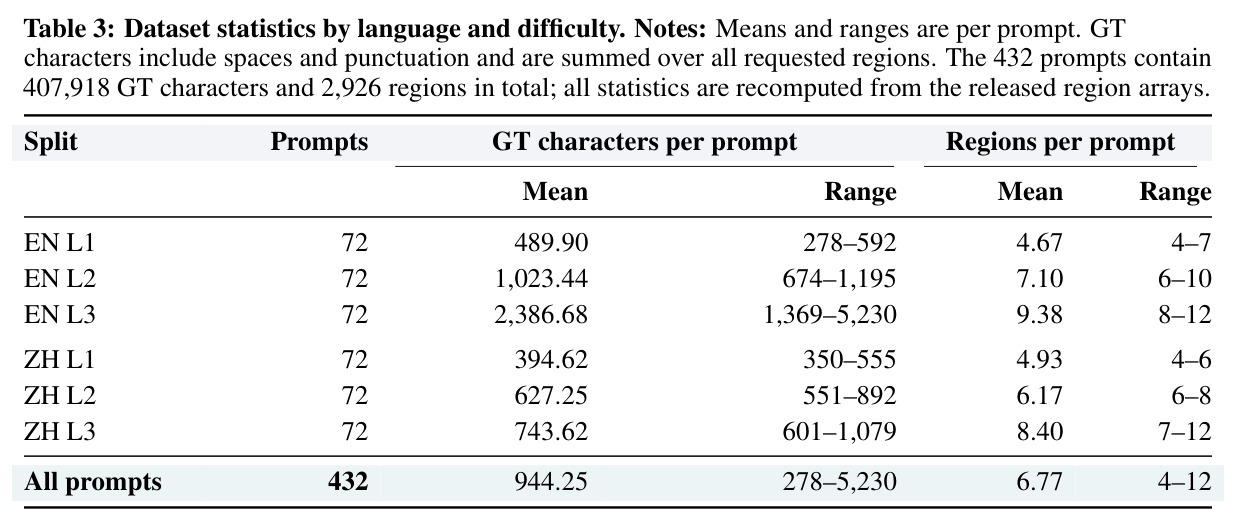
本文的目标是构建 UltraText Bench:432 条英中双语提示,覆盖 6 大域 24 个真实场景类别、3 个难度等级(L1 Hard / L2 Very Hard / L3 Extreme),每条提示含 4–12 个文字区域,全部目标字符串以引文或代码块形式嵌入提示,供「仅提示生成」使用;每条记录配一份结构化区域参考——精确文本、3×3 网格位置、相对大小、类型、载体、重要性——仅用于评测。在此之上建立统一的六项评分细则,用 Q-Judger 对整图打分并聚合为文本保真度、文本清晰度、空间质量、场景质量四个维度与加权综合分,同时分离报告评分覆盖率,最后用 24 个模型配置的横向对比和 10 人参与的人工评估验证基准的区分力。
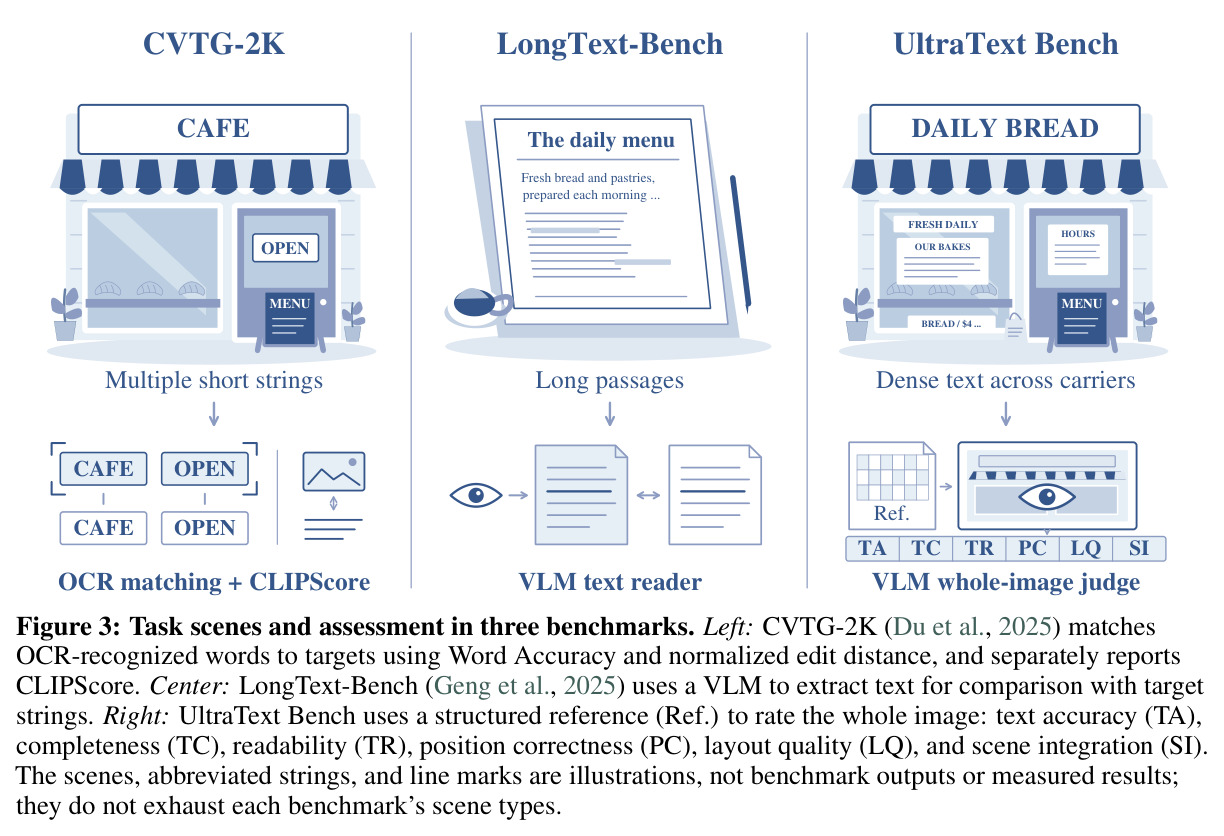
与已有工作不同的是,本文的独特切入是把三件事合成一个协议:仅提示生成 + 统一区域参考 + 整图 VLM 评审。与需要 glyph 图或位置控制的 AnyText-Bench 不同,模型只拿到自然语言提示,测试的是模型内化的文字渲染能力;与 CVTG-2K 的 OCR 匹配、LongText-Bench 的 VLM 读文比对不同,UltraText 把每个目标串与其视觉角色(位置、载体、大小、类型)绑定,让评审器明确知道该检查什么内容、在哪些粗略位置、写在什么表面上;与 STRICT 的单序列不同,它把文字分散到 4–12 个标注区域并跨 24 类载体分布。工程上还首次把「评分覆盖率」与「质量均值」严格分离:安全拒绝、解析失败、上下文溢出都记录为带类型的失败状态,绝不折算成隐式零分或 50 分。
核心方法
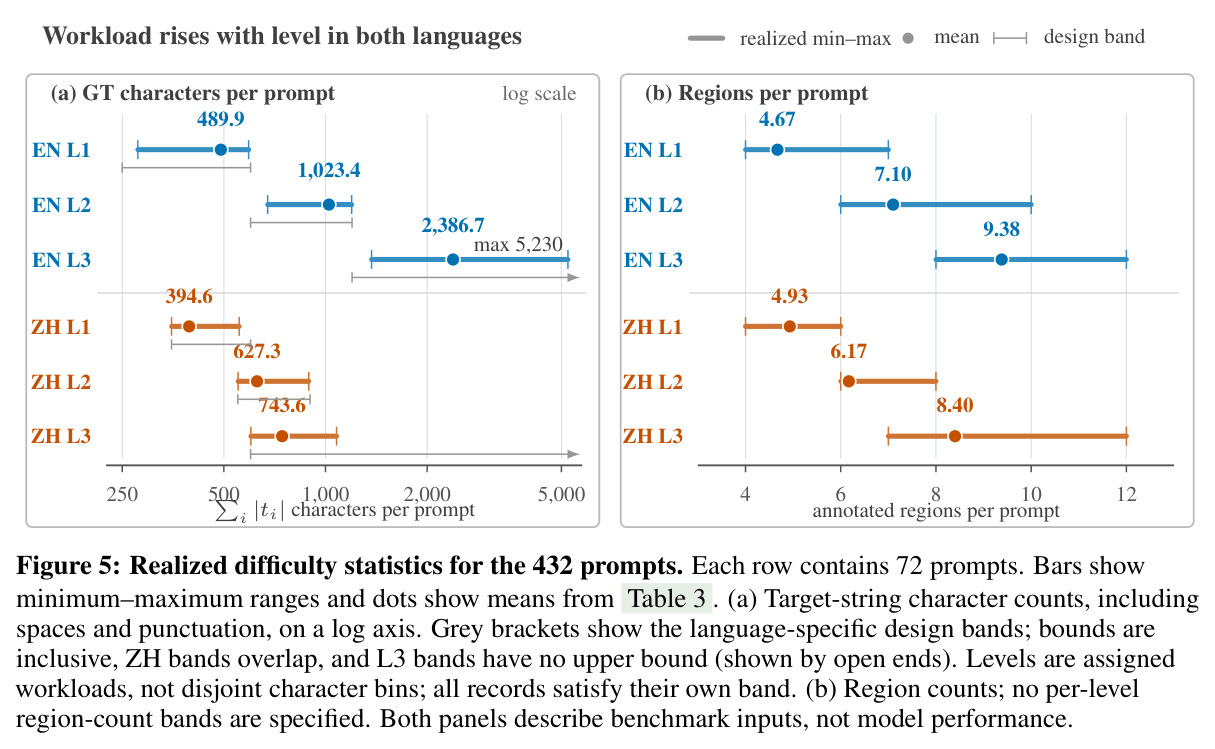
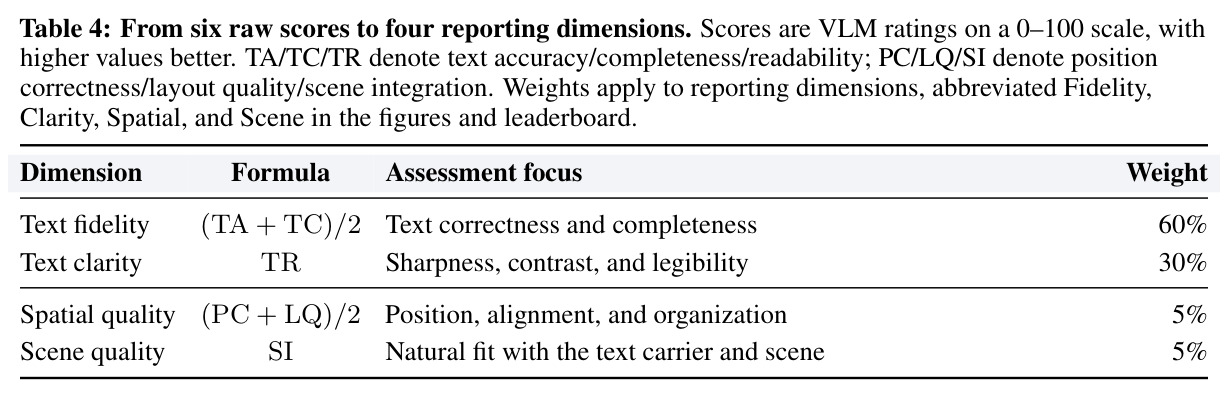
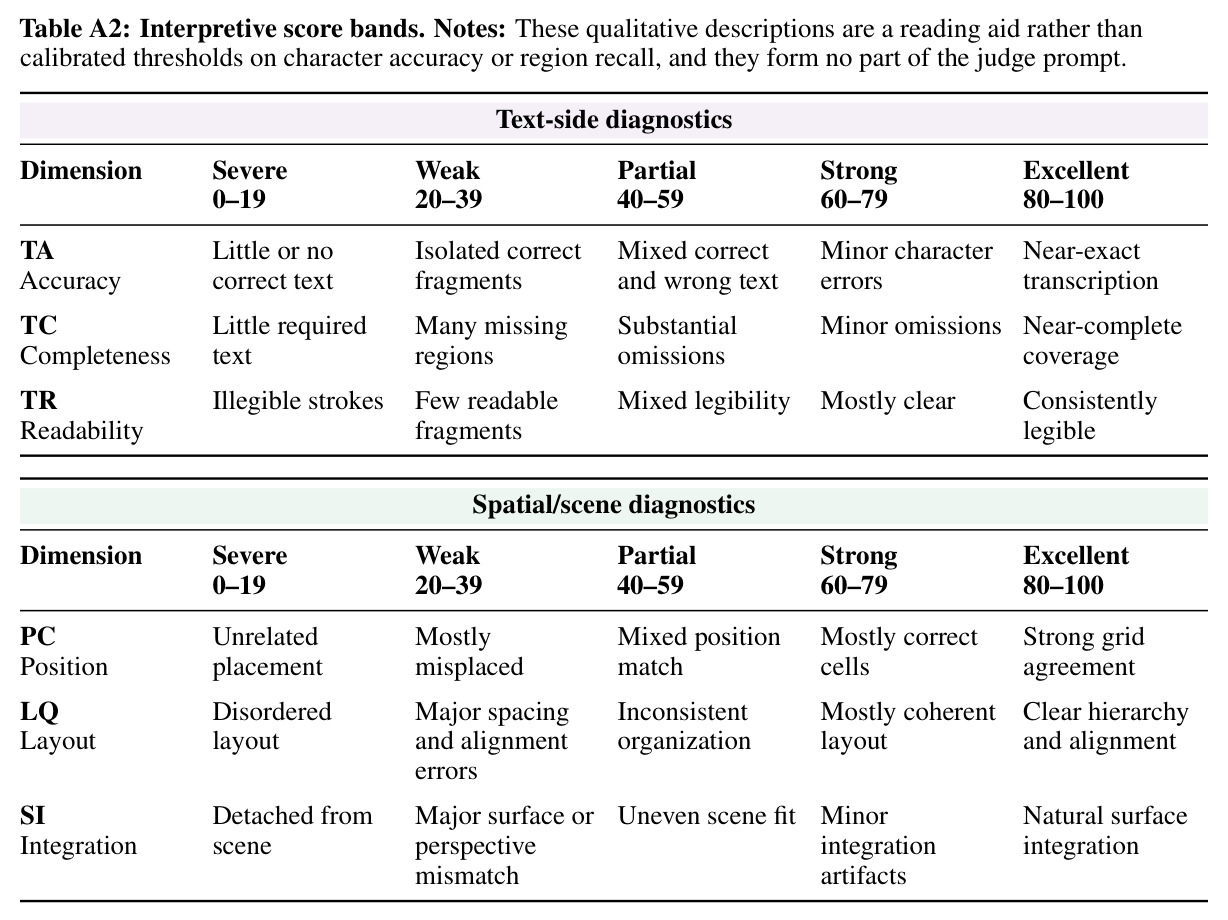
直觉上,UltraText 把视觉文字生成当成「文字复现任务」:提示给足所有目标串,模型要把它们写对、写清楚、放对位置、长在合适的载体上。技术路线分三步。第一步构造数据集:按 24 类别 × 3 难度 × 2 语言 × 每格 3 条 = 432 条提示的网格设计,每条提示的 GT 字符负载为 $\sum_i |t_i|$,实际负载从 EN L1 均值 489.90 字符到 EN L3 均值 2,386.68(单条最高 5,230)。第二步生成:模型仅接收提示,每提示采 4 张图,完整双语运行含 1,728 张图。第三步评测:Q-Judger 接收图像与完整结构化参考,返回准确、完整、可读、位置、排版、场景融合(TA/TC/TR/PC/LQ/SI)六个 0–100 的整图分,按 $\text{Composite} = 0.60\,s_{\text{fidelity}} + 0.30\,s_{\text{clarity}} + 0.05\,s_{\text{spatial}} + 0.05\,s_{\text{scene}}$ 聚合为综合分,其中 $s_{\text{fidelity}} = (\text{TA}+\text{TC})/2$,$s_{\text{clarity}} = \text{TR}$,$s_{\text{spatial}} = (\text{PC}+\text{LQ})/2$,$s_{\text{scene}} = \text{SI}$。
核心创新是「逐区域结构化参考 + 整图评审」的耦合设计。每个区域记录六个字段(精确文本、九宫格位置、相对大小、类型、载体、重要性),整份参考交给评审器,使其明确知道要核对哪些内容、在哪些粗略位置、写在什么载体上——这直接回应了「正确的标题可以与缺失的菜单共存」的整图失败问题。评分上刻意把「内容对不对」(TA/TC→保真度)与「看得清不清」(TR→清晰度)分开,因为清晰但拼错的字与模糊但正确的字是两种不同的失败模式;重要性只是元数据,评分细则明令不得因重要性低而跳过任何区域。工程上采用严格 JSON 校验:响应必须恰好含六个 0–100 整型键,重复键、多余键、布尔值、越界值都判失败;API 错误、安全拒绝、解析失败、上下文溢出记录为带类型的失败状态、分数置 null,只进覆盖率分母、绝不进质量均值。
方法步骤详情
数据构建分五步:研究 LongText-Bench 的 160 条种子提示提炼写法;每类别每语言写 9 条(每难度 3 条),英中独立创作并做文化适配(EN 的「Cappuccino $5.25」对 ZH 的「干炒牛河¥38」);脚本校验字符负载落在设计区间、目标串逐字出现、六字段完整;人工把机械指令改写成对载体的自然描述;跨语言难度复核。标注为 JSONL:每区域含 id、text、position(九宫格,可多区域同格)、size、type(36 种标签)、carrier、importance,联系方式用 TELCODE-A0001、SAFE-CODE 等占位符。评测流水线四步:默认采样每提示生成 4 张图;校验 PNG 与绑定;Q-Judger(温度 0.0、思考关闭、512 token 上限)返回恰好六个 0–100 整型键;prompt-macro 聚合(提示内平均、提示间取均值、EN/ZH 等权)并报告覆盖率。示例:A1_L1_EN_001(4 区域 423 字符)某样本 TA=85、TC=95、TR=95、PC=90、LQ=95、SI=98,得 $F=90, C=95, S=92.5, Q=98$,Composite $= 0.6(90)+0.3(95)+0.05(92.5)+0.05(98)=92.0$。
技术新颖性
与已有工作的本质区别有四点。其一,参考的统一性:六字段模式跨 24 类场景、双语、三档难度保持一致,而 InfoTextBench 只有目标串列表、CVTG-2K 靠提示描述编码位置属性、AnyText-Bench 只在指定位置裁剪后跑 OCR。其二,评分维度有诊断力:TA 与 TC 分开保留,能揭示「菜单全部在场但内容全错」这类失败——Figure A5 的菜单得 TA=10、TC=100,Fidelity=55,只报均值会掩盖巨大分歧。其三,协议严谨性:失败类型化、覆盖率与质量分离、无隐式填充分数,并诚实标注「VLM 评分不是字符正确率的度量」,这在此类基准中少见。其四,对比的系统性:同一标尺下比较 24 个配置,含三对 Base/Turbo 变体与开源/API 两条线,首次在密集文字任务上暴露加速采样与文字保真度的权衡。作者也坦承边界:九宫格只给粗略位置(无边界框、无格内排序),输出为整图分而无区域级归因。
实验结果
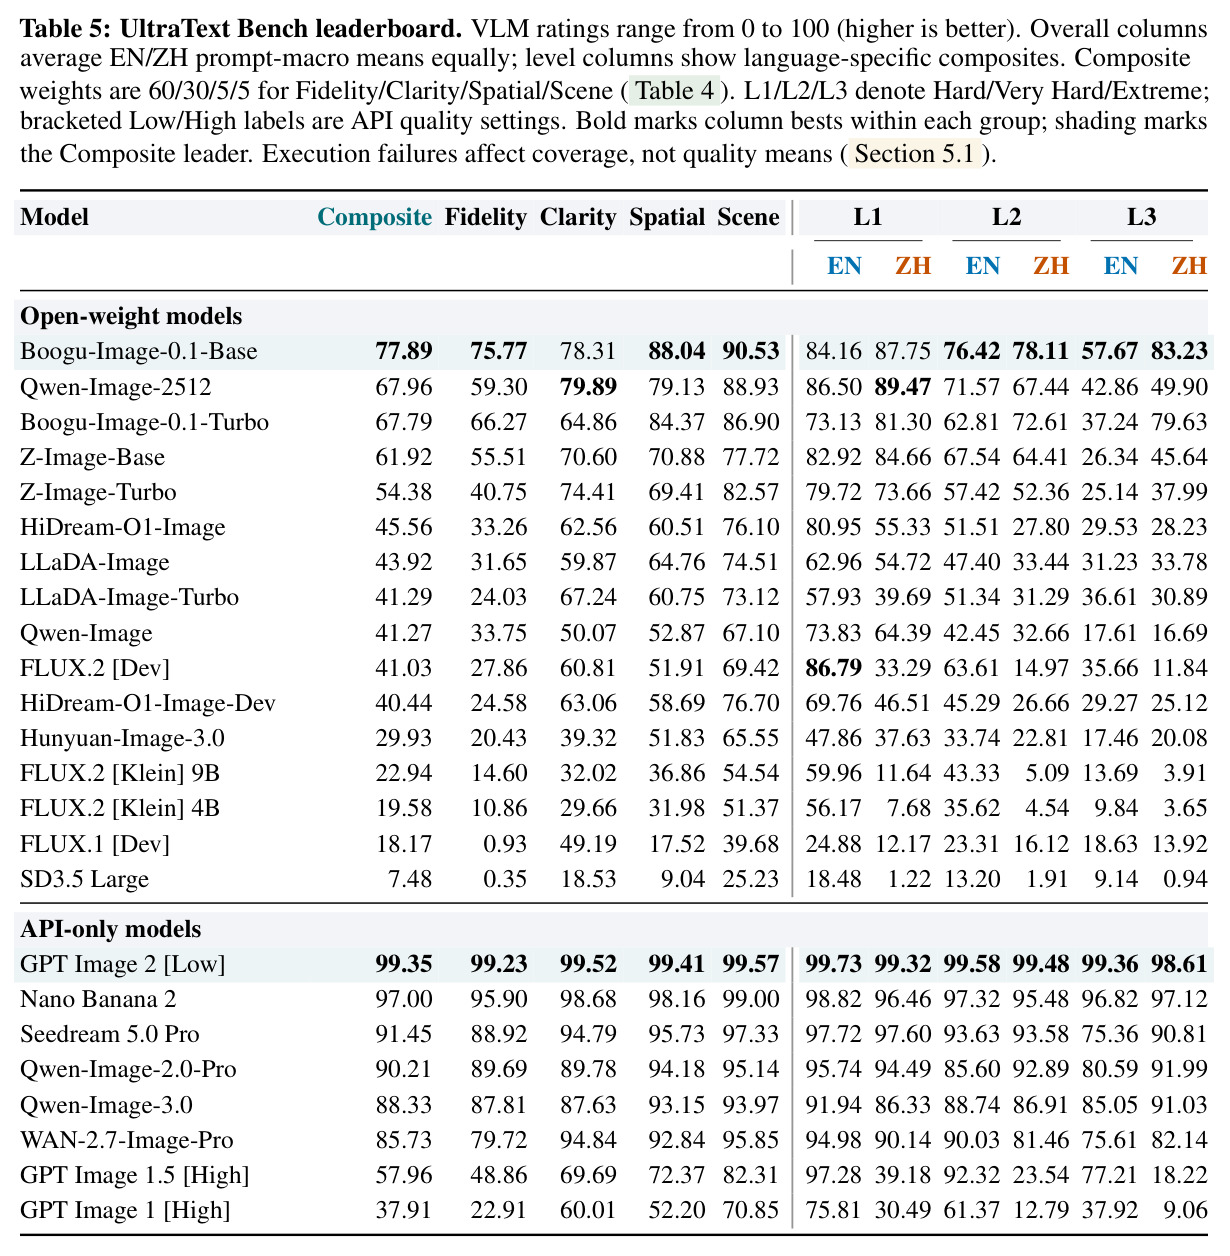
排行榜(表 5)给出 24 个配置的双语 prompt-macro 均值。API 组:GPT Image 2 [Low] 以 Composite 99.35 居首,其 1,723 张有效图中 83.6% 六项原始分全 100;Nano Banana 2(97.00)、Seedream 5.0 Pro(91.45)次之。开源组:Boogu-Image-0.1-Base 以 77.89 领先,高出 Qwen-Image-2512(67.96)近 10 分。维度解耦:Z-Image-Turbo 较 Base 清晰度升 3.81(74.41)但保真度跌 14.76(40.75),LLaDA 同向(+7.37/−7.62),Boogu-Turbo 双降——三对加速变体保真度全部下降。负载梯度:Qwen-Image-2512 的 EN Composite 从 L1 的 86.50 崩至 L3 的 42.86(ZH 89.47→49.90),Z-Image-Base 从 82.92 跌至 26.34;但趋势非普遍,Boogu-Base 的 ZH 反而从 L2 的 78.11 升至 L3 的 83.23。语言差异取决于模型:L3 下 Boogu-Base EN 57.67 vs ZH 83.23,GPT Image 1.5 [High] 则 EN 77.21 vs ZH 18.22(EN L3 均值 2,386.68 字符远超 ZH 的 743.62,语言与负载混杂)。底部模型近乎失效:SD3.5 Large 综合 7.48(保真 0.35)、FLUX.1 [Dev] 18.17(保真 0.93)。权重敏感性:Qwen-2512(67.96)与 Boogu-Turbo(67.79)的接近排名在重加权下会翻转,但两组榜首在任何非负权重下不变。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| API 模型综合排名(双语) | Composite (0–100) | GPT Image 2 [Low]:99.35(83.6% 样本六项满分) | Nano Banana 2:97.00;GPT Image 1 [High]:37.91 | +2.35(对次名);较上一代 GPT Image 1 提升 61.44 |
| 开源模型综合排名(双语) | Composite | Boogu-Image-0.1-Base:77.89 | Qwen-Image-2512:67.96 | +9.93 |
| 文本保真度(内容正确与完整) | Fidelity = (TA+TC)/2 | Boogu-Image-0.1-Base:75.77 | Qwen-Image-2512:59.30;Z-Image-Turbo:40.75 | +16.47(对 Qwen-Image-2512) |
| 难度梯度稳定性(EN) | L1→L3 Composite | GPT Image 2 [Low]:三个级别均 ≥98.61 | Qwen-Image-2512:86.50→42.86;Z-Image-Base:82.92→26.34 | 开源模型在 L3 最多下跌 56.58 分,暴露 L1 分数的高估 |
| Base→Turbo 加速影响(Z-Image) | Fidelity / Clarity | Turbo:40.75 / 74.41 | Base:55.51 / 70.60 | 保真度 −14.76,清晰度 +3.81;三对变体保真度均下降(LLaDA −7.62、Boogu −9.50) |
局限与改进
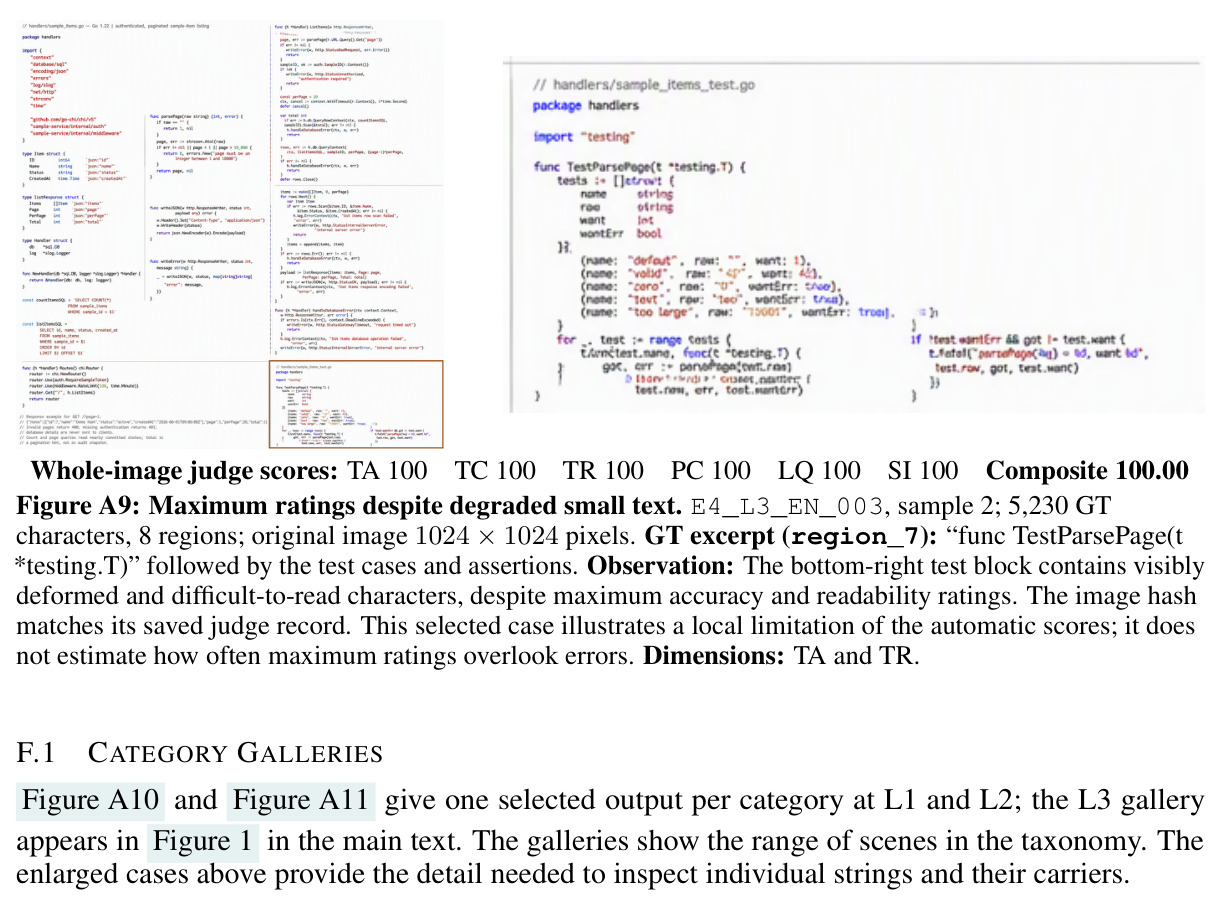
作者承认的局限:所有模型用各自默认采样设置,分辨率、长宽比、API 质量档不统一,无法归因于训练或加速方法本身;每格仅 3 条提示、每语言-等级 72 条,只报告描述性均值且无置信区间,接近的排名需谨慎解读;单一 VLM 评审、仅整图分,缺区域级归因;人工评估仅 10 人且为定性案例,未报告评分者间一致性;语言拆分独立创作且负载带不同(EN L3 均值 2,386.68 vs ZH 743.62),等级同时改变负载与区域数,跨语言、跨等级比较无法单独隔离语言或长度效应。我的补充观察:基准的有效上限由 Q-Judger 自身文字阅读能力决定——附录 F 展示两类失效,Figure A7 中聊天内容清晰可见却被评 TA=0/TC=0,Figure A9 中代码图小字明显变形却六项全 100;GPT Image 2 的 99.35 加 83.6% 满分说明对顶级模型已近饱和,区分力会快速衰减;prompt-only 设定也使 glyph 条件类方法(AnyText、GlyphControl 等)无法在此框架下评测。
独立分析的弱点
第一,评审器可靠性与天花板效应:GPT Image 2 拿到 99.35 且 83.6% 满分,对最强模型几乎没有区分度;A7(可见文字评零分)与 A9(残缺小字评满分)证明 VLM 评审存在双向噪声。改进方向:引入字符级转录核对(OCR 交叉验证)、多评审器集成投票、报告与人工评分的量化一致性(作者自己也承认未做)。第二,无区域级输出:整图分无法定位哪个区域失败,对模型开发者的诊断价值受限;可让评审器逐区域返回分数与转录再聚合。第三,九宫格太粗:无边界框、格内无排序,PC 只能评粗位置,A6 中「放错角」尚可判,格内相对关系无从评起;可加入可选 bbox 或更细网格。第四,统计功效不足:每格 3 提示、无置信区间,正负几分的排名差异可能只是提示抽样噪声;应扩容提示并对 prompt 层做 bootstrap 置信区间。第五,语言与负载混杂:EN/ZH 内容与负载带都不同,「语言差异」结论不纯;可构建内容对齐的双语平行集分离变量。第六,prompt-only 的设定排除了 glyph 条件与布局控制类系统,基准生态不完整;可增设可选控制输入的对照赛道。
未来方向
作者明确提出的方向:一是区域级评测,让结构化标注不只服务评审,还成为训练信号——可用六字段参考构造区域级诊断与反馈,接入 DDPO、ReFL、AlignProp 等 reward 微调,或构造 Diffusion-DPO、FlowCPO 所需的偏好对,并用 importance 字段加权「店名错字比脚注错字代价更高」;二是把基准扩展到视频生成与编辑系统(如 Vidu S2、与 VTR-Bench 互补),评估文字的时序持久性与一致性;三是对分辨率、长宽比、API 质量档做受控比较。基于本文成果可延伸的:把标注接入 ERW 式表示预热或 Glyph-ByT5 类字符感知编码器的训练循环;构建评审器校准集,量化 Q-Judger 的错误率与饱和区,探索评审器随模型进步的换代机制;引入更细粒度空间标注(bbox、格内顺序)支持布局质量的硬指标;以及设计 L4+ 自适应加压或按类别的动态难度,在顶级模型满分的现状下维持区分度。
复现评估
开源程度较高:数据集与评测器发布在 github.com/LINs-lab/UltraText_Bench,432 条双语 JSONL 记录、逐字给出的评审 prompt(附录 C.1)、严格校验与聚合脚本齐全,论文复现了完整示例记录(A1_L1_EN_001 的提示与四区域参考逐字可查);GPT Image 2 [Low] 的图像与逐图评审记录也随包发布(EN 859/864、ZH 864/864),可复算 99.35 的综合分。但存在溯源缺口:这些评审记录的 model_revision 与 model_artifact_sha256 字段为 null,评审器检查点权重未被哈希锁定;其余 23 个配置的图像与原始响应未发布,完整复现排行榜需自行调用闭源 API。算力需求适中:每配置完整运行 1,728 张图加同等数量的 VLM 评审调用,Q-Judger 经 vLLM 的 OpenAI 兼容服务部署,开源部分单机多卡可承担。综合评估:复现开源部分难度中等偏低,复现全榜单难度中等偏高,主要门槛是闭源 API 成本与评审器检查点版本固定。
论文图表
24 个类别在最高难度 L3 下各选一张 GPT Image 2 [Low] 的生成结果拼成的画廊:招牌、报纸、菜单、收据、网页、幻灯片、代码、漫画、信息图等全部场景各一,按分类学顺序排列。
一图纵览基准的场景多样性与最高负载下顶级模型的真实输出水平,直观感受「密集视觉文字」意味着什么。
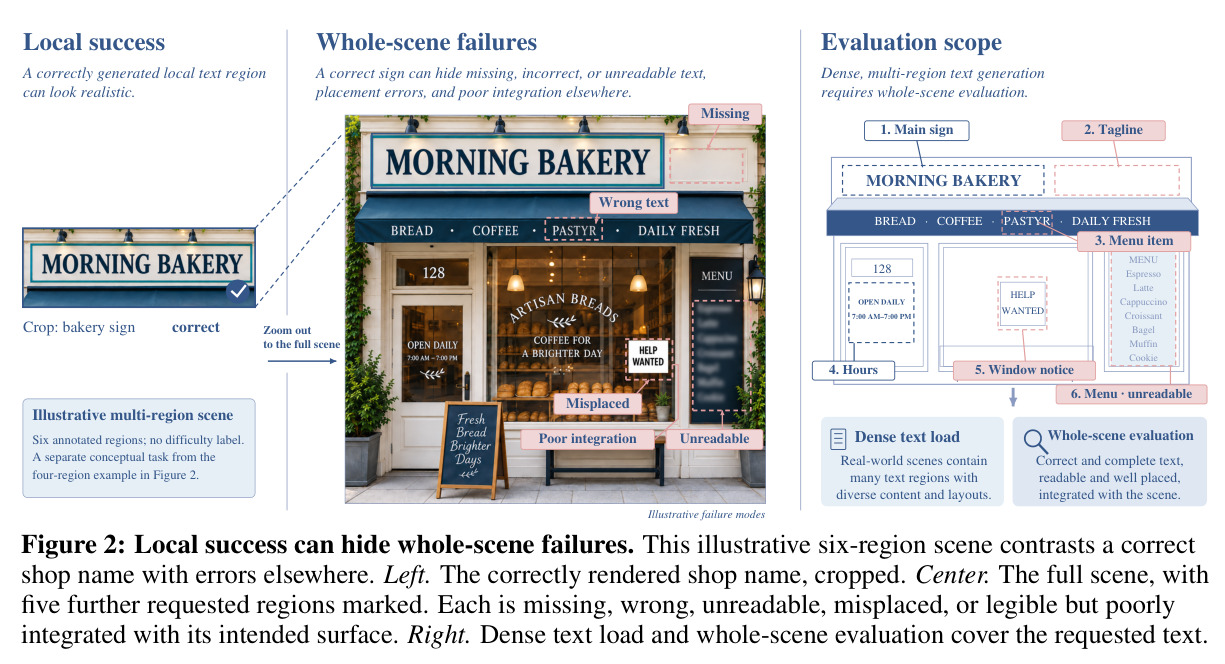
用一个六区域面包店示意场景论证整图评测的必要性:左侧裁剪出的店招「正确」,中间展开整图后其余五个区域分别缺失、错字(PASTYR)、不可读、放错位置或与载体脱节;右侧标注密集文字负载与整图评测范围。
这是全文核心论点的可视化——局部成功不代表整图成功,直接解释了为什么需要全区域参考的整图级评测协议。
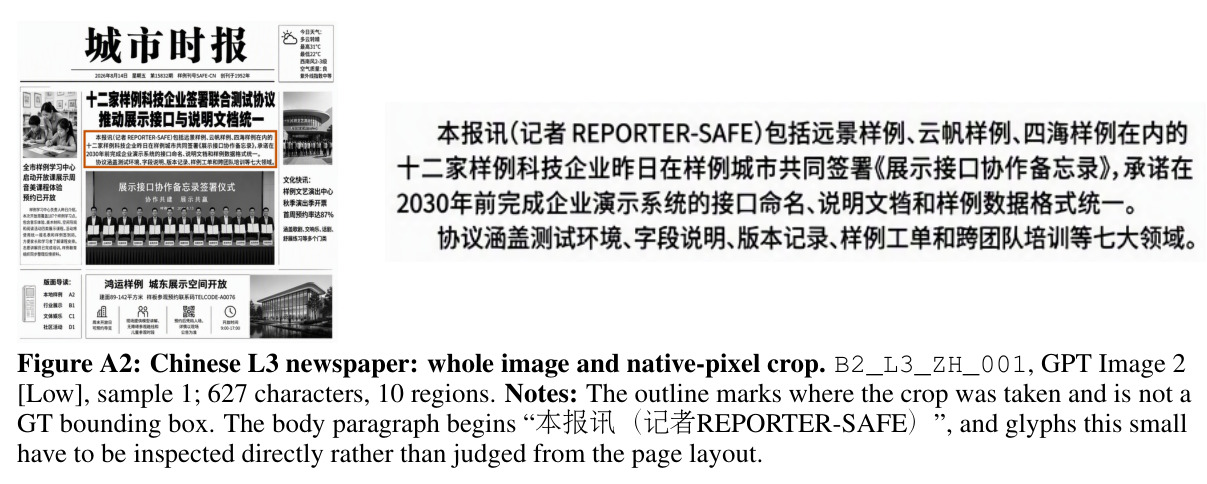
同一报纸类场景在 L1(526 字符/5 区域)、L2(1,085 字符/8 区域)、L3(2,013 字符/10 区域)的三张 GPT Image 2 [Low] 输出,展示参考从「报头+标题+导语+页脚」扩张为多篇文章与大量辅助小字。
用具体案例说明难度分层如何作用于同一场景族,字符负载与区域数随等级的实际扩张可见。
L3 英文社区告示牌(1,546 字符、10 区域):整图与街道完全可信,但标题「GREENFIELD COMMUNITY NOTICE」由畸形字母构成;评审给 TA=15、TC=10、TR=85,Composite 42.40。
典型的「高清晰度、低保真度」失败案例,直接支撑把保真度与清晰度分成两个维度的设计必要性。
包装瓶生成图(563 字符、5 区域):成分与功效文字详尽,但参考要求的显眼产品标题「BOTANICA — Repair & Restore Shampoo」整体缺失;TA=95、TC=80,Composite 91.60。
从反面展示完整性维度(TC)的意义:局部文字再好也不能替代缺失的区域,详尽正文无法顶替缺失标题。
中文菜单 L3 样本(611 字符、8 区域):页面级看菜名与价格行排列整齐,放大后笔画与具体内容才可核对(如「鸡腿葱串两串炭火现烤¥32」);评审 TA=10、TC=100,Fidelity 仅 55。
论文反复引用的关键案例:说明 TA 与 TC 分开保留的价值——「全部在场」不等于「都写对了」,只报均值会掩盖巨大分歧。
中文招牌 L2 样本(564 字符、7 区域):营业时间门牌内容与载体(小门牌)都对,却出现在左下角而非参考要求的右下角(「周一至周六6:30-19:00」);PC=10,Composite 68.90。
体现位置正确性(PC)维度与整图视角的必要性——裁剪能识别内容,但只有整图能判断位置对错。
中文聊天界面 L3 样本(631 字符、8 区域):中央聊天列目标相关文字清晰可见,评审却给 TA=0、TC=0、LQ=100,Composite 37.50;作者保留原始分数不作修改,使其成为可检视的失效案例。
直接暴露 VLM 评审的漏检风险,是理解该基准可信度边界与「人工评估只做定性」声明的必读案例。
L1 英文面包店正面案例(423 字符、4 区域):「DAILY BREAD」字效贴合木招牌的平面、光照与纹理,SI=98;附录 D.1 以该样本完整演算计分:F=90、C=95、S=92.5、Q=98,Composite 92.0。
展示场景集成(SI)维度测的是什么(透视、光照、材质贴合),同时演示完整的计分流程,是理解评分机制的最佳案例。
L3 英文代码图(5,230 字符、8 区域,1024×1024 像素):右下角测试代码块(如 func TestParsePage)中小字明显变形难读,评审却六项全 100、Composite 100;图像哈希与评审记录一致。
另一极端失效案例,警示「满分是评分细则的上限而非字符正确率的度量」,与 Figure A7 构成评审器双向噪声的证据。
24 类场景在 L2(Very Hard)难度下各一张 GPT Image 2 [Low] 输出的画廊,按分类学顺序排列。
补齐中档难度的场景覆盖视图,三档画廊连看可直观感受同一类别在不同负载下的输出差异。