EgoExplorer:面向原位人类移动操作的视觉-运动-触觉观测站 EgoExplorer: A Vision-Motion-Touch Observatory for Human Loco-Manipulation In Situ
可穿戴视觉-运动-触觉系统采集100小时人类移动操作数据,C3管线将全身重建误差降低71.9%
前置知识
Loco-manipulation(移动操作)
指人或机器人在移动(行走、蹲起、转身、挪位)的同时完成抓取、搬运、放置等操作任务的复合能力。核心在于下半身支撑、躯干姿态与手臂操作三者随任务进程动态耦合:走到哪里、身体如何摆放,直接决定了手够得到什么、以什么姿势施力。区别于固定站位下的桌面操作,它强调连续任务中的位置转移、姿态调整与恢复行为(如对失败尝试的反应)。
本文的数据采集与全身重建目标都围绕这种全身协同展开,理解它才能明白为什么必须同时记录视觉、全身运动与触觉。
SMPL-X 参数化人体模型
学界标准的统一参数化人体网格模型:用形状参数 $\beta \in \mathbb{R}^{10}$、全局根朝向 $\omega$、各关节相对父关节的局部旋转 $\theta$(本文 21 个关节)和骨盆位移 $u$ 描述一个人。给定参数后经前向运动学与蒙皮函数生成含手部的全身三角网格。本文用它作为运动的统一表示,其表面顶点还被用于自穿透与地面穿透约束。
论文的校准、补全、约束三层全部建立在 SMPL-X 的参数与网格之上,正文所有公式符号都源于该模型。
前向运动学(Forward Kinematics)
从根节点位姿与各关节局部旋转出发,逐级推导所有关节乃至蒙皮网格顶点在世界坐标系中位置的过程。它是一个可微映射,因此可以把「预测跟踪器位姿与实测位姿的误差」作为损失,反传更新关节旋转。本文 C3 的约束精修正是通过可微 FK 与蒙皮,对每帧状态 $(\omega_t, \theta_t, u_t)$ 做梯度优化。
读懂骨架层损失与式 (1)(3) 必须理解 FK:它是身体状态与跟踪器测量之间可优化的桥梁。
稀疏跟踪器全身重建
只用头、双手腕、双脚踝等少数刚体锚点的 6-DoF 位姿推断完整人体关节运动的问题。中间关节(肘、膝、脊柱)欠约束、直接拟合有多解;主流做法是训练一个时间运动先验网络(如 AvatarPoser:在 AMASS 上训练的 Transformer)从锚点观测历史补全未观测关节,再用优化或物理约束精修。本文的主要基线(SAGE、AGRoL、HMD-Poser 等)均来自该路线。
C3 的 Complete 与 Constrain 两步正是对这一范式的扩展,理解该范式才能看清本文改了什么。
内向外跟踪与数据手套
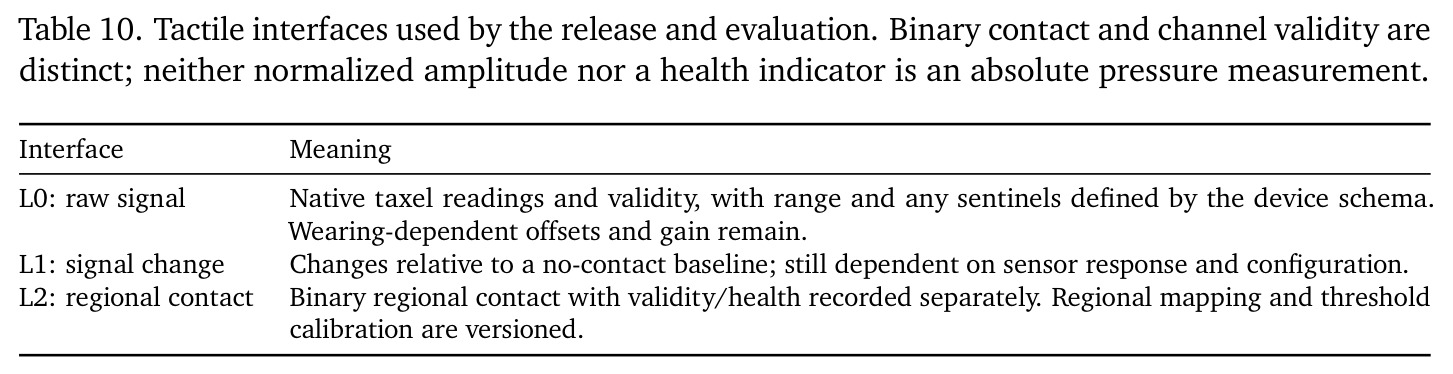
内向外(inside-out)跟踪指设备用自带的鱼眼/灰度相机观测环境来定位自身 6-DoF 位姿(如 VIVE Ultimate Tracker),无需外部基站,可部署于任意场地。数据手套在手背安装传感器直接测量各手指关节弯曲角度(MANUS Metagloves),Wuji 手套还能记录接触区域的触觉信号,两者提供不受视觉遮挡影响的直接测量。
硬件能力决定了「锚点」与模态的构成;正因为手套和跟踪器是外挂的,才产生安装偏移这一 C3 要解决的核心问题。
研究动机
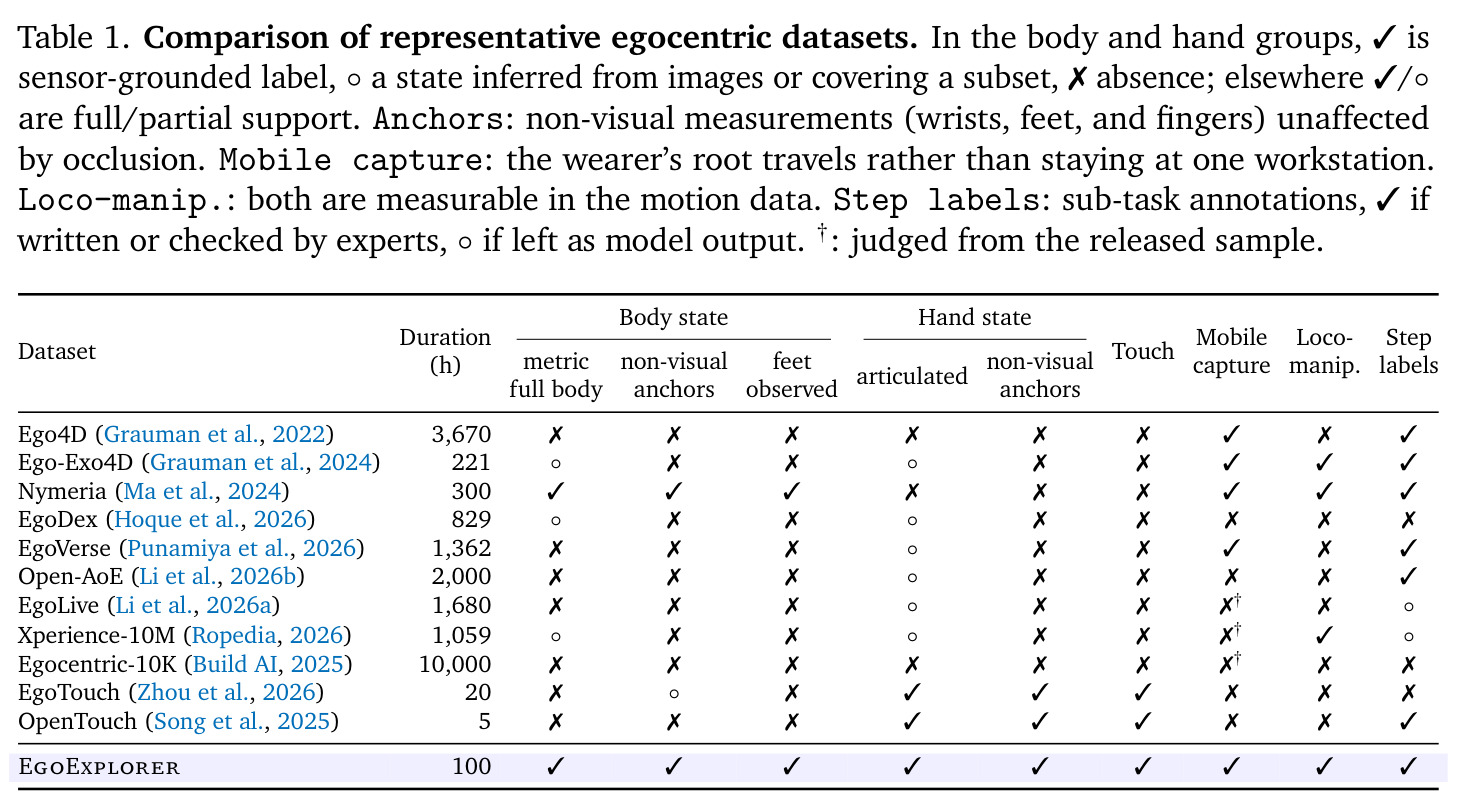
让人形机器人从人类示范学习移动操作,所需数据必须同时覆盖视觉上下文、全身与手部运动以及物理接触,且要在多样环境中连续采集。现有方案各有一块盲区:固定多相机阵列的动捕与多视角重建(如 GRAB、GYM-T 一类)测量精细,但每个录制空间都要专门架设并标定,跨环境扩展成本极高;自我中心视频数据集(Ego4D 3670 小时、EgoDex 829 小时、EgoVerse 1362 小时)场景丰富,却对身体运动缺乏传感器级标注,下肢与手部在画面外或被遮挡;可穿戴身体跟踪(Nymeria 300 小时)补上了全身轨迹,但没有手指细节与触觉;手部专精数据集(EgoTouch 20 小时、OpenTouch 5 小时)有手指与接触却完全丢掉全身运动。这些「局部视角」割裂了移动操作的核心——移动、姿态与物体交互如何协同演化。更糟的是,稀疏跟踪器直接拟合时,安装偏移会被吸收进关节运动估计,从源头污染标注。
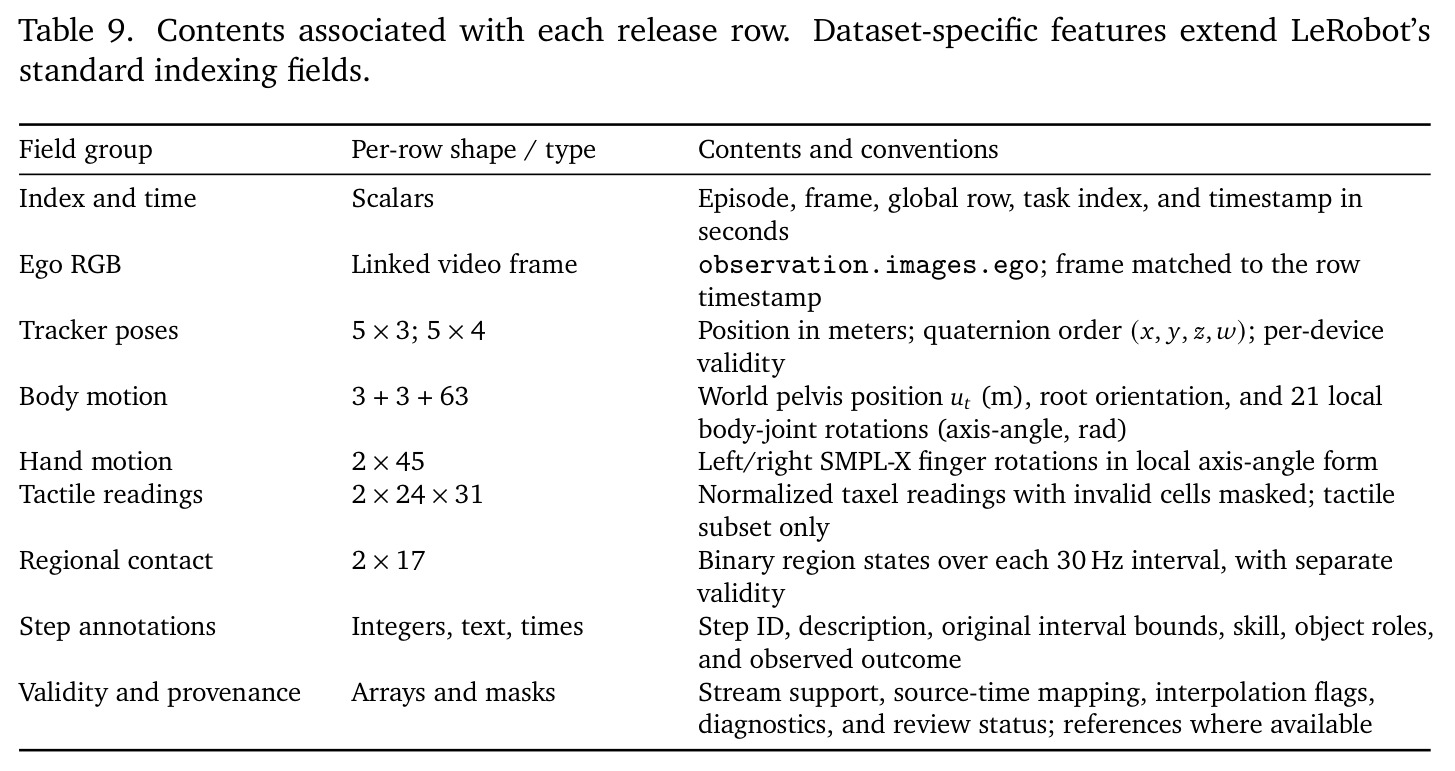
本文的目标是本文目标是搭建一套轻量、便携、可复用的穿戴采集系统,在真实工作现场记录连续的移动操作:2715 段自我中心录像共 100 小时,覆盖实验室、工厂、起居室、书房、备餐区 5 类环境,以及称量、旋转蒸发、柱层析、叠衣、整理书架、做三明治、折纸箱等 10 个任务模板,并包含对中断和失败尝试做出反应的恢复情节。所有模态在统一时间轴上对齐:第一人称视频、重建的度量级 SMPL-X 全身运动、手套直接测量的手指关节、触觉信号,以及经人工复核的步级文本描述。技术上要解决从 5 个稀疏跟踪器还原全身的歧义,把身体点误差压到 20mm 量级、让 17 个未跟踪关节也达到可用精度,同时保证重建网格不自穿透、不插入地板。
与已有工作不同的是,本文的独特切入点有三。第一,把「固定的人体-传感器几何」与「时变的关节运动」解耦:以往稀疏重建工作(AvatarPoser、SAGE 等)默认设备对准解剖锚点,或把安装误差与姿态混在一起优化,本文主张先用一次性、可复用的协议校准确定每位参与者的体型、尺度与 5 个安装变换,形成 profile,之后所有任务录制共用,从源头消除系统误差。第二,指出「运动先验认为合理」不等于「几何正确」——先验补全的动作仍可能手臂穿进躯干、脚插入地板,需要分层显式约束而非只靠平滑正则。第三,全身数据集与手部/触觉数据集长期两条线并行发展,本文用同一套穿戴硬件把两类非视觉测量合并到同一时间轴,专门面向移动操作的全身协同,这在便携采集中此前没有先例。
核心方法
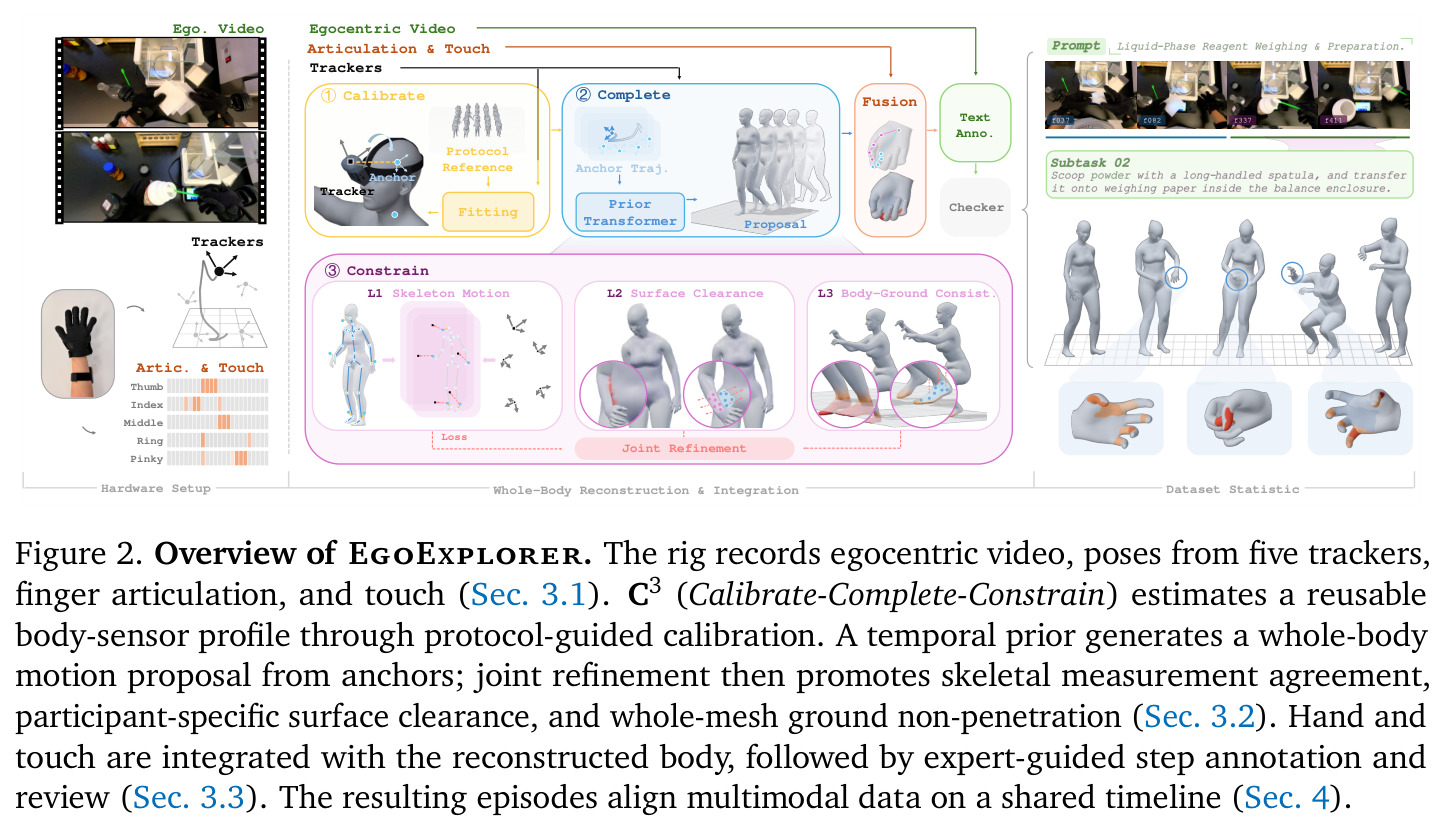
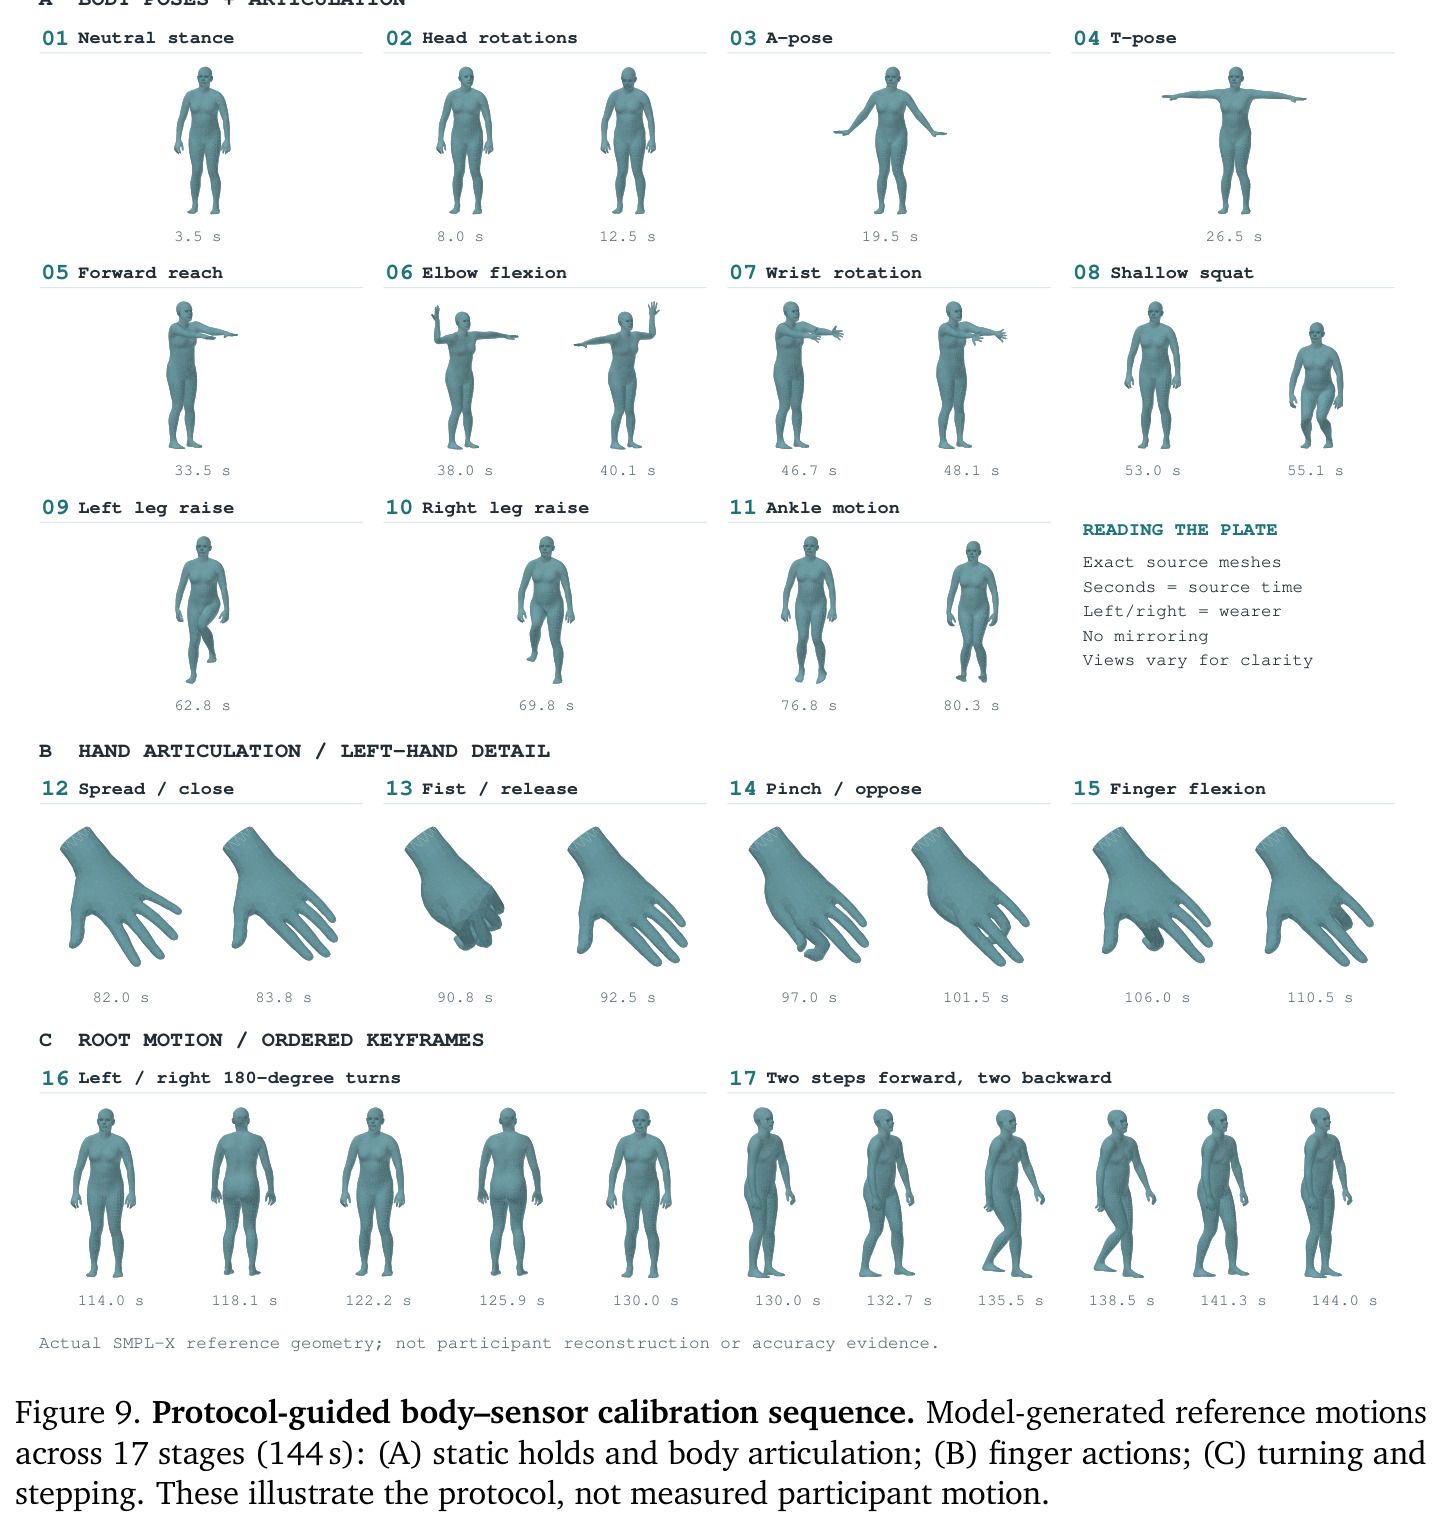
直觉上,5 个 VIVE 跟踪器只告诉你头、手腕、脚踝在哪,中间的肘、膝、脊柱全靠猜,而且跟踪器装歪一点,误差会全算到关节头上。C3(Calibrate-Complete-Constrain)管线分三步应对。先 Calibrate:让参与者做一套固定协议动作(站立、A/T-pose、手臂前伸、转头转腕、屈肘、浅蹲、抬腿、踝活动),按相位匹配到参考动作库,联合拟合 SMPL-X 体型 $\beta \in \mathbb{R}^{10}$、尺度 $s$ 和 5 个安装变换 $\{A_i, a_i\}$,形成可复用 profile。再 Complete:把校准后的锚点喂给在 AMASS 上训练的 AvatarPoser 式 Transformer,补全未观测关节,得到初始运动提案。最后 Constrain:在骨架贴合、参与者特定表面间隙、身体-地面一致性三层约束下分块联合精修。最终身体点误差 18.0mm,比最强的 5 锚点本地训练基线 AvatarPoser* 的 64.1mm 降低 71.9%,2715 段、100 小时的采集全部由这套轻量可复用硬件完成。
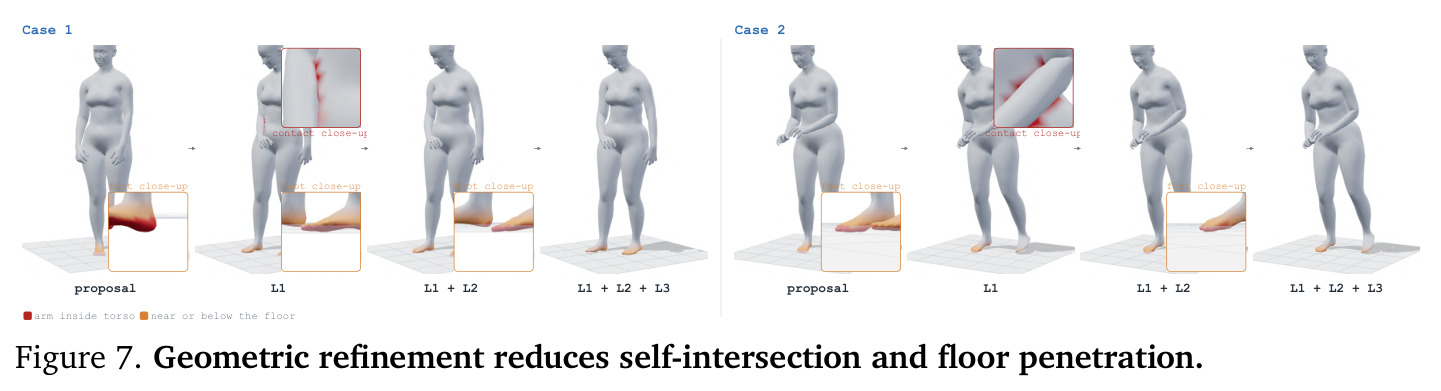
核心创新是「校准先行的解耦」:把跟踪器位姿的歧义显式拆成固定的安装几何(平移 $a_i$、旋转 $A_i$、体型 $\beta$、尺度 $s$)与时变的关节运动,前者由一次协议校准永久解决。协议样本按归一化相位 $\alpha_n$ 对应参考动作,以前向模型联合拟合,辅以人体测量学损失 $\mathcal{L}_{anth}$ 与几何正则,防止「肢长补偿安装偏移」的退化解。与已有方法的本质区别在于:基线把安装变换当作隐式未知量或假设已对齐,而消融证明它是数量级的误差来源——不做安装校准时误差从 18.0mm 恶化到 95.0/98.1mm。第二个关键点是分层约束哲学:先验合理 $\neq$ 几何正确,L1 骨架贴合、L2 沿法向的有向间隙惩罚、L3 全身顶点对地面惩罚进入同一目标 $\mathcal{L}_{body} = \mathcal{L}_{skel} + \lambda_{surf}\mathcal{L}_{surf} + \lambda_{floor}\mathcal{L}_{floor}$,消融显示三者互补而非冗余。
方法步骤详情
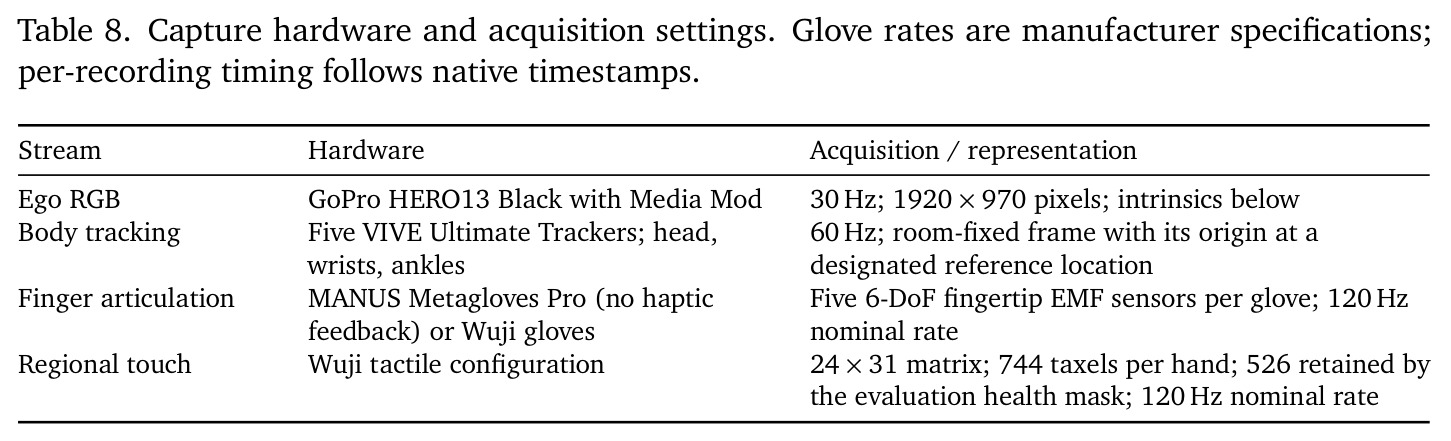
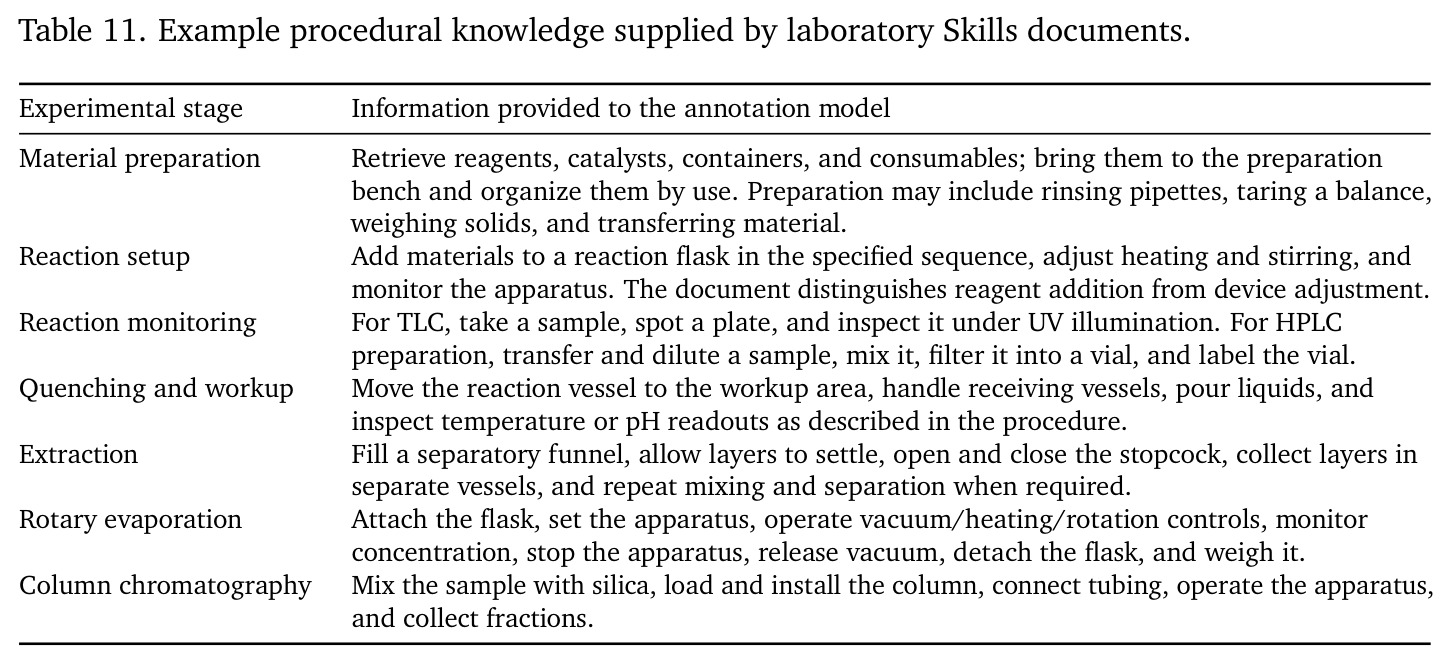
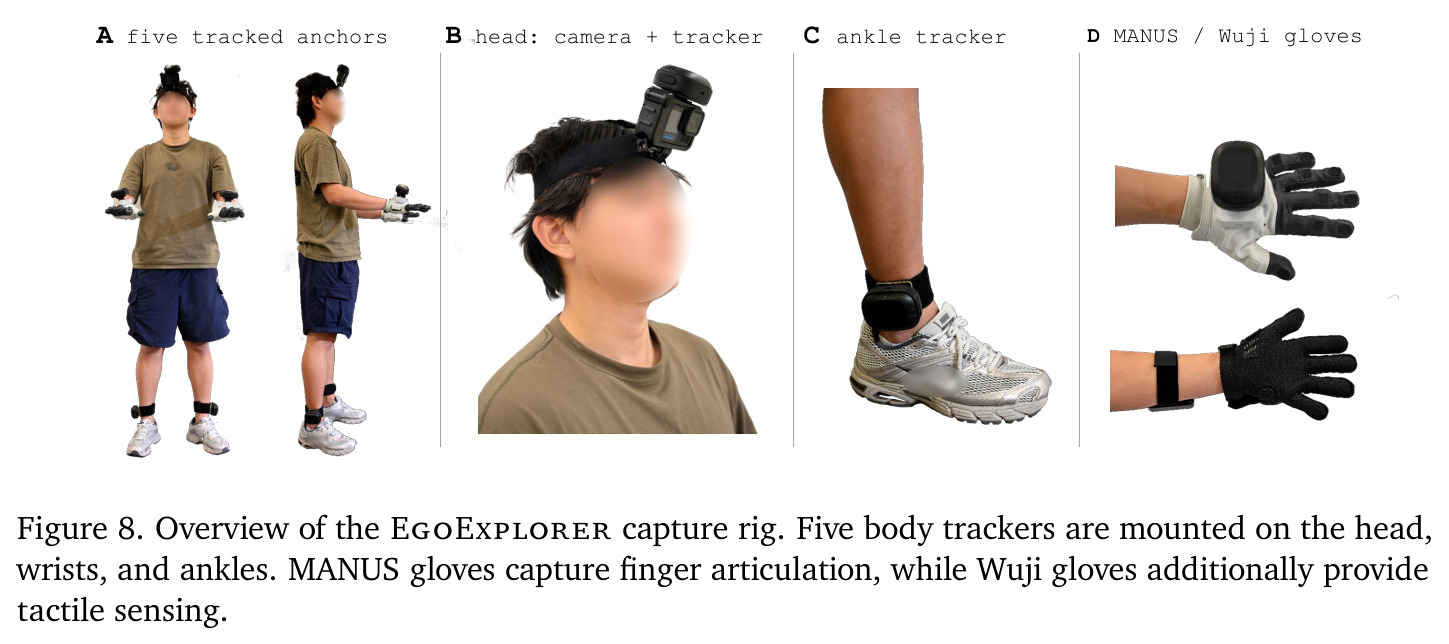
步骤一,采集:5 个 VIVE 跟踪器内向外跟踪头、双腕与双踝,头部连 GoPro;MANUS 手套测手指关节,Wuji 手套加记触觉。步骤二,协议校准:短视频经 GVHMR 得体型 $\beta_{vis}$,以实测身高定尺度初值 $s_0$;录制协议动作并按相位匹配参考库,以稳健位置损失、人体测量约束与几何正则联合求解 $\Theta_{fit}$,再恢复安装旋转 $A_i$,输出可复用 profile。步骤三,运动补全:校准变换把跟踪位姿映射为解剖锚点,5 锚点 Transformer 输出根朝向与 21 个关节旋转 $(\omega^0_t, \theta^0_t)$,骨盆由头部对齐得到,形成提案 $X^0$。步骤四,三层精修:L1 为骨架贴合(位置/朝向/先验/时序/限位损失),L2 沿法向惩罚部位间穿透,L3 惩罚顶点低于估计地面;分时间块优化得 $X^\star$。步骤五,整合标注:手指几何融合进手部网格,触觉按时间对齐;VLM 结合专家技能文档生成带时间戳与技能标签的步级描述,经人工复核发布。
技术新颖性
与已有技术的具体区别有三层。其一,相对 AvatarPoser、SAGE、HMD-Poser 等只学「锚点→姿态」映射的路线,C3 显式建模并拟合设备安装变换与个体几何,消融证明这是最大误差来源:训练时不做安装校准误差 95.0mm、测试时不校准 98.1mm、用均值体型 59.5mm,而完整校准仅 18.0mm。其二,相对 HMD 重建只约束骨架点的传统,本文引入参与者特定表面间隙约束(区分「在表面外」与「已穿入」的有向法向惩罚)和全身-地面一致性(对所有 SMPL-X 顶点而非仅脚踝加约束),把跨躯体穿透从每帧 72.8 对降到 38.1、地面违例从 61.4% 降到 6.0%。其三,相对 EgoDex、EgoTouch 等单侧模态数据集,本文在同一时间轴上同时提供全身锚点、手指关节与触觉三类传感器级非视觉测量,并以专家复核的步级文本串联,在 100 小时量级的便携采集中属首次。
实验结果
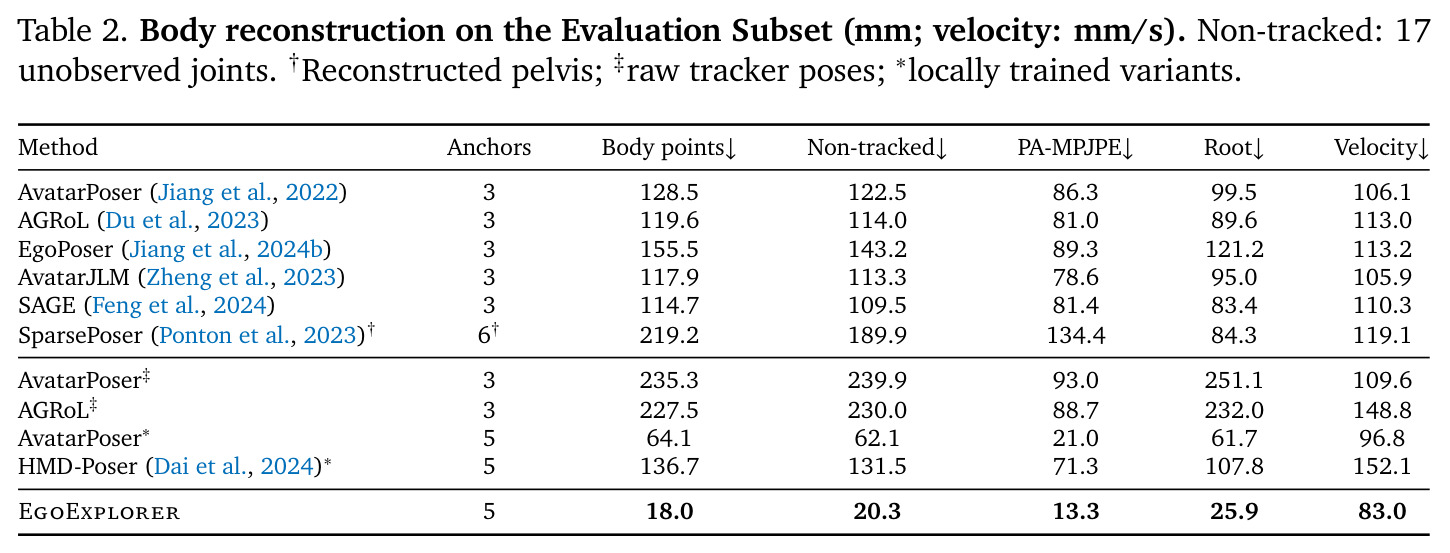
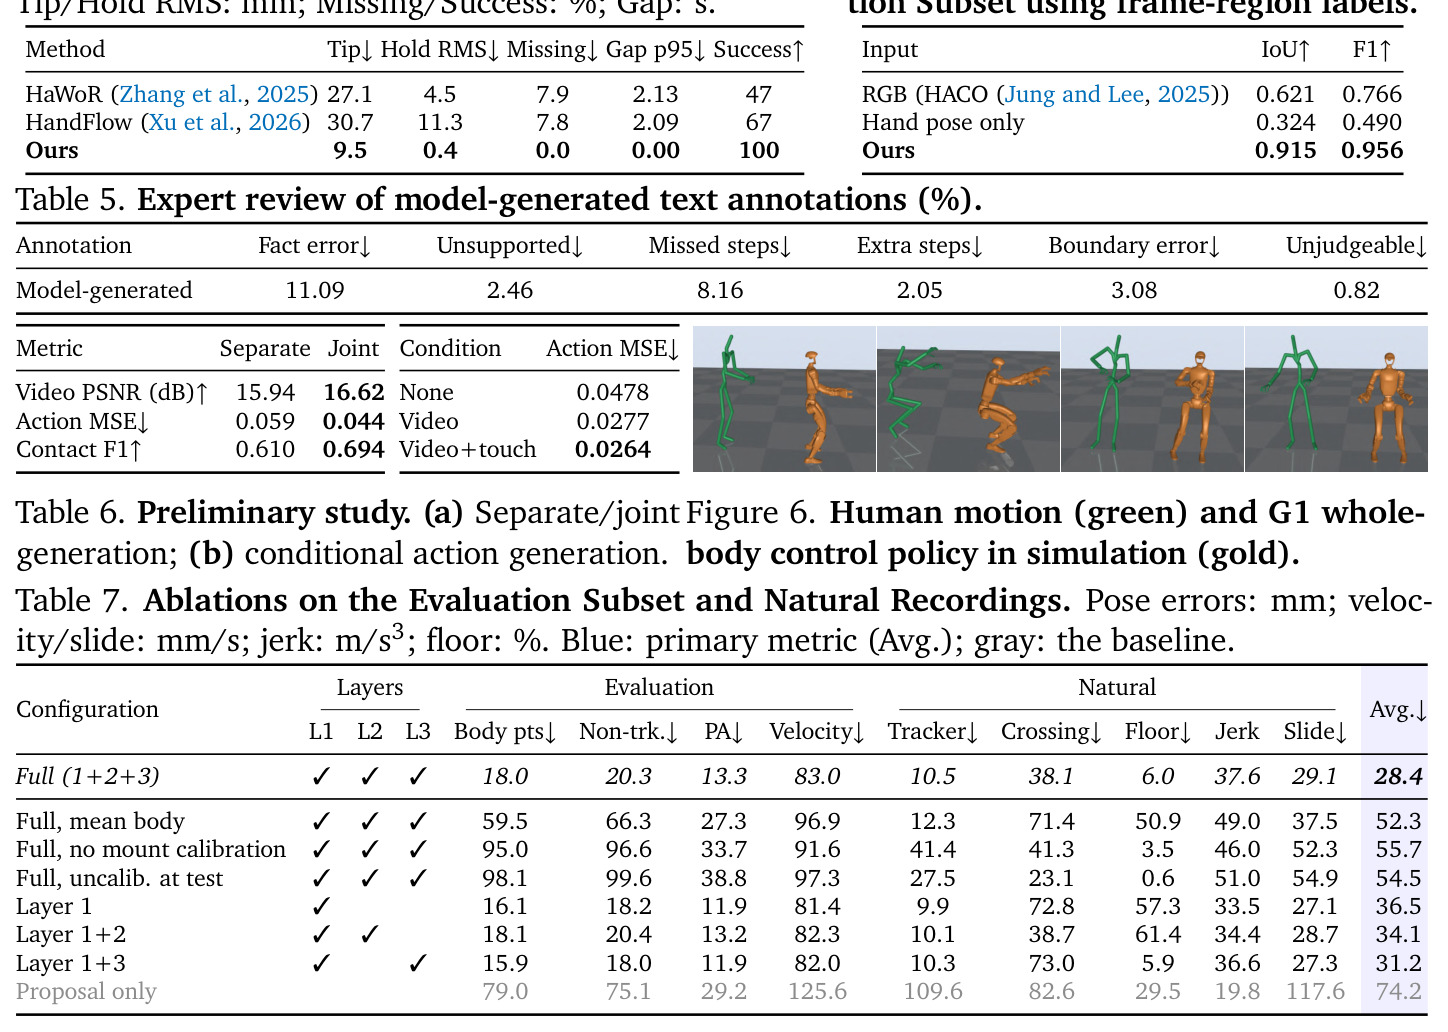
重建(Table 2):身体点误差 18.0mm、未跟踪点 20.3mm,优于公开预训练基线(SAGE 114.7mm 等)、原始位姿拟合(235.3mm)与最强 5 锚点微调 AvatarPoser*(64.1mm),相对降低 71.9%,且惠及肘、膝等未跟踪点。手部(Table 3):握持 RMS 0.4mm、缺失 0%、恢复率 100%,远好于 HaWoR(4.5mm)与 HandFlow(11.3mm)。接触(Table 4):IoU 0.915 / F1 0.956,对比 HACO 0.621/0.766。文本(Table 5):VLM 步级标注有 11.09% 事实错误、8.16% 漏步,需人工复核。初步训练研究(Table 6):Cosmos 联合生成使 PSNR 15.94→16.62dB、接触 F1 0.610→0.694;视频+触觉条件下动作 MSE 降至 0.0264。消融(Table 7):提案 79.0mm,L1 降至 16.1mm,L1+L3 地面违例 5.9%,完整配置 Avg 最优 28.4;G1 仿真重定向初步验证人到机器人运动迁移。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 全身运动重建(Evaluation Subset) | 身体点误差 (mm) | 18.0 | AvatarPoser*(5锚点本地训练)64.1;SAGE 114.7 | 相对最强基线降低 71.9% |
| 全身运动重建(未跟踪 17 关节) | 非跟踪点误差 (mm) | 20.3 | AvatarPoser* 62.1 | 约降低 67.3% |
| 手部动作捕捉 | 握持 RMS (mm) | 0.4 | HaWoR 4.5 / HandFlow 11.3 | 相对 HaWoR 降低约 91% |
| 接触区域估计 | IoU / F1 | 0.915 / 0.956 | HACO (RGB) 0.621 / 0.766 | IoU 提升 47.3%,F1 提升 24.8% |
| 多模态联合生成(Cosmos 初步研究) | 视频 PSNR (dB) / 接触 F1 | 16.62 / 0.694 | 分离生成 15.94 / 0.610 | PSNR +0.68dB,F1 +0.084 |
| 条件动作生成 | Action MSE | 0.0264(视频+触觉条件) | 无条件 0.0478 | 降低约 44.8% |
| 消融:几何合理性(Natural Recordings) | 地面违例 Floor (%) / 跨躯体穿透对 | 6.0% / 38.1(完整 L1+L2+L3) | 仅 L1:57.3% / 72.8;提案:29.5% / 82.6 | 地面违例相对仅 L1 降低约 89.5% |
局限与改进
作者承认三点:重建无法保证所有关节精确恢复(约束是软惩罚,快动作与跟踪漂移仍会残留误差);触觉传感可靠性不稳定(论文未给出 Wuji 手套的信噪比或漂移量化);初步研究仅在仿真中验证 Cosmos 生成与 ZeroWBC 式 G1 重定向,真实人形机器人上的策略学习收益未经验证。我的补充观察:其一,全身误差的参考标签本身由跟踪器拟合生成,方法与参考共享同一批传感器和 FK 模型,71.9% 的改进存在「与参考同源」的循环性风险;其二,校准假设装备位置在整个采集期不变,绑带滑动、手套转动会使 profile 失效,论文未讨论失效检测与在线重校准;其三,100 小时相对 Ego4D(3670h)仍小两个数量级,任务模板仅 10 个、以实验室化学操作和轻家务为主,缺少重体力工业与户外高动态场景;其四,步级文本 11.09% 的事实错误率意味着人工复核成本随数据规模线性增长,是扩产的隐性瓶颈。
独立分析的弱点
第一,参考循环性:全身重建以「跟踪器拟合」标签为参考,而本文方法使用同一批 VIVE 跟踪器与同一 SMPL-X 前向模型,评估可能高估绝对精度;改进方向是引入独立真值子集,如对少量会话叠加光学动捕或三维扫描网格做交叉验证。第二,校准的脆弱性:profile 假设 $a_i, A_i$ 在数小时采集内恒定,实际中绑带滑动、手套旋转都会使安装变换漂移,当前流程只能停下来重新校准;可在线监测位置残差并自动触发重校准,或把安装变换作为低带宽状态在优化中缓慢估计。第三,触觉质量不可控:论文只承认「variable reliability」,未发布触觉信噪比、漂移或标定协议,下游把它当监督信号有风险;应随数据发布触觉质量元数据与逐段置信度。第四,场景域偏窄:10 个模板集中在实验室操作与家务,重工业搬运、户外地形等高动态场景缺失,且内向外跟踪器贴身安装,蹲跪爬行时相机易被遮挡,可补充 IMU 冗余或少量外部锚点。第五,仿真到实机鸿沟:G1 重定向与全身控制跟踪仅在仿真完成,接触密集的化学操作迁移到实机将面临动力学与感知差异,需要在真机上闭环验证。
未来方向
作者提出的方向:验证数据对真实人形策略学习的收益(目前只有 Cosmos 生成与仿真重定向的初步证据),以及改进触觉传感可靠性。基于成果可延伸的方向包括:把 C3 校准升级为在线自适应,实现「即穿即用」、免协议部署;利用触觉-动作对齐数据训练接触预测器或触觉条件策略,服务灵巧手操作;将这 100 小时精确标注与 Ego4D 等大规模视频库结合,做伪标注蒸馏以放大数据规模;扩展到双人协作与人-机器人协同场景,捕捉交互动力学;以步级文本为条件探索层次化策略学习与任务规划;在真实 G1 或其他人形平台上复现 ZeroWBC 式全身跟踪,报告成功率与失败模式,把「初步研究」变成可比较的基准。
复现评估
论文提供主页、Toolkit 与数据入口(首页列出 Homepage/Toolkit/Data 链接),声称发布 2715 段录音、Evaluation Subset 与 Natural Recordings。复现 C3 所需硬件:5 个 VIVE Ultimate Tracker、GoPro HERO13 加 Media Mod、MANUS Metagloves 或 Wuji 触觉手套、3D 打印支架(成本与部署权衡在附录 G 讨论,估计数千美元量级)。算力方面,运动先验是在 AMASS 上训练的 AvatarPoser 式 Transformer,单张消费级 GPU 即可;约束精修为逐段优化,普通工作站可跑。主要不确定性在于:协议校准的实现细节、损失权重与参考动作库是否完整开源,VLM 标注管线(附录 D.2)依赖特定工具版本。对只想「用数据」的研究者门槛较低;对想复建整套采集系统的研究者,需复刻硬件支架、标定流程与标注审核工作流,属中等偏上难度。
论文图表
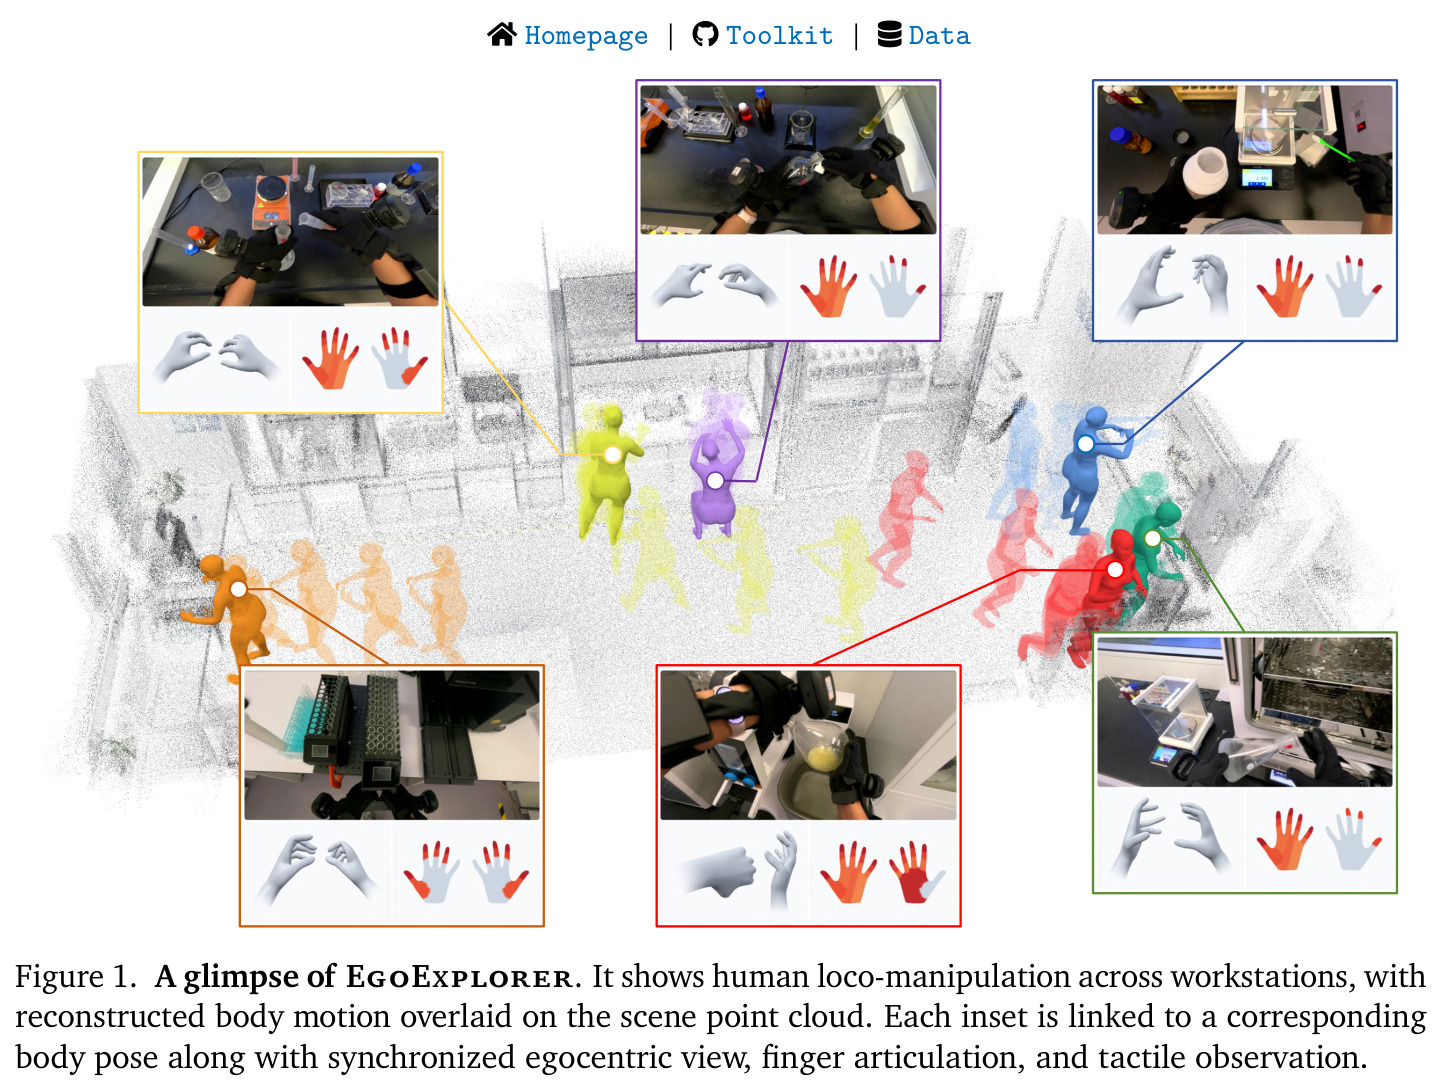
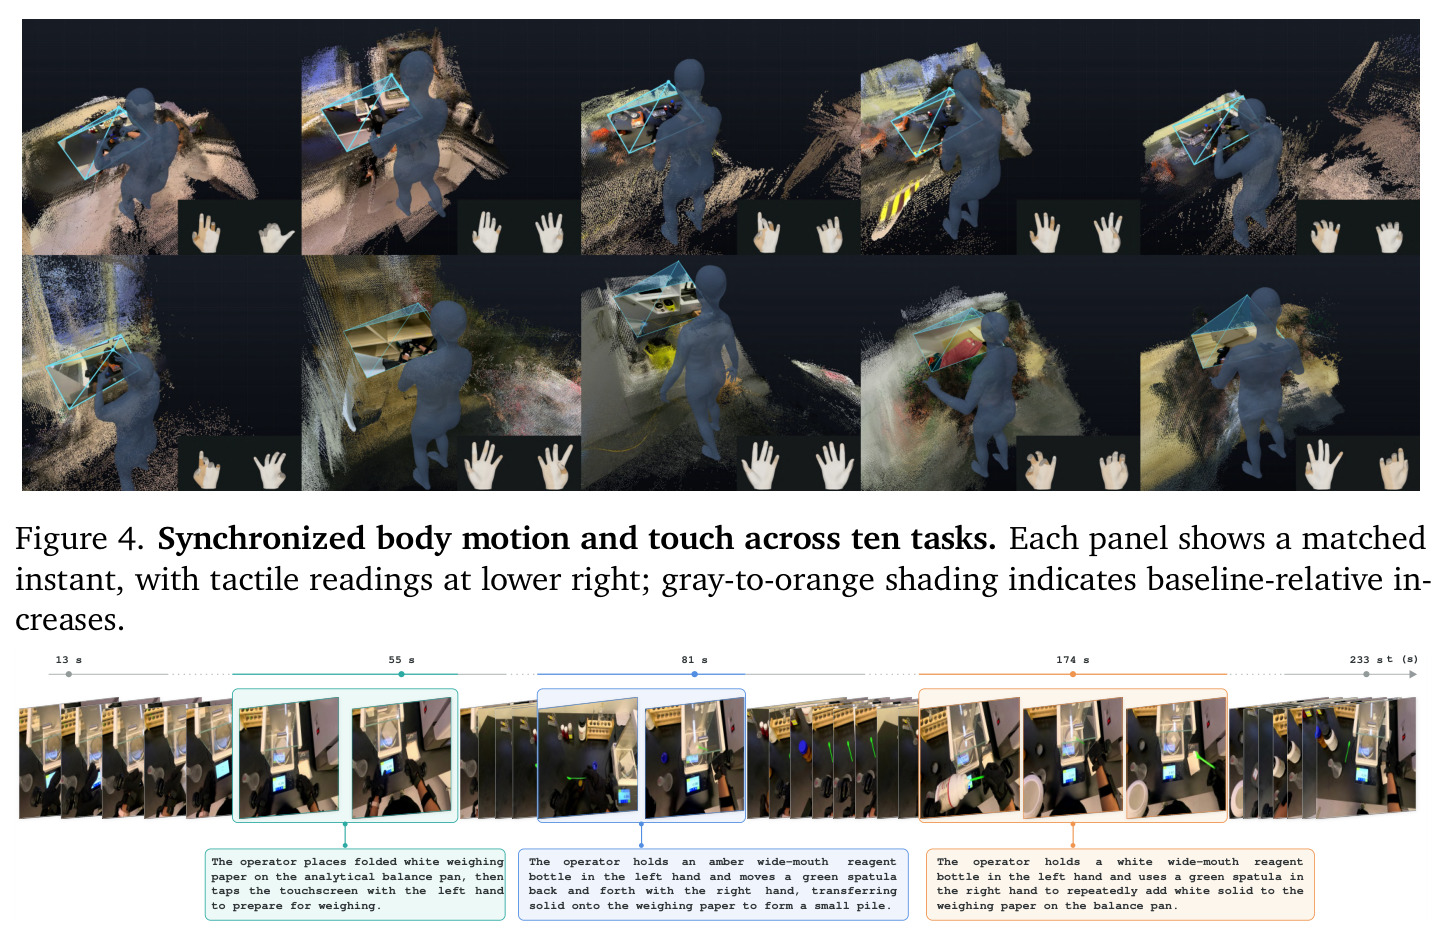
展示工作站点间人类移动操作的场景点云,其上叠加重建的身体动作;每个插图对应某一身体姿态,并配有同步的自我中心视角、手指关节与触觉观察。
一眼看懂数据集的模态构成与多模态时间轴对齐方式,是理解「观测站」定位的产品级展示图。
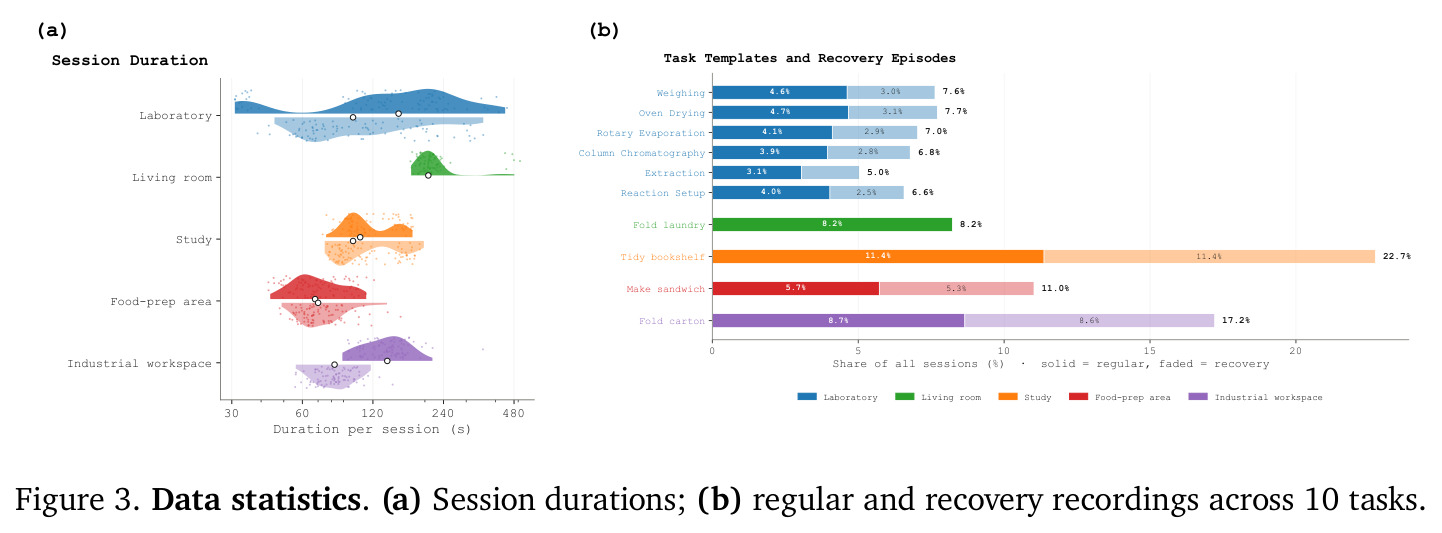
各环境的会话时长分布(30–480 秒); 10 个任务模板中常规录制与恢复录制的占比,如整理书架 11.4%、折纸箱 17.2%、称量 7.6% 等,并标注五种环境。
了解数据集规模、环境与任务构成必看此图,恢复情节(对中断与失败的反应)这一特色也由它呈现。