TouchScale:面向视觉-触觉学习的500小时人类视觉与触觉数据集 TouchScale: 500 Hours of Human Vision and Touch for Visual-Tactile Learning
统一穿戴设备采集500小时人类视觉与触觉数据,显著提升触觉预测与机器人操作
前置知识
自我中心(Egocentric)RGB-D 感知
头戴式相机从人眼视角同时记录彩色图像与深度图,深度流提供米制三维场景几何。相比纯 RGB,RGB-D 让模型不仅看到手在动,还能推断手与物体的空间关系、接近轨迹和接触前的几何布局,是具身学习中最主流的人类数据形态。
本文的核心数据布局就是头戴 RGB-D 加双腕 RGB 再配触觉手套,理解数据集结构和视觉到触觉的预测任务都依赖这个概念。
Taxel(触觉感应单元)
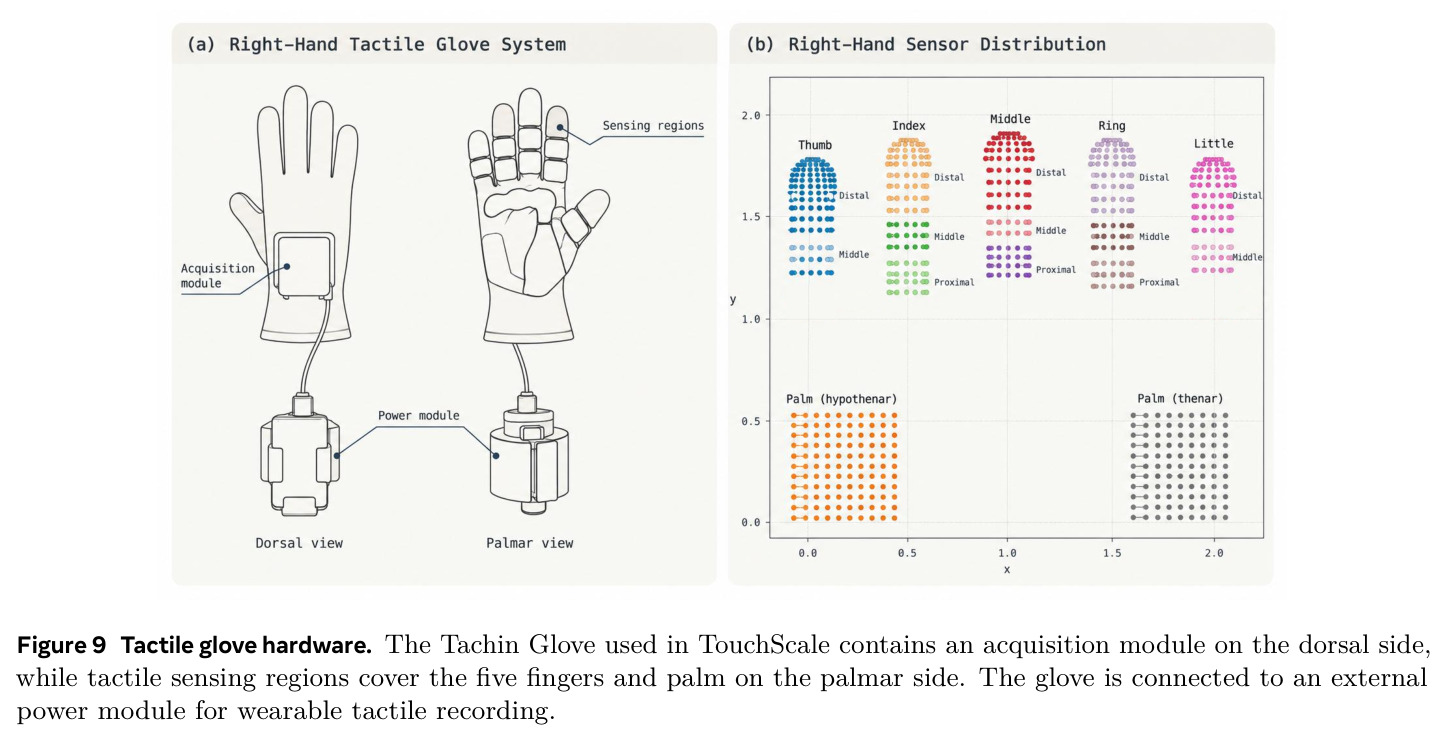
tactile pixel 的合成词,指触觉传感器上最小的压敏单元,类似图像像素。传感器密度用每只手的 taxel 数量衡量,本文手套每手 880 个、单元 1.5×1.5mm、空间分辨率低于 2mm,可输出整只手的稠密接触压力图。
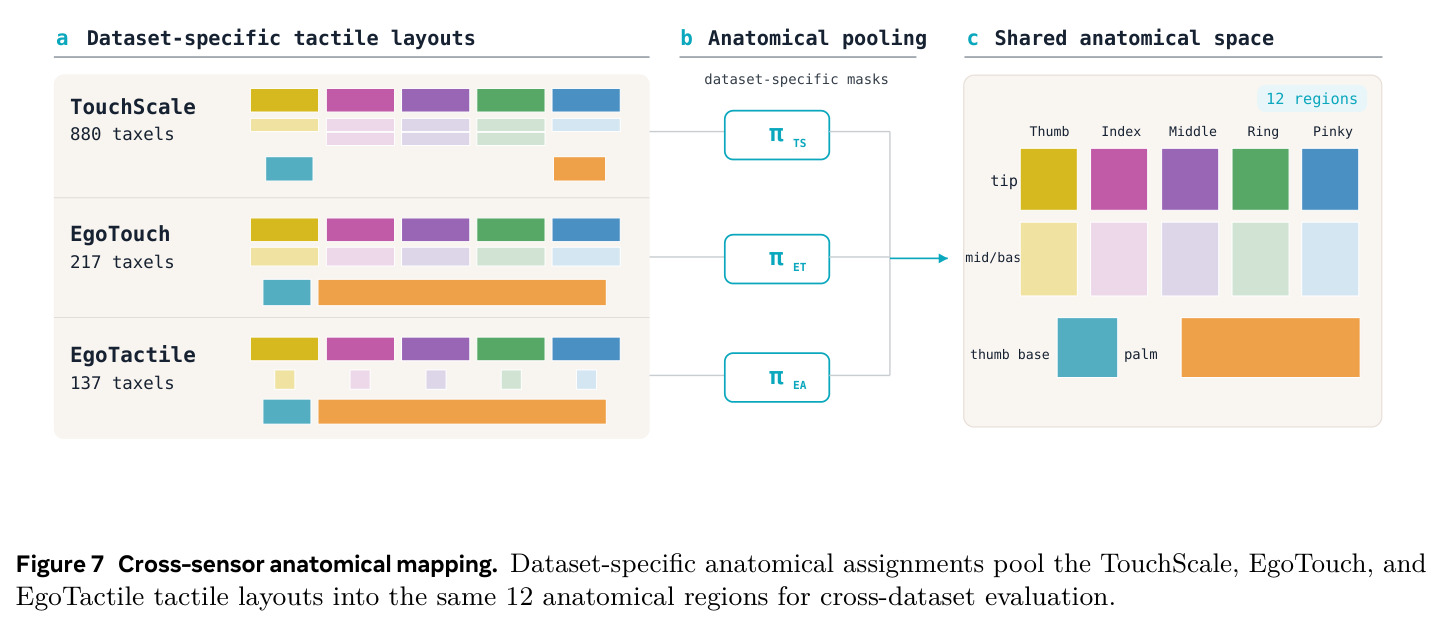
数据集的触觉分辨率、与 EgoTouch(217 格)、EgoTactile(137 格)的跨数据集对比,以及 12 个解剖区域的池化评测,全部建立在 taxel 布局差异之上。
cIoU / vIoU 等区域级触觉指标
把预测与真值压力图按手部解剖区域(指尖、指中基节、手掌、拇指根共 12 个)池化后,cIoU 计算二值接触区域的交并比,vIoU 计算区域平均压力的重叠度,另有压力中心 CoP 定位误差与区域压力幅值误差,共同构成跨传感器的统一评测协议。
论文所有触觉实验(零样本迁移、数据缩放)都围绕这四个指标展开,不懂指标定义就看不懂表 2 和图 4。
VLA 中间训练(mid-training)
在机器人专用数据后训练(post-training)之前,先用大规模人类或机器人数据训练策略的中间表征。本文在 N0-VTLA 上冻结 3.71B 主干,只训触觉投影层与预测器,用未来 50 帧触觉变化的对比预测做目标,不需要人手动作重定向。
这是机器人实验(成功率 22.5%→57.5%)的核心机制,也是本文区别于 TactAlign、TTP 等需要人机动作对齐工作的关键。
InfoNCE 对比损失与 Top-K 检索准确率
把配对正样本在表征空间拉近、批内其他样本推远的对比目标,形式为 $\mathcal{L}=-\log \frac{\exp(s_{ii}/\tau)}{\sum_j \exp(s_{ij}/\tau)}$,其中 $s_{ij}$ 为余弦相似度、$\tau$ 为温度。评测时把预测表征在候选集中排序,Top-K 准确率衡量正确目标进入前 K 名的比例。
TouchScale 中间训练的损失函数和未来触觉预测评测(Top-10 从 0.18% 到 3.31%)都基于这套框架,是理解附录 D 的前提。
研究动机
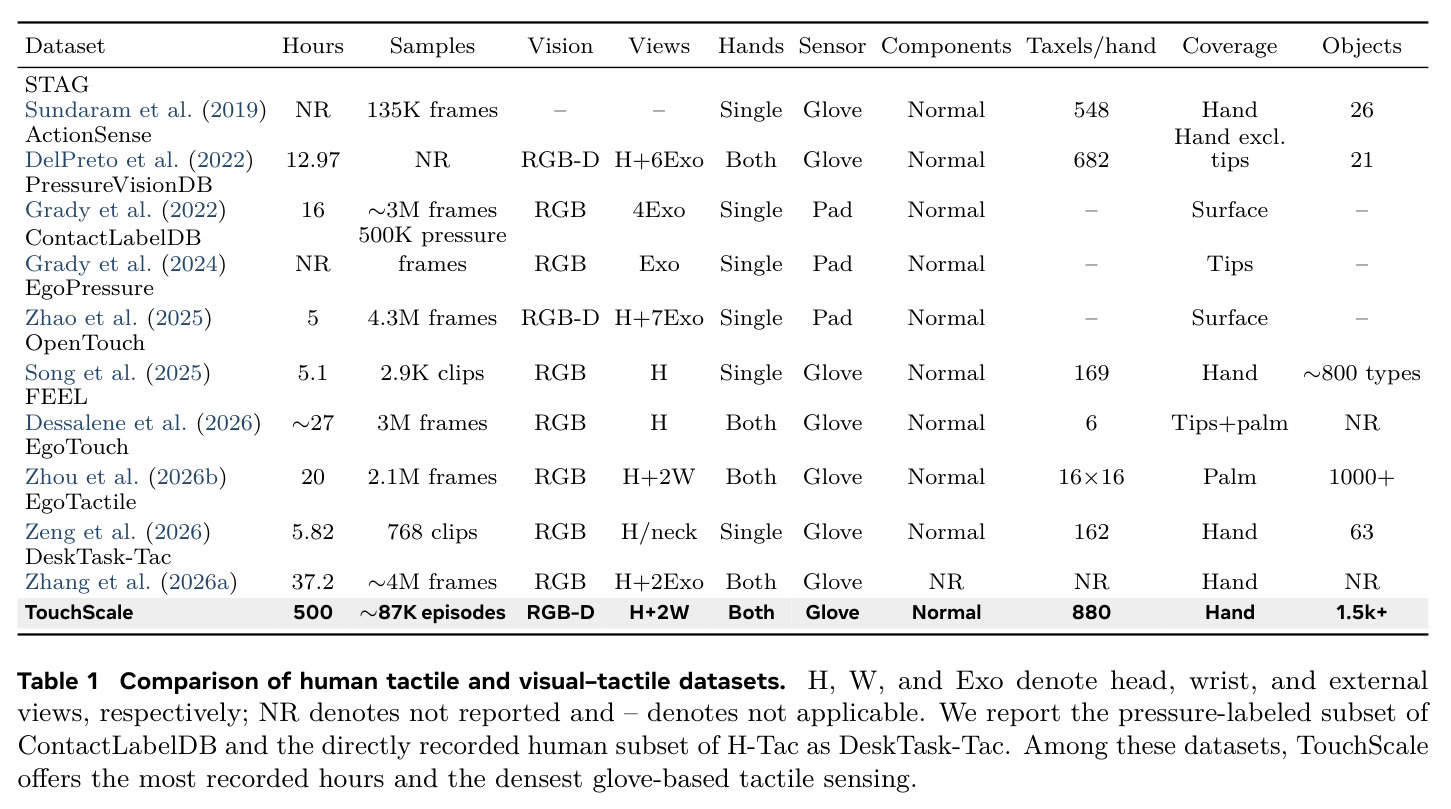
自我中心人类视频数据集已达到数千甚至两万小时以上的规模,并开始支撑机器人学习,但视频只记录手的运动:抓鸡蛋、拧湿布这类任务的成败取决于手指按压的位置与力度,而接触和压力信号在视频中完全缺失。现有视触觉数据集虽然补上了这一监督信号,规模却远小于人类视频——EgoTouch 约 20 小时、FEEL 约 27 小时、EgoTactile 仅 5.82 小时、OpenTouch 5.1 小时,多数不足 30 小时,无法在单一数据集内部研究“数据规模”本身的影响。更麻烦的是,若把多个数据集拼起来扩大规模,不同数据集在传感硬件(手套或压敏垫、每手 taxel 数从 6 到 880 不等)、标注流程与同步方案上的差异会与数据量混淆在一起,无法剥离规模的贡献。因此,用同一条感知管线、统一硬件连续采集数百小时人类视觉与触觉的数据集始终缺位,这也是阻碍视触觉学习走向 scaling 时代的根本瓶颈。
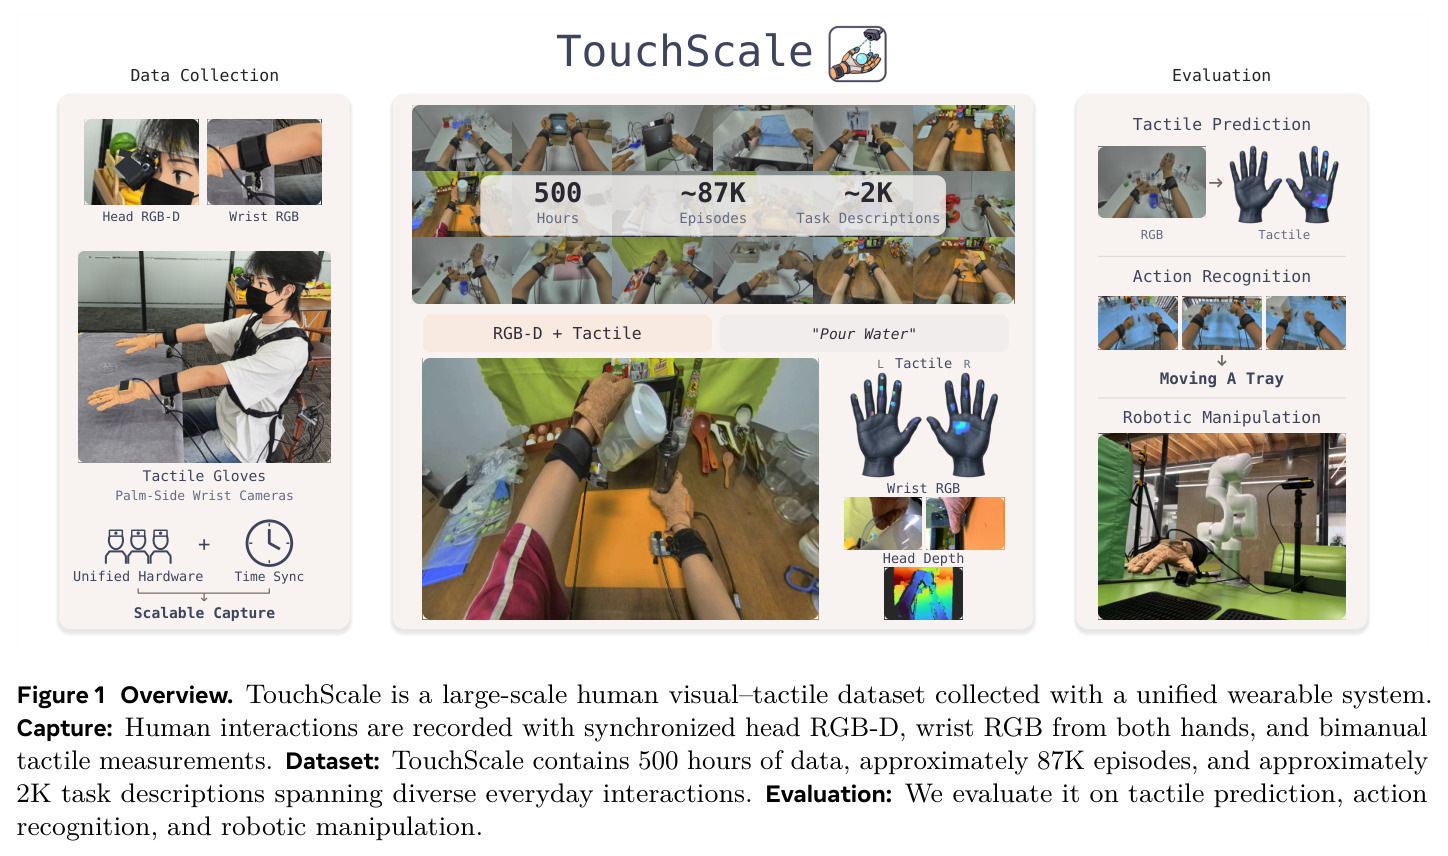
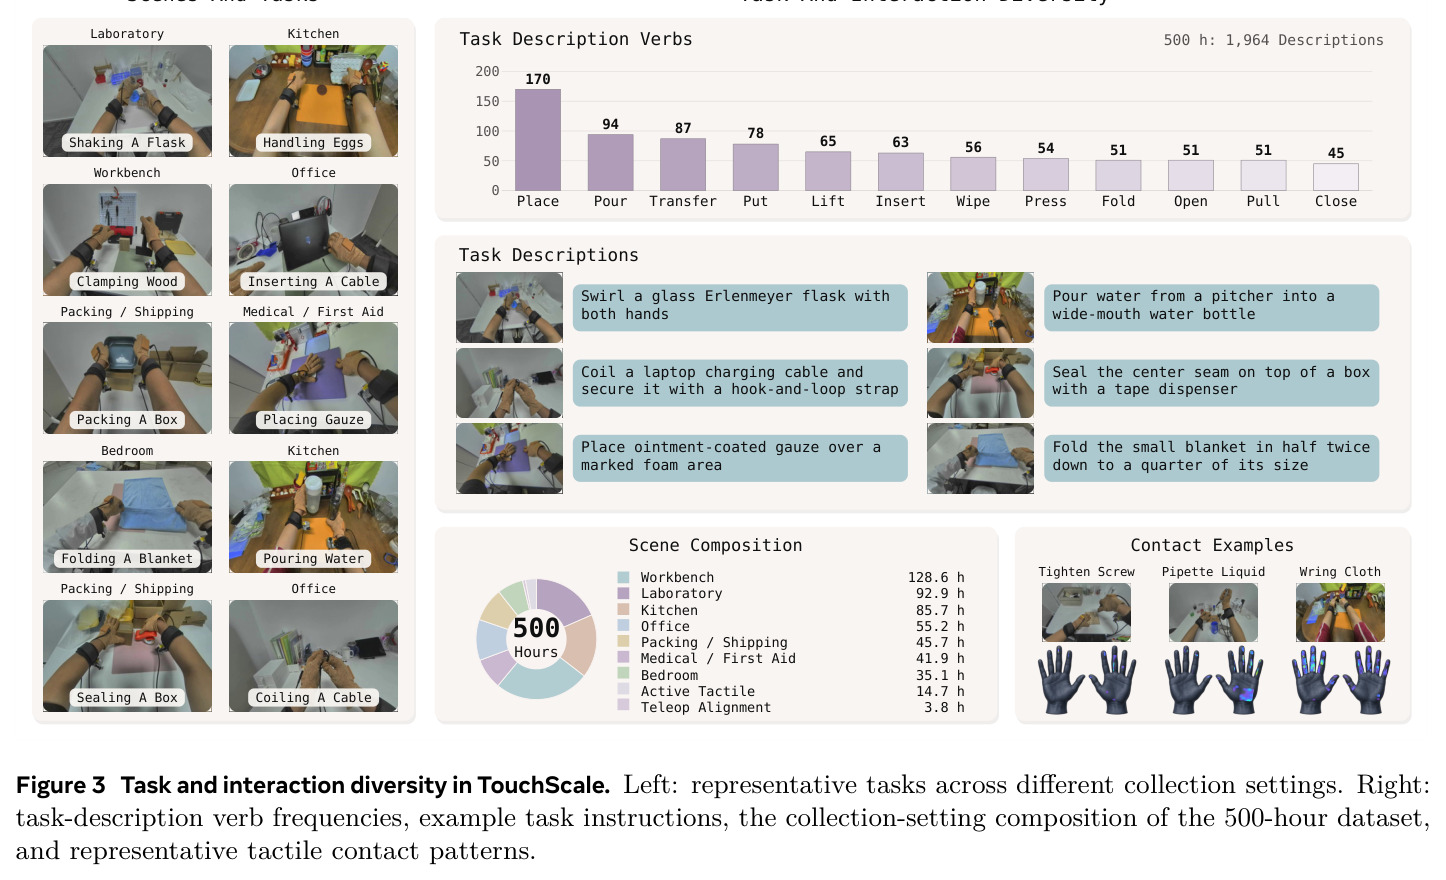
本文的目标是本文的目标是构建并公开发布 TouchScale:一个由统一可穿戴设备一次性采集的 500 小时、约 8.7 万条片段、约 2K 条(实际 1,964 条)自然语言任务描述、覆盖 1.5K+ 物体、9 大采集场景与 800+ 独立场景配置的双手机械触觉数据集,每条记录都时间同步头戴 RGB-D 视频、左右腕 RGB 视频与双手各 880 taxel 的稠密触觉测量,并附约 20 名受试者的多样化操作行为。在此数据上,作者明确要回答四个问题:(1) 在 TouchScale 上训练的模型能否零样本迁移到训练时未见过的触觉传感器;(2) 以触觉为监督预训练视觉编码器,能否学到可迁移到动作识别等下游任务的视觉表征;(3) 作为免动作标注的视觉-触觉中间训练,能否提升真实机器人接触密集操作的成功率;(4) 在传感器与采集协议完全固定的前提下,感知与控制性能是否随数据量增加而持续上升。
与已有工作不同的是,已有把人类数据用于机器人学习的工作分三类,各有局限:只用视频的方法缺少接触监督;TactAlign、TTP 等把人类触觉数据与动作监督绑定,需要人机观测对齐或动作空间重定向;T-Rex 与 N0-VTLA 的 Stage-1 在机器人数据上做触觉中间训练,仍然受限于机器人数据的规模。本文的独特切入有三点:其一,用完全统一的一代传感器与同步管线一次采足 500 小时,让“数据量”成为实验中唯一可变的因素,从而把规模效应与硬件异构性干净地分开;其二,接入 N0-VTLA 时完全不使用人类动作标签、不做手部动作重定向,只做免动作的视觉-触觉中间训练,直接检验人类视触觉信号本身的价值;其三,通过把 880、217、137 三种 taxel 布局映射到统一的 12 个手部解剖区域,首次让不同硬件上的零样本触觉预测可以公允比较。
核心方法
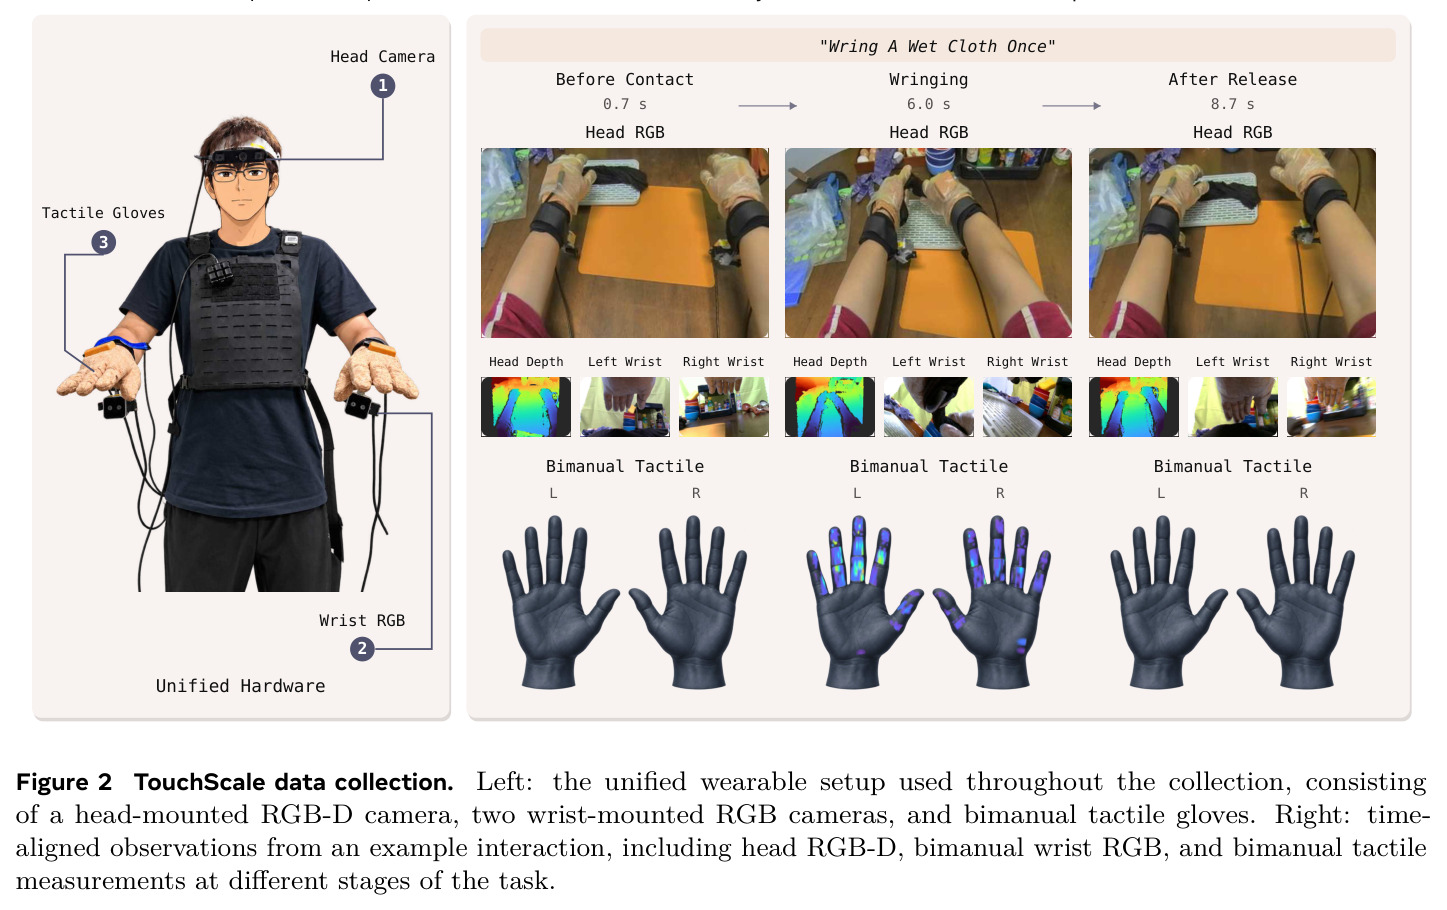
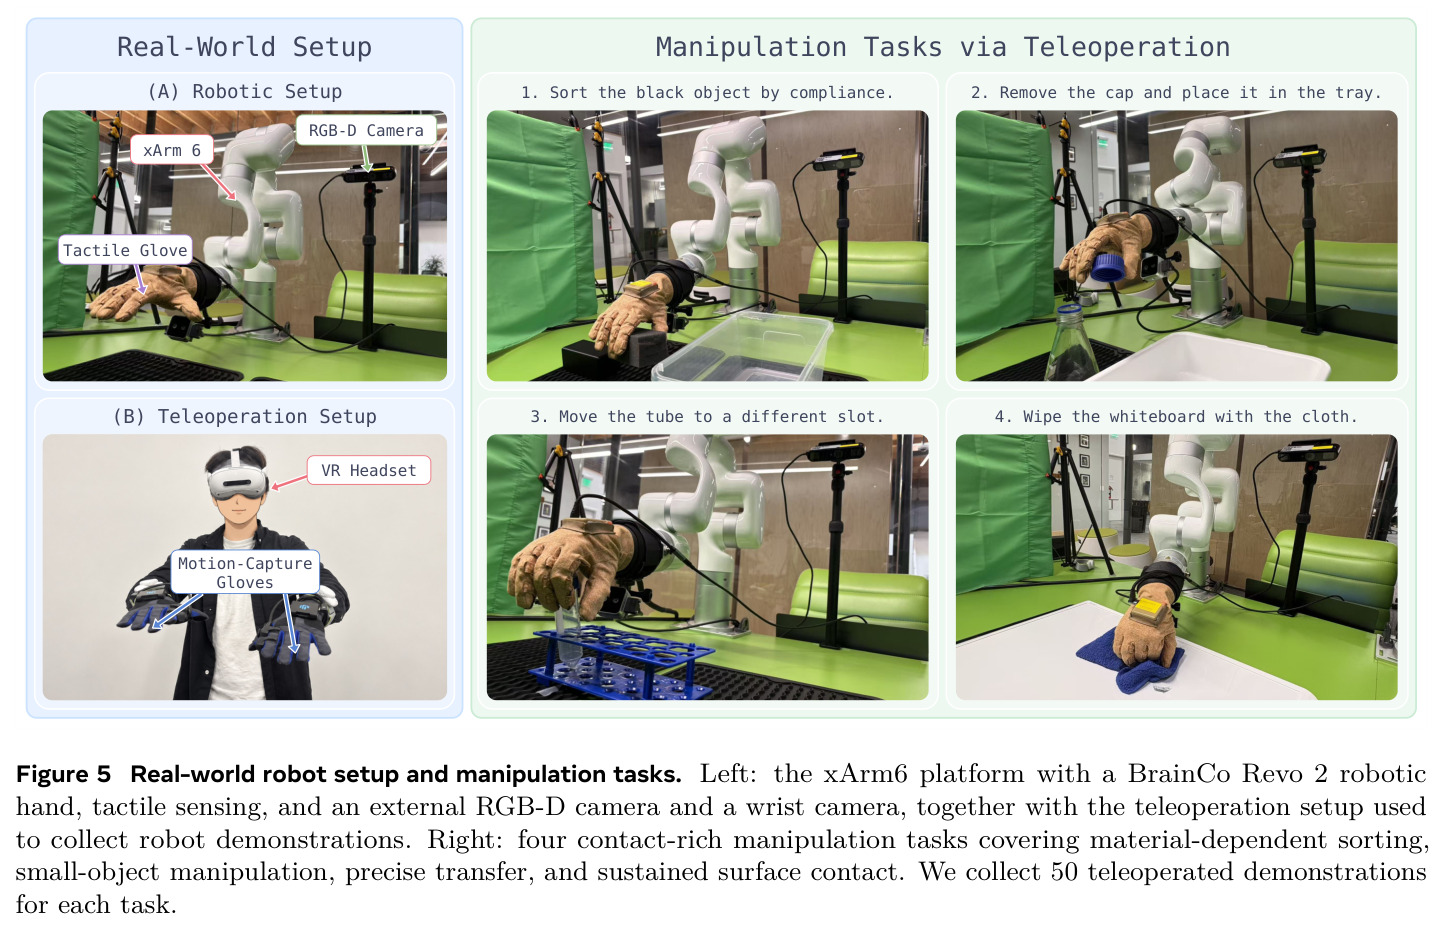
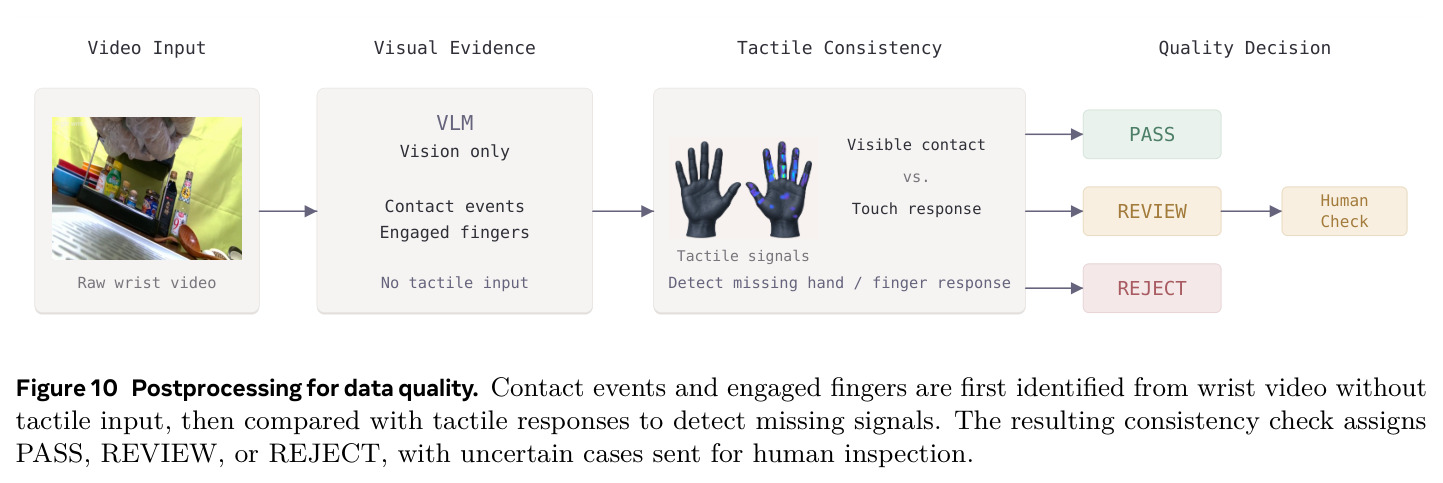
整体思路先直觉后技术:与其拼凑多个硬件各异的异构小数据集,不如用同一套可穿戴设备——头戴 Orbbec Gemini 345Lg RGB-D 相机、双腕 RealSense D405 相机、双手 Tachin 触觉手套——一次采足 500 小时,使硬件与同步协议在全数据集内恒定。技术路线分三步。第一步是数据采集与质检:约 20 名受试者在实验室、厨房、工作台等 9 类场景按 1,964 条任务描述操作 1.5K+ 物体,事后用 Gemini 3.7 Flash 在看不到触觉的腕部视频上盲判抓取区间与接触手指,与触觉交叉验证并自动给出 PASS/REVIEW/REJECT。第二步是感知评测:训练 TouchAnything 做视觉到触觉的压力预测,用 12 个解剖区域上的 cIoU、vIoU、CoP 定位误差与压力幅值误差在未见过的 EgoTactile 传感器上零样本评测,并以 Hiera-B 预训练检验表征迁移。第三步是机器人评测:把 TouchScale 作为 N0-VTLA 的免动作中间训练,再在 xArm6 上对四个真实接触密集任务后训练,评估成功率并扫描数据缩放曲线。
核心创新有三点。其一,“规模+一致性”的数据设计:500 小时全部出自同一代传感器与同步管线,对比 EgoTouch(20h)、FEEL(约 27h)等小规模或异构拼合的数据集,首次让数据量成为可单独研究的变量,并用 10%→100% 的受控缩放实验验证了正趋势。其二,免动作的视触觉中间训练:不同于 TactAlign/TTP 需要对齐人机观测或动作空间,本文只在 N0-VTLA 上训练触觉预测通路,让模型以当前触觉观测加视觉-语言上下文去对比预测未来 50 帧的触觉变化 latent token,人类数据阶段完全不涉及动作标签与手部重定向。其三,跨传感器解剖区域映射协议:把 TouchScale 32×44 网格(880 有效 taxel)、EgoTouch 21×21(217 格)、EgoTactile 17×19(137 格)三种原生布局固定映射到五指指尖、五指中基节、手掌、拇指根共 12 个解剖区域,训练时保留原生布局、仅在评测时池化,使不同硬件的零样本比较有了公允的标尺。
方法步骤详情
第一步,采集:头戴 RGB-D 与双腕 RGB 均 30Hz 记录(Gemini 345Lg 加双 D405),手套每手 880 个 1.5×1.5mm taxel。第二步,质检:Gemini 3.7 Flash 在 2fps 腕部视频上盲标抓取区间与接触手指,与触觉比对:整手静默但视觉确认在交互则 REJECT,多根确认手指全程无响应判故障,单指异常转 REVIEW,二次复核标出噪声。第三步,触觉评测:压力按每序列最大值归一化到 $[0,1]$,经查找矩阵 $M^{(d)}$ 池化到 12 个解剖区域,计算 cIoU、vIoU、CoP 与幅值误差。第四步,表征预训练:同一 Hiera-B 权重,用四个数据集分别做触觉预测预训练,再迁移到三个动作识别基准。第五步,中间训练:自 N0-VTLA 官方检查点出发,冻结 3.71B 主干,只训约 123.8M 参数的触觉通路,用对称 InfoNCE($\tau=0.07$)加 $\lambda_{rec}=0.5$ 的重建损失预测未来 $H=50$ 帧触觉变化。第六步,与基线用相同的每任务 50 条遥操作演示后训练,各 20 次试验评分。
技术新颖性
从技术新颖性看:(1) 数据维度上,TouchScale 以 500 小时、约 87K episodes 成为规模最大、且是唯一同时提供头戴 RGB-D、双腕 RGB、双手 880 taxel 触觉并附 1.5K+ 物体重建模型的单一管线数据集,遥遥领先 DeskTask-Tac 的 37.2 小时与 EgoTouch 的 20 小时;(2) 评测维度上,解剖区域池化把“传感布局不同”从比较障碍变成可控变量,配合区域级四指标避免直接在 taxel 数量不等的网格上刷分,为跨硬件触觉研究提供了可复用的协议;(3) 训练维度上,“人类数据免动作中间训练 + 机器人数据后训练”的两段式范式,把 N0-VTLA 原本在机器人数据上进行的 Stage-1 未来触觉预测前移到人类数据上,证明视触觉监督可以不经动作对齐就迁移到策略;(4) 缩放分析维度上,固定传感器与协议、只变数据量的 10%–100% 扫描(触觉预测)与 20%–100% 扫描(机器人成功率、未来触觉预测),为“人类视触觉数据是否服从 scaling 行为”提供了首个受控证据。
实验结果
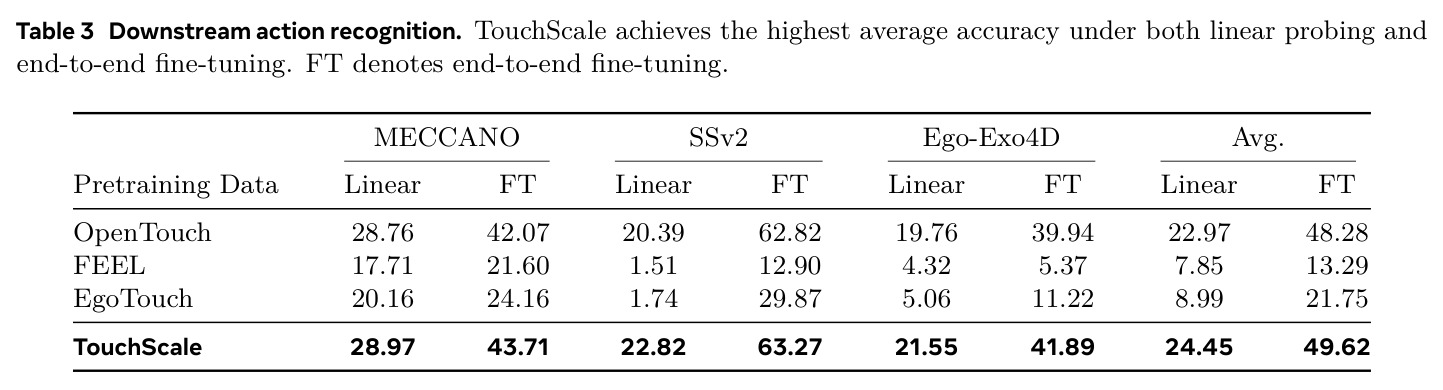
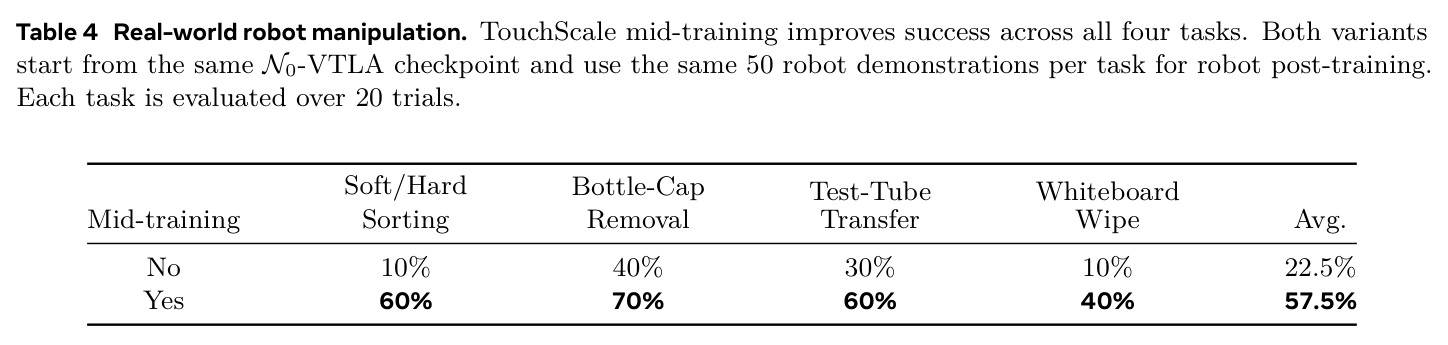
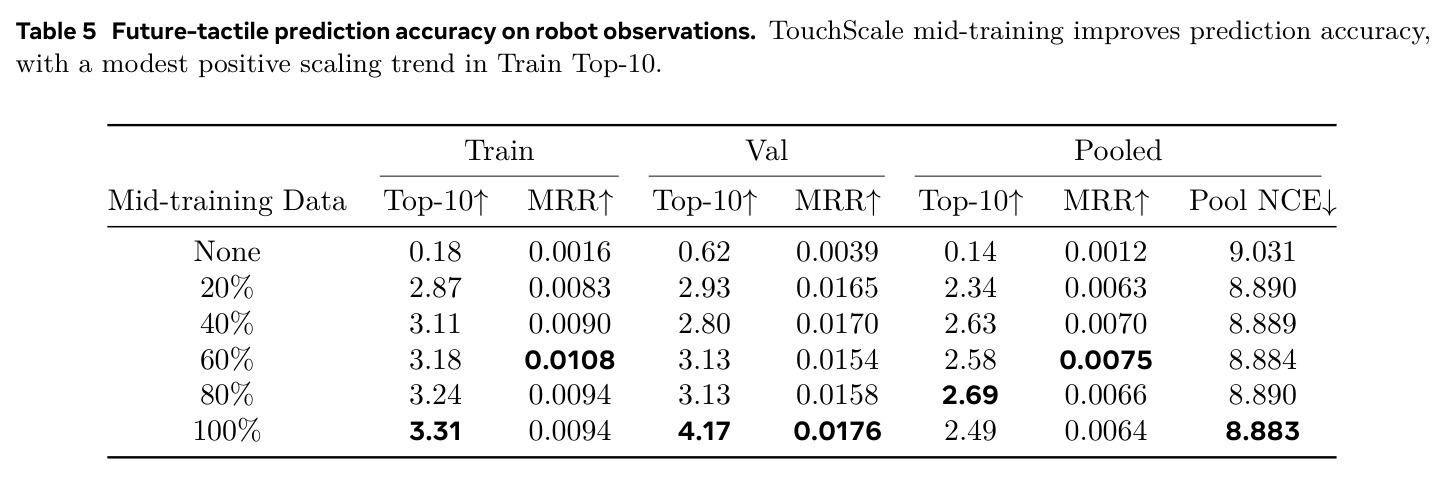
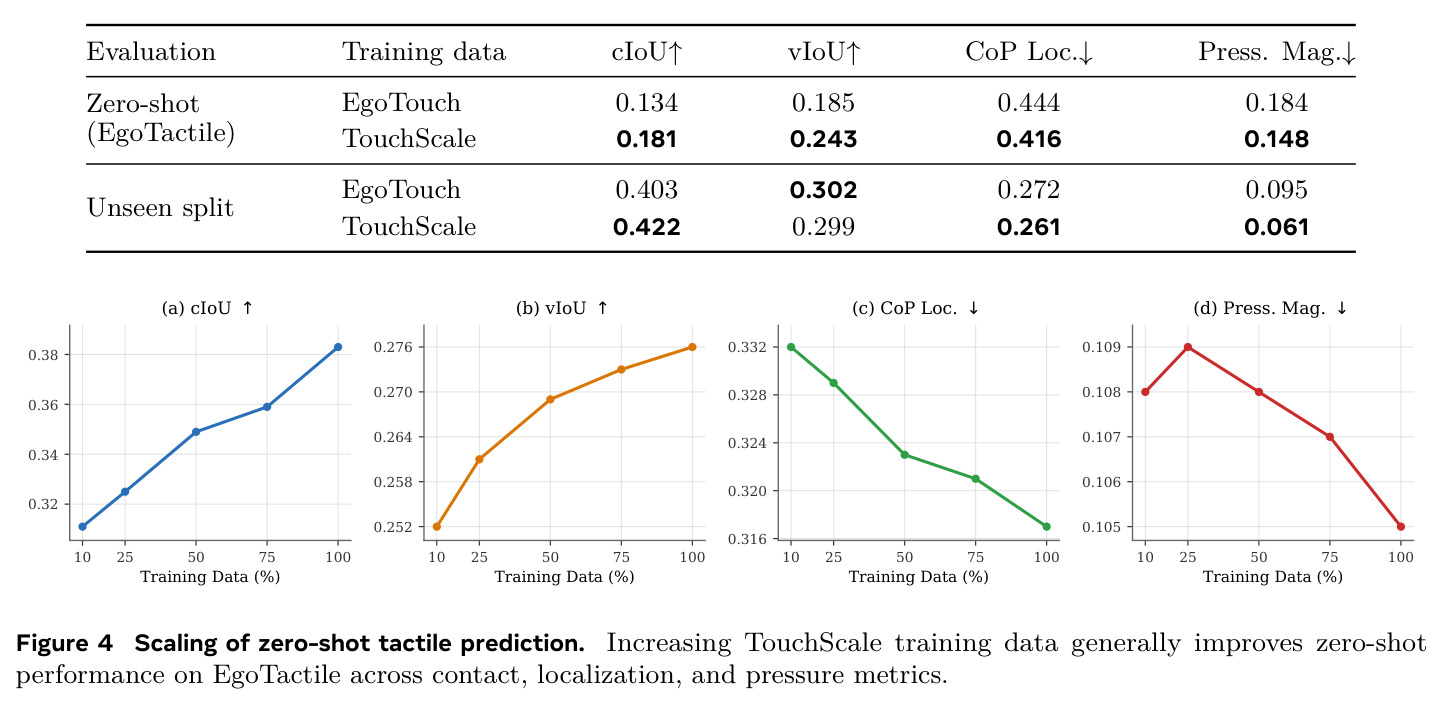
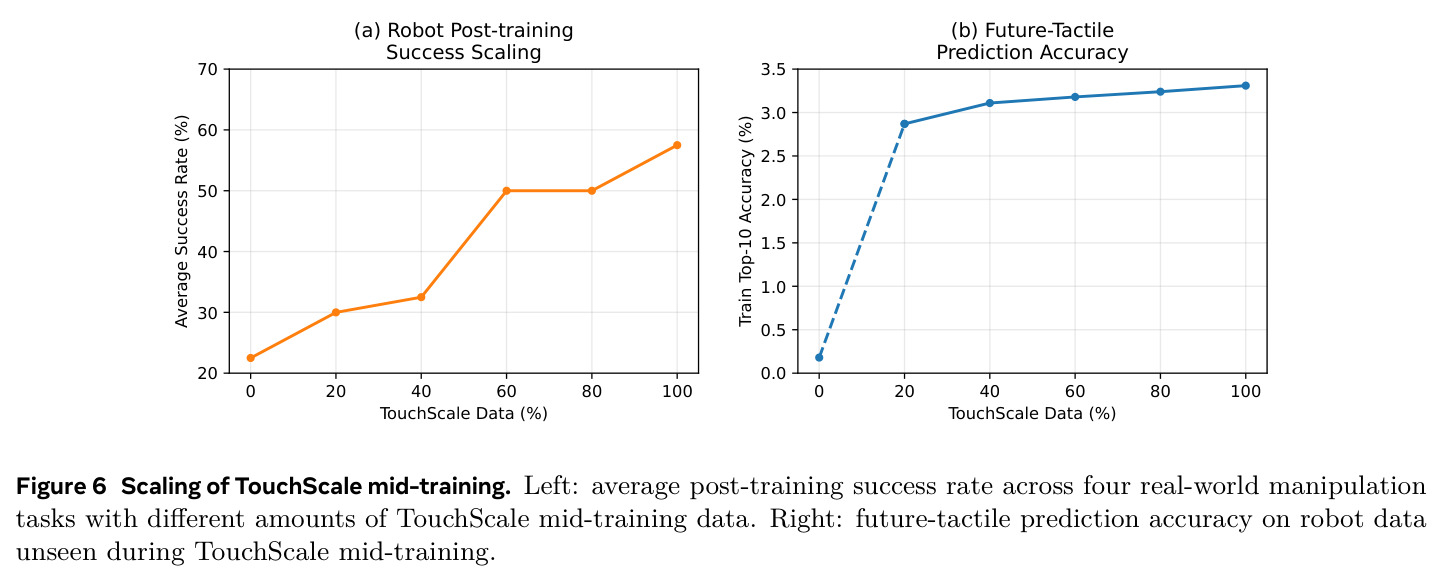
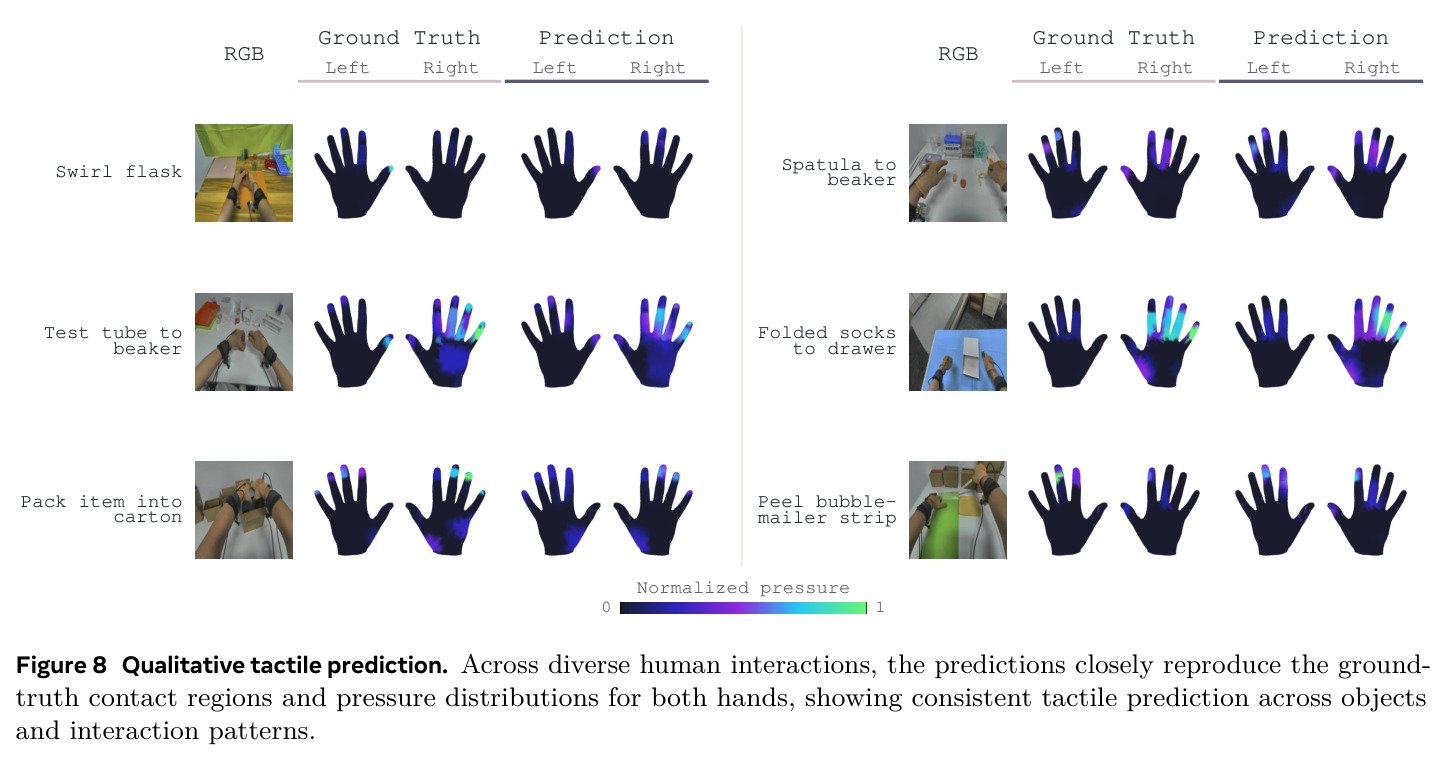
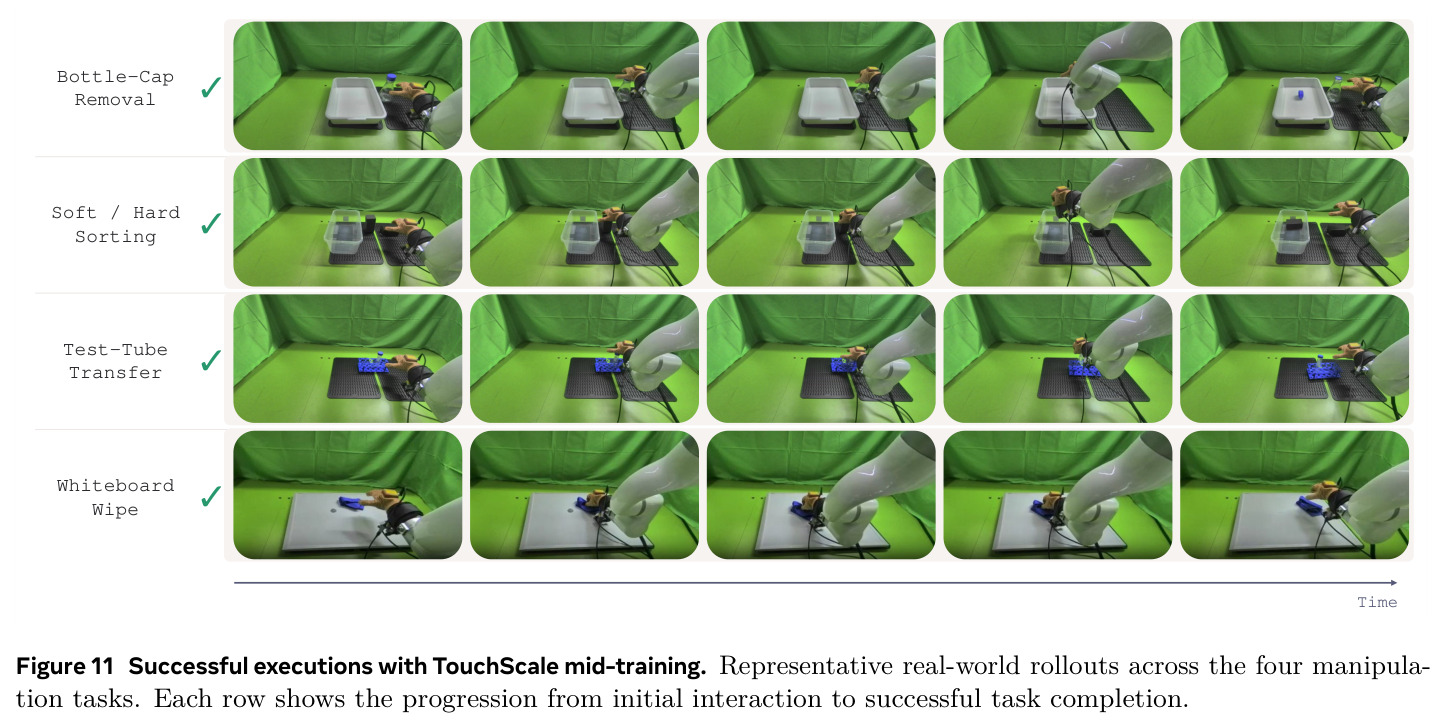
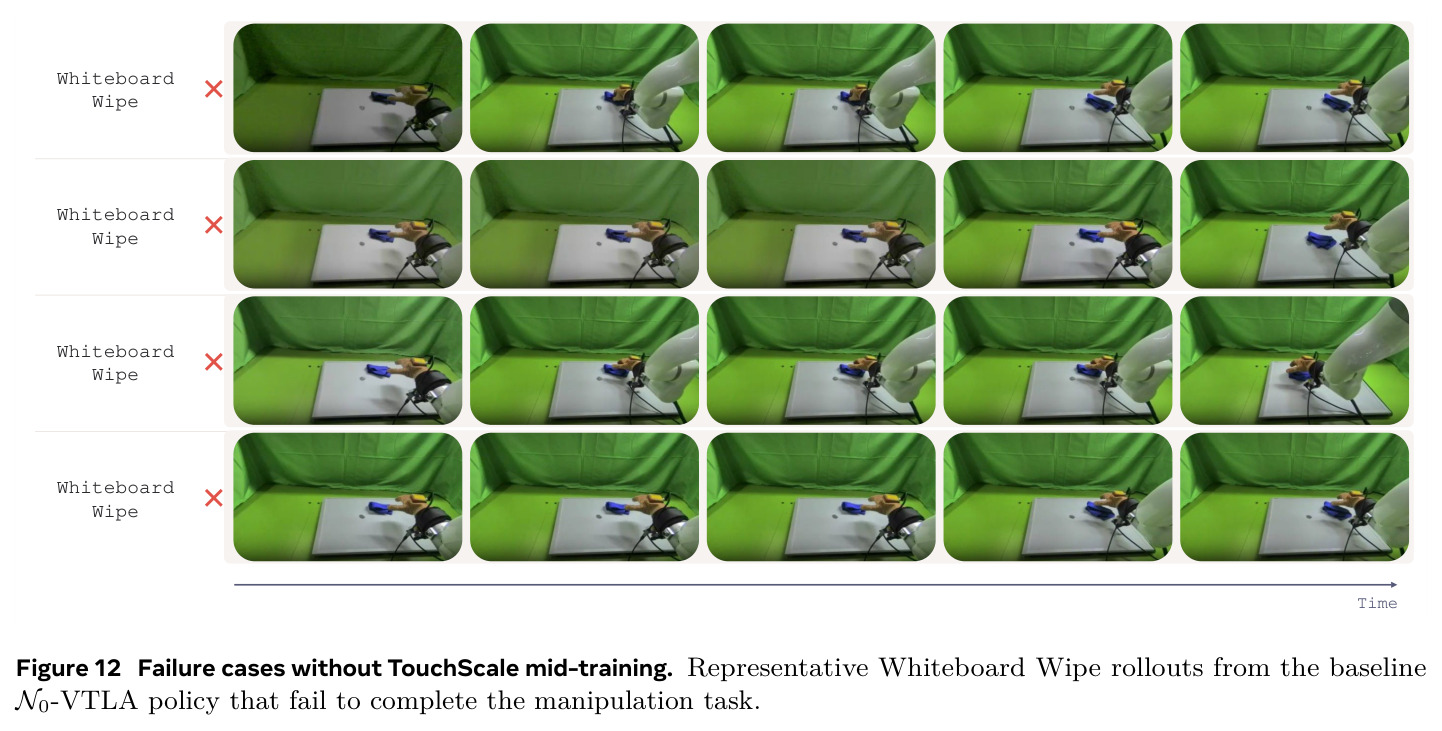
(1) 零样本触觉预测:同为 16 小时数据,TouchScale 在未见过的 EgoTactile 上 cIoU/vIoU 0.181/0.243,对 EgoTouch 0.134/0.185(+35.1%/+31.4%),CoP/幅值误差 0.416/0.148 对 0.444/0.184;数据 10%→100% 时 cIoU 0.311→0.383。(2) 表征迁移:预训练 Hiera-B,MECCANO/SSv2/Ego-Exo4D 上线性探测平均 24.45%、微调 49.62%,领先 OpenTouch 22.97/48.28、EgoTouch 8.99/21.75、FEEL 7.85/13.29。(3) 机器人操作:加中间训练后平均成功率 22.5→57.5%,分拣 10→60、拧瓶盖 40→70、试管 30→60、擦白板 10→40;数据 20→100% 时成功率 30.0→57.5%。(4) 未来触觉预测:无中间训练 Top-10 仅 0.18%,有训练升至 2.87–3.31%;预测与动作误差弱相关($r=0.119$、$p=0.020$,基线 0.003)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 零样本触觉预测(16h 等量数据,直接迁移到未见过的 EgoTactile 传感器) | cIoU(12 解剖区域平均) | 0.181(TouchScale 16h 子集) | 0.134(EgoTouch 16.2h 训练切分) | 相对提升 35.1% |
| 零样本触觉预测(16h 等量数据,迁移到 EgoTactile) | vIoU | 0.243 | 0.185(EgoTouch) | 相对提升 31.4%;CoP 误差 0.416 vs 0.444,幅值误差 0.148 vs 0.184 |
| 零样本触觉预测(TouchScale 数据 10%→100% 缩放) | cIoU | 0.383(全量 500h) | 0.311(10% 数据) | +0.072,且 vIoU/CoP/幅值误差同步改善 |
| 动作识别(MECCANO/SSv2/Ego-Exo4D 平均,Hiera-B 预训练) | 线性探测准确率 | 24.45% | 22.97%(OpenTouch);EgoTouch 8.99%;FEEL 7.85% | +1.48pp(对最强基线),对 EgoTouch 提升超过 15pp |
| 动作识别(同上三基准平均) | 端到端微调准确率 | 49.62% | 48.28%(OpenTouch) | +1.34pp |
| 真实机器人接触密集操作(软硬分拣/拧瓶盖/移液管转移/擦白板,4 任务平均,各 20 次试验) | 任务成功率 | 57.5%(TouchScale 中间训练) | 22.5%(无中间训练,同检查点同后训练数据) | +35 个百分点 |
| 未来触觉预测(机器人未见数据上的检索式评测) | Top-10 准确率 | 3.31%(全量中间训练,20% 数据时 2.87%) | 0.18%(无中间训练,近似随机) | 约 18 倍,但绝对值仍低 |
局限与改进
作者承认的局限:机器人评测只覆盖单一平台(xArm6 + BrainCo Revo 2 夹爪)与四个任务、每任务仅 20 次试验;数据集不含动作标签,无法直接用于模仿学习;未来触觉预测误差与动作预测误差只有弱相关($r=0.119$),未来触觉预测在机器人控制中的作用仍是开放问题。我的补充观察:(1) 未来触觉 Top-10 准确率即使用全量数据也只有 3.31%,虽远超 0.18% 的随机水平但绝对值很低,且 20%→100% 数据只带来 2.87%→3.31% 的微弱增益,说明缩放故事在触觉世界模型一侧并不扎实,57.5% 的成功率提升与该表征质量之间的因果链尚不清晰;(2) 零样本 cIoU 0.383 的绝对值仍偏低,跨传感器迁移远未解决;(3) 压力按每序列最大值归一化,丢失了绝对力度信息,跨人跨会话的触觉标定问题被绕开;(4) 场景分布偏实验室(128.6h)、厨房(92.9h)、工作台(92.9h)等结构化环境,家庭长尾场景覆盖有限;(5) 数据由商业供应商采集,成本与协议难以被学术实验室复制。
独立分析的弱点
(1) 缩放证据不完整:机器人成功率在 40%–80% 处出现平台(32.5%→50.0%→50.0%),并非严格单调,且只扫到 500 小时,无法回答再扩 10 倍是否仍有效——应推向更大数据量或在更大参数量 VLA 上重复扫描。(2) 免动作设计是双刃剑:避开了重定向,但也放弃了人类数据中最有价值的手部轨迹信息,机器人侧仍需每任务 50 条人工遥操作演示——可探索免动作预训练加少量动作桥接,如用 WiLoR 手姿估计构造 latent 动作监督。(3) 未来触觉表征偏弱:Top-10 仅 3.31%,检索池只有 8,539 个样本,5 个 latent token 的世界模型容量可能不足——可增加 token 数、以物体重建模型或深度图作几何条件。(4) 质检依赖 Gemini 3.7 Flash 视觉盲判,小指与手掌因视角不可靠被排除在缺失判定外,存在漏检空间——可用触觉自一致性或专用接触检测模型补充。(5) 压力按每序列最大值归一化抹掉绝对力度,学到的可能是相对压力模式而非物理量——应引入跨序列全局标定。(6) 每任务仅 20 次试验且未报告置信区间,统计强度有限。
未来方向
作者提出的方向:把评测扩展到更多机器人本体与更多接触密集任务;为数据集补充动作标签以支持人到机器人的完整迁移;厘清未来触觉预测在机器人控制中的真正作用。基于本文成果可延伸的研究:(1) 视触觉基础模型——用 TouchScale 预训练大规模触觉编码器或触觉世界模型,再在 EgoTouch、EgoTactile 等异构数据上以解剖区域映射做对齐,追求跨硬件通用的触觉表征;(2) 视觉到触觉的生成模型——利用 880 taxel 压力图与 RGB-D 配对,训练给定视觉预测完整压力场的生成模型,为仿真与遥操作合成接触监督;(3) 数据自动扩产流水线——把统一硬件加 VLM 质检的范式产品化,持续采集并把任务描述扩展到家庭长尾场景;(4) 结合附带的 3D 物体重建模型,学习接触感知的物体检索、抓取先验与可抓性分析;(5) 视触觉 scaling law 的定量刻画——把数据从 500 小时推向 5000 小时,在感知(cIoU)与控制(成功率)两条曲线上拟合幂律并寻找饱和点,检验人类视触觉数据是否复现视觉领域的规模定律。
复现评估
复现友好度中等偏上。数据侧:作者明确承诺公开全部同步视触觉记录与重建的 3D 物体模型,加分明显;但完整重采需要商用 Tachin 触觉手套、Orbbec Gemini 345Lg、双 RealSense D405 以及约 20 名受试者,成本高、协议依赖供应商。训练侧:论文给出关键细节——冻结 3.71B 主干、只训 123.8M 参数、InfoNCE 温度 0.07、$\lambda_{rec}=0.5$、$H=50$、AdamW batch 64、学习率 500 步热身到 1e-4 再 20K 步衰减到 1e-5——并基于官方公开的 N0-VTLA 检查点与开源 WiLoR 手姿估计;解剖区域映射与四个触觉指标在附录 A 以公式完整定义,可独立实现。障碍在于:质检使用 Gemini 3.7 Flash API(可换其他 VLM 但需重调阈值),机器人实验需要 xArm6 加 BrainCo Revo 2 加 VR 遥操作台(复现感知部分可绕开);论文未报告 GPU 配置,但只训 123.8M 参数、约 20K 步,单机多卡可承受。建议先复现触觉预测与动作识别,机器人部分门槛最高。
论文图表
对比 EgoTouch 与 TouchScale 训练的模型在零样本迁移到 EgoTactile 以及各自源数据集未见切分上的表现:零样本设置下 TouchScale cIoU 0.181 对 0.134、vIoU 0.243 对 0.185、CoP 0.416 对 0.444、幅值误差 0.148 对 0.184;未见切分上 cIoU 0.422 对 0.403、幅值误差 0.061 对 0.095。
触觉预测实验的主表,量化了“同架构同数据量下统一管线数据更好”这一核心主张,四个指标全部一致的结论说服力强。