λ₀:用开放世界自我中心人类数据扩展人形全身移动操作 λ_0: Scaling Open-World Egocentric Human Data for Humanoid Loco-Manipulation
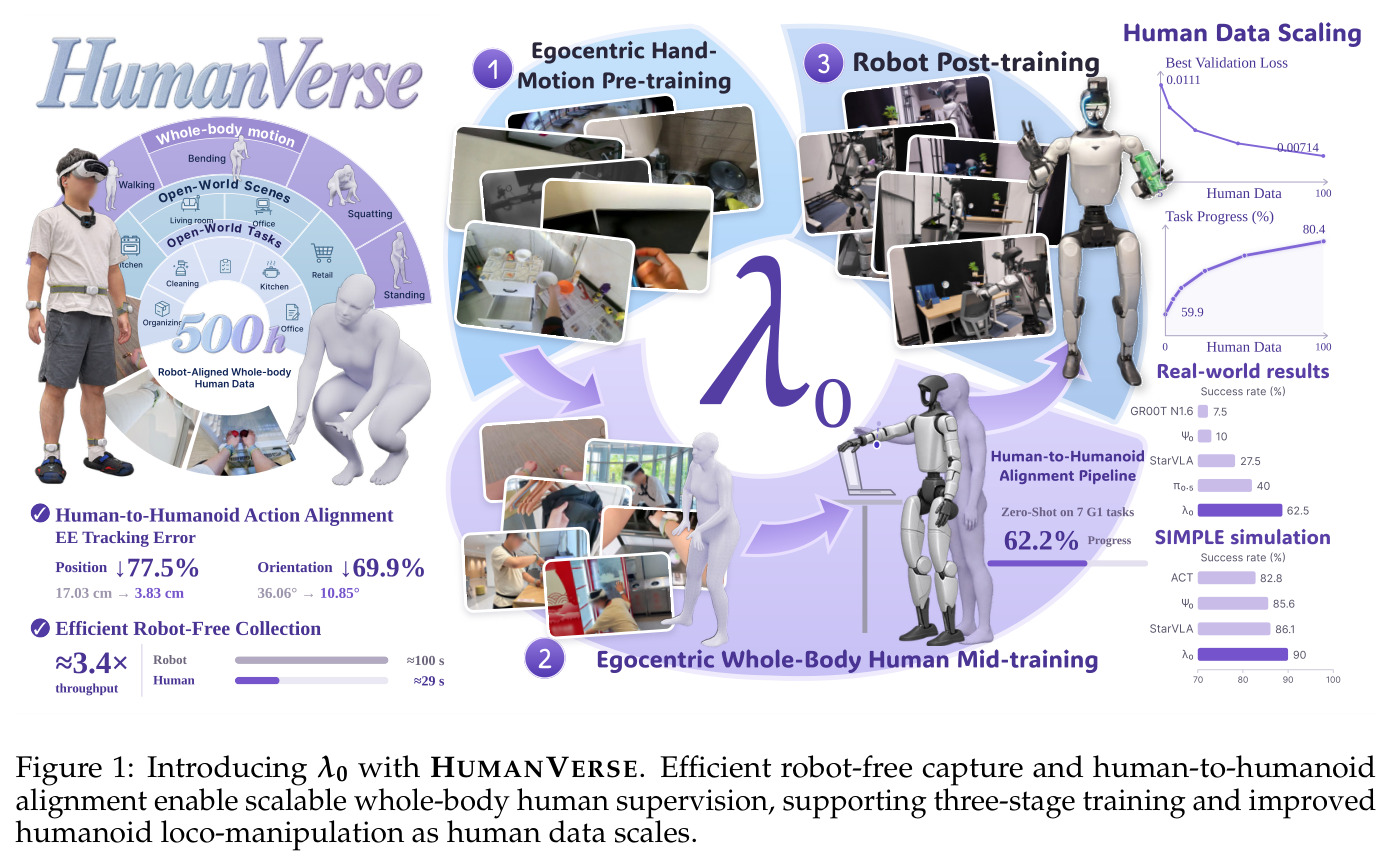
500小时自我中心人类全身数据加人-机对齐管线,三阶段训练λ₀使移动操作随数据规模单调提升
前置知识
VLA(视觉-语言-动作模型)
将视觉编码器、语言模型与动作生成头组合成一体的机器人策略网络:图像 token 与语言指令送入 VLM 主干,动作专家在主干逐层特征条件下生成控制输出。本文 λ₀ 用 Qwen3.5-2B 作主干、π₀.5 式生成式动作专家,一次预测 50 步动作块,并借鉴 X-VLA 用域标识符、独立输入输出投影和 32 个软提示 token 支持跨域(人类数据/机器人数据)切换。
λ₀ 的三阶段训练、人类数据如何接入同一策略、部署时如何切回机器人域,全部建立在 VLA 架构之上,不懂 VLA 就无法理解本文的训练设计。
Flow Matching(流匹配)与速度场损失
一类生成式动作解码方法:对真实动作块 $a$ 采样噪声步 $s\sim U(0,1)$ 和 $\epsilon\sim\mathcal{N}(0,I)$,构造加噪动作 $x_s=(1-s)\epsilon+sa$,训练网络预测目标速度 $a-\epsilon$;推理时从高斯噪声出发用少量欧拉积分步还原动作。π₀.5 用带掩码的版本:只对有效标量目标计损失,动作前缀保持无噪并被排除。
λ₀ 第二、三阶段的训练目标(论文式 (4) 的掩码速度场损失 $\mathcal{L}_q$)直接沿用该范式,是读懂训练公式的钥匙。
SMPL 与 MANO 人体参数化模型
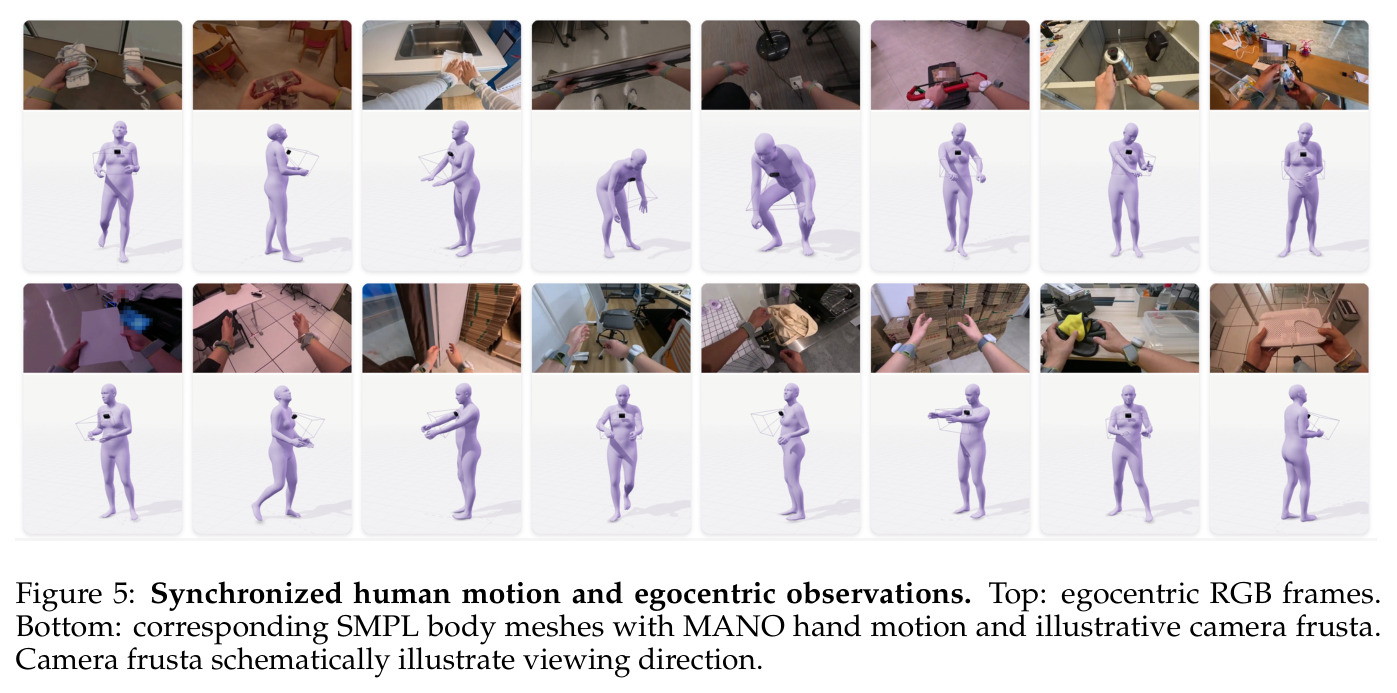
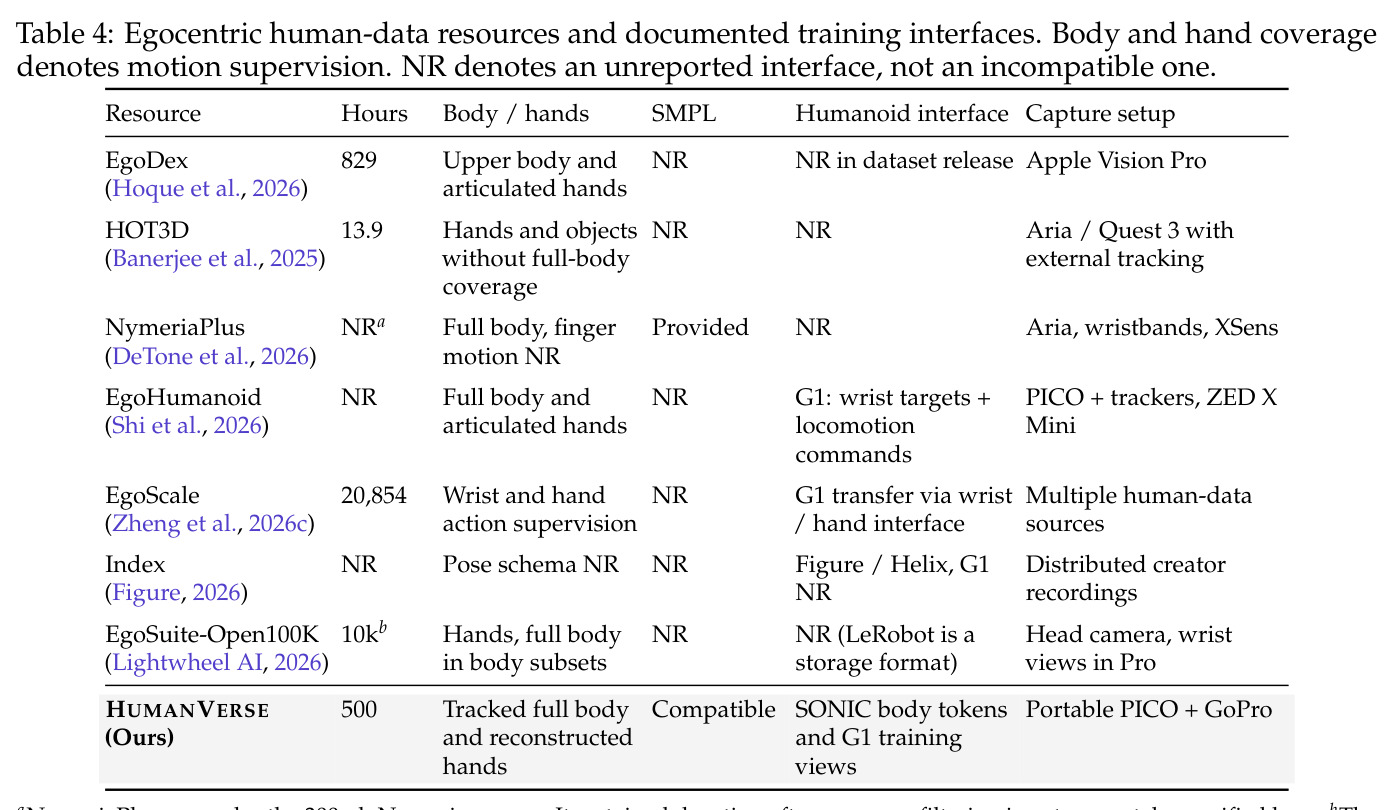
SMPL 是统计人体网格模型,给定姿态与形状参数即可生成可微的全身网格;MANO 是对应的参数化手部模型。本文用它表示从可穿戴设备和自我中心视频重建出的人类运动:PICO 提供 24 关节身体运动学,Dyn-HaMR 借助 ViPE 相机运动从视频重建每只手 21 个关节,统一表达为 SMPL 身体网格加 MANO 手。
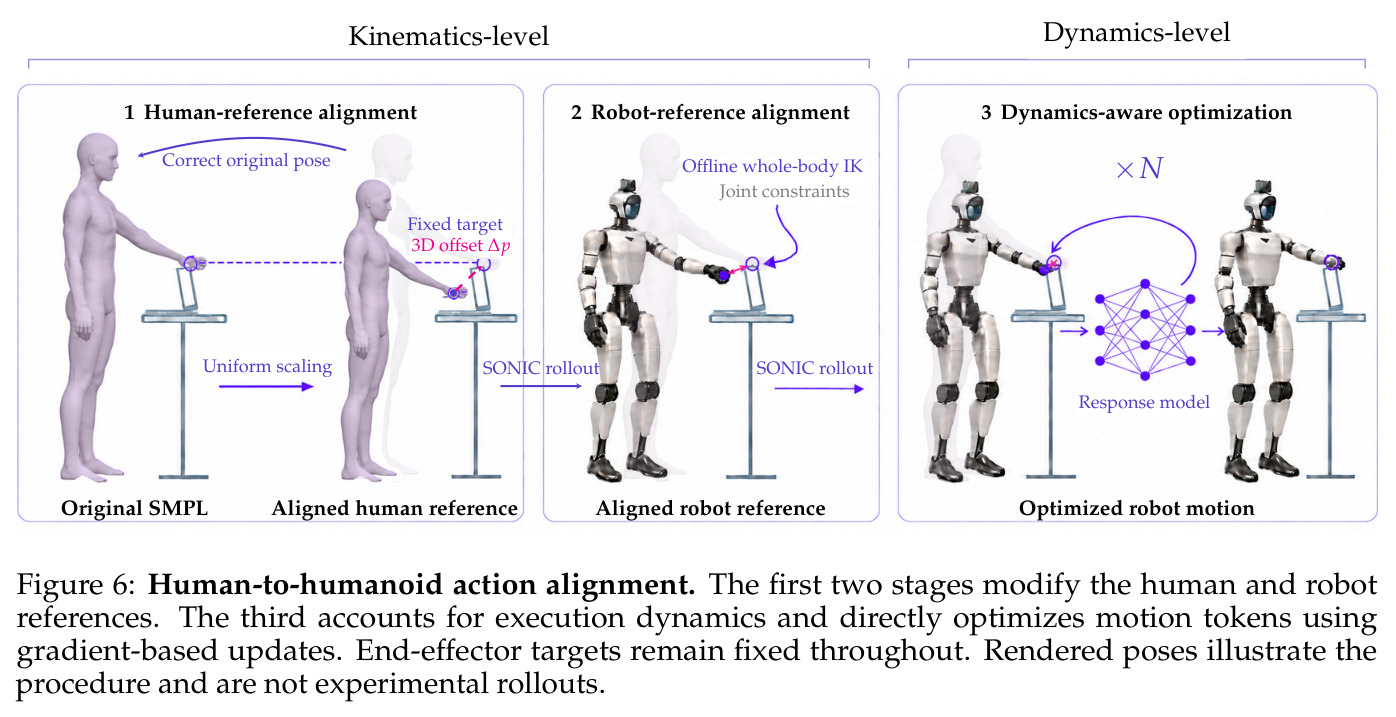
人到机器人的动作对齐以 SMPL 姿态为中间表示(缩放到 G1 高度再调整),是理解动作对齐管线的第一步。
运动重定向与全身跟踪控制器
重定向把人体关节轨迹映射到形态不同的机器人骨架上(本文用 GMR 类方法),跟踪控制器再把参考轨迹转成满足动力学约束的机器人指令(本文用 SONIC 驱动 Unitree G1 全身控制)。两级都会引入误差:几何失配污染参考轨迹,控制器跟踪引入执行误差,表现为末端执行器位置/朝向偏差。
论文的核心痛点正是这串链条造成的 17.03 cm / 36.06° 末端误差,三阶段动作对齐就是针对这两级误差源逐级设计的。
动作分块与实时分块(RTC)
动作分块指一次预测未来多步动作(本文 50 步、每步 76 维)以降低推理延迟、提高时序一致性;RTC(Real-Time Chunking)允许新观测到来时保留已执行的前缀若干步、只补预测剩余部分。训练时一半样本无前缀,其余最多保留 8 步有效前缀,前缀保持无噪并从损失中排除。
λ₀ 的动作接口(64 维 SONIC 运动潜码加 2×6 维 Revo2 手指令)与部署方式都以分块为前提,评估协议也按 50 Hz 绝对动作对齐。
研究动机
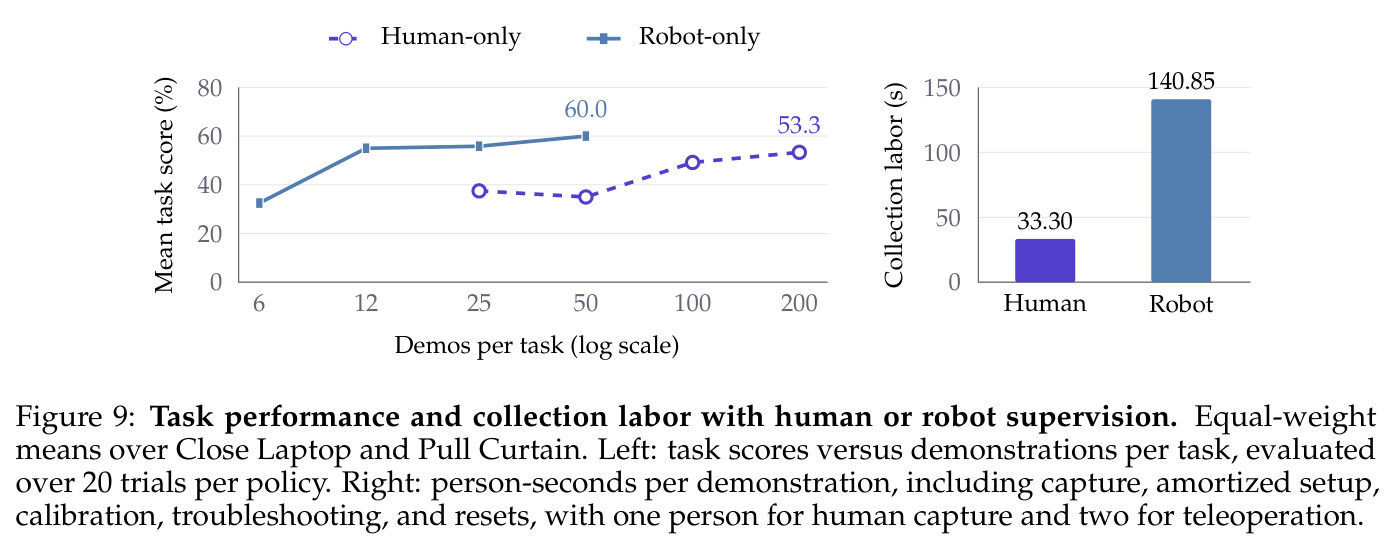
人形机器人的移动操作(loco-manipulation)要求行走、姿态与手部操作协同,但规模化获取机器人演示极其昂贵:全身遥操作要求操作者真实驱动一台人形机器人完成每条演示,硬件占用加反复复位使任务与环境覆盖难以扩展。论文给出具体数字:遥操作采集一条演示平均耗费 140.85 人·秒(需两人协作),长距离搬运动作的现场录制加复位约 130 秒/条,硬件可得性直接卡住数据规模。另一条路是自我中心(egocentric)人类视频,成本低且天然覆盖开放世界,但现有方法大多只恢复手腕/手部轨迹(如 EgoDex、Ψ₀ 用的 EgoDex 只有腕/指尖监督),丢掉了支撑全身交互的下肢移动与姿态变化;即便录了同步的全身动作,人体与 G1 的几何失配加控制器跟踪误差仍会让末端执行器偏差高达 17.03 cm 位置误差与 36.06° 朝向误差——这个量级足以让抓取和接触彻底失败。于是核心问题变成:自我中心的全身人类经验,能否既可迁移到人形机器人、又能规模化获取?
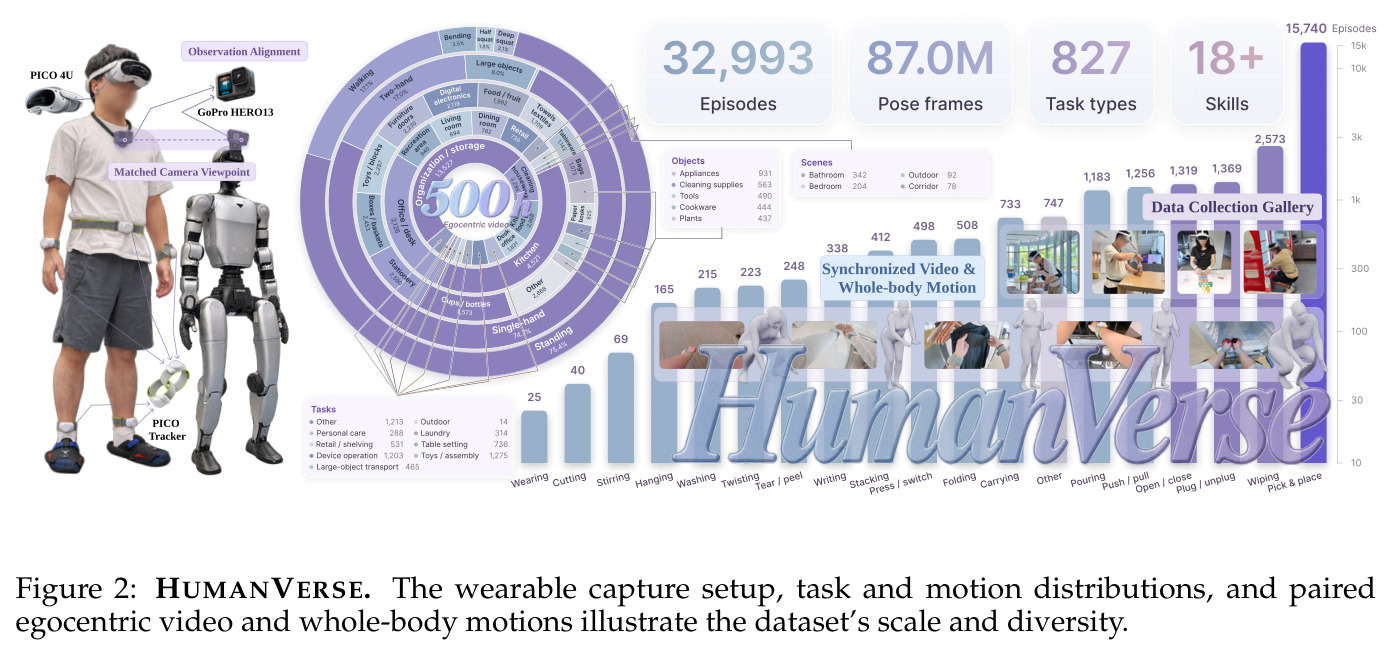
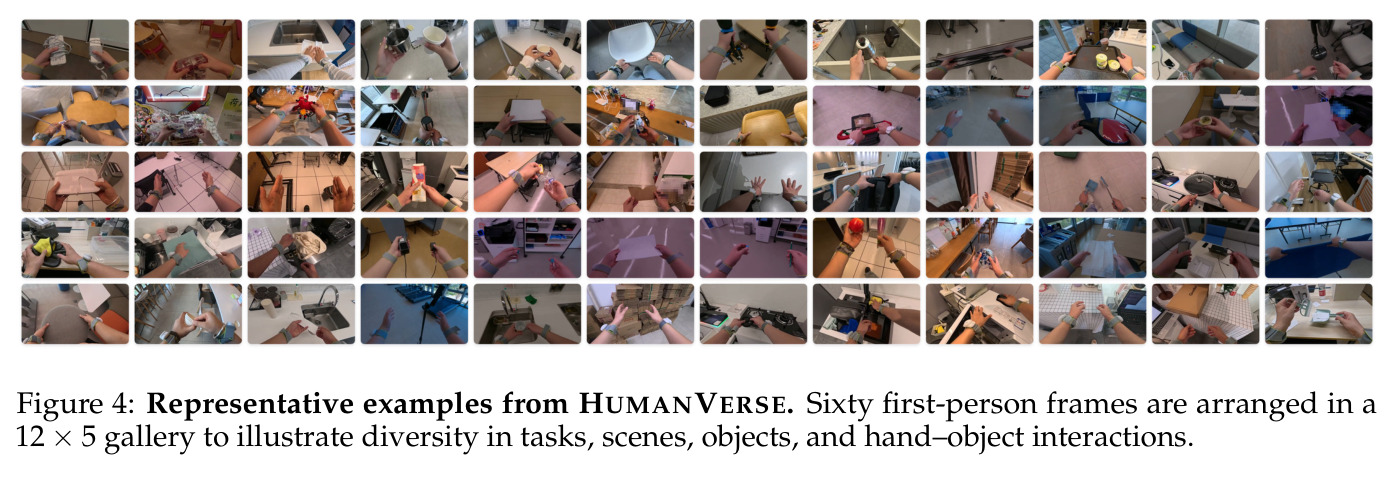
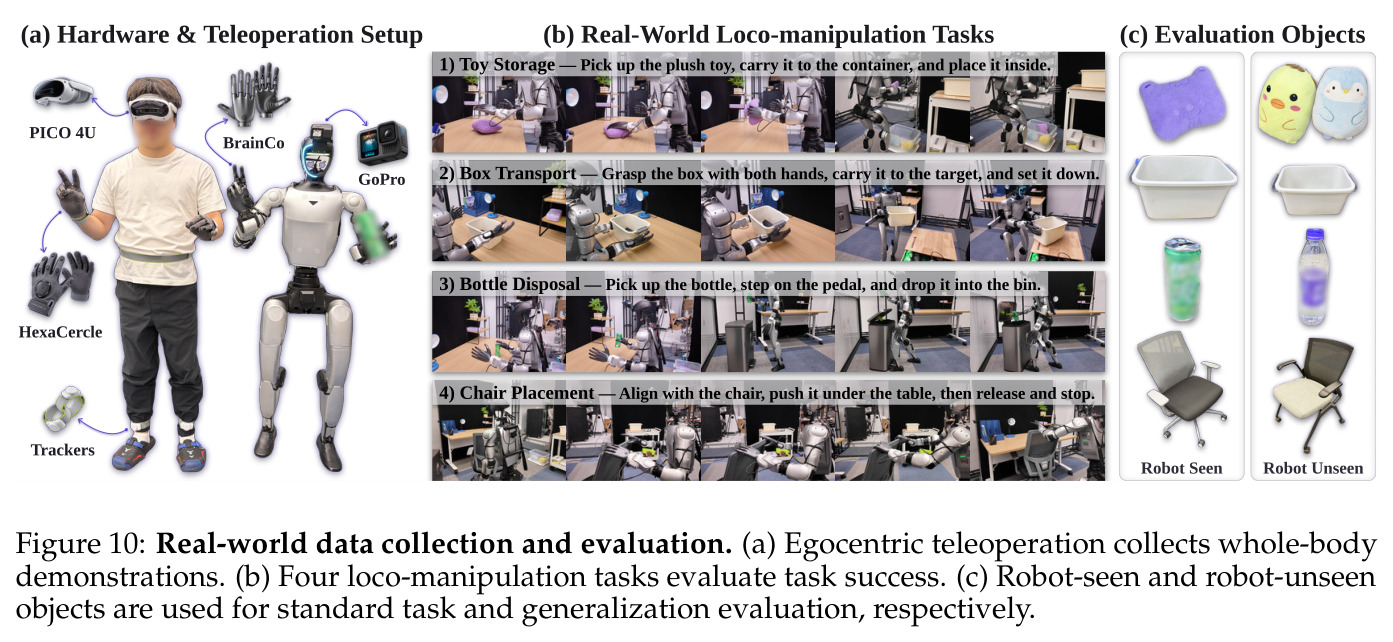
本文的目标是本文的目标分三层递进。第一,设计一套完全不需要机器人在场的人类数据采集方案:GoPro HERO13 头戴相机(安装高度与 G1 头部相机对齐)加 PICO 4 Ultra 头显与体感追踪器,在家庭、零售、办公、户外等真实场景按活动级提示自由采集,建成 500 小时、32,993 段、8700 万姿态帧、827 类任务的 HUMANVERSE 数据集。第二,建立人对人形(human-to-humanoid)对齐管线,从观察端(视角、手臂外观)与动作端(参考轨迹、控制器输入)两个方向系统性消除人类与机器人形态差异,把末端误差压缩到可用的程度。第三,在此之上构建 λ₀ 人形基础模型,用三阶段训练把自我中心人类经验渐进接入机器人控制,并通过受控实验验证关键假设:全身人类数据越多,下游真实世界移动操作越好。最终在 Unitree G1 上零样本迁移与真实任务上全面验证,不依赖目标任务的机器人演示。
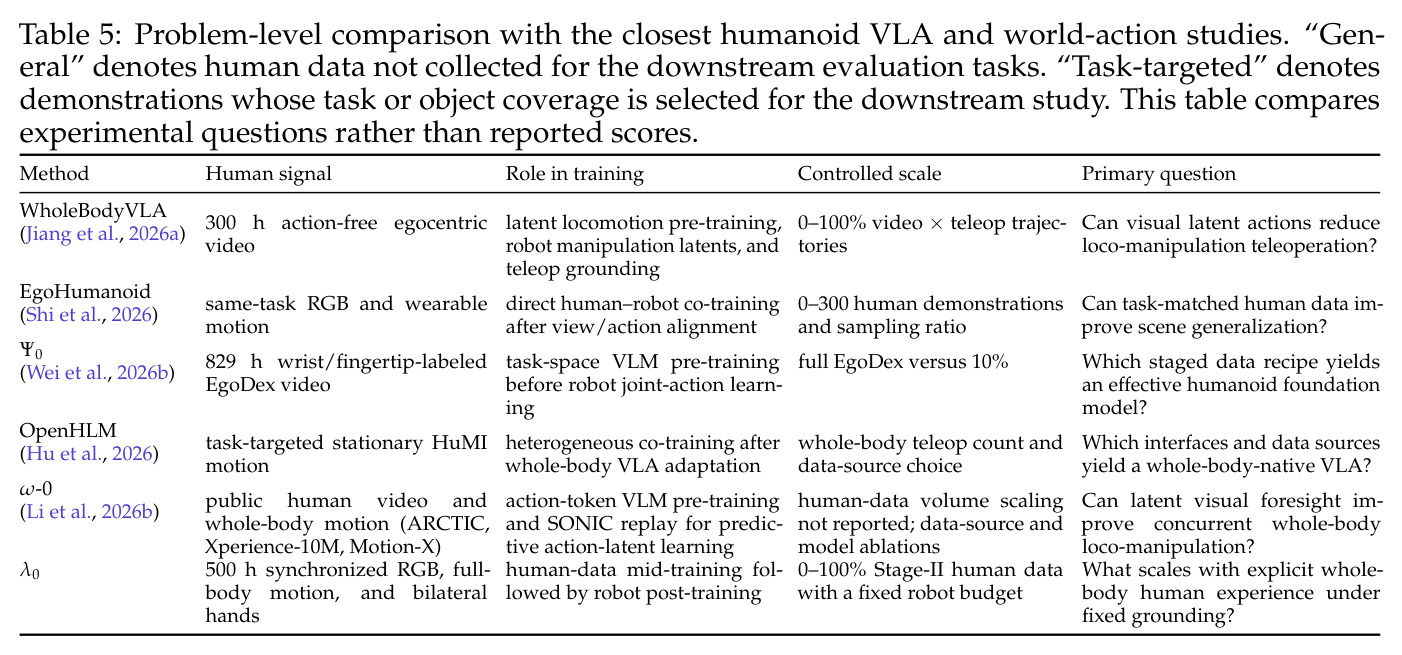
与已有工作不同的是,本文的切入角度有三个独特之处。其一,监督信号的完整性:不同于 EgoDex/Ψ₀ 只提供腕与指尖、WholeBodyVLA 用潜空间视频动作、ω-0 混用公开人体运动数据集,HUMANVERSE 直接配对自我中心视频与可穿戴设备记录的同步 24 关节全身运动加视频重建的 21 关节双手运动,明确瞄准双足人形的全身协调。其二,把离线动作修正当作一等公民:不是简单做一次重定向,而是依次修正人类参考(SMPL 缩放对齐)、机器人参考(约束全身 IK)、再深入到控制器输入层面(用响应模型引导的 motion token 梯度优化),把末端误差从 17.03 cm 压到 3.83 cm——这是文献中少见的把误差细分到运动学与动力学两级并分别治理的做法。其三,受控缩放实验设计:固定 Stage-I 初始化、模型容量、机器人演示与 Stage-III 更新预算,只动 Stage-II 人类数据量(0–100% 嵌套子集),同时在离线验证损失与真实世界任务进度两个轴上观测缩放效应;对比表 5 中 EgoHumanoid、Ψ₀、OpenHLM、ω-0 等近邻工作,这种在固定机器人预算下的全身人类数据缩放定量研究是缺失的。
核心方法
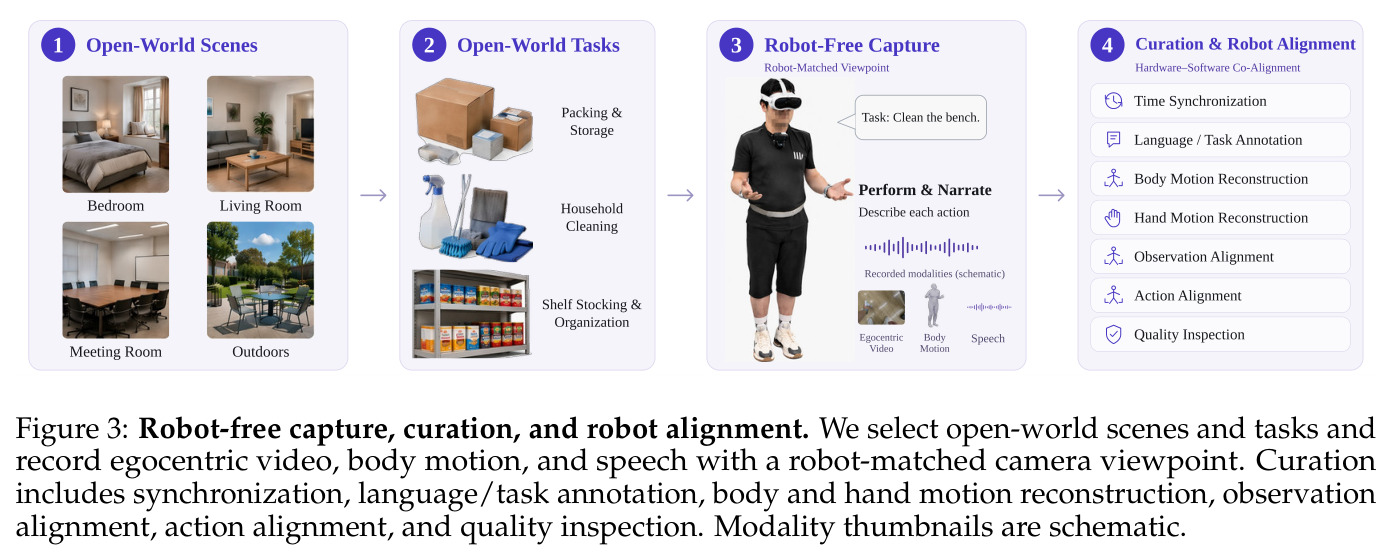
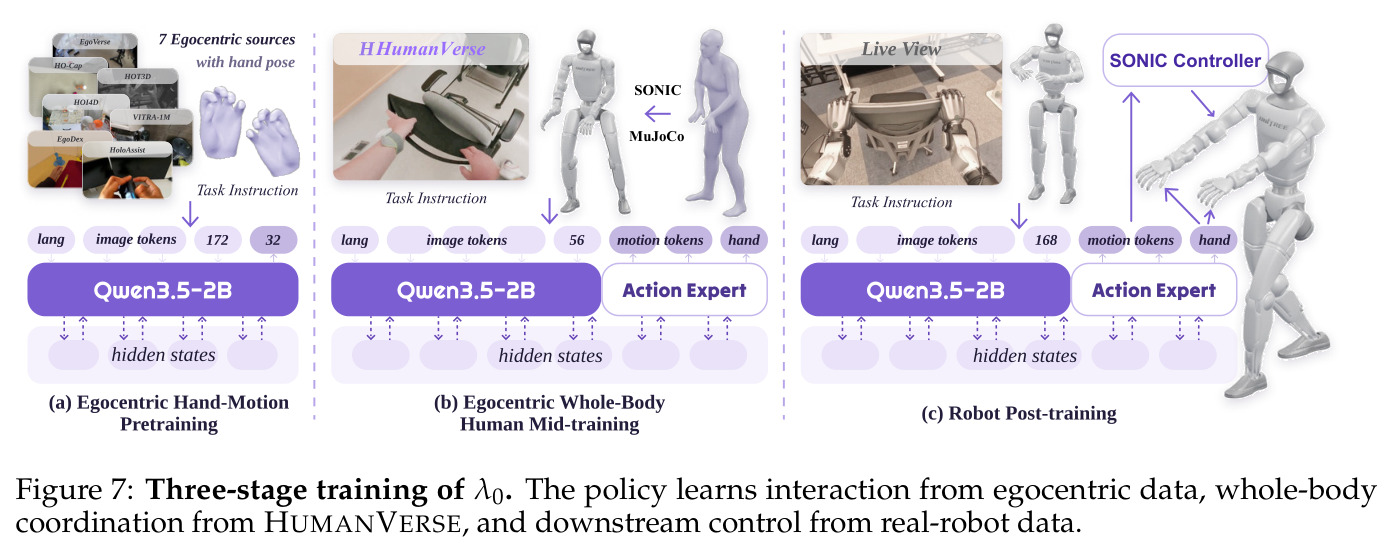
直觉上,人每天都在真实世界里搬东西、擦桌子、整理货架,这些经验若能让机器人看懂并照做,数据来源就不再受机器人数量限制。技术路线分三块。第一块是 HUMANVERSE 数据集:采集者佩戴头戴 GoPro HERO13(颈挂式,安装高度与 G1 头部相机一致)加 PICO 4 Ultra 头显与身体追踪器,在开放场景按活动级提示自由完成 827 类任务;GoPro 陀螺仪与追踪器角速度互相关做时间同步(约定 $t_{pico}=t_{gopro}+\Delta$),PICO 输出 24 关节身体运动,Dyn-HaMR+ViPE 从视频重建每只手 21 关节,最终得 500 小时、32,993 段、8700 万姿态帧。第二块是人对人形对齐管线:观察端用 SAM2 抠掉人类前臂与腕部追踪器、DiffuEraser 修复背景、再渲染 G1 手臂合成回去;动作端三级修正(人参考对齐→机器人参考对齐→动力学感知 token 优化)。第三块是 λ₀ 模型:Qwen3.5-2B 主干加生成式动作专家,先在 EgoDex、EgoVerse、HO-Cap、HOI4D、HoloAssist、HOT3D、VITRA-1M 七个自我中心数据集上做手部 token 预训练,再在 HUMANVERSE 全身数据上做中期训练(与机器人相同的 76 维动作接口),最后用少量机器人演示后训练,部署时输出 64 维 SONIC 运动 token 与 2×6 维 Revo2 手部指令。
核心创新是把人类演示系统性转化为机器人兼容的 state–action 监督,关键在双对齐。观察对齐让人类数据看起来像机器人数据:同型号相机、对齐安装高度、把人手臂换成渲染的 G1 手臂,训练与部署的视觉分布一致,策略部署时只看机器人图像。动作对齐针对两级误差源分别治理——几何失配影响参考轨迹、控制器跟踪引入执行误差——在运动学层先把 SMPL 副本缩放到 G1 高度并调整姿态使末端对齐固定目标,再用 G1 运动学模型做约束离线全身逆运动学修正机器人参考;在动力学层用 SONIC rollout 反馈加响应模型,对 motion token 做梯度更新,多轮迭代逼近末端目标。50 个任务(约 1 小时数据)验证显示位置误差 17.03→3.83 cm(降 77.5%)、朝向 36.06°→10.85°(降 69.9%)。与已有工作的本质区别:EgoHumanoid 等做视角对齐后共训练、EgoAlign 在线适配控制器参考,而本文是参考修正加控制器感知 token 优化的完整离线闭环,且修正后的数据不是直接模仿的对象,而是作为中期训练(mid-training)的桥接监督,衔接视频预训练与少量昂贵的机器人后训练。
方法步骤详情
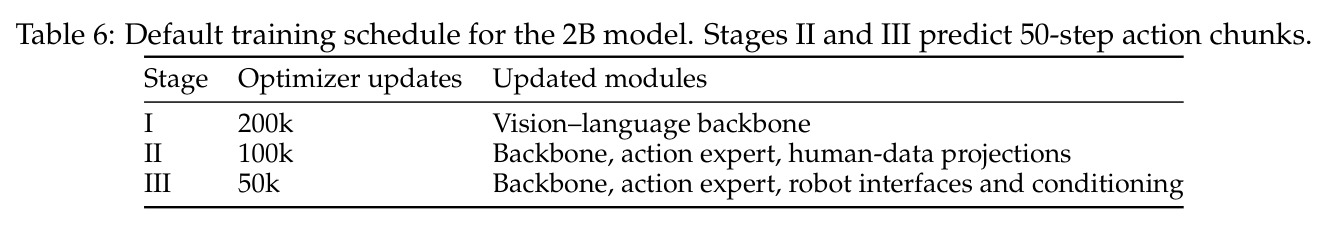
完整流程五步。第一步,开放世界采集:任务级提示(不规定关节轨迹),允许行走路径、初始姿态、物体实例、抓取策略与中间纠错的自由变化,保留走近、挪位、过渡的完整过程;同步录制语音叙述并转写为语言/任务标注。第二步,同步与重建:GoPro 与 PICO 独立时钟,用陀螺仪互相关估计偏移 $\Delta$ 后重采样到公共时间轴;PICO 给 24 关节身体运动学,Dyn-HaMR 借助 ViPE 估计每手 21 关节;手部轨迹同时存当前相机坐标系(用于重投影)与 episode 固定坐标系(保位移),手指几何存腕局部、掌对齐、尺度归一化坐标;身体与手部各留有效性掩码,缺失不插值。第三步,观察对齐:SAM2 分割前臂与 PICO 腕部追踪器→DiffuEraser 修复→按对齐后关节位置渲染 G1 手臂、拟合到人腕/前臂并合成。第四步,动作对齐三级:(1) 人参考对齐——SMPL 缩放到 G1 高度、调姿态对齐固定末端目标,SONIC rollout 得到更准运动;(2) 机器人参考对齐——约束离线全身 IK 修正参考,重编码并回放 token;(3) 动力学感知优化——rollout 反馈+响应模型引导梯度更新 motion token;数据生产时取三阶段最优结果,无改进则回退原始姿态 rollout。第五步,λ₀ 三阶段训练:Stage-I 按采样权重 $p_1(d)=\sqrt{N_d}/\sum_{d'}\sqrt{N_{d'}}$ 混合七个数据集,预测 138 维离散双手状态 token(每手 3D 腕位置+6D 旋转+20×3 局部关键点),200k 更新、批量 1024、学习率 $10^{-5}$;Stage-II 引入动作专家,用对齐后 HUMANVERSE 预测 50 步、每步 76 维(64 维 SONIC 潜码+2×6 维 Revo2 指令)动作块,状态 44 维(29 关节+每侧 6 手指令+3 维投影重力),100k 更新;Stage-III 用机器人数据后训练 50k 更新,损失为掩码速度场损失 $\mathcal{L}_q$,推理 10 步欧拉积分,EMA 衰减 0.999 逐级传递初始化。
技术新颖性
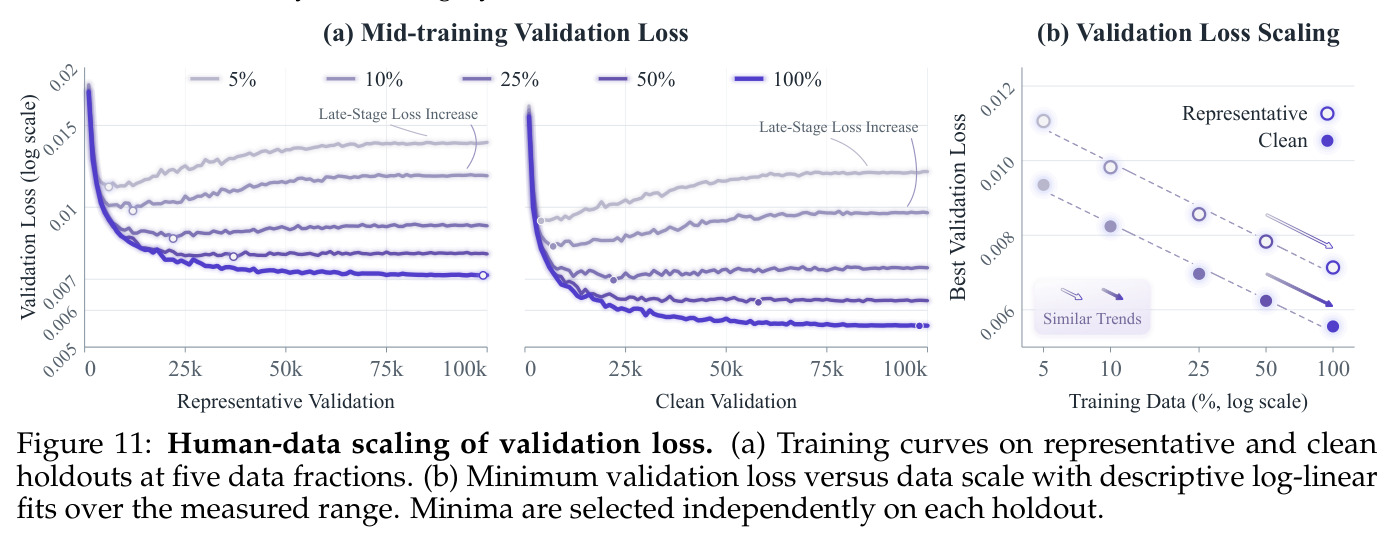
新颖性体现在四个层面。数据层:首个把同步全身动捕、自我中心视频与开放世界 827 类任务打包成 500 小时、并给出明确 G1 训练接口(SONIC 运动潜码)的数据集;表 4 显示对比之下的差距——EgoScale 有 20,854 小时但只有腕/手接口,NymeriaPlus 是全身运动但无机器人接口,EgoHumanoid 依赖外部 ZED X 相机而非机器人同款视角。对齐层:三级动作修正中的动力学感知 token 优化是新的——用响应模型近似控制器的输入输出响应,对离散 motion token 做梯度更新,而非传统的轨迹级重定向或在线适配(EgoAlign)。训练层:人类数据不直接充当部署策略的训练终点,而是作为 Stage-II 中间桥接,采用与机器人完全相同的 76 维 state–action 接口但配独立域标识符与输入输出投影(借鉴 X-VLA 的软提示机制),把视频预训练与少量机器人后训练平滑衔接。实验层:受控缩放协议严谨——按采集 session 划分防泄漏、嵌套 5–100% 子集、固定种子 43 与更新预算、双验证集(representative 按分布分层、clean 取标注有效性上四分位),给出对数线性拟合 $\hat{L}(D)=a+b\ln D$($R^2=0.9868/0.9901$,每翻倍降约 0.0009),并明确声明单种子与不外推的边界,这种诚实程度在机器人学习论文中少见。
实验结果
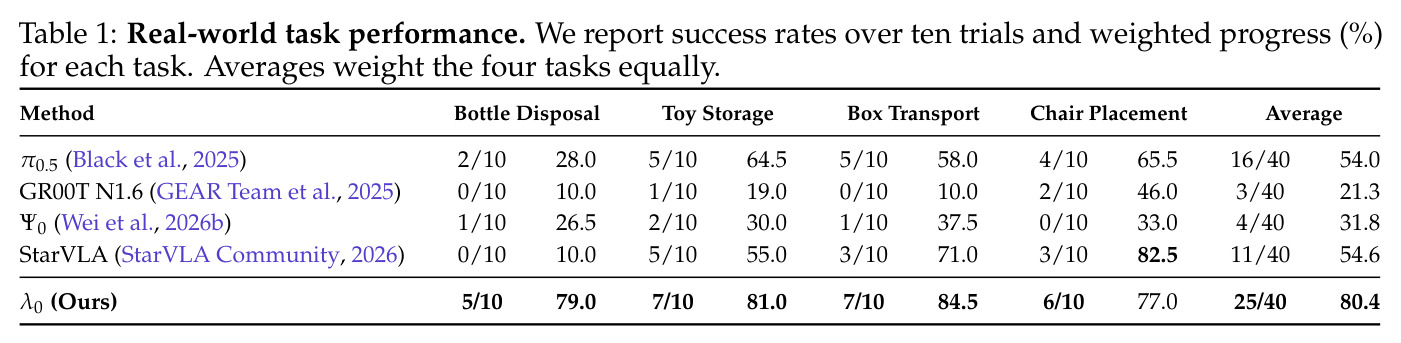
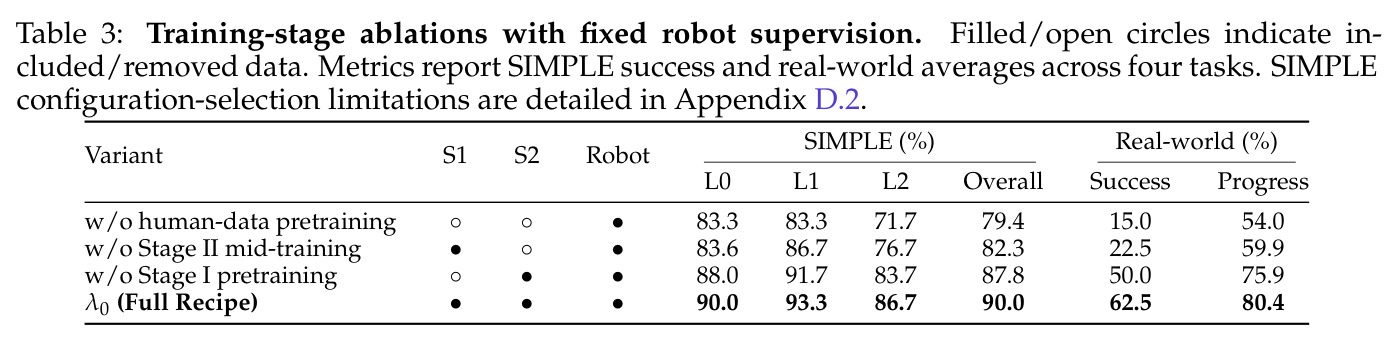
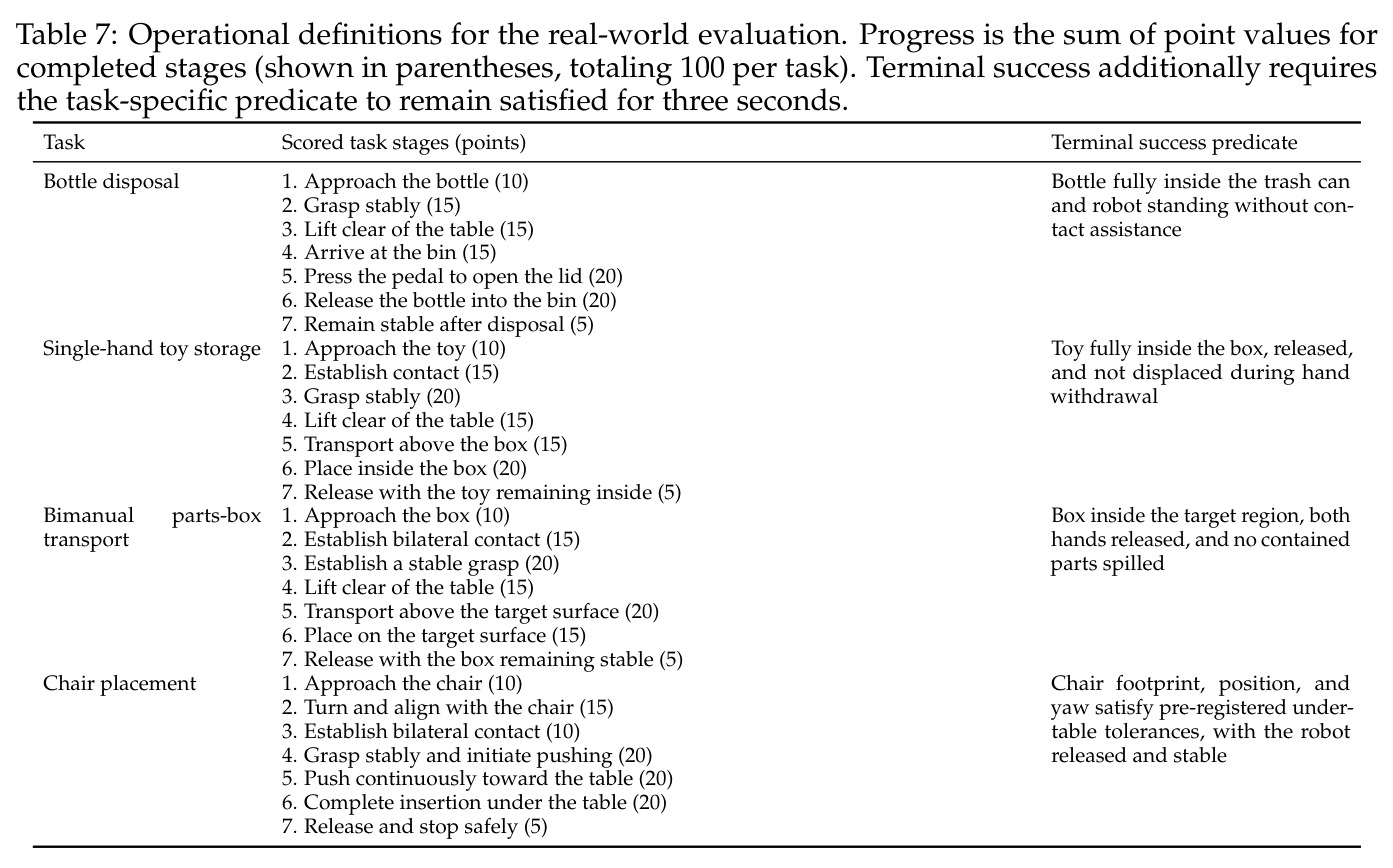
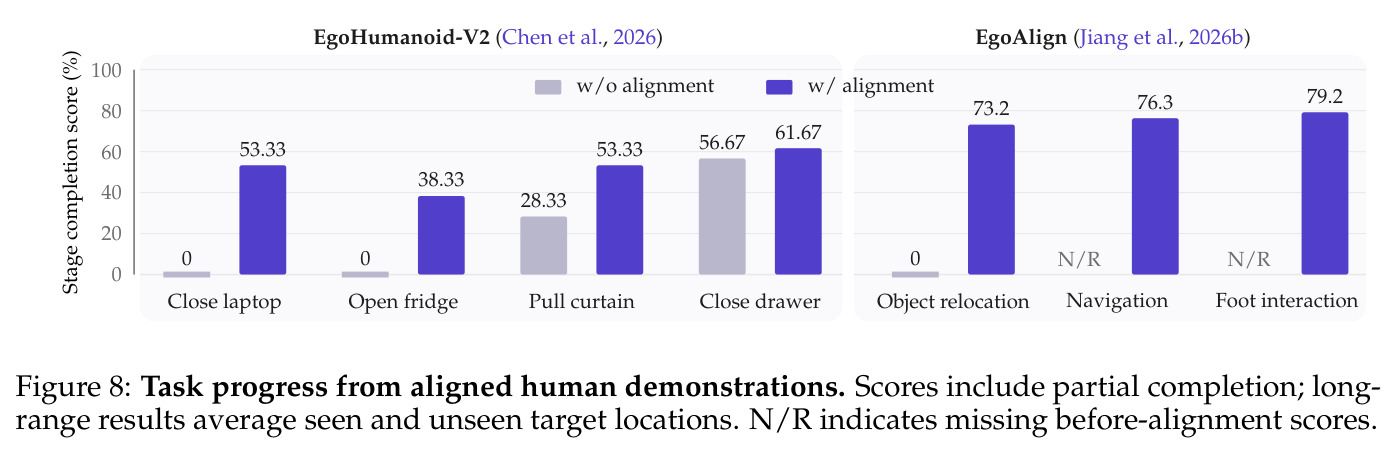
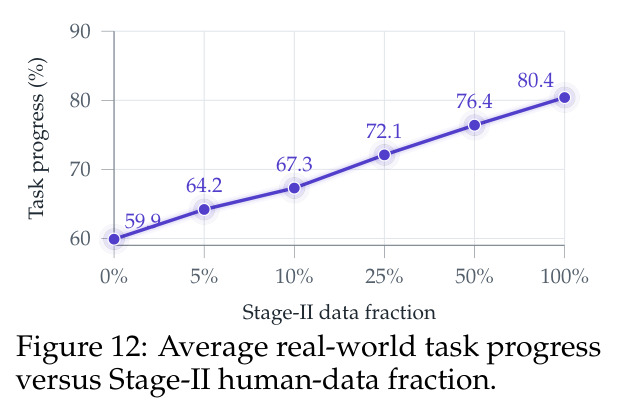
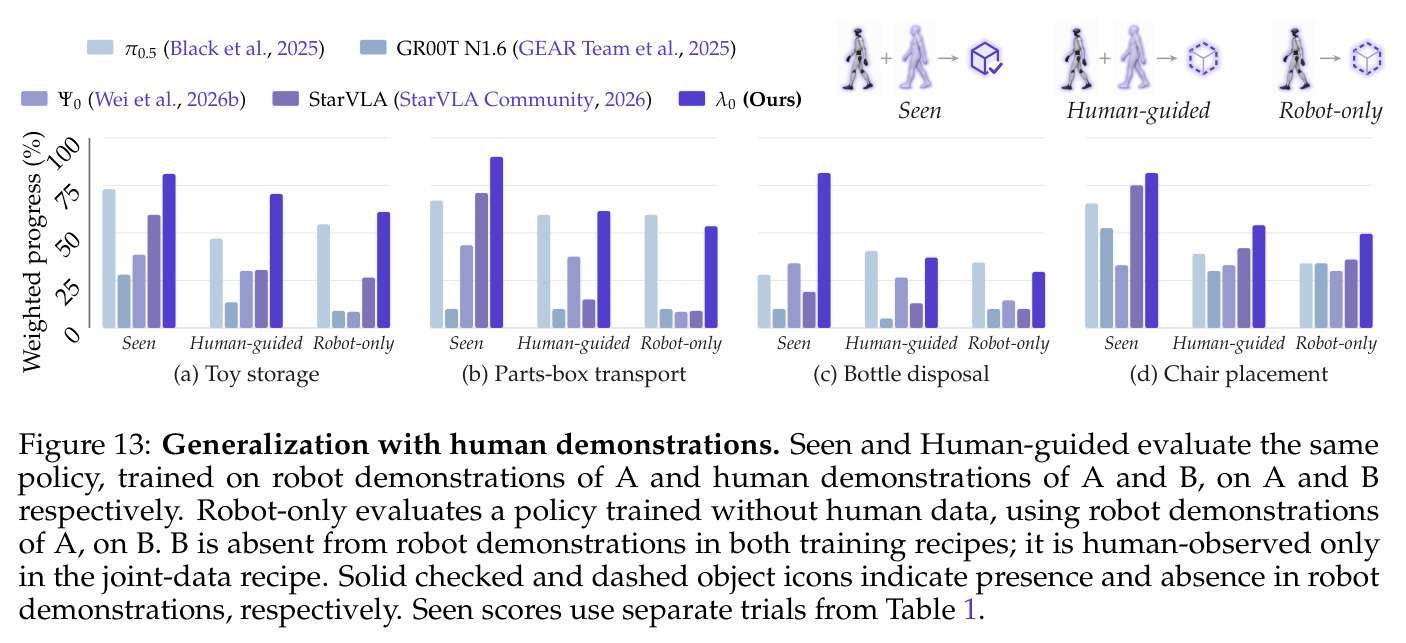
论文共五组实验。(1) 零样本迁移(无目标任务机器人演示):仅用任务特定人类演示训练的策略在 G1 七个任务上,全身操作类平均进度 51.7%、长距离移动操作类 76.2%(七任务等权 62.2%);图 8 与 EgoHumanoid-V2 的成对对比显示对齐带来增益(如关笔记本 53.33→56.67),EgoAlign 长距离任务完成度 61.67–79.2。(2) 采集效率(图 9):平均关笔记本与拉窗帘两任务,人类采集每条演示劳动 33.30 人·秒对遥操作 140.85 人·秒(省 76.4%,人均每小时多 4.23× 条),200 条人类演示训练达 53.3% 平均任务分,接近 50 条机器人演示的 60.0%;长距离任务录制+复位 25 秒对 130 秒,吞吐 5.2×;两个任务族等权汇总约 100/29 秒,即 3.4× 吞吐(作者注明这是近似估算)。(3) 真实世界(表 1):λ₀ 四任务 25/40 成功(62.5%)、加权进度 80.4%,分别超最强基线 22.5%(π₀.5 成功 16/40=40%)与 25.8%(StarVLA 进度 54.6%);四任务全部领先,瓶子处理进度增益最大(79.0,+51.0),唯椅子放置进度 77.0 低于 StarVLA 的 82.5 但成功数 6/10 对 3/10。(4) 仿真 SIMPLE(表 2):18 个任务-等级对总体 90.0%,超 StarVLA 86.1% 与 Ψ₀ 85.6%;逐级 90.0/93.3/86.7,BendPick 全等级满分、Handover L1/L2 满分,Mobile P&P 是短板(L1/L2 70% 对 StarVLA 80%);注意该汇总按任务选最优配置,作者声明不构成固定配置对比。(5) 缩放与消融(图 11/12、表 3):Stage-II 数据 0→100%,真实进度 59.9→80.4%(+20.5%)单调上升;验证损失从 5%到 100%降 35.5%(representative)/40.6%(clean);消融显示去 Stage-II 掉 40 个点成功(62.5→22.5)、去 Stage-I 只掉 12.5 点(62.5→50.0),全身中期训练贡献大于手部预训练。泛化实验(图 13):用 A 实例机器人演示加 A+B 人类演示训练,在机器人未见 B 实例上 λ₀ 平均进度 55.8%,比其 robot-only 变体(48.4%)高 7.4 点,也高于最强基线 π₀.5 的 46.5%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 仿真 SIMPLE(6 任务 × Level 0-2,共 18 个任务-等级对,每对 10 次) | 总体成功率 | 90.0% | StarVLA 86.1%,Ψ₀ 85.6% | +3.9%(对 StarVLA) |
| 真实世界移动操作(瓶子处理/玩具收纳/箱子搬运/椅子放置,各 10 试验) | 成功率 | 62.5%(25/40) | π₀.5 40.0%(16/40) | +22.5% |
| 真实世界移动操作(同上四任务) | 加权任务进度 | 80.4% | StarVLA 54.6%,π₀.5 54.0% | +25.8%(对最强基线) |
| 零样本全身操作(无目标任务机器人演示,4 任务) | 平均任务进度 | 51.7% | 对齐前后成对对比(EgoHumanoid-V2) | 对齐一致增益(如关笔记本 53.33→56.67) |
| 零样本长距离移动操作(3 任务,含未见目标位置) | 平均任务进度 | 76.2% | EgoAlign 各任务 61.67–79.2 | 同量级偏上 |
| Stage-II 人类数据缩放(0%→100%) | 真实世界平均任务进度 | 59.9%→80.4%(单调) | 无 Stage-II 中期训练 59.9% | +20.5% |
| 验证损失缩放(5%→100% 数据) | 最小验证损失降幅 / 对数线性拟合 | 降 35.5%(representative)/40.6%(clean),$\hat{L}(D)=a+b\ln D$,$R^2=0.987/0.990$ | 5% 数据点 | 每数据翻倍降约 0.0009 |
| 机器人未见物体实例泛化(4 任务共 600 试验) | 平均加权进度(Human-guided) | 55.8% | Robot-only 变体 48.4%;π₀.5 46.5% | +7.4%(对自身变体)/ +9.3%(对 π₀.5) |
| 数据采集效率(关笔记本+拉窗帘均值) | 每条演示劳动量(人·秒) | 33.30 | 全身遥操作 140.85 | −76.4%,吞吐 4.23× |
| 动作对齐质量(50 个任务,约 1 小时数据验证) | 末端执行器位置/朝向误差 | 3.83 cm / 10.85° | 17.03 cm / 36.06° | −77.5% / −69.9% |
局限与改进
作者承认的局限包括:SIMPLE 90.0% 的汇总采用逐任务选择最优记录配置,无统一检查点与推理设置,作者明确写明不应解读为固定配置对比(表 3 的 Full Recipe 行沿用同样口径);缩放实验每个数据比例只跑单种子(seed 43),无跨种子误差条,对数线性拟合只描述已测区间、不建立外推准确性;验证损失的后期回升(5%/10% 数据时最低点后回升 24.7%/19.0%)意味着最终 checkpoint 会混淆数据规模效应与过拟合,必须按最小值选点;500 小时是转换与有效性过滤前的录制时长;零样本与泛化实验中人类 B 演示的贡献无法与人类 A 演示及更早人类预训练分离。我的补充观察:身体流是可穿戴设备运动学而非光学动捕真值,手部靠 RGB 离线重建,快速运动与遮挡下质量受限;对齐管线深度绑定 SONIC 控制器,更换控制器需重新拟合响应模型;真实评估每任务仅 10 个固定初始配置、无置信区间与统计检验;椅子放置进度落后 StarVLA(77.0 对 82.5)说明接触丰富、需要持续推动的任务上人类参考仍有残余误差;Mobile P&P 落后 StarVLA 也提示移动取放这类对全身协调要求极高的任务尚未被人类数据完全覆盖。
独立分析的弱点
弱点一,动作对齐是离线且逐段的:响应模型拟合的是 SONIC 这一特定控制器的输入输出,一旦控制器升级或更换机器人本体,整套转换需重跑,且多轮 rollout 加梯度优化的算力开销随数据量线性增长。改进方向:学习跨控制器可迁移的通用动力学代理模型,或做在线自适应修正。弱点二,观察对齐依赖分割+修复+合成:SAM2 在遮挡、快速运动下掩码可能不干净,DiffuEraser 修复痕迹与渲染 G1 手臂和人腕的贴合误差都会成为视觉域差距,而这恰恰落在策略最需要关注的手部区域。改进:用学习式跨形态图像翻译,或训练域无关的手物交互表征绕开合成。弱点三,缩放结论只覆盖单一数量级且单种子:0–100% 内进度增益 20.5% 很有说服力,但没有误差条,10 倍数据后对数趋势是否延续未知。改进:至少 3 种子 × 5 规模,并加入数据源配比的第二轴。弱点四,评估统计强度不足:SIMPLE 按任务选最优配置、真实世界每任务 10 个固定初始配置,62.5% 对 40% 的差距虽大但缺少显著性检验。改进:预注册更多初始配置并报告 bootstrap 置信区间。弱点五,语言监督利用率低:标注来自语音转写的任务级描述,人类演示中天然的失败、停顿与自我纠正被当作普通监督。改进:检测纠错片段做失败感知条件化,或后验重标注为子指令,把人类数据独有的错误信号用起来。
未来方向
作者提出的方向:继续扩大 HUMANVERSE 并检验缩放曲线在更高数量级的行为;把对齐管线推广到更多人形形态与控制器;覆盖更丰富的全身技能(跑、蹲、大负载搬运)与更灵巧的手部操作。基于其成果可延伸的方向:其一,人类数据与机器人数据的联合缩放规律——本文只扫人类轴而固定机器人预算,两者的替代与互补关系值得系统建模,回答给多少钱该买哪种数据;其二,把语音叙述升级为密集子指令流,训练可中断、可纠正的分层策略,充分利用人类演示的时序结构;其三,响应模型可推广为控制器感知的世界模型,在 motion token 空间做规划与想象而不只是监督修正;其四,8700 万姿态帧可用于预训练视觉表征或手物交互动力学预测,服务非人形下游任务;其五,人类数据中失败与重试片段的利用——遥操作数据因成本高而剔错,人类数据便宜到可以保留错误,这是构建从失败中学习的策略的独特资源;其六,跨家庭/跨场所的部署泛化,检验开放世界采集对分布外环境的真实增益。
复现评估
复现条件总体较好但有硬门槛。开源情况:代码在 github.com/LambdaHumanoid/openlambda,主页 lambdahumanoid.github.io 有概览视频;论文附录异常详尽——B.1 给出状态-动作的精确维度定义(44 维状态、76 维动作、138 维手部 token),B.3 给出训练配置表(Stage-I 200k 更新/批量 1024/学习率 $10^{-5}$、Stage-II 100k、Stage-III 50k,EMA 衰减 0.999,缩放实验 seed 43、验证 seed 20260813),D.1 逐个给出四个基线的复现超参。数据:HUMANVERSE 的实际发布范围以代码仓库为准;Stage-I 的七个数据集全部公开可得。硬件门槛高:完整复现采集需要 GoPro HERO13、PICO 4 Ultra 加 5 个追踪器、HexaCercle M11 数据手套、Unitree G1(配 BrainCo Revo2 二指手)与多名采集者,重新采集 500 小时级数据不现实,但复现小规模验证(如 50 任务的对照实验)可行。算力:2B 模型三阶段共约 35 万次更新,加对齐管线的 rollout 计算,属于单机多卡可承受范围。难度评估:读懂方法并做微调实验为中等;完整复现采集+对齐+三阶段训练需要装备齐全的小团队数月,为高难度。
论文图表
仿真基准 6 任务 × Level 0-2 的成功率,共 18 个任务-等级对:λ₀ 总体 90.0%,逐级 90.0/93.3/86.7,超过 StarVLA(86.1)、Ψ₀(85.6)、ACT(82.8)等 10 个基线;BendPick 全等级 100、Handover L1/L2 100,Mobile P&P 最弱(L1/L2 70,低于 StarVLA 的 80)。
与公开排行榜接轨的仿真证据,展示方法在非全身任务上的通用性;作者同时声明该汇总按任务选最优配置、不构成固定配置对比,阅读时须带上这一保留。