FLOMSS:基于流匹配的生成式音乐源分离 FLOMSS: Generative Music Source Separation by Flow Matching
首个全带宽立体声流匹配音乐源分离框架,系统研究路径、预测目标与混合一致性
前置知识
音乐源分离(MSS)与四源设定
音乐源分离指从混音中恢复单轨信号。深度学习时代的主流做法是把一首歌拆成人声(Vocals)、贝斯(Bass)、鼓(Drums)、其他(Other)四个预定义声部,模型从混合波形或时频表示直接预测每个声部。MUSDB18-HQ 是标准数据集(100 首训练、50 首测试,44.1 kHz 立体声),SCNet、HTDemucs、Open-Unmix 等判别式模型用重建损失端到端训练,SDR 长期是主要指标。
本文的任务设定、数据集与全部对比基线都建立在这一标准范式上,理解四源划分与 MUSDB18-HQ 才能读懂实验设计。
流匹配与条件流匹配(CFM)
流匹配训练连续归一化流:学习速度场 $u_t$,把简单分布的样本沿指定概率路径输运到数据分布。由于边际目标速度不可解,条件流匹配(CFM)改为回归以样本对为条件的速度,其梯度与边际 FM 目标一致。OT-CFM 采用最优传输式线性插值路径,SB-CFM 采用端点固定、中途有方差的薛定谔桥式路径。
FLOMSS 的整个设计空间(概率路径、预测目标、单/多源建模、混合一致性)都围绕 CFM 展开,是读懂方法章节的前提。
v-prediction 与 x-prediction
同一条概率路径可有不同网络参数化:v-prediction 让网络回归速度场,损失 $\mathcal{L}_v=\mathbb{E}\|\mathrm{DNN}_\theta(x_t,t,\tilde{M})-u_t\|_2^2$;x-prediction 让网络直接估计目标样本,损失 $\mathcal{L}_x=\mathbb{E}\|\mathrm{DNN}_\theta(x_t,t,\tilde{M})-x_1\|_2^2$。二者理论上等价,但有限模型容量与有限数据下优化行为不同。
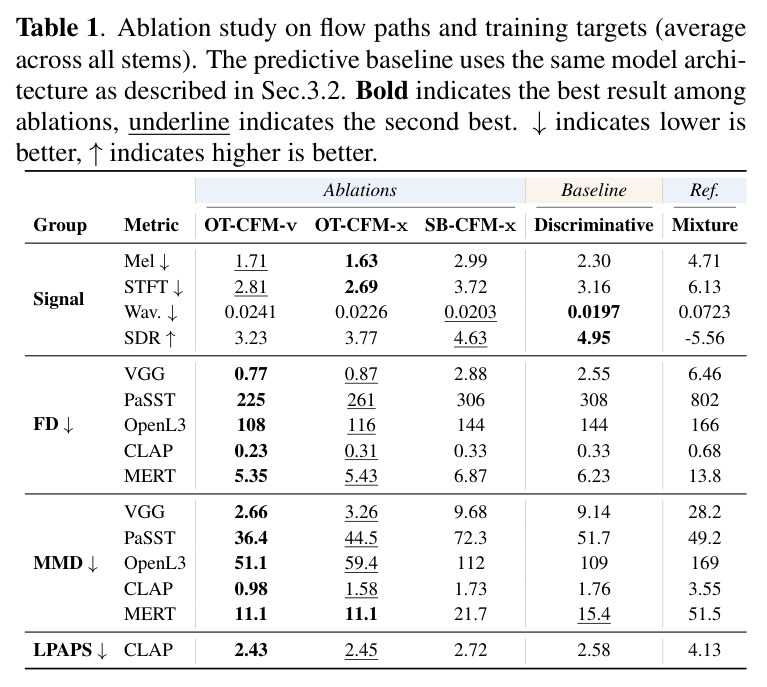
表 1 的核心消融之一就是预测目标,两者在信号指标与嵌入指标上呈现系统性差异,直接影响最终配置选择。
混合一致性(Mixture Consistency, MC)
直觉上,分离出的各声部求和应等于输入混合,即 $\sum_k \hat{x}_k = m$。软 MC 在训练损失中附加一个 MSE 惩罚项;硬 MC 则要求在整条概率路径的每个时刻 $t$,各源中间状态之和等于混合状态。约束可以施加在波形域,也可以施加在未压缩的复数 STFT 域。
多源建模消融(表 2)完全围绕软/硬 MC 展开,硬 MC 的失败是本文最有信息量的负结果之一。
嵌入式与分布性指标:SDR/FD/MMD/LPAPS
SDR 只衡量波形对齐误差,对感知质量不敏感。FD(Fréchet Distance)与 MMD 在预训练音频编码器(VGGish、PaSST、OpenL3、CLAP、MERT)的嵌入空间中比较生成集与真值集的分布距离;LPAPS 基于 CLAP 嵌入计算成对感知相似度。这类指标更贴近「听起来像不像原始声部」。
论文正是靠这套指标发现了「分布相似性—波形重建」权衡,这是全文最重要的概念性结论。
研究动机
音乐源分离长期由判别式方法主导:SCNet、HTDemucs、Open-Unmix 等在 MUSDB18-HQ 上用波形 $\ell_1$ 或幅度/复数 STFT 重建损失训练,平均 SDR 已达 5.19–9.69 dB。生成式路线则始终缺少针对全带宽立体声 MSS 的系统方案:InstGlow 在独立源先验与混合似然下优化潜变量;MSDM 学习联合源先验后做后验采样;MGE-LDM 把分离当作潜空间条件修复;SAM Audio 用流匹配以文本/视觉/时间提示做开放域音频分割。但这些工作要么只能输出低带宽单声道音频(MGE-LDM 16 kHz 单声道、InstGlow 22.05 kHz 单声道),要么面向开放域提示而非预定义四声部的全带宽立体声任务,难以用于高保真音乐制作。与此同时,社区评价几乎只看 SDR,无法刻画生成式输出在感知与分布层面的差异;流匹配虽已在语音增强、语音分离、语言查询音源分离中落地,却从未被系统研究并评测于全带宽立体声 MSS。
本文的目标是本文的目标是构建并系统研究首个面向全带宽(44.1 kHz)立体声、四声部(人声/贝斯/鼓/其他)设定的条件流匹配分离框架 FLOMSS,并承诺开源。具体分四步走:其一,在统一骨干(16M 与 67M 参数的 NCSN++ U-Net)上消融预测目标(v-prediction 与 x-prediction)和概率路径(OT-CFM 与 SB-CFM);其二,比较单源建模(每个声部独立模型)与多源联合建模(单模型输出四个声部),并研究软/硬两类混合一致性约束(硬约束分别施加在波形域与复数 STFT 域);其三,把评价从 SDR 扩展到 Mel/STFT/波形 L1、LPAPS,以及在 VGGish、PaSST、OpenL3、CLAP、MERT 五种编码器上的 FD 与 MMD,再用 23 人参与的 WebMUSHRA 主观测试收尾,为生成式 MSS 建立完整基准;其四,在 MUSDB18-HQ 上与 InstGlow、MGE-LDM、SAM Audio 等生成式基线以及 SCNet、HTDemucs 等判别式 SOTA 正面对比,检验流匹配路线的竞争力。
与已有工作不同的是,本文的独特切入在于把「生成式 MSS 该怎么设计」当成可系统消融的开放问题。以往生成式分离工作要么学习源先验、靠推理时的混合约束凑合(InstGlow、MSDM),要么把分离当作修复任务(MGE-LDM),都没有显式学习混合到源的生成映射,且止步于低带宽或单声道输出。FLOMSS 直接在压缩复数 STFT 域学习以混合为条件的输运过程,把分离变成一次 10 步 ODE 求解。第二个缺口是评价体系:MSS 社区长期只用 SDR,而音频生成社区已发展出 FD/MMD/LPAPS 等分布与感知指标,本文首次把两套指标并置评测 MSS,并借此发现判别式与生成式方法之间存在「分布相似性—波形重建」的权衡——嵌入指标更优的同时 SDR 更低。此外,论文首次在流匹配概率路径内部尝试硬混合一致性(波形域与 STFT 域两种实现),给出了对后续研究很有价值的负结果:非线性压缩破坏源可加性,硬约束全面退化。
核心方法
FLOMSS 把分离看作「沿学到的速度场从带噪混合走向干净声部」的生成过程,在压缩复数 STFT 域实现:对复数谱施加幂律压缩 $X=\beta|X|^{\alpha}e^{j\angle X}$($\alpha=0.5$、$\beta=0.15$)。以混合 $\tilde{M}$ 为条件定义高斯概率路径 $p_t(x|x_1,\tilde{M})=\mathcal{N}(x;\mu_t,\sigma_t^2 I)$,均值线性插值 $\mu_t=(1-t)\tilde{M}+t x_1$,$x_1=\tilde{X}_k$ 为目标声部压缩谱。骨干沿用 SGMSE 配置的 NCSN++ U-Net(16M/67M),输入拼接 $x_t$ 与 $\tilde{M}$;判别式基线用同一骨干直接回归 $\hat{X}_k$。推理积 10 步 Midpoint ODE 或指数积分器,再逆压缩、逆 STFT 还原波形。训练在 MUSDB18-HQ 官方划分上进行:随机裁剪 97,920 采样点、在线重混增强,93,600 步、Adam、学习率 $10^{-4}$、批量 32、4 张 A100。
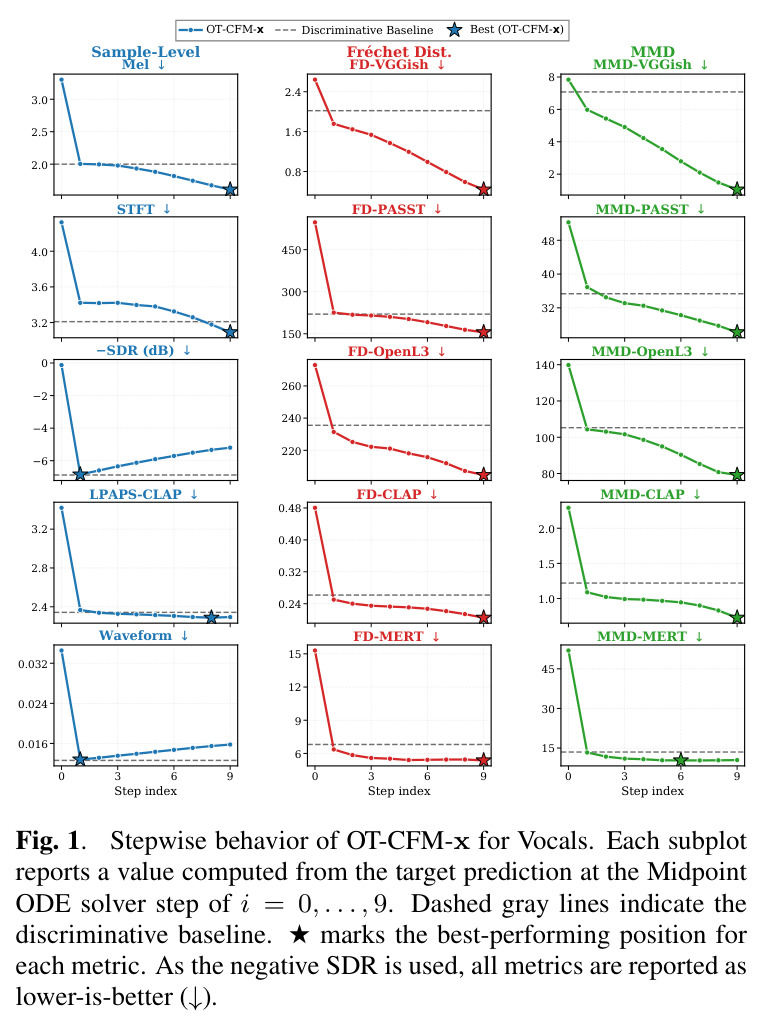
核心创新是首次把 CFM 用于全带宽立体声 MSS 并系统回答「该怎么配」:对 OT/SB 路径、v/x 预测目标、单源/多源建模、软/硬混合一致性逐一消融。结论一:OT-CFM-x 最均衡——x-prediction 信号指标优于 v-prediction(Mel 1.63 对 1.71、SDR 3.77 对 3.23),后者嵌入更好(FD-VGGish 0.77 对 0.87)但 SDR 偏低;SB-CFM 波形距离最好(0.0203),但 FD-VGGish 恶化到 2.88。结论二:存在「分布相似性—重建保真」权衡——图 1 显示早期 ODE 步预测接近判别式基线,后段步数才把 Mel 与嵌入指标推向更优、同时牺牲 SDR。结论三:软混合一致性 $\mathcal{L}_{\text{SoftMC}}=\mathcal{L}_x+0.1\mathcal{L}_{\text{MSE}}$ 能找回大部分 SDR(3.07→3.69),硬约束则因幂律压缩破坏可加性而退化(SDR 仅 2.11/2.34),说明硬 MC 需要 MSS 专属流路径设计。
方法步骤详情
流程五步。第一步域变换:混合与各声部做 Hann 窗复数 STFT,幂律压缩得 $\tilde{M}$、$\tilde{X}_k$。第二步路径与训练:从 $\mathcal{N}(\tilde{M},\sigma_0^2 I)$ 采样起点,沿均值 $\mu_t=(1-t)\tilde{M}+t\tilde{X}_k$ 采样中间态 $x_t$;OT-CFM/SB-CFM 分别取 $\sigma_{\max}=0.5$、$\sigma_\rho=1$;输入拼接 $(x_t,\tilde{M})$,最小化 $\mathcal{L}_v$ 或 $\mathcal{L}_x$。第三步数据增强:随机裁剪 97,920 采样点,在线重混:同曲同时段抽 2–4 声部重混成新混合。第四步多源与约束:多源版输出通道扩成四声部联合状态;软 MC 加 0.1 权重 MSE,硬 MC 在波形/未压缩 STFT 域强制 $\sum_k x_t^{(k)}=m$。第五步推理后处理:积 10 步 Midpoint ODE(SB 用指数积分器)后逆压缩、逆 STFT,分段重叠 10%、三角形交叉淡化拼接。
技术新颖性
技术新颖性体现在四个层面。第一,任务层面:这是首个面向全带宽立体声四声部 MSS 的流匹配框架——此前的 FlowSep 面向语言查询音源分离,SAM Audio 面向开放域提示,InstGlow、MSDM、MGE-LDM 均无法输出全带宽立体声。第二,设计空间的系统化:论文不是只报一个最终配置,而是把路径(OT/SB)、预测参数化(v/x)、单/多源建模、软/硬混合一致性逐一消融,给出可迁移的设计准则(OT-CFM-x 最均衡)。第三,评价层面:首次把 FD/MMD(五种音频编码器)、LPAPS、Mel/STFT/波形 L1 与 SDR 组成生成式 MSS 综合基准,并提出「分布相似性—重建保真」权衡这一概念性发现,嵌入指标最优的配置往往 SDR 更差。第四,约束层面:硬混合一致性此前主要出现在单声道语音分离中,本文首次在全带宽立体声 MSS 中检验其波形域与 STFT 域两种实现,指出幂律压缩的非线性破坏源可加性、需要专门设计路径,是坦诚且有信息量的负结果。此外,承诺开源的框架与完整指标集合本身也是社区贡献。
实验结果
一(表 1,MUSDB18-HQ):判别式基线 SDR 最好(4.95 dB)但 Mel 2.30 差;OT-CFM-x 将 Mel 降至 1.63;SB-CFM-x SDR 4.63 最高却 FD-VGGish 恶化到 2.88;OT-CFM-v 嵌入最好而 SDR 仅 3.23,故选 OT-CFM-x。二(图 1):ODE 逐步预测先像判别式基线,后段 Mel/FD/MMD 改善而 SDR 下降,呈现分布—重建权衡。三(表 2):多源单模型 FD-VGGish 0.87→2.30;软 MC 找回 SDR(3.69)但嵌入未恢复;硬 MC 两域 SDR 仅 2.11/2.34。四(表 3):FLOMSS-S 全面超过 InstGlow;对比同骨干判别式,Mel 2.30→1.63、FD-VGGish 2.55→0.87、仅 SDR 3.77;FLOMSS-M 达 Mel 1.55,除 SDR 外超过 Open-Unmix。五(表 4):23 人 WebMUSHRA 中 FLOMSS-M 59.12 分第 2(SCNet 62.59 第 1),超 HTDemucs 58.71。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
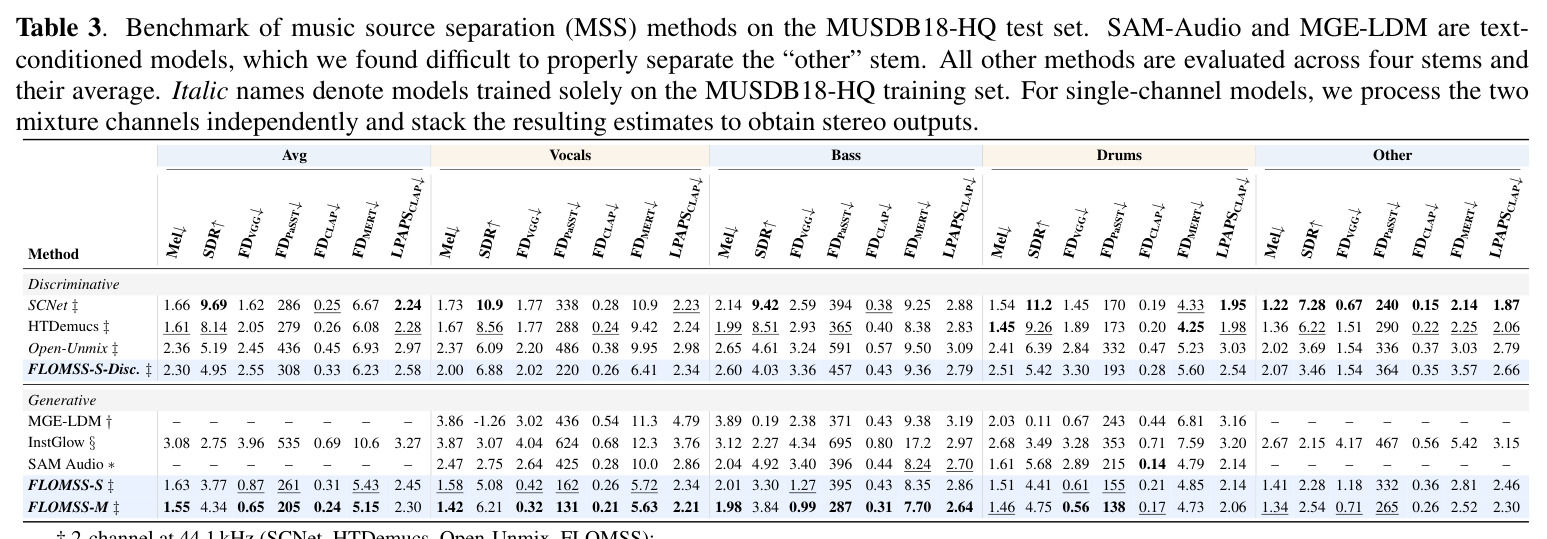
| 四源分离(MUSDB18-HQ 测试集,四声部平均) | SDR(MDX23 实现,dB) | FLOMSS-M 4.34 dB | 判别式 SCNet 9.69 dB / HTDemucs 8.14 dB;生成式 InstGlow 2.75 dB | 较最优生成式基线 InstGlow 高 1.59 dB,但仍落后判别式 SOTA 3.8–5.35 dB |
| 四源分离(四声部平均) | Mel L1 距离(越低越好) | FLOMSS-M 1.55 | SCNet 1.66 / HTDemucs 1.61 / InstGlow 3.08 | 在所有判别式与生成式方法中最优 |
| 四源分离(四声部平均) | FD-VGGish(Fréchet Distance,越低越好) | FLOMSS-M 0.65 | SCNet 1.62 / HTDemucs 2.05 / 同骨干判别式基线 2.55 | 约为最强判别式方法的 40%,相对降幅约 60% |
| 四源分离(四声部平均) | FD-PaSST / FD-CLAP / LPAPS-CLAP | FLOMSS-M 205 / 0.24 / 2.30 | HTDemucs 279 / 0.26 / 2.28;InstGlow 535 / 0.69 / 3.27 | FD 类指标全面领先;LPAPS 与 HTDemucs 基本持平(略差 0.02) |
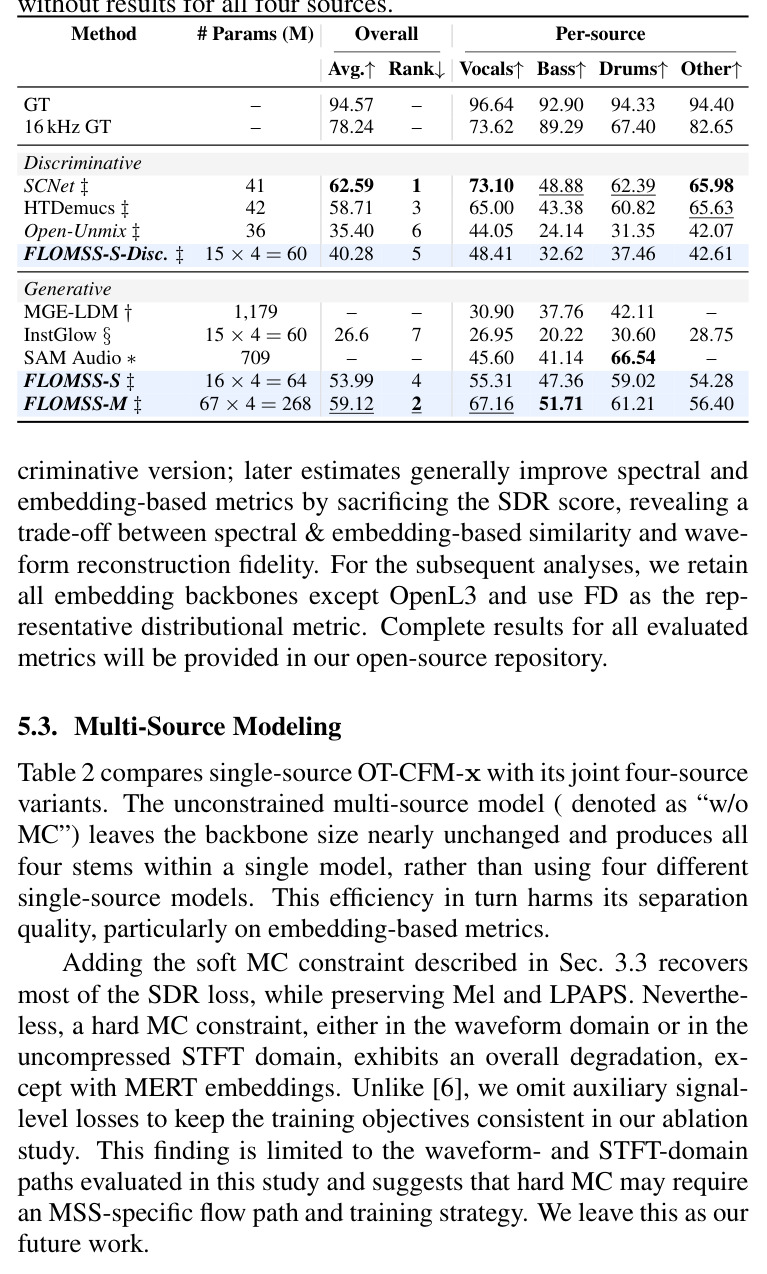
| 主观音质(WebMUSHRA,23 名被试,0–100 分) | MUSHRA 总分 | FLOMSS-M 59.12(系统排名第 2) | GT 94.57;SCNet 62.59(第 1)/ HTDemucs 58.71(第 3)/ InstGlow 26.6(第 7) | 超过 HTDemucs,为最佳生成式方法;贝斯单项第 1(61.21) |
| 同骨干生成式 vs 判别式(16M,四声部平均) | Mel / FD-VGGish / SDR | FLOMSS-S 1.63 / 0.87 / 3.77 dB | FLOMSS-S-Disc.(同骨干判别式)2.30 / 2.55 / 4.95 dB | 生成式版本 Mel 降 29%、FD-VGGish 降 66%,SDR 低 1.18 dB,体现权衡 |
局限与改进
作者承认且值得注意的局限:其一,SDR 差距显著,FLOMSS-M 平均 4.34 dB,远低于 SCNet 9.69 dB 与 HTDemucs 8.14 dB,作者把提升 SDR 列为未来工作;其二,多源单模型与硬混合一致性都是负结果——软 MC 只救回 SDR(3.69)而嵌入指标未恢复(FD-VGGish 2.87),硬 MC 在波形与 STFT 两域均整体退化,说明压缩域路径与硬约束不兼容;其三,对比存在混杂因素:SAM Audio 与 MGE-LDM 用不同数据训练,HTDemucs 额外用了 800 首歌,InstGlow 用 MUSDB18 加 Slakh2100 的吉他/钢琴声部,且各方法采样率与声道数不一(16/22.05/48 kHz 单声道对 FLOMSS 的 44.1 kHz 双声道),作者也提醒需谨慎解读;主观测试仅 10 段 8 秒片段、23 名被试。我自己的观察:单源推理需跑 4 个模型、各 10 步 ODE,实时性存疑;训练数据仅 100 首歌,对编曲复杂曲目泛化未知;SDR 对生成式方法可能有系统性偏置,对相位与时间对齐误差过于敏感。
独立分析的弱点
独立来看,本工作有几处可改进。第一,推理效率:FLOMSS-S 需 4 个单源模型、每个跑 10 步 Midpoint ODE,FLOMSS-M 四模型合计 268M 参数,难以实时或大吞吐使用;可借鉴 SoundCTM 的一致性蒸馏把步数压到 1–4 步,或改用多源单模型配更好的约束。第二,SDR 缺口:生成式输出在时间与相位对齐上的微小误差会直接拉低 SDR,可在 ODE 后段引入辅助信号级损失,或按图 1 的发现设计「判别式初始化 + 生成式细化」两段式采样。第三,混合一致性:硬 MC 失败的根因很可能是幂律压缩 $X=\beta|X|^{\alpha}e^{j\angle X}$ 破坏源可加性,值得设计压缩域内天然可加的路径,或让骨干直接在未压缩域运行。第四,评价:FD/MMD 依赖 10 秒非重叠分段与编码器选择,剔除 OpenL3 的理由可更透明;主观数据仅 10 段、23 人,统计功效有限。第五,数据与声部:仅 100 首训练歌,吉他、钢琴等全塞进 Other,可扩展更多声部或用 Slakh2100 预训练迁移。
未来方向
作者明确提出的方向有两个:进一步提升 SDR;为硬混合一致性设计 MSS 专属的流路径与训练策略。在此基础上可以自然延伸:其一,少步采样与蒸馏——本文的逐步分析展示了指标沿路径的演化,一致性模型或蒸馏可以把 FLOMSS 变成准实时分离器;其二,混合初始化——用判别式输出作为 ODE 起点(相当于 $\sigma_0\to 0$ 的特例),可能同时保住 SDR 与嵌入指标;其三,把框架推广到开放域声部或与 SAM Audio 式提示结合,做成「预定义四声部 + 开放域」统一分离器;其四,潜空间流匹配——结合 MGE-LDM 的潜扩散思路降低 67M 模型的计算成本;其五,把这套 FD/MMD/LPAPS/SDR 评价协议维护成社区级生成式 MSS 基准,加入更多编码器与显著性检验;其六,探索推理时可调的引导(guidance)机制,让用户按下游任务在「重建保真—分布相似」权衡谱上自由选点。
复现评估
复现条件中等偏友好。数据方面,MUSDB18-HQ 公开可下载(44.1 kHz 立体声官方划分)。模型方面,作者承诺开源(「接收后开放」,现为 demo 页 https://ik4sumii.github.io/FLOMSS/),骨干 NCSN++ U-Net 配置沿用 SGMSE 公开实现,OT-CFM/SB-CFM 与 ODE 求解器均有公开参考实现。算力方面,16M 模型在 4 张 A100 上训练 93,600 步、有效批量 32、学习率 $10^{-4}$,单源方案需训练 4 个模型才能完成全曲分离,67M 版成本相应增加。评价方面,SDR 用公开的 MDX23 实现,FD/MMD 依赖 VGGish、PaSST、OpenL3、CLAP、MERT 等公开编码器,LPAPS 与 WebMUSHRA 框架亦开源。风险点:正文超参之外(97,920 采样点裁剪、10% 重叠、三角形交叉淡化、$\alpha=0.5$/$\beta=0.15$)个别实现细节需自行推断,嵌入指标库版本可能影响 FD/MMD 数值;开源落地前部分流程需按论文描述复现,总体难度中等。
论文图表
23 名被试的 WebMUSHRA 主观测试(每人对 10 段 8 秒片段打 0–100 分):GT 94.57、16 kHz GT 78.24;系统中 SCNet 62.59 排第 1,FLOMSS-M 59.12 排第 2(贝斯 61.21 第 1、人声 67.16 第 2),HTDemucs 58.71 第 3,FLOMSS-S 53.99 第 4,Open-Unmix 35.40 第 6,InstGlow 26.6 第 7;MGE-LDM 与 SAM Audio 因缺声部不计总分。
客观指标之外的人类听觉验证:尽管 FLOMSS-M 的 SDR 远低于判别式 SOTA,主观分却超过 HTDemucs,说明嵌入类指标与感知质量更一致,是论文评价方法论的重要佐证。