SepGen:单模型同时实现多音轨音视频生成与分离 SepGen: Multi-Stem Audio-Video Separation and Generation in a Single Model
让预训练音视频生成器一次采样就输出视频、混音和每条声源各自的波形
前置知识
流匹配扩散模型 (Flow Matching)
一类生成模型,把干净数据 $z$ 与噪声 $\varepsilon$ 按噪声水平 $\sigma\in[0,1]$ 插值成 $z_\sigma=(1-\sigma)z+\sigma\varepsilon$,训练网络预测速度场 $u=\varepsilon-z$,采样时用求解器沿速度场逐步把纯噪声还原为数据。SepGen 的骨干 LTX-2.5 就是这样一个音视频联合扩散生成器。
本文一切训练目标、两种模式的切换(混音噪声水平)和推理调度(Estimated Separation)都建立在 $\sigma$ 与速度预测的语义上,不懂流匹配就看不懂方法核心。
LoRA 低秩适配
冻结预训练权重 $W_0$,只训练低秩增量 $\Delta W=BA$($B$、$A$ 为瘦矩阵),以极小参数量微调大模型。本文在 22B 参数的骨干音频流上加 rank 128 的 LoRA,共 480 个模块、327M 可训练参数,单张 A6000 即可训练。
SepGen 的全部新能力都由这个轻量适配器承载,且作者在混音 token 上把 LoRA 增量门控清零,这是保证骨干输出不被破坏的关键机制。
音频源分离与 Stem(分轨)
从混合录音中恢复每个声源独立波形的技术,每条独立波形称为一个 stem(分轨)。传统方法用掩码滤波(如 AudioSep),生成式方法则直接合成目标波形;理想分离要求各分轨互补且求和近似还原混音。
SepGen 的输出单位就是 caption 化的 stem,论文评价指标(swap margin、说话人余弦)全部围绕"分轨是否互补、是否忠实于各自描述"设计。
语言查询音频源分离 (LASS)
用自由文本描述作为查询条件的分离范式,代表工作有 AudioSep(CLAP 文本嵌入条件)、FlowSep(修正流生成式分离器)和 SAM Audio(流匹配 transformer,还接受视觉掩码)。它们对每条查询独立运行一次。
LASS 是本文的主要对比基线;其对查询独立作答的缺陷(两个同类声源返回同一结果)正是 SepGen 联合预测双 stem 要解决的核心痛点。
旋转位置编码 (RoPE) 与时间对齐
把位置信息以旋转变形注入注意力的编码方式。本文让混音与两条 stem 的音频通道各自保留预训练的时间位置,使第 $j$ 个 token 在所有通道上对应同一声音时刻,stem 才能按时刻读取混音内容。
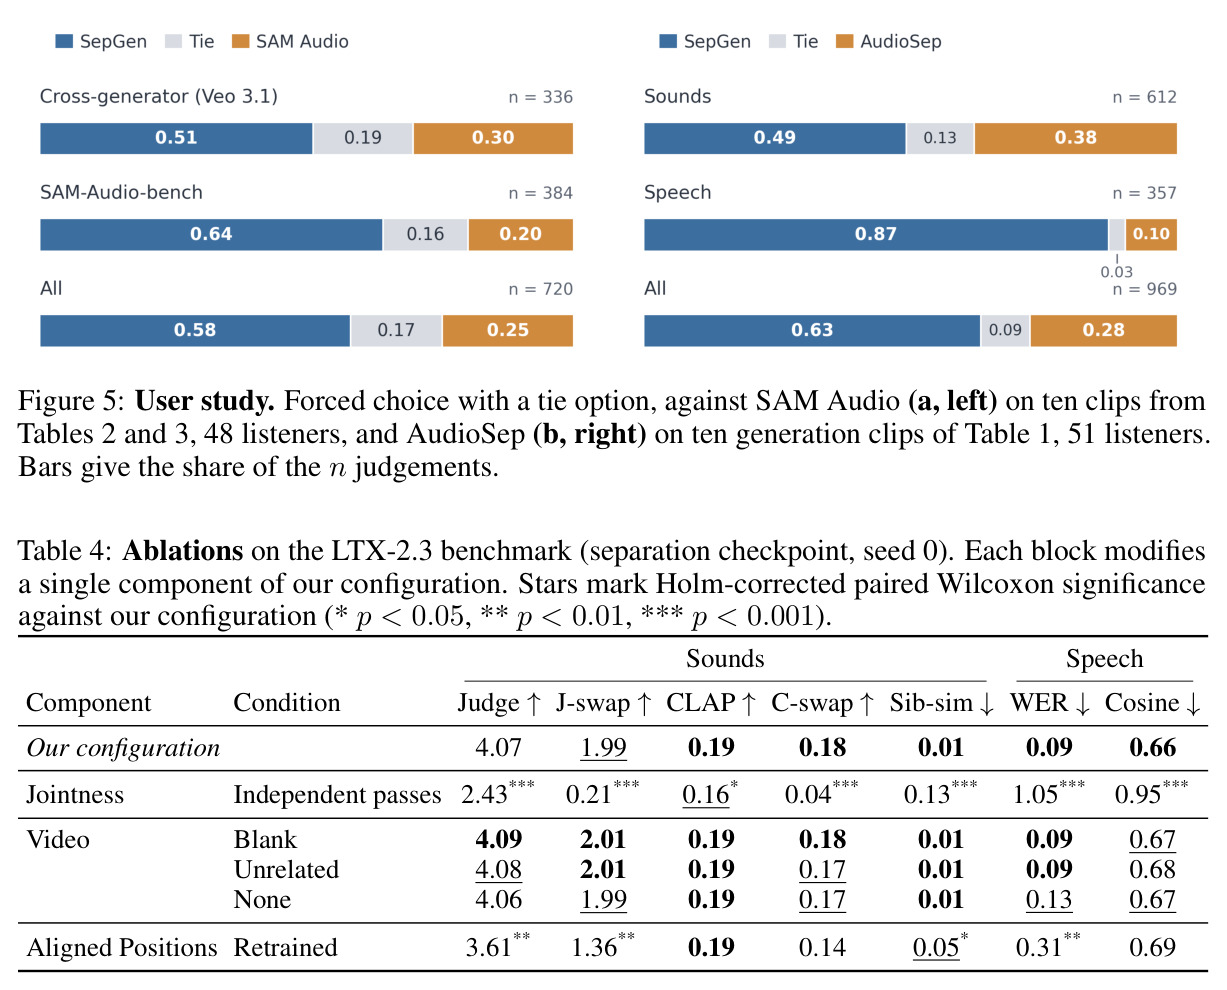
消融实验证明:若改成把三通道串成一条连续时间轴再重训,Judge 从 4.07 掉到 3.61、词错率增加两倍多,时间对齐是 stem 能"边听边拆"混音的前提。
归一化注意力引导 (NAG) 与负提示
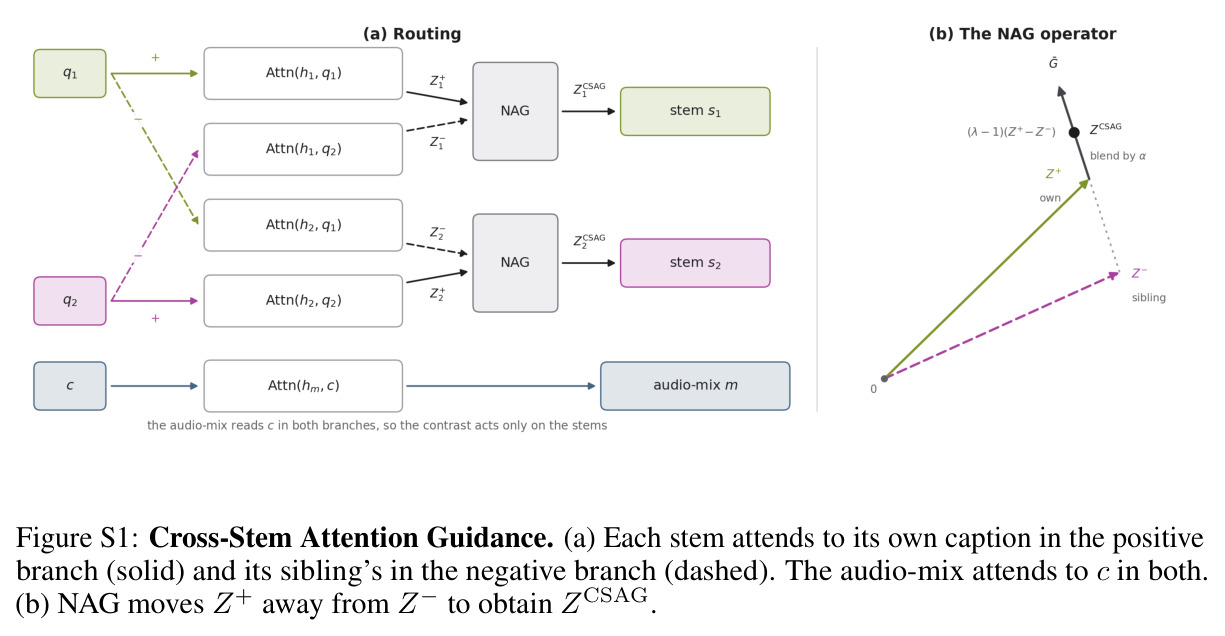
扩散模型的负提示引导技术:在交叉注意力中同时计算正分支 $Z^+$(自己的提示)和负分支 $Z^-$(要避开的提示),用 $G=\lambda Z^+-(\lambda-1)Z^-$ 做外推把生成推离负提示语义,再做范数归一与混合。
SepGen 的 Cross-Stem Attention Guidance(CSAG)把 NAG 改造成 stem 间对比机制——兄弟 stem 的 caption 当负分支——是防止两条 stem 内容串音(leakage)的直接手段。
研究动机
音视频联合生成器(LTX-2、Ovi、Veo 3.1 等)能从文本同时合成视频与同步配乐,但整条音轨以单一混音波形(audio-mix)输出,其中各声源不可单独访问。这在这些生成器输出的视频被重渲染时成为硬伤:单目视频方法可以把视频提升为可从新视点观察的 4D 场景,空间音频渲染器需要把每个声源放到场景中的位置与轨迹上、分别传播到观察者双耳再混合;但只有混音时,没有任何可放置的声源,重渲染后声音只能固定在原视点,双耳听到完全相同的声音。另一条路——语言查询分离(LASS)模型如 AudioSep、FlowSep、SAM Audio——虽然能事后按文字描述抽取声源,但它们对每条查询独立跑一次模型:一方面多一次调用,另一方面当两个声源同类时(例如向两位男性说话人分别发起查询),两个独立查询可能都返回同一个更响亮的说话人,得不到互补的两条分轨。
本文的目标是本文的目标是把一个预训练的音视频联合生成器扩展成多音轨(multi-stem)生成器:给定场景级文字描述和每条声源各自的 caption,模型在单次去噪采样中同时输出视频、完整混音,以及每条被描述声源独立的波形。同一套权重还要能反向工作成分离模式——输入已存在的视频与混音,按 caption 抽出对应分轨。同时有三条硬约束:不能损害骨干网络原有的视频与混音质量(混音最好逐位不变);两条 stem 必须忠实于各自 caption 且互不串音;生成与分离两种模式不需要分别维护两个模型。
与已有工作不同的是,本文的独特切入有三点。第一,它不是训练一个独立分离网络,而是首次把预训练音视频生成器本身改造成多 stem 输出器:两条 stem 作为额外通道与混音在同一音频 token 序列里联合去噪,彼此天然互补,从机制上消除了 LASS 独立作答导致的"两人同声"问题。第二,设计"受保护混音通道":混音只注意自身、完全旁路 LoRA 更新,使"加上 stem 后骨干输出不变"成为构造性保证而非经验观察。第三,用混音的噪声水平统一两种模式——分离时混音恒为零噪声、生成时混音与 stem 一起从噪声去噪,并配合 Estimated Separation 调度让 stem 高噪声段读带噪混音、低噪声段读其干净估计,从而一套检查点兼任生成与分离,只差一个短暂的续训阶段。
核心方法
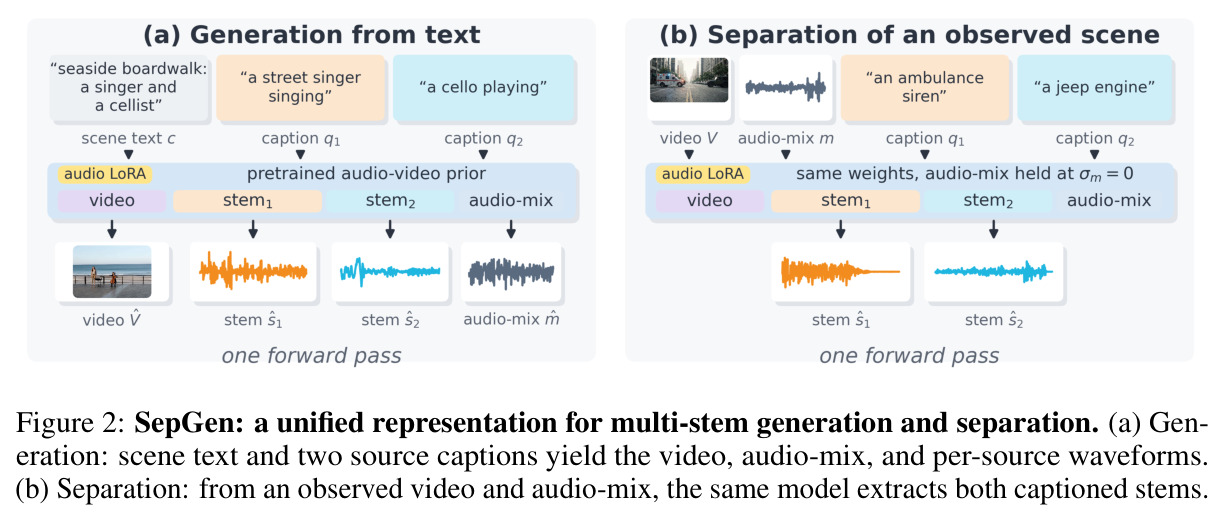
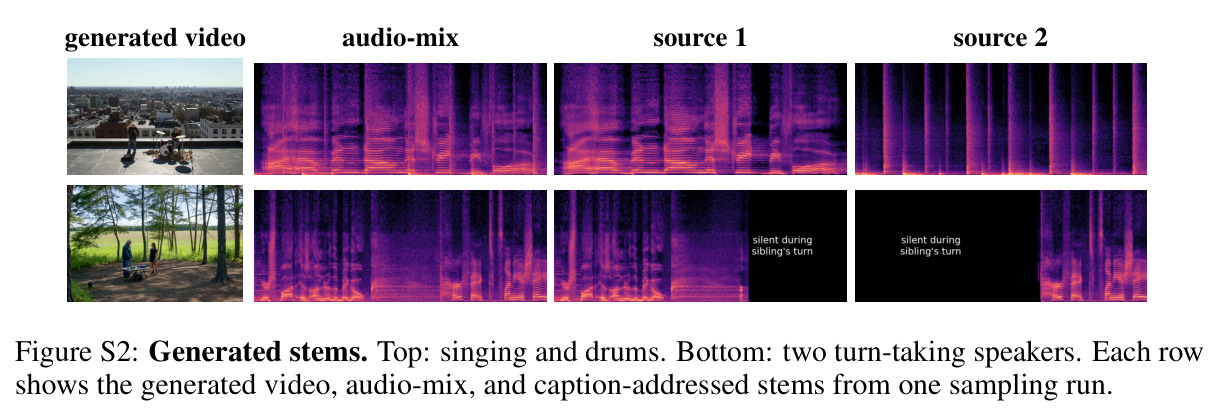
直觉上,SepGen 让每条 stem "边听混音、边读自己的说明书":stem 可以看混音、视频、其他 stem 和自己的 caption,但混音与视频看不到任何 stem,信息只能从场景单向流向分轨。技术上,骨干是流匹配扩散音视频生成器 LTX-2.5(22B 参数,视频流与音频流两个 transformer,双向音视频交叉注意力)。音频 VAE 把混音与两条 stem 各编码为与预训练音频 latent 等长时间步的 latent,沿 token 轴拼接为 $z_a=[z_{s_1}\,|\,z_{s_2}\,|\,z_m]$ 送入音频流。仅训练音频流上的 LoRA(rank 128、327M 参数、480 个模块),骨干权重冻结并 int8 量化。注意力掩码 $\Lambda$ 保证混音只注意自身;LoRA 增量在混音 token 上被门控置零 $g_j=\mathbf{1}[j\notin J_m]$;caption 交叉注意力按块对角路由,$s_i$ 只读 $q_i$、混音只读场景描述 $c$;三通道共享旋转位置编码使第 $j$ 个 token 对齐同一时刻。损失只加在 stem token 上,为流匹配速度目标。这样模型 $\mathcal{F}_\theta$ 同时支持生成 $(\hat V,\hat m,\hat s_1,\hat s_2)=\mathcal{F}_\theta(c,Q)$ 与分离 $(\hat s_1,\hat s_2)=\mathcal{F}_\theta(c,Q,V,m)$。
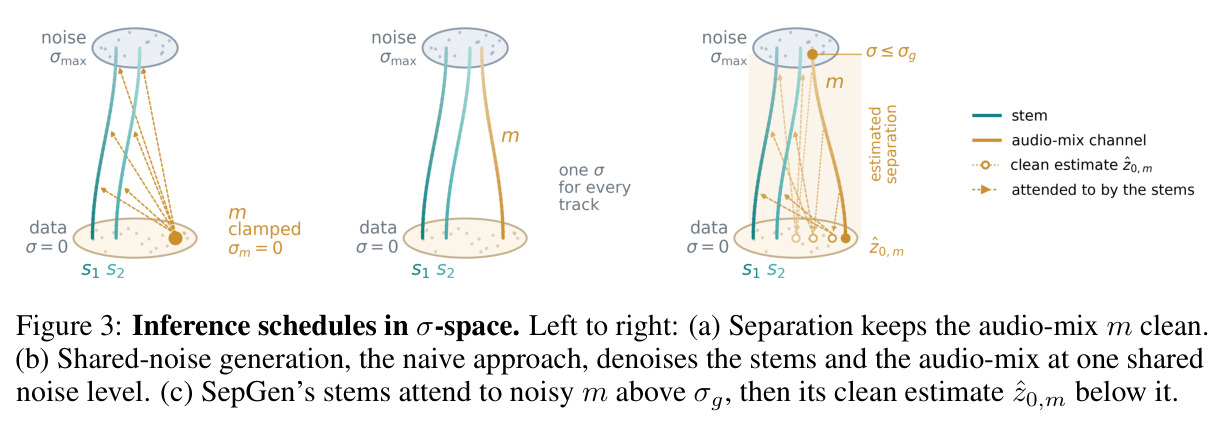
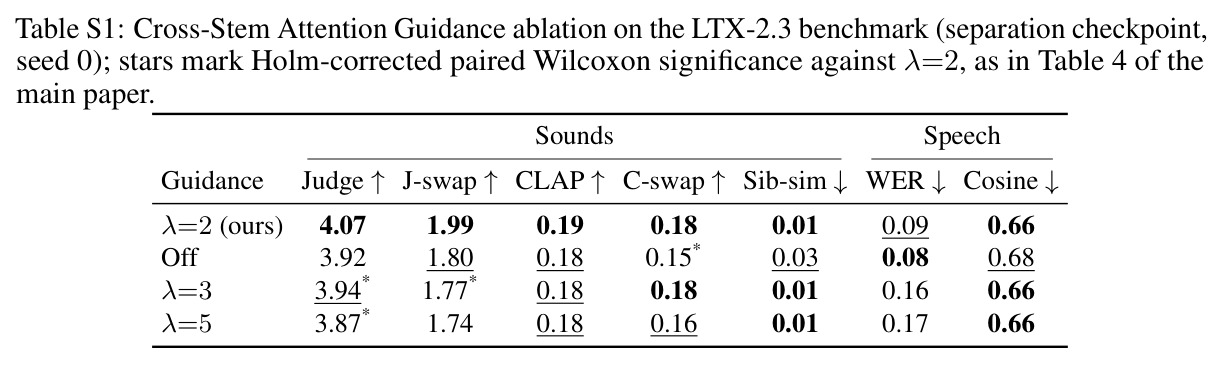
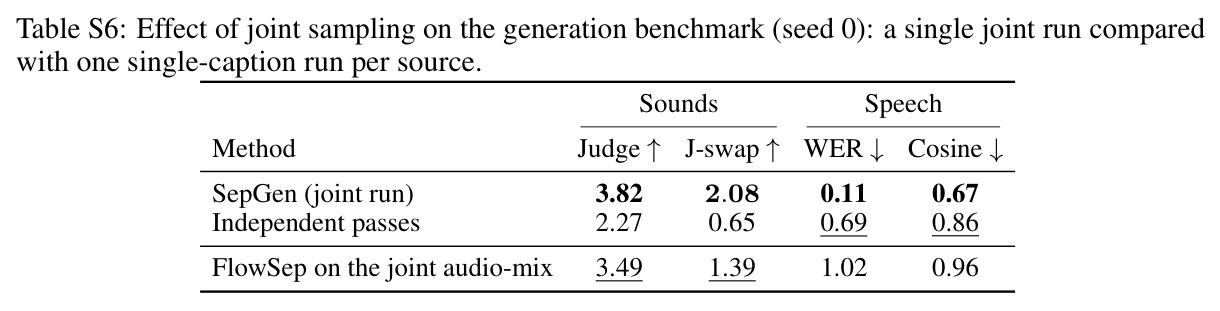
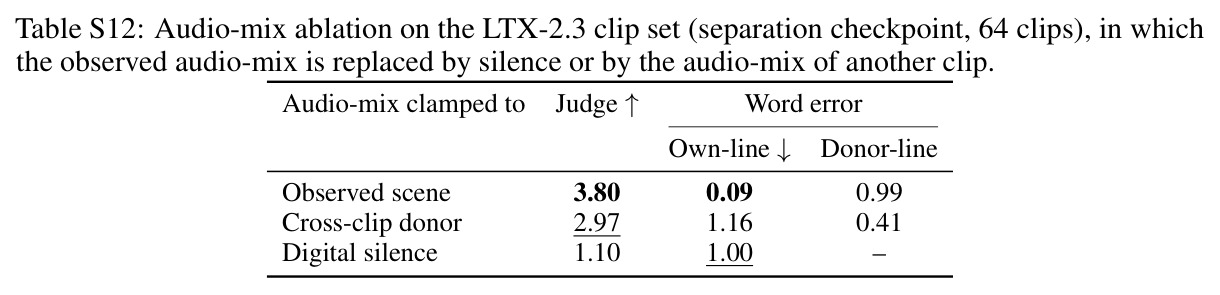
核心创新是"联合分解 + 受保护条件"的组合。与 LASS 把每条查询独立送入分离网络不同,SepGen 从同一个共享混音联合预测两条 stem,各自对齐自己的 caption——消融显示,若把两条 caption 拆成独立单跑,两条 stem 会退化为混音的近似复制:Judge 从 4.07 崩到 2.43、J-swap 从 1.99 跌到 0.21、词错率升到 1.05。第二个关键想法是把生成与分离统一为同一去噪过程的两端:分离时混音恒定干净($\sigma_m=0$),只对 stem 去噪;生成时混音与 stem 一起从噪声去噪,stem 通过 Estimated Separation 在 $\sigma_k\le\sigma_g=0.97$ 时改读当前步预测的干净估计 $\hat z_{0,m}=z_{\sigma_k^m}-\sigma_k\hat v_m$,避免读到尚未定型的噪声混音。第三是 Cross-Stem Attention Guidance:把兄弟 stem 的 caption 作为 NAG 的负分支($\lambda=2$),在注意力层面把每条 stem 推离兄弟的内容,处理"一个声音同时符合两条 caption"的歧义。这三者叠加,使轻量适配就能给 22B 骨干加上既保真又可控的多 stem 能力。
方法步骤详情
第一步,构建训练数据:4,843 段双声源素材,来自 CelebV-HQ 对话(1,658 段)、URMP 双乐器演奏(1,437 段)、模型自生成的双源片段(749 段)以及 VGGSound 与 MUSIC-21 跨视频合成的混音(999 段);每段含视频、混音、两条参考 stem 与三档详细程度的 caption(语义/方位/短语,训练时随机抽一档;方位 caption 在训练时用源区域框对 stem 的视频注意力加软偏置、推理时移除)。第二步,搭架构:把两条 stem latent 与混音 latent 拼接进音频流,施加掩码 $\Lambda$(stem 可看 stem 与混音、混音只看自己),LoRA 门控在混音 token 上置零,caption 走块对角路由。第三步,阶段一(分离):12,000 步,混音始终干净 $\sigma_m=0$,仅监督 stem token 的速度预测 $v_{\theta,i}$ 对目标 $u_{s_i}=\varepsilon-z_{s_i}$ 的 $\mathcal{L}_2$ 损失。第四步,阶段二(生成):从分离检查点续训 3,000 步,混音噪声按 $\sigma_m=(1-b)\min(\sigma_m',\sigma_s)$、$b\sim\mathrm{Bernoulli}(0.3)$ 采样——30% 保持干净以保住分离能力,其余封顶在 stem 噪声水平。第五步,推理:分离用 30 步 Euler 采样、每步把编码混音重新钳到 $\sigma=0$;生成用 15 步重采样调度、全部 latent 一起去噪、stem 在 $\sigma\le0.97$ 后读干净估计;全程在 caption 交叉注意力内施加 CSAG($\lambda=2,\tau=2.5,\alpha=0.5$)。训练全程单张 NVIDIA A6000,AdamW、批大小 1、学习率 $10^{-4}$ 线性衰减、bfloat16,片段 113 帧@25fps、768×512。
技术新颖性
技术新颖性有四点。(1) 首个多 stem 音视频生成器:最接近的 MGE-LDM 只处理音频且每次抽取一个源,MMAudioSep 每遍一个源,本文单次去噪运行同时输出视频、混音与双 stem。(2) 受保护通道带来可证明的骨干不变性:作者把同一输入分别以 LoRA 启用/禁用各跑一遍,混音 token 与视频在每一层、每个输出上逐位相同,只有 stem 行不同——"加 stem 不动骨干"是构造性保证,不是事后修补。(3) Estimated Separation 调度优雅地把分离式训练迁移到生成场景:$\sigma_g=0.97$ 相比全程读干净估计(J-swap 降到 1.91)或从不读(WER 升到 0.16)取得最佳折中,而且只需在阶段二把混音噪声分布改成覆盖两种机制即可,代价仅 3,000 步续训。(4) 把 NAG 改造成 CSAG,以兄弟 caption 为负提示做 stem 间对比引导,去掉它 C-swap 显著下降(Holm $p=0.03$)。此外对齐 RoPE 的消融(重排成串联时间轴后 Judge 掉到 3.61、WER 增至 0.31)证明时间对齐是 stem 读取混音的结构性前提,这些设计共同构成一套可迁移到其他音视频骨干的适配配方。
实验结果
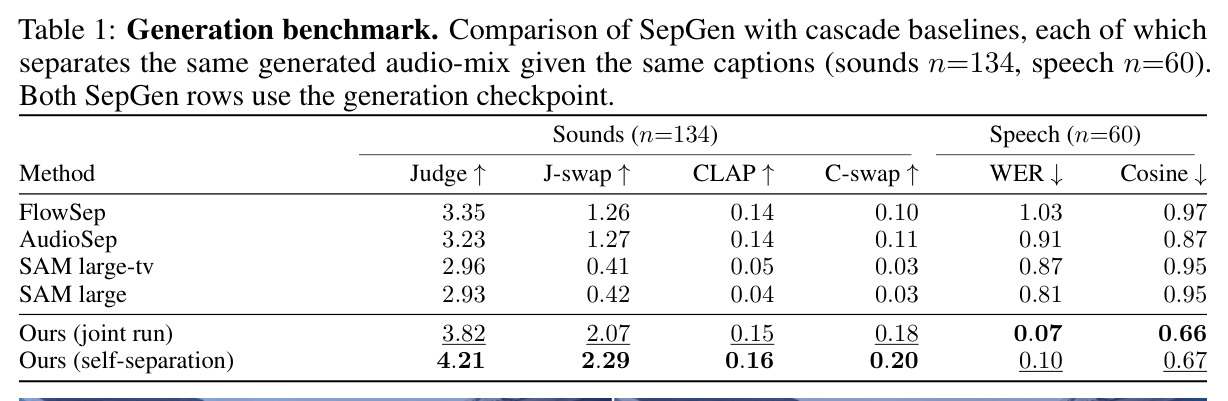
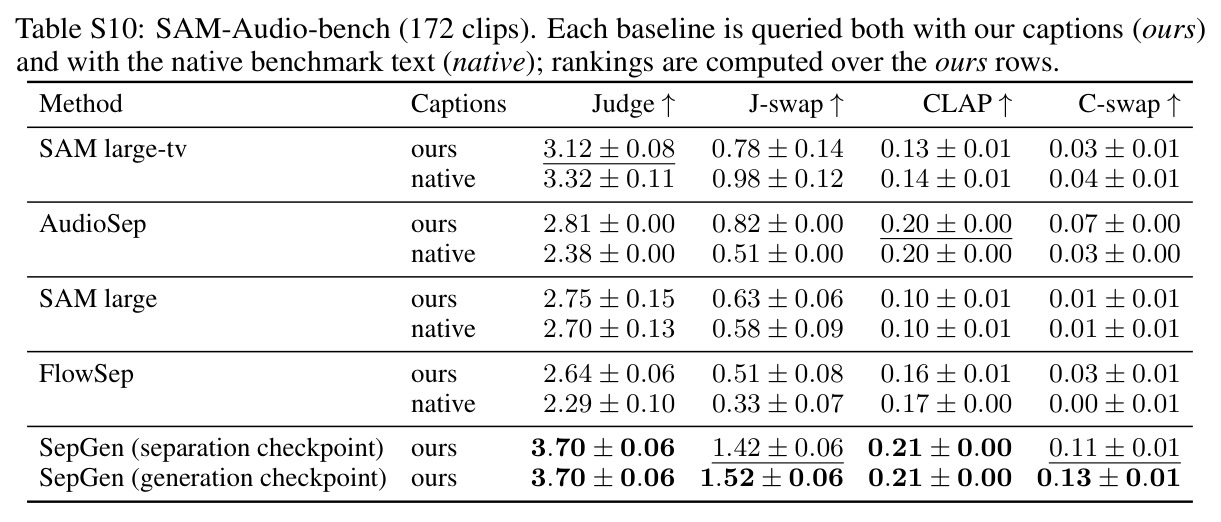
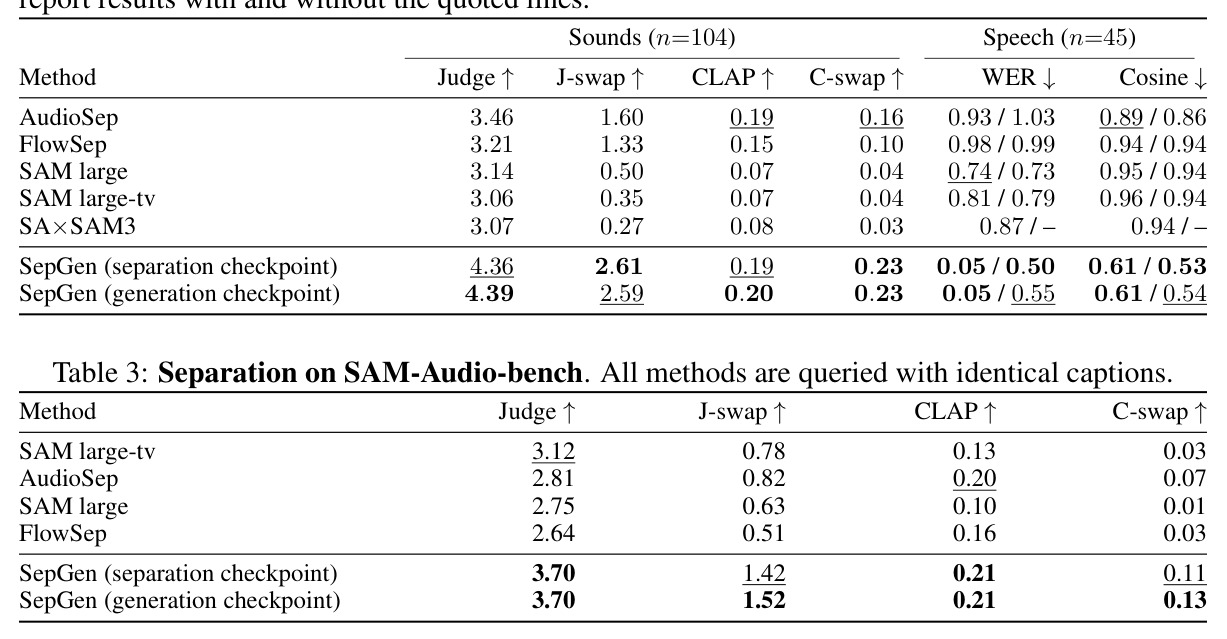
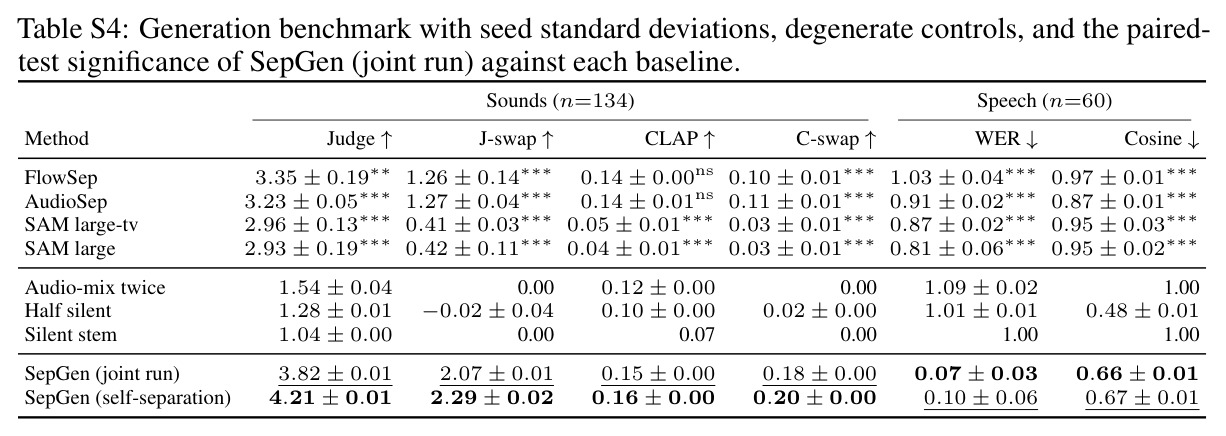
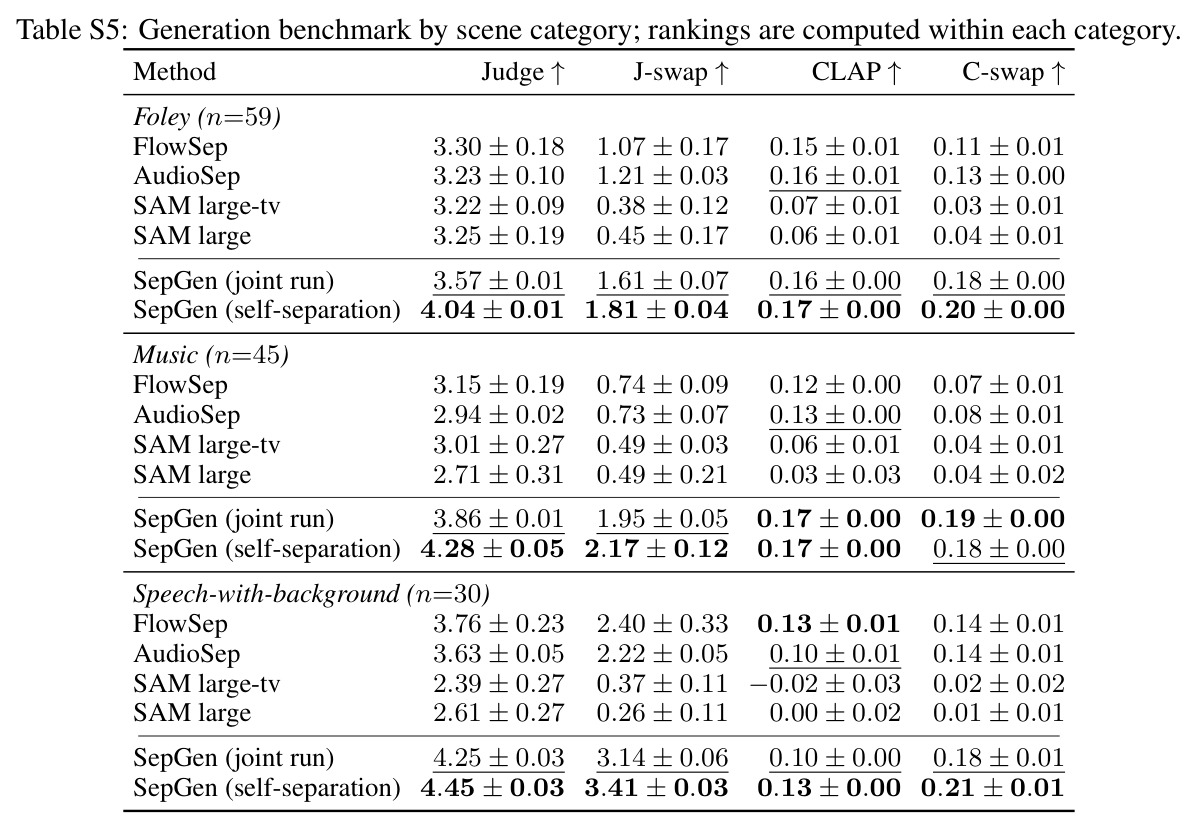
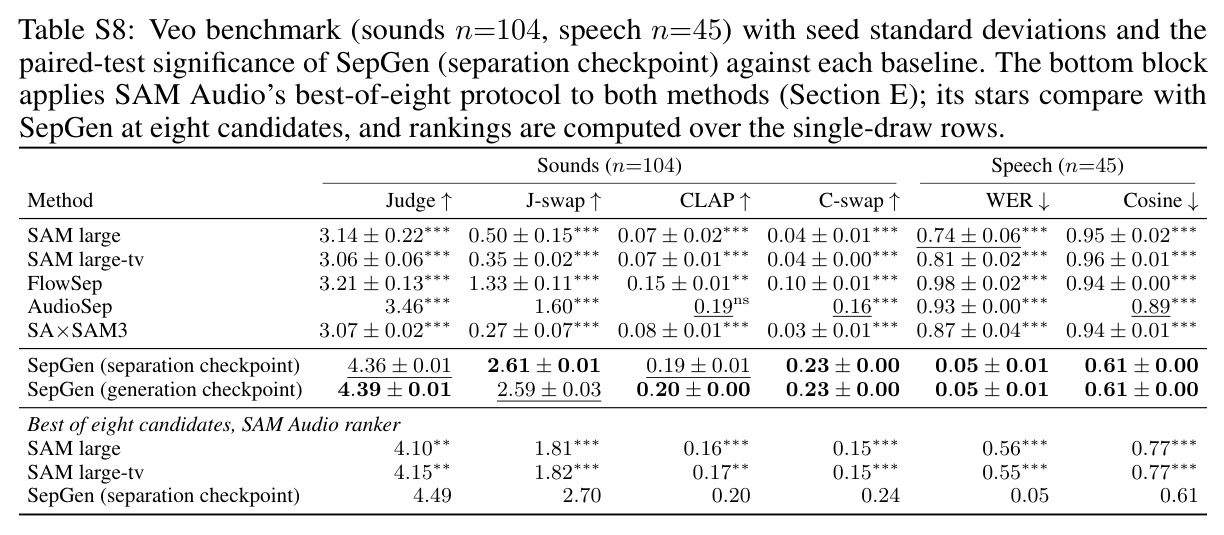
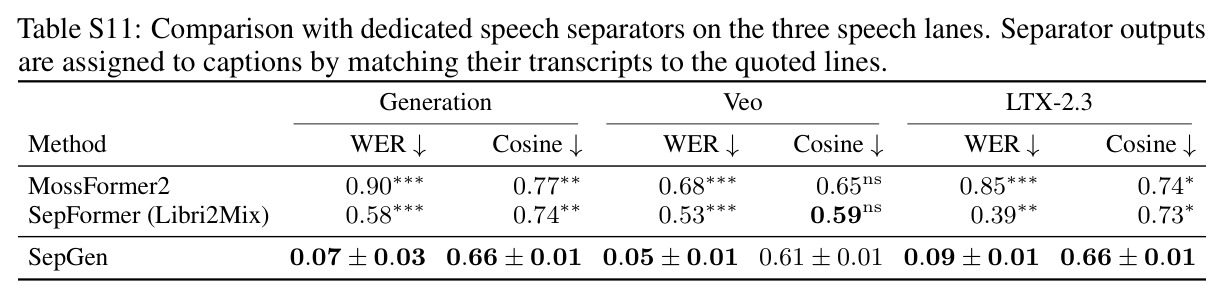
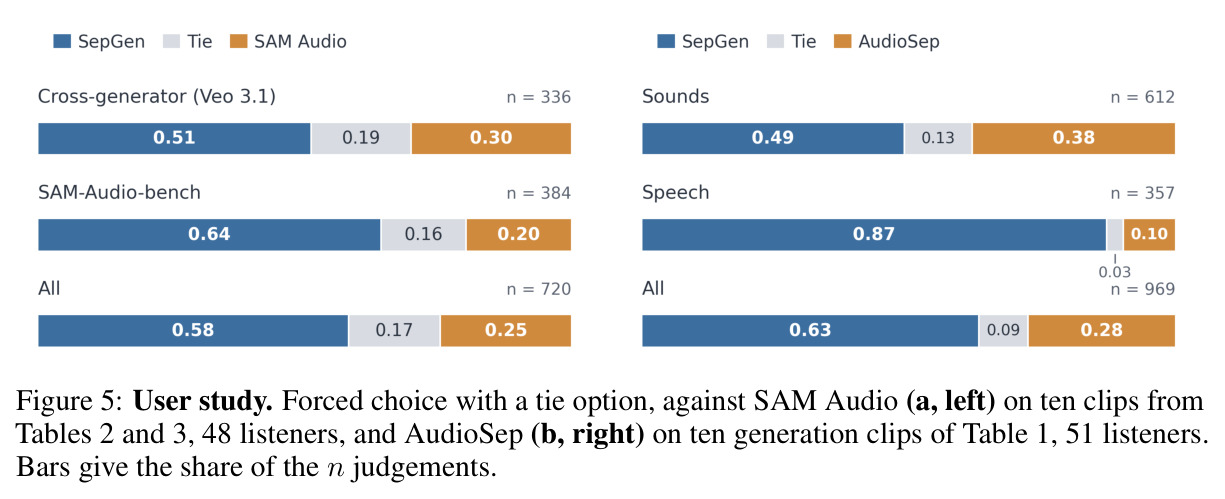
生成基准(194 个双源场景:134 声音 + 60 双人对话):联合运行取得 Judge 3.82、J-swap 2.07、own-line 词错率 0.07、说话人余弦 0.66,全面领先最强级联基线 FlowSep(3.35/1.26/1.03/0.97)、AudioSep(3.23/1.27/0.91/0.87)与 SAM large(2.93/0.42/0.81/0.95);语音上的词错率差距最为悬殊(0.07 对 0.81–1.03)。用同一权重再做一次自分离可把声音指标推到 Judge 4.21、J-swap 2.29。Veo 基准(149 段 Veo 3.1 Lite 渲染):分离检查点 Judge 4.36、J-swap 2.61、词错率 0.05,比最好的 AudioSep(3.46/1.60)高出约 0.9/1.0;即使用 SAM3 视频掩码驱动 SAM(SA×SAM3,3.07/0.27)也填不上差距;把 caption 中的台词删掉后词错率升到 0.50–0.55 但领先保持。LTX-2.3 基准(64 段):Judge 4.08、J-swap 2.04 全指标第一。真实录音 SAM-Audio-bench(172 段):Judge 3.70 对最强 SAM large-tv 的 3.12,J-swap 1.42/1.52 对 0.78。用户研究:分离任务 SepGen 获 0.58 偏好对 SAM Audio 0.25(48 名听众、720 次评判),生成任务 0.63 对 AudioSep 0.28(51 人、969 次),其中语音上 0.87 对 0.10。参考 stem 波形评估(129 段留出集、258 条 stem):包络相关 0.82、LSD 6.3 dB,优于 AudioSep(0.76/11.0)和 SAM 八选一重排(0.78/10.3);对话集 own-line 词错率 0.05 与真值 stem 持平。消融逐一确认:联合预测(独立双跑崩溃到 Judge 2.43)、对齐位置(重排后 Judge 3.61、WER 0.31)、混音条件(静音混音 Judge 崩至 1.10;换成跨片段供体混音时 stem 转录的是供体台词)缺一不可,而视频输入对分离几乎无贡献(空白/无关视频指标不变)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多 stem 生成(声音场景,n=134) | SAM Audio Judge(1–5 分) | 3.82(联合运行)/ 4.21(自分离) | FlowSep 3.35,AudioSep 3.23,SAM large 2.93 | +0.47 ~ +0.89(联合运行对最强基线) |
| 多 stem 生成(双人对白,n=60) | own-line WER(词错率,越低越好) | 0.07 | AudioSep 0.91,SAM large 0.81,FlowSep 1.03 | 降低约 0.74–0.96(约一个数量级) |
| 语言查询分离(Veo 基准,149 段) | Judge / J-swap | 4.36 / 2.61(分离检查点) | AudioSep 3.46 / 1.60,SAM large 3.14 / 0.50,SA×SAM3 3.07 / 0.27 | Judge +0.90,J-swap +1.01(对最强基线) |
| 语言查询分离(真实录音 SAM-Audio-bench,172 段) | Judge / J-swap | 3.70 / 1.42–1.52 | SAM large-tv 3.12 / 0.78,AudioSep 2.81 / 0.82 | Judge +0.58,J-swap +0.64 ~ +0.74 |
| 有参考分轨波形评估(129 段、258 条 stem) | 包络相关 / 对数谱距离 LSD | 0.82 / 6.3 dB | AudioSep 0.76 / 11.0 dB,SAM best-of-8 0.78 / 10.3 dB | LSD 改善 4.0–4.7 dB |
| 人工听感 A/B 测试(分离/生成) | 偏好份额(强制选择+平局) | 分离 0.58,生成 0.63(语音 0.87) | SAM Audio 0.25,AudioSep 0.28 | 偏好份额高出 0.33–0.35 |
局限与改进
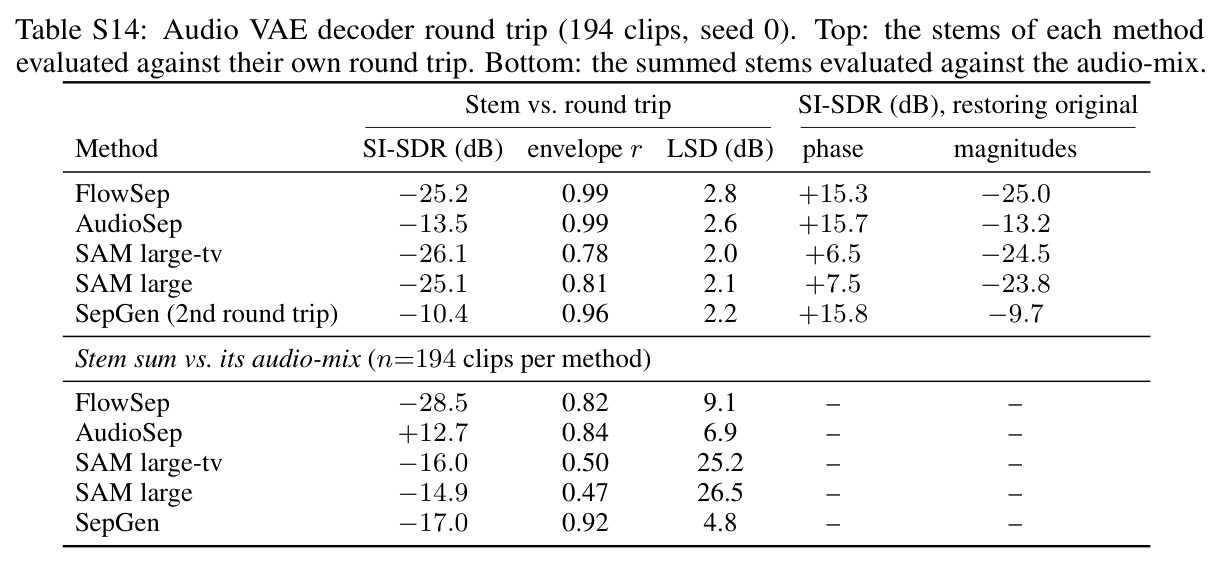
作者承认的局限:其一,音频 VAE 解码器会保留包络与频谱但重新合成相位,导致 SI-SDR 对所有方法(包括自身)均为负值,只能改用包络相关与 LSD 等相位不变指标,且真值 stem 经 VAE 往返也只有包络 0.96 / LSD 3.1 dB,分离保真度存在解码器上限;其二,当前布局固定为两个声源;其三,stem 保留了来源场景的声学特性(混响与距离线索),空间渲染器把声源传播到新视点前必须先处理这些属性,否则新视点会带上旧房间感。我的补充观察:主要无参考指标 Judge 与 SAM Audio 分离器同属 PE-AV 编码器家族,存在评测器亲和风险(作者用 VAE 再量化、16 kHz 频带限制等控制实验部分缓解,但结构性偏置仍在);AudioSep 的查询编码器恰是打分用的 CLAP 检查点,其 CLAP 列天然虚高;同类双源(同乐器二重奏)时 caption 无法指派拆分,LSD 从 6.3 dB 恶化到 11.7 dB 且置换不变 LSD(11.4 dB)也救不回来;片段仅 4.5–6 秒,长视频与更多声源未验证;未能与 FlowSep 2 对比(其模型发布时未开源);生成模式的 stem 质量仍低于自分离(Judge 3.82 对 4.21),说明联合去噪条件化还有提升空间。
独立分析的弱点
弱点一:固定双源。真实影视音轨常见语音+音乐+音效三轨以上,掩码与通道拼接布局需要手工扩展,训练数据也要按源数重组。改进方向:把 stem 通道做成可变长序列,引入源数预测头或迭代加轨(先生成两条、按需续接),或借鉴统一分离模型(TUSS 类)的任意源数输出。弱点二:保真度受音频 VAE 上限制约——真值 stem 经 VAE 往返 LSD 也有 3.1 dB、相位被重造,专业音频制作需要波形级保真。改进方向:换更高保真的音频编解码器、在解码器中引入相位感知损失或直接在波形域做最后一步精修。弱点三:生成模式的联合 stem 弱于自分离(Judge 3.82 对 4.21、J-swap 2.07 对 2.29),说明去噪早期 stem 读到的噪声混音信息不足。改进方向:增加阶段二训练步数、强化 stem 到混音的注意力偏置(当前 $w=4$ 帧局部带可调),或引入混音一致性正则(sum-to-mix 约束)。弱点四:评测对 caption 措辞敏感——SAM-Audio-bench 上换用本文 caption 风格使 SAM large-tv 得分波动 0.2–0.35,提示结果对提示工程有一定依赖,应报告多措辞区间。弱点五:对白场景的说话人区分依赖 caption 中引述的台词;当两条 caption 无台词且说话人声纹相近时,模型可能重蹈级联基线的覆辙,作者未系统测试这一退化路径。
未来方向
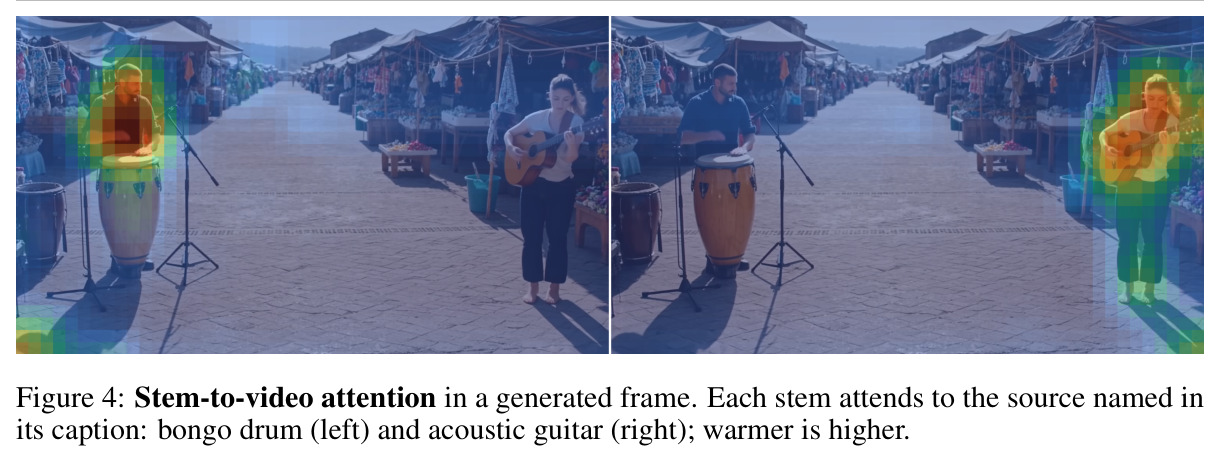
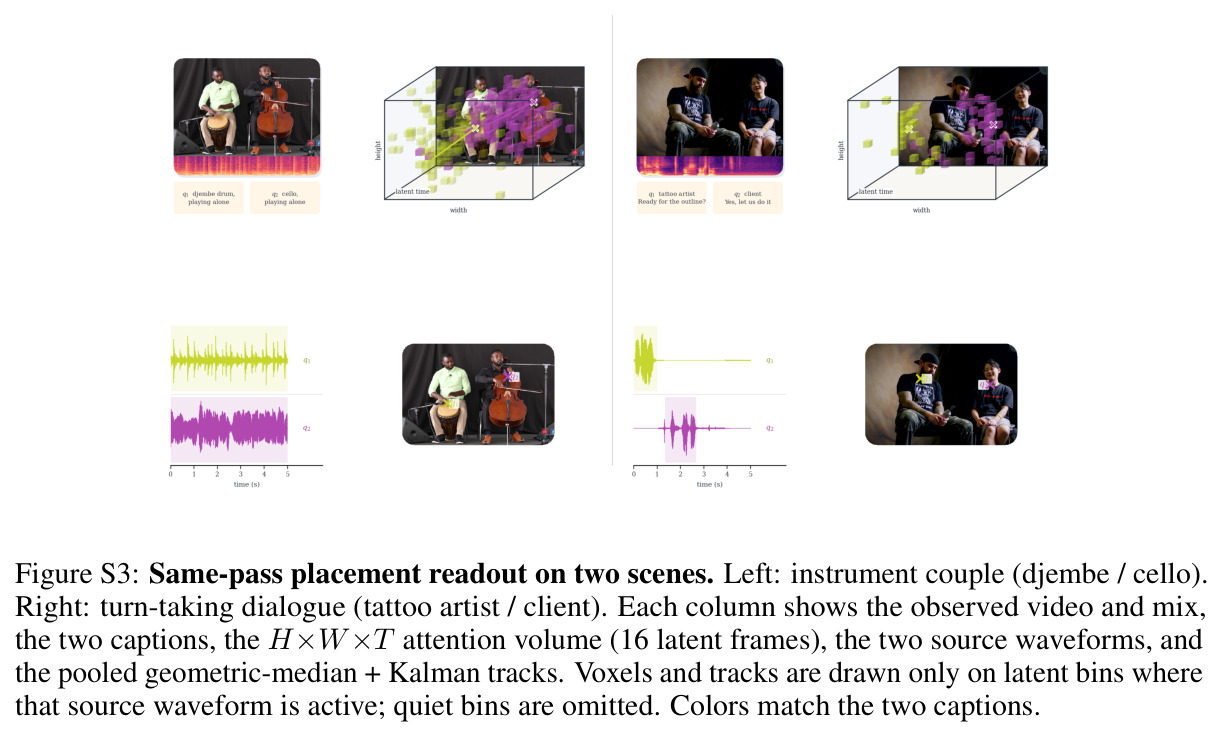
作者提出的方向:把布局扩展到两个以上 stem;把附录 G 的免训练放置读出(对视频-stem 注意力体做前 2% 强响应的加权几何中位数,再用 Kalman 平滑跟踪)整合进空间音频渲染器,形成 4D 场景重渲染的端到端闭环——这正是全文的动机场景。基于本文成果还可延伸:(1) 用 Estimated Separation 思想为 V2A 模型(MMAudio、HunyuanVideo-Foley 等)加上"再分离"能力,形成生成-分离-编辑的统一循环,支持对生成结果做局部声源替换;(2) 把 CSAG 推广为任意多条件间的负提示引导框架,例如多角色视频生成中防止角色属性串扰;(3) 利用块对角路由与局部注意力带的时间局部性,做长视频/流式版本,按时间分块处理;(4) 训练跨骨干的通用 stem 适配器,验证该配方在 Ovi、MovieGen 等其他音视频联合生成器上的可迁移性;(5) 引入源数可变与开集声源,配合 LLM 自动解析场景为 caption 化的源列表。
复现评估
复现条件在同类工作中相当友好:代码、检查点与数据集在项目页 sepgen.github.io 开源。骨干 LTX-2.5(22B)冻结并 int8 量化,仅训练 327M 参数的 LoRA(480 个模块、rank 128),单张 NVIDIA A6000 即可完成 12,000+3,000 步训练,批大小 1、学习率 $10^{-4}$ 线性衰减、bfloat16,属于"单卡可复现"的基础模型适配。训练数据 4,843 段的构成与配比在附录 A 交代得很细,但 CelebV-HQ、URMP、VGGSound、MUSIC-21 需从各自原始渠道下载并自行执行合成流程;作者还做了训练/评测视频不重叠的标识符核查。主要门槛有三:获取并 int8 量化 LTX-2.5 权重的工程细节;评测依赖 SAM Audio Judge、LAION-CLAP、Whisper large-v3、WavLM 等多个外部模型,环境搭建繁琐;Veo 基准需调用 Veo 3.1 Lite API 重渲染。推理侧分离 30 步 Euler、生成 15 步重采样加二阶段上采样(输出 1536×1024),消费级单卡可负担。论文统计规范(多种子、Holm 校正配对 Wilcoxon、消融的显著性标注)也便于第三方严格验证。
论文图表
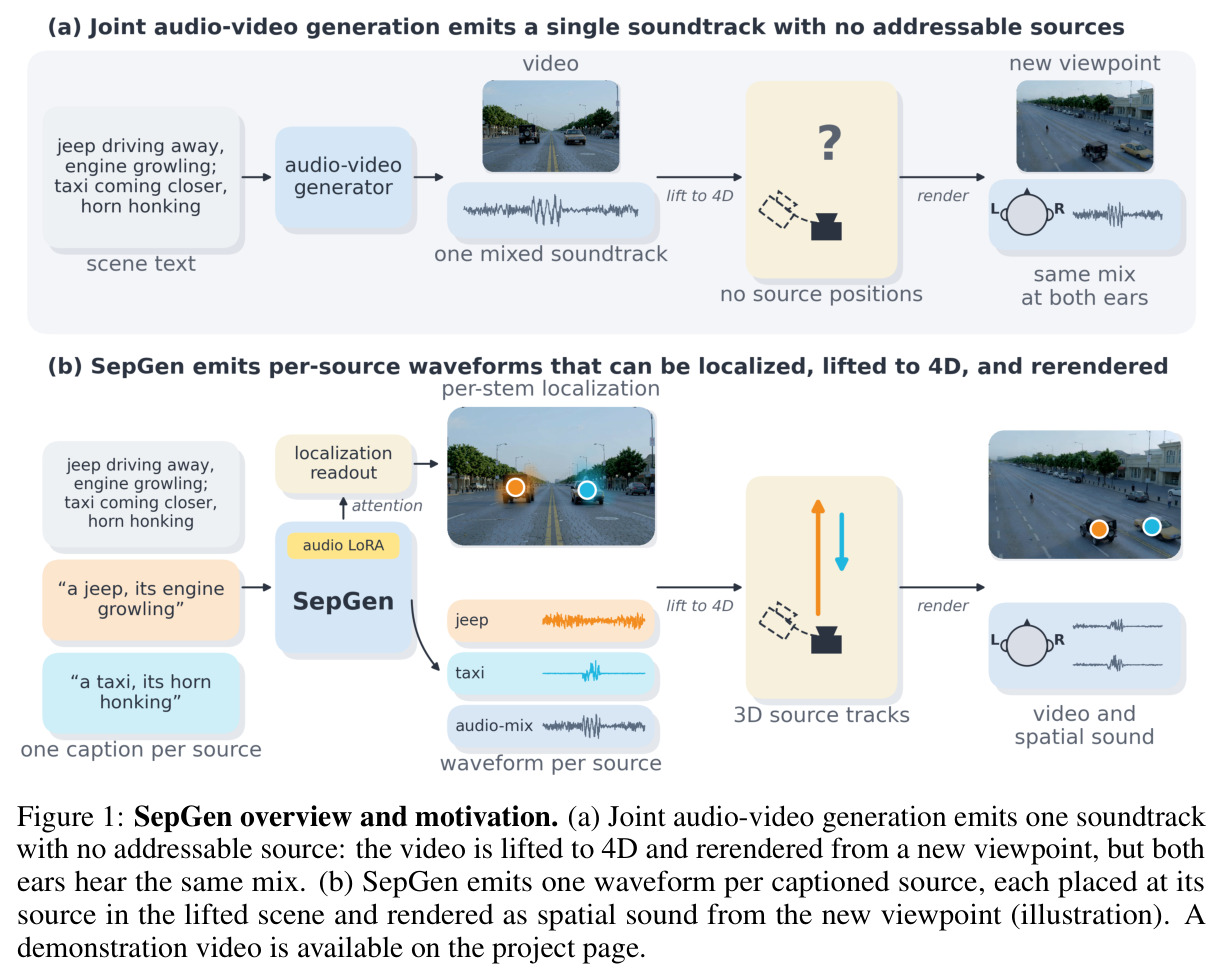
对比图:(a) 现有音视频联合生成把视频提升到 4D 并从新视点重渲染后,双耳听到的是同一条不可拆分的混音;(b) SepGen 为每条 caption 化声源输出独立波形,可把每个源放到 4D 场景中的位置并从新视点渲染成空间音频。
一图讲清论文动机:为什么生成器必须输出分轨才有意义——4D 场景空间音频渲染的前提是每个声源可独立寻址。
调度消融:σg=0.97 取得 J-swap 2.07;每步都读干净估计 J-swap 降到 1.91;从不读则 WER 升到 0.16;分离检查点当生成器用时 J-swap 1.95、WER 0.10,说明阶段二续训的必要性。
验证方法中最精巧的推理调度设计,并量化阶段二带来的 J-swap 1.95→2.07、WER 0.10→0.07、种子散布 0.13→0.01 改善。
有真值分轨的波形级评估:SepGen 包络相关 0.82、LSD 6.3 dB,优于 AudioSep(0.76/11.0)与 SAM 八选一(0.78/10.3);真值 stem 的 VAE 往返为 0.96/3.1,交叉片段空对照 0.04/23.8。
无参考指标之外唯一基于真值波形的评估,给出所有方法相对物理上限的位置,也暴露 VAE 解码器的保真天花板。