学习在哪里切分:面向音频源分离的动态频带划分 Learning Where to Split: Dynamic Band Splitting for Audio Source Separation
固定频带预算下按混合信号内容动态预测频带边界,显著提升多种分离骨干性能
前置知识
频带划分(Band-Split)架构
以 BSRNN 为代表的一类分离模型:先对混合信号做 STFT 得到复数谱(如 1025 个频点),再把频轴按预设布局切成若干非重叠频带(如 62 或 128 个),每个频带被编码为一个固定维度的 token,随后用 RNN 或 Transformer 建模时间与跨频带依赖,最后预测每个频点的复数掩码来重构各源。代表工作包括 BSRNN、BS-RoFormer、Mel-Band RoFormer 和 TIGER,它们的频带布局都是手工设计且对所有输入固定不变。
本文的全部动机就是把这一「固定布局」换成逐输入自适应的边界,理解频带划分范式才能看清改动点与收益来源。
STFT 复数谱与复数掩码
短时傅里叶变换把波形映射为复数谱 $X \in \mathbb{C}^{F \times T}$($F$ 个频点、$T$ 帧),保留相位信息。分离模型通常不直接输出波形,而是为每个源预测一个复数掩码 $M_k$,估计谱写作 $\hat{S}_k = X \odot M_k$,再经逆 STFT 还原波形。掩码是在每个频点上定义的,因此输出端必须恢复到频点级分辨率。
DBS 在频带级做分离、又必须回到频点级预测掩码,这一矛盾是理解其「扩展+精炼」解码器设计的前提。
SI-SDR 与 SDR 指标
SI-SDR(尺度不变信噪比)先对估计与参考波形做最小二乘投影对齐尺度,再算投影目标与残差的能量比:$\mathrm{SI\text{-}SDR} = 10 \log_{10}(\|a s\|_2^2 / \|\hat{s} - a s\|_2^2)$,以 dB 计。SDR(BSS Eval)额外允许一个 FIR 滤波器吸收线性失真,是音乐分离的标准指标;SDRi / SI-SDRi 表示相对未处理混合信号的改进量。
论文主结果用 SI-SDR(DnR v2、EchoSet)和四轨 SDR(MUSDB18-HQ)报告,不懂指标含义无法读懂实验对比。
直通估计器(Straight-Through Estimator, STE)
Hard Top-K 这类离散选择不可导,会阻断分离损失到边界预测器的梯度。STE 的做法是前向传播使用硬选择的离散结果,反向传播时改用一个局部软代理近似求导:$Z^{STE} = Z^{hard} + Z^{soft} - \mathrm{sg}[Z^{soft}]$,其中 $\mathrm{sg}$ 表示停止梯度。这里软代理是「边界存在/不存在」两种局部频带特征按边界概率 $p_r(f)$ 的插值。
DBS 能端到端训练的关键就是 STE 加上置信度路径,没有它边界预测器无法与分离器联合优化。
内容自适应频谱表示与 MoE 路由
让网络按输入动态调整频谱表示或计算路径的一类思路:可学习滤波器组直接优化波形域分析-综合前端;SFC 用跨注意力或 Mamba 替换频带编码器做输入自适应谱特征压缩;稀疏门控 MoE 分离模型按输入路由专家,TF-MoE 沿时间-频率轴路由。这些方法通常改变表示本身或计算路径,而不保留「有序频带」接口。
理解这一脉络才能定位 DBS 的独特之处:只移动频带边界、保持频带数与有序接口不变,从而能即插即用到多种骨干。
研究动机
以 BSRNN、BS-RoFormer、Mel-Band RoFormer 和 TIGER 为代表的频带划分分离模型,把 STFT 频轴按手工预设布局切成固定频带(如 BSRNN 在 1025 个频点上用 62 个带宽递增的频带,宽度向量为 2×24、4×12、12×8、24×8、48×8、128、129),并且对所有混合信号共用同一布局。然而有信息的谱结构位置随源内容变化:电影音轨数据集 DnR v2 同时包含音乐、语音和音效,MUSDB18-HQ 的四个 stems 频谱需求也各不相同。固定布局下,一个宽频带可能把多个有判别力的谱成分压进同一个 token,而另一些信息稀疏的区域却被切得很细、浪费了频带预算;若简单增加频带数提高分辨率,分离器的 token 序列变长、计算成本随之上升——论文数据显示把 BSRNN 扩到 128 频带后计算量达 76.6 G MACs/s,远高于原版 62 频带的 18.2 G/s。核心矛盾由此凸显:如何在频带数(即计算预算)固定不变的前提下,让频率分辨率的分配随每个混合信号自适应调整。
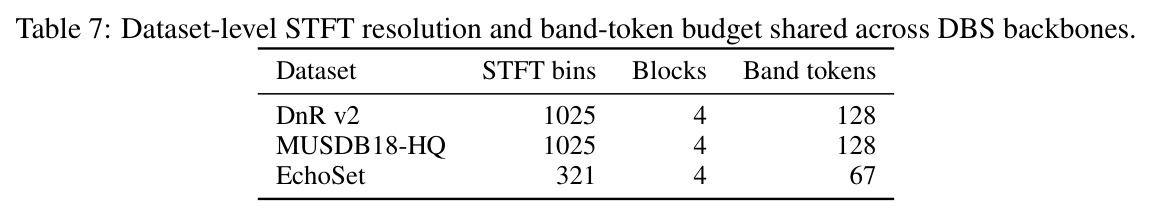
本文的目标是本文要构建一个端到端可训练的动态频带划分框架 DBS:在严格固定的频带 token 预算 $J$ 下(DnR v2 与 MUSDB18-HQ 为 128 个频带、EchoSet 为 67 个),让频带边界的位置和宽度随输入混合信号变化,并与分离骨干联合优化。可衡量的目标包括:在 DnR v2 上让 DBS-BSRNN 的平均 SI-SDR 显著超越静态 128 频带 BSRNN 的 7.69 dB;在 MUSDB18-HQ 上让 BSRNN、BS-RoFormer、MelRoFormer 三种骨干的单模型四轨 SDR 全面超越对应静态版本;在 EchoSet 上超越已发表的 BSRNN 与 TIGER 成绩;同时通过边界分析和固定边界对照实验,证明性能增益确实来自「边界随内容移动」而非模型容量变化。
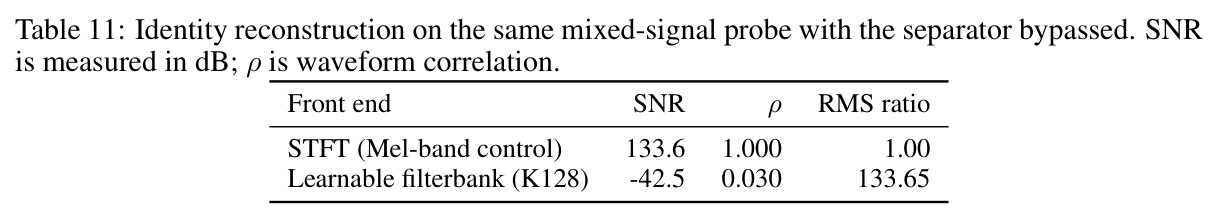
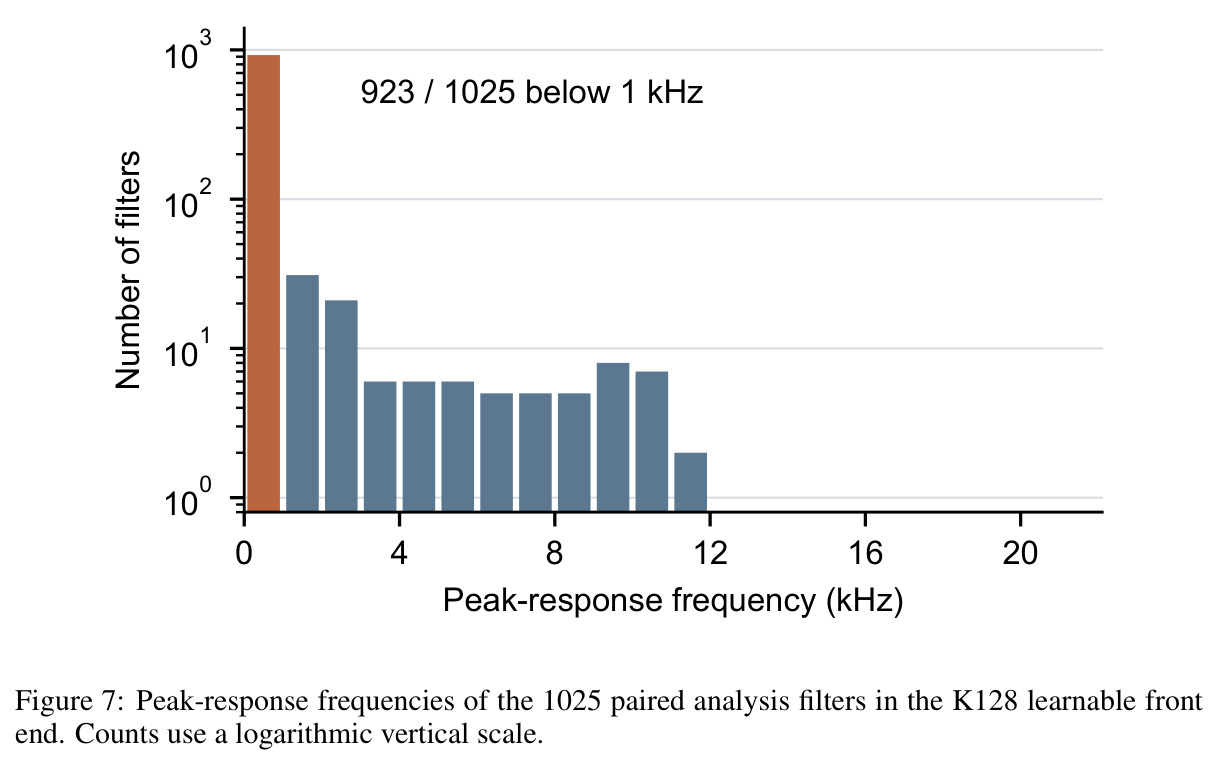
与已有工作不同的是,已有自适应频谱表示工作走了两条不同的路:一是可学习滤波器组(如 Dai 等人的工作),直接优化波形域分析-综合前端;二是替换频带编码器,如 SFC 用跨注意力或 Mamba 做输入自适应谱压缩;另有 MoE 类方法按输入路由专家。DBS 的独特切入在于:完整保留频带划分架构的「有序频带 token」接口和原始 STFT 网格,只让边界位置在固定块内随内容移动,且频带数严格固定。这样既规避了可学习滤波器组破坏重构与频带顺序的问题(论文附录 J 证明该基线在 44.1 kHz 下彻底失效:重构 SNR 仅 -42.5 dB、923/1025 个滤波器峰值挤在 1 kHz 以下),又让同一框架即插即用集成 BSRNN、TIGER、BS-RoFormer、MelRoFormer 四种骨干。据作者所知,这是首个在固定频带预算下学习逐输入频带边界、并与分离器端到端联合训练的工作。
核心方法
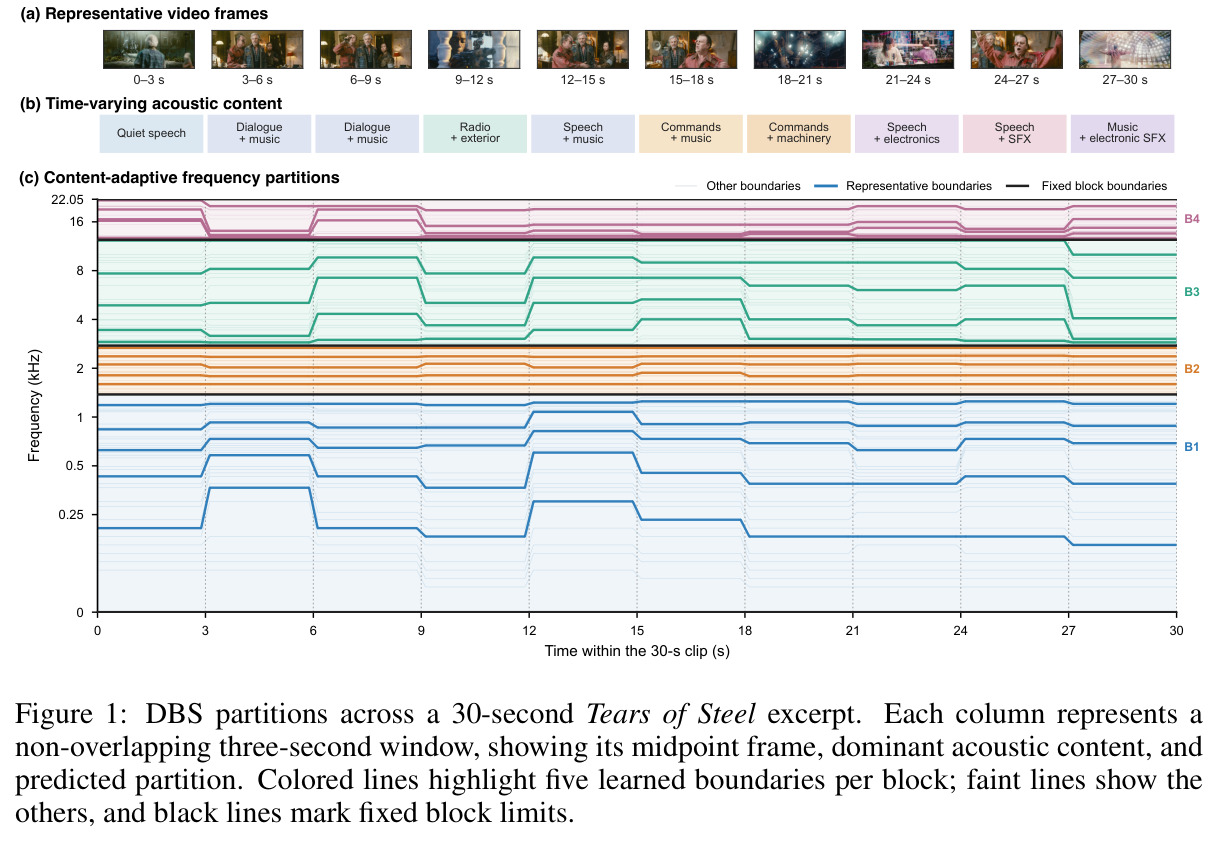
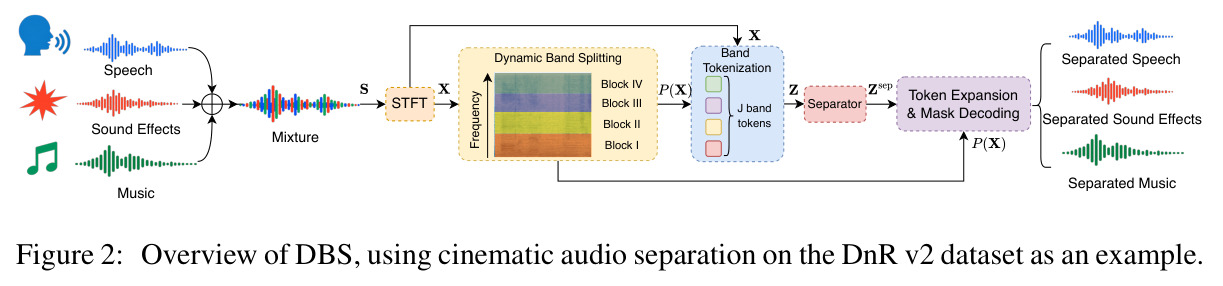
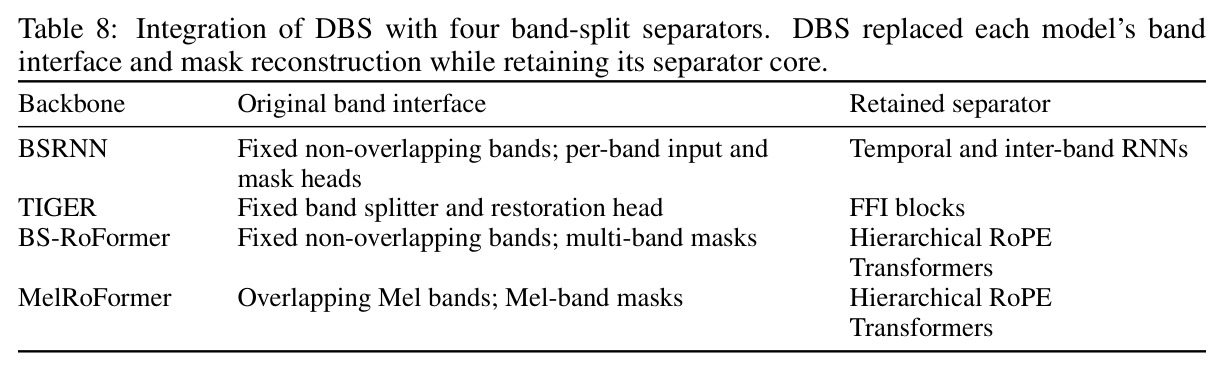
直觉上,DBS 像一台「按内容自动缩放」的频谱显微镜:信息密集的频段分配更多更窄的频带,平淡的频段用少量宽带覆盖,但显微镜的格子总数永远不变。技术路线上,DBS 先把复数谱频轴划成 $R=4$ 个固定块(如 DnR v2 上端点为 0/64/128/576/1025,每块预算 32 个频带,共 $J=128$ 个);每块内由边界预测器为每个候选频点打分并经校准得到边界概率,再用 Hard Top-K 选出恰好 $J_r - 1$ 个内部边界形成连续频带;随后按硬分配做内容相关的加权池化,把每个频带压成一个 $D$ 维 token,交给 BSRNN/TIGER 等骨干做时间与跨带建模;解码端先用边界概率引导的平滑软化 token 过渡,再把 token 按同一硬分配扩展回每个频点、经频率方向残差块精炼后,用频率共享的头预测复数掩码。训练时用直通估计器让分离损失穿过硬 Top-K 更新边界预测器,并用边界密度正则约束软概率的稀疏程度。
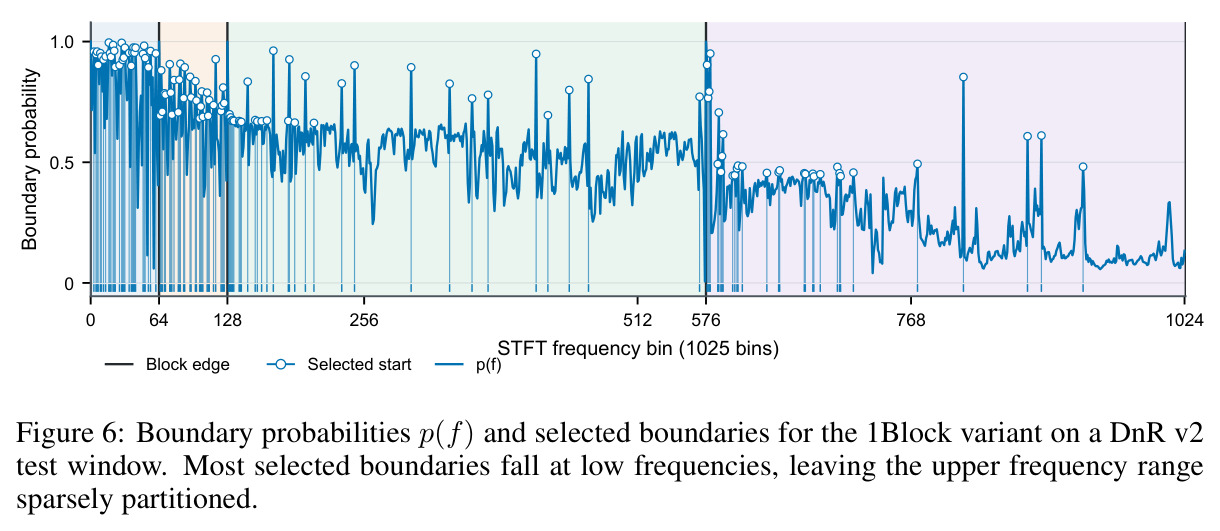
核心创新是「内容条件化的边界预测 + 预算固定的硬 Top-K 选择」。与所有已有频带划分方法的本质区别在于:频带布局不再是模型级结构先验(对所有输入共用一份),而是逐输入、逐窗口预测的函数 $\mathcal{P}(X)$;同时频带总数 $J = \sum_r J_r$ 严格不变,分离器的 token 序列长度和计算图形状完全固定。这种「边界可动、数量不动」的解耦带来两个关键性质:其一,频率分辨率的使用随内容重分配(如音效丰富的高频段获得更多窄带)而不增加 token 数;其二,编码与解码共用同一硬划分 $\mathcal{P}(X)$,频带级 token 可以确定性映射回 STFT 网格。为了让不可导的 Top-K 可训练,作者设计了双梯度通路:STE 软插值代理提供「边界存在/不存在」的特征差梯度,置信度路径 $c_r(f) = b_r(f) p_r(f) + (1 - b_r(f))(1 - p_r(f))$ 在不改变前向值的前提下为边界概率提供直接梯度,再配合边界密度正则稳定软概率分布。固定块结构则保证谱的每个区域都有保底预算,防止边界退化地堆在低频。
方法步骤详情
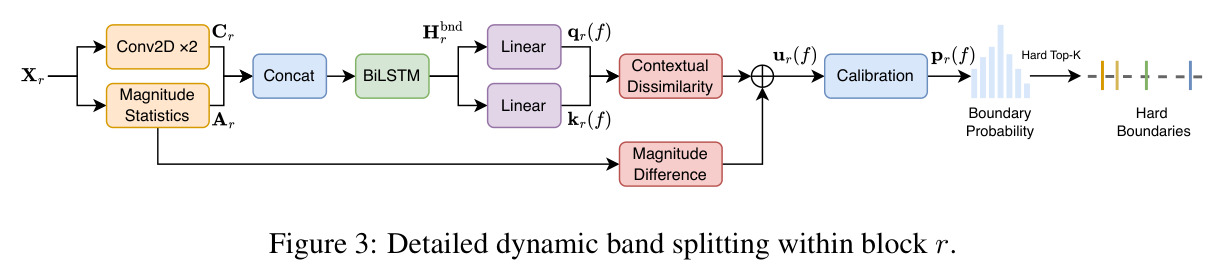
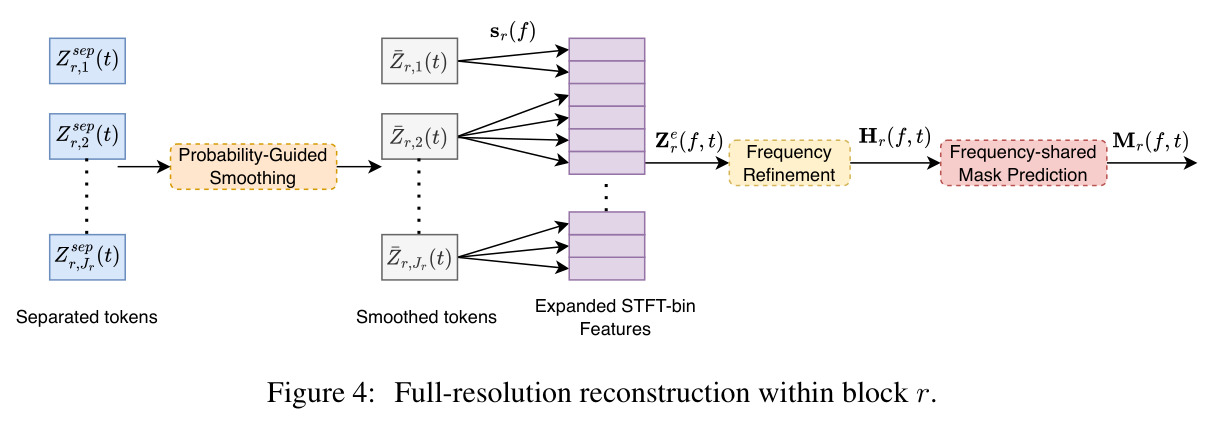
完整流程分四步。第一步,边界预测:对每块复数谱,两层 3×3 卷积(时间轴共下采样 4 倍)提取上下文特征,同时计算每频点三个幅度统计(时间均值、峰值/均值比、标准差/均值比,均经 log 压缩),BiLSTM 融合为上下文向量 $h_r(f)$;相邻频点得分 $u_r(f) = u^{feat}_r(f) + 0.15\, u^{mag}_r(f)$,前者是相邻频点表示的余弦不相似度 $(1 - q^\top k)/2$,后者是幅度统计差经 tanh 有界化;再经可学习的 $\tau_r$ 与 $\beta_r(f)$ 校准为概率 $p_r(f) = \sigma(\tau_r (u_r(f) - 0.5) + \beta_r(f))$。第二步,划分构建:块首频点强制为边界,Hard Top-K 在其余候选中选出 $J_r - 1$ 个位置,累计计数 $s_r(f) = \sum_{i \le f} b_r(i)$ 把每个频点指派到频带。第三步,token 化与分离:每频点编码为 $D$ 维特征,学习打分经带内 softmax 归一化得池化权重 $\alpha_{r,j}(f)$,加权池化 $Z_{r,j}(t) = \sum_{f \in \mathcal{S}_{r,j}} \alpha_{r,j}(f) U_r(f,t)$ 使每带每帧输出一个 token,按频率顺序拼接后送入保留原有时间/跨带建模核心的骨干网络。第四步,重构:按带内平均概率递归平滑 $\bar{Z}_{r,j} = \bar{p}_{r,j} Z^{sep}_{r,j} + (1 - \bar{p}_{r,j}) \bar{Z}_{r,j-1}$,按硬分配扩展到每个频点,经频率方向 depthwise + pointwise 残差块精炼,最后由频率共享头输出门控实/虚掩码并做多源一致性投影,$\hat{S}_k = X \odot M_k$ 经逆 STFT 输出波形。训练用 $\mathcal{L} = \mathcal{L}_{sep} + \lambda_{ratio} \mathcal{L}_{ratio}$,密度正则控制软边界概率的稀疏度。
技术新颖性
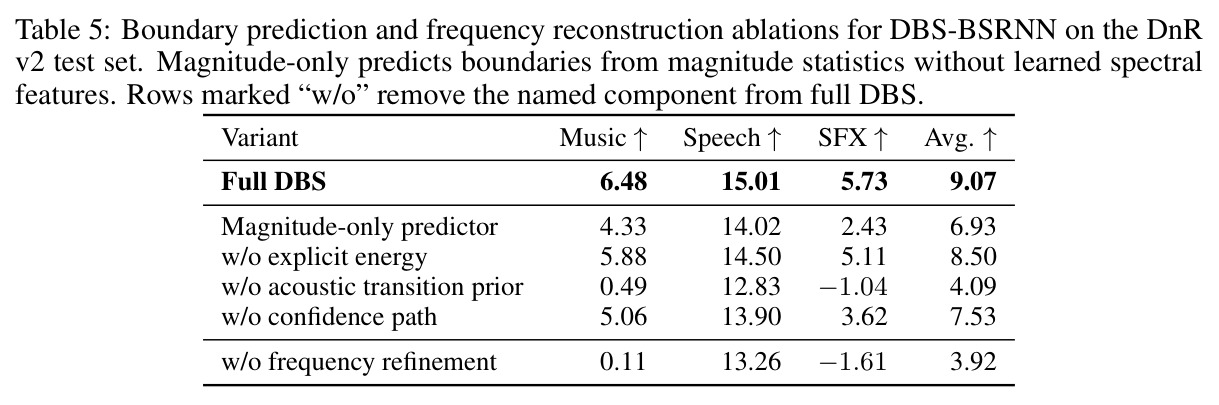
技术新颖性体现在三点。第一,「移动边界而非改变表示」:可学习滤波器组修改波形域前端(论文证明其前端重构 SNR 低至 -42.5 dB,且滤波器顺序与物理频率错乱,80 处相邻索引峰值反转超过 1 kHz,与频带有序建模假设冲突);SFC 则直接把频带编码器替换为序列模型;DBS 完全保留有序频带接口与 STFT 网格,只重排池化的分组方式,因此能近乎零改动地接入四种骨干。第二,「块结构 + 固定预算」约束下的离散路由:Hard Top-K 保证每块恰有 $J_r$ 个频带,块结构保证谱的每个区域都有保底预算——单块变体会把边界全堆在低频、高频几乎不分带,平均 SI-SDR 掉到 6.30 dB,这是对离散决策可行性的关键设计。第三,双通路代理梯度加密度正则的组合:既有 STE 局部插值提供的特征差梯度,又有不污染前向输出的置信度梯度,消融显示去掉声学过渡先验掉 4.98 dB、去掉置信度路径掉 1.54 dB,证明两个梯度通路与统计先验各有不可替代的作用。
实验结果
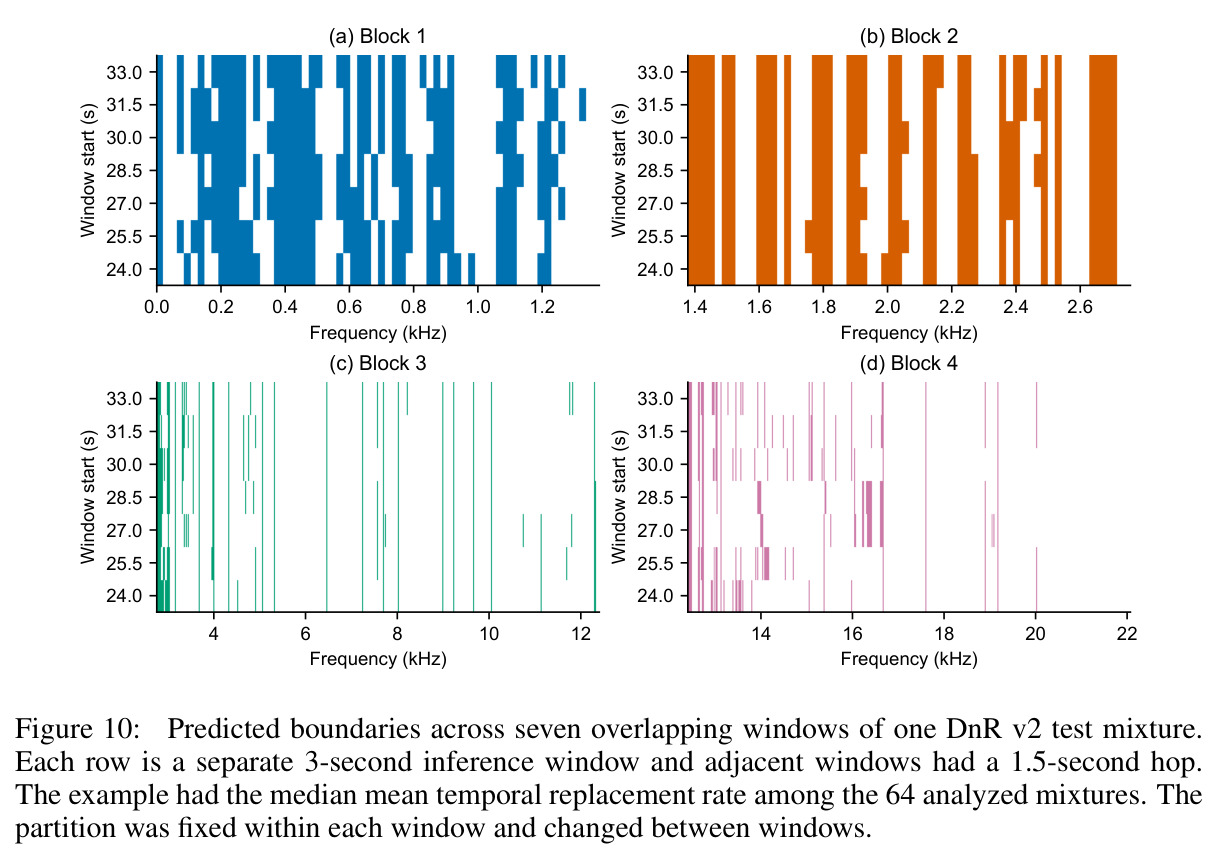
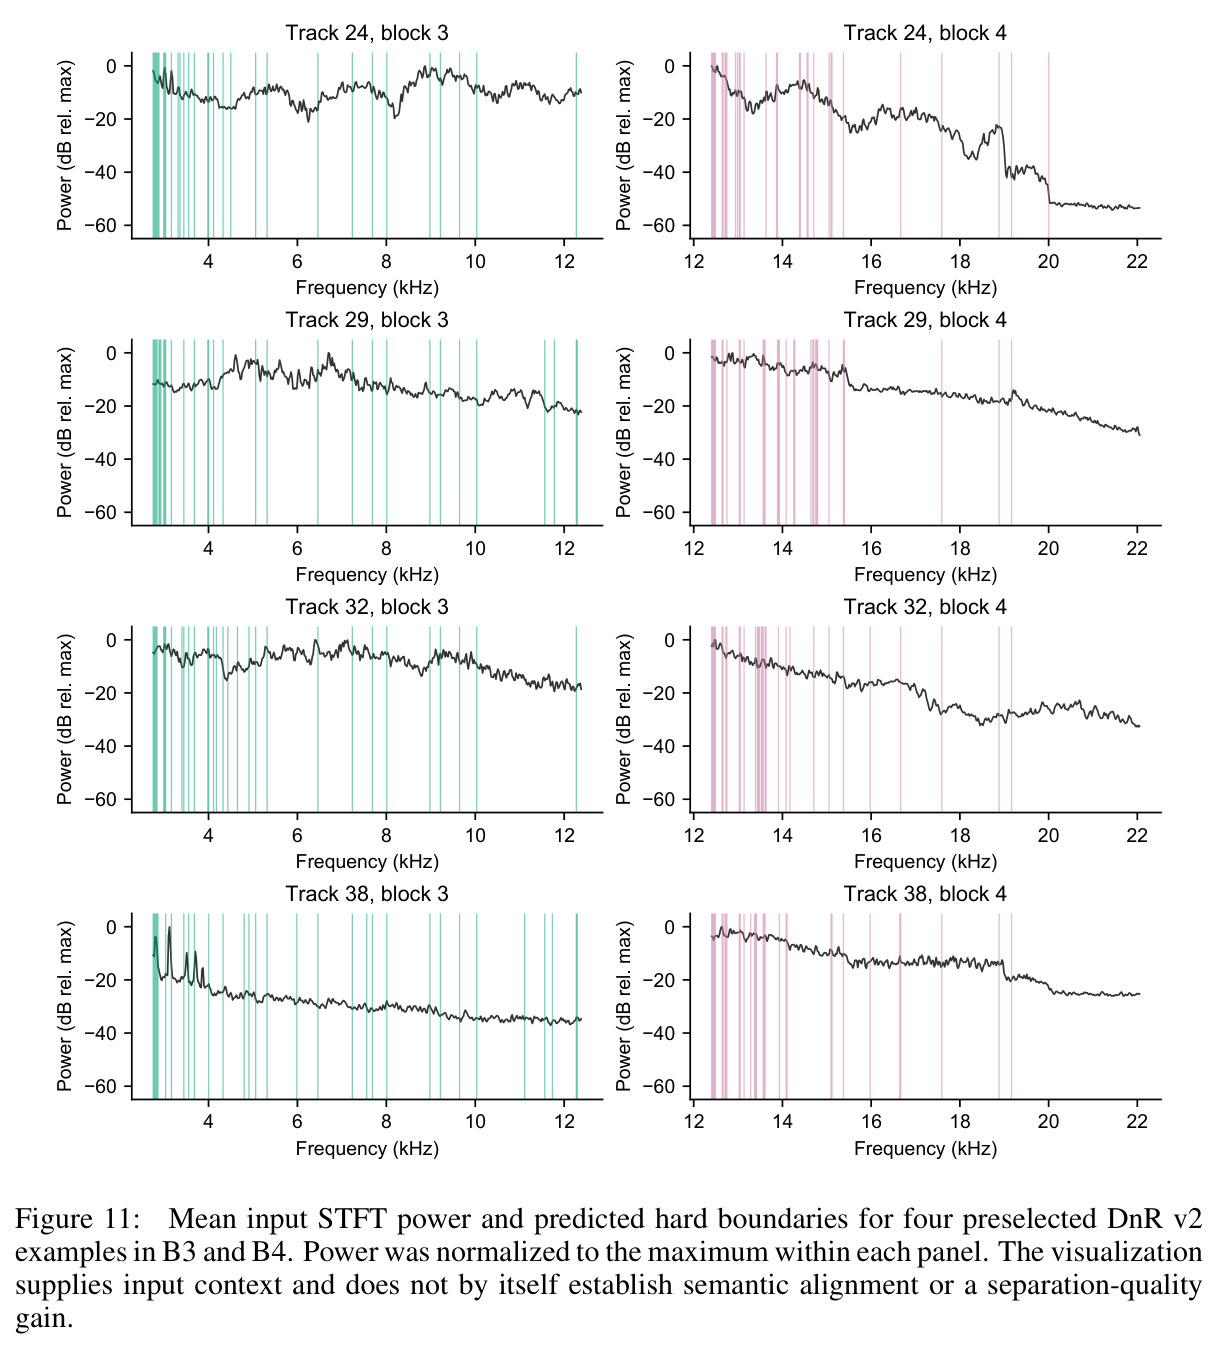
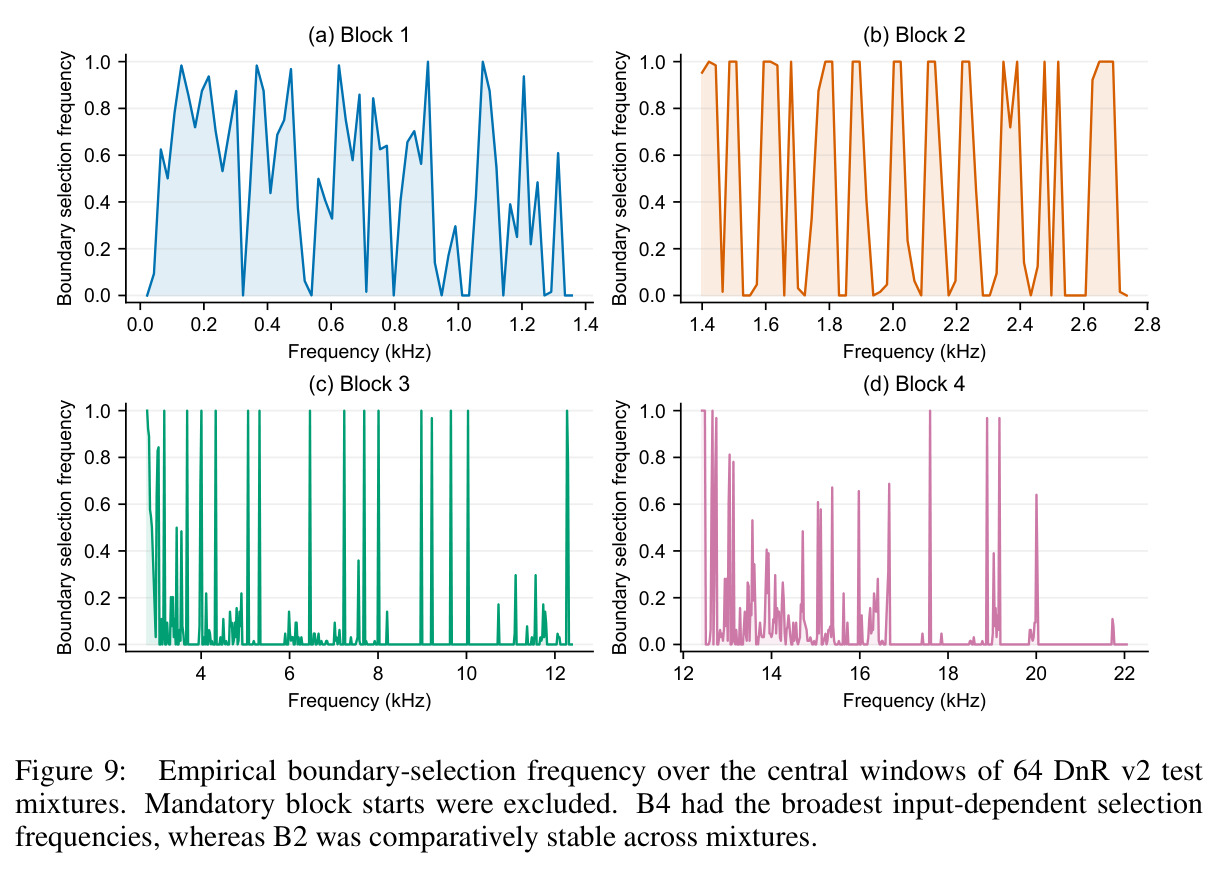
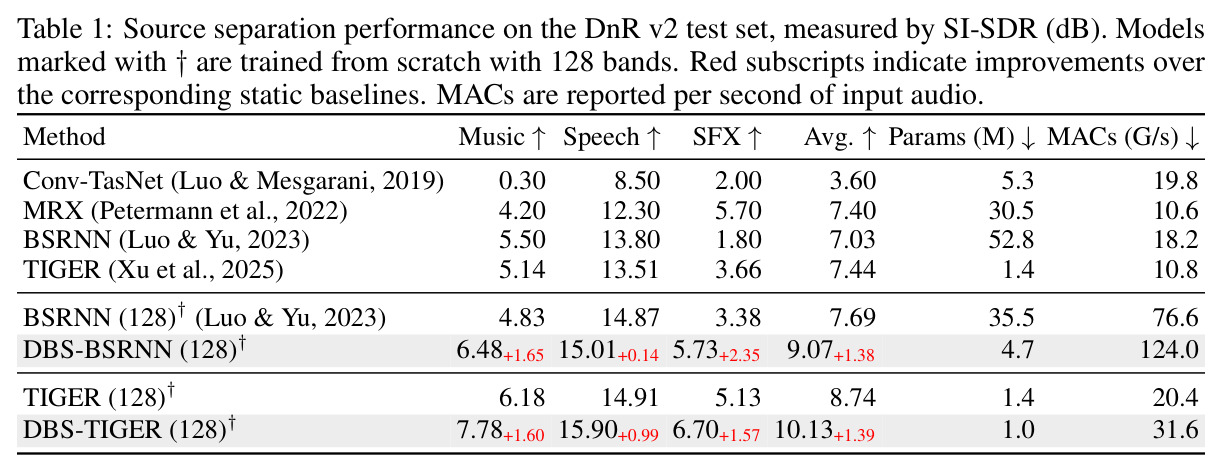
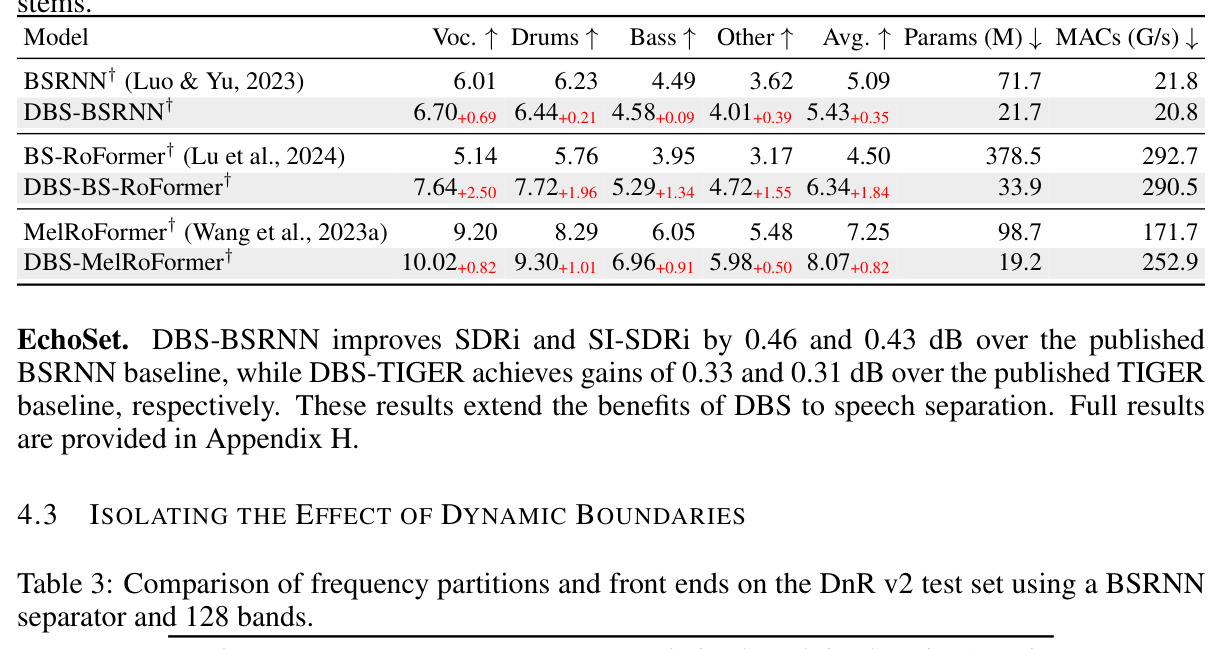
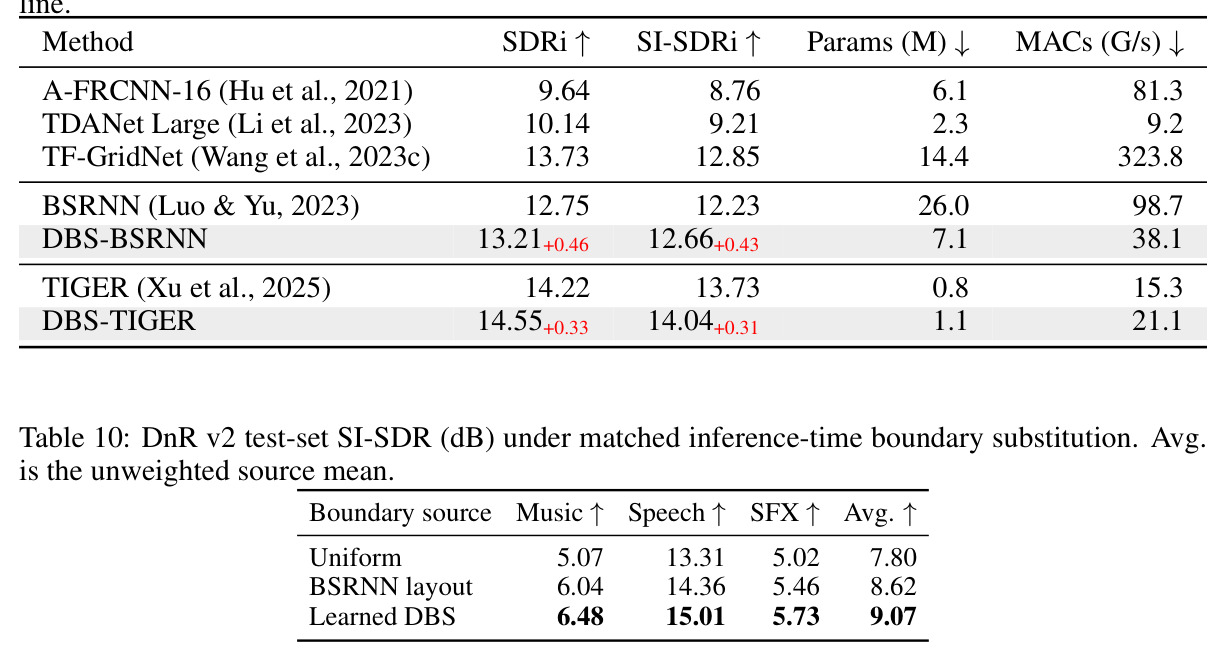
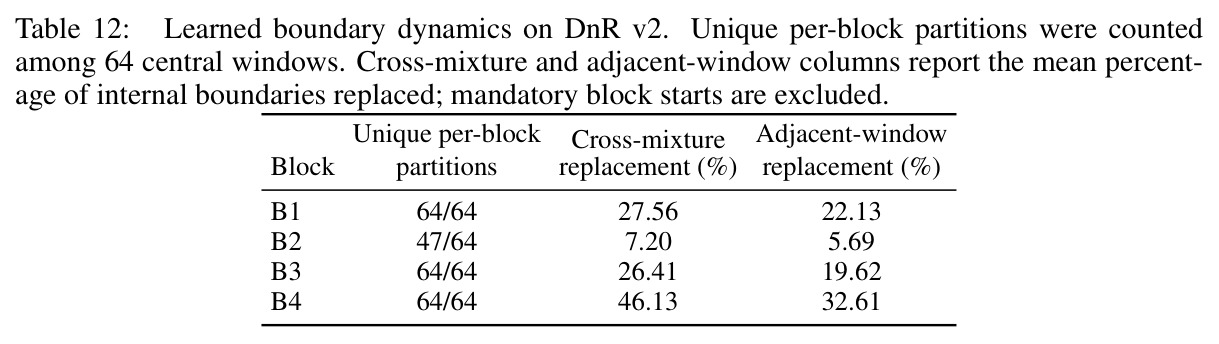
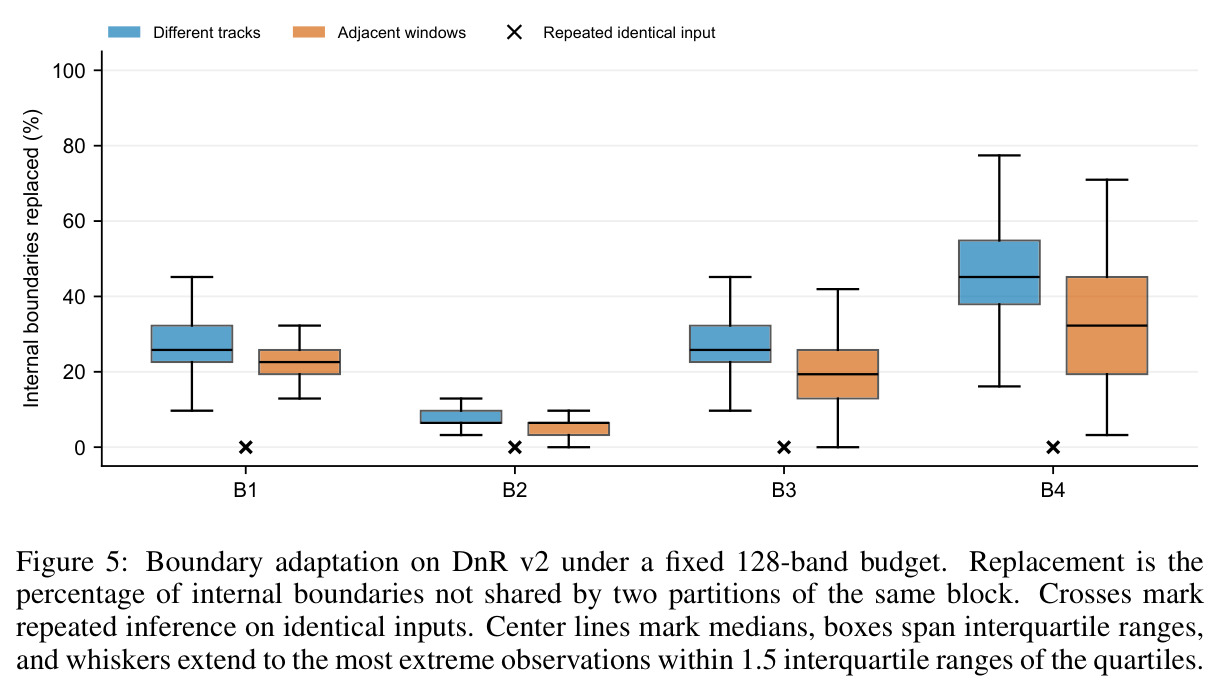
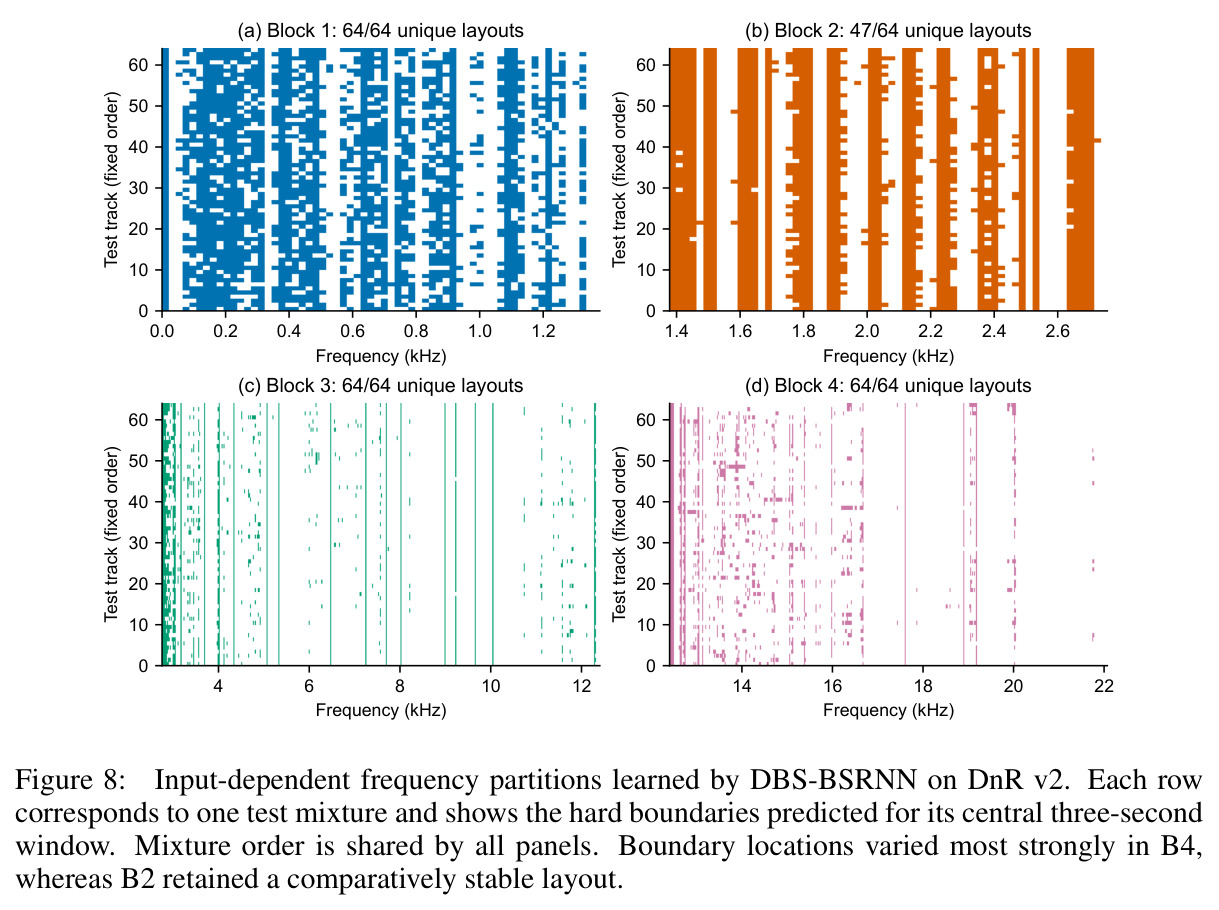
核心结果分四组。(1) DnR v2(SI-SDR,dB):128 频带下 DBS-BSRNN 从静态版 7.69 提到 9.07(+1.38),相对已发表 BSRNN 的 7.03 达 29.0% 相对增益,SFX 提升最大(3.38→5.73,+2.35),Music +1.65,Speech +0.14;DBS-TIGER 从 8.74 到 10.13(+1.39),三源全面超越;DBS-BSRNN 参数从 35.5M 降到 4.7M。(2) MUSDB18-HQ(单模型四轨 SDR,无外部数据):DBS-BSRNN 5.09→5.43,DBS-BS-RoFormer 4.50→6.34(+1.84,最大增益),DBS-MelRoFormer 7.25→8.07(+0.82),参数量均大幅下降(如 378.5M→33.9M)。(3) EchoSet:DBS-BSRNN 相对已发表 BSRNN 提升 SDRi 0.46 dB(12.75→13.21)、SI-SDRi 0.43 dB,计算量从 98.7 降到 38.1 G/s;DBS-TIGER 超已发表 TIGER 0.33/0.31 dB。(4) 归因与消融:同架构同训练下 DBS 比均匀划分高 1.07 dB(9.07 vs 8.00),Mel 频带仅 5.87,可学习滤波器组 -11.72;推理时把已训练模型的边界换成 BSRNN/均匀布局掉到 8.62/7.80,证明增益来自边界位置本身;64 个测试混合物的划分全部互不相同,跨混合物边界替换率 B1–B4 为 27.56%/7.20%/26.41%/46.13%,相邻窗口亦在移动,重复推理完全确定;块数 4→1 掉 2.77 dB,仅用幅度统计掉 2.14 dB,去掉过渡先验掉 4.98 dB,去掉置信度路径掉 1.54 dB,去掉频率精炼掉 5.15 dB。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DnR v2 三源分离(电影音轨:音乐/语音/音效) | 平均 SI-SDR (dB) | DBS-BSRNN(128 频带)9.07 | 静态 BSRNN(128 频带)7.69;已发表 BSRNN 7.03 | +1.38 dB(相对已发表 BSRNN 为 +29.0%);DBS-TIGER 亦 +1.39 dB(8.74→10.13) |
| MUSDB18-HQ 四轨音乐分离(单模型、无外部数据) | 平均 SDR (dB) | DBS-BS-RoFormer 6.34 | 静态 BS-RoFormer 4.50 | +1.84 dB;另 DBS-BSRNN +0.35(5.09→5.43)、DBS-MelRoFormer +0.82(7.25→8.07) |
| EchoSet 双说话人语音分离(含噪声与混响) | SDRi (dB) | DBS-TIGER 14.55;DBS-BSRNN 13.21 | 已发表 TIGER 14.22;BSRNN 12.75 | +0.33 / +0.46 dB(SI-SDRi 分别 +0.31 / +0.43) |
| DnR v2 划分方式对照(同架构同训练、128 频带) | 平均 SI-SDR (dB) | DBS 9.07 | 均匀划分 8.00;Mel 频带 5.87;可学习滤波器组 -11.72 | +1.07 dB(vs 均匀划分) |
| DnR v2 推理时边界替换(同一已训练模型) | 平均 SI-SDR (dB) | 学习到的边界 9.07 | BSRNN 固定布局 8.62;均匀布局 7.80 | +0.45 / +1.27 dB |
局限与改进
作者承认两点局限:其一,频带数固定,不随输入调整表示规模——预实验中可学习频带数的变体总是选每块允许的最大预算,说明可变预算路由需要显式复杂度约束;其二,每个推理窗口(3 秒)只预测一个划分,窗口内部边界不随时间变化,时间自适应停留在窗口级而非帧级。我的补充观察:第一,DnR v2 上 DBS-BSRNN 的计算量反而从 76.6 升到 124.0 G MACs/s(DBS-TIGER 从 20.4 到 31.6),参数减少与计算增加并存,「更省算力」的叙事在部分配置下不成立;第二,MUSDB 上 DBS-MelRoFormer 替换的是完整频带接口(重叠 Mel 滤波器 vs 128 频带网格),与静态对照的差异并非纯粹来自边界移动,作者在附录 F.2 亦承认;第三,块数与每块预算(如 EchoSet 的 40/10/8/9)是手工超参,跨采样率、跨数据集需重新调整;第四,边界与谐波结构的对齐只是可视化观察,缺乏定量因果分析;第五,未评估流式/低延迟场景下边界预测的开销与稳定性。
独立分析的弱点
独立分析四个弱点。其一,窗口级静态划分与内容动态性错配:一个 3 秒窗口内若先出现语音后出现鼓点,单一划分只能折中。改进方向是引入帧级或分段级边界调整(如相邻窗口边界热启动与插值),或让池化权重随帧变化。其二,可变预算完全缺失:谱结构密集的片段可能需要超过每块 32 个频带,稀疏片段的预算却被浪费;作者已观察到无约束变体贪心选最大预算的失败,改进方向是给可变频带数加显式率失真或 FLOPs 惩罚,或借鉴 MoE 的容量因子与负载均衡损失。其三,推理开销的再分配不透明:DnR v2 上 MACs 增加 62%(76.6→124.0 G/s),主要来自扩展后全分辨率的精炼与掩码预测;对资源受限场景应提供频带数-性能帕累托曲线,并探索低秩或稀疏精炼块。其四,评估协议的非对称性:MUSDB 上静态 MelRoFormer 保留重叠 Mel 滤波器而 DBS 版换成 128 频带网格,混淆了「接口替换」与「动态边界」两个因素;应补一个「静态 128 频带 + 相同内容池化/解码器」的对照(类似 DnR v2 上 Table 3 的做法),把增益唯一归因到边界移动。此外,边界预测器的 BiLSTM 逐频点处理在长窗口下可能成为推理瓶颈,值得做复杂度剖析。
未来方向
作者提出的方向:把固定预算放松为可控的可变预算,引入显式复杂度约束让模型学会「按需分配」频带数,这与其预实验中贪心选最大预算的失败观察直接相关。基于成果可延伸的方向:第一,时间维度自适应——让划分在窗口内随内容演化,或用低延迟流式边界更新适配助听器、实时混音等在线场景;第二,把 DBS 接口移植到更多骨干(如 TF-GridNet、Demucs 类编解码器)乃至多通道阵列输入,检验普适性;第三,边界的语义解释——目前只显示边界与谱形状共现,可与音符/元音边界标注对照,定量分析边界是否落在谐波结构或共振峰变化处;第四,与 SFC 类输入自适应压缩结合,让「如何分组」与「每带表示容量」同时自适应;第五,在 MUSDB18-HQ 上引入外部训练数据,检验动态划分在大规模训练、更大模型下是否仍保持增益,并探索与蒸馏结合把动态边界固化成少数几个静态布局以利部署。
复现评估
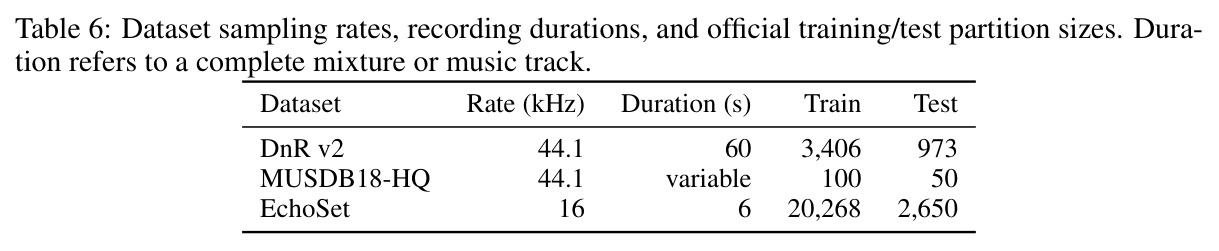
复现条件较好。代码与音频样例已放出(项目页 https://cslikai.cn/Dynamic-Band-Splitting),三个数据集全部公开:DnR v2(3406 训练/487 验证/973 测试,60 秒 44.1 kHz)、MUSDB18-HQ(100/50 首完整歌曲)、EchoSet(20268/4604/2650 条 6 秒 16 kHz)。训练硬件为 8×RTX 5090:DnR v2 与 EchoSet 用 3 秒片段、每卡 batch 4、Adam 初始学习率 1e-3;MUSDB 用 11 秒或 8 秒片段、每卡 batch 1、学习率 1e-5,并复用 Music-Source-Separation-Training 框架的公开四轨配置。损失函数(SI-SDR、时频 MAE、PIT)、STE 与置信度路径细节、密度正则权重($\lambda_{ratio}$=0.01,EchoSet 从 0 暖启到 0.02)、块端点与每块预算(附录 F.2)都写得相当具体。主要门槛:多数据集多骨干的训练总量不小,单卡复现需按比例缩减;Hard Top-K + STE 的实现细节(如块首频点 logit 置 10、无效索引回退)需照附录逐条对齐。总体属于中等难度,熟悉 band-split 代码库的工程师一至两周可跑通单数据集验证。
论文图表