DeltaTTG:用 Token-to-Go 进度计量表训练多轮智能体 DeltaTTG: Training Multi-Turn Agents with a Token-to-Go Progress Meter
以剩余待生成token数为进度信号,在多轮RL中实现步级信用重分配
前置知识
GRPO(组相对策略优化)
一种无需批评家(critic-free)的在线强化学习算法:对同一任务用当前策略采样 $G$ 条轨迹,以组内奖励的均值 $\mu$ 和标准差 $\sigma$ 归一化每条轨迹回报,得到相对优势 $A_i = (R_i - \mu)/(\sigma + \epsilon)$,再用 PPO 风格的裁剪代理目标更新策略。省去训练价值网络的开销,是 DeepSeek-R1 等推理模型的主流训练算法。
本文以 GRPO 为最重要的基线和骨干算法,DeltaTTG 只改写其优势在各 token 上的分配方式而不动奖励与损失结构,不理解 GRPO 就看不出它到底改了什么、省了什么。
稀疏奖励与信用分配
多轮智能体任务通常只在整条轨迹结束时给一个可验证的成败信号(任务是否完成),中间几十步决策没有任何反馈,这就是稀疏且延迟的奖励。信用分配(credit assignment)研究如何把这个终端信号拆到各个中间动作上,判断哪些步骤真正促进或损害了最终结果。
DeltaTTG 的全部动机就是解决稀疏奖励下的步级信用分配:终端奖励'说不出哪一步帮了忙',论文的计量表、$\Delta$ 信号、符号感知分配都是围绕这一痛点设计的。
优势函数与裁剪代理损失
优势 $A$ 衡量某动作相对平均水平的好坏,策略梯度按 $\nabla \log \pi \cdot A$ 更新。PPO/GRPO 用新旧策略比率 $r = \pi_\theta/\pi_{old}$ 的裁剪代理损失把单次更新限制在信任域内,防止策略崩坏。损失最终把轨迹优势广播到每个 token 上。
DeltaTTG 的核心操作是'不改方向、只改步内权重':保留 $A_i$ 的符号与 token 平均尺度,只为每个动作配权重 $w_{i,t}$,需要懂 token 级优势广播才能读懂公式 (11)。
过程奖励模型与过程监督
与只看最终答案的结果奖励相对,过程监督对推理或交互的中间步骤直接打分,信号可来自人工标注、外部强模型评审、验证器反馈或任务特定启发式(信息增益、里程碑等)。它在数学推理中已证明有效,但标注昂贵、评审模型有偏、启发式难以跨任务复用。
DeltaTTG 属于过程监督一族,但用'剩余完成工作量'这一可观测、可从录制轨迹免费提取的量替代人工评分,对照 PRM 才能理解它的低成本卖点。
多轮工具调用智能体与 RLVR
ReAct 等范式让 LLM 在'思考→调用工具→观察结果→再决策'的循环中完成任务,如查搜索引擎、操作家庭环境、调用 API。训练这类智能体常用带可验证奖励的强化学习(RLVR):以最终任务成败作为可验证奖励,在真实或模拟环境中做完整 rollout 后更新策略。
论文实验全部在 ALFWorld(交互决策)、PaperSearchQA(检索问答)、BFCLv3(函数调用)这类多轮环境中进行,熟悉该设定才能读懂基准、指标和基线比较。
研究动机
把 LLM 训练成多轮智能体(搜索、工具调用、家庭任务)普遍采用带可验证奖励的强化学习(RLVR),但环境只在整条轨迹结束后给出一个稀疏且延迟的终端信号,说不清哪些具体步骤帮了忙,步级信用分配非常困难。现有补丁分两类且各有硬伤:其一是在同一 rollout 组内做状态匹配的步间比较(GiGPO、HGPO),但开放式交互中精确状态匹配很少、相似状态可能隐含不同的决策相关条件,采样结果多样性不足和后续决策的混淆会进一步污染局部比较;其二是直接给步骤打分,需要昂贵的外部评判模型、人工步骤标注或任务特定启发式(如信息增益、里程碑)。学一个价值模型看似自然,但稀疏奖励下许多状态共享同一个回报目标,价值估计被'压平',且它绑定于生成其训练数据的那个 actor,难以复用。
本文的目标是本文要回答的问题是:能否从普通智能体的录制轨迹中学到一个可复用的进度信号,使其能在当前 rollout 组的证据之外评价每一个动作?具体目标包括:找到一个可观测、零额外标注成本、不依赖任务特定规则的监督目标,训练出跨模型家族、跨参数规模共享的进度计量表;然后在 actor 训练时冻结该计量表,用它对相邻状态估计值的变化把轨迹级结果优势重新分配到各步骤上,在不改变奖励、不显著增加算力的前提下缓解稀疏奖励问题;最终让智能体在 ALFWorld、PaperSearchQA、BFCLv3 上稳定超过 GRPO、DAPO、GiGPO、HGPO 等强基线,同时保持接近 GRPO 的训练成本并改善样本效率与域外泛化。
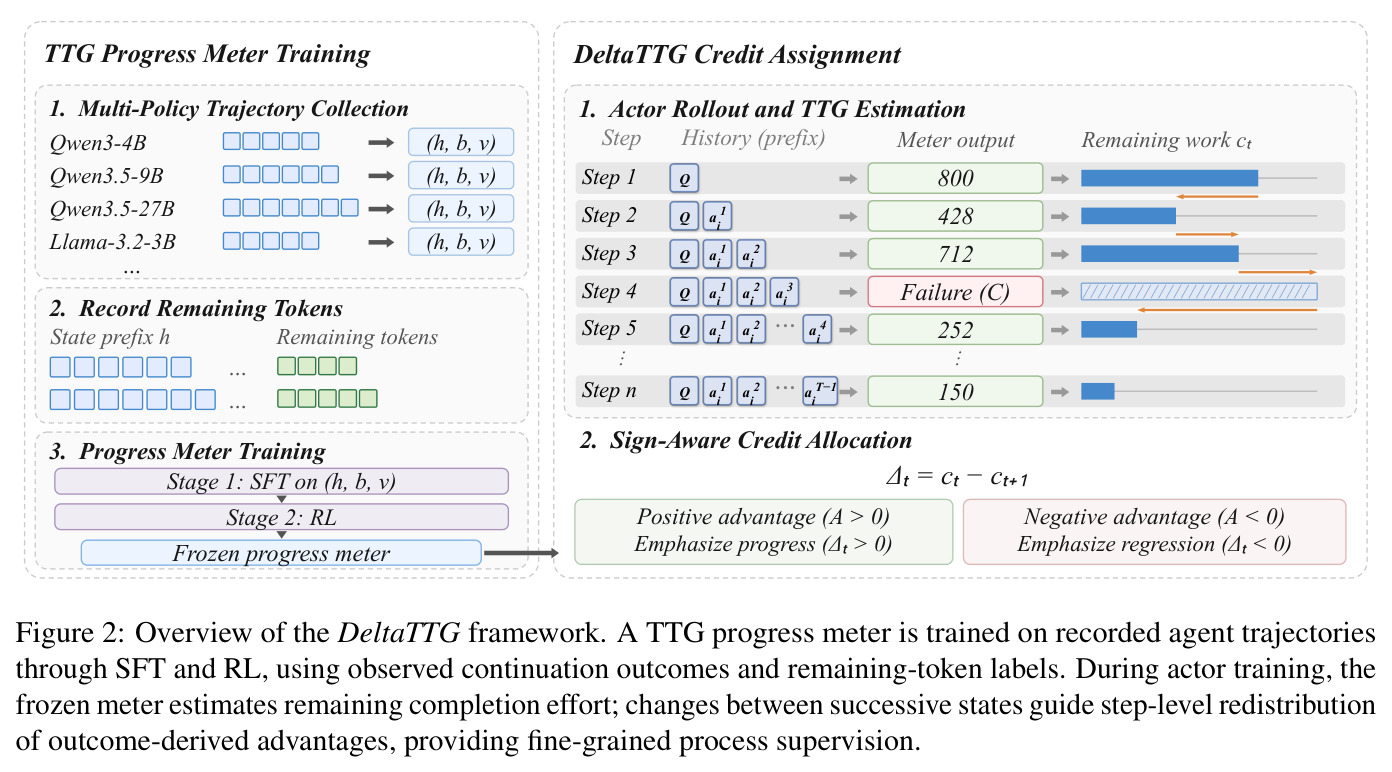
与已有工作不同的是,独特切入在于把'剩余完成工作量'当作任务进度的代理:作者提出 Token-to-Go(TTG)——从当前状态到任务成功还需生成的 assistant token 数(含推理、工具调用与最终回答,环境观察不计入)。关键洞察是:虽然剩余 token 用量随模型风格和交互框架波动,但在大量轨迹上平均来看,同一状态下的有益动作比有害动作留下更少的剩余工作(例如每创建一张工单就消耗掉一部分剩余工作),而失败续写会被赋予很大的剩余成本。TTG 标签从已有录制轨迹中零成本提取,且把不同家族、不同规模策略(Qwen3-4B、Qwen3.5-9B、Qwen3.5-27B、Llama-3.2-3B)的轨迹混池训练,得到的是共享估计而非某个 actor 的行为偏好——这与绑定单 actor 的价值模型、依赖同状态分组的 GiGPO/HGPO、需要外部评审的 PRM 都有本质区别。
核心方法
直觉上,若把任务比作一段路程,TTG 就是'还剩多少米'。训练好的进度计量表读入历史 $h$,输出结构化答案 $(\hat{b}, \hat{v})$:$\hat{b}$ 是能否完成的二元估计,$\hat{v}$ 是非负的剩余 token 预测。技术路线分两阶段。第一阶段训练计量表:从多个策略的录制轨迹中按 assistant 动作边界切出前缀-后缀对,成功轨迹的前缀获得 TTG 标签 $TTG_{i,t} = \sum_{u=t}^{T^{ref}_i - 1} n^{ref}_{i,u}$,失败轨迹标为不可完成;先做 SFT 教会输出格式,再用 GRPO 以预测奖励精修估计。第二阶段信用分配:actor 训练时冻结计量表,对每组 rollout 的每个决策历史批量评分得到剩余成本 $c_{i,t}$,用相邻状态之差 $\Delta_{i,t} = c_{i,t} - c_{i,t+1}$ 度量估计进度(正为推进、负为倒退),再按轨迹优势的符号做符号感知的权重分配,把 GRPO 轨迹优势广播为带权重的 token 级优势,代入裁剪损失更新 actor。奖励与轨迹优势本身均不被修改。
核心创新是'结果优势不变、只重新分配步内权重':轨迹优势 $A_i$ 仍由 GRPO 组内归一化得到,决定更新方向;DeltaTTG 只改优势在各 token 上的分布。当 $A_i > 0$ 时给有进度的步骤更多正权重 $m_{i,t} = \max(\Delta_{i,t}, 0)$;当 $A_i < 0$ 时给倒退的步骤更大负权重 $m_{i,t} = \max(-\Delta_{i,t}, 0)$,即'好消息放大进步、坏消息放大倒退'的符号感知反转。步权 $q_{i,t} = \rho/T_i + (1-\rho)\, m_{i,t}/\sum_s m_{i,s}$ 与均匀份额混合($\rho = 0.2$)以降低估计误差敏感性,再经 BM 算子按 token 数归一化到单位均值、把单 token 乘子截断在 $M = 5$,得到 $\tilde{A}_{i,t,k} = A_i \cdot [BM(\{q\};\{n\})]_t$。这既保留每条轨迹的优势符号与 token 平均尺度,又注入了超越当前 rollout 组的步级信息,且不需要配对同状态样本或外部过程奖励。
方法步骤详情
第一步,多策略轨迹收集:用 Qwen3-4B、Qwen3.5-9B/27B、Llama-3.2-3B 等策略录制各域轨迹,文本交互、信息检索、复杂工程三域各训一个计量表(从 Qwen3-4B-Instruct-2507 初始化)。第二步,构造监督:前缀 $h$ 配标签 $(b, v)$,成功轨迹 $b=1$、$v = TTG_{i,t}$(剩余 assistant 生成 token 数),失败轨迹 $b=0$、$v=null$。第三步,SFT:以答案 token 负对数似然 $\mathcal{L}_{SFT} = -\mathbb{E}[\log p_\phi(y_j|h, y_{<j})]$ 训练输出格式与初始映射。第四步,RL 精修:对标注前缀采样答案,正确成功预测给 $0.2 + 0.8u(\hat{v}, v)$($u$ 为剩余 token 相对精度),正确失败预测给 1,其余给 -1,GRPO 更新后冻结。第五步,信用分配:actor rollout 后冻结计量表给决策历史打分得 $c_{i,t}$(失败估计记大常数 $C$,终端成功为 0),计算 $\Delta_{i,t}$,经符号感知分配、均匀混合($\rho=0.2$)、BM 归一化(乘子上限 $M=5$)得加权优势,代入非对称裁剪($\eta_{low}=0.2$、$\eta_{high}=0.28$、双重裁剪 $d=3$)损失更新 actor。
技术新颖性
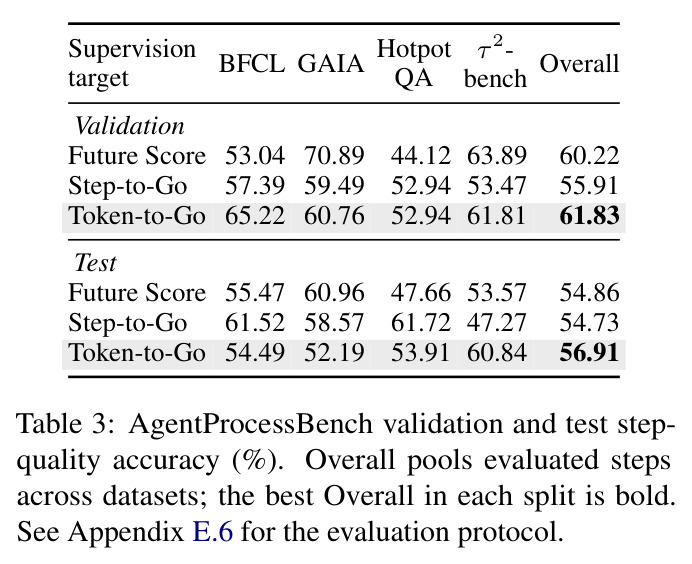
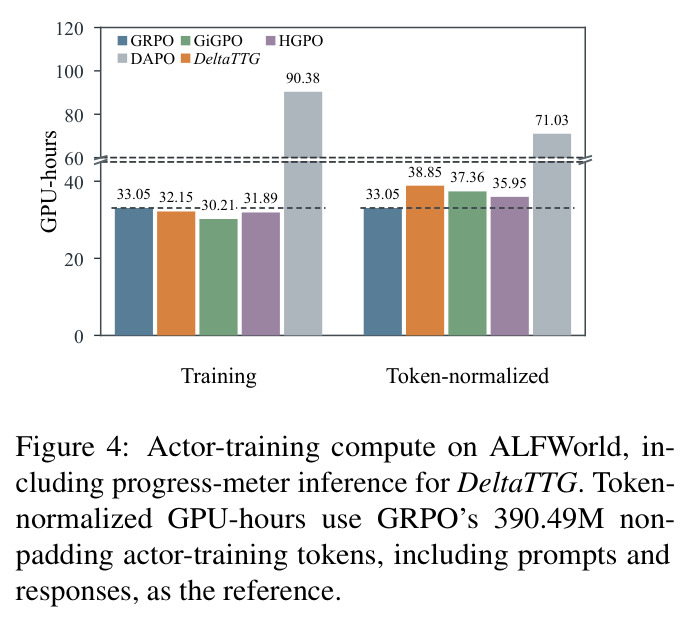
新颖性有四点。其一,监督目标本身:TTG 把'剩余完成工作量'从 BAGEN 式的推理预算控制移植为任务进度的可观测量,标签从录制轨迹免费获得,绕开了 PRM 的人工标注、外部评审与任务启发式,实验证明它比未来得分(Future Score)和剩余步数(Step-to-Go)更利于区分步骤质量。其二,跨策略共享:混池不同家族、规模、能力水平策略的轨迹训练,得到域级共享计量表——一个 ALFWorld 计量表(RL 训练约 10.45 GPU 小时)同时服务 Qwen3-4B 和 Llama-3.1-8B 两个 actor 而无需重训,甚至能跨域迁移去指导 PaperSearchQA 的训练。其三,定位为优势重分配器而非奖励:计量表不改环境奖励、不进损失项,只在优势广播时改权重,保持了 GRPO 的稳定结构,使 actor 训练成本几乎不变(35.95 对 GRPO 的 33.05 GPU 小时)。其四,训练与推理共用:同一冻结计量表还能在测试时指导动作选择,证明其学到的是真实步骤质量信号而非训练期统计巧合。
实验结果
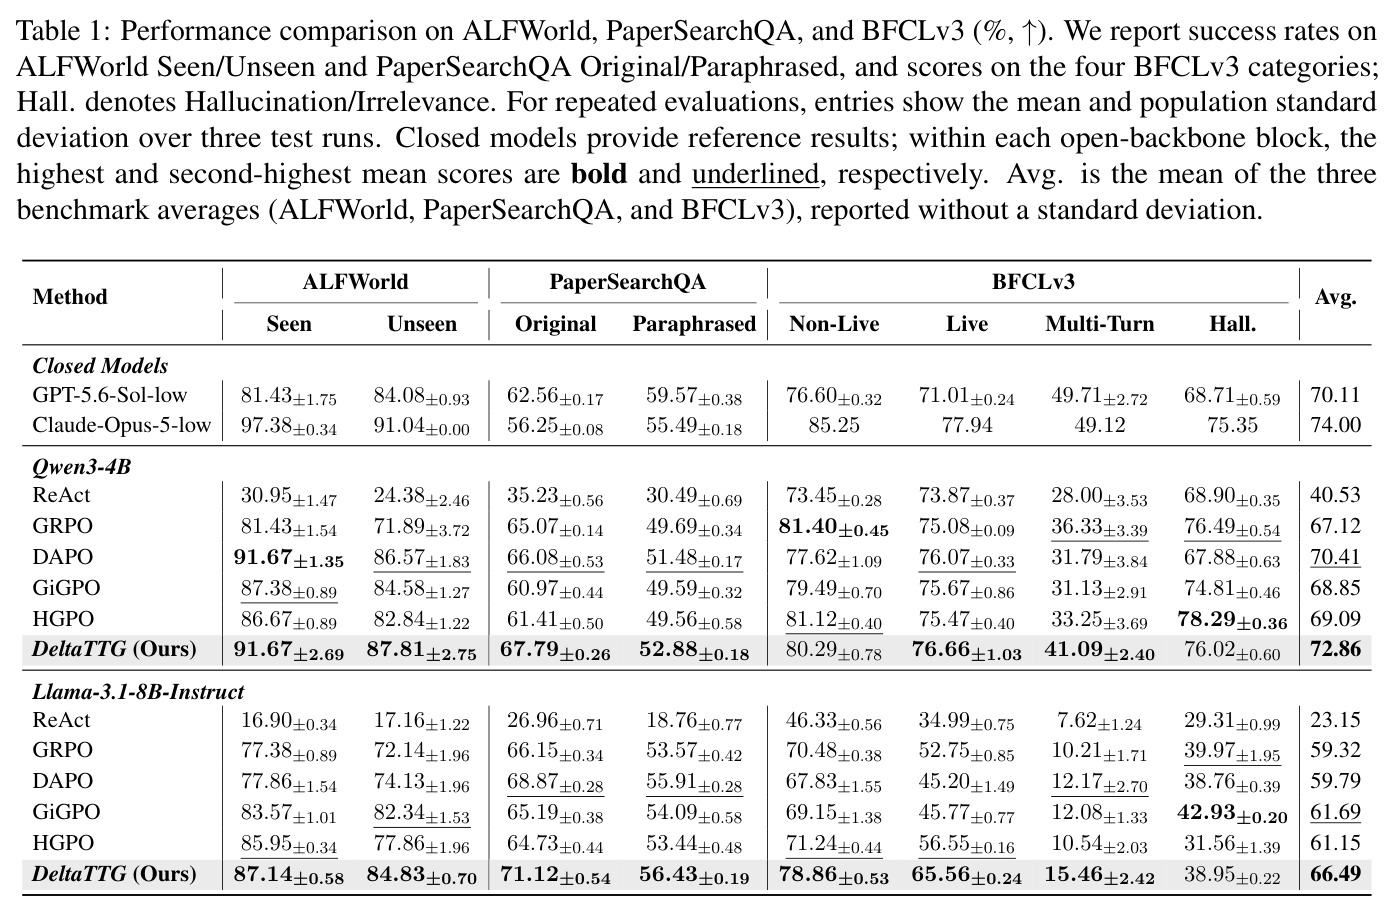
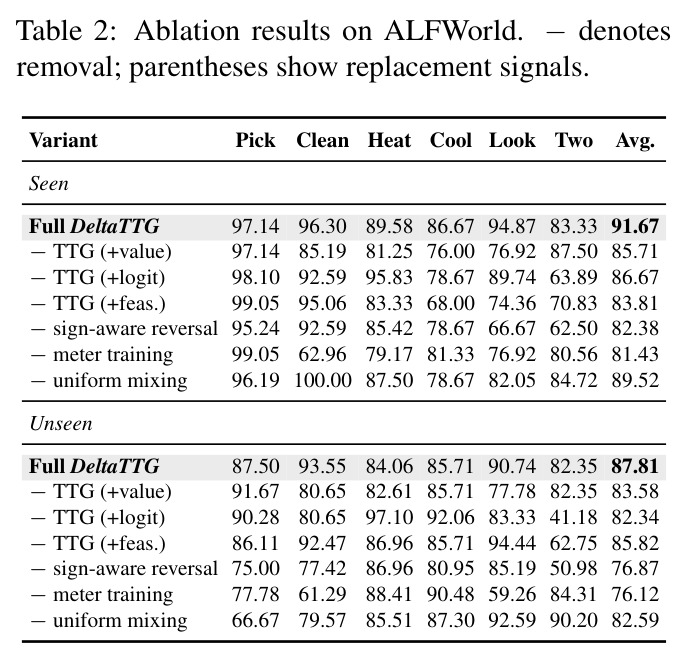
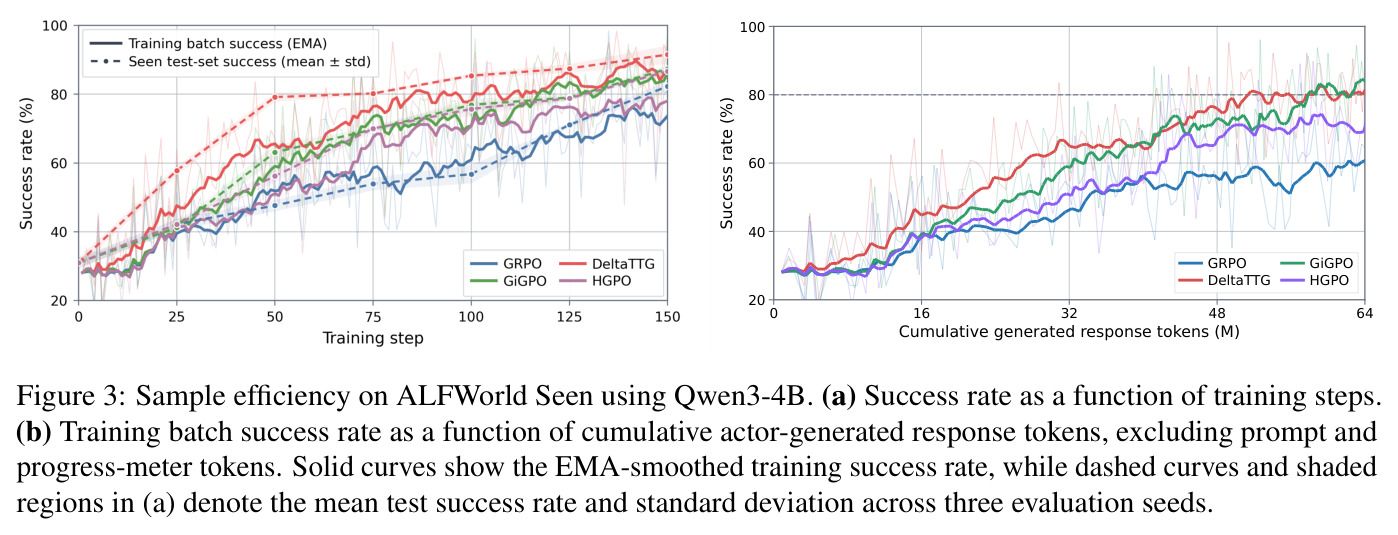
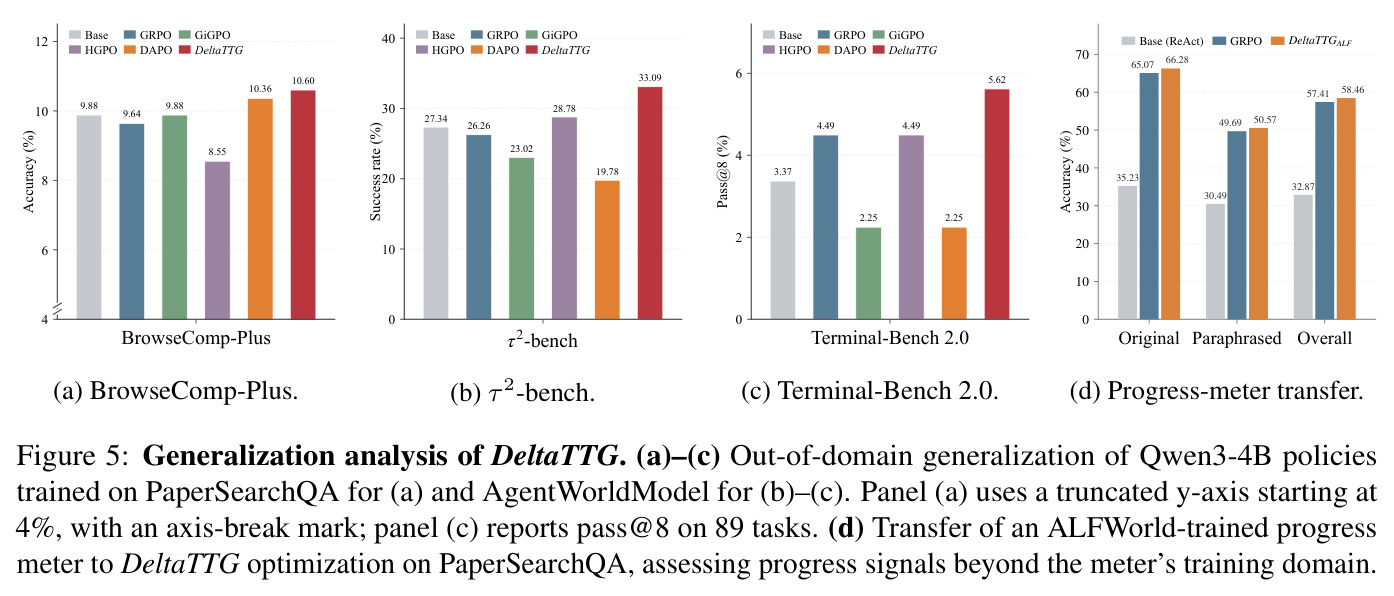
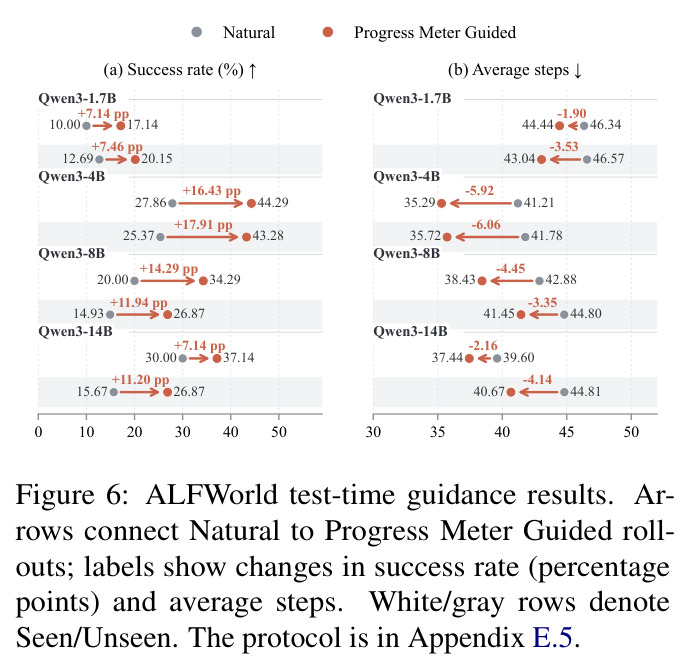
主实验用 Qwen3-4B 和 Llama-3.1-8B-Instruct 在 ALFWorld、PaperSearchQA、BFCLv3 上对比五个基线。Qwen3-4B 三基准平均 72.86,超最强基线 DAPO(70.41),比 GRPO(67.12)高 5.7 分;Llama 上 66.49,比 GRPO(59.32)高 7.2 分,超最强基线 GiGPO(61.69);16 个开放指标中 13 个最高。最大增益在 BFCLv3 工具调用:Qwen3-4B Multi-Turn 41.09(+4.8),Llama 上 Non-Live 78.86(+7.6)、Live 65.56(+9.0)。样本效率:ALFWorld Seen 达约 80% 成功率仅需约 75 步,GiGPO 需约 125 步;算力 35.95 GPU 小时接近 GRPO 的 33.05,DAPO 需 90.38(2.7 倍)。消融中去掉 meter 训练或符号感知反转伤害最大(Unseen 87.81→76.12/76.87)。计量表本身在 AgentProcessBench 步骤质量判别 Overall 61.83/56.91(验证/测试),高于 Future Score、Step-to-Go 和直接提示的 50.83%;测试时引导使 Qwen3-4B 成功率 27.86→44.29(+16.43pp),1.7B/8B/14B 分别 +7.14/+14.29/+7.14pp 且平均步数下降;ALFWorld 计量表迁移到 PaperSearchQA 训练仍超 GRPO(66.28 对 65.07);域外三基准均为对比方法最高。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ALFWorld Seen(Qwen3-4B) | 成功率 (%) | 91.67 | GRPO 81.43 / DAPO 91.67 | 较 GRPO +10.24,与最强基线 DAPO 持平但成本仅其约 40% |
| ALFWorld Unseen(Qwen3-4B) | 成功率 (%) | 87.81 | GRPO 71.89 / DAPO 86.57 | 较 GRPO +15.92,较最强基线 DAPO +1.24 |
| PaperSearchQA Original(Qwen3-4B) | 准确率 (%) | 67.79 | GRPO 65.07 / DAPO 66.08 | 较 GRPO +2.72,较最强基线 +1.71 |
| BFCLv3 Multi-Turn(Qwen3-4B) | 分数 (%) | 41.09 | GRPO 36.33 | +4.76(相对最强 RL 基线 +4.8) |
| BFCLv3 Live(Llama-3.1-8B-Instruct) | 分数 (%) | 65.56 | HGPO 56.55 | +9.01(论文报告 +9.0) |
| 三基准平均(Qwen3-4B / Llama-3.1-8B) | 平均分 (%) | 72.86 / 66.49 | GRPO 67.12 / 59.32;最强基线 DAPO 70.41、GiGPO 61.69 | 较 GRPO +5.74 / +7.17,较最强基线 +2.45 / +4.80 |
| ALFWorld Seen 训练效率(Qwen3-4B) | 达到约 80% 成功率的优化步数 / GPU 小时 | 约 75 步 / 35.95 GPU 时 | GiGPO 约 125 步;GRPO 33.05 GPU 时;DAPO 90.38 GPU 时 | 优化步数省约 40%;算力接近 GRPO,为 DAPO 的约 40% |
| 步骤质量判别(AgentProcessBench) | Overall 准确率 (%)(验证/测试) | 61.83 / 56.91 | Future Score 60.22/54.86;Step-to-Go 55.91/54.73;直接提示 50.83(测试) | 验证 +1.61、测试 +2.05(对最强替代监督目标) |
局限与改进
作者承认三点:评测只覆盖两个 actor 家族和若干域,更广的跨域迁移需进一步验证且可能需要适配;对失败成本常数 $C$ 的鲁棒性未建立——AgentWorldModel 审计显示仅 6.3%-10.5% 的成功轨迹含有受 $C$ 影响的转移(且只发生在完成估计在成败间翻转时),但仍缺乏系统的敏感性分析;报告的标准差来自同一 checkpoint 的三次重复评测而非独立训练种子,训练方差未被量化。我的补充观察:TTG 以 token 数为工作量单位,天然混入策略的'话多话少'风格差异,轨迹池若被某类风格主导会引入系统性偏差;BFCLv3 的 Hallucination/Irrelevance 上 DeltaTTG 在两个骨干都不如最强基线(Qwen3-4B 76.02 对 HGPO 的 78.29),提示进度导向的权重可能鼓励更激进的多轮工具使用从而增加无关输出;此外计量表每步需一次前向推理,长轨迹的墙钟时间会增加,论文只以 token 归一化口径论证成本可控。
独立分析的弱点
第一,TTG 把剩余 token 数当作工作量的唯一度量,混入了推理风格差异:同一状态下爱写长思维链的策略留下更大 TTG,进度信号可能被 verbosity 污染,改进方向是对 token 计数按策略归一化(如除以该策略的平均轨迹长度),或用动作数、环境步数等替代量做消融对比。第二,失败成本 $C$ 的处理较粗糙:失败状态与终端失败统一记 $C$,在失败率高的任务上正、负优势组内的 $\Delta$ 分布会被 $C$ 主导(尽管 $M=5$ 的乘子上限缓解了量级),可探索学习化的失败成本或对 $\Delta$ 做组内标准化。第三,可复用性声明只基于两个家族三个域:一个计量表能服务多少个域、何时失效没有边界,值得加'域距离 vs 迁移收益'的扫描实验。第四,统计功效不足:5-7 分的优势建立在单 checkpoint 三次评测上,应补多种子独立训练并报告训练方差。第五,测试时引导需对 4 个候选动作做环境分支试执行,在真实环境(如浏览器)中代价高昂,论文未讨论该成本。
未来方向
作者提出的方向包括:扩展到更多模型家族与域的迁移验证、对 $C$ 做系统的敏感性分析、以更多样化的策略轨迹扩充计量表训练。基于其成果可延伸:(1) 把测试时引导(4 候选试执行 + 计量表择优,Qwen3-4B +16.43pp)与训练期信用分配结合成'推理-训练协同',或用计量表做树搜索的价值引导剪枝;(2) 探索 TTG 之外的进度观测量(剩余交互轮数、环境状态距离、剩余子目标数)并与 TTG 融合,检验'剩余工作量'假设的边界;(3) 利用跨域迁移现象(ALFWorld 计量表可用于 PaperSearchQA 训练并超 GRPO)研究进度表征的普适结构,走向'通用进度基座模型';(4) 将 TTG 信号用于 off-policy 经验回放与数据筛选,研究旧轨迹进度标签的时效性;(5) 针对 Hallucination 指标的劣势,在权重分配中加入事实性正则或与过程评审模型混合。
复现评估
论文承诺开源代码(github.com/Xuyan923r/DeltaTTG);ALFWorld、BFCLv3 为公开基准,PaperSearchQA、AgentWorldModel、BrowseComp-Plus、Terminal-Bench 2.0、τ²-bench、AgentProcessBench 均有公开出处;轨迹生成所用模型(Qwen3-4B、Qwen3.5-9B/27B、Llama-3.2-3B、Qwen3-4B-Instruct-2507)全部开源可下载。算力门槛中等:主实验是 4B/8B 级 actor,单域 RL 训练约 33-36 GPU 小时(150 步预算口径),ALFWorld 计量表 RL 训练约 10.45 GPU 小时且可跨 actor 复用摊薄成本,一组 A100 数天内可完成单域完整流水线。不确定性在于计量表 RL 阶段的超参、各域轨迹数量与采样预算等细节是否在附录 D/E 中足够完备,以及浏览器类域外交互的评估可复现性(噪声大于 ALFWorld 模拟器)。总体评估:复现难度中等,工程主要难点在多策略轨迹采集与计量表批量推理的基建。
论文图表
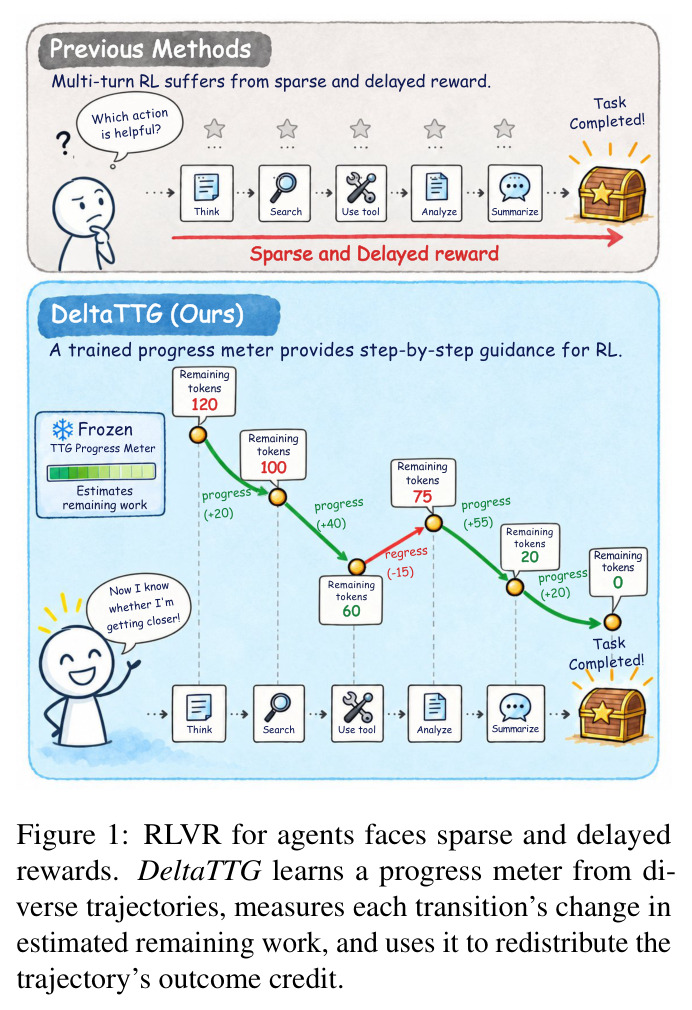
对比图。上半部分展示传统多轮 RLVR:智能体经历 Think/Search/Use tool/Analyze/Summarize 一长串步骤后,只在结尾收到一个'Completed!'的稀疏延迟奖励,无法说明哪一步有用。下半部分展示 DeltaTTG:一个冻结的 TTG 进度计量表对每一步给出剩余 token 估计(如剩余 120→100→75→20→0),相邻估计之差(+20、+40、+55、-15、+20)刻画每步的进度或倒退,并用于把结果信用分配到各步。
这是全文问题的浓缩:一图讲清'稀疏终端奖励 vs 逐步进度信号'的对照,以及 DeltaTTG 的信号形态(剩余 token 数及其差分),是向读者介绍核心直觉的第一入口。