各奖励归其相关 token:多奖励强化学习中的奖励特定 token 级信用分配 Each Reward to Its Relevant Tokens: Reward-Specific Token-Level Credit Assignment for Multi-Reward RL
用验证器信息的自回放 JS 距离,把每个奖励的优势精准分配到相关 token
前置知识
GRPO(组相对策略优化)
DeepSeekMath 提出的 LLM 强化学习算法:对每个 prompt 用当前策略采样一组(如 8 个)响应,用组内奖励的均值和标准差把奖励标准化成相对优势 $A=(r-\mu)/(\sigma+\epsilon)$,再用带 clip 的代理目标更新策略,省去价值网络。
本文的全部讨论都在 GRPO 框架内展开,MRTPO 保留其组内标准化与裁剪目标,只改动优势在 token 上的分配方式,读懂 GRPO 才能看清改了哪一步。
奖励坍缩与 GDPO
多奖励场景下若把奖励求和再做组标准化,不同奖励组合但总分相同的响应会得到相同优势(坍缩)。GDPO(Group reward-decoupled normalization)先对每个奖励在组内分别标准化得 $A_k^{(j)}$,再加权求和,使不同奖励组合保持可分。
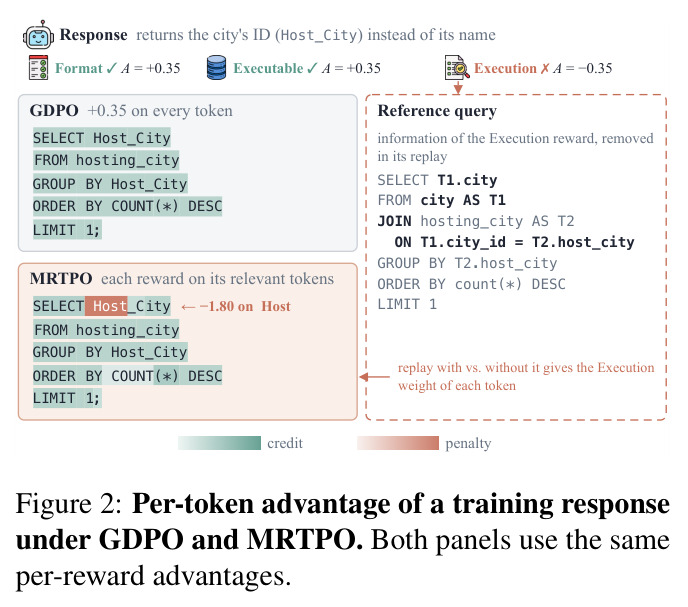
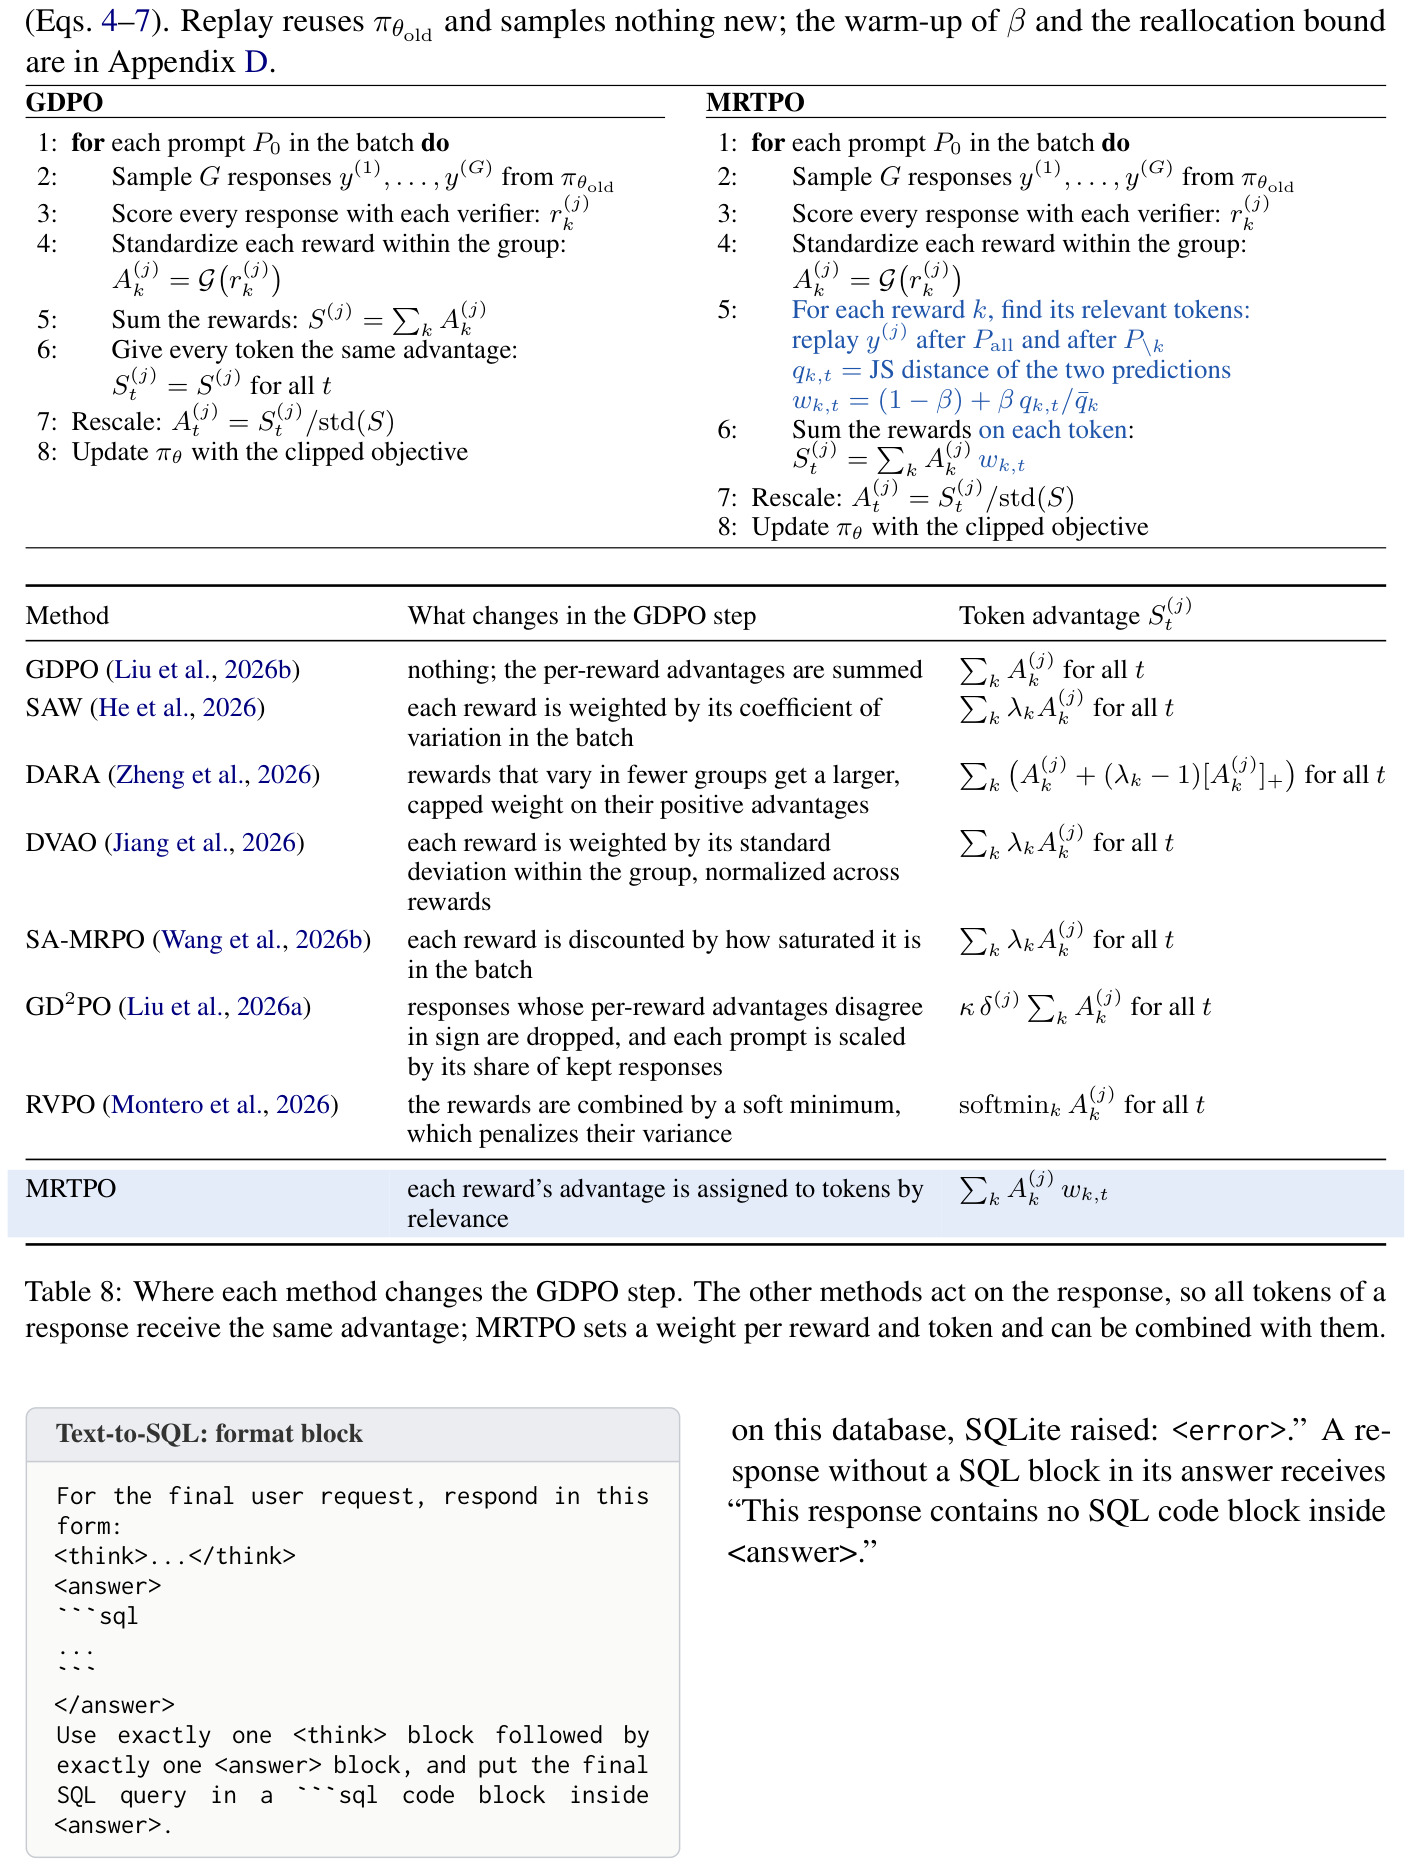
GDPO 是本文的直接基线:MRTPO 与 GDPO 计算完全相同的按奖励优势,唯一区别是 GDPO 把每个 $A_k$ 均匀铺到所有 token,MRTPO 按相关性铺。
Jensen–Shannon 散度
两个概率分布的对称散度:$JS(p\|q)=\tfrac{1}{2}D_{KL}(p\|m)+\tfrac{1}{2}D_{KL}(q\|m)$,其中 $m=\tfrac{1}{2}(p+q)$。它有界(最大 $\ln 2$)、对称,本文将其除以 $\ln 2$ 归一化到 $[0,1]$。
MRTPO 用删掉某奖励验证器信息前后下一 token 分布的 JS 距离来度量该 token 与此奖励的相关性,是整个方法的度量核心。
token 级信用分配
强化学习中的经典问题:奖励是响应级的,但更新要落到 token 上。默认做法把响应优势均分给每个 token;更细的做法包括过程奖励模型、VinePPO 的蒙特卡洛值估计、rubric 判别器等,但它们需要步级标注、额外采样或额外模型。
本文的贡献就是提出一种无需标注、无需辅助模型、无需额外采样的 token 级信用分配,并首次把它做成按奖励分别进行(reward-specific)。
特权信息与 on-policy 自蒸馏
让同一个模型在 seeing 额外信息(参考答案、环境反馈)时充当教师:把它对已生成响应的预测分布作为目标,学生用 KL 蒸馏去拟合(如 OPSD)。这把奖励最大化替换成向Privileged 教师的蒸馏。
MRTPO 借用了同一机制(用/不用某验证器信息各回放一遍)但用途不同:不是替换训练目标,而是只决定每个奖励的优势落在哪些 token 上——这是理解本文与 OPSD 差异的关键。
研究动机
RLVR(可验证奖励强化学习)已成为 LLM 后训练的标准组件,但实际目标几乎都是多准则的:工具调用 agent 要同时输出格式正确的调用并选对函数与参数;text-to-SQL 模型的查询既要可执行又要返回正确结果;指令遵循模型要满足 prompt 里每条约束(本文用的 HIR-16K 数据每条 prompt 带 5 到 13 条约束)。每个准则由独立验证器打分,直接把 GRPO 用在奖励之和上会让不同奖励组合坍缩成同一个优势值。GDPO 通过对每个奖励在 rollout 组内分别标准化解决了坍缩,后续一系列工作(SAW、DARA、DVAO、SA-MRPO、GD2PO、RVPO)继续调整每个奖励的聚合权重,但它们得到的优势仍然均匀分配给响应的每个 token。这隐含假设每个 token 对每个奖励同等负责,而验证器其实只检查响应的一小部分:例如工具调用所有参数都正确、只是漏了必需的 标签时,格式惩罚被均摊到完全正确的参数 token 上。更糟的是奖励越多稀释越严重——均匀分配下每个 token 收到所有奖励优势之和,其中大部分来自与它无关的奖励,有效信号被淹没。
本文的目标是论文要回答的核心问题是:能否识别出与每个奖励相关的 token,并把该奖励的优势主要分配到它们上面?约束条件非常明确:不引入辅助模型、不做 token 级人工标注、不做额外采样,只使用每个验证器本来就拥有的信息(参考答案、执行报错、单条约束文本)。具体目标分解为三点:一是保留 GDPO 按奖励组内标准化的优势 $A_k^{(j)}$,只改变其在 token 上的落点,从而与所有响应级重加权方法正交、可叠加;二是让每个奖励独立获得自己的 token 分配(reward-specific),而不是所有奖励共享一个加权 profile;三是在 text-to-SQL、多约束指令遵循、工具调用三类任务、六个模型上验证这样能更快收敛并超过 GRPO 与 GDPO。
与已有工作不同的是,本文的独特切入是把一个被忽视的观察变成可计算的量:每个验证器都持有决定该奖励的信息(参考查询、SQLite 报错、某条约束),那么删掉这条信息后模型预测发生变化的位置,就是与该奖励相关的位置。已有工作没有走这条路:GDPO 及其后续全部在响应层面决定各奖励贡献多少,token 间仍均分;过程奖励模型、VinePPO、rubric 判别器等 token 级方法需要步级标注、额外蒙特卡洛采样或额外训练判别器;基于 token 熵的方法或 CoRT 的反事实回放是对聚合后的总优势重加权,而非按奖励分别分配;OPSD 等自蒸馏方法用特权信息构造教师并把训练目标替换成蒸馏。MRTPO 中奖励仍然是训练目标,leave-one-out 回放只决定每个奖励的优势去向,因此保留了 reward maximization 的语义,并且实验证明只需要验证器本就使用的信息、不需要完整参考解答。
核心方法
先讲直觉:如果从上下文中删掉某个奖励的验证器信息(比如 SQLite 的报错文本、参考查询、或某条指令约束)后,模型在某一个 token 位置的下一 token 预测分布发生显著变化,说明这个位置的生成依赖这条信息,也就是与这个奖励相关。技术路线完全架在 GDPO 之上:每个 prompt $P_0$ 用行为策略 $\pi_{\theta_{old}}$ 采一组 $G$ 个响应,每个奖励 $k$ 在组内标准化得 $A_k^{(j)}=(r_k^{(j)}-\mu_k)/(\sigma_k+\epsilon)$。MRTPO 新增的只有三步:为每个奖励 $k$ 构造两个只差信息块 $Z_k$ 的上下文 $P^{all}=P_0\oplus Z_{K_x}$ 和 $P^{\neg k}=P_0\oplus Z_{K_x\setminus\{k\}}$;用 $\pi_{\theta_{old}}$ 对已采样响应各做一次前向回放,读出每个位置的分布 $p^{all}_t$ 与 $p^{\neg k}_t$,算归一化 JS 距离 $q_{k,t}=JS(p^{all}_t\|p^{\neg k}_t)/\ln 2\in[0,1]$ 作为相关性;最后按 $w_{k,t}=(1-\beta)+\beta\,q_{k,t}/\bar q_k$($\bar q_k$ 是响应平均)把每个奖励的优势重新铺到 token 上,逐 token 求和 $S_t^{(j)}=\sum_k A_k^{(j)}w_{k,t}^{(j)}$ 后进入原本的裁剪代理目标。分配强度 $\beta=0.5$,前 $N=10$ 步用 smoothstep 从 0 预热。
核心创新是把『奖励与 token 的相关性』变成模型自身一次前向传播就能度量的量——leave-one-out 自回放的 JS 距离,且每个奖励独立做一遍。与已有方法的本质区别有四层。第一,GDPO/SAW 等所有响应级方法决定的是『每个奖励对响应优势贡献多少』,而 MRTPO 决定的是『哪个 token 接收哪个奖励的优势』,两者正交(论文用 SAW 叠加验证了这一点)。第二,传统 token 级信用分配(过程奖励模型、VinePPO 蒙特卡洛估计、rubric 判别器)需要步级标注、额外采样或额外模型,MRTPO 只对已采样响应做若干次前向,零新采样、零辅助模型、零标注。第三,与 OPSD 等自蒸馏的关键差异在于训练目标不被替换:特权信息不构造教师,只用来定位优势落点,所以不需要完整参考解答——实验中 OPSD 拿到了含推理链的完整参考解、信息量远超 MRTPO,却在所有 text-to-SQL 基准上落后。第四,正和负优势用同一套权重,响应总 credit 不变(权重均值为 1),只改变落点,这保证了与 GDPO 的严格可比:两者计算完全相同的按奖励优势,性能差异只能来自 token 级分配本身。
方法步骤详情
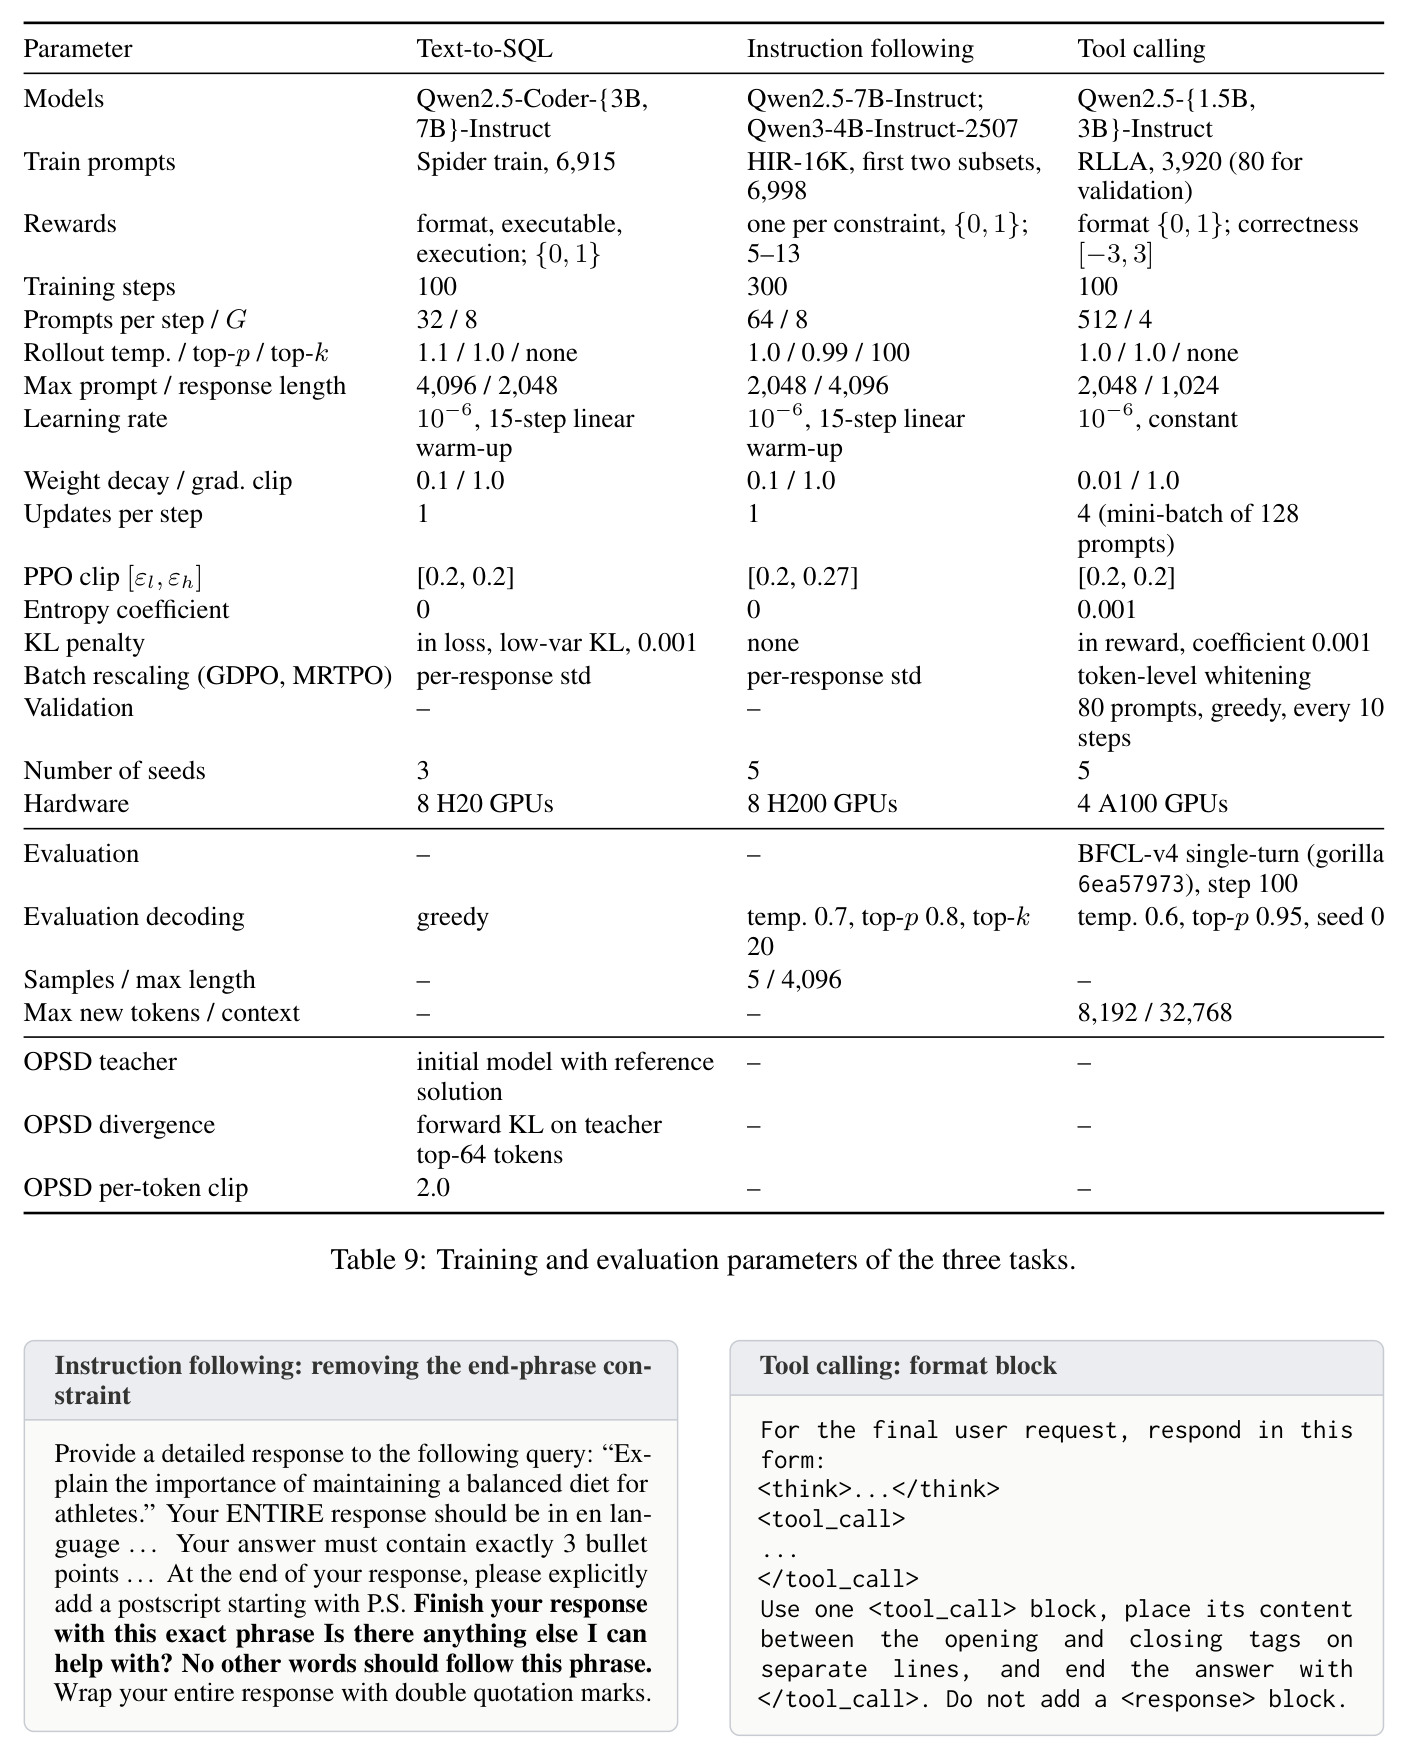
完整流程分七步。第一步采样:每个 prompt $P_0$ 从 $\pi_{\theta_{old}}$ 采 $G$ 个响应(text-to-SQL 与指令遵循 $G=8$,工具调用 $G=4$)。第二步打分:$K$ 个验证器给出 $r_1^{(j)},\dots,r_K^{(j)}$,例如 text-to-SQL 是 format/executable/execution 三个 0/1 奖励,指令遵循每条约束一个 0/1 奖励。第三步组内标准化:$A_k^{(j)}=(r_k^{(j)}-\mu_k)/(\sigma_k+\epsilon)$,$\mu_k,\sigma_k$ 是该奖励在 $G$ 个响应上的均值与样本标准差。第四步构造上下文:$P^{all}=P_0\oplus Z_{K_x}$,$P^{\neg k}=P^{all}$ 删去 $Z_k$,信息块 $Z_k$ 拼在用户消息后、空行分隔——text-to-SQL 的 $Z_k$ 是格式要求、该响应自己的 SQLite 报错、参考查询;工具调用是格式要求与参考调用列表;指令遵循的约束本就在 prompt 里,$P^{all}$ 就是原 prompt、$P^{\neg k}$ 删掉一条约束。第五步自回放:只对组内取值有变化的奖励回放(实测 12%–21% 的响应-奖励对需要回放),用 $\pi_{\theta_{old}}$ 前向读出 $p^{all}_t$ 与 $p^{\neg k}_t$,在完整词表上算 $q_{k,t}=JS(p^{all}_t\|p^{\neg k}_t)/\ln 2$。第六步加权:$w_{k,t}=(1-\beta)+\beta\,q_{k,t}/\bar q_k$,每响应权重平均为 1,任何 token 至少保留 $1-\beta$ 的份额。第七步合并更新:$S_t^{(j)}=\sum_k A_k^{(j)}w_{k,t}^{(j)}$,批内重缩放 $A_t^{(j)}=S_t^{(j)}/\mathrm{std}_B(S)$ 后进入 clip 目标。训练细节:$\beta_n=\beta\cdot(3u^2-2u^3)$、$u=\min(n/N,1)$ 做 warm-up;重分配部分用 $s=\min\big(1,\sqrt{\sum_j T_j(S^{(j)})^2/\sum_t(R_t^{(j)})^2}\big)$ 封顶,保证 token 优势二阶矩不超过均匀分配的 2 倍。
技术新颖性
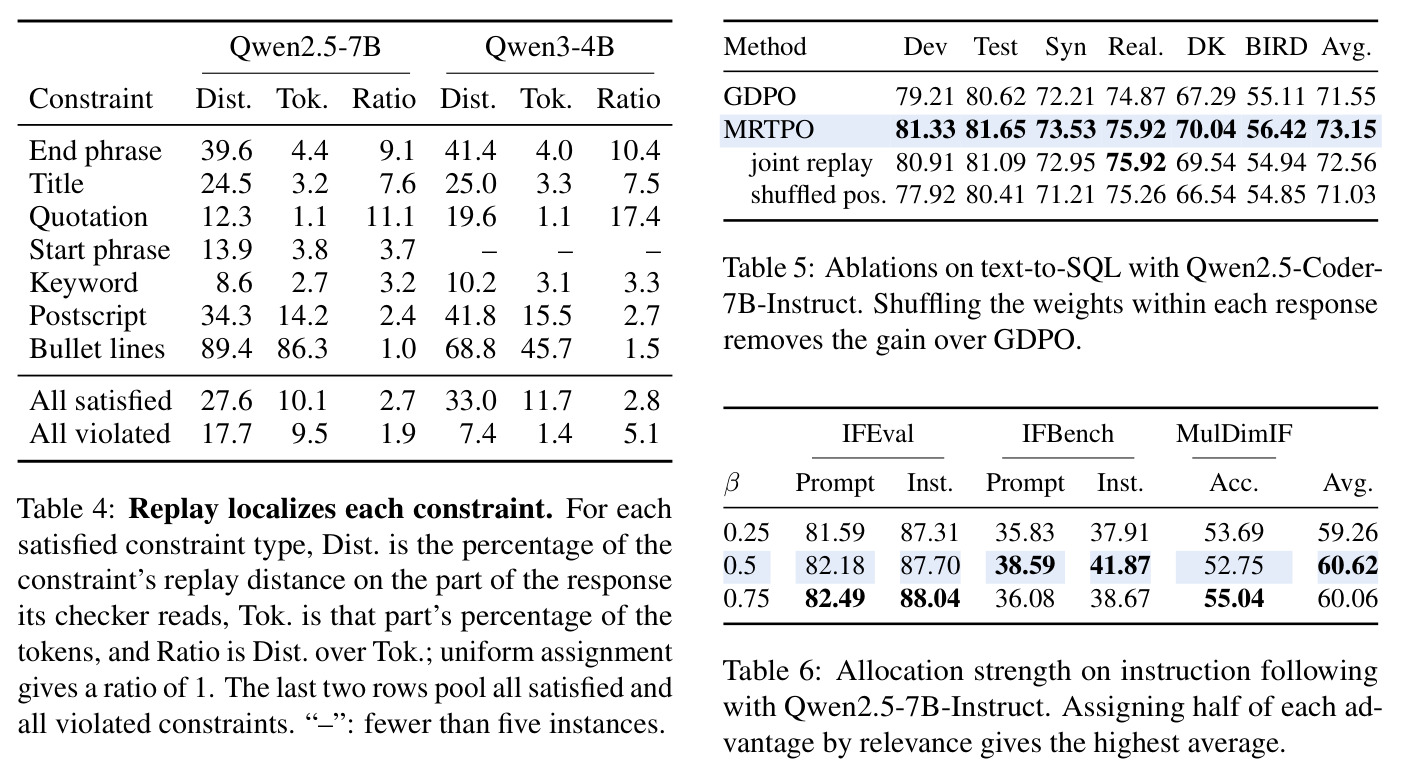
技术新颖性体现在四个层面。概念层面:首次在多奖励 RL 中把『奖励之间的权重』与『奖励到 token 的分配』分离成两个独立问题,并系统对比(Table 8)指出 SAW、DARA、DVAO、SA-MRPO、GD2PO、RVPO 全部只作用于响应级、token 仍均分,MRTPO 的改动维度与它们正交可叠加。度量层面:不需要任何 token 级监督,用删信息回放的 JS 散度定义相关性——这是一种因果敏感性分析(leave-one-out),而且在整个词表上比较分布而非只看被采样 token 的概率,因此能捕捉『概率质量在候选间移动但采样 token 不变』的情况。工程层面:零额外采样,回放复用 $\pi_{\theta_{old}}$ 与已采样响应,每个奖励只多一次前向;只回放组内有方差的奖励-响应对(12%–21%),训练步只慢 10%–20%,成本控制精细。稳健性层面:权重保底 $1-\beta$、重分配二阶矩封顶、$\beta$ warm-up 三重方差控制,说明作者明确意识到相关性估计的噪声风险。相比同期 token 级工作 CoRT(去掉整个 rubric 回放、对聚合优势重加权),MRTPO 的 reward-specific 是质的不同:Table 5 中『联合回放共享一个 profile』的变体只有 72.56、明显低于逐奖励回放的 73.15,直接证明每奖励独立分配是增益来源。
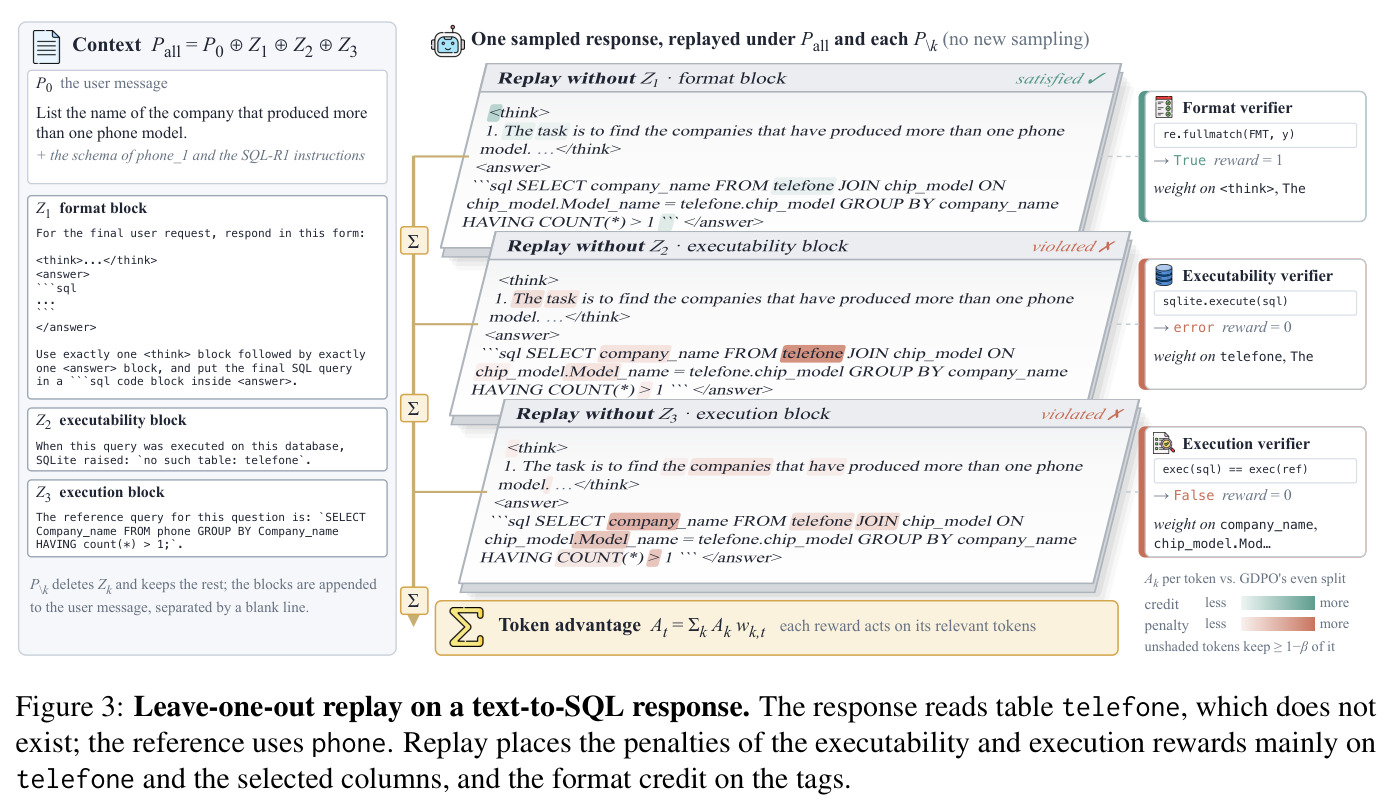
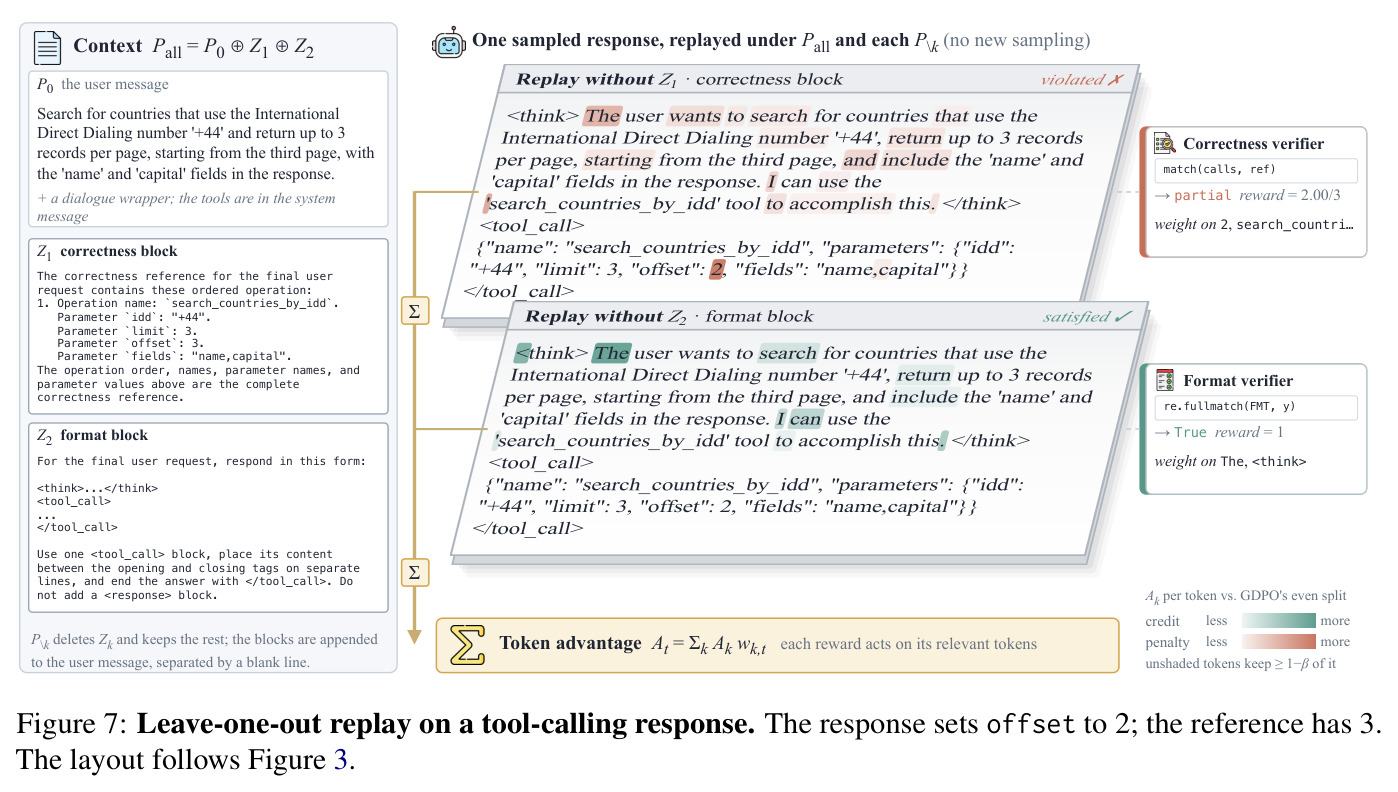
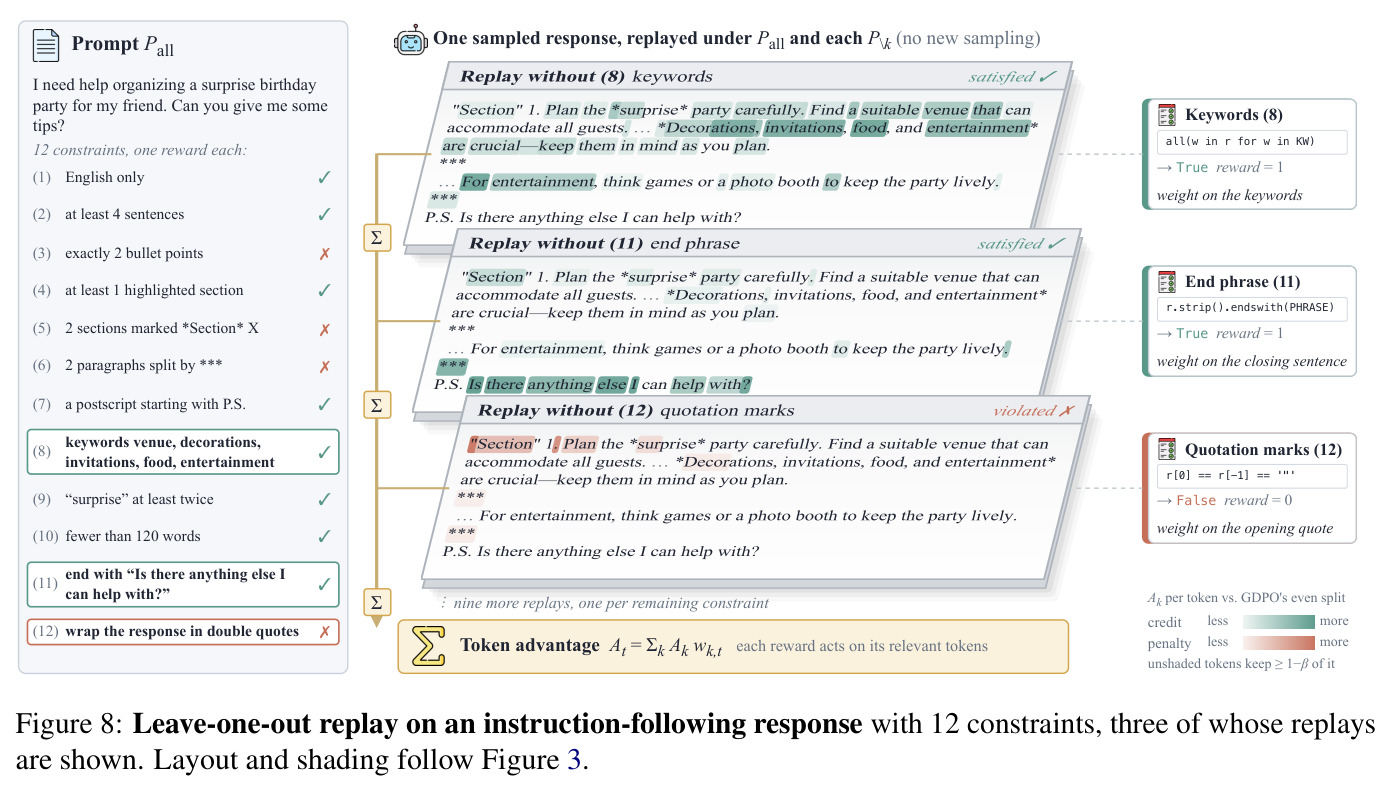
实验结果
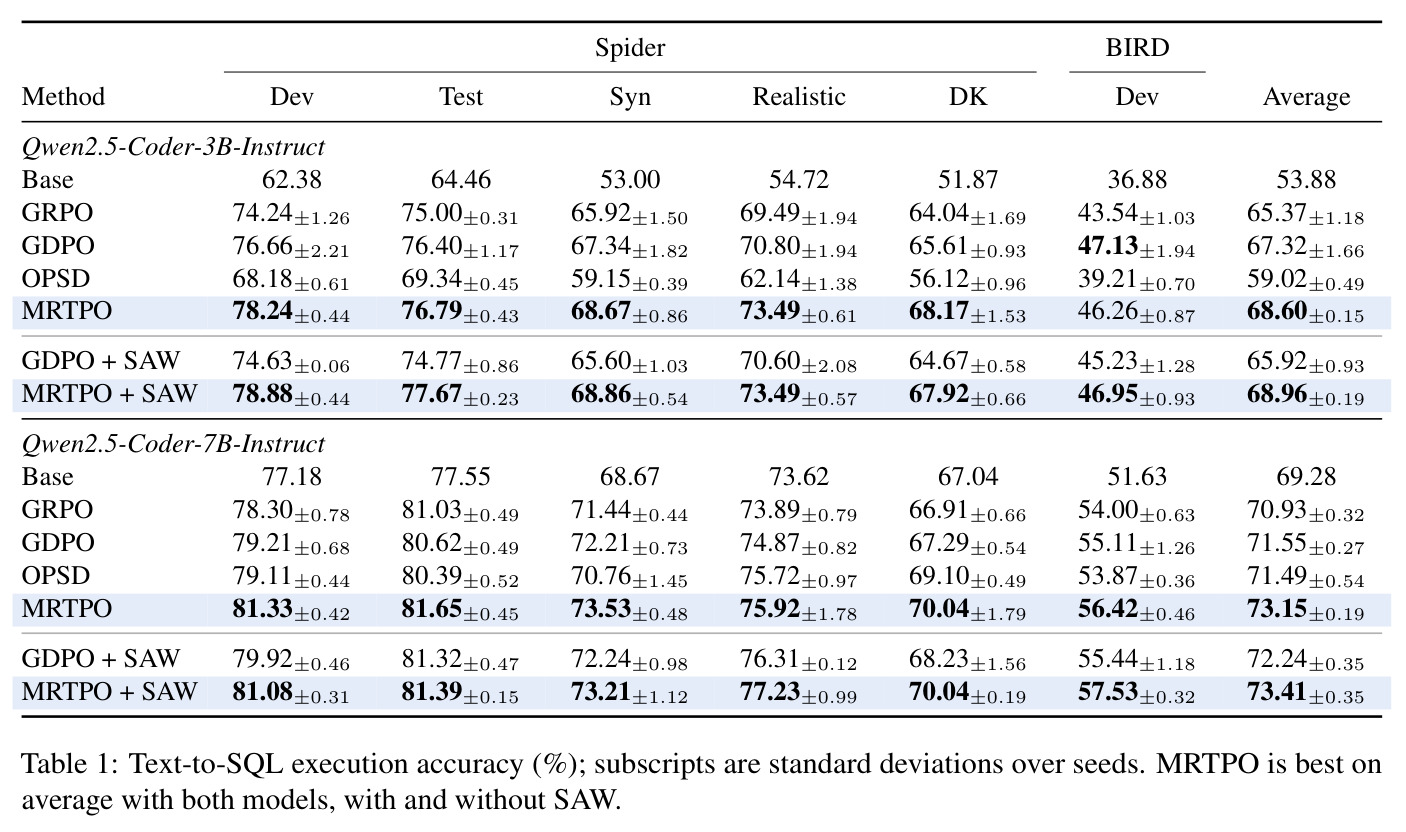
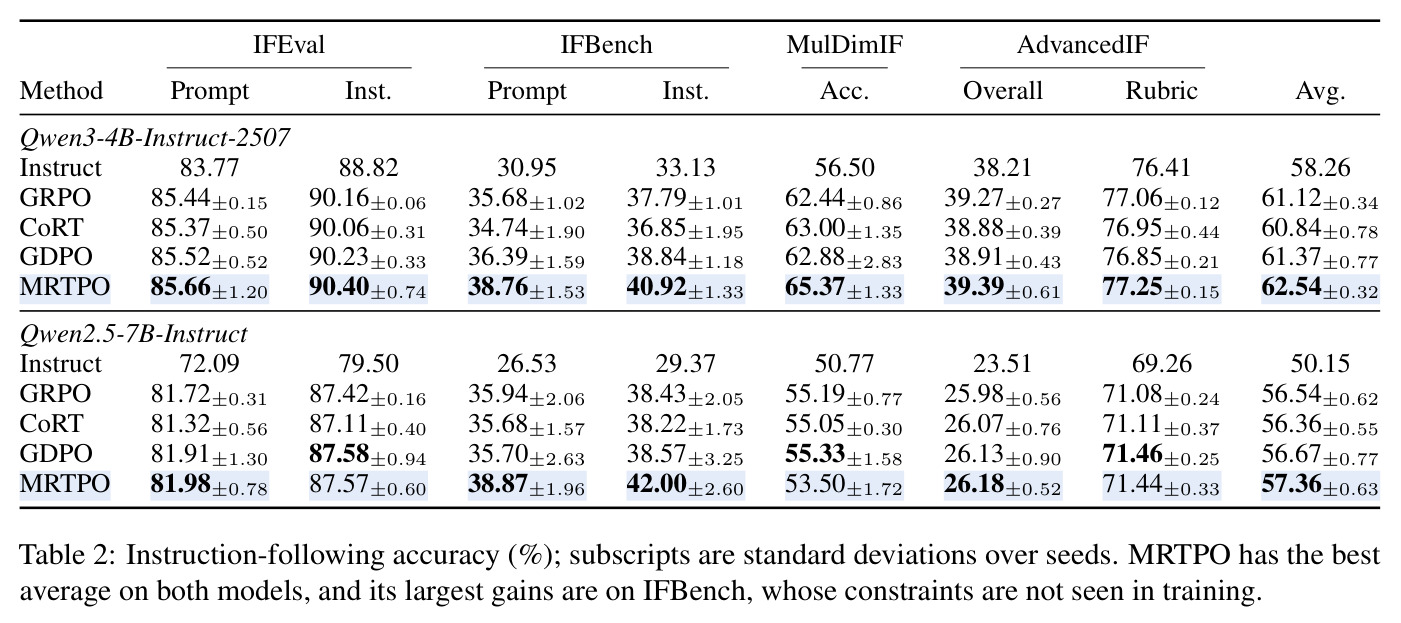
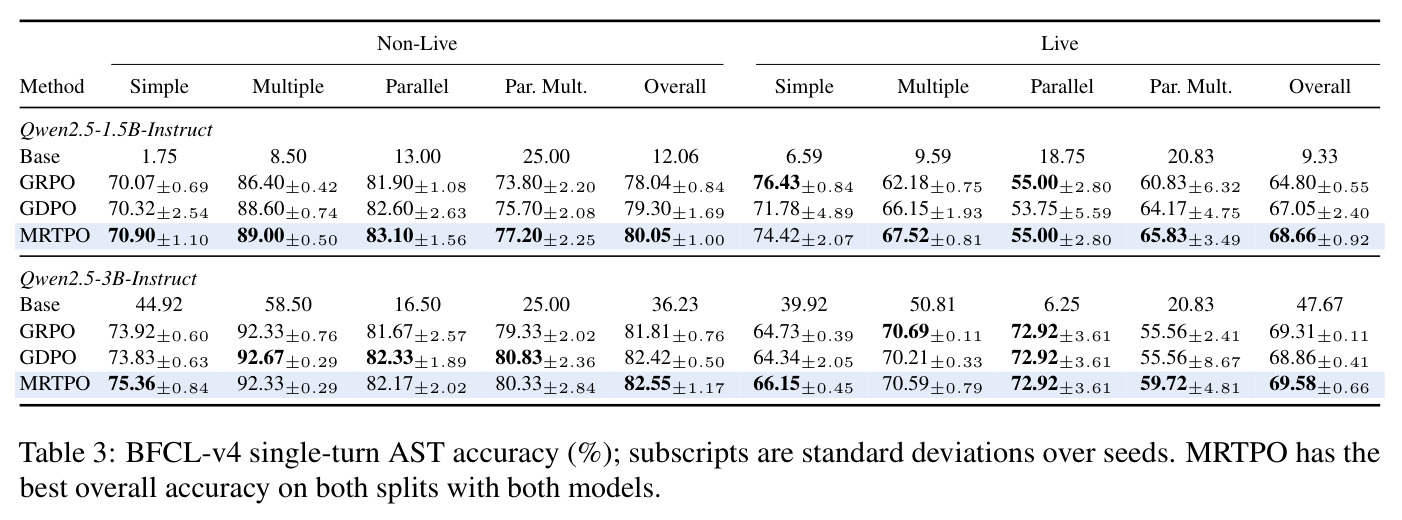
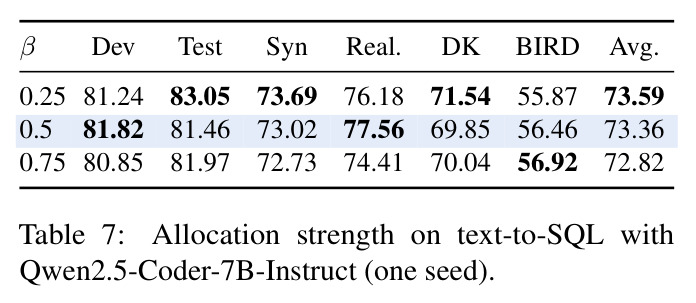
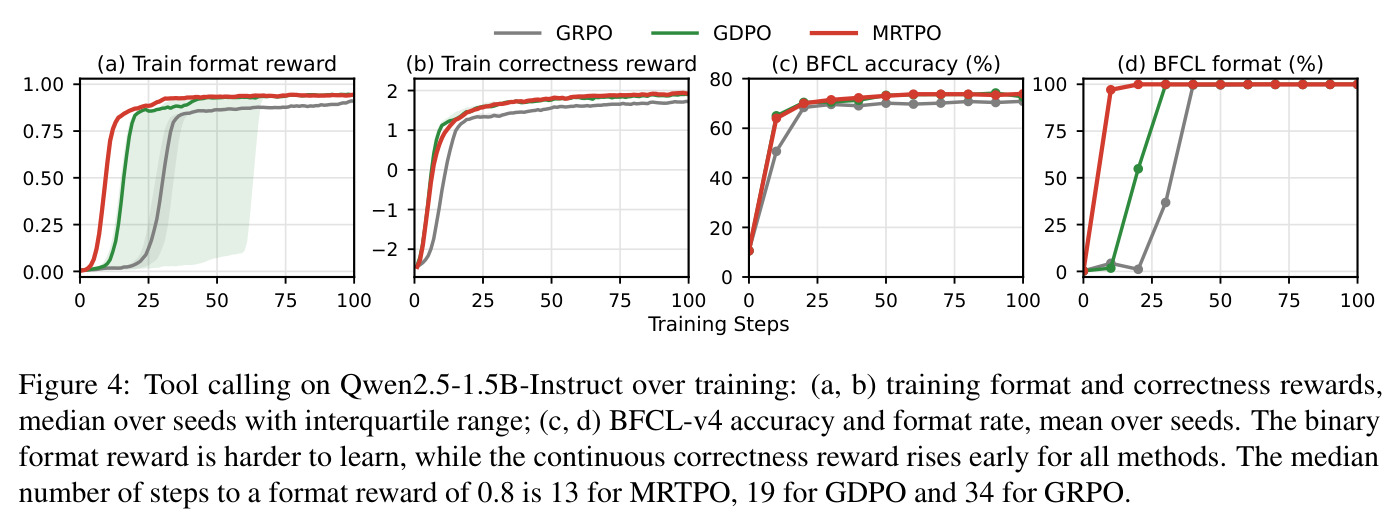
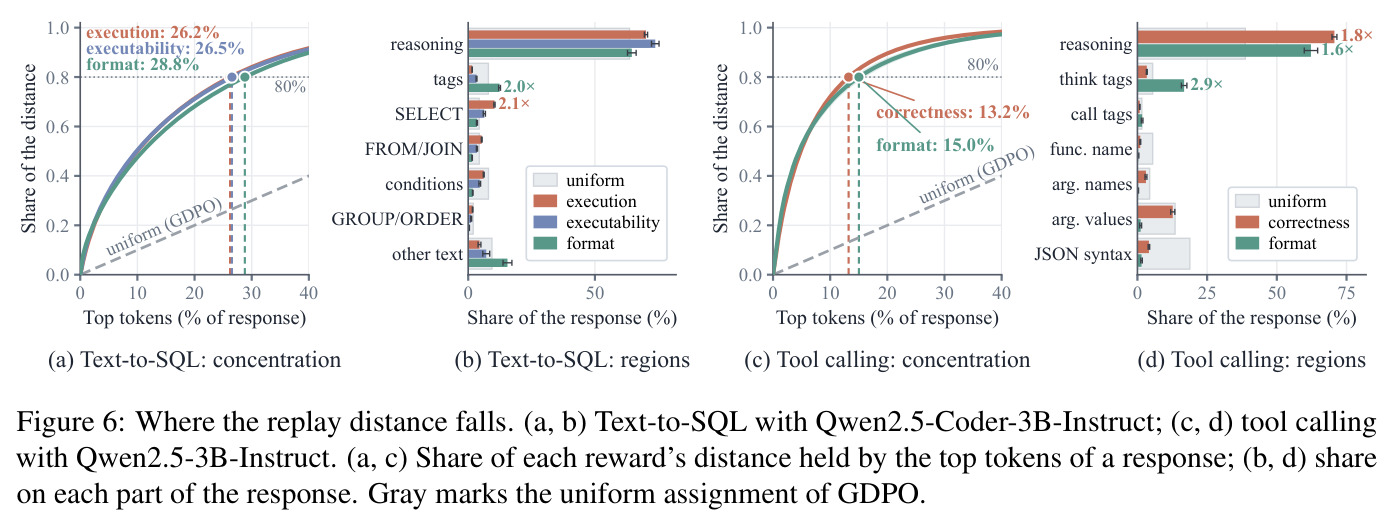
第一,三任务六模型全面最优(Table 1–3)。Text-to-SQL 平均执行准确率:Qwen2.5-Coder-3B 上 MRTPO 68.60 vs GDPO 67.32、GRPO 65.37、OPSD 59.02;7B 上 73.15 vs 71.55/70.93/71.49;叠加 SAW 后 68.96/73.41 仍是最佳,说明与响应级重加权互补。指令遵循增益最大:Qwen3-4B 平均 62.54 vs GDPO 61.37;Qwen2.5-7B 平均 57.36 vs 56.67,且最大涨幅出现在训练中未见过的约束类型 IFBench 上(+2.4 和 +3.2 个点),证明方法泛化到新约束。工具调用 BFCL-v4 上 1.5B 的 Non-Live 80.05、Live 68.66 均最佳,但绝对增益小——呼应了『奖励越多稀释越重、收益越大』的规律(指令遵循 5–13 个奖励收益最大,text-to-SQL 3 个次之,工具调用 2 个收益主要在速度)。第二,收敛显著更快(Figure 4–5):达到格式奖励 0.8 的中位步数 MRTPO 13、GDPO 19、GRPO 34;训练 10 步后 BFCL 格式达标率 97% vs GDPO 2%、GRPO 4%;Coder-7B 在第 60/100 步就超过 GDPO 的最终精度,Qwen3-4B 在第 200/300 步超过所有基线的最终 IFBench 精度;Coder-3B 的响应比 GDPO 短 40%(不影响结果的推理拿不到执行优势)。第三,相关性确实落在验证器检查的位置(Figure 6、Table 4):text-to-SQL 中 80% 的回放距离集中在 26%–29% 的 token 上,执行奖励在选中列上的密度是 token 占比的 2 倍、几乎不落在标签上,格式奖励在标签上密度 2 倍;工具调用中 80% 距离集中在 13%–15% 的 token,格式奖励在 think 标签上密度 2.9 倍,正确性奖励落在选择调用的推理部分;指令遵循中 end-phrase 约束 39.6% 的距离落在只占 4.4% token 的结尾短语上(密度 9.1 倍),quotation 约束密度 11.1–17.4 倍,违反的约束的距离会移到缺失内容应在的位置。第四,消融(Table 5–7):把权重值保留、位置打乱,增益完全消失(71.03,低于 GDPO 的 71.55);联合回放(所有奖励共享一个分配 profile)得 72.56,介于 GDPO 与 MRTPO 之间——证明增益既需要『按相关性分配』也需要『每奖励独立分配』;$\beta$ 扫描显示指令遵循 $\beta=0.5$ 最佳(平均 60.62),text-to-SQL 上 $\beta=0.25$ 略优(73.59),作者统一用 0.5 未按任务调优。
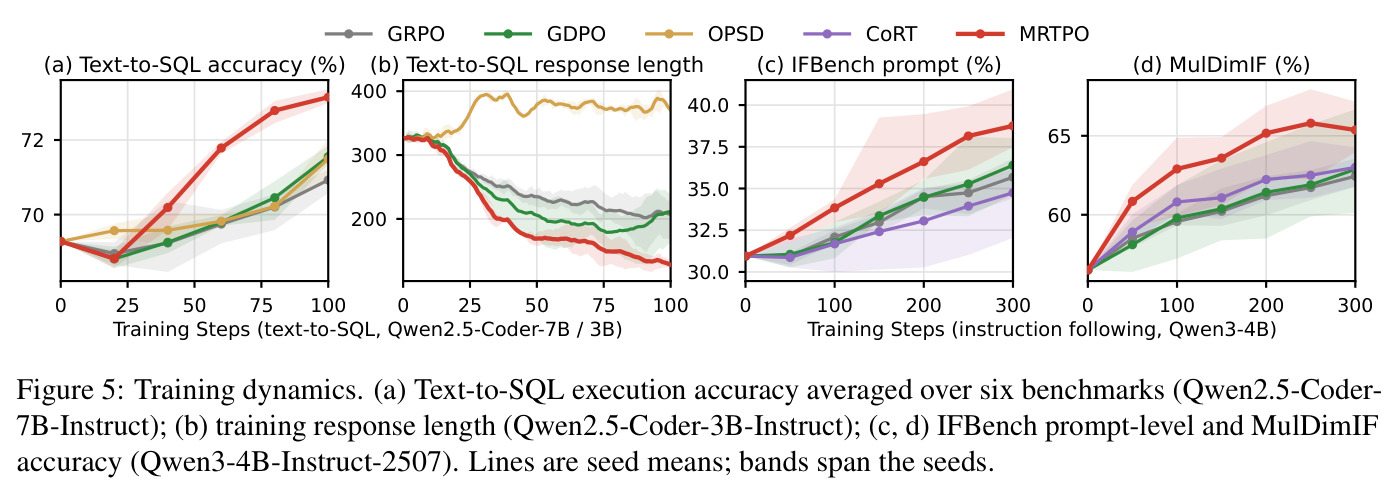
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Text-to-SQL(Spider/BIRD 等 6 基准平均,Qwen2.5-Coder-7B-Instruct) | 执行准确率 (%) | MRTPO 73.15;MRTPO+SAW 73.41 | GDPO 71.55;GRPO 70.93;OPSD 71.49;GDPO+SAW 72.24 | 较 GDPO +1.60,较 GDPO+SAW +1.17,较 GRPO +2.22 |
| Text-to-SQL(6 基准平均,Qwen2.5-Coder-3B-Instruct) | 执行准确率 (%) | MRTPO 68.60;MRTPO+SAW 68.96 | GDPO 67.32;GRPO 65.37;OPSD 59.02;GDPO+SAW 65.92 | 较 GDPO +1.28,较 GRPO +3.23;OPSD 拿完整参考解仍落后 9.58 |
| IFBench(训练未见约束,Qwen3-4B-Instruct-2507) | prompt 级准确率 (%) | 38.76 | GDPO 36.39;GRPO 35.68;CoRT 34.74 | 较 GDPO +2.37,为所有设置中最大涨幅之一 |
| IFBench(训练未见约束,Qwen2.5-7B-Instruct) | prompt 级准确率 (%) | 38.87 | GDPO 35.70;GRPO 35.94;CoRT 35.68 | 较 GDPO +3.17 |
| 指令遵循 4 基准平均(Qwen3-4B / Qwen2.5-7B) | 平均准确率 (%) | 62.54 / 57.36 | GDPO 61.37 / 56.67;GRPO 61.12 / 56.54;CoRT 60.84 / 56.36 | 较最强基线 +1.17 / +0.69 |
| BFCL-v4 工具调用(Qwen2.5-1.5B-Instruct) | 单轮 AST 准确率 (%) | Non-Live 80.05;Live 68.66 | GDPO 79.30 / 67.05;GRPO 78.04 / 64.80 | 较 GDPO +0.75 / +1.61;主要增益在速度:格式奖励达 0.8 仅需 13 步(GDPO 19、GRPO 34) |
| BFCL-v4 工具调用(Qwen2.5-3B-Instruct) | 单轮 AST 准确率 (%) | Non-Live 82.55;Live 69.58 | GDPO 82.42 / 68.86;GRPO 81.81 / 69.31 | 较 GDPO +0.13 / +0.72(两奖励任务上增益小,符合论文的规律分析) |
| 训练效率(Coder-7B text-to-SQL / Qwen3-4B 指令遵循) | 达到基线最终精度所需步数 | 60/100 步超过 GDPO 终值;200/300 步超过所有基线 IFBench 终值 | GDPO/GRPO 训满 100/300 步的终值 | 约 1.5–1.7 倍加速;额外开销仅每步 +10%–20% 时长 |
局限与改进
作者明确承认的限制:MRTPO 要求每个奖励的验证信息能写成文本块,且增删它会改变策略的预测;没有此类信息的奖励(如响应长度)无法定位,只能保留 GDPO 的均匀分配。实验只覆盖 1.5B–7B 参数的模型,$\beta$ 在所有任务固定为 0.5 而未按任务调优(Table 7 显示 text-to-SQL 上 0.25 其实略好),更大模型、由 LLM 判分的奖励(如 rubric 项)、自适应 $\beta$ 都留作未来工作。我的补充观察:一是相关性不等于归因——JS 距离度量的是『预测对信息的敏感性』而非『该 token 是否导致奖励得失』,若错误根源在推理早段而信息只改变末端预测,credit 会放错位置;二是方法会静默失效,当策略对 $Z_k$ 完全不敏感时 $q_{k,t}\approx 0$、权重退回均匀,退化为 GDPO 且没有任何报警信号;三是回放条件与采样条件不完全一致(信息块拼进 prompt 相当于轻微改变了任务),可能引入分布偏移;四是正负优势共用同一权重,把如 $-2.15$ 的惩罚集中到少数相关 token(Figure 1)可能带来局部过度惩罚与熵下降风险,论文未报告熵或多样性指标;五是 Table 4 中 bullet lines 约束的定位比值为 1.0(与均匀无异),说明部分约束类型上定位会失效;六是每个任务的 $Z_k$ 模板需人工设计(Appendix C),向新任务迁移有工程成本。
独立分析的弱点
弱点一:相关性度量是敏感性而非责任。删除 $Z_k$ 后预测变化大的 token 只是『依赖该信息』,不一定是『造成奖励增减的原因』——比如模型可能在正确列上对参考查询敏感、却在真正出错的 join 条件上不敏感。改进方向:引入反事实回放,把 $Z_k$ 替换成『修正后的信息』(如正确的参考查询),看哪些 token 的预测会因此被修复,用预测修复量而非预测变化量定权重。弱点二:静默退化。若模型对验证器信息不敏感(弱模型、或信息在上下文中大量冗余重复),$q_{k,t}$ 整体趋零,方法无声地退回 GDPO。改进方向:把组内 $q$ 分布作为训练诊断信号监控,对持续低敏感的奖励自动回退到其他信用分配方案或加大 $\beta$。弱点三:回放与采样的条件不一致。$P^{all}$ 包含全部信息块而采样时的 prompt 未必有(工具调用场景把参考调用列表加进上下文相当于轻微换了任务),相关性估计建立在偏离策略分布的条件下。改进方向:统一在采样时就把 $Z_{K_x}$ 放入 prompt(指令遵循已是这样做的),或用重要性加权校正条件差异。弱点四:负优势集中风险。把大额惩罚(Figure 1 中的 $-2.15$)集中到少数 token 可能造成局部策略坍缩、损害探索。改进方向:对负优势使用更小的有效 $\beta$,或按 token 熵自适应调节分配强度,并监控训练中的熵曲线。弱点五:$Z_k$ 模板需人工设计,限制了即插即用。改进方向:用 LLM 从验证器原始输出(报错栈、diff、约束列表)自动生成信息块,并验证自动生成与人工模板的相关性质量差异。
未来方向
作者提出的方向:把方法验证推广到更大模型(当前只有 1.5B–7B);处理由 LLM 判分的奖励(如 AdvancedIF 的人工 rubric 项),看其判分信息能否写成有效的 $Z_k$;自适应地按任务甚至按奖励选择 $\beta$(Table 6/7 已显示最优值因任务而异)。基于本文成果可以自然延伸的方向:一是把 leave-one-out 回放距离当作廉价的过程级信号,与过程奖励模型或 VinePPO 结合,替代昂贵的蒙特卡洛估计;二是扩展到多步 agent 轨迹,把环境反馈(报错、工具返回)当作 $Z_k$,做长 horizon 的步级信用分配;三是与更激进的响应级聚合(如 RVPO 的 soft-min)正交叠加,系统研究『重加权 × 重分配』的交互;四是给出理论分析——JS 敏感性权重下策略梯度的偏差与方差性质,以及重分配封顶 $s$ 与训练稳定性的关系;五是利用相关性权重做数据选择与 curriculum(哪些响应值得回放、哪些奖励在该阶段有信息量);六是监控熵与多样性,确认负优势集中不损害探索,必要时引入熵正则;七是把方法用于偏好类不可验证奖励,探索用成对比较信息构造 $Z_k$ 的可能性。
复现评估
复现条件较好。代码已开源(github.com/zhaihaotian/MRTPO),有项目页。训练数据全部公开:Spider 训练集(剔除 3 条参考不可执行与 82 条超 4096 token 的 prompt 后剩 6915 条)、HIR-16K 前两个子集(6998 条 prompt、43496 条约束)、RLLA(3920 条)。附录 B 给出完整超参数表:AdamW($\beta_1=0.9$、$\beta_2=0.999$)、学习率 $10^{-6}$、rollout 温度与 top-p/top-k、clip 区间(如指令遵循 $[0.2,0.27]$)、每任务训练步数(100/300/100)、硬件(text-to-SQL 8×H20、指令遵循 8×H200、工具调用 4×A100);附录 C 给出全部任务的 $Z_k$ 文本块模板原文;附录 D 给出 JS 散度的完整词表计算、smoothstep warm-up 公式与重分配封顶公式 $s$。算力门槛中等偏下:最小配置 4 张 A100 训 1.5B 模型 100 步即可复现工具调用实验;text-to-SQL 需要 8 张 H20(约相当于 8×80GB 卡)训 3B/7B 各 100 步。结果报 3–5 个随机种子并附标准差,可信度高。复现难度评估为中低:方法本体只是 GDPO 之上加回放与加权,逻辑清晰、伪代码完备(Algorithm 1);主要风险在于基线(GDPO/SAW/OPSD/CoRT)的实现细节与可得性——部分基线是 2026 年的预印本,官方代码未必齐整,需按论文描述自行实现,以及 $Z_k$ 模板的具体措辞可能影响相关性质量(论文未做模板敏感性分析)。
论文图表
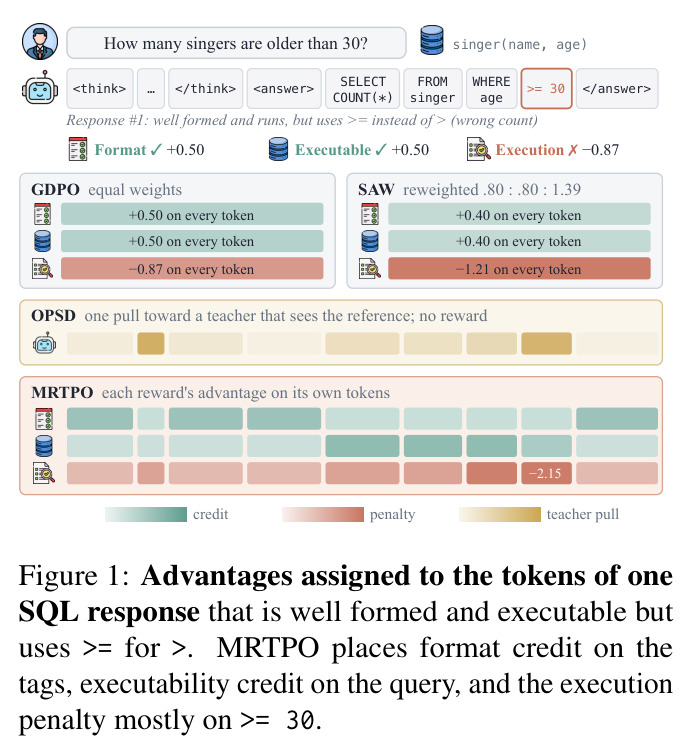
同一条 SQL 响应(格式正确、可执行、但用 >= 而非 > 导致结果错误)在四种方法下的 token 级优势对比:GDPO 把 +0.50 的格式与可执行 credit 和 -0.87 的执行惩罚均摊到每个 token;SAW 重加权后(0.80:0.80:1.39)仍均摊;OPSD 给每个 token 一个朝向看过参考答案的教师的拉力;MRTPO 把格式 credit 放在标签上、可执行 credit 放在查询主体上、-2.15 的执行惩罚集中在 >= 30 处。
一图概括论文的问题(均摊信用稀释了针对少数 token 的信号)与解法(每个奖励的优势落到自己相关的 token),是全文的直观摘要。
对 192 条指令遵循响应逐约束回放的定量统计:对每类满足的约束,Dist. 是该约束回放距离落在其检查器实际读取的文本部分的比例,Tok. 是该部分占响应 token 的百分比,Ratio 是两者之比(均匀分配为 1)。end-phrase 约束比值 9.1/10.4(40% 距离落在仅 4% token 上)、quotation 11.1/17.4 最高;bullet lines 比值仅 1.0 说明此类约束无法定位;所有满足约束平均 2.7/2.8 倍,违反约束的距离会移到缺失内容应在的位置。
方法有效性的定量证据核心:证明相关性度量在 token 级确实对准了验证器读取的位置,同时诚实地暴露了定位失效的约束类型,是评估 claim 强度的关键表。
两个只改动分配方式的消融:把 token 权重值保留、位置在响应内随机打乱后,平均 71.03 反而低于 GDPO 的 71.55,增益完全消失;把所有奖励一起回放、共享一个分配 profile 的联合回放得 72.56,介于 GDPO(71.55)与 MRTPO(73.15)之间。
直接回答『增益到底来自哪里』:既需要按相关性分配,也需要每个奖励独立分配,二者缺一不可,是方法核心 claim 的归因实验。