When2Think:面向高效混合推理的难度感知长度控制 When2Think: Learning Difficulty-Aware Length Control for Efficient Hybrid Reasoning Models
用难度感知的奖励塑形让推理模型学会何时思考、思考多深。
前置知识
RLVR(可验证奖励强化学习)
用确定性验证器(如数学答案比对)替代学习型奖励模型,直接以任务正确性作为奖励信号训练 LLM。模型生成的最终答案经规则抽取后与标准答案比对,答对得 1、答错得 0,无需步骤级人工监督,避免了奖励模型的偏差和被钻空子(reward hacking)的风险,为多步推理提供可靠奖励。
When2Think 的正确性信号 $\mathcal{V}(x_i,o_{i,k})$ 完全建立在可验证奖励之上,整个训练框架是 RLVR 的实例,这也是方法局限在数学等可自动判对领域的根本原因。
PPO 与裁剪代理目标
PPO 是主流策略梯度算法,用重要性比率 $\rho$ 衡量新旧策略差异,并把 $\rho$ 裁剪在 $[1-\epsilon,1+\epsilon]$ 区间防止单次更新过猛导致训练崩溃。本文采用的轨迹级目标为 $\mathcal{L}(\theta)=-\mathbb{E}[\min(\rho_{i,k}A_{i,k},\ \min(\max(\rho_{i,k},1-\epsilon),1+\epsilon)A_{i,k})]$。
论文的优化目标是 PPO 风格的裁剪代理损失,且配合无 critic 的轨迹级优势估计,理解该目标是读懂第 3 节预备知识与训练细节的前提。
双过程理论(System 1 / System 2)
认知科学把思维分为系统 1(快速、直觉、低耗)与系统 2(缓慢、审慎、高耗)。本文将其映射到混合推理:NOTHINK 模式直接作答对应系统 1,THINK 模式展开显式思维链对应系统 2;理想行为是简单题走系统 1、难题走系统 2,并由模式 token 显式切换。
论文的问题定义、方法设计(THINK/NOTHINK 模式 token)和实验分析(think 比率随难度变化)全部围绕这一概念框架展开,是理解全文叙事的钥匙。
重要性采样(Importance Sampling)
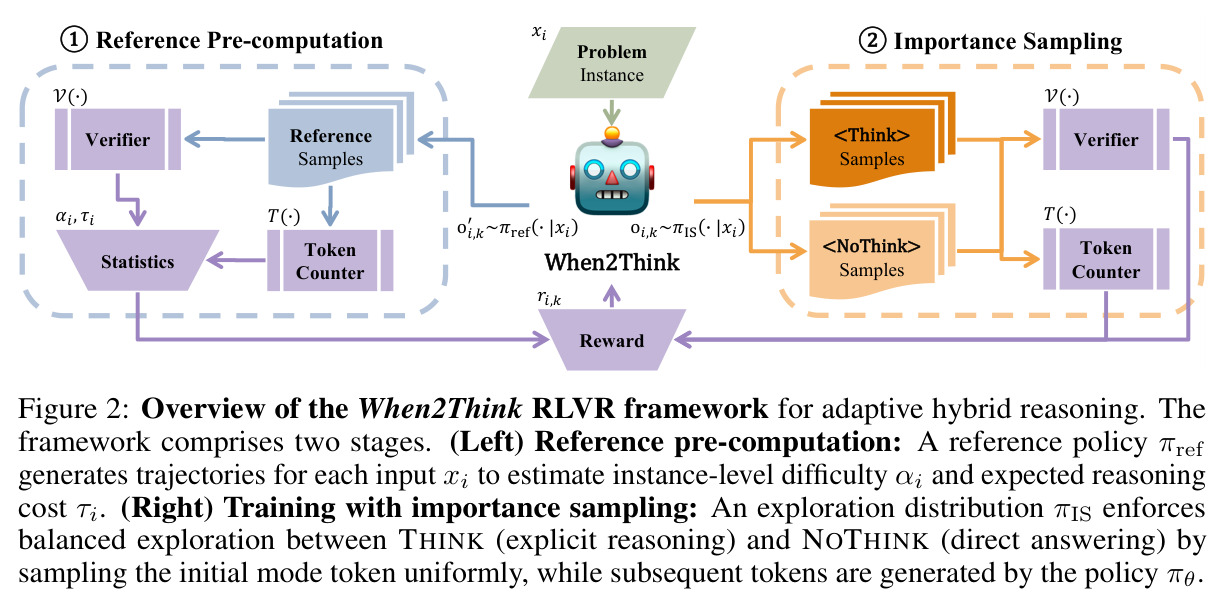
当探索分布 $\pi_{IS}$ 与目标策略 $\pi_\theta$ 不同时,用比率 $\rho_{i,k}=\pi_\theta(o_{i,k}|x_i)/\pi_{IS}(o_{i,k}|x_i)$ 对样本重加权,得到关于目标策略的无偏梯度估计。本文沿用 AdaptThink 方案:初始模式 token 由 $\pi_{IS}$ 均匀采样以保证 THINK/NOTHINK 平衡探索,其余 token 由当前策略生成。
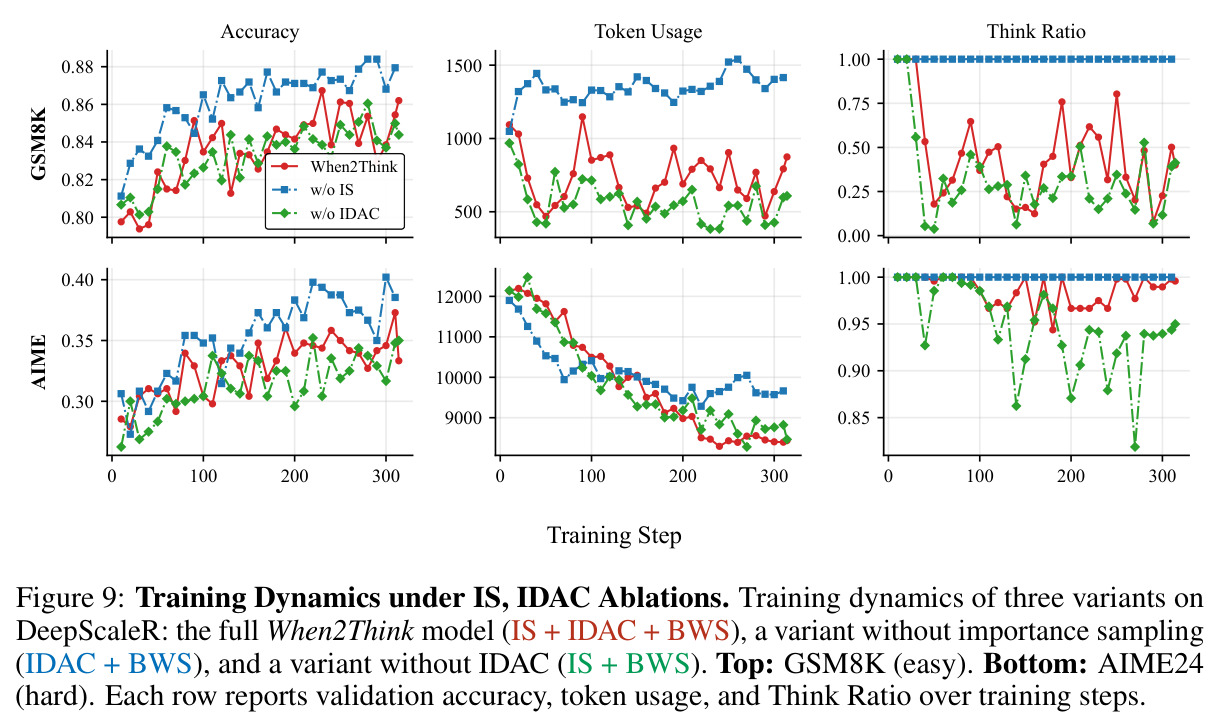
重要性采样是防止策略过早坍缩到单一模式、维持混合推理探索的关键机制,也是消融实验(w/o IS)的分析对象,涉及训练稳定性与效率的结论都与此相关。
Pass@k 与效率指标
Pass@k 是采样式评估指标:对同一题目独立采样 $k$ 次输出,只要至少一次答案正确即算通过,衡量模型多次尝试下的成功率上限;效率则以每实例平均生成 token 数衡量,两者结合刻画准确率—效率权衡(帕累托前沿)。
论文所有主实验以 Pass@3 报告准确率、以平均 token 报告成本,AIME24 上 +10.0% 精度与 -27.9% token 的双改善就是用这两个指标定义的。
研究动机
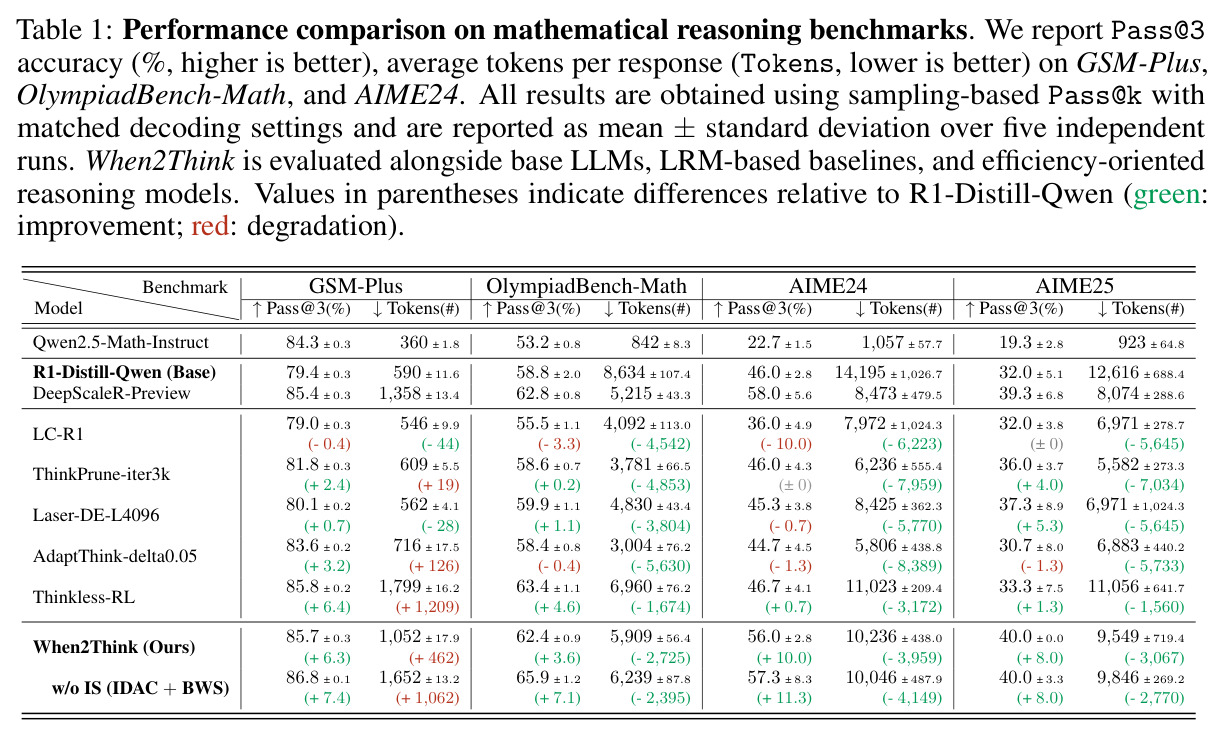
大型推理模型(LRM)存在系统性低效:对简单题过度思考(overthinking),生成大量冗余推理 token 却无精度收益;对难题又思考不足(underthinking),推理链过早截断或碎片化。更棘手的是,现有提效手段本身会引入'效率税'(efficiency tax):统一长度惩罚或静态压缩在砍掉简单题冗余推理的同时,也砍掉了难题上仍然必需的推理。论文用数据量化了这一点:在 AIME24 上,基座 R1-Distill-Qwen 以 14,195 个 token 拿到 46.0% 的 Pass@3,压缩方法 LC-R1 把 token 压到 7,972,准确率却暴跌 10 个百分点至 36.0%;离散路由方法 AdaptThink 省 8,389 个 token 的同时也损失 1.3 个点(44.7%)。即省下的算力是以难题准确率为代价换来的,成本只是被转移而非消除。
本文的目标是本文目标是训练一个单一的混合推理模型,实现实例级自适应计算分配:简单题走 SYSTEM 1 式直接作答(NOTHINK),把 token 用量降到 LLM 水平;难题保留甚至加深 SYSTEM 2 式长推理(THINK),保住 LRM 级准确率。可量化的目标是同时在两个方向上改善——例如在 AIME24 上相对基座 R1-Distill-Qwen 既提升 Pass@3 又大幅降低平均 token,从而证明效率税可以被消除而非仅仅转移。实验达成该目标:AIME24 Pass@3 提升 10.0 个点至 56.0%,token 减少 27.9%(省 3,959 个),AIME25 达 40.0% Pass@3,全面超过压缩与路由两类基线。
与已有工作不同的是,已有工作分两条路线,各有盲区。压缩路线(LC-R1、ThinkPrune、LASER)用全局或启发式长度约束缩短思维链,本质是'一刀切'地最小化长度,无法感知单题难度;混合推理路线(AdaptThink、ThinkLess)学习控制器决定是否跳过思考,但只回答'要不要想'(when),不回答'想多深'(how much),在难题上会系统性分配不足。本文的独特切入是把高效推理从'压缩问题'重新表述为'实例级自适应计算分配问题':奖励不再简单惩罚长度,而是用离线预计算的每题参考统计量(难度 $\alpha_i$、预算 $\tau_i$)做连续的难度感知调制,在统一策略中同时学习模式选择与推理深度,即'低效源于算力错配而非容量不足'的新诊断。
核心方法
直觉上,好的答题者会先掂量题目难度:简单题秒答,难题沉下心多想几步。技术上是两阶段后训练框架。第一阶段离线预计算:用参考策略 $\pi_{ref}$ 对每个训练题采样 $K$ 条轨迹,统计参考准确率 $\alpha_i$(难度代理)与参考长度 $\tau_i$(token 预算)并缓存。第二阶段在线强化学习:沿用 AdaptThink 的重要性采样方案,每条轨迹开头的模式 token(THINK/NOTHINK)由探索策略均匀采样以保证平衡探索,后续 token 由当前策略 $\pi_\theta$ 生成;奖励由可验证器正确性乘以 IDAC 调制的效率加成、再减去实例基线 $\alpha_i$ 构成;优势用批内标准化(BWS)得到,无需 critic;最后按 PPO 风格裁剪代理目标更新。整个流程无奖励模型、无学习 critic、训练时无需在线查询参考模型,训练在 R1-Distill-1.5B 上用约 4 万道竞赛数学题的 DeepScaleR 数据集完成。
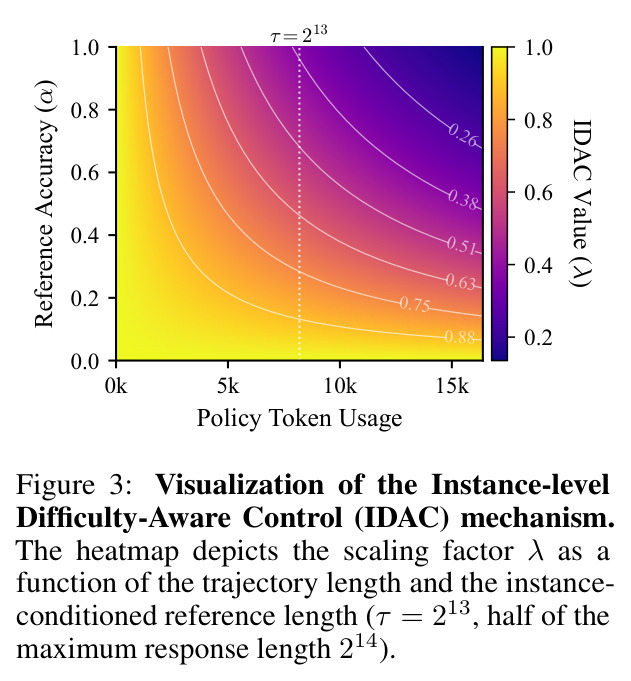
核心创新是实例级难度感知控制 IDAC——一个确定性的轨迹级长度衰减因子。定义 $\tilde{\lambda}_{i,k}=\exp\left(-\frac{T(o_{i,k})}{\tau_i}\alpha_i\right)$,THINK 模式取 $\lambda_{i,k}=\tilde{\lambda}_{i,k}$,NOTHINK 模式取 $\lambda_{i,k}=1$,嵌入奖励 $r_{i,k}=\mathcal{V}(x_i,o_{i,k})(1+\lambda_{i,k}\delta)-\alpha_i$($\delta>0$ 控制效率加成强度)。参考准确率 $\alpha_i$ 编码难度:简单题 $\alpha_i$ 大、指数衰减陡,长轨迹被强惩罚;难题 $\alpha_i$ 小、衰减平缓,允许更长推理。同时 $\alpha_i$ 兼作逐实例奖励基线,天然免去学习 critic。与已有方法的本质区别:压缩方法用静态全局约束、路由方法用离散 0/1 决策,而 IDAC 是按实例难度连续缩放的深度控制器,把'何时想'与'想多深'统一进同一个奖励函数。
方法步骤详情
完整流程五步。第一步,参考预计算:每轮训练前用 $\pi_{ref}$ 对每个 $x_i$ 采样 $K$ 条轨迹,答案比对得验证函数 $\mathcal{V}=\mathbb{I}[g(o')=y_i]$,算出 $\alpha_i$($\gamma=0.9$)与 $\tau_i$ 并缓存。第二步,数据收集:探索策略 $\pi_{IS}$ 均匀采样初始模式 token(NOTHINK 直接作答,THINK 推理至结束符),其余 token 由当前策略 $\pi_\theta$ 生成。第三步,奖励计算:求 $r_{i,k}$,答对才可能获得效率加成,$\alpha_i$ 把奖励中心化到参考水平。第四步,优势估计:对每个轨迹序号 $k$ 求批内 $M$ 个实例的均值方差,得 $A_{i,k}=(r_{i,k}-\mu_k)/(\sigma_k+\varepsilon)$(BWS),同轨迹所有 token 共享。第五步,按含重要性比率 $\rho_{i,k}$ 的 PPO 裁剪目标更新参数。基座 R1-Distill-1.5B,数据为约 4 万道竞赛数学题的 DeepScaleR 数据集。
技术新颖性
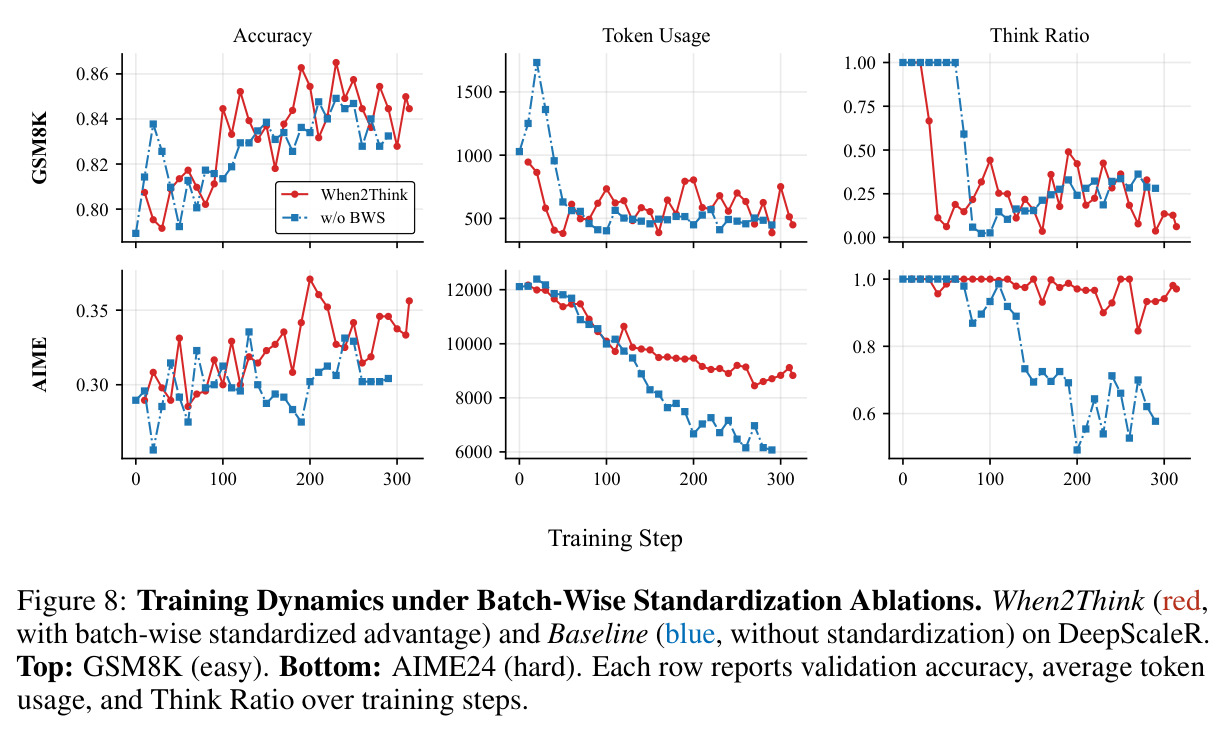
技术新颖性有四点。其一,把推理效率从'压缩'重构为'分配',用离线参考统计把题目难度显式写进奖励,是对 LRM 低效根因(算力错配而非容量不足)的新诊断,DeepScaleR-Preview 的强劲表现也佐证分配改善能带来效率收益。其二,IDAC 是确定性的轨迹级连续控制量,而非可学习模块或离散路由,零额外参数且可解释(Figure 3 热力图直观展示 $\lambda$ 随长度与 $\tau$ 的衰减)。其三,$\alpha_i$ 一量两用——既是难度缩放因子又是逐实例基线——使无 critic 的 PPO 式优化依然稳定,绕开学习奖励模型与在线参考模型查询的开销。其四,BWS 沿轨迹序号 $k$ 在批内标准化而非全批混合,保留跨实例难度结构,让难题上的长轨迹仍能获得正优势。消融印证分工:IDAC 主攻精度(w/o IS 变体 AIME24 达 57.3%),BWS 稳定优化(think 比率 0.9 对 0.6),IS 主攻效率(GSM-Plus token 从 1,652 降到 1,052)。
实验结果
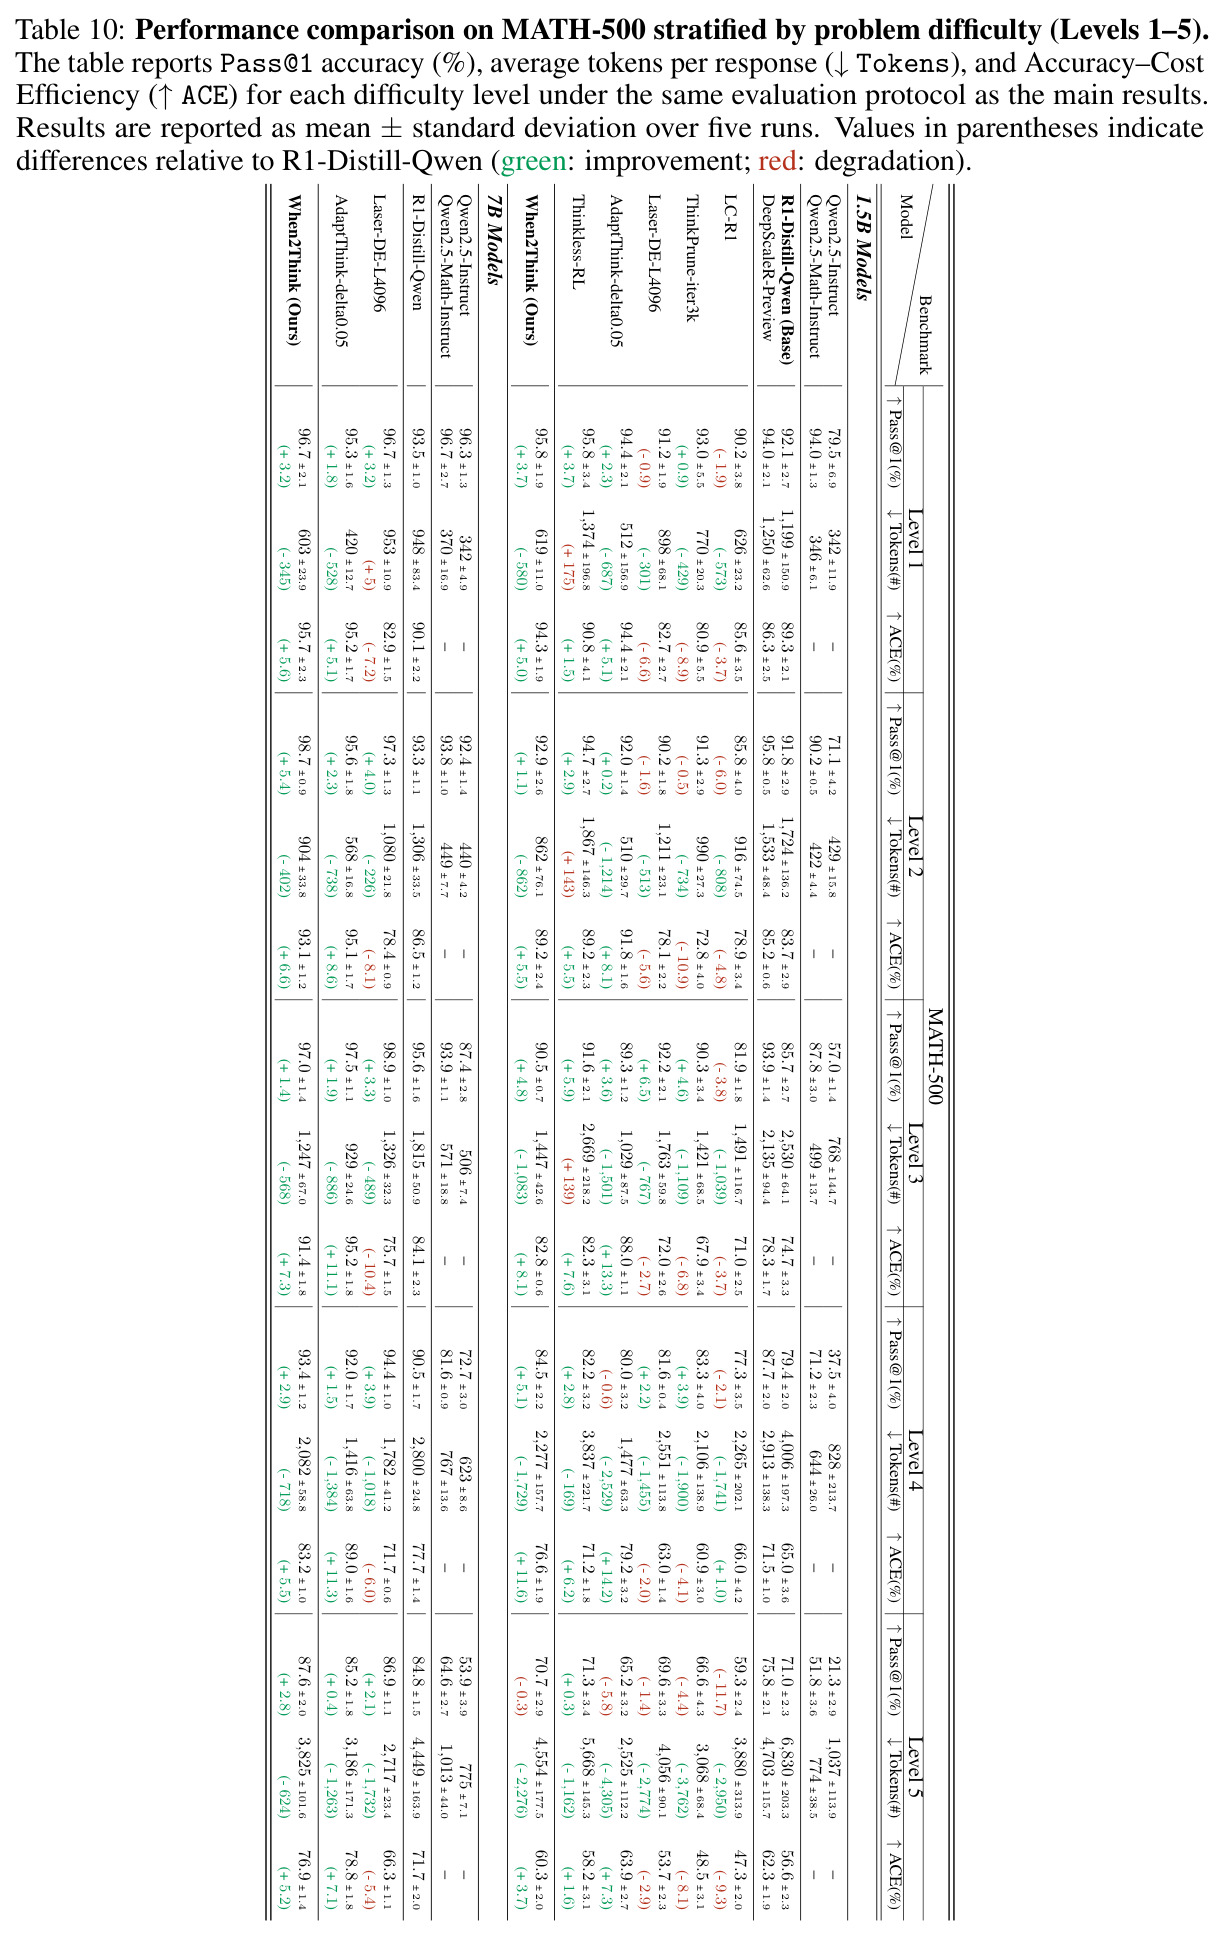
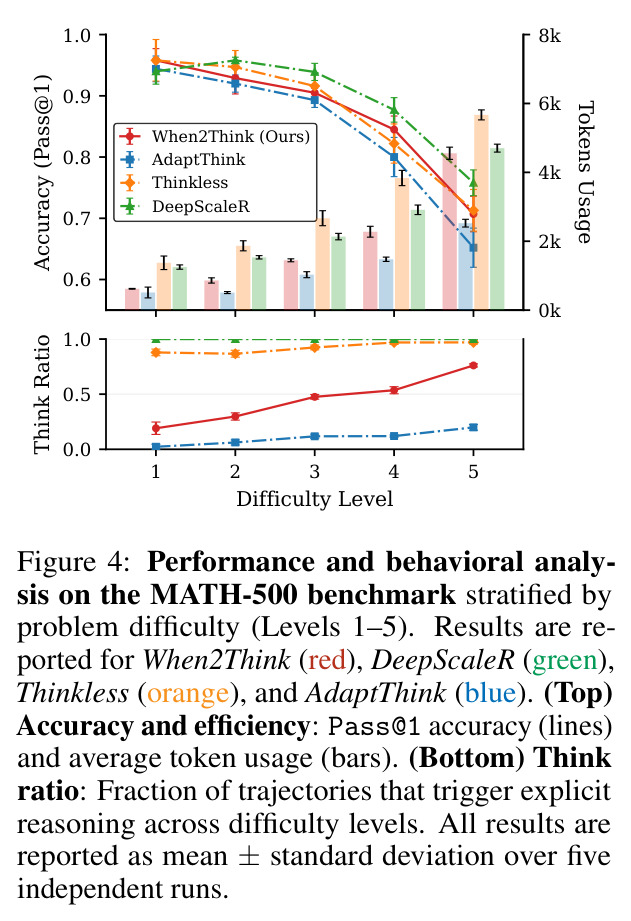
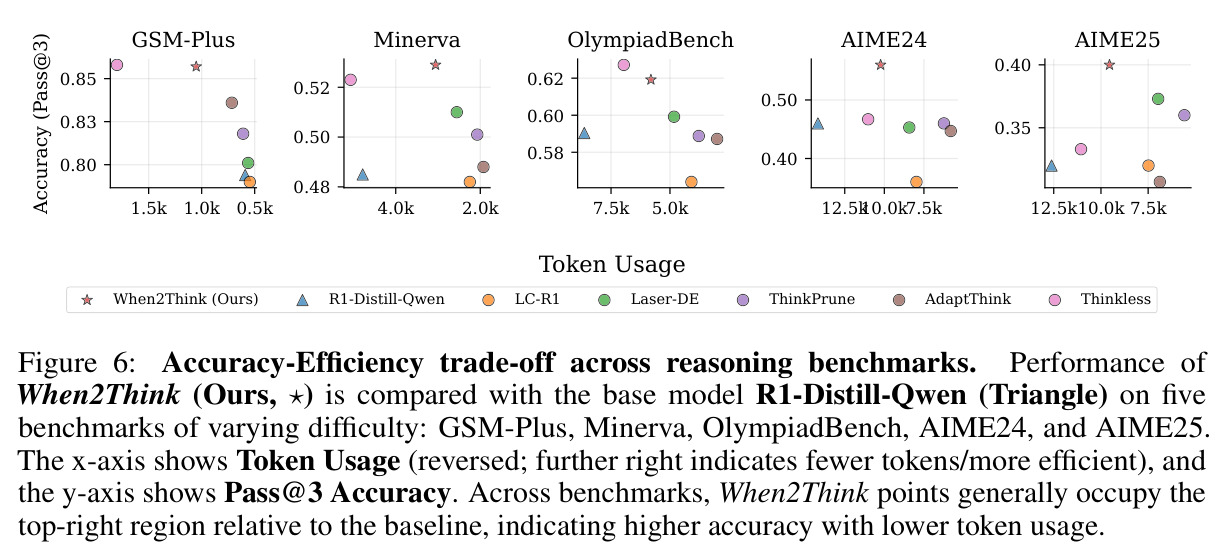
主实验(Table 1)全面改善。AIME24:56.0% Pass@3,比基座 46.0% 高 10.0 个点,token 从 14,195 降至 10,236(-27.9%)。AIME25:40.0% 对基座 32.0%(+8.0),token 省 3,067,超全部基线。GSM-Plus:85.7%(+6.3),token 反增 462(对扰动题有意加深推理)。OlympiadBench:62.4%(+3.6),省 2,725 token。难度分层 MATH-500 揭示机制:Level 1 token 从 1,199 砍到 619 仍保 95.8% 精度,Level 5 省 2,276 token 不掉点,THINK 比率从约 0.2 单调升至 0.7 以上(基线则近常数或难题欠分配)。消融:w/o IS 变体精度最高(AIME24 57.3%、OlympiadBench 65.9%),精度主要来自 IDAC+BWS;IS 贡献在效率(GSM-Plus 1,652→1,052 token);BWS 稳住 think 比率约 0.9(无 BWS 为 0.6)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AIME24(竞赛数学) | Pass@3 准确率 / 平均 token | 56.0% / 10,236 tokens | 基座 R1-Distill-Qwen 46.0% / 14,195 tokens | 准确率 +10.0 个点,token -27.9%(省 3,959 个) |
| AIME25(竞赛数学) | Pass@3 准确率 / 平均 token | 40.0% / 9,549 tokens | 基座 32.0% / 12,616 tokens;基线中最高 LASER 37.3% | 准确率 +8.0 个点,token 省 3,067 个,全面超越压缩与路由基线 |
| GSM-Plus(对抗扰动小学数学) | Pass@3 准确率 / 平均 token | 85.7% / 1,052 tokens | 基座 79.4% / 590 tokens | 准确率 +6.3 个点,token +462(对扰动难题有意加深 SYSTEM 2 推理) |
| OlympiadBench-Math(奥赛级) | Pass@3 准确率 / 平均 token | 62.4% / 5,909 tokens | 基座 58.8% / 8,634 tokens | 准确率 +3.6 个点,token 省 2,725 个 |
| MATH-500 难度分层(RQ2 行为分析) | Pass@1 / THINK 比率 / 平均 token | L1 token 1,199→619(精度 95.8%);L5 省 2,276 token 不掉点;THINK 比率 0.2→0.7+ 单调升 | 基座各难度均长推理;ThinkLess 比率近常数;AdaptThink 难题欠分配 | 难度—计算对齐度最高,实现 LLM 级效率 + LRM 级精度 |
局限与改进
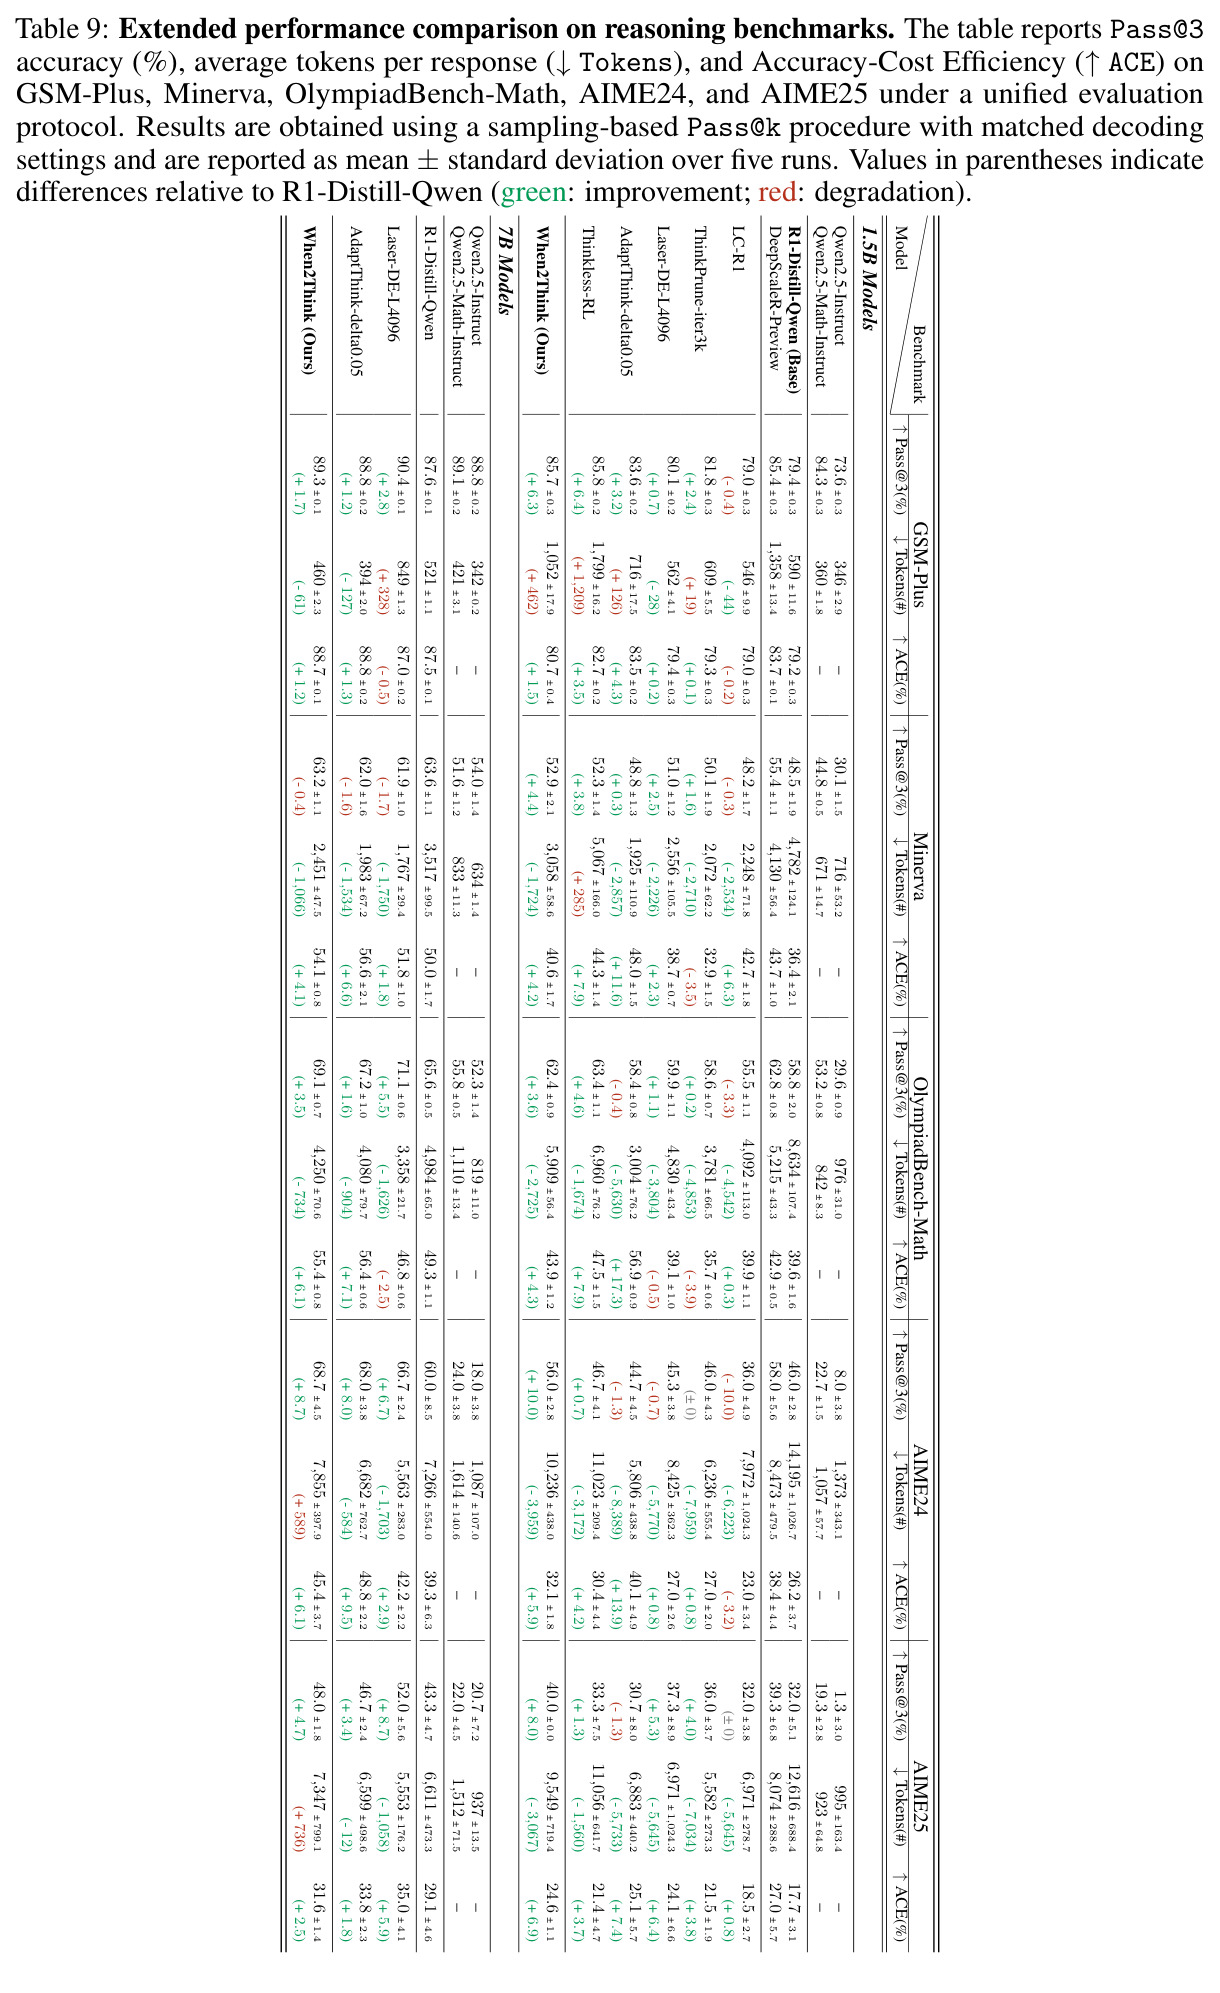
作者承认三点:方法依赖可验证奖励,最适用于数学等可自动判对的领域,扩展到开放式任务需要额外奖励建模或人工评估;难度估计依赖离线参考统计,题目难度本身模糊时 $\alpha_i$、$\tau_i$ 不再可靠;存在'规模悖论'——效率税在 1.5B 小模型上最明显(附录 Table 9、10),大模型天然推理更高效,方法收益是否随规模保持存疑。我的补充观察:参考统计按 epoch 预计算后冻结,随策略改进会逐渐过时(stale),$\tau_i$ 预算可能无法反映策略已学会的更短解法;AIME25 全量模型报告 40.0±0.0,五次运行方差为零略显异常;$\gamma$、$\delta$、$K$ 等超参的敏感性未系统报告;GSM-Plus 上 token 反增 462,说明'更省'并非在所有基准成立,效率叙事需谨慎解读。
独立分析的弱点
独立分析四个弱点。第一,参考统计静态化:$\alpha_i$、$\tau_i$ 每轮预计算后使用,策略变强后基线失真,可能惩罚过于精炼的更优解法;改进方向是滚动更新或用指数移动平均平滑参考统计。第二,难度代理粗糙:$\alpha_i$ 只是参考策略的采样准确率,$K$ 有限时方差大,且'参考策略做不出'不等于'对目标策略难',两者能力分布不同;可引入多参考模型集成或基于通过率的连续难度标注。第三,训练开销与稳定性:每题每轮 $K$ 条参考轨迹的生成成本不低,重要性采样引入比率方差,方法仅在 1.5B 上验证,向更大模型扩展的训练成本未知;改进方向是结合离线偏好优化减少采样量,或用难度课程调度采样预算。第四,评估面窄:全部为数学基准,'效率税'在代码生成、Agent 长程任务上的存在性与方法迁移均未知,这是结论外推的最大风险;应先在代码(测试通过率可验证)上复现验证。此外 $\delta$ 的取值只有定性说明,效率加成过强是否诱发投机性短答案值得压力测试。
未来方向
作者提出的方向:把 When2Think 扩展到开放式任务,引入奖励模型或人类评估替代可验证器;改进难度模糊情形下的参考统计可靠性。基于成果可延伸的:其一,在线/增量式参考统计更新,让 $\alpha_i$、$\tau_i$ 随策略进化滚动刷新,消除陈旧性问题;其二,把 IDAC 思想迁移到代码生成、工具调用与 Agent 长程任务,用测试通过率等可验证信号定义难度;其三,研究规模定律——效率税随模型规模的衰减曲线,以及 IDAC 在 7B/32B 上的边际收益;其四,与测试时扩展(best-of-n、自一致性)结合,做预算感知的推理调度,把'想多深'与'采样几次'统一优化;其五,理论层面刻画'分配优于压缩'的充分条件,例如静态长度惩罚何时必然产生效率税,为奖励设计提供原则性指导。
复现评估
复现条件较好。基座 R1-Distill-Qwen-1.5B 与全部基线(LC-R1、ThinkPrune、LASER、AdaptThink、ThinkLess)均为开源权重;训练数据 DeepScaleR(约 4 万道竞赛数学题,聚合 AIME 1984-2023、AMC、Omni-MATH、Still)公开可下载;评估基准 GSM-Plus、OlympiadBench、AIME 2024/2025、Minerva、MATH-500 全部公开,判分用 Math-Verify 与 MARIO Eval 双验证器,均有开源实现。附录 A/B 给出实现细节($\gamma=0.9$、IS 方案、BWS 与 PPO 设置)。1.5B 规模配合无 critic 的 BWS 优化,对算力要求温和,单节点多卡(8×A100 级别)应可复现;参考预计算的 $K$ 值与 $\pi_{ref}$ 具体设置需查阅附录确认。正文未提及官方代码发布,RL 训练管线(模式 token 注入、重要性加权、双验证器对齐)需自行实现,整体难度中等,主要工程量在训练基础设施与判分对齐。
论文图表
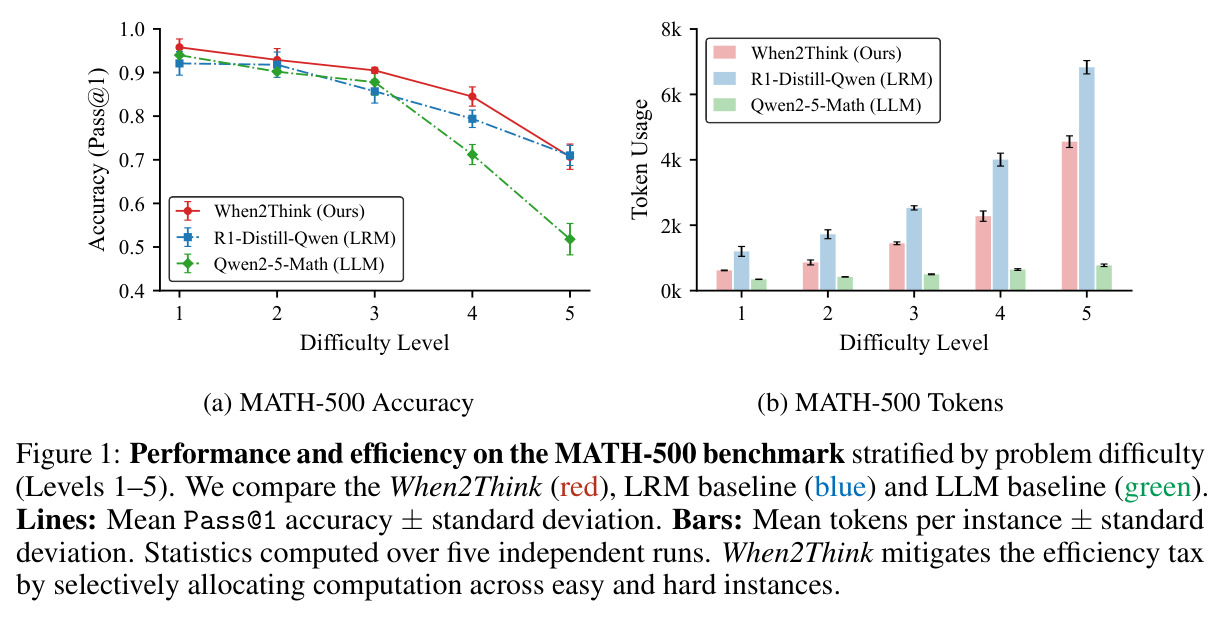
双子图对比 When2Think(红)、LRM 基线 R1-Distill-Qwen(蓝)、LLM 基线 Qwen2.5-Math(绿)在 MATH-500 五个难度等级上的 Pass@1 精度(折线)与平均 token 用量(柱状),统计基于五次独立运行。LLM 简单题省 token 但难题掉分,LRM 难题强但简单题浪费,When2Think 在各难度上同时逼近两者优点。
一图点题'效率税':直观展示三类模型的精度—token 剖面差异,是理解研究动机与理想行为(简单题快答、难题深思)的入口。