DuoDiscover:突破评估瓶颈的可扩展自主发现系统 DuoDiscover: Scaling Autonomous Discovery Beyond the Evaluation Bottleneck
让智能体共发现优化目标与廉价评估标尺,以保真测试防漂移,突破真评估瓶颈
前置知识
代理评估器与多保真优化(MFO)
多保真优化指同时使用昂贵但精确的评估(如完整基准测试)与廉价但近似的评估(代理模型、缩减输入)来指导优化:大部分预算花在廉价代理上,只在关键候选上调用昂贵真评估。常见做法是拟合可校正的代理模型,或自适应分配资源、逐步淘汰劣质候选。
DuoDiscover 的 yardstick 正是智能体自写的代理评估器,理解 MFO 的'便宜筛选、昂贵确认'逻辑是读懂其快慢双循环设计的前提。
Kendall τ 秩相关
一种非参数统计量,衡量两个评分对同一组对象的排序一致程度:τ = (n_c − n_d)/(n_c + n_d),其中 n_c 是顺序一致的对数、n_d 是顺序相反的对数,取值 [−1,1],1 表示完全同序。本文只在真分差超过 2σ̂ 噪声的'可分辨对'上计算该统计量。
保真测试完全建立在受限 Kendall τ 上:τ≥0.5 是 yardstick 验证的门槛,漂移检测与作废逻辑全部由它驱动,是方法的核心统计工具。
奖励黑客(reward hacking)
当优化器针对一个代理奖励而非真实目标搜索时,会找到提高代理分数却不产生真实收益、甚至钻空子的解。这是 RLHF 与代理优化中的经典风险:代理与真目标之间的缝隙会被搜索过程自适应地利用,且代理越被优化偏差越大。
本文的关键动机:yardstick 初期忠实也会随搜索漂移而失真,保真测试与'真评估确认每笔收益'的机制正是为对抗这种被利用的缝隙而设计。
阿姆达尔定律
局部优化收益的基本上限:若某部分占总时间的比例为 w,即使把这部分加速到无穷快,整体加速比上限为 1/(1−w)。例如一个占 20% 时间的区域,无论优化得多好,最多只能带来 1.25 倍的整体提升。
每个智能体选定目标后要估计其对真分数的贡献占比 w_T,并用该定律判断优化天花板,避免把昂贵预算浪费在无关紧要的代码区域上。
速度之光(SOL)分数
衡量 GPU 内核实现达到硬件理论峰值吞吐百分比的指标。SOL-ExecBench 用它为 235 个真实内核打分并维护公开排行榜;未优化参考码平均仅 26% SOL,100% 意味着完全榨干硬件的带宽与算力。
SOL-Exec 是论文最重要的内核基准,79.74% 的平均 SOL 分数与排行榜名次是核心实验结果,不理解该指标无法解读内核实验。
进化式自主发现(FunSearch/AlphaEvolve)
用 LLM 充当变异算子、程序化反馈充当适应度的搜索范式:维护候选程序种群,迭代生成、评估、筛选。FunSearch 发现了组合数学的新构造,AlphaEvolve 将其扩展为自动化流水线,是本文最主要的对照谱系。
DuoDiscover 的定位是修正这条路线的盲点:AlphaEvolve 需要用户标记演化区域且把评估器视为给定,而本文让评估器与优化目标一起被自动发现。
研究动机
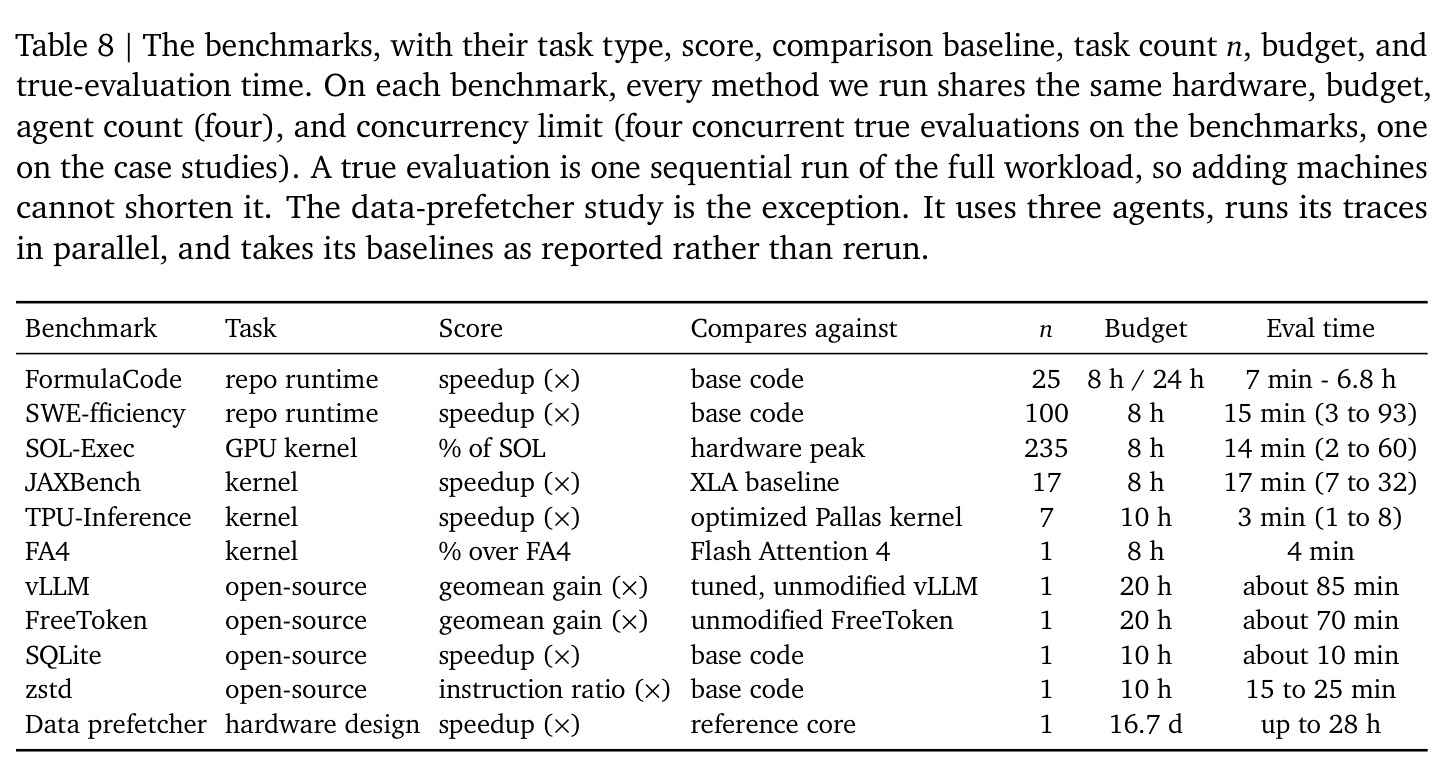
搜索式自主发现系统(如 FunSearch、AlphaEvolve)将 LLM 与迭代搜索和评估器反馈结合,在数学、算法和系统优化上成绩斐然,但它们大多假设评估器是给定且固定的。在算法基准上这没问题——一次评估只需几秒;可在真实工程系统上,评估本身就是瓶颈。论文给出的具体数据:优化 vLLM 的多目标服务,一次真评估需要 85 分钟,即便前沿编码智能体在 20 小时预算内也只能做十几次评估;SWE-fficiency 的评估中位数 15 分钟、最长 93 分钟;SOL-Exec 内核评估中位 14 分钟、最长 1 小时;而 CPU 微架构预取器设计(DPC4)单次真评估要跑约 1700 个模拟、消耗约 2600 CPU 小时、最长 28 小时。评估昂贵意味着无论搜索算法多聪明,能被真正测试的候选被严格限制在几十个量级,这就是自主发现扩展到真实世界工程的核心瓶颈。
本文的目标是本文的目标是构建一个在'评估成为瓶颈'的真实系统上仍能扩展的自主发现系统 DuoDiscover,让它联合回答两个此前被拆开的问题:优化什么(target)以及如何廉价度量进展(yardstick)。具体目标有三:(1) 让每个编码智能体自己发现值得优化的代码区域,并为该区域自动编写一个比真评估快几十倍的代理评估器(yardstick),然后对 yardstick 而非真目标爬山搜索;(2) 保证搜索不被代理与真目标之间的缝隙欺骗——每笔上报收益都必须经真评估确认,且 yardstick 的排序保真度被持续复检、漂移即作废,做到零虚假收益;(3) 用自底向上的多智能体 fleet 加轻量编排器取代人工问题分解,在同一套机制下覆盖仓库软件、GPU/TPU 内核、开源系统软件直到 CPU 芯片微架构,并与人类专家及最强基线在完全相同的预算下比较。
与已有工作不同的是,已有工作的切入方式各不相同:进化搜索路线(FunSearch、AlphaEvolve 及其后续)专注改进搜索框架本身,把评估器当作给定,AlphaEvolve 甚至要求用户在源码中用显式标记指定要演化的代码区域;SIFT 只把昂贵评估留给最有希望的候选;LLM 生成测试的工作(CodeT、ExecCritic 等)用合成测试保证正确性而非加速搜索;多保真优化(MFO)则依赖预先拟合的固定代理模型或自适应资源分配。本文的独特之处在于三点叠加:第一,代理评估器不是预先设计而是由智能体针对每个目标即时编写,且与目标共同发现——一个目标只有配上忠实的廉价 yardstick 才值得优化;第二,保真度被当作运行时属性,系统在搜索中反复用 Kendall τ 检验并动态验证/作废 yardstick,直接对抗搜索利用代理漏洞的奖励黑客;第三,整个过程自底向上、无中央分解。据作者所述,这是首个在发现过程中自行合成并校验评估器的发现智能体。
核心方法
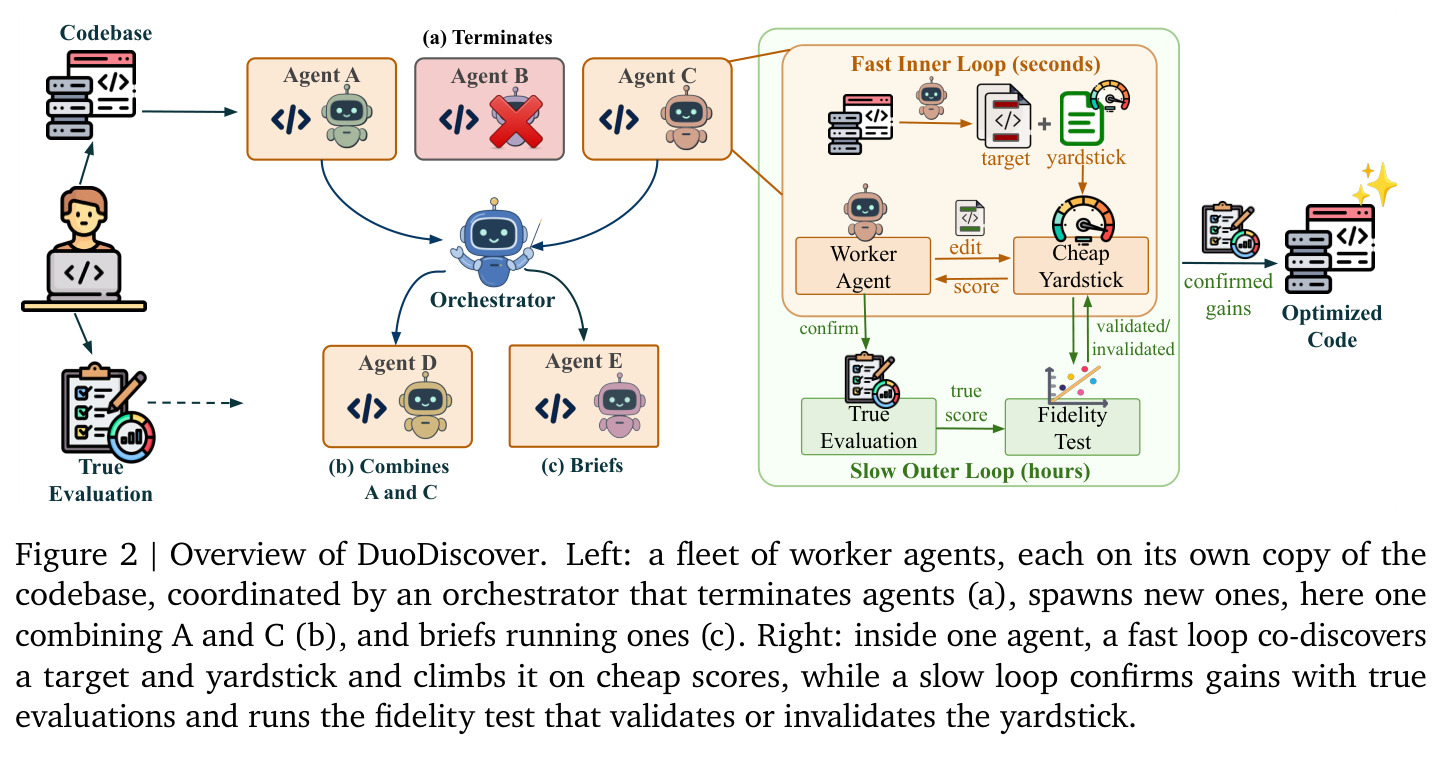
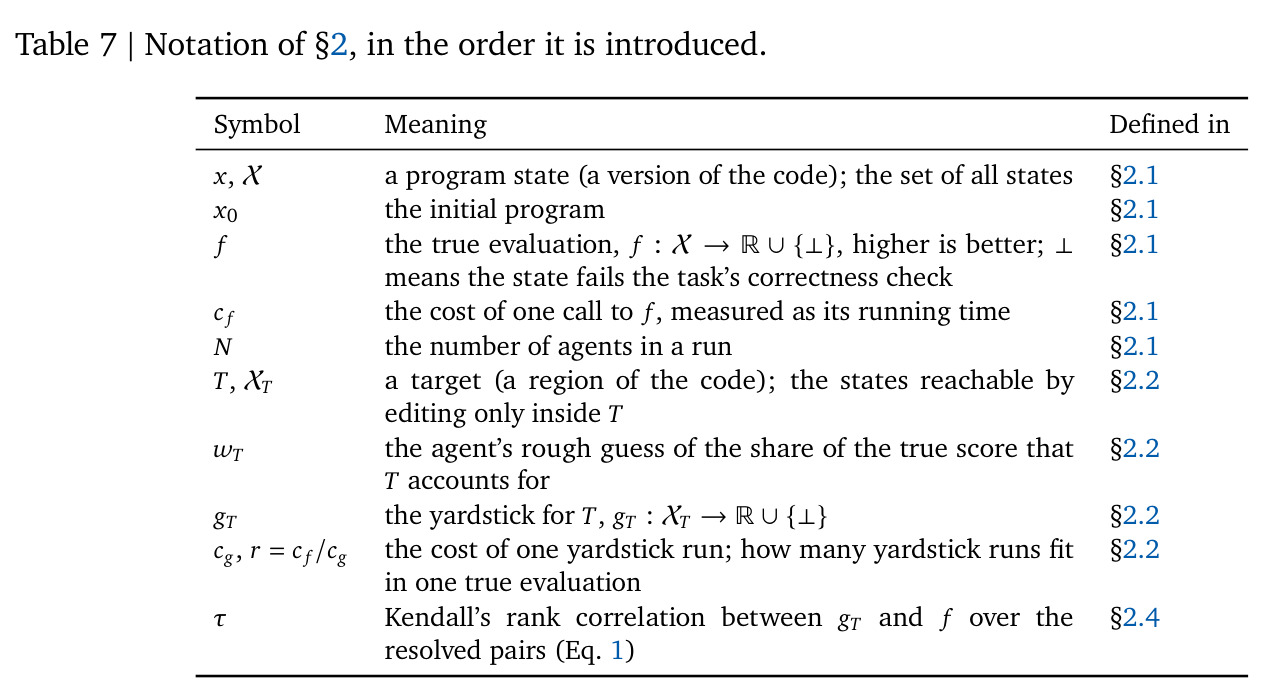
直觉上,大型加速往往来自对少数小代码区域的聚焦修改——一个热点函数或一个内核阶段——而这些局部区域的进展可以用远比完整评估便宜的方式度量:跑一个缩减输入的微基准、孤立计时热点循环、或用一个静态成本模型。DuoDiscover 把这个观察系统化:一群现成的编码智能体各持一份代码副本,先共同发现'目标 T(代码区域)+ 该目标的廉价标尺 g_T',然后在秒级的快速内循环中对 g_T 爬山;编排器管理的小时级慢外循环用真评估 f 确认每笔收益,并在每次真评估后重跑保真测试以验证或作废 yardstick。编排器的角色被刻意限制为协调而非规划:它读取各智能体的简短进度摘要,终止无进展者、在有望或未覆盖的目标上生成新智能体(可全新启动、继承已确认状态、或把多个智能体的已确认修改合并),并用 fleet 的发现简报在跑的智能体。整个系统没有中央问题分解,搜索结构从个体智能体的局部决策中自底向上涌现。
核心创新是'共发现'(co-discovery):优化目标与评估器必须联合选择。一个目标只有在能为它构建与真目标排序一致的廉价 yardstick 时才有价值;一个 yardstick 只对真正能改变真分数的目标才有用。论文的 vLLM 案例很直观:一个智能体选定调度器的 prefill 批处理为目标,并写了一个只建模 decode 步时间的成本模型作为 yardstick,秒级返回,而真评估要 85 分钟。这与 AlphaEvolve 需要用户标记演进区域、PerfAgent 按 profiler 固定流程走有本质区别。第二个关键创新是把保真度当作需要持续检验的运行时性质:由于搜索会自适应地利用 yardstick 与 f 之间的缝隙(奖励黑客),初始忠实的 yardstick 也会漂移,因此每次真评估后都用 Kendall τ(≥0.5,且只计真分差超过 2σ̂ 噪声的可分辨对)复检,漂移即作废,智能体重建标尺或换目标。真评估是唯一裁判:任何上报收益必须经它确认,系统因此永不计入虚假收益——快循环换速度、慢循环与保真测试保正确,这套组合而非任何单点技巧才是方法的本质。
方法步骤详情
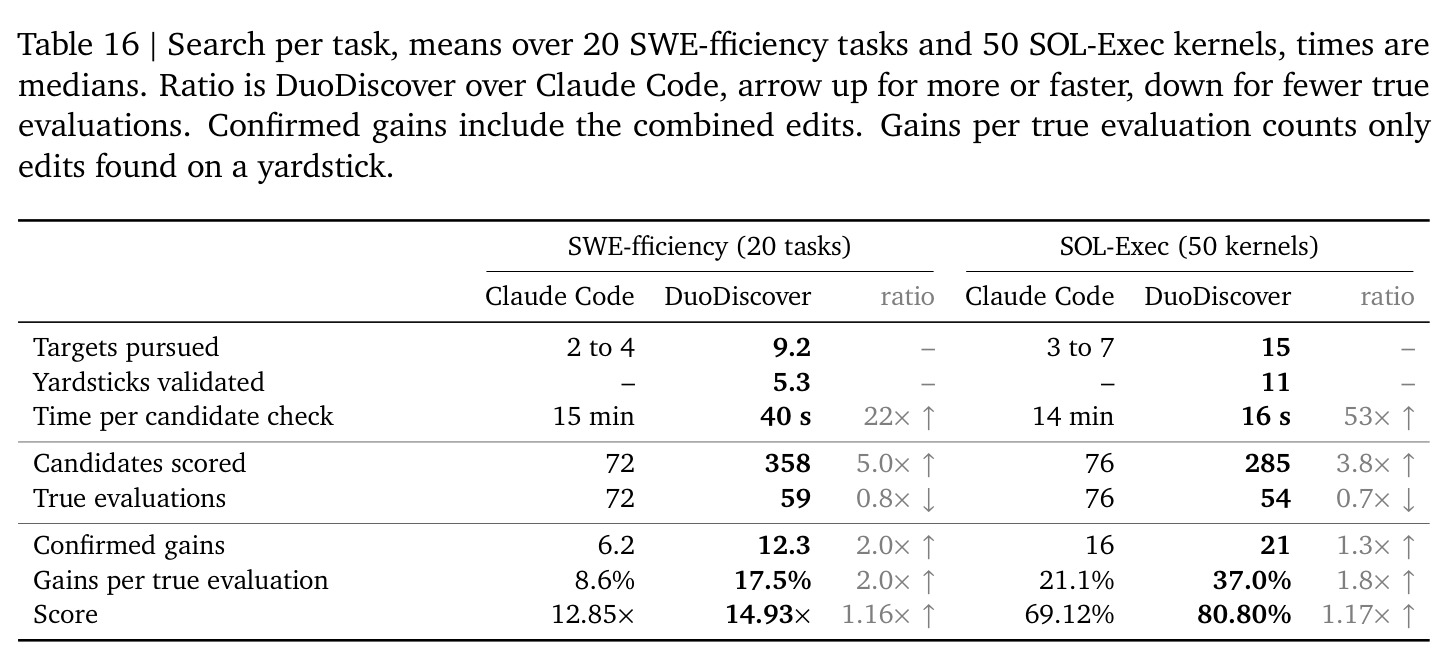
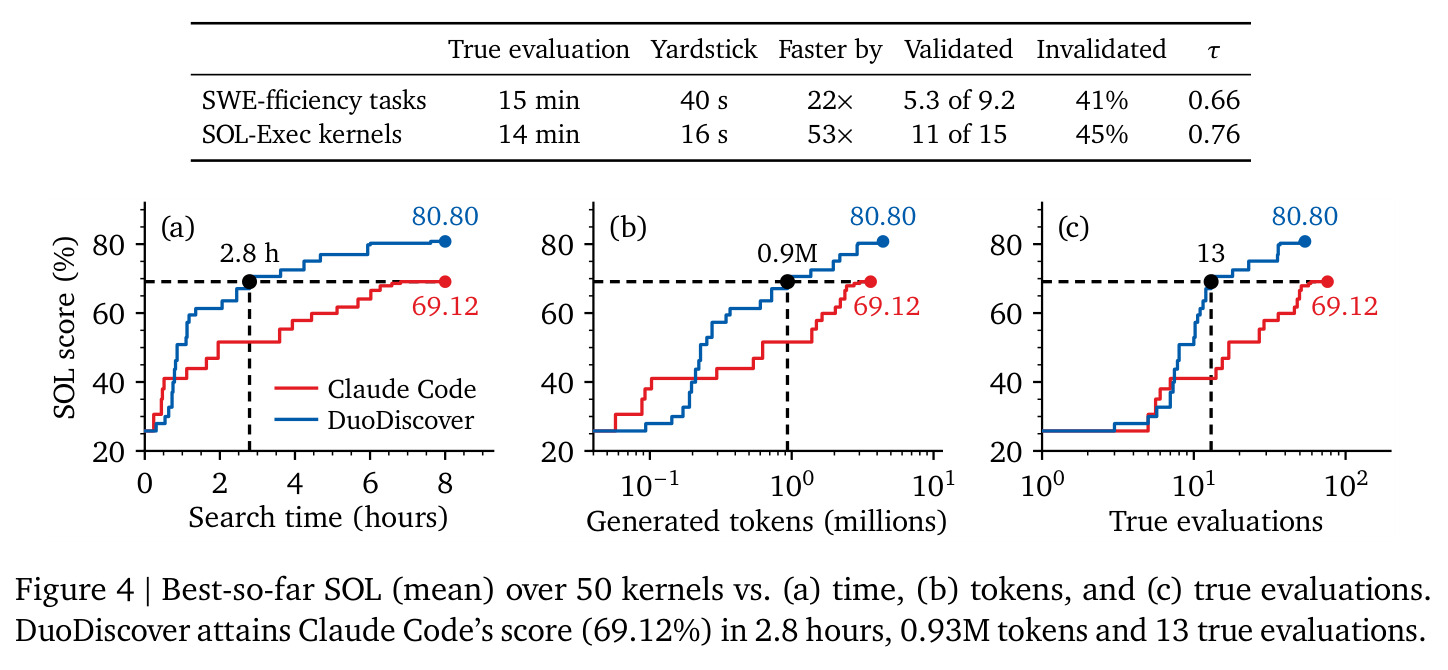
完整流程:(1) 编排器在共享预算下启动 N 个(基准 N=4)worker 智能体,各持代码副本,输入为任务与初始状态 x0。(2) 每个智能体剖析代码、自选目标 T(一个函数或模块等区域),并估计其贡献占比 w_T——按阿姆达尔定律,T 无限快也最多提升 1/(1−w_T) 倍。(3) 智能体编写 yardstick 脚本 g_T(返回分数与正确性标志),编排器测其成本并把加速比 r=c_f/c_g 反馈。(4) 快循环:在只许改 T 的状态空间内编辑→用 g_T 打分→改进保留、否则回滚;标尺中位仅 40 秒(仓库)/16 秒(内核),先筛掉 81–84% 候选。(5) 慢循环:少数有希望候选送真评估 f,确认增益才被接受。(6) 每次真评估后重跑保真测试:噪声 σ̂ 取同快照重复评估残差的 95% 置信上界,只在真分差超 2σ̂ 的可分辨对上算 Kendall τ;已测噪声、至少 6 个可分辨状态、τ≥0.5 且置换检验 α=0.05 显著则验证,否则作废,智能体重建标尺或换目标。(7) 编排器周期性终止/生成/简报智能体,把真评估预算导向有进展者。(8) 预算耗尽后报告最终候选多次重评估的中位数(按 Student-t 下界选择),绝不报搜索中见过的最高分。
技术新颖性
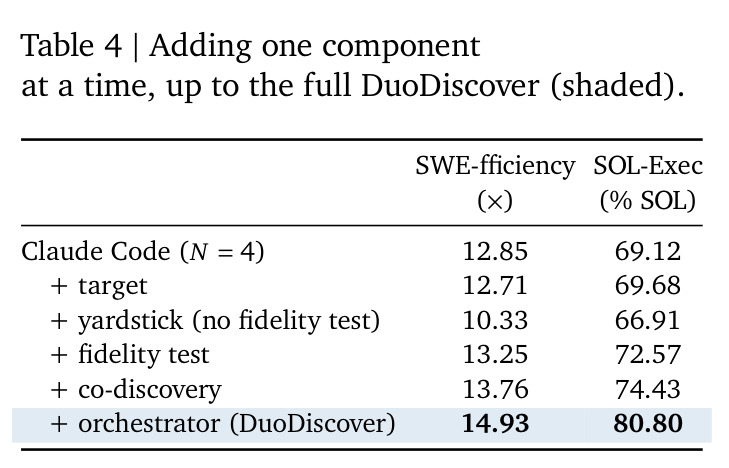
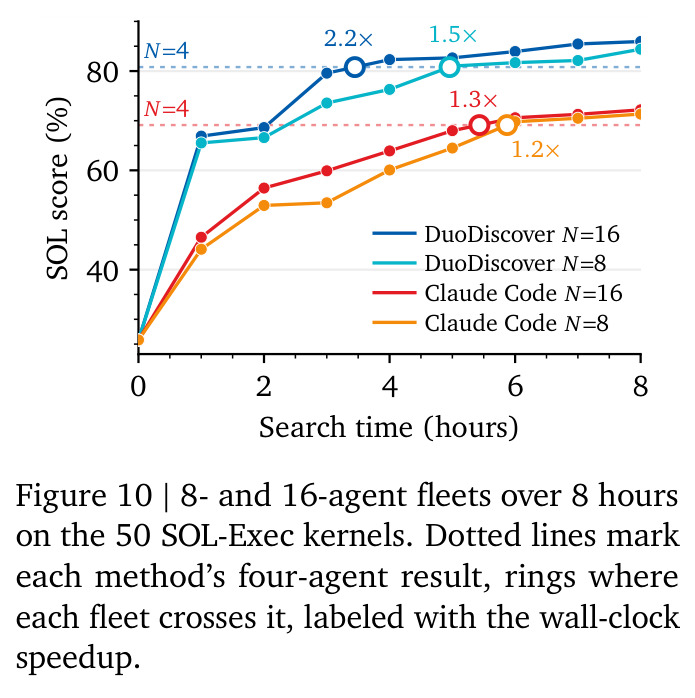
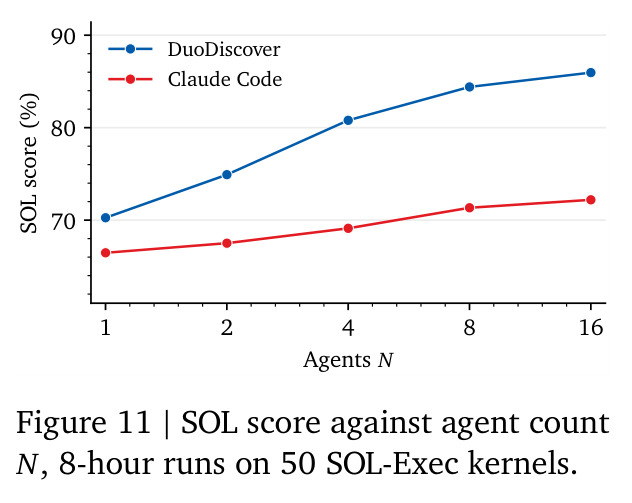
技术新颖性有四个维度。其一,评估器的自动合成与目标耦合:以往 MFO 的代理模型是任务级、预先拟合的,LLM 测试生成工作只针对正确性;DuoDiscover 的 yardstick 是目标级、搜索中即时编写的,消融证明任务级单评估器显著更差(仓库 12.98× vs 14.93×,内核 71.36% vs 80.80% SOL),因为裁剪工作负载会错排不同区域修改的收益。其二,把保真度从一次性校准升级为持续复检:45%(内核)/41%(仓库)的已验证标尺后来因漂移被作废,但系统零虚假收益。其三,编排器的终止/生成/简报与转移、合并机制让 fleet 规模化收益递增:N=16 时领先 Claude Code 13.8 个 SOL 点,N=1 时仅领先 3.8。其四,通用性:同一机制覆盖六个基准与五个真实系统(含约 5900 行 C++ 的芯片预取器设计)。消融还揭示组件深度耦合:不经验证的标尺把成绩拉到 10.33×,低于不用它的 12.85×,补上保真测试恢复到 13.25×,说明机制组合才是设计核心。
实验结果
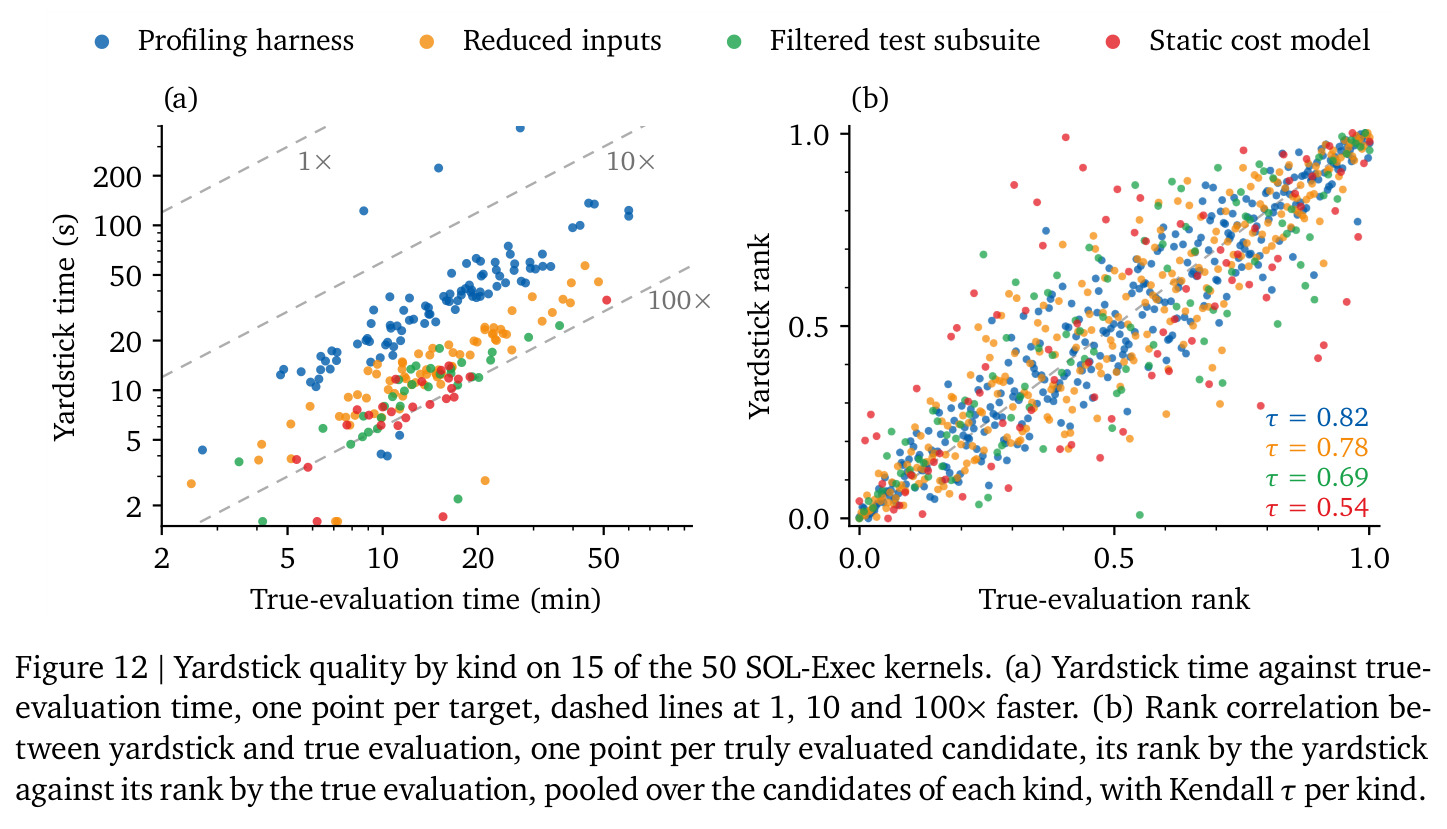
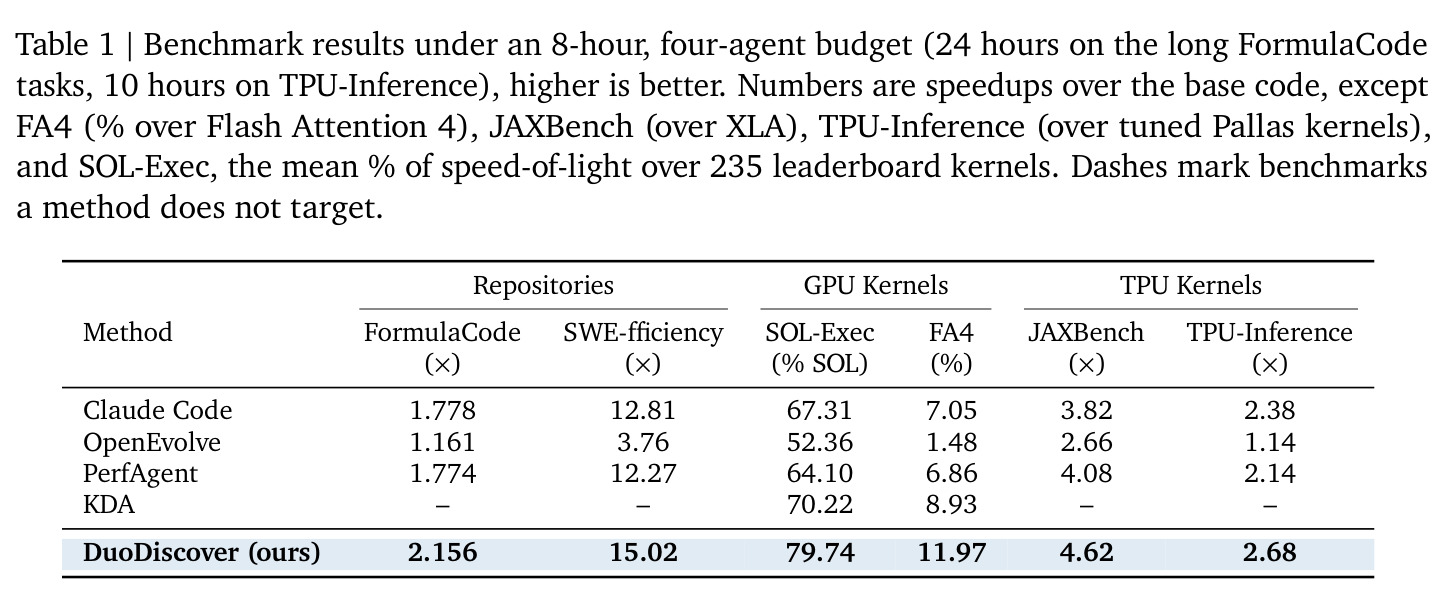
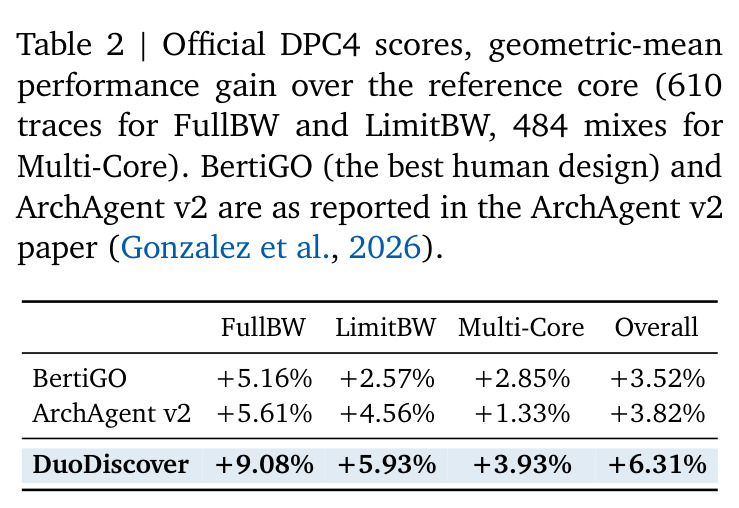
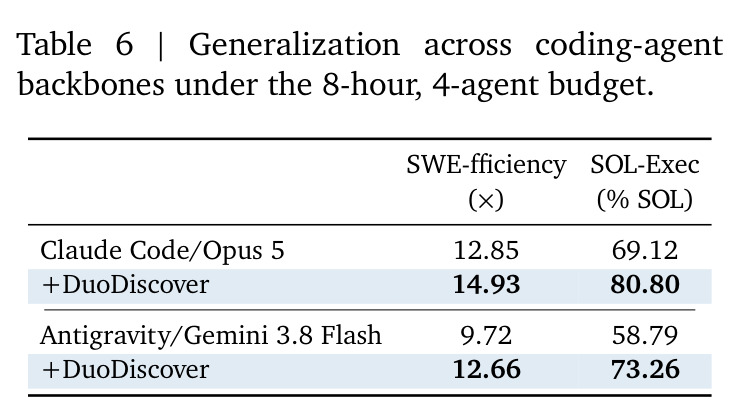
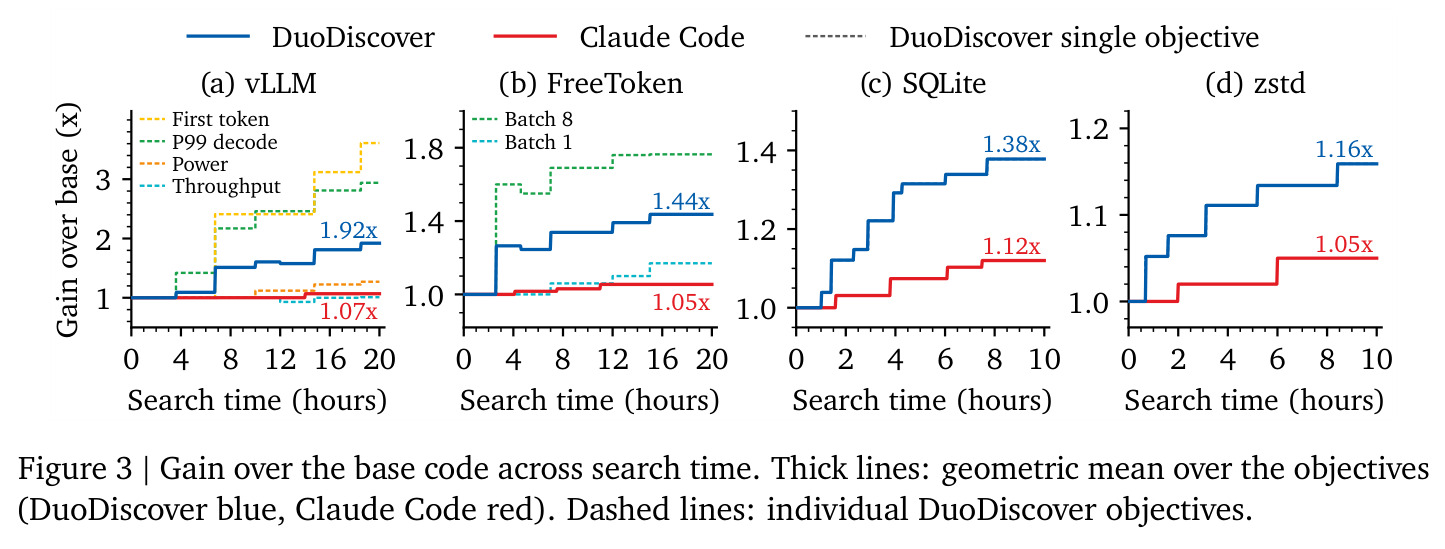
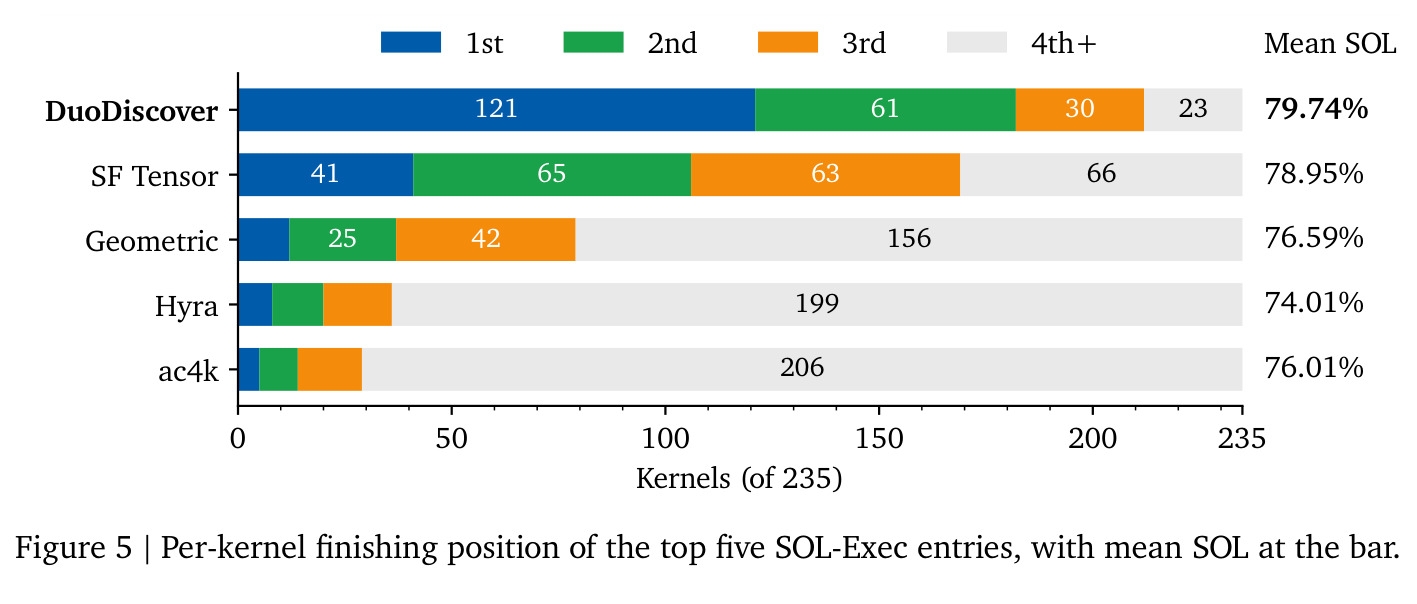
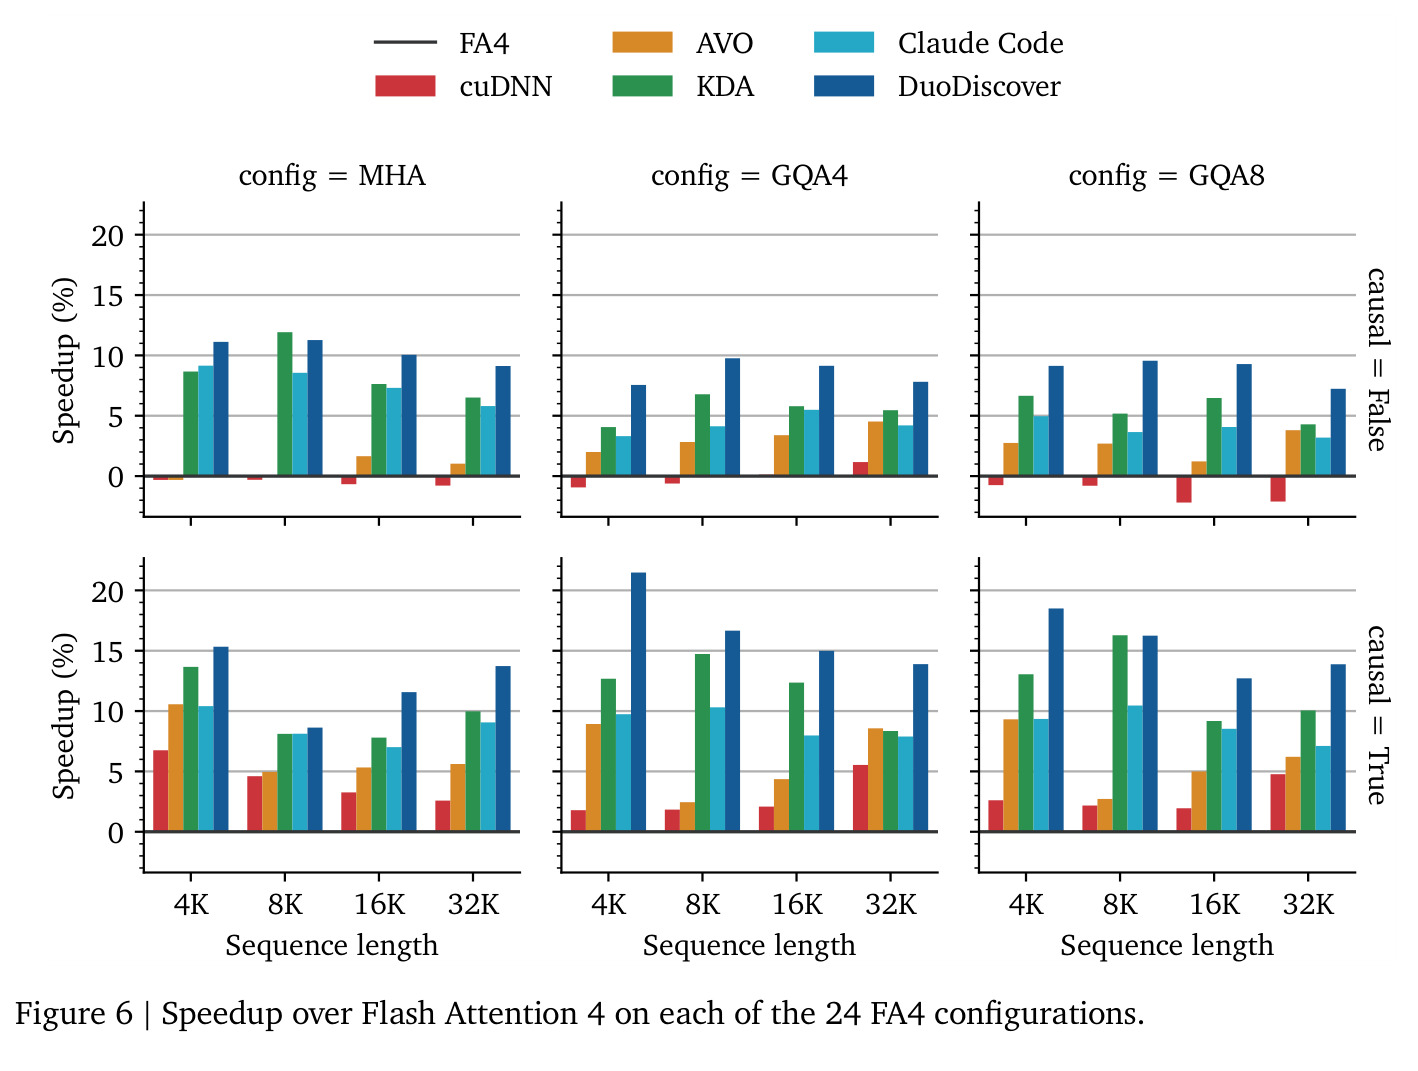
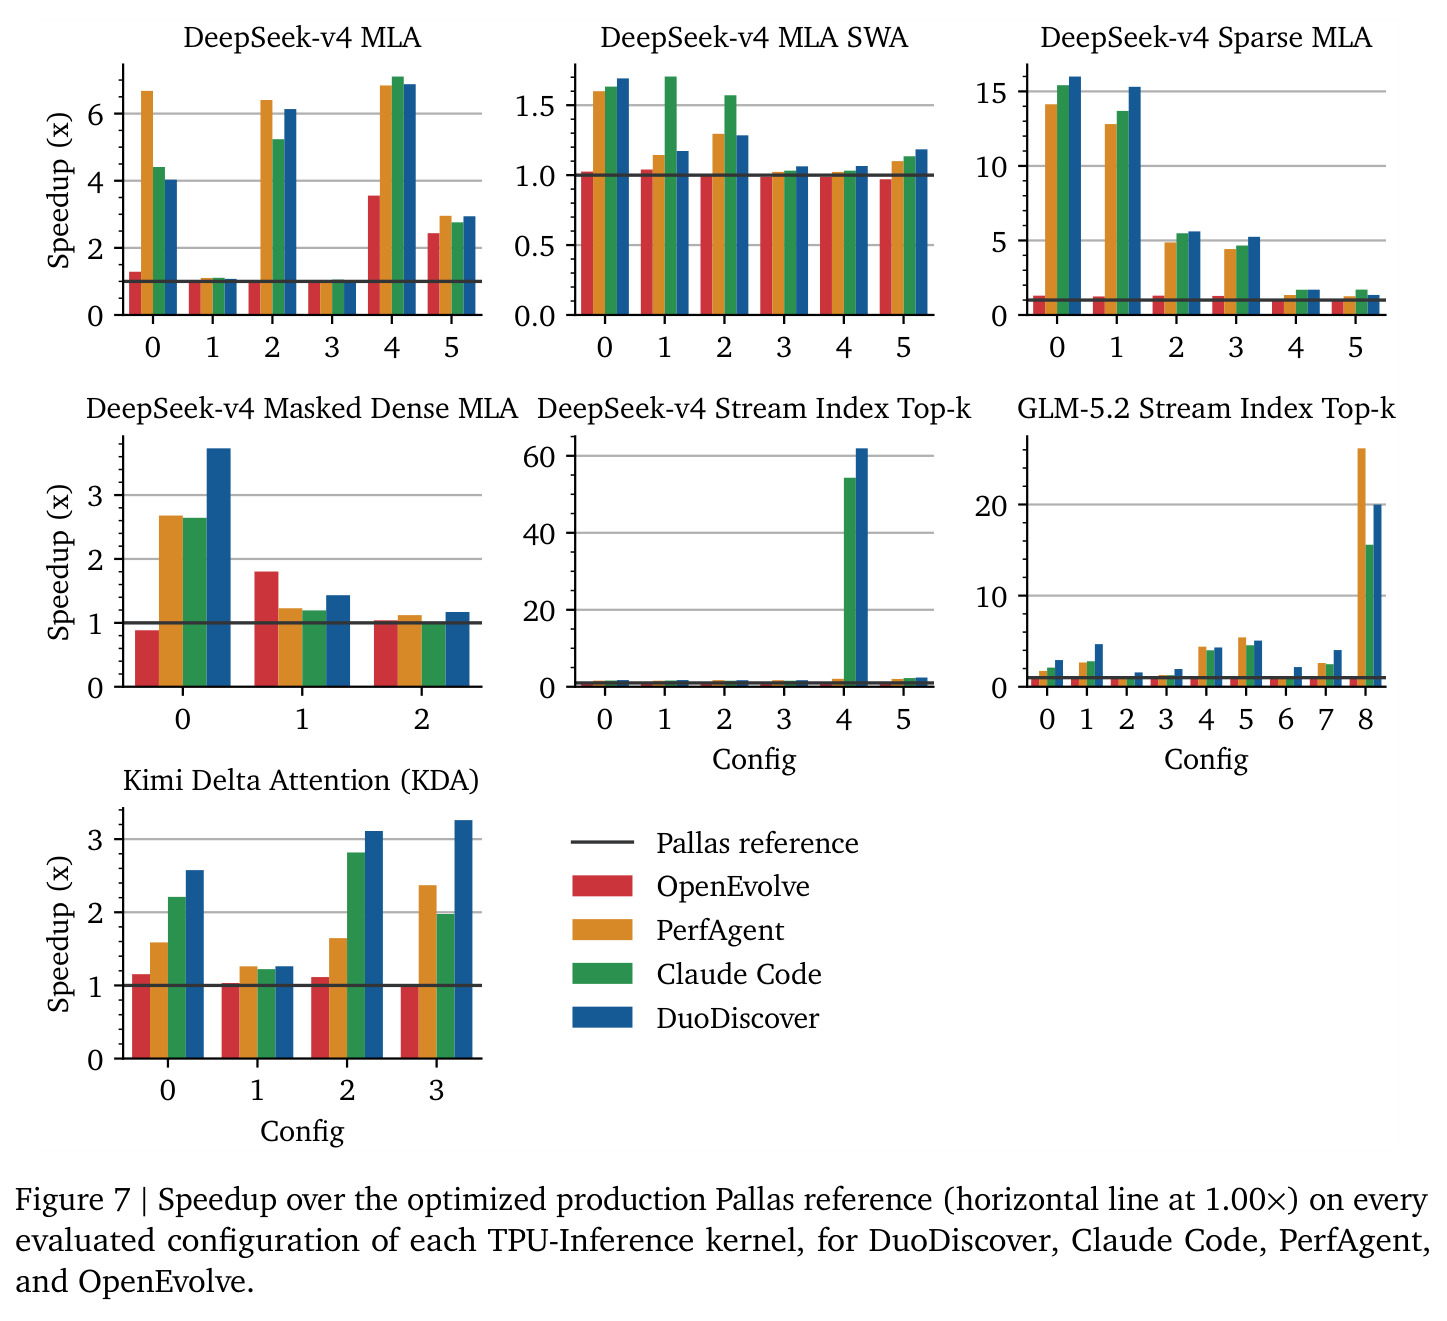
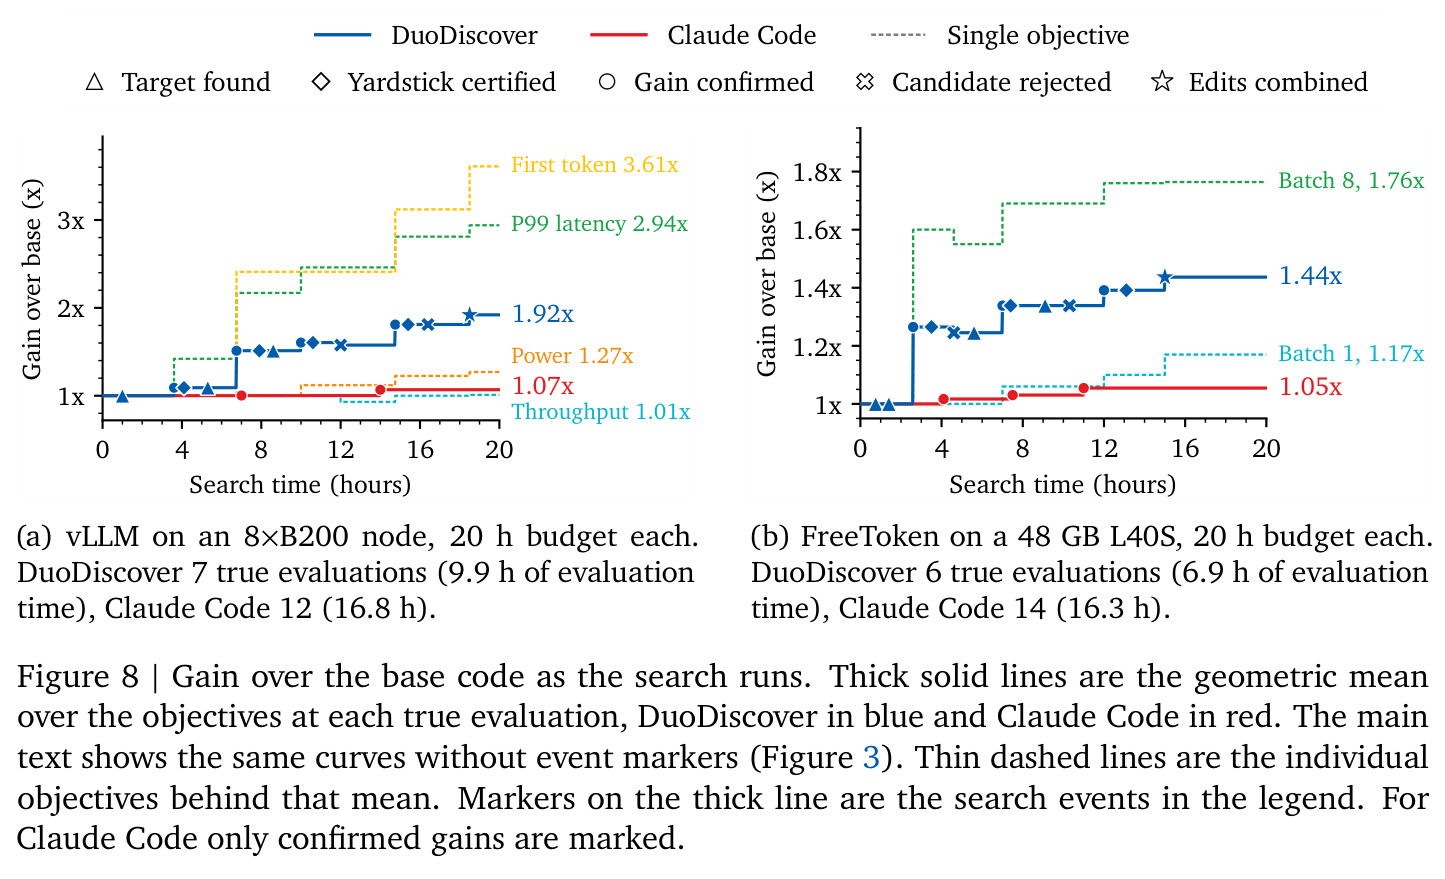
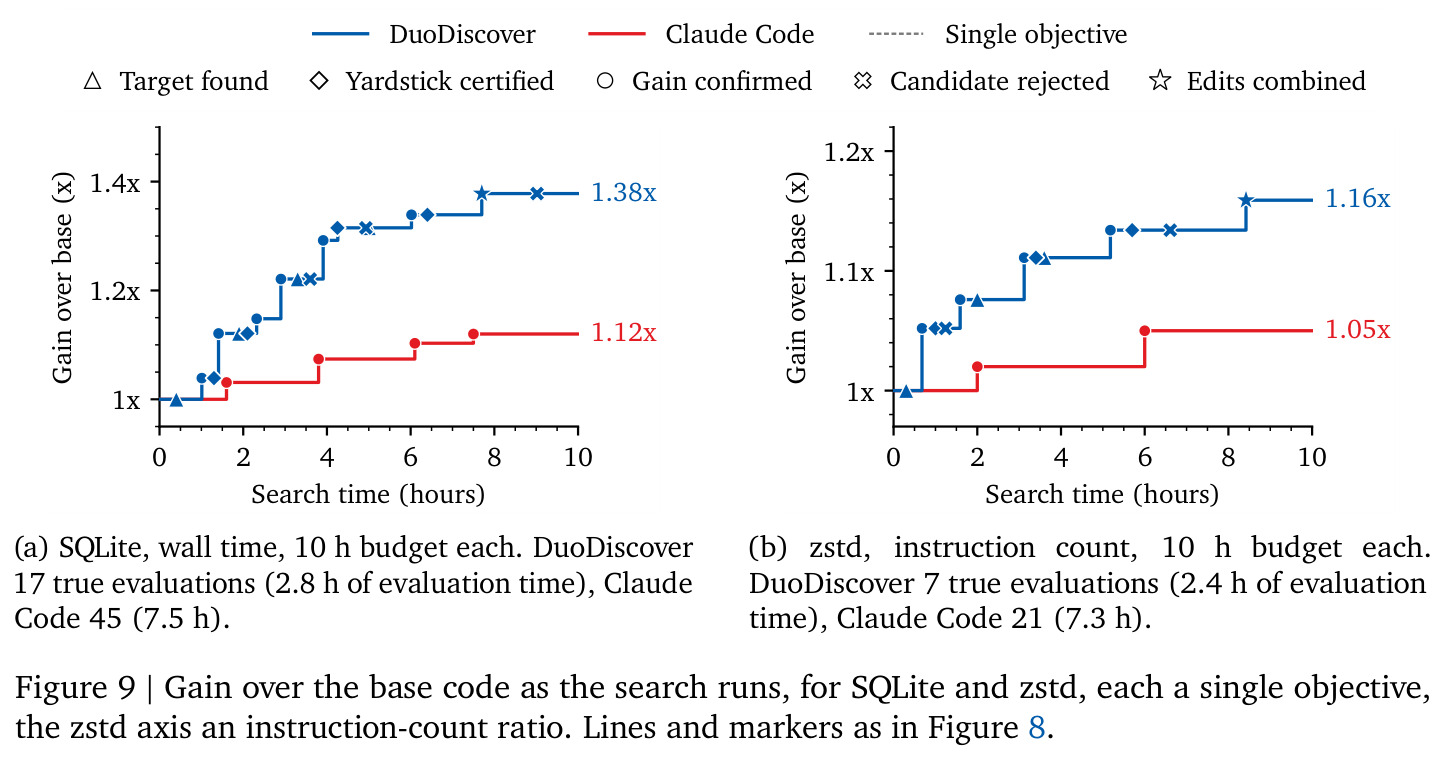
相同 8 小时、4 智能体预算下,DuoDiscover 在六个基准全面第一(Table 1)。仓库:FormulaCode 25 任务 2.156×,最强基线 Claude Code 1.778×(+21%),人类 PR 仅 1.048×,16/25 任务第一;SWE-fficiency 100 任务 15.02×,超专家补丁 6.90× 与 Claude Code 12.81×。内核:SOL-Exec 235 内核平均 79.74% SOL,121 个第一、212 进前三,登顶公开排行榜,领先 KDA(70.22%)9.5 分;FA4 超 Flash Attention 4 达 11.97%(KDA 8.93%);JAXBench 4.62×(基线 4.08×);TPU-Inference 2.68×(基线 2.38×)。真实系统:vLLM 四目标几何均值 1.92×(Claude Code 1.07×),p99 延迟降 2.94×、首 token 降 3.61×、功耗降 21%,真评估 7 次 vs 12;FreeToken 1.44×(批 8 达 1.76×);SQLite 1.38× vs 1.12×(17 vs 45 次真评估);zstd 1.16× vs 1.05×;DPC4 预取器 +6.31%,超 ArchAgent v2 +3.82% 与人类最佳 +3.52%,用 8000 候选 16.7 天 vs 12000+ 候选 40+ 天。机制:标尺快 22–53×、中位 τ 0.66–0.76;追平基线 8 小时成绩仅需 2.8 小时、74% 更少 token、83% 更少真评估。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SWE-fficiency 仓库级提速(100 任务) | 几何平均加速比 | 15.02× | Claude Code 12.81×;人类专家补丁 6.90× | +17.2%(相对 Claude Code),约为专家补丁的 2.2 倍 |
| FormulaCode 仓库级提速(25 任务) | 几何平均加速比 | 2.156× | Claude Code 1.778×;OpenEvolve 1.161× | +21%(相对最强基线);16/25 任务第一 |
| SOL-Exec GPU 内核优化(235 内核公开排行榜) | 平均速度之光百分比(% SOL) | 79.74% | KDA 70.22%;Claude Code 67.31% | +9.5 SOL 分(相对 KDA);121/235 第一、212 进前三 |
| FA4 注意力内核(24 个 B200 配置) | 相对 Flash Attention 4 的几何平均加速 | +11.97% | KDA +8.93%;Claude Code +7.05% | +3.04 个百分点(相对 KDA) |
| JAXBench JAX/TPU 内核(17 内核) | 相对 XLA 基线的几何平均加速比 | 4.62× | PerfAgent 4.08×;Claude Code 3.82× | +13%(相对最强基线 PerfAgent) |
| TPU-Inference 生产内核(7 内核) | 相对调优 Pallas 参考的几何平均加速比 | 2.68× | Claude Code 2.38×;PerfAgent 2.14× | +13%(相对 Claude Code);5/7 内核第一 |
| vLLM 多目标服务(8×B200,四项 SLO) | 四目标几何平均增益 | 1.92× | Claude Code 1.07× | +79%;p99 延迟降 2.94×、首 token 降 3.61×、功耗降 21%,真评估仅 7 次 vs 12 次 |
| SQLite 提速(speedtest1 工作负载) | 端到端加速比 | 1.38× | Claude Code 1.12× | +23%;真评估 17 次 vs 45 次 |
| DPC4 CPU 数据预取器设计 | 相对参考核的几何平均 IPC 增益 | +6.31% | ArchAgent v2 +3.82%;最佳人类设计 BertiGO +3.52% | 约 1.65× 于 ArchAgent v2 的增益;8000 候选/16.7 天 vs 12000+ 候选/40+ 天 |
局限与改进
作者承认两点:其一,当目标无法构建忠实 yardstick 时(每内核约 15 个目标中 4 个、20 个仓库任务中 2 个),系统退化为对昂贵真目标的标准搜索,这是方法地板;其二,构建标尺与初始保真测试带来预热开销,极短预算下不划算。我的观察:(1) 保真测试需至少 6 个噪声可分辨状态,超昂贵评估下几乎不可达——DPC4 案例被迫把门槛降到 2,且含 4 次人为干预(改评分、开放 L2/LLC、加多核 mix),'全自主'在极端场景有折扣;(2) 主结果为单次运行(虽有三种子方差佐证),且 backbone 全是闭源前沿模型(claude-opus-5、Gemini 3.8 Flash),开源小模型能否写出忠实标尺存疑;(3) 噪声估计依赖同快照重复评估,噪声大的任务会推迟验证、消耗预算;(4) 收益依赖'大加速来自局部热点'的先验,瓶颈分散于全库时优势缩水;(5) 45% 标尺中途作废虽零虚假收益,但浪费了构建成本。
独立分析的弱点
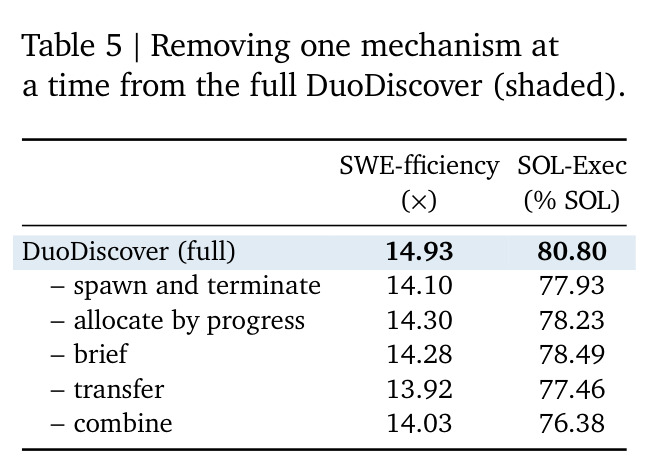
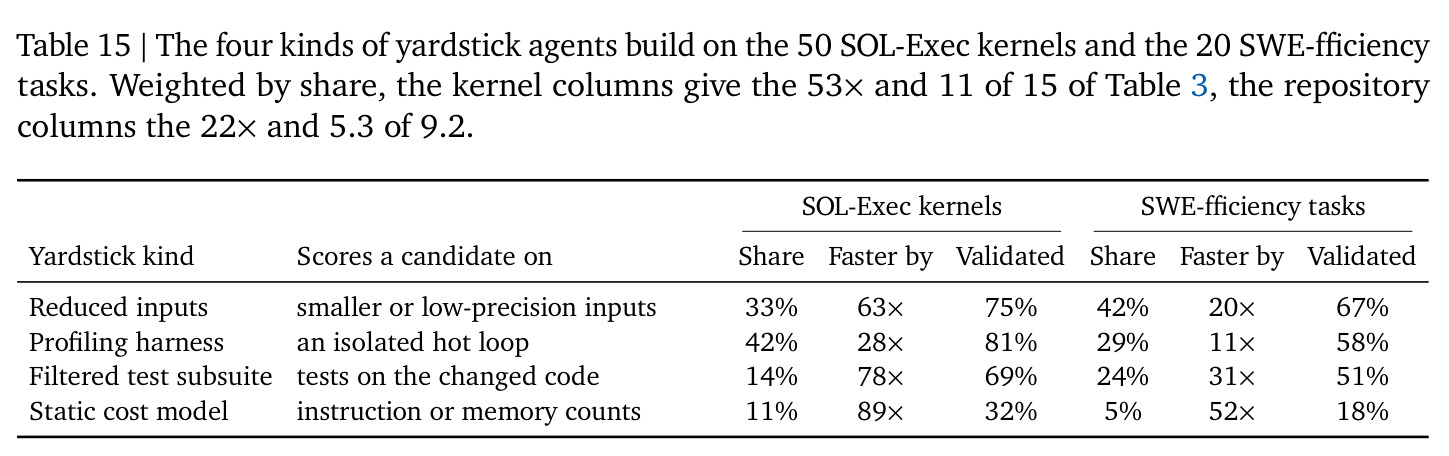
独立分析的弱点与改进方向:(1) 预热开销——标尺构建与首次验证常耗去第一小时,短预算吃亏;可建跨任务 yardstick 模板库或元学习'任务类型→标尺种类'先验(Table 15 显示剖析类验证率 81% vs 静态成本模型 32%),或用历史运行微调标尺生成器。(2) 无忠实标尺即退化——可让智能体把不可评估目标重述为可评估子问题,或主动构造探针输入快速积累可分辨状态。(3) 保真测试只查排序不查幅度:τ 高不保证外推可靠,平局对被排除可能掩盖系统性偏差;可要求标尺对确认收益的幅度预测落入置信区间。(4) 编排器动作相互依赖(Table 5 中单项损失之和超过净增益),缺乏自适应策略,可用 bandit/RL 学何时终止/生成/合并。(5) 成本与闭源依赖:单内核 8 小时 API 费 $375 且强依赖 claude-opus-5,DPC4 用 3000-vCPU 集群 16.7 天;可配合开源模型与蒸馏标尺技能降门槛,研究保真测试能否弥补弱模型差距。
未来方向
作者在结论中指出,协同发现(让智能体自找目标与评估方式)为自主发现扩展到科学与工程打开了一条路,未来可把该范式推广到更广的发现任务。基于成果可延伸的方向:(1) yardstick 的迁移与复用——同一内核套件内四类标尺反复出现,可构建可检索的 yardstick 库实现跨任务冷启动,消除预热开销;(2) 理论化保真度-效率权衡——τ 阈值、噪声分离与显著性水平 α 共同决定验证时机,值得样本复杂度视角的分析(附录已显示 α 在 0.01–0.10 内分数仅 1.4% 波动);(3) 多目标保真测试——vLLM 案例中每个 yardstick 只管一个目标,如何为多目标几何均值构建单一忠实标尺是开放问题;(4) 扩展到非代码发现——实验设计、EDA 硬件描述、分子模拟等同样存在评估瓶颈,co-discovery 框架可直接迁移;(5) 与上游工程流程打通——FreeToken 方案已部分合入上游(PR #619),自动生成可审阅 PR 并把维护者反馈回灌搜索是自然延伸;(6) 全自主收尾——消除 DPC4 案例中的人工干预,让编排器自己发现评分函数应随搜索阶段演化。
复现评估
复现评估:论文未提供官方开源代码(唯一开源产物是 FreeToken 部分方案,已合入上游 PR #619),编排器与智能体 prompt 未公开,这是最大障碍。有利条件:(1) 基准全公开——FormulaCode、SWE-fficiency-Lite、SOL-ExecBench(235 内核公开排行榜)、FA4、JAXBench、TPU-Inference、vLLM、SQLite、zstd、DPC4/ChampSim;(2) 方法描述详尽:附录 A 给出保真测试的噪声估计(同快照重复评估残差的 95% 置信上界)、τ 公式与验证判据(τ≥0.5、至少 6 个可分辨状态、α=0.05),附录 F 给出运行统计(每内核约 15 目标、285 候选、54 次真评估)与成本明细(单内核 8 小时 $375)。算力门槛:需 B200/TPU v6e 与大量 API 费,DPC4 需 3000-vCPU 集群 16.7 天。综合:方法论可复现性高,完整复现难度高(成本大、无官方代码),建议先在 20 任务/50 内核样本复现核心机制。
论文图表
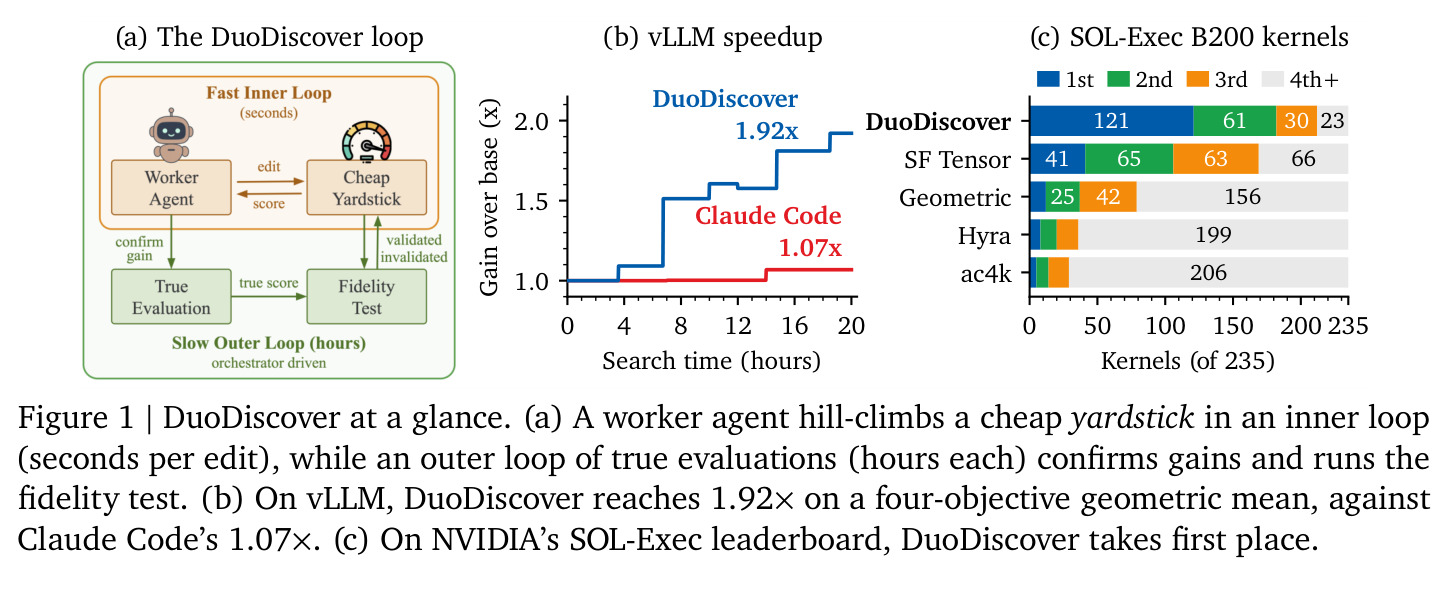
三联图:(a) 展示内循环(worker 智能体在秒级 yardstick 上爬山)与外循环(小时级真评估确认收益并跑保真测试)的双环结构;(b) vLLM 上 DuoDiscover 达到 1.92× 四目标几何均值增益,对比 Claude Code 的 1.07×;(c) SOL-Exec 排行榜上 DuoDiscover 以 121 个第一领先各商业/机构提交。
一页看懂论文的问题(真评估昂贵)、方法(双循环+保真测试)与两条最强结果,是向他人介绍本文的最佳入口。