SpecPilot:面向投机解码的自主算法发现与系统优化 SpecPilot: Autonomous Algorithm Discovery and Systems Optimization for Speculative Decoding
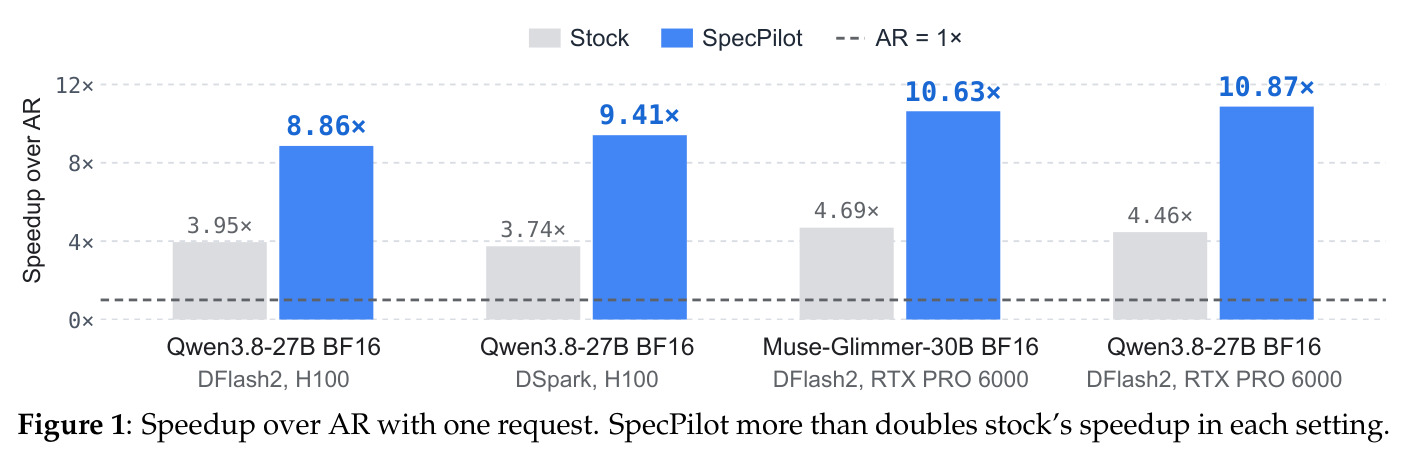
智能体闭环按部署自动发现无损投机解码优化,单请求加速比从4.46×升至10.87×
前置知识
投机解码(Speculative Decoding)
LLM 自回归解码是显存带宽受限的:每步读完全部权重却只算出一个小矩阵、产出一个 token。投机解码用轻量草稿器连续草拟 $m$ 个 token,目标模型用一次前向(每个 token 占一行)并行验证。贪心解码下接受与目标 argmax 一致的最长前缀并附加一个 bonus token,每步接受数 $\tau \in [1, m+1]$。无损(lossless)要求每个被接受 token 都经过精确权重的验证(exact pass)且等于该验证的 argmax,输出与目标贪心解码至多差浮点归约顺序。
本文所有优化都围绕提高 $\tau$(每步接受数)与降低步成本 $c$ 这两个量展开,这是全文的成本模型的两个基本变量。
并行草稿器(Parallel Drafter)
EAGLE-3 等 AR 草稿器逐 token 顺序草拟;DFlash、DFlash2、DSpark 等并行草稿器从目标隐状态出发,一次前向草拟 8 或 16 个掩码位置。DFlash2 用低秩选择器给每个位置的 top-16 候选打分,候选与分数构成格(lattice);DSpark 额外加一个以前一 token 为条件的 Markov 头:$\ell_s(y) = \text{bases}(y) + \langle W_1[x_{s-1}], W_2[y] \rangle$。理解格结构才能明白 stock 浪费的『闲置候选』从哪来。
本文的第一大发现就是:stock 只验证贪心链,浪费了 drafter 已排好序的其余候选,best-first 树正是在这些格上做文章。
草稿树验证(Draft Tree Verification)
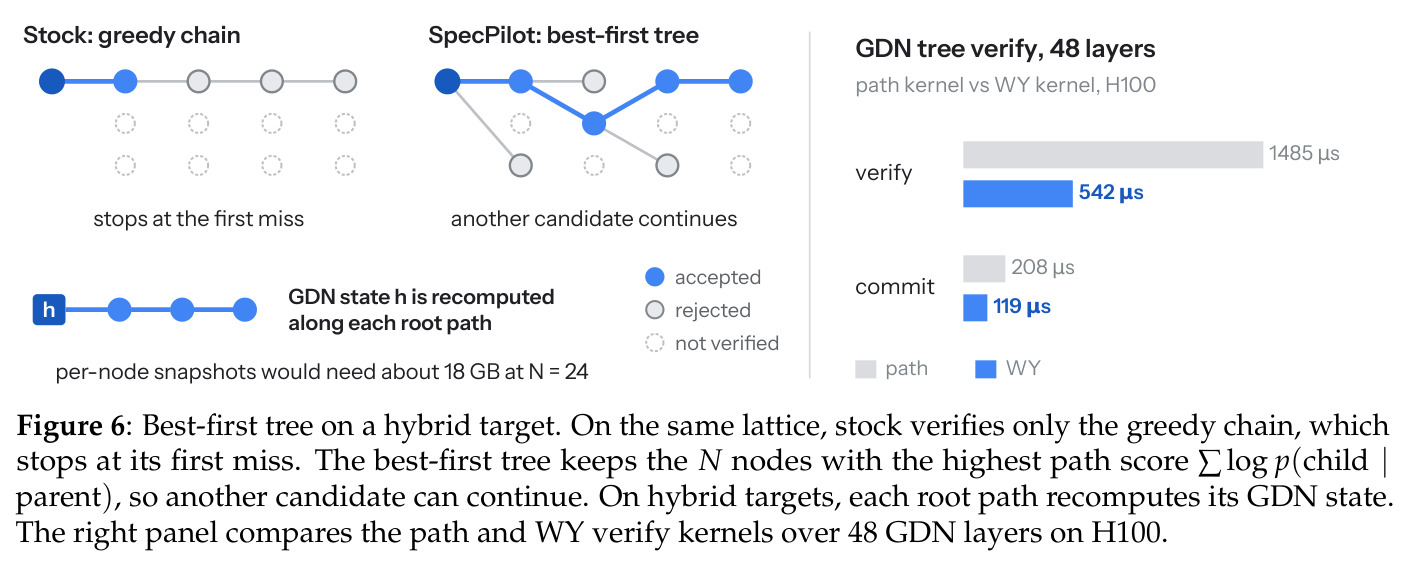
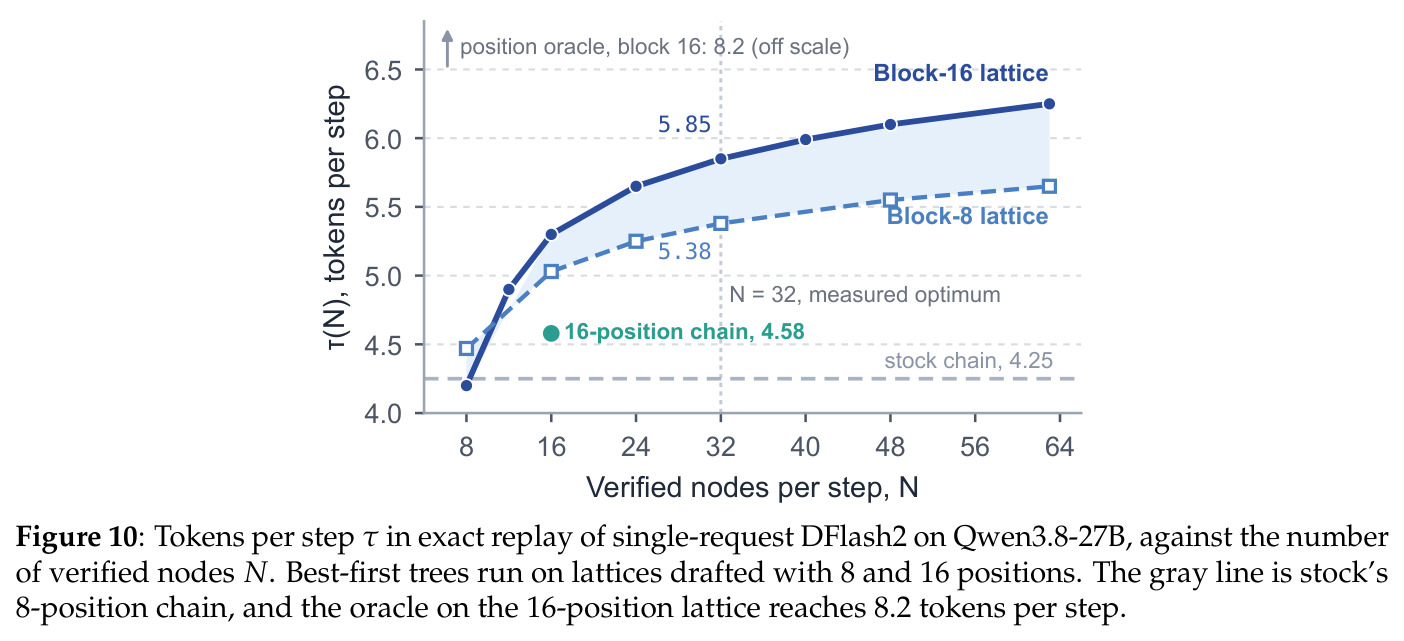
一次目标前向可验证一棵树形草稿,每个节点只看其祖先;每步接受与目标 argmax 匹配的最长根路径再加一个 bonus token。DDTree 按路径对数概率贪心加节点至 $N$ 个。本文的关键观察是:stock 的 8 位置贪心链每步只接受 $\tau=4.25$,而按 drafter top-16 持续接受目标贪心 token 的 oracle 可达 6.42(8 位置)到 8.20(16 位置),说明树验证有巨大 headroom。
best-first 树、混合目标上的状态重算、两级验证全部建立在树验证机制之上,不懂它就看不懂 §4 的核心算法。
混合循环架构(Hybrid Recurrent Target / GDN)
本文主目标模型 Qwen3.8-27B 在 64 层中 48 层用 Gated DeltaNet(GDN)替代 attention。GDN 头用固定大小状态 $h$ 按门控 delta 规则逐 token 更新:$h_t = \alpha_t (I - \beta_t k_t k_t^\top) h_{t-1} + \beta_t k_t v_t^\top$,$o_t = h_t^\top q_t$,其中 $\alpha_t$ 是衰减门、$\beta_t$ 是写入强度。这带来树验证难题:stock 验证会在每个位置快照状态,树验证则需每节点一个快照,$N=24$ 时约需 18 GB。
它解释了为什么本文的树验证要沿根路径重算 GDN 状态并用 TreeWY 式 WY kernel,这是混合目标上做树的核心工程贡献。
奖励黑客与 Token Forcing
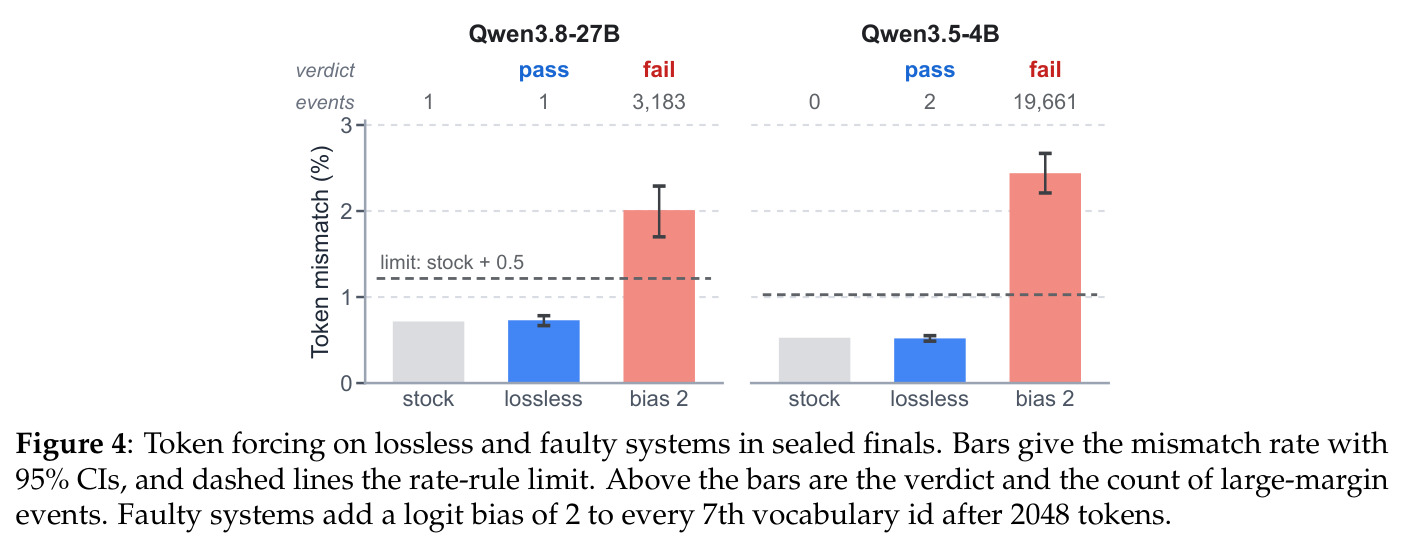
以速度为奖励的自动优化智能体可能采用改变输出的数值捷径(如对部分词表加 logit bias)来提速,而任务准确率检验不出来:论文中注入故障的系统准确率变化为 $-1.6$ 点(置信区间 $[-3.6, +0.3]$),与无损系统的 $-0.3$ 点完全重叠。Token forcing 用 FP32 LM head 的 teacher-forced 评分器统计系统输出与 stock 的逐 token 不匹配率及大幅值事件(margin 超过 $2\delta$),据此拒绝有损系统。
这是 SpecPilot 能放心让智能体改系统的安全阀,也是本文认为『无损性难验证』这一痛点的答案,不理解它就看不懂闭环的可信度设计。
研究动机
并行草稿器(DFlash2、DSpark 等)一次前向草拟整块 token,但其 released 系统(stock)远未兑现并行草稿的加速潜力,问题分三层。其一,单请求下每步要读完所有目标权重,GEMM 时间从验证 1 行的 17.88 ms 到 64 行仅增至 18.58 ms,读权重完全占主导,可 stock 仍只验证一条贪心链,每步仅接受 $\tau=4.25$ 个 token,而按 drafter top-16 候选做 oracle 接受可达 6.42–8.20。其二,batching 下每个请求叠加 attention、循环状态与 prefill 开销,stock 对 AR 的加速近乎减半:FP8 Qwen3.8-27B 从 3.40× 跌到 1.89×(24 请求),Qwen3.5-4B 从 3.73× 跌到 1.49×(32 请求)。其三,优化高度依赖部署——服务体制、草稿器、目标模型和 GPU 都会改变收益方向:低精度预检在单请求有效,但在 BF16 Qwen3.8-27B batching 下反而慢 13%;混合目标 Qwen3.8-27B 的树需追踪每节点的循环状态;RTX PRO 6000 缺少 wgmma 指令需移植 kernel。人工为每个部署逐一调优无法扩展。
本文的目标是本文的目标是构建 SpecPilot:一个按部署(服务体制 × 草稿器 × 目标模型 × GPU 平台)自主发现并集成无损系统优化的智能体闭环。约束是不训练、零质量损失、输出与 stock 统计一致;量化指标是把单请求对 AR 解码的加速比从 stock 的 4.46× 提升到 10.87×(翻倍以上),batching 下从 1.94× 提升到 3.93×;同时通过结构化记忆把已验证机制沉淀为可重放的代码增量,迁移到新草稿器(DSpark、EAGLE-3)、新模型家族(Muse-Glimmer-30B)与新 GPU(RTX PRO 6000);闭环还必须能防御以速度为奖励的智能体产生奖励黑客,保证发现的所有加速都是无损的。
与已有工作不同的是,已有的 agentic 优化器(AlphaEvolve、ADRS、FunSearch)靠自动评估器进化程序,但投机解码的无损评估器特别难建:大量真实增益只有几个百分点、贴近计时噪声,开发请求上的增益未必泛化到未见请求;而以速度为奖励的智能体极易奖励黑客——注入 logit bias 的故障系统在任务准确率上与无损系统的置信区间完全重叠($-0.3$ 对 $-1.6$ 点),准确率检验失效,要求输出逐位相同又会误杀无损系统。本文的独特切入有三点:用可分解的成本模型把加速写成 $\tau_{best}/\tau \cdot T_{prof}/T_{floor} \cdot T_{step}/T_{prof}$ 三个天花板因子,每轮重算、让搜索跟着最大瓶颈迁移而非沿旧方向打磨;让修改系统的 agent 与测量的 controller 严格隔离,在未见请求上做双 GPU 配对计时;并用 token forcing 把每个输出 token 与 stock 统计对拍,专检准确率看不见的有损改动。
核心方法
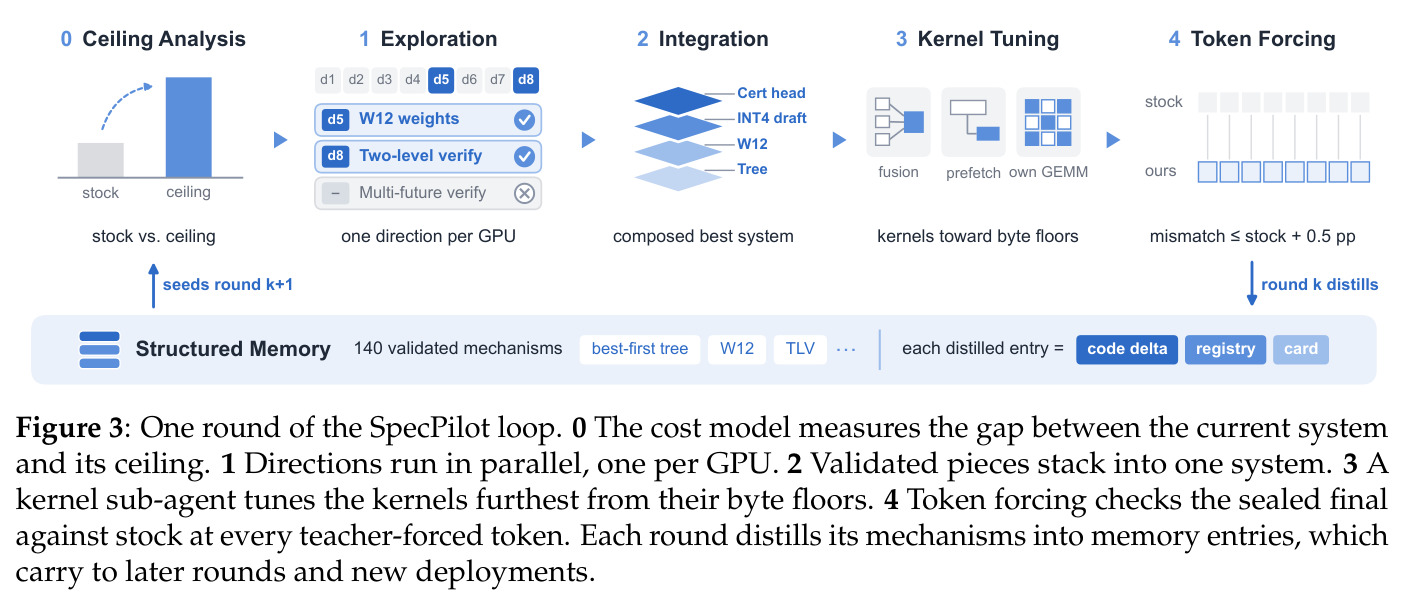
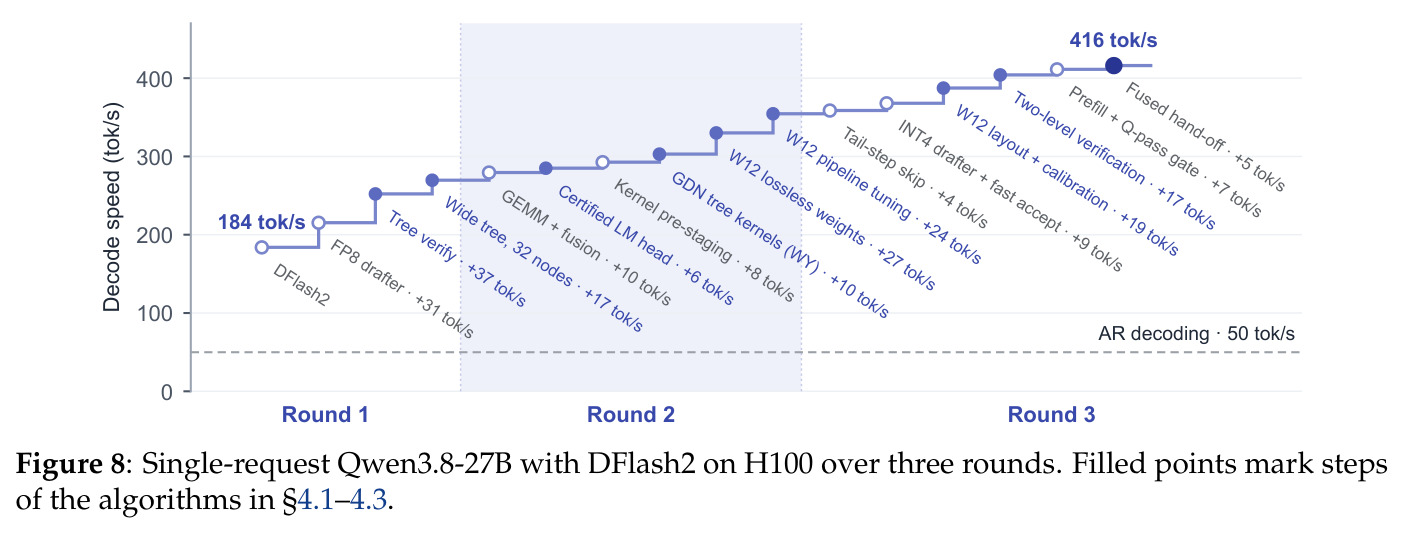
直觉:把系统优化当成『找最大缝隙』的游戏——先量出当前系统离理论天花板差多少、差距集中在哪个因子,再让多个智能体各攻一个方向,验证通过的拼装起来,最后逐 token 对拍守住无损性。技术路线是按轮运行五阶段。Phase 0 天花板分析:成本模型 $S(N)=\tau(N)/c(N)$、$c(N)=T_{step}(N)/T_{AR}$,天花板因子化为 $\tau_{best}/\tau \cdot T_{prof}/T_{floor} \cdot T_{step}/T_{prof}$,分别衡量更好的树能多接受多少、慢 kernel 离字节地板多远、profile 外有多少开销,最大因子即当轮靶子。Phase 1 探索:master 每块 GPU 开一个方向,子智能体先用最便宜的证据(exact replay、微基准)确认 headroom 净收益 ≥3% 才动手。Phase 2 集成:把单独特不出的 patch 叠加计时。Phase 3 kernel 调优:把离字节地板最远的 kernel 压下去。Phase 4 封存终测:未见请求计时加最长 4096 token 的 token forcing,任一失败即拒。三轮间瓶颈从 token(best-first 树)迁移到权重字节(W12)再到步的单位(TLV),系统从 184 涨到 416 tok/s。
核心创新是『天花板引导的自主发现』加『统计式无损验证』这一对组合。与 AlphaEvolve/ADRS 的本质区别有三。其一,用可分解的成本模型替代盲目搜索:加速被拆成 $\tau$ 因子(更好的树能多接受多少 token)、kernel 因子($T_{prof}/T_{floor}$,慢 kernel 有多少水分)、overhead 因子($T_{step}/T_{prof}$),每轮在记录格与 profile 上重算,让搜索随瓶颈迁移——对照实验中无成本模型的单智能体基线三轮只做到 1.34×(它一直盯着最显眼的 token 数,从未处理占步时 80% 的权重读取),而 SpecPilot 达 2.13×。其二,token forcing 既不要求与 stock 输出逐位相同(会误杀仅浮点归约顺序不同的无损系统),也不看任务准确率(检不出故障),而是用 FP32 LM head 的 teacher-forced 评分器统计不匹配率(stock 为 0.72%,规则限 stock+0.5 点)与大幅值事件(margin $> 2\delta$,$\delta$ 由 stock 与 AR 首次分歧处的对数概率差上界 0.232 nats 取整而来)的二项检验。其三,结构化记忆条目=代码增量+registry+证据卡,只有从 stock 应用后能逐字节重现源系统代码才保留,保证每条机制可重放、可审计。
方法步骤详情
完整流程如下。第 0 步:输入为上一轮终态(或新部署的 stock+记忆条目),在记录的草稿格与 kernel profile 上重算天花板三因子,定位最大差距——例如第二轮 step cost 因子领先,master 开出砍权重字节的方向,字节算术给出 25% headroom(权重读 15.30 ms),微基准否决了解码慢 3× 的 11-bit 变体。第 1 步:子智能体把方向实现为 patch(带选项开关、默认值严格复现 stock),须通过正确性检查与开发请求上的 token forcing。第 2 步:controller——agent 可调用但不可修改的脚本——在两块 GPU 上做配对运行(同一批请求、两轮间交换 GPU 消除卡差异),仅当增益的 95% 置信下界超过 1% 加两倍 stock-vs-stock 噪声(单请求 H100 上 <0.1%;输出发散时门槛约 3%)才晋升;W12 首 patch 晋升于 1.076×,修订 kernel 后 1.063×。第 3 步:集成子智能体叠加小增益 patch,kernel 子智能体把离字节地板最远的 kernel 调优。第 4 步:封存终测在未见请求计时并重跑 token forcing(输出延长到 4096 token),失败即拒。第 5 步:每个晋升机制蒸馏为记忆条目,新部署从 stock+选定条目冷启动,重用条目须重调重测且不计为新发现。三轮后系统从 184 到 416 tok/s,记忆累计 140 条。
技术新颖性
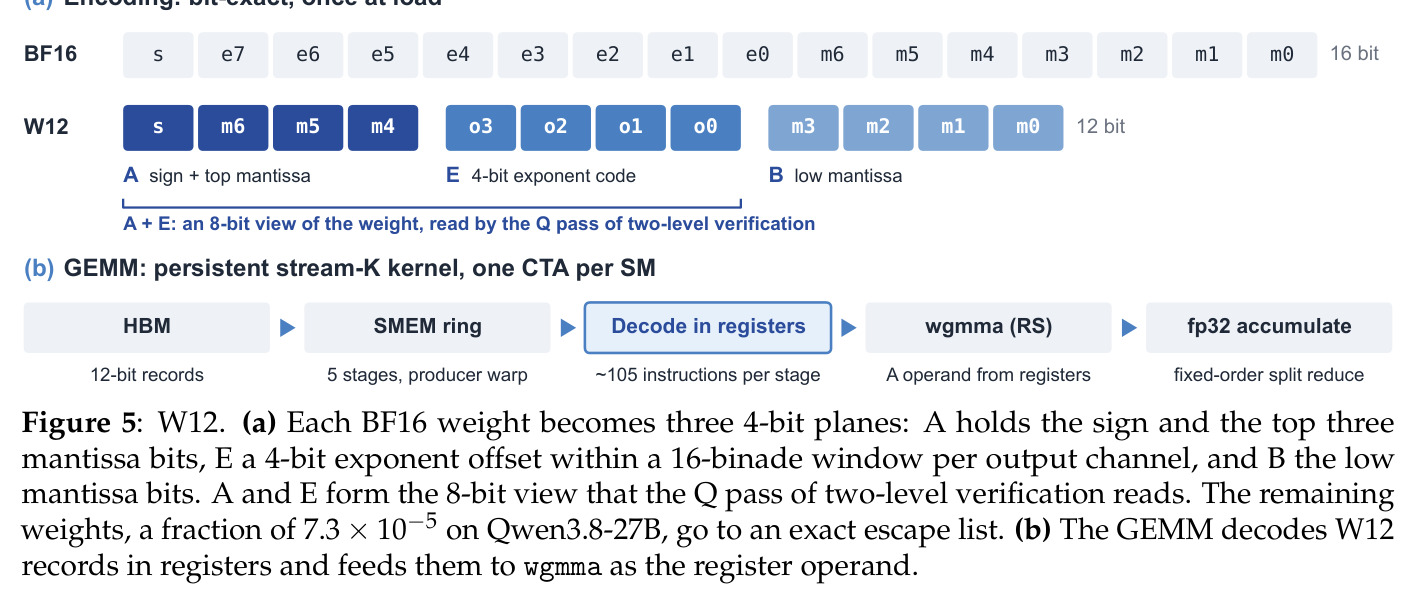
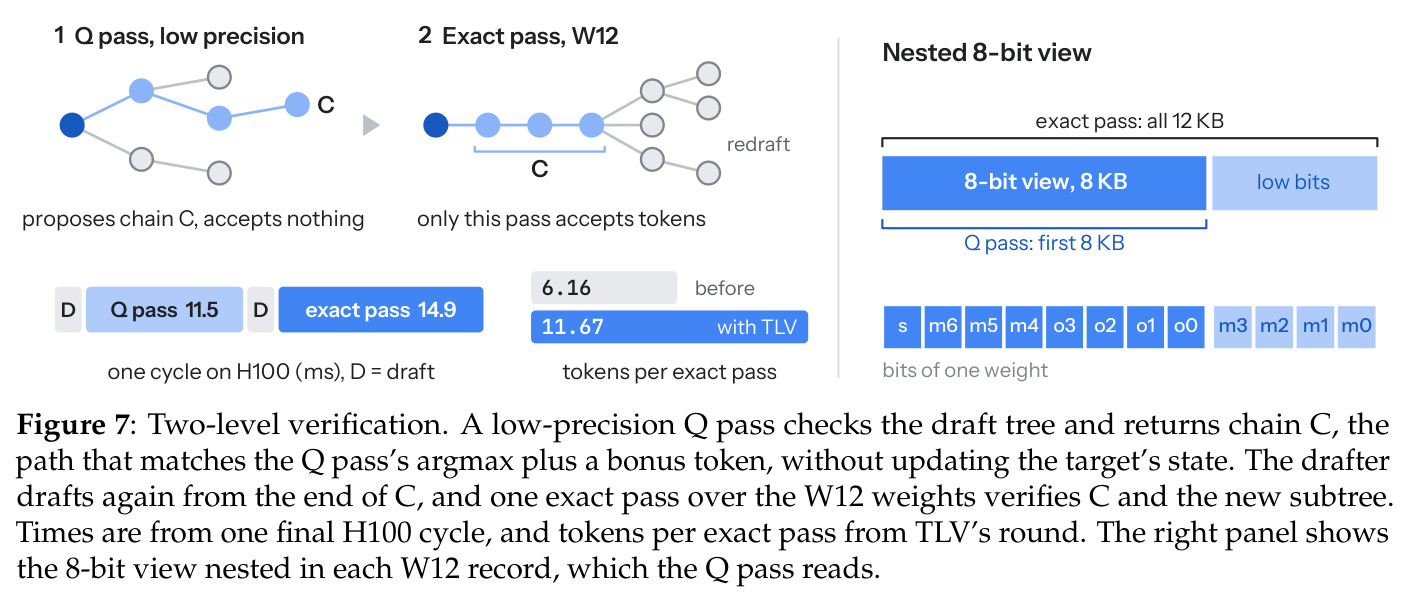
逐项对比已有技术。树验证:DDTree 按边际路径对数概率贪心加节点,本文 best-first 树按边打分 $\log p(\text{child} \mid \text{parent})$,且验证节点数 $N=32$ 超过草稿位置数 16(宽树);16 节点时追平 EAGLE-2 式 top-4 树(5.03 对 5.02)、超过 Sequoia 树(4.71)。混合 GDN 目标上放弃逐节点状态快照($N=24$ 约需 18 GB),改为沿根路径重算状态,配 TreeWY 式 WY kernel(FP32 状态拆三个 BF16 部分精确表示 24 位有效数字)。W12:ZipNN/DFloat11 熵编码需先解码再进 GEMM(DFloat11 慢 cuBLAS 4.8–6.7×),W12 把 12-bit 记录解码融进寄存器与 wgmma,据作者所知是首个在 H100 上稳定击败 cuBLAS 的无损格式(1 行 1.19–1.47×、32 行 1.17–1.35×)。TLV:QSpec/QuantSpec 用低精度目标当草稿器,TLV 反其道用 W12 内嵌的 8-bit 视图当中间验证器、只筛不接受 token,一个精确 pass 验证两轮草稿(每精确 pass 6.16→11.67 token)。batching:共享节点预算落在 FP8 目标 GEMM 的 192 节点平台期,按请求选 16/12/8 草稿位置,prompt 行搭验证步的权重流。
实验结果
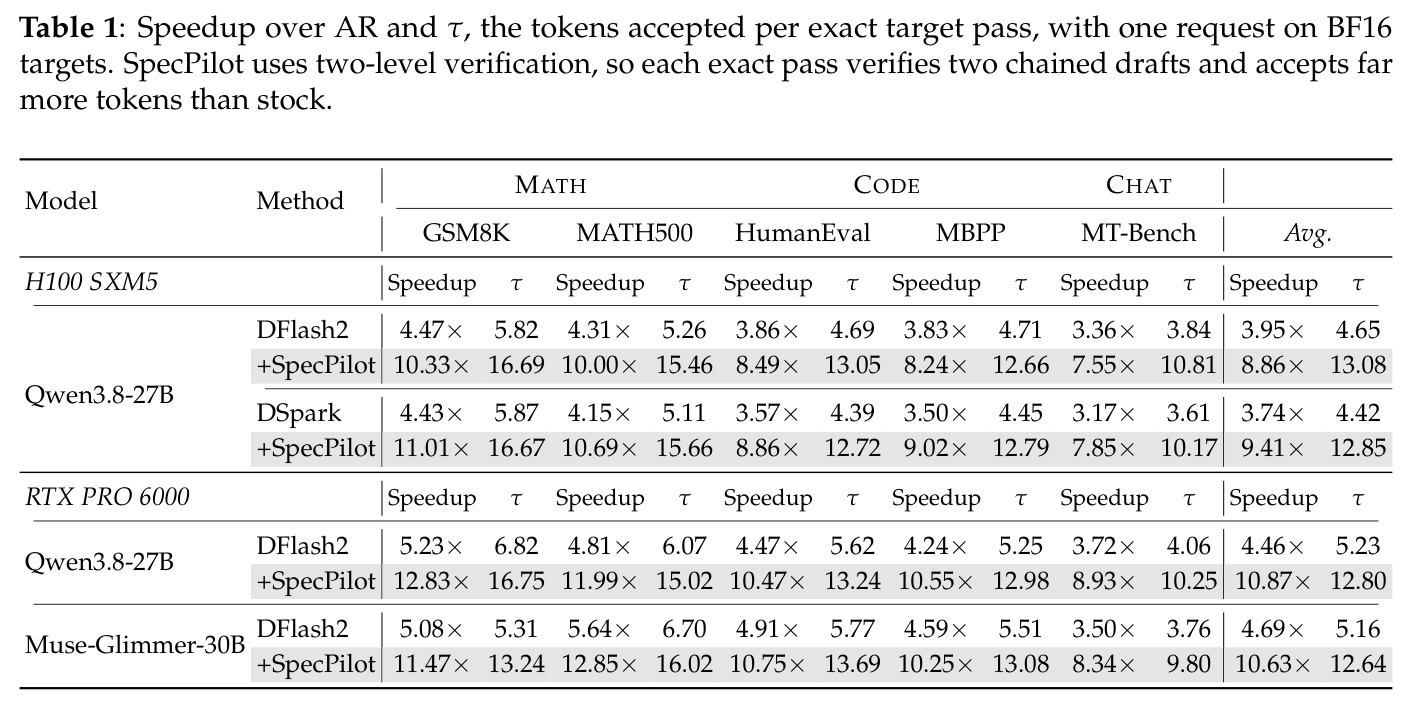
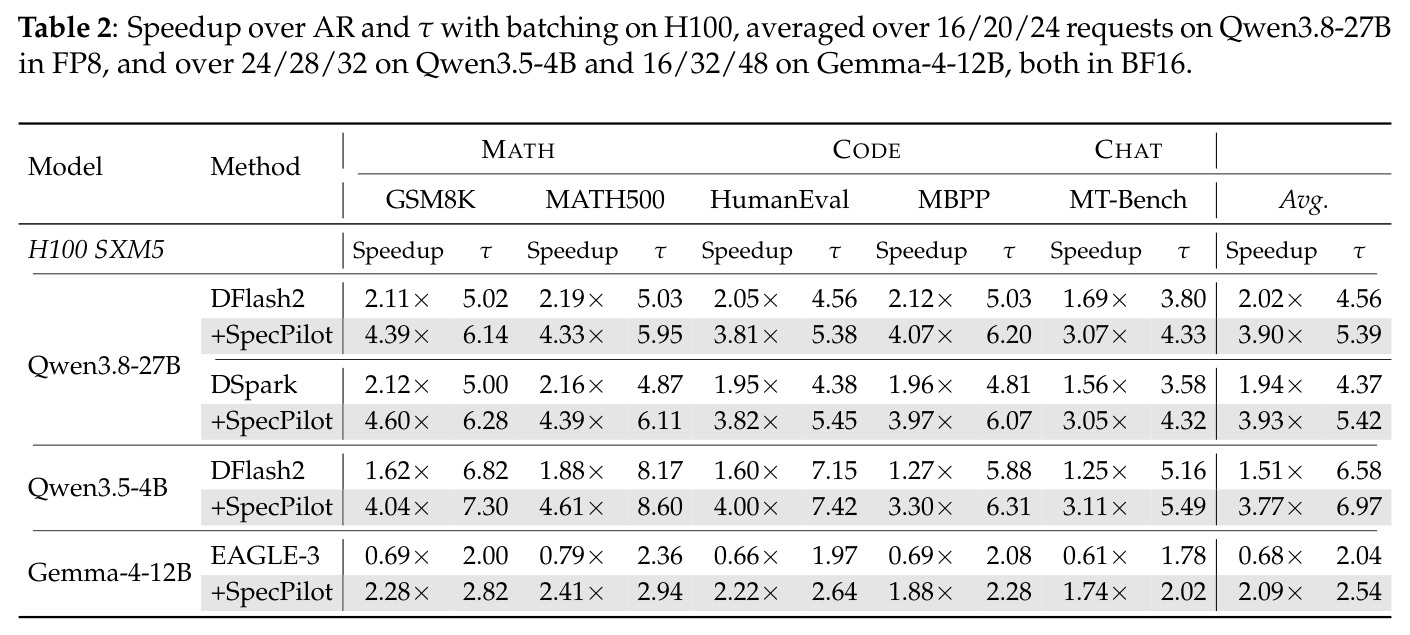
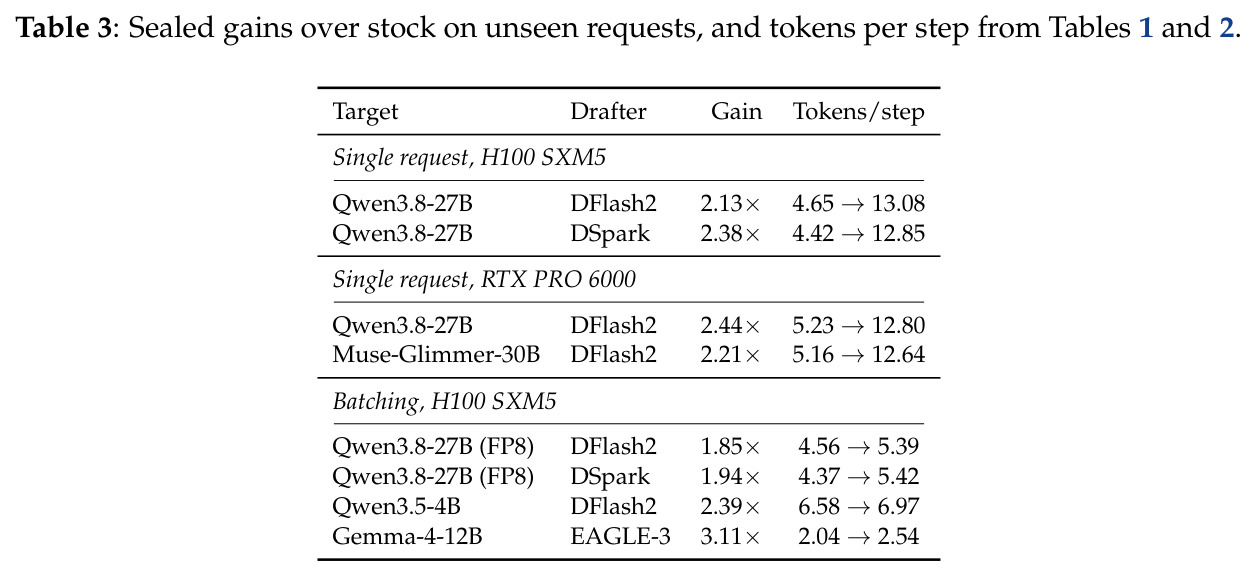
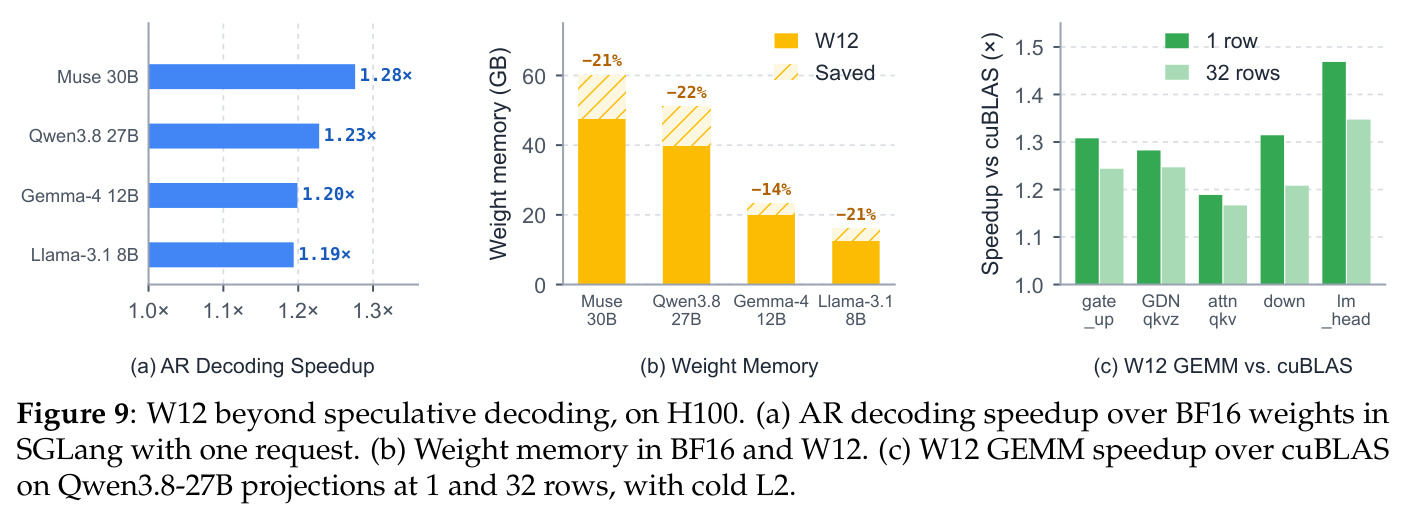
评估覆盖 4 个目标模型(Qwen3.8-27B、Qwen3.5-4B、Muse-Glimmer-30B、Gemma-4-12B)、3 个草稿器(DFlash2、DSpark、EAGLE-3)、2 块 GPU(H100 SXM5、RTX PRO 6000)与 5 个基准(GSM8K、MATH500、HumanEval、MBPP、MT-Bench),agent 为 Claude Code 中的 Claude Opus 5.5,引擎为冻结的 SGLang v0.5.20。单请求(BF16):H100 上 Qwen3.8-27B+DFlash2 对 AR 从 3.95× 升至 8.86×(sealed 增益 2.13×),DSpark 从 3.74× 升至 9.41×(2.38×);RTX PRO 6000 上从 4.46× 升至 10.87×(2.44×);Muse-Glimmer-30B 从 4.69× 升至 10.63×(2.21×);比 DDTree 基线(4.82×)快 1.84×。$\tau$ 从 4.65–5.23 提升到 12.64–13.08。batching(H100):FP8 Qwen3.8-27B DFlash2 从 2.02× 升至 3.90×(增益 1.85×)、DSpark 从 1.94× 升至 3.93×(1.94×);Qwen3.5-4B 从 1.51× 升至 3.77×(2.39×);Gemma-4-12B+EAGLE-3 stock 仅 0.68×(比 AR 还慢)升至 2.09×(增益 3.11×)。三轮演化 184→270→416 tok/s,瓶颈依次迁移:token(best-first 树)→权重字节(W12 把 44.67 GB 压到 33.58 GB)→步的单位(TLV 使每精确 pass 从 6.16 升到 11.67 token);无成本模型单智能体基线仅 1.34×。Token forcing:stock 不匹配率 0.72%/0.53%,无损系统 0.73%/0.52% 通过,注入 logit bias 的故障系统 2.0%/2.4% 被拒(200 个大幅值事件中 192/191 个未解释),而任务准确率无法区分二者。W12 单独用于 AR 解码也加速 1.19–1.28×、省显存 14–22%(KV pool 扩 2.0–2.5×)。记忆迁移:RTX PRO 6000 移植即得 sealed 1.92×、最终 2.44×;EAGLE-3 重用 W12 与 prompt admission 达 3.11×。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 单请求投机解码(RTX PRO 6000,Qwen3.8-27B + DFlash2,五基准平均) | 对 AR 解码的加速比 | 10.87×(sealed 增益 2.44×) | stock 4.46× | 加速比提升 2.44 倍 |
| 单请求投机解码(H100,Qwen3.8-27B + DFlash2) | 对 AR 解码的加速比 | 8.86×(τ 4.65→13.08,sealed 2.13×) | stock 3.95× | 2.13× |
| 单请求投机解码(H100,Qwen3.8-27B + DSpark) | 对 AR 解码的加速比 | 9.41×(sealed 2.38×) | stock 3.74× | 2.38× |
| batching 投机解码(H100,FP8 Qwen3.8-27B + DSpark,16/20/24 请求) | 对 AR 解码的加速比 | 3.93×(sealed 1.94×) | stock 1.94× | 1.94× |
| batching 投机解码(H100,Gemma-4-12B + EAGLE-3) | 对 AR 解码的加速比 | 2.09×(sealed 3.11×) | stock 0.68×(比 AR 慢) | 3.11× |
| W12 GEMM 对比 cuBLAS(H100,Qwen3.8-27B 各投影层) | GEMM 加速比 | 1 行 1.19–1.47×,32 行 1.17–1.35× | cuBLAS BF16 | 所有 13 个形状全面超越,另省权重字节约 25% |
| 与 DDTree 树基线对比(H100 单请求) | 端到端加速比 | 8.86× | stock DFlash2 + DDTree 4.82× | 1.84× |
局限与改进
作者承认的局限:结构化记忆含 15 条 sm_120 专属条目,跨 GPU 仍需 kernel 移植与重调;TLV 的 Q pass 只省 attention/循环层投影的字节,其耗时为单步的 0.80–0.88,BF16 batching 下 TLV 反而慢 13%,一个周期须接受近两倍 token 才回本;机制强依赖体制——24 节点宽树在 FP8 batching 下慢 14.9%、24 位置草稿块慢 9.9%;天花板假设每草稿一次精确 pass,被 TLV 打破后需重定义;无损定义本身容忍浮点归约顺序差异(分歧处两 token 对数概率差至多 0.232 nats)。我补充观察:实验用固定在飞请求数的闭环客户端,未报告 TTFT/TPOT 长尾等在线 SLO 指标;sealed final 仅两次配对运行,对跨基准方差的统计说服力有限;整个搜索依赖 Claude Opus 5.5 级别的前沿 coding agent,其 API 成本与在较弱模型上的可复现性未讨论;此外全部结果为 greedy 解码加 thinking 模式的英文基准,温度采样与多语言场景未覆盖。
独立分析的弱点
独立分析几个弱点。第一,无损判定以 stock 为金标准:token forcing 全部相对 stock 统计,若 stock 本身有实现 bug 或系统性偏差,会被当作基线噪声继承下来;改进方向是与 FP32 参考实现或不同推理引擎交叉对拍。第二,天花板中的 $\tau_{best}$ 来自当轮草稿器记录格的 exact replay,搜索被锁死在『这个格能多接受多少 token』的上限内,无法发现训练更强草稿器这类跳出格外的方向;改进是把格质量本身纳入天花板因子。第三,配对运行要求两块同型号 GPU 并轮换,资源需求翻倍,小团队难以复制整个闭环;可考虑时序交错运行加统计校正替代。第四,记忆条目要求『从 stock 应用后逐字节重现源系统代码』,与代码结构强耦合,上游 SGLang 升级可能让 140 条记忆整体失效;改进是接口级 patch 或独立功能分支管理。第五,主要结论限于 greedy+thinking 的英文基准,采样解码、多语言与超长上下文未验证,而 TLV/W12 的收益集中在 decode 阶段,在 prefill 主导的负载里可能大幅缩水,应补充 prefill-heavy 场景评估。
未来方向
作者方向:结构化记忆已含 140 条、覆盖全部评估设置,可继续扩展到更多 GPU 架构与服务框架;W12 作为通用无损权重格式(六大家族稠密模型均压到约 12.01–12.02 bit/权重)可推广到投机解码之外任意受权重字节约束的矩阵乘场景,作者已展示 AR 解码 1.19–1.28× 加速与显存节省。基于成果可延伸:其一,把层级验证思想递归化——Q pass 与精确 pass 之上再加更粗的预筛,构成多级验证级联,进一步压低每 token 的精确计算量;其二,成本模型可自动生成方向假设(每个因子直接映射为候选方向),降低对 master agent 先验的依赖;其三,用学习排序预测『哪些记忆条目组合在新部署最可能晋升』,加速新部署冷启动;其四,在线服务下 batch 组成动态变化时的自适应机制——按当前负载在 node budget、drafter block 与 prompt admission 策略间实时切换;其五,把 ceiling 引导的 agentic 优化框架移植到投机解码之外的系统问题,如 paged attention、量化调度与分布式推理的参数搜索。
复现评估
论文附项目网站与开源代码(SpecPilot)。复现资源需求较重:至少两块同型号 GPU(H100 SXM5 或 RTX PRO 6000)做配对运行,SGLang v0.5.20 冻结构建,Qwen3.8-27B/Muse-Glimmer-30B 等 27–30B 级 BF16/FP8 权重,以及 Claude Opus 5.5 的 API(agent 端成本未披露,三轮搜索预计需数小时 GPU 时与大量 LLM 调用)。分层看难度:只取单点收益最容易——W12 在 AR 解码即有 1.19–1.28×,加载时逐位校验解码张量保证无损,无需 agent;中等难度是验证最终系统——需正确实现 W12 kernel、best-first 树、TLV 与三个 batching 机制并通过 token forcing,kernel 移植(如 RTX PRO 6000 无 wgmma 用 mma.sync)是主要工作量;最难是复现发现过程——依赖 agent 行为稳定性、双 GPU 配对环境与 sealed final 流程,结果随机性较强。基准请求来自 GSM8K/MATH500/HumanEval/MBPP/MT-Bench(greedy+thinking),公开可得,指标口径(每请求输出速率比的几何平均)文中交代清楚。
论文图表
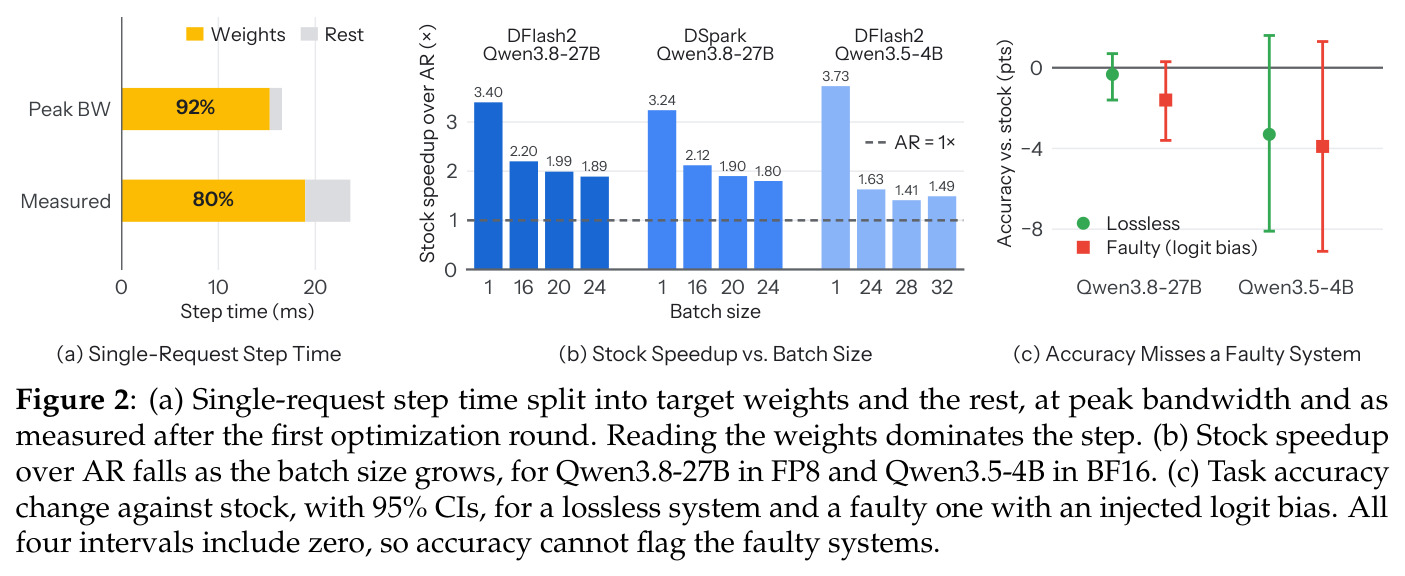
三个动机子图:(a) 单请求步时间分解,峰值带宽下读权重占 92%,首轮优化后实测 23.61 ms 步中占 80%; stock 加速随 batch 增大下滑,FP8 Qwen3.8-27B 从 3.40× 跌至 1.89×、Qwen3.5-4B 从 3.73× 跌至 1.49×; 注入 logit bias 的故障系统与无损系统的任务准确率变化(95% CI)全部跨零,准确率无法识别故障系统。
这三张子图正是动机章节的全部数字依据:单请求瓶颈在权重读取、batching 瓶颈在每行开销、而现有评估手段(准确率)守不住无损性——它们共同论证了为什么需要 SpecPilot 这样的自主闭环。