EvoDuet:面向科学发现的网络搜索与任务求解双层协同进化 EvoDuet: Bilevel Co-Evolution of Web Searching and Task Solving for Scientific Discovery
双层协同进化解与搜索查询,知识缺口门控让LLM按需上网检索
前置知识
进化搜索脚手架
以 LLM 为变异算子的黑盒优化框架:给定任务 $\tau=(I, x_0, E)$(指令、初始解、确定性评估器),循环执行『选父代与历史 → LLM 生成候选 → 评估器打分 → 按选择策略 $\phi$ 决定入池或丢弃』。FunSearch、AlphaEvolve、OpenEvolve 均属此类:评估器能给任意候选打分,但最优解无法直接计算,只能靠迭代逼近。
EvoDuet 的外环就是一个标准进化搜索脚手架,全文的任务设定、评估流程与实验预算都建立在这个框架之上,不懂它就无法理解内外环如何分工。
归一化发现增益(NDG)
论文的核心评价指标,衡量一次运行关闭了『初始解到 SOTA』差距的百分比:$$\mathrm{NDG}=\frac{E(x_{\mathrm{best}})-E(x_0)}{E(x_{\mathrm{SOTA}})-E(x_0)}\times 100$$ 其中 $x_{\mathrm{SOTA}}$ 是先前工作报道的最佳程序分数。100% 表示追平 SOTA,超过 100% 即刷新纪录。
不同任务的评估器量纲差异巨大(SWAP 次数、误差界、分数),NDG 提供跨任务可比的统一标尺,论文所有主结果和消融都以它报告。
双层优化
一类嵌套优化问题:外层变量的优化以内层最优解为约束,形如 $\min_x F(x, y^\star(x))\ \mathrm{s.t.}\ y^\star=\arg\min_y f(x,y)$,典型例子是元学习。本文中外层优化解 $x$、内层优化查询 $q$,而内层目标 $E(x_{t+1}(q))$ 只有真实生成并评估候选才能观测,因此用 LLM 自身作预测器 $\hat{E}_\theta$ 来近似。
EvoDuet 的名字(Duet,二重奏)与核心形式化(公式 1)都是双层优化,不理解嵌套结构就无法理解内外环如何通过门控耦合。
Loop Packing(环叠加)
论文提出的概念:在解循环之外再包一层辅助循环以延缓搜索饱和,例如 EvoX 在解循环外包一个『策略循环』,在进展停滞时修订搜索策略。关键观察是:迄今为止所有被叠加的环都只从两个知识源取材——本次运行的历史与 LLM 的参数知识,因此搜索始终是封闭的。
EvoDuet 自我定位为第一个引入真正外部知识源的『搜索环』,理解这一概念才能看懂图 1 的问题定位与相关工作的对比逻辑。
Oracle 文档对照实验
预实验中的理想化设置:在每次迭代都给模型提供与任务相关且确认有帮助的文档,相当于『检索结果完美』的上界。在 31 个任务上 oracle 文档使 Qwen3.5-9B 平均 NDG 提升 10.3%、GPT-5.6-Luna 提升 4.0%,但效果参差:Rosetta 上反而下降 9.0% 和 23.3%,且基线 NDG 已超 80% 的 16 个任务上平均只变化 0.1%。
只有理解 oracle 实验,才能理解动机部分的三个关键观察:外部知识有用、模型需要探索余量(N=8 才见效)、查询必须随解演化。
研究动机
LLM 驱动的进化搜索脚手架(FunSearch、AlphaEvolve、OpenEvolve 等)已在 Erdős 最小重叠、GPU 内核设计、单细胞 RNA-seq 去噪等黑盒优化任务上迭代提出候选程序并由评估器打分,但当进展需要参数知识之外的外部信息(例如新版库的 API 用法)时搜索会停滞。现有加环方案如 EvoX 的策略环仍只依赖运行历史与参数知识,搜索是封闭的。作者实验进一步表明,直接把 Tavily 搜索工具塞进解循环(joint-level)也不行:Denoising 任务 100 轮中返回 URL 有 88.1% 是重复页面,第 50 轮后就停止改进,held-out NDG 仅 27.7%;而 oracle 文档在每迭代 1 个候选时对 Sums/Diffs 无效(14.8% 对 15.4%),8 个并行候选时才带来 +14.9% 的提升。
本文的目标是本文的目标是把外部知识自动、适时地注入 LLM 进化搜索,且全程不微调任何模型参数:在覆盖数学(8 题)、量子编译、天体动力学、科学算法、AI 基础等领域的 21 个主实验任务上提升 OpenEvolve 的归一化发现增益 NDG,并在部分任务上刷新人类已发表的 SOTA 程序分数;同时让检索随知识缺口按需触发,消除 joint-level 方案 88.1% 的重复 URL 问题;并保证方法可插拔——作为额外一个『搜索环』叠加到 OpenEvolve、Top-K、EvoX 等既有脚手架上都有效,且单任务成本控制在数十美元量级(11 个 SOTA 运行平均 45.56 美元)。
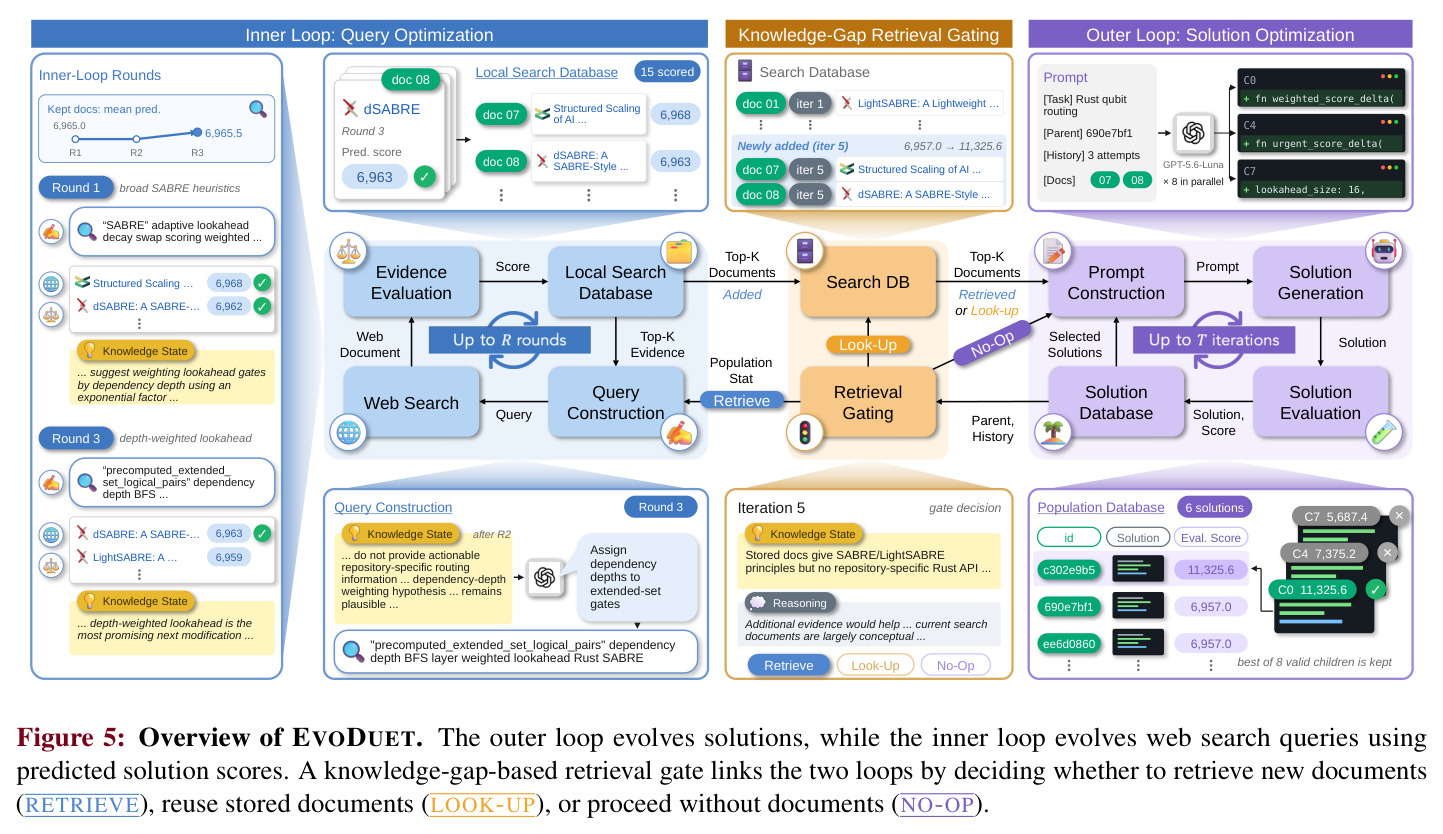
与已有工作不同的是,独特切入角度是把『该不该搜、搜什么』从解循环中剥离出来,用双层优化建模:外环进化解 $x$,内环进化查询 $q$,二者通过知识缺口门控耦合。若内环对每条查询都真实生成并评估候选将代价高昂,作者改用 LLM 充当分数预测器 $\hat{E}_\theta$,对每篇文档给出『假设性证据评分』$\hat{s}_t(d)$——预测基于该文档单独改进父代解所能得到的评估器分数——以此代理信号排序文档并指导下一轮查询。这与 EvoX(策略环与解环共享同一知识源,封闭搜索)和 DeepEvolve(顺序耦合搜索与解优化)本质不同;检索到的文档还会连同真实评估分数存入搜索数据库供后续 LOOK-UP 复用,使查询与解真正共同演化。
核心方法
直觉:人类科学家只在遇到知识盲区时才查文献,且查询词随研究进展持续变化。EvoDuet 据此把发现过程形式化为双层优化 $x^\star=\arg\operatorname{opt}_{x\in X} E(x)$,约束 $q^\star_t=\arg\operatorname{opt}_{q\in Q_t} E(x_{t+1}(q))$;因内层目标需真实评估,用 LLM 预测器 $\hat{E}_\theta$ 近似。技术路线含三块:(1) 外环沿用 OpenEvolve 进化流程,候选生成时可注入文档集 $S_t$,RETRIEVE/LOOK-UP 时并行生成 N=8 个候选取最优,NO-OP 时 N=1;(2) 知识缺口门控每迭代输出知识状态 $K_t$ 与决策 $g_t\in\{\text{NO-OP},\text{LOOK-UP},\text{RETRIEVE}\}$;(3) 内环在 R 轮内循环执行查询构造、网络搜索、假设性证据评分与知识状态更新,保留 Top-D 文档交回外环,全程不生成也不评估任何候选。
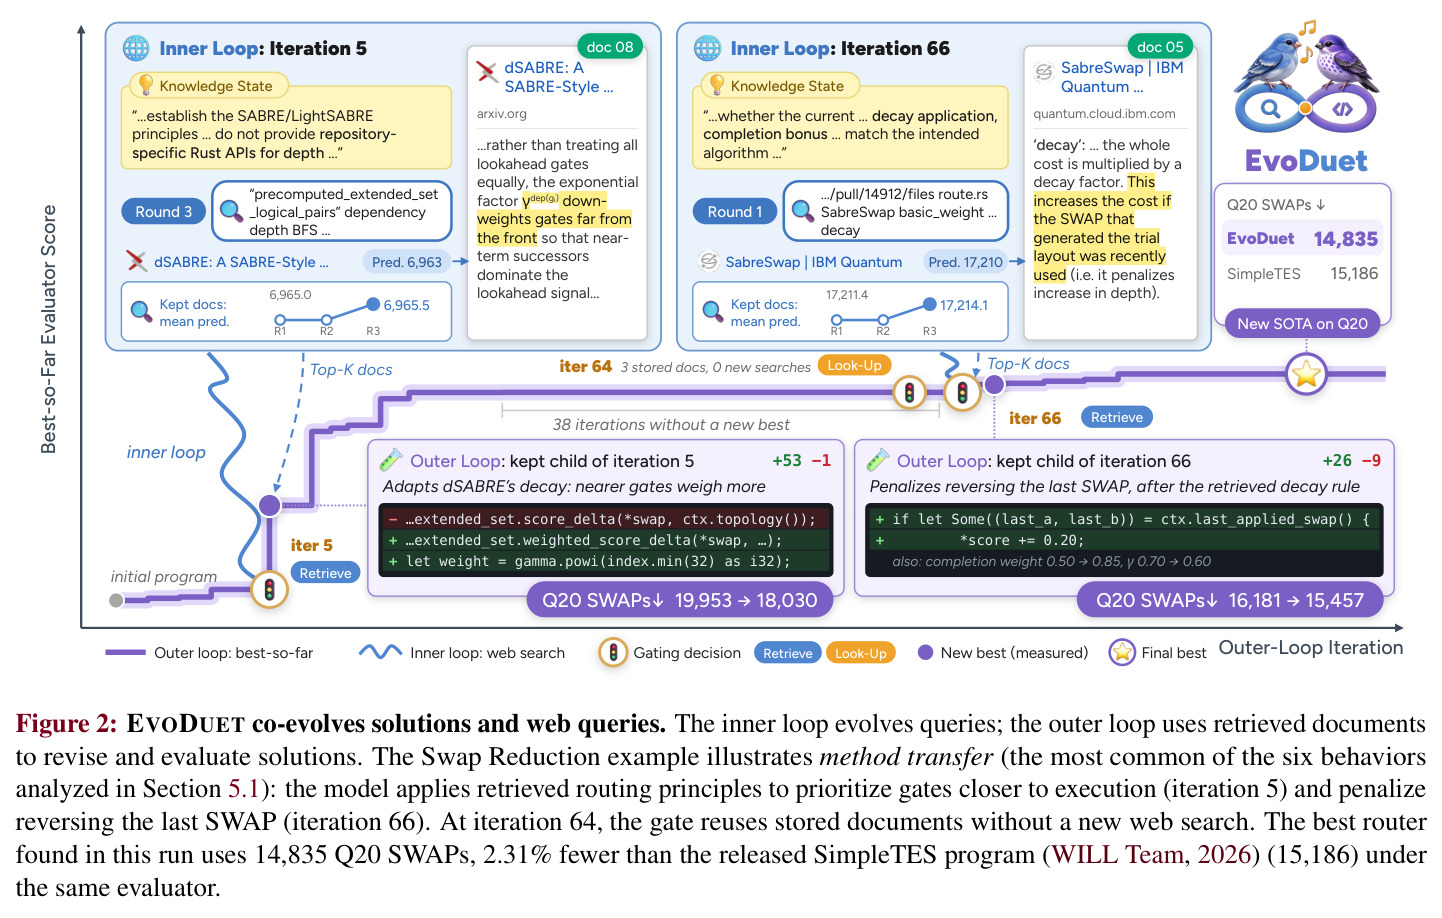
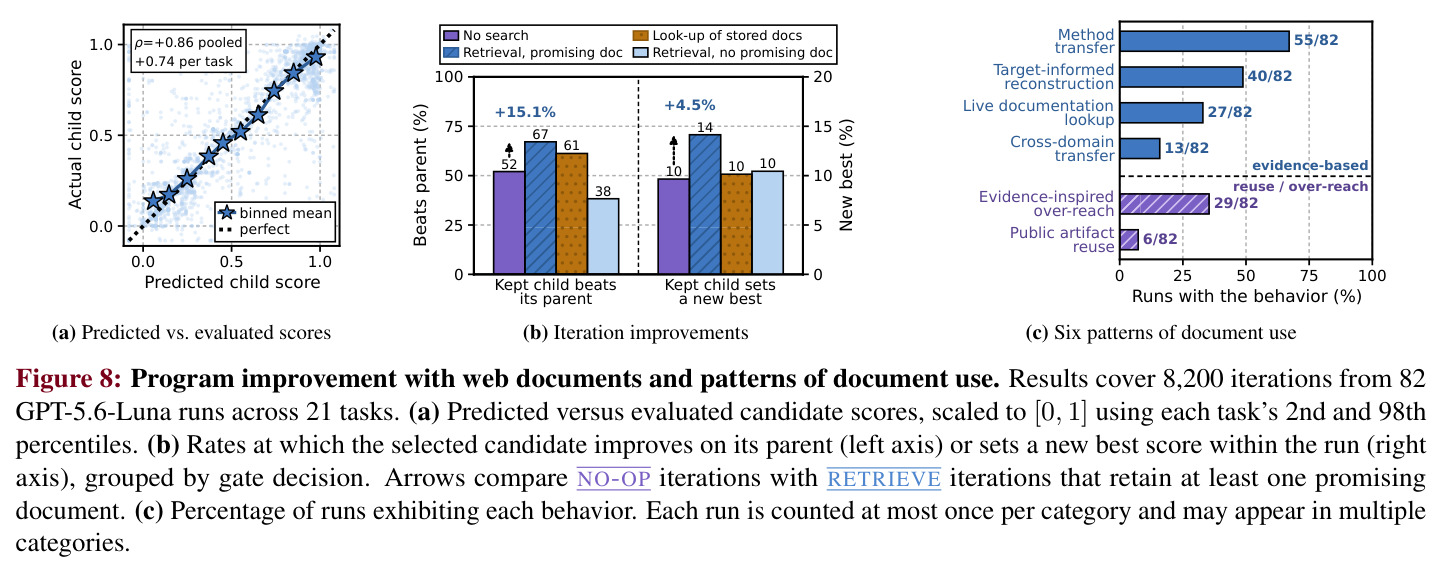
核心创新是『假设性证据评分 + 知识缺口门控』的组合,把查询质量定义为『由该文档生成的候选解的评估器得分』,从而在不评估候选的前提下优化查询。该代理信号非常可靠:4,324 次检索中预测分与实际评估分的 Spearman $\rho=+0.86$,21 个任务全部正相关(中位 +0.74)。与已有工作的本质区别:EvoX 的策略环与解环仍共用参数知识与运行历史两个知识源,是封闭搜索;DeepEvolve 顺序耦合搜索与解优化;joint-level 让解模型边解题边搜索,导致反复抓取相同页面(88.1% URL 重复)。EvoDuet 把文档与真实评估分存入搜索数据库,门控可判定 LOOK-UP 直接复用存储文档而无需新搜索——Swap Reduction 运行的第 64 迭代就出现『3 篇存储文档、0 次新搜索』的决策,说明系统能识别知识已足够并主动跳过检索。
方法步骤详情
完整流程:每迭代 $t$,选择策略 $\phi$ 从种群选出父代 $x_t$ 与历史 $H_t$ 构成上下文 $c_t$。第一步门控:LLM 综合知识与最近存储文档输出 $(K_t,g_t)$——知识足够则 NO-OP;存储文档可补缺则 LOOK-UP;两者都不足则 RETRIEVE。第二步内环(仅 RETRIEVE):先由种群统计得到事实观察 $A_t$,随后 R 轮循环:构造 J 条针对性查询 $Q_r$、每条执行一次网络搜索、新文档并入池 $P_r=S^{r-1}_t\cup\text{SEARCH}(Q_r)$、单次调用同时完成假设性评分 $\hat{s}_t(d)=M_\theta(\tilde{c}^{r-1}_t,E(x_t),d)$ 与知识状态更新 $K^r_t$,保留预测分最高的 D 篇。第三步外环生成:以 $M_\theta(I,c_t,S_t)$ 并行采样 $N_t$ 个候选,逐一评估,取最优有效解交由 $\phi$ 决定去留。第四步记录:文档连同真实评估分 $E(x_{t+1})$ 写入搜索数据库 $D_s$,供后续门控与 LOOK-UP 复用。
技术新颖性
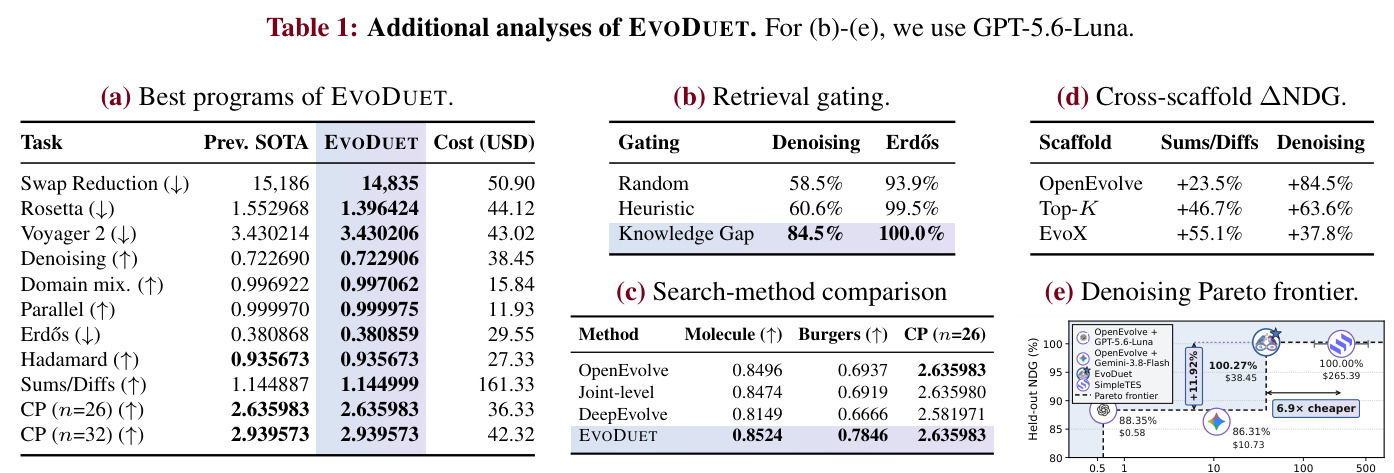
新颖性有四点:(1) 首次把『网络搜索查询』作为独立的被优化对象与解双层协同进化,查询的适应度由下游候选解的(预测)评估分定义——把进化搜索『按分数选择』的思想搬进查询空间,且内环零候选评估;(2) 知识缺口门控让模型自评『我还缺什么』,消融显示在 Denoising 上比 EvoX 的停滞启发式门控高 23.9 个百分点(84.5% 对 60.6%),比随机门控(p=0.5,58.5%)高 26.0 个百分点;(3) 假设性证据评分经 4,324 次检索验证相关性达 $\rho=+0.86$,支撑了用一次 LLM 调用同时完成打分与知识更新的高效设计,11 个 SOTA 运行平均成本仅 45.56 美元;(4) 通用性强:作为可叠加的环,在 OpenEvolve(+23.5/+84.5)、Top-K(+46.7/+63.6)、EvoX(+55.1/+37.8)上于 Sums/Diffs 与 Denoising 均带来增益,证明环叠加设计的组合性。
实验结果
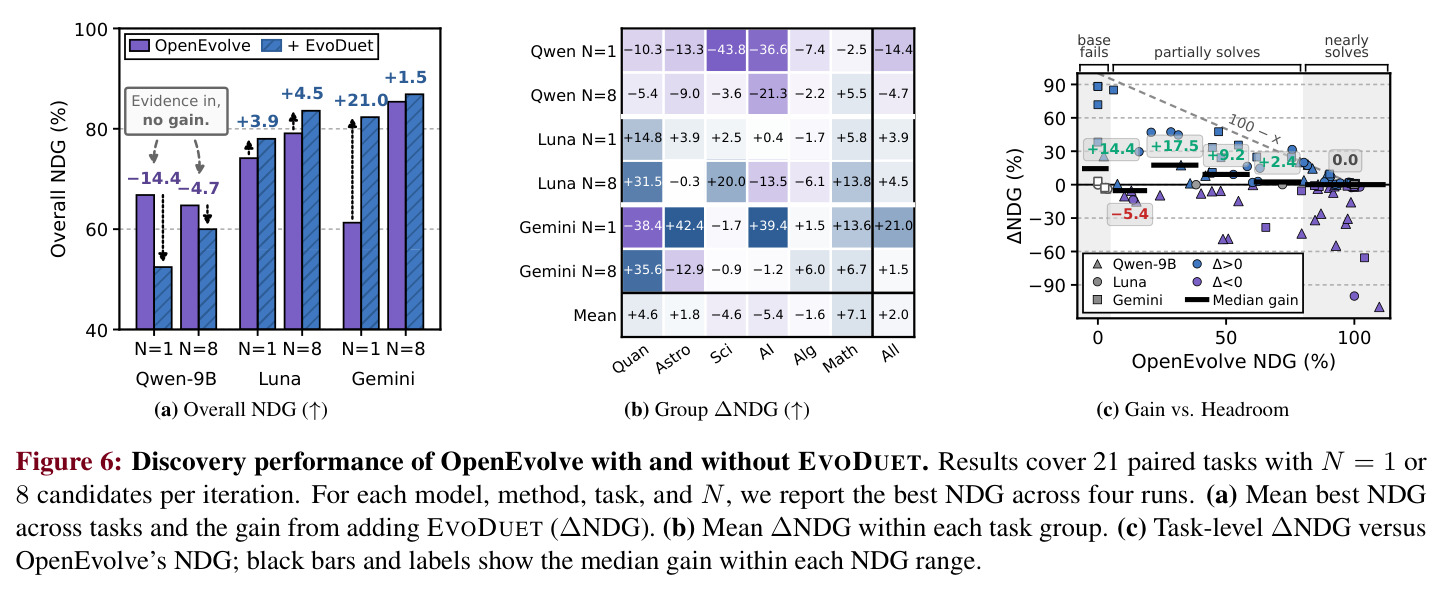
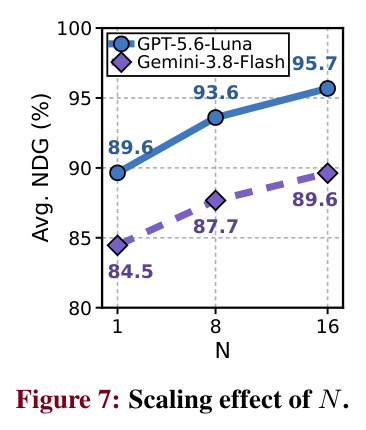
主结果(21 任务,N=1):EvoDuet 把 GPT-5.6-Luna 的 NDG 从 74.1% 提到 78.0%(+3.9%),Gemini-3.8-Flash 从 61.3% 提到 82.3%(+21.0%),但 Qwen3.5-9B 反降 14.4%(N=8 仍 -4.7%),26% 的修订未用或错用检索方法。N=16 时 Luna 达 95.7%、Gemini 达 89.6%;数学任务增益最大(+7.1%)。SOTA 层面刷新 8 项、打平 3 项:Swap Reduction 从 15,186 降至 14,835 个 Q20 SWAP(-2.31%),Rosetta 1.396424 对 1.552968,Denoising 0.722906 对 0.722690,以 38.45 美元达 100.27%,比 SimpleTES(265.39 美元)便宜 6.9 倍。机制上:有前景文档($\hat{s}_t(d)>E(x_t)$)使 67.1% 迭代超父代、14.1% 创新最优,NO-OP 仅 52.1%/9.6%;36.5% 检索无前景文档时改进率跌至 38.3%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 21 个优化任务整体(N=1,GPT-5.6-Luna) | 平均最佳 NDG (%) | 78.0 | OpenEvolve 74.1 | +3.9 |
| 21 个优化任务整体(N=1,Gemini-3.8-Flash) | 平均最佳 NDG (%) | 82.3 | OpenEvolve 61.3 | +21.0 |
| Swap Reduction(量子编译,Q20 芯片) | SWAP 门数(越低越好) | 14,835(成本 $50.90) | 此前 SOTA SimpleTES 15,186 | -2.31% |
| Denoising(单细胞 RNA 去噪) | NDG / 成本 | 100.27% / $38.45 | SimpleTES 100% / $265.39 | 成本降低 6.9 倍 |
| Rosetta(科学算法) | 评估分数(越低越好) | 1.396424($44.12) | 1.552968 | -10.1% |
| 检索门控消融(Denoising) | NDG (%) | 84.5(知识缺口门控) | 停滞启发式 60.6 / 随机 58.5 | +23.9 |
局限与改进
作者承认的局限:收益高度依赖骨干模型能力,Qwen3.5-9B 反而受损,说明框架要求模型既能找到又能正确实现证据;当基线已接近 SOTA(NDG 不低于 80%)时增益趋零,126 组比较中 NDG 不低于 80% 的 75 组中位增益为 0.0%,52 组 NDG 不低于 95% 的比较里有 6 组下降超过 5%;基线 NDG 低于 5% 的 10 例中仍有 5 例原地踏步;36.5% 的检索未产生任何有前景文档,且预测有前景的文档也可能产出更差候选(82 个运行中 29 例过度发挥)。我的补充观察:整个框架依赖确定性可验证的评估器 $E$,不适用于缺乏可靠评估器的开放任务;查询能否奏效以外部文献可检索为前提,冷门问题可能搜不到有用页面;即便 EvoDuet 的 URL 重复率仍有 62.4%;假设性评分的可靠性($\rho=+0.86$)只在较强模型上验证,弱模型上未单独报告。
独立分析的弱点
独立分析的弱点:(1) 门控与评分由同一个 LLM 承担,存在自我偏好与校准风险,可引入独立的轻量打分模型或对 $\hat{s}_t(d)$ 按任务分位数校准;(2) 内环固定 R 轮、每轮 J 条查询,未按任务难度自适应,可让门控输出连续检索预算并按边际预测增益提前停止;(3) 搜索数据库只存文档与最终分数,丢弃了中间迭代轨迹,可为文档建立引用图或失败原因标注以提升 LOOK-UP 命中率;(4) 弱模型失效(26% 修订误用方法)可在生成后加证据一致性校验步骤,或用少量数据微调『按文档改代码』的能力;(5) 即便 EvoDuet 仍有 62.4% 重复 URL,可加局部向量索引做增量检索与去重;(6) 每任务数十美元成本对大规模任务扫描仍偏贵,可做成本感知的候选数调度与提前终止。
未来方向
作者提出的方向包括与更多脚手架组合、深入分析六类文档使用行为。基于成果可延伸:(1) 把知识状态 $K_t$ 显式建模为跨任务可迁移的长期记忆,让检索经验得以复用;(2) 引入多模态证据(论文图表、代码仓库 diff)参与证据评分;(3) 结合 N∈{1,8,16} 的单调收益(Luna 从 89.6% 到 95.7%)做成本感知的预算分配;(4) 自动在『方法迁移』与『公开产物复用』(仅 7.3% 运行出现)之间切换探索模式;(5) 把双层框架推广到无确定性评估器的场景,用 LLM 评审或真实实验反馈替代 $E$;(6) 系统研究弱模型加强检索器的互补条件,回答『检索能否替代参数知识』;(7) 针对基线 NDG 低于 5% 的僵局任务(10 例中 5 例无法起步)设计主动式知识注入策略。
复现评估
复现评估:论文提供项目页与算法伪代码(算法 1、图 5),附录给出 31 个预实验与 21 个主实验任务的描述、oracle 文档构造方法与逐任务完整结果,NDG 定义清晰,可复现性设计较好。算力门槛主要在 API 成本:主实验跨 21 任务 × 3 模型 × 2 预算 × 4 种子,82 个 GPT-5.6-Luna 运行共 8,200 次迭代;11 个 SOTA 运行单次成本 11.93 至 161.33 美元(均值 45.56 美元),Denoising 全程 38.45 美元。外部依赖包括 Tavily 搜索 API、OpenEvolve/Top-K/EvoX 脚手架,以及 GPT-5.6-Luna、Gemini-3.8-Flash、Qwen3.5-9B 的访问权。总体复现难度中等:流程描述完整,主要不确定性在提示词模板与门控判定的细节一致性。
论文图表
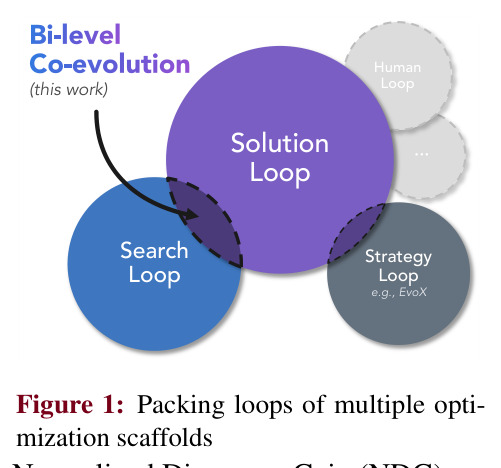
对比三种脚手架的环结构:仅含解循环的基础脚手架、EvoX 的『策略环包住解循环』、以及本文的『搜索环包住解循环与策略环』。图注点明关键事实:此前所有叠加的环都只依赖参数知识与运行历史两类知识源,而本文首次引入外部网络知识。
一张图完成问题定位:它解释了 Loop Packing 概念,并把 EvoDuet 在设计空间中的位置(第一个开放搜索环)与 EvoX 等相关工作清晰区分开。
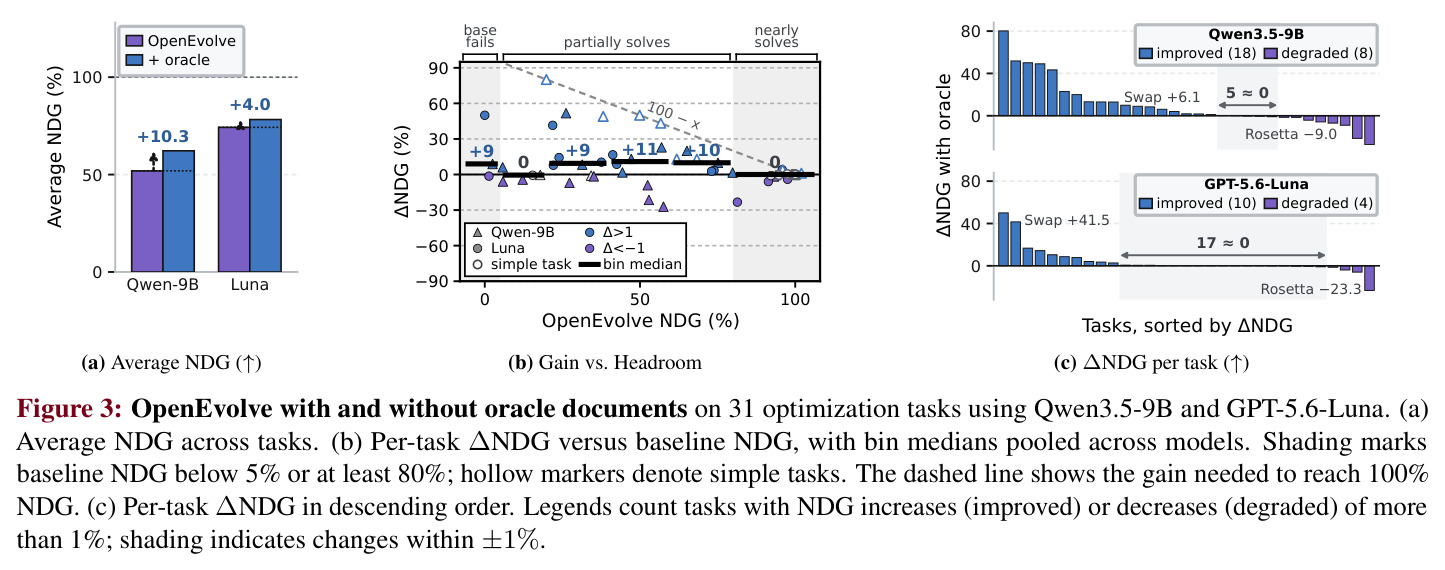
三个子图:(a) 平均 NDG,oracle 文档使 Qwen3.5-9B 提升 10.3%、Luna 提升 4.0%;(b) 逐任务增益对基线余量的散点与分箱中位数,基线 NDG 已达 80% 以上的 16 个任务中文档平均只改变 0.1%;(c) 逐任务 ΔNDG 降序,Qwen 有 8 个任务、Luna 有 4 个任务下降超 1%,Rosetta 上分别为 -9.0% 与 -23.3%。
动机部分的核心证据:证明外部知识有用但收益不均、依赖探索余量与任务余量,直接引出『为什么需要查询演化与门控』的研究问题。
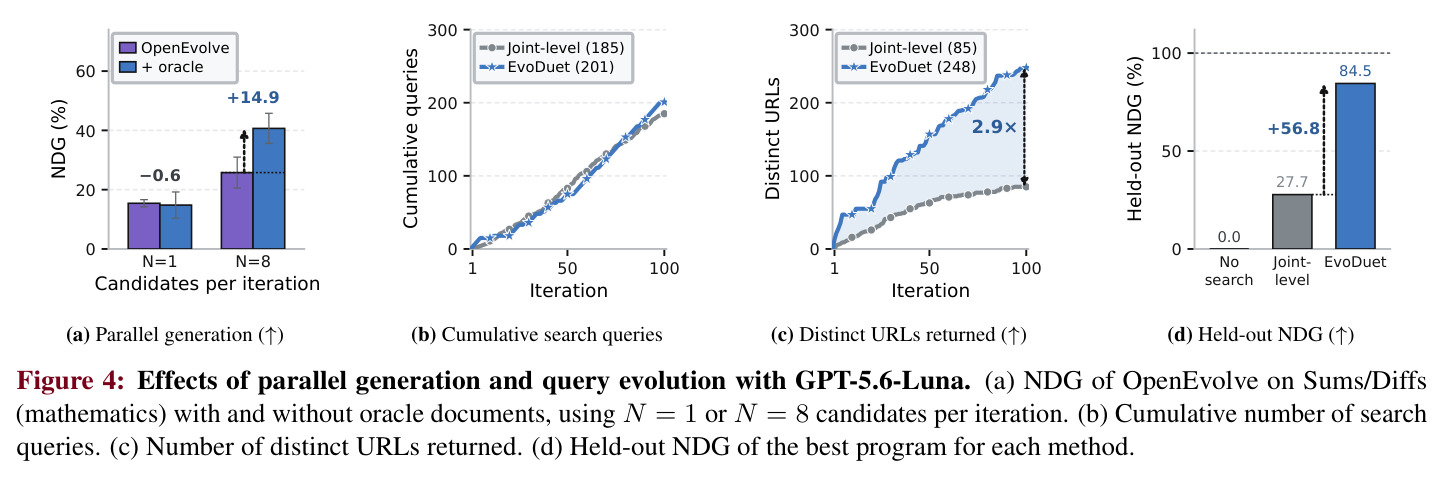
四个子图:(a) Sums/Diffs 上 N=8 时 oracle 文档把 NDG 从 25.8% 提到 40.7%,N=1 时反而略降(14.8% 对 15.4%);(b) Denoising 上 100 迭代的累计查询数,joint-level 185 条对 EvoDuet 201 条,数量相当;(c) 去重后 URL 数 85 对 248(约 2.9 倍),重复率 88.1% 对 62.4%;(d) held-out NDG 27.7% 对 84.5%(+56.8%)。
用对照实验证明『查询必须随解共同演化』这一核心论点:同等查询预算下,双层设计找回的独立信息量是联合搜索的 2.9 倍,是双层架构合理性的最直接证据。