CALON:面向实体、关系与事件抽取的校准化类型化决策 Calibrated Typed Decisions for Entity, Relation, and Event Extraction
0.6B统一编码器覆盖实体/关系/事件抽取,用相对奖励优化类型化决策并校准置信度
前置知识
信息抽取与 schema 条件化抽取
信息抽取(IE)把非结构化文本转成结构化记录,包含命名实体识别(NER)、关系抽取(RE)、事件抽取(EE)三个子任务。schema 指定要抽取的类型集合(如人物、组织、works_for 及其定义)。传统模型为固定类型集训练,每换一套类型就要重训;schema 条件化模型把类型名/描述作为输入的一部分,从而一个模型可以服务不同用户的不同类型需求而无需重新训练。
本文的 CALON 正是这样一个 schema 条件化统一抽取器,全文围绕"同一模型如何跟随用户指定的类型定义、跨领域跨任务准确抽取"展开,评测(40 个基准全部零样本)与贡献都建立在这一设定上。
Span-based 抽取与 null 类
把候选片段(span)或 span 有序对作为分类对象,每个候选在"查询类型 + null 类"上做 softmax,null 类表示"不属于任何要找的类型"。训练时绝大多数候选都是 null,通常对 null 候选降权(本文权重 $\omega=0.1$);预测时用非 null 概率之和 $1-p_c(0)$ 过阈值决定是否抽取,再用 argmax 定类型。这是处理候选爆炸与类别极不平衡的标准做法。
CALON 把实体归约为 span 分类、关系归约为 span 对分类、事件归约为两次此类预测;其校准创新正是针对 null 降权引入的概率偏置,理解 null 类机制才能理解其解码与修正设计。
RLCD / GRPO 式相对奖励
一类不带 critic 的强化学习目标:对同一输入采样多个输出,用组内其余样本的平均奖励做基线(leave-one-out),优势 $\delta^{(k)}=R^{(k)}-\bar R^{(-k)}$ 驱动策略梯度更新,把高奖励决策的概率推高。RLCD 强调用显式概率刻画的偏好决策,GRPO 是其在 LLM 训练中的代表实现(DeepSeekMath 提出)。
论文的核心训练创新就是把这一机制从序列生成搬到候选 span 的类型化决策上:给 logits 加高斯噪声采样 S=8 个决策,正确类型 +1、错型/误报 −1、null 0,用相对优势补充极大似然损失。
置信度校准、温度缩放与 ECE
校准指模型输出的概率应反映真实正确率。温度缩放用 $p_i=\mathrm{softmax}(z_i/T)$ 以单一温度 T 调整分布尖锐度,T 在验证集上最小化多类 Brier 分数求得;ECE(期望校准误差)把预测按置信度分桶,计算每桶平均置信度与实际准确率之差的加权平均,越低越可信。抽取系统若置信度虚高,下游就无法可靠地做阈值过滤和人机分流。
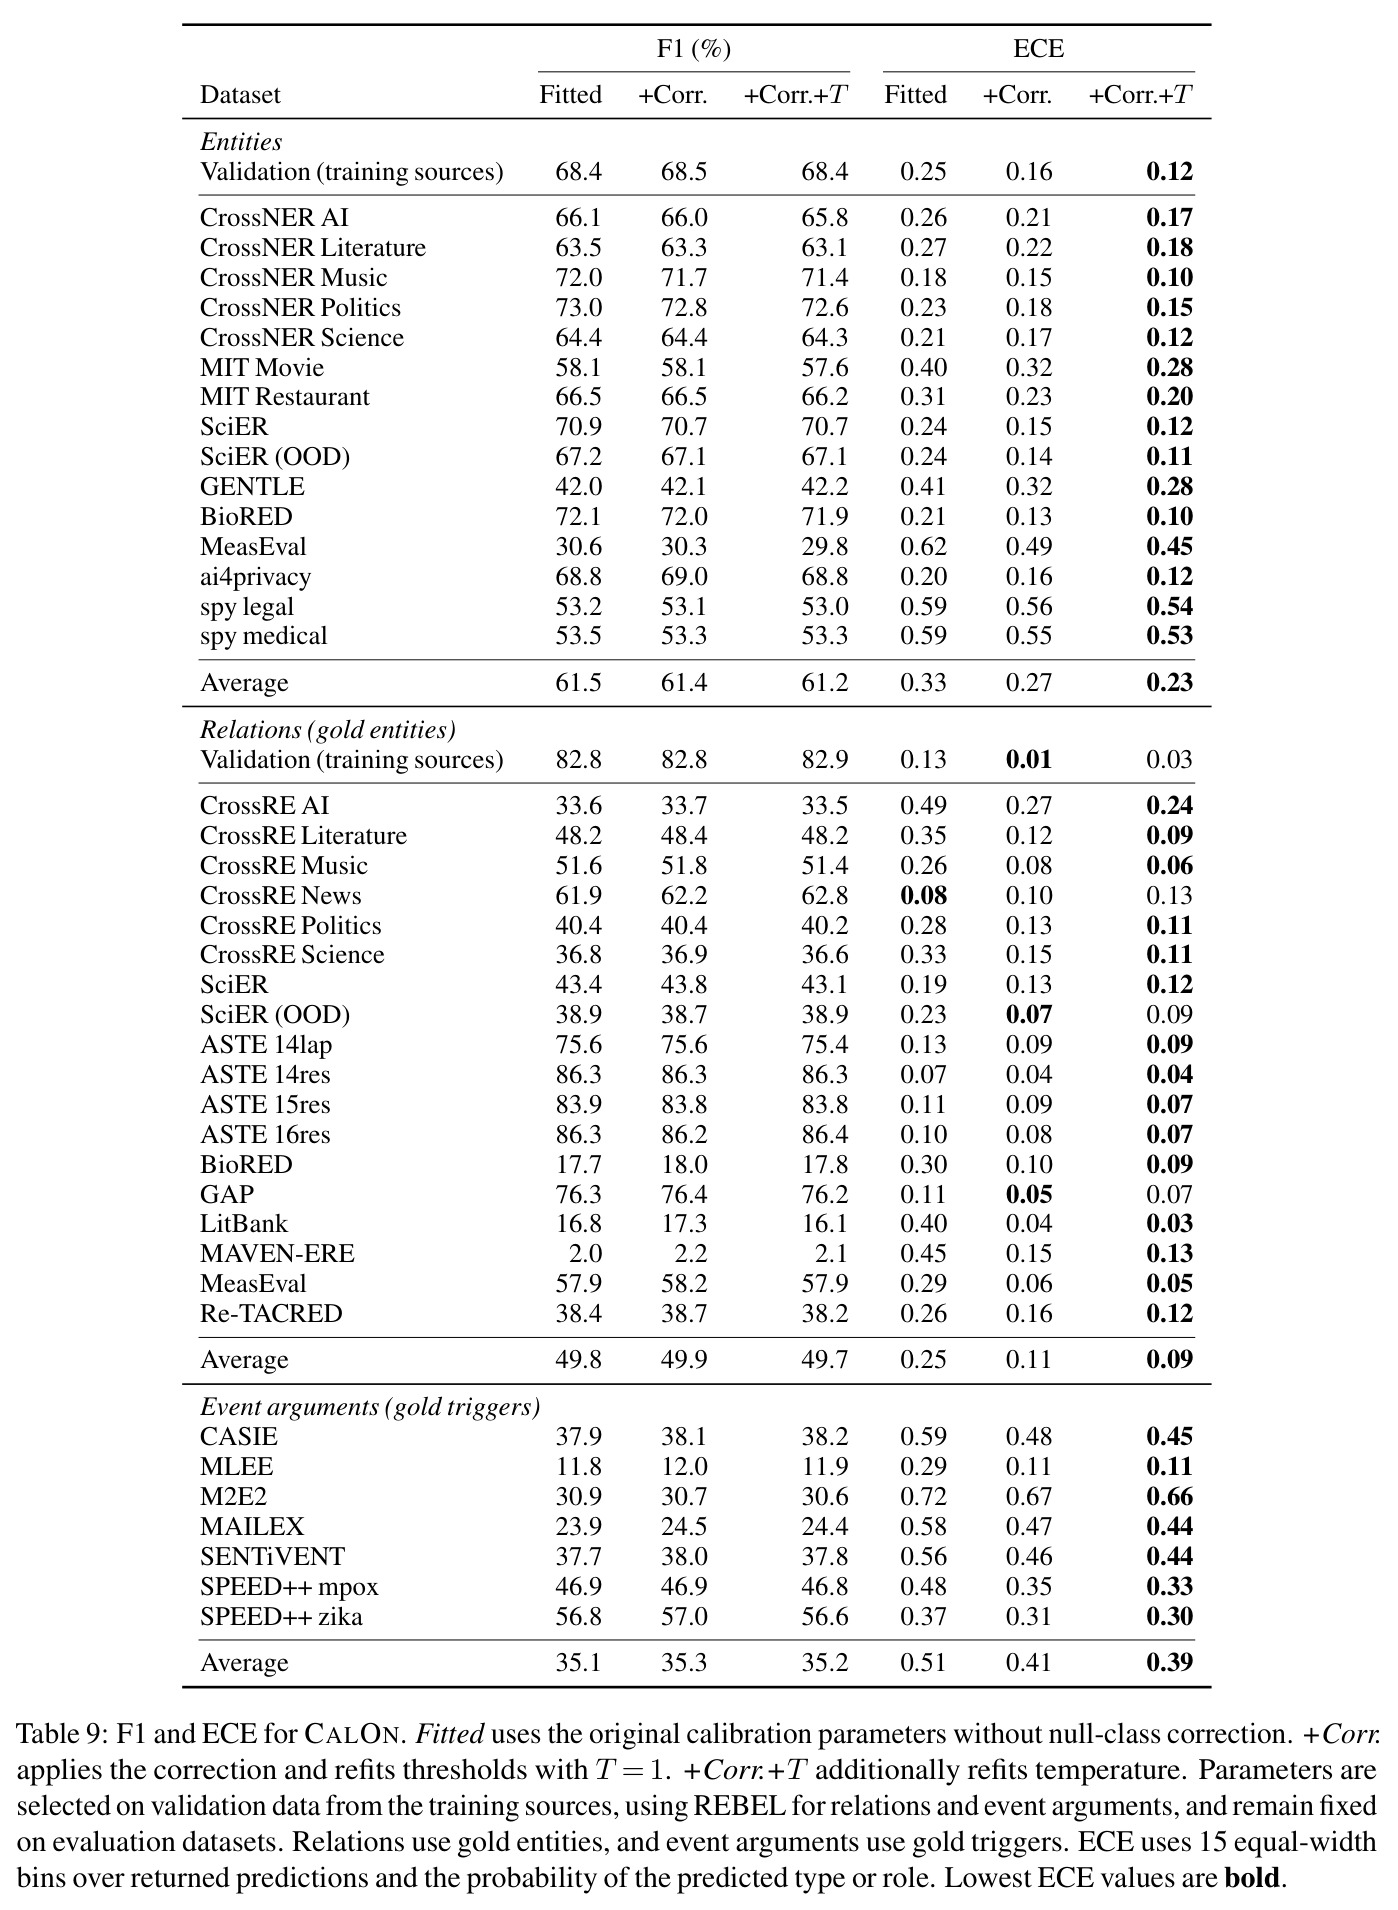
本文第三个贡献是抽取置信度校准:训练时给 null 候选降权会系统性压低 null 概率,作者借用稀有事件逻辑回归的先验修正 $\log(1/\omega)$ 修正 null logit,再配合温度缩放与阈值,使三个任务的 ECE 大幅下降而 F1 几乎不变。
研究动机
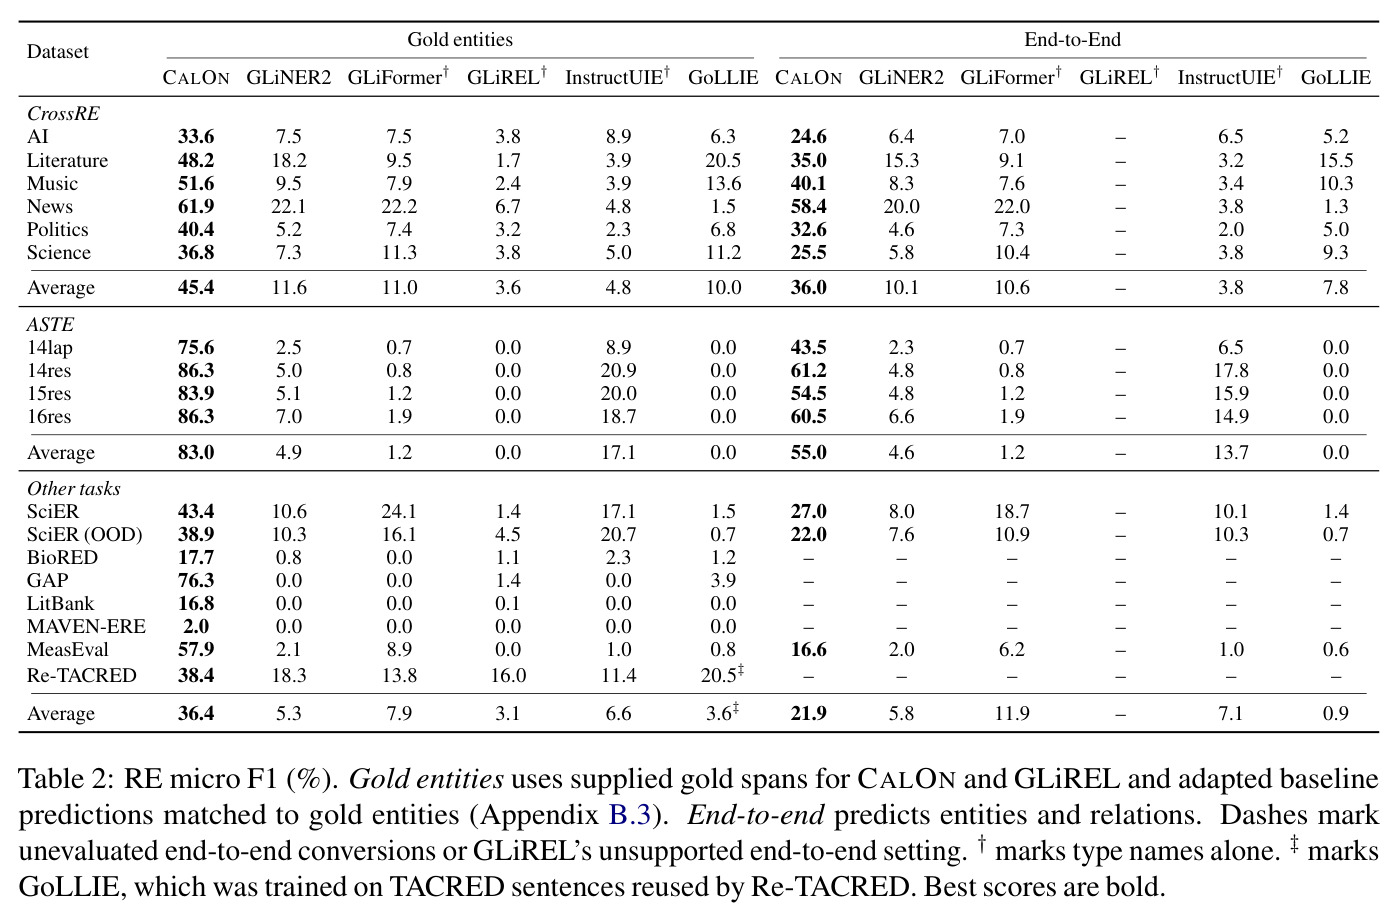
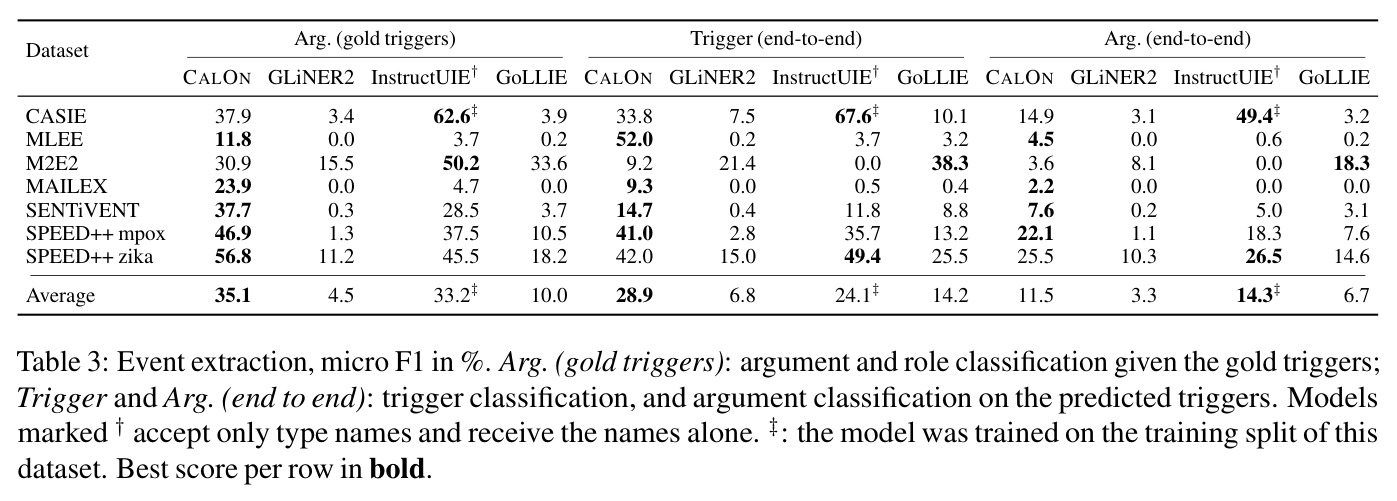
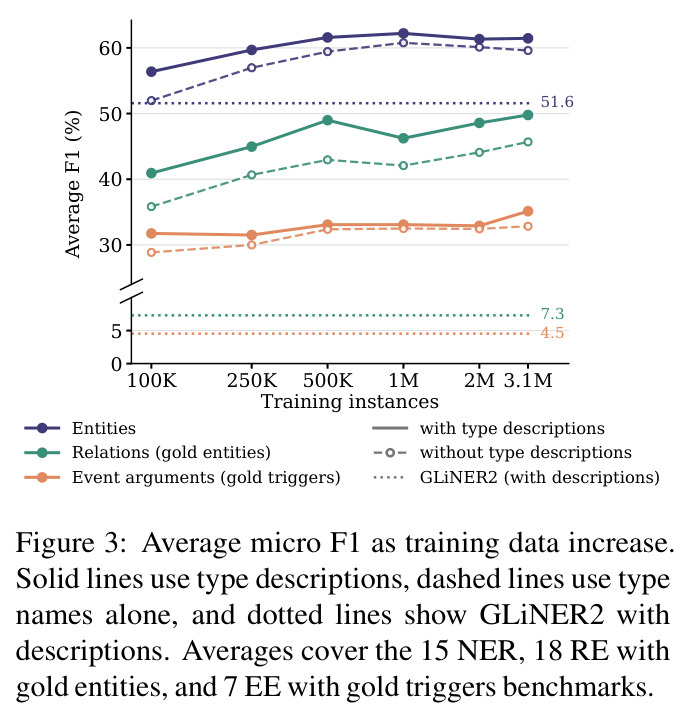
信息抽取模型通常在自己训练的数据集上表现良好,但迁移到新领域或新标注指南就明显退化。生成式方法还会产生不可控的结构性错误:GPT-NER 会报出文本中不存在的实体,GNER 则被记录有边界错误以及漏抽、增删或改写输入词。即便新一代通用抽取器支持用户自定义 schema,实测表现也很不稳定:在本文的 40 个基准上,GLiNER2 的零样本 NER 平均 F1 从 CrossNER 的 62.4 跌到 GENTLE 的 24.1、MeasEval 的 22.7;关系抽取中 GLiREL 若把所有 gold 实体的有序对都当作候选,平均 F1 只有 2.6——它几乎不会拒绝无关对,即便只提供已标注关系的正样本对,其 18 个基准上的平均类型准确率也只有 40%;事件抽取更弱,GLiNER2 在 7 个事件基准上给定 gold 触发词的参数 F1 平均仅 4.5。此外,不同训练源的标注覆盖不一致(如 RAMS 每段只标注一个事件,未标注的类型可能只是没标),"未标注"并不等于"不存在",这是统一训练长期面临的难题。
本文的目标是本文要构建一个统一的、支持用户指定 schema 的抽取器 CALON:一个 0.6B 参数的编码器,同时处理实体、关系和事件抽取,且同一套 span/span-pair 公式还能覆盖情感三元组抽取(ASTE)、代词消解(GAP)、共指(LitBank)以及事件间时序/因果/子事件关系(MAVEN-ERE)等任务。具体目标有三:(1) 在不使用任何目标数据集标注做训练、模型选择或校准的前提下,单一模型在 40 个基准的大多数上超过现有通用基线,并领跑全部关系抽取基准和给定 gold 触发词时的事件触发词与参数平均 F1;(2) 在似然监督之外引入对"采样出的抽取决策"的期望奖励的直接优化,让模型在"分数稍有变化就可能变成错型或误报"的候选上更坚定地选择正确决策;(3) 修正训练中 null 类降权引入的概率偏置,使实体、关系、事件参数在几乎不损失 F1 的情况下获得更可信的置信度估计。
与已有工作不同的是,现有工作分裂为两派:判别式(UniEX、GLiNER、GLiNER2、GLiFormer)直接对 span 或 span 对打分,保留原文边界、支持灵活 schema,但跨领域、跨任务性能波动大;生成式(UIE、InstructUIE、GoLLIE)用文本生成表达抽取目标,能容纳详细指南,却会引入输入中不支持的实体并破坏原 mention 边界。强化学习方面,LA-RL 把 RL 用于生成式 IE 的标签感知自反思,RLCD 与 GRPO 提供了无需 critic 的偏好/组相对奖励框架,但尚无人把"候选 span 的类型化决策"本身当作随机策略来强化。校准方面,温度缩放(Guo et al., 2017)与 label smoothing(Desai and Durrett, 2020)是通用手段,而把稀有事件逻辑回归(King and Zeng, 2001)和点击预测(He et al., 2014)中的先验修正搬到"span 抽取对 null 候选降权"这一具体场景,并给出无数据、不改变候选排序的修正方式,是本文独有的切入角度。
核心方法
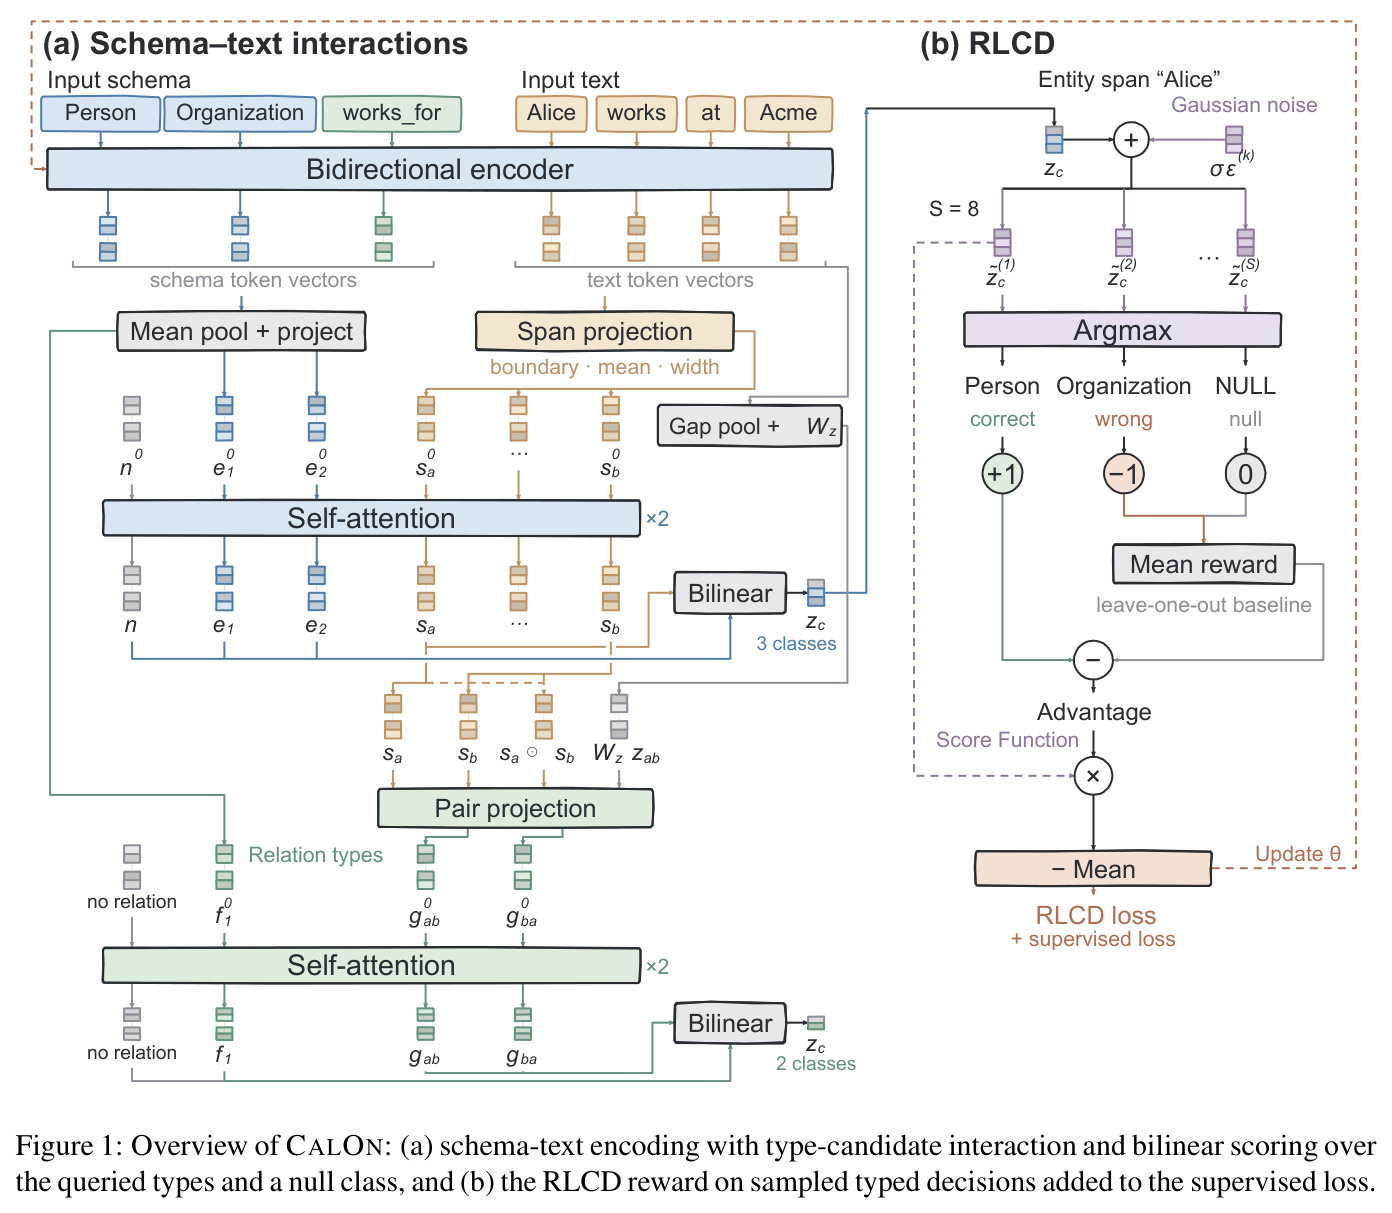
直觉上,抽取应拆成两个解耦的决策:先判断候选(span 或有序 span 对)是否属于任何要找的类型,即非 null 总概率 $1-p_c(0)$ 是否过阈值,再在查询类型之间做选择。这样即使重叠/层级类型分享了概率质量,也不会因某一单个类型概率偏低而错杀候选。技术上,CALON 用去掉因果掩码的 Qwen3-0.6B 联合编码 schema(类型名+一句描述)与文本;候选 span 用首尾 token、token 均值和宽度嵌入表示,与各类型向量及可学习的 null 向量拼成序列,过 $L=2$ 层无位置编码的全自注意力交互块,让类型与候选、候选与候选互相感知;随后用秩 $r=64$ 的双线性形式在 $\{0\}\cup K$ 上打分做 softmax。关系候选是有序 span 对(含两 span 逐元素积与中间文本均值向量),同时预测关系方向;事件被转化为两个训练实例(事件类型当实体类型、触发词当 span;角色当实体类型、触发词到参数当关系)。训练目标=加权负对数似然 + RLCD 式决策奖励;推理时对 null 类阈值化,并做温度缩放与先验修正。
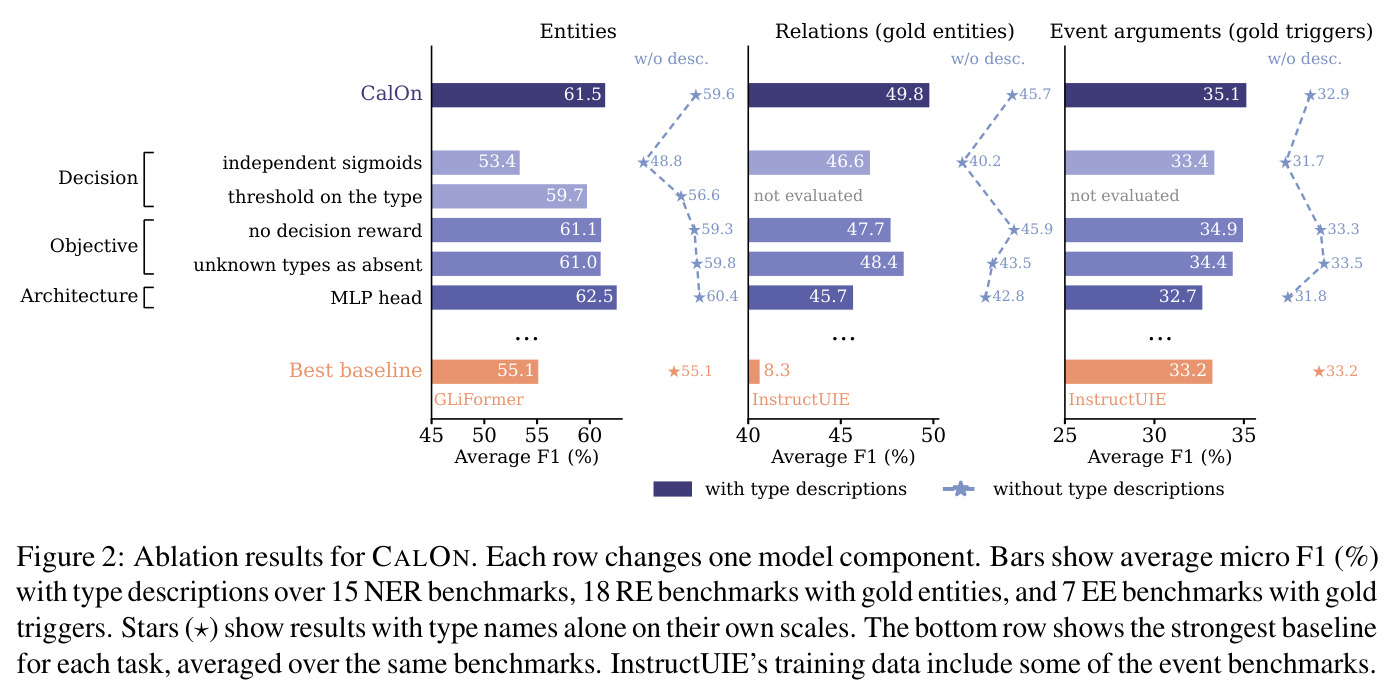
核心创新有三点。第一,判别式类型化决策+显式 null 类而非生成:所有 mention 都锚定在输入文本上,抽取与否由 $1-p_c(0)\ge\tau$ 决定、类型由 argmax 决定,从机制上避免生成式方法的幻觉与边界破坏;且阈值作用在"非 null 总概率"而非单个类型概率上——消融显示对单一类型阈值化会把 NER 平均 F1 从 61.5 拉低到 59.7。第二,把每个候选的决策视为随机策略:给 logits 加高斯扰动 $\tilde z_c^{(k)}=z_c+\sigma\epsilon^{(k)}$ 采样 $S=8$ 个决策,按评测口径给奖励(gold 类型 +1、错型或误报 −1、null 0),用其余样本的平均奖励做 leave-one-out 基线计算优势做策略梯度,全程无 critic。这直接利用了"同一候选改变类型分数就可能从正确变成错型或误报"的结构,把正确决策与两类典型错误的对比作为额外训练信号,与纯极大似然训练有本质区别。第三,先验修正:null 权重 $\omega=0.1$ 相当于负采样,会使模型把 null 对类型的几率报低,在温度缩放前给 null logit 加 $\log(1/\omega)$ 即可无数据地修正。
方法步骤详情
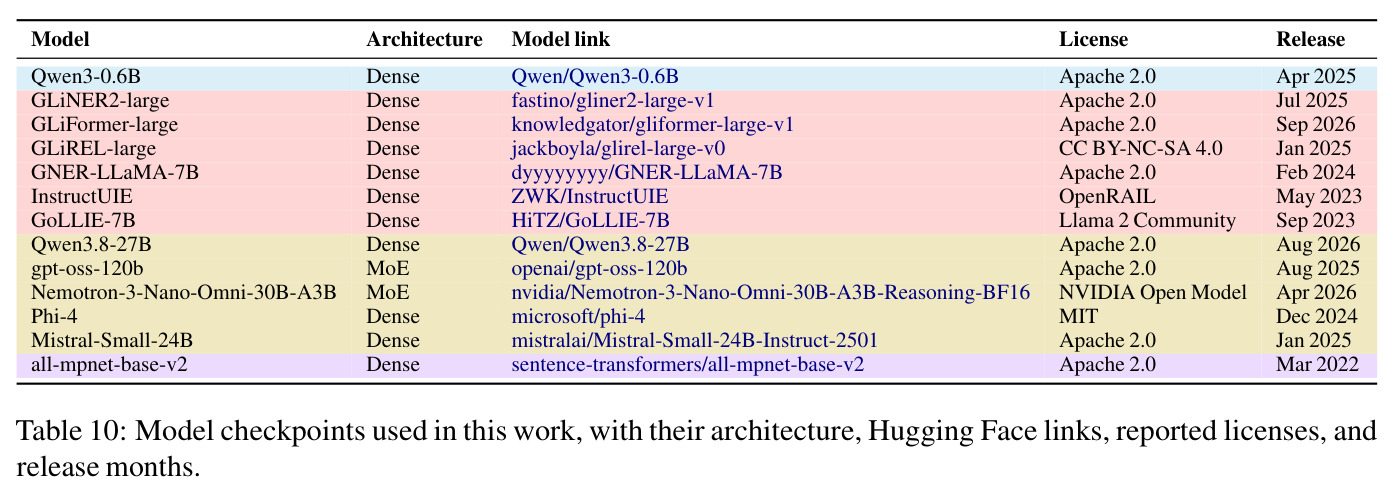
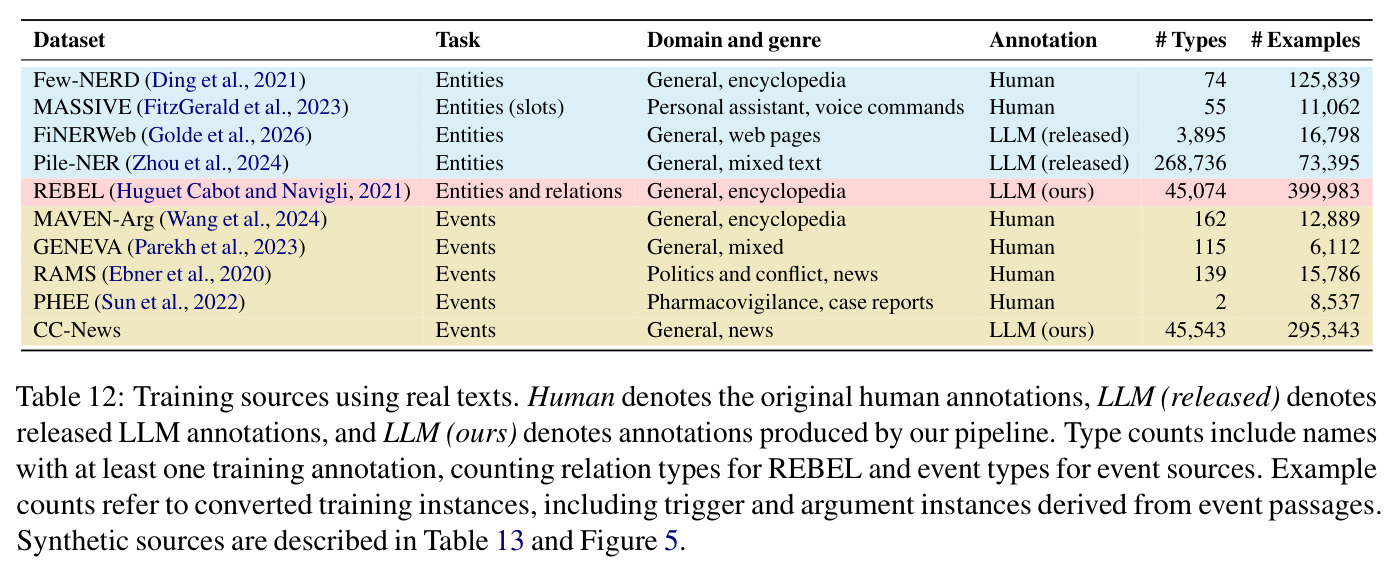
流程分六步。(1) 编码:schema 与文本拼成 $\langle\mathrm{LABEL}\rangle y_1{:}d_1\cdots\langle\mathrm{REL}\rangle r_1{:}d'_1\cdots\langle\mathrm{TEXT}\rangle x$,文本单独分词保留字符偏移,去因果掩码的 Qwen3-0.6B 输出 $H$,总长上限 3072 token。(2) 表示:≤32 token 的候选 span 编码为 $s^0_{ij}=W_s[H_i;H_j;\bar h_{ij};w_{j-i}]$,实体类型 $e^0_m=W_e\bar h_m$、关系类型 $f^0_k=W_r\bar h'_k$。(3) 交互:[null 向量; 类型; span] 序列(加 kind 嵌入、无位置信息)过 $L=2$ 层 Transformer 全自注意力,使类型与候选互相感知。(4) 打分:实体 logits $z_{m,c}=\tfrac{1}{\sqrt r}(Ve_m)^\top(U s_c)+b$ 后在 $\{0\}\cup K$ 上 softmax;关系对 $g^0_{ab}=W_g[s_a;s_b;s_a\odot s_b;W_z\bar z_{ab}]$(≤24 span)经独立交互层后选型并预测方向;事件转化为两个训练实例(触发词作实体;角色作实体+触发→参数作关系)。(5) 训练:$\ell_c=-\log\sum_{g\in G_c}p_c(g)$,null 权重 $\omega=0.1$,unknown 类型不进决策;决策奖励 $S=8$、$\sigma=1$、$\rho=0.5$;$L=L_{ent}+\lambda L_{rel}$($\lambda=1$);AdamW、40,000 步、全局 batch 128、32 GPU,数据为 84 源 3.1M 实例(约 35% 实体/41% 关系/23% 事件)。(6) 推理:$1-p_c(0)\ge\tau$ 抽取并 argmax 定类型;实体温度 T 最小化 Brier、τ 最大化 F1(训练源校准集),关系 T=1、τ 在 REBEL 上拟合,null logit 加 $\log(1/\omega)$。
技术新颖性
技术新颖性体现在四点。(1) 统一性:实体、关系、事件全部归约为 span/span-pair 上的类型化分类,同一公式还覆盖 ASTE(aspect→opinion 的有向关系、情感作类型)、代词消解、共指、事件间时序/因果/子事件关系,这是判别式阵营少有的广度——GLiNER2 虽号称多任务但没有可用的 RE/EE 基准结果。(2) 训练目标:把 GRPO 的组相对优势机制从序列生成迁移到单候选离散决策,无需价值网络;奖励定义与评测完全一致(精确匹配类型即 +1),使优化信号与指标对齐,是对判别式 IE 似然训练的新补充而非替换(权重 ρ 仅 0.5)。(3) 标注状态建模:positive/negative/closed-world negative/unknown 四态区分不同源的标注覆盖差异,unknown 类型退出决策、含 unknown 实例的无 gold span 被忽略,比简单把缺失当负例更合理。(4) 校准:把稀有事件逻辑回归的先验修正移植到 null 降权场景,加 $\log(1/\omega)$ 不需要数据、不改变固定温度下的候选排序,就能把关系 ECE 从 0.25 降到 0.10,简洁而实用。
实验结果
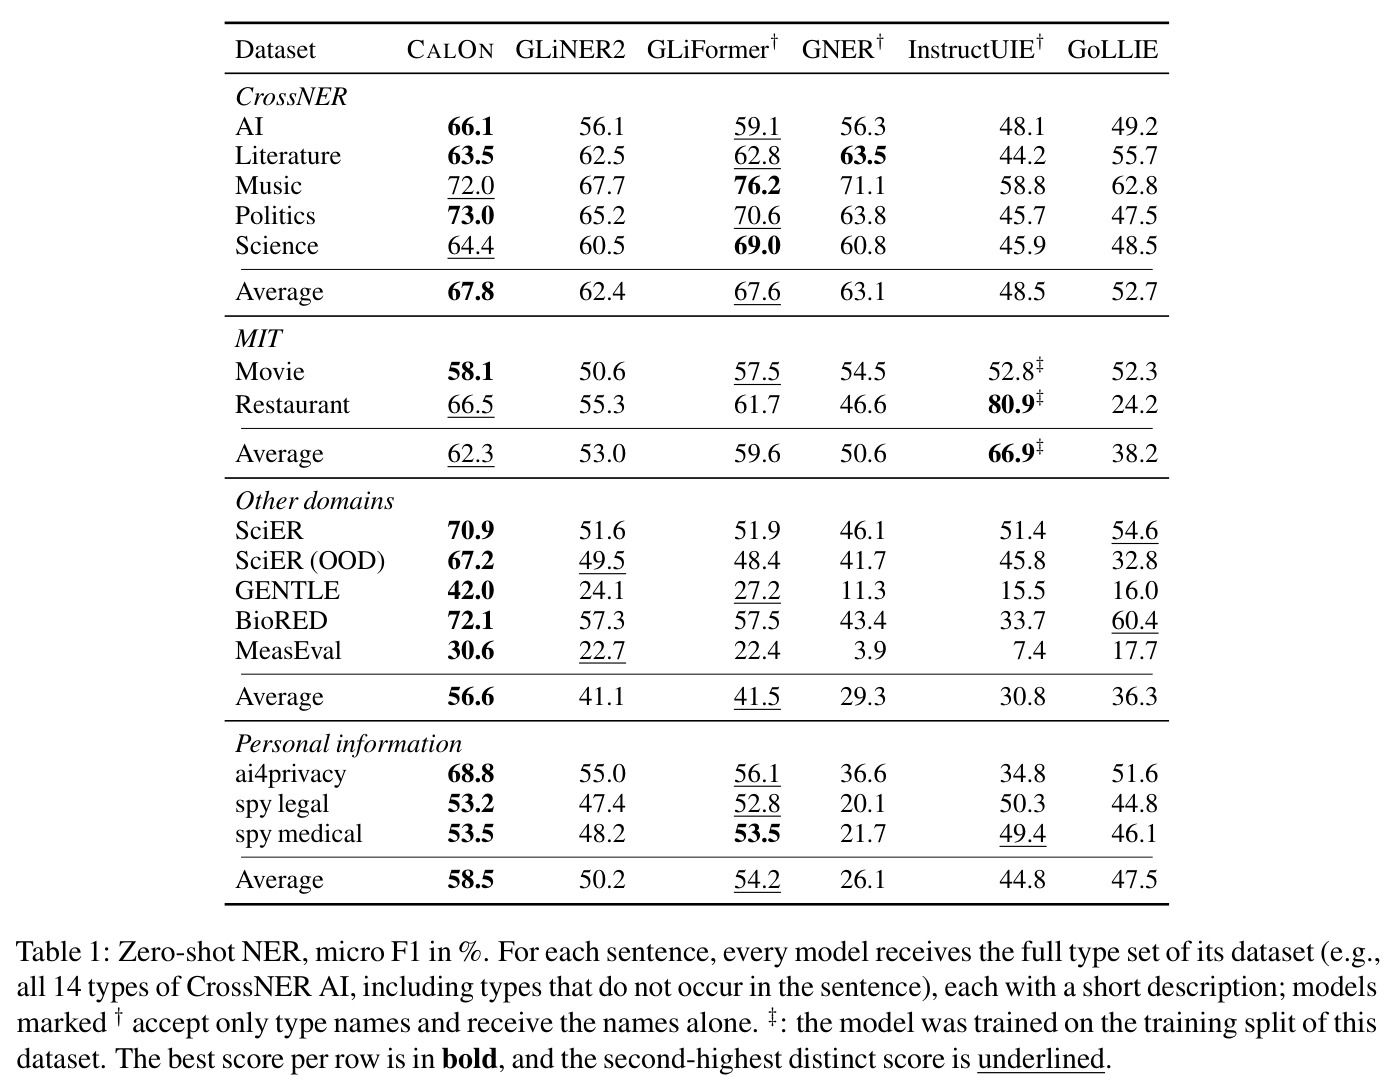
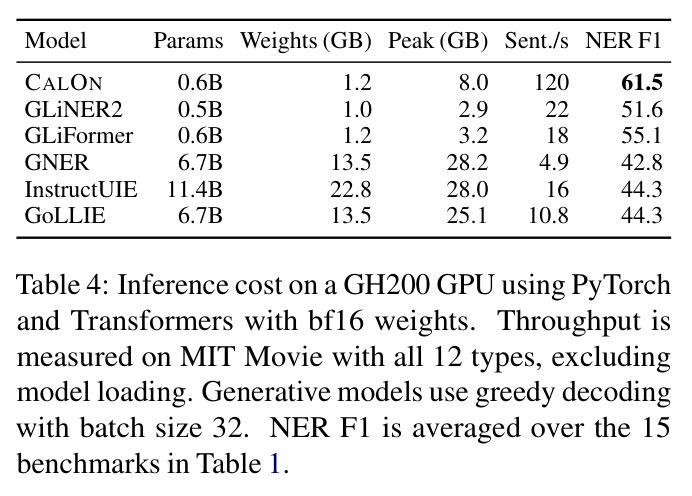
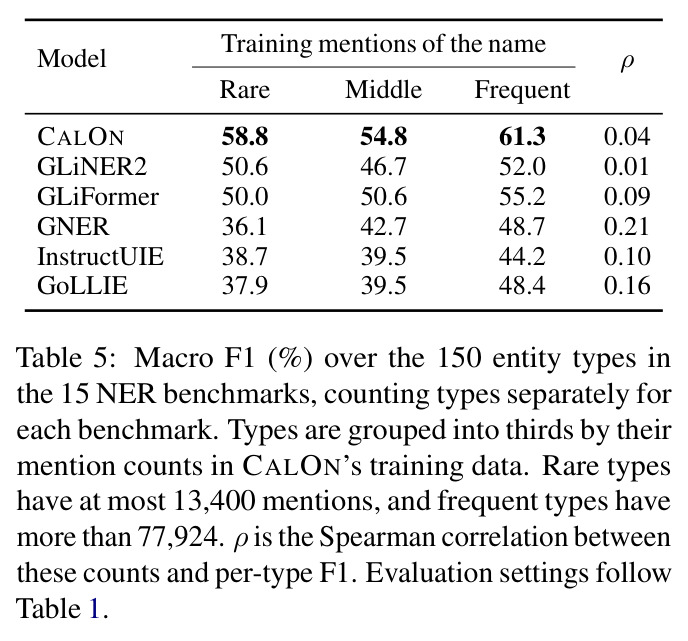
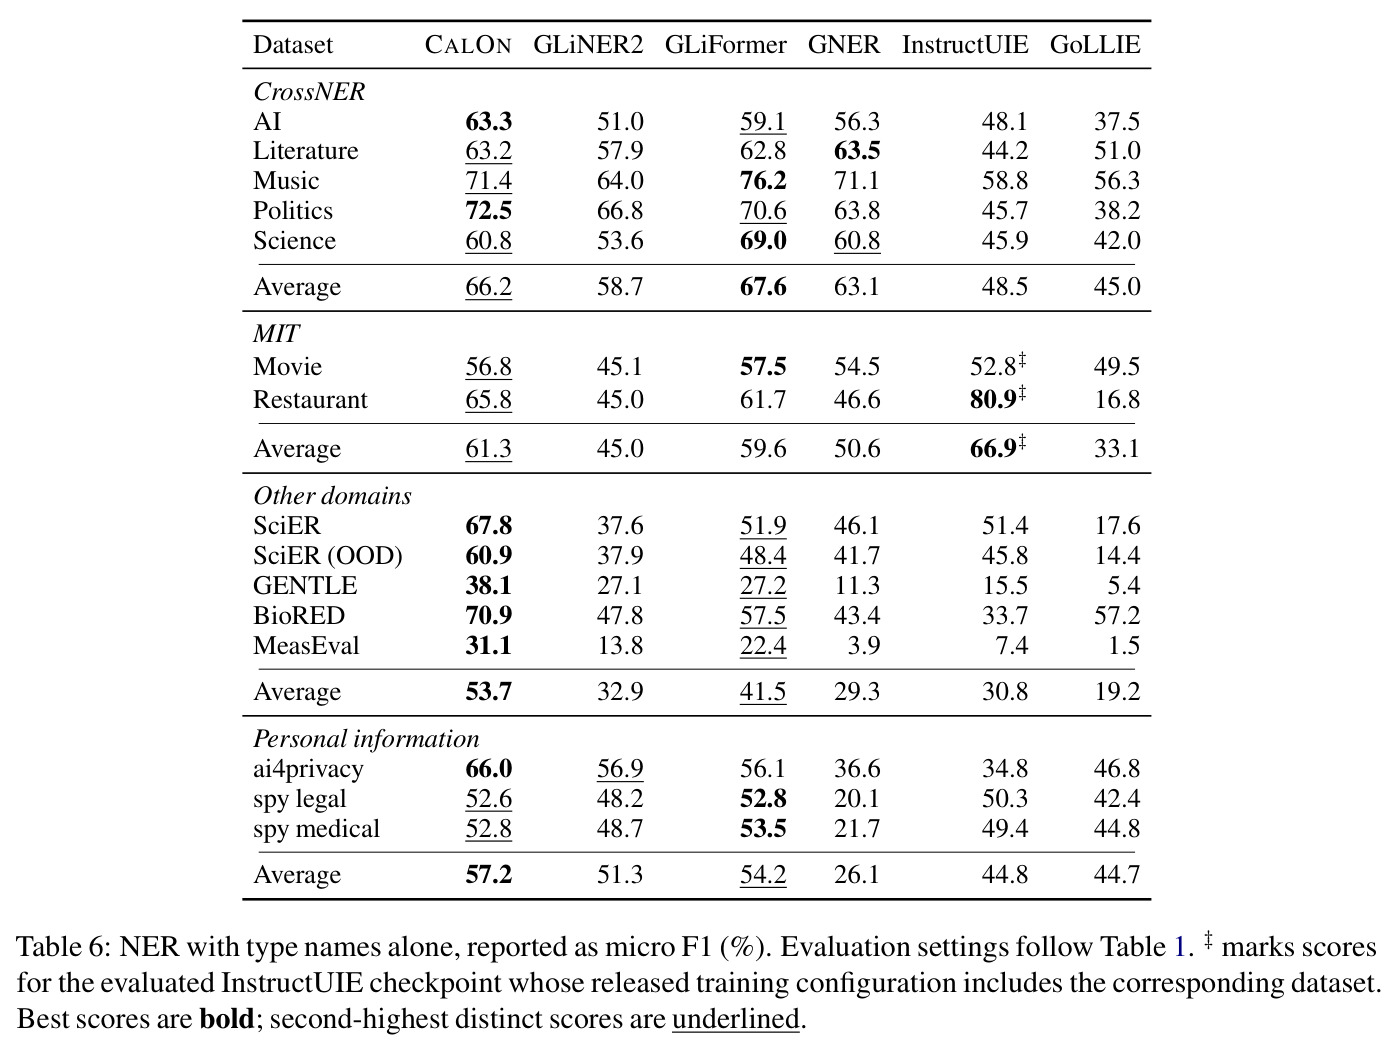
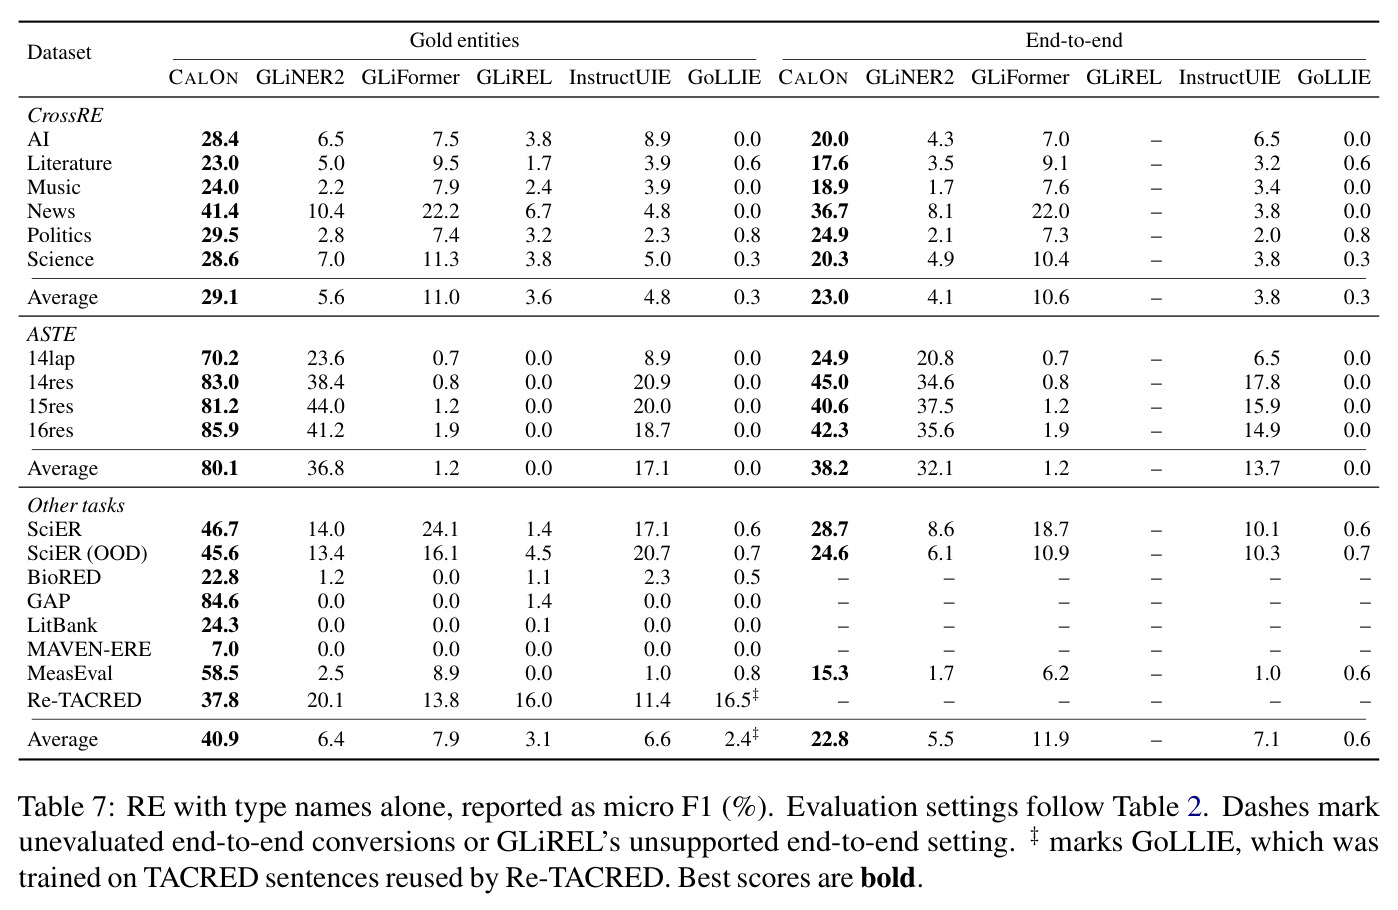
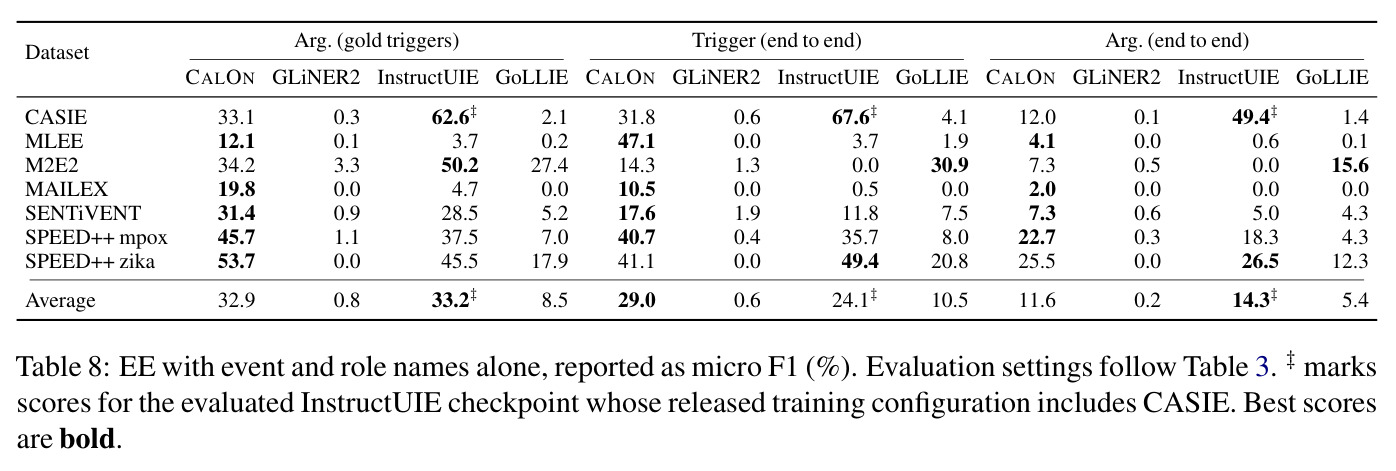
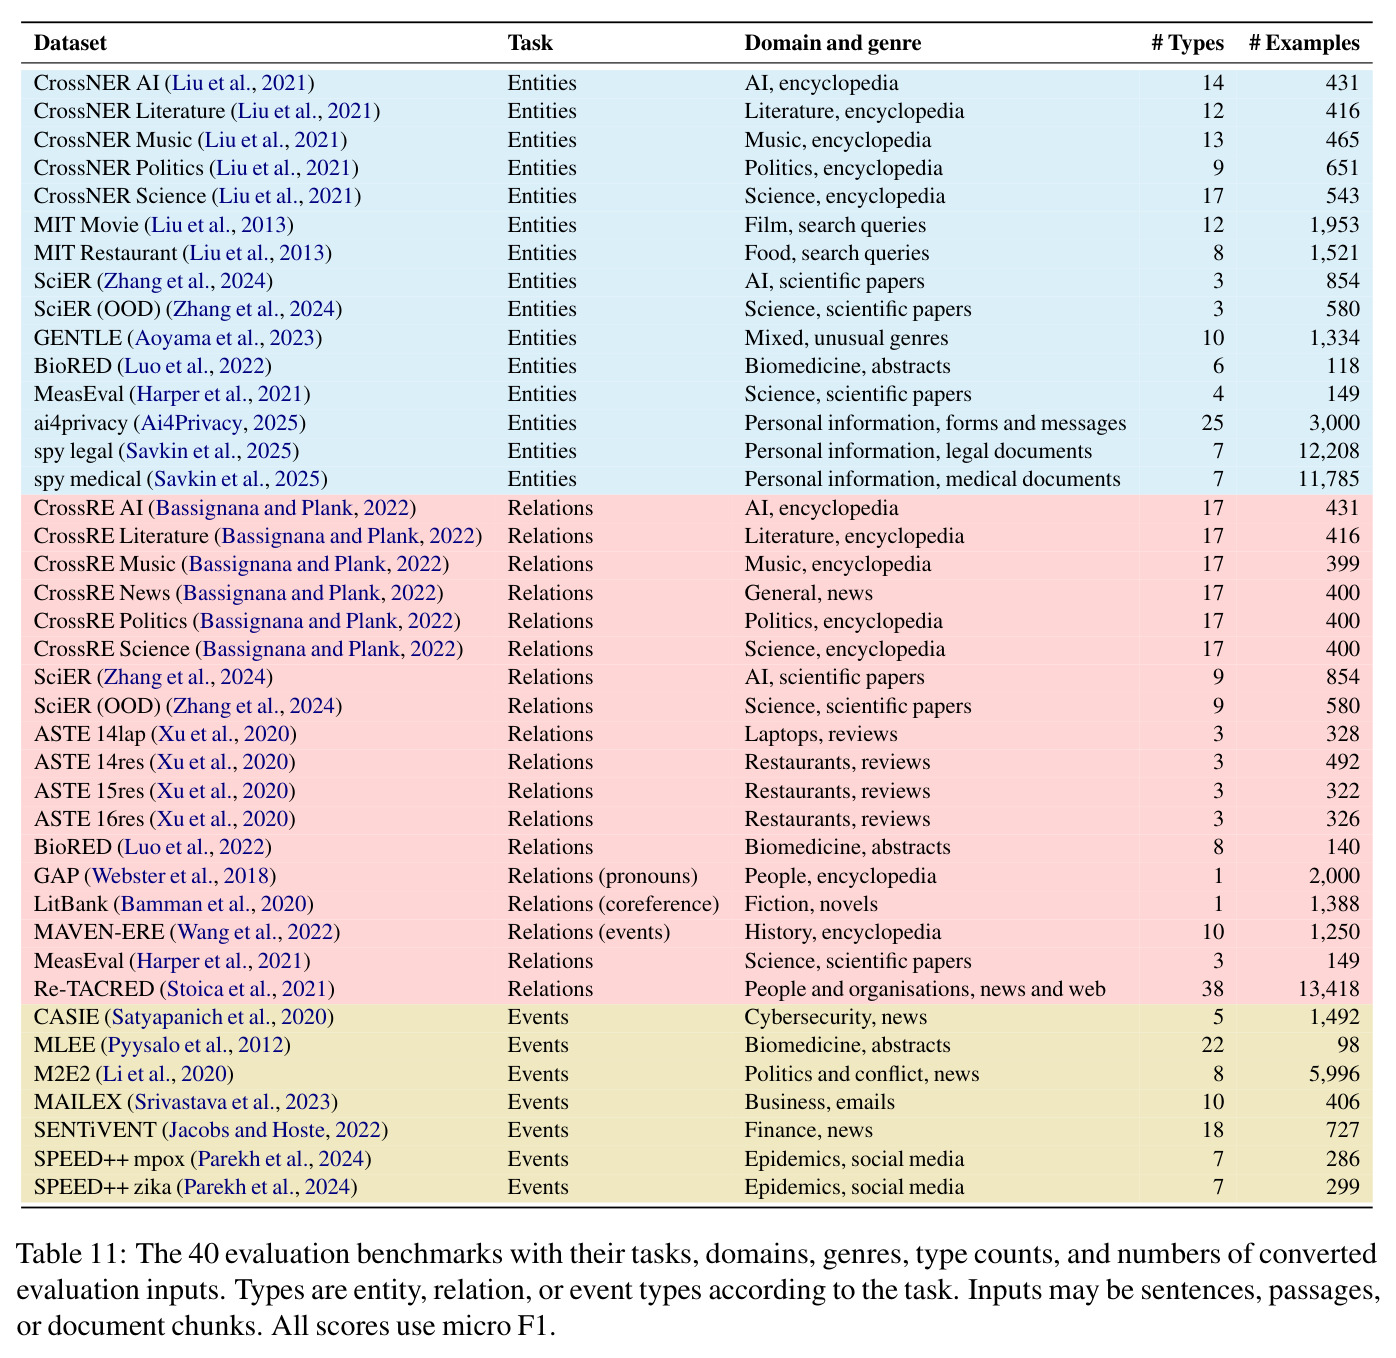
在 40 个基准(15 NER、18 RE、7 EE;micro F1 等权平均)上,不用任何目标数据标注:(1) NER——CrossNER 平均 67.8(GLiFormer 67.6),其他领域组 56.6 vs 最强基线 41.5(GENTLE 42.0 vs 27.2、BioRED 72.1 vs 60.4、SciER OOD 67.2 vs 49.5),个人信息组 58.5 vs 54.2;MIT 组 62.3 低于 InstructUIE 的 66.9,但其训练含这两个数据集。(2) RE——领跑全部 18 个基准:gold 实体下 CrossRE 平均 45.4(基线最高 11.6),端到端 36.0 vs 10.6;ASTE 平均 83.0 vs 17.1;GAP 76.3;与 GLiREL 对比:正样本对类型准确率 79% vs 40%,全 gold 对候选 F1 49.8 vs 2.6。(3) EE——gold 触发词参数 F1 平均 35.1(InstructUIE 33.2,其训练含 CASIE),端到端触发词 28.9 vs 24.1;剔除 CASIE 后三项 EE 指标全部第一(34.7 vs 28.4;端到端参数 10.9 vs 8.4)。(4) 消融——独立 sigmoid 使 NER 61.5→53.4,对类型阈值化→59.7,去决策奖励 RE 49.8→47.7,unknown 当负例三项全降。(5) 描述与频率——描述对 RE 关键(CrossRE 45.4→无描述 29.1),NER 仅 1–3 点;评测类型名虽全在训练数据中,F1 与训练频率的 Spearman 相关仅 0.04,最稀有组领先最多(58.8 vs 50.6)。(6) 校准——修正后 ECE 关系 0.25→0.10、实体 0.33→0.23、事件参数 0.51→0.39,F1 几乎不变。(7) 效率——GH200 上 120 句/秒(基线 5–25 倍),权重 1.2 GB。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 零样本 NER(15 个基准平均,含类型描述) | micro F1 (%) | 61.5 | 55.1(最强基线 GLiFormer 同口径平均) | +6.4 |
| 零样本 NER(其他领域组:SciER/SciER OOD/GENTLE/BioRED/MeasEval) | micro F1 (%) | 56.6 | 41.5(GLiFormer) | +15.1(GENTLE 42.0 vs 27.2) |
| 关系抽取,CrossRE 六域平均(gold 实体) | micro F1 (%) | 45.4 | 11.6(GLiNER2)/ 11.0(GLiFormer) | +33.8 |
| 关系抽取端到端,CrossRE 平均 | micro F1 (%) | 36.0 | 10.6(GLiFormer) | +25.4 |
| ASTE 情感三元组(4 数据集平均,gold 实体) | micro F1 (%) | 83.0 | 17.1(InstructUIE) | +65.9 |
| 事件参数分类(gold 触发词,7 基准平均) | micro F1 (%) | 35.1 | 33.2(InstructUIE,其训练含 CASIE) | +1.9(剔除 CASIE 后 34.7 vs 28.4) |
| 事件触发词分类(端到端,7 基准平均) | micro F1 (%) | 28.9 | 24.1(InstructUIE) | +4.8 |
| 关系置信度校准(18 基准平均,gold 实体) | ECE | 0.10(先验修正+阈值重拟合) | 0.25(修正前) | −0.15,F1 几乎不变 |
| 推理吞吐(GH200,MIT Movie 全 12 类型,PyTorch bf16) | sentences/s | 120 | 22(GLiNER2)/ 4.9(GNER) | 5–25 倍 |
局限与改进
作者承认:仅英语;候选 span 上限 32 token、关系仅限同一输入内,更长 mention 与跨输入关系超出范围;大量训练数据由 LLM 标注,投票与仲裁无法完全消除共享偏差;校准参数在训练源验证集上拟合,换域后概率可能仍不完美;单种子报告。我的观察:(1) 绝对水平仍低——端到端事件参数 F1 仅 10.9,MAVEN-ERE 2.0、LitBank 16.8、MeasEval 30.6,复杂事件结构与文档级共指远未解决;(2) 基线适配可能不利——GNER/InstructUIE/GLiREL 只收类型名,部分基线端到端关系分数依赖与 gold 实体的匹配启发式,比较并非纯粹关系能力;(3) 决策奖励增益有限且不均衡(RE +2.1,NER 几乎无变化),又无显著性检验;(4) 训练管道复杂(84 源、多 LLM 投票),复现门槛高,LLM 数据的许可与偏差链条长;(5) 修正后个别数据集(CrossRE News)ECE 反而上升,温度重拟合并非处处有效。
独立分析的弱点
弱点一:决策奖励收益小且不均衡——去掉它 RE 从 49.8 降到 47.7,NER 几乎无变化(61.5→61.1),无描述的 EE 也不明显,说明其作用可能主要在关系对的拒绝上;改进方向:按候选难度自适应采样数 S,或引入针对重叠候选的对比奖励。弱点二:±1 奖励对"接近正确"没有梯度意义——边界差一个字符、粗细类型层级同样算错;改进方向:分级奖励(边界 IoU、类型层级距离)。弱点三:校准仍依赖训练源分布——修正后 MeasEval 实体 ECE 仍 0.45、spy medical 0.53、事件参数平均 0.39;改进方向:测试时自适应校准、共形预测或按域估阈。弱点四:结构性限制——span 上限 32 token、关系限同输入,对 MAILEX(端到端参数 F1 仅 2.2)这类长文本不友好;改进方向:滑动窗口+跨块链接或长上下文骨干。弱点五:泛化到新类型名未被真正检验——附录 F 承认 15 个 NER 基准的全部类型名都逐字出现在训练数据中,Table 5 的"频率无关"分析只覆盖见过的名字;改进方向:构造类型名确实未见的评测集。弱点六:单种子、无置信区间,大量 2 分以内的组级差异(如 CrossNER 67.8 vs 67.6)难以断言优劣。
未来方向
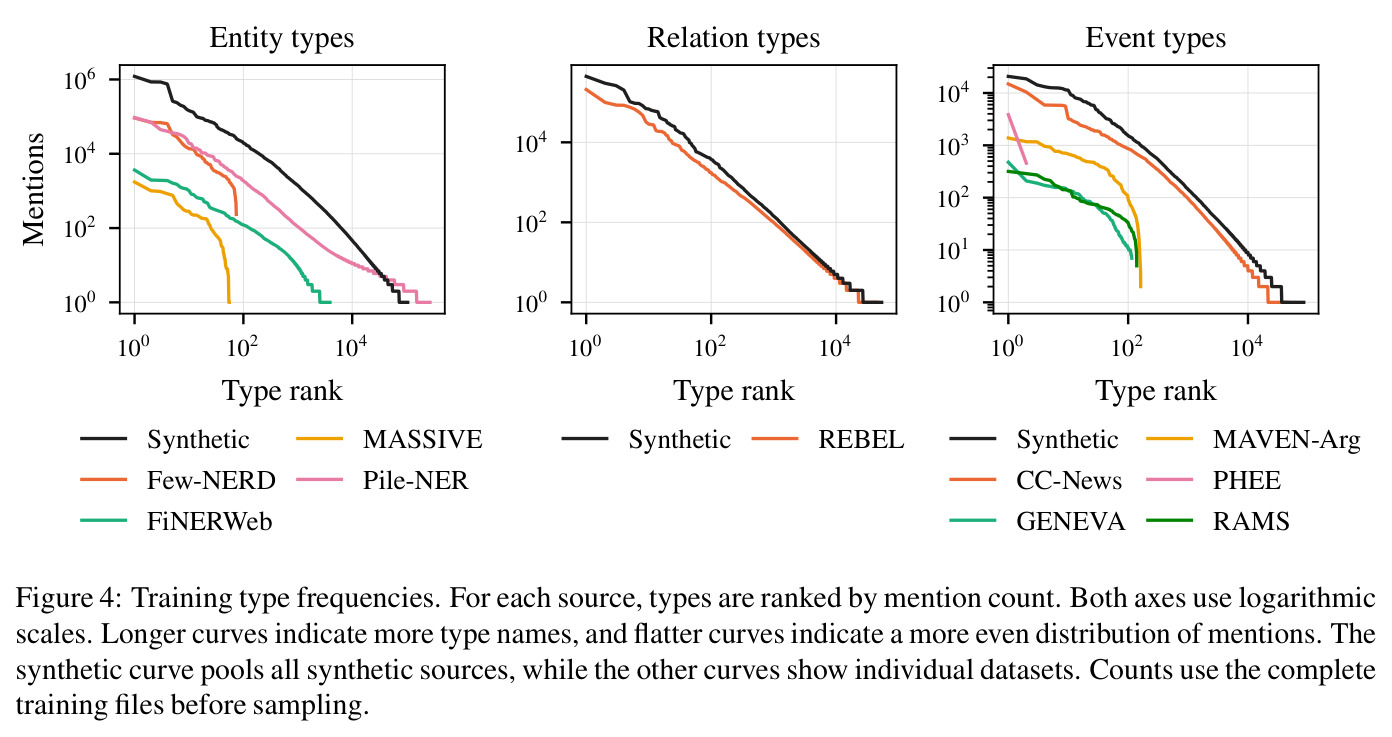
作者提出的方向:扩展到英语之外的语言;突破 32 token span 与同输入关系的限制;进一步消除 LLM 标注的共享偏差;研究跨域情形下的校准方法。基于其成果可延伸的方向:(1) 把决策奖励与描述 dropout、UniMax 采样做课程化联合调度,并探索奖励与指标的更多对齐形式(如对方向错误的轻惩罚);(2) 利用校准后的概率做选择性预测与人机协同——低置信度转人工,验证 ECE 改善在真实流水线中的业务价值;(3) 将同一 span-pair 公式扩展到嵌套实体、n 元关系、文档级共指,研究此时 leave-one-out 奖励是否仍有效;(4) schema 约束显式化:类型间目前只通过交互层软性通信,可把方向互斥、类型层级等约束编码进打分或解码;(5) 数据效率研究:Figure 3 显示 500K 实例后收益递减,可探索主动采样与合成数据质量控制,缩小 84 源管道的成本;(6) 对 LLM 标注源做来源加权或去偏训练,量化标注器偏差对跨域迁移的贡献;(7) 多语言化后检验 $\log(1/\omega)$ 修正在不同语言/标注密度下的稳健性。
复现评估
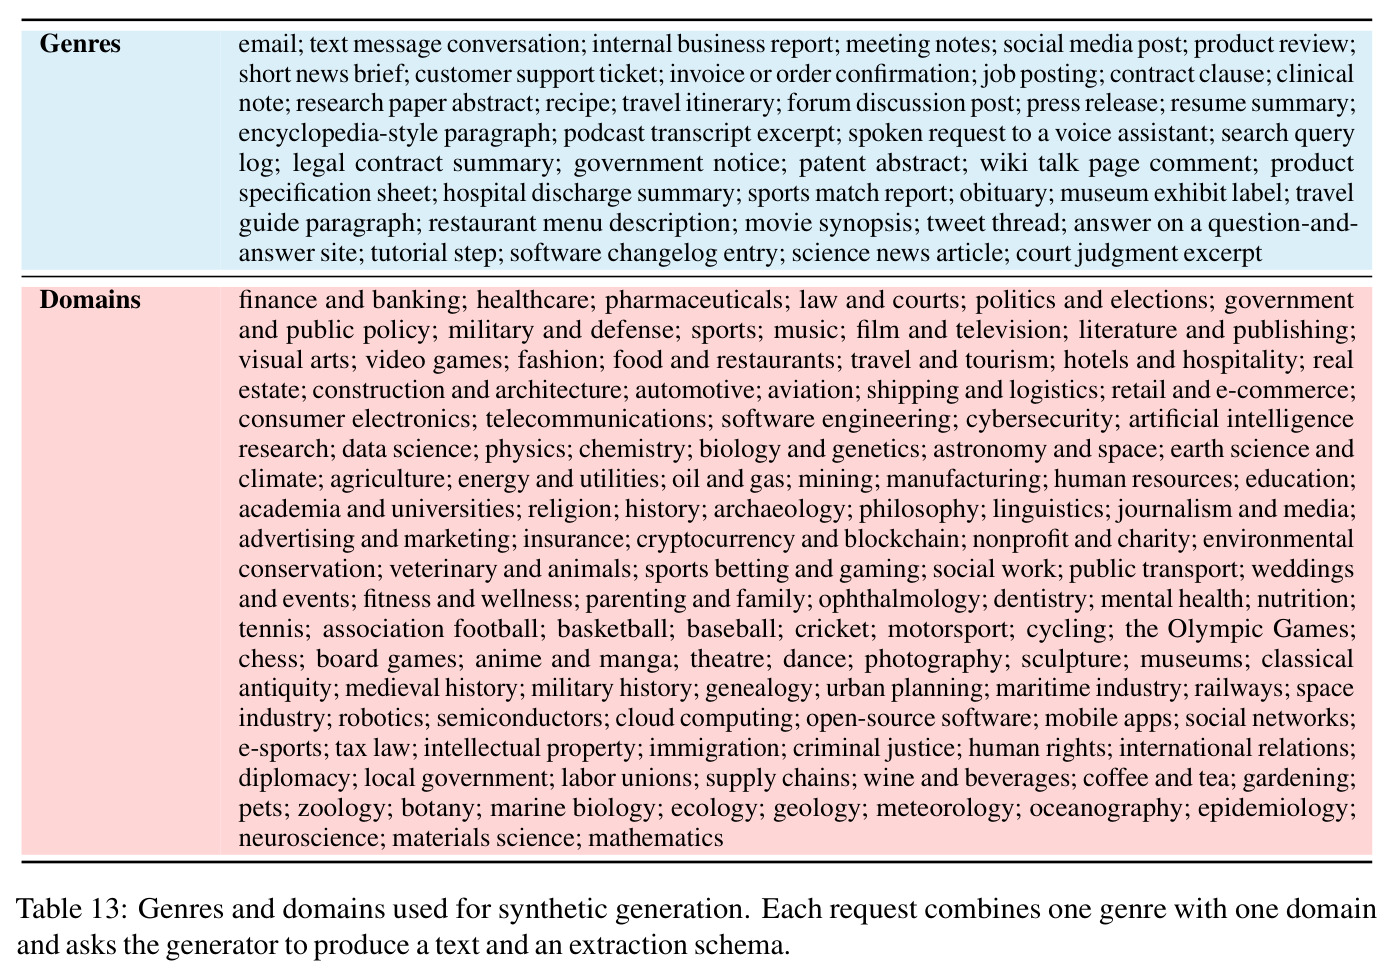
协议透明度很高:附录 B.4 给出全部超参(AdamW、编码器 lr $4\times10^{-5}$、头 $2\times10^{-4}$、10% warmup 线性衰减、40,000 步、全局 batch 128、32 GPU、bf16、$A=256$、$r=64$、$L=2$ 层 4 头、$\omega=0.1$、$S=8$、$\sigma=1$、$\rho=0.5$、$\lambda=1$、描述 dropout 0.3);13 张附录表列全 40 个评测基准(Table 11)、训练来源(Table 12)、合成数据的体裁×领域清单(Table 13)与完整生成提示模板(Figure 5),数据校验所用模型(Qwen3.8-27B 生成、Nemotron 校验、gpt-oss-120b 仲裁)及所有对比模型的 HF 链接与许可证(Table 10)一应俱全。骨干 Qwen3-0.6B 与全部基线均为公开权重,复现评测(加载 released 权重跑 40 基准)相对容易;但正文未给出 CALON 自身权重或 3.1M 训练数据的发布链接,合成数据生成+多模型投票+去重管道需要可观的 LLM 推理算力,训练本身需要 32 卡。总体:评测可复现性高,端到端训练复现属中高难度,若权重与数据不开源则只能部分复现。
论文图表
实体/关系/事件三套合成数据生成提示的完整模板:要求生成器先写一段指定体裁×领域的真实文本,再设计 6–12 个实体类型(含至少两组易混类型对)并逐 mention 标注,最后列出 3–5 个"相关但不出现"的 absent 类型,返回严格 JSON;关系版要求 5–10 个有向关系类型(含互逆对),事件版要求 3–6 个事件类型及 2–6 个角色并标触发词。absent 类型经校验后提供显式负例。
训练数据是本文一半的竞争力所在,这张图完全公开了合成数据的构造方式(含显式负例设计),是复现其数据管道和评估"absent 类型监督"价值的唯一依据。
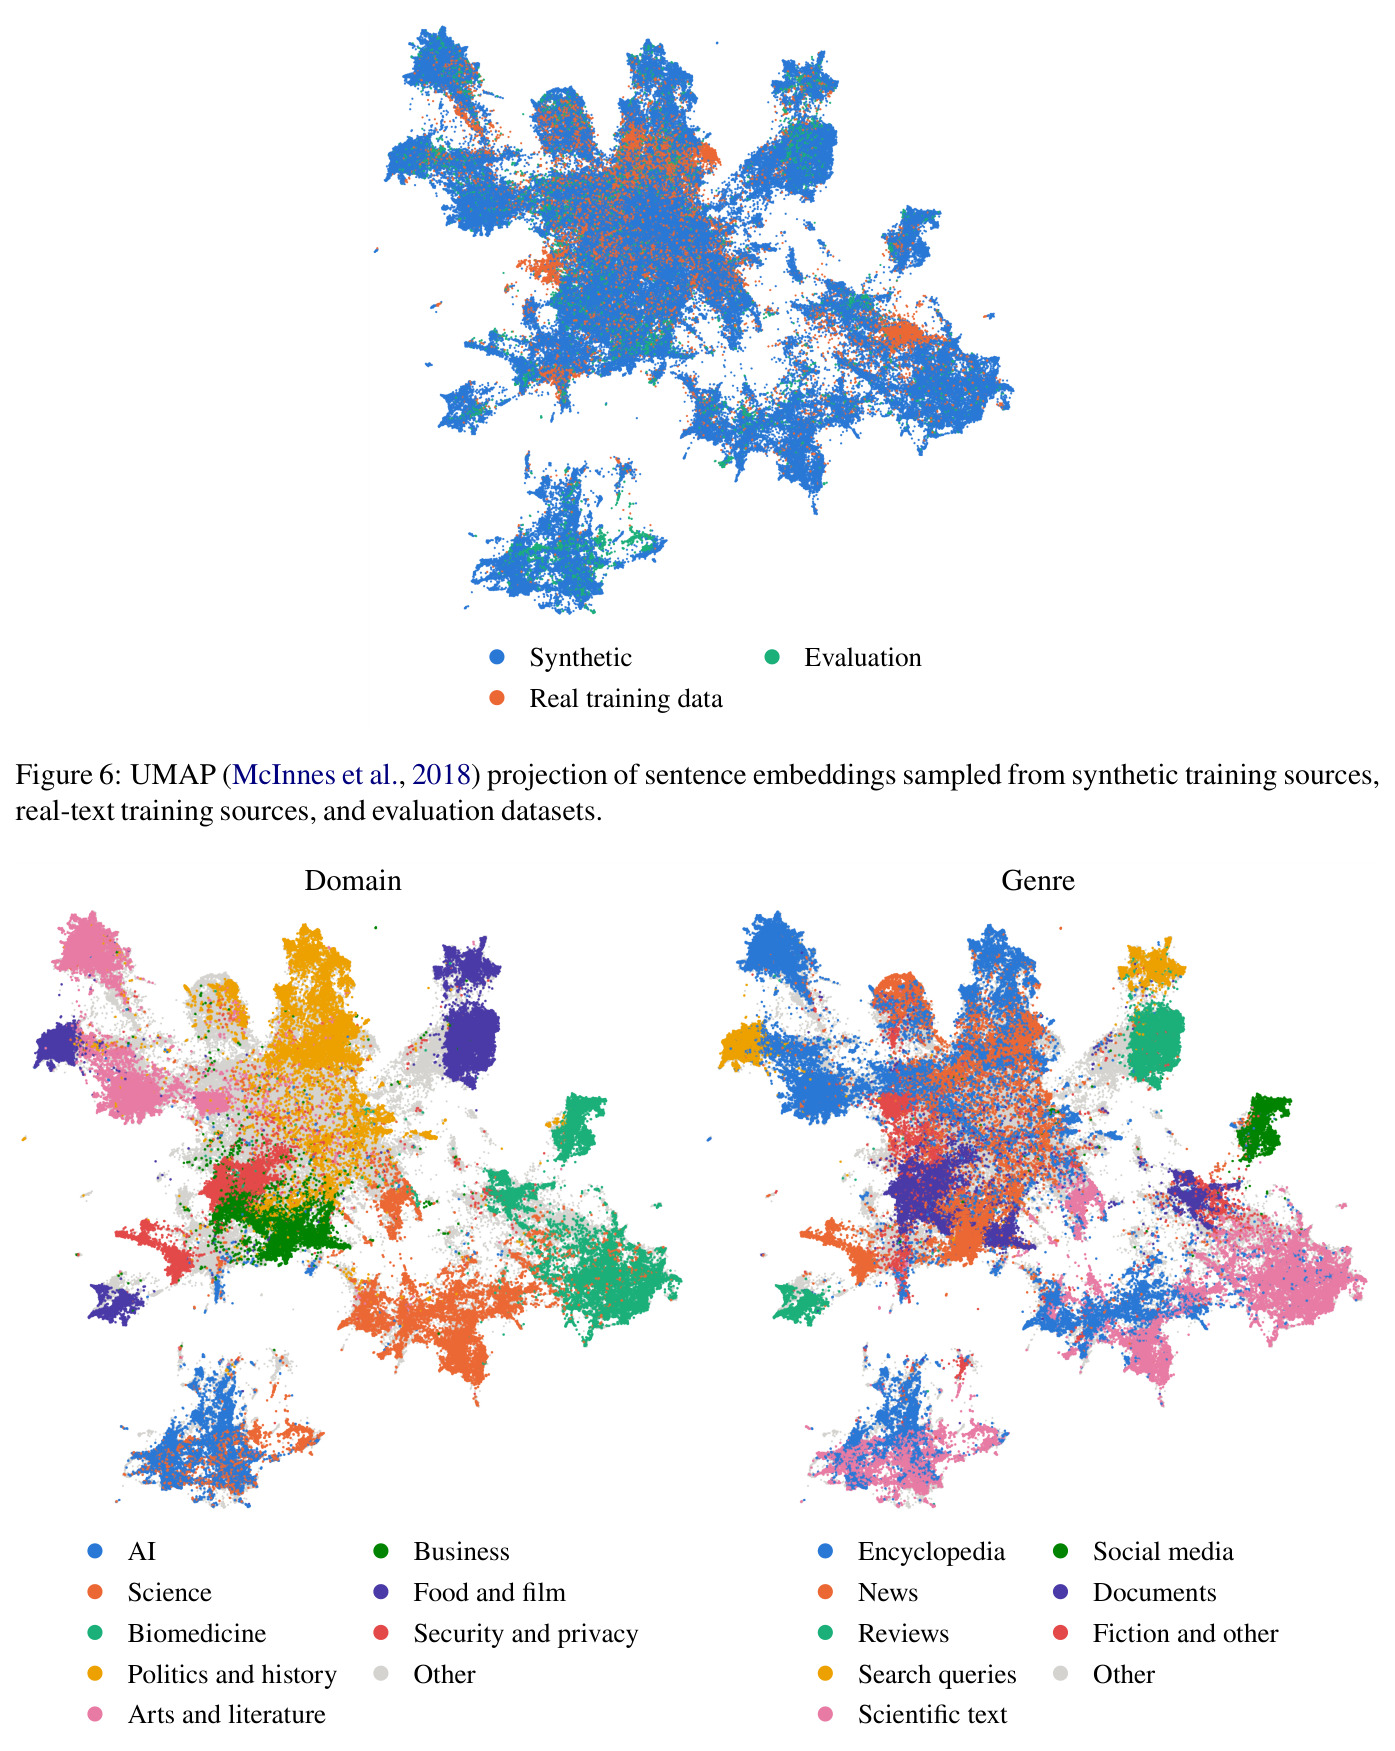
同一 UMAP 投影按领域(AI、生物医学、法律、金融等)和体裁(百科、社交媒体、新闻、评论、搜索查询等)着色,未列出的类别显示为灰色,可以观察哪些领域/体裁簇与评测区域相邻或重合。
它是 Figure 6 的定性补充,用于检查合成数据在各领域/体裁上的覆盖是否均衡,对诊断未来换域时的弱点(如低资源体裁)有参考意义。