为视觉语言模型空间推理蒸馏路由式3D特权信息 Distilling Routed 3D Privilege for Spatial Reasoning in Vision-Language Models
用深度/语义/BEV文本线索作训练特权,仅蒸馏错误轨迹,部署模型保持纯RGB推理
前置知识
特权信息(Privileged Information)
源自 Vapnik 的学习使用教师隐信息(LUPI)思想:某些信息在训练时可以获取、但部署时无法获取。例如本文中 3D 扫描数据自带的深度、语义分割和鸟瞰布局标注,训练阶段可拿来指导模型,推理阶段只有 RGB 图像。GPD 把这类信息作为特权交给教师侧,让它只进入训练信号而不进入推理接口。
GPD 整个框架建立在“3D 几何只作训练特权、部署模型保持纯 RGB”之上,理解这个概念才能分清它与显式 3D 方法(改架构、加推理开销)的本质区别。
在策略自蒸馏(OPSD, On-Policy Self-Distillation)
同一个模型扮演两个角色:学生只看任务输入(图像+问题)采样推理轨迹;教师额外看到特权上下文(本文是 3D 线索+参考答案),对学生采样出的每个 token 重新打分,用师生对数概率差构造蒸馏损失。因为蒸馏发生在学生自己采样的轨迹上而非教师生成的文本上,所以叫“在策略”。
GPD 是把 OPSD 的特权内容从参考答案换成问题路由后的 3D 几何证据,所有训练机制都建立在 OPSD 之上,不懂它就看不懂损失函数的设计。
GRPO(组相对策略优化)
DeepSeekMath 提出的强化学习算法:每个问题采样一组 $G$ 条回答,用组内奖励归一化得到优势 $A_i$(无需价值网络),用带 clip 的策略梯度更新,并附加对冻结参考策略的 KL 正则控制偏移。是当前 VLM 推理训练最主流的 outcome-reward RL 基线。
GPD 的最终目标 $\mathcal{L} = \mathcal{L}_{GRPO} + \lambda\tilde{\mathcal{L}}_{OPSD}$ 是在 GRPO 上加权叠加特权蒸馏项,论文的对照实验也是同数据同骨干的 GRPO,读表格必须知道这条基线。
BEV(鸟瞰图,Bird's-Eye-View)
把场景投影到水平俯视平面的空间表示,直接编码物体的平面位置、朝向和相对布局,规避了透视图中的遮挡与尺度歧义,是自动驾驶感知的标准表示。本文不用图像形式的 BEV,而是用固定模板把它转成文本,如 “chair(left-front, 1.4m), table(front, 2.1m)”。
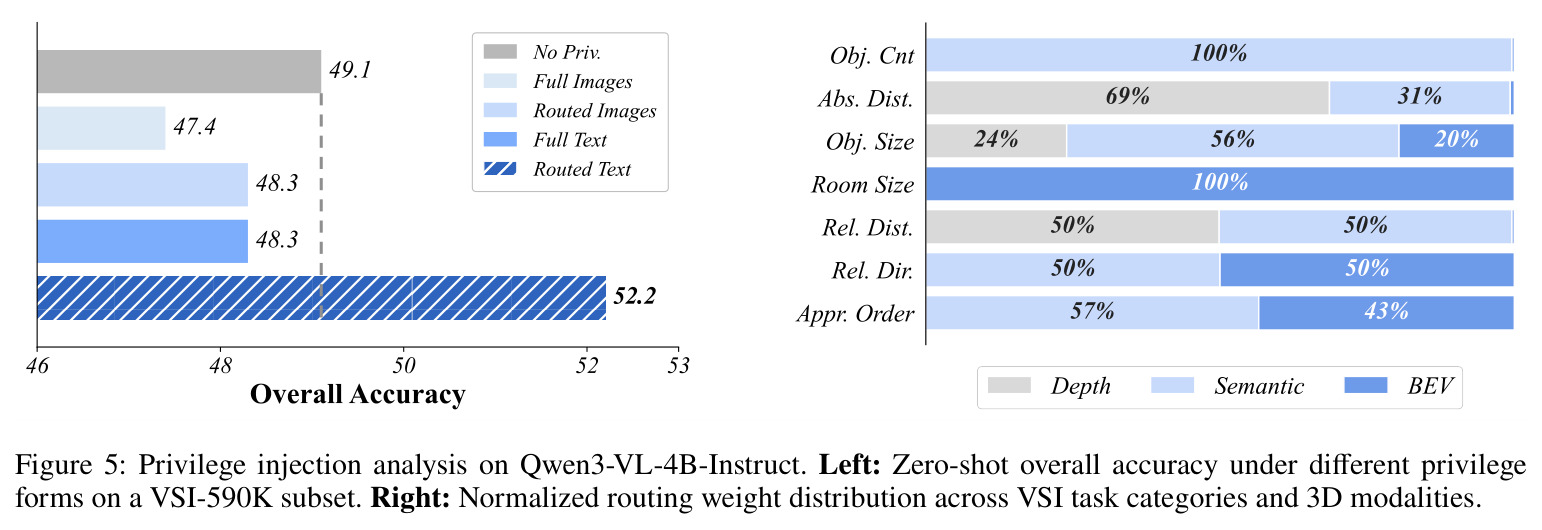
BEV 是 GPD 三种 3D 线索之一,路由分布分析显示“房间尺寸”类问题几乎完全依赖 BEV 证据,是理解特权路由设计的必要背景。
反向 KL 散度(Reverse KL)
$D_{KL}[\pi_\theta \| \pi_{ref}]$,衡量当前策略对参考分布的逼近,逐 token 精确计算需要对整个词表求和、代价极高。GPD 采用学生采样 token 上的单样本估计:设师生对数概率差 $\Delta_{i,j}$,取 $d_{i,j} = \exp(\Delta_{i,j}) - \Delta_{i,j} - 1$。
特权蒸馏损失就是这个 KL 的 token 级单样本估计,是教师“逐 token 打分”的数学载体,公式看不懂就无法理解方法核心。
研究动机
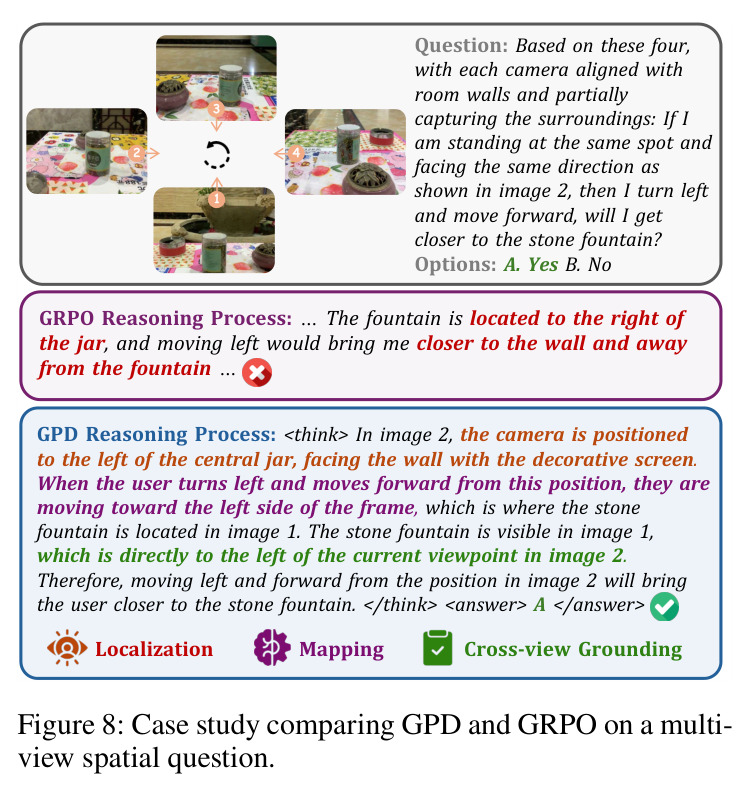
空间推理——判断距离、方向、物体布局——是视觉语言模型的长期短板,根源在于 RGB 输入本身不携带几何证据,模型只能凭外观猜测深度与布局。基准数据很直观:VSI-Bench 上 GPT-4o 平均仅 34.0 分、Qwen2.5-VL-7B 仅 35.8 分,LLaVA-OneVision-72B 也只有 40.3。现有补救分两条路线:显式 3D 方法(Spatial-MLLM、Think3D 等)在推理时注入几何编码器或调用深度估计工具,代价是改动架构并增加推理延迟;训练式方法(SpaceR-7B、SpatialLadder-3B)只用最终答案的 outcome 奖励做 SFT 或 RL,推理保持纯 RGB,但监督只落在答案上——一旦推理链中途出现“深度排序判反”“左右关系颠倒”这类几何错误,答案奖励既无法定位也无法纠正,错误会带着貌似连贯的推理一路走到底。两条路线分别卡在“有几何证据但推理贵”和“推理便宜但缺几何监督”的两端。
本文的目标是本文的目标可以概括为:让模型“训练时开卷、考试时闭卷”。具体而言,作者希望在不改变部署模型架构、不增加任何推理开销(推理时仍只看 RGB 图像和问题)的前提下,把 3D 扫描数据中现成可得的深度、语义分割、鸟瞰图(BEV)信息转化为训练时的特权监督,使模型沿着自己的推理轨迹获得 token 级别的几何纠正,而不是只在答案层面得到对错反馈。同时该机制要与主流 GRPO 强化学习兼容,并定下量化目标:在 VSI-Bench、MindCube、SPAR、MMSI、ViewSpatial 五个空间推理基准上,稳定超越同数据同骨干的 GRPO,以及只把参考答案当特权的 OPSD 变体。
与已有工作不同的是,作者的独特切入点是把 OPSD 中的“特权信息”从参考答案升级为“问题相关的 3D 几何证据”。关键洞察是:感知层面的错误只有真实几何才能纠正——数数需要语义可见性线索、测距需要深度次序、房间尺寸需要 BEV,不同问题依赖的证据形态完全不同,因此特权必须按问题路由而不是全量注入。GPD 的做法是:离线把三种 3D 线索渲染成紧凑文本,由基础 VLM 挑选与当前问题相关的子集交给教师;再只对答错的轨迹施加特权 KL 蒸馏,避免教师信号扰动本已正确的推理。这个“几何特权 + 问题路由 + 错误门控”的三件套,恰好填补了显式 3D 方法(架构代价)与 outcome-only RL(监督盲区)之间的空档。
核心方法
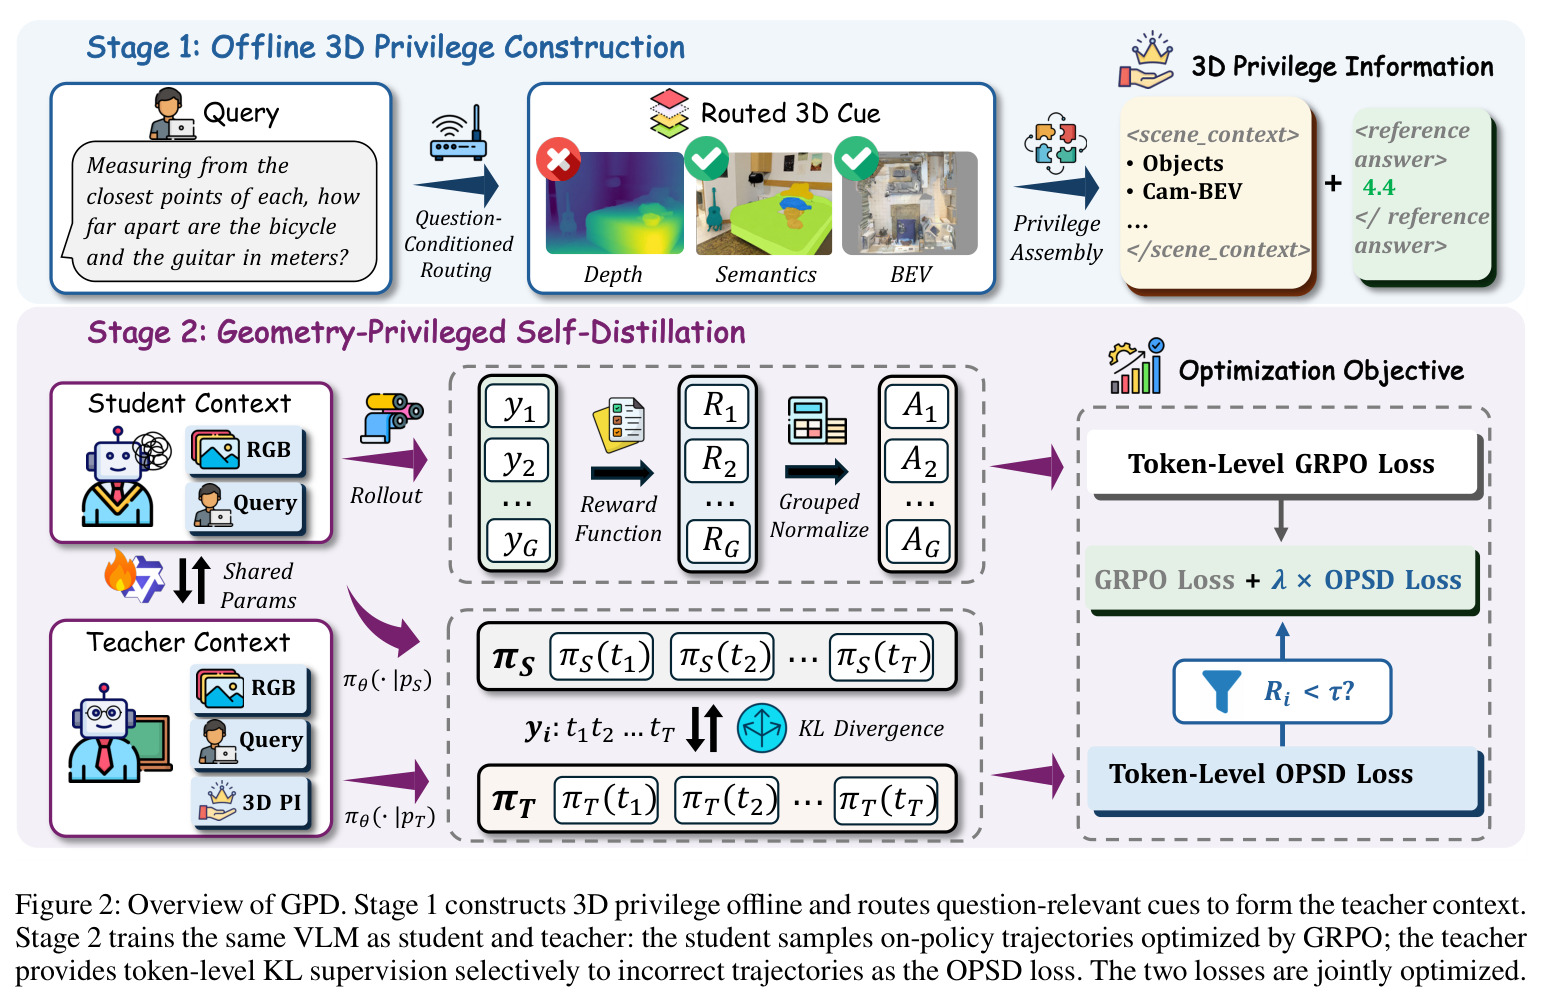
直觉上 GPD 是“训练时开卷、考试时闭卷”。方法分两阶段。第一阶段离线构建 3D 特权:有对齐 3D 标注(VSI、SPAR 来自 ScanNet)就直接导出深度、语义、BEV 线索,否则用 Depth Anything 3 估深度、Grounded-SAM-2 取语义实例;固定模板把线索转成紧凑文本(深度记录距离与由近到远次序、语义列物体区域、BEV 描述俯视关系),再由基础 VLM 做问题条件化路由,选出相关子集拼成 $c_{scene}(q) = \mathrm{concat}(s_m : m \in r(q))$,并与参考答案拼成特权 $c_{priv}(q, a^\star)$。第二阶段:同一 VLM 以学生身份只看 $p_S = \mathrm{concat}(v, q)$ 采样轨迹,用 GRPO 组归一化优势优化;以教师身份额外看特权上下文 $p_T$ 逐 token 打分学生轨迹,构成特权 KL 蒸馏损失;两者按 $\mathcal{L} = \mathcal{L}_{GRPO} + \lambda\tilde{\mathcal{L}}_{OPSD}$($\lambda = 0.003$)联合优化,部署模型保持纯 RGB 推理。
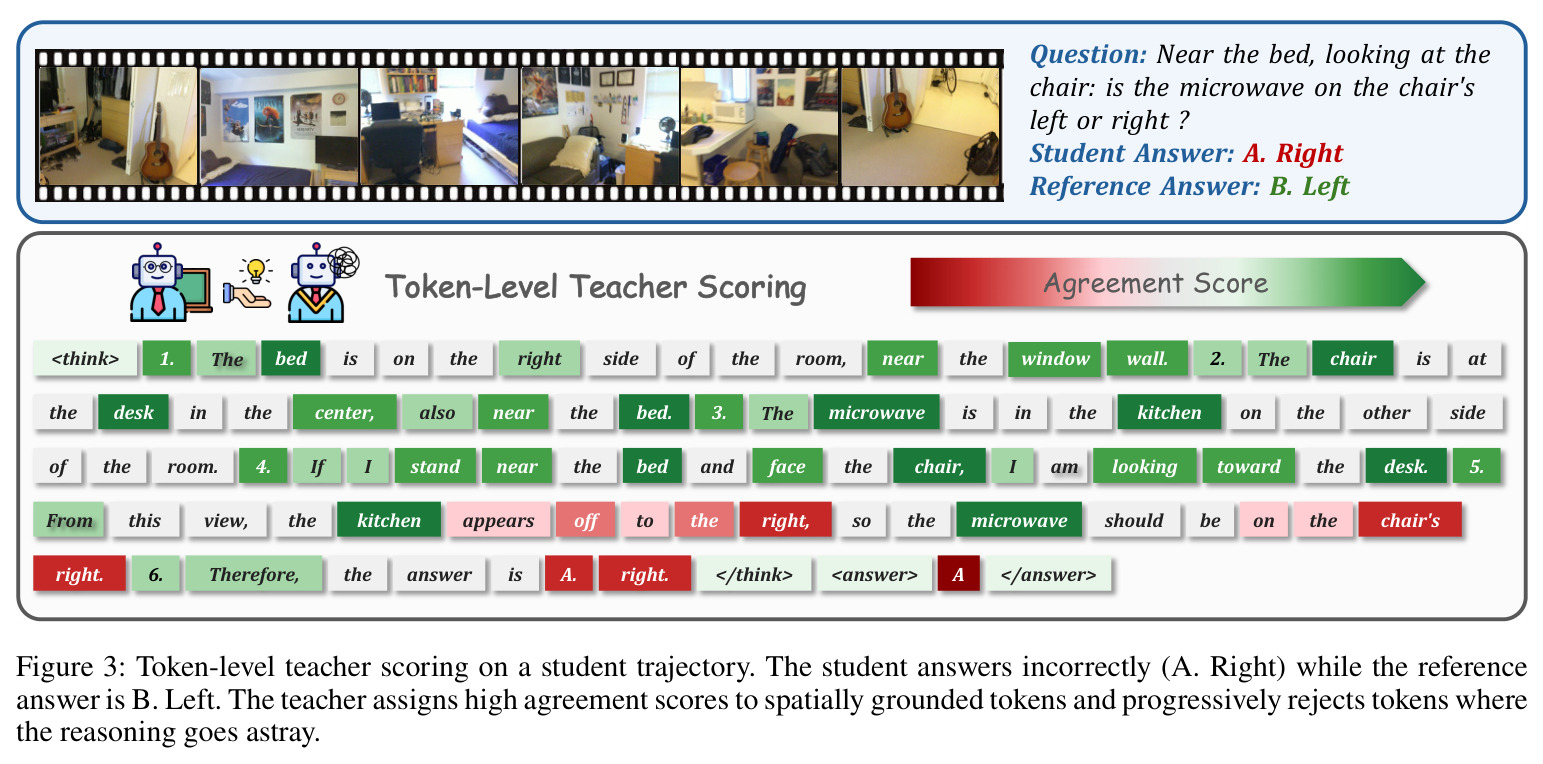
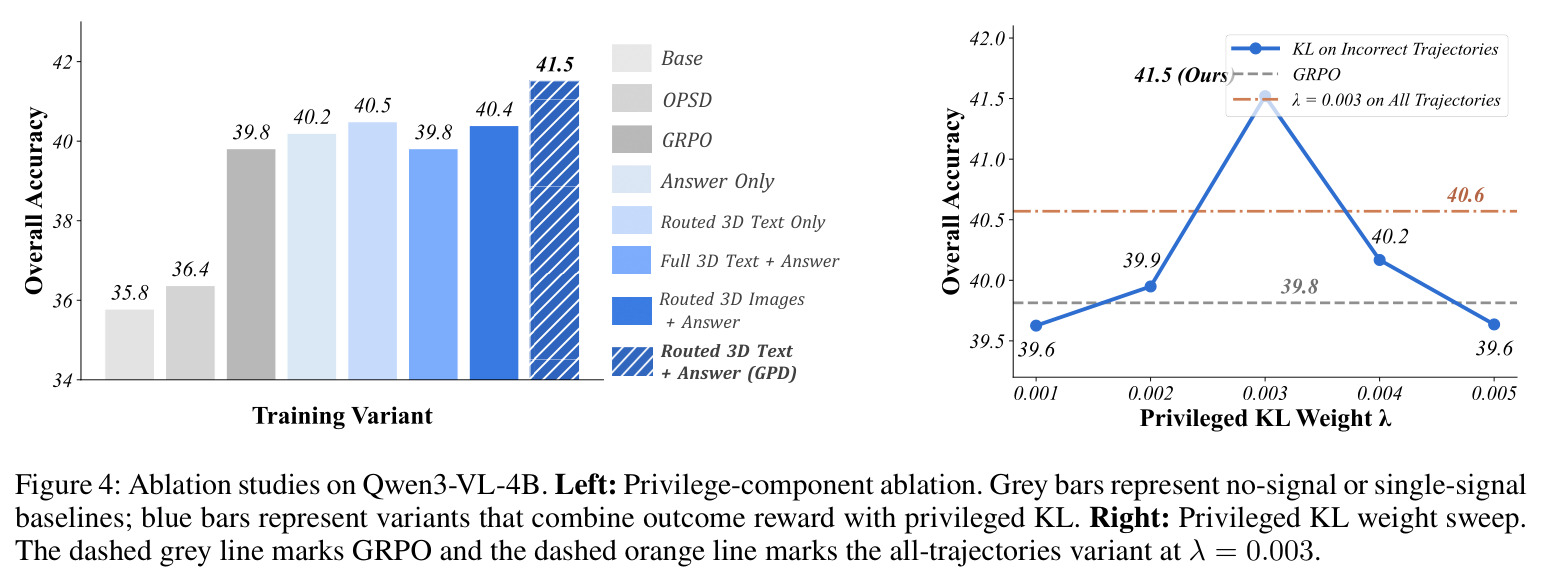
核心创新有三点。其一,把特权的性质从“答案”换成“几何证据”:参考答案无法告诉模型哪里想错了,而路由后的深度次序、物体区域、BEV 布局能精确指出“由近到远应是椅子(1.39m)→桌子(2.08m)→沙发(2.64m)→门(3.05m)”这类事实,教师据此沿学生轨迹逐 token 施加监督,token 级师生概率差为 $\Delta_{i,j} = \log\pi_\theta(t_j|t_{<j}, p_T) - \log\pi_\theta(t_j|t_{<j}, p_S)$。其二,问题条件化路由:不同空间问题依赖不同证据,消融显示把全部 3D 文本无差别注入反而比路由后低 1.7 分(41.5→39.8),路由避免了无关上下文稀释教师信号。其三,错误门控:特权 KL 只施加于奖励 $R_i < \tau = 0.5$ 的错误轨迹并把聚合损失截断在 1.5,防止教师噪声干扰正确推理——若对所有轨迹蒸馏,平均分会从 41.5 降到 40.6。与显式 3D 方法的本质区别是几何只进训练信号、推理接口零改动。
方法步骤详情
第一步(离线特权构建):输入三元组 $(v, q, a^\star)$。有 3D 标注直接导出线索,否则用 Depth Anything 3 估深度、Grounded-SAM-2 生成语义实例,位姿可靠才加 BEV;线索一次算好冻结,模板化为文本 $s_m$。第二步(问题路由):基础 VLM 选相关模态子集 $r(q) \subseteq M$,拼接得 $c_{scene}(q)$,再拼参考答案成教师特权 $c_{priv}(q, a^\star)$。第三步(学生采样+GRPO):学生只看 $p_S = \mathrm{concat}(v, q)$,每组采 $G = 8$ 条轨迹,按奖励 $R_i$ 组归一化得优势 $A_i$,优化带 clip 与参考 KL 的 $\mathcal{L}_{GRPO}$。第四步(教师打分):教师条件 $p_T = \mathrm{concat}(v, q, c_{priv})$,逐 token 算概率差 $\Delta_{i,j}$,取单样本反向 KL 估计 $d_{i,j} = \exp(\Delta_{i,j}) - \Delta_{i,j} - 1$,沿学生自己的轨迹聚合。第五步(错误门控联合优化):仅在错误集合 $E = \{i : R_i < 0.5\}$ 的有效 token 上求和并截断至 1.5 得 $\tilde{\mathcal{L}}_{OPSD}$,最终 $\mathcal{L} = \mathcal{L}_{GRPO} + \lambda\tilde{\mathcal{L}}_{OPSD}$。训练用 Qwen3-VL-Instruct 2B/4B,1 个 epoch,学习率 $10^{-6}$,数据为 10K VSI + 4K SPAR + 1K MindCube。
技术新颖性
从新颖性看,GPD 是首个把 3D 几何信号作为 OPSD 教师侧特权的空间推理框架。与显式 3D 方法(SpatialVLM、SpatialRGPT、Video-3D LLM、TIGeR 等)的本质区别在于:几何证据只存在于训练损失里,不需要 3D 编码器架构改动,也不需要测试时调用感知工具,推理延迟为零。与 outcome-supervised RL(SpaceR、SpatialLadder)的区别在监督粒度:它们只在最终答案给 0/1 反馈,GPD 沿学生自己的错误轨迹提供 token 级过程监督,能在“深度判反、左右颠倒”这类中途错误发生的位置直接施加纠正梯度。工程上还有两个新设计:一是把“多模态信息注入”表述为路由问题,零样本实验证明路由文本(52.2)是唯一超过 RGB 基线(49.1)的特权形式,胜过全量文本(48.3)和图像形式(47.4/48.3);二是错误门控配合损失截断,把蒸馏定位成“纠错器”而非“约束器”,$\lambda$ 扫描显示过小无纠错力、过大约束过强,最优 0.003 时比 GRPO 高 1.9 分。
实验结果
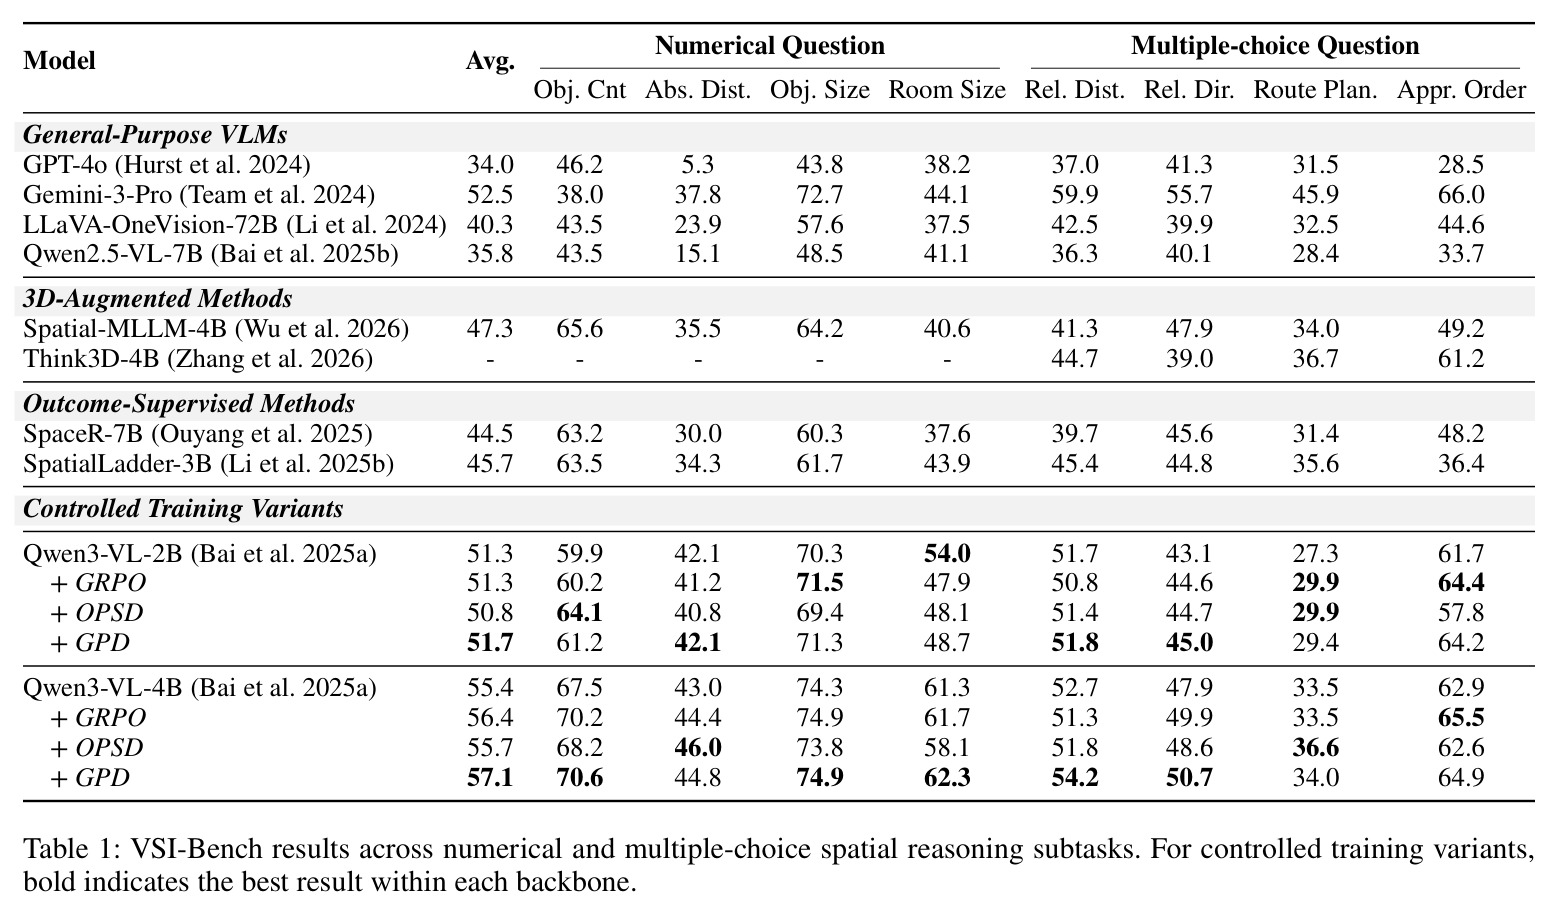
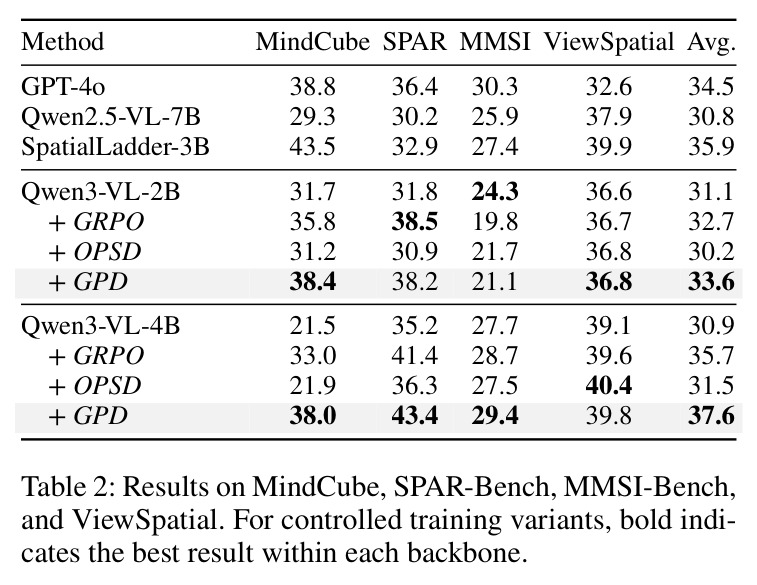
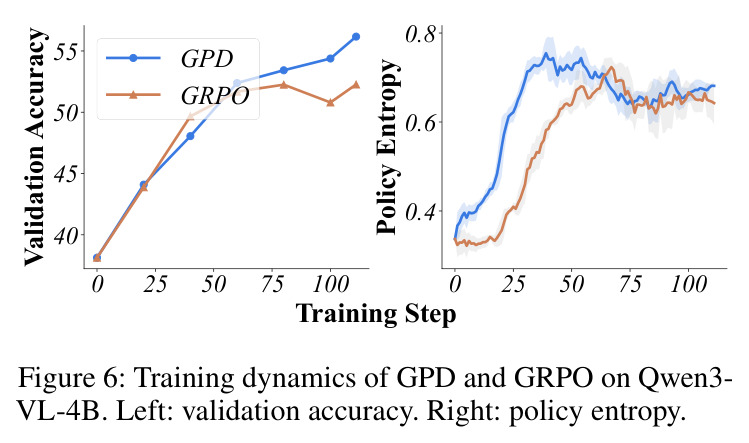
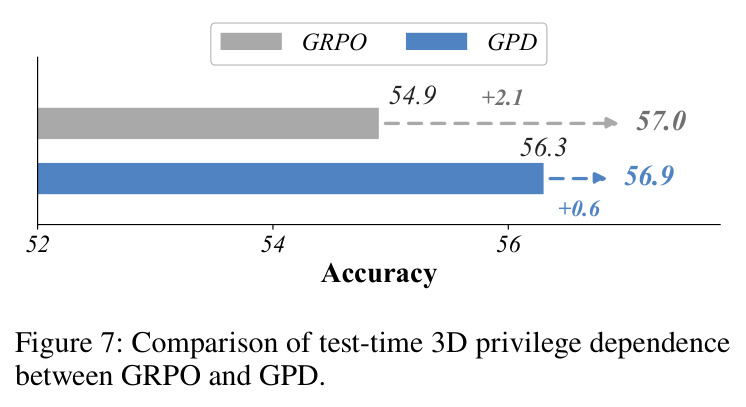
主实验在 Qwen3-VL-Instruct 2B/4B 上与同数据同骨干的 GRPO/OPSD 严格对照。VSI-Bench(Table 1):4B 的 GPD 达 57.1,比基座 55.4 高 1.7、比 GRPO 56.4 高 0.7、比 OPSD 55.7 高 1.4,也超过 Spatial-MLLM-4B(47.3)与 SpaceR-7B(44.5);2B 的 GPD 51.7 同为受控最佳。四大基准(Table 2):4B 平均 37.6,比 GRPO 35.7 高 1.9、比 OPSD 31.5 高 6.1,其中 MindCube 提升最大(38.0 vs 33.0,+5.0),SPAR 43.4(+2.0),MMSI 29.4(+0.7),ViewSpatial 39.8;2B 平均 33.6(+0.9),MindCube 38.4(+2.6)。消融(Figure 4):仅答案特权 40.2、仅路由 3D 文本 40.5、合用 41.5,两者互补;全量文本注入反降为 39.8;特权 KL 施加于全部轨迹降至 40.6,$\lambda$ 扫描中仅错误轨迹、0.003 最优。零样本注入(Figure 5):路由文本 52.2 是唯一超 RGB 基线 49.1 的特权形式(+3.1)。内化分析(Figure 7):GPD 纯 RGB 推理 56.3 已高于 GRPO 54.9,测试时注入特权增益更小(+0.6 vs +2.1),证明几何已内化。训练动态(Figure 6):GPD 熵峰更早更高,准确率持续上升而 GRPO 平台化。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| VSI-Bench(Qwen3-VL-4B,8 个数值/选择题子任务平均) | 平均准确率 | 57.1 | GRPO 56.4(基座 55.4,OPSD 55.7,Spatial-MLLM-4B 47.3) | +0.7 vs GRPO,+1.7 vs 基座 |
| VSI-Bench(Qwen3-VL-2B) | 平均准确率 | 51.7 | GRPO 51.3(OPSD 50.8,基座 51.3) | +0.4 vs GRPO |
| MindCube(Qwen3-VL-4B) | 准确率 | 38.0 | GRPO 33.0(OPSD 21.9) | +5.0 vs GRPO |
| SPAR-Bench(Qwen3-VL-4B) | 准确率 | 43.4 | GRPO 41.4(OPSD 36.3) | +2.0 vs GRPO |
| MMSI-Bench(Qwen3-VL-4B) | 准确率 | 29.4 | GRPO 28.7(OPSD 27.5) | +0.7 vs GRPO |
| ViewSpatial(Qwen3-VL-4B) | 准确率 | 39.8 | GRPO 39.6(OPSD 40.4) | +0.2 vs GRPO |
| 四大基准平均(Qwen3-VL-4B) | 平均准确率 | 37.6 | GRPO 35.7(OPSD 31.5,GPT-4o 34.5) | +1.9 vs GRPO,+6.1 vs OPSD |
| 四大基准平均(Qwen3-VL-2B) | 平均准确率 | 33.6 | GRPO 32.7(OPSD 30.2) | +0.9 vs GRPO,+3.4 vs OPSD |
局限与改进
局限方面:其一,VSI-Bench 上绝对提升只有 0.7 分(56.4→57.1),MMSI 仅 +0.7,ViewSpatial 基本持平(39.8 vs 39.6),收益集中在 MindCube/SPAR 等几何依赖更强的任务,说明对已有较强空间能力的模型收益递减;其二,特权质量受制于外部估计器——MindCube 上深度靠 Depth Anything 3、语义靠 Grounded-SAM-2,估计错误会被模板忠实转成文本当作“特权”灌输给教师,论文未量化噪声线索的影响,BEV 更是只有位姿可靠时才存在,覆盖不全;其三,流水线强依赖参考答案与 3D 标注,训练数据仅 15K 样本且几乎全部来自 ScanNet 类室内场景,对室外、大尺度空间泛化未知;其四,教师与学生共享参数,当路由线索有误导时“被带偏的教师”如何表现缺少分析;其五,评估只覆盖 Qwen3-VL 2B/4B,对更大或异构模型的普适性有待验证;其六,路由器直接用基础 VLM 零样本选择,路由错误时会把无关甚至误导性线索交给教师。
独立分析的弱点
独立分析几点弱点。第一,特权噪声:光照复杂、透明反光物体的 ScanNet 场景中,Depth Anything 3 与 Grounded-SAM-2 都可能出错,而这些错误会被模板照单全收交给教师——相当于用错误答案教老师,且门控只挡学生错误、不挡教师错误。改进:给线索附置信度并在路由时过滤,或训练线索验证器。第二,门控过糙:$R_i < 0.5$ 的二值门控把“只错一步”与“全盘皆错”同等对待,丢失细粒度纠错机会。改进:按奖励连续软加权,或按 token 与参考推理链的偏离度选择性蒸馏。第三,路由器无学习信号:路由由基础 VLM 零样本完成,无法针对下游任务优化。改进:把路由做成可学习策略,用蒸馏收益作奖励端到端训练。第四,特权形式单一:纯文本数值丢失几何连续性与空间结构,图像形式全面落后也可能只是注入方式不当。改进:混合文本与渲染 BEV 图像,或用 3D Gaussian Splatting 渲染特权视图。第五,算力开销:教师需对每条学生轨迹额外前向打分,训练成本约为纯 GRPO 的两倍,论文未报告训练时长与显存对比,落地成本不透明。
未来方向
作者在结论中把方向收敛为“问题路由的 3D 特权是空间推理的有效监督形式”这一命题本身,未列具体后续。可延伸的方向包括:其一,特权来源从静态标注/估计器扩展到神经重建(3D Gaussian Splatting)或仿真引擎,获得更稠密、可微、可靠的几何证据;其二,迁移到具身与机器人场景——导航、抓取天然有 3D 数据,GPD 框架可直接套用而不增加机载推理开销;其三,在线特权构建:目前线索全部离线算好冻结,若随策略进步动态调整路由或线索粒度(先粗后细的课程式特权),可能进一步提升;其四,特权来源泛化:OPSD 框架中“特权”不必是几何,代码任务可给测试用例、医学影像可给诊断报告,把 GPD 的“路由+门控”抽象成通用特权蒸馏配方;其五,系统研究训练特权与测试时工具调用的替代关系——Figure 7 显示 GPD 内化后测试时注入增益变小(+0.6 vs GRPO 的 +2.1),暗示两者可互补或互换,值得量化建模;其六,用教师特权蒸馏做模型压缩,让小模型借大模型同款几何特权追赶大模型的无特权表现。
复现评估
复现条件较好。代码已在 GitHub 开源(github.com/ZJU-REAL/GPD);骨干 Qwen3-VL-Instruct 2B/4B 公开;特权构建工具 Depth Anything 3、Grounded-SAM-2 均为开源模型;训练数据来自公开基准训练划分(VSI-590K/ScanNet、SPAR、MindCube),共 15K 样本。超参数披露完整:1 个 epoch、学习率 $1 \times 10^{-6}$、rollout 组大小 $n = 8$、蒸馏权重 $\lambda = 0.003$、错误阈值 $\tau = 0.5$、损失截断 1.5。主要门槛在工程:需要一套支持同一模型双上下文(学生/教师条件)逐 token 打分的 RL 训练框架,教师前向使训练成本约为纯 GRPO 的两倍,对 4B 模型通常需要多卡 A100/H100 量级资源;ScanNet 对齐标注的获取与多帧线索模板化也需要一定数据处理工作。总体难度中等偏上,对有 GRPO/verl 类框架经验的团队,预计一至两周可复现主结果。
论文图表
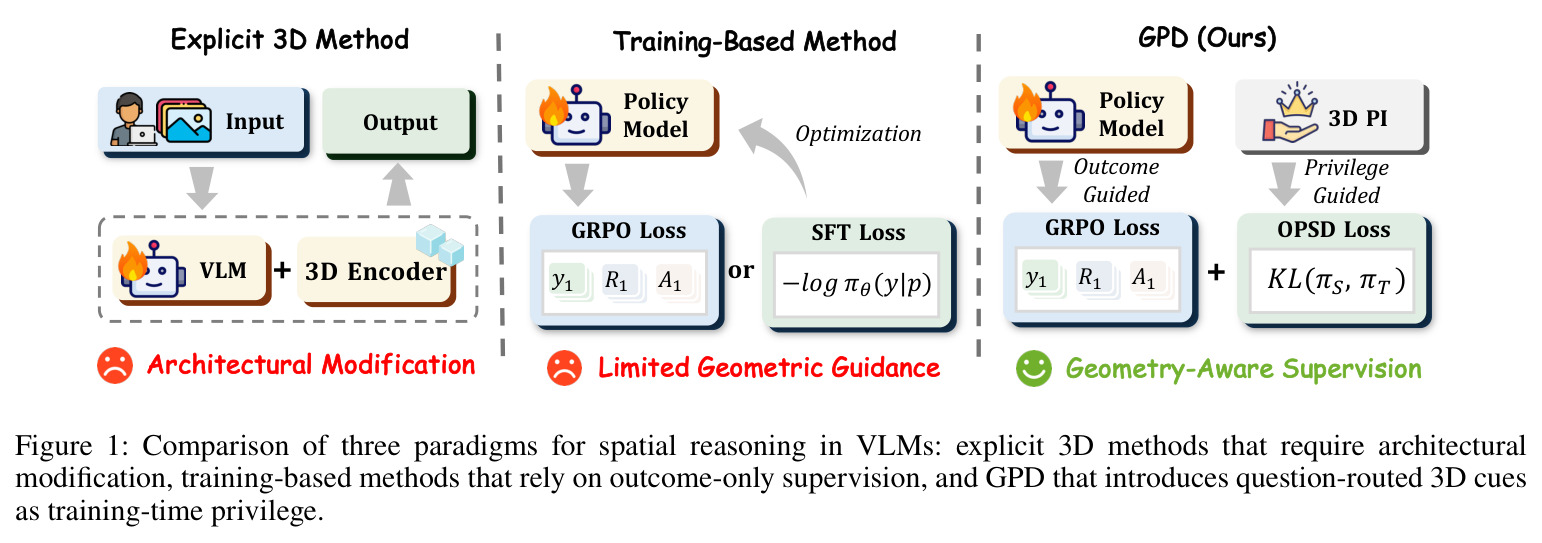
三栏对比图:显式 3D 方法在输入端接入 VLM+3D 编码器,需要架构修改;训练式方法用 SFT/GRPO 损失做 outcome-only 优化,几何指导有限;GPD 则在训练时引入 3D 特权信息(PI),损失为 GRPO 项加特权引导的 OPSD 项 $y_i R_i A_i + \mathrm{KL}(\pi_S, \pi_T)$,实现几何感知监督而不改推理接口。
一图看懂论文的问题定位与贡献坐标:GPD 相对两大既有范式(改架构的显式 3D、只看答案的训练式)处于什么位置、解决了什么权衡,是全文的导览图。