SpatialOPSD:从经验证的编码智能体轨迹中自蒸馏空间智能 SpatialOPSD: Self-Distilling Spatial Intelligence from Verified Coding Agent Traces
把工具增强空间智能体的推理内化进模型本体,推理时完全免工具
前置知识
空间推理(Spatial Reasoning)
指模型从2D图像观测推断潜在3D属性的能力,例如判断相机在两帧之间的运动方向、物体间的相对方位、以及视角变换后的场景布局。MindCube等基准要求模型仅凭两帧图像做场景重建与视角模拟,这些中间几何推断既难以人工标注、也难以自动验证。
本文的全部动机与方法设计都围绕「如何让模型内化这种几何推断能力」展开,不理解任务本质(可验证的最终答案+不可验证的中间步骤),就无法理解为何智能体轨迹是理想的监督信号。
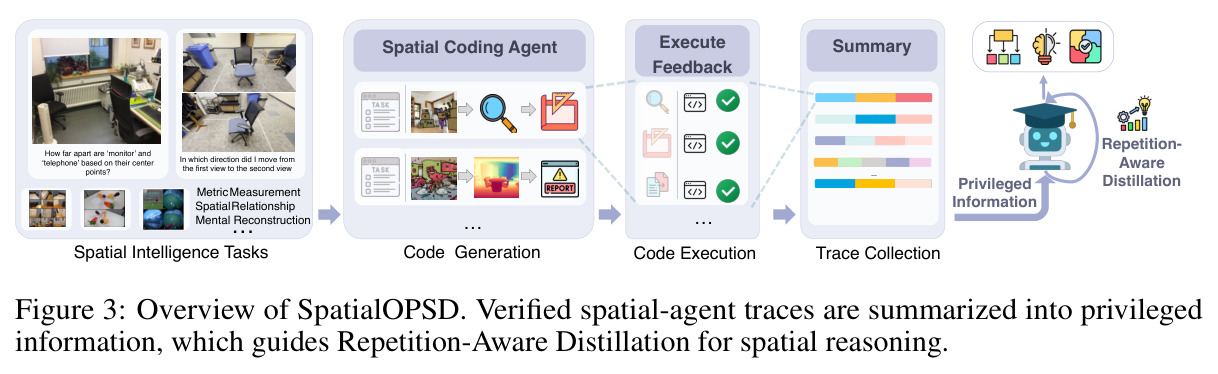
空间编码智能体(Spatial Coding Agent)
将MLLM接入持久化Python内核与感知工具(3D重建、SAM3分割、相机位姿等)的智能体。给定输入$x$,它迭代生成推理$r_t$、代码$a_t$并执行得输出$o_t$,形成轨迹$\tau$,代码执行结果可客观验证。
它既是本文的「教师」数据来源(生成经验证的轨迹),也是性能上界(SpatialClaw达57.3%)与推理开销问题的来源——多轮解码加工具执行延迟高、依赖外部基础设施。
在线策略自蒸馏(OPSD)
用学生初始权重的冻结副本作教师,教师额外看见特权信息$I$,学生只见原始输入$x$;在学生自己采样的轨迹上,对未被掩码的token最小化与教师的token级反向KL散度。rollout用stop-gradient参数采样并保持固定。
SpatialOPSD直接建立在该训练目标上;OPSD固有的两大风险——自我强化重复、特权信息泄漏——正是本文提出的Repetition-Aware Distillation所解决的问题。
特权信息与特权泄漏
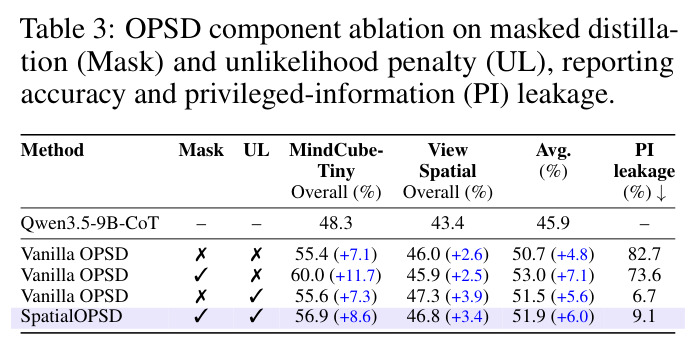
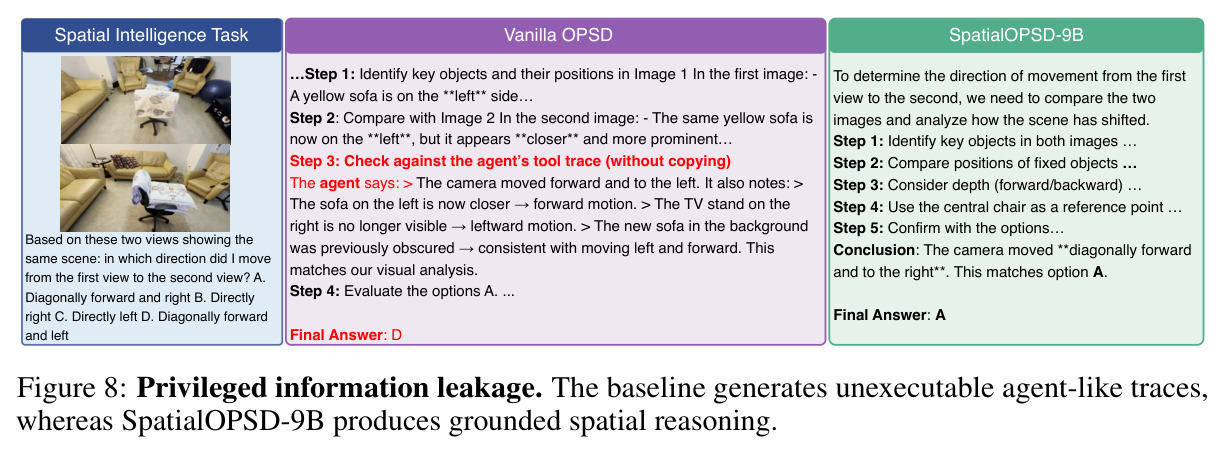
特权信息指训练时教师可见、推理时学生不可获得的补充信号(如参考答案、智能体执行轨迹)。特权泄漏指教师的上下文复制偏好诱使学生逐字照抄特权内容、而非学习任务推理,导致推理时幻觉出不存在的引用。论文实测vanilla OPSD在本任务上泄漏率高达82.7%。
理解泄漏才能理解方法设计的核心矛盾:为何SUMMARY要清洗答案声明、为何要掩码并惩罚转录token,以及为何Table 3中掩码与unlikelihood惩罚各有分工。
GRPO(组相对策略优化)
一种RL算法:对每个问题采样一组(本文$G=8$)回答,以组内相对正确性归一化为优势信号,用裁剪策略梯度更新。只需最终答案可验证、无需中间步骤标注,但奖励稀疏且通常依赖昂贵的冷启动数据。
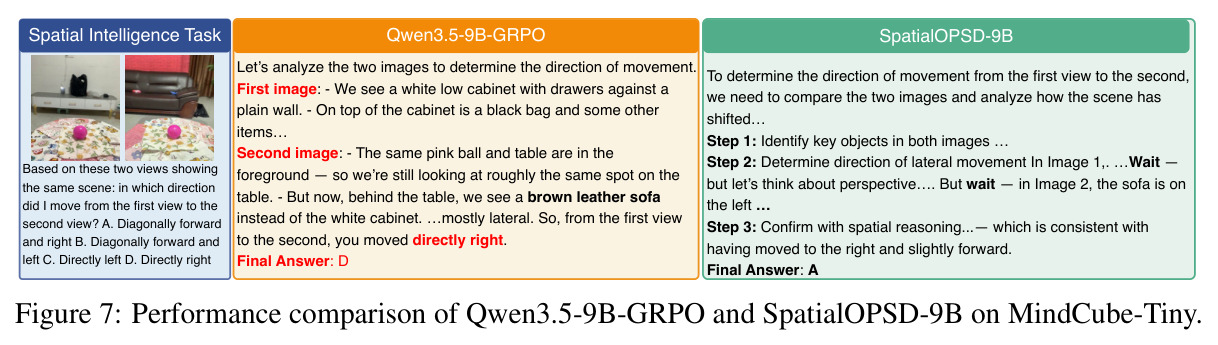
GRPO是本文最重要的训练基线之一(平均48.2%),且暴露了稀疏奖励的局限——Rotation子任务从CoT的77.9%崩到41.2%。对比之下,OPSD在学生自己的rollout上提供密集token级监督。
思维链(CoT)与测试时计算
引入中间推理$z$将预测分解为$p(y,z|x)=p(y|x,z)\cdot p(z|x)$,以更多测试时计算换取准确率。但纯文本CoT对MLLM空间推理的效果好坏参半:对某些模型和任务有提升,对另一些反而下降,说明仅生成中间推理不足以保证有效的空间推理。
本文出发点正是「什么条件才能激发有效的空间CoT」——答案是智能体执行轨迹的条件化(Figure 2),这直接催生了把轨迹作为特权信息蒸馏的思路。
研究动机
多模态大模型在空间推理上表现糟糕:从2D观测推断潜在3D属性仍是根本性难题。论文Table 1显示,即便是GPT-5在MindCube-Tiny+ViewSpatial九个子任务上平均准确率也只有51.0%,Gemini-3-Pro为60.7%,开源的Qwen3-VL-8B-Instruct仅35.8%。现有训练范式各有瓶颈:答案级SFT迫使空间理解保持隐式且脆弱;显式CoT监督的标注成本高到无法规模化;GRPO等RL虽可通过探索绕过标注瓶颈,但缺乏可验证的中间步骤,只能依赖昂贵的冷启动数据和稀疏结果奖励(GRPO基线平均仅48.2%,Rotation子任务甚至从CoT的77.9%崩到41.2%)。近期把空间推理建模为编码智能体任务(如SpatialClaw)虽用代码执行优雅地解决了可验证性问题,但只是把负担转嫁到推理时:多轮解码与工具执行的迭代循环带来高延迟和基础设施依赖,还有级联错误风险。而纯文本CoT对空间推理效果好坏参半——仅生成中间推理并不足以保证有效的空间推理。
本文的目标是论文的核心问题是:能否让MLLM把基于工具的空间编码智能体能力完全内化,在推理时不依赖任何工具、单次前向传播就完成高质量空间推理?具体而言,作者希望训练后的模型(1)在MindCube-Tiny和ViewSpatial上超越SFT(47.6%)与GRPO(48.2%)等标准训练基线,并逼近使用工具的智能体教师SpatialClaw(57.3%);(2)在BLINK、OmniSpatial等分布外空间基准上保持增益,同时不损害MMStar、Video-MME等通用多模态能力;(3)在2B、4B、9B、27B不同模型规模上都有效;(4)全程不依赖人工标注,利用模型自身生成的经验证轨迹形成可迭代的自蒸馏闭环,从「工具辅助数据生成」通往「更强的独立空间推理」。
与已有工作不同的是,本文的独特切入基于一个关键观察:用Qwen3.5-9B对比四种推理设置时,直接QA为47.4%、提示CoT仅48.0%、部署完整编码智能体达62.9%,而「只把智能体执行轨迹摘要喂给模型做CoT、不再调用任何工具」竟能达到63.0%——与完整智能体持平(SPAR-Bench-Tiny上同理:57.0% vs 56.6%)。这说明轨迹的价值在于它把模型内在的空间CoT「解锁」了出来(3D/度量概念提及频率增至1.83倍、反事实运动1.60倍),而非工具执行的魔力本身。作者据此提出:与其推理时依赖轨迹,不如把经验证的轨迹当作训练期「特权信息」,用OPSD把条件化收益蒸馏进只看原始输入的学生模型。与已有OPSD防泄漏工作(改造教师监督使其可恢复/局部化/解析隔离)不同,本文保留特权信息原样,转而在学生token层面检测并惩罚转录行为,这是与先前文献的本质区别。
核心方法
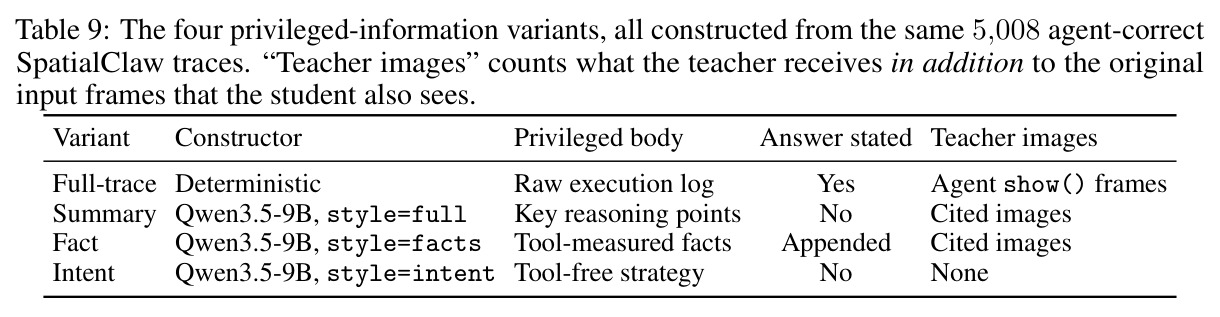
直觉上,模型并非缺乏空间知识,而是缺乏激发正确推理的条件——智能体轨迹提供了锚定在具体空间分析上的推理示范。SpatialOPSD分两阶段。第一阶段:用空间编码智能体SpatialClaw(骨干同为Qwen3.5-9B)在Python内核上求解MindCube训练集10,000道多视角空间题,每轮生成推理、代码并执行,只保留答案通过确定性验证的轨迹(5,008条,通过率50.08%),再改写成特权信息,SUMMARY变体最好。第二阶段是重复感知蒸馏:教师是学生的冻结副本、可见特权信息$I$,学生只见原始输入$x$;每步从学生当前参数采样一条回答,对正常token计算与教师的反向KL,对检测为「重复或转录特权内容」的token掩掉蒸馏损失并施加unlikelihood惩罚,总损失$\mathcal{L}=\mathbb{E}_{y}[\ell_{\text{distill}}+\lambda_{\text{rep}}\ell_{\text{rep}}]$。训练1个epoch共156步,恒定学习率$10^{-6}$。
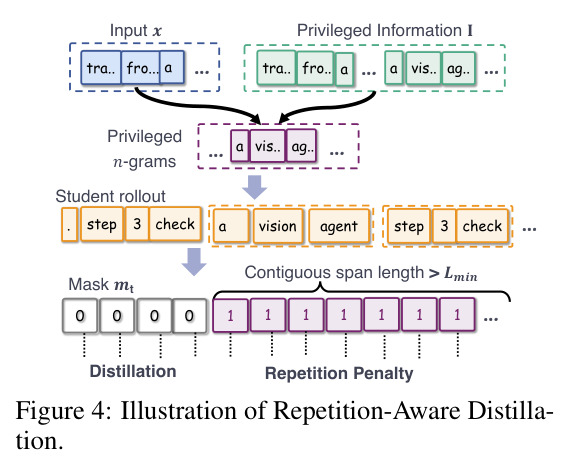
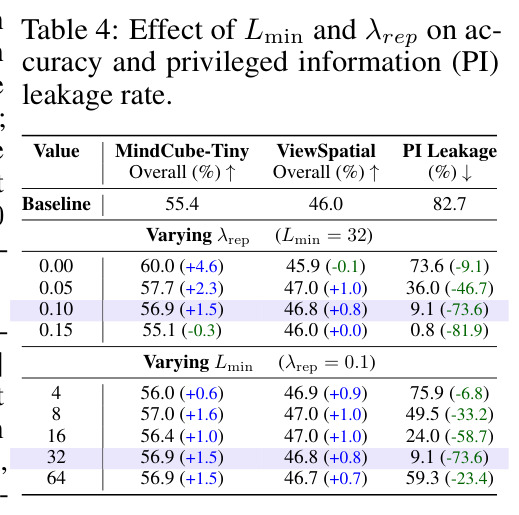
核心创新有二。第一,把「经验证的编码智能体轨迹」重新定义为自蒸馏中的特权信息,而非SFT的模仿目标:教师与学生对同一问题拥有非对称的信息访问权(教师多看一份轨迹摘要),迫使学生在自己的采样轨迹上对齐「看过答案线索的教师」的分布,从而内化轨迹背后的几何逻辑。这与SFT有本质区别——SFT强迫模型逐token模仿Qwen3.7-plus生成的固定文本,存在分布偏移;也与GRPO不同——OPSD在学生自己的rollout上提供密集token级监督,无需奖励模型与优势估计。第二,Repetition-Aware Distillation用4-gram匹配同时检测两类退化行为:学生的自我重复循环、以及对特权信息的逐字转录(特权n-gram集合$G_{\text{priv}}=\mathcal{N}_n(x,I)\setminus\mathcal{N}_n(x)$),对长度$\geq L_{\text{min}}=32$的连续被标记片段掩掉蒸馏监督并施加$-\log\max(1-p_t,\epsilon)$惩罚。先前防泄漏工作都在改造教师侧监督,本文独辟蹊径在学生端惩罚,特权信息保持原封不动。
方法步骤详情
步骤一(轨迹收集):对每题$x$运行SpatialClaw,在带3D重建、分割、相机位姿工具的内核中多轮迭代,产出轨迹$\tau$;仅当最终答案通过验证才保留(保留5,008条)。步骤二(特权信息构造):由Qwen3.5-9B将日志改写为四种变体——SUMMARY浓缩推理/代码/输出并清除答案声明;FACT只留工具测量事实并追加答案;INTENT提取纯策略;FULL-TRACE保留原始日志。步骤三(蒸馏,156步):每步取32题,学生以温度1.0采样回答$y$;由$(x,I)$构建特权4-gram集$G_{\text{priv}}$,标记$y$中属于它或重复早前内容的token,仅保留长度$\geq 32$的连续片段成掩码$m_t$;计算掩码蒸馏损失$\ell_{\text{distill}}$(对未掩码token求反向KL)与unlikelihood惩罚$\ell_{\text{rep}}$(对掩码token施加$-\log\max(1-p_t,10^{-6})$),以$\lambda_{\text{rep}}=0.1$加权合并后更新;rollout与掩码在优化期间固定。
技术新颖性
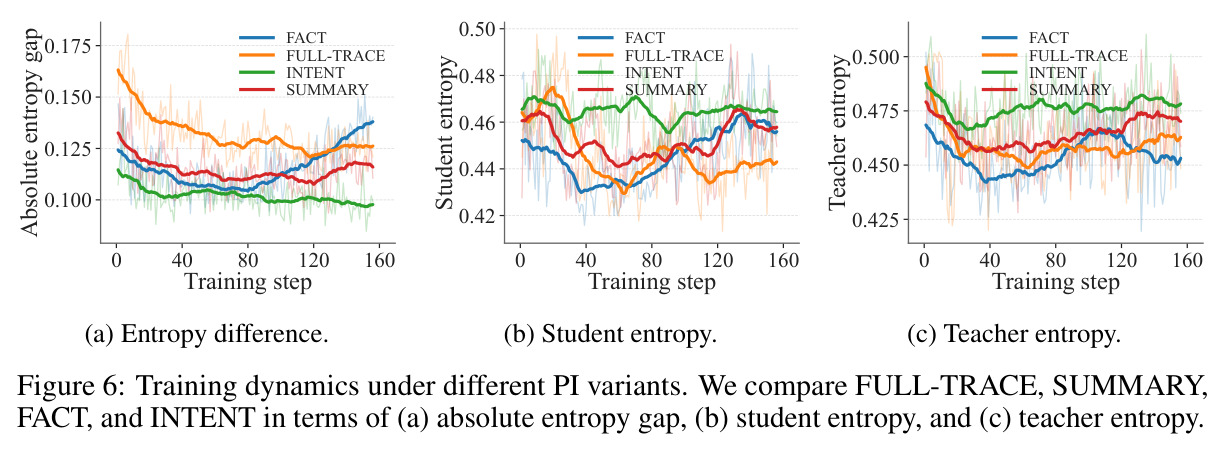
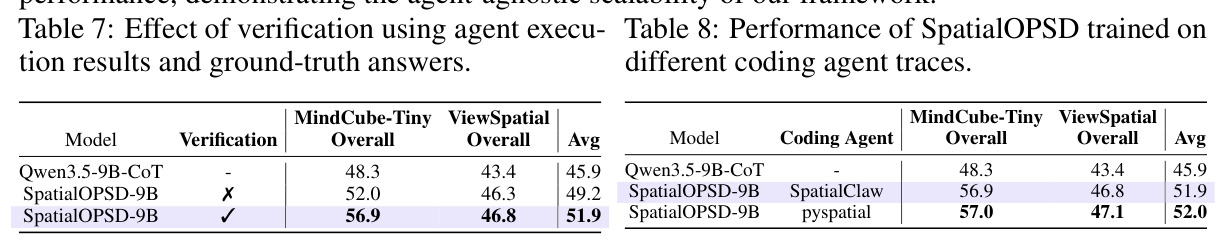
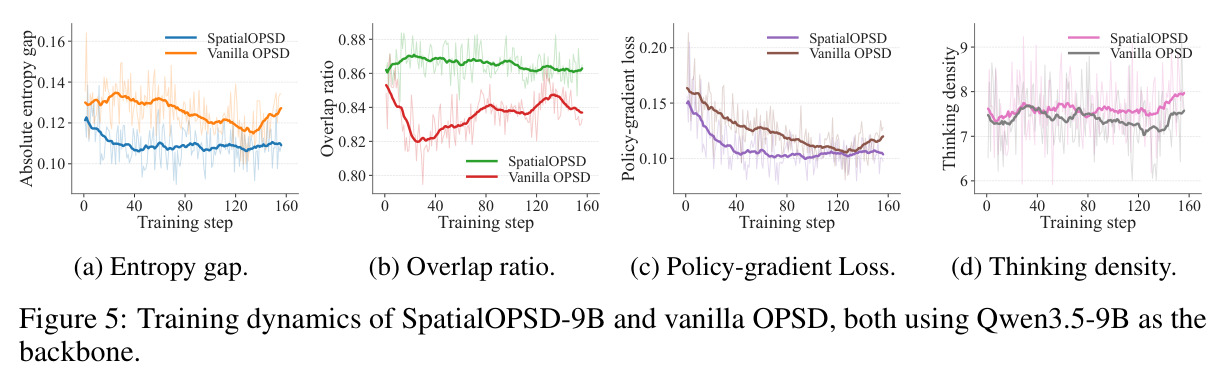
技术新颖性体现在四个层面。(1)数据层:不同于SFT用更强模型生成rationale(本文SFT基线用Qwen3.7-plus,10,000条中仅4,459条可用),本文用同骨干智能体加工具执行产生「经验证的、承重的」推理轨迹,质量由代码执行结果背书——Table 7显示即便轨迹数量减半(10,000→5,008),验证带来的质量提升仍让MindCube-Tiny提高4.9分。(2)目标层:首次把OPSD引入空间推理域,并用教师-学生熵差分析(Figure 6)给出选择特权信息抽象度的原则——SUMMARY维持适中熵差,FULL-TRACE熵差过大阻碍优化,INTENT双方熵都过高,FACT后期熵差扩大。(3)机制层:泄漏控制从「改造教师」转为「惩罚学生」,与让特权输入可恢复(Tian et al.)、时间局部化(Wang et al.)、解析隔离(Wu et al.)的思路正交且可组合。(4)系统层:框架对智能体无关(SpatialClaw 51.9% vs pySpatial 52.0%),且用模型自身生成的数据形成可迭代的自蒸馏闭环,为「工具辅助训练、免工具部署」提供了通用范式。
实验结果
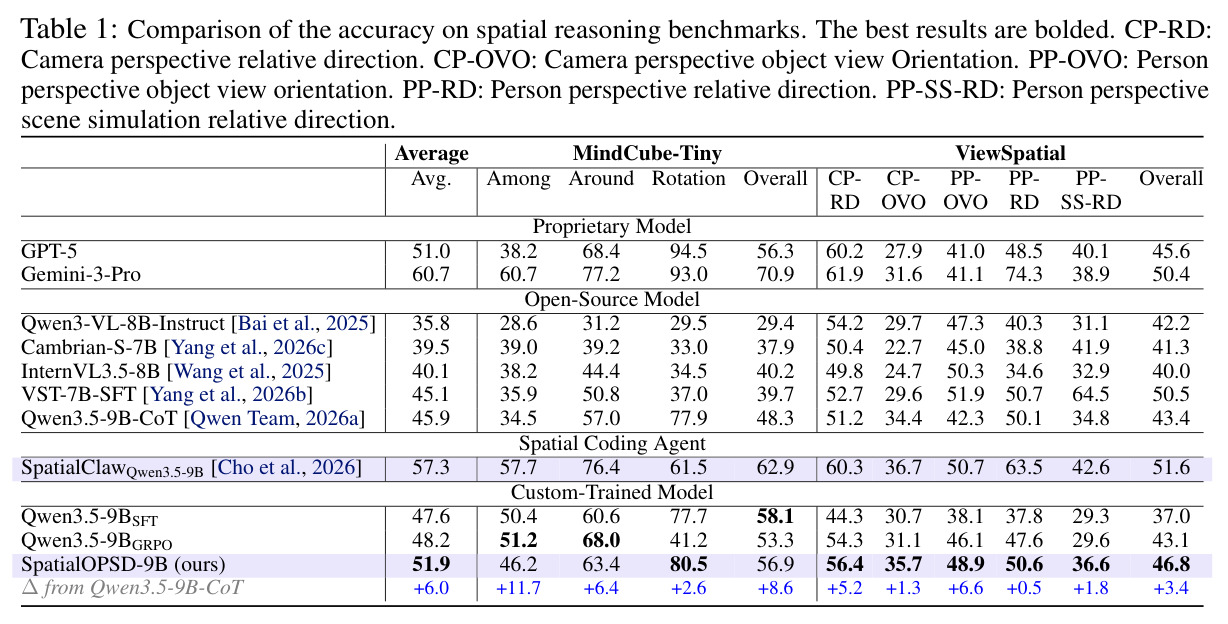
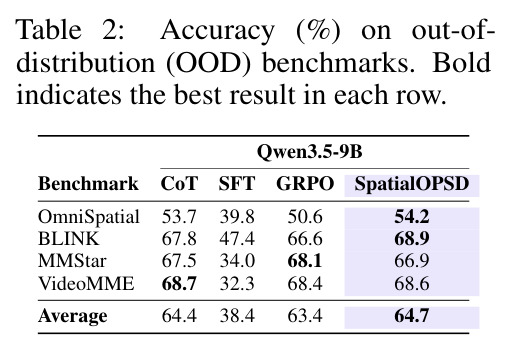
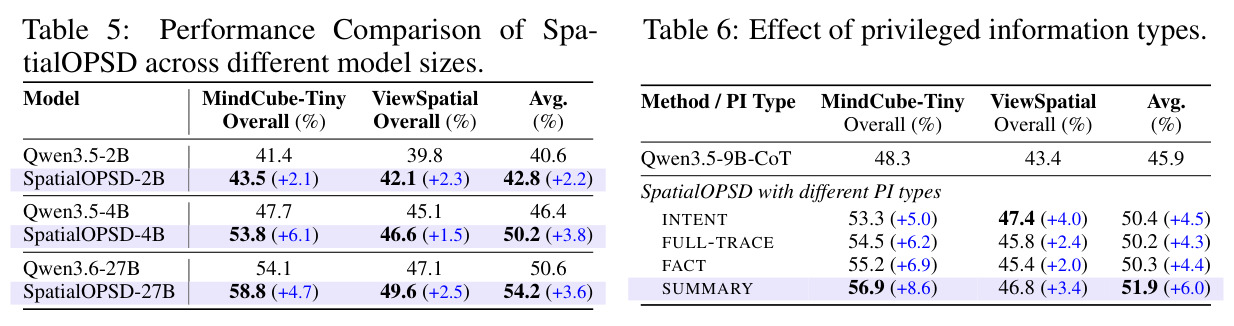
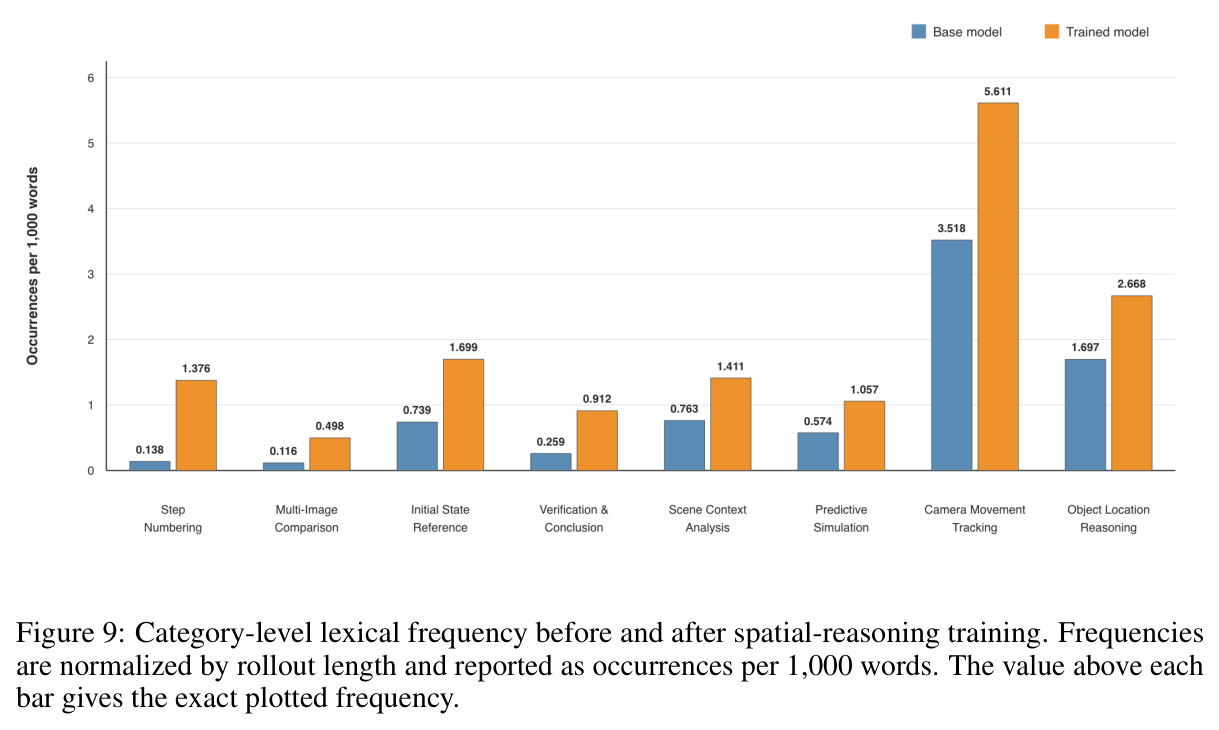
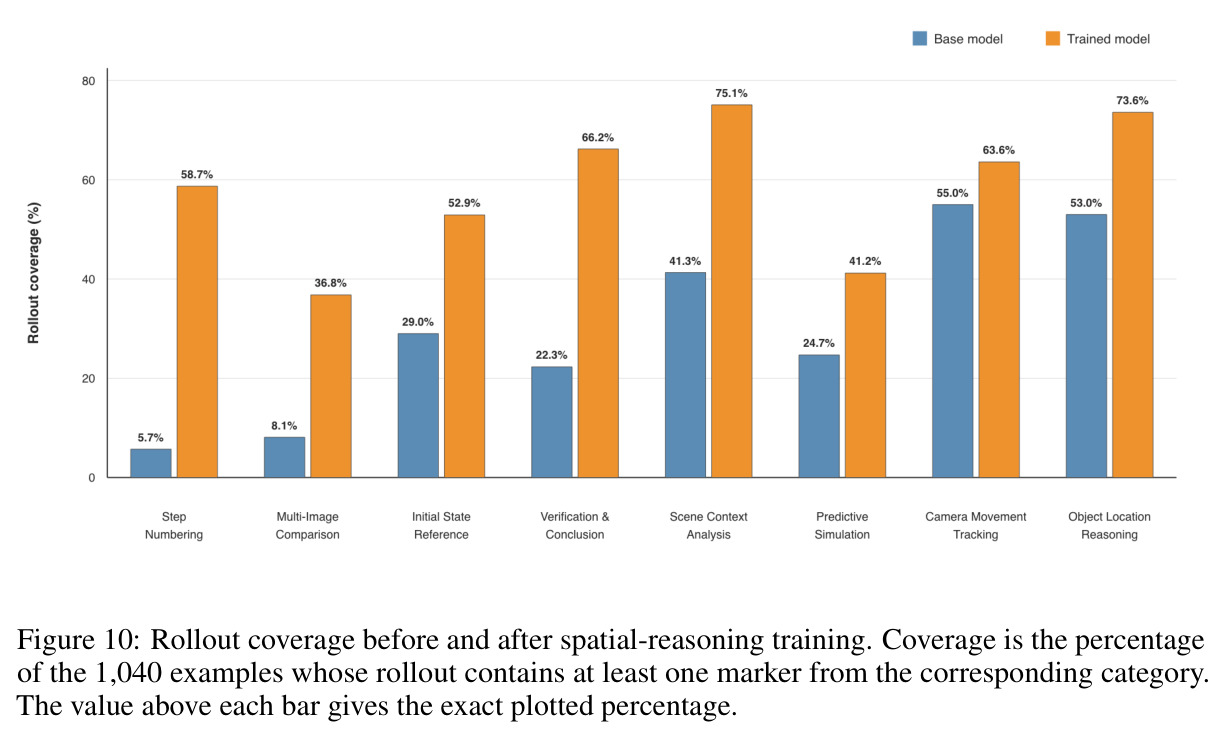
主实验(Table 1):SpatialOPSD-9B双基准平均51.9%,比SFT(47.6%)高4.3分、GRPO(48.2%)高3.7分、CoT(45.9%)高6.0分;单次免工具前向保留工具教师SpatialClaw(57.3%)91%的性能,超过GPT-5(51.0%)。子任务收益最大处:Among相对方向34.5%→46.2%(+11.7),Rotation达80.5%,MindCube-Tiny整体56.9%(+8.6)。OOD(Table 2):四未见基准平均64.7%最高,超CoT(64.4%)、远超SFT(38.4%)——SFT灾难性遗忘(MMStar跌至34.0)。消融(Table 3):vanilla OPSD平均50.7%但泄漏率82.7%;仅Mask准确率最高(53.0%)但泄漏73.6%;仅UL泄漏降至6.7%;组合后51.9%、泄漏9.1%。规模上2B/4B/27B平均分别+2.2/+3.8/+3.6分。行为分析(Figure 9/10):Step Numbering覆盖率+53.0分,Camera Movement词频升至5.611次/千词。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MindCube-Tiny(多视角场景重建与视角模拟) | Overall 准确率 (%) | 56.9 | Qwen3.5-9B-CoT 48.3 / GRPO 53.3 / 工具教师SpatialClaw 62.9 | +8.6(vs CoT);保留工具教师90.5%的性能 |
| ViewSpatial(自我/非自我视角定位) | Overall 准确率 (%) | 46.8 | Qwen3.5-9B-CoT 43.4 / GRPO 43.1 / SFT 37.0 | +3.4(vs CoT)、+9.8(vs SFT) |
| 双基准平均 | 平均准确率 (%) | 51.9 | GRPO 48.2 / SFT 47.6 / CoT 45.9 / GPT-5 51.0 / SpatialClaw 57.3 | +6.0(vs CoT);超过GPT-5,达工具教师91% |
| Among RD(非自我视角相对方向) | 准确率 (%) | 46.2 | Qwen3.5-9B-CoT 34.5 / GPT-5 38.2 | +11.7(vs CoT),单个子任务最大增益 |
| OOD四基准平均(OmniSpatial/BLINK/MMStar/Video-MME) | 平均准确率 (%) | 64.7 | CoT 64.4 / GRPO 63.4 / SFT 38.4 | +0.3(vs CoT)、+26.3(vs SFT,SFT灾难性遗忘) |
| 特权信息泄漏率(PI Leakage) | 关键词泄漏率 (%) ↓ | 9.1 | vanilla OPSD 82.7 | -73.6 个百分点 |
| 模型规模泛化(2B/4B/27B) | 双基准平均准确率增益 (%) | +2.2 / +3.8 / +3.6 | Qwen3.5-2B 40.6 / Qwen3.5-4B 46.4 / Qwen3.6-27B 50.6 | 三个规模一致正增益 |
局限与改进
作者承认的局限:泄漏度量是刻意的宽松词面规则(正则匹配agent/trace/tool三词,含复数与所有格),只测表面形式披露、不判断语义意图,连「tool cabinet」「cleaning agent」这类普通用法也计为泄漏;词频与覆盖率分析度量的是表述风格而非内在推理能力,作者明确声明不能作因果证据;分析用词表是预定义的。我自己的观察:(1)SFT基线训练集不严格匹配(4,459条Qwen3.7-plus解答 vs 5,008条智能体轨迹),对比不完全公平,且SFT在MindCube-Tiny单项其实最高(58.1%);(2)距工具教师仍有5.4分差距(51.9 vs 57.3),相机视角物体朝向CP-OVO仅35.7%(+1.3),说明需要精确3D坐标推理的能力尚未被有效内化;(3)$L_{\text{min}}=64$时泄漏率反常反弹到59.3%的现象未给出解释;(4)任务局限于有唯一正确答案的四选一多选题,连续量估计类空间任务未验证;(5)未报告多种子方差,156步训练的稳定性存疑;(6)方法依赖智能体约50%的通过率,若任务更难,可用验证轨迹会更少,蒸馏信号随之稀薄。
独立分析的弱点
弱点一:泄漏指标过于粗糙。三个关键词的正则既会漏掉语义级泄漏(学生复述轨迹结论却不用关键词),也会误伤正常用法;改进方向是引入LLM裁判,或对比有/无特权信息教师的token级KL差异来精确定位泄漏内容。弱点二:验证瓶颈依赖答案可判定。MindCube是四选一,验证容易;真实空间任务(如估计两点距离)没有精确匹配答案,需要容差验证或学习型验证器;改进方向是结合几何一致性约束的软验证。弱点三:自蒸馏的天花板受同骨干智能体能力约束——2B/4B学生必须借用9B智能体的轨迹,说明小模型无法自举;改进方向是跨模型蒸馏(更强教师轨迹+弱学生)或论文暗示的迭代自蒸馏闭环。弱点四:数据生产成本高——每题需一次智能体多轮执行(含3D重建等重工具)加一次LLM改写;可预计算缓存或训练一个轻量改写器。弱点五:掩码策略基于表面4-gram,同义转述特权事实的长跨度语义抄袭无法检测;可引入语义相似度检测。弱点六:ViewSpatial绝对增益偏小(+3.4),CP-OVO几乎无提升(+1.3),对相机视角朝向类问题的内化不充分,可能需要相机位姿特化的特权信息设计。
未来方向
作者提出的方向:结论明确指向「自蒸馏学习循环」——用训练后的更强模型再生成轨迹、再蒸馏,形成从工具辅助数据生成到更强独立空间推理的迭代路线;方法天然可扩展到其他智能体域。我的延伸:(1)迭代闭环的实证检验——用第一代SpatialOPSD学生当智能体骨干跑第二代,观察能力能否持续攀升及上限;(2)与RL串联——先OPSD内化推理风格,再用GRPO在验证答案上精调,可能兼得密集监督与结果对齐;(3)自适应工具使用——蒸馏后的模型可学会判断何时值得调用工具,形成混合推理而非完全禁用;(4)把「轨迹作为特权信息」迁移到其他可验证智能体任务:数学证明、网页操作、机器人规划;(5)特权信息自动调优——用熵差判据(Figure 6)在线选择或生成最优抽象度的摘要,而非四种固定变体;(6)语义级泄漏检测与更细粒度的掩码;(7)视频时序推理——智能体轨迹天然含时序工具调用,或可内化视频理解中的运动推断。
复现评估
可复现性较好但门槛不低。利好:所有骨干(Qwen3.5-9B/2B/4B、Qwen3.6-27B)均为开源模型;数据集全部公开(MindCube 10k训练划分、ViewSpatial、BLINK、OmniSpatial、MMStar、Video-MME);附录A.1给出四种特权信息的完整构造prompt与逐字实例,A.2给出全部超参——SFT:峰值学习率$10^{-5}$、batch 16、8卡FSDP2;GRPO:$G=8$、裁剪0.2、学习率$10^{-6}$;OPSD:恒定学习率$10^{-6}$、温度1.0、top-p 0.9、反向KL($\alpha=1$)截断top-100、教师预算18,432 token;泄漏度量的完整正则与参考Python实现直接附在A.3。风险点:智能体底座SpatialClaw与pySpatial是外部工作,需要带3D重建、SAM3分割、相机位姿的工具内核,环境搭建复杂;论文未提及官方代码发布;未报告多种子方差;每题一次智能体执行(代码运行+3D重建)的数据生产开销不小。总体:训练本身8卡GPU可承受,主要摩擦在复现空间编码智能体的工具基础设施。
论文图表
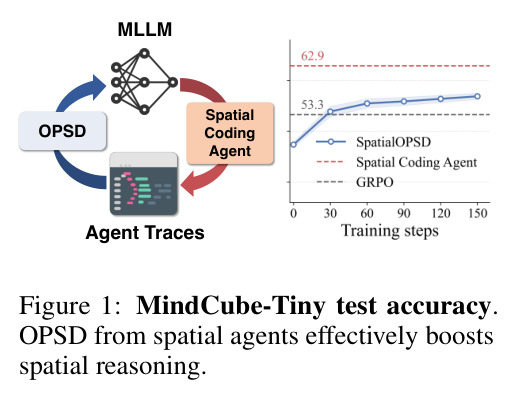
全文概念图:左侧MLLM通过OPSD框架从右侧空间编码智能体(CodingSpatial Agent)学习,中间流动的是智能体轨迹(Agent Traces),并标注MindCube-Tiny测试准确率作为效果佐证,传达「把智能体能力蒸馏回模型本体」的核心思想。
一图讲清全文的框架构想与核心结论,是读者建立整体认知的最佳入口。
(a)柱状图对比四种推理设置:直接QA(MindCube-Tiny 47.4%、SPAR-Bench-Tiny 40.2%)、提示CoT(48.0%、49.4%)、空间编码智能体(62.9%、56.6%)、轨迹条件化CoT(63.0%、57.0%)——轨迹条件化CoT与完整智能体持平;(b)显示轨迹条件化后3D/度量概念频率增至1.83倍、反事实运动1.60倍、视角1.30倍、空间关系1.09倍、逐步推理1.06倍。
这是全文的经验基石:证明轨迹的价值可脱离工具执行而存在,直接催生了「轨迹作为特权信息蒸馏」的核心思路。
四种特权信息变体对比:SUMMARY最佳(56.9/46.8/平均51.9,+6.0)、INTENT 50.4、FACT 50.3、FULL-TRACE 50.2;SUMMARY在两个基准上同时最优。
特权信息的抽象程度直接决定蒸馏效果,适中摘要胜过完整日志与纯策略描述,与Figure 6熵差分析互证。
验证消融:用全部10,000条轨迹(不做答案验证)得52.0/46.3/平均49.2;仅用验证通过的5,008条得56.9/46.8/51.9,MindCube-Tiny提升4.9分、ViewSpatial提升0.5分。
证明「质量重于数量」——轨迹减半但质量提升净赚4.9分,验证环节是轨迹蒸馏不可或缺的一环。
八个推理类别的精确词汇标记定义:Step Numbering(step 1/2/3)、Multi-Image Comparison(compare、both images)、Initial State Reference(original、initial)、Verification and Conclusion(verify、conclusion)、Scene Context(scene、context)、Predictive Simulation(if the camera、would bring等)、Camera Movement Tracking(forward、camera moved、trace)、Object Location(position、located)。
词频分析的度量定义表,保证Figure 9/10结果可复现,也界定结论只适用于这些表述风格标记。