SparseDecoding:解码感知的准确高效大模型剪枝框架 SparseDecoding: Decoding-Aware Pruning for Accurate and Efficient LLM Inference
校准激活改取自模型自回归解码步并配定制N:M稀疏内核,解码加速最高1.48倍
前置知识
训练后剪枝与OBS框架(Optimal Brain Surgeon)
不重新训练,直接把不重要的权重置零。OBS用二阶泰勒展开近似删除单个权重的输出重构误差,并分解为逐层问题:由校准激活算 Hessian $H = 2X_\ell X_\ell^\top$,迭代删显著度 $L_q = \frac{w_q^2}{2[H^{-1}]_{qq}}$ 最小的权重,再用 $\delta w = -\frac{w_q}{[H^{-1}]_{qq}} H^{-1}_{:,q}$ 补偿其余权重,SparseGPT 把它做到大模型可行。
本文不发明新求解器,而是替换其校准激活来源。不懂 OBS 与 Hessian 的角色,就无法理解“校准数据决定剪枝质量”这条主线。
Prefill 与 Decoding(预填充与解码)
LLM 推理分两阶段:prefill 一次性并行处理完整 prompt,是矩阵-矩阵乘(GEMM/SpMM),计算密集;decoding 逐个自回归生成 token,每步只算当前 token 的隐藏状态,接近矩阵-向量乘(GEMV/SpMV),每生成一个词都要重读全部权重,是访存受限(memory-bound)过程,通常主导端到端延迟。
本文所有设计都围绕解码阶段的特性展开,分不清两个阶段的计算形态,就无法理解 SpMM 内核为何在解码时反而比 dense 还慢。
N:M 半结构化稀疏
每 $M$ 个连续权重只保留 $N$ 个非零的规则模式(如 2:4 即每 4 个留 2 个)。比非结构化稀疏硬件友好:A100 的 Sparse Tensor Core 可直接加速,又保留挑权重的自由度。关键性质是每行非零个数相同、元数据规整,利于 GPU 线程负载均衡,这是本文内核能做固定步长遍历的前提。
论文的内核设计(bitmask、固定步长遍历)与全部实验配置(2:4、4:8、8:16、16:32)都建立在这一模式的规则性之上。
校准数据与 teacher forcing
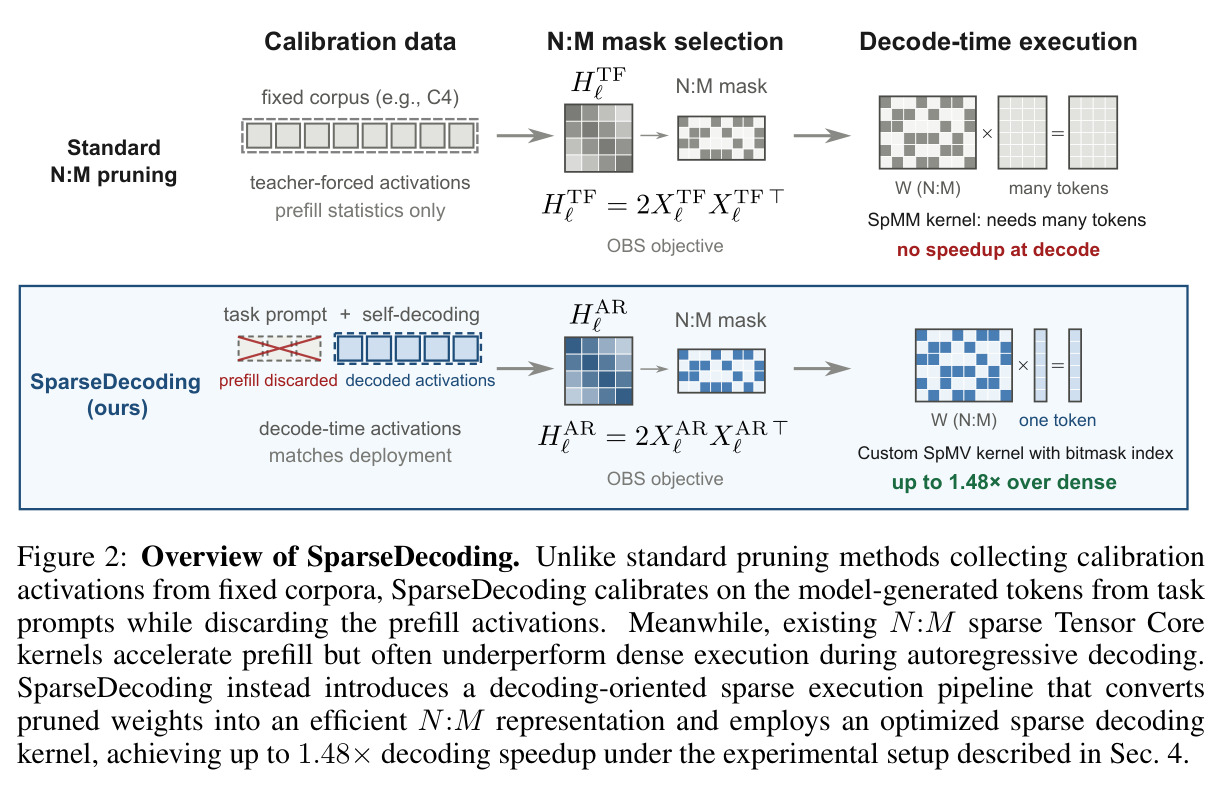
训练后剪枝需要一小批校准文本过一遍模型,收集每层输入激活来估计 Hessian。传统做法把固定语料(如 C4)整段喂入模型,每个位置的输入 token 都是预先给定的,即 teacher forcing。它隐含假设:部署时模型看到的输入分布与校准时一致。
本文核心论点正是打破这一假设:自回归解码时模型吃的是自己生成的 token,分布会漂移,校准必须换一种收集激活的方式。
SpMM 与 SpMV
SpMM 是稀疏矩阵-稠密矩阵乘,输入多列,出现在 prefill 或大 batch;SpMV 是稀疏矩阵-向量乘,输入一列,对应 batch=1 解码。cuSPARSELt 等 2:4 稀疏库只针对 SpMM + Tensor Core 优化,没有覆盖解码主导的 SpMV 路径,稀疏权重在解码时缺少现成加速通道。
这解释了 Figure 1b 现象——2:4 稀疏解码时只有 dense 的 0.85-0.87 倍速度,也说明作者为何要用 Triton 自写解码专用 SpMV 内核。
研究动机
大语言模型解码阶段是访存受限的:每生成一个 token 都要把全部权重从显存读一遍,主导端到端推理延迟。逐层、免训练的 Hessian 剪枝(如 SparseGPT)是主流缓解方案,但这类方法用固定语料(C4)在 teacher forcing 下收集校准激活——模型输入完全由预先给定的文本决定。而实际部署时模型是自回归的:早期解码步引入的剪枝误差会改变后续预测与上下文,激活分布随之逐步偏离校准分布。作者实测(Figure 1a):dense 与剪枝模型的相对激活差异在前 12 个解码步内就达到平台期的 90%,之后数百步保持不变,说明固定文本校准与生成时激活存在系统性错位。系统侧同样有缺口:现有 2:4 稀疏库(cuSPARSELt)主要优化稀疏矩阵-矩阵乘 SpMM,适合 prefill;小 batch 解码主导的却是稀疏矩阵-向量乘 SpMV。Figure 1b 显示 2:4 Sparse Tensor Core 路径在 prefill 上有 1.31-1.46 倍加速,但自回归解码时只有 dense 的 0.85-0.87 倍——理论内存减半,实际反而更慢。
本文的目标是本文目标是让“剪枝时的优化目标”与“解码时的真实运行状态”对齐,并让稀疏权重在解码阶段产生真实的墙钟加速。具体拆成两个互补子目标:算法侧,构造 decoding-aware 校准协议,直接从 dense 模型自回归生成过程收集逐层输入激活,只保留解码步、丢弃 prefill,用它们定义逐层重构目标;该协议可直接插到 SparseGPT、Wanda 等现有求解器上,不需要任何再训练或新优化器。系统侧,针对 batch-one 解码设计专用的 N:M SpMV GPU 内核,通过更小的元数据开销与线程间负载均衡,使 2:4 到 16:32 的各种 50% 稀疏权重都能在 A100 上稳定快于 dense 基线。质量与速度两条轴合起来,构成“准确且高效”的完整主张。
与已有工作不同的是,已有工作并非没有意识到校准数据的重要性,但切入点不同。Bandari 等(2024)比较不同预训练语料作为校准集的效果,Ji 等(2025)发现自生成语料更贴近模型分布——它们回答的是“用哪个语料”;RAC(Lucas 等,2026)与 RESP(Wang 等,2025)把 on-policy 思维链轨迹信息引入剪枝,但分别面向思维链重构与结构化剪枝的梯度目标。SparseDecoding 的独特角度在于改变“如何收集”校准激活这一最底层协议:把任务 prompt 喂给 dense 模型自由生成,只保留解码步激活、显式丢弃 prefill,使 $H = 2XX^\top$ 恰好概括生成时的激活统计;并用定理 A.1 给出校准目标与解码重构目标之间最坏情况相对差异 $\epsilon$ 的紧致刻画,把“分布错位伤害剪枝质量”从直觉变成可度量的量。系统侧则借鉴 nmSPARSE 但为解码 SpMV 量身定制 bitmask 表示。算法与系统两条轴同时推进,是与前人工作的本质区别。
核心方法
直觉很朴素:想让剪枝后的模型在生成时表现好,剪枝校准就应该“看着”生成时的激活做优化。SparseDecoding 是一个框架而非新求解器:先用 dense 模型在 $K$ 个目标任务 prompt(写作用 LongWriter,代码用 LiveCodeBench)上自回归生成,记录每个可剪枝线性层在解码步的输入激活 $x^{(m)}_{\ell,t}$,丢弃 prefill 激活,拼成校准矩阵 $X^{AR}_\ell \in \mathbb{R}^{d_{in} \times N_D}$;随后沿用 OBS 类求解器,以 $H = 2X^{AR}_\ell (X^{AR}_\ell)^\top$ 为 Hessian 逐层求稀疏权重。C4 基线与本文方法用同样的 1M 校准 token、同一后端,唯一变量是激活来源。系统侧把剪出的 N:M 权重转成 bitmask 表示,用 Triton 编写的 SpMV 内核解码,在 Llama-3.1-8B、Llama-3.3-70B、Qwen3-14B/32B 上报告 1.34-1.48 倍端到端解码加速,质量全面优于 C4 校准。
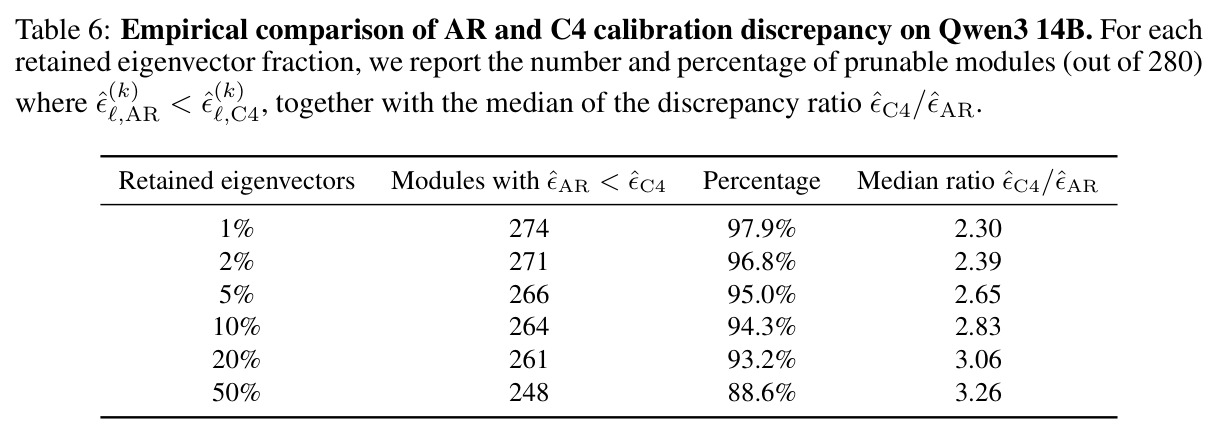
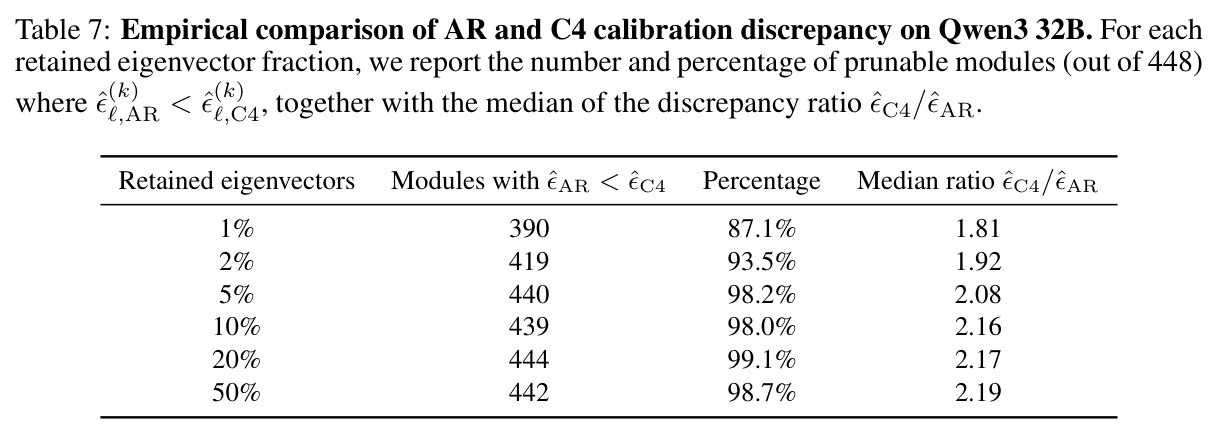
核心创新一:把逐层重构目标从 teacher-forcing 激活换为解码步激活,目标 $\mathcal{L}^{AR}_\ell = \|(W_\ell - {}^cW_\ell)X^{AR}_\ell\|_F^2$ 枚举全部 $N_D$ 个生成 token,求解器一行不改。定理 A.1 给出理论支撑:以解码 Hessian 的前 $k$ 个特征向量为基准投影归一化,定义校准差异 $\epsilon^{(k)}_{\ell,C} = \|\hat{H}^{(k)}_{\ell,C} - I_k\|_{op}$,证明它恰等于最坏情况相对损失上界;实证中 AR 在至少 87% 的模块上差异小于 C4,中位比值 1.81-3.26。核心创新二:SpMV 内核的两个设计——bitmask 索引(每非零仅 2 bit 元数据,比 int32 索引省 16 倍、比 uint8 偏移省 4 倍),与固定步长遍历($M \le 32$ 时每个 32-bit 掩码恰含 16 个 set bit,循环长度编译期固定、可展开,bit-scan 找最低置位得列号后清位继续,线程步数一致、负载均衡)。
方法步骤详情
第一步,生成校准激活:取 $K$ 个任务 prompt,让 dense 模型自回归采样共 1M 个解码 token;hook 记录各线性层输入激活,只保留解码位置 $t \in D_m$、丢弃 prefill,拼成 $X^{AR}_\ell$。第二步,逐层剪枝:构造 $H = 2X^{AR}_\ell (X^{AR}_\ell)^\top$,交给 SparseGPT 迭代——算显著度 $L_q = \frac{w_q^2}{2[H^{-1}]_{qq}}$,删最小者,按 $\delta w = -\frac{w_q}{[H^{-1}]_{qq}} H^{-1}_{:,q}$ 更新剩余权重,直至目标稀疏度(50%、2:4 等)。第三步,模式转换:权重按行存为紧凑数组加 32-bit bitmask,set 位对应非零。第四步,Triton SpMV 解码:每行固定长度循环,位扫描定位下一个非零列、清位继续;输入向量走 .ca 缓存促复用,权重与掩码走 .cg 流式;按模式单独编译并 autotune,必要时 split reduction + atomicAdd。全程只剪一次、无训练。
技术新颖性
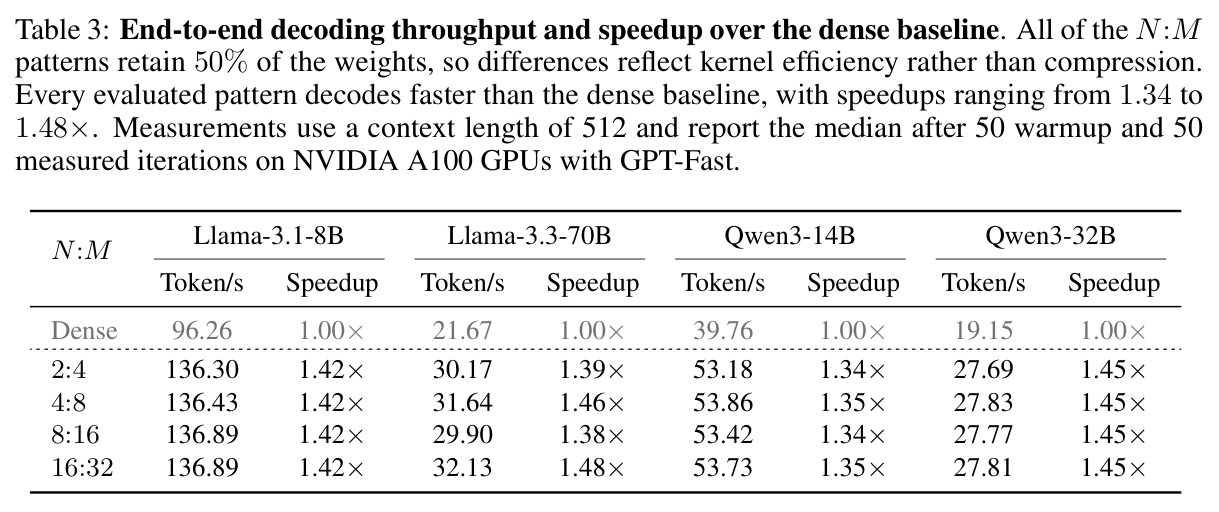
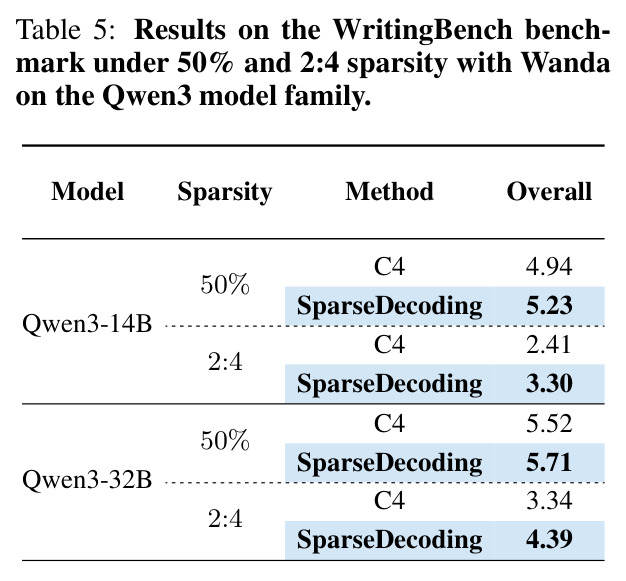
新颖性体现在三点。其一,协议级而非算法级创新:SparseGPT/Wanda 的求解逻辑原封不动,收益完全来自激活来源的更换,因此是即插即用的;Table 5 用 Wanda 复验证明增益与求解器无关。其二,理论闭环:不同于以往只报告困惑度的工作,本文定义了可计算的校准差异 $\epsilon^{(k)}_{\ell,C}$ 并证明其等价于最坏情况相对重构损失差异(定理 A.1),再在 Qwen3-14B/32B 的 280/448 个可剪枝模块上实证 AR 优于 C4(Table 6/7),方法—理论—证据自洽。其三,内核设计抓住 N:M 模式的规则性:不做通用的不规则稀疏加速,而是利用“每个 32-bit 掩码字恰含 16 个 set bit”这一结构性事实,把变长遍历变成编译期常量循环,同时让 2:4、4:8、8:16、16:32 四种 50% 模式拥有完全相同的内存流量,实测吞吐几乎一致(Table 3)。这是与 cuSPARSELt、nmSPARSE 等通用库的本质差别:前者为 prefill 的 SpMM 优化,后者为通用 N:M 计算,都不是为解码 SpMV 定制。
实验结果
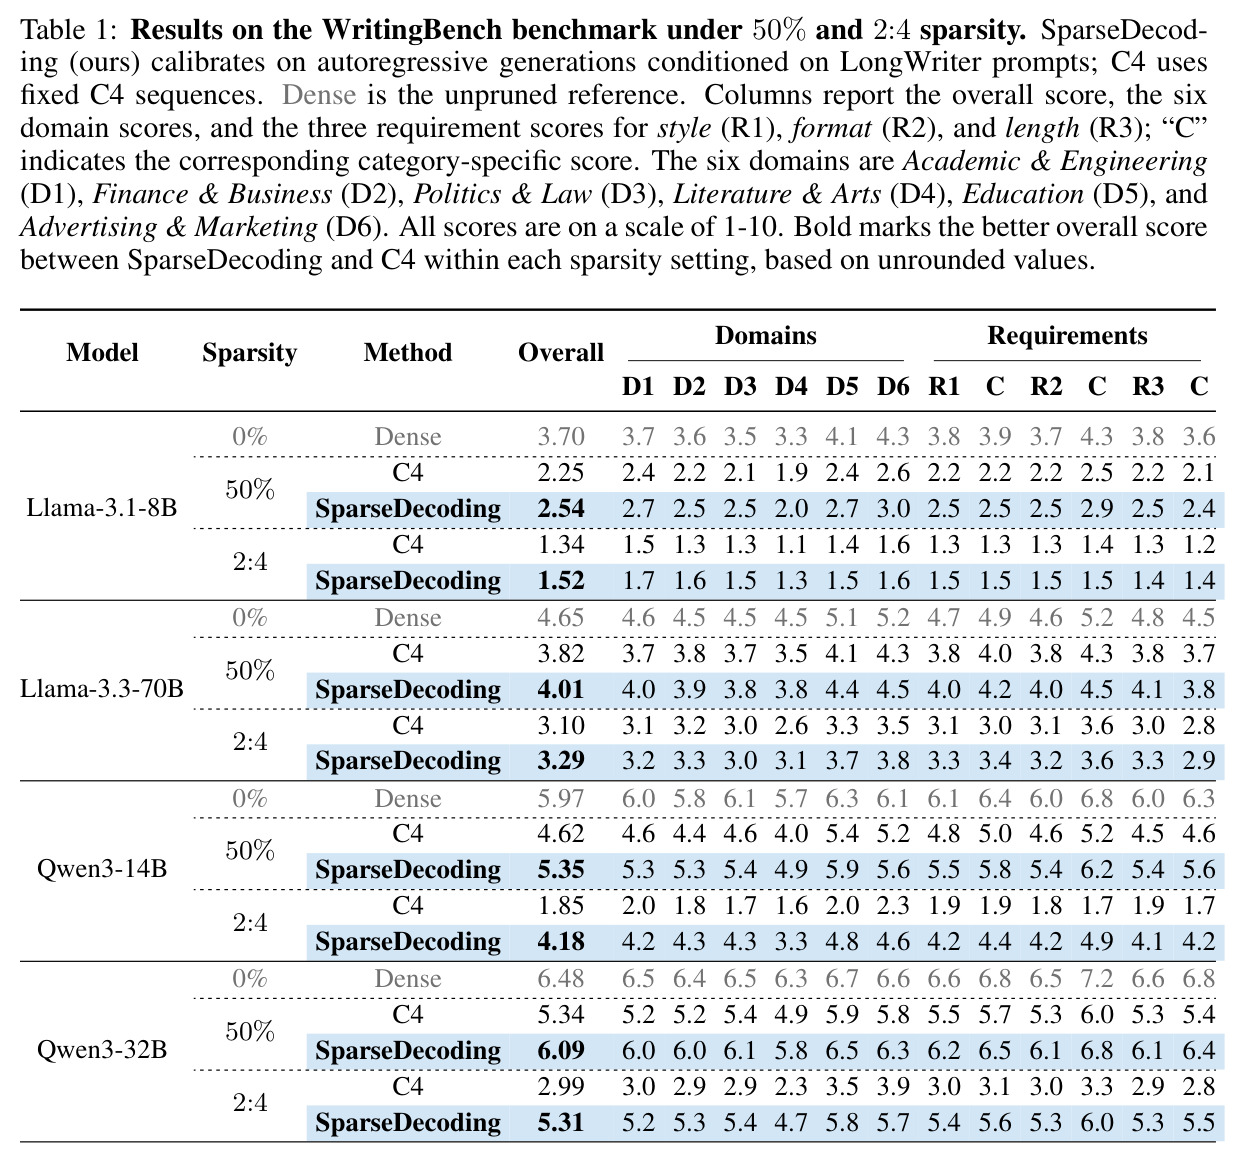
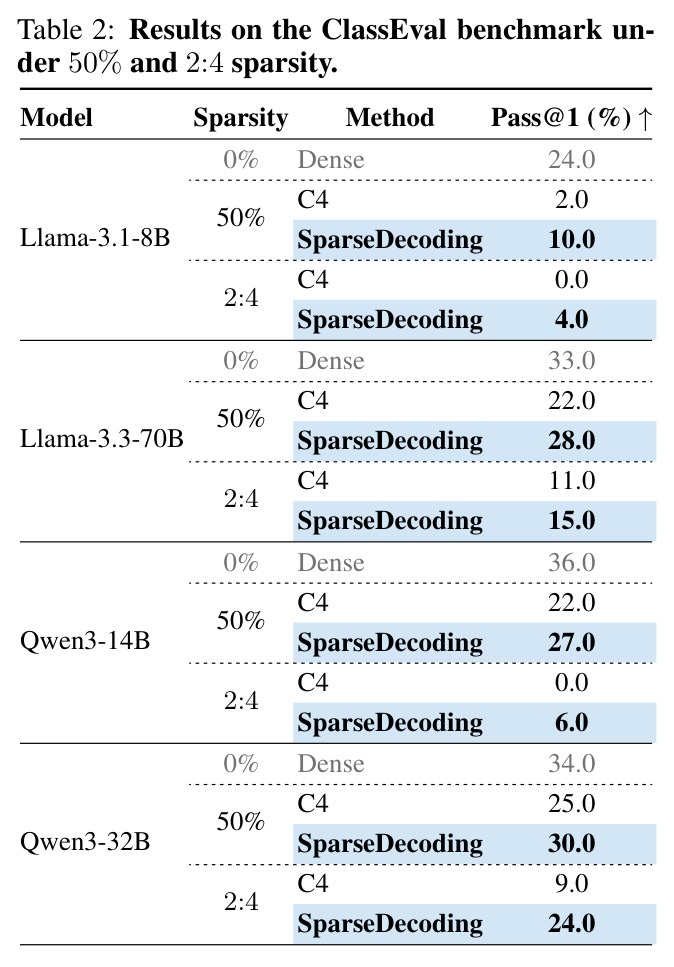
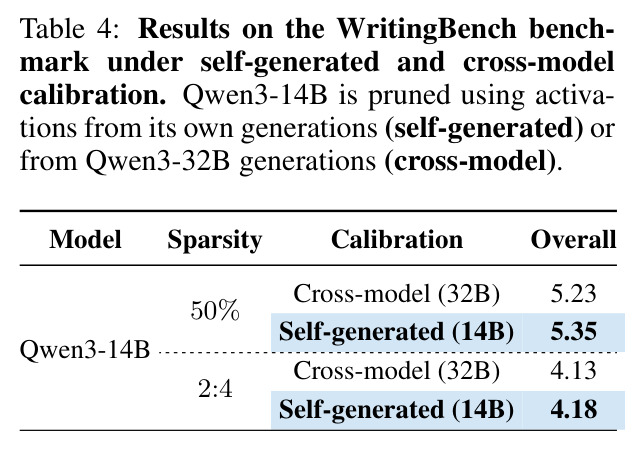
WritingBench(Table 1):50% 稀疏下较 C4 提升 0.19-0.75 分,四模型 2.25→2.54、3.82→4.01、4.62→5.35、5.34→6.09;2:4 下 Qwen 系 1.85→4.18、2.99→5.31,Llama 系 1.34→1.52、3.10→3.29。ClassEval(Table 2):八组合全部领先 C4 4-15 个百分点;2:4 下 Qwen3-32B 9.0%→24.0%,Qwen3-14B 与 Llama-3.1-8B 从 0.0% 恢复到 6.0%/4.0%。内核(Table 3,A100):四种 N:M 模式吞吐几乎相同,解码加速 1.42×-1.48×(70B 21.67→32.13 token/s),而 2:4 Tensor Core 解码仅 0.85-0.87×(Figure 1b)。消融:自生成优于跨模型校准(5.35 vs 5.23、4.18 vs 4.13,Table 4),且在 Wanda 后端(Table 5)、其他语料(Table 9)、8:16 模式(Table 8)下优势保持。
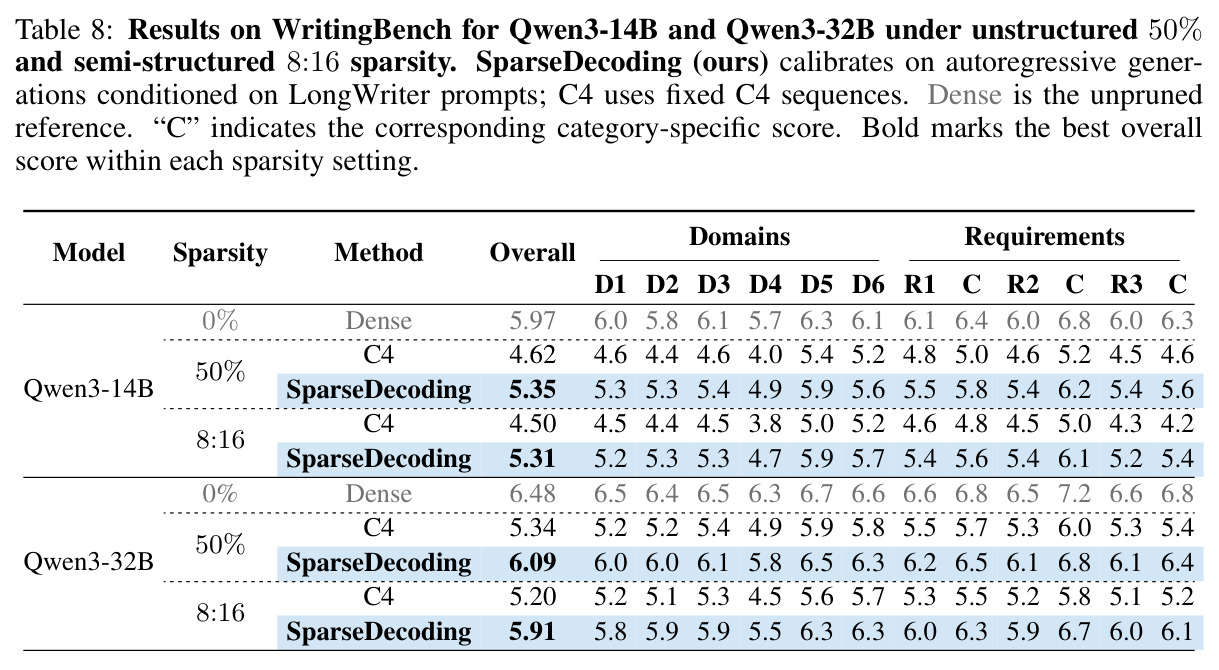
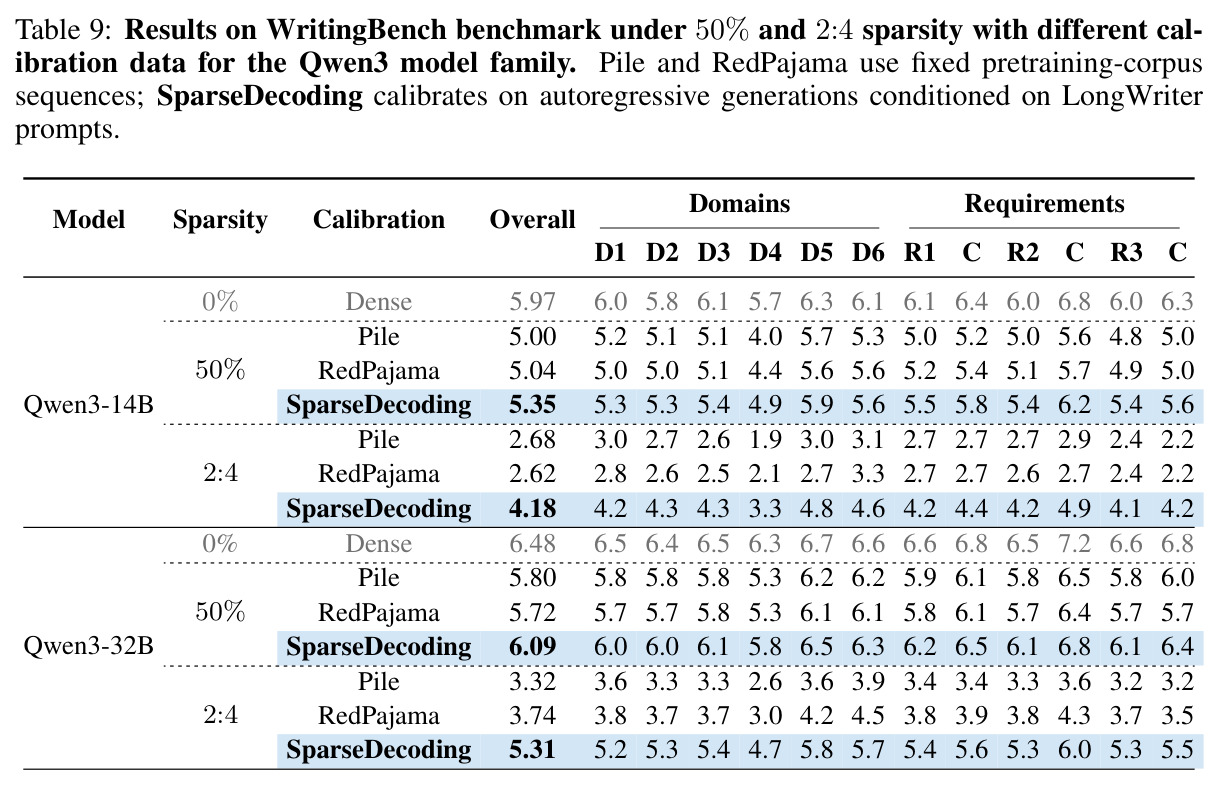
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| WritingBench 长文写作(Qwen3-32B,2:4 稀疏) | Overall 分数(1-10,LLM judge) | 5.31 | C4 校准 2.99(dense 6.48) | +2.32 分 |
| WritingBench 长文写作(Qwen3-14B,2:4 稀疏) | Overall 分数(1-10,LLM judge) | 4.18 | C4 校准 1.85(dense 5.97) | +2.33 分 |
| ClassEval 类级代码生成(Qwen3-32B,2:4 稀疏) | Pass@1 (%) | 24.0% | C4 校准 9.0%(dense 34.0%) | +15.0 个百分点 |
| ClassEval 类级代码生成(Llama-3.1-8B,50% 非结构化) | Pass@1 (%) | 10.0% | C4 校准 2.0%(dense 24.0%) | +8.0 个百分点 |
| 端到端解码吞吐(Llama-3.3-70B,A100,50% N:M 各模式) | token/s 与相对 dense 加速比 | 32.13 token/s(16:32 模式) | dense 21.67 token/s(1.00×) | 1.48× 加速(对比 2:4 Tensor Core 路径解码仅 0.85-0.87×) |
局限与改进
作者承认的边界主要在实验设置:加速实测只覆盖 NVIDIA A100 + GPT-Fast、batch-one/小 batch、固定上下文 512 的场景,其他硬件与推理栈未验证;质量评估依赖 WritingBench 的单一 LLM judge(DeepSeek-V4-Flash),存在主观性与噪声。补充观察:第一,2:4 下质量缺口仍巨大(Qwen3-14B 距 dense 还差 1.79 分,ClassEval 只从 0.0% 恢复到 dense 36.0% 中的 6.0%),说明分布对齐缓解但无法消除半结构化约束的损伤,也未探索与量化或微调补偿的组合;第二,校准本身不便宜——需 dense 模型先自回归生成 1M token,prompt 的 prefill 计算全部作废,对 70B 是不小的离线开销;第三,加速只在 50% 稀疏率验证,更高稀疏率与更细模式未测;第四,理论分析限于解码 Hessian 前 $k$ 个特征方向张成的子空间,对剪枝误差常集中的尾部谱刻画有限;第五,只剪线性层,embedding/lm_head 与 KV cache 未动,内存收益上限受限。
独立分析的弱点
弱点一:校准与评测任务耦合。写作实验用 LongWriter、代码实验用 LiveCodeBench 做校准,本质是任务内分布匹配;换到覆盖之外的新任务(数学、多语言)是否仍有效,缺少迁移实验。改进:任务无关的混合解码校准集或按输入域自动路由。弱点二:解码收益依赖 batch-one/小 batch 假设,在 continuous batching 服务场景 SpMV 会被 SpMM 路径取代,1.48× 的卖点会打折扣;改进:batch 自适应内核,小 batch 走 SpMV、大 batch 切回 cuSPARSELt。弱点三:内核需为每种 N:M 模式单独编译并 autotune,新形状适配成本高;可预编译常用形状。弱点四:WritingBench 上 0.19-0.75 的小分差(尤其 Llama 2:4 的 +0.18/+0.19)未做显著性检验,单 judge 打分可能落在噪声内;应报告多次评测方差或多 judge 投票。弱点五:校准需 dense 先完整生成,未讨论 token 量缩放规律(1M 是否必要、10 万 token 损失多少)。
未来方向
作者在结论中未给出明确的未来方向,以下是基于成果的可延伸路线:其一,on-policy 迭代剪枝——目前校准激活来自剪枝前的 dense 模型,若让剪枝后模型再生成一轮激活、交替执行“生成-剪枝”,可能进一步收窄 $\epsilon$ 差异,并可与 RAC 的思维链重构思路互补;其二,与量化正交组合:50% 稀疏 + INT4/FP4 量化的联合目标与稀疏量化融合内核是明显的下一步;其三,把定理 A.1 的 $\epsilon$ 度量反过来用作校准集选择指标,指导“选哪些 prompt、生成多长、留多少 token”;其四,内核侧扩展到 prefill 与 decode 统一路径、batch>1 的分组 SpMV,并在 H100/Blackwell 等新硬件上重新设计 bitmask;其五,把解码感知校准推广到 MoE 专家剪枝、KV cache 压缩、推测解码 draft 模型压缩等其他压缩维度;其六,补齐服务化场景(continuous batching、投机采样)下的端到端系统评估。
复现评估
论文信息相对充分:模型(Llama-3.1-8B、Llama-3.3-70B、Qwen3-14B/32B)、基准(WritingBench 1000 prompt、ClassEval 100 个类)、评判模型(DeepSeek-V4-Flash)、稀疏配置(50%/2:4/8:16,统一 1M 校准 token)与内核细节(Triton、.ca/.cg 缓存策略、autotune)都写明,附录 C 甚至给出 PTX 缓存操作符层面的说明,项目主页 wang-qitong.github.io/SparseDecoding 汇总了资源。但正文未明确承诺开源代码与剪后权重,SpMV 内核与解码感知校准 pipeline 均需自行实现,复现门槛中等偏高。算力方面:8B/14B 模型单张 A100 80GB 可完成,32B/70B 需多卡或卸载;校准要对每个模型自回归生成 1M token,70B 的离线生成成本可观;WritingBench 评测依赖外部 judge API,结果可能随 judge 版本漂移。总体属于“细节足够、缺官方代码则工作量不小”的可复现级别。
论文图表
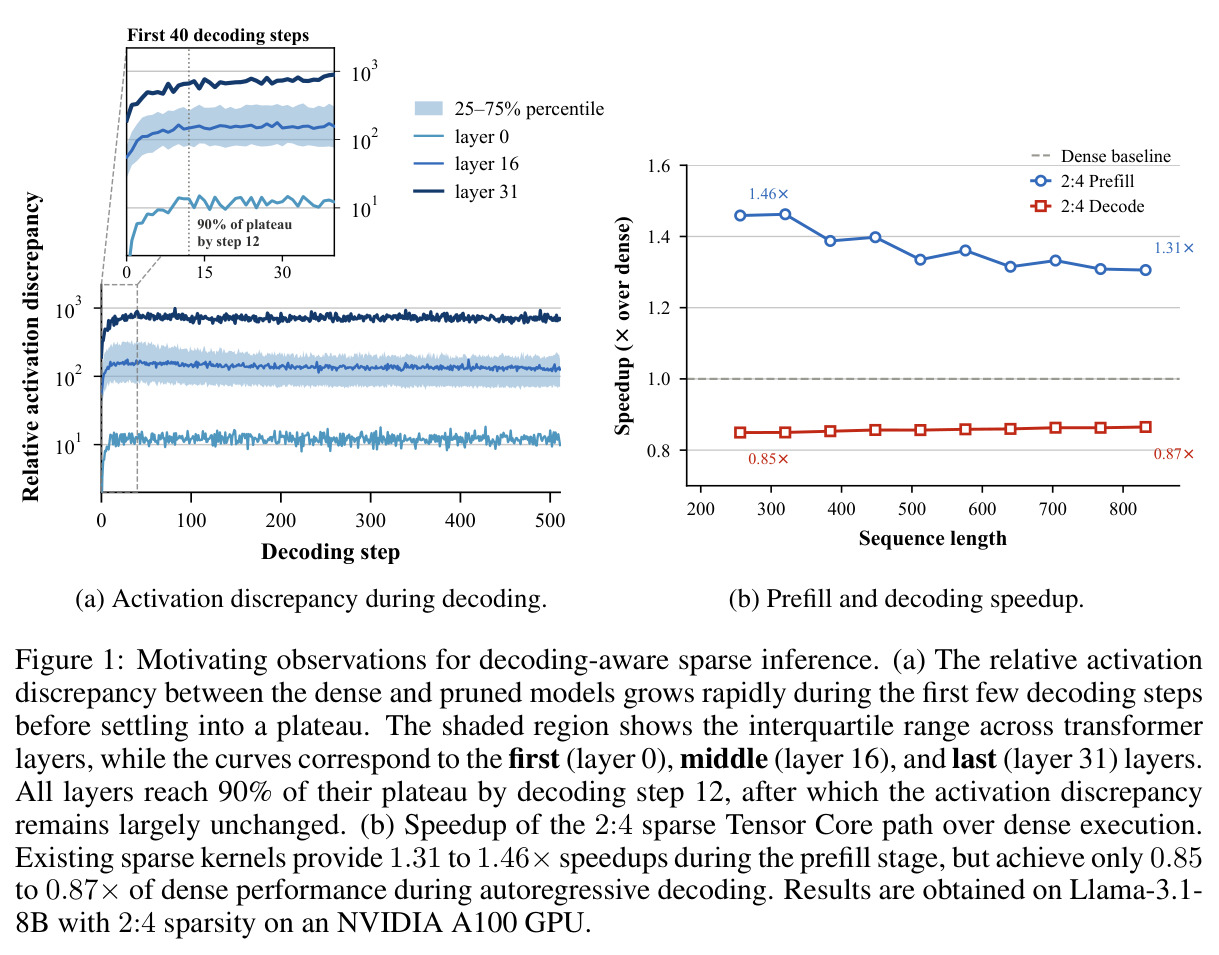
(a) dense 与剪枝模型在自回归解码过程中的相对激活差异:前几步迅速爬升,各层(第 0/16/31 层,阴影为层间四分位距)都在第 12 步内达到平台期的 90%,之后数百步基本不变。(b) 2:4 稀疏 Tensor Core 路径相对 dense 的加速:prefill 阶段为 1.46× 与 1.31×,但自回归解码时只有 0.85× 与 0.87×,即反而比 dense 慢。
这是全文的两个动机实验:一张图同时证明“解码时激活分布漂移真实存在且很快稳定”与“现有稀疏内核在解码阶段失效”,分别对应本文算法侧与系统侧两条工作轴的出发点。