SlimWise:面向高效 MoE 服务的 Prefill 与 Decode 解耦专家剪枝 SlimWise: Decoupling Expert Pruning Across Prefill and Decode for Efficient MoE Serving
解耦两阶段专家剪枝:全模型 Prefill + 剪枝 Decode,解码吞吐最高 1.81 倍
前置知识
MoE(Mixture of Experts)
稀疏激活架构:每层包含大量专家(独立 FFN)和一个 router,每个 token 只被路由到 $k$ 个专家(如 256 选 8)参与计算,从而在总参数量很大的同时保持单 token 计算量小,但所有专家权重都必须驻留显存。
本文的讨论对象就是 MoE 的专家池:如何剪枝、如何按推理阶段分配专家容量,都建立在理解专家激活机制之上。
Prefill 与 Decode 阶段
LLM 推理的两个阶段:prefill 一次性并行处理整段 prompt,每个专家权重可被大量 token 复用,是计算受限的;decode 每步每序列只产出一个 token,权重复用少,反复读显存,是内存带宽受限的。
SlimWise 的核心主张就是两个阶段应配置不同的专家池,理解两阶段瓶颈差异是读懂论文动机的第一步。
Prefill-Decode 分离(PD disaggregation)
把 prefill 和 decode 部署在不同实例上,中间只传输 KV cache,避免长 prefill 干扰 decode 时延,还允许两阶段使用不同硬件与并行策略;PD 合置(colocated)则是单实例内两阶段共存、共享显存。
部署模式决定了剪枝收益的形态:分离部署可以把省下的专家显存换成更大 KV cache 和 batch,合置部署只能靠 router 掩码减少权重流量。
KV cache
注意力机制中缓存的历史 token 的 key/value 张量,decode 时增量追加并复用,避免重算整个前缀;其形状与格式由注意力架构决定,与 MoE 专家数量无关(混合注意力模型中还包含线性注意力的 recurrent 状态)。
KV cache handoff 是本文免训练恢复精度的关键:正因为剪枝不改变 KV cache 格式,全模型 prefill 的输出才能被剪枝解码器零成本接手。
专家剪枝准则(Mass / EAN / REAP)
用校准数据给每层每个专家打重要性分并移除低分者:routing mass 累加门控概率;EAN 度量专家输出范数;REAP 用门控概率加权激活范数。一次前向即可完成打分排序,剪枝时保持每 token 激活数 $k$ 不变。
SlimWise 不发明新准则,而是把三种最新准则作为可插拔组件,实验结论(不同准则下行为差异巨大)依赖对这些准则的理解。
知识蒸馏(KD)
用教师模型的输出分布(经 KL 散度)监督学生模型训练,让学生以更小容量逼近教师行为,常与真实标签的交叉熵损失加权组合;本文只微调极小参数子集,类似 LoRA 的参数高效思路。
本文蒸馏的特殊之处是训练条件与部署条件对齐——让学生练习'从教师 KV cache 续写',理解标准蒸馏才能体会这一差异的价值。
研究动机
MoE 模型每个 token 只激活 $k$ 个专家,但连续批处理(continuous batching)会摧毁这种稀疏性:每个 decode 步骤必须加载批内所有 token 选中专家的并集,期望值为 $E_{distinct} = m\left(1-(1-k/m)^B\right)$,随批大小 $B$ 增大趋近整个专家池。以 Qwen3.6-35B-A3B 为例,256 个路由专家中每 token 仅激活 8 个,专家权重池约 60 GiB;实测 batch=64 时每步已访问约 75% 的专家池。由于 KV cache 容量与逐 token 时延 SLO 限制 batch 上限,每个专家平均摊到不足 10 个 token,专家权重流量成为内存受限解码的主瓶颈。专家剪枝可缩小访问池,但传统做法让 prefill 与 decode 共用同一剪枝模型——而 prefill 是计算受限的,各剪枝比例下吞吐变化仅几个百分点,剪枝等于白白牺牲精度。更隐蔽的是,基准分数会掩盖生成行为扭曲:HumanEval+ 中位输出长度从 2.3k 崩到 0.3k,MATH-500 却从 2.4k 涨到 6.6k。
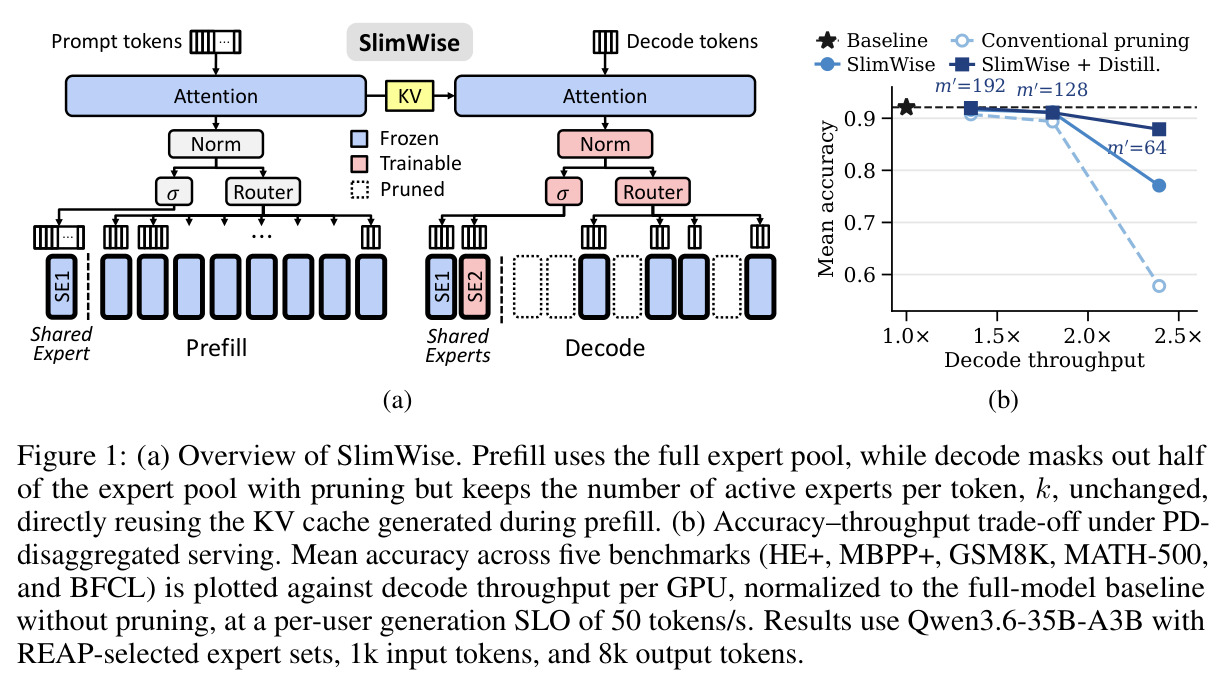
本文的目标是本文要构建一个按推理阶段分别配置专家池的 MoE 服务框架 SlimWise:prefill 阶段运行完整模型,保住提示词表示质量;decode 阶段只使用剪枝后的专家池(每层保留前 $m'$ 个专家、每 token 激活数 $k$ 不变),削减权重流量。关键目标是让剪枝解码器无需任何 KV cache 转换就能直接接管 prefill 生成的 KV cache,从而免训练收回大部分剪枝精度损失;对残余精度损失和生成长度扭曲,再引入一个极低成本的蒸馏阶段(仅约 100M token、只更新 0.42%–2.12% 的参数)加以修复。工程上要求在 vLLM 中同时支持 PD 分离部署(剪枝省下的显存换成更大 KV cache 与 batch)与 PD 合置部署(phase-aware router masking),最终在 50% 专家剪枝下实现最高 1.81× 解码吞吐加速且精度损失极小。
与已有工作不同的是,本文的独特切入是把专家剪枝从'一次性模型压缩'重新定义为'按推理阶段的资源分配'问题。三个关键观察构成切口:其一,prefill 计算受限而 decode 内存受限,同一个剪枝操作在两个阶段的价值完全不同,理应区别对待,而此前所有工作都默认两阶段共用同一模型;其二,专家剪枝不改变注意力架构和 KV cache 格式,因此'完整模型 prefill + 剪枝模型 decode'可以经由 KV cache 零成本衔接——这与 Lynx、OEA、ExFold 等运行时专家选择方法(必须保留全部专家权重、无法释放显存)有本质区别;其三,评估方法学上,作者发现单看 benchmark 准确率会掩盖剪枝对推理长度和终止行为的双向扭曲,提出应把输出长度分布(p50/p90)作为一等评估指标。这三点组合出一个此前未被系统探索的设计空间:phase-aware 的专家容量分配。
核心方法
直觉上,SlimWise 让每个推理阶段各取所需:prefill 批内 token 多、权重复用充分、是计算受限的,用完整专家池不吃亏;decode 每序列每步只产出一个 token、权重流量是瓶颈,用剪枝专家池立竿见影。技术路线分三块:首先离线用校准数据对每层专家按重要性准则(routing mass、EAN 或 REAP)排序,保留前 $m'$ 个构成保留集 $K'_\ell$;然后构造剪枝解码器的两种等价实现——导出仅含保留专家的独立 checkpoint(用于 PD 分离,省下的显存换成 KV cache 和更大 batch),或保留全池但对 router 做掩码(用于 PD 合置,prefill 用原 router、decode 用掩码 router);最后是服务时的 KV cache 交接:剪枝不触碰注意力结构,故 prefill 产生的 KV cache 可被剪枝解码器直接消费,零转换、零重算。若免训练恢复不够充分,再加一段只训练 0.42%–2.12% 参数、约 100M token 的低成本蒸馏,教剪枝解码器'从教师 KV cache 续写'。
核心创新有二。其一是 KV cache handoff:专家剪枝不触碰注意力层,KV cache 的形状与语义和 $m'$ 无关,完整模型 prefill 的输出可被剪枝解码器无缝续用。作者证明剪枝模型与'全池 + router 掩码'数学等价:掩码后 logits 取 $\tilde{z}_i = z_i$(若 $i \in K'_\ell$),否则 $\tilde{z}_i = \tau$(大负值),top-$k$ 只在保留集内选择,且门控重归一化只在选中的 $k$ 个专家上进行,因此每个幸存专家拿到的门控值与真正的剪枝模型完全一致。这意味着免训练交接即可恢复大量精度,且一套 vLLM 实现通过掩码开关就能表达完整模型、传统剪枝、SlimWise 三种模式。其二是面向部署条件的蒸馏:训练时对每条长度 $L$ 的序列均匀采样切分点 $s \in [0, L)$,教师处理前缀 $[0,s)$ 生成 KV cache,学生从该 cache 出发续算剩余 token——精确复现部署时'从教师 cache 续写'的条件分布;传统蒸馏只是 $s=0$ 的特例,消融证明这种对齐本身带来额外增益。
方法步骤详情
第一步,离线校准:在 REAP 校准集(6 个组件、各 4096 条 2048 token 序列)上前向一遍,按 routing mass、EAN、REAP 为每层专家打分排序,保留前 $m'$ 个,输出保留集 $K'_\ell$。第二步,构建剪枝解码器:PD 分离导出只含保留专家的 checkpoint,PD 合置用 router 掩码,两者数学等价。第三步,免训练服务:完整模型做 prefill,KV cache 交接给剪枝解码器做 decode,$k$ 不变。第四步,低成本蒸馏:64k 条序列(不超过 12k token,含 35% APIGen-MT 轨迹,约 282M token,学生只处理切分后约 102M),每条均匀采样切分点 $s$,教师算前缀 KV cache,学生续算,损失 $\mathcal{L} = \alpha\mathcal{L}_{CE} + (1-\alpha)\mathcal{L}_{KD}$($\alpha=0.1$,KD 为教师 top-64 token 的 KL 加残余桶);只训练共享专家、router、归一化层(Qwen3.6 占 0.42% 参数),冻结 SE1、新增零初始化下投影的 SE2 学残差修正,router 学习率取 1/10;8,000 步、4×B200 约 6 小时。第五步,导出:SE1 与 SE2 可合并为一个两倍宽度的标准专家,无需定制算子。
技术新颖性
与已有工作的本质区别体现在四个层面。对比传统专家剪枝(两阶段共用同一剪枝模型):SlimWise 首次把剪枝限定在 decode 阶段、prefill 保持完整模型,并证明两者可免训练衔接。对比运行时专家选择(Lynx、OEA、ExFold):那些方法只在推理时减少批内专家访问但必须保留全部专家权重,而 SlimWise 的剪枝 checkpoint 真正缩小权重驻留,在 PD 分离下省出的显存可转成更大的 KV cache 和 batch——这是运行时方法拿不到的收益。对比剪枝后大规模重训练的工作(Nemotron Nano 2、SlimQwen 等需数十亿 token 重训):SlimWise 的蒸馏只用约 100M token、只更新 0.42%–2.12% 的参数,且训练条件与部署条件精确对齐(从教师 cache 续写),消融证明这种对齐本身就有增益。方法学上,作者首次系统揭示剪枝对生成长度的双向扭曲(剪枝 prefill 导致过早截断、剪枝 decode 导致过度延长),把 p50/p90 输出长度引入剪枝评估,并以表 3 的 Reverse 配置完成归因。
实验结果
实验覆盖 Qwen3.6-35B-A3B 与 Gemma 4-26B-A4B 两个骨干。测量(图 2):batch=64 时每步访问约 75% 的 60 GiB 专家池,prefill 吞吐在各剪枝比例下几乎不动,decode 提升约 1.5×。精度(表 1,50% 剪枝):Qwen3.6+REAP 下 GSM8K 从基线 0.962、传统剪枝 0.949、免训练 SlimWise 0.959 到加蒸馏 0.962,追平全模型;MBPP+ 0.969→0.932→0.967→0.946。Gemma 4+EAN 是免训练失效反例:传统剪枝 GSM8K 0.816,SlimWise 崩到 0.173(生成撞满 32.8k 预算),加蒸馏回升至 0.965,反超 14.9 个百分点。剪枝强度(表 2,REAP,75% 剪枝):HumanEval+ 0.917→0.331→0.856→0.894,GSM8K 0.962→0.742→0.867→0.959;$s=0$ 消融证明用教师 cache 蒸馏更优。归因(表 3):Reverse(剪枝 prefill+完整 decode)MATH-500 中位长度 2.2k 接近基线,SlimWise 为 4.7k 且 p90 撞预算——过长生成源于剪枝 decode,过早截断源于剪枝 prefill。吞吐(图 4):PD 分离、50 token/s SLO 下 50% 剪枝 1.81×、75% 剪枝 2.39×;PD 合置为 1.72×/2.28×。贪心解码下结论一致(图 5)。
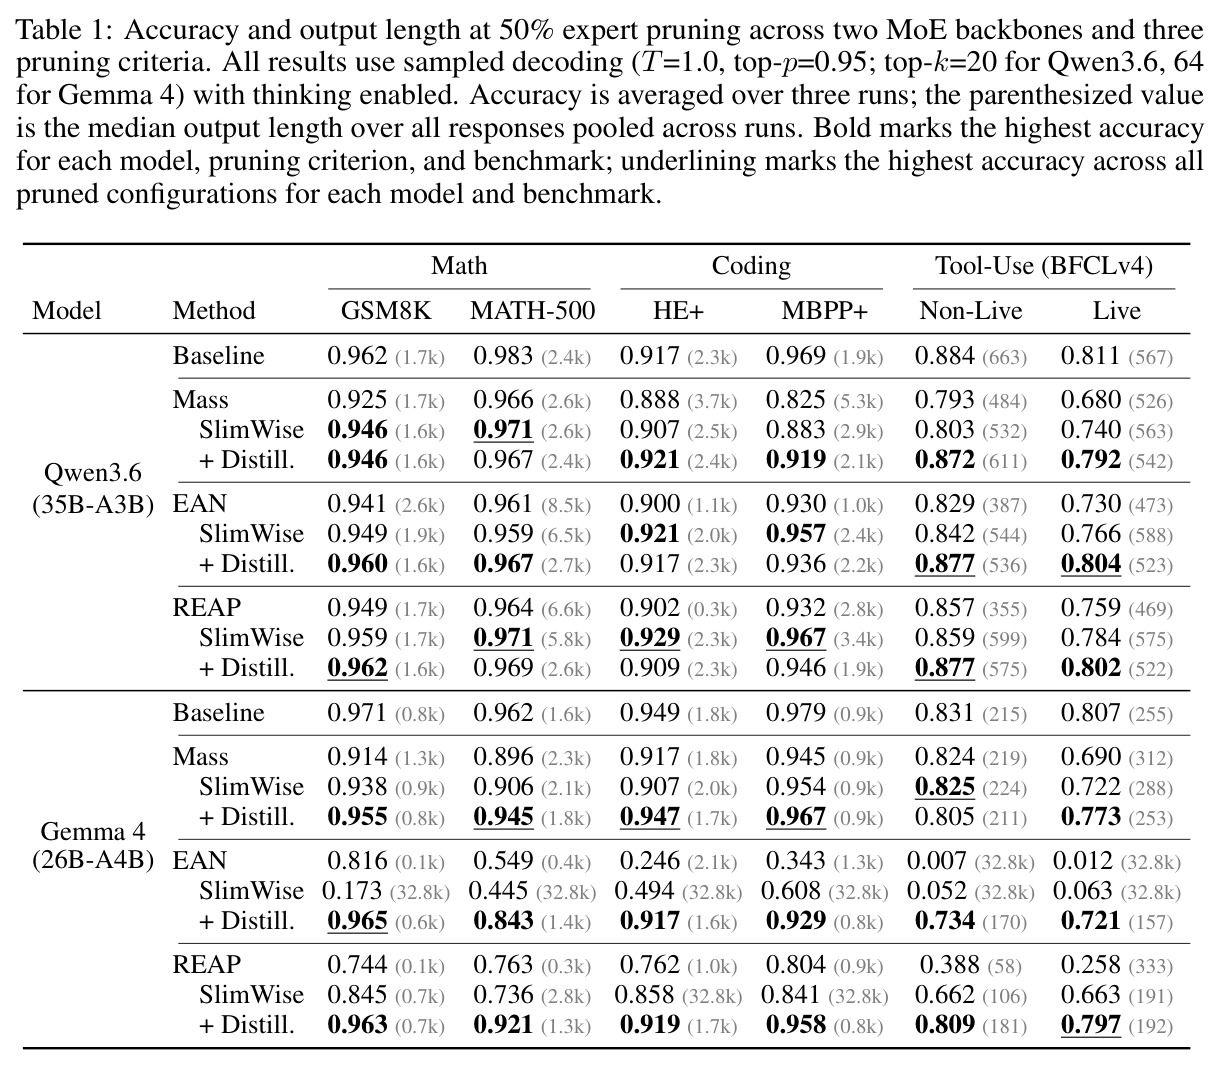
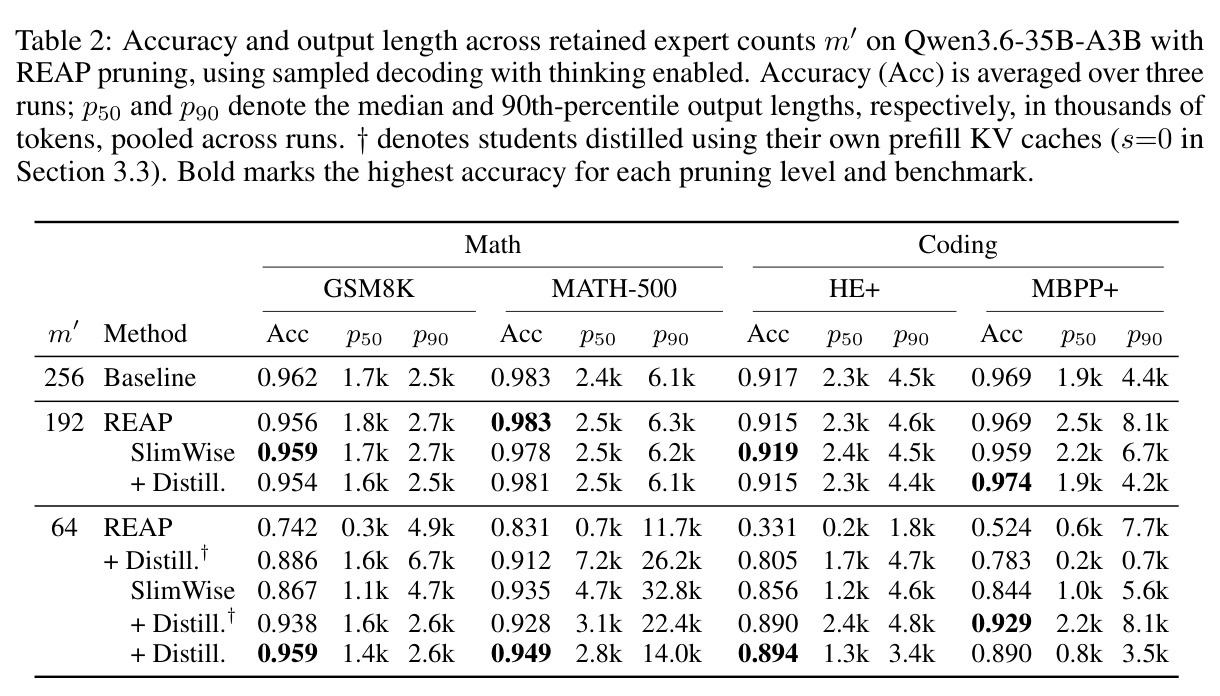
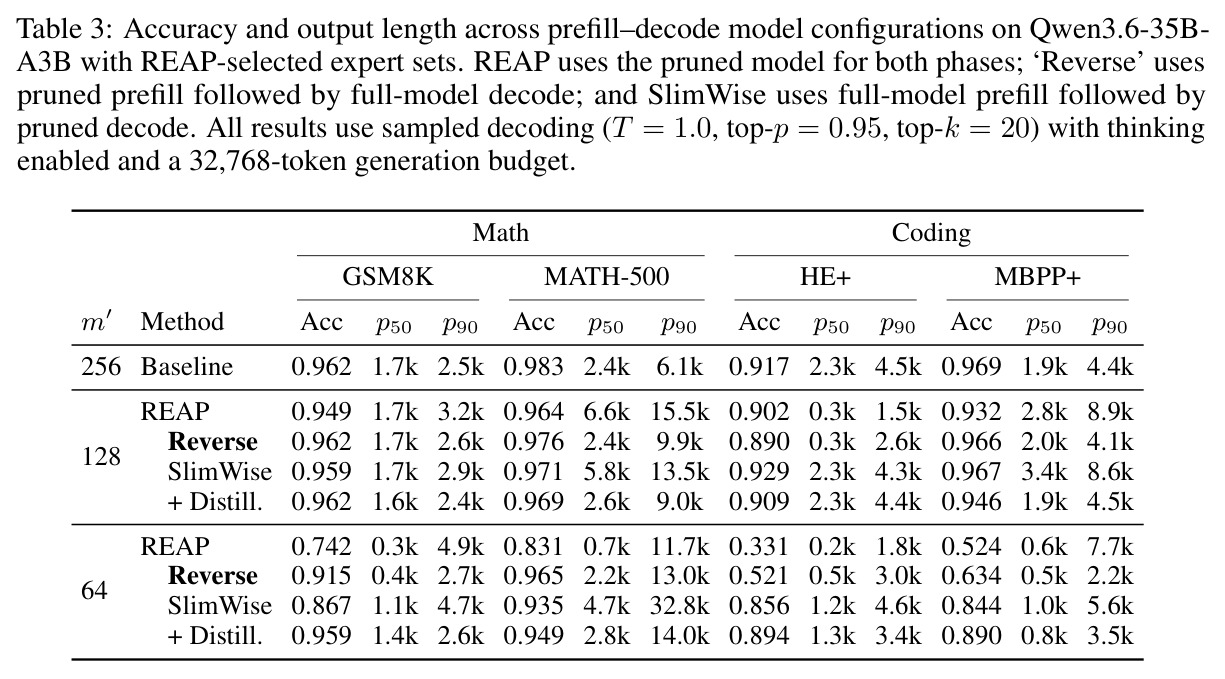
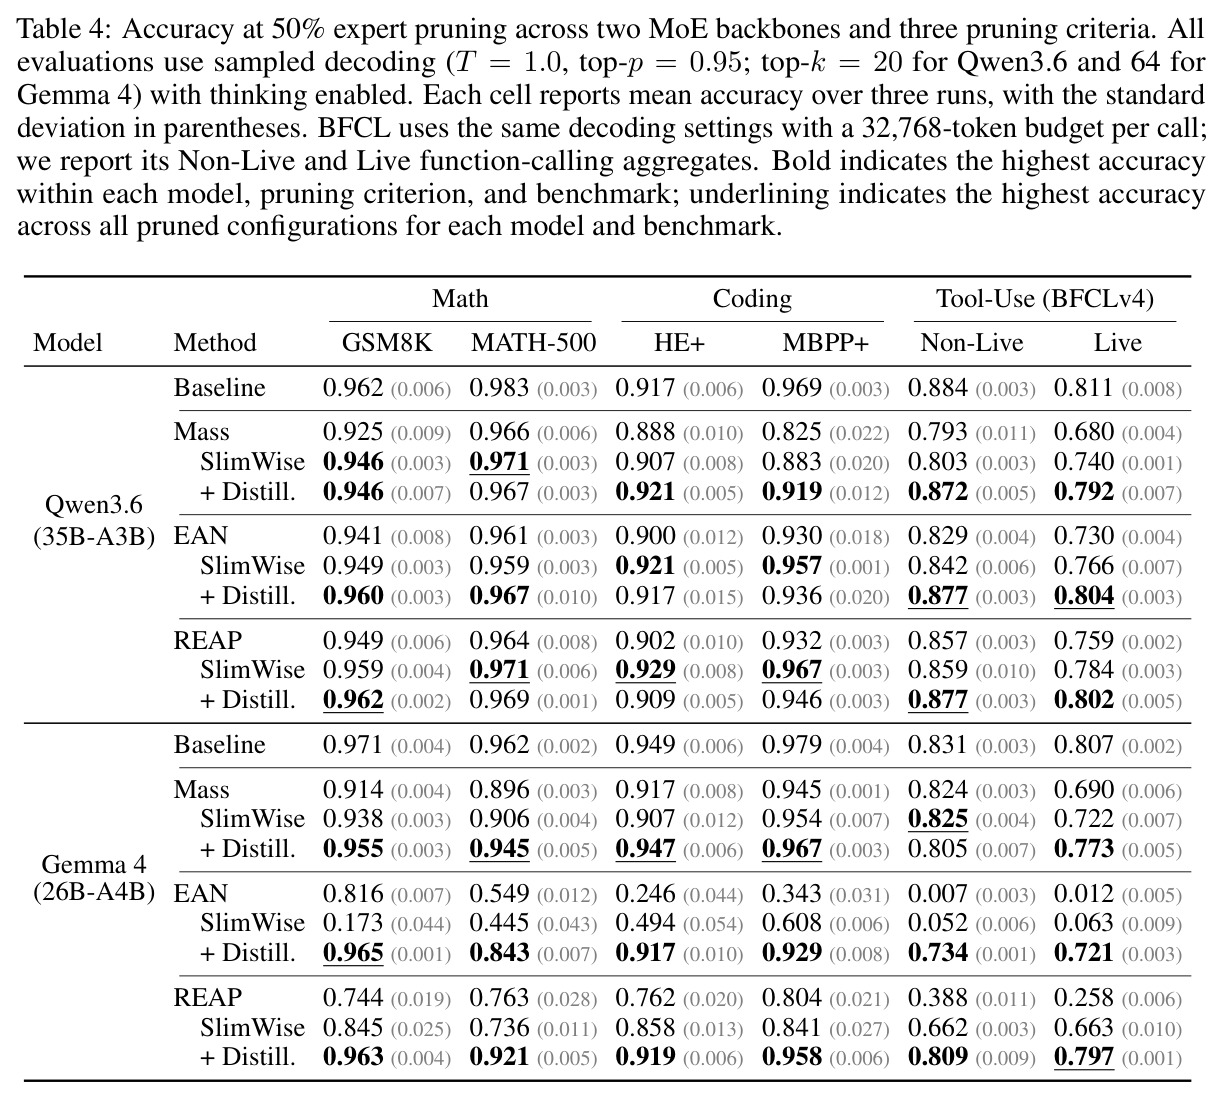
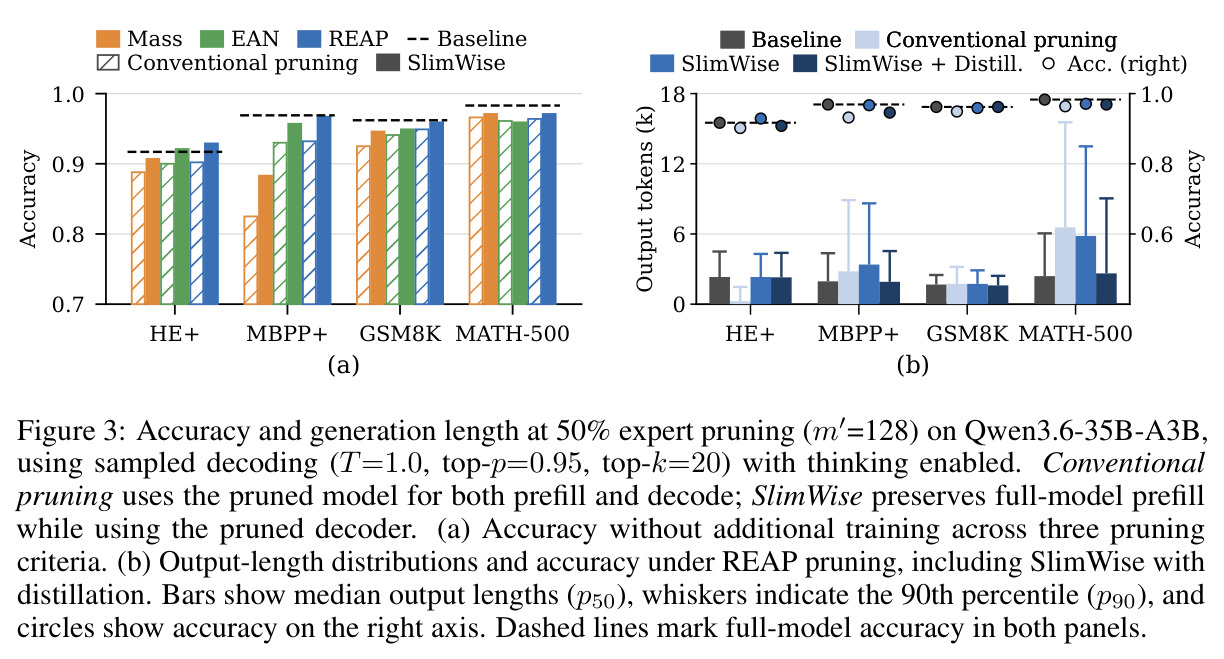
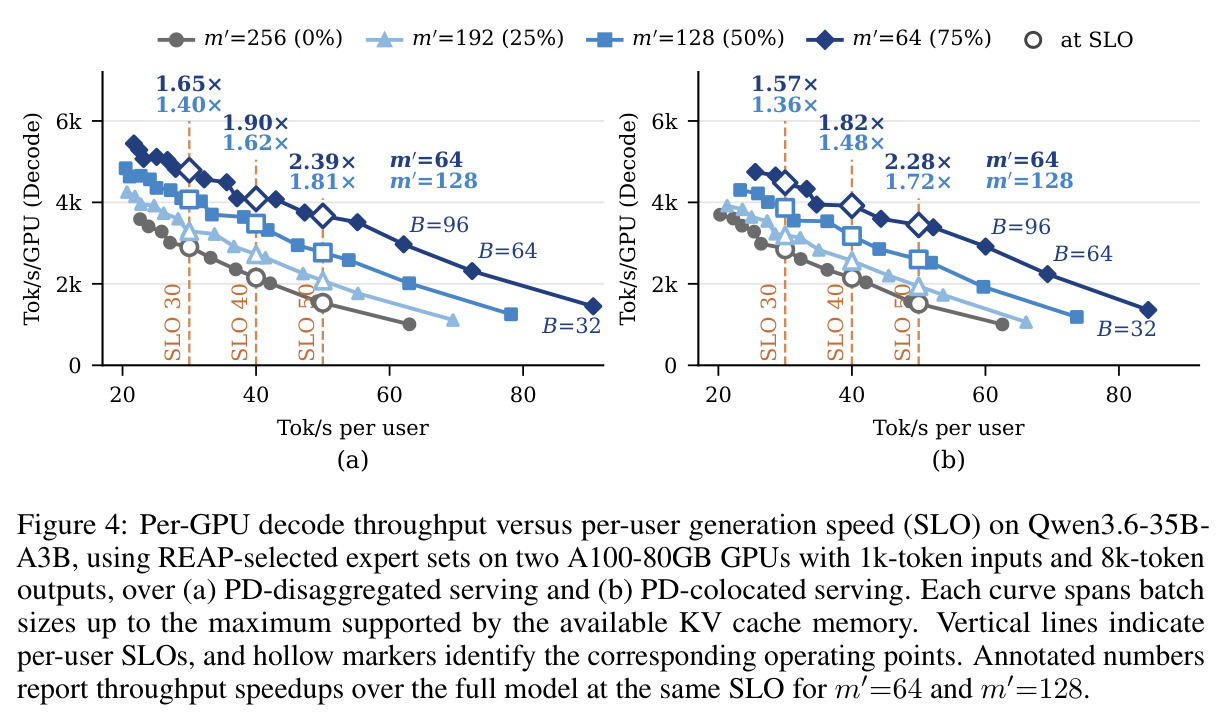
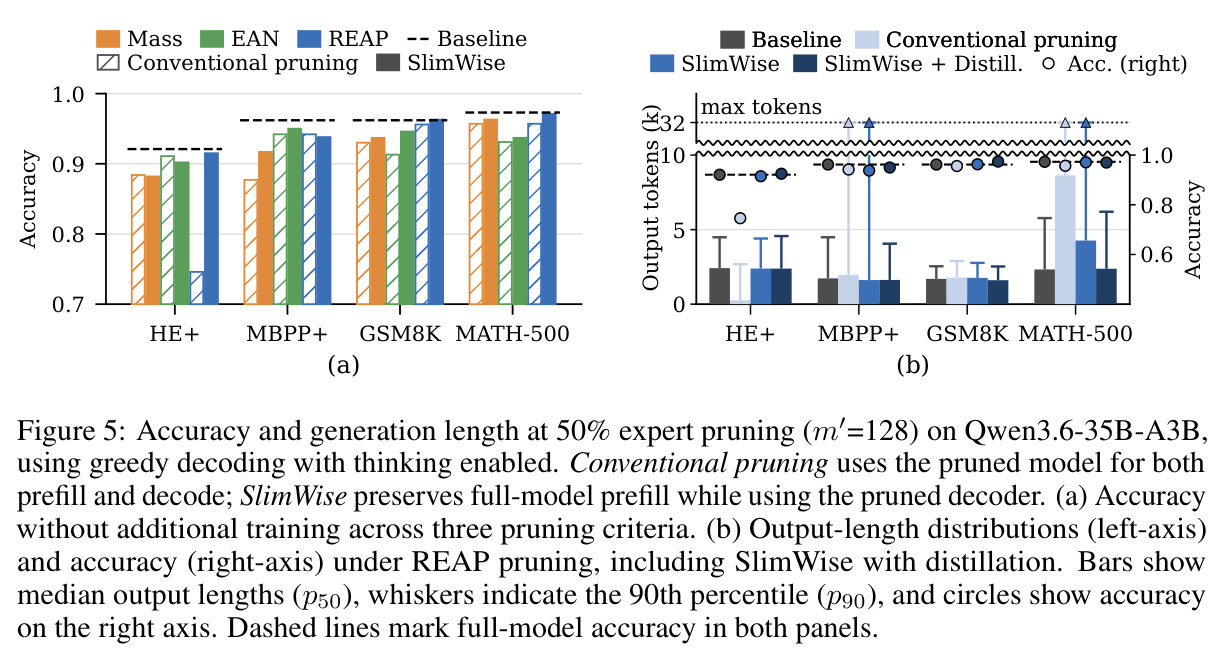
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 解码吞吐(Qwen3.6,PD 分离,50% REAP 剪枝,50 token/s SLO) | 每 GPU 解码吞吐相对全模型倍数 | 1.81×(SlimWise+蒸馏,m'=128) | 1.0×(全模型 m'=256) | +81% |
| 解码吞吐(Qwen3.6,PD 分离,75% REAP 剪枝,50 token/s SLO) | 每 GPU 解码吞吐相对全模型倍数 | 2.39×(m'=64) | 1.0×(全模型) | +139% |
| GSM8K(Qwen3.6,50% REAP 剪枝) | 准确率(3 次运行均值) | 0.962(SlimWise+蒸馏) | 0.962(全模型)/ 0.949(传统剪枝) | 追平全模型,较传统剪枝 +1.3pp |
| HumanEval+(Qwen3.6,75% REAP 剪枝) | 准确率 | 0.894(SlimWise+蒸馏) | 0.917(全模型)/ 0.331(传统剪枝) | 较传统剪枝 +56.3pp |
| GSM8K(Gemma 4,50% EAN 剪枝,崩溃修复案例) | 准确率 | 0.965(SlimWise+蒸馏) | 0.971(全模型)/ 0.816(传统剪枝)/ 0.173(免训练 SlimWise) | 较传统剪枝 +14.9pp,几乎追平全模型 |
| BFCL v4 Live(Qwen3.6,50% Mass 剪枝) | AST 函数调用准确率 | 0.792(SlimWise+蒸馏) | 0.811(全模型)/ 0.680(传统剪枝) | 较传统剪枝 +11.2pp |
| MATH-500(Qwen3.6,75% REAP 剪枝) | p90 输出长度(千 token) | 14.0k(SlimWise+蒸馏) | 6.1k(全模型)/ 11.7k(传统剪枝,免训练 SlimWise 达 32.8k 撞预算) | 长尾长度较免训练缩短 57% |
局限与改进
作者明确承认两点:其一,prefill 成本不变,端到端加速取决于服务时间中 decode 的占比,对长输入短输出的负载(RAG、长文档摘要)收益有限;其二,PD 合置部署保留完整专家池,不减少模型显存占用。我补充观察:第三,即便加蒸馏,75% 剪枝下 MATH-500 的 p90 输出长度仍达 14.0k(基线 6.1k),长尾失真未完全修复;第四,免训练收益并不普适——Gemma 4+EAN 下 SlimWise 免训练精度 0.173 远低于传统剪枝 0.816,说明 KV handoff 在某些准则/骨干组合下会放大失控生成,必须逐配置验证;第五,蒸馏依赖教师模型与 4×B200 级算力,且训练语料 35% 来自 APIGen-MT 智能体轨迹,目标域失配时效果存疑;第六,$m'$ 每层统一、部署后固定,无法响应请求分布漂移;第七,评估限于两个模型与 2×A100 环境,外推到更大专家池或更低端 GPU 未验证;与 token rerouting 方法的正交组合也未做实验。
独立分析的弱点
独立分析四个弱点并给出改进方向。(1) 免训练模式不稳定:Gemma 4+EAN 组合下生成长度全部撞到 32.8k 预算、GSM8K 精度跌至 0.173,说明 KV handoff 并非保险箱;改进方向是在服务层引入轻量在线监控(滑窗生成长度分布、终止率),异常时自动回退完整 router 或触发蒸馏。(2) 端到端收益受 decode 占比天花板约束:TTFT 完全不变,prompt 长而输出短的场景收益微弱;改进方向是给 prefill 配温和加速(如与 ExFold 类 expert folding 正交组合),或在 PD 分离时把 prefill 实例换成更小硬件。(3) 蒸馏配置静态且缺乏消融:$\alpha=0.1$、top-K=64、统一 $m'$ 等关键超参无敏感性分析,逐层统一保留率忽略层间冗余差异;改进方向是补充超参消融、探索敏感度驱动的逐层异构预算。(4) 静态剪枝无法适应负载漂移:某些任务天然依赖长尾专家,固定 $m'$ 会系统性伤害此类请求;改进方向是维护多档位(m'=192/128/64)checkpoint 按流量在线切换,或研究请求级动态保留池。
未来方向
作者在结论中未提出具体后续方向,只列出 prefill 成本不变与 PD 合置不省显存两条局限。基于本文成果可延伸的方向包括:(1) 与 token rerouting / expert folding(Lynx、OEA、ExFold)正交组合——SlimWise 降低专家池上限、这些方法降低批内访问分数,收益理论上可叠乘;(2) 把'从教师 KV cache 续写蒸馏'推广为通用技术:量化、投机解码草稿模型等任何改变解码器的部署,都可用'按部署条件对齐训练'的思路修复精度与行为失真;(3) 对剪枝 decode 导致过度思考、剪枝 prefill 导致过早截断的机理做可解释性分析,可能导向无需蒸馏的定向修复(如针对终止 token 的校准);(4) 逐层/逐专家异构剪枝率与混合专家池(热门专家常驻 + 长尾专家按需加载)以及多档位弹性切换的服务层调度;(5) 在含线性注意力 recurrent 状态的混合模型上系统验证 KV handoff 边界,并扩展到多模态 MoE;(6) prefill 侧轻量加速,解除端到端收益对 decode 占比的依赖。
复现评估
论文未给出开源代码链接,但实现细节披露充分:基于 vLLM,支持 PD 分离与合置;校准集为 REAP mixture(6 个组件 × 4096 条 2048 token);评估用 lm-evaluation-harness 与 Math-Verify,GSM8K 五示例取前 500 题、MATH-500 四示例、HumanEval+/MBPP+ 零样本、BFCLv4 原生函数调用,采样 T=1.0、top-p=0.95、thinking 开启、32,768 token 预算,指标为三次运行均值(表 4 附标准差)。蒸馏配置完整:64k 序列(每条不超过 12k token)、8,000 步、AdamW、batch 8、lr $10^{-4}$(router $10^{-5}$)、$\alpha=0.1$、top-64 KL,4×B200 约 6 小时。复现需要两个骨干模型权重及 open-perfectblend、APIGen-MT 数据;评估 2×A100-80GB 即可,蒸馏需 4×B200 级算力。难点在 vLLM 中 phase-aware masking、KV handoff 与师生共享冻结张量同卡训练的工程改造,属中高难度;若作者开源可降为中等。
论文图表
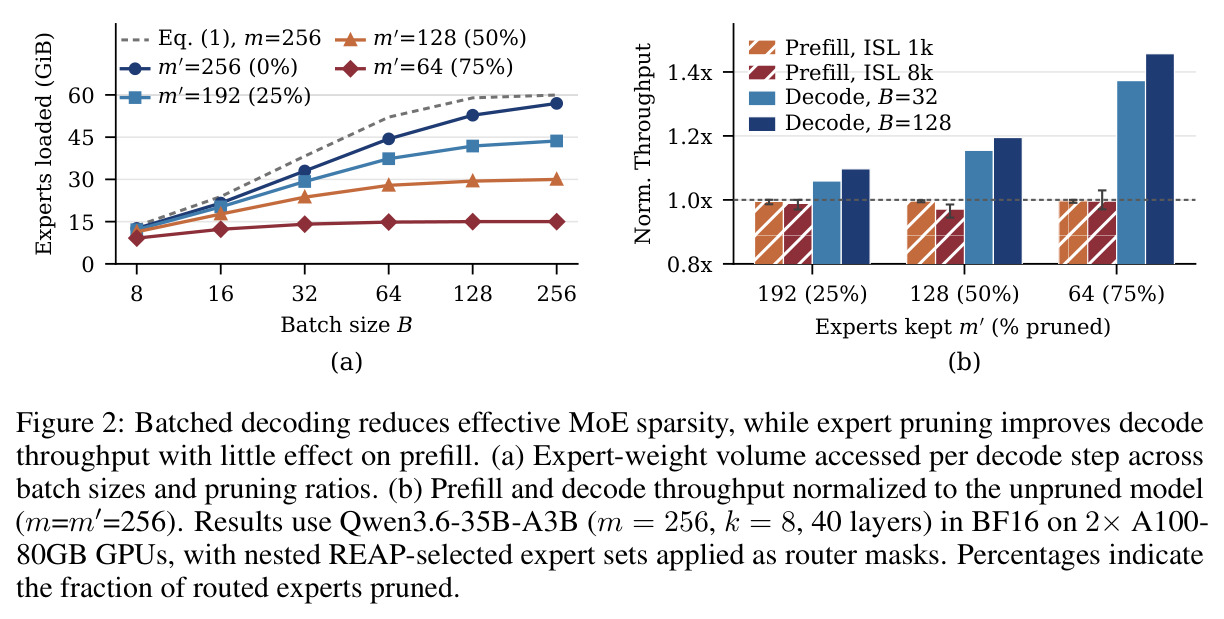
(a) 显示 Qwen3.6-35B-A3B 在 2×A100 上每个解码步加载的专家权重:batch=64 时约 75% 的 60 GiB 专家池被访问,batch 继续增大趋近全量,剪枝把饱和上限降到 m'/m;(b) 显示各剪枝比例下 prefill 吞吐变化不足几个百分点,而 decode 吞吐提升最高约 1.5×,证明两阶段瓶颈不对称。
这张图是全文动机的实证基础:它量化了'批处理摧毁 MoE 稀疏性'和'剪枝只对 decode 有吞吐收益'两个关键论断,没有它就无法理解为什么两阶段应该区别对待。