分层稀疏注意力:在极端稀疏下缩小稀疏与稠密注意力的差距 Stratified Sparse Attention: Reducing the Sparse-to-Dense Gap at Extreme Sparsity
以分数引导采样补充top-k检索,在极端稀疏下逼近稠密注意力并获2.96倍解码加速。
前置知识
KV缓存与解码带宽瓶颈
自回归解码时,每生成一个新token,其query都要与之前所有token的Key/Value(KV缓存)做注意力计算。KV缓存存放在GPU高带宽显存HBM中,每步都需搬运到片上SRAM参与计算,成本随上下文长度线性增长,使长文本解码成为内存带宽受限问题:上下文越长,每步读取缓存的数据量越大。
本文的全部动机与加速比都围绕'减少KV缓存读取量'展开。不理解解码为何受限于HBM带宽,就无法理解稀疏注意力为何能带来端到端加速,以及为何1M上下文时batch越大加速越高。
稀疏注意力与确定性top-k检索
稀疏注意力只让query访问KV缓存的一小部分(如$1/50$)而非全部$N$个token。主流做法是确定性检索:用近似的代理分数(如Quest、PQCache)选出得分最高的top-k个token参与注意力计算,输出为重集内的加权求和。它方差低,但当注意力分布弥散或长尾时,top-k之外的注意力质量被完全丢弃,产生与稠密注意力的差距。
SSA的第一层'分层'就建立在top-k检索之上,论文的主要对比基线PQCache与vAttention也属于这一类。必须先理解其机制与失效模式(漏掉残差注意力质量),才能理解SSA为什么要补一层采样。
重要性采样与逆概率加权
蒙特卡洛估计技术:要估计 $\mu = \mathbb{E}_{x\sim p}[f(x)]$,可从提议分布 $q(x)$ 抽样并用重要性权重 $p(x)/q(x)$ 校正。只要 $q$ 在贡献大的区域抽得更多,同样样本数下方差更低。在注意力场景下,每个被选中token的权重乘以 $1/\pi_i$($\pi_i$ 为其入选概率),即可无偏估计稠密注意力输出。
SSA的核心创新是把残差token的均匀采样替换为按代理分数引导的重要性采样,并用入选概率 $\pi_i = 1-(1-p_i)^m$ 做逆概率校正。这是读懂算法流程与第4.2节误差理论的关键前置知识。
PQ量化代理分数
乘积量化把每个key向量切成若干子空间,各自用码本质心近似,查询时通过查找表快速累加出 $q^\top k$ 的近似分数,无需读取完整key。论文中每个key仅需16字节PQ码(16个子空间×256个质心),而fp16的KV对在head dimension 256时占1KiB,全库扫描的字节开销缩小约60倍。
SSA的'分数引导'依赖廉价的代理分数,实验全部采用PQCache的PQ分数构造提议分布。理解PQ的近似本质也有助于理解误差界中提议质量参数 $\rho$ 的来源。
评测基准:RULER-HARD、LOFT、AIME
RULER是长上下文能力综合评测(32K-128K),其HARD子集在50倍稀疏下能明显拉开方法差距;LOFT是长文本任务集,本文用它测注意力相对L2误差与subspan-EM;AIME 2025是数学竞赛题集,需要32K token长生成,考察稀疏注意力在长链推理中的抗崩塌能力;LongBench覆盖10K-16K多任务。
论文的核心数字(如RULER-HARD 84.17、AIME 59.8、注意力误差下降)都来自这些基准。理解各基准测什么、难度在哪,才能判断各表格中提升幅度对应的实际意义。
研究动机
长上下文LLM推理中,每生成一个token都要对不断增长的KV缓存做注意力,成本随上下文线性增长,1M上下文时解码严重受限于HBM带宽。稀疏注意力通过只访问部分缓存缓解这一问题,但现有三类方法各有硬伤。确定性top-k检索(PQCache、Quest,以及扩展到top-p的Tactic)只保留代理分数最高的token,当注意力分布弥散或长尾时会漏掉大量真实注意力质量。纯采样方法(如MagicPig用LSH重要性采样)覆盖更广,但采样方差大,预算受限时离稠密注意力反而更远。混合方法(vAttention把top-k与均匀残差采样结合)虽兼顾置信与覆盖,但均匀采样完全无视残差注意力质量高度非均匀的分布——论文Figure 1显示,在50倍稀疏下,分数引导的重要性采样相对L2误差始终低于均匀采样。结果是激进稀疏下与稠密注意力的差距仍显著:Llama-3.1-8B在RULER-HARD 128K上PQCache仅39.73分,而稠密注意力为71.26。
本文的目标是本文的目标是:在固定注意力预算(如50倍稀疏)下,设计一种同时利用'确定性高置信token'与'残差分布形状信息'的稀疏注意力方法,大幅缩小与稠密注意力的准确率差距,同时保持足够低的选token开销,使精度优势真正转化为端到端解码加速。具体分解为三点:其一,在从3B到27B的五个模型(Llama-3.1-8B-Instruct、Qwen3.5-4B/9B、Ministral-3-3B/8B-Instruct-2517)与RULER、LongBench、LOFT、AIME四大基准上,系统性超过确定性top-k、纯采样与混合三类基线;其二,提供严格的 $(\epsilon,\delta)$ 理论误差界,刻画有限预算下对稠密注意力的逼近程度;其三,开发CUDA/Triton优化内核,在1M上下文上实现对FlashInfer稠密解码的实际加速。
与已有工作不同的是,本文的独特切入是把统计学中的'分层抽样'思想引入稀疏注意力:不把预算统一花在一种选择机制上,而是划分为确定性层与随机层——高置信token确定性保留(利用,exploitation),残差token按代理分数引导的重要性采样探索(探索,exploration)。关键洞察来自一个简单观察:残差注意力质量虽集中于top-k之外,但并非均匀分布,代理分数仍能指示哪些残差token更可能携带质量。此前混合方法vAttention只用均匀采样对待残差,等于扔掉这一信息;纯采样方法则完全放弃确定性保留。SSA进一步把top-k、top-p与hybrid top-k+采样统一为重要性采样框架的特例,并首次给出显式误差界:误差按 $A_R\rho/\sqrt{m}$ 缩放,其中 $A_R$ 为残差注意力质量、$\rho$ 为提议覆盖度、$m$ 为采样预算,且去重只引入普适常数因子 $\kappa(c)$ 的损失。
核心方法
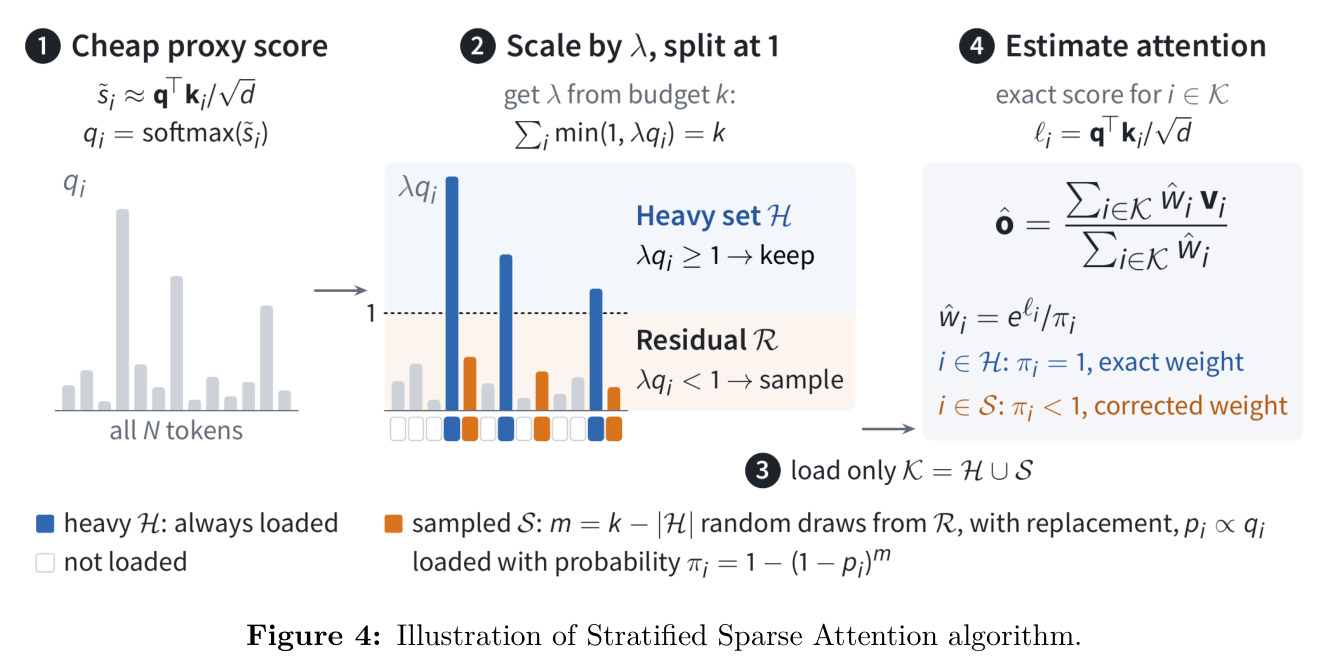
直觉上,稀疏预算有限时最值得花在两类token上:(1)几乎肯定重要的高置信token,应确定性保留;(2)残差中'可能重要'的token,应按代理分数抽样,命中后用逆概率校正还原其真实贡献。技术上SSA(Algorithm 1)分三阶段:第一阶段用softmax把代理分数 $\tilde{s}_i$ 转为概率 $q_i$,求 $\lambda>0$ 使 $\sum_i \min\{1,\lambda q_i\}=k$,凡 $\lambda q_i\geq 1$ 的token构成确定性重集 $H$,剩余预算 $m=k-|H|$ 自动分给残差采样——无需人为指定heavy set大小;第二阶段把代理分布在残差集 $R=[N]\setminus H$ 上归一化为提议 $p_i$,做 $m$ 次有放回多项式抽样并去重得 $S$,$K=H\cup S$;第三阶段对 $K$ 中每个token计算精确分数 $\ell_i = q^\top k_i/\sqrt{d}$,以校正权重 $\hat{w}_i=\exp(\ell_i)/\pi_i$ 加权($\pi_i=1-(1-p_i)^m$),输出归一化加权和 $\hat{o}$。理论上误差被界为 $\|\hat{o}-o\|_2 \leq \frac{4\sqrt{2}}{\kappa(c)}\sqrt{1-\epsilon_D(\delta)}\,\frac{A_R\rho}{\sqrt{m}}\sqrt{\log(4/\delta)}\,\|V\|_2$,达到精度 $\epsilon$ 只需 $m=O(A_R^2\rho^2\epsilon^{-2}\log(1/\delta))$。
核心创新是'分数引导的分层'取代'均匀混合'。与vAttention的本质区别在残差采样的提议分布:vAttention在残差上均匀抽样,SSA用同一代理分数构造提议 $p_i$,让采样偏好可能携带残差注意力质量的token,再通过 $\pi_i=1-(1-p_i)^m$ 的逆概率校正保持估计的一致性,从而把'coverage'与'exploitation'同时做到。理论误差界清晰揭示了权衡结构:误差 $\propto A_R\rho/\sqrt{m}$,其中 $A_R$ 是重集留下的真实残差注意力质量(确定性层越大 $A_R$ 越小),$m$ 是采样预算;$\rho=\max_{i\in R} a_i/\bar{a}_i$ 衡量代理分数对残差的覆盖质量。另一个关键点是预算分配的自动性:$\lambda$ 的存在使heavy set大小与采样预算随每个query的分数分布自适应决定,不引入新超参。去重导致的有放回重复抽样问题被证明只引入普适常数 $\kappa(c)=(1-e^{-c})/c > 1-e^{-1}$ 的损失。这使SSA成为统一收纳top-k、top-p、hybrid的一般框架,并能直接继承任何代理分数检索方法的进步。
方法步骤详情
算法1输入代理分数 $\{\tilde{s}_i\}$、query $q$、KV缓存与总预算 $k$。步骤1-2:softmax把代理分数转为概率 $q_i$。步骤3:数值求解 $\lambda>0$ 满足 $\sum_i\min(1,\lambda q_i)=k$。步骤4:划分重集 $H=\{i:\lambda q_i\geq 1\}$、残差集 $R=[N]\setminus H$、采样预算 $m=k-|H|$;此时每个残差token的期望抽取次数 $mp_i=\lambda q_i<1$,天然抑制重复。步骤5:$p_i=q_i/\sum_{j\in R}q_j$。步骤6-7:从 $p$ 有放回抽 $m$ 次(多项式分布),去重得 $S$,$K=H\cup S$,故 $|K|\leq k$。步骤8-10:入选概率 $\pi_i=1-(1-p_i)^m$($H$ 中为1)。步骤11-15:对 $K$ 计算精确分数 $\ell_i=q^\top k_i/\sqrt{d}$ 与校正权重 $\hat{w}_i=\exp(\ell_i)/\pi_i$,返回 $\hat{o}=\sum_{i\in K}\hat{w}_iv_i/\sum_{i\in K}\hat{w}_i$。GPU实现四阶段:每key仅16字节PQ码(16子空间×256质心)算代理分,sink/local掩码在同一内核完成;radix top-k选出不排序的 $H$;两级分层采样器(先选1024-token块、再选32-token子块、最后扫至多32个token)降低采样开销,per-row哈希表去重,$\pi_i$ 截断于 $10^{-4}$,counter-based RNG兼容CUDA graph;最后从paged KV缓存gather并在线softmax计算,query head按块并行、log-sum-exp稳定归并。
技术新颖性
第一,框架统一性:通过改变预算在确定性与随机性之间的分配方式,top-k(全部预算给重集)、top-p(按累计质量截断)、hybrid top-k+均匀采样都是该重要性采样框架的特例,首次把稀疏注意力的选择机制统一在逆概率加权估计器之下,并能即插即用任何提供代理分数的近似检索方法。第二,理论保证:给出 $(\epsilon,\delta)$ 形式的谱范数误差界,显式刻画残差质量 $A_R$、提议质量 $\rho$、预算 $m$ 与去重常数 $\kappa(c)$ 的作用,并证明样本复杂度 $m=O(A_R^2\rho^2\epsilon^{-2}\log(1/\delta))$——vAttention等混合方法没有此类保证。第三,系统实现:为'采样'这一top-k方法不具备的操作设计了高效内核——两级分层采样器把采样开销较纯chunk路由降低1.21-3.16倍,16字节PQ码让全库扫描只读几字节/token,1M上下文上64路split比32路快1.58-1.71倍,配合counter-based RNG兼容CUDA graph。这让统计优势落地为实测加速:batch 16、50倍稀疏时解码注意力较FlashInfer快2.96倍,与许多只做算法改进、无法端到端提速的工作形成对比。
实验结果
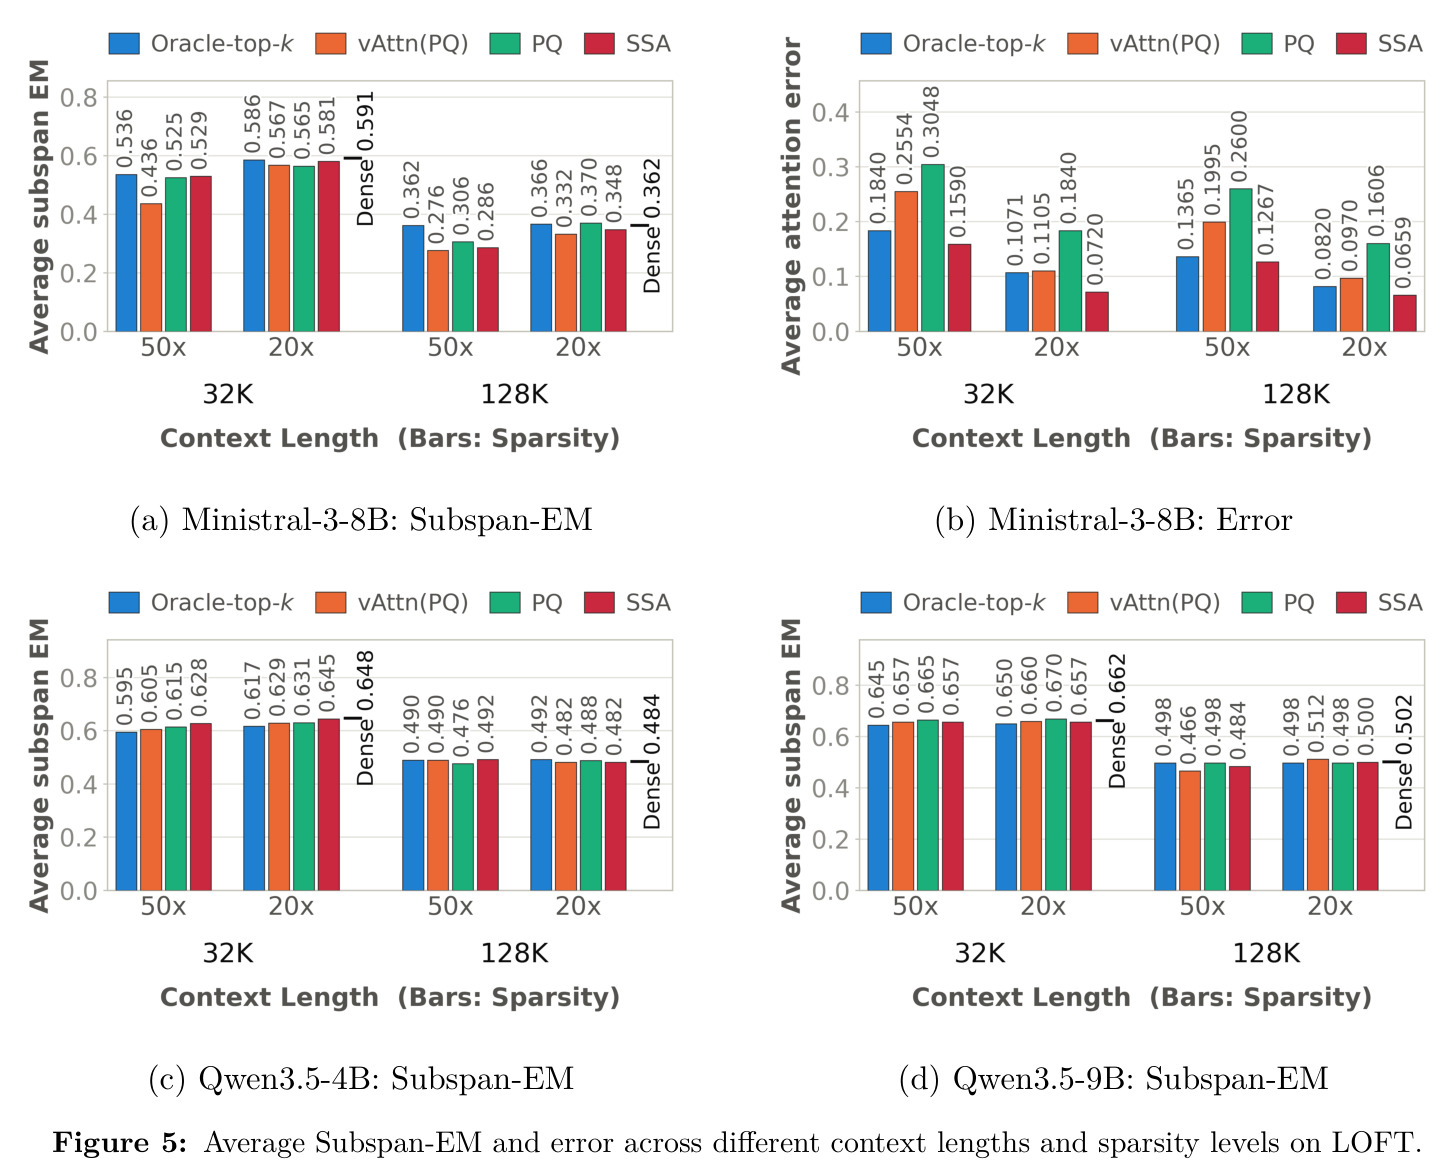
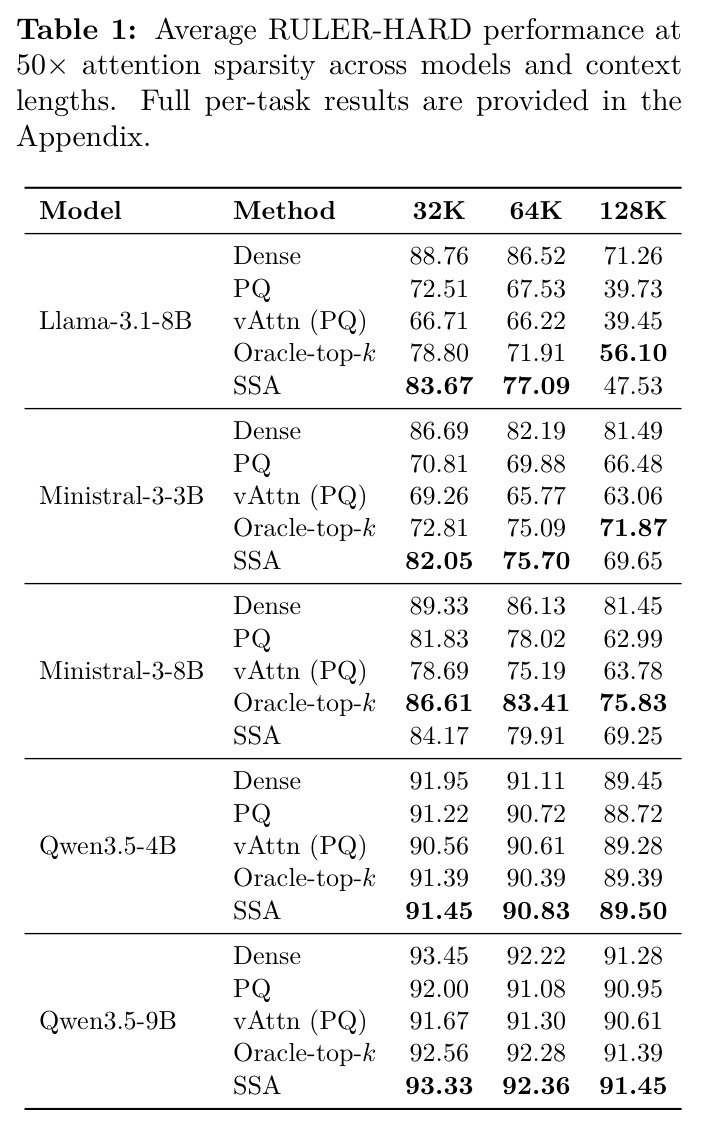
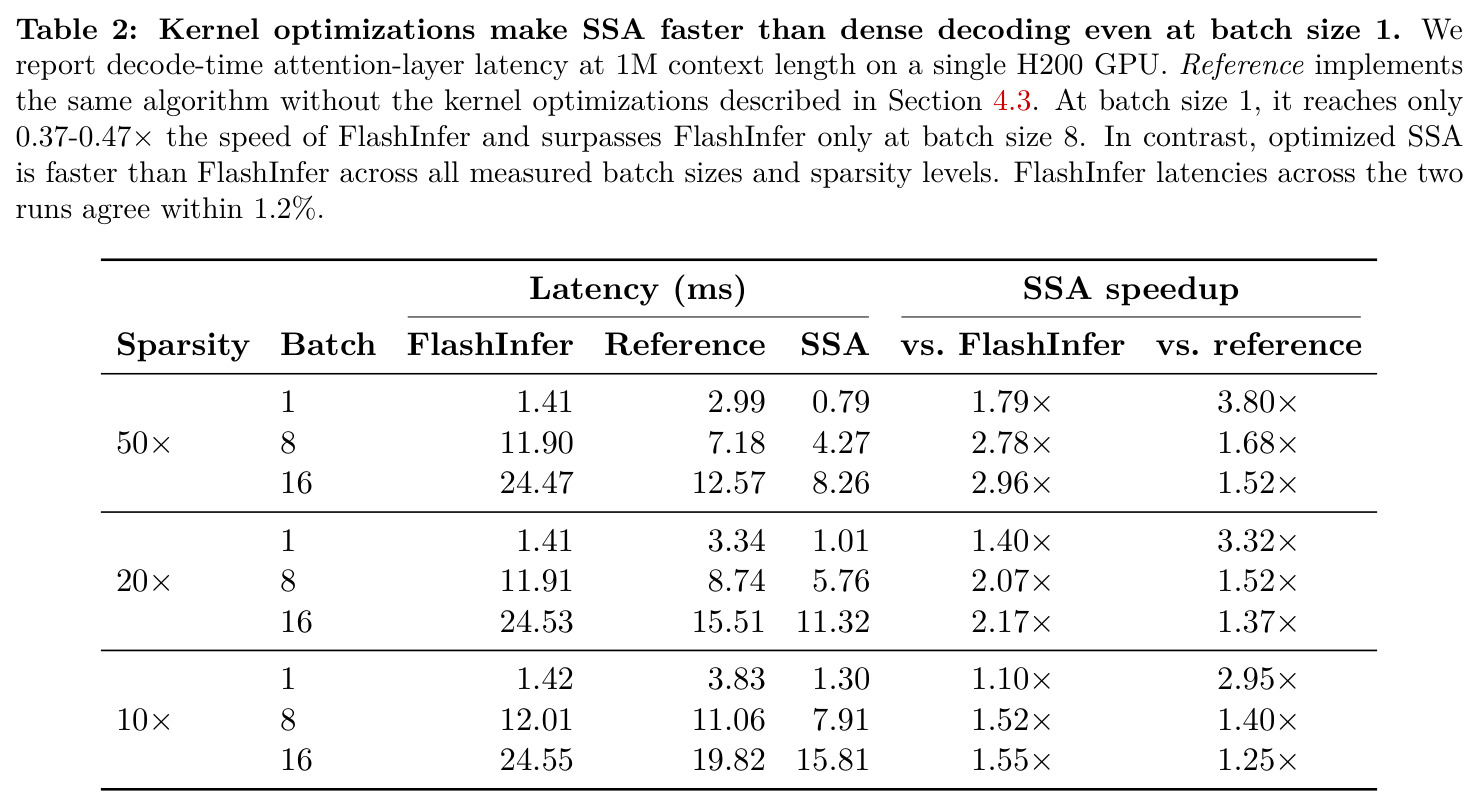
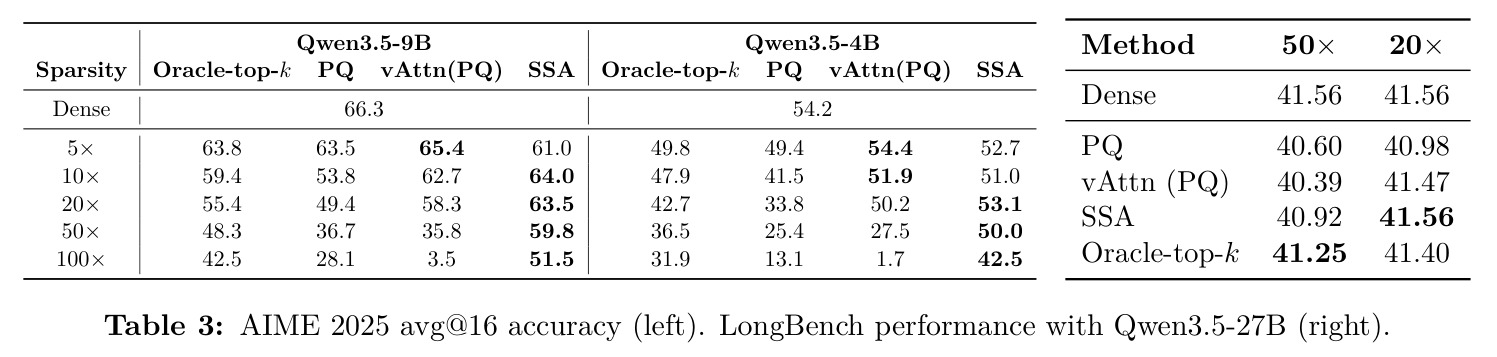
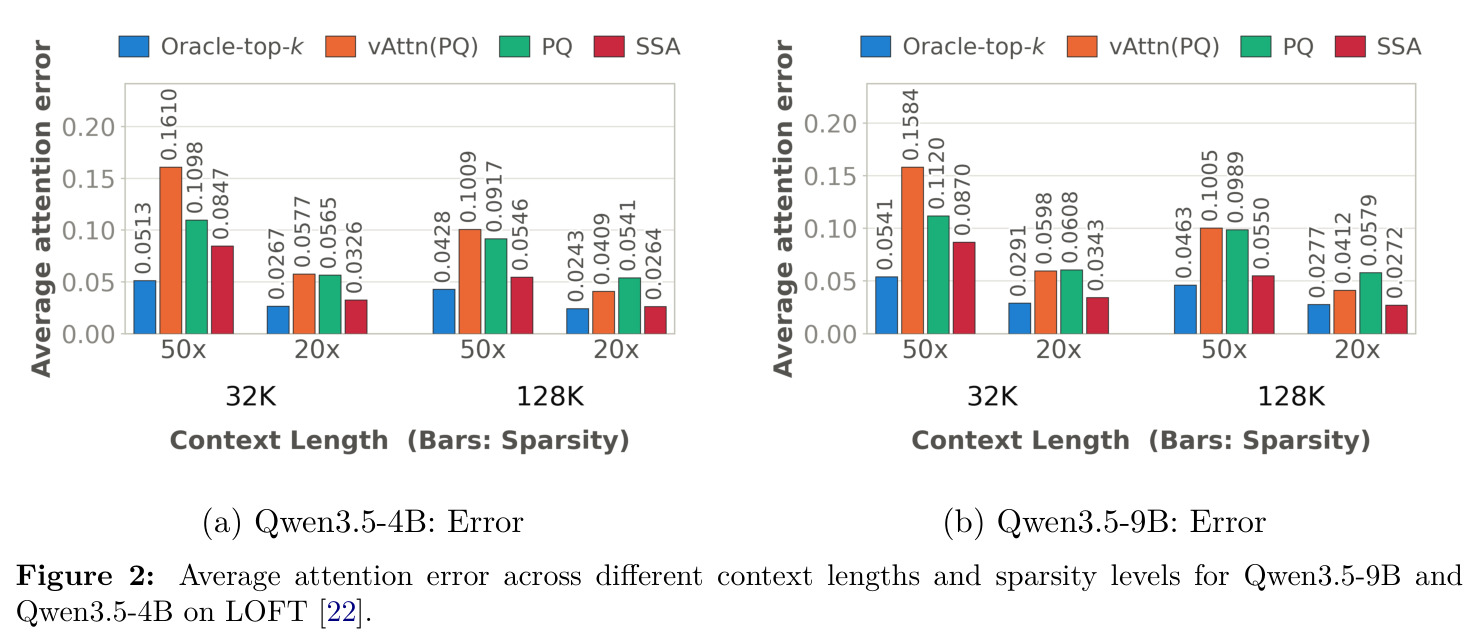
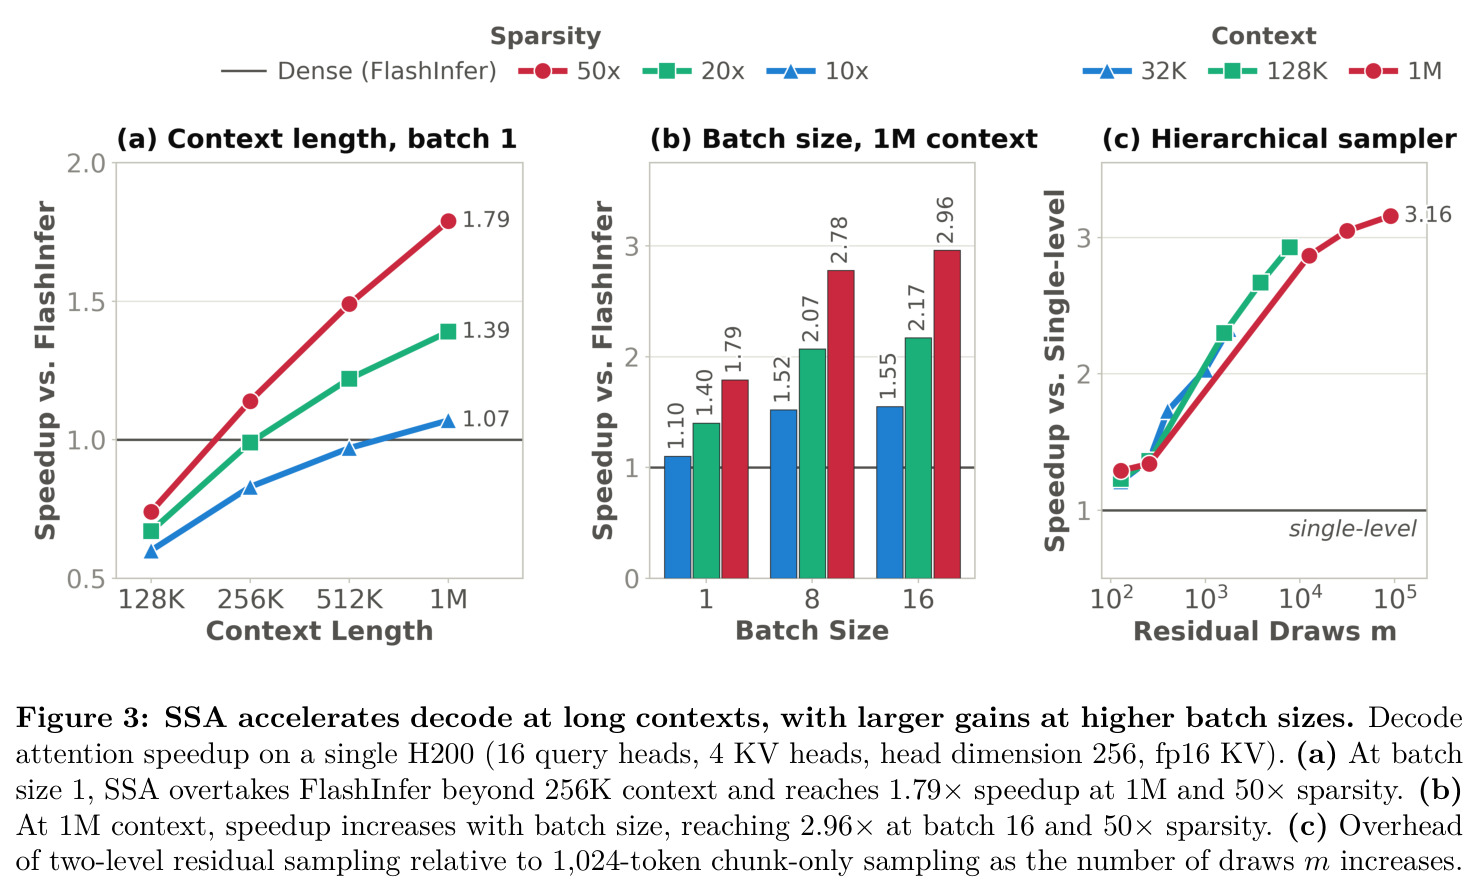
逐项分析:(1) RULER-HARD 50倍稀疏(Table 1):Ministral-3-8B上32K时SSA 84.17,超过最强实用基线(PQ 81.83、vAttn 78.69),恢复稠密89.33的94%;128K时SSA 69.25对基线63.78/62.99,恢复稠密81.45的85%。Llama-3.1-8B 32K上SSA把PQ的72.51拉到83.67(稠密88.76);Ministral-3-3B 32K为82.05对PQ 70.81;Qwen3.5-4B/9B上所有稀疏方法距稠密2分内(9B 128K:SSA 91.45 vs 稠密91.28)。(2) AIME 2025长生成(Table 3):Qwen3.5-9B 50倍稀疏下SSA 59.8,超oracle top-k 48.3、PQ 36.7、vAttn 35.8;100倍稀疏SSA仍达51.5而vAttn崩至3.5、PQ 28.1;heavy fraction消融(Table 13)显示 $h\in[0.2,0.8]$ 得61.0-64.0,纯采样($h=0$)仅40.2-42.5,纯top-k($h=1$)为49.4-53.8,验证分层互补。(3) LOFT(Figure 2):SSA在所有上下文长度与稀疏度的注意力相对L2误差均为非oracle方法最低,而subspan-EM各方法差异不超过0.04。(4) LongBench Qwen3.5-27B:20/50倍稀疏下各方法距稠密1分内(SSA 41.56/40.92 vs 稠密41.56/41.56)。(5) 解码效率(Figure 3、Table 2):batch 1时SSA在128K为FlashInfer的0.60-0.74倍,1M处反超达1.79×(50×);batch 16、50×达2.96×(20×/10×为2.17×/1.55×);内核优化使batch 1较参考实现提速2.95-3.80×(参考实现仅0.37-0.47×FlashInfer);两级采样器较chunk-only省1.21-3.16×,1M下采样延迟仅0.30-1.18ms。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RULER-HARD(Ministral-3-8B,128K) | 平均准确率 @50×稀疏 | 69.25(SSA) | vAttn(PQ) 63.78 / PQ 62.99 / Oracle-top-k 75.83 | 较vAttn +5.47,恢复稠密(81.45)的85% |
| RULER-HARD(Ministral-3-8B,32K) | 平均准确率 @50×稀疏 | 84.17(SSA) | PQ 81.83 / vAttn(PQ) 78.69 | 较PQ +2.34,恢复稠密(89.33)的94% |
| RULER-HARD(Llama-3.1-8B,32K) | 平均准确率 @50×稀疏 | 83.67(SSA) | PQ 72.51 / vAttn(PQ) 66.71 | 较PQ +11.16,逼近稠密88.76 |
| AIME 2025(Qwen3.5-9B,50×稀疏) | avg@16 准确率 | 59.8(SSA) | Oracle-top-k 48.3 / PQ 36.7 / vAttn(PQ) 35.8 | 较oracle top-k +11.5,较vAttn +24.0 |
| AIME 2025(Qwen3.5-9B,100×稀疏) | avg@16 准确率 | 51.5(SSA) | Oracle-top-k 42.5 / PQ 28.1 / vAttn(PQ) 3.5 | 较oracle +9.0,抗极端稀疏崩塌(vAttn仅3.5) |
| LOFT(Qwen3.5-9B/4B) | 平均注意力相对L2误差 | 所有非oracle方法中最低(全部长度与稀疏度) | PQ、vAttn(PQ) | 误差全面下降;subspan-EM各方法差≤0.04 |
| LongBench(Qwen3.5-27B) | 平均分 @20×/50×稀疏 | 41.56 / 40.92(SSA) | Dense 41.56 / 41.56;PQ 40.98/40.60 | 与稠密差距≤0.64,20×处持平稠密 |
| 1M上下文解码(单卡H200) | 注意力层延迟加速比 vs FlashInfer | 1.79×(batch 1,50×);2.96×(batch 16,50×) | FlashInfer稠密解码 | 随batch与稀疏度增大:batch16时20×为2.17×、10×为1.55× |
局限与改进
作者承认的局限:(1) 自适应算法与高效内核之间存在差距——GPU实现使用固定heavy fraction $h$ 而非逐query自适应分配,与理论版性能的匹配仅由附录Table 4验证,自适应实现留作未来工作;(2) 为数值稳定把 $\pi_i$ 截断在 $10^{-4}$,引入小偏差,破坏严格无偏性;(3) batch 1且中短上下文(如128K)时SSA仍慢于FlashInfer(约0.60-0.74×),选token开销未被摊销,只有足够长的上下文才能兑现加速。我自己的观察:(4) 误差界依赖 $\rho$(代理分数对残差的覆盖质量),若代理系统性低估某类重要残差token,$\rho$ 变大误差界迅速劣化,而论文未给出 $\rho$ 的实证测量;(5) 采样的方差对需要数值精确性的任务(精确字符串检索复述等)的影响未单独分析;(6) 评估集中于3B-27B开源模型与英文基准,未覆盖更大的MoE模型、多语言与真实生产负载;(7) $\lambda$ 求解、去重哈希在超大batch下的开销以及能耗数据未报告。
独立分析的弱点
(1) 固定heavy fraction削弱了理论自适应性:卖点本是逐query自动分配重集与采样预算,实现却用固定 $h$(如0.4),对注意力高度集中的query本可全用top-k以消除采样方差。改进方向:用代理分数的熵或Gini系数等轻量统计量在线估计每query/每层的 $A_R$,自适应设置 $h$。(2) 提议分布完全依赖PQ代理分数,与确定性检索共享同一误差源——被代理分数系统性低估的token在采样层同样低概率被抽中,此时 $\rho$ 无界、理论保证退化。改进方向:引入LSH哈希、随机投影等异构信号构造混合提议,或对低代理分但历史命中率高的token设最小采样率。(3) batch 1中短上下文(128K)无加速,限制了交互式单请求场景落地。改进方向:与KV淘汰/压缩(SnapKV、KVZip)正交组合先缩小缓存基数,或跨请求复用采样计算。(4) AIME 100×稀疏下oracle top-k(42.5)反而低于SSA(51.5),说明确定性选择在极端稀疏长生成下有系统性失败模式,但论文缺少'何时该采样'的诊断工具。改进方向:建立注意力长尾程度的在线指示器,据此在top-k与SSA间自动切换。(5) 对Qwen3.5系列收益很小(距稠密2分内),说明强模型+短上下文场景基线已够好,方法的价值区间需要事先判断。改进方向:提供基于稀疏度/模型/上下文组合的收益预测模型。
未来方向
作者明确提出:将SSA做成可验证的稀疏注意力,让用户可控地指定近似质量保证——利用Corollary 3的样本复杂度 $m=O(A_R^2\rho^2\epsilon^{-2}\log(1/\delta))$,给定目标 $\epsilon$ 自动决定采样量;以及实现真正自适应预算分配的高效内核。基于本文成果可延伸的方向:(a) 与KV压缩/淘汰、GQA/MLA正交叠加,把存储与访问两头一起省;(b) 把分层采样思想推广到prefill阶段的chunked attention与投机解码的验证步;(c) 用真实注意力统计在线校准 $\rho$,发展代理分数质量的监测与自动降级机制;(d) 结合Tactic式的power-law衰减建模,在SSA框架下实现自适应top-p质量阈值;(e) 训练时显式让模型适应稀疏估计器(借鉴KNN-Attention的训练侧思路);(f) 多GPU/tensor并行下的split归并策略与通信开销优化;(g) 把采样置信度与输出不确定性量化结合,为长链推理任务提供风险提示与回退策略。
复现评估
代码已开源(https://github.com/skylight-org/SSA-Paper-Code,摘要给出)。评测资源全部公开:数据集为RULER、LongBench、LOFT、AIME 2025,模型为开源权重(Llama-3.1-8B-Instruct、Qwen3.5-4B/9B/27B、Ministral-3-3B/8B-Instruct-2517),代理分数沿用PQCache的PQ方案(16子空间×256质心)。复现难点:(1) 内核部分需要H200级GPU与CUDA/Triton工程能力,1M上下文、head dim 256、fp16的KV缓存显存开销巨大,中小实验室难以复现速度数字;(2) 准确率实验中AIME需avg@16即16次采样、每次生成32K token,推理成本可观;(3) 论文未说明随机种子与方差报告方式,采样方法的波动可能影响个位数结论;(4) 关键补充材料(Table 4固定h匹配实验、Table 5与MagicPig/HashAttention/Double Sparsity/Quest的对比、Table 6数据子集、Table 13的h消融)在附录,复现时需细读。总体:算法逻辑(NumPy级实现)易于复现验证,内核性能数字复现门槛较高,需要约单卡H200×多轮长上下文推理的算力。
论文图表
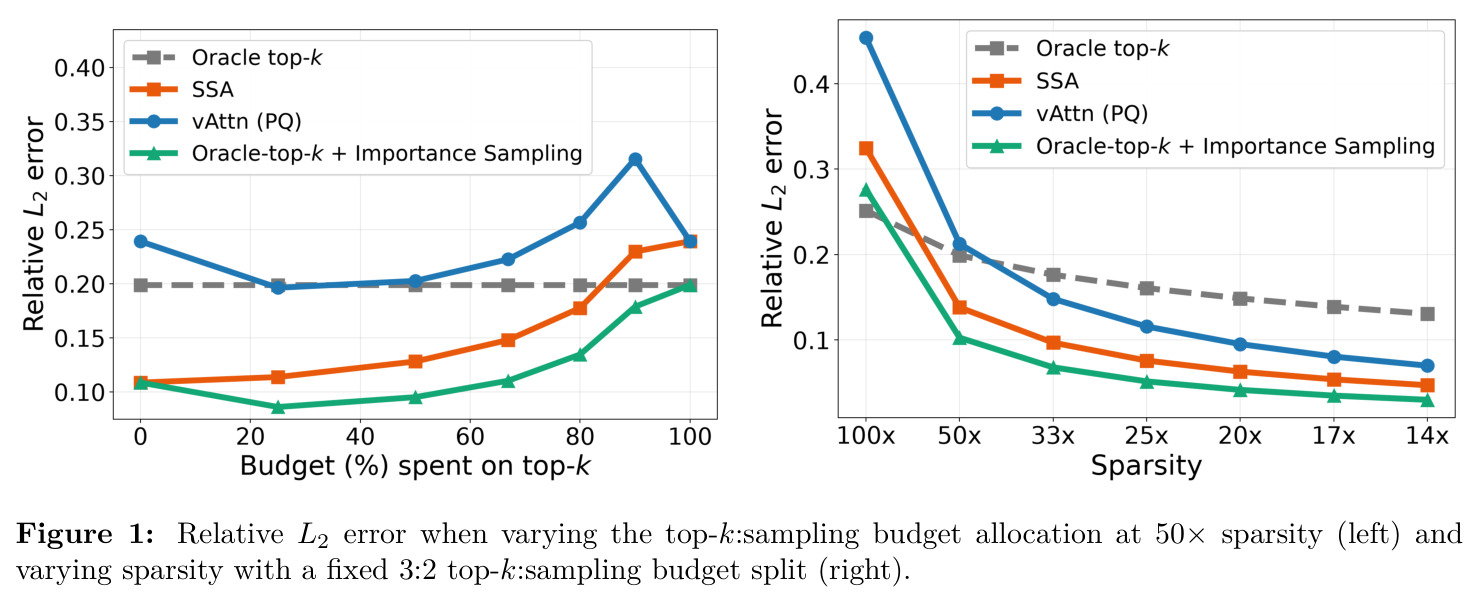
左图固定50倍稀疏,变化top-k与采样预算的分配比例;右图固定3:2的top-k:采样分配,变化稀疏度。对比均匀采样与分数引导重要性采样(含用真实注意力分数的Oracle版本)在注意力输出上的相对L2误差。
这是SSA的核心动机证据:证明均匀采样因忽视残差注意力质量的非均匀分布而误差更高,分数引导采样在所有分配比例与稀疏度下一致更低,直接催生了'分层+分数引导'的方法设计。