从提示到组合:面向海报生成的空间画布界面 From Prompting to Composing: A Spatial Canvas Interface for Poster Generation
用空间画布加四种绑定取代纯文本提示,让海报构图意图可直接在二维空间中组合表达。
前置知识
多模态扩散变换器(MMDiT / DiT)
当前图像生成与编辑模型的主流骨干网络:图像先经 VAE 编码为 latent token 序列,文本经语言模型编码为语言 token,二者拼接后由 Transformer 逐层联合处理并预测去噪方向(通常基于流匹配或扩散目标训练)。MMDiT 为图像与文本设置独立权重分支,在注意力层内交互。本文的 Compo 就建立在预训练 MMDiT 图像编辑模型(LongCat-Image-Edit、Qwen-Image-Edit-2511)之上。
理解 Compo 的输入组织方式——文本分支处理 VL tokens、图像分支同时处理带噪目标 tokens 与画布 tokens,以及 LoRA 应挂在哪些分支——都必须先掌握这一架构。
LoRA 低秩适配
一种参数高效微调方法:冻结预训练模型的全部原始权重,只在每层注入一对低秩矩阵乘积 $BA$(秩 $r$ 远小于权重维度)作为可训练增量,从而大幅降低显存、算力与数据需求。本文在监督训练阶段使用 rank 128 的 LoRA,强化学习阶段换用新的 rank 64 LoRA。
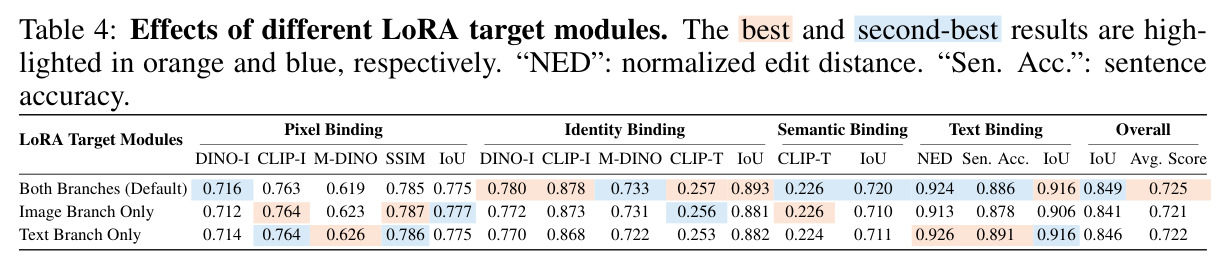
Compo 的核心策略是不从头训练海报生成器,而是用 LoRA 把通用编辑模型适配到新接口;论文还专门消融了 LoRA 应作用于文本分支、图像分支还是两者,结论是两者都调效果最好。
指令式图像编辑模型(text-and-image-to-image)
以参考图像加自然语言指令为输入、输出编辑后图像的生成模型(如 Qwen-Image-Edit、LongCat-Image-Edit),一般由多模态语言模型与扩散变换器组合而成,天然支持多图输入、指令跟随和文字渲染,是近两年开源社区的主流路线。
Spatial Canvas 接口之所以可行,正是因为这类模型已具备多图条件与指令跟随的原生能力:画布本质上只是另一种输入图像,Compo 只需教会骨干读懂这种新条件格式,而不需要新的架构组件。
扩散模型在线强化学习后训练(DiffusionNFT)
对扩散模型做在线 RL:对每个输入采样多个候选输出(rollout),用奖励函数打分,再按 RL 目标更新模型。DiffusionNFT 利用前向加噪过程构造无噪声代理损失,避免了标准扩散 RL 中反向去噪过程梯度反传的高昂开销,适合在有限算力下做后训练。
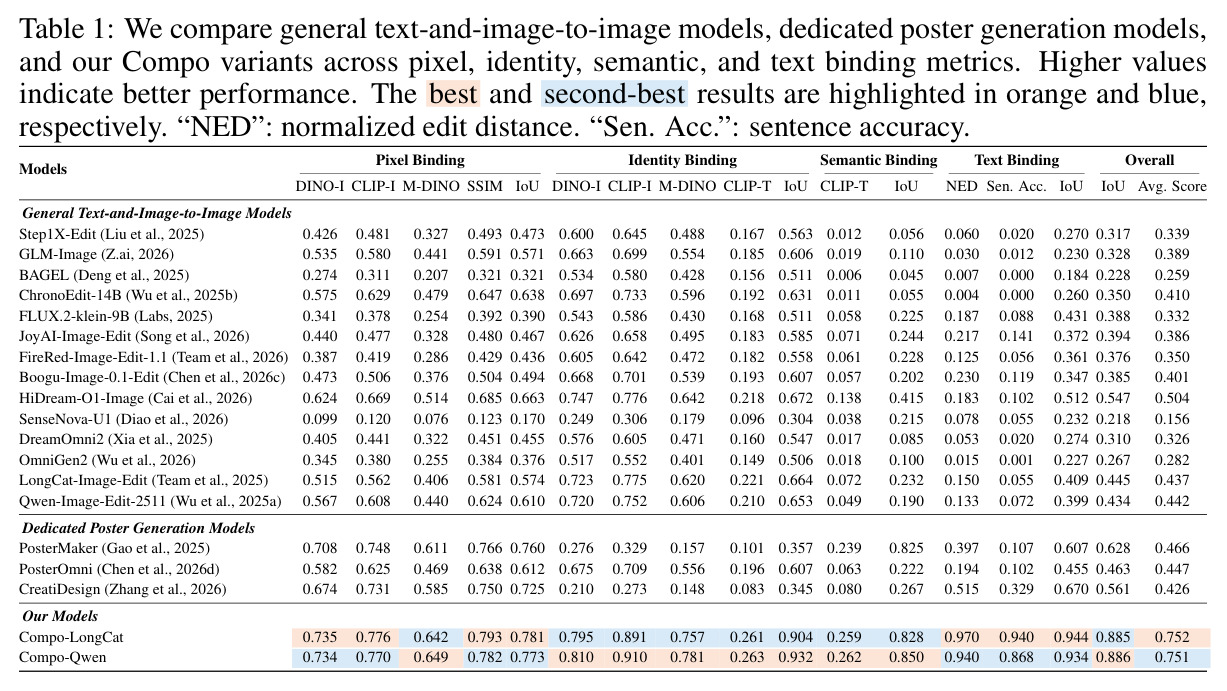
Compo 的第二阶段即用 DiffusionNFT 优化绑定感知的多奖励(文本、实例相似度、布局),是各绑定指标(尤其文本整句正确率从 0.886 提升到 0.940)大幅提升的直接来源。
视觉度量与感知工具链(CLIP/DINO、SAM-3、OCR)
CLIP-I 与 DINO-I 分别用 CLIP 和 DINOv2 特征度量两张图像的相似度,CLIP-T 度量图像与文本的语义相似度;SAM-3 可按文本概念分割图中任意实例;OCR 模型(Chandra-OCR-2)识别图中文字并返回其空间位置。本文用这组工具既构造评测指标,也计算 RL 奖励。
论文的整套评测协议是先用 SAM-3 或 OCR 把生成结果与画布上的目标区域按最大 IoU 匹配,再对匹配成功的区域计算上述相似度,匹配失败则记零分——理解这套区域匹配协议才能正确解读表格中的每一个数字。
研究动机
现代生成模型几乎都以文本提示作为交互接口,海报生成系统也不例外。但海报在本质上是二维、结构化的视觉产物:主体、标题、logo 与图形元素各自占据有意图的位置,且经常要求保留特定角色的身份或特定视觉内容的原始外观。用一维词序列编码这些空间与视觉约束既间接又含糊——要在指定区域放精确文字、让某角色双手持剑、原样保留某个水晶,全部写进一句话后模型很难精确执行,构图越复杂问题越严重。作者的基准实验量化了这一痛点:在 500 个组合式海报样本上,最强通用编辑模型 HiDream-O1-Image 平均分仅 0.504,最强专用海报系统 PosterMaker 为 0.466、PosterOmni 0.447、CreatiDesign 0.426;更能说明问题的是文本渲染整句正确率(sentence accuracy),基线中最高的 CreatiDesign 也只有 0.329,多数低于 0.15,而海报文字一旦拼错整张图基本不可用。同时,现有专用方法依赖受限的参考类型或任务特定控制模块,通用编辑模型则缺乏空间区域与文本描述间的显式细粒度绑定,扩展新控制形式都要重新设计模块。
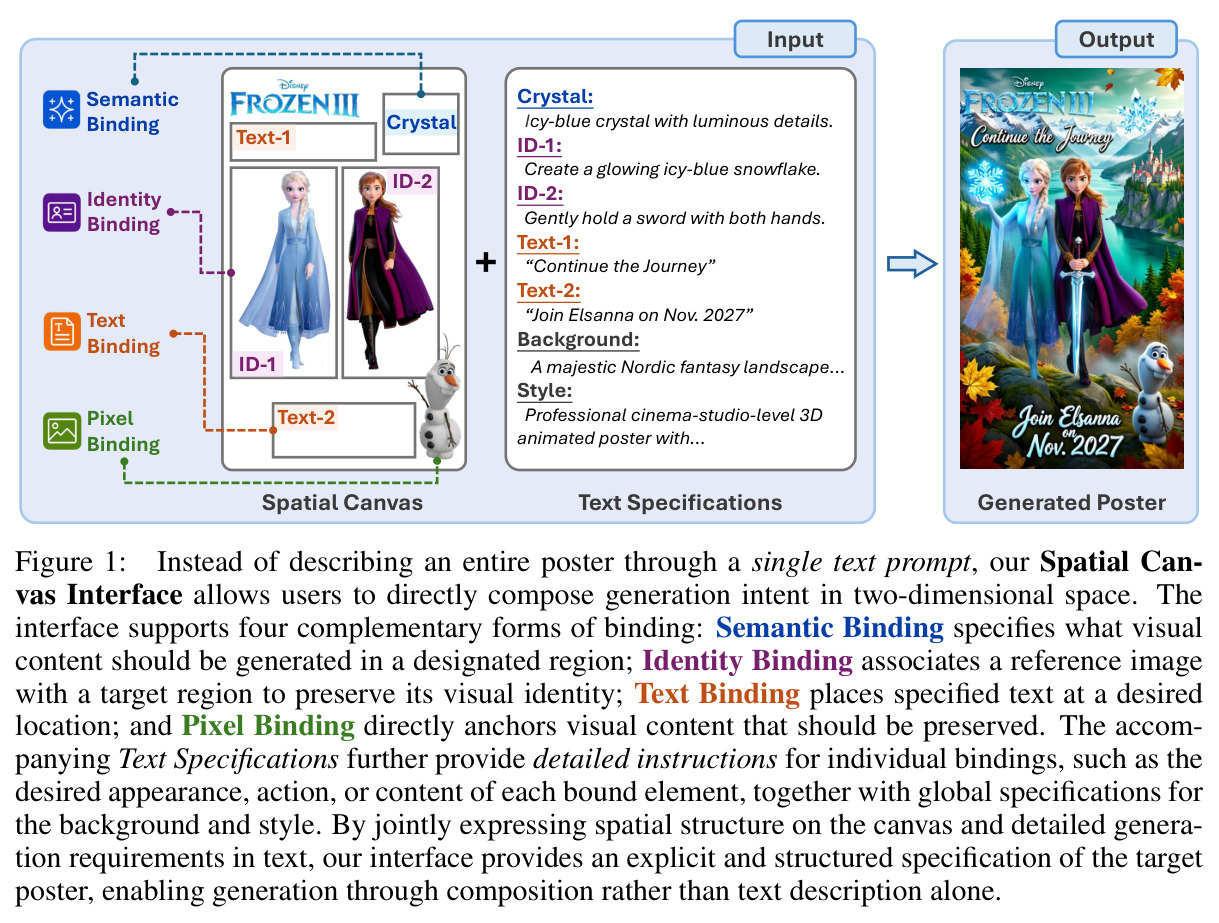
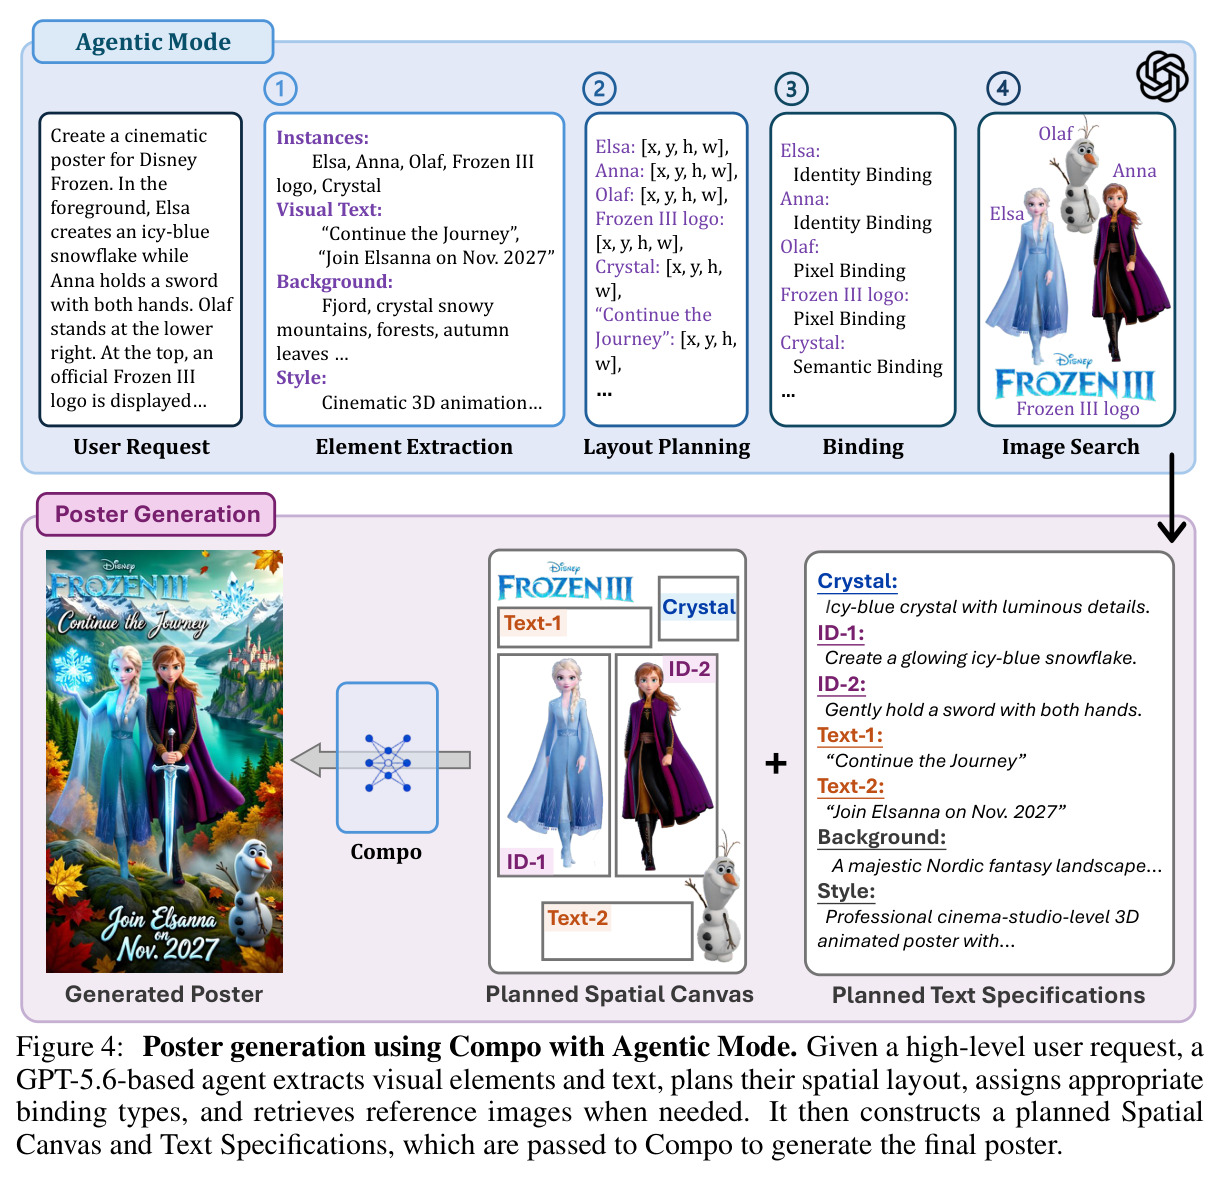
本文的目标是本文的目标是把「意图规范」与「视觉生成」解耦,构建一个让用户直接在二维空间中组合生成意图的接口。具体拆成四件事:其一,定义 Spatial Canvas Interface,用四种互补绑定统一表达控制意图——语义绑定(指定某区域生成什么视觉概念)、身份绑定(把参考图绑定到某区域以保留其视觉身份)、文本绑定(指定精确文字及其位置)、像素绑定(直接钉住必须保留的视觉内容),配合元素级与全局(背景、风格)的 Text Specifications,构成目标海报的结构化表示;其二,训练能理解该接口的模型 Compo,且不从零训练,而是高效适配预训练图像编辑模型以保留其生成能力;其三,构建可自动扩展的训练数据管线与 500 样本评测基准,逐项评估每种绑定的遵从度及其联合组合,而非只看整体画质;其四,同时支持用户手动画布的直接推理,以及由 agent 把高层次请求自动翻译成画布的 agentic 模式。
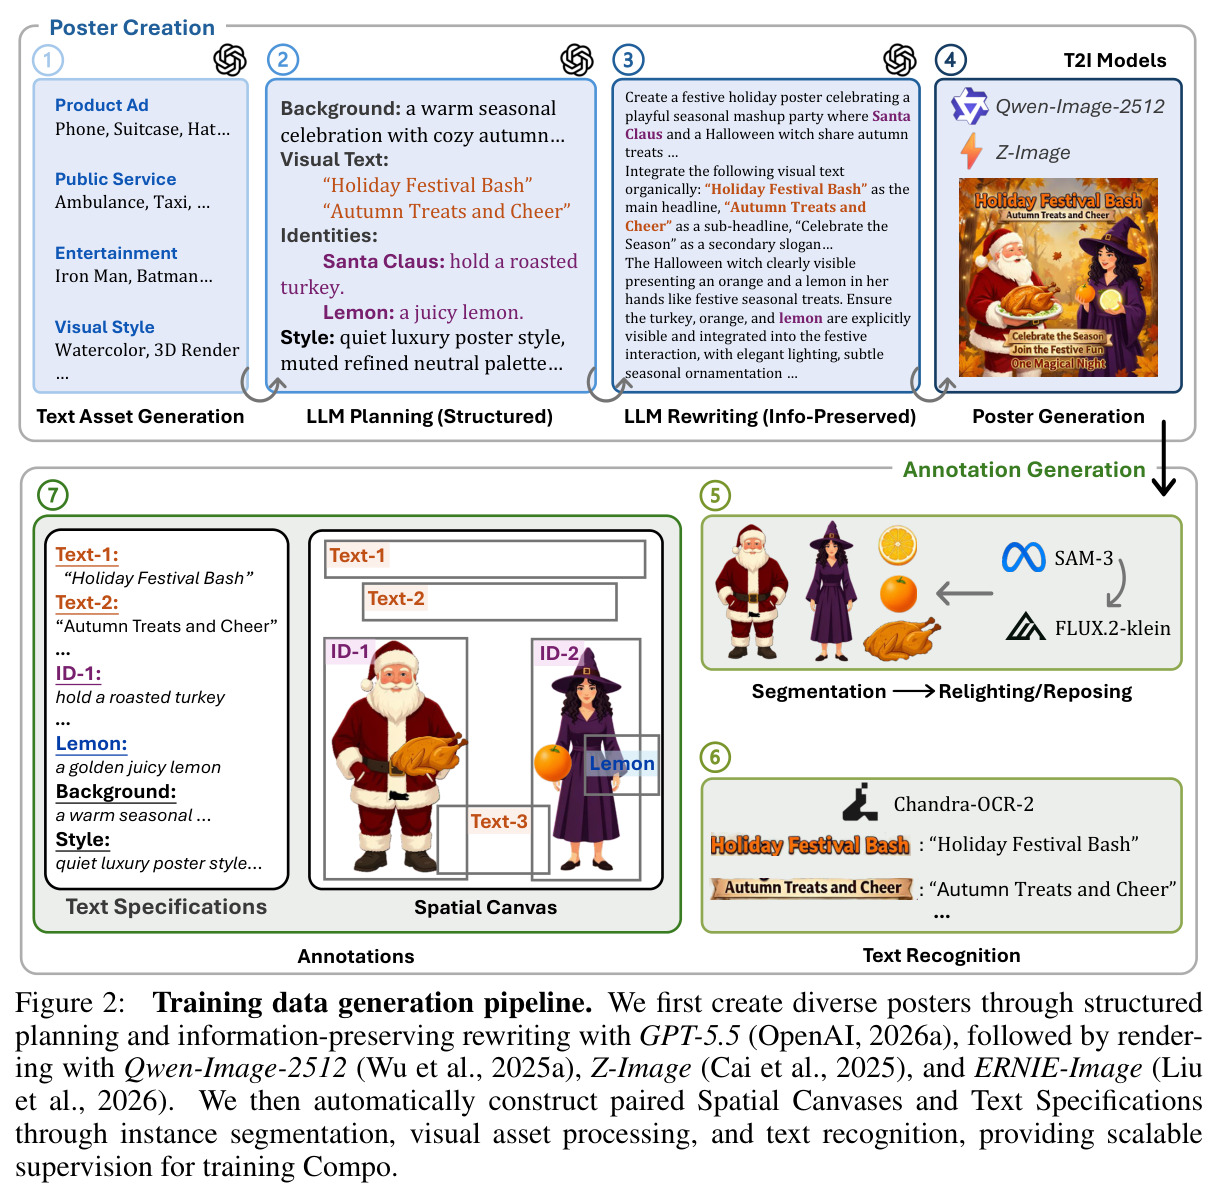
与已有工作不同的是,本文最独特的切入点是一个统一抽象:布局控制、参考驱动生成、文本渲染、图像编辑这四条看似分散的研究线,可被看作同一原则的不同实例——把生成约束绑定到共享画布上的空间位置。在此视角下,四种绑定不是四个独立模块,而是同一接口的四种参数化方式,可在一张画布上自由组合,天然统一了此前各自为政的技术路线。与 Canvas-to-Image 等统一输入方法相比,Compo 强调空间区域与对应文本描述间的显式细粒度绑定;与 CreatiDesign、PosterMaker 等多条件海报系统相比,它不依赖任务特定控制模块,新增控制类型只需扩展画布渲染规则。另一处关键差异在训练侧:收集大规模人工设计的画布-海报配对成本过高,作者于是反向操作——先用文本到图像模型生成多样海报,再用 SAM-3 分割、FLUX.2-klein 重光照/重姿态、Chandra-OCR-2 文本识别等感知工具自动「反推」结构化监督,把数据瓶颈转化为工程问题。最后,画布既是面向人的构图界面,也是 agent 规划的结构化中间表示,这种双重角色也是此前工作不具备的。
核心方法
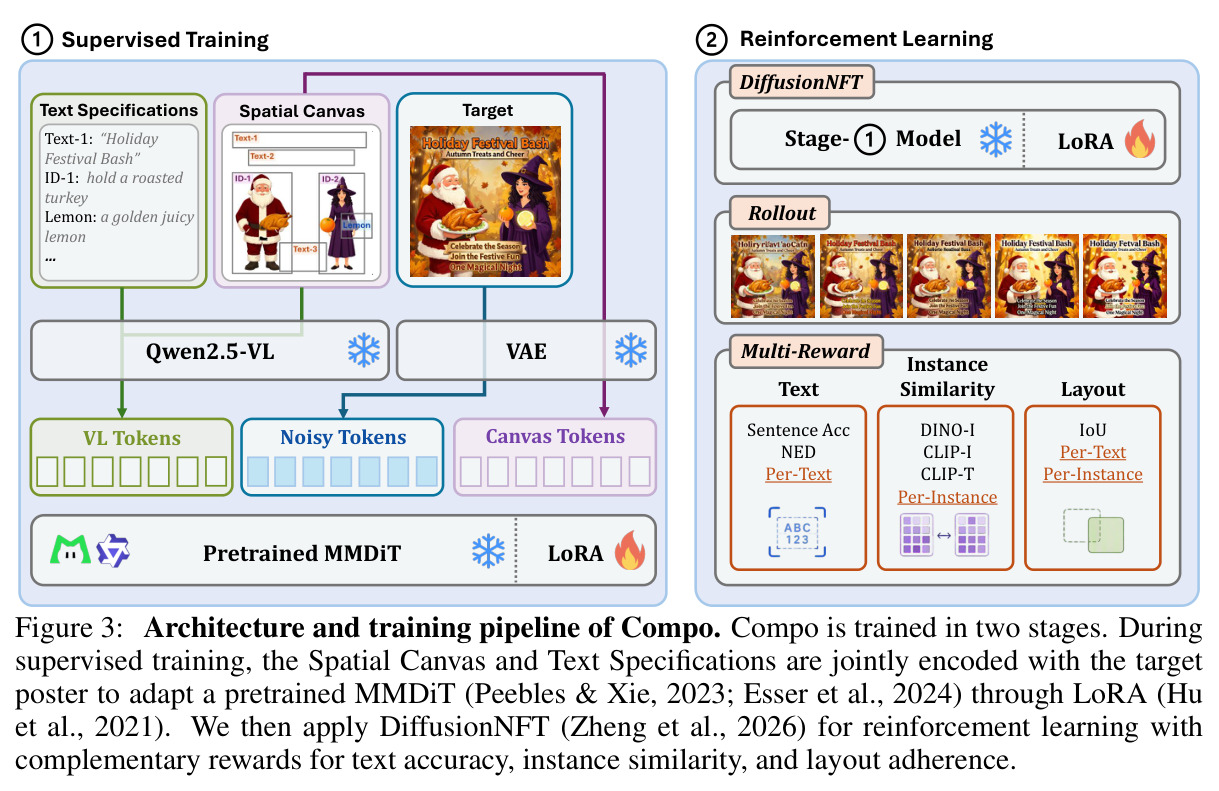
直觉上,与其让模型从一段话里猜布局,不如直接给它一张「标注过的画布」:哪里放标题、哪里放角色、哪里保留原图一目了然,模型只需学会照着画布作画。输入由两个模态构成:Spatial Canvas 是与海报同分辨率的黑色画布图,直接渲染白色边界框、txt-k/obj-k 等标识、身份参考小图或需原样保留的像素内容;Text Specifications 以语言记录每个绑定的详细描述(外观、动作、字体样式)及全局背景与风格。架构上,Compo 以预训练多模态扩散变换器(MMDiT)编辑模型为骨干(LongCat-Image-Edit 与 Qwen-Image-Edit-2511 两个版本):冻结的 Qwen2.5-VL 将规范编码为视觉-语言 token(VL tokens),冻结的 VAE 将画布与目标海报编码为 latent tokens;MMDiT 文本分支处理 VL tokens,图像分支同时处理带噪目标 tokens 与画布 tokens,全程只用 LoRA(rank 128)训练适配参数。训练分两阶段:先用自动合成的 Compo-200K 做监督训练,让模型学会解读异构空间绑定;再用 DiffusionNFT 强化学习,以绑定感知的多奖励(文本、实例相似度、布局)精调每种绑定的逐项保真度。
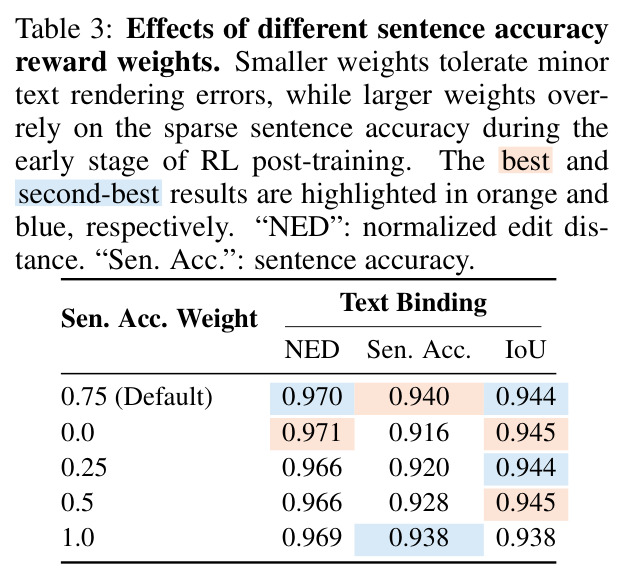
核心创新是「绑定(binding)」这一统一抽象及其三个机制。第一,四类绑定把语义、身份、文字、像素四种控制统一为「区域 + 约束」的同构表达且可自由组合,与以往为每种条件设计专用编码器或控制模块的路线有本质区别——Compo 只需让 MMDiT 图像分支「看」画布、文本分支「读」规范,一个骨干吃下所有条件。第二,监督数据完全自动合成:先用 LLM 结构化规划加信息保持改写生成提示词,用 Qwen-Image-2512、Z-Image、ERNIE-Image 渲染海报,再用 SAM-3 分割实例、FLUX.2-klein-9B 统一参考姿态光照、Chandra-OCR-2 识别文字及位置,从成品海报反推出画布与规范,绕开人工标注画布-海报配对的高昂成本,得到约 20 万样本的 Compo-200K。第三,绑定感知的强化学习:奖励计算与评测协议完全同构(同一套区域匹配规则与感知工具),文本奖励中整句正确率采用逻辑 AND 聚合——只有所有绑定文字全部正确才得 1 分——再与连续的 NED 按 $R_{\text{text}} = wR_{\text{Sen.Acc.}} + (1-w)R_{\text{NED}}$ 加权($w=0.75$),兼顾稠密字符级反馈与「整张海报零错字」这一稀疏但关键的目标。
方法步骤详情
方法分五步。(1)构建资产库:用 GPT-5.5、Claude Opus 4.6、Gemini 3.5 Flash 整理 12 类主题约 1000 实例的内容库与约 250 种风格的风格库。(2)海报合成:每次采样一个主题、3–8 个实例与一种风格,GPT-5.5 按 JSON schema 规划场景、背景、3–5 条视觉文字及人物-物体交互,在信息保持前提下改写为自然提示词,随机交给 Qwen-Image-2512、Z-Image、ERNIE-Image 之一渲染 1024 平方像素海报(约 32 张 A100 80GB)。(3)自动标注:SAM-3 文本引导分割实例,人物用 FLUX.2-klein-9B 重摆为规范姿态、物体平光化;Chandra-OCR-2 识别文字与区域,且以 OCR 结果为最终真值保证与图像对齐;在黑底画布上渲染绑定——文本绑定画白框标 txt-k、身份绑定贴参考图标 obj-k、物体随机分配像素绑定(直接粘贴)或语义绑定(类名框),并生成对应 Text Specifications,得到约 20 万配对样本。(4)两阶段训练:SFT 用 rank 128 LoRA、学习率 1e-4、500 步 warmup(LongCat 版 8×A100 batch 64,Qwen 版 16×A100 batch 32);RL 换新 rank 64 LoRA,每样本 rollout 10 个候选(10 步去噪、guidance 1.0,Qwen 版降 512 平方省显存),按 $R = 0.4R_{\text{Text}} + 0.4R_{\text{Ins.Sim.}} + 0.2R_{\text{Layout}}$ 用 DiffusionNFT 优化。(5)推理:直接推理由用户手绘画布;agentic 模式由 GPT-5.6 完成元素提取、布局规划、绑定分配与图像检索(Openverse 优先、T2I 回退)后交给 Compo 出图。
技术新颖性
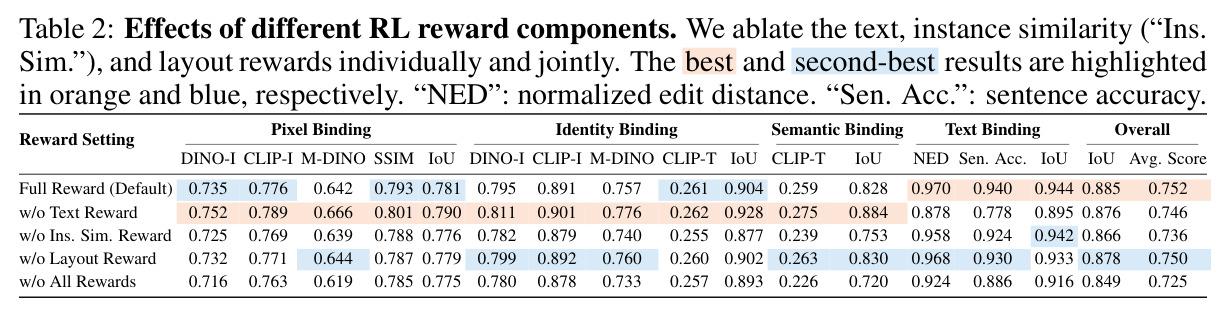
技术新颖性体现在四个层面。接口层面:此前布局、参考、文字、编辑四类控制分属不同研究线,各自需要专门的条件编码器(ControlNet 分支、布局 transformer、glyph 编码器等),Compo 把它们统一为画布上的绑定,控制类型可组合且可扩展,新增绑定只需定义画布渲染规则,无需改动模型结构。数据层面:「先渲染后反推」的自动标注是关键工程创新——把最昂贵的人工结构化标注替换为感知模型调用(SAM-3、Chandra-OCR-2、FLUX.2-klein),且数据质量随底层 T2I 模型升级自动提升,形成可持续的数据引擎。训练层面:不从头训练海报专用生成器,而是用 LoRA 适配预训练编辑模型,最大程度保留通用视觉先验与文字渲染能力,并在两个不同骨干(LongCat、Qwen)上验证同样有效,说明接口设计与骨干选择解耦。优化层面:在线 RL 与评测完全同构——奖励计算与基准指标一致(同样的区域匹配协议与工具链),这种「以评代奖」的设计保证优化目标与评测目标不漂移;消融进一步确认三个奖励组件各自补位:文本奖励专管文字、实例相似度奖励专管像素与身份一致性、布局奖励专管空间对齐。
实验结果
核心结果有五点。一,总体大幅领先:在 500 个无重叠样本上,Compo-LongCat 平均分 0.752、Compo-Qwen 0.751,比最佳通用编辑模型 HiDream-O1-Image(0.504)高约 0.25,比最佳专用系统 PosterMaker(0.466)、PosterOmni(0.447)、CreatiDesign(0.426)高约 0.29–0.33,几乎所有指标占据前两名(Table 1)。二,文本绑定优势最悬殊:Compo-LongCat 的 NED 0.970、句对 0.940、文本区域 IoU 0.944,而基线最好的 CreatiDesign 仅 NED 0.515、句对 0.329——基线约七成海报文字有错,Compo 压到约 6%。三,身份与像素绑定领先:Compo-Qwen 身份绑定 DINO-I 0.810、IoU 0.932,高于最佳通用基线 LongCat-Image-Edit 的 0.723 与 0.664;像素绑定 DINO-I 0.735 略高于 PosterMaker 的 0.708,而 CreatiDesign 身份保持崩坏(DINO-I 仅 0.210)。四,语义绑定提升温和:CLIP-T 0.259–0.262(最佳基线 0.239)、IoU 0.828–0.850(基线 0.825),绝对值偏低说明开放词汇语义对齐是共性难题。五,RL 贡献明确:RL 使 LongCat 版总体 0.725→0.752、句对 0.886→0.940、语义 IoU 0.720→0.828(Table 5);去掉文本奖励句对跌至 0.778,去掉实例相似度总体掉 0.016,去掉布局奖励 IoU 降至 0.878(Table 2);$w=0.75$ 最优,$w=0$/0.25 容忍小错,$w=1$ 奖励过稀疏(Table 3);LoRA 双分支同调最好(Table 4)。定性上基线普遍文字错拼、区域错位(Figure 5–7),对训练未见主题仍泛化良好(Figure 8)。
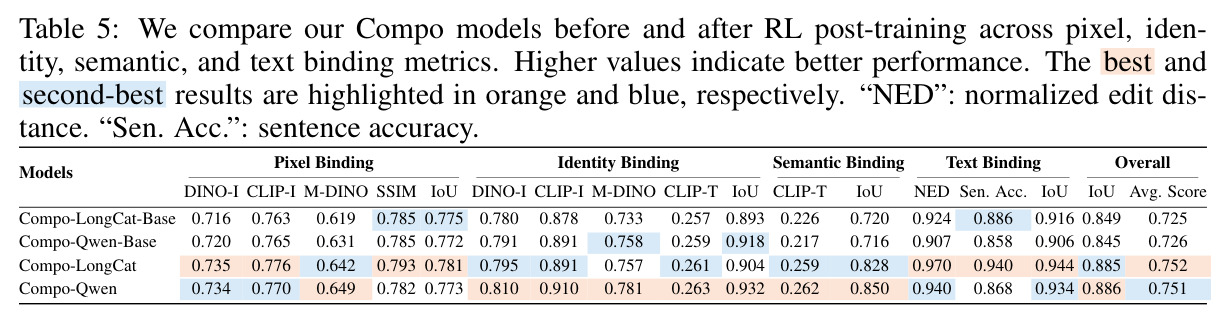
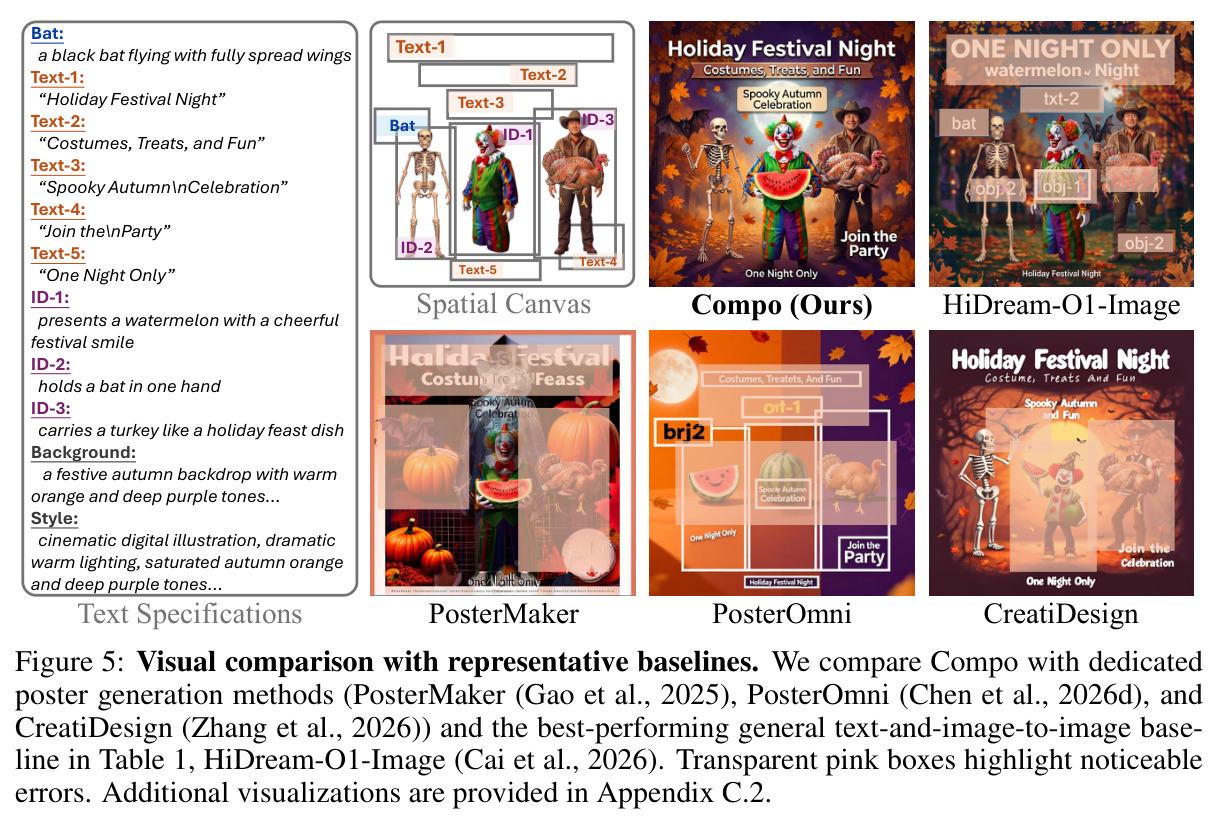
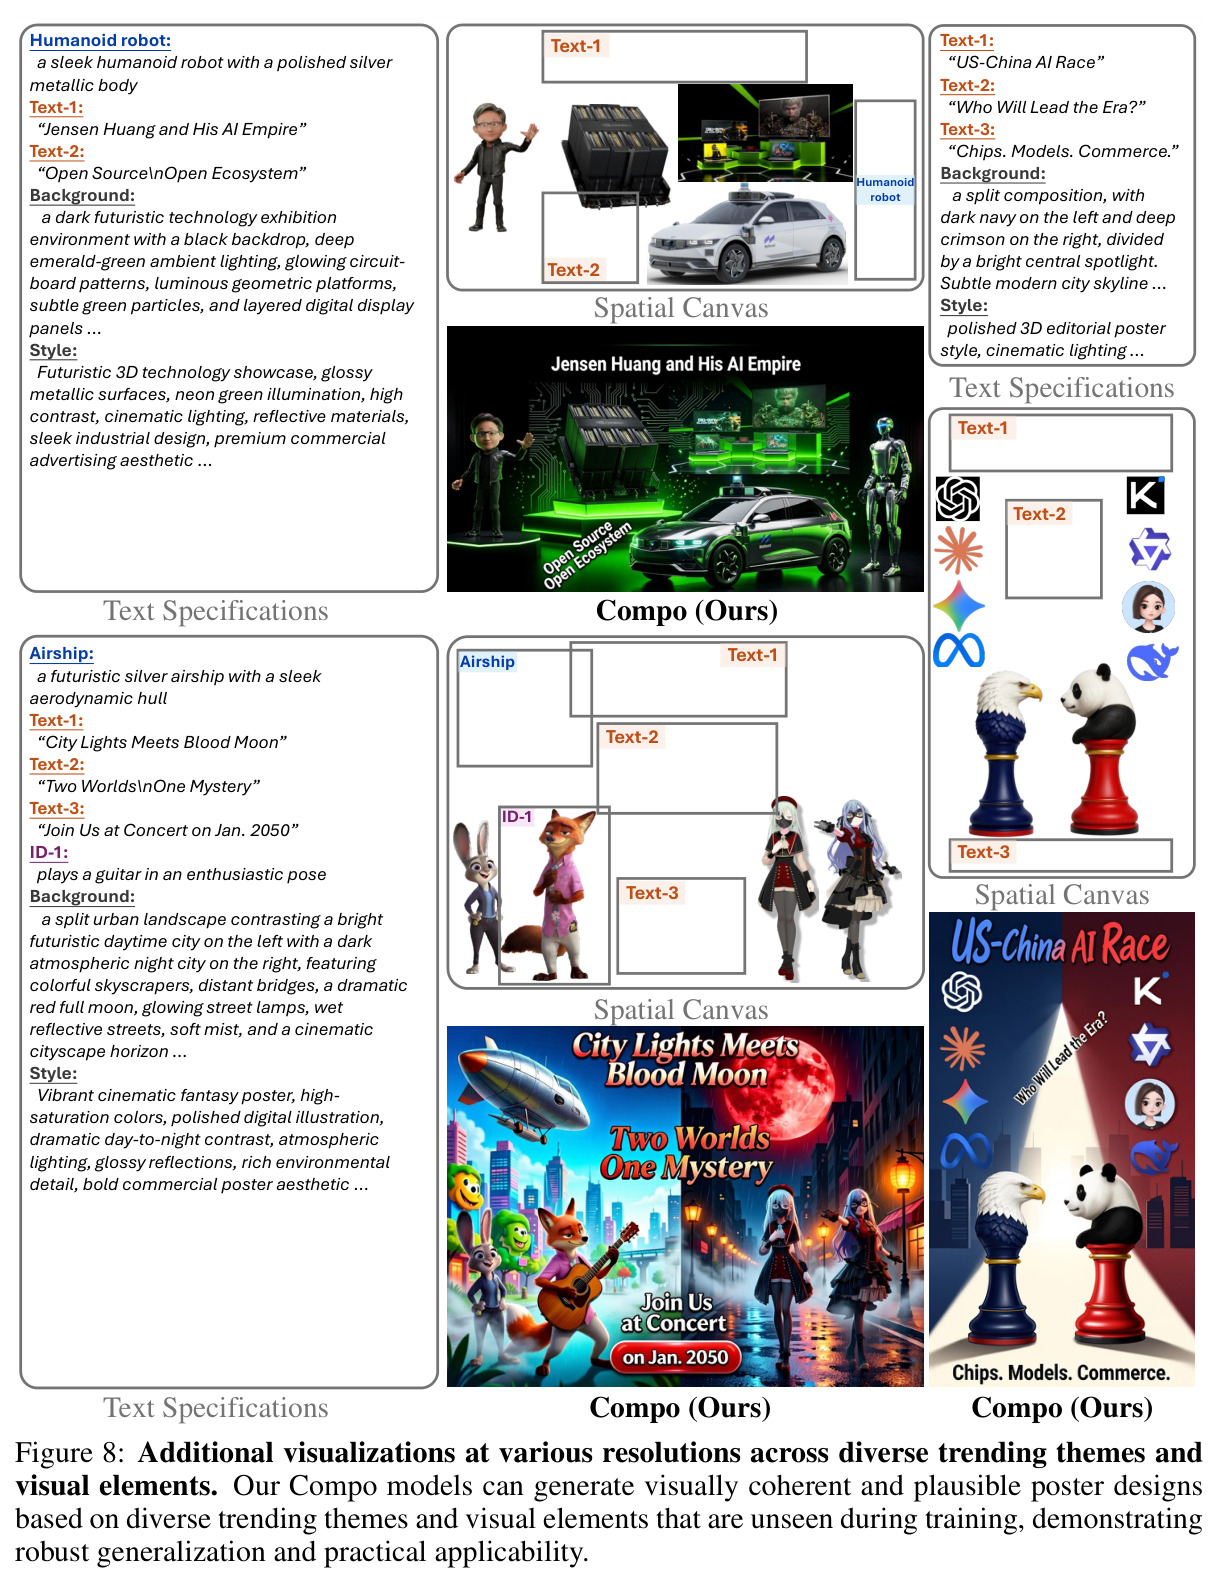
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 空间组合式海报生成(总体) | Avg. Score(所有绑定指标平均) | 0.752(Compo-LongCat)/ 0.751(Compo-Qwen) | HiDream-O1-Image 0.504(最佳通用模型);PosterMaker 0.466(最佳专用系统) | +0.248(对最佳通用模型)/ +0.286(对最佳专用系统) |
| 文本绑定(精确文字渲染) | Sentence Accuracy(整句正确率) | 0.940(Compo-LongCat) | CreatiDesign 0.329(基线最佳) | +0.611 |
| 文本绑定(字符级保真) | NED(归一化编辑距离) | 0.970(Compo-LongCat) | CreatiDesign 0.515 | +0.455 |
| 身份绑定(参考角色保持) | DINO-I | 0.810(Compo-Qwen) | LongCat-Image-Edit 0.723(通用最佳);CreatiDesign 仅 0.210 | +0.087 |
| 像素绑定(视觉内容原样保留) | DINO-I / SSIM | 0.735 / 0.793(Compo-LongCat) | PosterMaker 0.708 / 0.766(专用最佳) | +0.027 / +0.027 |
| 语义绑定(区域内容语义对齐) | IoU(区域对齐) | 0.850(Compo-Qwen) | PosterMaker 0.825 | +0.025 |
局限与改进
作者明确承认的局限不多,主要隐含在数据与评测的构成方式中:训练数据与基准全部由合成管线产生,依赖一长串第三方模型(GPT-5.5/GPT-5.6、Claude Opus 4.6、Gemini 3.5 Flash、Qwen-Image-2512、Z-Image、ERNIE-Image、SAM-3、FLUX.2-klein-9B、Chandra-OCR-2),其能力上限与风格偏置直接传导进 Compo;基准与训练数据同源同分布,与真实设计素材存在差距。我自己的观察有六点:其一,语义绑定 CLIP-T 仅约 0.26,语义-区域对齐远未解决,且 CLIP 类分数作奖励噪声较大;其二,视觉文字全是英文短语,中文、多语种与长文本渲染完全未验证,而这恰是海报设计的重要场景;其三,画布只能表达轴对齐矩形框,无法控制旋转、图层遮挡顺序或异形轮廓,物体在像素/语义绑定间的分配还是随机的;其四,agentic 模式绑定 GPT-5.6 与 Openverse 检索,规划质量受制于闭源模型,且示例直接生成迪士尼 IP 海报,身份与版权滥用风险讨论不足;其五,训练分布由 T2I 渲染的「AI 风」海报构成,真实摄影与印刷排版素材未覆盖;其六,规划器限制元素总数不超过 10 个,对信息密集的复杂商业设计可能不够。
独立分析的弱点
独立分析四个弱点。第一,闭源依赖链条长、复现风险高:数据合成与 agentic 规划依赖 GPT-5.5/GPT-5.6、Claude Opus 4.6、Gemini 3.5 Flash 等商业 API,这些模型持续更迭会使管线行为漂移、历史数据无法精确重现;改进方向是用开源 VLM 复刻规划器,并对规划输出建立确定性的 schema 校验与过滤。第二,奖励信号不完美:CLIP-T/DINO-I 属于全局或粗粒度相似度,难以区分「语义对但细节错」的情形,而 sentence accuracy 的 AND 聚合又使奖励在训练早期极度稀疏(guidance 1.0 时候选几乎不可能全部文字正确,这正是 Table 3 中 w=1 变差的原因);改进方向是引入区域级 VLM-as-judge 打分器,或设计基于 OCR 对齐的渐进式部分得分以稠密化奖励。第三,输出是单一扁平图像,缺少图层化结果:真实设计流程需要可分别编辑的背景、主体与文字层,改动一个标题就得整体重生成,交互成本高;改进方向是输出分层 RGBA 表示,或支持画布上的局部区域重生成。第四,评测以 IoU 阈值二值化匹配、失败即全零计分,但论文未报告阈值敏感性分析,可能放大或掩盖真实差距;改进方向是给出阈值扫描曲线并辅以小规模人工一致性检验。
未来方向
作者在结论中主要强调接口范式的确立,未列具体后续计划;基于其成果可以延伸多个方向。一是扩展绑定类型与画布表达力:加入风格绑定、旋转与非矩形区域、显式图层与遮挡顺序,并把输出从扁平图像扩展为可编辑的多层设计文件,对齐真实设计工具的工作流。二是多语种与本地化:把文本绑定扩展到中文、日文及混排场景,检验 OCR 工具链与 AND 聚合奖励在 CJK 字符上的适配。三是更自治的 agentic 闭环:让 agent 用与基准相同的自动评估协议对生成结果自检(文字是否全对、区域是否对齐、身份是否一致),迭代修订画布再生成,形成规划-生成-验证循环。四是与真实资产结合:接入品牌 logo 库、字体库与版式网格规则,让像素/身份绑定消费真实素材而非 T2I 生成的参考图,缩小合成到真实的差距。五是跨任务推广:画布加绑定的抽象是任务无关的,可延伸到幻灯片、UI 界面、漫画分镜与信息图等结构化版面生成。六是奖励模型化:用学习型 reward model 替换 CLIP/DINO 启发式,并利用数据引擎随 T2I 底座升级的特性,系统验证数据规模与质量的扩展规律。
复现评估
复现评估:论文承诺正文与附录 A/B 详细描述数据构建、训练、推理与评估设置,附录 D 公开了数据规划、提示词改写与 agentic 规划的完整 prompt 模板,接口定义(画布渲染规则、txt-k/obj-k 标识约定、区域匹配协议)描述充分,方法论层面可复现性较好。但工程门槛相当高:数据生成需约 32 张 A100 80GB,外加多个商业 LLM API(GPT-5.5、Claude Opus 4.6、Gemini 3.5 Flash)及 Qwen-Image-2512、Z-Image、ERNIE-Image 三个 T2I 权重;监督训练需 8–16 张 A100,强化学习需 16 张 A100。截至论文版本,作者未声明开源数据、代码或模型权重(仅有项目主页),若最终不开源,独立复现 Compo-200K 与最终模型基本不现实——障碍不仅在算力,更在管线与 SAM-3、Chandra-OCR-2 等特定工具版本的深度耦合。对第三方而言,更可行的路径是复用其接口设计(空间画布、四绑定、Text Specifications、区域匹配评测),在自有编辑模型上用小规模自动标注数据复刻流程;若后续开源数据与权重,由于整条管线无需人工标注,复现与再训练难度属中等水平。
论文图表
补充的定性对比第一部分,包含西部片海报、图书促销等更多主题,同样以「Text Specifications + Spatial Canvas + 各模型输出」的版式呈现,粉框标注基线的错误区域。
提供更多失败模式样本,帮助读者判断 Figure 5 的对比是否为精心挑选的特例,增强定性结论的可信度。
补充定性对比第二部分,包括教育文化节、野餐零食、学术集市等示例,其中可见基线把「Cucumber」渲染成断字错排等文本绑定失败,而 Compo 保持全部五条文字正确且位置准确。
进一步覆盖多元素、多文本的复杂构图场景,展示模型在绑定数量增多时的稳健性,是对定量结果的必要补充。