VibeEdit:基于画布指令的图像编辑 VibeEdit: Image Editing with Canvas Instructions
在图上圈选、涂鸦、拖箭头并写简短注释即可精准局部编辑,无需文本提示词
前置知识
Flow Matching(流匹配)
一种生成建模框架:在数据分布与噪声分布之间定义插值路径,训练网络预测沿路径的速度场。本文中噪声潜变量为 $z_t = (1-\sigma_t)z_0 + \sigma_t\epsilon$,目标速度 $v^* = \epsilon - z_0$,模型学习 $v_\theta$ 逼近 $v^*$,训练损失即速度预测的均方误差。
VibeEdit 的监督微调损失和强化学习目标全部建立在流匹配的速度预测之上,不理解 $z_t$ 与 $v^*$ 的定义就无法读懂其公式(1)(2)和 DiffusionNFT 目标。
LoRA(低秩适配)
参数高效微调方法:冻结预训练权重,只训练低秩分解出的旁路矩阵。VibeEdit 在 Qwen-Image-Edit 的 DiT 注意力投影与调制层上训练 rank-128 的 LoRA 适配器,SFT 与 RL 阶段各训练一个独立适配器,可训练参数约 7.08 亿。
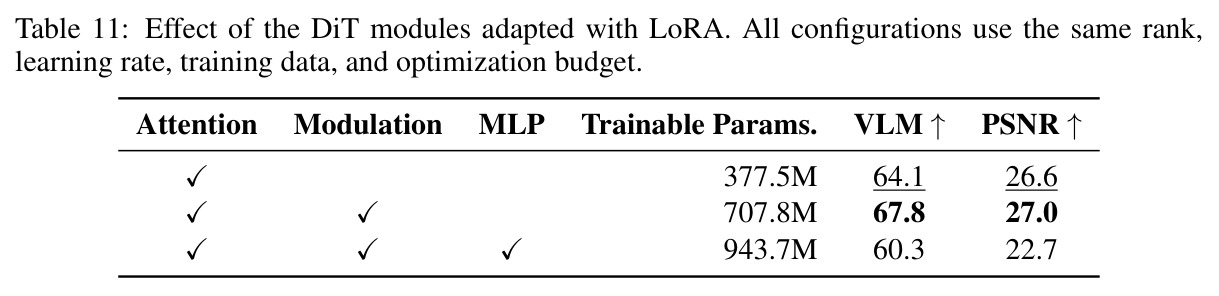
论文的多处消融(适配哪些模块、两阶段为何各用新 LoRA)都围绕 LoRA 配置展开,附录 Table 11 显示加适配调制层 crucial、再加 MLP 反而有害。
DiT 参考条件机制
Diffusion Transformer 是现代扩散/流模型的骨干。Qwen-Image-Edit 的条件方案把带时间步 $t$ 的噪声目标 token 与时间步 0 的参考条件 token 一并送入 DiT 做注意力,参考 token 携带待编辑源图信息,使模型能『照着原图改』。
理解 layer-decoupled conditioning 的前提是知道 DiT 接收哪些 token:本文让源图 token、画布 token、语义 token 各司其职,消融 Table 2 证明这一分工的价值。
DiffusionNFT(前向过程强化学习)
一种无需存储完整去噪轨迹的扩散模型 RL 算法:把 rollout 的最终潜变量重新加噪,用正向重构损失构造隐式正负预测 $v^+_\theta=(1-\beta)v_{old}+\beta v_\theta$ 与 $v^-_\theta=(1+\beta)v_{old}-\beta v_\theta$,再以奖励导出的权重 $\rho_k\in[0,1]$ 平衡正负分支的重构损失。
VibeEdit 第二阶段直接采用 DiffusionNFT 更新策略,奖励如何归一化成 $\rho_k$、条件内中心化与类型内标准化各起什么作用,是其 RL 设计的核心细节。
区域外 PSNR
峰值信噪比衡量两图逐像素差异(dB,越高越相似)。本文特制版本是『编辑区域外 PSNR』:把输出图与源图在排除编辑区(加 padding 后)的范围内比较,专门度量未编辑区域是否被模型顺手改动。
局部编辑的核心矛盾是『改对目标』与『不动其他地方』的平衡,rubric 分数量化前者,区域外 PSNR 量化后者,两者互补才构成完整评价。
Rubric 评测(LLM-as-Judge)
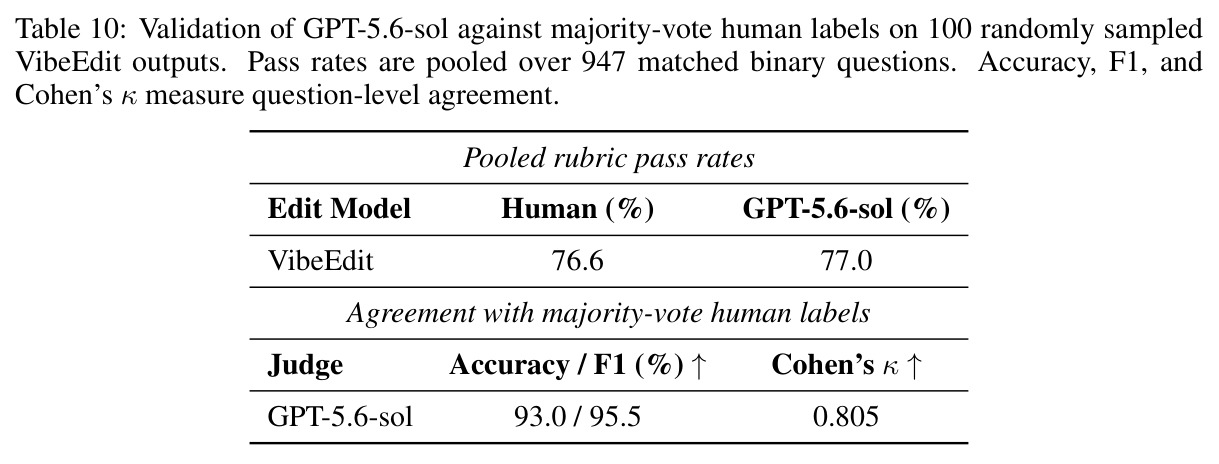
用多模态大模型按预定义二值问题清单逐项判分。本文 rubric 分三组:编辑成功、区域外保持、局部编辑质量;每题 0/1,取平均为 rubric 分数。RL 时用 GPT-5.4-mini 做裁判,基准评测用 GPT-5.6-sol,与人类多数票一致率 93.0%、Cohen's κ=0.805。
本文的 RL 奖励信号和主实验结论都依赖这套判分体系,理解 rubric 如何构造、如何被验证可信,是判断实验结论成色的关键。
研究动机
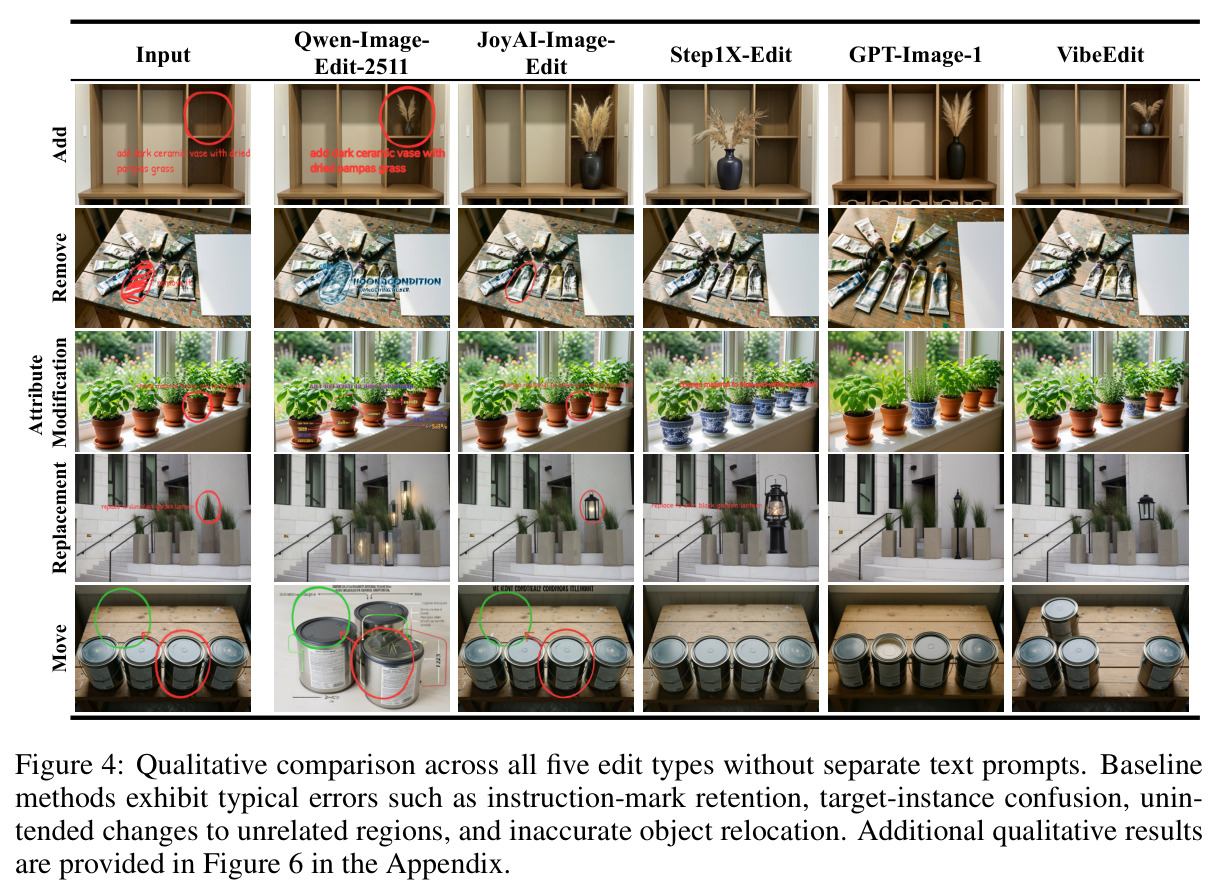
指令式图像编辑要求用户同时说清『改什么』和『改哪里』。改什么往往一句话就够,但指认目标在相似物体密集的场景会变得非常繁琐:画面里有几把外观接近的椅子时,用户不得不用『左数第二把、靠窗那把、扶手是木质的』这类冗长描述来消歧,编辑模型还经常理解错、改错对象。已有的空间控制手段各有局限:DragGAN、DragDiffusion 等拖拽式方法只支持移动/形变一类操作;Inter-Edit、FineEdit、涂鸦引导编辑等区域引导方法虽用 mask、边框或涂鸦定位,但仍需要一条独立的外部文本指令来表达语义,交互被拆成『图上定位 + 文本框里写要求』两步;MagicQuill 系列引入更丰富的笔刷交互,但编辑提示由模型推断或需要分层控制,尚未把开放词表的手写文字直接放进画布。此外,局部编辑中绝大多数像素不应改变,而通用编辑器经常顺带重绘无关区域,甚至把界面标注的圆圈笔迹原样复现到输出图里。
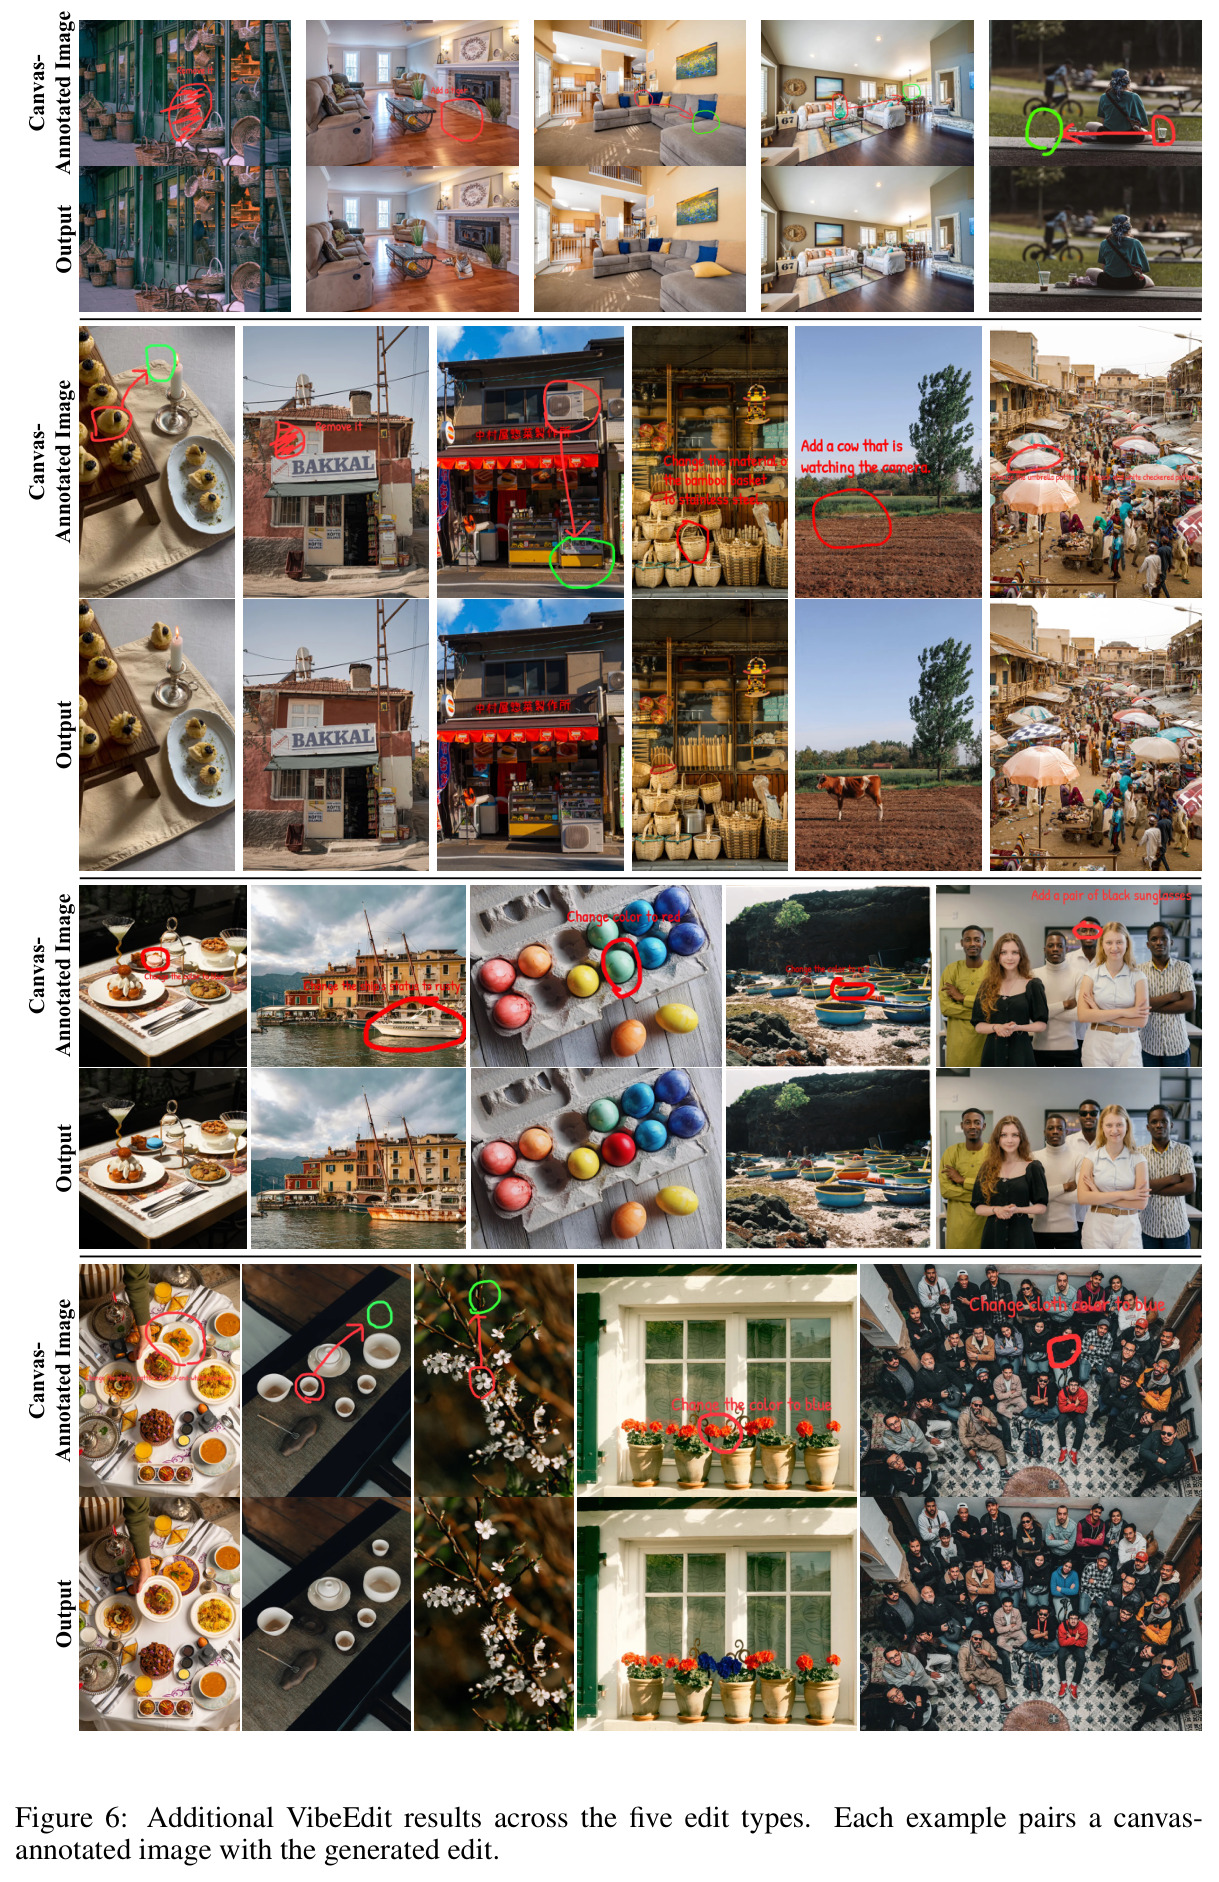
本文的目标是本文要构建一种『画布指令』式的新编辑界面与配套模型:用户直接在图像上放置空间标记——圆圈指认要编辑的对象或区域、涂鸦表示删除、带方向的箭头表示移动,并可在标记旁写简短的手写或印刷体文字说明想要的内容或属性(例如圈住一把椅子在旁边写上新颜色,或圈住空白区域写上要添加的物体名)。这些标记共同构成一条画布指令,同时编码『改哪里』与『改什么』,从而完全不需要单独的文本提示词。模型需支持添加、移除、替换、属性修改、移动五类操作,并满足三个硬性要求:在相似物体中正确选中目标实例、高质量完成局部编辑、保持未编辑区域几乎不动,且输出图中不能残留任何标注笔迹。
与已有工作不同的是,本文的独特切入是把语义指导本身搬到画布上:此前空间线索只负责定位、语义仍依赖外部文本,VibeEdit 让圆圈、涂鸦、箭头与开放词表的手写短注在同一张图上共同构成完整指令,且不要求标注贴合物体精确边界。训练侧的关键巧思是把『编辑内容』与『标注样式』解耦——离线只存储源图、目标图、物体掩码和结构化编辑描述,画布标注在训练时在线渲染,于是同一对样本可以变换笔触形状、宽度、字体(手写/印刷),可逆操作还能随机采样正反两个编辑方向,一份存储服务两种监督。架构上提出 layer-decoupled conditioning,让语义理解与生成条件各走各的编码通路,从机制上避免标注被当作图像内容复现到输出;训练策略上先做区域加权监督微调,再用按 rubric 分组奖励的 DiffusionNFT 强化学习,专治『看似合理但改错对象/误伤无辜区域』这类监督学习难以根治的行为缺陷。
核心方法
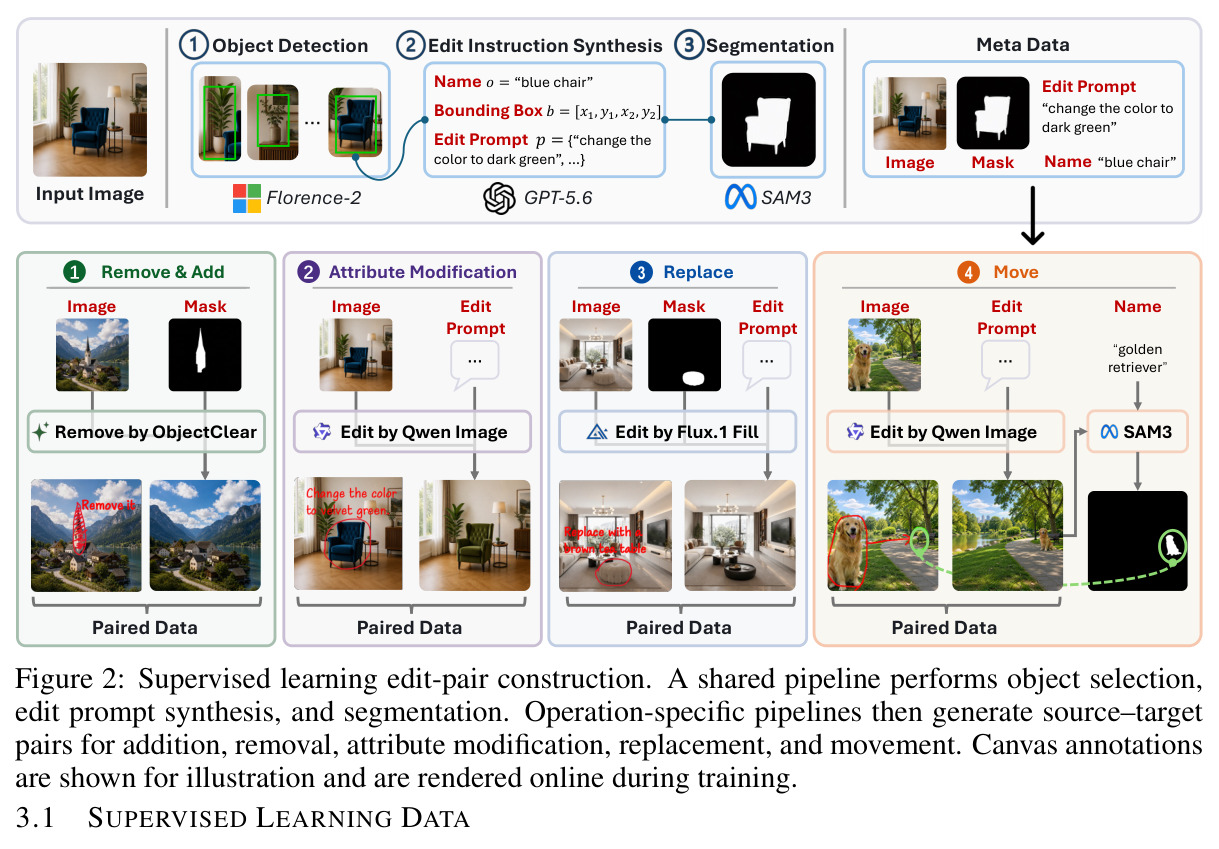
VibeEdit 的直觉是像在纸质文档上批注一样编辑图片:圈出目标、写上要求即可,模型负责读懂批注并只改动该改的地方。技术路线上,作者从 Qwen-Image-Edit 出发做三段式适配。第一步构建约 155 万对源-目标编辑对:Florence-2 生成开放词表候选框,GPT-5.6-sol 按规则挑选可编辑对象并生成编辑描述,SAM 3 依框产出掩码;随后 ObjectClear(移除/添加)、Qwen-Image-Edit(属性修改/移动)、FLUX.1 Fill(替换)分别合成目标图,画布指令(圆圈、涂鸦、箭头、手写短注)在训练时在线渲染。第二步区域加权监督微调:以流匹配损失为基础,对编辑对象与标注笔迹覆盖的潜变量区域施加 $\lambda=1.5$ 的额外权重,掩码先膨胀 50 像素再下采样;冻结 VAE、视觉语言编码器与 DiT 主干,只训练 rank-128 LoRA。第三步 rubric 引导的强化学习:从 12000 步的 SFT 检查点出发,对按奖励方差筛出的 3520 个条件各采样 12 个 rollout,由 GPT-5.4-mini 按编辑成功、区域外保持、局部质量三组二值问题打分并施加区域外 PSNR 惩罚,用 DiffusionNFT 前向过程目标更新新的 LoRA 适配器。
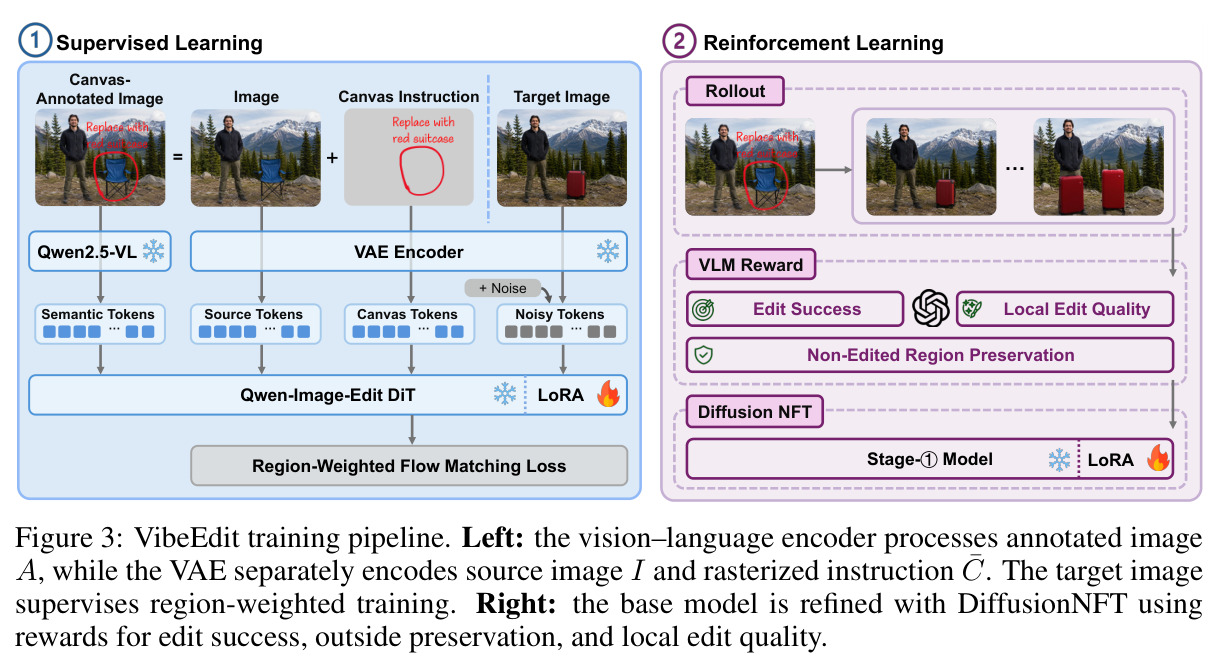
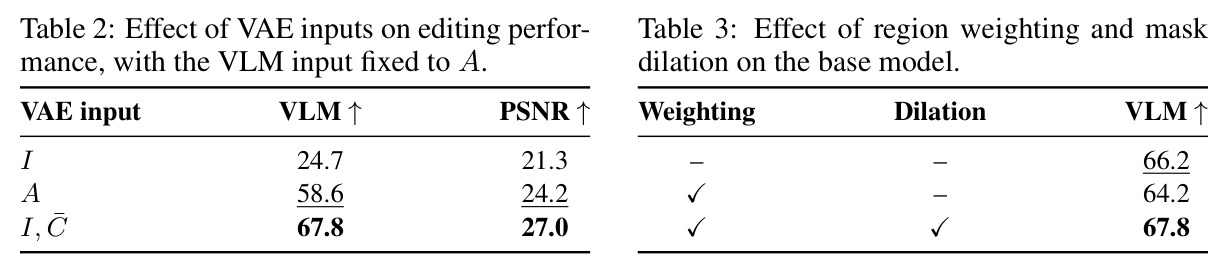
核心创新是 layer-decoupled conditioning,即『标注只做语义、不做内容』的信息分层设计。若只把标注后的图像 $A = I \oplus C$ 送进生成通路,VAE 会把红色圈痕和手写字当作图像内容编码,输出常常原样复现这些标注。VibeEdit 的解法是双通路分工:冻结的 Qwen2.5-VL 编码器读取完整标注图,输出语义 token $h = E_{VL}(A)$,在场景上下文中理解指令含义;生成通路则把干净源图 $I$ 与渲染在中性灰底 $(128,128,128)$ 上的标注层 $\bar{C}$ 分开编码为 $z_I = E_{VAE}(I)$ 和 $z_C = E_{VAE}(\bar{C})$,二者以时间步 0 的参考条件进入 DiT。这样显式的空间布局由 $z_C$ 提供,干净的像素参照由 $z_I$ 保证,语义理解由 $h$ 完成,三条信息互不污染。消融(Table 2)证明该设计至关重要:VAE 只编码源图时 rubric 仅 24.7,改编码标注图 $A$ 升到 58.6,分离编码 $I$ 与 $\bar{C}$ 进一步达到 67.8,区域外 PSNR 从 24.2 提升到 27.0 dB。
方法步骤详情
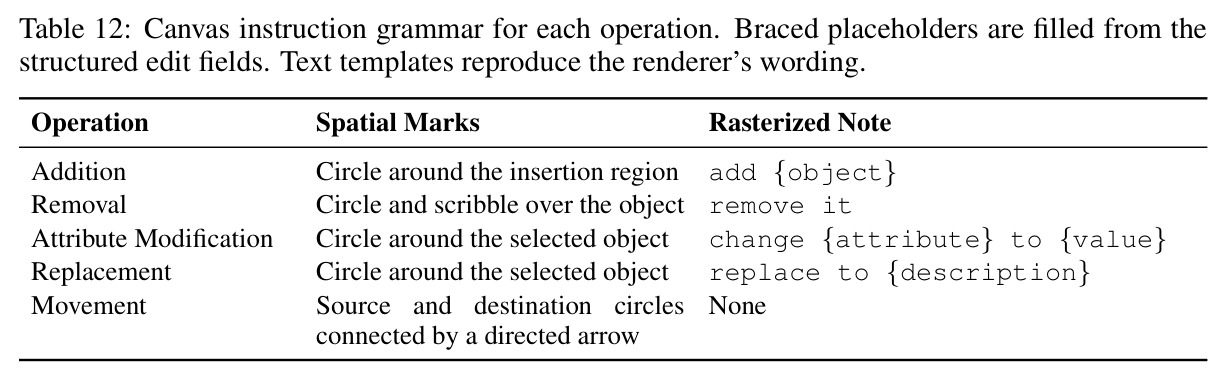
完整流程分数据构造、SFT、RL 三段。数据构造:每张图先由 Florence-2 生成候选框,过滤过大过小后交 GPT-5.6-sol 按操作专属规则选对象(要求可识别、可见充分、空间可分离),产出物体名与编辑提示 $p$,SAM 3 依框生成掩码 $M$。移除用 ObjectClear 修补出无目标图,把『原图→修补图』与反转方向分别作为移除/添加监督;属性修改由 GPT 从颜色/材质/纹理/图案/状态/局部风格中选一个可见属性并指定可验证目标值,Qwen-Image-Edit 执行;替换由 FLUX.1 Fill 在扩张掩码内生成他类对象;移动由 Qwen-Image-Edit 搬运刚性物体,再用 SAM 3 在结果图上定位终点得到目标掩码。所有记录离线存储;训练时在线渲染画布指令:添加/属性/替换用红圈加手写短注(如 'add {object}'、'change {attribute} to {value}'),移除用圈住的涂鸦加 'remove it',移动用红圈(起点)与绿圈(终点)加有向箭头,圈与掩码边界距离随机取 0.25–0.45 倍等效半径、透明度取 0.82–1.0、字体覆盖手写与印刷体。SFT:$z_t=(1-\sigma_t)z_0+\sigma_t\epsilon$、$v^*=\epsilon-z_0$,损失 $\mathcal{L}_{SFT}=\mathbb{E}\left\|(1+\lambda f_M)\odot(v_\theta(z_t;h,z_I,z_C,t)-v^*)\right\|^2$,监督掩码 $M_{sup}=M_{obj}\vee M_{ann}$(移动时 $M_{obj}$ 为起终点掩码并集)膨胀 50 像素,$\lambda=1.5$;约 $1024^2$ 分桶、全局 batch 128、lr $5\times10^{-5}$(500 步预热后恒定)训 12000 步。RL:每条件用 SFT 模型离线采 12 个 rollout 算奖励标准差 $\sigma(c)$,每类选方差最高的 704 个、共 3520 个条件;奖励 $R_k=\frac{1}{|Q|}\sum_j q_{k,j}-\gamma_p\mathbb{1}[PSNR_{out}<\tau_p]$($\gamma_p=0.3$、$\tau_p=25$ dB),条件内中心化、类型内标准差归一化得 $\rho_k$;在 $512^2$ 分辨率、每条件 12 个 rollout、8 步去噪、CFG 1 下训 220 步,超参 $a_{max}=5$、$\beta=1$、$\eta=10^{-4}$。两阶段共用 32 张 A100。
技术新颖性
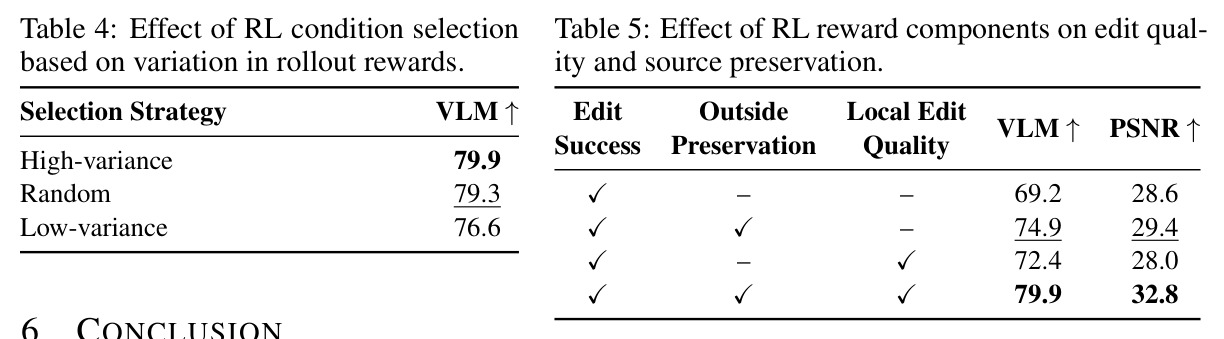
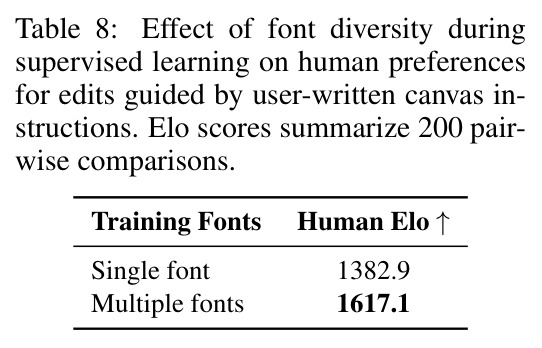
新颖性体现在五个层面。其一,接口层面:画布指令是首个把定位标记与开放词表手写语义统一在同一画布上、并覆盖添加/移除/替换/属性/移动五类操作的编辑接口,区别于只做单一操作的拖拽方法和『图上定位+外部文本』两段式的区域引导方法。其二,架构层面:layer-decoupled conditioning 把语义通路(VLM 看标注图)与生成通路(VAE 分别编码干净图与灰底标注层)解耦,直接解决视觉指令方法特有的『输出残留标注』难题,消融显示分离编码比混编标注图多拿 9.2 分 rubric、2.8 dB。其三,数据层面:存储结构化记录、在线渲染标注,使 155 万对样本每次呈现不同笔迹字体,可逆方向采样进一步翻倍监督多样性;人类 Elo 评估证明多字体训练从 1382.9 提升到 1617.1。其四,优化层面:区域加权加膨胀的 SFT 损失针对局部编辑中『绝大多数像素不变』造成的梯度稀释(不膨胀反而从 66.2 掉到 64.2);RL 条件按奖励方差而非均值筛选,为 DiffusionNFT 的组内相对信号保留最多信息(高方差 79.9 vs 低方差 76.6)。其五,奖励层面:三组 rubric(成功/保持/质量)加 PSNR 低层惩罚的组合经 Table 5 验证缺一不可,PSNR 惩罚专门弥补二值 VLM 判断对低层像素变化的盲区。
实验结果
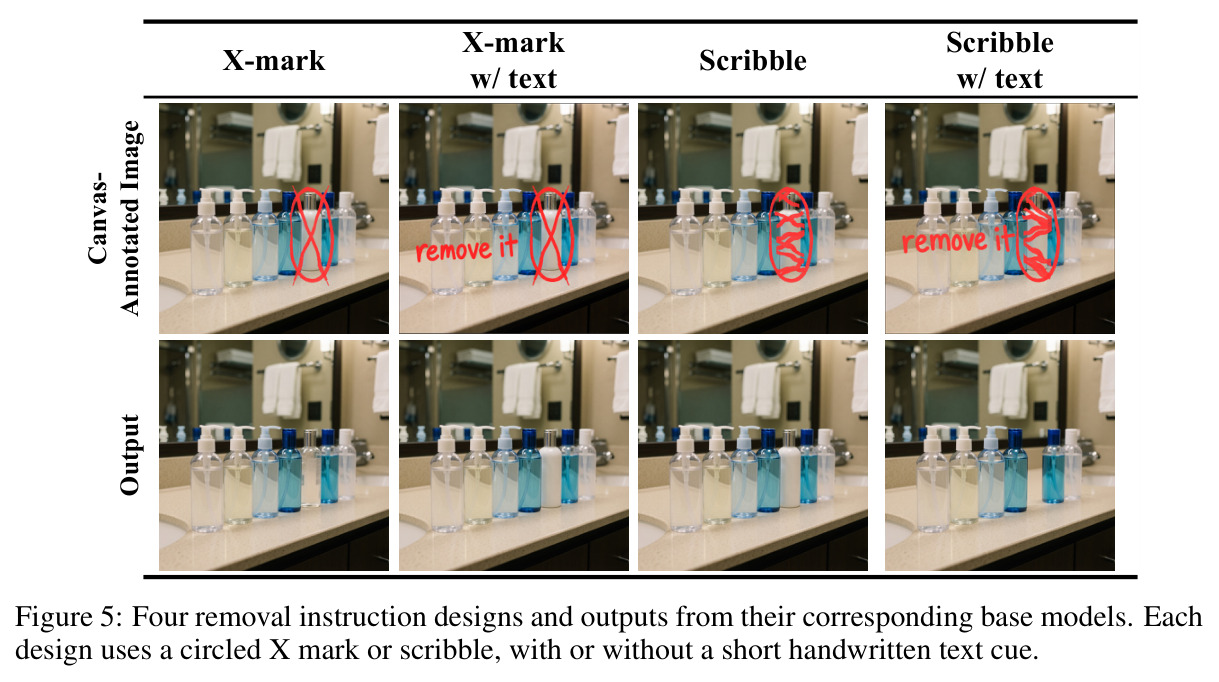
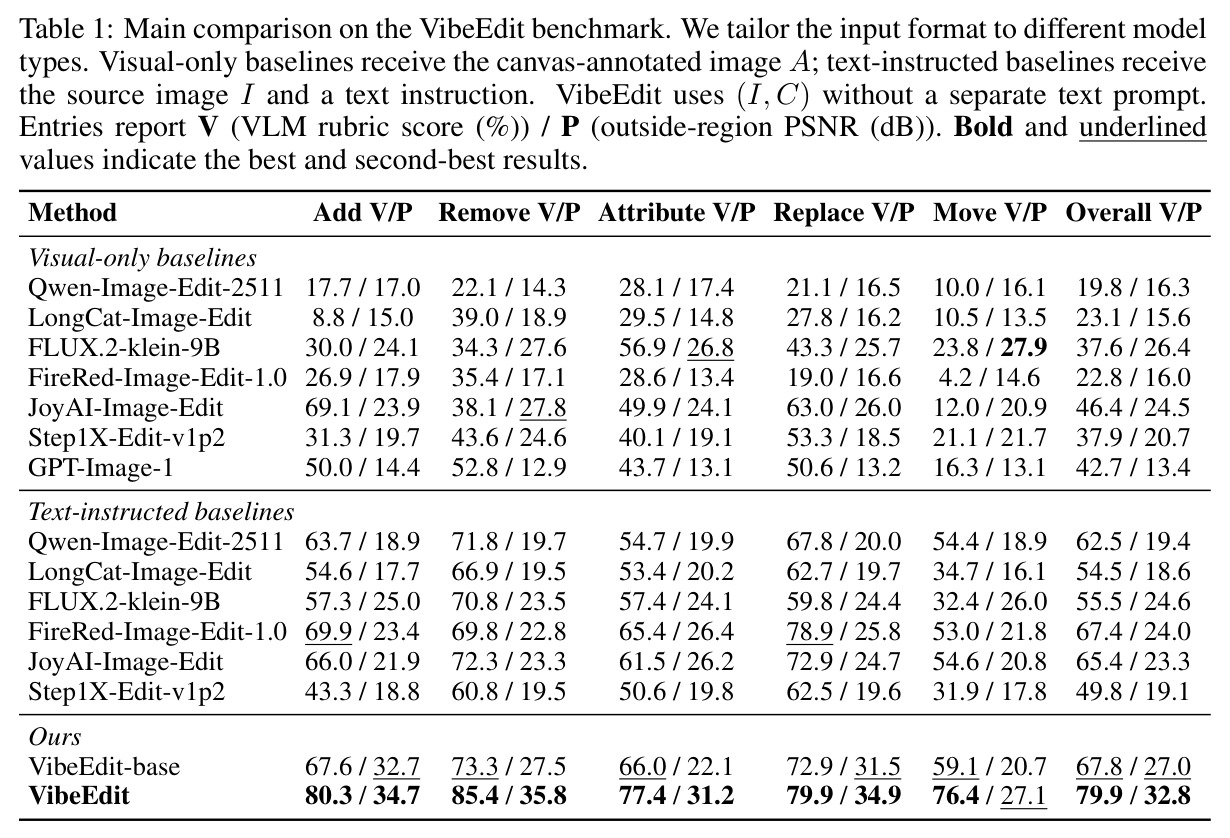
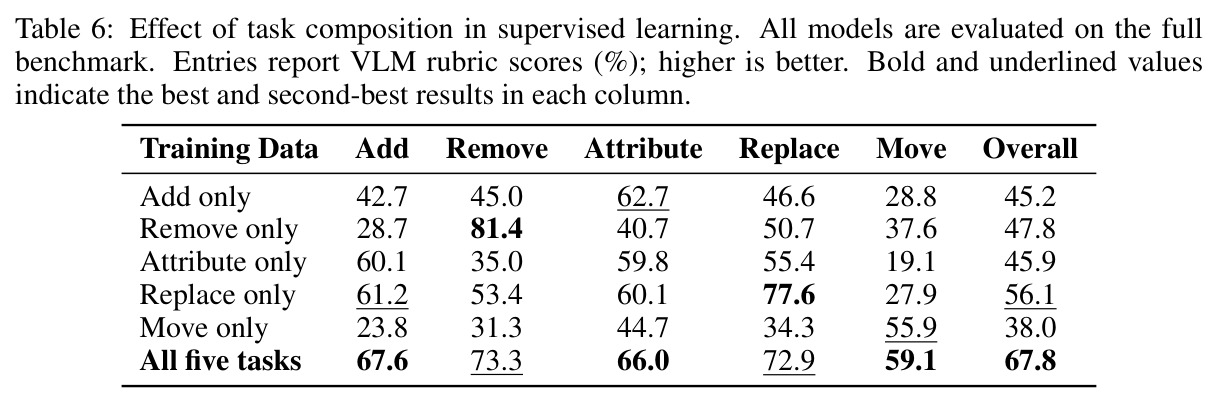
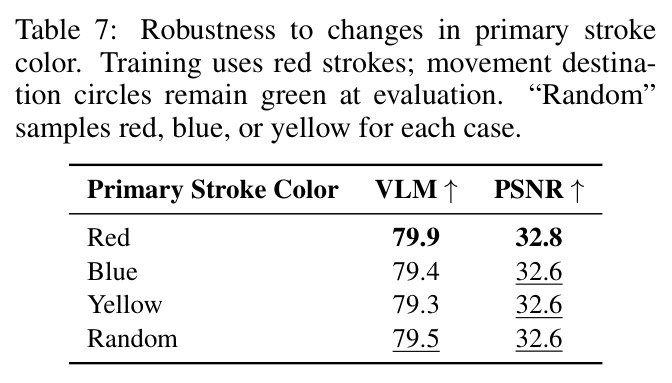
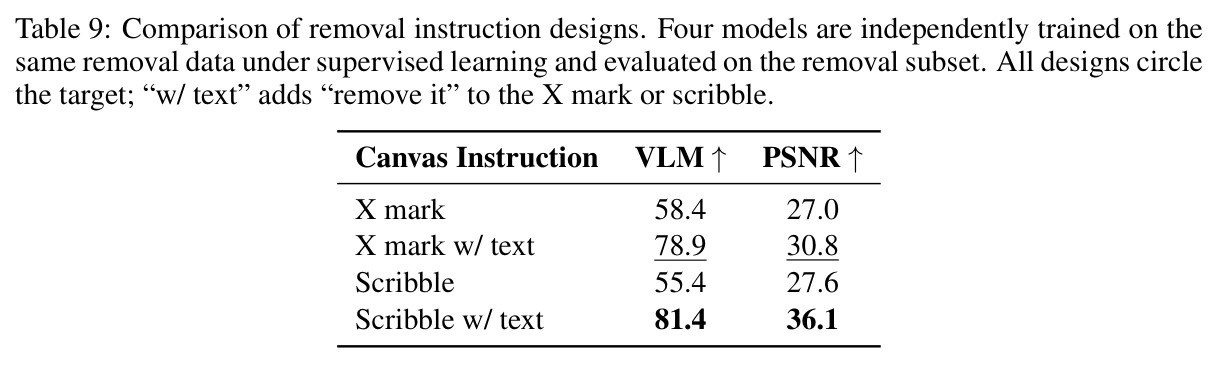
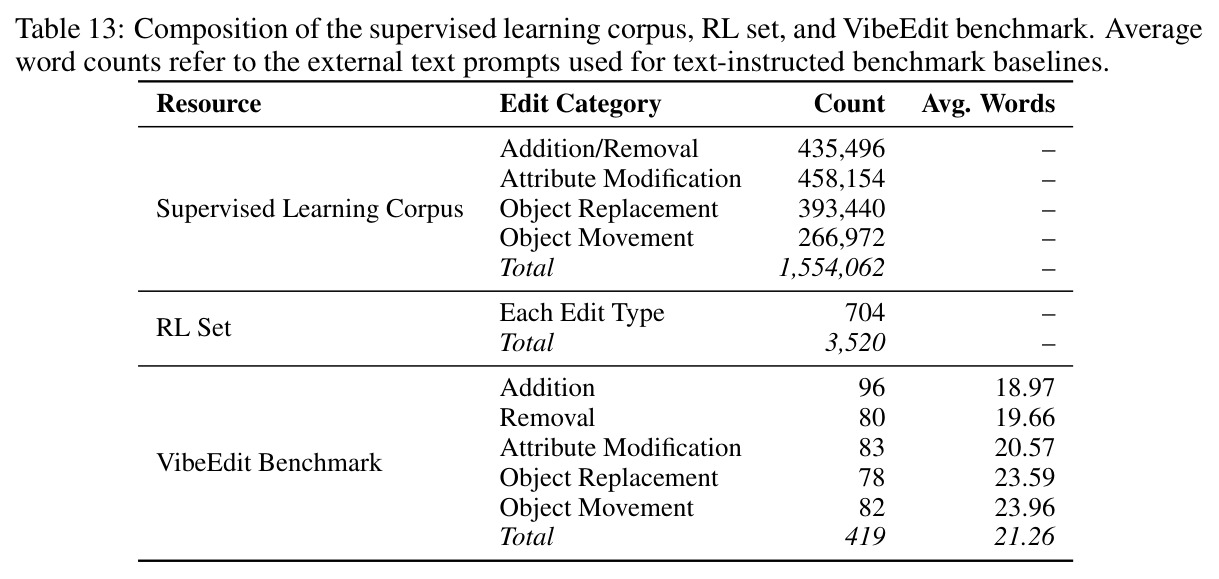
主实验在独立构建、人工精选的 419 例基准上进行(强调相似物体场景),对比七个基线。最关键的发现是:所有公开基线拿到标注图而无文本时表现崩溃(总体 rubric 19.8–46.4),说明现有模型根本读不懂画布指令;即便给文本基线平均 21.3 词的详细外部指令(明确指出目标位置和要求),最高分的 FireRed 也只达 67.4 分/24.0 dB。VibeEdit-base(纯 SFT)以 67.8 分/27.0 dB 追平 FireRed 分数且保真更好;RL 后的最终模型达到 79.9 分/32.8 dB,并在五个子任务上全部第一:添加 80.3/34.7、移除 85.4/35.8、属性 77.4/31.2、替换 79.9/34.9、移动 76.4/27.1;区域外 PSNR 比最强基线(FLUX.2-klein 24.6 dB)高 8.2 dB,说明它既改得准又几乎不碰无关像素。消融逐一确认组件贡献:层解耦条件 24.7→58.6→67.8;区域加权必须配合 50 像素膨胀(66.2 与 64.2 vs 67.8);RL 条件高方差筛选 79.9 优于随机 79.3 和低方差 76.6;三组奖励缺一不可(仅编辑成功 69.2/28.6,加质量 72.4 但 PSNR 降,加保持 74.9/29.4,全用 79.9/32.8);五任务联合训练 67.8 显著优于任何单任务模型(38.0–56.1),且在添加、属性、移动上出现正向迁移。附加分析:笔触换蓝/黄/随机色最多掉 0.6 分,颜色鲁棒;移除指令『圈涂鸦+文字』81.4/36.1 远优于纯 X 记号 58.4/27.0;LoRA 适配注意力+调制层最佳(67.8),再加 MLP 反而暴跌到 60.3;GPT-5.6-sol 评委与人类多数票在 947 个二值问题上一致率 93.0%、F1 95.5%、κ=0.805,评测协议可信。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 总体(五类编辑平均) | VLM rubric (%) / 区域外 PSNR (dB) | 79.9 / 32.8 | FireRed-Image-Edit-1.0(最强文本指令基线)67.4;最强 PSNR 基线 FLUX.2-klein 24.6 | +12.5 分 / +8.2 dB |
| 对象添加 | VLM rubric / 区域外 PSNR | 80.3 / 34.7 | FireRed 69.9 分;FLUX.2-klein 25.0 dB | +10.4 分 / +9.7 dB |
| 对象移除 | VLM rubric / 区域外 PSNR | 85.4 / 35.8 | JoyAI-Image-Edit 72.3 / 27.8 | +13.1 分 / +8.0 dB |
| 属性修改 | VLM rubric / 区域外 PSNR | 77.4 / 31.2 | FireRed 65.4 / 26.4 | +12.0 分 / +4.8 dB |
| 对象替换 | VLM rubric / 区域外 PSNR | 79.9 / 34.9 | FireRed 78.9 分;JoyAI 26.2 dB | +1.0 分 / +8.7 dB |
| 对象移动 | VLM rubric / 区域外 PSNR | 76.4 / 27.1 | JoyAI 54.6 分;FireRed 21.8 dB | +21.8 分 / +5.3 dB |
局限与改进
作者明确讨论的局限不多,但可从论文细节推断几点。其一,评测基准仅 419 例且由作者团队自建标注,虽强调与训练语料独立,但每类约 80 例的子集让 1–2 分级别的差异难以达到统计显著。其二,RL 奖励与基准评测都依赖 GPT 系评委,虽与人类一致率达 93.0%(κ=0.805),但该验证只在 VibeEdit 自身输出的 100 个样本上进行,评委在其他模型输出(风格可能迥异)上的偏差未经验证。其三,鲁棒性测试只覆盖笔触颜色(红/蓝/黄)与字体多样性,未测真实用户更随意的笔迹、圈选不贴合目标、箭头画得不规范等分布外输入。其四,整条流水线深度依赖闭源或第三方模型(GPT-5.6-sol、GPT-5.4-mini、SAM 3、ObjectClear、FLUX.1 Fill、Qwen-Image-Edit),数据合成中的误差只能靠 GPT 质检加 RL 缓解,无法根除;论文自己承认『过滤未必消除所有错误』。其五,移动任务相对最弱(76.4/27.1),其区域外 PSNR 比其他任务低约 4–9 dB,说明大位移重绘仍会波及周边像素;所有实验限于约 $1024^2$ 分辨率,未报告推理耗时与交互延迟。
独立分析的弱点
独立分析有四个值得关注的弱点。第一,监督信号全部来自模型合成:目标图由 Qwen-Image-Edit、FLUX.1 Fill、ObjectClear 生成,这些生成器自身的伪影(修补区纹理痕迹、替换物光影不接)会混入『标准答案』,模型可能学进系统性偏差;改进方向是引入真实前后对比图(如设计师修图历史、图像版本管理记录)做校准集,或在数据质检中加入伪影判别器而非仅靠 GPT 打分。第二,画布指令语法较封闭:Table 12 的模板('add {object}'、'change {attribute} to {value}' 等)限定了可表达意图的范围,多对象联合编辑、模糊意图(『让它好看点』)、条件性编辑均无法表达;可扩展为多轮渐进式画布对话,允许圈多个区域写组合要求。第三,短注理解本质上是 OCR+语义解析,训练语料的手写风格由渲染引擎合成,覆盖有限——人类评估也只做了 200 对偏好比较,真实书写场景(连笔、倾斜、中英混排、简写俚语)下的退化程度未知;应扩充手写渲染多样性并纳入真实用户标注数据做域适应。第四,RL 阶段规模很小:每类 704 个条件、每条件 12 个 rollout、仅 220 步,与 155 万对的 SFT 相差三个数量级,说明最终 12 分的提升可能远未到上限;更大规模在线采样、更高效的探索或离线优先级回放都值得尝试。
未来方向
作者方向上,rubric 分组奖励与 DiffusionNFT 的组合可自然迁移到其他『局部修改保真』任务,如虚拟试穿、文档图像编辑、摄影修图流水线;其评委-人类一致性验证流程(κ=0.805)也可作为社区评测协议推广。基于本文成果可延伸的研究包括:(1) 把画布指令从静态单轮扩展为多轮交互,支持『先圈椅子改蓝、再把旁边桌子挪走』的渐进式编辑并保持前轮结果不变;(2) 引入真实用户书写数据与在线学习,弥合合成手写与真实笔迹的分布差距;(3) 把移动箭头推广为形变控制(缩放、旋转、非刚性变形),与 DragGAN 类细粒度控制合流成统一画布语法;(4) 在输出端加标注残留检测头或显式『擦除监督』,进一步压低笔迹复现率,并把该机制作为通用视觉指令编辑的即插即用组件;(5) 摆脱闭源依赖:用开源 VLM 替代 GPT 系评委与选择器、开源分割模型替代 SAM 3,形成完全可复现的开源训练栈,并公开发布数据集与权重;(6) 扩展到视频局部编辑——画布上的箭头天然对应运动意图,区域加权损失与区域外保持奖励可直接推广到时空区域。
复现评估
复现难度中偏高。利好方面:论文对流程的描述异常详尽——附录给出对象选择规则全文、评委系统与用户 prompt、全部 rubric 二值问题、DiffusionNFT 目标与超参($K=12$、$a_{max}=5$、$\beta=1$、$\eta=10^{-4}$、$\delta=10^{-4}$)、渲染细节(圆距掩码边界 0.25–0.45 倍等效半径、透明度 0.82–1.0)以及语料统计(Table 13),并提供了项目主页。障碍方面:数据构造依赖 GPT-5.6-sol 与 GPT-5.4-mini 两个闭源 API(155 万对的选择、描述、质检全走 GPT,成本可观),ObjectClear、SAM 3、Qwen-Image-Edit、FLUX.1 Fill、Florence-2 虽大多公开但需要工程拼装整条流水线;155 万对训练数据与模型权重截至论文成文未见开源发布;训练需要 32 张 A100(SFT 12000 步全局 batch 128 + RL 220 步),RL 每轮还要对 3520 条件做在线 rollout 并调用 GPT 判分,API 开销与工程复杂度显著。资源有限的复现者建议先小规模复现 SFT 与核心消融(如 Table 2 的层解耦条件对比,仅需 Qwen-Image-Edit + 小量合成对),确认趋势后再按比例缩减 RL 条件数验证奖励设计。
论文图表
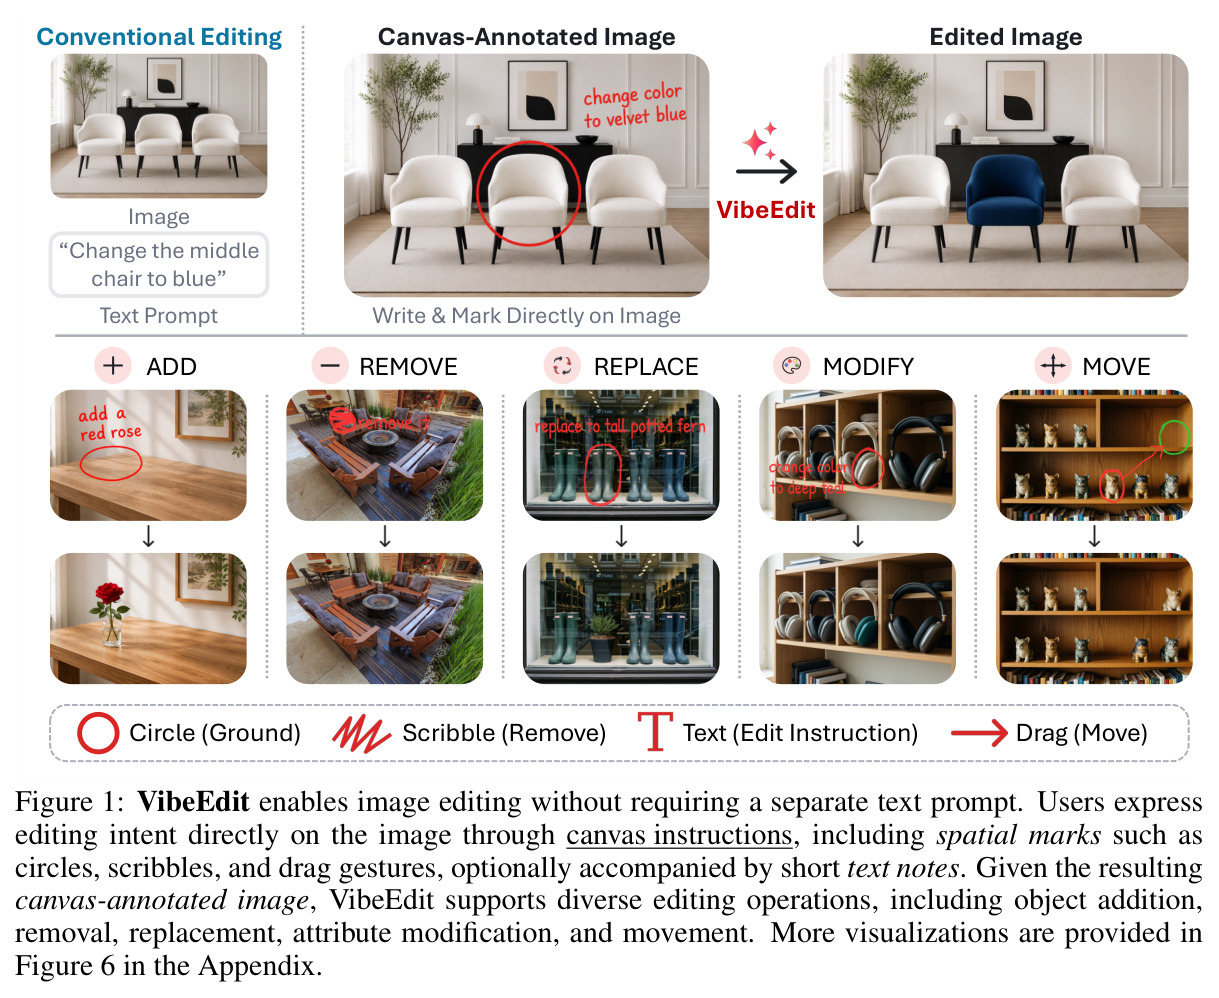
论文开篇的概念图:上半部分对比传统文本提示编辑与 VibeEdit 的画布标注方式;下半部分展示四种画布标记——圆圈(定位目标)、涂鸦(删除)、手写文字(编辑说明)、拖拽箭头(移动),并给出添加/移除/替换/修改/移动五种操作的示意。
一图看懂论文提出的新交互范式:空间标记加简短注释如何在图上直接同时表达『改哪里』和『改什么』,是理解全文动机的入口。
区域加权监督的消融:不加权 66.2,加权但不膨胀掩码反而降到 64.2,加权加 50 像素膨胀达 67.8。
揭示一个反直觉细节:只对编辑区加权而不膨胀会让边界监督不足、性能反而下降,说明上权区域必须覆盖标注痕迹附近与编辑的外溢效应。
奖励组合消融:仅编辑成功 69.2/28.6;加局部质量 72.4 但 PSNR 降至 28.0;加区域外保持 74.9/29.4;三组全用 79.9/32.8。
证明三类 rubric 奖励的互补性:质量奖励会诱使模型过度修饰、牺牲保真,必须与保持奖励配对;这是 RL 奖励设计的核心权衡证据。